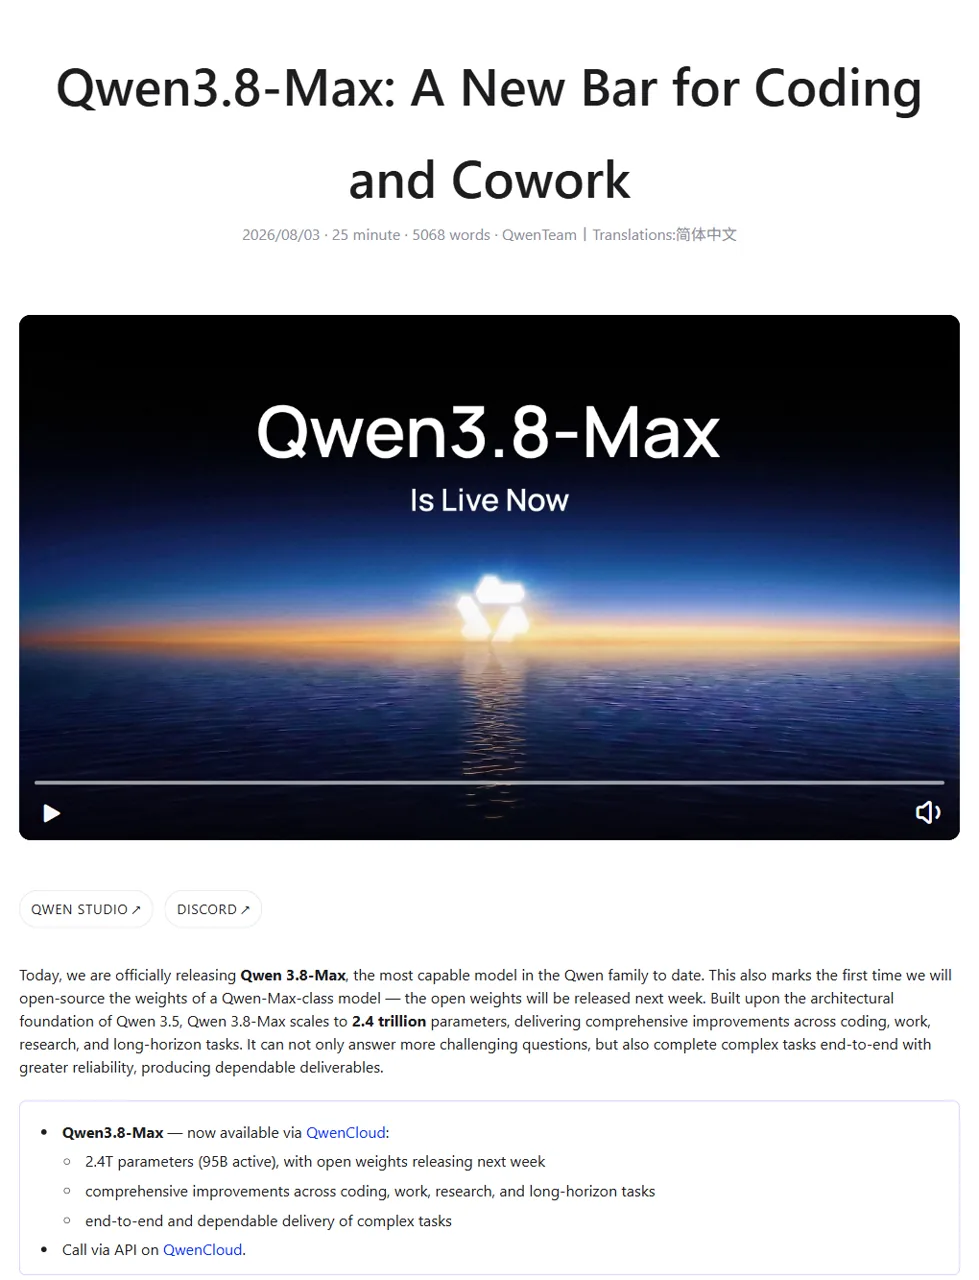
Le Qwen 3.8 Max est le nouveau modèle phare d'Alibaba Qwen, destiné au codage, aux tâches professionnelles, à l'exécution d'agents en continu et aux tâches multimodales. Son nom officiel est Qwen3.8-Max, son lancement a été annoncé le 3 août 2026 : il compte au total 2 400 milliards de paramètres, dont 95 milliards de paramètres actifs, et dispose d'une fenêtre de contexte d'un million de tokens.
Ce lancement va bien au-delà d'une simple mise à jour de référence de routine. Qwen positionne ce modèle comme un agent capable de planifier, d'utiliser des outils, d'analyser des retours visuels et de poursuivre son travail tout au long de longues chaînes de tâches — et non pas simplement comme un chatbot qui répond à une seule requête à la fois. Cela le place dans la même catégorie que le les meilleurs modèles d'IA pour une utilisation concrète, mais son prix par API, son forfait à consommation illimitée et ses exigences de déploiement méritent d'être examinés de plus près avant de changer de fournisseur.
Qu'est-ce que le Qwen3.8-Max ?
Qwen3.8-Max est un modèle de type « mélange d’experts » à grande échelle développé par l’équipe Qwen d’Alibaba. Il compte au total 2,4 billions de paramètres, mais n’en active que 95 milliards pour chaque token. Ce modèle combine la compréhension du texte, du code et des images, l'utilisation d'outils et la planification à long terme au sein d'un système unique conçu pour mener à bien des tâches complexes de A à Z.
Le Communiqué officiel Qwen décrit quatre objectifs centraux : un codage autonome plus performant, des livrables professionnels de qualité industrielle, des tâches en boucle fermée plus longues et des agents multimodaux natifs. Concrètement, Qwen souhaite que le modèle passe d’une approche consistant à “ répondre à cette question ” à une approche consistant à “ prendre cet objectif, élaborer un plan, utiliser les outils disponibles, vérifier le résultat et continuer jusqu’à ce que le travail soit terminé ”.”
Qwen 3.8 Caractéristiques techniques maximales
Le nombre de paramètres doit être replacé dans son contexte. Un modèle de 2,4 billions de paramètres est gigantesque, mais « Qwen3.8-Max » n’utilise pas tous ces paramètres pour chaque token. Sa conception de type « mélange d’experts » achemine chaque token via une partie active plus restreinte du réseau. Le chiffre de 95 milliards de paramètres actifs est donc plus utile pour comprendre le comportement d’inférence que le nombre total seul, même si aucun de ces deux chiffres ne permet à lui seul de déterminer la latence réelle ou les exigences matérielles.
La fenêtre de contexte d'un million de tokens est plus utile dans l'immédiat. Elle permet de traiter, en une seule requête, de grands dépôts, de longs ensembles de documents, des historiques d'agents étendus ou plusieurs mois d'enregistrements opérationnels. Cela ne garantit pas une récupération parfaite de chaque token, mais cela offre aux développeurs une marge de manœuvre bien plus grande pour conserver les instructions, les résultats des outils, le code et les décisions intermédiaires sans avoir à procéder à des coupes drastiques.
Que peut faire le Qwen3.8-Max ?
Codage autonome
Les documents de lancement de Qwen mettent l’accent sur des projets qui vont bien au-delà d’une simple demande de génération de code. L’entreprise décrit un développement autonome s’étalant sur plus de 10 jours, passant d’un dossier vide à un projet de production tout en s’adaptant aux erreurs et aux nouvelles exigences. C’est la bonne direction à prendre pour les agents à l’échelle du référentiel, même si les acheteurs doivent tout de même valider le modèle avec leurs propres langages, suites de tests, règles de sécurité et environnement de déploiement.
Dans le cadre de l'ingénierie au quotidien, les questions pratiques sont plus simples : le modèle est-il capable de traiter plusieurs fichiers à la fois ? Préserve-t-il les interfaces lors de la refactorisation ? Est-il capable d'écrire des tests, d'analyser les échecs et de corriger son propre correctif ? Ces critères ont plus d'importance qu'un simple score au classement lorsqu'il s'agit de choisir le Le meilleur modèle d'IA pour le codage.
Tâches professionnelles de “ coworking ”
Le terme “ cowork ” fait référence à des livrables professionnels plutôt qu’à des discussions informelles. Qwen met en avant des rapports, des études, des présentations, des analyses, des documents et d’autres livrables issus de centaines de métiers. Un bon modèle de « cowork » doit respecter un cahier des charges, structurer les données, utiliser le format approprié et aboutir à un résultat que l’on peut modifier ou transmettre — et non pas simplement à un paragraphe plausible.
Agents à horizon lointain
Qwen fait également état de tâches au niveau système s'étendant sur des centaines de cycles. Parmi les exemples cités, on trouve notamment plus de 500 tours d’optimisation de la conception de puces et une simulation de stratégie de commerce électronique s’étalant sur une année. Il s’agit là de démonstrations proposées par le fournisseur, et non d’une promesse que chaque agent fonctionnera sans surveillance pendant plusieurs jours. Elles montrent toutefois clairement l’orientation du produit : une planification persistante, une évaluation en boucle fermée et une amélioration continue, plutôt que des réponses isolées.
Planification multimodale et retour visuel
Qwen3.8-Max traite les images et les écrans dans le cadre de la boucle de l'agent. Un agent visuel peut inspecter une page, choisir une action, observer ce qui a changé et réviser son plan. Cela permet de prendre en charge les tâches informatiques, la compréhension de documents, les tests d'interface, le codage visuel, les graphiques et le raisonnement spatial. La difficulté ne réside pas simplement dans la reconnaissance d’une image, mais dans le fait de maintenir le lien entre les observations visuelles et l’objectif de l’agent tout au long d’une série d’étapes.
Tests pratiques : résultats utiles, réponses lentes et un test sans résultat
J'ai lancé trois requêtes indépendantes sur le qwen3.8-max ID du modèle via l'API compatible avec Anywhere OpenAI, le 4 août 2026. Il s'agit de petits tests pratiques, et non d'un benchmark indépendant ni d'une affirmation concernant tous les déploiements Qwen. Ils sont utiles car ils montrent à la fois la qualité de la réponse visible et le comportement du chemin de passerelle testé.
Débogage de Retry-helper
La première tâche utilisait une fonction de nouvelle tentative défectueuse issue d'un scénario de webhook de paiement. La consigne imposait au modèle trois tentatives, deux délais de retrait précis, un retour immédiat en cas de réussite et le déclenchement à nouveau de la troisième exception en cas d'échec total.
La réponse a mis en évidence trois défauts distincts : un « sleep » inconditionnel après chaque tentative, une variable non déclarée résultat après les exceptions, et une vérification de « truthiness » qui a retardé ou mal géré la réussite. La ligne attendue était : " paid " avec les arguments [0,1 ; 0,2] de la fonction sleep_fn.
J'ai alors exécuté le code localement plutôt que de me fier à l'explication. Il a réussi trois cas : deux échecs suivis d'un succès, une valeur de succès « falsey » lors du premier appel de 0, et trois échecs où le résultat final RuntimeError("failure-3") a dû être relancée. C'était une bonne solution technique. Le compromis concernait la latence : la réponse visible a pris 51,577 secondes via la passerelle testée.
Synthèse des données contradictoires
La deuxième tâche visait à vérifier si le modèle était capable de distinguer les informations officielles actuelles des anciennes notes, des affirmations des fournisseurs, d'un commentaire de la communauté et d'un itinéraire non vérifié sur la plateforme.
Le modèle a correctement géré le conflit introduit. Il n’a pas repris le contexte « 256K » ni le prix d’entrée « $1.20 » comme étant actuels, n’a pas converti une remarque concernant quatre GPU en une exigence matérielle, et n’a pas affirmé que « GlobalGPT » disposait déjà d’un itinéraire dédié « Qwen3.8-Max ». Il a également indiqué que le tableau officiel des benchmarks provenait des fabricants. La réponse a pris 94,973 secondes ; il s’agissait donc là encore d’un résultat privilégiant la qualité plutôt que la rapidité d’extraction.
Qu'est-ce qui n'a pas fonctionné lors de l'épreuve de planification ?
Une troisième requête demandait un plan de migration CMS de deux heures, impliquant deux ingénieurs, avec des étapes de décision « oui/non » et de retour en arrière clairement définies. La première requête s'est terminée après 133,682 secondes, lorsque la connexion en amont s'est fermée. Une série de tentatives plus courte max_completion_tokens à 1 200, mais l'API a indiqué finish_reason : " longueur ", a épuisé l'intégralité du budget de raisonnement et n'a fourni aucune réponse visible au bout de 32,899 secondes.
Il s'agit d'un avertissement opérationnel utile, mais cela ne prouve pas que Qwen3.8-Max soit incapable de planifier des migrations. Aucun plan n'était disponible pour être évalué. Dans ce contexte, une planification complexe nécessite une marge d'achèvement plus importante, un traitement par flux ou une invite par étapes afin que le raisonnement interne n'épuise pas l'intégralité du budget de réponse avant que le texte visible ne soit généré.
Qwen : performances maximales de 3,8
Le pack de tests de référence officiel de Qwen présente Qwen3.8-Max comme un agent multimodal et de codage performant, mais les résultats sont mitigés plutôt que sans appel. Il devance les modèles répertoriés dans certains tests, se place près du leader dans d’autres, et se classe derrière GPT-5.6 Sol ou Fable 5 dans plusieurs catégories. Il s’agit là d’une analyse plus pertinente que de réduire des dizaines de tests à une seule étiquette de “ meilleur modèle ”.
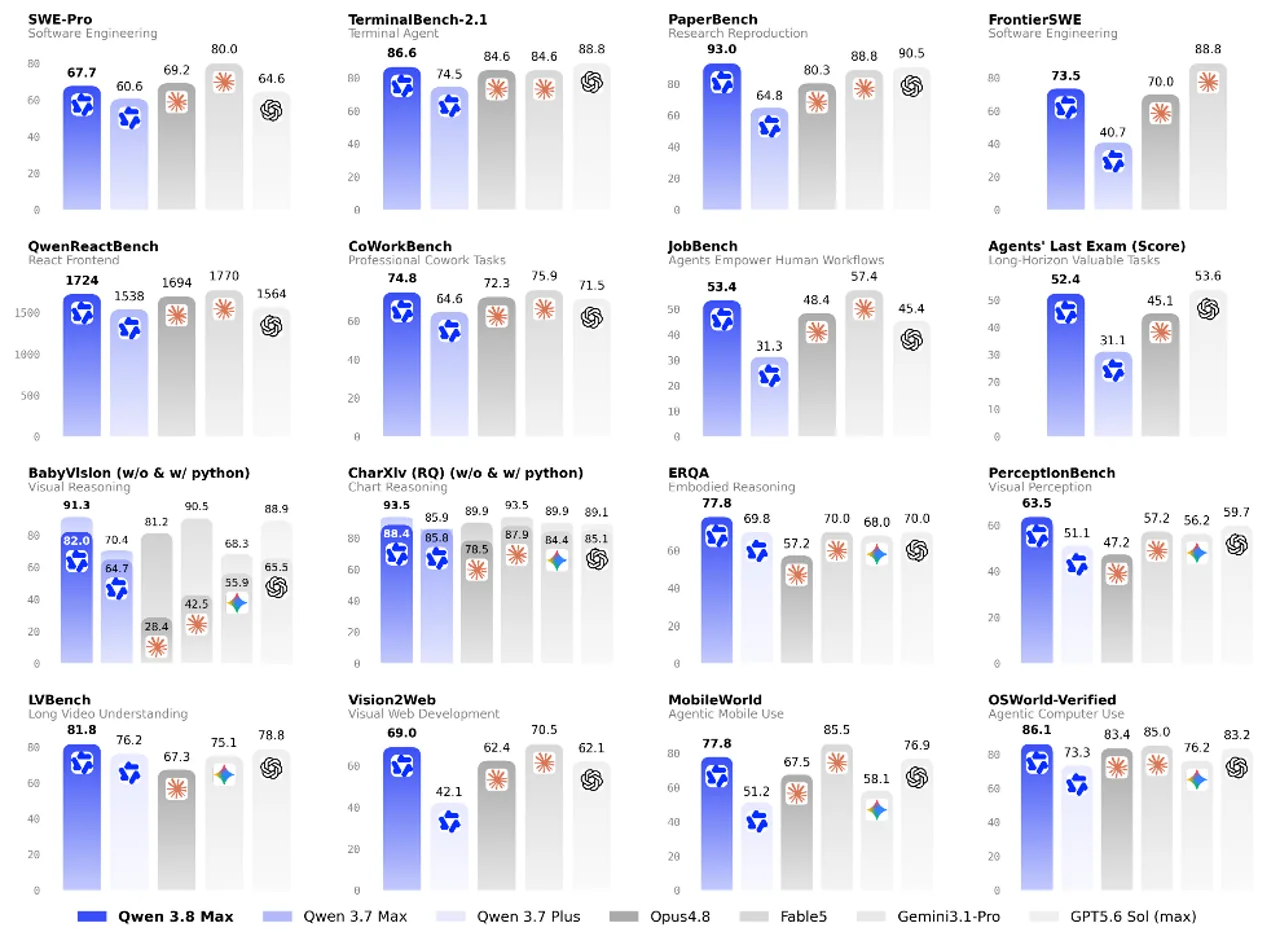
Sélection de résultats tirés du classement officiel de la course Qwen
Ces chiffres proviennent des documents de presse publiés par Qwen. Les notes de bas de page indiquent que le tableau combine des rapports officiels sur les modèles, des fiches techniques, des classements publics et les évaluations internes de Qwen. Les harnais et les réglages varient également selon certains modèles. Utilisez ce tableau pour identifier les points forts prometteurs, puis vérifiez la liste restreinte par vous-même avant de prendre une décision impliquant un investissement important.
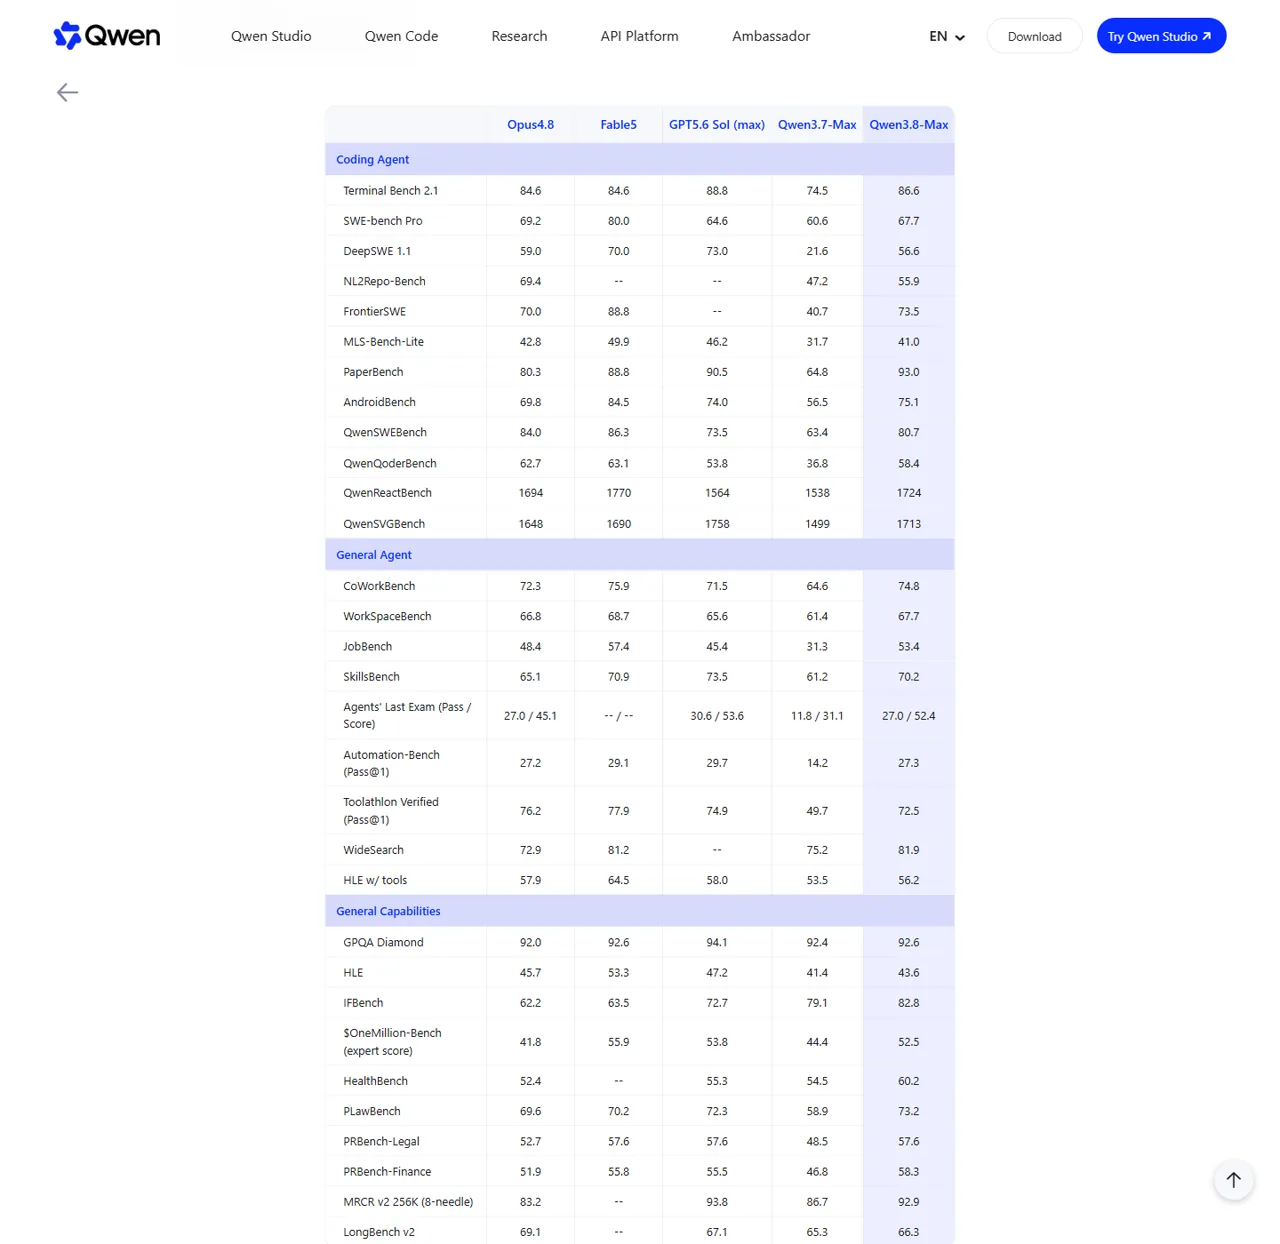
Que signifient les résultats du codage ?
Son principal atout réside dans son équilibre. Le modèle Qwen3.8-Max se classe parmi les meilleurs dans des domaines aussi variés que le travail sur terminal, l’ingénierie logicielle, la mise en œuvre de documents, les tâches collaboratives, la recherche sur le Web et le suivi d’instructions. Il n’a pas besoin de remporter toutes les épreuves pour être utile ; un agent qui reste performant de manière constante dans les domaines de la planification, du codage, de l’utilisation d’outils et des vérifications visuelles peut s’avérer plus fiable qu’un modèle optimisé pour un test spécifique.
Le tableau officiel montre également pourquoi les tests comparatifs sont importants. Le GPT-5.6 Sol arrive en tête dans plusieurs catégories axées sur le raisonnement ou les terminaux, tandis que le Fable 5 reste particulièrement performant dans les tâches de collaboration, d'interface et visuelles. Un autre Comparaison entre GPT-5.6 et Fable 5 peut vous aider à transposer ces gammes de modèles en cas d'utilisation concrets avant d'ajouter le modèle Qwen3.8-Max à votre liste de présélection.
Que signifient ces résultats multimodaux ?
Qwen3.8-Max affiche d'excellents résultats officiels en raisonnement multimodal, ancrage visuel, utilisation d'un ordinateur, traitement de documents et compréhension spatiale. Son score de 86,1 sur OSWorld-Verified est particulièrement pertinent pour les agents opérant sur écran, car il évalue la capacité à accomplir des tâches au sein d'environnements de bureau, et ne se limite pas à la simple description d'une image.
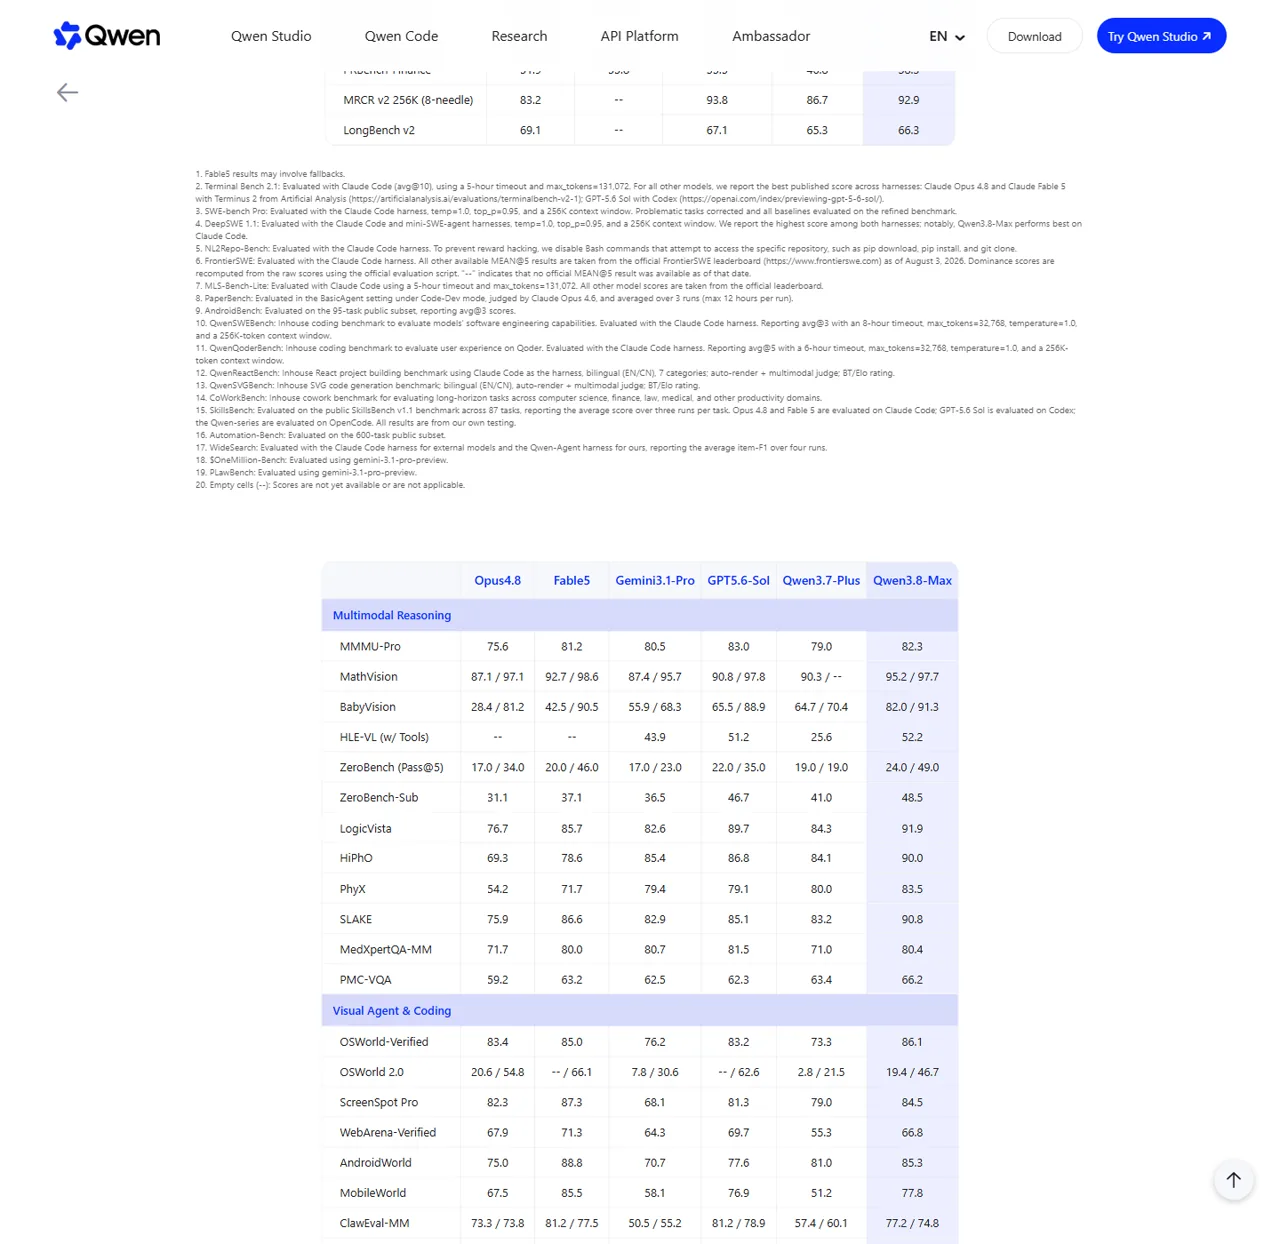
Comparaison du modèle Qwen3.8-Max
Il n’existe pas de réponse concise et fiable à la question “ Le modèle Qwen3.8-Max est-il meilleur que le GPT, le Claude ou le Gemini ? ”. Les données fournies par Qwen montrent que les leaders de chaque catégorie varient d’une ligne à l’autre. L'adéquation du produit dépend également de la fiabilité de l'outil, de la qualité des résultats, de la latence, de la disponibilité régionale, des contrôles de confidentialité et de l'interface associée au modèle.
Le modèle Qwen3.8-Max s'avère particulièrement intéressant lorsque vous recherchez un modèle capable de couvrir à la fois le codage, la gestion de documents, la recherche, les tâches de longue durée et les agents visuels. Le modèle GPT-5.6 Sol reste toutefois le meilleur choix pour les charges de travail où ses capacités de raisonnement et ses résultats finaux, qui constituent ses points forts, sont transposables à votre environnement. Le modèle Fable 5 mérite qu’on s’y attarde davantage pour les tâches de collaboration et celles faisant largement appel à l’interface utilisateur ; le Comparaison entre Fable 5 et Opus 4.8 apporte davantage d'éléments de contexte sur cette partie de la décision.
Les poids ouverts prévus pour ce modèle pourraient constituer son principal atout structurel. Si les performances via l’API sont aujourd’hui primordiales, les poids téléchargeables offrent des possibilités de réglage fin, de mise en place d’une infrastructure privée, de recherche et de déploiement régional. La valeur finale dépendra de la licence accordée, des formats de poids, de la prise en charge de la quantification et du matériel nécessaire pour faire fonctionner le modèle à une vitesse acceptable.
Tarifs API Qwen3.8-Max
Qwen a indiqué les prix de lancement suivants dans son communiqué officiel:
Voici une estimation simple :
coût estimé = entrée non mise en cache × $2/M + entrée mise en cache × $0,25/M + sortie × $6/M
Par exemple, une exécution utilisant 10 millions de jetons d’entrée non mis en cache et 2 millions de jetons de sortie coûterait environ $32 aux tarifs de lancement, hors frais facturés par d’autres plateformes : $20 pour l’entrée plus $12 pour la sortie. Un agent qui relit un vaste référentiel à chaque tour peut dépenser beaucoup plus, ce qui rend la mise en cache et la gestion du contexte aussi importantes que le prix d'entrée annoncé.
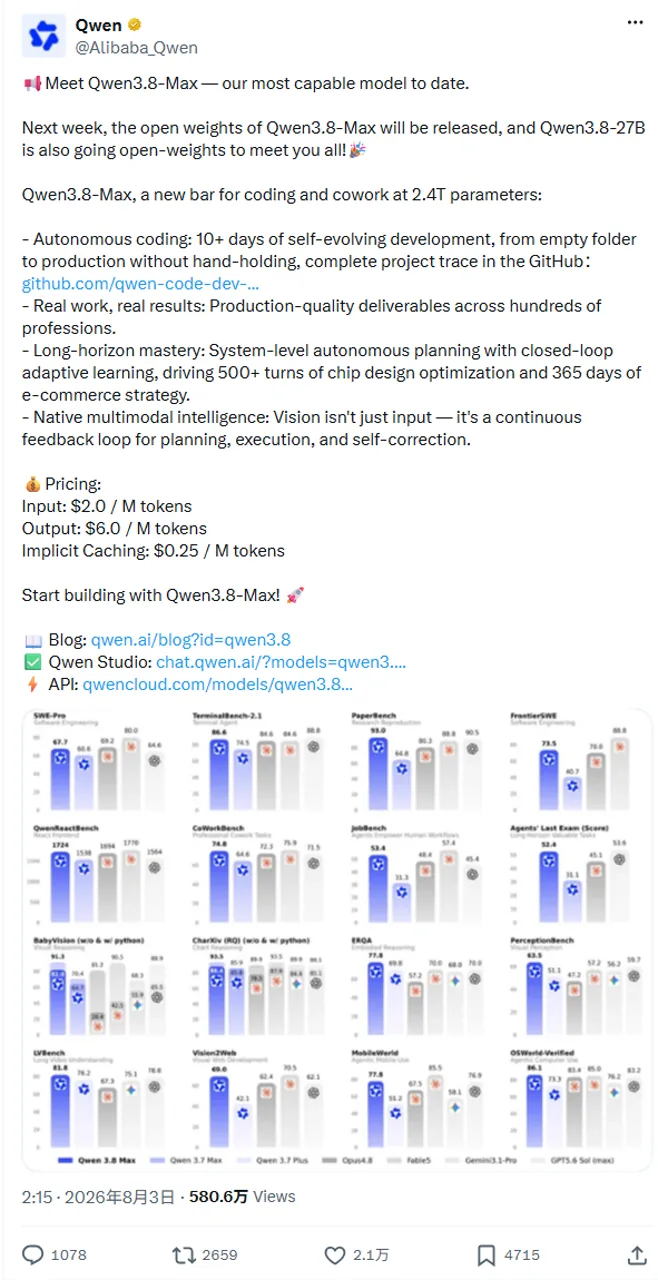
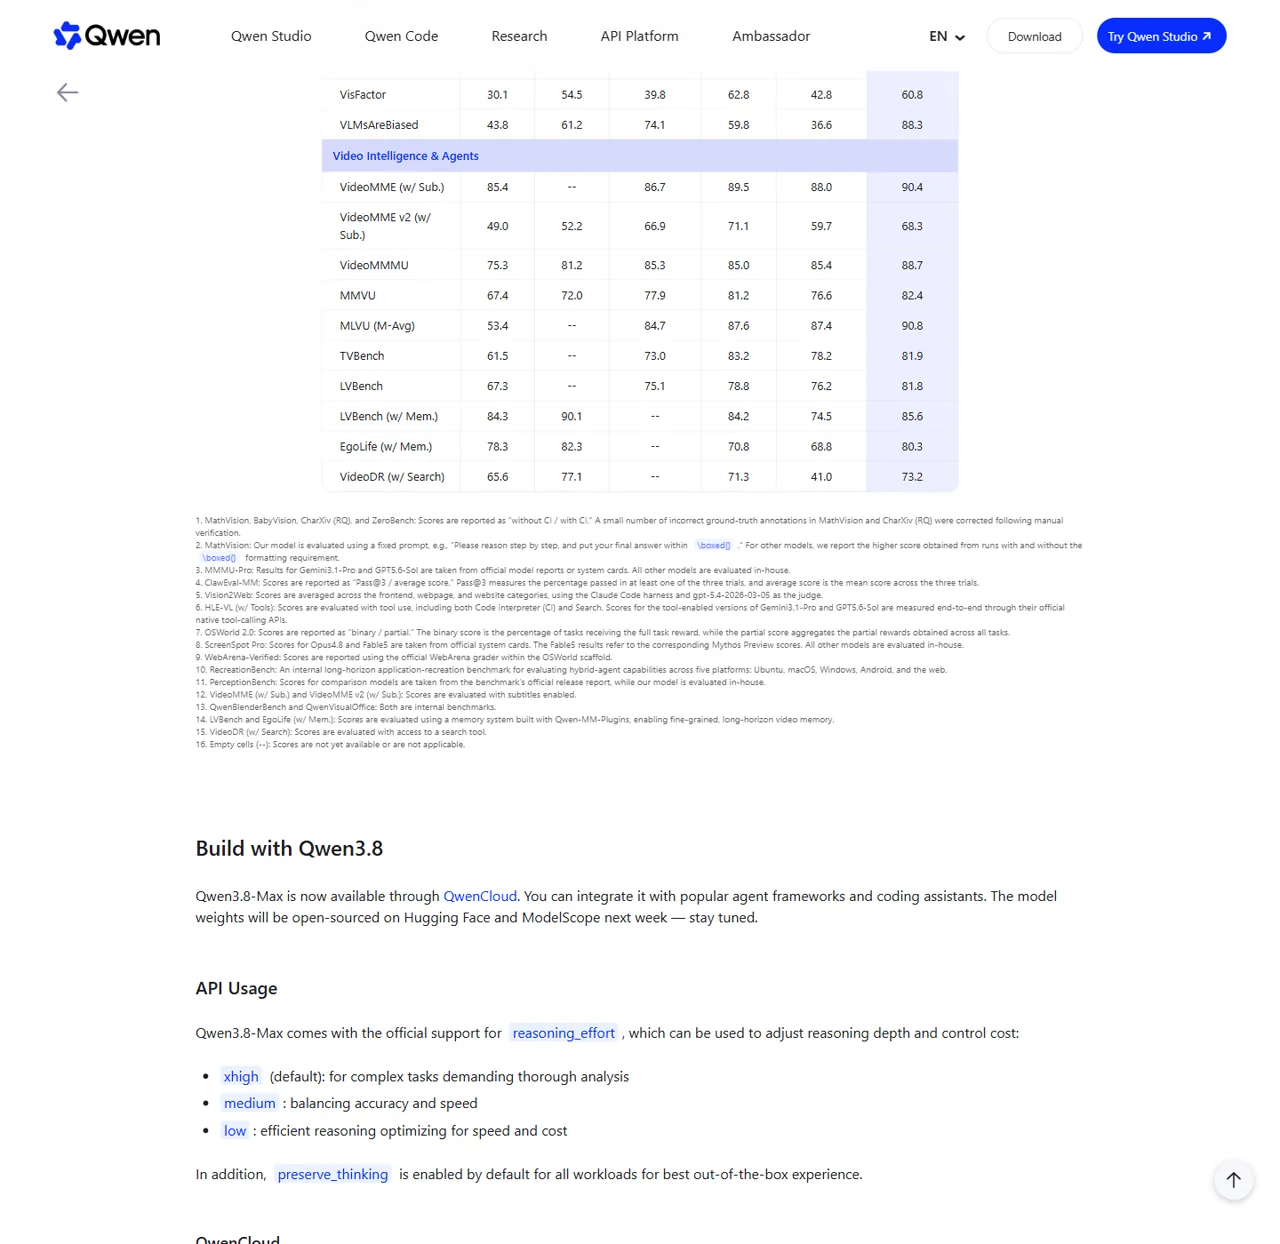
Le modèle Qwen3.8-Max prend également en charge effort_de_raisonnement commandes. La section officielle consacrée à l'API répertorie xhigh comme valeur par défaut pour l'analyse complexe, moyen pour concilier précision et rapidité, et faible pour un travail plus rapide et plus efficace. preserve_thinking est activée par défaut. Ces contrôles peuvent permettre de réduire les coûts, mais ils doivent être évalués au regard de la qualité des tâches plutôt que d’être considérés comme des modes interchangeables.
La comparaison des tarifs entre différents fournisseurs doit également être effectuée avec prudence. Un modèle proposant un tarif par jeton moins élevé peut tout de même s’avérer plus coûteux s’il nécessite des invites plus longues, davantage de tentatives ou des appels d’outils supplémentaires. Le Guide des tarifs de l'API Gemini 3.1 Pro C'est un exemple parlant qui illustre pourquoi la longueur du contexte et les niveaux d'utilisation sont importants, au même titre que le taux de base.
Comment accéder à Qwen3.8-Max
1. Utilisez Qwen Studio pour une évaluation directe
Le moyen le plus rapide pour un « premier regard » est Studio Qwen. Commencez par une tâche concrète plutôt que par une question de culture générale : proposez un cahier des charges peu structuré, un problème de codage impliquant plusieurs fichiers, un ensemble de documents ou un flux de travail basé sur des images. Vérifiez si le résultat est suffisamment précis, modifiable et complet pour permettre un gain de temps.
2. Utiliser l'API QwenCloud pour les applications
Le modèle Qwen3.8-Max est disponible auprès de QwenCloud. La page de présentation indique que son API prend en charge les protocoles de saisie semi-automatique et de réponse conformes aux normes du secteur, compatibles avec la spécification OpenAI, ainsi qu’une interface compatible avec la spécification Anthropic. Cela facilite la migration, mais il est tout de même recommandé de vérifier les noms des modèles, les paramètres, le comportement en matière de streaming, les schémas des outils et la gestion des erreurs dans la documentation officielle.
3. Le relier aux outils de programmation et aux outils d'agent
La page de présentation de Qwen mentionne des intégrations avec Qwen Code, Claude Code, Codex et OpenClaw. Ce modèle peut donc s'intégrer dans un flux de travail existant de terminal ou d'agent sans nécessiter la mise en place d'une nouvelle interface. La prise en charge de l'intégration ne supprime pas le coût de l'outil associé ; il convient donc de comparer la facture du modèle avec celle, distincte, de Structure tarifaire de Codex avant de normaliser le processus de travail d'une équipe.
Les utilisateurs du code Claude doivent également distinguer le coût du produit de codage de celui de l'API du modèle externe. Les formules disponibles et les modalités de facturation sont résumées dans le Guide des tarifs du code Claude.
Les utilisateurs de OpenClaw se posent une autre question : quel modèle offre le meilleur compromis entre utilisation des outils, rapidité et prix pour un agent donné ? Le Comparaison des modèles OpenClaw offre un cadre pratique pour faire ce choix, plutôt que d'opter par défaut pour le modèle le plus grand.
4. Veiller à la cohérence du flux de travail multimodèle
À son lancement, QwenCloud constitue la voie de production validée pour le Qwen3.8-Max. Si vous comparez également les alternatives GPT, Claude, Gemini ou Fable, le Espace de travail multimodèle GlobalGPT peut réduire les changements d'onglet entre les modèles qu'il prend en charge. Utilisez la page officielle dédiée au modèle Qwen pour le Qwen3.8-Max jusqu'à ce qu'une page dédiée au modèle GlobalGPT soit validée ; ne partez pas du principe qu'une nouvelle URL existe simplement parce que le modèle a été annoncé.
Qwen3.8 - Poids maximaux à l'ouverture
Qwen a annoncé que les poids Qwen3.8-Max seraient commercialisés dans la semaine suivant le lancement du 3 août. De même, publication officielle sur X a également indiqué que le modèle Qwen3.8-27B passerait en catégorie « open-weight ». C'est une bonne nouvelle pour les déploiements locaux et la recherche, mais cette annonce ne suffit pas à elle seule pour planifier la mise en place d'un cluster de production.
Avant de télécharger ou de prévoir le budget pour le matériel, vérifiez les cinq éléments suivants figurant sur la fiche technique finale :
- Les conditions exactes de la licence et d'utilisation à des fins commerciales.
- URL officielles des dépôts Hugging Face ou ModelScope.
- Formats de précision et de quantification disponibles.
- Configuration minimale et recommandée pour le processeur, la carte graphique, la mémoire vive et l'espace de stockage.
- Vérifier si le modèle publié correspond au comportement de l'API hébergée et à la longueur du contexte.
“Les notions d”“ open weight ” et d’« open source » ne sont pas toujours identiques. Le terme « poids ouverts » indique que les paramètres du modèle peuvent être téléchargés ; c’est la licence qui détermine ce que vous êtes autorisé à modifier, redistribuer ou utiliser à des fins commerciales. Tant que les dépôts et la licence ne sont pas disponibles, les pages promettant un téléchargement de Qwen3.8-Max, une version GGUF ou des spécifications matérielles locales précises s’avancent trop.
L'annonce concernant le modèle 27B devrait être traitée de la même manière. Il pourrait s'agir du choix le plus réaliste pour les utilisateurs locaux, mais son architecture, la longueur de son contexte, ses besoins en mémoire et ses résultats aux benchmarks devraient provenir de sa propre fiche technique officielle, et non être copiés depuis celle du modèle Max.
Qwen3.8 - Limites maximales et ajustement optimal
Limites à prendre en compte
- La plupart des données relatives au lancement proviennent de Qwen. Les évaluations indépendantes peuvent recourir à des consignes, des outils ou des règles de notation différents.
- Le contexte long n'est pas synonyme de mémoire parfaite. Un modèle peut traiter un million de tokens et pourtant passer à côté d'un détail ou suivre une instruction peu claire.
- Les agents à forte production peuvent s'avérer coûteux. Le taux de production de $6 par million est important lorsqu'un workflow génère du code volumineux, des rapports ou des traces de raisonnement répétées.
- Les informations relatives au déploiement local ne seront pas complètes tant que les poids et la fiche du modèle ne seront pas arrivés. Un système à 2,4 T de paramètres totaux ne fonctionnera pas comme un petit modèle de bureau.
- L'utilisation d'outils ajoute un niveau supplémentaire de risque de défaillance. L'état du navigateur, les autorisations, les erreurs réseau et des schémas d'outils mal définis peuvent compromettre un modèle qui, sans cela, serait performant.
- Les informations relatives au lancement évoluent rapidement. Il convient de vérifier à nouveau les tarifs, les référentiels, les intégrations et la disponibilité avant toute publication ou commande.
Qui devrait l'essayer dès maintenant ?
En résumé, Qwen3.8-Max mérite d'être testé de manière approfondie, mais ne doit pas faire l'objet d'une migration à l'aveugle. Utilisez une tâche exigeante avec un critère de réussite clair, enregistrez le nombre total de tokens et de tentatives, puis comparez le résultat final — et pas seulement la première réponse.
Questions fréquemment posées
Quand la version Qwen 3.8 Max est-elle sortie ?
Qwen3.8-Max a été officiellement annoncé le 3 août 2026. Dès son lancement, le modèle hébergé était disponible via Qwen Studio et QwenCloud. Qwen a indiqué que les poids ouverts seraient publiés la semaine suivante ; la disponibilité de l'API et celle des poids téléchargeables doivent donc être considérées comme des étapes distinctes.
Le logiciel Qwen3.8-Max est-il open source ?
Qwen a annoncé la sortie d'une version “ open weights ” pour Qwen3.8-Max, mais ce sont le dépôt final et la licence qui déterminent ce que les utilisateurs sont autorisés à exécuter, modifier, redistribuer ou utiliser à des fins commerciales. Tant que ces fichiers ne sont pas mis en ligne et vérifiés, il est plus juste de parler d'« annonce de la sortie d'une version open weights » plutôt que de supposer que toutes les autorisations open source ou tous les formats locaux sont déjà disponibles.
Combien de paramètres le modèle Qwen3.8-Max comporte-t-il ?
Qwen3.8-Max compte 2 400 milliards de paramètres au total et active 95 milliards de paramètres par jeton. Il utilise une architecture de type « mixture-of-experts » ; par conséquent, le nombre total de paramètres et le nombre de paramètres actifs décrivent des aspects différents du système. Aucun de ces deux chiffres, pris isolément, ne permet de prédire la vitesse réelle ni les besoins en matériel.
Qu'est-ce que la fenêtre de contexte Qwen3.8-Max ?
La version officielle indique une fenêtre de contexte d'un million de jetons. Cela est suffisant pour des codes volumineux, des documents, les résultats d'outils et l'historique des agents, mais la taille maximale du contexte ne garantit pas une récupération parfaite. Testez le modèle en tenant compte de la position, du format et de la densité des informations utilisées dans votre flux de travail réel.
Combien coûte l'API Qwen3.8-Max ?
Lors de son lancement, Qwen affichait les tarifs suivants : $2 par million de jetons d'entrée, $6 par million de jetons de sortie et $0,25 par million de jetons mis en cache implicitement. Considérez ces tarifs comme des prix de lancement et vérifiez-les avant d'établir votre budget. Les coûts des agents dépendent également de la réutilisation du contexte, de l'effort de raisonnement, des tentatives de réessai et de la longueur des sorties générées.
Le modèle Qwen3.8-Max est-il meilleur que le GPT-5.6 Sol ou le Fable 5 ?
Ce n'est pas le cas dans tous les tests. Le tableau officiel du Qwen montre que le modèle Qwen3.8-Max arrive en tête dans certains tests de référence portant sur le codage, la recherche, l'exécution d'instructions et l'utilisation d'un ordinateur, tandis que les modèles GPT-5.6 Sol ou Fable 5 se classent en tête dans d'autres. Le choix du meilleur modèle dépend de la tâche à accomplir, de l'environnement logiciel, de la latence, du prix et de la qualité du résultat final.
Puis-je exécuter Qwen3.8-Max en local ?
Qwen a annoncé la mise à disposition de poids téléchargeables pour la semaine suivant le lancement, mais la faisabilité au niveau local dépendra des fichiers définitifs, de la précision, de la prise en charge de la quantification, de la licence et des recommandations matérielles. Il convient d’attendre la fiche technique officielle du modèle avant de se fier aux estimations exactes concernant la RAM, la VRAM ou l’espace de stockage. Les variantes plus compactes, telles que le Qwen3.8, pourraient s’avérer plus pratiques une fois qu’elles auront fait l’objet d’une documentation officielle.
Qu'est-ce que le Qwen3.8-27B ?
Le message d'annonce de Qwen indique que la version Qwen3.8-27B sera également disponible avec des poids ouverts. L'article consacré à la sortie de Max ne fournit pas suffisamment de détails pour réutiliser les spécifications du modèle Max pour la version 27B. Consultez la fiche technique dédiée au modèle pour connaître son architecture, sa fenêtre contextuelle, ses benchmarks, sa licence et les instructions de téléchargement.
Puis-je utiliser le modèle Qwen3.8-Max sur le modèle GlobalGPT ?
Au moment de la publication, aucune route GlobalGPT dédiée à Qwen3.8-Max n'avait été vérifiée. Utilisez Qwen Studio ou QwenCloud pour un accès direct. GlobalGPT reste utile pour comparer les autres modèles disponibles (GPT, Claude, Gemini et Fable) sans changer de plateforme.
Verdict final
Utilisez Qwen Studio ou QwenCloud pour évaluer directement le modèle Qwen3.8-Max. Utilisez GlobalGPT pour comparer d'autres modèles validés, sans pour autant supposer qu'un itinéraire dédié au modèle Qwen3.8-Max existe déjà.
Comparer les modèles disponiblesQwen 3.8 Max est l'un des lancements de modèle les plus ambitieux de 2026 : 2 400 milliards de paramètres au total, 95 milliards de paramètres actifs, une fenêtre de contexte d'un million de tokens, d'excellents résultats officiels en matière de programmation et d'agents multimodaux, ainsi qu'une feuille de route annoncée vers une architecture à poids ouverts. Le tarif de son API de lancement est suffisamment compétitif pour permettre de le tester, d’autant plus que la mise en cache réduit les coûts liés à la répétition du contexte.
La principale raison de s’y intéresser ne réside pas dans une simple victoire lors d’un benchmark. Il s’agit plutôt de la volonté de réunir dans un même modèle le codage, les livrables professionnels, la planification à long terme, le retour visuel et l’utilisation d’outils. Commencez par Qwen Studio ou par une évaluation contrôlée de QwenCloud, évaluez la qualité des tâches accomplies et le coût total, puis attendez la publication officielle des pondérations et l’octroi de la licence avant de vous engager sur un déploiement local.
Sources primaires consultées le 4 août 2026 : Version officielle Qwen3.8-Max et Message officiel de lancement @Alibaba_Qwen.