Étude exploratoire GlobalGPT portant sur la délégation des tâches, les exigences en matière de résultats et le contrôle par l'utilisateur.
Source des données et autorisation : Cette étude s'appuie sur les données fournies par des utilisateurs qui ont volontairement partagé leurs données avec GlobalGPT au mois d'août et ont autorisé leur utilisation dans le cadre de cette recherche. Les exemples sont généralisés afin de protéger la vie privée des personnes concernées. Les totaux exacts des activités, le nombre de comptes, la taille de l'échantillon et les dates d'observation ne sont pas rendus publics.
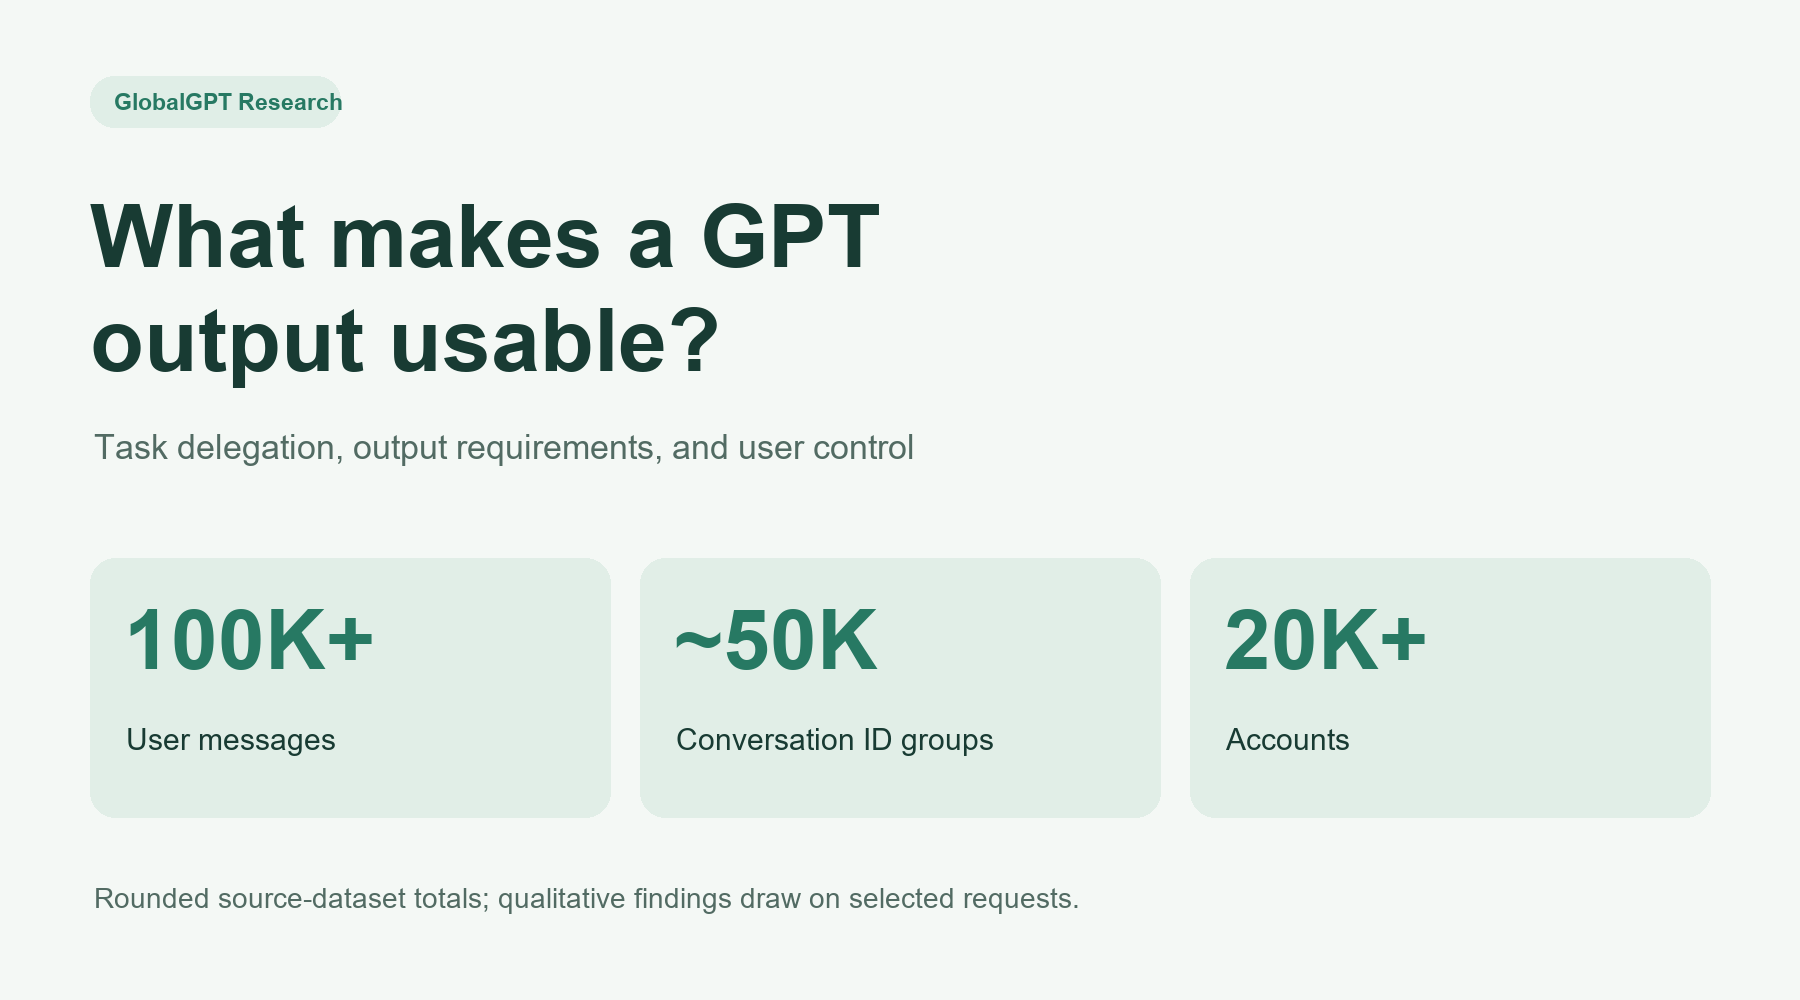
Les données de l'étude en bref : Plus de 100 000 messages d'utilisateurs, environ 50 000 groupes d'identifiants de conversation et plus de 20 000 comptes. Ces totaux arrondis correspondent à l'ensemble de données source, et non au nombre de requêtes examinées dans le cadre de l'analyse qualitative.
Résumé
Contexte : Les études sur l'IA conversationnelle font la distinction entre les sujets abordés par les utilisateurs et leur intention d'obtenir des informations ou de déléguer une tâche. La délégation d'une tâche peut toutefois s'accompagner d'exigences allant au-delà de la simple production d'un contenu pertinent : un format adapté, le respect des documents fournis, des justificatifs, ou encore la possibilité de vérifier le travail avant son exécution.
Questions de recherche : Comment les demandes de documents précisent-elles les conditions dans lesquelles un résultat serait utilisable ? Comment les demandes de suivi expriment-elles les exigences en matière de livraison et de contrôle ? Quelles distinctions sont masquées par des libellés de tâches limités au sujet ?
Méthodes : Cette étude s'appuie sur une analyse qualitative assistée par l'IA portant sur des extraits de demandes sélectionnés parmi les documents autorisés. Des tableaux d'évaluation – consacrés à la tâche principale, au diagnostic et au suivi – ont permis de comparer les exigences en matière de résultats, la fidélité à la source, les preuves, le contrôle conservé et l'accès à la plateforme. Ces tableaux ont été analysés séparément ; les conclusions thématiques décrivent les documents examinés plutôt que la prévalence au sein de la population.
Résultats : Les demandes examinées font la distinction entre la production de contenu et la fourniture d’un artefact utilisable. Certaines précisent des formats modifiables ou téléchargeables ; d’autres limitent les modifications apportées au matériel source, demandent des justifications ou se réservent le droit de procéder à une révision avant la mise en œuvre. Les questions relatives à la navigation sur la plateforme et les invites destinées à d’autres outils compliquent encore davantage une description limitée au sujet. Parmi les cas contrastés, on trouve des questions factuelles directes, des demandes de conseils sans mise en œuvre et des contributions dont le contexte est insuffisant.
Interprétation : La délégation de tâches et le contrôle par l'utilisateur peuvent coexister au sein d'une même requête. Les données disponibles permettent d'établir une distinction analytique entre l'opération demandée et les conditions liées à son résultat. Elles ne permettent toutefois pas de déterminer la prévalence de ces schémas, la réussite de leur mise en œuvre, la réduction des efforts nécessaires, ni l'existence d'un effet de causalité lié à l'utilisation du modèle.
1. Introduction
Ce rapport examine une sélection de requêtes issues de données GlobalGPT partagées volontairement et autorisées, afin d'étudier une question à laquelle le volume d'utilisation seul ne permet pas de répondre : De quoi un utilisateur a-t-il besoin avant qu'un résultat généré par l'IA ne soit prêt à être utilisé ?
Une demande visant à expliquer un tableur et une demande visant à restituer un tableur modifiable peuvent porter sur le même sujet tout en impliquant des tâches différentes. De même, la révision d’un document peut signifier soit la correction de sa formulation sans modification des faits qu’il contient, soit l’élaboration libre d’une nouvelle version. Ces deux cas peuvent être classés dans la catégorie de la rédaction, mais le rôle autorisé du modèle et les critères d’acceptation de l’utilisateur diffèrent.
Cette étude examine la manière dont les utilisateurs définissent le travail qu'ils souhaitent confier à GPT ainsi que les conditions liées à son résultat. S'inscrivant dans le cadre de la recherche sur l'interaction homme-machine, elle explore la délégation de tâches à travers les exigences exprimées en matière de livraison, de fidélité, de justification et de contrôle.
Des recherches à grande échelle sur les usages ont mis en évidence une distinction utile entre les sujets de conversation et l’intention de l’utilisateur. Chatterji et al. distinguent les actions « demander », « faire » et « exprimer » dans leur étude sur le ChatGPT des consommateurs [1]. Cela soulève une autre question : parmi les demandes visant à accomplir une action, que reste-t-il à l’utilisateur à préciser, vérifier ou autoriser ? Un résultat peut être pertinent par rapport à un sujet sans pour autant respecter le format demandé ni conserver le contenu source conformément aux instructions.
GlobalGPT, une plateforme d’abonnement à l’IA multimodèle, offre un cadre dans lequel les requêtes peuvent porter à la fois sur une tâche externe et sur les moyens de la réaliser. Les enregistrements sélectionnés comprennent des questions relatives au contenu, aux fichiers, aux capacités des modèles et à l’accès aux travaux antérieurs. Il s’agit d’enregistrements étiquetés « GPT » sur GlobalGPT, et non d’un échantillon des utilisateurs de l’application officielle ChatGPT.
Nous posons trois questions :
- RQ1 — Conditions d'utilisabilité : Quelles sont les exigences spécifiques que les demandes examinées imposent aux résultats escomptés ?
- RQ2 — Délégation et contrôle : Comment les demandes initiales et les demandes de suivi précisent-elles les modalités de mise en œuvre, les révisions, les justifications, ainsi que la distinction entre conseil et exécution ?
- RQ3 — Mesure : Lesquelles de ces distinctions sont perdues lorsque les requêtes sont décrites uniquement par une étiquette thématique principale ?
Cette contribution propose un cadre permettant de comprendre comment les utilisateurs définissent un résultat d’IA jugé utilisable. En distinguant l’opération demandée des exigences de prestation et du contrôle conservé, cette analyse met en évidence les distinctions qui importent pour la conception et l’évaluation du travail assisté par l’IA.
2. Travaux antérieurs et approche analytique
2.1 Thème, objectif et activité économique
Comment les utilisateurs utilisent ChatGPT examine l'activité ChatGPT observée chez les consommateurs à l'aide de plusieurs classifications [1]. Son ensemble de données de classification principal comprend un échantillon de conversations et un message issu de chaque conversation échantillonnée, les pondérations d'échantillonnage étant ajustées pour tenir compte de l'évolution des taux dans la table source sous-jacente. La classification s'appuie sur le contexte de la conversation précédente plutôt que de traiter chaque message court comme un élément autonome.
Cet article établit une distinction entre le sujet et l'intention. La rubrique « Demander » concerne les demandes d'informations ou de conseils ; la rubrique « Faire » concerne les résultats produits par le modèle ; la rubrique « Exprimer » couvre les énoncés qui ne constituent ni des demandes d'informations ni des délégations de tâches. Une question technique peut porter sur une explication ou un code fonctionnel, tandis qu'une demande de rédaction peut porter sur un brouillon directement réutilisable. La distinction ne se résume donc pas au sujet traité.
Cette étude distingue également la classification à grande échelle de la validation. Son annexe B compare les étiquettes du modèle aux jugements humains portés sur des données publiques issues de WildChat, présente des mesures de concordance et utilise un ensemble de données de développement distinct. La régression, dans le cadre de son analyse démographique, aborde les différences associées aux caractéristiques mesurées. Ces procédures répondent à des questions et à des structures de données spécifiques ; ni l'échantillon de grande taille ni le modèle de régression ne sont transposables au présent ensemble de données.
Notre question porte sur les exigences liées aux résultats délégués. Nous utilisons la distinction entre information et action comme point de départ pour l'interprétation, sans appliquer le classificateur du NBER ni prétendre à une validation équivalente. Les demandes examinées suggèrent que la “ réalisation ” peut être décrite plus en détail en termes de ce qui doit être conservé, de la manière dont un résultat doit être fourni et du moment où l'utilisateur souhaite le consulter.
2.2 De la catégorisation à la comparaison
L'analyse qualitative peut apporter davantage qu'une simple liste de catégories, en comparant les exigences de demandes similaires et en examinant les cas qui remettent en cause une interprétation. Gale et al. décrivent l'intérêt de la comparaison cas par cas, d'un cadre analytique explicite et de la prise en compte des cas contradictoires [2]. Ils soulignent également qu'une matrice ne rend pas pour autant les données sélectionnées de manière ciblée statistiquement représentatives.
La présente analyse s'inspire de cette logique comparative. Elle ne prétend pas mettre en œuvre l'intégralité de la méthode Framework : il n'y a pas eu d'équipe de codage multidisciplinaire, ni de codage exhaustif ligne par ligne de l'ensemble du texte source, ni d'évaluation indépendante par des chercheurs qualitatifs. Le matériel est hétérogène, et la comparaison se limite à une caractéristique commune : les exigences explicites adressées à un système d'IA. Nous appelons cette procédure « analyse qualitative exploratoire du contenu », s’appuyant sur une matrice thématique des données.
2.3 Concepts de base
Délégation des tâches désigne une demande explicite adressée au système afin qu'il effectue une opération ou produise un résultat. Conditions d'utilisation sont énoncées les exigences relatives à ce résultat, telles que la possibilité de modification, la fidélité à la source, les justifications, l'adéquation au public ou la présentation. Contrôle conservé fait référence à des limites explicites concernant ce que le système doit faire à ce stade, notamment la demande de présenter un plan ou un projet avant de poursuivre.
Ces concepts décrivent le contenu des demandes. Une instruction détaillée n’est pas automatiquement le signe d’un manque de confiance, d’une expertise, d’une frustration ou d’une charge de travail plus importante. Une demande de source ne prouve pas que la réponse précédente était erronée. L’analyse distingue ces explications possibles de ce qui est directement exprimé.
3. Méthodes
3.1 Conception et sources des données
Il s'agit d'une analyse exploratoire rétrospective des données existantes provenant d'utilisateurs qui ont volontairement partagé leurs données avec GlobalGPT au mois d'août et ont autorisé leur utilisation dans le cadre de cette recherche. Le mois d'août correspond à la période durant laquelle les utilisateurs ont partagé ces données ; il ne s'agit pas d'une période d'observation complète. Aucun nouveau participant n'a été recruté, aucune intervention n'a été mise en place et aucune extraction supplémentaire de la base de données n'a été effectuée pour cette étude.
L'extraction fournie a conservé les lignes de messages utilisateur non vides et non supprimées, dont les identifiants de conversation n'étaient pas vides et dont les étiquettes de modèle correspondaient au filtre GPT fourni. L'acheminement, l'éligibilité et les limites des conversations complètes n'ont pas fait l'objet d'une vérification indépendante. Les dates exactes d'extraction, les totaux d'activité et le nombre de comptes ne sont pas divulgués afin de protéger les informations commercialement sensibles.
Les conclusions qualitatives s'appuient sur une sélection de documents issus de l'analyse. Cette analyse ne consiste pas en un examen dossier par dossier de l'ensemble des données extraites, et les contributeurs autorisés ne sont pas considérés comme un échantillon représentatif de l'ensemble des utilisateurs de la plateforme.
3.2 Supports de révision et modules disponibles
| Matériau | Utilisation dans cette analyse |
|---|---|
| Tableau récapitulatif des tâches principales | Analyse selon l'intention et recodage exploratoire des catégories résiduelles |
| Tableau récapitulatif des diagnostics | Comparaison des conditions de sortie, du contrôle explicite et des cas contrastés |
| Tableau de suivi des révisions | Examen des extraits de la demande initiale et des demandes ultérieures |
| Tableaux de résultats agrégés | Contrôles internes des prélèvements ; les chiffres exacts ne sont pas rendus publics |
Le tableau de diagnostic comprend des étiquettes incertaines et des catégories de tâches de fond. Sa composition n'est pas proportionnelle à l'extraction des données sources. La sélection s'est concentrée sur les classifications incertaines, et aucune probabilité d'inclusion n'a été établie.
Certains textes initiaux apparaissent de manière récurrente dans les tableaux d'analyse. La présence de textes identiques ne permet pas de conclure à l'existence d'utilisateurs ou de conversations identiques, mais elle empêche de considérer ces tableaux comme des échantillons corroborants manifestement indépendants. Leurs dénominateurs ne sont pas regroupés, et les proportions recodées ne sont pas extrapolées à l'ensemble des données extraites.
L'unité qualitative correspond à une requête identifiable au sein d'un champ inspecté ou d'un extrait de suivi. Une ligne enregistrée peut inclure des documents collés ou un historique intégré ; elle ne correspond pas nécessairement à un tour de parole naturel. Les tailles exactes des tableaux d'examen ne sont pas rendues publiques, ce qui limite l'évaluation externe de la portée de l'analyse.
3.3 Procédure de lecture et d'interprétation
L'analyse initiale a porté sur les ouvertures révélatrices d'une intention issues du tableau des tâches principales, ainsi que sur certaines fins de champs longs ou ambigus. Des catégories exploratoires ont été attribuées aux enregistrements précédemment classés dans la catégorie « Autres ». Les extraits initiaux et ultérieurs du tableau de suivi ont été examinés afin d'identifier les comportements exprimés, sans toutefois en estimer la fréquence.
L'examen qui a suivi a porté sur les débuts et, pour les champs plus longs, sur les fins, à travers le tableau de diagnostic. Les éléments masqués par la troncature de la sortie ont été relus. Il s'agissait d'une inspection d'extraits pertinents pour la tâche, et non d'une lecture exhaustive de chaque contrat intégré, passage de recherche, biographie ou historique de code. Les pièces jointes et les liens externes référencés n'ont pas été ouverts.
Le cadre de comparaison distinguait les données d'entrée, l'opération demandée, le format de sortie, les conditions d'acceptation, le contrôle conservé et l'accès à la plateforme. Il a été élaboré après analyse des données et s'appuyait sur la littérature ; il n'avait pas fait l'objet d'un enregistrement préalable. Les étiquettes originales du classificateur sont restées visibles.
L'analyse a comparé des formes contrastées : production directe contre explication ; conservation contre révision libre ; mise en œuvre immédiate contre planification préalable ; exigences externes liées à la tâche contre navigation sur la plateforme. Les passages ambigus de la source, les formules de politesse, les instructions comportant des réponses fixes et les éléments de rôle intégrés ont été conservés en tant que limites à l'interprétation plutôt que d'être classés de force dans des catégories de fond.
Un seul assistant d'IA a procédé à l'analyse et à l'interprétation. Il n'y a pas eu de codeurs humains indépendants, d'étiquettes en aveugle, de vérification par des pairs ni de saturation thématique démontrée. Les dimensions conceptuelles n'ont pas été attribuées de manière exhaustive sous forme d'étiquettes binaires à chaque ligne. La matrice des résultats décrit des tendances et des contre-exemples, et non des taux de prévalence ou de cooccurrence.
3.4 Analyse descriptive et statistique
Les calculs agrégés et les décomptes exploratoires par catégorie ont été vérifiés en interne. Les chiffres exacts, les pourcentages, les moyennes et la durée des fenêtres d’observation ne sont pas publiés, car ils pourraient révéler des données commercialement sensibles. Le rapport public présente les totaux arrondis issus de l’ensemble de données source ainsi que des comparaisons qualitatives. Il ne fournit pas d’estimations extrapolées ni arrondies des fréquences par catégorie.
Le recodage par tâche principale a attribué une catégorie exploratoire à chaque enregistrement résiduel examiné. Il s'agissait d'un travail de comptabilité pour un sous-ensemble sélectionné, et non d'une estimation de population pondérée par échantillonnage. La structure des lignes stockées et les limites d'extraction empêchent également de traiter les résumés internes des groupes comme des probabilités de suivi des conversations achevées ou comme des longueurs de tour de parole naturelles.
Aucun test d'hypothèse, aucune régression, aucun intervalle de confiance sur la population ni aucune probabilité de transition n'ont été calculés. Les probabilités d'inclusion inconnues, les répétitions de texte, les liens conversationnels incomplets et les étiquettes non validées limitent l'inférence statistique. Un rééchantillonnage des lignes sélectionnées ne permettrait pas de corriger leur processus de sélection. Aucune statistique de concordance inter-évaluateurs n'est présentée, car il n'y a pas eu d'évaluations indépendantes.
3.5 Vie privée et réflexivité
Le rapport utilise des descriptions générales plutôt que des citations personnelles, des récits particuliers, des identifiants de compte ou des coordonnées. Les références à la situation personnelle ne sont pas considérées comme des identités ou des caractéristiques vérifiées. Aucun profil démographique n'est déduit du langage utilisé dans les messages ou de leur sujet.
GlobalGPT gère la plateforme source et a un intérêt commercial dans son utilisation. Le rapport a été élaboré dans le cadre d’une recherche thématique, ce qui comporte un risque de privilégier les récits attrayants concernant la productivité ou la demande. Afin de limiter cette interprétation, l’analyse inclut des cas contrastés et ne confond pas une demande avec une exécution réussie. L'autorisation donnée par l'utilisateur de partager ses données ne constitue pas un examen éthique indépendant ni une validation humaine de l'analyse ; aucune de ces deux choses n'est prétendue ici.
4. Résultats
4.1 Question de recherche n° 1 : un résultat exploitable peut nécessiter davantage qu’un contenu pertinent
Certaines demandes portent sur un support plutôt que sur une simple réponse. Elles portent sur une feuille de calcul modifiable, une présentation, une image téléchargeable ou un document adapté à une étape de production ultérieure. Dans ces cas-là, le contenu et le format de livraison constituent des exigences distinctes. Une explication sur la manière de créer un fichier ne répondrait pas, à elle seule, à la demande exprimée de recevoir ce fichier.
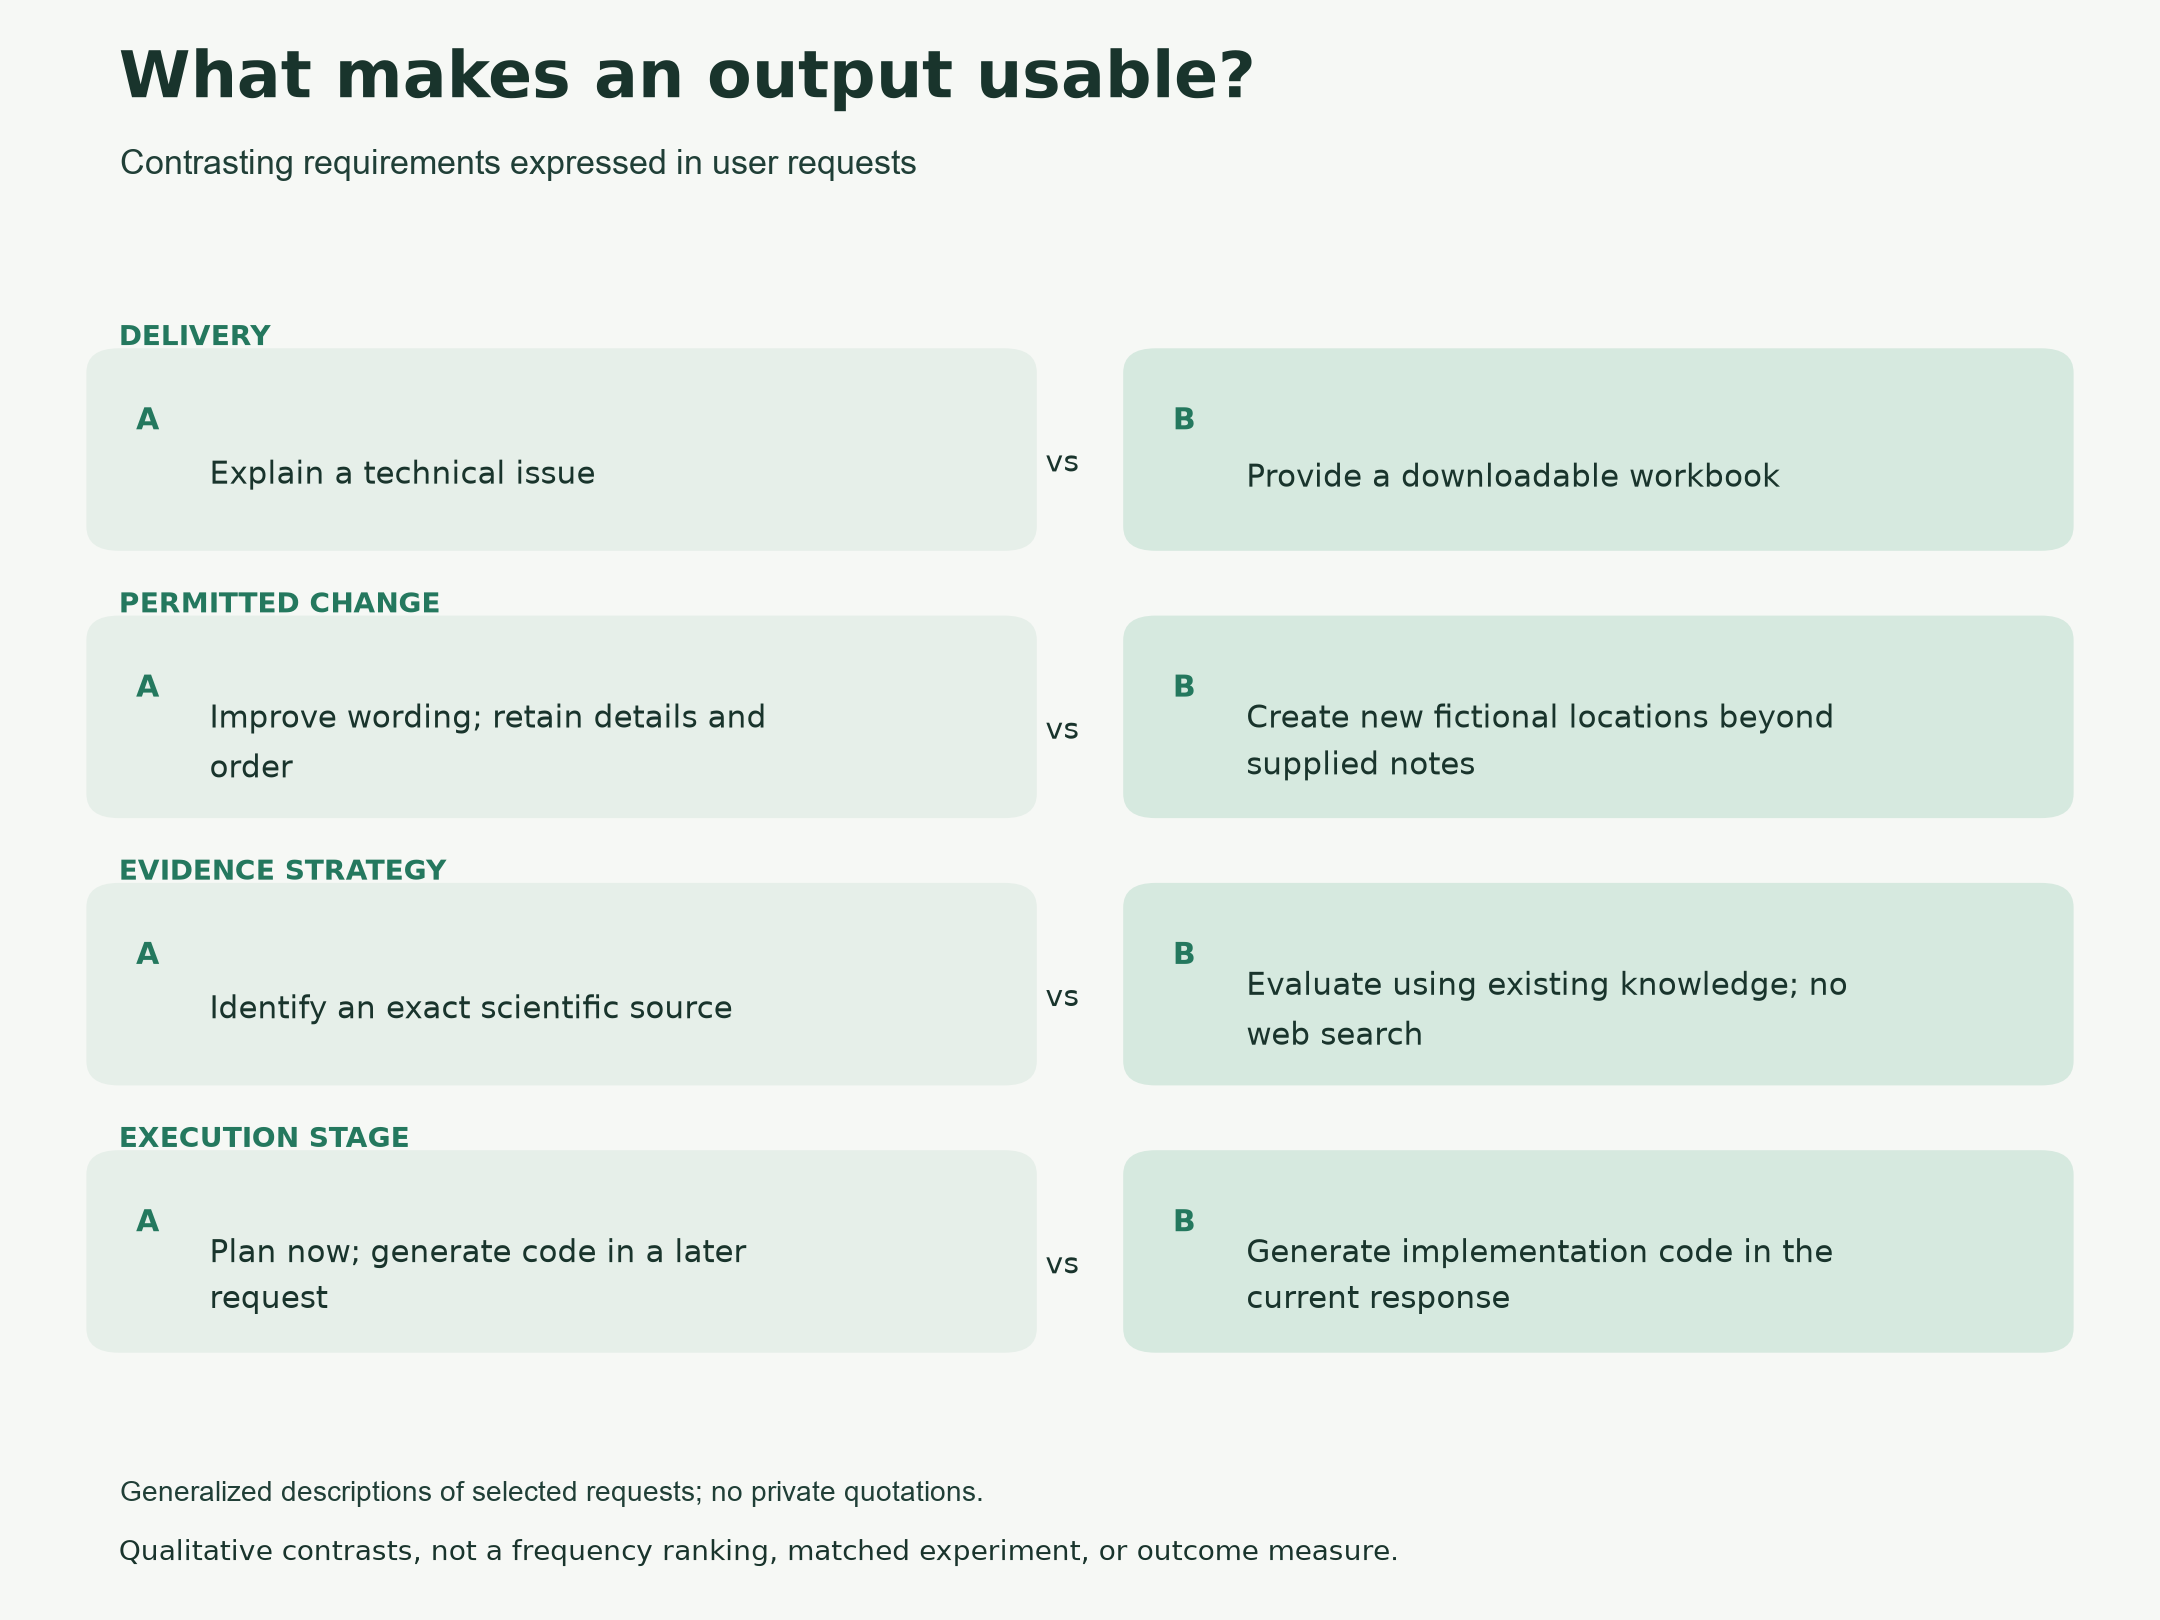
Les comparaisons ci-dessous reformulent certaines demandes afin d'illustrer les différences entre les exigences formulées ; il ne s'agit ni de citations textuelles ni d'estimations de prévalence. Chaque élément A et B correspond à un enregistrement source. Ces comparaisons mettent en parallèle les conditions des tâches entre différentes demandes, et non des expériences appariées ou des changements observés chez un même utilisateur.
Comparaison n° 1 — Expliquer un problème technique et transmettre un fichier.
Demande A — générale : Un utilisateur demande si la conversion entre différents formats numériques peut entraîner un débordement négatif. L'objectif indiqué est d'obtenir une explication technique ; aucun fichier n'est demandé. Demande B — formulation générale : Un autre utilisateur fournit un code permettant de créer un classeur et demande une feuille de calcul téléchargeable générée à partir de ce code. Ce qu'il attend, c'est le fichier, et non une explication du code fourni.
La différence porte sur la mise en œuvre : la réponse A peut être fournie sous forme de texte, tandis que la réponse B nécessite explicitement un élément que l’utilisateur peut obtenir. Malgré leurs sujets différents, ces deux exemples corroborent la distinction établie par la question de recherche 1 (RQ1) entre répondre à une question de fond et satisfaire à une exigence relative au format de sortie. Ils ne permettent toutefois pas d’établir que la feuille de calcul a été générée ou téléchargée, ni que l’une ou l’autre des réponses a répondu aux besoins de l’utilisateur.
D'autres demandes imposent des conditions à la transformation. Elles exigent une amélioration du style tout en conservant intacts les faits, les détails ou l'ordre de l'explication. Le texte source ne sert donc pas simplement de toile de fond : il peut définir une limite aux modifications autorisées. Une étiquette thématique telle que « écriture » ne révèle pas cette limite.
Comparaison n° 2 — Préserver un document et développer un univers fictif.
Demande A — générale : Un utilisateur demande que des corrections grammaticales et stylistiques soient apportées à un rapport qui lui a été fourni, tout en conservant ses détails et l'ordre des explications. Demande B — formulation générale : Un utilisateur fournit des notes sur la création d'un univers fictif et demande des lieux supplémentaires accompagnés de brèves descriptions, en invitant explicitement à proposer des idées allant au-delà de l'univers fourni, tout en veillant à ce qu'elles restent en cohérence avec le cadre.
Ces deux demandes impliquent la production d’un texte à partir d’un matériau existant, mais la source sert des objectifs différents. A fait du contenu conservé une contrainte pour la révision ; B considère le cadre fourni comme un point de départ pour une nouvelle création. Cela corrobore les questions de recherche 1 et 3 : une consigne d’écriture à elle seule ne décrit pas le degré de modification autorisé. Cette comparaison ne permet pas de vérifier les affirmations factuelles du rapport ni de démontrer que l’un ou l’autre des résultats ait respecté ses instructions ; la liberté créative accordée à B reste limitée aux ajouts fictionnels.
La « preuve » est une autre propriété demandée. Certains documents recherchent une référence précise, demandent la vérification d'allégations factuelles ou exigent que l'incertitude soit distinguée des informations avérées. Cela ne permet pas de déterminer si la réponse obtenue était fiable. Cela montre simplement que l'utilisateur a explicitement intégré la notion de preuve dans le résultat demandé.
Comparaison n° 3 — Identification d'une source et limitation de la recherche externe.
Demande A — générale : Un utilisateur demande la référence scientifique exacte correspondant à une illustration jointe, présentée sous la forme d'une citation académique. Demande B — formulation générale : Un autre utilisateur demande une comparaison technique concise des matériaux en s'appuyant sur les connaissances existantes du modèle et exclut explicitement les recherches sur Internet afin d'économiser des crédits.
La différence réside dans les exigences en matière de sources et dans les moyens autorisés pour répondre. A exige une source identifiable ; B impose une limite explicite à la recherche d’informations externes. L’option A ne précise pas de procédure de recherche obligatoire, et la restriction imposée par l’option B ne supprime pas l’exigence d’exactitude. Ensemble, elles corroborent l’approche de la question de recherche n° 1 (RQ1), selon laquelle la stratégie de recherche de preuves est spécifique à la tâche. La figure et les réponses fournies n’ont pas été évaluées ici ; par conséquent, ni l’identification réussie de la source ni la fiabilité des conseils techniques n’ont été établies.
Ces cas contrastés ont leur importance. Une question factuelle directe ne nécessite pas forcément de préciser un dossier. Certaines demandes visent à obtenir un avis ou une explication, et l’un des types examinés limite explicitement la recherche externe. Les résultats confirment donc l’existence de multiples formes d’utilisabilité, et non une préférence universelle pour la production d’artefacts ou la recherche intensive.
4.2 Question de recherche n° 2 : La délégation peut-elle préserver une limite explicite au niveau de l'exécution ?
Ces documents comprennent notamment des demandes visant à obtenir un plan avant l'élaboration du cahier des charges, une première version avant la rédaction d'un résumé prêt à être présenté, ainsi que des conseils sur le degré d'automatisation à appliquer à un processus. Ces demandes consistent à déléguer une partie du travail tout en se réservant le droit de prendre une décision ultérieurement. D'autres documents demandent une mise en œuvre immédiate ou la livraison immédiate d'un livrable complet.
Comparaison n° 4 — Planifier tout de suite et écrire le code tout de suite.
Demande A — générale : Un utilisateur décrit un projet logiciel, mais demande explicitement au système de se concentrer, dans le cadre de cette réponse, sur la recherche et la planification de la mise en œuvre, en réservant la génération de code à une demande ultérieure. Demande B — formulation générale : Un autre utilisateur demande le code source permettant de mettre en œuvre une routine automatisée donnée, avec des paramètres et des règles de fonctionnement configurables.
Les deux concernent la conception de logiciels, mais leurs limites d’exécution actuelles diffèrent. A définit un objectif de mise en œuvre futur tout en limitant la tâche présente à la planification ; B demande une mise en œuvre dans la réponse immédiate. Cela corrobore la question de recherche n° 2 : déléguer un projet n’autorise pas automatiquement toutes les étapes suivantes d’un seul coup. Ces deux exemples ne permettent pas d’établir que la phase de codage ultérieure de A a eu lieu, que le programme de B a fonctionné, ni que la planification a d’abord permis d’améliorer les résultats. Il s’agit de demandes distinctes, et non d’une séquence « avant-après » observée.
Ce contraste nuance une simple distinction entre « demander » et « faire ». Une requête peut porter sur une production future, tout en demandant au système de s'arrêter dès maintenant à une étape intermédiaire. La considérer comme une exécution sans restriction reviendrait à ignorer une limite de contrôle explicitement définie.
Les extraits suivants apportent un autre point de vue. Les utilisateurs demandent une reformulation, fournissent le contexte manquant, sollicitent un format différent, recherchent des liens vers les sources ou demandent comment accéder à un résultat. Il s’agit là d’exigences d’interaction distinctes. Elles ne peuvent pas toutes être codées comme des cas de récupération après échec : une nouvelle exigence peut constituer un approfondissement de la tâche plutôt qu’une réponse à une erreur.
Ces extraits ne permettent pas non plus d'établir un enchaînement universel entre la demande, le projet et le dossier final. Le dossier ne fournit pas un historique complet et vérifié de manière indépendante des réponses. Nous observons des formulaires de demande et quelques suivis locaux, mais pas de modèle général de processus ni de probabilités de transition.
4.3 Question de recherche n° 2 : Certains travaux portent sur l'accès et le transfert entre les outils
Certains messages demandent où se trouvent les travaux antérieurs, comment télécharger des documents, quel modèle permet de traiter une tâche proposée ou comment utiliser une intégration. Ces demandes concernent l'environnement dans lequel le travail est effectué. Elles se distinguent de la tâche relative au contenu externe, même lorsqu'elles sont nécessaires à sa réalisation.
D'autres documents exigent une instruction concernant une image, une présentation ou un outil de recherche distinct. Dans ce cas, l'instruction elle-même constitue un livrable intermédiaire prévu. Elle peut s'inscrire dans un flux de travail plus large, mais le document ne permet pas de déterminer si l'outil en aval a été utilisé ou si un changement de modèle a effectivement eu lieu.
D'un point de vue analytique, cela signifie qu'une requête d'IA formulée par un utilisateur peut porter sur au moins trois éléments distincts : la tâche, son résultat et l'accès aux moyens permettant de produire ou d'obtenir ce résultat. Les questions relatives à la plateforme mettent en évidence des besoins de navigation explicites ; elles ne permettent toutefois pas, à elles seules, de détecter des défauts d'interface ou des fonctionnalités manquantes.
4.4 Question de recherche n° 3 : Les étiquettes thématiques regroupent des distinctions qui transcendent les tâches
Le recodage antérieur de la catégorie « résidu » a permis d’identifier, parmi les enregistrements initialement classés dans la catégorie « autres », la production visuelle, la recherche d’informations, la rédaction, les conseils pratiques, l’aide logicielle, les documents structurés, le codage, l’apprentissage et la navigation sur la plateforme. Le tableau complémentaire contient également des demandes explicites dont la nature n’est pas bien décrite par leur étiquette thématique existante. Certains champs source longs se terminent par une instruction opérationnelle demandant de traduire, de résumer ou de produire un document.
Deux problèmes de mesure en découlent. Premièrement, un classificateur peut réagir au sujet du contenu collé plutôt qu’à l’opération demandée au modèle. Deuxièmement, même une attribution correcte du sujet peut omettre les conditions relatives au format, à la fidélité, aux preuves ou à l’approbation qui distinguent une requête d’une autre.
| Dimension | Éléments probants figurant dans les documents examinés | Ce qui manque à une étiquette « par thème » | Cas limite |
|---|---|---|---|
| Livraison | Demandes de résultats modifiables ou téléchargeables | Seul un texte suffirait-il à répondre à la demande ? | Explications directes sans obligation de fournir un fichier |
| Fidélité | Instructions visant à conserver les faits, l'ordre ou les détails relatifs à la source | Dans quelle mesure les modifications sont-elles autorisées ? | Génération ouverte |
| Preuves | Demandes de références ou de vérification des faits | Les motifs invoqués pour accepter une demande d'indemnisation | Des restrictions explicites concernant la recherche externe |
| Contrôle | Planification ou examen préalable à la mise en œuvre | Ce que le système est autorisé à faire à ce stade | Demandes de production immédiate |
| Transfert | Consignes destinées à un autre outil | Le rôle intermédiaire du résultat demandé | Éléments destinés à être utilisés dans le cadre de la conversation |
| Accès | Questions relatives au modèle, au téléchargement, à l'historique et à l'intégration | Travaux axés sur l'environnement des services | Tâches externes ne faisant pas référence à l'exploitation de la plateforme |
Ces dimensions peuvent se recouper. Elles constituent un cadre d'interprétation et non un classificateur exhaustif récemment validé. Le tableau résume les contrastes observés dans les documents examinés et ne fournit aucun classement par fréquence.
4.5 Les documents qui ne se prêtent pas à une interprétation de fond
Le tableau de vérification principale comprend des séquences de réponses courtes répétitives ou fixes. Leur origine est inconnue ; elles pourraient correspondre à une utilisation courante, à des évaluations, à des contrôles de connectivité, à des exemples copiés ou à un autre processus. Elles n’ont pas été supprimées sans notification ni identifiées comme du trafic de test confirmé.
D'autres champs contiennent des déclarations de rôle intégrées, des marqueurs d'outils ou l'historique d'une conversation copié-collé. Ce type de présentation complique l'attribution d'une phrase à la requête actuelle de l'utilisateur. Certains enregistrements ne contiennent que du contenu source ou un fragment dont l'objectif ne peut être déterminé en l'absence de contexte.
Ces cas présentent un intérêt analytique car ils restreignent la portée de l'affirmation. L'ensemble de données ne constitue pas une transcription fidèle d'épisodes de délégation indépendants et entièrement observés. À elles seules, de meilleures catégories de tâches ne suffisent pas à lever l'incertitude quant à ce que représente un enregistrement stocké.
5. Discussion
5.1 Déléguer la production ne revient pas à renoncer au contrôle
L'interprétation principale est que les requêtes peuvent déléguer une opération tout en conservant des conditions relatives au résultat et au processus. Un utilisateur peut demander au système de produire un projet tout en préservant les faits, de planifier la mise en œuvre avant de générer du code, ou de fournir des éléments probants avant une décision. Ces cas sont compatibles avec la délégation de tâches plutôt que de constituer des exceptions à celle-ci.
Cela élargit la distinction entre la recherche d’informations et leur production au niveau des besoins exprimés. Cela n’établit pas pour autant une nouvelle théorie universelle de la collaboration entre l’humain et l’IA. Ces éléments suffisent à montrer pourquoi une étiquette d’intention unique peut nécessiter des dimensions complémentaires, mais pas à estimer la fréquence à laquelle chaque combinaison se produit.
5.2 La production de résultats et leur mise à disposition effective constituent des critères d'évaluation distincts
Une évaluation qui se contente de vérifier si une réponse aborde un sujet donné risque de passer à côté de conditions de livraison explicites. Pour les demandes d'artefacts inspectées, une évaluation pertinente devrait également déterminer si le formulaire demandé a bien été fourni, s'il est resté modifiable lorsque cela était nécessaire, s'il a conservé le contenu source spécifié et s'il a respecté une procédure d'approbation par étapes.
Il s'agit là de critères d'évaluation proposés, issus des demandes, et non de résultats de performance mesurés. Les données dont nous disposons actuellement ne nous permettent pas d'évaluer le niveau réel de conformité. Néanmoins, cette distinction permet de définir un indicateur de résultat futur plus précis que le nombre de messages ou la simple présence d'un suivi.
5.3 Ce que les conclusions ne permettent pas d'établir concernant la coordination
La définition des exigences, la vérification des preuves et la recherche d'un dossier peuvent être considérées comme des activités de coordination liées au travail délégué. Leur présence soulève une question plus profonde : l'IA réduit-elle l'effort global, ou le redistribue-t-elle vers la définition et la vérification ?
Cette étude n'apporte pas de réponse à cette question. Elle ne comporte pas de condition de comparaison, de mesures temporelles, de résultats complets ni d'évaluations indépendantes de la réussite des tâches. Un suivi pourrait correspondre à une collaboration utile, à des frictions évitables, à un changement d'objectif ou à une étape suivante de routine. Le simple fait de le prendre en compte ne permet pas de distinguer ces différentes explications.
De futures hypothèses pourraient chercher à déterminer si les conditions de diffusion explicites permettent de prédire des révisions ultérieures du format, ou si les demandes d’approbation par étapes sont associées à un nombre moindre d’actions indésirables. Pour tester ces hypothèses, il faudrait disposer d’épisodes liés entre eux, d’étiquettes validées et d’un traitement approprié des observations répétées chez les utilisateurs. Il s’agit là de pistes de recherche, et non de conclusions tirées de cette étude.
6. Limitations
Sélection et dépendance. Les tableaux de synthèse ont été fournis à des fins diagnostiques, sans indication des probabilités d'inclusion. Certains textes initiaux apparaissent à plusieurs reprises au sein d'un même tableau et d'un tableau à l'autre. Les données ne permettent pas d'étayer les affirmations relatives à la prévalence dans la population ni celles concernant une reproduction indépendante des résultats.
Interprétation. Un assistant IA a réalisé l'analyse en ayant accès aux étiquettes d'origine. Il n'y a pas eu de validation humaine indépendante ni d'estimation de la fiabilité inter-évaluateurs. Le cadre analytique a été élaboré après examen des données et peut refléter les attentes de l'analyste.
Lecture incomplète et manque de contexte. L'inspection s'est concentrée sur les introductions, certaines conclusions et des extraits de suivi. Les longs passages sources, les pièces jointes référencées et les réponses complètes des assistants n'ont pas fait l'objet d'un examen exhaustif. Il est possible que certaines instructions ou certains contre-exemples aient été omis.
Limites d'extraction. Les lignes étiquetées GPT et présentées sous forme de fenêtres peuvent omettre des activités antérieures, postérieures ou intermédiaires. Le tracé du modèle n’a pas fait l’objet d’une vérification indépendante. Les lignes stockées peuvent contenir des historiques intégrés ; le nombre de lignes ne correspond pas nécessairement au nombre de tours naturels.
Résultats. Les requêtes ne constituent pas une preuve de livraison, d'exactitude, de satisfaction, de productivité, de conversion ou de supériorité du modèle. L'étude ne tire aucune conclusion concernant des caractéristiques personnelles sensibles à partir du contenu des requêtes.
Transférabilité et contexte commercial. Les résultats portent sur une sélection de données issues d’une plateforme multimodèle. Ils ne reflètent pas l’utilisation officielle du ChatGPT ni l’ensemble du grand public. Il convient de tenir compte des intérêts commerciaux de la plateforme et de l’absence d’une évaluation indépendante de la recherche lors de l’interprétation de ces résultats.
7. Conclusion
Les demandes examinées font la distinction entre l’opération déléguée à GPT et les conditions liées à un résultat exploitable. Ces conditions comprennent le format de livraison, la fidélité au matériel source, les justificatifs et les possibilités de révision avant toute action ultérieure. L’accès à la plateforme et les invites relatives à d’autres outils ajoutent des exigences que les étiquettes thématiques ne permettent pas à elles seules de cerner.
Les données étayent une thèse précise : la délégation et le maintien du contrôle peuvent coexister au sein d’une même requête. Pour décrire cette relation, il faut s’intéresser à ce que l’utilisateur souhaite obtenir, à ce qui doit rester inchangé et à ce qu’il est demandé au système de faire ensuite. La présente analyse met en évidence ces distinctions ; elle n’évalue pas leur fréquence dans la population ni ne démontre qu’elles améliorent les résultats.
Références
- Chatterji, A., Cunningham, T., Deming, D. J., Hitzig, Z., Ong, C., Shan, C. Y. et Wadman, K. (2025). Comment les utilisateurs utilisent ChatGPT. Document de travail du NBER n° 34255. https://doi.org/10.3386/w34255. Référence officielle : https://www.nber.org/papers/w34255. Un document de travail n’est pas présenté ici comme un article de revue soumis à un comité de lecture.
- Gale, N. K., Heath, G., Cameron, E., Rashid, S. et Redwood, S. (2013). Utilisation de la méthode du cadre conceptuel pour l'analyse des données qualitatives dans la recherche multidisciplinaire en santé. BMC Medical Research Methodology, 13, 117. https://doi.org/10.1186/1471-2288-13-117. Texte intégral : https://pmc.ncbi.nlm.nih.gov/articles/PMC3848812/.
Annexe A. Liste des catégories qualitatives
Le recodage exploratoire a permis d'identifier les éléments suivants : production visuelle, instructions à réponse fixe, recherche d'informations, rédaction, conseils pratiques, navigation sur la plateforme, saisies ambiguës, dépannage logiciel, livrables structurés, codage, apprentissage, musique, conceptualisation, restructuration de sources longues et présentation des rôles et de l'historique.
Cet inventaire répertorie les catégories rencontrées dans les contenus sélectionnés. Le nombre d'occurrences par catégorie et les totaux ne sont pas communiqués ; cette liste ne constitue ni un classement par fréquence ni une estimation de la demande sur la plateforme.
Informations relatives à la recherche
Assistance par IA : Un assistant IA a examiné les extraits mentionnés, élaboré l'interprétation exploratoire, effectué les vérifications descriptives et rédigé le manuscrit. Aucune concordance avec un étiquetage humain indépendant n'est revendiquée.
Disponibilité des données : Le dossier source contient des informations confidentielles communiquées volontairement par des contributeurs autorisés et n'est pas reproduit. Les chiffres exacts et les dates d'observation ne sont pas non plus divulgués. Le présent rapport n'autorise pas la redistribution de messages individuels ou de modèles. Tous les exemples cités dans les conclusions sont des descriptions généralisées et non des citations confidentielles.