Un seul modèle suffit à recréer l'ensemble de l'ambiance sonore.
Seed Audio 1.0 permet de combiner voix, bruitages, ambiances, synchronisation et musique instrumentale. Nos tests ont révélé un potentiel créatif exceptionnellement élevé, mais aussi un problème de reproductibilité qu’il ne faut pas négliger.
Seed Audio 1.0 est l'un des premiers modèles audio que j'ai testés qui semble avoir été conçu autour d'une scène complète plutôt que d'un simple type de sortie. Il est capable de parler, de jouer un rôle, d'ajouter une ambiance sonore, de créer des bruitages, de placer des dialogues sur une timeline et de produire de la musique instrumentale à partir d'une seule consigne.
En bref : Seed Audio 1.0 offre des possibilités exceptionnelles en matière de création audio unifiée, notamment pour les dialogues synchronisés et les scènes sonores cinématographiques. Son point faible réside dans la reproductibilité. Une exécution réussie peut sembler remarquablement complète, tandis qu'une autre exécution à partir de la même consigne peut générer un discours inintelligible, omettre un événement ou modifier la voix demandée.
J'ai généré 23 échantillons notés à l'aide de l'environnement de test Anywhere/BrolyAI. Ensemble, ils couvraient la narration, les dialogues entre deux personnages, les discours horodatés, les séquences composées uniquement d'effets sonores, les scènes mêlant voix et musique, la musique seule, les interprétations multilingues, les monologues de deux minutes et la poursuite d'un enregistrement audio de référence.
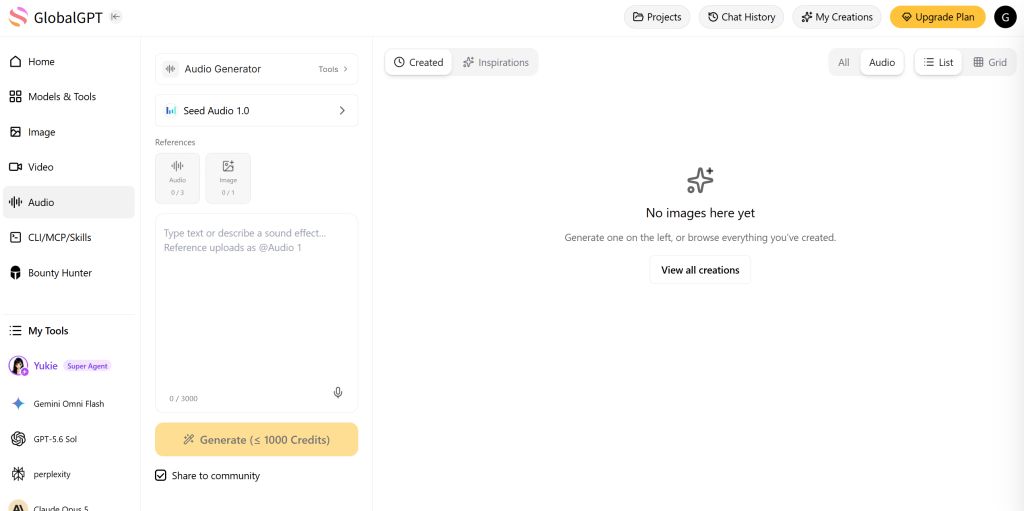
Test de Seed Audio 1.0 : le verdict en bref
| Catégorie | Résultats de nos tests |
|---|---|
| Une voix expressive | Une qualité exceptionnelle lors du premier passage, mais inégale lors des répétitions |
| Dialogue à plusieurs intervenants | Des scripts précis et une excellente séparation des voix |
| Synchronisation des dialogues | La caractéristique la plus fiable de notre ensemble de test |
| Effets sonores | Ordre réaliste des espaces et des événements ; faiblesse dans le comptage exact des événements |
| Voix + effets sonores + musique | Des scènes complètes et convaincantes où chaque événement attendu se produit |
| Musique indépendante | Plus performant que prévu ; a généré des repères structurés de 30 secondes |
| Voix multilingue | Excellent dans le meilleur des cas, mais l'une des deux lectures comportait des répliques supplémentaires imaginaires |
| Enregistrement audio de deux minutes | Une identité vocale forte et une cohérence narrative dans les deux séries |
| Audio de référence | Peu fiable lors de nos essais ; la ressemblance vocale était médiocre |
Meilleur pour : des créateurs qui réalisent des pièces radiophoniques, des séquences de jeux vidéo, des concepts de podcasts, des prototypes cinématographiques et des storyboards axés sur l'audio.
Moins adapté à : les tâches qui nécessitent une formulation déterministe, un décompte précis et répétitif d'événements, ou un clonage vocal fiable issu d'une génération automatique.
Qu'est-ce que Seed Audio 1.0 ?
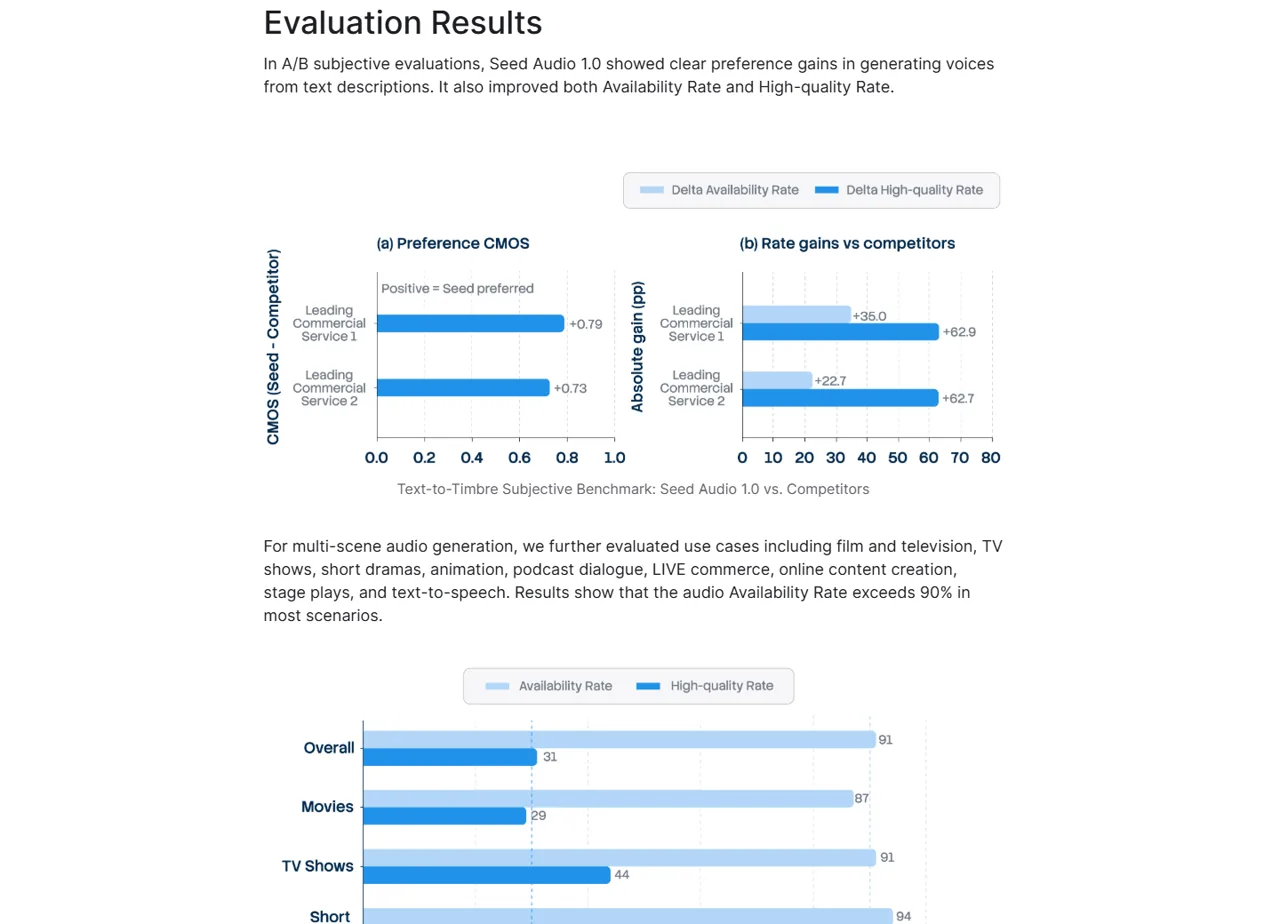
Seed Audio 1.0 est le modèle unifié de création « texte-audio » de ByteDance Seed. Au lieu de traiter la parole, les ambiances, les effets et la musique comme des tâches distinctes, il est capable de les générer ensemble pour former une scène sonore unique. La page officielle du produit indique qu’il prend en charge la synchronisation des dialogues par intervalles de 100 millisecondes et qu’il peut générer jusqu’à deux minutes de contenu en un seul passage.
C'est justement cette conception homogène qui fait tout l'intérêt de l'œuvre. Une consigne peut décrire qui parle, quelle est la sonorité de la voix, ce qui se passe dans la pièce, quels effets interviennent par la suite et quel type de musique accompagne la scène. Lors d'une bonne représentation, le résultat donne l'impression d'être une composition aboutie plutôt qu'un assemblage disparate.
Il existe toutefois une distinction importante. Selon la feuille de route de ByteDance, le synchronisme de précision se concentre actuellement principalement sur les dialogues. Le contrôle plus précis des effets sonores, des ambiances et de la musique reste un domaine à développer davantage. Nos tests ont confirmé cette distinction : le synchronisme des dialogues était excellent, tandis que la précision des effets sonores était moins fiable.
Sources officielles consultées le 6 août 2026 :
- Page produit Seed Audio 1.0
- Présentation de ByteDance Seed
- Documentation de l'API BytePlus Audio 1.0
- Tarifs de BytePlus Audio 1.0
Comment nous avons testé Seed Audio 1.0
Nous avons conçu neuf tâches et effectué 23 générations notées. La plupart des tests de performance ont été répétés deux ou trois fois, car un seul échantillon optimisé ne permet guère d'évaluer la fiabilité en production.
| Test | Tâche | Séries |
|---|---|---|
| T01 | Une narration expressive en anglais | 3 |
| T02 | Dialogue radio entre deux personnages | 3 |
| T03 | Dialogue à 0, 4 et 9 secondes | 3 |
| T04 | Séquence dans le couloir avec uniquement des effets spéciaux | 2 |
| T05 | Voix, ambiance, effets sonores et musique | 3 |
| T06 | Musique instrumentale autonome | 3 |
| T07 | Un caractère commun à l'anglais, au japonais et à l'allemand | 2 |
| T08 | Monologue de 120 secondes pour un podcast | 2 |
| T09 | Suite d'une voix de référence | 2 |
Les 23 résultats prévus comprenaient environ 12,5 minutes d'audio généré et ont généré un coût de génération en amont de $1.7504 dans l'environnement de test. Seed Audio n'a pas fourni d'informations sur l'utilisation des jetons de texte. La facturation étant basée sur le nombre de secondes générées, les jetons de génération sont enregistrés comme « sans objet ».
Tous les fichiers de sortie étaient au format WAV PCM stéréo, 40 kHz, 16 bits. Lorsque la lecture automatisée directe n'était pas disponible, le Gemini 3.6 Flash recevait les fichiers WAV en entrée audio et renvoyait des transcriptions structurées, des vérifications d'événements, des estimations de durée et des notes sur les artefacts. Ces évaluations sont des analyses d'écoute automatisées, et non des notes MOS attribuées par des évaluateurs humains.
Génération vocale : aigus impressionnants, répétabilité inégale
T01 · Récit expressif
Variance élevéeL'une d'entre elles comportait un passage superflu qui semblait tiré par les cheveux, une autre semblait guindée, et la dernière était naturelle et complète.
Prompt utilisé
Une narratrice à la voix posée prononce deux phrases identiques, passant d'un ton inquiet à un ton assuré. Pas de musique ni d'effets sonores.La consigne de narration demandait à une narratrice à la voix calme de prononcer deux phrases identiques, en passant d'une inquiétude modérée à une confiance grandissante, sans bruit de fond.
Les trois exécutions se sont déroulées de manière très différente :
- 1re manche : a prononcé la phrase demandée, puis a enchaîné avec quelques secondes de propos incohérents et improvisés.
- 2e manche : Il a prononcé le texte mot pour mot, mais sa voix semblait lente et saccadée.
- 3e manche : a interprété le script dans son intégralité avec naturel, en respectant parfaitement le rythme et la cohérence de la voix.
C'est là le principe fondamental de cette analyse. Seed Audio 1.0 permet d'obtenir un résultat vocal de grande qualité, mais un seul passage ne suffit pas pour un travail où le choix des mots est crucial. Générez des variantes et écoutez l'intégralité du résultat avant de le publier.
Le modèle a bien respecté les consignes négatives lors des trois passages de narration : aucune musique, aucun effet sonore et aucun bruit de fond indésirable n'ont été détectés.
Dialogues à plusieurs personnages et identification des locuteurs
T02 · Pièce radiophonique à deux personnages
3/3 scripts exactsLes trois scripts étaient identiques. Le bruit de fond de la pièce et la durée de l'introduction variaient d'une prise à l'autre.
Prompt utilisé
Maya murmure, Eli répond calmement, et le ronronnement du réfrigérateur accompagne ces trois répliques.Notre scène dans la supérette mettait en scène deux personnages adultes et comportait trois répliques fixes. Maya devait chuchoter d'un ton tendu, tandis qu'Eli s'efforçait de paraître calme. Le seul bruit de fond demandé était un léger ronronnement de réfrigérateur.
Les trois essais ont permis de restituer les dialogues dans le bon ordre, avec deux voix bien distinctes. Le meilleur essai alliait des répliques fidèles, une séparation claire entre les locuteurs, une émotion convaincante et un bourdonnement continu du réfrigérateur.
Les autres prises présentaient des problèmes mineurs au niveau de la scène. L'une d'entre elles a consacré environ la première moitié de ses 30 secondes à l'ambiance sonore avant d'entamer le dialogue. Une autre a omis le bourdonnement du réfrigérateur demandé. Aucune de ces erreurs n'a gâché la scène parlée, mais toutes deux réduisent l'efficacité du montage.
En ce qui concerne les pièces radiophoniques, le résultat concret est encourageant : Seed Audio saisit bien les changements de ton des personnages et les contrastes vocaux. Il se peut toutefois que vous deviez encore raccourcir les longues introductions ou relancer le calcul pour obtenir une ambiance sonore adéquate.
La synchronisation des dialogues a été le point fort
T03 · Synchronisation au niveau des invites
Le plus fiableLes trois essais ont permis de positionner les lignes à proximité des points demandés, dans les limites de l'incertitude de mesure de l'évaluateur.
Prompt utilisé
Placez trois lignes radio à 0,0, 4,0 et 9,0 secondes avec des voix d'homme, de femme et d'homme.
Le test de synchronisation a nécessité trois liaisons radio :
- “ Unité sept, au rapport. ” à 0,0 seconde.
- “ Entrée nord sécurisée. ” à 4,0 secondes.
- “ Maintenez la position. ” à 9,0 secondes.
Pour les trois passages, les lignes, l'ordre et la séquence « homme-femme-homme » des locuteurs étaient corrects. Les estimations audio de Gemini ont situé les débuts des passages répétés à environ 0,1, 4,0 et 9,0 secondes. Pour la première série, les estimations se situaient à environ 0,1, 3,9 et 8,9 secondes.
Ces mesures ne doivent pas être présentées comme une preuve de précision à 100 millisecondes digne d'un laboratoire : l'évaluateur lui-même a indiqué une incertitude d'environ 0,1 seconde. Même en tenant compte de cette réserve, il s'agissait de la fonctionnalité la plus reproductible que nous ayons testée. Si vous avez besoin d'insérer des dialogues à des positions proches de celles prévues dans la chronologie, Seed Audio 1.0 s'avère particulièrement prometteur.
Création d'effets spéciaux : scènes réalistes, comptage imparfait
T04 · Couloir (effets sonores uniquement)
Échec du comptageL'espace et l'ordre étaient convaincants, mais les deux passages ont laissé respectivement quatre empreintes de pas et deux empreintes de pas.
Prompt utilisé
Des clés, une porte lourde, exactement trois pas, un coup de tonnerre, puis un dernier claquement. Ni voix, ni musique.La consigne, qui ne comportait que des effets sonores, décrivait un petit couloir carrelé : des clés près du micro, une lourde porte en bois qui s'ouvrait, trois pas lents s'éloignant, un coup de tonnerre lointain, puis un dernier claquement de porte. Les dialogues et la musique étaient interdits.
Les deux sorties ont permis de créer un espace acoustique crédible, de préserver l'ordre des événements et d'éviter toute fuite de voix ou de musique. Les effets ont été jugés réalistes, avec une bonne perception de la distance et une bonne cohérence spatiale.
Aucune des deux séquences ne correspondait exactement au nombre indiqué. L'une comportait quatre bruits de pas, l'autre deux. Cela rend Seed Audio utile pour créer un concept de bruitage convaincant, mais moins fiable lorsqu'un monteur a besoin exactement de trois impacts, coups, bruits de pas ou coups de feu.
La meilleure méthode consiste à utiliser la génération d'effets sonores en un seul passage pour créer l'ambiance et réaliser un prototypage rapide, puis à remplacer ou modifier les événements où le nombre de répétitions est crucial dans une station de travail audio numérique (DAW).
Voix, bruitages d'ambiance, effets sonores et musique dans une même scène
T05 · Mixage cinématographique complet
Terminé à 2/3Deux des trois séries ont été menées à bien à chaque coup. L'une d'entre elles a raté le dernier coup métallique.
Prompt utilisé
Une ruelle sous la pluie, le bruit de la circulation, une sirène, un détective qui murmure, un rythme de cordes, des pas précipités et un claquement métallique.
Le test de scène complète était délibérément chargé. Il fallait y reproduire une ruelle nocturne humide, des gouttes d'eau, la circulation, une sirène de police en mouvement, une réplique de détective murmurée, des cordes en sourdine, des pas précipités et un claquement de porte métallique.
Deux des trois essais comprenaient la séquence complète de l'événement. Les dialogues restaient clairs malgré le bruit de fond et la musique, et la scène donnait une impression de cohérence spatiale, plutôt que celle d'une succession de clips sans lien entre eux superposés. Un essai n'a pas reproduit le bruit métallique final, bien qu'il ait par ailleurs su recréer l'atmosphère adéquate et restituer fidèlement les répliques.
C'est là que le modèle unifié démontre le mieux ses atouts. Pour la création de storyboards et la conception créative, générer une scène mixte complète à partir d'une seule consigne est plus rapide et plus expressif que de rechercher chaque élément séparément. Pour la production finale, les repères de fin importants doivent toutefois encore être vérifiés.
Can Seed Audio 1.0 permet-il de créer de la musique ?
T06 · Musique autonome
Œuvres musicalesTous les trois ont composé une musique structurée. L'un d'entre eux a rendu le son du piano en sourdine difficile à distinguer.
Prompt utilisé
Un morceau de suspense à 72 BPM avec un ostinato de violoncelle, un piano en sourdine, un bourdonnement analogique, une montée en puissance et une fin en suspens.
Oui. Lors de nos tests, Seed Audio 1.0 a généré une musique instrumentale autonome clairement identifiable, et non pas seulement une vague texture d'ambiance.
La consigne demandait un morceau de suspense de 30 secondes à 72 BPM, avec un ostinato de violoncelle grave, des pulsations de piano en sourdine, un bourdonnement analogique doux, une montée en puissance claire et un accord final non résolu. Les trois versions proposées formaient un morceau cohérent, respectant le tempo, l’ambiance et la fin demandés. Deux d’entre elles comprenaient tous les éléments demandés ; dans l’une d’elles, le piano en sourdine était difficile à distinguer.
Cela ne signifie pas pour autant que Seed Audio puisse automatiquement se substituer à un générateur de morceaux dédié. Notre mission consistait à créer un court extrait instrumental de type cinématographique, et non un morceau comportant un couplet et un refrain avec des paroles. Néanmoins, ses capacités musicales sont suffisamment importantes pour accompagner des scènes de jeu vidéo, des bandes-annonces, des podcasts et des prévisualisations — en particulier lorsque la musique doit interagir avec les dialogues et la conception sonore au cours de la même génération.
Performances multilingues : excellentes dans le meilleur des cas, faibles dans le pire des cas
T07 · Une seule voix, trois langues
1/2 propreL'une des exécutions s'est déroulée sans accroc ; l'autre a donné lieu à des répétitions et à des déformations du discours au moment du changement de langue.
Prompt utilisé
Un personnage féminin parle anglais, japonais et allemand avec le même naturel et le même calme.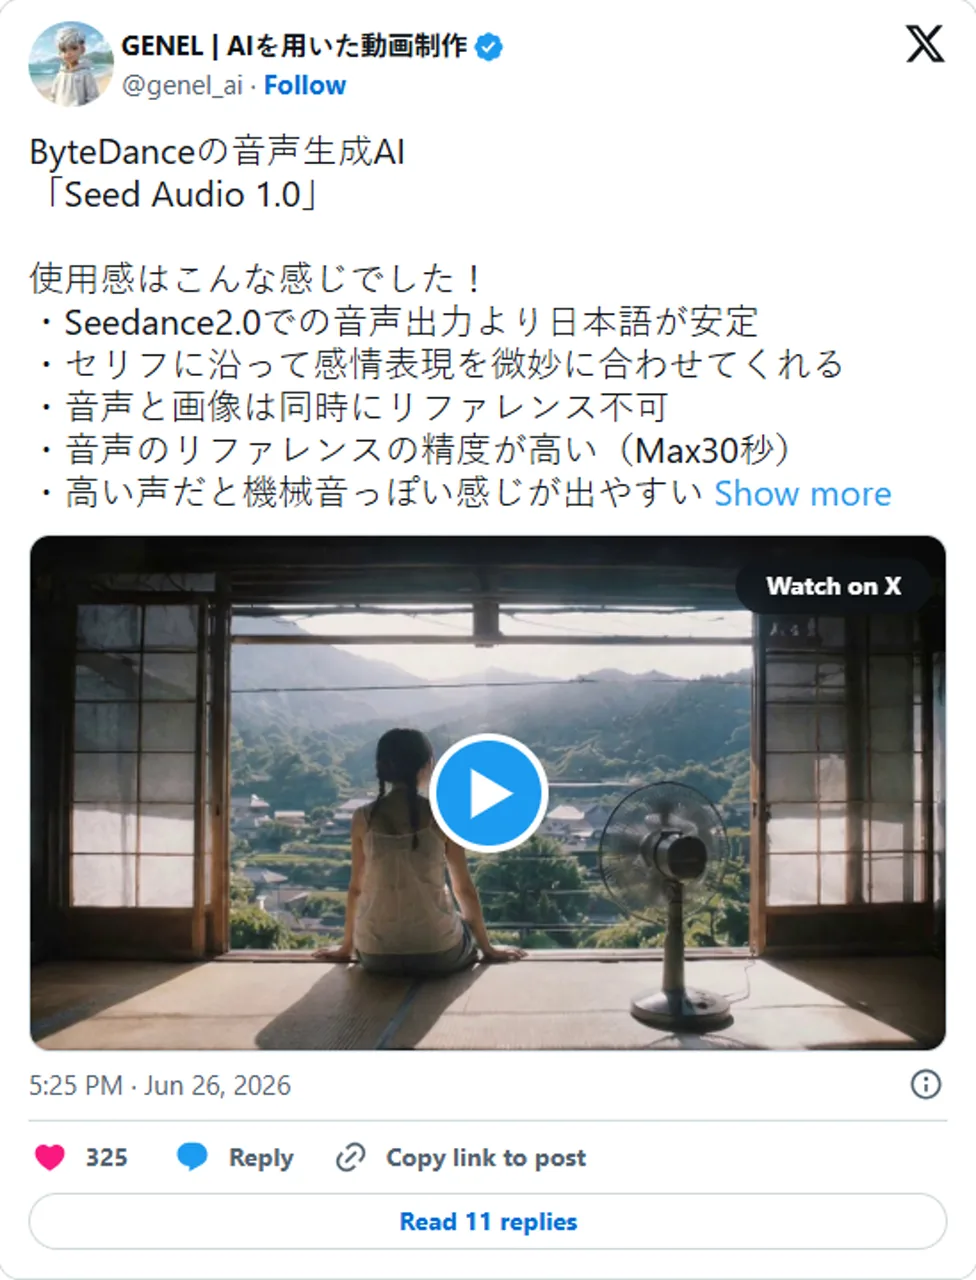
Dans le cadre de cet exercice multilingue, un personnage féminin devait interpréter le même rôle en anglais, en japonais et en allemand. Les deux prises ont donné lieu à des impressions diamétralement opposées.
La version la plus aboutie a restitué les trois phrases avec précision, a conservé le même ton, a su maintenir un ton calme et a utilisé des pauses bien marquées. La version la moins aboutie a bien commencé en anglais, mais a ensuite répété et déformé le discours au niveau de la partie en japonais, ce qui a nui à l'introduction en allemand. La cohérence perçue du ton d'une langue à l'autre a fortement diminué.
Cela signifie que Seed Audio 1.0 est capable de produire des performances convaincantes pour les personnages multilingues, mais cette fonctionnalité nécessite plusieurs candidats et une révision tenant compte de la langue. Ne validez pas un résultat multilingue en ne vérifiant que la première langue.
Création en deux minutes et stabilité des contenus vocaux longs
T08 · Monologue de 120 secondes
2/2 stableLes deux fichiers ont atteint 120 secondes avec une voix stable. L'un d'eux présentait un bref trou d'élocution.
Prompt utilisé
Un animateur de podcast raconte l'histoire d'une station météo de manière structurée, en évoquant trois découvertes sans donner de contexte.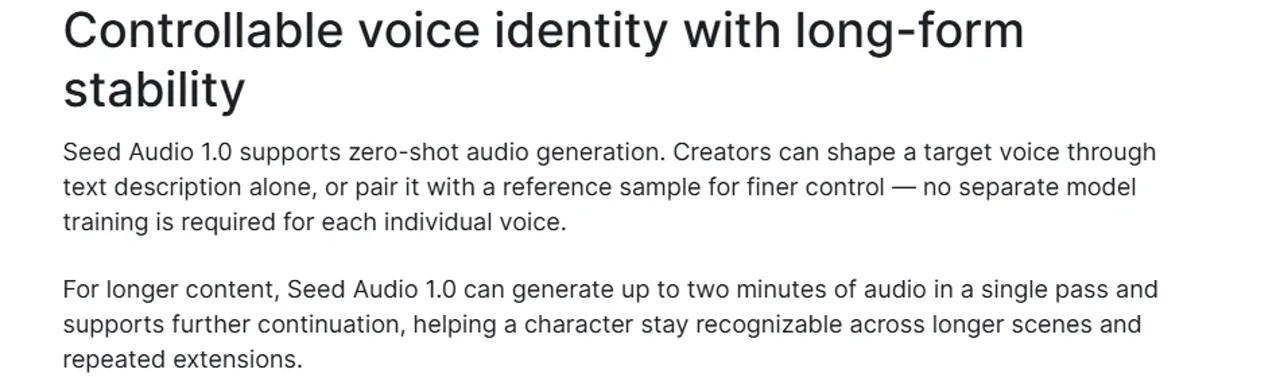
Les deux exercices de longue durée ont généré des fichiers WAV d'une durée exacte de 120 secondes. Chacun d'entre eux mettait en scène un animateur de podcast masculin, avec un son de studio « sec », sans musique ni effets sonores.
La première version présentait une voix unique et une structure narrative cohérente tout au long du texte : une introduction claire, trois découvertes présentées par ordre chronologique, une évolution de la curiosité vers le malaise, et une question finale restée sans réponse. Aucun écart de ton ni segment confus n'a été détecté.
La deuxième exécution s'est révélée tout aussi cohérente et stable, avec un bref accroc de prononciation vers 1 min 31 s. C'est un excellent résultat pour un monologue de deux minutes enregistré en une seule prise. Cela suggère que l'argument de Seed Audio concernant les formats longs ne se résume pas à une simple limite de durée ; le modèle est capable de préserver l'identité et la structure narrative tout au long de la séquence.
La continuité audio de référence nécessite une certaine prudence
T09 · Suite de la référence
Itinéraire incertainLe texte était fidèle, mais la ressemblance vocale était médiocre ; l'un des résultats a été transformé en voix masculine et des effets sonores ont été ajoutés.
Prompt utilisé
Reprendre à partir d'un enregistrement de référence féminin autorisé, tout en conservant l'identité vocale et le style d'enregistrement intimiste.Le test de référence a utilisé l'échantillon de narration le plus marquant comme données d'entrée autorisées et a demandé une suite respectant la même identité féminine générale et le même style d'enregistrement intime.
Les deux résultats reproduisaient exactement la suite demandée, mais aucun des deux ne correspondait bien à la référence. Le premier s'est transformé en un murmure haletant et a obtenu un score de similarité vocale modeste de 2/5. Le second a été jugé comme utilisant une voix masculine, a obtenu un score de similarité de 1/5 et a ajouté environ 17 secondes d'effets sonores indésirables avant de commencer à parler.
Il convient toutefois de noter une limitation importante à ce niveau. Le point de terminaison de la tâche « Anywhere » a bien accepté le champ de référence, mais il n’a pas renvoyé de confirmation indiquant comment le modèle en amont avait exploité cette référence. Ces résultats démontrent que la continuité des références n’était pas fiable sur notre parcours de test ; ils ne prouvent pas pour autant que l’API native de BytePlus se comporte toujours de la même manière.
Tarifs et restrictions de Seed Audio 1.0
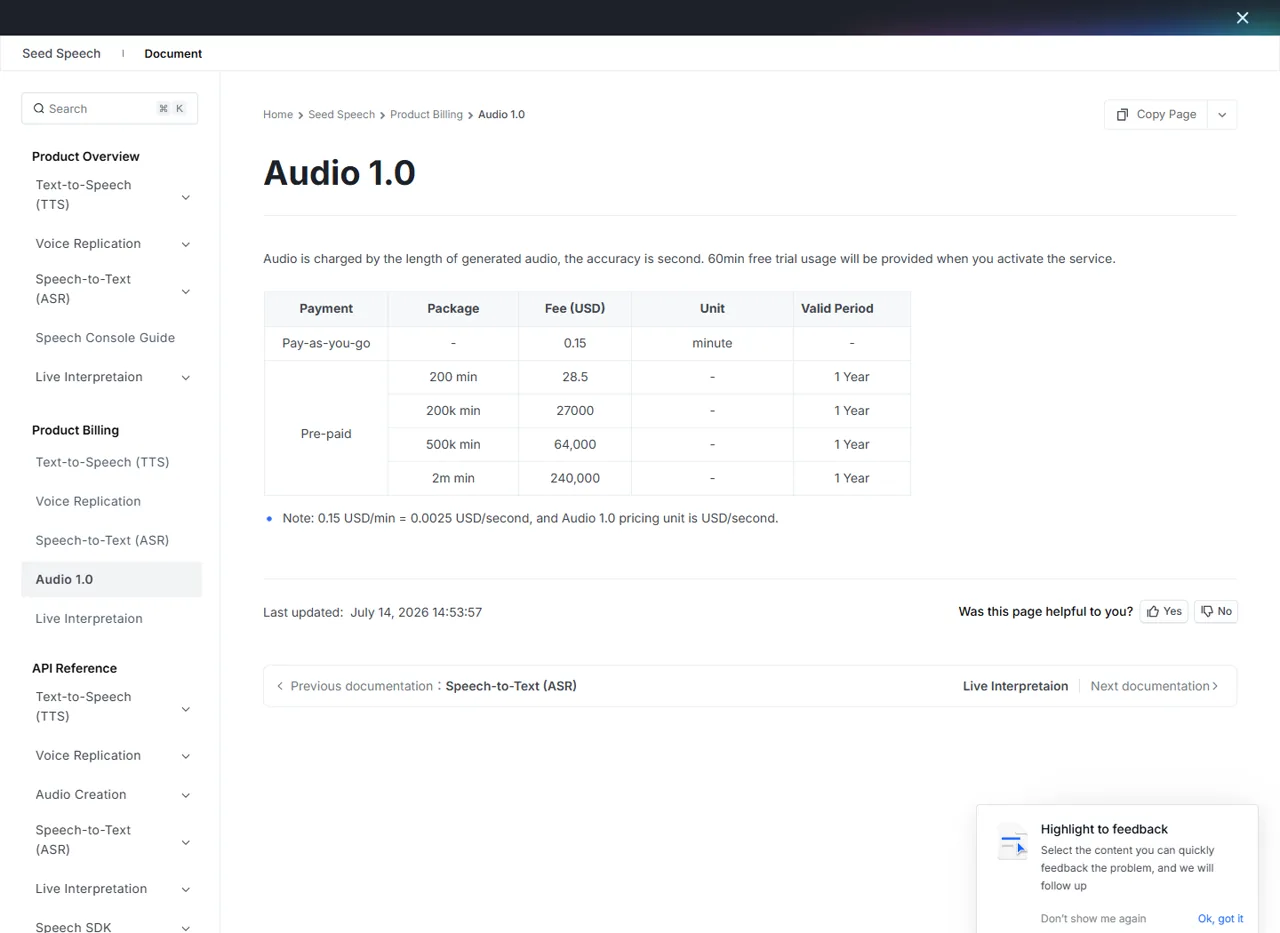
Facturation à la seconde, avec 60 minutes d'essai gratuites à l'activation du service.
puissance maximale
caractères d'invite
références audio
image de référence
BytePlus indique le prix officiel du forfait prépayé à $0,15 par minute générée, facturé à la seconde, avec 60 minutes d'essai gratuit lorsque le service est activé. La documentation de l'API définit une Puissance maximale pendant 120 secondes, prend en charge les invites jusqu’à 3 000 caractères, permet jusqu'à trois extraits audio de référence, et accepte une image de référence.
Chaque extrait audio de référence peut durer jusqu'à 30 secondes et peser jusqu'à 10 Mo. La taille maximale des images de référence est de 10 Mo. Il s'agit là des limites propres à BytePlus ; les plateformes tierces peuvent proposer un formulaire de saisie plus restreint ou appliquer une tarification différente.
Notre parcours de test Anywhere/BrolyAI a indiqué le coût en amont séparément, avec une moyenne d'environ $0,14 par minute générée. Ce champ relatif à l'environnement de test ne doit pas être confondu avec les tarifs grand public de BytePlus ni avec le prix final d'une autre plateforme.
Avantages et inconvénients de Seed Audio 1.0
Ses points forts
- Voix, bruitages, ambiances sonores et musique unifiés
- Un excellent sens du timing dans les dialogues
- Une identité forte et approfondie
- Musique de film utile
Où ça casse
- Grande variance d'un échantillon à l'autre
- Des troubles occasionnels de l'élocution
- Comptage exact « faible » des effets SFX
- Continuité des repères peu fiable sur notre itinéraire
Pour
- Génère des voix, des ambiances, des bruitages et de la musique en une seule étape.
- Un excellent timing des dialogues lors de nos tests répétés.
- Une séparation nette entre les deux locuteurs et une restitution fidèle du texte.
- Permet de créer une musique de film autonome et de grande qualité.
- Préserve l'identité vocale et la cohérence narrative pendant deux minutes.
- Il produit un fichier WAV stéréo de 40 kHz de bonne qualité via notre circuit de test.
Cons
- Les exécutions répétées peuvent présenter des écarts considérables en termes de naturel et de fiabilité.
- Des troubles occasionnels de l'élocution, avec des propos incohérents ou confus.
- Les chiffres exacts concernant les effets sonores ne sont pas fiables.
- Certaines scènes complètes ne comportent pas l'événement final demandé.
- Les performances multilingues doivent faire l'objet d'un examen minutieux.
- La continuité de la voix de référence était médiocre dans notre environnement de test.
- Un nombre élevé de soumissions parallèles a provoqué des erreurs de concurrence en amont, bien que les tâches ayant échoué n'aient pas été facturées.
À qui s'adresse Seed Audio 1.0 ?
Seed Audio 1.0 est la solution idéale pour les créateurs audio qui raisonnent en termes de scènes plutôt qu’en éléments isolés. Il s’avère particulièrement utile pour les pièces radiophoniques, les dialogues de jeux vidéo, les prototypes cinématiques, les storyboards audio, les concepts de podcasts et les courts extraits musicaux à suspense.
Il s'avère moins convaincant en tant que système de livraison finale en un seul clic. Si la formulation exacte, l'identité vocale ou le nombre d'événements revêtent une importance cruciale d'un point de vue juridique ou créatif, prévoyez plusieurs itérations et une révision humaine. Ce modèle fonctionne mieux lorsque vous le considérez comme un « réalisateur audio » rapide proposant plusieurs prises, et non comme un moteur de rendu déterministe.
Foire aux questions
Seed Audio 1.0 est-il un modèle de synthèse vocale ?
Can Seed Audio 1.0 permet-il de générer des effets sonores sans voix ?
Can Seed Audio 1.0 permet-il de créer de la musique ?
Combien de temps Seed Audio 1.0 peut-il générer des sons ?
Seed Audio 1.0 prend-il en charge l'audio de référence ?
Combien coûte Seed Audio 1.0 ?
Verdict final
Seed Audio 1.0 est un modèle audio unifié véritablement intéressant. Sa capacité à produire des voix, des bruitages, des ambiances et de la musique convaincants à partir d'une seule consigne n'est pas seulement un argument de lancement : nos tests combinant scènes et musique ont démontré que ces éléments peuvent fonctionner ensemble.
Son principal atout résidait dans le timing des dialogues. Son plus grand point faible était le manque de cohérence. Sur les 23 échantillons analysés, le modèle a régulièrement présenté un résultat optimal excellent, mais aussi une variante nettement moins convaincante.
Dans le cadre du prototypage créatif, ce compromis est facile à accepter. Générez plusieurs versions, conservez la meilleure d’entre elles et examinez chaque fin. Pour la production déterministe, la correspondance vocale exacte ou les travaux où le nombre d’événements est déterminant, prévoyez une étape de révision et d’édition par un humain dans le flux de travail.
Verdict final : Seed Audio 1.0 est l'un des générateurs audio au niveau de la scène les plus performants que nous ayons testés, mais il est plus efficace lorsqu'il est utilisé comme outil créatif permettant de réaliser plusieurs prises plutôt que comme outil de rendu final en une seule prise.