Muse Spark 1.2 allie un coût par jeton exceptionnellement bas à une fenêtre contextuelle de 1 million de jetons, et a réussi les trois tâches de codage du modèle de base lors de notre première série de tests via l'API. Meta a lancé ce modèle le 5 août 2026, avec une fenêtre contextuelle d'un million de tokens, deux niveaux tarifaires pour l'API et un agent terminal distinct appelé Muse Code. Les résultats des tests de performance de Meta sont prometteurs ; les classements publics indépendants en matière de programmation n'ont toutefois pas encore validé ces mêmes combinaisons de modèles et d'agents.
Cette analyse distingue le modèle de l’agent, les scores officiels des preuves indépendantes, et la tarification standard du compromis entre utilisation des données et niveau « Contributor ». Lors de nos tests, le modèle a mené à bien une correction d’idempotence en Python, une refactorisation TypeScript préservant la compatibilité et une fonctionnalité JSONL à l’échelle du dépôt, sans aucune tentative de rattrapage. L’exécution de l’agent Muse Code n’a pas été testée, pas plus que la fiabilité des appels d’outils. Si vous souhaitez d’abord comparer l’ensemble du secteur, consultez notre guide sur le Les meilleurs modèles d'IA pour le codage donne une vue d'ensemble du contexte concurrentiel.
Test de Muse Spark 1.2 : en bref
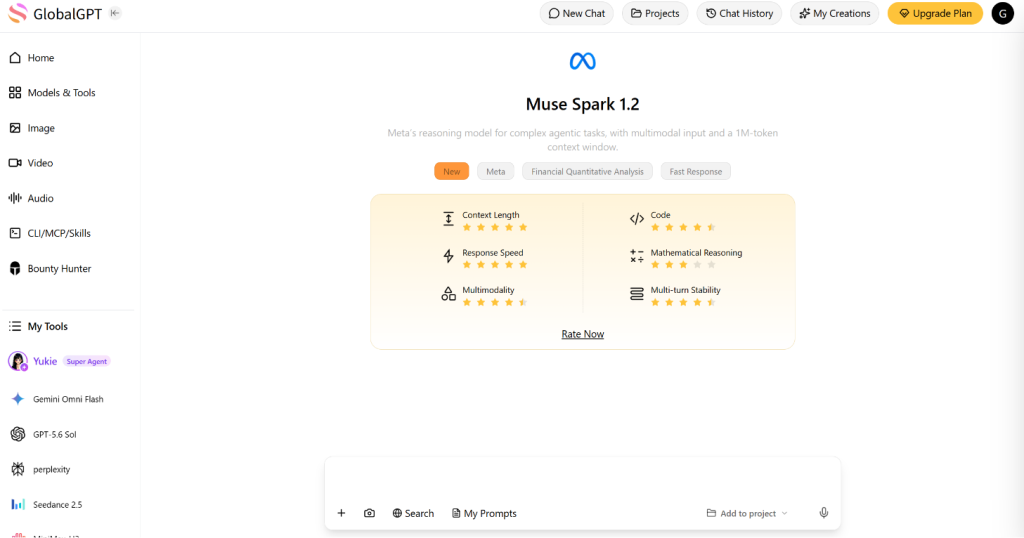
En bref : Muse Spark 1.2 est un modèle Meta axé sur le codage, doté d’une fenêtre de 1 million de tokens, d’un accès API compatible avec le SDK OpenAI et d’un niveau « Contributor » particulièrement attractif. Son principal atout, mis en avant publiquement, est son rapport qualité-prix : 1 TP 41 T 0,10 en entrée et 1 TP 41 T 0,20 en sortie par million de tokens sur le modèle « Contributor ». Ce niveau peut être utilisé pour améliorer les produits Meta, alors que le modèle standard, plus coûteux, n’est pas destiné à cet usage.
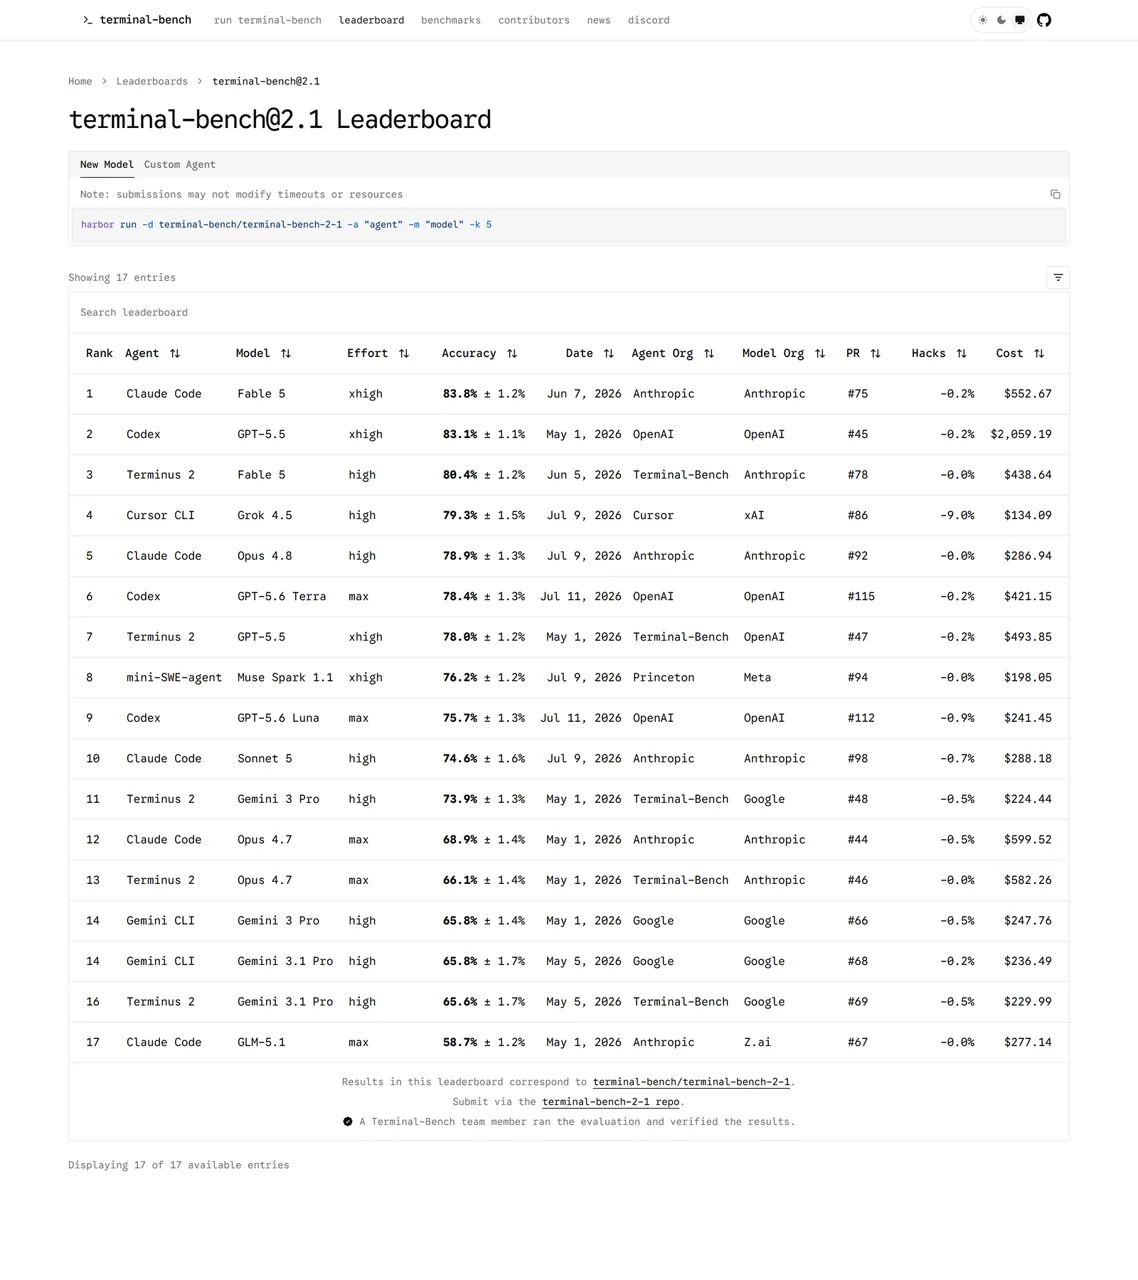
Les performances devraient être interprétées avec plus de prudence. Meta annonce un score de 82,91 TP40T sur Terminal-Bench 2.1 pour Muse Spark 1.2 avec Muse Code, et de 59,31 TP40T sur DeepSWE. Il s'agit là de résultats obtenus par Meta. Les classements publics de Terminal-Bench et DeepSWE ne mentionnaient toujours pas Muse Spark 1.2 lors d'une vérification effectuée le 26 août 2026. Analyse artificielle fournit une vérification indépendante : son « Intelligence Index » reste à 57, soit un niveau supérieur à la médiane de 35 pour les modèles comparables.
- La meilleure raison de l'essayer dès maintenant : des tarifs avantageux pour les contributeurs, un contexte étendu et une API qui suit le modèle client OpenAI bien connu.
- La meilleure raison de rester prudent : Ces trois tâches contrôlées sur le modèle de base ne permettent pas d'établir la fiabilité de l'agent Muse Code, la qualité des appels d'outils ni ses performances au sein d'un vaste référentiel de production.
- Choix important concernant la confidentialité : Utilisez le modèle standard pour le code ou les invites que vous ne souhaitez pas voir utilisés pour améliorer les produits Meta.
Muse Spark 1.2 en bref
Caractéristiques techniques vérifiées
Meta décrit Muse Spark 1.2 comme un modèle offrant une plus grande précision de codage dès la première tentative et un appel d'outils plus fiable que Muse Spark 1.1. Il s'agit là d'allégations du fournisseur issues du page officielle du modèle Muse Spark, et non des conclusions tirées de notre propre session de codage.
Muse Spark 1.2 vs Muse Code
Muse Spark 1.2 est le modèle. Muse Code est un agent terminal bêta distinct qui s'appuie sur ce modèle. Cette distinction est importante car un agent peut intégrer des fonctionnalités de planification, d'orchestration des outils, de navigation dans le référentiel, d'isolation de l'arborescence de travail, de journalisation et de gestion des tentatives de réessai autour du modèle sous-jacent.
Gardez les calques séparés
Muse Spark 1.2
Contexte, raisonnement, comportement de l'API, facturation des jetons, résultats et décisions relatives à l'appel des outils.
Identifiants des modèlesContexte 1MPrix de l'API
Code Muse
Expérience utilisateur du terminal, sous-agents, arborescences de travail Git, journal des événements, reprise du flux, compétences groupées et orchestration.
Flux de travail des agentsRésultats du système de méta-exécution
Le page officielle du Muse Code qualifie ce produit d’« agent de codage bêta ». Cela rend les comparaisons avec des produits tels que Claude Code et Codex plus pertinentes que de prétendre que chaque différence observée dans le flux de travail provient uniquement d’un modèle de prédiction. Notre Comparaison entre Codex et le code Claude explique pourquoi l'environnement de développement peut influencer l'expérience du développeur autant que le modèle lui-même.
Tests de performances de Muse Spark 1.2 : ce que révèlent réellement les résultats
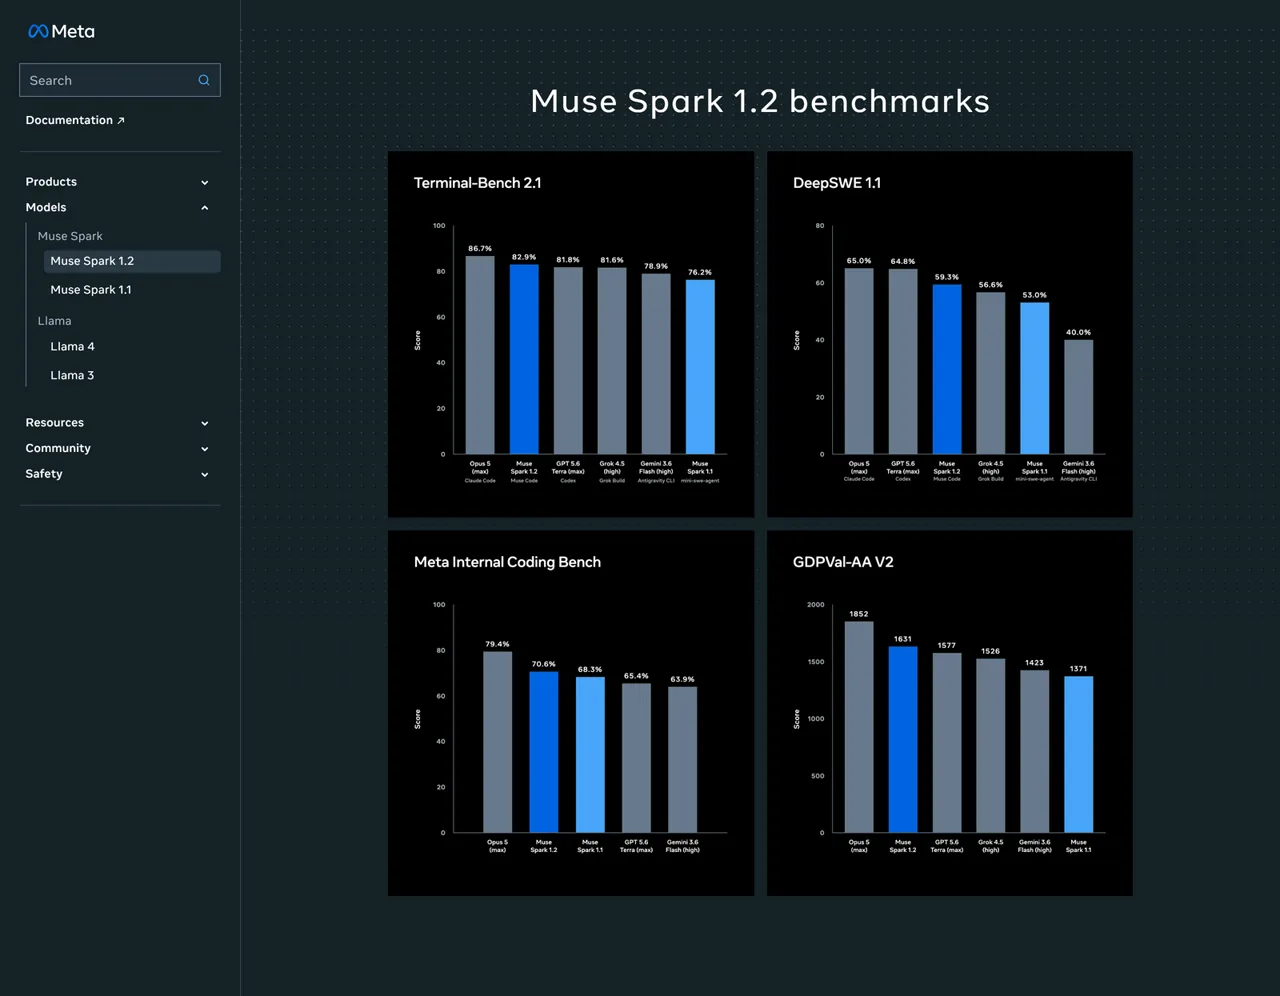
Le tableau comparatif de Meta place Muse Spark 1.2 parmi les meilleurs résultats de plusieurs évaluations de codage. Ces chiffres méritent d’être examinés, mais ils ne constituent pas un classement unique et clair de la qualité brute du modèle. Le modèle, l’agent, le harnais, la capacité de raisonnement et le protocole de tâche peuvent tous évoluer simultanément.
Meta-reported Terminal-Bench 2.1
Panel de référence Meta
Terminal-Bench 2.1
Les 89 tâches · réussite à la première tentative après cinq essais · combinaisons sélectionnées de modèles et d'agents
Le chiffre 82,9% correspond à un Résultat du code Muse généré par Meta-run. Le Classement public de Terminal-Bench 2.1 n'a pas répertorié Muse Spark 1.2 le 26 août 2026, donc il s'agit Entrée non vérifiée dans le classement public. Le tableau public indiquait en effet une valeur de 76,21 TP40T ± 1,21 TP40T pour le Muse Spark 1.1 équipé du mini-SWE-agent.
DeepSWE 1.1 tel que rapporté par Meta
Panel de référence Meta
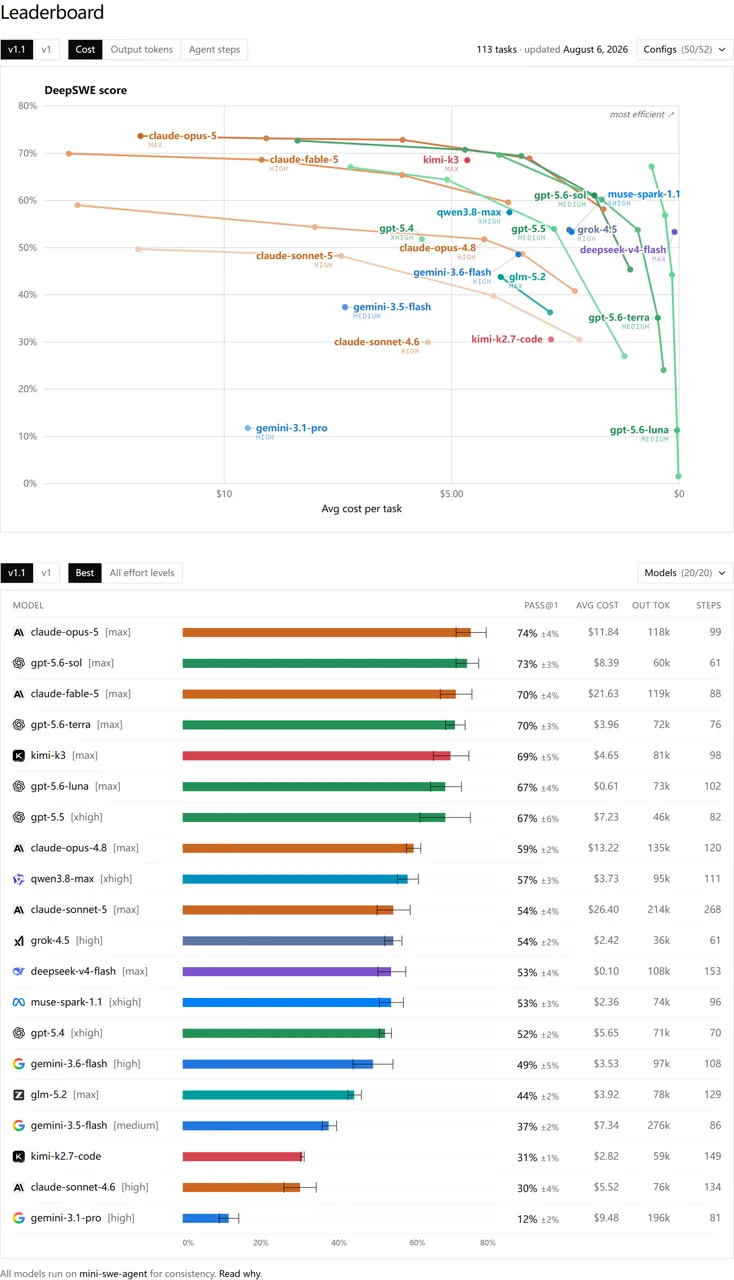
DeepSWE 1.1
113 tâches · 91 dépôts · cinq langues · pass@1 en cinq tentatives
Le Classement public DeepSWE v1.1 utilise mini-swe-agent sur l'ensemble de ses modèles répertoriés, par souci de cohérence. Au moment de la vérification, Muse Spark 1.2 n'avait pas encore été ajouté ; Muse Spark 1.1 était répertorié sous la référence 53%. Le résultat de Meta (59,3%) utilise Muse Code ; les deux chiffres ne correspondent donc pas exactement au même banc d'essai.
Évaluations internes et par des agents généraux de Meta
Deux échelles d'évaluation différentes
Banc de codage interne de Meta
440 tâches internes · deux tentatives par tâche
| Modèle | Score |
|---|---|
| Opus 5 | 79.4% |
| Muse Spark 1.2 | 70.6% |
| GPT-5.6 Terra | 65.4% |
| Gemini 3,6 Flash | 63.9% |
| Grok 4,5 | Non illustré |
GDPVal-AA v2
Évaluation générale des tâches agentiques · Valeurs de type Elo
| Modèle | Score |
|---|---|
| Opus 5 | 1852 |
| Muse Spark 1.2 | 1631 |
| GPT-5.6 Terra | 1577 |
| Grok 4,5 | 1526 |
| Gemini 3,6 Flash | 1423 |
Meta’s méthodologie d'évaluation Selon Terminal-Bench, le système utilise l’ensemble des 89 tâches et obtient un « pass@1 » sur cinq tentatives. DeepSWE couvre 113 tâches réparties sur 91 dépôts et cinq langages, avec également un « pass@1 » sur cinq tentatives. Meta précise également que sa configuration n’est peut-être pas optimisée pour les modèles tiers. Pour une comparaison actuelle avec la concurrence, fondée sur des décisions réelles en matière de produits, voir Claude Opus 5 contre GPT-5.6.
La méthodologie change le sens
Modèle + agent sélectionné
89 tâches, cinq tentatives, des paramètres de raisonnement maximaux différents, et il se peut que le cadre de test de Meta ne soit pas optimisé de la même manière pour les systèmes tiers.
Entrées vérifiées
Muse Spark 1.2 n'apparaissait pas lors de la vérification. Les configurations de la carte et l'état de vérification doivent être consultés séparément dans le tableau de Meta.
Agent « mini-swe » courant
113 tâches réparties sur 91 dépôts et cinq langages. Muse Spark 1.2 n'apparaissait pas ; Muse Spark 1.1 était répertorié sous la référence 53%.
Analyse artificielle : un contexte indépendant utile
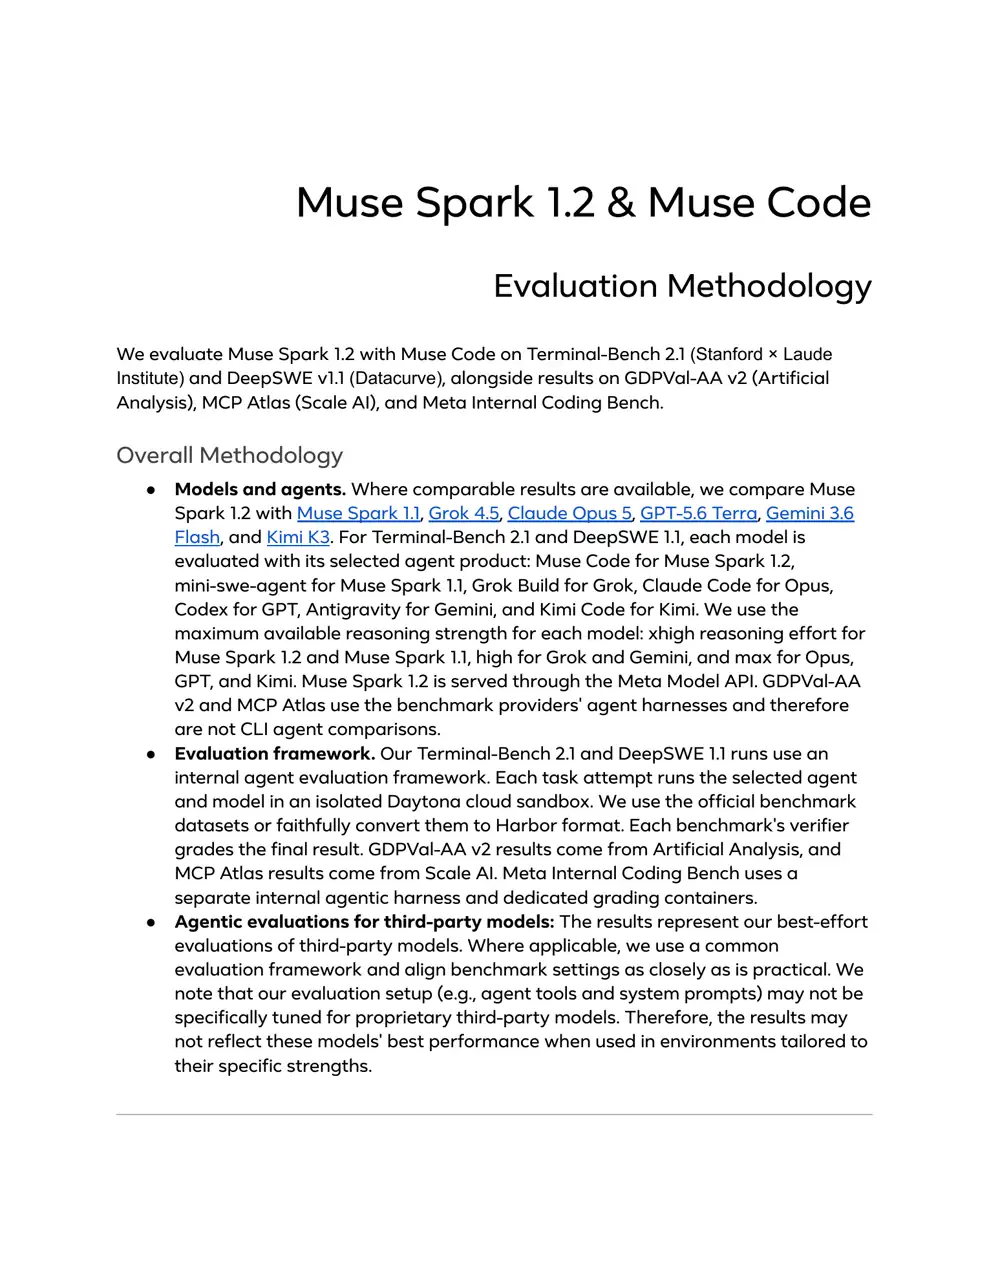
Le Page du modèle d'analyse artificielle attribue à Muse Spark 1.2 un indice d'intelligence de 57, soit un chiffre supérieur à la médiane des modèles comparables, qui s’élevait à 35 lors de la vérification effectuée le 26 août 2026. Son harnais affiche 80% sur Terminal-Bench v2.1, 57% normalisé sur GDPVal-AA v2, 56% sur SciCode et 83% lors de l’évaluation AA-LCR à long contexte.
Évolution de la version d'« Artificial Analysis »
La leçon à en tirer est simple : Muse Spark 1.2 semble compétitif, mais aucun score pris isolément ne permet de cerner le modèle. Considérez le graphique de Meta comme une preuve en faveur du système Muse Code, les classements publics comme une vérification croisée distincte, et Artificial Analysis comme une évaluation indépendante mais configurée différemment.
Muse Spark 1.2 : compromis entre prix et confidentialité
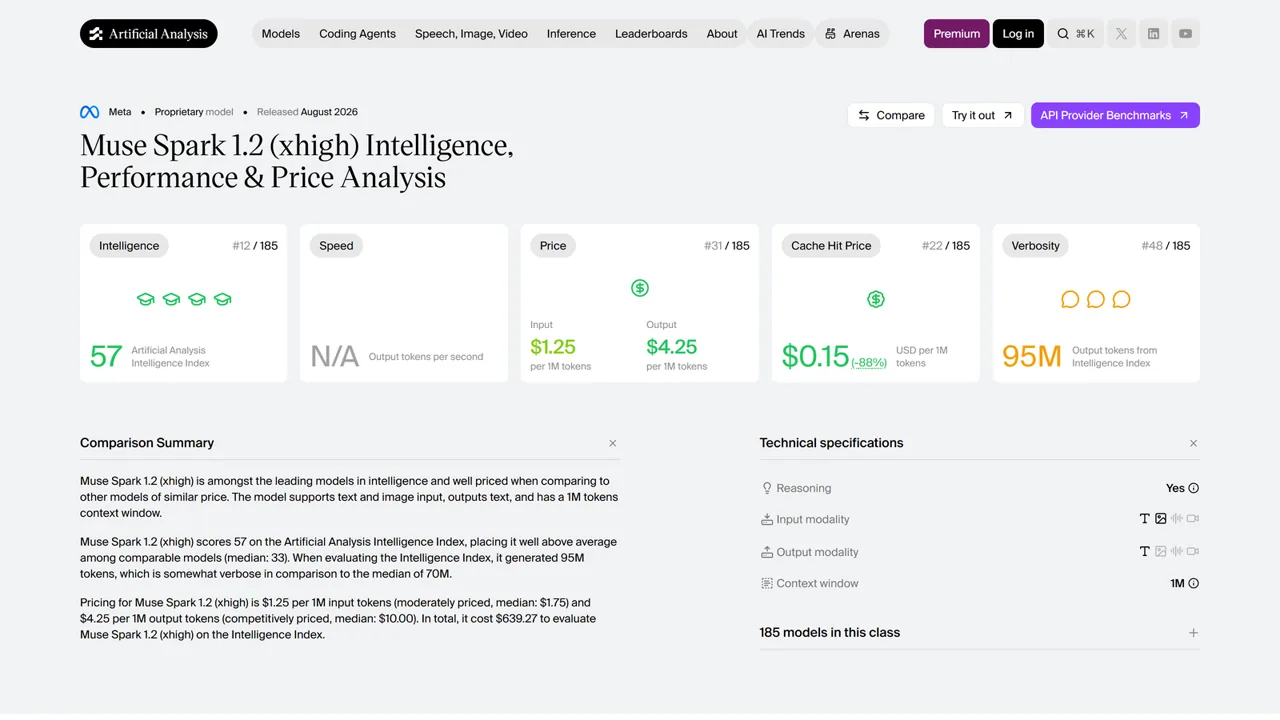
Meta propose deux identifiants de modèle d'API dont les prix varient considérablement. L'option la moins chère n'est pas simplement une réduction : elle modifie la manière dont les données transmises peuvent être utilisées.
USD par million de jetons · Contexte « 1M »
Non utilisé pour l'amélioration des produits
N'est pas utilisé pour améliorer les produits Meta
Moins cher, mais avec des restrictions en matière de consommation de données
Données peuvent être utilisées pour améliorer les produits Meta
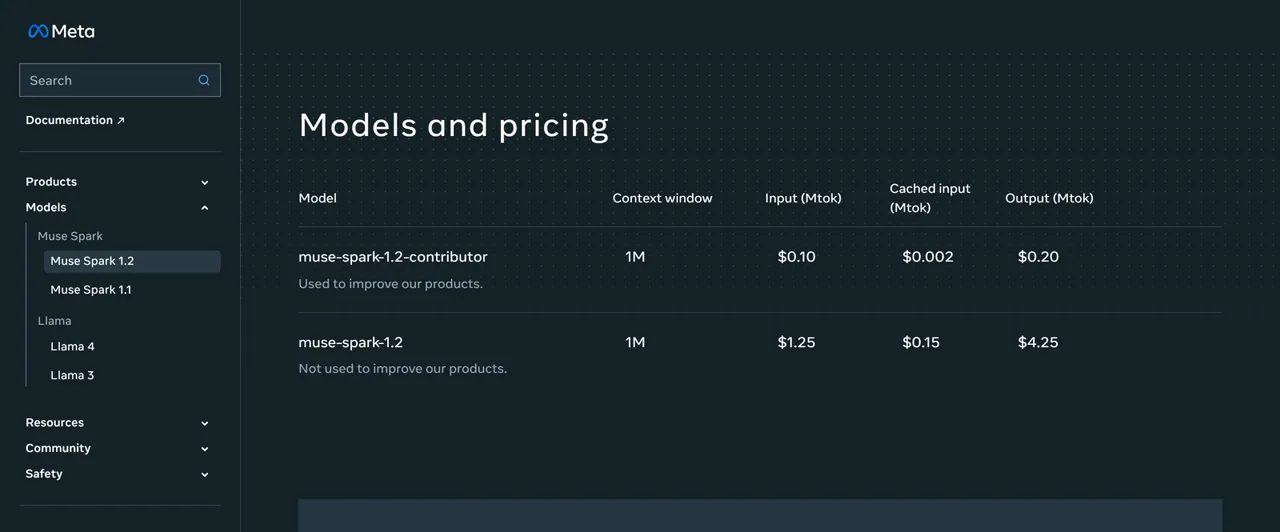
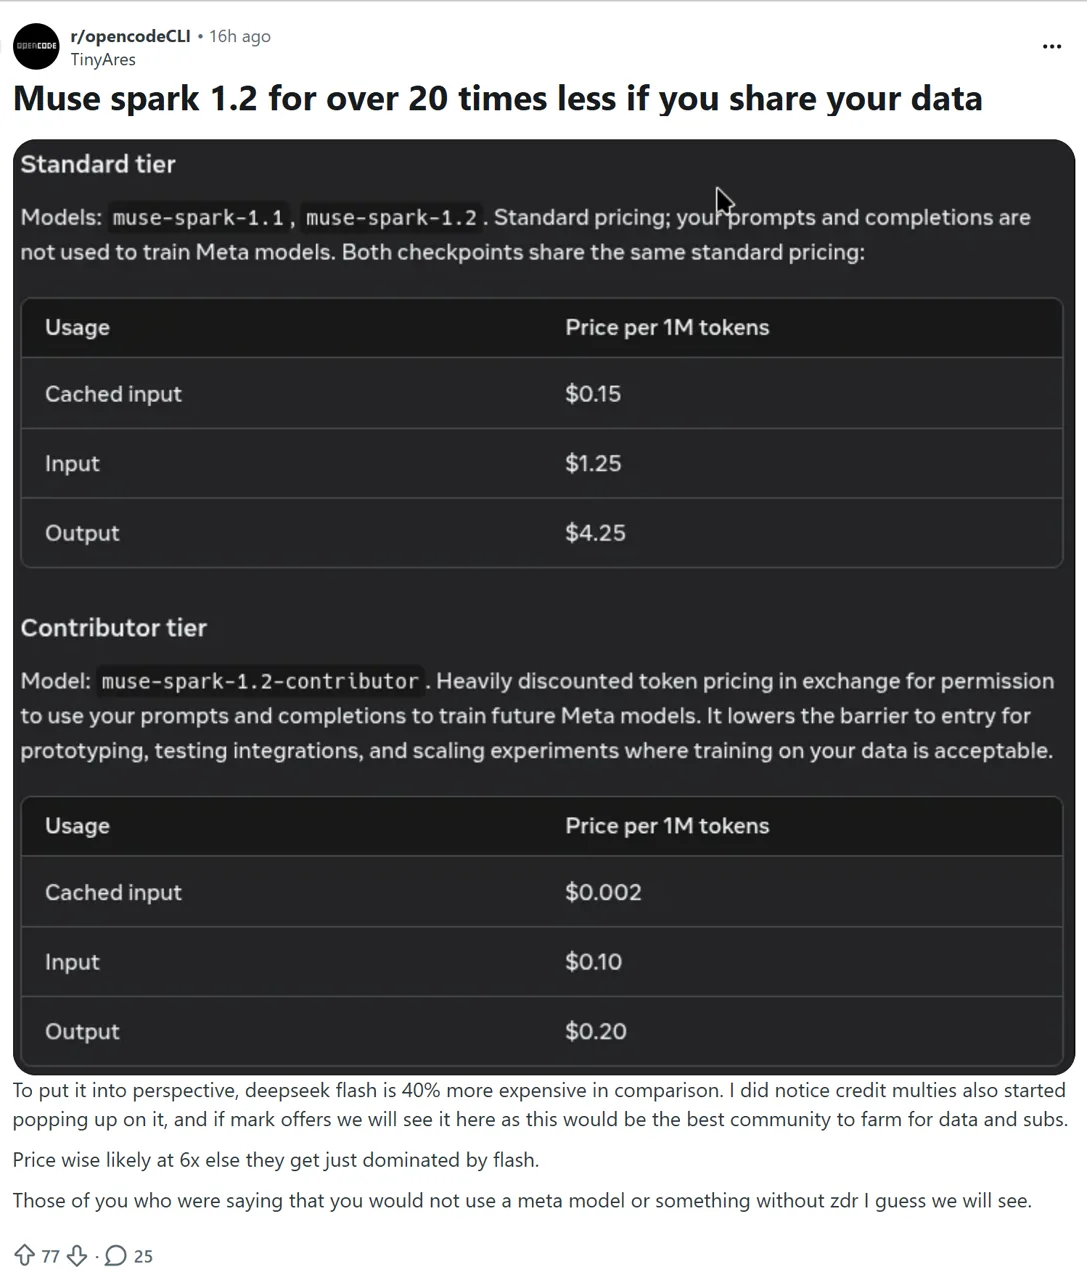
Les tarifs « Contributor » sont 12,5 fois moins chers pour les entrées, 75 fois moins chers pour les entrées mises en cache et 21,25 fois moins chers pour les sorties que ceux du niveau standard. Il n’existe pas de pourcentage de réduction unique qui s’applique à tous les types de jetons.
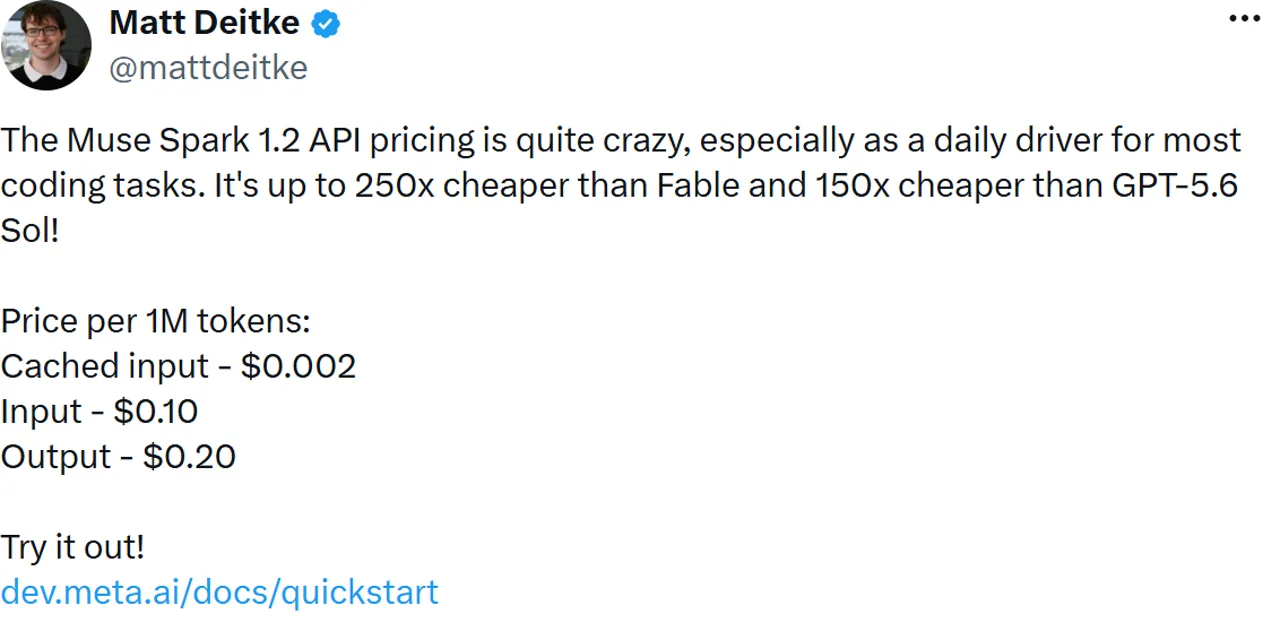
Un chercheur de Meta a présenté le niveau “ Contributor ” comme étant “ jusqu’à 250 fois moins cher ” que Fable et « 150 fois moins cher » que GPT-5.6 Sol. Cela comparaison sociale utilise les tarifs « Contributor », et non le modèle standard, et doit toujours être assorti de la mention relative à l'utilisation des données. Les lecteurs qui souhaitent comparer les coûts actuels des concurrents peuvent consulter notre Guide des tarifs GPT-5.6 et Répartition des prix selon le code Claude.
Pour les dépôts publics, les tâches synthétiques ou les environnements d'évaluation jetables, le niveau « Contributor » peut s'avérer intéressant. En revanche, pour le code privé, les données clients, les identifiants ou les architectures propriétaires, le niveau « Standard » constitue le choix par défaut le plus sûr. Meta indique également qu’elle commence à accepter les demandes de non-conservation des données via son service commercial, ce qui constitue une voie d’accès distincte du paramètre par défaut en libre-service.
Accès à l'API Muse Spark 1.2 et exemple
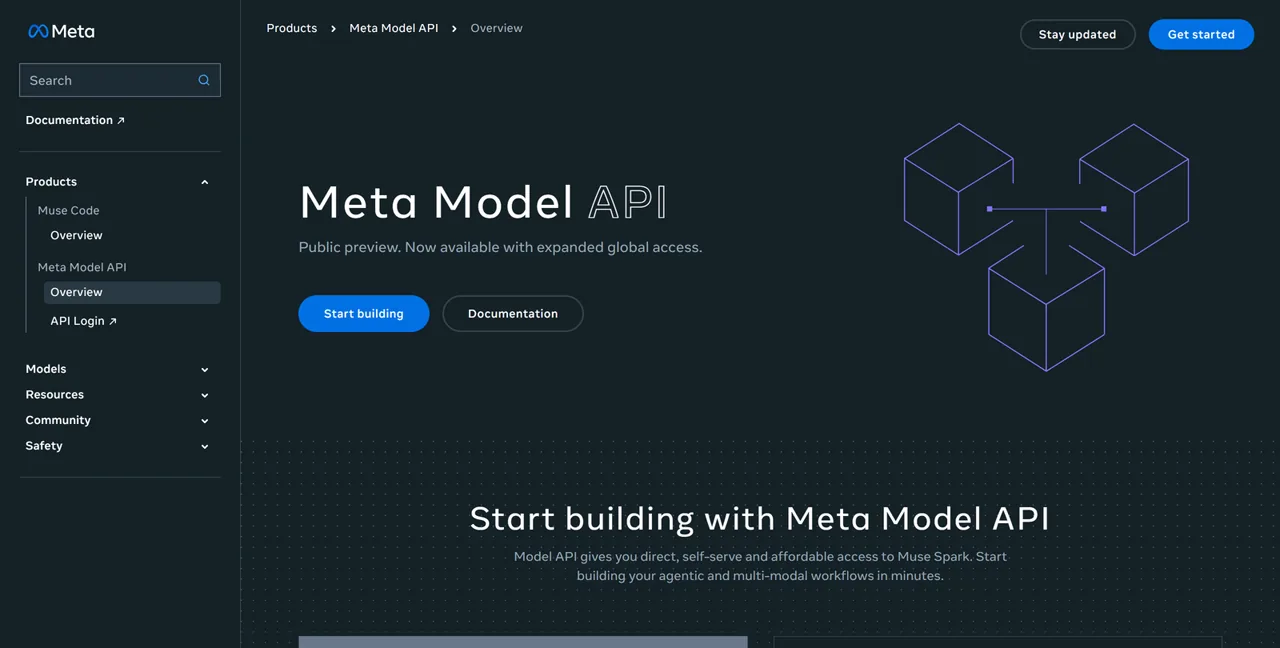
Trois voies d'accès officielles
URL de base du livre de recettes officiel : https://api.meta.ai/v1 · 1.2 demande formulée dans le cadre de cet examen : non exécutée
Le API du méta-modèle prend en charge un flux de travail compatible avec le SDK OpenAI. Le guide officiel de Meta utilise l'URL de base https://api.meta.ai/v1 et lit la clé à partir de MODEL_API_KEY. La page du produit décrit également l'ancrage de la recherche, tandis que le guide pratique aborde les complétions dans le chat, le streaming, l'appel d'outils, la sortie structurée, la mise en cache des invites, les contrôles de raisonnement, la vision, le contexte étendu, les nouvelles tentatives et les recettes de recherche.
Exemple de livre de recettes officiel — version enregistrée : Le Guide officiel de GitHub utilise toujours muse-spark-1.1. Cela permet de vérifier la structure du client et l'URL de base, et non pas que l'exemple ait été mis à jour pour la version 1.2.
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.1",
    messages=[{"role": "user", "content": "Hello, world!"}],
)

print(response.choices[0].message.content)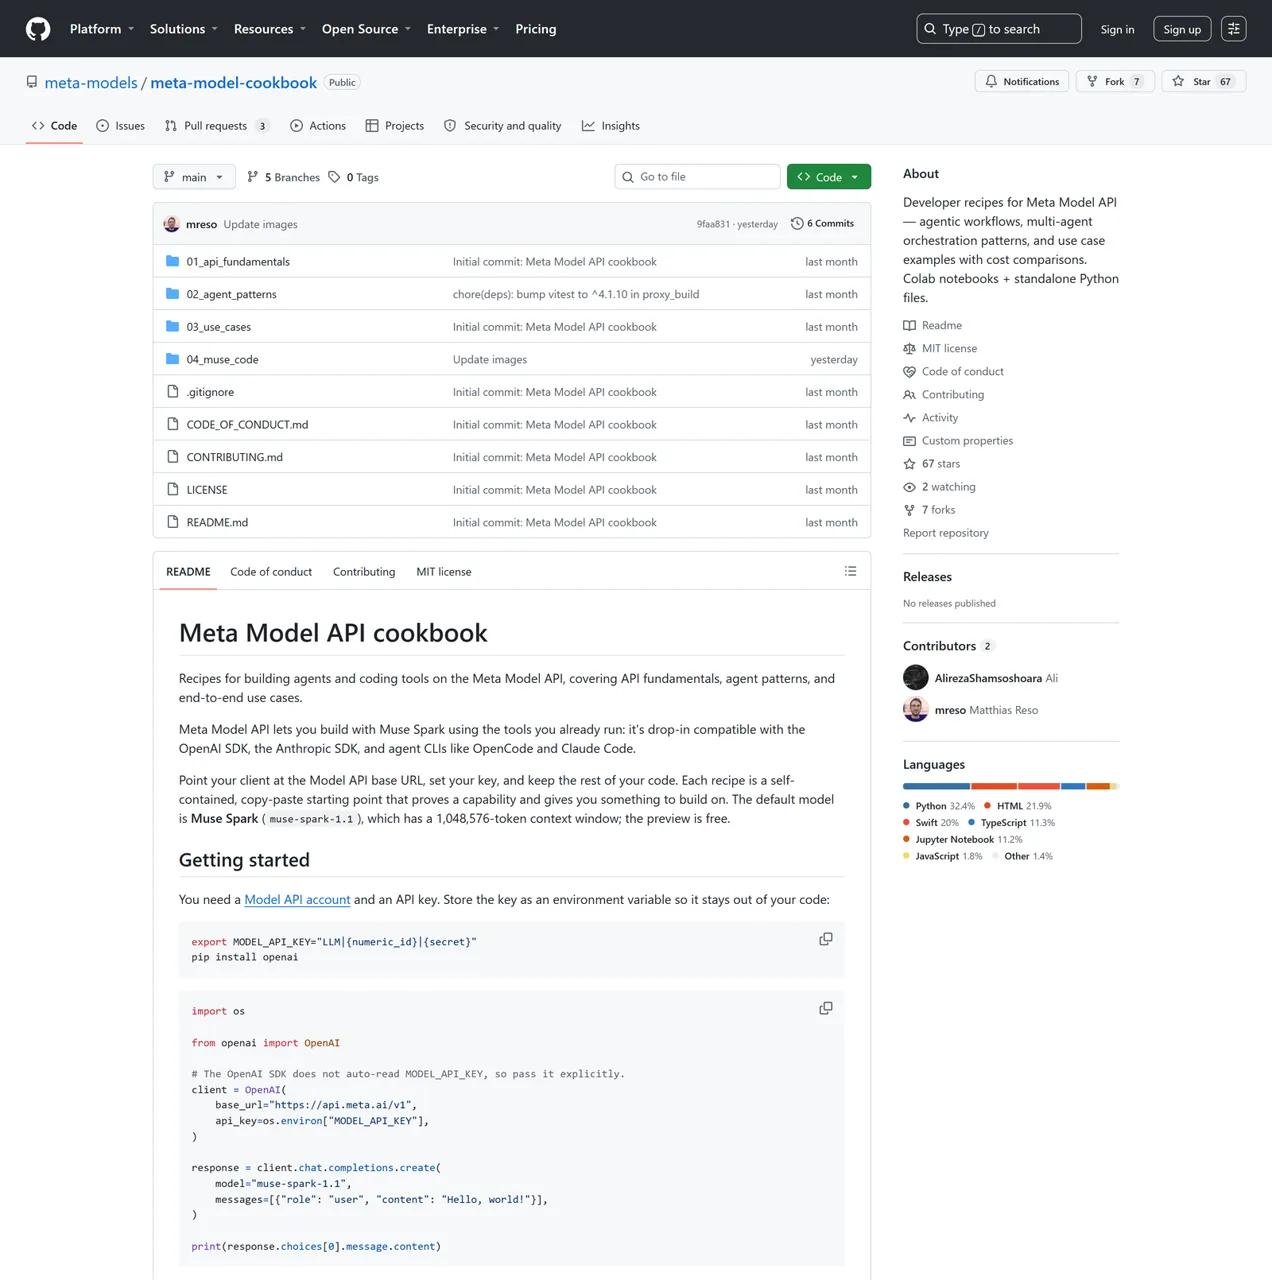
Adaptation documentée — non exécutée : Meta les répertorie séparément muse-spark-1.2 sous la référence standard 1.2. La substitution minimale ci-dessous combine deux informations officielles, mais aucune demande payante n'a été envoyée au cours de cet examen.
response = client.chat.completions.create(
    model="muse-spark-1.2",
    messages=[{"role": "user", "content": "Hello, world!"}],
)
Muse Spark est un modèle de raisonnement, et les jetons de raisonnement sont facturés en tant que production. Cela confère au taux de sortie standard $4.25 une importance plus grande qu'il n'y paraît à première vue : une réponse apparemment brève peut tout de même receler un raisonnement sous-jacent significatif. La latence réelle, le temps nécessaire pour obtenir le premier token, le taux de réessai et le coût par tâche ne sont pas mesurés ici.
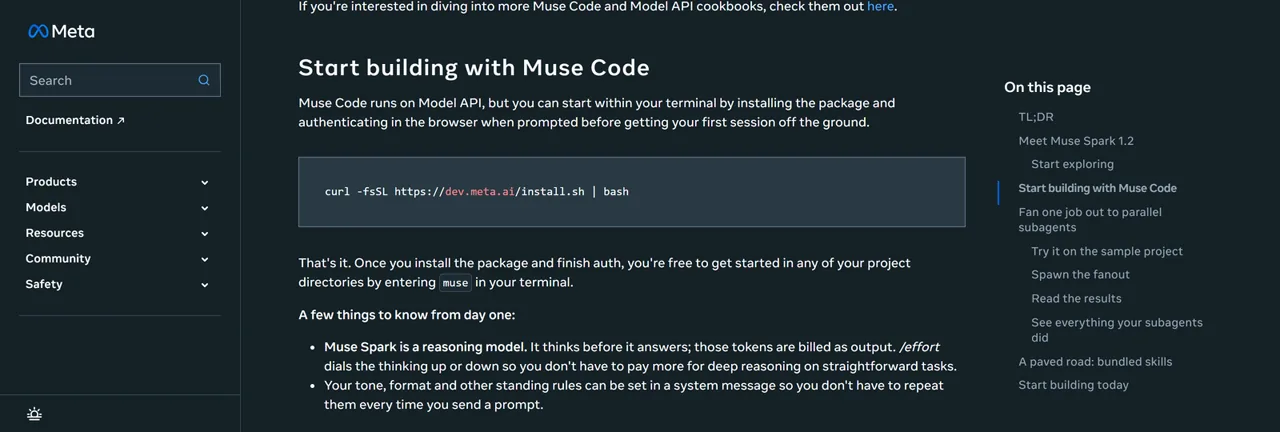
/effort Cette commande modifie la profondeur de raisonnement. Source : Guide du développeur Meta.Ce qu'apporte Muse Code
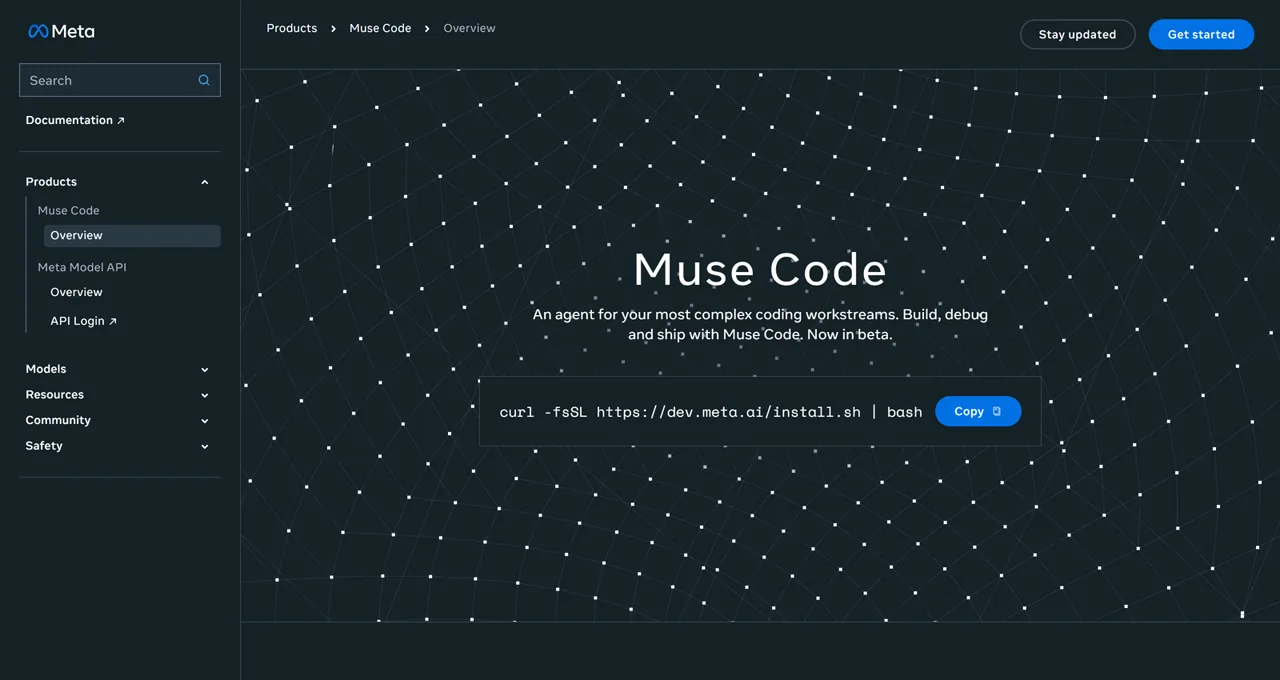
Muse Code s'installe depuis le terminal et intègre Muse Spark 1.2 dans un workflow d'agent. Meta’s Analyse approfondie pour les développeurs décrit plusieurs comportements qui ne relèvent pas d'un simple appel d'API :
- Agents parallèles : Les tâches peuvent s'exécuter dans des arborescences Git isolées.
- Journal d'événements en ajout seul : Les sessions et les actions sont enregistrées dans un fichier JSONL local à des fins d'audit et de relecture.
- Reprise du flux :
CV de Musepeut reprendre les sessions interrompues. - Contrôle du raisonnement : le
/effortCette commande permet de régler l'intensité du raisonnement. - Compétences explicites : Noms de Meta
/goût,/cuisson au barbecue,/grill-avec-documentation, et/plan.
Caractéristiques du produit « Agent »
Sous-agents
Les tâches indépendantes peuvent se multiplier.
Arbres de travail
Les branches restent distinctes lors d'un travail en parallèle.
Journal JSONL
Les événements locaux de type « ajout uniquement » prennent en charge la relecture.
CV
CV de Muse poursuit les séances interrompues.
Compétences
/goût, /cuisson au barbecue, /grill-avec-documentation, /plan.
Cet ensemble de fonctionnalités fait de Muse Code un acteur incontournable sur le marché plus large des agents de programmation, où la planification, l'isolation, la relecture et la rigueur dans l'utilisation des outils sont tout aussi importantes que l'intelligence des modèles. Le Guide comparatif : OpenClaw vs Claude Code vs OpenCode Cela fournit un contexte utile pour comprendre ces différences au niveau des produits.
Allégations relatives au lancement et premières réactions de la communauté
Une réaction n'est pas une validation
Formation + horizon à long terme
Davantage de puissance de calcul pour le codage, une plus grande diversité d'environnements, un co-entraînement et un test de résistance impliquant plus de 1 000 appels d'outils.
Prix et OpenCode
Un utilisateur de Reddit a salué l'intérêt et la valeur d'une première expérience en programmation.
Confidentialité + fiabilité
D'autres utilisateurs ont fait part de leurs inquiétudes concernant la consommation de données, le prix standard, la disponibilité et la fiabilité initiale.
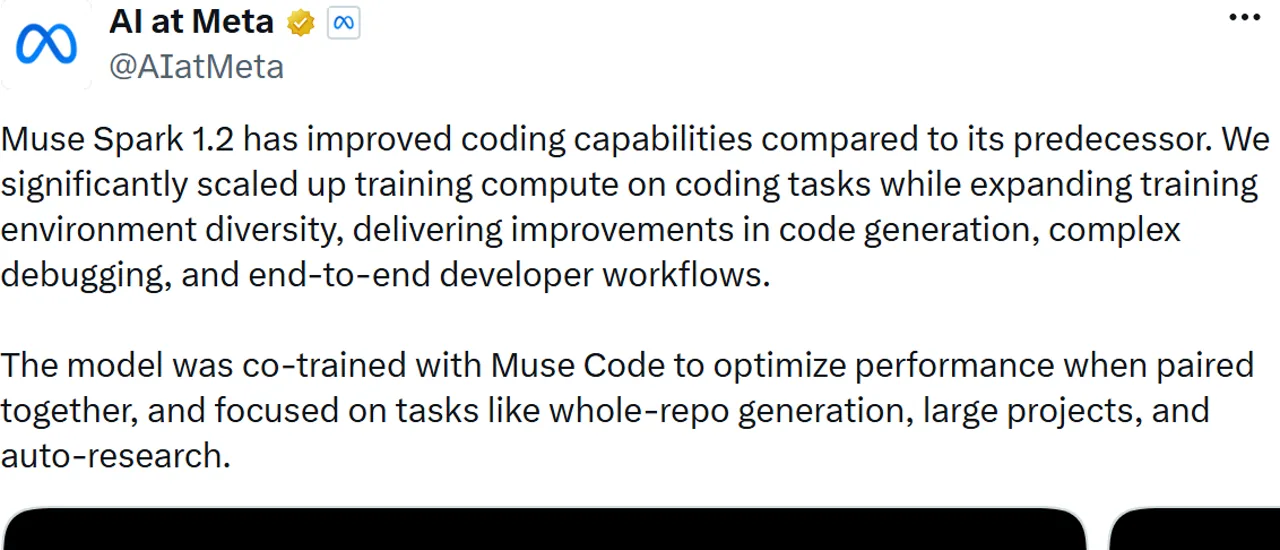
Selon le service d'IA de Meta, Muse Spark 1.2 a bénéficié d'une puissance de calcul accrue pour l'entraînement au codage, d'environnements plus variés, d'une attention accrue portée à la génération et au débogage de dépôts complets, ainsi que d'un entraînement conjoint avec Muse Code. Un autre fil de discussion de lancement décrit un test de résistance d'une durée pouvant aller jusqu'à 24 heures, avec plus de 1 000 appels de fonctions sur des GPU NVIDIA Hopper.
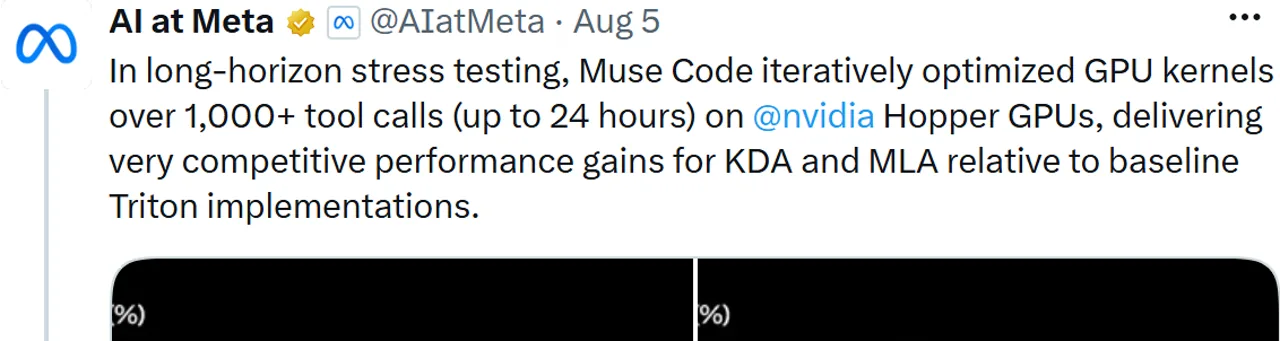
C'est une démonstration impressionnante, mais il ne s'agit pas d'un taux de réussite global mesuré. Elle ne nous indique pas à quelle fréquence l'agent a choisi le bon outil, a su se remettre d'une erreur, a évité les appels redondants ou a mené à bien une tâche courante liée au référentiel sans intervention humaine.
Les premiers messages publiés sur Reddit sont tout aussi mitigés. L'un d'entre eux Un utilisateur de r/opencode a fait part d'une expérience positive avec OpenCode et a salué son prix. Un autre Discussion sur la tarification des contributeurs ont soulevé des questions concernant l'utilisation des données, le coût de l'offre standard, la disponibilité et la fiabilité. Il s'agit là de réactions individuelles, et non d'un consensus au sein de la communauté.
Tests de programmation Muse Spark 1.2 : 3 tâches sur 3 réussies
Lors de nos tests, le modèle de base Muse Spark 1.2 a réalisé trois tâches de codage contrôlées via une API de complétion de chat compatible avec OpenAI. Chaque tâche a fait l'objet d'une seule tentative, sans aucune nouvelle tentative ni intervention humaine. Nous avons évalué les fichiers renvoyés dans des dépôts jetables à l'aide de tests publics et cachés. L'exécution de l'agent Muse Code n'a pas été testée, pas plus que la fiabilité des appels d'outils ; ces résultats ne doivent donc pas être considérés comme un benchmark de l'agent.
Résultat d'un seul essai
Les réponses comportaient 6 618 éléments de raisonnement. Les trois raisons invoquées pour justifier le classement étaient les suivantes : arrêt, et le champ « fournisseur » indiquait « Meta ».
Test 1 : correction d'un bug d'idempotence en Python — Réussi
Empêcher les transferts en double sans modifier l'API publique
Le modèle a identifié l'absence de la protection « request-ID », a ajouté la correction la plus simple et la plus sûre, et a fourni un test de régression tout en préservant les mises à jour atomiques des soldes.
L'évaluateur caché d'origine exigeait à tort un appel en double pour renvoyer une valeur. Faux, alors que la tâche exigeait simplement de ne pas facturer deux fois l'expéditeur. Après avoir corrigé cette exigence inventée concernant la valeur de retour, la première réponse, qui n'avait pas été modifiée, a réussi les six tests. Nous n'avons ni réessayé ni modifié la sortie du modèle.
Test 2 : refactorisation d'un projet TypeScript à plusieurs fichiers — Réussi
Séparation de la validation, de la persistance et de la journalisation d'audit
Les fichiers renvoyés conservaient le contrat d'itinéraire public, le TypeScript strict et la transaction unique couvrant à la fois les écritures de commande et d'audit. Ils intégraient également des tests de validation ciblés, sans dépendance d'exécution.
Le premier évaluateur a comparé des objets avec des données brutes JSON.stringify, de sorte que des objets équivalents dont l'ordre d'insertion des clés différait apparaissaient comme inégaux ; sa version Windows npx Le lancement a également échoué avant la vérification des types. Grâce à un comparateur insensible à l'ordre des éléments et à un appel de commande compatible avec Windows, la réponse d'origine a passé tous les contrôles avec succès. Là encore, aucune nouvelle tentative n'a été effectuée.
Test n° 3 : fonctionnalité de référentiel JSONL — Réussi
Respect des consignes à l'échelle du référentiel
Ajouter JSONL sans altérer le format CSV
Le modèle intégrait la détection des extensions, la gestion des erreurs de ligne mal formée à partir de 1, la sortie atomique, la sécurité en mode simulation, des tests ciblés, un texte d'aide et un exemple dans le fichier README.
Ce que révèlent les tests : Muse Spark 1.2 est capable de générer des correctifs multi-fichiers exploitables, de respecter les contraintes de compatibilité, d'ajouter des tests et de traiter une fonctionnalité de portée modeste à l'échelle du référentiel en une seule opération. Le coût moyen rapporté était d'environ $0,0151 par tâche, mais ces tests étaient de petite envergure et ne doivent pas servir à estimer le coût d'une base de code de grande envergure.
À qui s'adresse Muse Spark 1.2 ?
Guide d'aide à la décision
Évaluation contrôlée
Code public ou synthétique, tâches mesurables, besoins dans un contexte étendu et un résultat prometteur pour le modèle de base 3/3.
Justificatif d'agent requis
Le comportement de Muse Code, les limites de débit stables, les appels répétés à des outils ou les tests de performance à grande échelle sur les référentiels constituent des critères de décision.
Code sensible ou rendement élevé
Utilisez le niveau standard ou comparez les alternatives lorsque la confidentialité et le coût des jetons de raisonnement sont des facteurs déterminants.
Utilisez le modèle standard pour le code sensible, sauf si votre organisation a approuvé séparément les conditions d'utilisation pour les contributeurs. Si le prix de vente standard modifie le calcul de la valeur, comparez-le avec le prix actuel Tarification Codex, le code Claude et les autres coûts liés aux agents de codage avant de s'engager dans un processus de travail.
Verdict de l'essai du Muse Spark 1.2
Muse Spark 1.2 figure parmi les finalistes de l'évaluation, mais ne fait pas l'objet d'une recommandation automatique pour la mise en production. Le contexte du jeton 1M, la structure familière de l'API, les tarifs avantageux pour les contributeurs, les trois tentatives de codage dès la première approche et les excellents scores obtenus par le code Muse lors des tests de Meta : autant d'éléments qui rendent ce projet difficile à ignorer. Meta s'est également montré plus transparent que de nombreux autres lancements en publiant les détails de sa méthodologie.
Les bémols sont tout aussi concrets. La tarification des contributeurs s'accompagne d'un compromis en matière d'utilisation des données. Les tokens de sortie et de raisonnement standard peuvent faire grimper le coût réel. Les meilleurs résultats de Meta en matière de codage n’ont pas été reproduits sous forme d’entrées correspondantes sur les tableaux publics Terminal-Bench ou DeepSWE, et notre échantillon pratique couvre trois tâches de modèles de base plutôt que l’exécution d’agents Muse Code.
La démarche la plus judicieuse consiste à mener un test contrôlé sur du code non sensible, en enregistrant les données brutes d'utilisation et en effectuant une vérification locale. Considérez les coûts et la latence mesurés comme un échantillon issu de tâches mineures, puis testez la taille de votre propre référentiel, la reprise après défaillance et le flux de travail des agents avant de l'adopter en production.
FAQ Muse Spark 1.2
Qu'est-ce que Muse Spark 1.2 ?
Muse Spark 1.2 est le modèle de Meta dédié au codage, lancé le 5 août 2026, doté d'une fenêtre de contexte de 1 million de tokens et accessible via Muse Code, l'API Meta Model et OpenRouter.
Muse Spark 1.2 est-il identique à Muse Code ?
Non. Muse Spark 1.2 est le modèle ; Muse Code est un agent terminal bêta distinct qui s'appuie sur celui-ci. Muse Code ajoute des fonctionnalités telles que les sous-agents, les arborescences Git isolées, la journalisation des événements, la reprise et les compétences intégrées.
Combien coûte l'API Muse Spark 1.2 ?
Le modèle standard coûte $1,25 en entrée, $0,15 en entrée mise en cache et $4,25 en sortie par million de tokens. Le modèle Contributor coûte $0,10 en entrée, $0,002 en entrée mise en cache et $0,20 en sortie.
Meta utilise-t-elle les données de l'API Muse Spark pour l'entraînement ?
Meta précise que les données de niveau « standard » ne sont pas utilisées pour améliorer ses produits. Les données de niveau « contributeur » peuvent être utilisées à cette fin ; par conséquent, le code privé ou propriétaire doit emprunter la voie « standard », sauf autorisation contraire d'une organisation.
Muse Spark 1.2 figure-t-il dans les classements publics de Terminal-Bench ou de DeepSWE ?
Lors d'une vérification effectuée le 7 août 2026, ce résultat ne figurait sur aucun des deux tableaux publics. Meta indique 82,91 TP40T sur Terminal-Bench 2.1 avec Muse Code et 59,31 TP40T sur DeepSWE, mais il s'agit là de résultats obtenus par Meta.
Muse Spark 1.2 a-t-il fait l'objet de tests pratiques dans le cadre de cette critique ?
Oui. Lors de trois tests effectués en une seule tentative sur le modèle de base, Muse Spark 1.2 a réussi la correction d’un bug Python, la refactorisation d’un code TypeScript et la mise en place d’une fonctionnalité de référentiel JSONL. La latence moyenne était de 12,98 secondes et le coût total rapporté s’élevait à $0,045362. La fiabilité de l'agent Muse Code et des appels d'outils n'a pas été testée.
Comment les développeurs peuvent-ils accéder à Muse Spark 1.2 ?
Meta répertorie trois méthodes : l'agent terminal Muse Code (version bêta), l'API Meta Model et OpenRouter. Le guide officiel utilise un client compatible avec le SDK OpenAI dont l'URL de base est https://api.meta.ai/v1.