
Tarification de l'API Grok 4 : coûts, limites et comment commencer

Vous développez une application ou établissez le budget d'un agent ? Commencez par le modèle que vous allez réellement mettre en œuvre. Le Avis de migration du 15 mai 2026 indique que l'identifiant d'origine « Grok 4 » correspond désormais à « Grok 4.3 » sans nécessiter un effort de raisonnement important. Le fait qu'un appel vers un ancien identifiant aboutisse ne prouve plus que le modèle d'origine l'ait géré.

L'utilisation de l'API est facturée séparément des abonnements grand public de Grok. Tarifs d'abonnement et d'accès à Grok couvre les forfaits de chat ; ces frais mensuels ne correspondent pas à des crédits symboliques pour une intégration directe de xAI.

Vous souhaitez tester une commande avant de l'intégrer à une application ? Essayez Grok 4.6 sur GlobalGPT pour un workflow basé sur le chat. Utilisez une clé API xAI pour votre propre intégration et la facturation directe auprès de xAI. Cet article est publié par GlobalGPT ; les liens vers les produits intègrent un système de suivi des parrainages.
Tarification Grok 4 API : tarifs actuels et ancienne version retirée

Le tableau ci-dessous utilise Prix catalogue xAI vérifiés le 8 septembre 2026. Chaque montant est exprimé en dollars américains par million de jetons. Les entrées, les entrées mises en cache et les sorties constituent des catégories facturables distinctes ; par conséquent, un “ prix par million ” global unique masque le coût réel de la charge de travail.

USD par million de jetons · traitement standard

grok-4.3

Cible de redirection d'origine Grok 4

Contexte : 1 000 000 jetons

Consigne < 200 000

Entrée
$1.25
Entrée mise en cache
$0.20
Résultat / raisonnement
$2.50

Invite >= 200K

Entrée
$2.50
Entrée mise en cache
$0.40
Résultat / raisonnement
$5.00

grok-4.6

Le navire amiral actuel

Contexte : 500 000 jetons

Consigne < 200 000

Entrée
$2.00
Entrée mise en cache
$0.50
Résultat / raisonnement
$6.00

Invite >= 200K

Entrée
$4.00
Entrée mise en cache
$1.00
Résultat / raisonnement
$12.00

grok-4.5

Option antérieure de la génération actuelle

Contexte : 500 000 jetons

Consigne < 200 000

Entrée
$2.00
Entrée mise en cache
$0.30
Résultat / raisonnement
$6.00

Invite >= 200K

Entrée
$4.00
Entrée mise en cache
$0.60
Résultat / raisonnement
$12.00

Dès que la requête atteint 200 000 tokens, les tarifs « long-context » s'appliquent à tous les tokens de cette requête, y compris la sortie.

Les autres identifiants de la famille 4 Grok répertoriés sont les suivants : grok-4.20-0309-raisonnement, grok-4.20-0309-sans-raisonnement et grok-4.20-multi-agent-0309. Chacune dispose d'une fenêtre de contexte de 1 million de tokens et présente les mêmes taux de tokens courts/longs que ceux indiqués pour Grok 4.3. Le prix unitaire correspondant n'implique pas nécessairement une consommation totale de tokens équivalente, en particulier dans le cadre d'un travail impliquant plusieurs agents.

Pour une alternative spécifique au codage, grok-build-0.1 dispose d'une fenêtre de contexte de 256 Ko et de débits d'entrée/de cache/de sortie à contexte court de $1,00/$0,20/$2,00, qui passent à $2,00/$0,40/$4,00 au seuil de 200K de la ligne de commande. Pour en savoir plus sur le comportement général et les cas d'utilisation, consultez notre Avis sur le Grok 4.6.
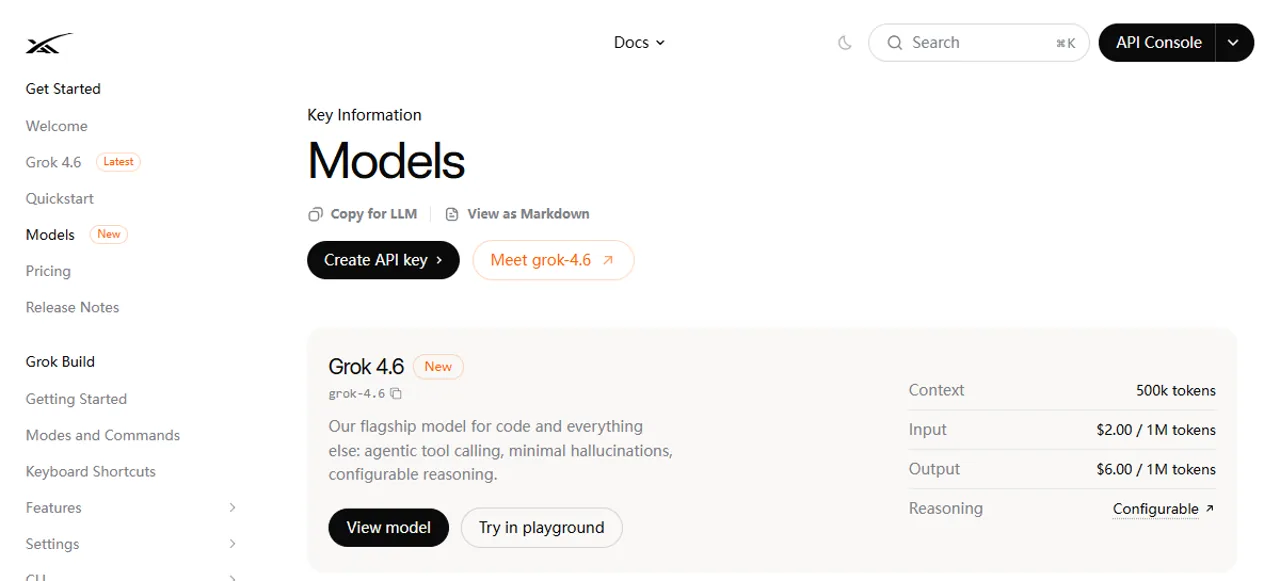
Documentation officielle de xAI présentant le modèle Grok 4.6, son identifiant, une capacité de contexte de 500 000 et un raisonnement configurable.
Catalogue officiel des modèles xAI, enregistré le 7 septembre et revérifié le 8 septembre 2026. Le tarif $2/$6 correspond au tarif Grok 4,6 pour les opérations d'entrée/sortie à contexte court ; les tarifs pour le cache et les opérations à contexte long sont indiqués ci-dessus.

Qu'est-il advenu du prix initial des modèles $3 / $15 ?

Les références plus anciennes, notamment notre Guide d'intégration API Grok 4, tarif $3 par million de jetons d'entrée et $15 par million de jetons de sortie pour le modèle d'origine Grok 4. Considérez cela comme un tarif historique, et non comme la facture actuelle d'un identifiant qui n'est plus en service. L’ancienne URL officielle du modèle renvoie désormais au catalogue général des modèles ; il ne s’agit donc pas d’une nouvelle fiche tarifaire d’archives vérifiée.

Le Annonce originale Grok 4 décrit une fenêtre de contexte de 256 000 tokens. Cette capacité historique, ainsi que les anciens prix ou seuils du modèle Fast, ne doivent pas être repris dans le budget prévu pour le remplacement. La règle précise pour grok-4-0709 est désormais de Grok 4.3 avec un faible niveau d'effort de raisonnement, facturé aux tarifs Grok 4.3.
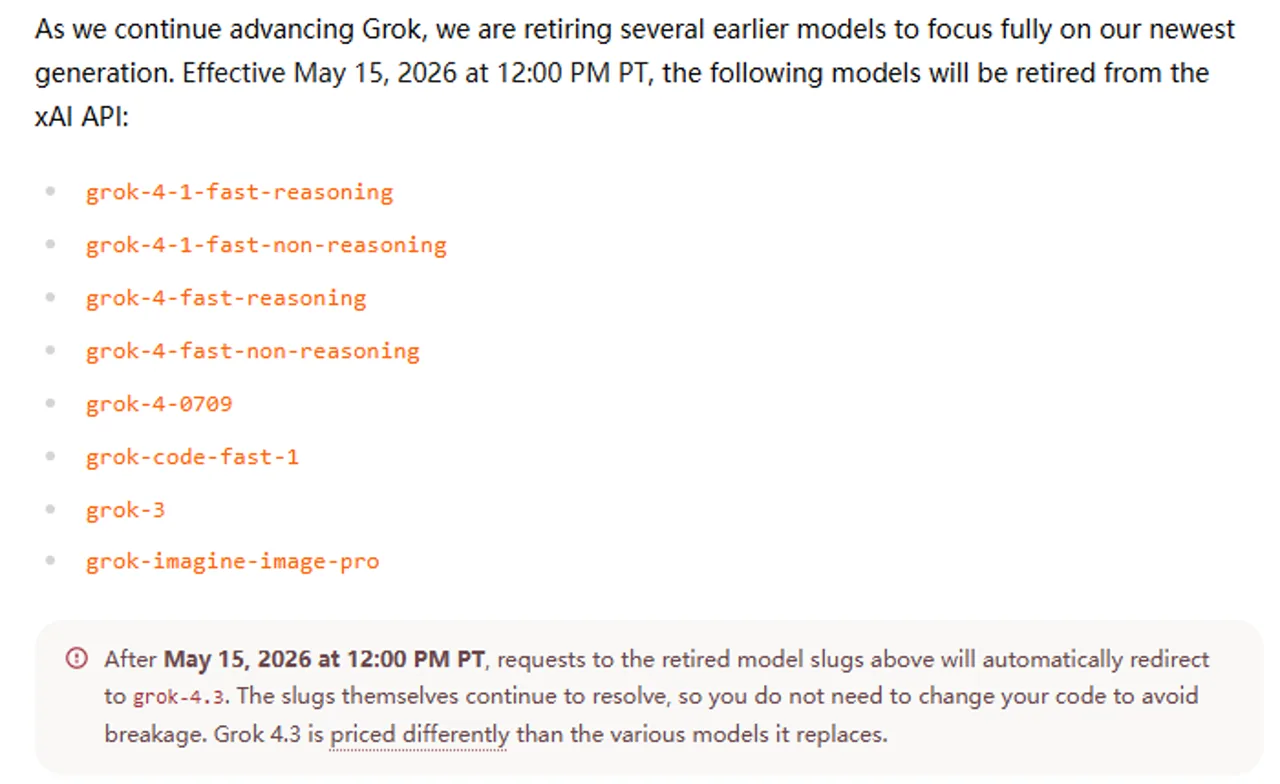
Avis officiel de fin de prise en charge mentionnant grok-4-0709 et sa redirection vers grok-4.3
Avis de cessation d'activité de xAI, enregistré le 7 septembre 2026 ; texte revérifié le 8 septembre. La référence d'origine Grok 4 ID renvoie à la version Grok 4.3. L'avis complet précise séparément les exceptions concernant les modèles de codage et d'image.

« Grok 4 » désigne une génération de modèles, tandis que « Grok » est également le nom d'un produit grand public. Notre Explication de ce qu'est « Grok 4 » fournit ces informations générales sur le produit. Pour les nouveaux codes, sélectionnez explicitement un modèle pris en charge au lieu de vous fier à une redirection en cas de retrait ou de supposer que l’alias d’un fournisseur reste inchangé.

Comment les données d'entrée, les données d'entrée mises en cache et le raisonnement influencent la facture

Une demande, trois frais symboliques

Données non mises en cache

(I – C) × débit d'entrée

I = tous les jetons de prompt ; C = jetons de prompt mis en cache.

Entrée mise en cache

C × taux de mise en cache

Les jetons mis en cache font partie des données d'entrée ; il ne s'agit pas de données d'entrée supplémentaires.

Chiffre d'affaires facturable

O × débit de sortie

O inclut le raisonnement lorsque le point final le signale dans la sortie.

Estimation de la valeur du jeton en USD = [(I – C) × taux d’entrée + C × taux d’entrée mis en cache + O × taux de sortie] / 1 000 000. Ajoutez ensuite les frais éventuels liés aux outils, au stockage ou autres. Sélectionnez les tarifs en contexte long à l'aide de l'invite « total », en incluant les jetons mis en cache, avant d'effectuer le calcul.

Les données d'entrée comprennent les messages, les instructions et l'historique des conversations envoyés au modèle. La mise en cache réutilise un préfixe de départ identique pour toutes les requêtes ; ce processus est automatique, et xAI recommande d'utiliser un identifiant de conversation afin d'optimiser la réutilisation. Une invite d'apparence similaire ne garantit pas nécessairement un accès au cache. Le Documentation sur la mise en cache des invites explique le fonctionnement de la mise en correspondance.

Dans « Compléments de conversation », lisez prompt_tokens_details.cached_tokens; dans la rubrique « Réponses », lire input_tokens_details.cached_tokens. Le Guide d'utilisation et de tarification du cache calcule les jetons de raisonnement au taux de réalisation total. Si le total de la production inclut déjà le raisonnement, l'ajout de jetons_de_raisonnement cela reviendrait à le compter deux fois.

La version Grok 4.6 prend en charge les niveaux d’effort de raisonnement « faible », « moyen », « élevé » et « très élevé » ; sa valeur par défaut documentée est « élevé », et le raisonnement ne peut pas être désactivé. La version Grok 4.3 prend en charge les niveaux « aucun », « faible », « moyen » et « élevé ». Cela rend la version Grok 4.3 avec le niveau « none » intéressante à évaluer pour les tâches d’extraction strictes, tandis que la version Grok 4.6 peut consommer davantage de tokens même lorsque sa réponse visible est courte. Voir le paramètres de raisonnement et la fiche technique du modèle Grok 4.3 ci-dessus.

Appels d'outils, traitement par lots et demandes prioritaires

Conformément à la barème officiel des prix des outils, les fonctions « Web Search », « X Search » et « Code Execution » coûtent chacune $5 pour 1 000 appels, soit $0,005 par appel, auxquels s'ajoute la consommation de jetons. Une requête peut invoquer ces outils plusieurs fois. Dix appels de recherche ajoutent $0,05 avant les jetons du modèle ; l’activation d’un outil ne permet pas de savoir combien de fois il sera utilisé.

La recherche de pièces jointes coûte $10 pour 1 000 appels ; la recherche dans les collections coûte $2,50 pour 1 000. Les fichiers et collections stockés sont également soumis à des frais quotidiens de stockage et de téléchargement. Les images et les vidéos ont leurs propres unités de prix ; veillez donc à ne pas les inclure dans une estimation basée uniquement sur le texte. Notre Tutoriel sur le flux de travail image et vidéo du Grok couvre ce parcours de production distinct.

Le API par lots offre une réduction de 20% sur le modèle Grok 4.3 et les trois variantes Grok 4.20 répertoriées. Cette réduction s’applique aux jetons d’entrée, d’entrée mise en cache, de sortie et de raisonnement. La page du modèle Grok 4.6 indique que l’API Batch n’est pas prise en charge. N’appliquez pas systématiquement une réduction de 50% et ne partez pas du principe que tous les modèles répertoriés prennent en charge le traitement par lots.

Traitement prioritaire coûte deux fois le tarif standard des jetons, y compris les jetons de mise en cache et de raisonnement, lorsque la valeur renvoyée niveau_de_service confirme priorité. En cas de retour au niveau par défaut, les tarifs standard s'appliquent. La priorité s'applique aux « Chat Completions » et aux « Responses », mais pas à l'API par lots.

Trois exemples concrets de coûts liés aux API

Il s'agit d'estimations de prix catalogue, et non de factures réelles. Toutes les demandes ci-dessous sont traitées selon un processus standard : texte uniquement, sans outils, sans stockage, sans nouvelles tentatives et hors taxes. Le terme “ résultat ” inclut tout raisonnement facturable. Les deux premières charges de travail supposent des invites de moins de 200 000 tokens.

Coût par requête et par 10 000 requêtes

Grok 4,3 · pas de cache

$0.005 / demande

2 000 entrées × $1,25 + 1 000 sorties × $2,50, divisé par 1 million. 10 000 requêtes = $50.

Grok 4,6 · pas de cache

$0.010 / demande

2 000 entrées × $2 + 1 000 sorties × $6, divisé par 1 million. 10 000 requêtes = $100.

Grok 4,6 · 90% entrée mise en cache

$0.0073 / demande

200 non mises en cache × $2 + 1 800 mises en cache × $0,50 + 1 000 en sortie × $6, divisé par 1 M. 10 000 requêtes = $73.

Un taux élevé de réussite de mise en cache est particulièrement utile lorsque les opérations d'entrée prédominent dans la charge de travail. Dans cet exemple Grok 4.6, la mise en cache permet d’économiser $0,0027 par appel, soit 27% du total, même si 90% de jetons d’entrée sont mis en cache. La charge de sortie reste à $0,006. Évaluez les économies par rapport à la requête dans son ensemble, et non pas uniquement par rapport à la partie mise en cache.

Le seuil de 200 000 caractères peut modifier l'ensemble de la requête

Un jeton supplémentaire franchit le seuil de prix

199 999 jetons de prompt

$0.459998

Grok 4.6 : (199 999 × $2 + 10 000 sorties × $6) / 1M. Pas de cache.

200 000 jetons de réponse

$0.920000

Grok 4.6 : (200 000 × $4 + 10 000 sorties × $12) / 1M. Pas de cache.

Le principal Le tableau des tarifs mentionne explicitement “ Contexte long >= 200 000 tokens ”.” et précise que tous les jetons sont facturés au tarif le plus élevé dès que le nombre de caractères atteint le seuil. Une note explicative du modèle indique “ dépasser ” 200 000. Pour établir un budget à exactement 200 000, utilisez la limite explicite du barème tarifaire ; ne partez pas du principe que le tarif le plus avantageux s'applique toujours.

Pour établir une prévision mensuelle, estimez le volume de requêtes séparément pour chaque charge de travail, chaque tranche de contexte, chaque profil d’accès au cache et chaque paramètre de raisonnement. Ajoutez-y le nombre prévu de tentatives de réessai et d’appels d’outils. Comparez ensuite cette estimation avec vos propres données de coûts obtenues à l’issue d’un petit projet pilote. Un coût exprimé en centimes par appel n’est utile que si ses hypothèses correspondent à celles de l’environnement de production.

Le contexte, le résultat, les limites de débit et les limites de dépenses sont des notions distinctes

Quatre limites à vérifier avant de mettre à l'échelle

Fenêtre de contexte

Sur demande

Grok 4.3 : 1 million de jetons. Grok 4.6 : 500 000. Il ne s'agit pas d'une allocation mensuelle.

Budget des dépenses

Par réponse

Définissez une capacité de sortie prise en charge. La capacité contextuelle ne garantit pas une sortie aussi importante.

RPS / TPM

Débit

Nombre de requêtes par seconde et nombre de jetons par minute. Ces deux valeurs doivent rester dans les limites du niveau « Team ».

Contrôle des dépenses

Argent

Le solde prépayé, la recharge automatique et les limites de facturation déterminent chacun le mode de réapprovisionnement.

Le public tableau des limites de débit Le niveau 0 est indiqué à 37 requêtes par seconde et 10 millions de jetons par minute pour la version Grok 4.3 ; la version Grok 4.6 est indiquée à 150 requêtes par seconde et 50 millions de jetons par minute. Il s’agit d’informations de niveau publiées à une date donnée, et non d’une garantie que chaque clé dispose de la même capacité utilisable. La console de votre équipe fait foi en ce qui concerne l’accès et les limites de son modèle actuel.

Les niveaux sont déterminés en fonction des dépenses cumulées liées à l'API depuis le 1er janvier 2026 : $0, $50, $250, $1 000 et $5 000 pour les niveaux 0 à 4. Les requêtes sont limitées par seconde en divisant le budget de requêtes par minute par 60 ; vous ne pouvez donc pas utiliser l'intégralité de l'allocation d'une minute en une seule fois. Les jetons d'entrée, de sortie, de raisonnement et mis en cache sont tous pris en compte dans le TPM, même si certains coûtent moins cher.

Les fiches techniques validées des modèles Grok 4.3 et 4.6 indiquent les tailles de contexte sans préciser de valeur maximale absolue pour le débit. La version actuelle Référence du point de terminaison des réponses définit max_output_tokens sous la forme d’un budget combiné de sortie et de raisonnement : sa valeur par défaut est de 128 000 lorsqu’il n’est pas défini, et il accepte une valeur plus élevée pour des générations plus longues. Cette valeur par défaut ne garantit pas 128 000 tokens de réponse visibles ni une capacité de contexte illimitée. Définissez un budget explicite et examinez les réponses incomplètes.

Documentation relative à la facturation xAI distingue les crédits prépayés de la facturation mensuelle, qui est désactivée par défaut. La recharge automatique permet de réapprovisionner les crédits prépayés et dispose de ses propres seuils et de son propre plafond mensuel. Une limite de facturation contrôle l'utilisation en postpayé ; elle ne correspond pas à un plafond unique et global couvrant les achats, les recharges et les demandes en prépayé.

Pour votre première intégration, commencez par un crédit prépayé limité et examinez attentivement les paramètres de recharge automatique. Pour accéder au chat au quotidien sans avoir à créer d'intégration, utilisez la fonctionnalité distincte Guide d'utilisation du Grok couvre le cycle de vie du produit. L'abonnement au chat et l'équipe API disposent de contrôles différents.

Deux tâches réelles Grok 4.6 : ce que révèlent les données d'utilisation

Nous avons réutilisé deux tests déjà effectués le 7 septembre 2026 via l'API d'agrégation Broly à l'adresse https://anywhere.broly.ai/v1, en utilisant la fonction « Suggestions de saisie ». Les valeurs demandées et renvoyées grok-4.6; l'identité du modèle en amont n'a pas été vérifiée de manière indépendante. Il s'agit des résultats obtenus avec la passerelle Grok 4.6, et non des tests originaux du Grok 4 ni d'une comparaison entre différents modèles.

Chaque tâche a été exécutée une fois avec température = 0, max_tokens=2048 et stream=false. Aucun outil ni aucune consigne explicite concernant l'effort de raisonnement n'ont été fournis. La même instruction système a été utilisée pour les deux requêtes :


Instruction relative au système partagé

Extraction des dépenses

La tâche a converti cinq notes de frais fictives en un format JSON structuré, avec les centimes exprimés en nombres entiers, y compris un remboursement négatif. La réponse a conservé tous les champs demandés et a généré le montant net correct de $209,00.

Consigne exacte : Extraction des dépenses

Résultat complet : extraction des dépenses

{
  "devise" : "USD",
  "articles" : [
    {
 "libellé" : "train",
 "montant_en_cents" : 4680
    },
    {
 "label": "hôtel",
 "amount_cents": 12800
    },
    {
      "label": "dîner",
 "amount_cents": 2745
    },
    {
 "label": "remboursement",
 "amount_cents": -1250
    },
    {
 " label " : " taxi ",
 " amount_cents " : 1925
    }
  ],
  " net_total_cents " : 20900
}

Utilisation déclarée · Extraction des dépenses

Entrée / mis en cache

364 / 192

Les jetons mis en cache sont pris en compte dans le décompte des entrées.

Achèvement / raisonnement

991 / 857

Le raisonnement est présenté dans les détails de la réalisation.

Heure civile

22,753 secondes

Comprend les frais généraux liés au réseau et à la passerelle ; une exécution.

Planification sous contraintes

Le problème consistait à sélectionner des tâches indivisibles dans le cadre d'un budget de huit heures, avec certaines contraintes. La réponse retenue comprenait les tâches A, B, C et E, totalisant huit heures et une valeur de 24. Nous avons énuméré indépendamment les 64 sous-ensembles possibles : 17 étaient réalisables, et il s'agissait là du seul ensemble optimal.

Consigne exacte : Planification sous contraintes

Résultats complets : ordonnancement sous contraintes

{
  "selected" : ["A", "B", "C", "E"],
  "order" : ["A", "B", "C", "E"],
  "total_hours": 8,
  "total_value": 24
}

Utilisation déclarée · Planification soumise à des contraintes

Entrée / mis en cache

428 / 192

Les jetons mis en cache sont pris en compte dans le décompte des entrées.

Achèvement / raisonnement

4267 / 4217

Le raisonnement est présenté dans les détails de la réalisation.

Heure civile

61,980 secondes

Comprend les frais généraux liés au réseau et à la passerelle ; une exécution.

La réponse relative à la planification est plus courte que le JSON des dépenses, mais son total de tokens indiqué est de 4 267, dont 4 217 tokens de raisonnement. C'est là toute la leçon à tirer en matière de budgétisation : la longueur apparente d'une réponse est un indicateur peu fiable de la consommation du modèle de raisonnement. Ces deux tâches constituent des exemples utiles de profil d'utilisation, et non un test de performance en termes de latence ni un classement général de la qualité.

Extrait sur l'utilisation des passerelles : planification contrainte

{
  "prompt_tokens" : 428,
  "completion_tokens" : 4267,
  "total_tokens" : 4695,
  "prompt_tokens_details": {
    "cached_tokens": 192
  },
  "completion_tokens_details": {
    "reasoning_tokens": 4217
  }
}

La passerelle a également renvoyé une valeur nulle token_d'entrée et output_tokens champs, malgré des compteurs de « Chat Completions » non nuls. Pour ces enregistrements, nous avons utilisé prompt_tokens et jetons_de_complétion. Nous n'avons pas considéré les alias à valeur nulle comme des requêtes gratuites, ni déduit le nombre de jetons visibles à partir d'autres champs à valeur nulle.

Appliquer les tarifs officiels sans appeler cela une facture

Si ces compteurs de passerelles étaient facturés selon les prix catalogue actuels de la liste xAI ’ short-context » de Grok 4.6, la tâche d'extraction coûterait [(364 – 192) × $2 + 192 × $0,50 + 991 × $6] / 1M = $0,006386. Le calendrier serait le suivant : [(428 – 192) × $2 + 192 × $0,50 + 4 267 × $6] / 1M = $0,026170. Il s'agit d'estimations hypothétiques du taux d'xAI, et non de charges observées chez Broly.

La réponse de planification a indiqué 4 267 jetons d'achèvement, alors que la requête envoyée max_tokens=2048. La sémantique de la limite de la passerelle n’a pas été vérifiée. Cette divergence ne permet pas de déterminer comment fonctionne la limite de sortie propre à xAI, et la limite demandée ne peut être considérée comme un plafond de dépenses avéré pour cette passerelle.

Les réponses directes de xAI fournissent un indicateur de facturation plus utile : coût_en_ticks_USD. La documentation officielle définit un USD comme équivalant à 10 000 000 000 de ticks et précise que ce champ inclut les frais liés au jeton de la requête, les remises et les appels d'outils côté serveur. Les réponses réutilisées de la passerelle ne contiennent pas ce champ. Pour une conversation, additionnez les valeurs en ticks par requête plutôt que de supposer que chaque réponse contient le total de la session.

Ce qu'ont remarqué les utilisateurs indépendants de l'API

Le 21 août 2026, un utilisateur de Hacker News mediaman ont souligné que le taux d’entrées mises en cache de Grok 4.6, soit $0,50 par million, correspond à 25% de son taux d’entrées non mises en cache de $2. Leur préoccupation portait sur les lectures en cache répétées dans le cadre d’un travail agentique. Les deux taux correspondent au tableau officiel actuel ; les comparaisons plus larges et les spéculations de l’auteur du commentaire relèvent d’évaluations personnelles.

mediaman sur Hacker News évoque la tarification du cache API Grok
mediaman, à propos des prix de la mémoire cache Grok 4.6, le 21 août 2026. Évaluation personnelle des coûts ; les comparaisons et les hypothèses sont celles de l'auteur du commentaire. Archivé le 8 septembre 2026.

Auparavant, le 9 novembre 2025, XCSme décrit comme utilisant le modèle Grok 4 Fast via une API pour l’analyse et l’extraction de données, le qualifiant de « bon marché » et « rapide ». Il s’agit d’un rapport historique concernant un modèle Fast aujourd’hui retiré de la vente. Il ne fournit aucune indication sur le prix, la vitesse ou la qualité actuels des modèles Grok 4.3 ou Grok 4.6.

XCSme sur Hacker News parle de l'extraction de données via l'API Grok
XCSme à propos de l'utilisation du Grok 4 Fast pour l'extraction, le 9 novembre 2025. Expérience personnelle passée avec un modèle aujourd'hui discontinué. Enregistré le 8 septembre 2026.

Ces deux expériences individuelles soulèvent des questions préliminaires utiles : quelle part de votre facture provient du contexte mis en cache, et quelle part provient du raisonnement et des nouvelles tentatives ? Elles ne constituent pas pour autant un consensus parmi les développeurs. Si vous comparez également le travail qui en résulte, notre Comparaison entre Grok et ChatGPT : travail, recherche et codage traite de cette décision distincte.

Comment commencer à utiliser l'API officielle xAI

Le Guide de démarrage rapide officiel de xAI utilise l'API Responses à l'adresse https://api.x.ai/v1/responses. Il s'agit d'un point de terminaison et d'un compte différents de ceux utilisés dans le cadre de nos tests du 7 septembre.

  1. Créez un compte xAI Console ou connectez-vous à votre compte, puis sélectionnez l'équipe appropriée.
  2. Ajoutez des crédits API et vérifiez les paramètres de dépenses. Vérifiez que le modèle sélectionné est bien accessible à votre équipe.
  3. Créez une clé API et transmettez-la à votre processus serveur sous le nom XAI_API_KEY. Veillez à ne pas l'inclure dans le code du navigateur, le contrôle de version, les captures d'écran ni les journaux.
  4. Envoyez une petite requête en indiquant explicitement l'identifiant du modèle actuel, puis enregistrez le modèle renvoyé, son utilisation, le niveau de service et l'identifiant de la requête.

L'exemple ci-dessous utilise Node.js 18 ou une version ultérieure ainsi que sa fonction `fetch` intégrée ; aucune installation de SDK n'est donc nécessaire. Définissez la variable XAI_API_KEY dans l'environnement de votre processus avant de l'exécuter. Il utilise le modèle de requête officiel « Responses » actuel et un niveau de raisonnement faible ; le code a été testé localement sans envoyer de nouvelle requête API payante.

Première requête officielle · Node.js

Vérifiez que le statut est « terminé » et examinez l’objet d’utilisation avant d’augmenter la capacité. Cet exemple prévoit 2 048 jetons de sortie et de raisonnement via le champ officiel « Responses ». Un délai d’expiration correspond à une échéance côté client ; il ne prouve pas que le traitement côté serveur a été annulé ou n’a pas été facturé. L'exemple n'effectue pas de nouvelle tentative automatiquement ; le plafond de jetons ne correspond pas à un plafond financier global pour une application qui envoie également des données d'entrée ou appelle des outils.

Pour un SDK compatible avec OpenAI, l'URL de base est https://api.x.ai/v1 et l'identifiant reste le vôtre xAI Clé API. L'API « Responses » utilise entrée et justification : { effort : " faible " }; La fonction « Suggestions de chat » utilise messages et ses propres noms de paramètres. La copie d'une requête de passerelle telle quelle vers un autre point de terminaison peut échouer, même si les deux acceptent le format JSON.

Erreurs courantes d'intégration et maîtrise des coûts

  • 401 Non autorisé: vérifiez l'en-tête « Bearer », la clé et l'environnement d'exécution. Un code d'erreur 403 peut indiquer des problèmes d'autorisations au sein de l'équipe ou des restrictions d'accès. Répéter la même requête non valide ne résoudra pas le problème.
  • 404 Not Found : vérifiez le point de terminaison et l'ID du modèle exacts. Faites la distinction entre un ID non valide et un ID retiré, documenté, qui reste accessible via une redirection.
  • 400 ou 422 : vérifiez le schéma de la requête et les paramètres pris en charge. Par exemple, la documentation actuelle sur le raisonnement exclut les pénalités de présence/fréquence et les paramètres d'arrêt pour les modèles de raisonnement.
  • 429 Nombre de requêtes trop élevé : mettez les tâches en file d'attente, lissez les pics de trafic et utilisez un recul exponentiel borné avec gigue. Surveillez à la fois le RPS et le TPM, et incluez les tentatives de réessai dans le budget de charge de travail.
  • Résultat inattendu ou statut incomplet : vérifiez la réponse, les paramètres de raisonnement et la limite de sortie applicable. Vérifiez la validité de la sortie lisible par machine avant de l'utiliser ; une réponse HTTP réussie ne garantit pas la qualité de la tâche.

Pour maîtriser les coûts, choisissez le modèle et le paramétrage de raisonnement les moins onéreux qui satisfont à vos propres critères de validation des tâches, conservez des instructions stables au début pour favoriser la réutilisation du cache, supprimez l'historique non pertinent, surveillez la limite des 200 000 invites et limitez les boucles d'outils des agents. N'utilisez le traitement par lots que si le modèle le prend en charge et si le travail peut attendre. Considérez la priorité comme un critère d'achat distinct.

Conservez les estimations de jetons à des fins de planification et les données de coût renvoyées pour le rapprochement. Enregistrez les valeurs entières lors de l'agrégation de nombreuses requêtes, puis comparez les totaux des requêtes avec l'utilisation indiquée dans la console et les factures. Un champ de coût manquant signifie “ inconnu ”, et non zéro ; une réponse de petite taille ne garantit pas une facture modeste.

Pour connaître les tarifs actuels de l’API Grok 4, établissez votre budget en fonction du modèle qui traite effectivement la requête, de la fourchette de prix de la consigne et du volume total facturable. Commencez par une petite requête officielle, examinez ses champs d’utilisation et de coût, puis adaptez la charge de travail en fonction de vos propres critères. Pour explorer les consignes dans un espace de travail de chat, ouvrir Grok 4,6 sur GlobalGPT.

Grok 4 - FAQ sur la tarification de l'API

Combien coûte actuellement le modèle Grok 4 API ?

Depuis le 8 septembre 2026, l'identifiant « grok-4-0709 », désormais obsolète, redirige vers « Grok 4.3 ». En dessous de 200 000 tokens de prompt, ses tarifs en dollars US par million sont de $1,25 pour les entrées, $0,20 pour les entrées mises en cache et $2,50 pour les sorties. Les tarifs pour les contextes longs sont doublés.

L'API Grok 4 d'origine est-elle toujours disponible ?

Le modèle original « grok-4-0709 » a été retiré de l'API xAI le 15 mai 2026. Son identifiant reste valide, mais les requêtes sont traitées par le modèle « Grok 4.3 », avec un effort de raisonnement réduit, et facturées aux tarifs applicables au modèle de remplacement.

Combien coûte l'API Grok 4.6 ?

Grok 4.6 coûte $2 en entrée, $0,50 en entrée mise en cache et $6 en sortie par million de tokens pour les prompts de moins de 200 000 tokens. À partir de 200 000, les taux sont respectivement de $4, $1 et $12. Les appels d’outils et autres frais applicables sont facturés séparément.

Les jetons de raisonnement sont-ils payants ?

Oui. xAI facture les jetons de raisonnement au taux de réalisation. Lorsque le raisonnement est déjà inclus dans le total des résultats ou des réalisations déclarés, ne l'ajoutez pas une deuxième fois dans votre estimation.

Les données mises en cache sont-elles prises en compte dans le calcul du seuil de 200 000 ?

Oui. Il faut compter l'intégralité de la requête, y compris les jetons mis en cache. Selon le barème tarifaire officiel, une requête de 200 000 jetons ou plus relève de la tranche « contexte long », et les tarifs les plus élevés s'appliquent à l'ensemble des jetons de cette requête.

L'abonnement au service de chat donne-t-il droit à un quota gratuit d'API Grok ?

Ne partez pas du principe qu’un abonnement au service de chat inclut des crédits pour l’API xAI. Le guide de démarrage rapide officiel de l’API utilise un compte Console et des crédits distincts. Toute promotion doit être vérifiée auprès de l’équipe chargée de cette API ; l’accès gratuit pour les particuliers est une offre différente.

Quelles sont les limites de débit de l'API Grok ?

Les limites dépendent du modèle et du niveau de l'équipe. Le tableau du niveau 0 consulté indique les valeurs suivantes : Grok 4.3 à 37 RPS et 10 millions de TPM, et Grok 4.6 à 150 RPS et 50 millions de TPM. Utilisez la console de votre équipe pour vérifier les limites qui s'appliquent à votre clé.

Puis-je utiliser le Grok 4.6 sur le GlobalGPT ?

Oui. GlobalGPT dispose d'une entrée de chat Grok 4.6 vérifiée. Il s'agit d'un workflow distinct de la plateforme ; il ne remplace pas une clé API xAI, la facturation directe via l'API ni les contrôles de votre console xAI.

Comment puis-je vérifier le coût réel d'une requête xAI ?

Lisez la valeur « usage.cost_in_usd_ticks » dans la réponse officielle et divisez-la par 10 000 000 000 pour obtenir le montant en USD. Ce champ couvre cette requête, y compris les réductions sur les jetons et les outils côté serveur. Additionnez les requêtes pour suivre une conversation.

Partager l'article :

Articles connexes