Qwen 3.8 Max ist das neue Flaggschiffmodell von Alibaba Qwen für Programmierung, professionelle Anwendungen, lang laufende Agenten und multimodale Aufgaben. Die offizielle Bezeichnung lautet Qwen3.8-Max, … wurde am 3. August 2026 mit insgesamt 2,4 Billionen Parametern, 95 Milliarden aktiven Parametern und einem Kontextfenster von 1 Million Token angekündigt.
Die Markteinführung ist mehr als nur eine routinemäßige Aktualisierung der Leistungswerte. Qwen positioniert das Modell als Agenten, der planen, Werkzeuge einsetzen, visuelles Feedback auswerten und über lange Aufgabenketten hinweg weiterarbeiten kann – und nicht nur als Chatbot, der jeweils eine Anfrage nach der anderen beantwortet. Damit rückt es in denselben Kaufkontext wie das Die besten KI-Modelle für den praktischen Einsatz, doch der Preis der API, das Tarifmodell mit offenem Datenvolumen und die Bereitstellungsanforderungen sollten Sie vor einem Wechsel genauer unter die Lupe nehmen.
Was ist Qwen3.8-Max?
Qwen3.8-Max ist ein großes „Mixture-of-Experts“-Modell, das vom Qwen-Team von Alibaba entwickelt wurde. Es verfügt insgesamt über 2,4 Billionen Parameter, aktiviert jedoch für jedes Token 95 Milliarden Parameter. Das Modell vereint Text, Code, visuelles Verständnis, den Einsatz von Werkzeugen und langfristige Planung in einem System, das darauf ausgelegt ist, komplexe Aufgaben von Anfang bis Ende zu erledigen.
Die Offizielle Veröffentlichung von Qwen beschreibt vier zentrale Ziele: stärkere autonome Programmierung, professionelle Ergebnisse in Produktionsqualität, längere Aufgaben im geschlossenen Regelkreis und native multimodale Agenten. Praktisch gesehen zielt Qwen darauf ab, dass sich das Modell von “Beantworte diese Frage” hin zu “Nimm dieses Ziel, erstelle einen Plan, nutze die verfügbaren Werkzeuge, überprüfe das Ergebnis und fahre fort, bis die Arbeit erledigt ist” entwickelt.”
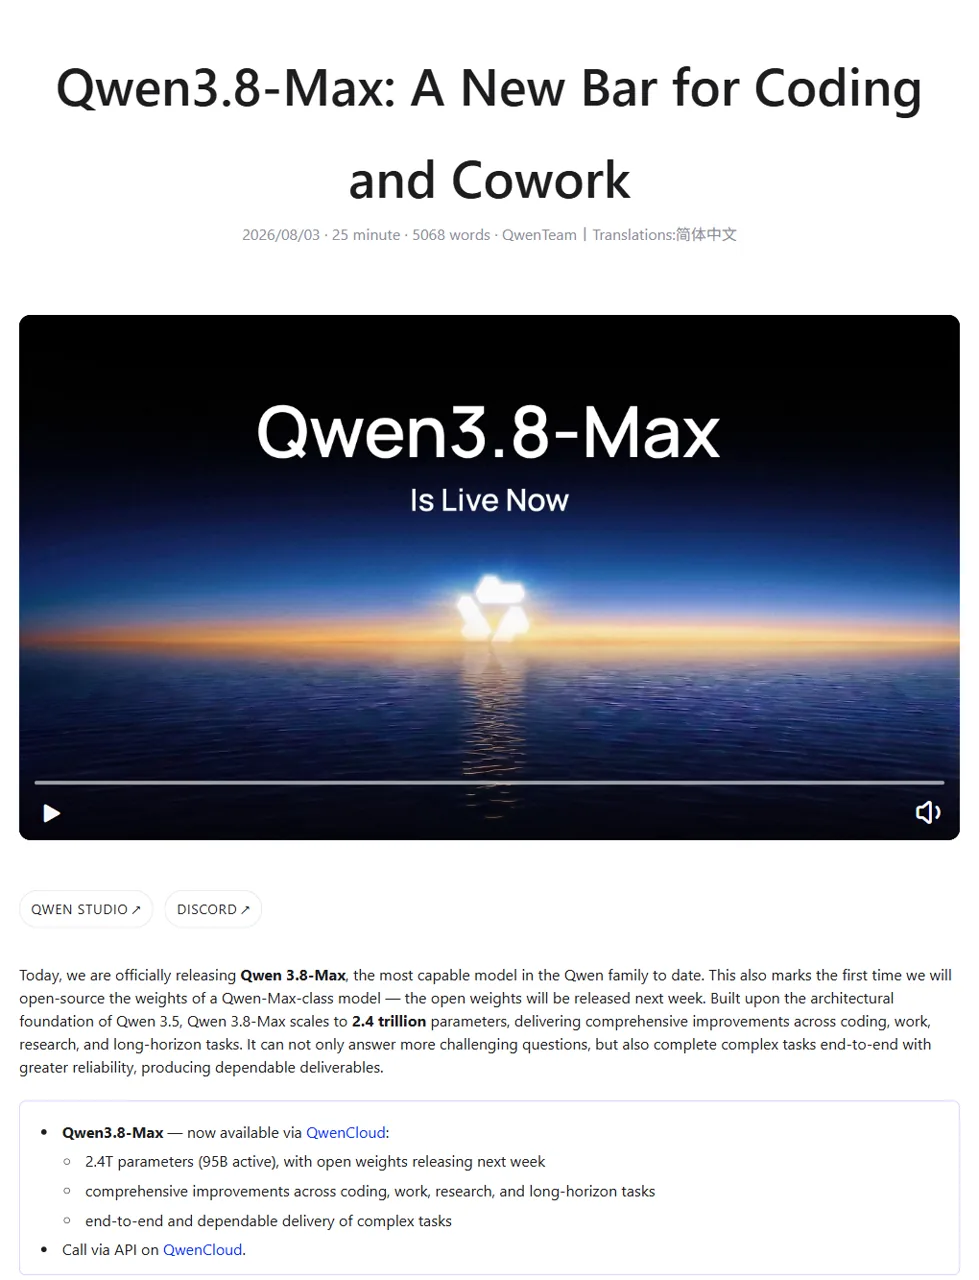
Qwen 3.8 – Technische Daten (Maximalwerte)
Die Anzahl der Parameter muss im Kontext betrachtet werden. Ein Modell mit 2,4 Billionen Parametern ist enorm, aber „Qwen3.8-Max“ nutzt nicht jeden Parameter für jedes Token. Sein „Mixture-of-Experts“-Design leitet jedes Token durch einen kleineren aktiven Teil des Netzwerks. Die Zahl von 95 Milliarden aktiven Parametern ist daher für das Verständnis des Inferenzverhaltens aussagekräftiger als die Gesamtzahl allein, obwohl keine der beiden Zahlen für sich genommen Aufschluss über die tatsächliche Latenz oder die Hardwareanforderungen gibt.
Das Kontextfenster mit einer Kapazität von 1 Million Token ist unmittelbar nützlicher. Es kann große Repositorys, umfangreiche Dokumentensätze, ausführliche Agentenverläufe oder Betriebsaufzeichnungen mehrerer Monate in einer einzigen Anfrage erfassen. Das garantiert zwar keine lückenlose Erfassung aller Token, bietet Entwicklern jedoch deutlich mehr Spielraum, um Anweisungen, Tool-Ausgaben, Code und Zwischenentscheidungen ohne drastische Kürzungen zu bewahren.
Was kann der Qwen3.8-Max?
Autonome Kodierung
In den Einführungsunterlagen von Qwen werden Projekte hervorgehoben, die weit über einen einzelnen Auftrag zur Codegenerierung hinausgehen. Das Unternehmen beschreibt eine autonome Entwicklung, die länger als 10 Tage dauert und von einem leeren Ordner bis hin zu einem Produktionsprojekt reicht, wobei Fehler und neue Anforderungen berücksichtigt werden. Das ist der richtige Weg für Agenten auf Repository-Ebene, auch wenn Käufer das Modell dennoch anhand ihrer eigenen Sprachen, Testsuiten, Sicherheitsregeln und Bereitstellungsumgebung validieren sollten.
Im technischen Alltag sind die praktischen Fragen einfacher: Kann das Modell mehrere Dateien gleichzeitig verarbeiten? Bleiben Schnittstellen bei der Refaktorisierung erhalten? Schreibt es Tests, analysiert es Fehler und korrigiert es seinen eigenen Patch? Diese Kriterien sind bei der Auswahl des bestes AI-Modell für die Codierung.
Professionelle “Cowork”-Aufgaben
Der Begriff “Cowork” bezieht sich eher auf Arbeitsergebnisse als auf zwanglose Gespräche. Qwen stellt Berichte, Forschungsergebnisse, Präsentationen, Analysen, Dokumente und andere Arbeitsergebnisse aus Hunderten von Berufsfeldern in den Mittelpunkt. Ein gutes „Cowork“-Modell muss sich an eine Aufgabenstellung halten, Belege strukturieren, das richtige Format verwenden und ein Ergebnis liefern, das man bearbeiten oder weitergeben kann – nicht nur einen plausiblen Absatz.
Akteure mit langfristigem Horizont
Qwen berichtet zudem von Aufgaben auf Systemebene, die sich über Hunderte von Durchläufen erstrecken. Zu den Beispielen gehören eine über 500 Runden umfassende Optimierung des Chip-Designs und eine einjährige Simulation einer E-Commerce-Strategie. Hierbei handelt es sich um Hersteller-Demonstrationen und nicht um das Versprechen, dass jeder Agent tagelang unbeaufsichtigt laufen wird. Sie zeigen jedoch, worauf das Produkt abzielt: kontinuierliche Planung, Bewertung im geschlossenen Regelkreis und wiederholte Verbesserung statt isolierter Antworten.
Multimodale Planung und visuelles Feedback
Qwen3.8-Max behandelt Bilder und Bildschirminhalte als Teil der Agenten-Schleife. Ein visueller Agent kann eine Seite untersuchen, eine Aktion auswählen, beobachten, was sich geändert hat, und seinen Plan entsprechend anpassen. Dies unterstützt Aufgaben im Bereich der Computernutzung, das Verstehen von Dokumenten, das Testen von Benutzeroberflächen, visuelles Programmieren, Diagramme und räumliches Denken. Die Schwierigkeit besteht nicht nur darin, ein Bild zu erkennen, sondern darin, visuelle Beobachtungen über viele Schritte hinweg mit dem Ziel des Agenten in Verbindung zu halten.
Praxistests: Nützliche Ergebnisse, langsame Reaktionszeiten und ein leerer Durchlauf
Ich habe drei unabhängige Abfragen an die qwen3.8-max Modell-ID über die Anywhere OpenAI-kompatible API am 4. August 2026. Hierbei handelt es sich um kleine praktische Überprüfungen, nicht um einen eigenständigen Benchmark oder eine Aussage über jede Qwen-Bereitstellung. Sie sind nützlich, da sie sowohl die Qualität der angezeigten Antwort als auch das Verhalten des getesteten Gateway-Pfads aufzeigen.
Fehlerbehebung mit dem Retry-Helper
Die erste Aufgabe basierte auf einer fehlerhaften Wiederholungsfunktion aus einem Zahlungs-Webhook-Szenario. Die Vorgabe beschränkte das Modell auf drei Versuche, zwei genau festgelegte Wartezeiten, eine sofortige Rückkehr bei Erfolg und das erneute Auslösen der dritten Ausnahme nach einem vollständigen Fehlschlag.
Die Antwort identifizierte drei separate Fehler: bedingungsloses Einschlafen nach jedem Versuch, eine nicht zugewiesene Ergebnis nach Ausnahmen und einer „Truthiness“-Prüfung, die den Erfolg verzögerte oder falsch behandelte. Die erwartete Zeile lautete "paid" mit den Argumenten [0,1; 0,2] für sleep_fn.
Anstatt mich auf die Erklärung zu verlassen, habe ich den Code dann lokal ausgeführt. Er hat drei Fälle bestanden: zwei Fehlschläge, gefolgt von einem Erfolg, sowie einen „Falsey“-Erfolgswert beim ersten Aufruf von 0, sowie drei Fehlversuche, bei denen das Endergebnis RuntimeError("failure-3") musste erneut gesendet werden. Das war eine gute technische Lösung. Der Nachteil war die Latenz: Die sichtbare Antwort dauerte über das getestete Gateway 51,577 Sekunden.
Zusammenfassung widersprüchlicher Beweise
In der zweiten Aufgabe wurde geprüft, ob das Modell aktuelle offizielle Fakten von alten Notizen, Angaben von Anbietern, einem Kommentar aus der Community und einer unbestätigten Plattformroute unterscheiden konnte.
Das Modell hat den künstlich eingeführten Konflikt korrekt verarbeitet. Es hat weder den 256K-Kontext noch den Eingabepreis $1.20 als aktuell wiederholt, hat einen Hinweis auf vier GPUs nicht in eine Hardwareanforderung umgewandelt und nicht behauptet, dass GlobalGPT bereits über eine dedizierte Qwen3.8-Max-Route verfüge. Außerdem kennzeichnete es die offizielle Benchmark-Tabelle als „vom Anbieter gemeldet“. Die Antwort dauerte 94,973 Sekunden, sodass es sich hierbei eher um ein Ergebnis, bei dem Qualität im Vordergrund stand, als um ein schnelles Extraktionsergebnis handelte.
Was ist bei der Planungsprüfung schiefgelaufen?
In einer dritten Anfrage wurde ein zweistündiger CMS-Migrationsplan für zwei Techniker mit expliziten Go/No-Go- und Rollback-Kontrollpunkten gefordert. Die erste Anfrage endete nach 133,682 Sekunden, als die Upstream-Verbindung unterbrochen wurde. Eine kürzere Wiederholungsserie max_completion_tokens auf 1.200, doch die API meldete finish_reason: "Länge", hat das gesamte Berechnungsbudget aufgebraucht und nach 32,899 Sekunden keine sichtbare Antwort zurückgegeben.
Das ist zwar eine nützliche operative Warnung, aber kein Beweis dafür, dass Qwen3.8-Max keine Migrationen planen kann. Es lag kein Plan zur Bewertung vor. Bei diesem Gateway erfordert eine komplexe Planung eine größere Fertigstellungsreserve, Streaming oder eine stufenweise Eingabeaufforderung, damit die interne Verarbeitung nicht das gesamte Antwortbudget aufbraucht, bevor sichtbarer Text ausgegeben wird.
Qwen 3.8 – Maximale Leistungswerte
Das offizielle Benchmark-Paket von Qwen präsentiert Qwen3.8-Max als leistungsstarken Kodierungs- und multimodalen Agenten, doch die Ergebnisse sind eher durchwachsen als ein klarer Sieg. In einigen Tests liegt er vor den aufgeführten Modellen, in anderen dicht hinter dem Spitzenreiter, und in mehreren Kategorien bleibt er hinter GPT-5.6 Sol oder Fable 5 zurück. Das ist eine aussagekräftigere Einschätzung, als Dutzende von Tests auf ein einziges “Bestmodell”-Label zu reduzieren.
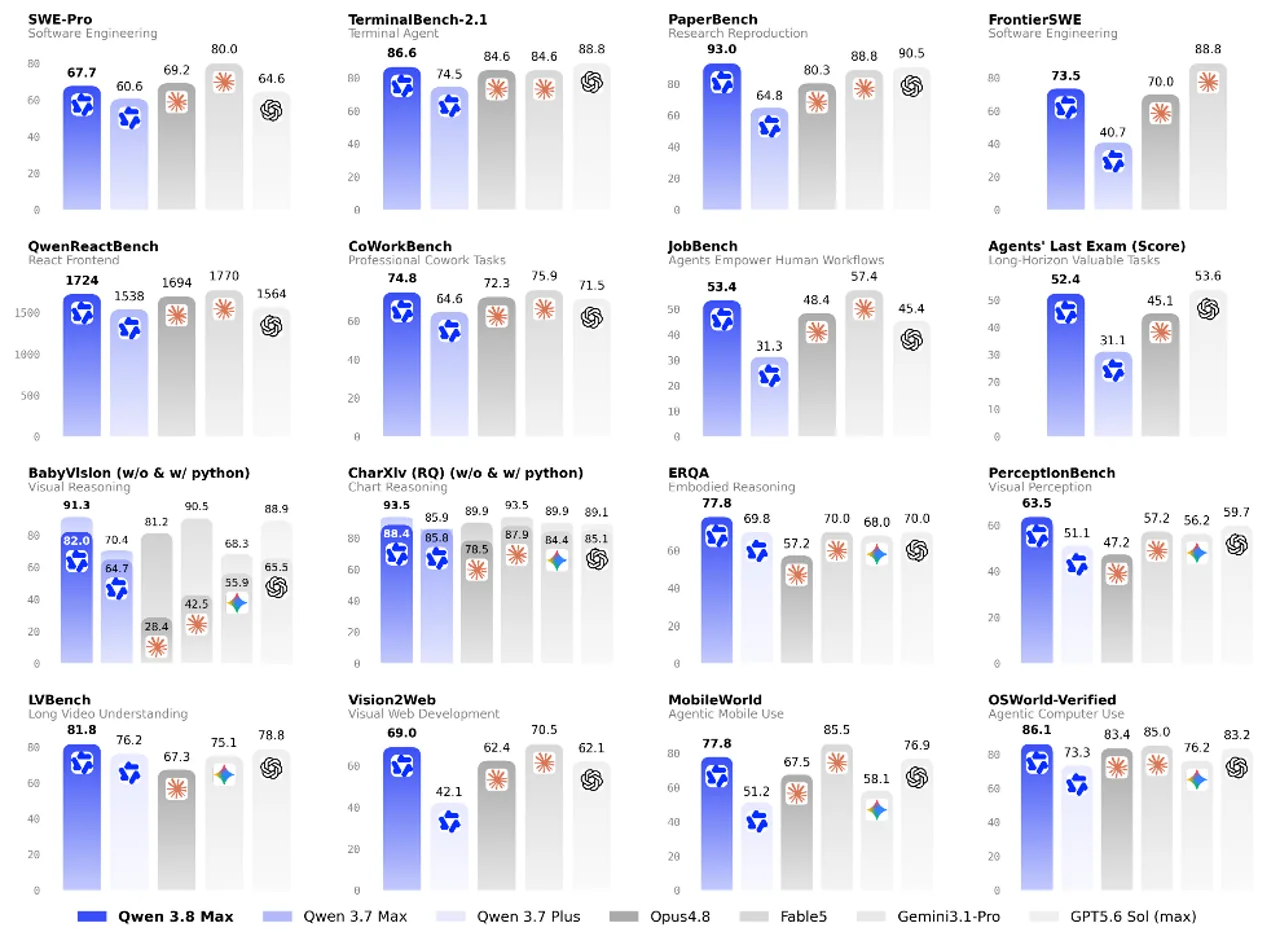
Ausgewählte Ergebnisse aus der offiziellen Tabelle von Qwen
Diese Zahlen stammen aus den eigenen Pressematerialien von Qwen. Aus den Fußnoten geht hervor, dass die Tabelle offizielle Modellberichte, Systemdatenblätter, öffentliche Ranglisten und die internen Bewertungen von Qwen miteinander kombiniert. Auch die Kabelbäume und Einstellungen unterscheiden sich bei einigen Modellen. Nutzen Sie die Tabelle, um vielversprechende Stärken zu identifizieren, und überprüfen Sie die engere Auswahl anschließend anhand Ihrer eigenen Arbeit, bevor Sie eine kostspielige Entscheidung treffen.
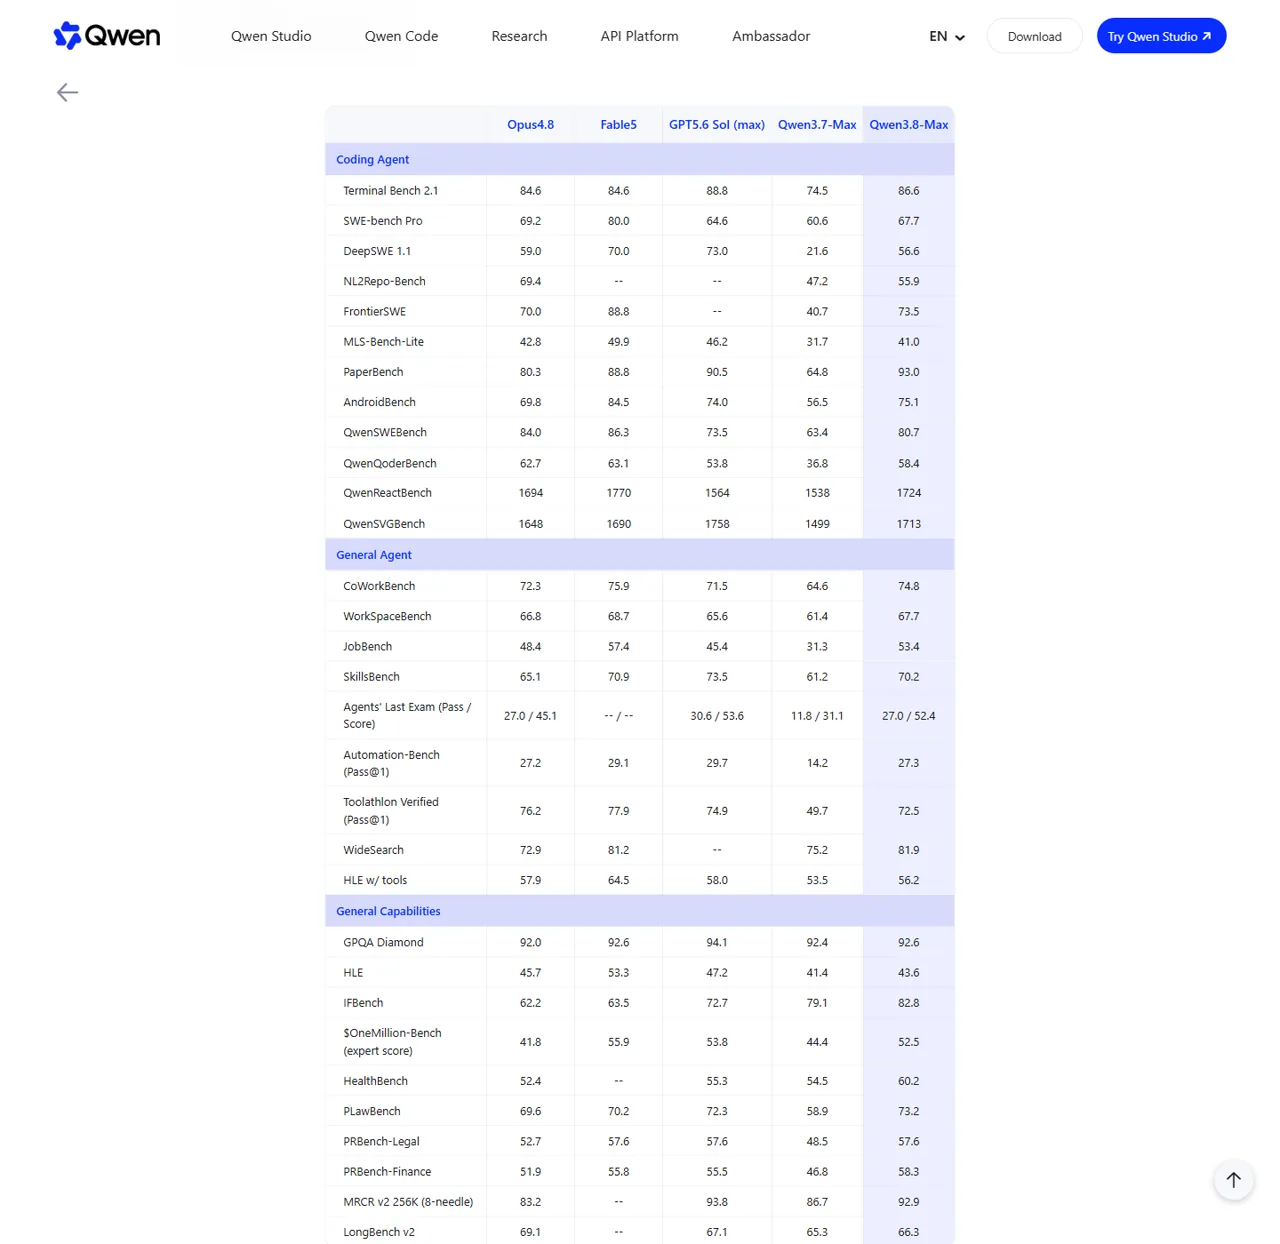
Was die Kodierungsergebnisse bedeuten
Der deutlichste Vorteil ist die Ausgewogenheit. Qwen3.8-Max schneidet bei Terminal-Aufgaben, Softwareentwicklung, der Umsetzung von Anweisungen, Aufgaben im Team, der Websuche und der Befolgung von Anweisungen durchweg gut ab. Es muss nicht in jeder Kategorie gewinnen, um nützlich zu sein; ein Agent, der bei Planung, Programmierung, dem Umgang mit Tools und visuellen Überprüfungen durchweg starke Leistungen erbringt, ist möglicherweise zuverlässiger als ein Modell, das für einen einzigen, eng gefassten Test optimiert wurde.
Die offizielle Tabelle verdeutlicht zudem, warum Vergleichstests so wichtig sind. GPT-5.6 Sol führt in mehreren Bereichen, die auf Schlussfolgerungen oder Terminalfunktionen ausgerichtet sind, während Fable 5 bei Aufgaben in den Bereichen Zusammenarbeit, Benutzeroberfläche und visuelle Darstellung besonders wettbewerbsfähig bleibt. Eine separate Vergleich zwischen GPT-5.6 und Fable 5 kann Ihnen dabei helfen, diese Modellfamilien auf alltägliche Anwendungsfälle zu übertragen, bevor Sie das Modell Qwen3.8-Max in die engere Auswahl aufnehmen.
Was die multimodalen Ergebnisse bedeuten
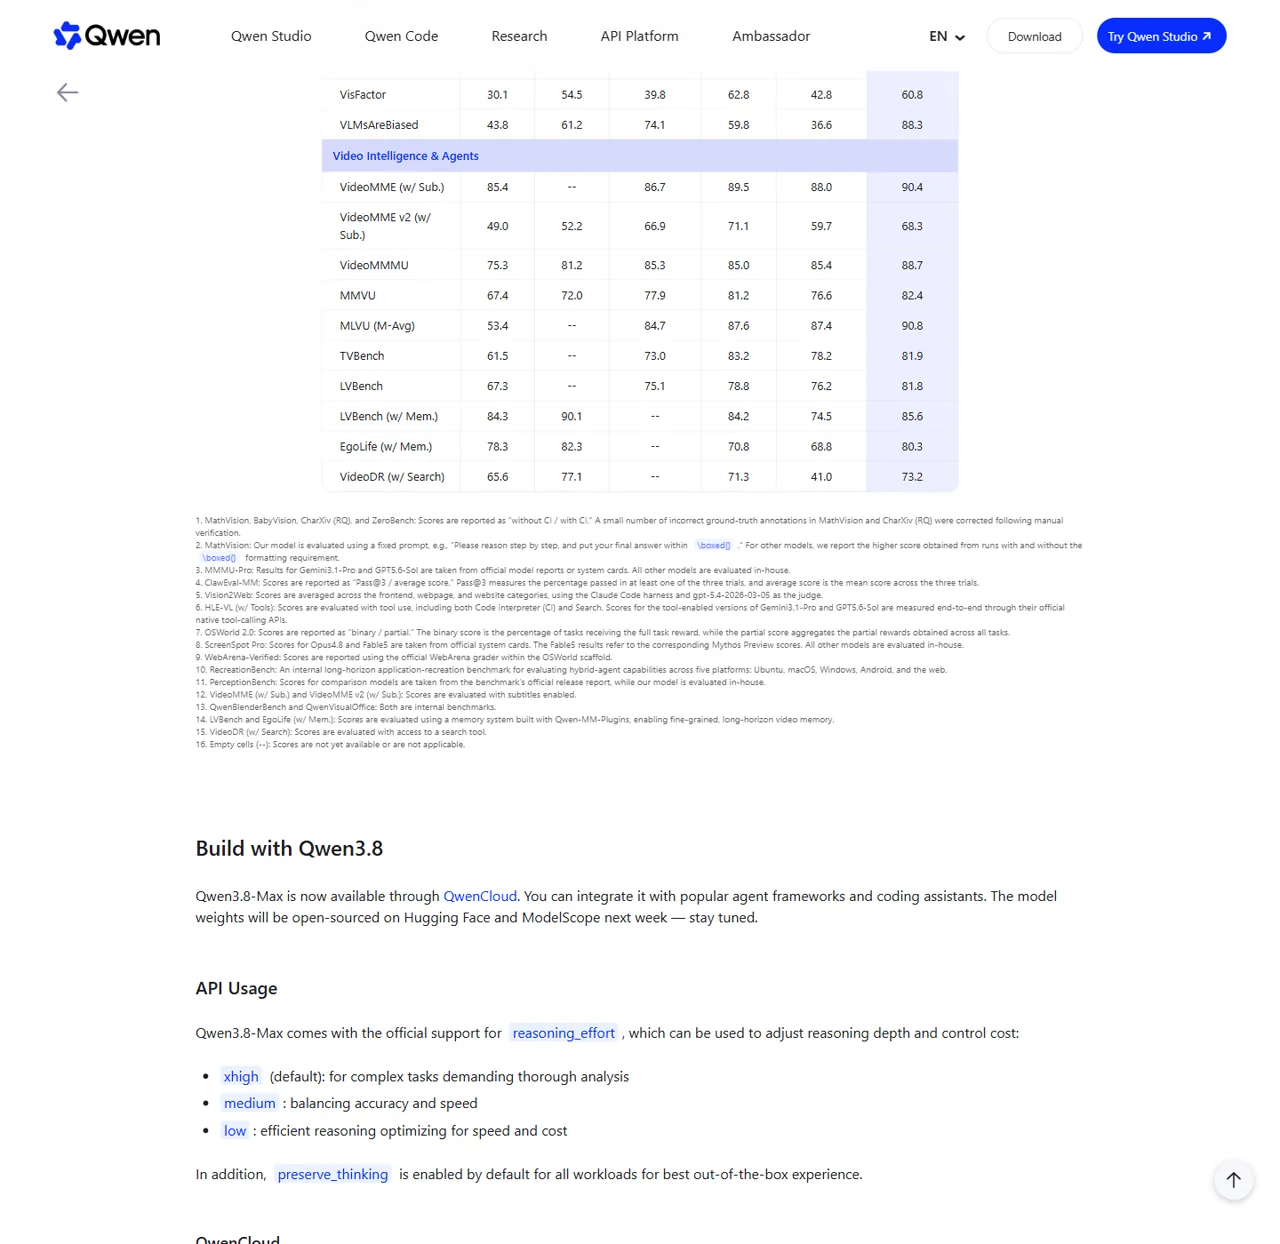
Qwen3.8-Max erzielt starke offizielle Ergebnisse in den Bereichen multimodales Schlussfolgern, visuelle Verankerung, Computernutzung, Dokumentenbearbeitung und räumliches Verständnis. Seine Punktzahl von 86,1 bei OSWorld-Verified ist besonders relevant für bildschirmgesteuerte Agenten, da hier die Erledigung von Aufgaben in Desktop-Umgebungen gemessen wird und nicht lediglich die Beschreibung eines Bildes.
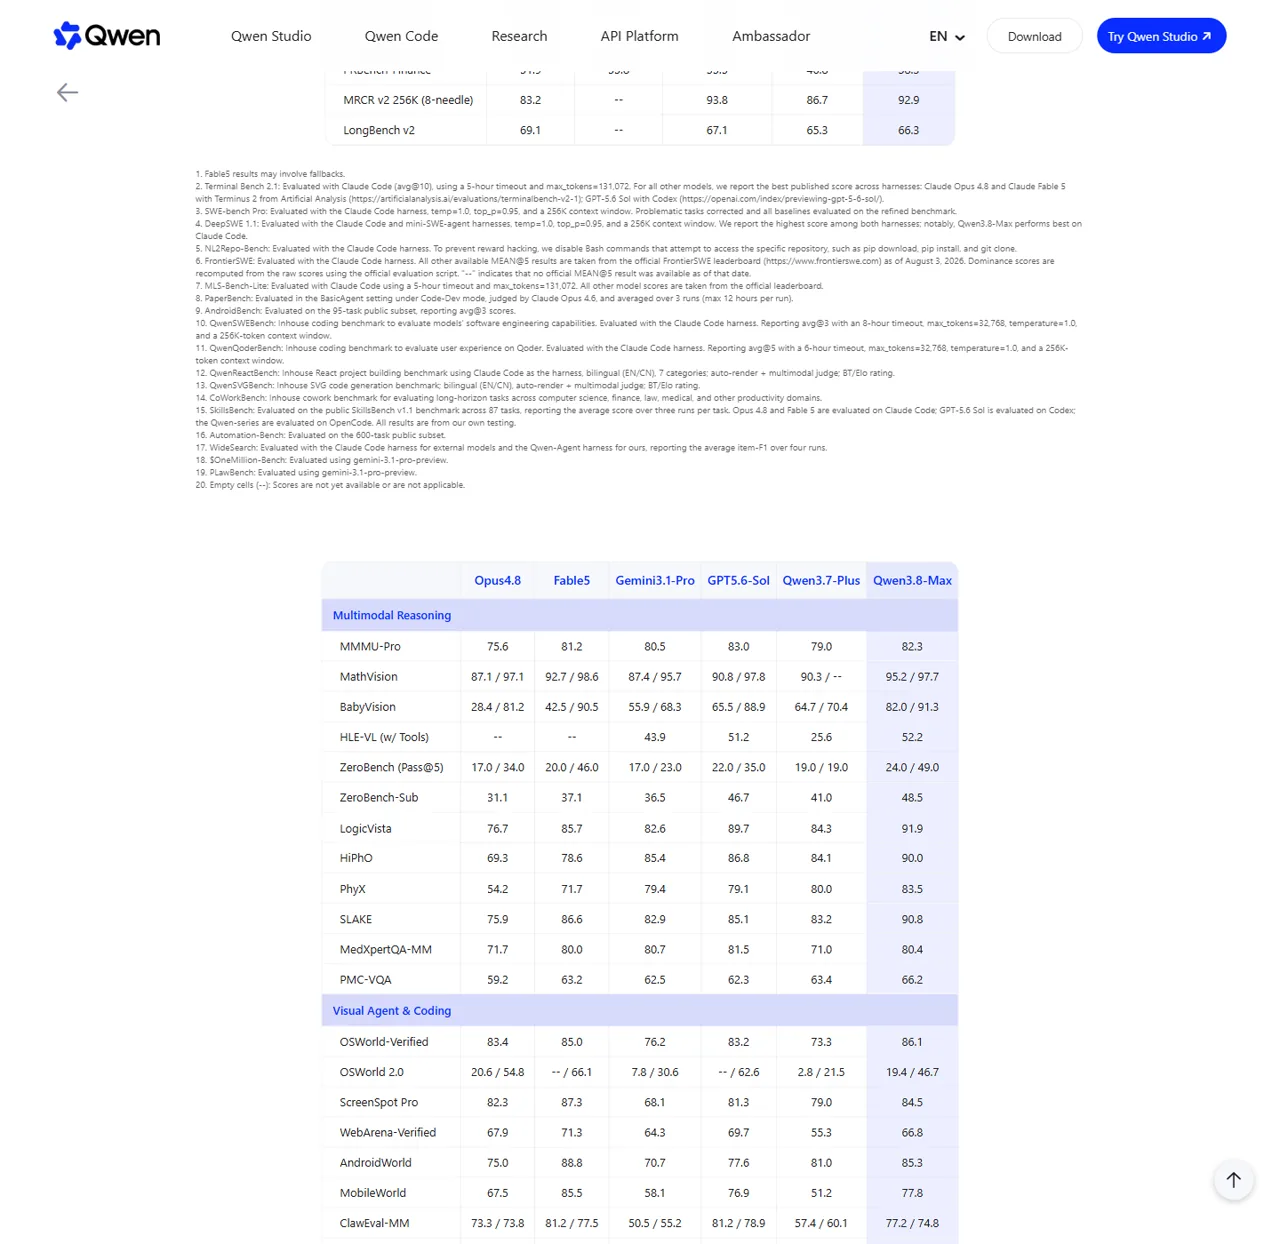
Wie schneidet der Qwen3.8-Max im Vergleich ab?
Auf die Frage “Ist Qwen3.8-Max besser als GPT, Claude oder Gemini?” gibt es keine aussagekräftige Einzeiler-Antwort. Die Daten von Qwen selbst zeigen, dass sich die Spitzenreiter in den einzelnen Kategorien von Zeile zu Zeile ändern. Die Eignung eines Produkts hängt zudem von der Zuverlässigkeit des Tools, der Ausgabequalität, der Latenz, der regionalen Verfügbarkeit, den Datenschutzmaßnahmen und der Benutzeroberfläche rund um das Modell ab.
Qwen3.8-Max ist besonders interessant, wenn Sie ein einziges Modell suchen, das Programmierung, Dokumentenbearbeitung, Recherche, umfangreiche Aufgaben und visuelle Agenten abdeckt. GPT-5.6 Sol ist möglicherweise nach wie vor die bessere Wahl für Arbeitslasten, bei denen sich seine herausragenden Fähigkeiten im logischen Schlussfolgern und seine Endergebnisse auf Ihre Umgebung übertragen lassen. Fable 5 verdient bei Aufgaben mit viel Zusammenarbeit und UI-lastigen Aufgaben eine genauere Betrachtung; das Vergleich zwischen Fable 5 und Opus 4.8 liefert weitere Hintergrundinformationen zu diesem Teil der Entscheidung.
Die geplanten offenen Gewichte des Modells könnten sich als sein größter struktureller Vorteil erweisen. Zwar spielt heute die reine API-Leistung eine wichtige Rolle, doch bieten herunterladbare Gewichte Möglichkeiten zur Feinabstimmung, zum Aufbau einer eigenen Infrastruktur, zur Forschung und zum regionalen Einsatz. Der endgültige Nutzen hängt von der veröffentlichten Lizenz, den Gewichtsformaten, der Quantisierungsunterstützung und der Hardware ab, die erforderlich ist, um das Modell mit einer brauchbaren Geschwindigkeit auszuführen.
Qwen3.8 – Max API-Preise
Qwen führte in seinem Bericht die folgenden Einführungspreise auf: offizielle Bekanntgabe:
Eine einfache Schätzung lautet:
geschätzte Kosten = nicht zwischengespeicherte Eingabe × $2/M + zwischengespeicherte Eingabe × $0,25/M + Ausgabe × $6/M
Beispielsweise würde ein Durchlauf mit 10 Millionen nicht zwischengespeicherten Eingabetoken und 2 Millionen Ausgabetoken zu den Einführungspreisen vor der Berechnung weiterer Plattformgebühren etwa $32 kosten: $20 für die Eingabe plus $12 für die Ausgabe. Ein Agent, der in jedem Zug ein großes Repository erneut einliest, kann deutlich mehr ausgeben, weshalb Caching und Kontextmanagement ebenso wichtig sind wie der angegebene Eingabepreis.
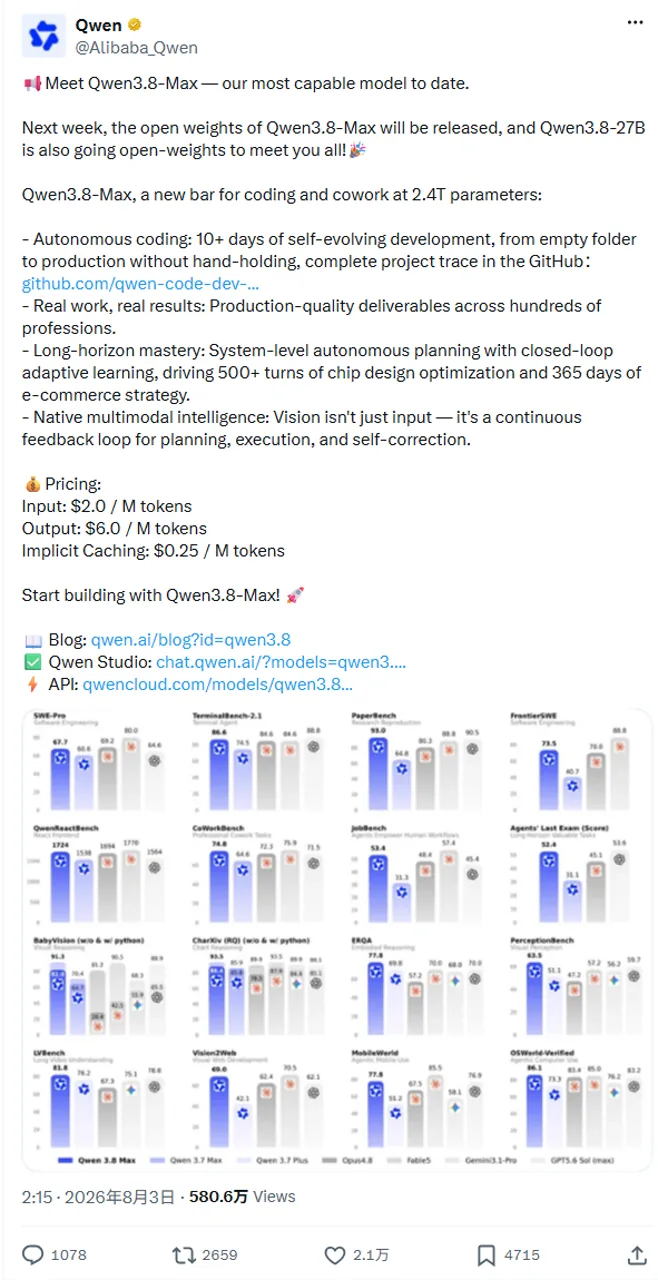
Qwen3.8-Max unterstützt außerdem logisches_Denken Steuerelemente. Im offiziellen API-Abschnitt sind aufgeführt xhoch als Standard für die komplexe Analysis, mittel um Genauigkeit und Geschwindigkeit in Einklang zu bringen, und niedrig für schnelleres und effizienteres Arbeiten. preserve_thinking ist standardmäßig aktiviert. Diese Steuerungsmöglichkeiten können Kosten senken, sollten jedoch im Hinblick auf die Aufgabenqualität getestet werden, anstatt als austauschbare Modi betrachtet zu werden.
Bei der Preisgestaltung über verschiedene Anbieter hinweg ist ebenfalls Vorsicht geboten. Ein Modell mit einem niedrigeren Token-Preis kann dennoch teurer sein, wenn es längere Eingabeaufforderungen, mehr Wiederholungsversuche oder zusätzliche Tool-Aufrufe erfordert. Das Gemini 3.1 Pro API – Preisübersicht ist ein anschauliches Beispiel dafür, warum neben der Basisrate auch die Kontextlänge und die Nutzungsstufen eine Rolle spielen.
So greifen Sie auf Qwen3.8-Max zu
1. Verwenden Sie Qwen Studio zur direkten Bewertung
Der schnellste Weg für einen ersten Blick ist Qwen Studio. Beginnen Sie mit einer echten Aufgabe statt mit einer trivialen Aufforderung: Geben Sie ein unübersichtliches Briefing, ein Programmieraufgabe mit mehreren Dateien, einen Dokumentensatz oder einen bildbasierten Arbeitsablauf vor. Prüfen Sie, ob das Ergebnis korrekt, bearbeitbar und vollständig genug ist, um Zeit zu sparen.
2. Verwenden Sie die QwenCloud-API für Anwendungen
Qwen3.8-Max ist erhältlich über QwenCloud. Auf der Veröffentlichungsseite heißt es, dass die API branchenübliche Protokolle für die Chat-Vervollständigung und die Antwortverarbeitung unterstützt, die mit der OpenAI-Spezifikation kompatibel sind, sowie eine Schnittstelle, die mit Anthropic kompatibel ist. Das erleichtert die Migration, dennoch sollten Sie die Modellnamen, Parameter, das Streaming-Verhalten, die Tool-Schemas und die Fehlerbehandlung in der offiziellen Dokumentation überprüfen.
3. Mit Programmier- und Agenten-Tools verknüpfen
Die Produktseite von Qwen enthält Integrationen für Qwen Code, Claude Code, Codex und OpenClaw. Das Modell lässt sich daher möglicherweise in einen bestehenden Terminal- oder Agenten-Workflow einbinden, ohne dass eine neue Schnittstelle erforderlich ist. Die Integrationsunterstützung hebt die Kosten für das zugehörige Tool nicht auf; vergleichen Sie daher die Modellrechnung mit der separaten Preisstruktur des Codex bevor der Arbeitsablauf eines Teams vereinheitlicht wird.
Nutzer des Claude-Codes sollten zudem die Kosten für das Codierungsprodukt von denen für die externe Modell-API trennen. Die verfügbaren Tarife und Abrechnungswege sind in der Preisliste für den Code Claude.
OpenClaw-Anwender stellen sich zudem die Frage: Welches Modell bietet für einen bestimmten Agenten die beste Kombination aus Werkzeugnutzung, Geschwindigkeit und Preis? Das Modellvergleich OpenClaw bietet einen praktischen Rahmen für diese Entscheidung, anstatt automatisch das größte Modell zu wählen.
4. Achten Sie darauf, dass der modellübergreifende Arbeitsablauf konsistent bleibt
Zum Zeitpunkt der Markteinführung ist QwenCloud der verifizierte Produktionsweg für Qwen3.8-Max. Wenn Sie zudem GPT, Claude, Gemini oder Fable-Alternativen vergleichen, dann ist die GlobalGPT-Arbeitsbereich für mehrere Modelle kann das Wechseln zwischen den Registerkarten bei den unterstützten Modellen reduzieren. Verwenden Sie für das Modell Qwen3.8-Max die offizielle Qwen-Route, bis eine eigene Modellseite für das Modell GlobalGPT verifiziert ist; gehen Sie nicht davon aus, dass eine neue Modell-URL existiert, nur weil das Modell angekündigt wurde.
Qwen3.8 – Maximale Gewichte bei geöffneter Position
Qwen gab bekannt, dass die Gewichte für Qwen3.8-Max in der Woche nach der Markteinführung am 3. August veröffentlicht würden. Das Gleiche Offizieller X-Beitrag Außerdem hieß es, dass Qwen3.8-27B als Open-Weight-System verfügbar sein werde. Das sind gute Nachrichten für den lokalen Einsatz und die Forschung, doch die Ankündigung allein reicht nicht aus, um einen Produktionscluster zu planen.
Bevor Sie Hardware herunterladen oder in Ihr Budget einplanen, überprüfen Sie bitte die folgenden fünf Punkte anhand der endgültigen Modellkarte:
- Die genauen Lizenz- und Nutzungsbedingungen für die kommerzielle Nutzung.
- Offizielle URLs der Repositorys von Hugging Face oder ModelScope.
- Verfügbare Präzisions- und Quantisierungsformate.
- Mindest- und empfohlene Anforderungen an CPU, GPU, Arbeitsspeicher und Speicherplatz.
- Ob das veröffentlichte Modell mit dem Verhalten der gehosteten API und der Kontextlänge übereinstimmt.
“Open Weight” und “Open Source” sind nicht immer dasselbe. „Open Weight“ bedeutet, dass die Modellparameter heruntergeladen werden können; die Lizenz legt fest, was Sie ändern, weiterverbreiten oder kommerziell nutzen dürfen. Solange die Repositories und die Lizenz noch nicht verfügbar sind, greifen Seiten, die einen Download von Qwen3.8-Max, einen GGUF-Build oder genaue lokale Hardwareanforderungen versprechen, den Tatsachen vor.
Die Ankündigung des 27B sollte auf die gleiche Weise behandelt werden. Es könnte für lokale Nutzer die realistischere Wahl werden, doch seine Architektur, die Kontextlänge, der Speicherbedarf und die Benchmark-Ergebnisse sollten aus der offiziellen Modellbeschreibung des Geräts stammen – und nicht vom Max-Modell übernommen werden.
Qwen3.8 – Maximale Einschränkungen und optimale Anpassung
Zu berücksichtigende Einschränkungen
- Die meisten Belege für den Start stammen aus Qwen. Bei unabhängigen Bewertungen können unterschiedliche Anweisungen, Instrumente oder Bewertungsregeln zum Einsatz kommen.
- Ein langer Kontext ist kein perfektes Gedächtnis. Ein Modell kann 1 Million Token verarbeiten und dennoch ein Detail übersehen oder einer unklaren Anweisung folgen.
- Agenten mit hohem Output können kostspielig werden. Die Fehlerrate von $6 pro Million ist von Bedeutung, wenn ein Workflow lange Codes, Berichte oder wiederholte Ablaufverfolgungen erzeugt.
- Die Details zur lokalen Bereitstellung sind erst vollständig, wenn die Gewichte und die Modellkarte eingetroffen sind. Ein 2,4-T-Gesamtparametersystem verhält sich nicht wie ein kleines Tischmodell.
- Der Einsatz von Werkzeugen führt zu einer weiteren Fehlerquelle. Der Browserzustand, Berechtigungen, Netzwerkfehler und schlecht definierte Tool-Schemas können ein ansonsten leistungsfähiges Modell beeinträchtigen.
- Informationen zur Markteinführung ändern sich schnell. Preise, Repositorien, Integrationen und Verfügbarkeit sollten vor der Veröffentlichung oder Beschaffung noch einmal überprüft werden.
Wer sollte es jetzt ausprobieren?
Es läuft ganz einfach darauf hinaus, dass Qwen3.8-Max zwar einen gründlichen Test verdient, aber keine blindlings durchgeführte Migration. Verwenden Sie eine anspruchsvolle Aufgabe mit einer klaren Erfolgskriterium, erfassen Sie die Gesamtzahl der Tokens und Wiederholungsversuche und vergleichen Sie das Endergebnis – nicht nur die erste Antwort.
Häufig gestellte Fragen
Wann wurde Qwen 3.8 Max veröffentlicht?
Qwen3.8-Max wurde am 3. August 2026 offiziell angekündigt. Das gehostete Modell war bereits zum Start über Qwen Studio und QwenCloud verfügbar. Qwen gab bekannt, dass die offenen Gewichte in der folgenden Woche veröffentlicht würden, sodass die Verfügbarkeit der API und die Verfügbarkeit der herunterladbaren Gewichte als separate Meilensteine betrachtet werden sollten.
Ist Qwen3.8-Max Open Source?
Qwen hat offene Gewichte für Qwen3.8-Max angekündigt, doch erst das endgültige Repository und die Lizenz legen fest, was Nutzer ausführen, ändern, weiterverbreiten oder kommerziell nutzen dürfen. Solange diese Dateien noch nicht online und verifiziert sind, ist die Formulierung “Veröffentlichung offener Gewichte angekündigt” zutreffender, als davon auszugehen, dass bereits alle Open-Source-Berechtigungen oder lokalen Formate verfügbar sind.
Wie viele Parameter hat Qwen3.8-Max?
Qwen3.8-Max verfügt über insgesamt 2,4 Billionen Parameter und aktiviert 95 Milliarden Parameter pro Token. Da das Modell auf einer „Mixture-of-Experts“-Architektur basiert, beschreiben die Gesamtzahl der Parameter und die Anzahl der aktiven Parameter unterschiedliche Teile des Systems. Keine der beiden Zahlen allein lässt Rückschlüsse auf die tatsächliche Geschwindigkeit oder den Hardwarebedarf zu.
Was ist das Kontextfenster „Qwen3.8-Max“?
In der offiziellen Veröffentlichung wird ein Kontextfenster von 1 Million Token angegeben. Das ist groß genug für umfangreiche Codeabschnitte, Dokumente, Tool-Ausgaben und den Agentenverlauf, doch die maximale Kontextgröße garantiert keine perfekte Rückgabe. Testen Sie das Modell hinsichtlich der Position, des Formats und der Dichte der Informationen, die in Ihrem tatsächlichen Arbeitsablauf verwendet werden.
Wie viel kostet die API Qwen3.8-Max?
Zum Start wurden für Qwen folgende Werte angegeben: $2 pro Million Eingabe-Token, $6 pro Million Ausgabe-Token und $0,25 pro Million implizit zwischengespeicherter Token. Betrachten Sie diese Werte als Startpreise und überprüfen Sie sie vor der Budgetplanung. Die Agentenkosten hängen außerdem von der Wiederverwendung von Kontexten, dem Aufwand für die Schlussfolgerung, Wiederholungsversuchen und der Länge der generierten Ausgaben ab.
Ist Qwen3.8-Max besser als GPT-5.6 Sol oder Fable 5?
Nicht bei jedem Test. Die offizielle Tabelle von Qwen zeigt, dass Qwen3.8-Max bei einigen Benchmarks in den Bereichen Programmierung, Suche, Befehlsbefolgung und Computerbedienung führend ist, während GPT-5.6 Sol oder Fable 5 bei anderen Tests die Nase vorn haben. Welches Modell besser geeignet ist, hängt von der Aufgabe, der Tool-Umgebung, der Latenz, dem Preis und der Qualität des Endergebnisses ab.
Kann ich Qwen3.8-Max lokal ausführen?
Qwen hat für die Woche nach der Markteinführung herunterladbare Gewichte angekündigt, doch die lokale Umsetzbarkeit hängt von den endgültigen Dateien, der Genauigkeit, der Quantisierungsunterstützung, der Lizenz und den Hardware-Richtlinien ab. Warten Sie die offizielle Modellkarte ab, bevor Sie sich auf genaue Schätzungen zu RAM, VRAM oder Speicherplatz verlassen. Kleinere Qwen3.8-Varianten könnten sich als praktischer erweisen, sobald sie offiziell dokumentiert sind.
Was ist Qwen3.8-27B?
Im Ankündigungsbeitrag zu Qwen heißt es, dass Qwen3.8-27B ebenfalls mit offenen Gewichten veröffentlicht wird. Der Artikel zur Veröffentlichung von Max enthält nicht genügend Details, um die Spezifikationen des Max-Modells für die 27B-Version zu übernehmen. Informationen zu Architektur, Kontextfenster, Benchmarks, Lizenz und Download-Anweisungen finden Sie auf der entsprechenden Modellkarte.
Kann ich Qwen3.8-Max auf GlobalGPT verwenden?
Eine dedizierte GlobalGPT-Route für Qwen3.8-Max wurde zum Zeitpunkt der Veröffentlichung noch nicht verifiziert. Verwenden Sie Qwen Studio oder QwenCloud für den direkten Zugriff. GlobalGPT eignet sich weiterhin zum Vergleich anderer verfügbarer GPT-, Claude-, Gemini- und Fable-Modelle, ohne die Plattform wechseln zu müssen.
Endgültiges Urteil
Verwenden Sie „Qwen Studio“ oder „QwenCloud“ für eine direkte Evaluierung von „Qwen3.8-Max“. Verwenden Sie „GlobalGPT“, um andere verifizierte Modelle zu vergleichen, ohne dass dies bedeutet, dass bereits eine dedizierte „Qwen3.8-Max“-Route existiert.
Verfügbare Modelle vergleichenQwen 3.8 Max ist eine der ambitioniertesten Modelleinführungen des Jahres 2026: insgesamt 2,4 Billionen Parameter, 95 Milliarden aktive Parameter, ein Kontextfenster von 1 Million Token, überzeugende offizielle Ergebnisse in den Bereichen Programmierung und multimodale Agenten sowie ein angekündigter offener Gewichtungspfad. Die Preise für die Launch-API sind wettbewerbsfähig genug, um das Modell zu testen, insbesondere da durch Caching die Kosten für wiederholte Kontextabfragen reduziert werden.
Der wichtigste Grund, sich dafür zu interessieren, ist nicht der Sieg bei einem einzelnen Benchmark-Test. Es ist vielmehr der Versuch, Programmierung, professionelle Arbeitsergebnisse, langfristige Planung, visuelles Feedback und den Einsatz von Tools in einem Modell zu vereinen. Beginnen Sie mit Qwen Studio oder einer kontrollierten Evaluierung von QwenCloud, messen Sie die Qualität der abgeschlossenen Aufgaben und die Gesamtkosten und warten Sie auf die offiziellen Gewichtungen und die Lizenz, bevor Sie Zusagen für eine lokale Bereitstellung machen.
Primärquellen, geprüft am 4. August 2026: Qwen3.8-Max – Offizielle Veröffentlichung und Offizieller Beitrag zur Markteinführung von @Alibaba_Qwen.