Ein einziges Modell kann die gesamte Klangszene erzeugen.
Seed Audio 1.0 kann Gesang, Geräusche, Umgebungsgeräusche, Timing und Instrumentalmusik miteinander kombinieren. Unsere Tests ergaben ein ungewöhnlich hohes kreatives Potenzial – und ein Problem hinsichtlich der Wiederholbarkeit, das Sie nicht außer Acht lassen sollten.
Seed Audio 1.0 ist eines der ersten Audiomodelle, die ich getestet habe und bei denen man den Eindruck hat, dass sie eher auf eine komplette Szene als auf einen einzelnen Ausgabetyp ausgelegt sind. Es kann sprechen, schauspielern, Umgebungsgeräusche hinzufügen, Foley-Geräusche erzeugen, Dialoge auf einer Zeitachse platzieren und aus einer einzigen Eingabe Instrumentalmusik erzeugen.
Das kurze Fazit: Seed Audio 1.0 bietet ungewöhnlich viele Möglichkeiten für die einheitliche Audioerstellung, insbesondere für zeitlich abgestimmte Dialoge und filmische Tonszenen. Seine Schwäche liegt in der Wiederholbarkeit. Ein gelungener Durchlauf kann bemerkenswert vollständig klingen, während ein anderer Durchlauf mit derselben Eingabe möglicherweise verzerrte Sprache enthält, ein Ereignis auslässt oder die gewünschte Stimme ändert.
Ich habe mithilfe der Anywhere/BrolyAI-Testumgebung 23 bewertete Beispiele generiert. Zusammen deckten sie folgende Bereiche ab: Erzählung, Dialoge zwischen zwei Figuren, zeitgestempelte Sprache, reine Soundeffekt-Sequenzen, Szenen mit Gesang und Musik, eigenständige Musik, mehrsprachige Darbietungen, zweiminütige Monologe sowie die Fortsetzung von Referenz-Audioaufnahmen.
Seed Audio 1.0 Testbericht: Das kurze Fazit
| Kategorie | Ergebnis unserer Tests |
|---|---|
| Ausdrucksstarke Stimme | Hohe Qualität bei der besten Durchfahrt, bei den Wiederholungen jedoch uneinheitlich |
| Dialog mit mehreren Sprechern | Präzise Skripte und klare Sprechertrennung |
| Timing der Dialoge | Das zuverlässigste Merkmal in unserem Testset |
| Sound-Effekte | Realistische Raum- und Ereignisreihenfolge; Schwächen bei der exakten Zählung von Ereignissen |
| Sprache + Soundeffekte + Musik | Überzeugende, vollständige Szenen, in denen jedes gewünschte Ereignis eintritt |
| Eigenständige Musik | Leistungsfähiger als erwartet; erzeugte strukturierte 30-Sekunden-Signale |
| Mehrsprachige Sprachausgabe | Ein hervorragendes Best-Case-Szenario, aber bei einem der beiden Durchläufe wurde zusätzliche Sprache halluziniert |
| Zweiminütige Audioaufnahme | Eine ausgeprägte stimmliche Identität und narrative Kohärenz in beiden Durchgängen |
| Referenz-Audio | An unserem Teststandort unzuverlässig; die Stimmähnlichkeit war schlecht |
Am besten geeignet für: Kreative, die Hörspiele, Spielszenen, Podcast-Konzepte, filmische Prototypen und Audio-First-Storyboards erstellen.
Weniger geeignet für: Aufgaben, die eine deterministische Formulierung, die exakte Zählung wiederholter Ereignisse oder eine zuverlässige Stimmklonung aus einer unbeaufsichtigten Generierung erfordern.
Was ist Seed Audio 1.0?
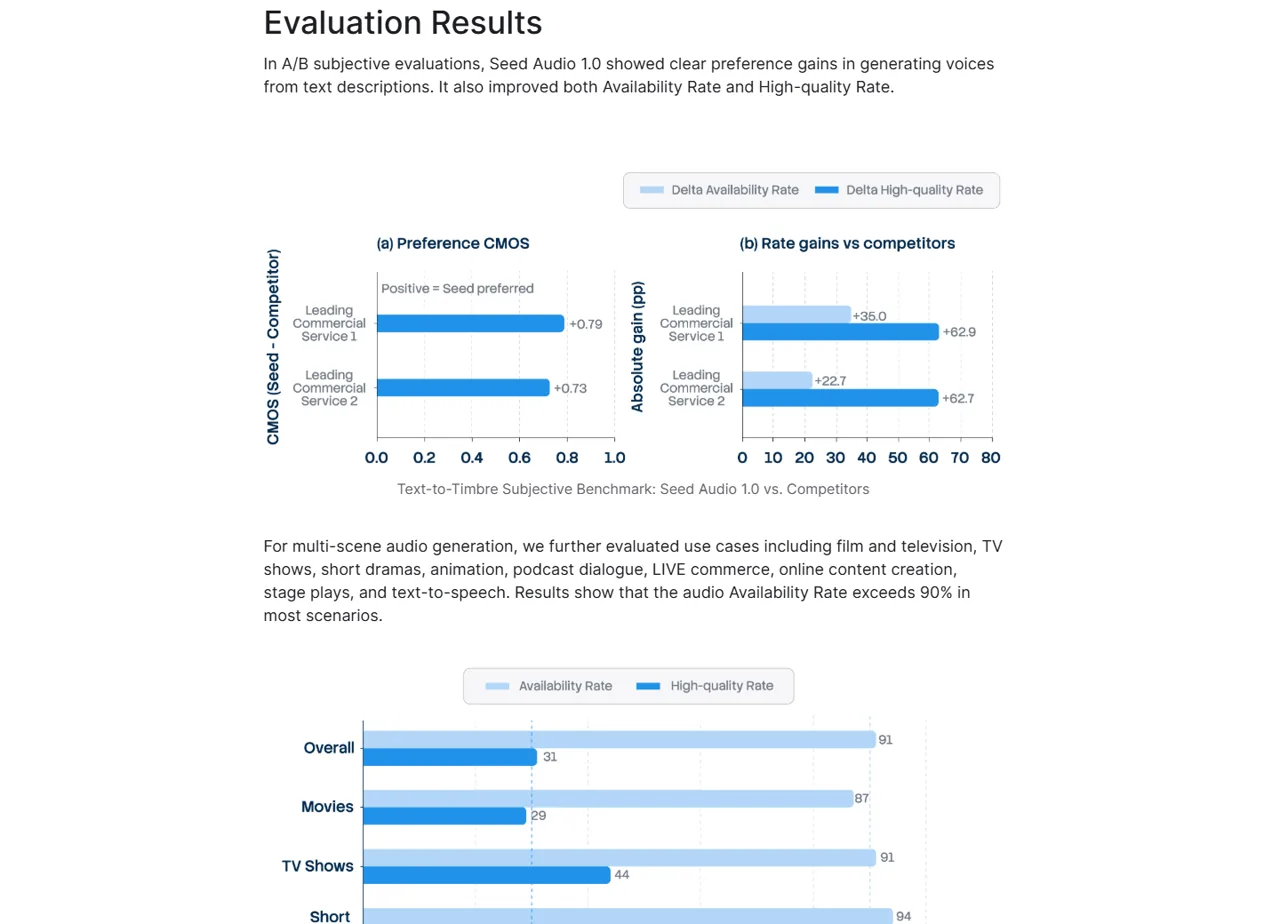
Seed Audio 1.0 ist das einheitliche Modell von ByteDance Seed zur Erstellung von Text-zu-Audio-Inhalten. Anstatt Sprache, Umgebungsgeräusche, Effekte und Musik als separate Aufgaben zu behandeln, kann es diese gemeinsam als eine einzige Klangszene generieren. Laut der offiziellen Produktseite unterstützt es Dialog-Timing in 100-Millisekunden-Intervallen und kann in einem Durchgang bis zu zwei Minuten generieren.
Dieses einheitliche Konzept ist der eigentliche Reiz. Eine Regieanweisung kann beschreiben, wer spricht, wie die Stimmen klingen, was im Raum geschieht, welche Effekte später hinzukommen und welche Art von Musik die Szene untermalt. Bei einer gelungenen Aufführung klingt das Ergebnis eher wie ein komponiertes Ganzes als wie ein Zusammenschnitt.
Es gibt jedoch eine wichtige Grenze. Laut der Roadmap von ByteDance konzentriert sich die fein abgestimmte zeitliche Abstimmung derzeit hauptsächlich auf die Dialoge der Figuren. Eine präzisere Steuerung von Soundeffekten, Umgebungsgeräuschen und Musik ist nach wie vor ein Bereich, in dem noch Entwicklungsbedarf besteht. Unsere Tests bestätigten diese Unterscheidung: Die zeitliche Abstimmung der Dialoge war hervorragend, während die exakte Zählung der Geräuscheffekte weniger zuverlässig war.
Offizielle Quellen, geprüft am 6. August 2026:
- Produktseite zu Seed Audio 1.0
- Einführung in ByteDance Seed
- BytePlus Audio 1.0 – API-Dokumentation
- Preise für BytePlus Audio 1.0
So haben wir Seed Audio 1.0 getestet
Wir haben neun Aufgaben entworfen und 23 bewertete Generationen durchgeführt. Bei den meisten Leistungsfähigkeitstests wurden zwei oder drei Wiederholungen durchgeführt, da eine einzige, optimierte Stichprobe nur sehr wenig über die Produktionszuverlässigkeit aussagt.
| Test | Aufgabe | Läufe |
|---|---|---|
| T01 | Ausdrucksstarke englische Erzählung | 3 |
| T02 | Funkdialog zwischen zwei Figuren | 3 |
| T03 | Dialog bei 0, 4 und 9 Sekunden | 3 |
| T04 | Flur-Sequenz ausschließlich mit Spezialeffekten | 2 |
| T05 | Stimmen, Umgebungsgeräusche, Soundeffekte und Musik | 3 |
| T06 | Instrumentalmusik als eigenständiges Werk | 3 |
| T07 | Ein Zeichen in Englisch, Japanisch und Deutsch | 2 |
| T08 | 120-Sekunden-Podcast-Monolog | 2 |
| T09 | Fortsetzung einer Referenzstimme | 2 |
Die 23 geplanten Ergebnisse umfassten etwa 12,5 Minuten generiertes Audiomaterial und wiesen in der Testumgebung Generierungskosten in Höhe von $1.7504 aus. Seed Audio lieferte keine Angaben zur Nutzung von Text-Tokens. Die Abrechnung erfolgte auf Basis der generierten Sekunden, daher werden Generierungstokens als „nicht zutreffend“ erfasst.
Alle ausgewerteten Ausgaben waren 40-kHz-, 16-Bit-, Stereo-PCM-WAV-Dateien. Wenn keine direkte automatisierte Wiedergabe möglich war, empfing Gemini 3.6 Flash die WAV-Dateien als Audioeingabe und lieferte strukturierte Transkripte, Ereignisprüfungen, Zeitangaben und Anmerkungen zu Artefakten zurück. Bei diesen Beurteilungen handelt es sich um automatisierte Hörbewertungen, nicht um menschliche MOS-Bewertungen.
Klangwiedergabe: beeindruckende Höhen, uneinheitliche Wiederholbarkeit
T01 · Ausdrucksstarke Erzählung
Hohe VarianzEin Durchgang klang überladen, ein anderer gekünstelt, und einer war natürlich und rund.
Verwendete Eingabeaufforderung
Eine ruhige weibliche Sprecherin spricht zwei präzise Sätze, wobei sie von Besorgnis zu Zuversicht übergeht. Keine Musik und keine Soundeffekte.Die Sprechanweisung sah vor, dass eine ruhige Sprecherin zwei genau festgelegte Sätze vortragen sollte, wobei sie von zurückhaltender Besorgnis zu wachsender Zuversicht übergehen sollte, und zwar ohne Hintergrundgeräusche.
Die drei Durchläufe verliefen sehr unterschiedlich:
- Lauf 1: sprach den gewünschten Satz, fuhr dann aber mit einer mehrere Sekunden langen, unverständlichen, nicht vorbereiteten Rede fort.
- Lauf 2: Er sprach den Text wortwörtlich nach, klang dabei jedoch langsam und abgehackt.
- Lauf 3: hat das gesamte Skript auf natürliche Weise vorgetragen, mit optimalem Tempo und einheitlicher Stimmführung.
Das ist das zentrale Muster dieser Rezension. Seed Audio 1.0 liefert zwar eine überzeugende Sprachausgabe, doch ein einziger Durchlauf reicht für textkritische Arbeiten nicht aus. Generieren Sie Alternativen und hören Sie sich den gesamten Text vor der Veröffentlichung an.
Das Modell hat die negativen Anweisungen in allen drei Erzähldurchläufen befolgt: Es wurden weder Musik noch Soundeffekte noch unerwünschte Hintergrundgeräusche erkannt.
Dialoge mit mehreren Sprechern und Sprecherunterscheidung
T02 · Hörspiel mit zwei Figuren
3/3 genaue SkripteAlle drei Drehbücher waren identisch. Die Dauer des Raumgeräuschs und der Einleitung variierte von Aufnahme zu Aufnahme.
Verwendete Eingabeaufforderung
Maya flüstert, Eli antwortet ruhig, und das Summen des Kühlschranks untermalt drei feststehende Dialogrunden.In unserer Convenience-Store-Szene kamen zwei erwachsene Figuren und drei festgelegte Dialoge zum Einsatz. Maya musste angespannt flüstern, während Eli versuchte, ruhig zu klingen. Als Hintergrundgeräusch war lediglich ein leises Brummen des Kühlschranks vorgesehen.
Bei allen drei Durchläufen wurden die Dialoge in der richtigen Reihenfolge mit zwei klar unterscheidbaren Stimmen wiedergegeben. Der beste Durchlauf zeichnete sich durch exakte Textwiedergabe, klare Sprecherunterscheidung, überzeugende Emotionalität und ein kontinuierliches Brummen des Kühlschranks aus.
Die anderen Durchläufe wiesen kleinere Probleme auf Szenebene auf. Bei einem wurde etwa die erste Hälfte der 30-sekündigen Dauer für Umgebungsgeräusche verwendet, bevor der Dialog begann. Bei einem anderen fehlte das gewünschte Brummen des Kühlschranks. Keiner dieser Fehler hat die gesprochene Szene ruiniert, aber beide beeinträchtigen die Effizienz beim Schnitt.
Was Hörspiele angeht, ist das praktische Ergebnis vielversprechend: Seed Audio versteht Charakterwechsel und stimmliche Kontraste. Möglicherweise müssen Sie jedoch noch lange Einleitungen kürzen oder die Aufnahme neu generieren, um den richtigen Raumklang zu erzielen.
Das beste Ergebnis wurde beim Timing der Dialoge erzielt
T03 · Zeitsteuerung auf Prompt-Ebene
Am zuverlässigstenBei allen drei Durchläufen lagen die Linien nahe an den gewünschten Punkten innerhalb der Zeitunsicherheit des Auswerters.
Verwendete Eingabeaufforderung
Setzen Sie drei Radiolinien bei 0,0, 4,0 und 9,0 Sekunden mit den Sprechern „Mann/Frau/Mann“ ein.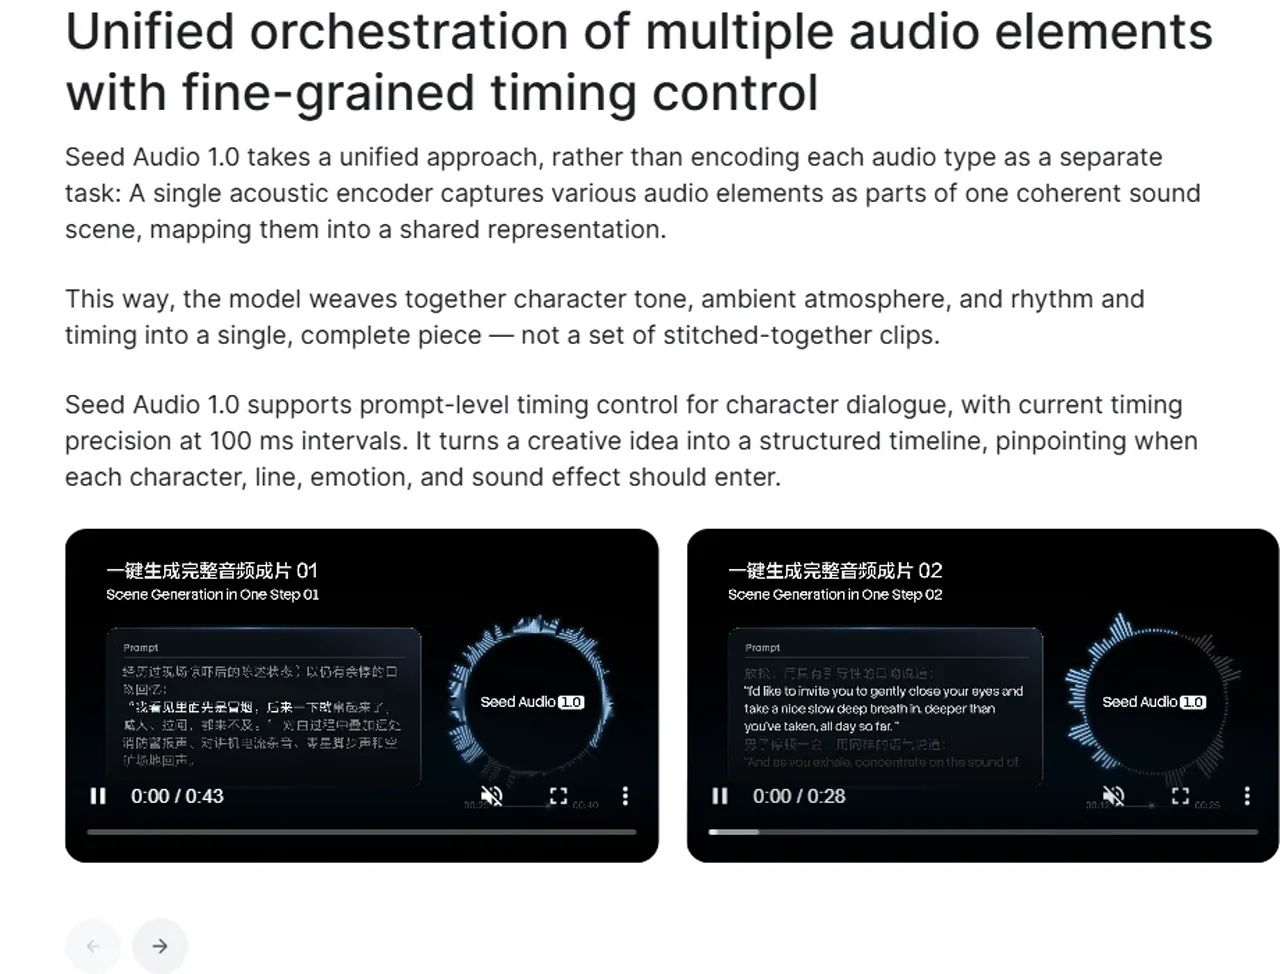
Für den Timing-Test wurden drei Funkverbindungen benötigt:
- “Einheit sieben, melden.” bei 0,0 Sekunden.
- “Nordeingang gesichert.” bei 4,0 Sekunden.
- “Position halten.” bei 9,0 Sekunden.
In allen drei Durchläufen waren die Zeilen, die Reihenfolge und das Muster „Mann-Frau-Mann“ bei den Sprechern korrekt. Die Audio-Schätzungen von Gemini ergaben für die Beginnzeitpunkte der wiederholten Durchläufe Werte von etwa 0,1, 4,0 und 9,0 Sekunden. Der erste Durchlauf wurde auf etwa 0,1, 3,9 und 8,9 Sekunden geschätzt.
Diese Messwerte sollten nicht als laborgenauer Nachweis einer Genauigkeit von 100 Millisekunden dargestellt werden – der Tester selbst gab eine Ungenauigkeit von etwa 0,1 Sekunden an. Selbst unter Berücksichtigung dieser Einschränkung war dies die wiederholbarste Funktion, die wir getestet haben. Wenn Sie Dialoge an Positionen einfügen müssen, die nahe an geplanten Zeitmarken liegen, ist Seed Audio 1.0 ungewöhnlich vielversprechend.
Erzeugung von Soundeffekten: realistische Szenen, ungenaue Zählung
T04 · Flur (nur Soundeffekte)
Zählung fehlgeschlagenDie Raumaufteilung und die Ordnung waren überzeugend, doch bei den beiden Durchläufen entstanden vier Fußabdrücke und zwei Fußabdrücke.
Verwendete Eingabeaufforderung
Schlüssel, eine schwere Tür, genau drei Schritte, ein Donnerschlag und ein letzter Knall. Keine Stimme, keine Musik.Die rein auf Soundeffekte beschränkte Regieanweisung beschrieb einen kleinen, gefliesten Flur: Schlüssel in der Nähe des Mikrofons, eine schwere Holztür, die sich öffnete, drei langsame Schritte, die sich entfernten, fernes Donnergrollen und ein abschließendes Zuschlagen der Tür. Sprache und Musik waren verboten.
Beide Ausgabevarianten schufen einen glaubwürdigen akustischen Raum, bewahrten die Abfolge der Ereignisse und verhinderten das Überlaufen von Stimmen oder Musik. Die Effekte wurden als realistisch bewertet und zeichneten sich durch eine gute räumliche Tiefe sowie eine gleichbleibende Raumcharakteristik aus.
Keiner der beiden Durchläufe entsprach genau der angegebenen Anzahl. Der eine ergab vier Schritte, der andere zwei. Damit eignet sich Seed Audio gut zur Erstellung eines überzeugenden Foley-Konzepts, ist jedoch weniger zuverlässig, wenn ein Cutter genau drei Aufprallgeräusche, Klopfgeräusche, Schritte oder Schüsse benötigt.
Am besten ist es, für die Atmosphäre und das schnelle Prototyping die SFX-Erzeugung in einem Durchgang zu nutzen und anschließend ereignisrelevante Passagen in einer DAW zu ersetzen oder zu bearbeiten.
Sprache, Umgebungsgeräusche, Soundeffekte und Musik in einer Szene
T05 · Komplette Film-Abmischung
zu 2/3 fertigBei zwei von drei Durchgängen wurde jeder Stoß erfolgreich ausgeführt. Bei einem Durchgang wurde der letzte metallische Schlag verfehlt.
Verwendete Eingabeaufforderung
Regen in der Gasse, Verkehr, Sirene, flüsternder Kommissar, Streichermelodie, schnelle Schritte und metallisches Knallen.
Der Test mit der kompletten Szene war bewusst überladen. Gefordert waren eine nasse Gasse bei Nacht, Wassertropfen, Verkehr, eine ertönende Polizeisirene, eine geflüsterte Detektivzeile, zurückhaltende Streichermusik, schnelle Schritte und ein metallisches Türenschlagen.
Bei zwei von drei Durchläufen war die gesamte Abfolge der Ereignisse enthalten. Die Dialoge waren trotz Umgebungsgeräuschen und Musik deutlich zu verstehen, und die Szene wirkte räumlich stimmig und nicht wie eine Aneinanderreihung zusammenhangloser Clips. Bei einem Durchlauf fehlte das abschließende metallische Knallen, obwohl ansonsten die richtige Atmosphäre und der genaue Dialog wiedergegeben wurden.
Hier überzeugt das einheitliche Modell am meisten. Beim Storyboarding und bei der kreativen Ideenfindung ist es schneller und ausdrucksstärker, eine komplette gemischte Szene aus einer einzigen Vorgabe zu generieren, als jede Komponente einzeln zu beschaffen. Bei der endgültigen Produktion müssen wichtige Endsignale jedoch noch überprüft werden.
Kann Seed Audio 1.0 Musik erzeugen?
T06 · Musik als eigenständiges Medium
MusikwerkeAlle drei schufen strukturierte Musik. Bei einem davon war das gedämpfte Klavier kaum zu erkennen.
Verwendete Eingabeaufforderung
Ein 72-BPM-Suspense-Cue mit Cello-Ostinato, gedämpftem Klavier, analogem Drone, Steigerungsphase und offenem Ende.
Ja. In unseren Tests erzeugte Seed Audio 1.0 erkennbare Instrumentalmusik für sich allein und nicht nur eine vage Ambient-Textur.
Die Vorgabe lautete: ein 30-sekündiger Spannungs-Cue bei 72 BPM mit einem tiefen Cello-Ostinato, gedämpften Klavierimpulsen, einem sanften analogen Drone, einem klaren Aufbau und einem unaufgelösten Schlussakkord. Alle drei Durchläufe bildeten einen zusammenhängenden musikalischen Cue mit dem gewünschten Tempo-Feeling und dem gewünschten Ende. Zwei davon enthielten alle gewünschten Elemente; in einem Durchgang war das gedämpfte Klavier jedoch schwer zu erkennen.
Das bedeutet jedoch nicht automatisch, dass Seed Audio einen dedizierten Song-Generator ersetzen kann. Unsere Aufgabe war ein kurzes instrumentales Filmstück, kein Song mit Strophe und Refrain sowie Text. Dennoch sind die musikalischen Möglichkeiten umfangreich genug, um Spielszenen, Trailer, Podcasts und Vorvisualisierungen zu untermalen – insbesondere dann, wenn die Musik in derselben Generationsphase mit Sprache und Sounddesign interagieren muss.
Mehrsprachige Leistung: im besten Fall hervorragend, im schlimmsten Fall schwach
T07 · Eine Stimme, drei Sprachen
1/2 sauberEin Durchlauf verlief einwandfrei; beim anderen kam es beim Sprachwechsel zu Wiederholungen und Sprachstörungen.
Verwendete Eingabeaufforderung
Eine weibliche Figur spricht Englisch, Japanisch und Deutsch mit derselben Selbstsicherheit und Gelassenheit.
Bei der mehrsprachigen Aufgabe wurde eine weibliche Figur gebeten, dieselbe Rolle im Aufnahmeraum auf Englisch, Japanisch und Deutsch zu sprechen. Zwei Durchgänge hinterließen gegensätzliche Eindrücke.
Der stärkere Durchlauf gab alle drei Sätze korrekt wieder, behielt denselben Sprachstil bei, blieb emotional ruhig und setzte klare Pausen ein. Der schwächere Durchlauf begann auf Englisch korrekt, wiederholte dann jedoch im japanischen Abschnitt die Sprache und produzierte Sprachfehler, wodurch der deutsche Anfang beeinträchtigt wurde. Die wahrgenommene sprachübergreifende Konsistenz des Sprachstils nahm stark ab.
Das bedeutet, dass Seed Audio 1.0 eine überzeugende mehrsprachige Charakterdarstellung erzielen kann, doch für diese Funktion sind mehrere Kandidaten und eine sprachgerechte Überprüfung erforderlich. Genehmigen Sie eine mehrsprachige Ausgabe nicht, indem Sie nur die erste Sprache überprüfen.
Erstellung innerhalb von zwei Minuten und Stabilität bei längeren Sprachaufnahmen
T08 · 120-Sekunden-Monolog
2/2 stabilBeide Dateien dauerten 120 Sekunden und wiesen eine gleichbleibende Sprachqualität auf. Bei einer gab es eine kurze Aussprachepanne.
Verwendete Eingabeaufforderung
Ein männlicher Podcast-Moderator erzählt eine strukturierte Geschichte über eine Wetterstation mit drei Entdeckungen und ohne Hintergrundinformationen.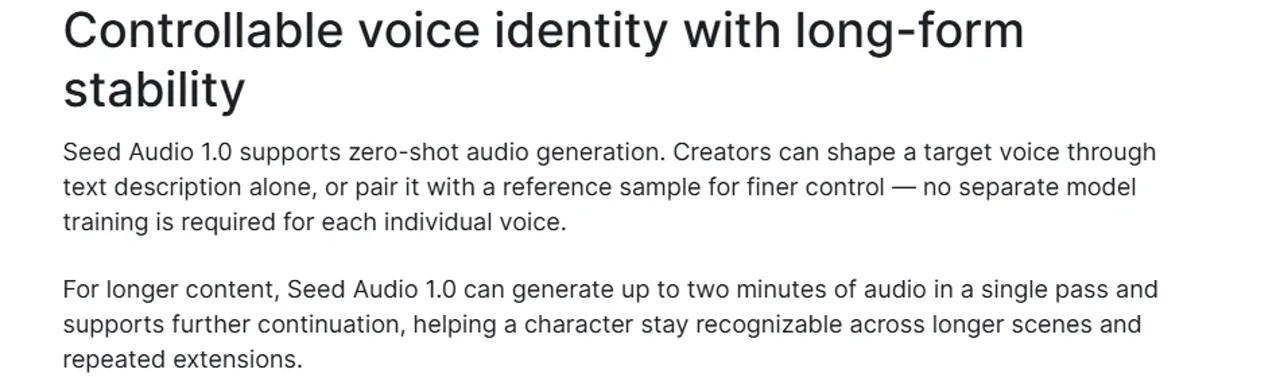
Beide Langform-Aufgaben ergaben WAV-Dateien mit einer Länge von genau 120 Sekunden. Bei beiden kam ein männlicher Podcast-Moderator mit nüchternem Studioklang zum Einsatz, ohne Musik und ohne Soundeffekte.
Der erste Durchlauf zeichnete sich durch eine durchgängig einheitliche Erzählstimme und eine schlüssige Ermittlungsstruktur aus: eine klare Einleitung, drei chronologisch geordnete Entdeckungen, ein Übergang von Neugier zu Unbehagen und eine abschließende, ungelöste Frage. Es wurden keine offensichtlichen Abweichungen in der Erzählstimme oder unverständliche Passagen festgestellt.
Der zweite Durchlauf war ähnlich stimmig und stabil, mit einem kurzen Aussprachefehler bei etwa 1:31. Das ist ein starkes Ergebnis für einen zweiminütigen Monolog in einem Durchgang. Es deutet darauf hin, dass die Behauptung von Seed Audio bezüglich der Langform nicht nur eine zeitliche Begrenzung ist; das Modell kann Identität und Erzählstruktur über den gesamten Zeitraum hinweg aufrechterhalten.
Bei der Kontinuität des Referenz-Audios ist Vorsicht geboten
T09 · Fortsetzung der Referenz
Route ungewissDer Text war korrekt, aber die Stimmähnlichkeit war schlecht; bei einer Ausgabe wurde die Stimme in eine Männerstimme geändert und mit Geräuscheffekten unterlegt.
Verwendete Eingabeaufforderung
An einer autorisierten weiblichen Referenzaufnahme anknüpfen und dabei die stimmliche Identität sowie den intimen Aufnahmestil beibehalten.Beim Referenztest wurde die aussagekräftigste Erzählprobe als Vorlage verwendet, und es wurde um eine Fortsetzung im gleichen allgemeinen Stil – aus der Perspektive einer Frau und im intimen Erzählstil – gebeten.
Beide Ausgaben gaben die gewünschte Fortsetzung zwar exakt wieder, entsprachen jedoch nicht gut dem Referenzbeispiel. Die erste ging in ein gehauchtes, leises Flüstern über und erhielt eine zurückhaltende Bewertung der Stimmähnlichkeit von 2/5. Bei der zweiten wurde festgestellt, dass eine männliche Stimme verwendet wurde; sie erhielt eine Ähnlichkeitsbewertung von 1/5 und fügte vor dem Sprechen etwa 17 Sekunden unerwünschte Geräuscheffekte hinzu.
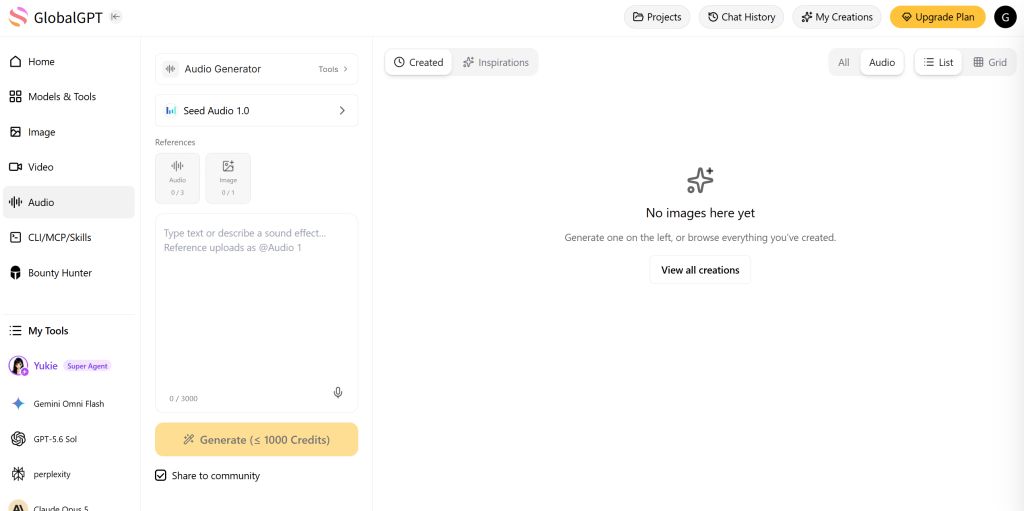
Hier gibt es eine wichtige Einschränkung hinsichtlich der Plattform. Der „Anywhere“-Task-Endpunkt hat das Referenzfeld zwar akzeptiert, aber keine Bestätigung zurückgegeben, aus der hervorgeht, wie das vorgelagerte Modell diese Referenz verarbeitet hat. Diese Ergebnisse belegen, dass die Referenzkontinuität über unseren Testpfad hinweg unzuverlässig war; sie beweisen jedoch nicht, dass sich die native API von BytePlus stets auf dieselbe Weise verhält.
Preise und Einschränkungen von Seed Audio 1.0
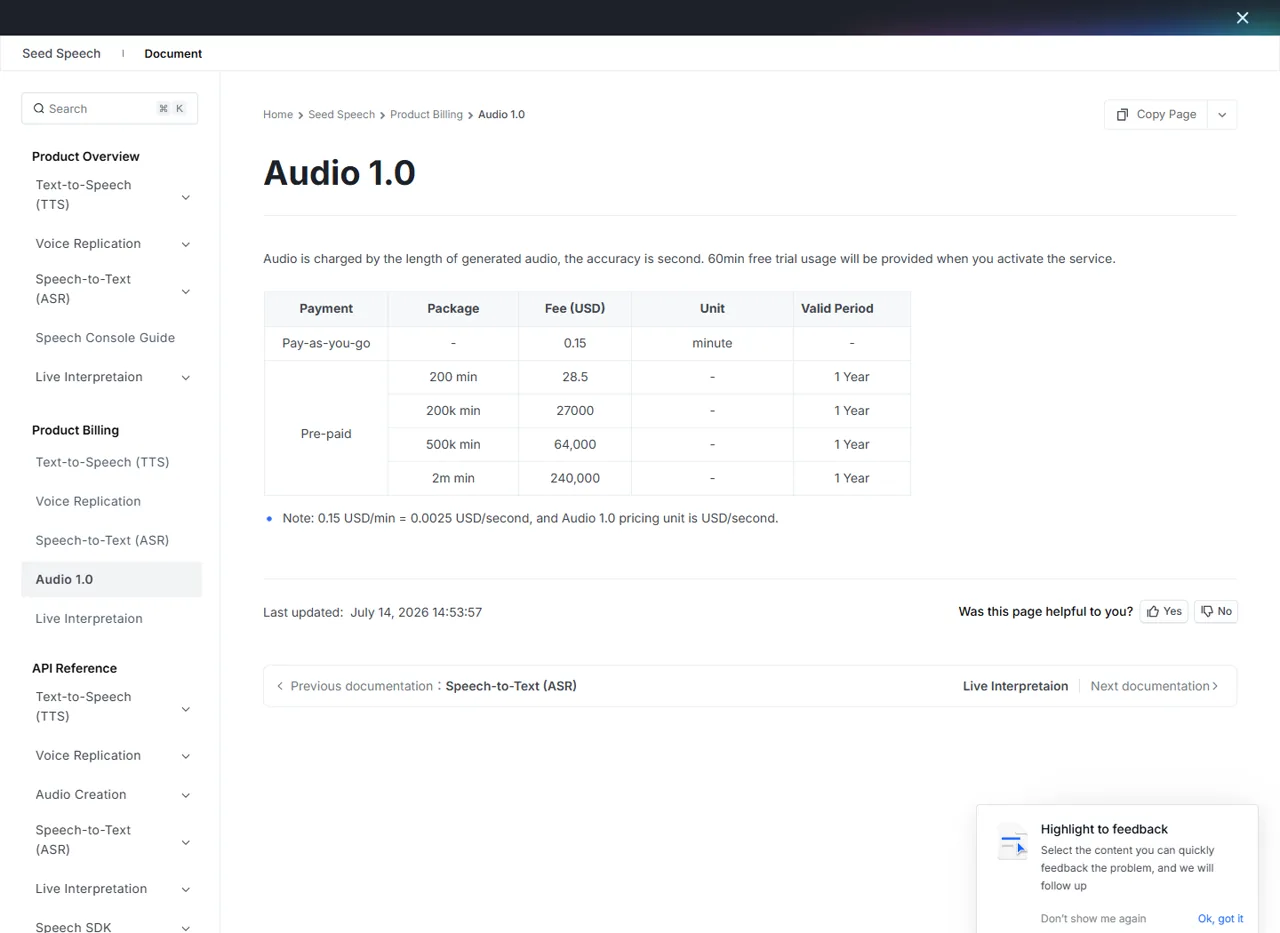
Die Abrechnung erfolgt sekundengenau, bei Aktivierung des Dienstes stehen 60 kostenlose Testminuten zur Verfügung.
maximale Leistung
Eingabeaufforderungszeichen
Audio-Referenzen
Referenzbild
BytePlus gibt den offiziellen Preis für die nutzungsabhängige Abrechnung mit an: $0,15 pro erzeugter Minute, sekundengenau abgerechnet, mit 60 kostenlose Testminuten wenn der Dienst aktiviert wird. In der API-Dokumentation wird ein Maximale Leistung für 120 Sekunden, unterstützt Eingabeaufforderungen bis zu 3.000 Zeichen, erlaubt bis zu drei Referenz-Audioclips, und akzeptiert ein Referenzbild.
Jeder Referenz-Audioclip darf maximal 30 Sekunden lang sein und 10 MB groß sein. Die Obergrenze für Referenzbilder liegt bei 10 MB. Dies sind die von BytePlus festgelegten Grenzwerte; Plattformen von Drittanbietern können ein kleineres Eingabeformular bereitstellen oder andere Preisgestaltung anwenden.
Unsere Testroute „Anywhere/BrolyAI“ wies die Upstream-Kosten separat aus; der Durchschnittswert lag bei etwa $0,14 pro generierter Minute. Dieses Feld aus der Testumgebung sollte nicht mit den Endkundenpreisen von BytePlus oder dem Endpreis einer anderen Plattform verwechselt werden.
Vor- und Nachteile von Seed Audio 1.0
Wo es punktet
- Gesang, Geräusche, Umgebungsgeräusche und Musik
- Hervorragendes Timing der Dialoge
- Ausgeprägte Identität in der Langform
- Passende Filmmusik
Wo es bricht
- Große Varianz zwischen den einzelnen Aufnahmen
- Gelegentlich unverständliche Sprache
- Exakte SFX-Zählung bei schwacher Wechselwirkung
- Unzuverlässige Durchgängigkeit der Referenzpunkte auf unserer Route
Profis
- Erzeugt Stimmen, Umgebungsgeräusche, Geräuscheffekte und Musik in einem Durchgang.
- Hervorragendes Timing der Dialoge in unseren wiederholten Tests.
- Deutliche Trennung der beiden Sprecher und präzise Umsetzung des Skripts.
- Erzeugt nützliche, eigenständige Filmmusik.
- Bewahrt über zwei Minuten hinweg die stimmliche Identität und die narrative Kohärenz.
- Gibt über unseren Testpfad ein klares 40-kHz-Stereo-WAV-Signal aus.
Nachteile
- Wiederholungsläufe können hinsichtlich ihrer Natürlichkeit und Zuverlässigkeit erheblich voneinander abweichen.
- Gelegentlich halluzinatorische oder unverständliche Sprache.
- Genaue Angaben zur Anzahl der Soundeffekte sind unzuverlässig.
- In einigen vollständigen Szenen fehlt ein abschließendes, angefordertes Ereignis.
- Die mehrsprachige Darstellung muss sorgfältig geprüft werden.
- Die Kontinuität der Referenzstimme war in unserer Testumgebung mangelhaft.
- Eine hohe Anzahl paralleler Einreichungen führte zu Fehlern bei der Upstream-Parallelität, wobei fehlgeschlagene Aufgaben jedoch nicht in Rechnung gestellt wurden.
Für wen ist Seed Audio 1.0 geeignet?
Seed Audio 1.0 eignet sich hervorragend für Audio-Kreative, die eher in Szenen als in einzelnen Elementen denken. Es ist besonders nützlich für Hörspiele, Spieledialoge, filmische Prototypen, Audio-Storyboards, Podcast-Konzepte und kurze Spannungssequenzen.
Als System für die endgültige Auslieferung mit nur einem Klick ist es weniger überzeugend. Wenn der genaue Wortlaut, die Stimmidentität oder die Anzahl der Ereignisse rechtlich oder kreativ entscheidend sind, sollten Sie wiederholte Erzeugungsdurchläufe und eine Überprüfung durch Menschen einplanen. Das Modell funktioniert am besten, wenn Sie es als schnellen Audio-Regisseur mit mehreren Takes betrachten – und nicht als deterministischen Renderer.
Häufig gestellte Fragen
Ist Seed Audio 1.0 ein Text-to-Speech-Modell?
Kann Seed Audio 1.0 Soundeffekte ohne Sprache erzeugen?
Kann Seed Audio 1.0 Musik erzeugen?
Wie lange kann Seed Audio 1.0 Daten generieren?
Unterstützt Seed Audio 1.0 Referenz-Audio?
Wie viel kostet Seed Audio 1.0?
Endgültiges Urteil
Seed Audio 1.0 ist ein wirklich interessantes einheitliches Audiomodell. Die Fähigkeit, anhand einer einzigen Eingabe überzeugende Sprache, Geräusche, Umgebungsgeräusche und Musik zu erzeugen, ist nicht nur ein Werbespruch zur Markteinführung: Unsere Tests mit gemischten Szenen und Musik haben gezeigt, dass die einzelnen Elemente gut zusammenwirken.
Die größte Stärke des Modells war das Timing der Dialoge. Seine größte Schwäche war die Konsistenz. Bei 23 Beispielen zeigte das Modell wiederholt einen hervorragenden Best-Case-Fall und eine deutlich schwächere alternative Variante.
Beim kreativen Prototyping lässt sich dieser Kompromiss leicht akzeptieren. Erstellen Sie mehrere Versionen, behalten Sie die überzeugendste Variante bei und prüfen Sie jedes Ende. Bei deterministischer Produktion, exakter Stimmabgleichung oder Arbeiten, bei denen die Anzahl der Ereignisse eine Rolle spielt, sollten Sie eine Phase der Überprüfung und Bearbeitung durch einen Menschen im Arbeitsablauf beibehalten.
Gesamtfazit: Seed Audio 1.0 ist einer der leistungsfähigsten Audio-Generatoren auf Szenenebene, die wir getestet haben, eignet sich jedoch am besten als kreatives Werkzeug für mehrere Durchgänge und weniger als Werkzeug für einen einmaligen endgültigen Rendering-Durchlauf.