Eine explorative GlobalGPT-Studie zu Aufgabenübertragung, Leistungsanforderungen und Benutzerkontrolle.
Datenquelle und Genehmigung: Diese Studie stützt sich auf Daten von Nutzern, die ihre Daten im August freiwillig an GlobalGPT weitergegeben und deren Verwendung für diese Untersuchung genehmigt haben. Die Beispiele wurden zum Schutz der Privatsphäre verallgemeinert. Genaue Gesamtzahlen zu Aktivitäten, Konten und Stichproben sowie Beobachtungsdaten werden nicht veröffentlicht.
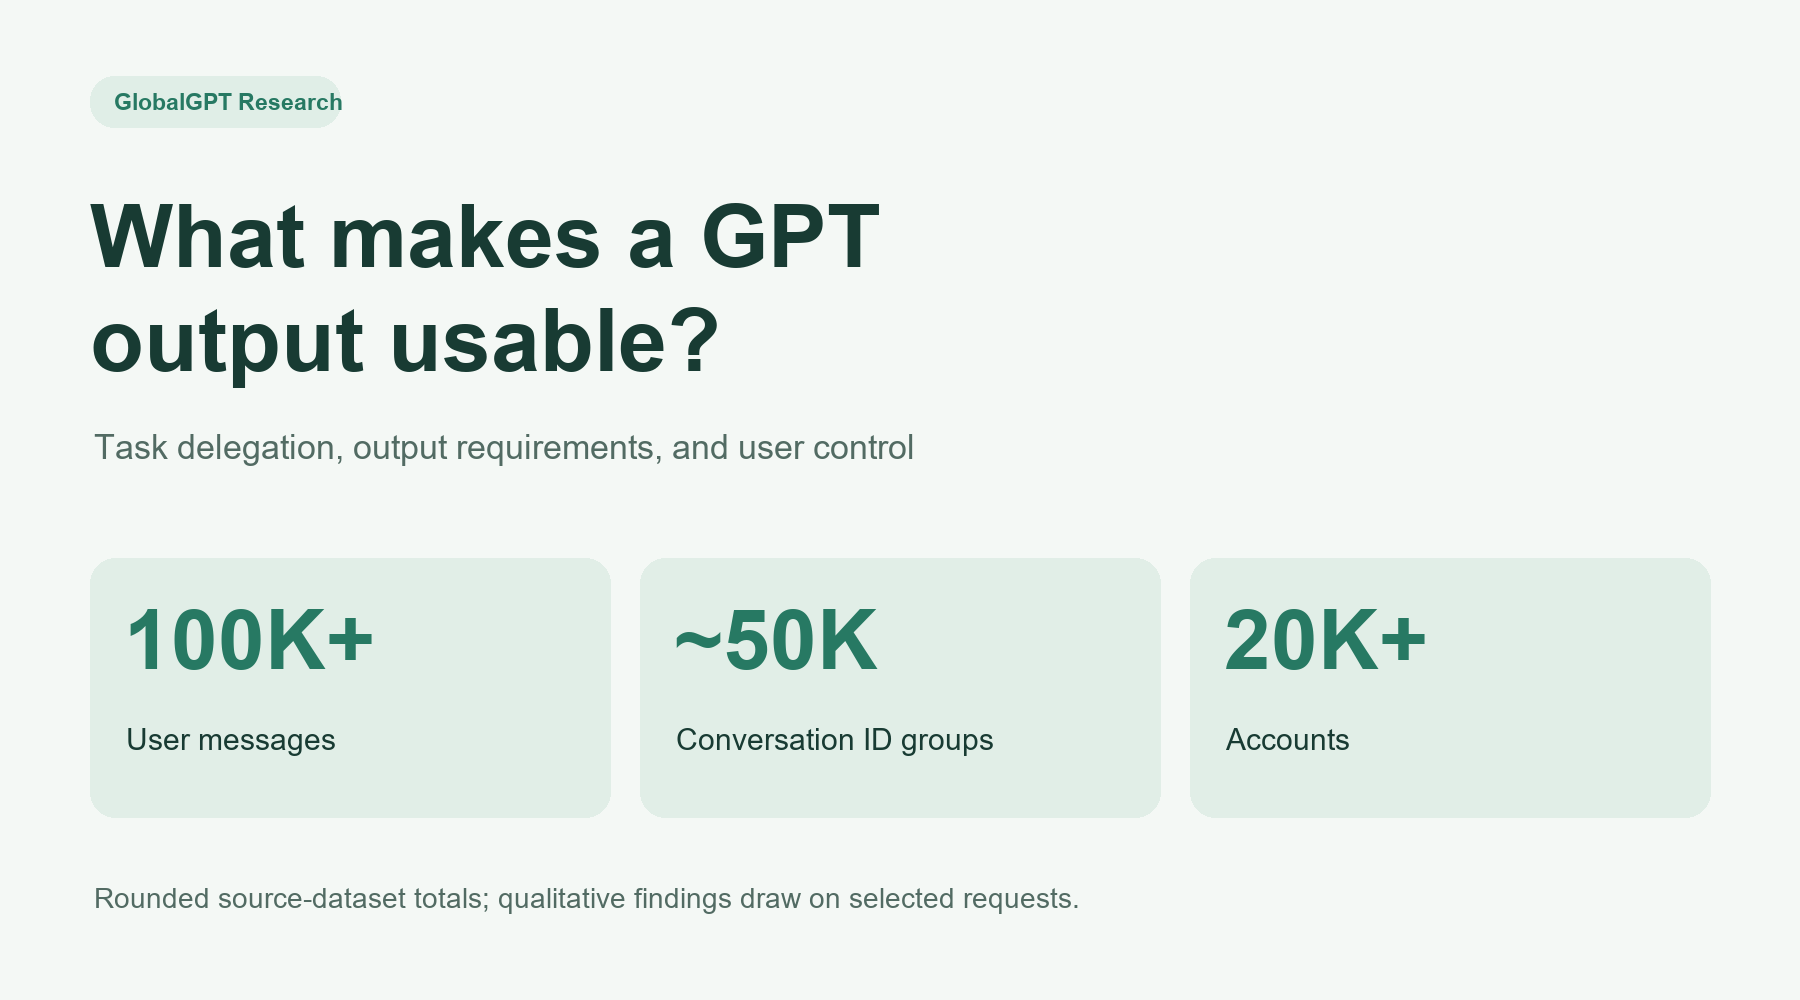
Studiendaten auf einen Blick: Über 100.000 Benutzernachrichten, etwa 50.000 Gruppen mit Konversationskennungen und über 20.000 Konten. Diese gerundeten Gesamtzahlen beziehen sich auf den Quelldatensatz und nicht auf die Anzahl der in der qualitativen Analyse untersuchten Anfragen.
Zusammenfassung
Hintergrund: Studien zur dialogorientierten KI unterscheiden zwischen den Themen, über die Menschen sprechen, und ihrer Absicht, Informationen zu erhalten oder Aufgaben zu delegieren. Delegierte Aufgaben können jedoch Anforderungen mit sich bringen, die über die Erstellung relevanter Inhalte hinausgehen: ein benutzerfreundliches Format, die Übereinstimmung mit dem bereitgestellten Material, Belege oder die Möglichkeit zur Überprüfung vor der Ausführung.
Forschungsfragen: Inwiefern legen Anforderungsunterlagen die Bedingungen fest, unter denen ein Ergebnis nutzbar wäre? Wie werden in Folgeanfragen die Anforderungen an die Lieferung und die Kontrolle zum Ausdruck gebracht? Welche Unterscheidungen werden durch rein themenbezogene Aufgabenbezeichnungen verschleiert?
Methoden: Die Studie stützt sich auf eine KI-gestützte qualitative Analyse ausgewählter Auszüge aus den Anfragen des autorisierten Materials. Tabellen zur Primäraufgabe, zur Diagnose und zur Nachverfolgung ermöglichten Vergleiche hinsichtlich der Ausgabeanforderungen, der Quellentreue, der Nachweise, der beibehaltenen Kontrolle und des Plattformzugangs. Die Tabellen wurden separat analysiert; die thematischen Ergebnisse beschreiben das untersuchte Material und nicht die Prävalenz in der Grundgesamtheit.
Ergebnisse: Die untersuchten Anfragen unterscheiden zwischen der Erstellung von Inhalten und der Bereitstellung eines nutzbaren Artefakts. Einige geben bearbeitbare oder herunterladbare Formate vor; andere beschränken Änderungen am Ausgangsmaterial, verlangen Nachweise oder behalten sich eine Überprüfung vor der Umsetzung vor. Fragen zur Plattformnavigation und Aufforderungen, die für andere Tools bestimmt sind, erschweren eine rein themenbezogene Beschreibung zusätzlich. Zu den gegensätzlichen Fällen gehören direkte Sachfragen, Beratungsanfragen ohne Ausführung sowie Eingaben mit unzureichendem Kontext.
Übersetzung: Die Delegation von Aufgaben und die Benutzerkontrolle können innerhalb derselben Anfrage nebeneinander bestehen. Die Ergebnisse sprechen für eine analytische Unterscheidung zwischen der angeforderten Operation und den an ihr Ergebnis geknüpften Bedingungen. Sie belegen jedoch weder die Häufigkeit dieser Muster noch eine erfolgreiche Umsetzung, einen geringeren Aufwand oder einen kausalen Effekt der Modellnutzung.
1. Einleitung
In diesem Bericht werden ausgewählte Abfragen aus freiwillig zur Verfügung gestellten, autorisierten GlobalGPT-Daten untersucht, um eine Frage zu klären, die sich allein anhand des Nutzungsvolumens nicht beantworten lässt: Was muss ein Nutzer tun, bevor ein von einer KI generiertes Ergebnis einsatzbereit ist?
Eine Anfrage zur Erläuterung einer Tabellenkalkulation und eine Anfrage zur Rückgabe einer bearbeitbaren Tabellenkalkulation können zwar denselben Gegenstand betreffen, jedoch unterschiedliche Arbeitsleistungen erfordern. Ebenso kann die Überarbeitung eines Dokuments bedeuten, dass dessen sprachlicher Ausdruck korrigiert wird, ohne die Sachverhalte zu ändern, oder dass eine neue Version frei erstellt wird. Beides lässt sich zwar als „Schreiben“ klassifizieren, doch unterscheiden sich die zulässige Rolle des Modells und die Akzeptanzkriterien des Nutzers.
Diese Studie untersucht, wie Nutzer die von GPT auszuführenden Aufgaben sowie die mit dem Ergebnis verbundenen Bedingungen formulieren. Vor dem Hintergrund der Forschung zur Mensch-Computer-Interaktion untersucht sie die Delegation von Aufgaben anhand der formulierten Anforderungen hinsichtlich Ergebnis, Genauigkeit, Nachweisbarkeit und Kontrolle.
In groß angelegten Nutzungsveranstudierungen wurde eine nützliche Unterscheidung zwischen Gesprächsthemen und Nutzerabsichten getroffen. Chatterji et al. unterscheiden in ihrer Studie zum Verbraucher ChatGPT zwischen „Fragen“, „Handeln“ und „Ausdrücken“ [1]. Dies wirft eine weitere Frage auf: Was bleibt dem Nutzer bei Aufforderungen, etwas zu tun, noch zu spezifizieren, zu prüfen oder zu autorisieren? Eine Ausgabe kann für ein Thema relevant sein, ohne dessen gefordertes Format zu erfüllen oder das Ausgangsmaterial wie angegeben beizubehalten.
GlobalGPT, eine Multi-Modell-KI-Abonnementplattform, bietet eine Umgebung, in der Anfragen sowohl eine externe Aufgabe als auch die Mittel zu deren Ausführung betreffen können. Die ausgewählten Datensätze umfassen Fragen zu Inhalten, Dateien, Modellfähigkeiten und dem Zugriff auf frühere Arbeiten. Es handelt sich hierbei um GPT-beschriftete Datensätze auf GlobalGPT, nicht um eine Stichprobe der Nutzer der offiziellen ChatGPT-Anwendung.
Wir stellen drei Fragen:
- RQ1 – Bedingungen für die Nutzbarkeit: Welche spezifischen Anforderungen stellen die geprüften Anfragen an die gewünschten Ergebnisse?
- RQ2 – Delegation und Kontrolle: Inwiefern legen Erstanträge und Folgeanträge die Erbringung, die Überarbeitung, den Nachweis sowie die Abgrenzung zwischen Beratung und Ausführung fest?
- RQ3 – Messung: Welche dieser Unterscheidungen gehen verloren, wenn Suchanfragen nur durch eine primäre Themenbezeichnung beschrieben werden?
Der Beitrag liefert einen Rahmen, um zu verstehen, wie Nutzer eine nutzbare KI-Ausgabe definieren. Durch die Trennung der angeforderten Operation von den Anforderungen an die Bereitstellung und der beibehaltenen Kontrolle identifiziert die Analyse Unterscheidungsmerkmale, die für die Gestaltung und Bewertung KI-gestützter Arbeit von Bedeutung sind.
2. Verwandte Arbeiten und analytische Ausrichtung
2.1 Thema, Zweck und wirtschaftliche Tätigkeit
Wie ChatGPT genutzt wird untersucht die beobachtete ChatGPT-Aktivität der Verbraucher anhand mehrerer Klassifizierungen [1]. Der primäre Klassifizierungsdatensatz umfasst Stichproben von Unterhaltungen sowie jeweils eine Nachricht aus jeder ausgewählten Unterhaltung, wobei die Stichprobengewichte angepasst wurden, um den schwankenden Häufigkeiten in der zugrunde liegenden Quelltabelle Rechnung zu tragen. Bei der Klassifizierung wird der vorangehende Kontex der Unterhaltung herangezogen, anstatt jede Kurznachricht als für sich stehend zu betrachten.
Der Artikel unterscheidet zwischen Thema und Absicht. „Fragen“ beziehen sich auf Informationen oder Ratschläge; „Ausführen“ bezieht sich auf die vom Modell erzeugten Ergebnisse; „Ausdrücken“ umfasst Äußerungen, die weder Informationsanfragen noch Aufgabenübertragungen sind. Eine technische Frage kann nach einer Erklärung oder nach funktionierendem Code fragen, während eine Schreibanfrage nach einem direkt wiederverwendbaren Entwurf fragen kann. Die Unterscheidung lässt sich daher nicht auf den Sachverhalt reduzieren.
In dieser Studie wird zudem zwischen groß angelegter Klassifizierung und Validierung unterschieden. In Anhang B werden Modellkennzeichnungen mit menschlichen Beurteilungen anhand öffentlich zugänglicher WildChat-Daten verglichen, Übereinstimmungsmaße angegeben und ein separater Entwicklungsdatensatz verwendet. Die Regressionsanalyse im Rahmen der demografischen Auswertung befasst sich mit Unterschieden, die mit gemessenen Merkmalen zusammenhängen. Diese Verfahren dienen der Beantwortung bestimmter Fragestellungen und sind auf bestimmte Datenstrukturen ausgerichtet; weder die große Stichprobe noch das Regressionsdesign lassen sich auf das vorliegende Datenpaket übertragen.
Unsere Frage betrifft die Anforderungen an delegierte Ergebnisse. Wir nutzen die Unterscheidung zwischen Information und Aktion als interpretativen Ausgangspunkt, ohne dabei die NBER-Klassifizierung anzuwenden oder eine gleichwertige Validierung zu beanspruchen. Die untersuchten Anfragen legen nahe, dass “Doing” näher beschrieben werden kann anhand dessen, was erhalten bleiben muss, wie ein Ergebnis bereitgestellt werden muss und wann der Nutzer es einsehen möchte.
2.2 Von der Kategorisierung zum Vergleich
Eine qualitative Analyse kann mehr leisten als nur eine Auflistung von Kategorien, indem sie die Anforderungen ähnlicher Anfragen vergleicht und Fälle untersucht, die eine Interpretation in Frage stellen. Gale et al. beschreiben den Nutzen des Vergleichs von Einzelfällen nach Kategorien, eines expliziten analytischen Rahmens und der Berücksichtigung widersprüchlicher Fälle [2]. Sie weisen zudem darauf hin, dass eine Matrix zweckmäßig ausgewähltes Material nicht automatisch statistisch repräsentativ macht.
Die vorliegende Analyse greift diese vergleichende Logik auf. Sie erhebt nicht den Anspruch, die Framework-Methode vollständig umzusetzen: Es gab weder ein multidisziplinäres Kodierungsteam noch eine erschöpfende Zeile-für-Zeile-Kodierung des gesamten Quelltextes oder eine unabhängige Bewertung durch qualitative Forscher. Das Material ist heterogen, und der Vergleich beschränkt sich auf ein gemeinsames Merkmal – explizite Anforderungen an ein KI-System. Wir bezeichnen das Verfahren als explorative qualitative Inhaltsanalyse, unterstützt durch eine thematische Evidenzmatrix.
2.3 Arbeitskonzepte
Aufgabenzuweisung bedeutet eine ausdrückliche Aufforderung an das System, eine Operation auszuführen oder ein Ergebnis zu liefern. Nutzungsbedingungen sind die für dieses Ergebnis festgelegten Anforderungen, wie beispielsweise Bearbeitbarkeit, Originaltreue, Belegbarkeit, Eignung für die Zielgruppe oder Bereitstellung. Beibehaltung der Beherrschung bezieht sich auf ausdrückliche Vorgaben dazu, was das System nun tun soll, einschließlich der Aufforderung, vor dem Fortfahren einen Plan oder Entwurf vorzulegen.
Diese Konzepte beschreiben den Wortlaut von Anfragen. Eine detaillierte Anweisung ist nicht automatisch ein Hinweis auf Misstrauen, Fachwissen, Frustration oder eine höhere Arbeitsbelastung. Die Bitte um eine Quelle ist kein Beweis dafür, dass die vorangegangene Antwort falsch war. Bei der Analyse werden diese möglichen Erklärungen von dem, was direkt zum Ausdruck gebracht wird, getrennt betrachtet.
3. Methoden
3.1 Aufbau und Datenquelle
Es handelt sich hierbei um eine retrospektive, explorative Analyse bestehender Datensätze von Nutzern, die ihre Daten im August freiwillig an GlobalGPT weitergegeben und deren Verwendung für diese Studie genehmigt haben. Der Monat August gibt an, wann die Nutzer die Daten zur Verfügung gestellt haben; er wird nicht als vollständiger Beobachtungszeitraum dargestellt. Für diese Auswertung wurden keine neuen Teilnehmer rekrutiert, keine Intervention zugewiesen und keine zusätzlichen Datenextraktionen aus der Datenbank durchgeführt.
Die bereitgestellte Extraktion umfasste nicht leere, nicht gelöschte Benutzer-Nachrichten-Zeilen mit nicht leeren Konversationskennungen und Modellbezeichnungen, die dem bereitgestellten GPT-Filter entsprachen. Routing, Berechtigung und vollständige Konversationsgrenzen wurden nicht unabhängig überprüft. Genaue Extraktionsdaten, Aktivitätensummen und Kontenzahlen werden zum Schutz wirtschaftlich sensibler Informationen nicht offengelegt.
Die qualitativen Ergebnisse stützen sich auf ausgewähltes Material aus der Auswertung. Die Auswertung stellt keine Einzelanalyse aller extrahierten Datensätze dar, und die autorisierten Mitwirkenden werden nicht als repräsentative Stichprobe aller Plattformnutzer betrachtet.
3.2 Verfügbares Lernmaterial und Lerneinheiten
| Material | Verwendung in dieser Analyse |
|---|---|
| Übersichtstabelle zu den Hauptaufgaben | Intent-Review und explorative Neukodierung von Restkategorien |
| Tabelle zur diagnostischen Überprüfung | Vergleich von Ausgabebedingungen, expliziter Steuerung und Gegenbeispielen |
| Tabelle zur Nachprüfung | Überprüfung von Auszügen aus dem ursprünglichen und den nachfolgenden Anträgen |
| Tabellen mit aggregierten Ergebnissen | Interne Auswertungen; genaue Zahlen werden nicht veröffentlicht |
Die Diagnosetabelle enthält unklare Bezeichnungen und inhaltliche Aufgabenkategorien. Ihre Zusammensetzung steht nicht im Verhältnis zur Datenextraktion. Der Schwerpunkt der Auswahl lag auf unklaren Klassifizierungen, und es wurden keine Einbeziehungswahrscheinlichkeiten festgelegt.
Einige Anfangstexte tauchen in den verschiedenen AuswertungsTabellen wiederholt auf. Identische Texte bedeuten zwar nicht, dass es sich um dieselben Nutzer oder dieselben Unterhaltungen handelt, verhindern jedoch, dass die Tabellen als nachweislich unabhängige, sich gegenseitig bestätigende Stichproben betrachtet werden können. Ihre Nenner werden nicht zusammengefasst, und neu kodierte Anteile werden nicht auf die Extraktion hochgerechnet.
Die qualitative Einheit ist eine identifizierbare Anfrage innerhalb eines geprüften Feldes oder eines Auszugs aus der Nachverfolgung. Eine gespeicherte Zeile kann eingefügte Dokumente oder eingebettete Verlaufsdaten enthalten; sie stellt nicht automatisch einen natürlichen Gesprächswechsel dar. Die genauen Größen der Überprüfungstabellen werden nicht öffentlich bekannt gegeben, was eine externe Bewertung des Umfangs der Analyse einschränkt.
3.3 Verfahren zur Ablesung und Auswertung
Bei der ersten Überprüfung wurden aussagekräftige Einträge aus der Tabelle „Primäraufgaben“ sowie ausgewählte Endungen langer oder mehrdeutiger Felder untersucht. Datensätze, die zuvor als „Sonstiges“ gekennzeichnet waren, wurden explorativen Kategorien zugeordnet. Erste und nachfolgende Auszüge aus der Folgetabelle wurden auf zum Ausdruck gebrachte Verhaltensweisen hin untersucht, ohne deren Häufigkeit zu schätzen.
Bei der anschließenden Überprüfung wurden die Einträge und – bei längeren Feldern – die Enden der gesamten Diagnosetabelle geprüft. Durch die Kürzung der Ausgabe verdeckte Inhalte wurden erneut gelesen. Dabei handelte es sich um eine Überprüfung der für die Aufgabe relevanten Auszüge und nicht um eine vollständige Lektüre aller eingebetteten Verträge, Forschungsabschnitte, Biografien oder Code-Verläufe. Die referenzierten Anhänge und externen Links wurden nicht geöffnet.
Das Vergleichsrahmenwerk unterschied zwischen Eingabematerial, angeforderter Operation, Ausgabeform, Akzeptanzbedingungen, beibehaltener Kontrolle und Plattformzugang. Es wurde nach Auswertung der Daten und unter Berücksichtigung der Fachliteratur entwickelt; eine Vorregistrierung erfolgte nicht. Die ursprünglichen Klassifikationsbezeichnungen blieben sichtbar.
Die Analyse verglich gegensätzliche Formen: direkte Wiedergabe versus Erklärung; Beibehaltung versus freie Bearbeitung; sofortige Umsetzung versus vorherige Planung; externe Aufgabenanforderungen versus Navigation auf der Plattform. Mehrdeutige Quelltextstellen, Begrüßungen, Anweisungen mit festgelegten Antworten und eingebettetes Rollenmaterial wurden als Interpretationsgrenzen beibehalten, anstatt sie in inhaltliche Kategorien zu zwängen.
Die Überprüfung und Auswertung wurden von einem einzigen KI-Assistenten durchgeführt. Es gab keine unabhängigen menschlichen Kodierer, keine verblindeten Kennzeichnungen, keine Schlichtung und keine nachgewiesene thematische Sättigung. Die konzeptionellen Dimensionen wurden nicht jeder Zeile erschöpfend als binäre Kennzeichnungen zugeordnet. Die Ergebnismatrix beschreibt Muster und Gegenbeispiele, nicht Prävalenz- oder Ko-Auftrittsraten.
3.4 Deskriptive und statistische Analyse
Aggregierte Berechnungen und vorläufige Kategoriehäufigkeiten wurden intern überprüft. Genaue Zahlen, Prozentsätze, Durchschnittswerte und die Länge der Beobachtungszeiträume werden nicht veröffentlicht, da sie geschäftlich sensible Größenordnungen offenlegen könnten. Der öffentliche Bericht enthält gerundete Gesamtwerte aus dem Quelldatensatz sowie qualitative Vergleiche. Er enthält keine hochgerechneten oder gerundeten Schätzungen der Kategoriehäufigkeiten.
Bei der Neukodierung nach Primäraufgaben wurde jedem untersuchten Restdatensatz eine explorative Kategorie zugewiesen. Es handelte sich um eine Bestandsaufnahme einer ausgewählten Teilmenge, nicht um eine stichprobengewichtete Schätzung der Gesamtpopulation. Die Struktur der gespeicherten Zeilen und die Grenzen der Datenextraktion verhindern zudem, dass interne Gruppenzusammenfassungen als Wahrscheinlichkeiten für die Fortsetzung abgeschlossener Gespräche oder als natürliche Gesprächsrundenlängen behandelt werden können.
Es wurden keine Hypothesentests, Regressionen, Konfidenzintervalle für Grundgesamtheiten oder Übergangswahrscheinlichkeiten berechnet. Unbekannte Einbeziehungswahrscheinlichkeiten, Textwiederholungen, unvollständige Verknüpfungen zwischen den Dialogen und nicht validierte Bezeichnungen schränken die statistische Schlussfolgerung ein. Ein erneutes Stichprobenverfahren für ausgewählte Zeilen würde den Auswahlprozess nicht korrigieren. Es wird keine Statistik zur Übereinstimmung zwischen den Bewertern angegeben, da keine unabhängigen Bewertungen vorlagen.
3.5 Privatsphäre und Reflexivität
Der Bericht stützt sich auf allgemeine Beschreibungen und verzichtet auf private Zitate, spezifische Lebensgeschichten, Kontokennungen oder Kontaktdaten. Hinweise auf persönliche Umstände werden nicht als verifizierte Identitäten oder Merkmale gewertet. Aus der Sprache oder dem Inhalt der Nachrichten werden keine demografischen Profile abgeleitet.
GlobalGPT betreibt die Quellplattform und hat ein wirtschaftliches Interesse an deren Nutzung. Der Bericht entstand im Rahmen einer inhaltlichen Untersuchung, wodurch das Risiko besteht, dass attraktive Geschichten über Produktivität oder Nachfrage bevorzugt behandelt werden. Um diese Interpretation einzuschränken, umfasst die Analyse auch gegensätzliche Fälle und setzt eine Anfrage nicht mit einer erfolgreichen Umsetzung gleich. Die Zustimmung der Nutzer zur Weitergabe von Daten stellt weder eine unabhängige ethische Überprüfung noch eine Validierung der Analyse durch Menschen dar; beides wird hier nicht beansprucht.
4. Ergebnisse
4.1 Forschungsfrage 1: Ein brauchbares Ergebnis kann mehr als nur relevante Inhalte erfordern
Manche Anfragen beziehen sich nicht nur auf eine Antwort, sondern auch auf ein bestimmtes Artefakt. Dabei wird um ein bearbeitbares Arbeitsblatt, eine Präsentation, ein herunterladbares Bild oder ein Dokument gebeten, das für einen nachfolgenden Produktionsschritt geeignet ist. In diesen Fällen sind Inhalt und Bereitstellungsformat getrennte Anforderungen. Eine Erklärung, wie eine Datei erstellt wird, würde für sich genommen nicht der geäußerten Anfrage nach Erhalt dieser Datei entsprechen.
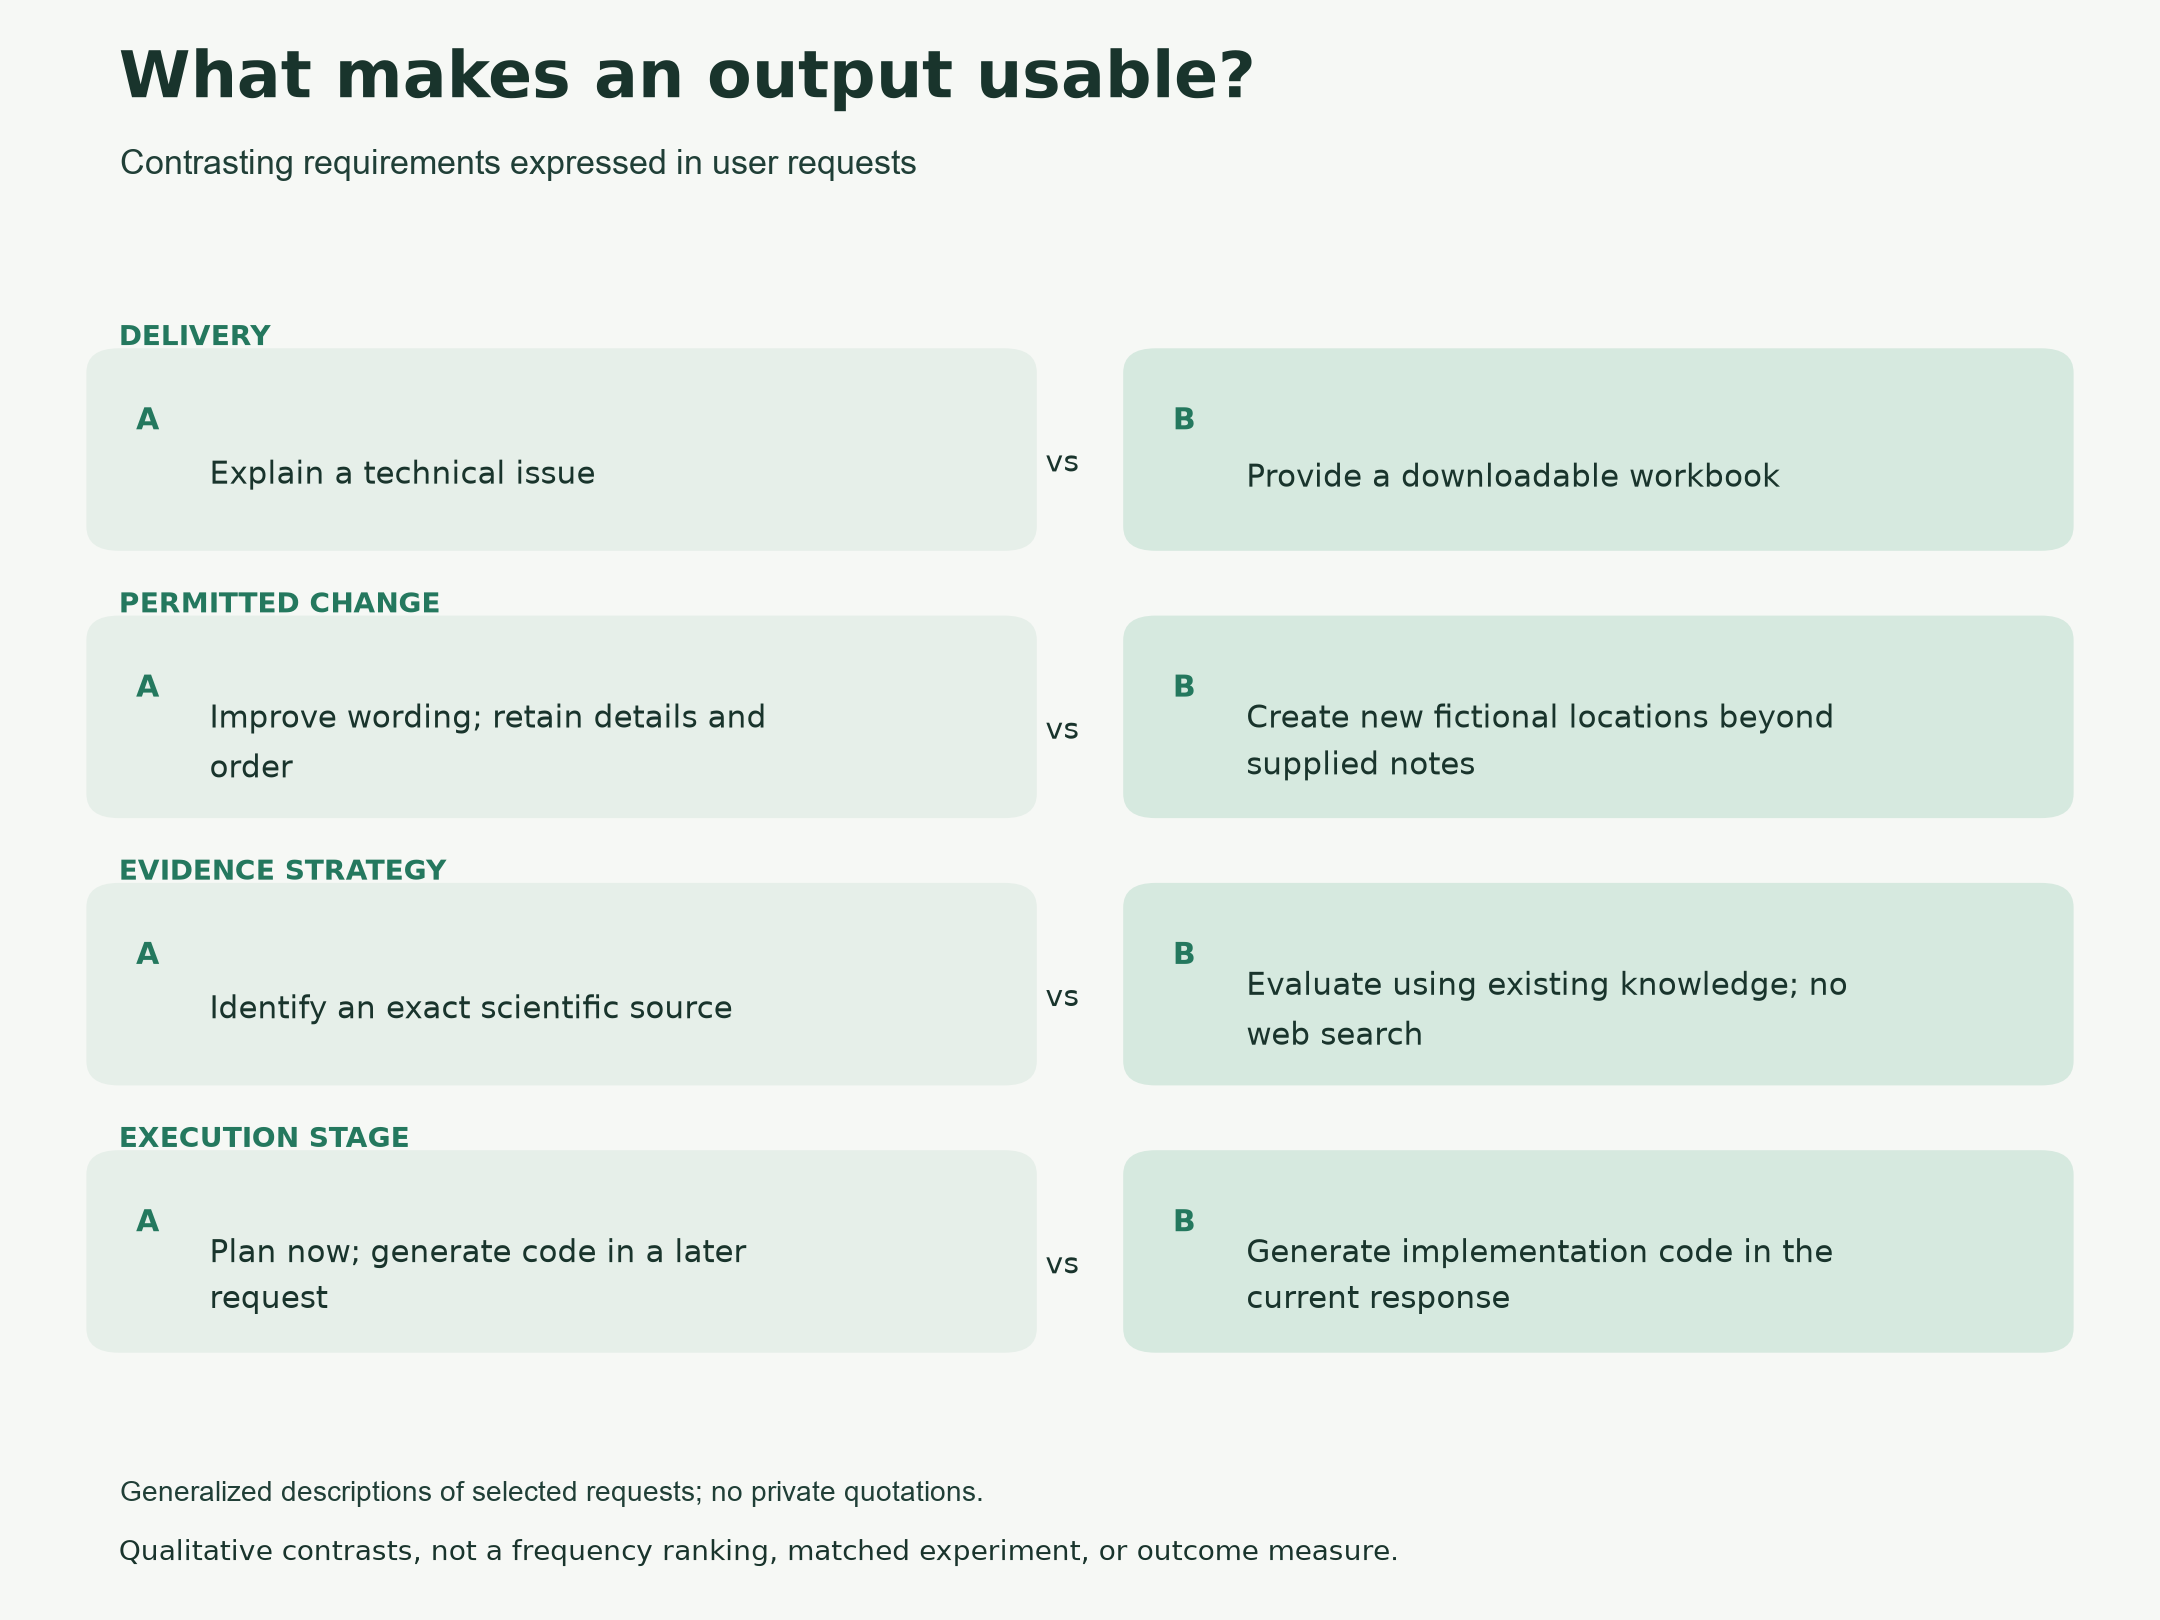
Die folgenden Vergleiche stellen ausgewählte Anfragen in eigenen Worten dar, um Unterschiede in den angegebenen Anforderungen zu veranschaulichen; es handelt sich dabei weder um wörtliche Zitate noch um Schätzungen der Häufigkeit. Jedes „A“ und „B“ beschreibt einen Quelldatensatz. Die Gegenüberstellungen vergleichen die Aufgabenbedingungen verschiedener Anfragen miteinander, nicht jedoch übereinstimmende Experimente oder Veränderungen innerhalb desselben Nutzers.
Vergleich 1 – Ein technisches Problem erläutern und eine Datei übergeben.
Anfrage A – allgemein: Ein Nutzer fragt, ob die Konvertierung zwischen Zahlenformaten zu einem Unterlauf führen kann. Das angegebene Ziel ist eine technische Erklärung; es wird keine Datei angefordert. Anfrage B – allgemein: Ein anderer Nutzer stellt Code zum Erstellen einer Arbeitsmappe zur Verfügung und bittet um eine daraus erstellte, herunterladbare Tabelle. Der gewünschte Endpunkt ist die Datei, nicht eine Erläuterung des bereitgestellten Codes.
Der Unterschied betrifft die Bereitstellung: A kann im Rahmen einer textlichen Antwort behandelt werden, während B ausdrücklich ein Artefakt erfordert, das der Benutzer erhalten kann. Trotz ihrer unterschiedlichen Themen untermauert dieses Beispielpaar die in RQ1 getroffene Unterscheidung zwischen der Beantwortung einer inhaltlichen Frage und der Erfüllung einer Anforderung hinsichtlich des Ausgabeformats. Es lässt sich daraus jedoch nicht ableiten, dass die Tabellenkalkulation erstellt oder heruntergeladen wurde oder dass eine der beiden Antworten den Bedürfnissen des Nutzers entsprach.
Andere Anforderungen knüpfen Bedingungen an die Umformung. Sie verlangen eine sprachliche Verbesserung, während Fakten, Details oder die Reihenfolge der Erläuterungen unverändert bleiben. Das Ausgangsmaterial dient daher nicht nur als Hintergrund: Es kann eine Grenze für zulässige Änderungen vorgeben. Eine Themenbezeichnung wie „Schreiben“ lässt diese Grenze nicht erkennen.
Vergleich 2 – Die Bewahrung eines Dokuments und die Erweiterung eines fiktionalen Schauplatzes.
Anfrage A – allgemein: Ein Nutzer bittet um grammatikalische und stilistische Verbesserungen an einem vorgelegten Bericht, wobei die Einzelheiten und die Reihenfolge der Erläuterungen beibehalten werden sollen. Anfrage B – allgemein: Ein Nutzer stellt fiktionale Notizen zur Weltgestaltung zur Verfügung und bittet um weitere Schauplätze mit kurzen Beschreibungen, wobei er ausdrücklich zu Ideen einlädt, die über die bereitgestellten Hintergrundinformationen hinausgehen, diese aber dennoch im Einklang mit dem Setting stehen sollen.
Bei beiden Aufgaben geht es darum, aus vorhandenem Material einen Text zu erstellen, doch die Quelle dient unterschiedlichen Zwecken. Bei A stellt der beibehaltene Inhalt eine Einschränkung für die Überarbeitung dar; bei B wird der vorgegebene Rahmen als Ausgangspunkt für neue Ideen betrachtet. Dies stützt die Forschungsfragen RQ1 und RQ3: Eine Schreibvorgabe allein beschreibt nicht den zulässigen Grad an Änderungen. Der Vergleich überprüft weder die sachlichen Behauptungen des Berichts noch zeigt er, dass eines der beiden Ergebnisse die Vorgaben eingehalten hat; die kreative Freiheit bei B beschränkt sich weiterhin auf fiktionale Ergänzungen.
„Belege“ ist eine weitere angeforderte Eigenschaft. Manche Datensätze erfordern einen genauen Verweis, verlangen die Überprüfung sachlicher Aussagen oder erfordern die Unterscheidung zwischen Unsicherheiten und gesicherten Informationen. Dies sagt nichts darüber aus, ob die resultierende Antwort zuverlässig war. Es zeigt lediglich, dass der Nutzer Belege ausdrücklich als Teil des angeforderten Ergebnisses festgelegt hat.
Vergleich 3 – Identifizierung einer Quelle und Einschränkung der externen Suche.
Anfrage A – allgemein: Ein Nutzer fragt nach der genauen wissenschaftlichen Quellenangabe zu einer angehängten Abbildung, formatiert als akademisches Zitat. Anfrage B – allgemein: Ein anderer Nutzer bittet um einen prägnanten technischen Vergleich von Materialien unter Verwendung des vorhandenen Wissens des Modells und schließt die Suche im Internet ausdrücklich aus, um Credits zu sparen.
Der Unterschied liegt in den Anforderungen an die Quellenangabe und den zulässigen Antwortmöglichkeiten. A verlangt eine identifizierbare Quelle; B schränkt das Heranziehen externer Quellen ausdrücklich ein. A schreibt kein verbindliches Suchverfahren vor, und die Einschränkung bei B hebt die Notwendigkeit der Genauigkeit nicht auf. Zusammen stützen sie die in RQ1 vertretene Auffassung, dass die Strategie zur Nachweiserhebung aufgabenspezifisch ist. Die Abbildung und die ausgefüllten Antworten wurden hier nicht bewertet, sodass weder eine erfolgreiche Quellenidentifizierung noch eine zuverlässige technische Beratung nachgewiesen werden kann.
Die gegensätzlichen Fälle sind von Bedeutung. Eine direkte Sachfrage muss nicht unbedingt auf eine bestimmte Akte Bezug nehmen. Manche Anfragen zielen auf eine Beurteilung oder eine Erklärung ab, und bei einer der untersuchten Arten ist die externe Recherche ausdrücklich eingeschränkt. Die Ergebnisse sprechen daher für vielfältige Formen der Nutzbarkeit und nicht für eine allgemeine Präferenz für die Erstellung von Artefakten oder für maximale Recherche.
4.2 Forschungsfrage 2: Durch Delegation kann eine explizite Ausführungsgrenze beibehalten werden
Zu den Anforderungen gehören die Forderung nach einem Entwurf vor der Ausarbeitung der endgültigen Fassung, nach einer ersten Version vor der Erstellung einer präsentationsreifen Zusammenfassung sowie nach einer Empfehlung, in welchem Umfang ein Prozess automatisiert werden sollte. Diese Anforderungen delegieren einen Teil der Arbeit, während eine Entscheidung darüber erst zu einem späteren Zeitpunkt getroffen wird. In anderen Unterlagen wird hingegen die direkte Umsetzung oder die sofortige Lieferung eines vollständigen Ergebnisses gefordert.
Vergleich 4 – Jetzt planen und jetzt Code erstellen.
Anfrage A – allgemein: Ein Nutzer beschreibt ein Softwareprojekt, fordert das System jedoch ausdrücklich auf, sich bei der aktuellen Antwort auf die Recherche und die Umsetzungsplanung zu konzentrieren und die Codegenerierung für eine spätere Eingabe zu reservieren. Anfrage B – allgemein: Ein anderer Nutzer bittet um den Quellcode zur Implementierung einer bestimmten automatisierten Routine mit konfigurierbaren Einstellungen und Betriebsregeln.
Beide betreffen die Softwareentwicklung, doch ihre aktuellen Ausführungsgrenzen unterscheiden sich. A definiert ein zukünftiges Implementierungsziel und beschränkt die gegenwärtige Aufgabe auf die Planung; B fordert die Implementierung in der aktuellen Antwort. Dies stützt RQ2: Die Delegierung eines Projekts autorisiert nicht automatisch jeden nachfolgenden Schritt auf einmal. Das Paar belegt nicht, dass die spätere Programmierphase von A stattgefunden hat, dass das Programm von B funktioniert hat oder dass die Planung zunächst zu besseren Ergebnissen geführt hat. Es handelt sich um separate Anforderungen, nicht um eine beobachtete Vorher-Nachher-Abfolge.
Dieser Kontrast relativiert eine einfache Unterscheidung zwischen „Anfordern“ und „Ausführen“. Eine Anforderung kann sich zwar auf die spätere Ausführung beziehen, während das System jedoch aufgefordert wird, bereits jetzt in einer Zwischenphase anzuhalten. Würde man dies als uneingeschränkte Ausführung betrachten, würde man eine ausdrücklich festgelegte Kontrollgrenze übersehen.
Ausfolgende Auszüge eröffnen eine weitere Perspektive. Nutzer bitten um eine andere Formulierung, liefern fehlenden Kontext, wünschen ein anderes Format, suchen nach Quellenlinks oder fragen, wie sie auf ein Ergebnis zugreifen können. Dies sind unterschiedliche Interaktionsanforderungen. Sie können nicht alle als Fehlerbehebung kodiert werden: Eine neue Anforderung kann eine Präzisierung der Aufgabe sein und nicht unbedingt eine Reaktion auf einen Fehler.
Auch lassen sich anhand dieser Auszüge keine allgemeingültige Abfolge von der Anfrage über den Entwurf bis hin zur endgültigen Akte feststellen. Das Paket enthält keine vollständige, unabhängig überprüfte Historie der Antworten. Wir sehen Antragsformulare und einige lokale Folgemaßnahmen, jedoch kein allgemeines Prozessmodell oder Übergangswahrscheinlichkeiten.
4.3 Forschungsfrage 2: Einige Arbeiten befassen sich mit dem Zugriff auf und dem Austausch zwischen Tools
In einigen Nachrichten wird gefragt, wo sich frühere Arbeiten befinden, wie Material hochgeladen werden kann, welches Modell für eine vorgeschlagene Aufgabe geeignet ist oder wie eine Integration genutzt wird. Diese Anfragen betreffen die Umgebung, in der die Arbeit ausgeführt wird. Sie unterscheiden sich von der Aufgabe bezüglich externer Inhalte, auch wenn sie für deren Umsetzung notwendig sind.
Andere Datensätze erfordern eine Eingabeaufforderung für ein separates Bild, eine Präsentation oder ein Recherchetool. Hier ist die Eingabeaufforderung selbst ein beabsichtigtes Zwischenergebnis. Sie kann Teil eines umfassenderen Arbeitsablaufs sein, doch der Datensatz belegt weder, dass das nachgelagerte Tool verwendet wurde, noch dass tatsächlich ein Modellwechsel stattgefunden hat.
Aus analytischer Sicht bedeutet dies, dass eine benutzerseitige KI-Anfrage mindestens drei verschiedene Objekte betreffen kann: die Aufgabe, deren Ergebnis und den Zugriff auf die Mittel zur Erzeugung oder zum Abruf dieses Ergebnisses. Fragen zur Plattform zeigen den ausdrücklichen Navigationsbedarf auf; sie allein reichen jedoch nicht aus, um Fehler in der Benutzeroberfläche oder fehlende Funktionen festzustellen.
4.4 RQ3: Themenbezeichnungen verdichten Unterschiede, die sich über verschiedene Aufgaben hinweg erstrecken
Bei der zuvor durchgeführten Neukodierung der Restkategorie wurden unter den Datensätzen, die ursprünglich als „Sonstiges“ gekennzeichnet waren, visuelle Produktion, Informationsabruf, Schreiben, praktische Ratschläge, Software-Hilfe, strukturierte Dokumente, Programmierung, Lernen und Plattformnavigation identifiziert. Die ergänzende Tabelle enthält zudem explizite Anfragen, deren Zweck durch die bestehende Themenbezeichnung nicht ausreichend beschrieben wird. Einige lange Quellfelder enden mit der operativen Anweisung, ein Dokument zu übersetzen, zusammenzufassen oder zu erstellen.
Daraus ergeben sich zwei Messprobleme. Erstens kann ein Klassifikator möglicherweise eher auf den Inhalt des eingefügten Materials reagieren als auf die vom Modell angeforderte Operation. Zweitens können selbst bei einer korrekten Themenzuordnung das Format, die Genauigkeit, die Belege oder die Genehmigungsbedingungen außer Acht gelassen werden, die eine Anfrage von einer anderen unterscheiden.
| Dimension | Hinweise im untersuchten Material | Was bei einer reinen Themenbezeichnung außer Acht gelassen wird | Grenzfall |
|---|---|---|---|
| Lieferung | Anfragen nach bearbeitbaren oder herunterladbaren Ergebnissen | Ob der Text allein ausreichen würde, um der Anfrage gerecht zu werden | Direkte Erläuterungen ohne Dateianforderung |
| Treue | Anweisungen zur Beibehaltung von Fakten, Reihenfolge oder Quellenangaben | In welchem Umfang sind Änderungen zulässig? | Unbegrenzte Erzeugung |
| Beweise | Anfragen bezüglich Referenzen oder der Überprüfung von Sachverhalten | Die angegebene Grundlage für die Anerkennung eines Anspruchs | Ausdrückliche Einschränkungen für externe Forschung |
| Steuerung | Planung oder Überprüfung vor der Umsetzung | Was das System in dieser Phase tun darf | Anfragen zur sofortigen Produktion |
| Übertragung | Eingabeaufforderungen, die für ein anderes Tool bestimmt sind | Die zwischengeschaltete Rolle der angeforderten Ausgabe | Ausgaben, die für die Verwendung innerhalb der Konversation vorgesehen sind |
| Zugang | Fragen zu Modell, Upload, Verlauf und Integration | Maßnahmen im Bereich der Dienstleistungsumgebung | Externe Aufgaben, bei denen der Plattformbetrieb nicht erwähnt wird |
Diese Dimensionen können sich überschneiden. Sie bilden einen Interpretationsrahmen und sind kein neu validiertes, erschöpfendes Klassifikationsschema. Die Tabelle fasst die Unterschiede im untersuchten Material zusammen und enthält keine Rangfolge nach Häufigkeit.
4.5 Aufzeichnungen, die sich einer inhaltlichen Auslegung entziehen
Die Tabelle zur Primärüberprüfung enthält wiederholte oder feste Muster mit kurzen Antworten. Ihre Herkunft ist unbekannt; sie könnten auf normalen Gebrauch, Auswertungen, Konnektivitätsprüfungen, kopierte Beispiele oder einen anderen Vorgang zurückzuführen sein. Sie wurden weder stillschweigend entfernt noch als bestätigter Testverkehr identifiziert.
Andere Felder enthalten eingebettete Rollendeklarationen, Tool-Markierungen oder eingefügte Konversationsverläufe. Eine solche Zusammenstellung erschwert die Zuordnung eines Satzes zur aktuellen Benutzeranfrage. Einige Datensätze enthalten lediglich Quellmaterial oder ein Fragment, dessen Zweck ohne den fehlenden Kontext nicht bestimmt werden kann.
Diese Fälle sind für die Analyse nützlich, da sie die Aussage einschränken. Der Datensatz ist keine transparente Aufzeichnung unabhängiger, vollständig beobachteter Delegationsvorgänge. Bessere Aufgabenkategorien allein können die Unsicherheit darüber, was ein gespeicherter Datensatz darstellt, nicht beseitigen.
5. Diskussion
5.1 Die Auslagerung der Produktion ist nicht gleichbedeutend mit dem Verzicht auf die Kontrolle
Die zentrale Interpretation lautet, dass Anfragen eine Operation delegieren können, während die Bedingungen hinsichtlich des Ergebnisses und des Ablaufs beibehalten werden. Ein Benutzer kann das System beispielsweise auffordern, unter Beibehaltung der Fakten einen Entwurf zu erstellen, die Umsetzung vor der Codegenerierung zu planen oder vor einer Entscheidung Belege vorzulegen. Dies steht im Einklang mit der Aufgabenübertragung und stellt keine Ausnahme davon dar.
Dies erweitert die Unterscheidung zwischen Informationssuche und -erstellung auf die Ebene der formulierten Anforderungen. Es wird damit keine neue universelle Theorie der Zusammenarbeit zwischen Mensch und KI begründet. Der vorliegende Stoff reicht aus, um zu zeigen, warum eine einzelne Intentionsbezeichnung möglicherweise durch zusätzliche Dimensionen ergänzt werden muss, jedoch nicht, um abzuschätzen, wie häufig die einzelnen Kombinationen vorkommen.
5.2 Die Erzeugung von Ergebnissen und die nutzbare Bereitstellung sind getrennte Bewertungsziele
Eine Bewertung, bei der lediglich geprüft wird, ob eine Antwort ein Thema behandelt, lässt möglicherweise explizite Bereitstellungsbedingungen außer Acht. Bei den untersuchten Artefaktanfragen wäre es sinnvoll, zusätzlich zu prüfen, ob das angeforderte Formular bereitgestellt wurde, bei Bedarf bearbeitbar blieb, den angegebenen Quellinhalt beibehielt und eine stufenweise Genehmigungsgrenze einhielt.
Es handelt sich hierbei um vorgeschlagene Bewertungskriterien, die aus Anfragen abgeleitet wurden, und nicht um gemessene Leistungsergebnisse. Anhand der vorliegenden Unterlagen lässt sich die tatsächliche Einhaltung nicht bewerten. Dennoch trägt diese Unterscheidung dazu bei, einen präziseren Maßstab für zukünftige Ergebnisse zu formulieren als die Anzahl der Nachrichten oder das bloße Vorhandensein einer Nachverfolgung.
5.3 Was die Ergebnisse hinsichtlich der Koordinierung nicht belegen
Das Festlegen von Anforderungen, das Überprüfen von Nachweisen und das Abrufen einer Datei lassen sich als Koordinationsaufgaben im Zusammenhang mit delegierten Arbeiten verstehen. Ihre Existenz wirft eine tiefgreifendere Frage auf: Reduziert KI den Gesamtaufwand oder verteilt sie ihn lediglich auf die Bereiche Spezifikation und Überprüfung?
Diese Studie gibt keine Antwort auf diese Frage. Es fehlen eine Vergleichsgruppe, Zeitmessungen, vollständige Ergebnisse und unabhängige Bewertungen des Aufgabenerfolgs. Eine Folgestudie könnte eine sinnvolle Zusammenarbeit, vermeidbare Reibungspunkte, ein geändertes Ziel oder einen routinemäßigen nächsten Schritt darstellen. Eine bloße Zählung kann diese Erklärungen nicht voneinander unterscheiden.
Zukünftige Hypothesen könnten untersuchen, ob explizite Bereitstellungsbedingungen spätere Formatänderungen vorhersagen oder ob gestaffelte Genehmigungsanfragen mit weniger unerwünschten Aktionen verbunden sind. Die Überprüfung dieser Hypothesen würde verknüpfte Episoden, validierte Kennzeichnungen und eine angemessene Behandlung wiederholter Beobachtungen bei den Nutzern erfordern. Es handelt sich dabei um Forschungsansätze und nicht um Ergebnisse aus dieser Studie.
6. Einschränkungen
Auswahl und Abhängigkeit. Die Übersichts-Tabellen wurden zu diagnostischen Zwecken bereitgestellt, wobei die Einbeziehungswahrscheinlichkeiten unbekannt waren. Einige der ursprünglichen Texte tauchen sowohl innerhalb einzelner Tabellen als auch tabellenübergreifend auf. Die Datensätze lassen keine Rückschlüsse auf die Prävalenz in der Bevölkerung oder auf unabhängige Replikationsergebnisse zu.
Auslegung. Ein KI-Assistent führte die Analyse durch, wobei die ursprünglichen Kennzeichnungen sichtbar waren. Es liegt keine unabhängige Validierung durch Menschen und keine Einschätzung der Interrater-Reliabilität vor. Das analytische Rahmenwerk wurde nach Prüfung der Daten entwickelt und spiegelt möglicherweise die Erwartungen des Analysten wider.
Unvollständige Lektüre und fehlender Kontext. Die Überprüfung konzentrierte sich auf Einleitungen, ausgewählte Schlusspassagen und Auszüge aus den Folgeantworten. Lange Quellpassagen, referenzierte Anhänge und vollständige Antworten der Assistenten wurden nicht umfassend geprüft. Möglicherweise wurden einige Anweisungen oder Gegenbeispiele übersehen.
Extraktionsgrenzen. In den mit „GPT“ gekennzeichneten Zeilen mit Zeitfenstern können frühere, spätere oder dazwischenliegende Aktivitäten ausgelassen sein. Die Modellführung wurde nicht unabhängig überprüft. Gespeicherte Zeilen können eingebettete Verlaufsdaten enthalten; die Zeilenanzahl entspricht nicht unbedingt den natürlichen Wendepunkten.
Ergebnisse. Anfragen stellen keinen Nachweis für die Bereitstellung, Richtigkeit, Zufriedenheit, Produktivität, Konversion oder die Überlegenheit eines Modells dar. Die Studie lässt keine Rückschlüsse auf sensible persönliche Merkmale aus dem Inhalt der Anfragen zu.
Übertragbarkeit und kommerzielles Umfeld. Die Ergebnisse beziehen sich auf ausgewählte Datensätze einer Multi-Modell-Plattform. Sie spiegeln weder die offizielle Nutzung von ChatGPT noch die breite Öffentlichkeit wider. Bei der Interpretation dieses Beitrags sollten die kommerziellen Interessen der Plattform sowie das Fehlen einer unabhängigen wissenschaftlichen Überprüfung berücksichtigt werden.
7. Schlussfolgerung
Die geprüften Anfragen unterscheiden zwischen der an GPT delegierten Aufgabe und den Bedingungen, die mit einem verwertbaren Ergebnis verbunden sind. Zu diesen Bedingungen gehören das Ausgabeformat, die Übereinstimmung mit dem Ausgangsmaterial, Belege sowie die Möglichkeit zur Überprüfung vor weiteren Schritten. Der Zugriff auf die Plattform und Eingabeaufforderungen für andere Tools bringen zusätzliche Anforderungen mit sich, die durch Themenkennzeichnungen allein nicht erfasst werden.
Die Erkenntnisse stützen eine gezielte These: Delegation und Beibehaltung der Kontrolle können in einer Anfrage nebeneinander bestehen. Um dieses Verhältnis zu beschreiben, muss berücksichtigt werden, was der Nutzer als Ergebnis wünscht, was unverändert bleiben muss und was das System als Nächstes tun soll. Die vorliegende Analyse identifiziert diese Unterscheidungen; sie schätzt jedoch weder deren Häufigkeit in der Gesamtpopulation noch belegt sie, dass sie zu besseren Ergebnissen führen.
Literaturverzeichnis
- Chatterji, A., Cunningham, T., Deming, D. J., Hitzig, Z., Ong, C., Shan, C. Y. und Wadman, K. (2025). Wie ChatGPT genutzt wird. NBER-Arbeitspapier Nr. 34255. https://doi.org/10.3386/w34255. Offizieller Eintrag: https://www.nber.org/papers/w34255. Ein Arbeitspapier wird hier nicht als begutachteter Zeitschriftenartikel dargestellt.
- Gale, N. K., Heath, G., Cameron, E., Rashid, S. und Redwood, S. (2013). Anwendung der Rahmenmethode zur Analyse qualitativer Daten in der multidisziplinären Gesundheitsforschung. BMC Medical Research Methodology, 13, 117. https://doi.org/10.1186/1471-2288-13-117. Volltext: https://pmc.ncbi.nlm.nih.gov/articles/PMC3848812/.
Anhang A. Verzeichnis der qualitativen Kategorien
Bei der explorativen Neukodierung wurden folgende Bereiche identifiziert: visuelle Produktion, Anweisungen mit festgelegten Antworten, Informationsabruf, Schreiben, praktische Ratschläge, Navigation auf der Plattform, mehrdeutige Eingaben, Fehlerbehebung bei der Software, strukturierte Ergebnisse, Programmierung, Lernen, Musik, Ideenfindung, Umstrukturierung langer Quelltexte sowie die Zusammenfassung von Rollen und Verlauf.
Diese Aufstellung beschreibt die Kategorien, die im ausgewählten Material vorkommen. Die Anzahl der Kategorien und die Gesamtzahlen werden nicht angegeben; die Liste stellt weder eine Rangfolge nach Häufigkeit noch eine Schätzung der Nachfrage auf der Plattform dar.
Offenlegung von Forschungsergebnissen
KI-Unterstützung: Ein KI-Assistent hat die angegebenen Auszüge geprüft, die explorative Interpretation erarbeitet, deskriptive Überprüfungen durchgeführt und den Manuskriptentwurf verfasst. Es wird keine Übereinstimmung mit einer unabhängigen menschlichen Bewertung beansprucht.
Verfügbarkeit der Daten: Das zugrunde liegende Paket enthält vertrauliche Aufzeichnungen, die von autorisierten Mitwirkenden freiwillig zur Verfügung gestellt wurden und nicht wiedergegeben werden. Genaue Zahlenangaben und Beobachtungsdaten werden ebenfalls zurückgehalten. Dieser Bericht berechtigt nicht zur Weitergabe einzelner Nachrichten oder Vorlagen. Alle Beispiele in den Ergebnissen sind verallgemeinerte Beschreibungen und keine wörtlichen Zitate.