Muse Spark 1.2 kombiniert ungewöhnlich niedrige Token-Preise mit einem Kontextfenster von 1 Million Token und hat alle drei Codierungsaufgaben für Basismodelle in unserer API-Suite beim ersten Versuch bestanden. Meta hat das Modell am 5. August 2026, mit einem Kontextfenster von 1 Million Tokens, zwei API-Preisstufen und einem separaten Terminal-Agenten namens „Muse Code“. Die Benchmark-Ergebnisse von Meta sind vielversprechend; unabhängige öffentliche Coding-Ranglisten haben diese Modell- und Agenten-Kombinationen jedoch noch nicht überprüft.
Diese Bewertung unterscheidet zwischen dem Modell und dem Agenten, zwischen offiziellen Bewertungen und unabhängigen Belegen sowie zwischen der Standardpreisgestaltung und dem Kompromiss zwischen Datenverbrauch und Leistungsumfang der „Contributor“-Stufe. In unseren Tests führte das Modell eine Korrektur der Python-Idempotenz, eine kompatibilitätserhaltende TypeScript-Umgestaltung und eine repositoryweite JSONL-Funktion ohne Wiederholungsversuche durch. Die Ausführung des Muse Code-Agenten wurde nicht getestet, ebenso wenig wie die Zuverlässigkeit der Tool-Aufrufe. Wenn Sie zunächst einen Vergleich des breiteren Feldes vornehmen möchten, finden Sie in unserem Leitfaden zum beste AI-Modelle für die Codierung vermittelt den breiteren wettbewerblichen Kontext.
Muse Spark 1.2 Testbericht: Kurzfassung
Die Kurzfassung: Muse Spark 1.2 ist ein auf Programmierung ausgerichtetes Meta-Modell mit einem Fenster von 1 Million Token, einem OpenAI-SDK-kompatiblen API-Zugriff und einer besonders attraktiven „Contributor“-Stufe. Sein größter öffentlicher Vorteil ist das Preis-Leistungs-Verhältnis: $0,10 für die Eingabe und $0,20 für die Ausgabe pro Million Token beim „Contributor“-Modell. Diese Stufe kann zur Verbesserung von Meta-Produkten genutzt werden, während das teurere Standardmodell nicht für diesen Zweck eingesetzt wird.
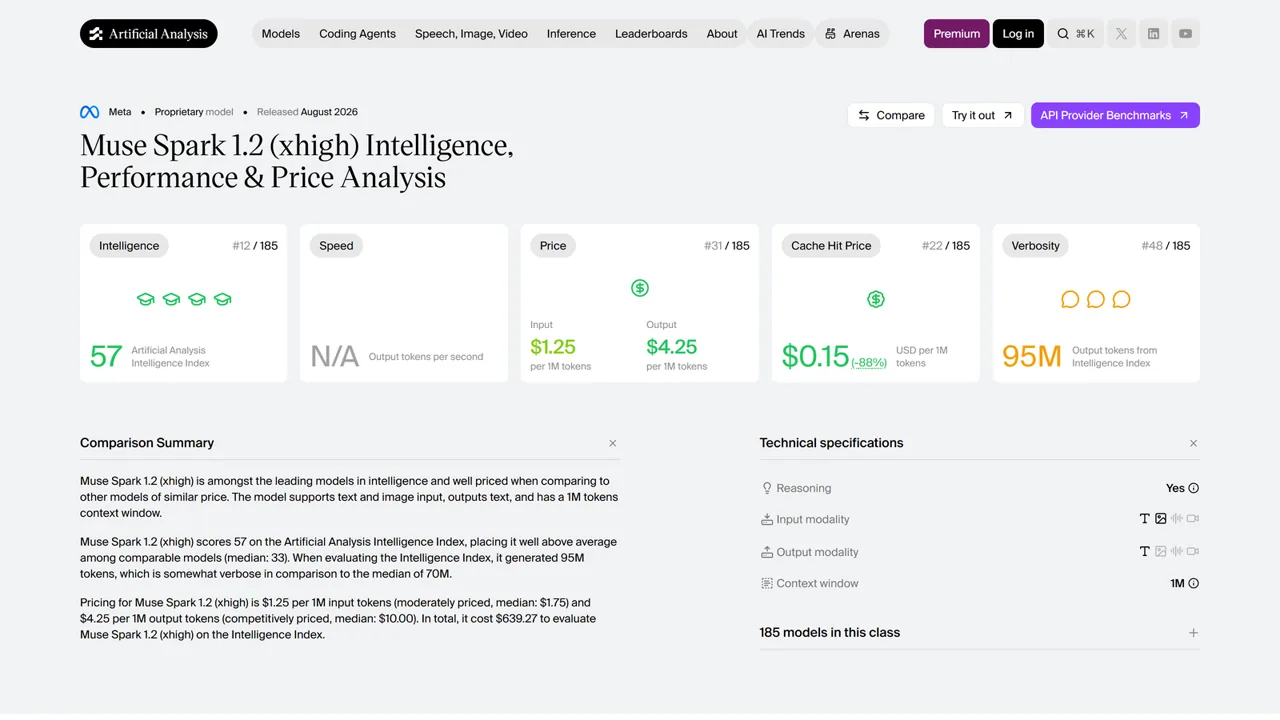
Was die Leistungsdaten angeht, ist etwas mehr Zurückhaltung geboten. Meta gibt für Muse Spark 1.2 mit Muse Code einen Wert von 82,91 TP40T auf Terminal-Bench 2.1 und einen Wert von 59,31 TP40T auf DeepSWE an. Dabei handelt es sich um von Meta ermittelte Ergebnisse. Auf den öffentlichen Terminal-Bench- und DeepSWE-Listen war Muse Spark 1.2 bei einer Überprüfung am 26. August 2026 noch immer nicht aufgeführt. Künstliche Analyse bietet eine unabhängige Gegenprüfung: Sein Intelligenzindex liegt weiterhin bei 57 und damit über dem Medianwert vergleichbarer Modelle von 35.
- Der beste Grund, es jetzt auszuprobieren: Günstige Preise für Mitwirkende, ein umfangreicher Kontext und eine API, die dem bekannten OpenAI-Client-Muster folgt.
- Der wichtigste Grund, vorsichtig zu bleiben: Drei kontrollierte Aufgaben auf Basis des Basismodells reichen nicht aus, um die Zuverlässigkeit des Muse-Code-Agenten, die Qualität der Tool-Aufrufe oder die Leistung in einem großen Produktions-Repository nachzuweisen.
- Wichtige Entscheidung zum Datenschutz: Verwenden Sie das Standardmodell für Code oder Eingabeaufforderungen, die nicht zur Verbesserung von Meta-Produkten verwendet werden sollen.
Muse Spark 1.2 auf einen Blick
Geprüfte Spezifikationen
Meta beschreibt Muse Spark 1.2 als ein Modell mit einer höheren Genauigkeit beim Programmieren im ersten Versuch und einer zuverlässigeren Tool-Auswahl als Muse Spark 1.1. Dies sind Angaben des Anbieters aus dem Offizielle Modellseite von Muse Spark, nicht Schlussfolgerungen aus unserer eigenen Kodierungssitzung.
Muse Spark 1.2 im Vergleich zu Muse Code
„Muse Spark 1.2“ ist das Modell. „Muse Code“ ist ein separater Beta-Terminal-Agent, der auf diesem Modell basiert. Diese Unterscheidung ist von Bedeutung, da ein Agent um das zugrunde liegende Modell herum Funktionen wie Planung, Werkzeugkoordination, Repository-Navigation, Isolierung des Arbeitsverzeichnisses, Protokollierung und Wiederholungsverhalten hinzufügen kann.
Halten Sie die Ebenen getrennt
Muse Spark 1.2
Kontext, Argumentation, API-Verhalten, Token-Abrechnung, Ausgaben und Entscheidungen bezüglich des Aufrufs von Tools.
Modell-IDs1M KontextAPI-Preise
Muse-Code
Terminal-UX, Subagenten, Git-Worktrees, Ereignisprotokoll, Wiederaufnahme des Ablaufs, gebündelte Skills und Orchestrierung.
Agenten-WorkflowErgebnisse des Meta-Run-Systems
Die offizielle Muse-Code-Seite bezeichnet das Produkt als Beta-Codierungsmittel. Dadurch sind Vergleiche mit Produkten wie Claude Code und Codex aussagekräftiger, als so zu tun, als ob jeder beobachtete Unterschied im Arbeitsablauf allein auf den Modellabruf zurückzuführen wäre. Unser Codex vs. Claude – Code-Vergleich erklärt, warum das Umfeld die Entwicklererfahrung ebenso stark beeinflussen kann wie das Modell.
Muse Spark 1.2-Benchmarks: Was die Ergebnisse wirklich aussagen
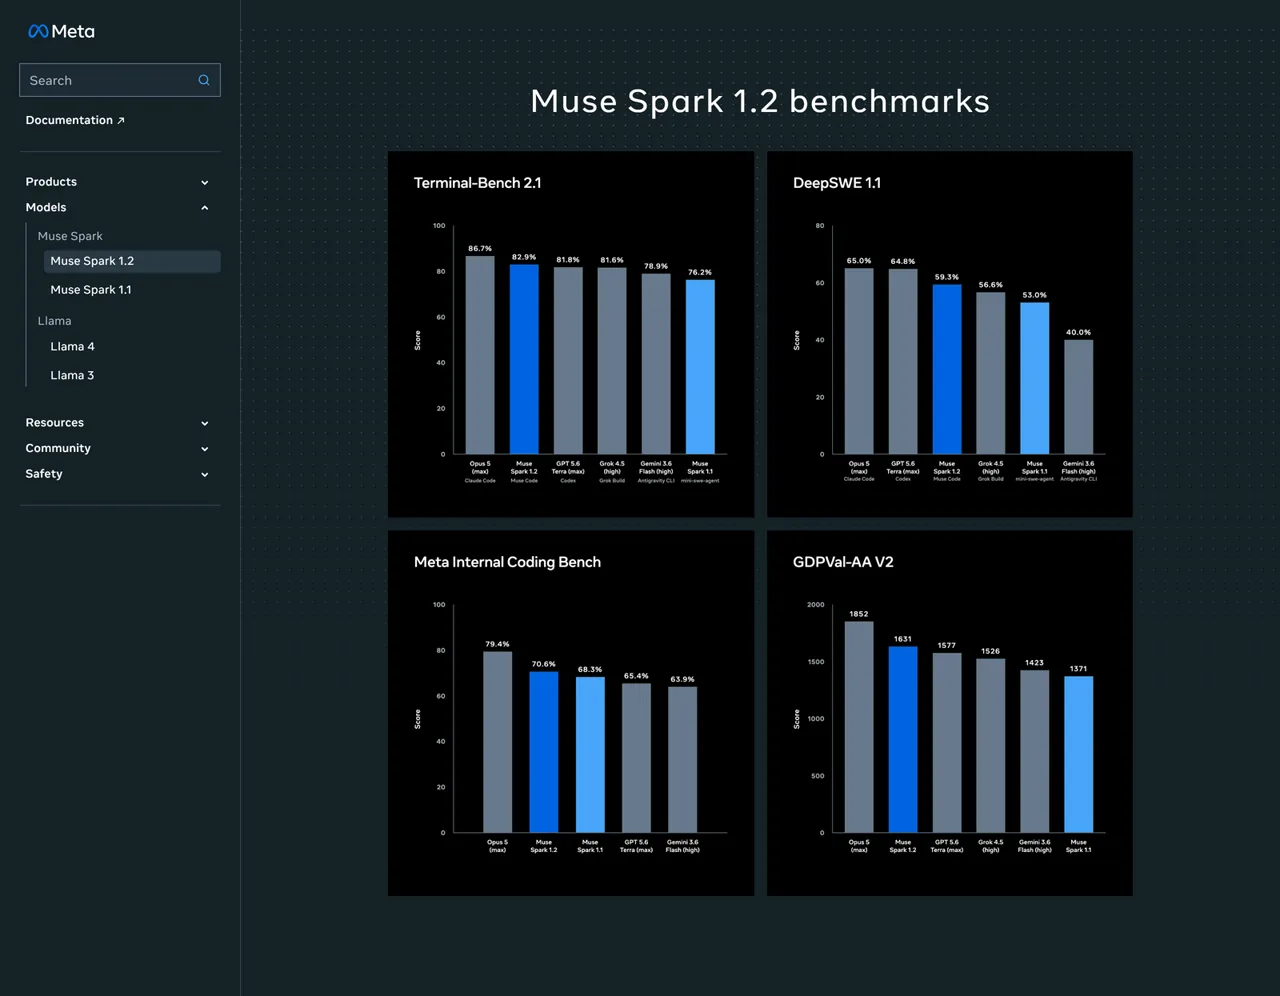
In der Benchmark-Übersicht von Meta rangiert Muse Spark 1.2 bei mehreren Programmierbewertungen ganz oben. Die Zahlen sind zwar eine genauere Betrachtung wert, stellen jedoch keine eindeutige Rangliste der reinen Modellqualität dar. Das Modell, der Agent, das Test-Harness, die Schlussfolgerungsfähigkeit und das Aufgabenprotokoll können sich alle gemeinsam ändern.
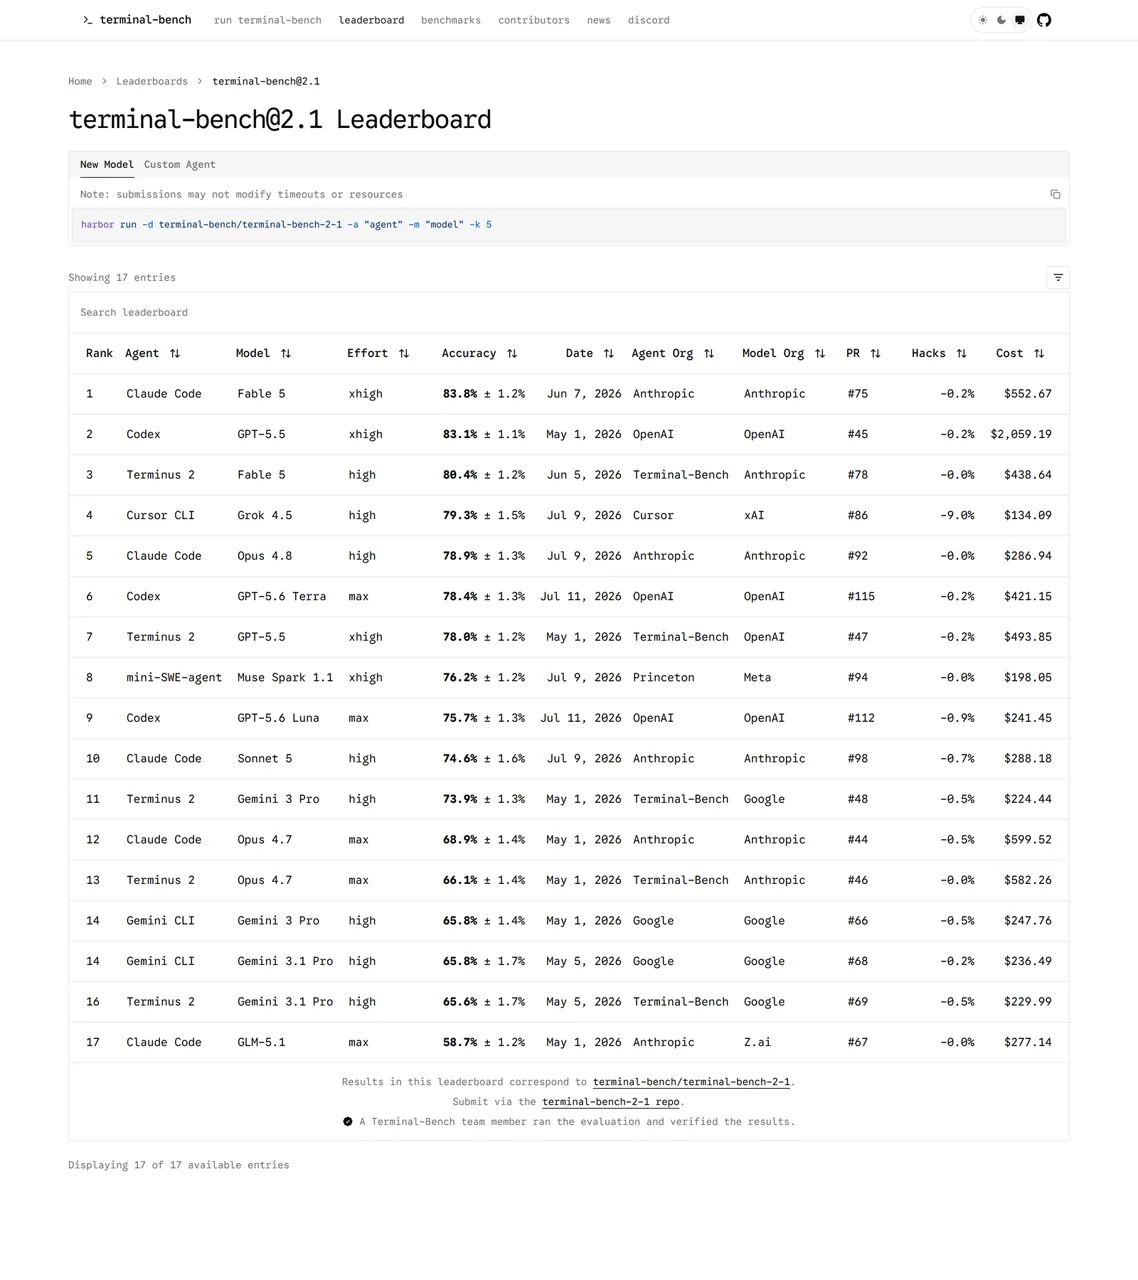
Meta-Bericht zu Terminal-Bench 2.1
Meta-Benchmark-Panel
Terminal-Bench 2.1
Alle 89 Aufgaben · „pass@1“ bei fünf Versuchen · ausgewählte Modell- und Agentenkombinationen
Die Zahl 82,9% ist eine Ergebnis des Meta-Laufs des Muse-Codes. Das public Terminal-Bench 2.1-Rangliste hat „Muse Spark 1.2“ am 26. August 2026 nicht aufgeführt, daher ist es Kein verifizierter Eintrag in der öffentlichen Rangliste. In der öffentlichen Tabelle wurde Muse Spark 1.1 mit Mini-SWE-Agent mit 76,21 TP40T ±1,21 TP40T aufgeführt.
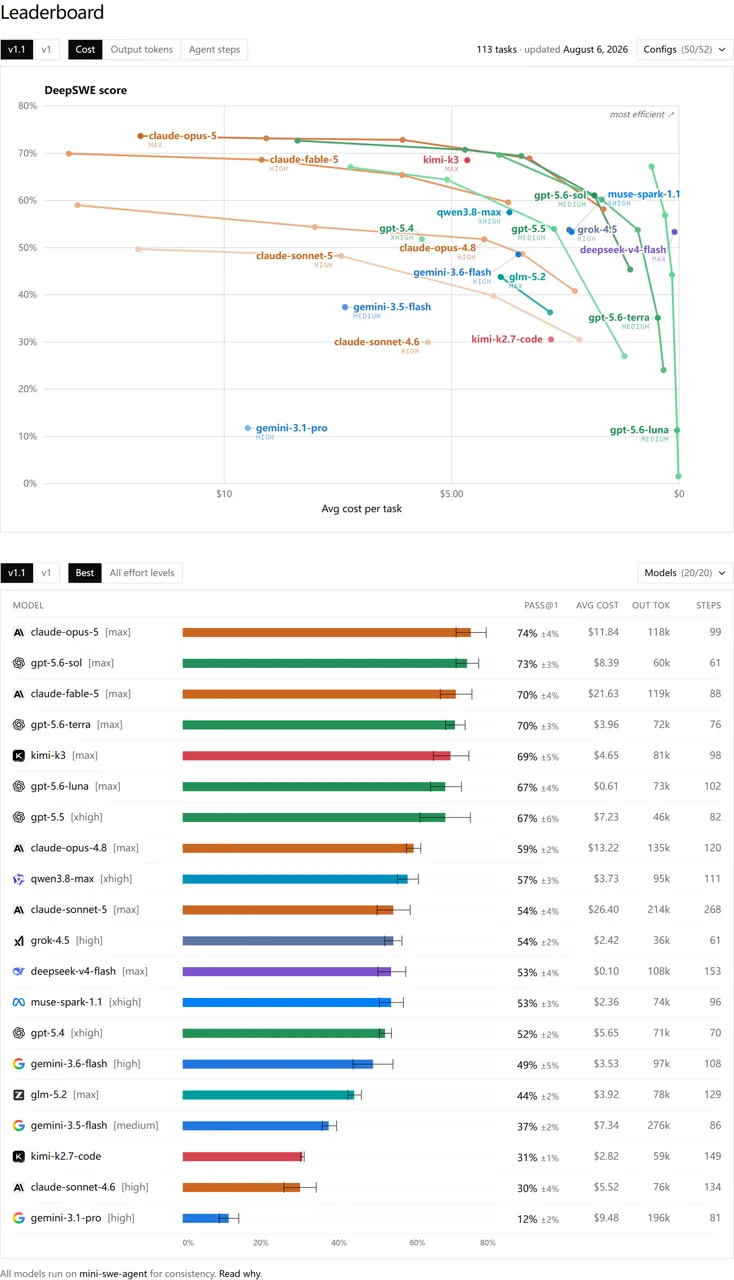
Meta-Bericht zu DeepSWE 1.1
Meta-Benchmark-Panel
DeepSWE 1.1
113 Aufgaben · 91 Repositorys · fünf Sprachen · „pass@1“ bei fünf Versuchen
Die Öffentliche DeepSWE v1.1-Rangliste verwendet aus Gründen der Einheitlichkeit bei allen aufgeführten Modellen den „mini-swe-agent“. Zum Zeitpunkt der Überprüfung war der „Muse Spark 1.2“ noch nicht hinzugefügt worden; der „Muse Spark 1.1“ war mit 53% aufgeführt. Das Ergebnis von Meta (59,3%) basiert auf „Muse Code“, sodass die beiden Werte nicht auf derselben Testumgebung beruhen.
Die internen und allgemeinen Agentenbewertungen von Meta
Zwei verschiedene Bewertungsskalen
Meta-interne Programmierwerkbank
440 interne Aufgaben · zwei Versuche pro Aufgabe
| Modell | Punktzahl |
|---|---|
| Opus 5 | 79.4% |
| Muse Spark 1.2 | 70.6% |
| GPT-5.6 Terra | 65.4% |
| Gemini 3.6 Flash | 63.9% |
| Grok 4,5 | Nicht abgebildet |
GDPVal-AA v2
Allgemeine Bewertung agentischer Aufgaben · Werte nach Elo-Art
| Modell | Punktzahl |
|---|---|
| Opus 5 | 1852 |
| Muse Spark 1.2 | 1631 |
| GPT-5.6 Terra | 1577 |
| Grok 4,5 | 1526 |
| Gemini 3.6 Flash | 1423 |
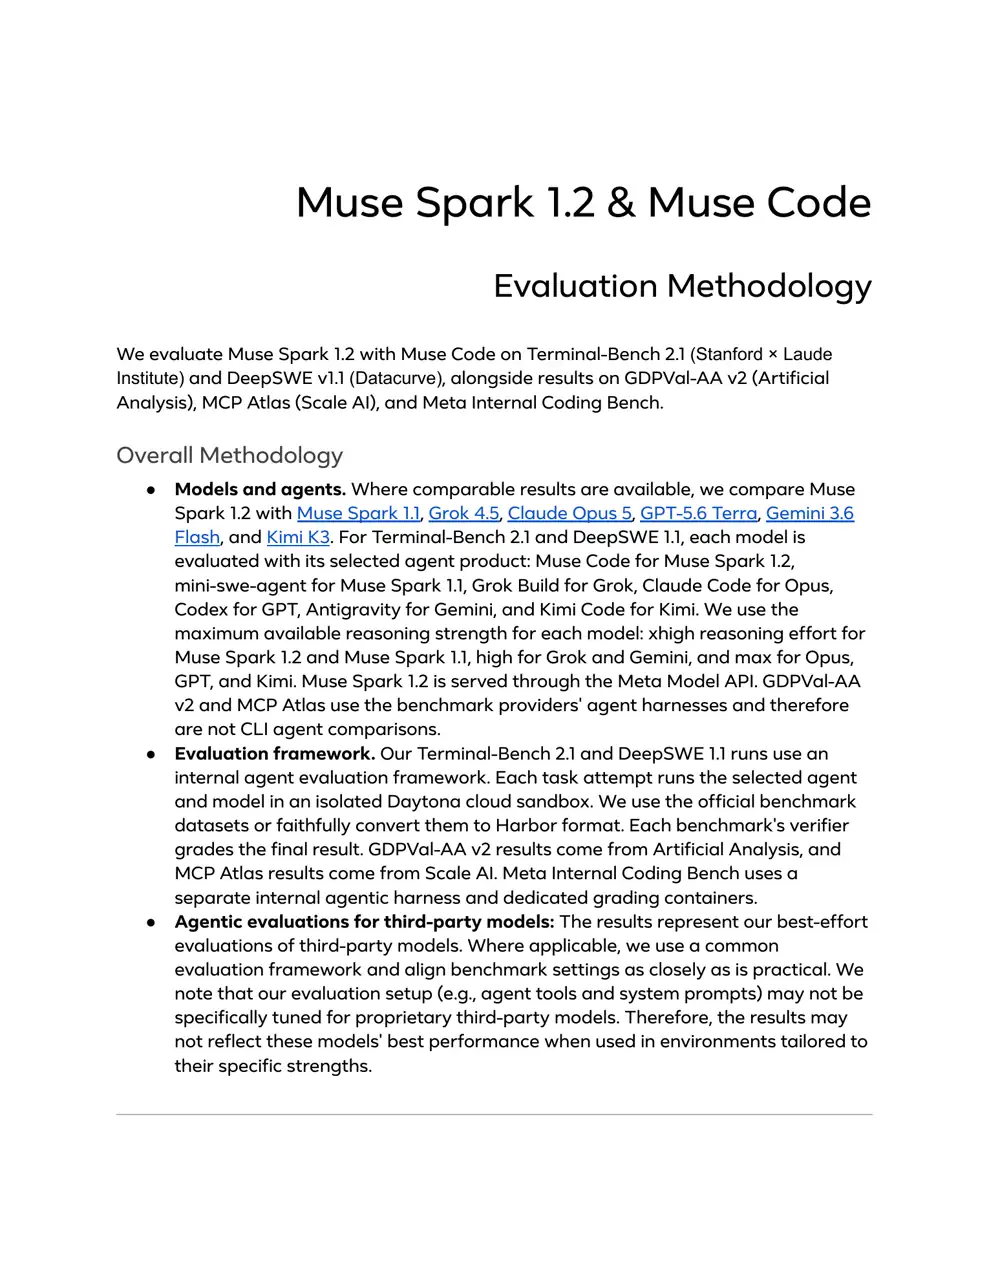
Meta’s Bewertungsmethodik Laut Angaben nutzt Terminal-Bench alle 89 Aufgaben und erreicht bei fünf Versuchen „pass@1“. DeepSWE deckt 113 Aufgaben in 91 Repositories und fünf Sprachen ab und erreicht ebenfalls bei fünf Versuchen „pass@1“. Meta weist zudem darauf hin, dass seine Konfiguration möglicherweise nicht optimal auf Modelle von Drittanbietern abgestimmt ist. Einen aktuellen Vergleich mit Wettbewerbern, der auf realen Produktentscheidungen basiert, finden Sie unter Claude Opus 5 gegen GPT-5.6.
Die Methodik verändert die Bedeutung
Modell + ausgewählter Vermittler
89 Aufgaben, fünf Versuche, unterschiedliche Einstellungen für die maximale Schlussfolgerungsfähigkeit, und das Testumfeld von Meta ist möglicherweise nicht gleichermaßen auf Systeme von Drittanbietern abgestimmt.
Verifizierte Einträge
Muse Spark 1.2 war bei der Überprüfung nicht vorhanden. Die Konfigurationen und der Verifizierungsstatus der Platine müssen separat aus der Tabelle von Meta entnommen werden.
Gängiger Mini-Swe-Agent
113 Aufgaben in 91 Repositories und fünf Sprachen. Muse Spark 1.2 fehlte; Muse Spark 1.1 war mit 53% aufgeführt.
Künstliche Analyse: nützlicher unabhängiger Kontext
Die Seite zum Modell der künstlichen Analyse ergibt für Muse Spark 1.2 einen Intelligenzindex von 57, was über dem Medianwert vergleichbarer Modelle von 35 liegt (Stand: 26. August 2026). Sein Harness weist 80% auf Terminal-Bench v2.1, 57% (normalisiert) auf GDPVal-AA v2, 56% auf SciCode und 83% bei der AA-LCR-Bewertung mit langem Kontext auf.
Abweichung bei der künstlichen Analyse
Die praktische Erkenntnis ist einfach: Muse Spark 1.2 scheint wettbewerbsfähig zu sein, aber keine einzelne Bewertung kann das Modell isoliert betrachten. Betrachten Sie die Grafik von Meta als Beleg für das Muse-Code-System, öffentliche Ranglisten als separate Gegenprüfung und „Artificial Analysis“ als unabhängige, aber anders konfigurierte Bewertung.
Muse Spark 1.2: Abwägung zwischen Preis und Datenschutz
Meta bietet zwei API-Modell-IDs mit erheblich unterschiedlichen Preisen an. Die günstigere Variante ist nicht nur ein Preisnachlass: Sie hat auch Auswirkungen darauf, wie die übermittelten Daten genutzt werden dürfen.
USD pro einer Million Token · 1M-Kontext
Wird nicht zur Produktverbesserung verwendet
Wird nicht zur Verbesserung von Meta-Produkten verwendet
Günstiger, allerdings mit Einschränkungen beim Datenverbrauch
Daten können zur Verbesserung von Meta-Produkten verwendet werden
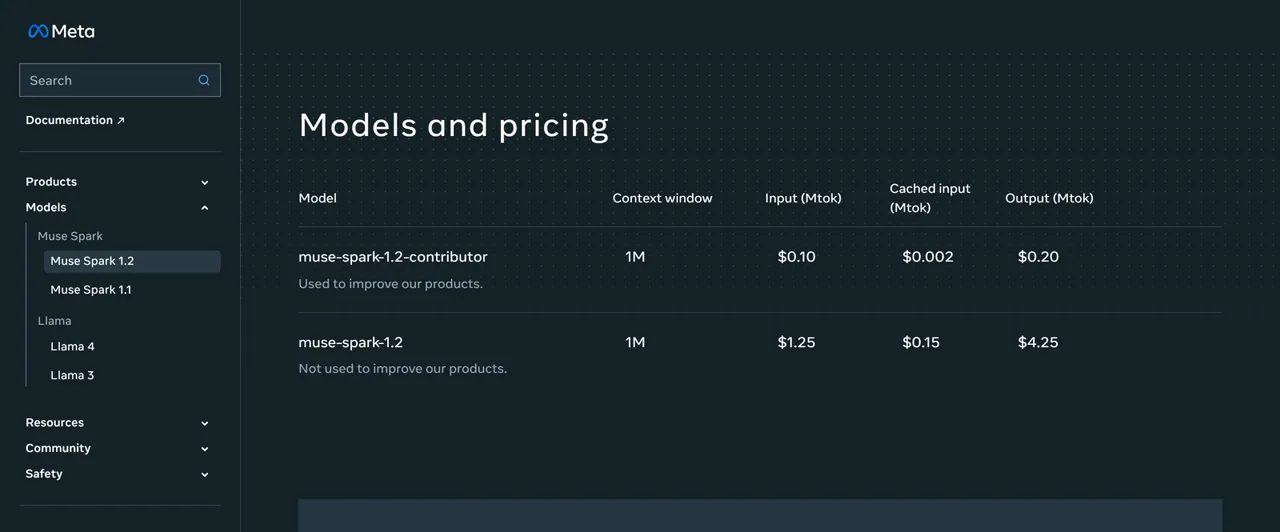
Die Preise für „Contributor“ sind bei Eingaben 12,5-mal günstiger, bei zwischengespeicherten Eingaben 75-mal günstiger und bei Ausgaben 21,25-mal günstiger als in der Standardstufe. Es gibt keinen einheitlichen Rabattprozentsatz, der für alle Token-Typen gleichermaßen gilt.
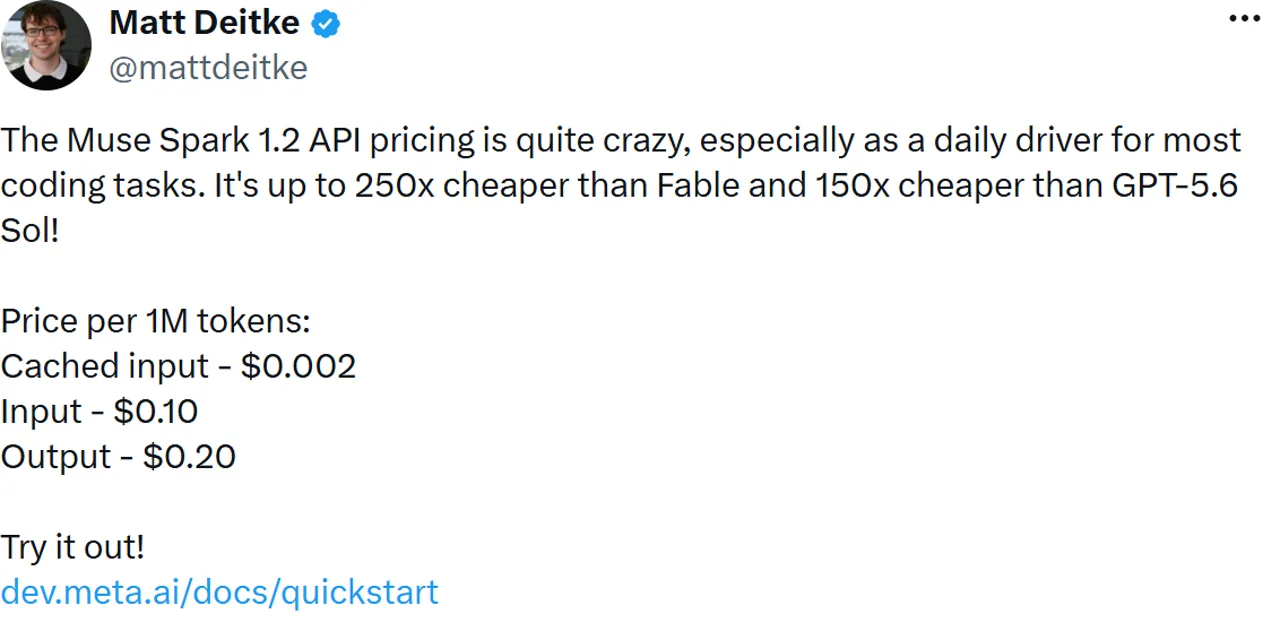
Ein Meta-Forscher bewarb die “Contributor”-Stufe als “bis zu 250-mal günstiger” als Fable und „150-mal günstiger“ als GPT-5.6 Sol. Das sozialer Vergleich basiert auf den „Contributor“-Preisen und nicht auf dem Standardmodell und sollte stets mit dem Hinweis auf die Datennutzung versehen sein. Leser, die die aktuellen Kosten von Wettbewerbern vergleichen möchten, können unsere separate GPT-5.6-Preisliste und Aufschlüsselung der Preise für den Code Claude.
Für öffentliche Repositorys, synthetische Aufgaben oder Einweg-Testumgebungen könnte die „Contributor“-Stufe attraktiv sein. Für privaten Code, Kundendaten, Anmeldedaten oder proprietäre Architekturen ist die Standardstufe die sicherere Standardwahl. Meta gibt außerdem bekannt, dass es nun damit beginnt, Anträge auf keine Datenspeicherung über den Vertrieb anzunehmen; dies ist ein separater Zugangsweg und unterscheidet sich von der standardmäßigen Self-Service-Einstellung.
Muse Spark 1.2: API-Zugriff und Beispiel
Drei offizielle Zugangswege
Offizielle Basis-URL des Kochbuchs: https://api.meta.ai/v1 · 1.2 Anfrage in dieser Überprüfung: nicht ausgeführt
Die Meta-Modell-API unterstützt einen OpenAI-SDK-kompatiblen Workflow. Das offizielle Kochbuch von Meta verwendet die Basis-URL https://api.meta.ai/v1 und liest den Schlüssel aus MODEL_API_KEY. Auf der Produktseite wird zudem das „Search Grounding“ beschrieben, während das Kochbuch Themen wie Chat-Vervollständigungen, Streaming, den Aufruf von Tools, strukturierte Ausgaben, das Zwischenspeichern von Eingabeaufforderungen, Steuerelemente für Schlussfolgerungen, Bildverarbeitung, lange Kontexte, Wiederholungsversuche und Suchrezepte behandelt.
Beispiel aus einem offiziellen Kochbuch – erfasste Version: Die Das offizielle GitHub-Kochbuch wird nach wie vor verwendet muse-spark-1.1. Dies belegt die Client-Struktur und die Basis-URL, nicht jedoch, dass das Beispiel für Version 1.2 aktualisiert wurde.
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.1",
    messages=[{"role": "user", "content": "Hallo, Welt!"}],
)

print(response.choices[0].message.content)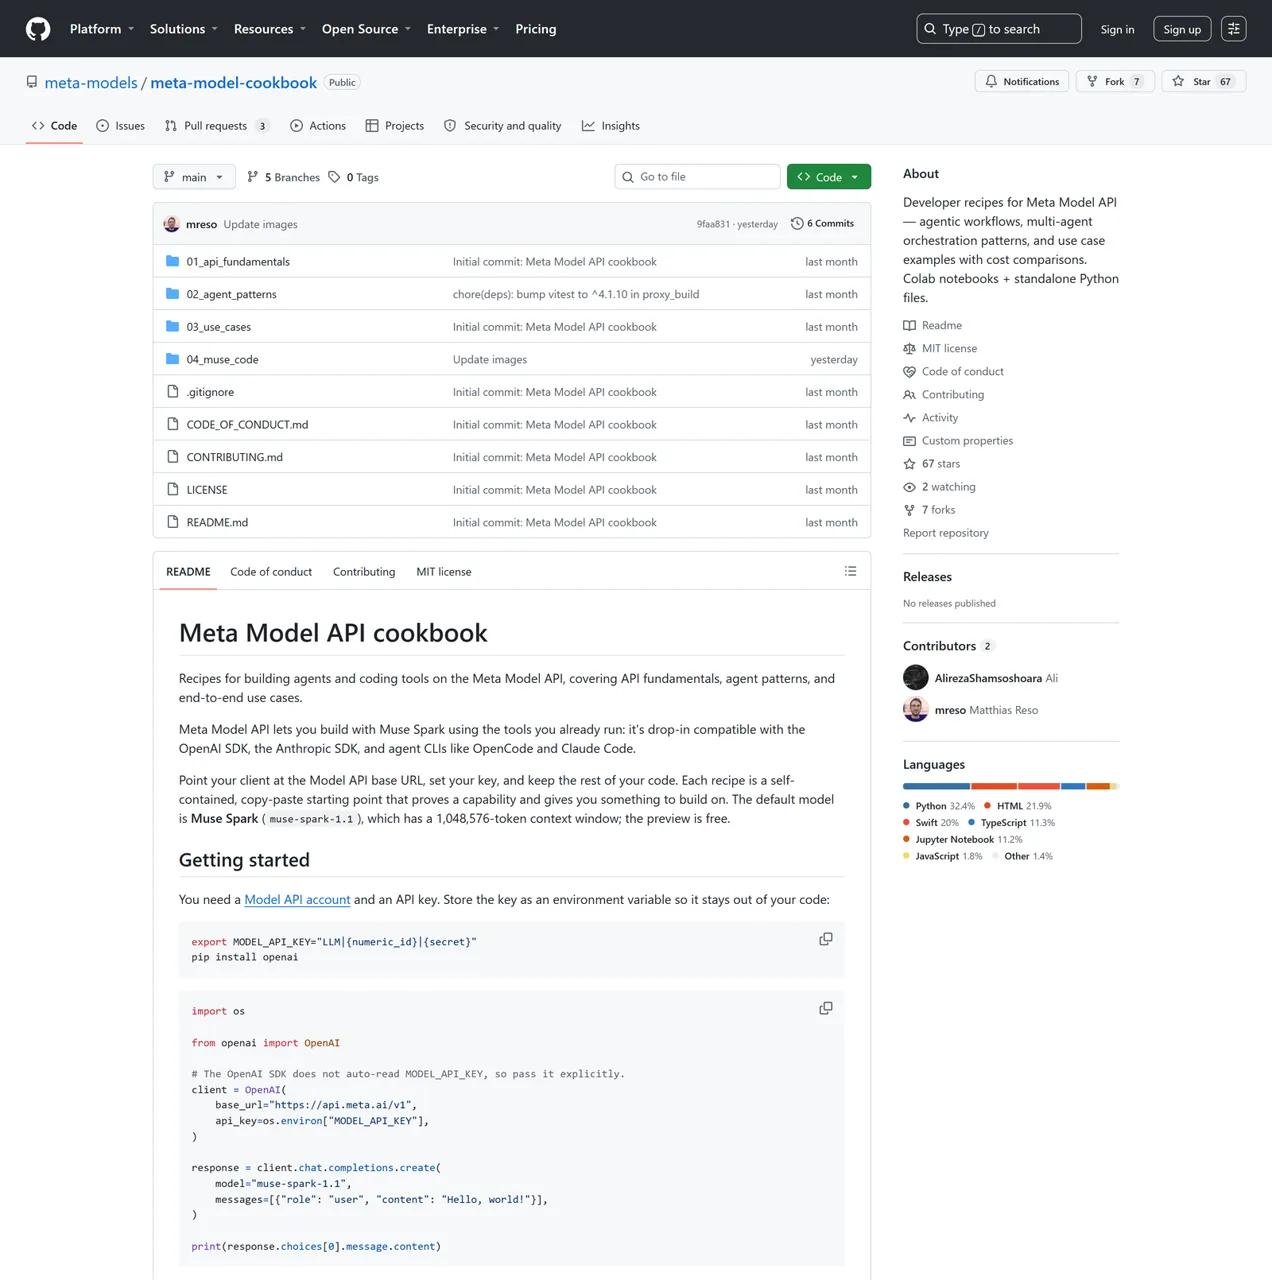
Dokumentierte Anpassung – nicht ausgeführt: Meta listet separat auf muse-spark-1.2 als Standard-Modell-ID 1.2. Die nachstehende minimale Ersetzung kombiniert zwei offizielle Angaben, es wurde jedoch im Rahmen dieser Überprüfung keine kostenpflichtige Anfrage gesendet.
response = client.chat.completions.create(
    model="muse-spark-1.2",
    messages=[{"role": "user", "content": "Hallo, Welt!"}],
)
Muse Spark ist ein Schlussfolgerungsmodell, und Argument-Token werden als Ausgabe abgerechnet. Damit ist die Standard-Ausgaberate von $4,25 wichtiger, als es auf den ersten Blick scheint: Eine scheinbar kurze Antwort kann dennoch eine verborgene logische Struktur enthalten. Die tatsächliche Latenz, die Zeit bis zum ersten Token, die Wiederholungsrate und die Kosten pro Aufgabe bleiben hier ungemessen.
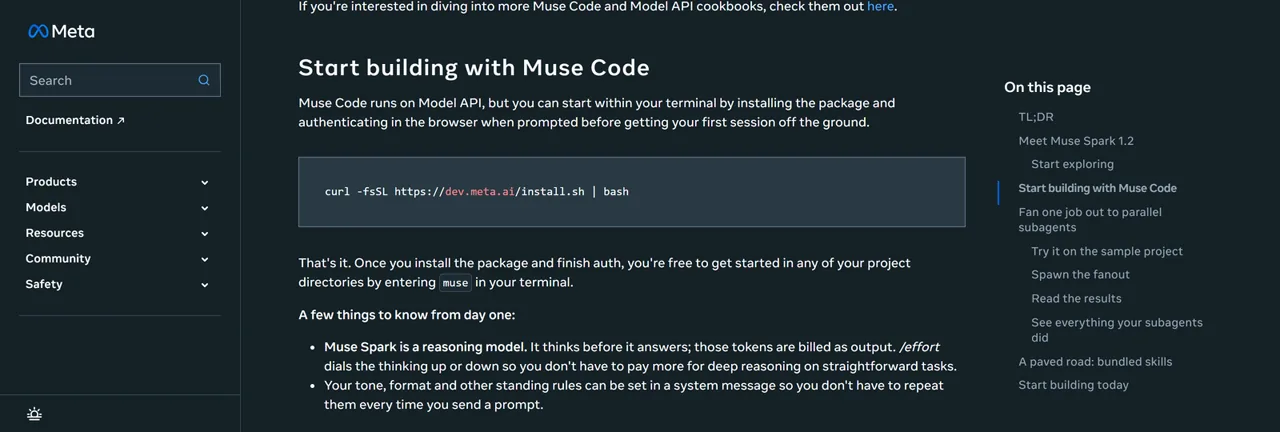
/Aufwand Der Befehl ändert die Tiefe der Schlussfolgerung. Quelle: Meta-Entwicklerhandbuch.Was Muse Code bietet
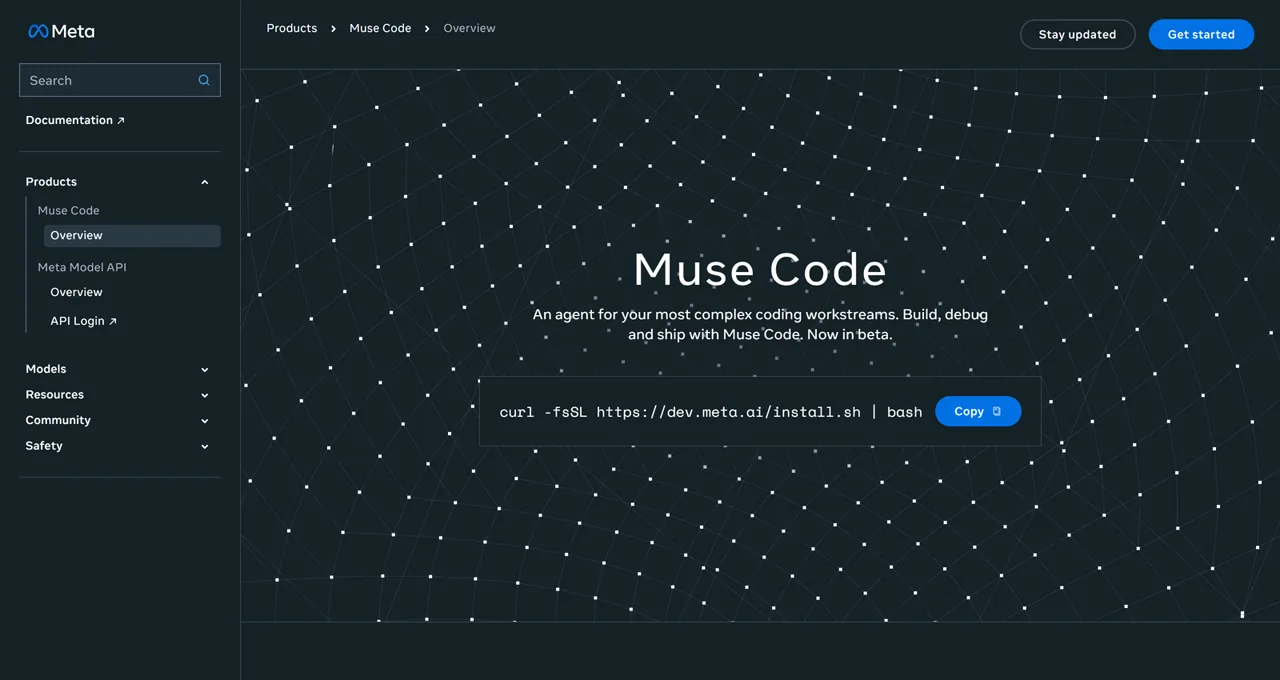
Muse Code wird über das Terminal installiert und bindet Muse Spark 1.2 in einen Agent-Workflow ein. Metas Ein tiefer Einblick in die Welt der Entwickler beschreibt verschiedene Verhaltensweisen, die nicht zu einem reinen API-Aufruf gehören:
- Parallele Agenten: Aufgaben können in isolierten Git-Worktrees ausgeführt werden.
- Ereignisprotokoll, das nur am Ende ergänzt wird: Sitzungen und Aktionen werden zu Prüfungs- und Wiedergabezwecken in eine lokale JSONL-Datei geschrieben.
- Lebenslauf-Ablauf:
Lebenslauf von Museunterbrochene Sitzungen fortsetzen können. - Prüfung der Argumentation: das
/AufwandDer Befehl passt die Stärke der Argumentation an. - Konkrete Fähigkeiten: Meta-Bezeichnungen
/Geschmack,/Grillen,/Grill-mit-Anleitungen, und/plan.
Produktmerkmale des Agenten
Untervertreter
Unabhängige Aufgaben können sich verzweigen.
Arbeitsbäume
Die Zweige bleiben während der parallelen Arbeit voneinander getrennt.
JSONL-Protokoll
Lokale Ereignisse, die nur angehängt werden können, unterstützen die Wiedergabe.
Lebenslauf
Lebenslauf von Muse setzt unterbrochene Sitzungen fort.
Fertigkeiten
/Geschmack, /Grillen, /Grill-mit-Anleitungen, /plan.
Dank dieser Funktionen ist Muse Code für den breiteren Markt für Programmieragenten von Bedeutung, auf dem neben der Modellintelligenz auch Planung, Isolation, Wiedergabe und Tool-Disziplin eine wichtige Rolle spielen. Die Leitfaden: OpenClaw vs. Claude Code vs. OpenCode bietet nützliche Hintergründe für diese Unterschiede auf Produktebene.
Behauptungen zum Start und erste Reaktionen der Community
Eine Reaktion ist keine Bestätigung
Ausbildung + langfristige Perspektive
Mehr Programmierleistung, Vielfalt der Umgebungen, Co-Training und ein Stresstest mit über 1.000 Tool-Aufrufen.
Preis und OpenCode
Ein einzelner Reddit-Nutzer lobte seine frühen Erfahrungen mit dem Programmieren und deren Nutzen.
Datenschutz + Zuverlässigkeit
Andere Nutzer äußerten Bedenken hinsichtlich des Datenverbrauchs, des Standardpreises, der Verfügbarkeit und der anfänglichen Zuverlässigkeit.
Laut der KI-Abteilung von Meta erhielt Muse Spark 1.2 mehr Rechenleistung für das Programmiertraining, vielfältigere Umgebungen, einen stärkeren Fokus auf die Generierung und Fehlerbehebung ganzer Repositorys sowie ein gemeinsames Training mit Muse Code. Ein separates Start-Thread beschreibt einen bis zu 24 Stunden dauernden Stresstest mit mehr als 1.000 Tool-Aufrufen auf NVIDIA-Hopper-GPUs.
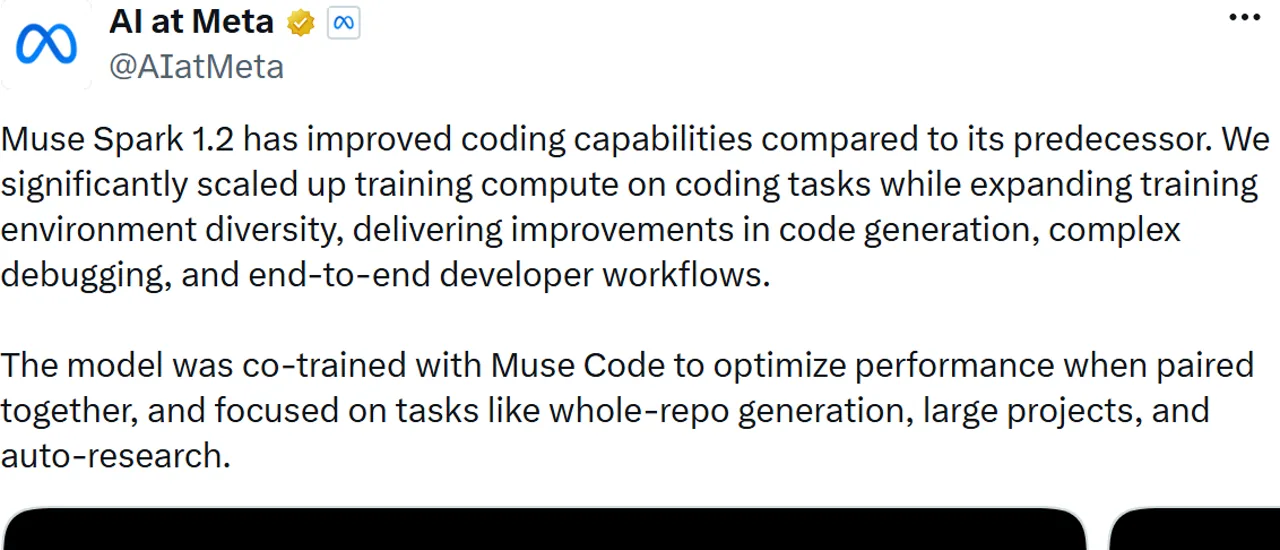
Das ist zwar eine beeindruckende Demonstration, stellt jedoch keine gemessene allgemeine Erfolgsquote dar. Sie gibt keinen Aufschluss darüber, wie oft der Agent das richtige Werkzeug ausgewählt, Fehler behoben, doppelte Aufrufe vermieden oder eine normale Repository-Aufgabe ohne Eingriffe abgeschlossen hat.
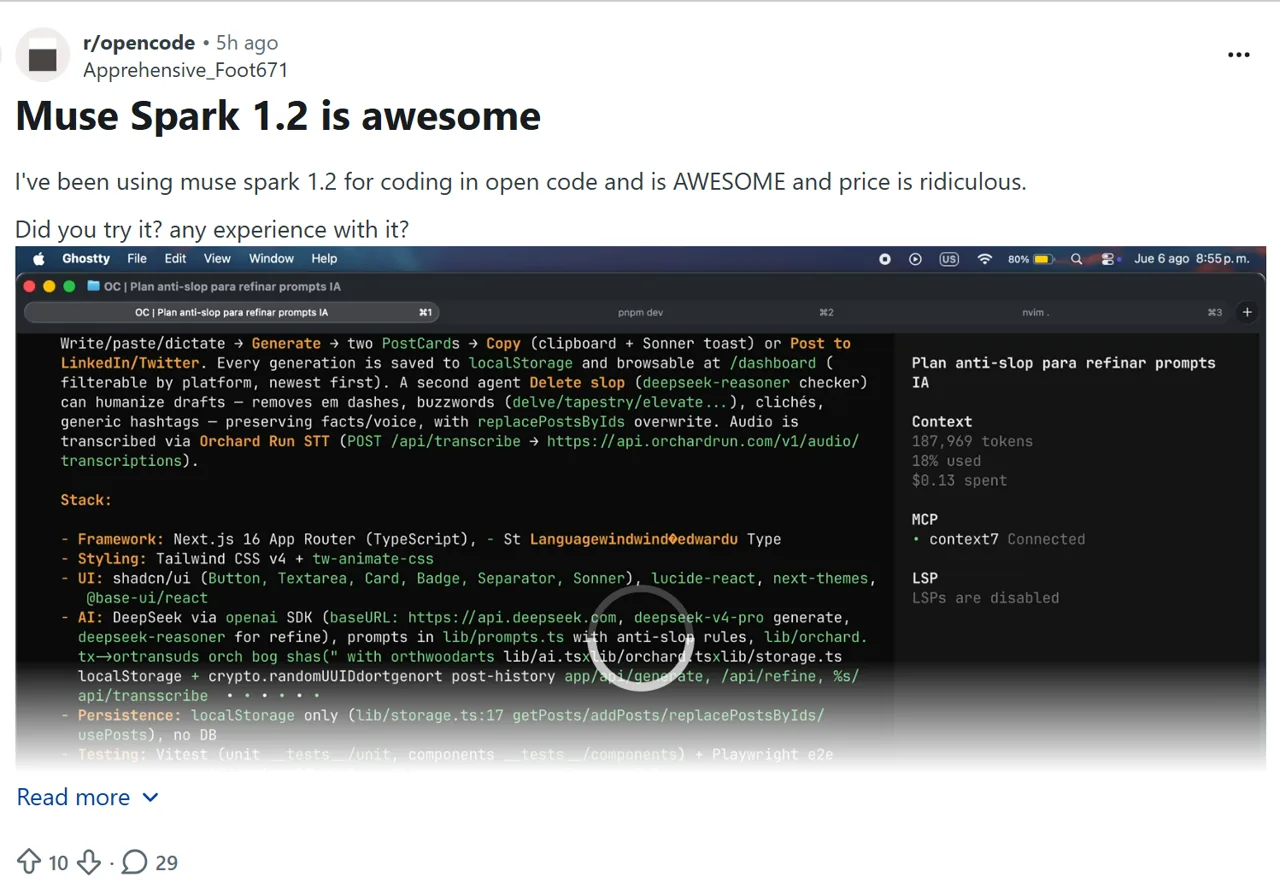
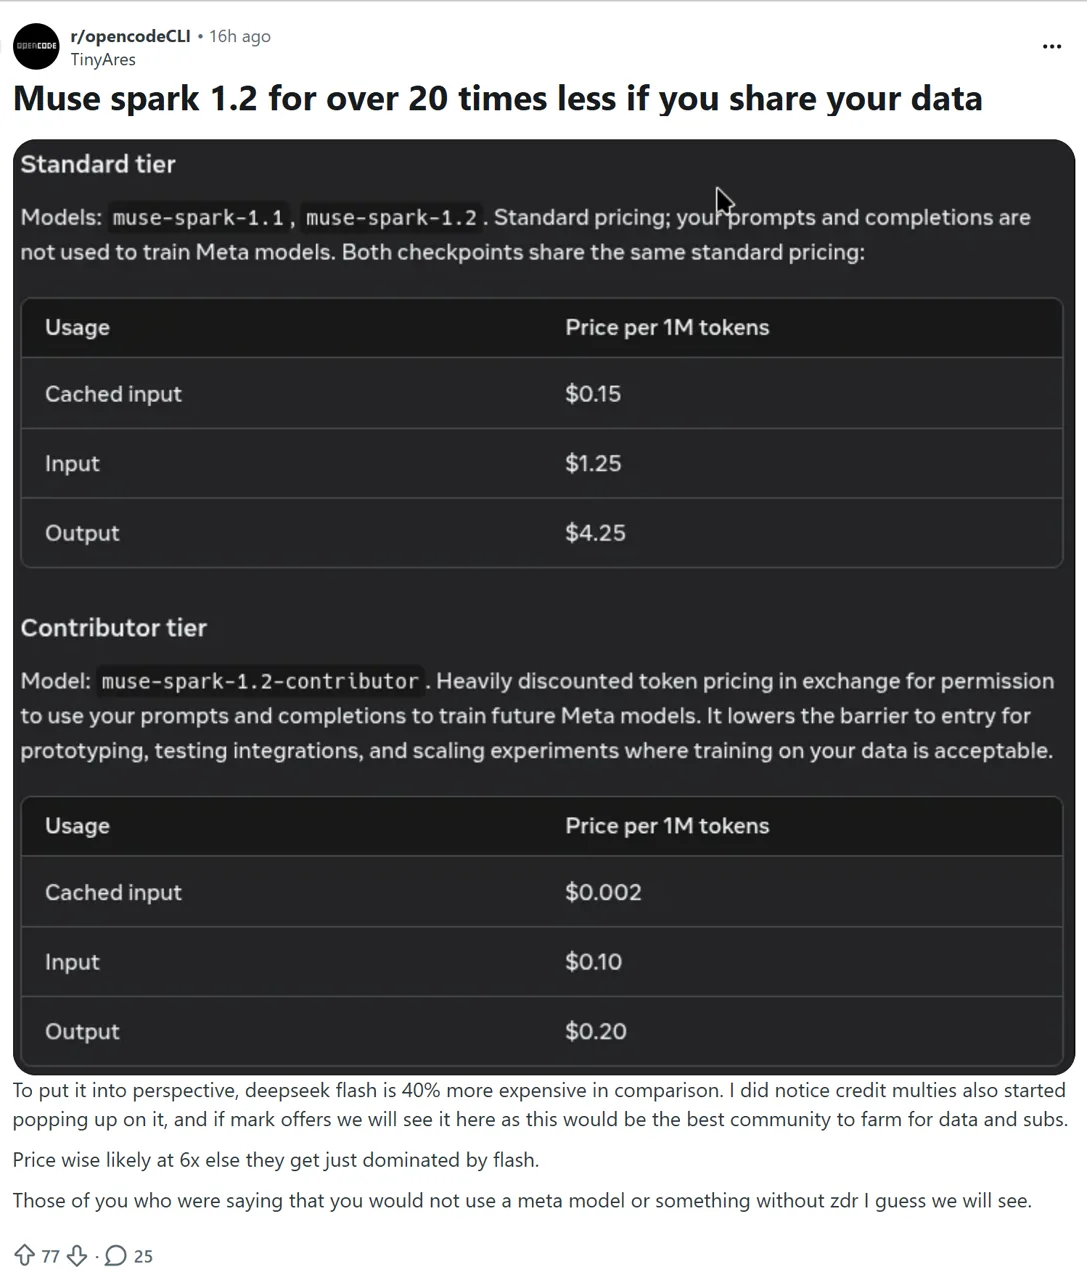
Die ersten Beiträge auf Reddit sind ebenfalls gemischt. Einer Ein Nutzer von r/opencode berichtete von einer positiven Erfahrung mit OpenCode und lobte den Preis. Ein separater Diskussion zur Preisgestaltung für Mitwirkende Es wurden Fragen zur gestiegenen Datennutzung, zu den Kosten der Standardstufe sowie zur Verfügbarkeit und Zuverlässigkeit aufgeworfen. Dabei handelt es sich um individuelle Reaktionen, nicht um einen Konsens der Community.
Muse Spark 1.2 Programmiertests: 3 von 3 Aufgaben bestanden
In unseren Tests führte das Basismodell „Muse Spark 1.2“ drei kontrollierte Programmieraufgaben über eine OpenAI-kompatible API zur Vervollständigung von Chat-Beiträgen aus. Für jede Aufgabe gab es einen Versuch, ohne Wiederholungsversuche und ohne manuelle Steuerung. Wir haben die in temporären Repositorys zurückgegebenen Dateien anhand öffentlicher und versteckter Prüfkriterien ausgewertet. Die Ausführung des Muse-Code-Agenten wurde nicht getestet, ebenso wenig wie die Zuverlässigkeit der Tool-Aufrufe; daher sollten diese Ergebnisse nicht als Benchmark für den Agenten gewertet werden.
Ergebnis nach einem Versuch
Die Antworten umfassten 6.618 Argumentations-Token. Alle drei Schlussfolgerungsgründe lauteten Stopp, und im Feld „Anbieter“ wurde „Meta“ angegeben.
Test 1: Behebung eines Fehlers bezüglich der Idempotenz in Python — Bestanden
Verhindern Sie doppelte Überweisungen, ohne die öffentliche API zu ändern
Das Modell identifizierte die fehlende Schutzmaßnahme für die Request-ID, fügte die kleinste sichere Korrektur hinzu und stellte einen Regressionstest bereit, wobei die atomaren Bilanzaktualisierungen beibehalten wurden.
Der ursprüngliche versteckte Auswerter verlangte fälschlicherweise einen doppelten Aufruf, um einen Wert zurückzugeben. Falsch, obwohl die Aufgabe lediglich vorsah, dass dem Absender keine doppelte Gebühr berechnet werden darf. Nachdem wir diese erfundene Anforderung an den Rückgabewert korrigiert hatten, bestand die unveränderte erste Antwort alle sechs Tests. Wir haben weder einen erneuten Versuch unternommen noch die Modellausgabe bearbeitet.
Test 2: Refactoring mehrerer TypeScript-Dateien — Bestanden
Getrennte Validierung, Persistenz und Protokollierung von Prüfvorgängen
Die zurückgegebenen Dateien behielten den öffentlichen Routenvertrag, striktes TypeScript und die einzige Transaktion bei, die sowohl Auftrags- als auch Audit-Schreibvorgänge abdeckt. Zudem wurden gezielte Validierungstests ohne Laufzeitabhängigkeit hinzugefügt.
Der erste Bewerter verglich Objekte mit Rohdaten JSON.stringify, sodass gleichwertige Objekte mit unterschiedlicher Reihenfolge der Schlüsseleinfügung als ungleich erschienen; unter Windows npx Auch der Startvorgang schlug vor der Typprüfung fehl. Mit einem reihenfolgeunabhängigen Vergleichsoperator und einem Windows-sicheren Befehlsaufruf bestand die ursprüngliche Antwort alle Prüfungen. Auch hier erfolgte kein modellbasierter Wiederholungsversuch.
Test 3: JSONL-Repository-Funktion – Bestanden
Anweisungen für das gesamte Repository befolgen
JSONL hinzufügen, ohne die CSV-Datei zu beschädigen
Das Modell umfasste die Erkennung von Erweiterungen, Fehlermeldungen bei fehlerhaften Zeilen (beginnend bei 1), atomare Ausgabe, Sicherheit bei Trockenläufen, gezielte Tests, Hilfetext sowie ein README-Beispiel.
Was die Tests zeigen: Muse Spark 1.2 kann in einem einzigen Durchlauf brauchbare Patches für mehrere Dateien liefern, Kompatibilitätsbeschränkungen berücksichtigen, Tests hinzufügen und eine überschaubare, repositoryweite Funktion bearbeiten. Die durchschnittlichen gemeldeten Kosten beliefen sich auf etwa $0,0151 pro Aufgabe, doch handelte es sich hierbei um kleine Testfälle, die nicht zur Prognose der Kosten für eine große Codebasis herangezogen werden sollten.
Für wen ist Muse Spark 1.2 geeignet?
Entscheidungshilfe
Kontrollierte Bewertung
Öffentlicher oder synthetischer Code, messbare Aufgaben, Anforderungen an große Kontexte und ein vielversprechendes 3/3-Ergebnis des Basismodells.
Nachweis des Maklers erforderlich
Das Verhalten von Muse Code, stabile Ratenbegrenzungen, wiederholte Tool-Aufrufe oder umfassende Repository-Benchmarks sind Entscheidungskriterien.
Sensible Programmierung oder hohe Leistung
Verwenden Sie die Standardstufe oder vergleichen Sie Alternativen, wenn Datenschutz und die Kosten für Reasoning-Token im Vordergrund stehen.
Verwenden Sie das Standardmodell für sensiblen Code, es sei denn, Ihre Organisation hat die Bedingungen für Mitwirkende gesondert genehmigt. Falls sich durch den Standardausgabepreis die Wertberechnung ändert, vergleichen Sie diese mit den aktuellen Codex-Preise, den Claude-Code und die Kosten für andere Kodierungsbeauftragte, bevor Sie sich für einen Arbeitsablauf entscheiden.
Fazit zum Testbericht zu Muse Spark 1.2
Muse Spark 1.2 hat sich einen Platz auf der Auswahlliste der Bewertung gesichert, was jedoch keine automatische Empfehlung für den Einsatz in der Produktion bedeutet. Der Kontext des 1M-Tokens, die vertraute API-Struktur, die günstigen Preise für Mitwirkende, drei Programmierdurchläufe beim ersten Versuch und die hervorragenden Ergebnisse bei den Meta-Run-Muse-Code-Tests machen es schwer, dieses Projekt zu ignorieren. Außerdem hat Meta die Details zur Methodik besser offengelegt als viele andere Projekte bei ihrer Einführung.
Die Einschränkungen sind ebenso konkret. Die Preise für Mitwirkende gehen mit einem Kompromiss hinsichtlich der Datennutzung einher. Standard-Ausgabe- und Schlussfolgerungstoken können die tatsächlichen Kosten in die Höhe treiben. Die Spitzenwerte von Meta im Bereich der Programmierung konnten nicht als übereinstimmende Einträge auf den öffentlichen Boards von Terminal-Bench oder DeepSWE reproduziert werden, und unser Praxistest umfasst drei Aufgaben für Basismodelle anstelle der Ausführung von Muse-Code-Agenten.
Der sinnvolle Ansatz ist ein kontrollierter Test mit nicht sensiblen Code, bei dem die Rohdaten zur Nutzung und die lokale Überprüfung gespeichert werden. Betrachten Sie die gemessenen Kosten und die Latenz als Beispiel für kleine Aufgaben und testen Sie anschließend die Größe Ihres eigenen Repositorys, die Fehlerbehebung und den Agent-Workflow, bevor Sie sich für den Einsatz in der Produktion entscheiden.
Muse Spark 1.2 – Häufig gestellte Fragen
Was ist Muse Spark 1.2?
Muse Spark 1.2 ist das auf Programmierung ausgerichtete Modell von Meta, das am 5. August 2026 eingeführt wurde. Es verfügt über ein Kontextfenster von 1 Million Token und ist über Muse Code, die Meta Model API und OpenRouter zugänglich.
Ist Muse Spark 1.2 dasselbe wie Muse Code?
Nein. „Muse Spark 1.2“ ist das Modell; „Muse Code“ ist ein separater Beta-Terminal-Agent, der darauf basiert. „Muse Code“ bietet zusätzliche Produktfunktionen wie Subagenten, isolierte Git-Worktrees, Ereignisprotokollierung, Wiederaufnahme und gebündelte Skills.
Wie viel kostet die Muse Spark 1.2 API?
Das Standardmodell kostet $1,25 für den Input, $0,15 für den zwischengespeicherten Input und $4,25 für den Output pro Million Token. Das Contributor-Modell kostet $0,10 Eingabe, $0,002 zwischengespeicherte Eingabe und $0,20 Ausgabe.
Verwendet Meta Daten der Muse Spark-API für das Training?
Meta gibt an, dass Daten der Standardstufe nicht zur Verbesserung von Meta-Produkten verwendet werden. Daten der Contributor-Stufe können zur Verbesserung von Meta-Produkten verwendet werden; daher sollte privater oder proprietärer Code den Standardweg nutzen, sofern eine Organisation nichts anderes genehmigt.
Ist Muse Spark 1.2 in den öffentlichen Ranglisten von Terminal-Bench oder DeepSWE vertreten?
Bei einer Überprüfung am 7. August 2026 war es auf keiner der beiden öffentlichen Plattformen gelistet. Meta meldet 82,91 TP40T auf Terminal-Bench 2.1 mit Muse Code und 59,31 TP40T auf DeepSWE, doch dabei handelt es sich um von Meta ermittelte Ergebnisse.
Wurde Muse Spark 1.2 im Rahmen dieses Testberichts in der Praxis getestet?
Ja. In drei Tests mit dem Basismodell, bei denen jeweils nur ein Versuch unternommen wurde, hat Muse Spark 1.2 eine Python-Fehlerbehebung, eine TypeScript-Umgestaltung und eine JSONL-Repository-Funktion erfolgreich durchgeführt. Die durchschnittliche Latenz betrug 12,98 Sekunden und die gemeldeten Gesamtkosten beliefen sich auf $0,045362. Die Zuverlässigkeit des Muse Code-Agenten und der Tool-Aufrufe wurde nicht getestet.
Wie können Entwickler auf Muse Spark 1.2 zugreifen?
Meta nennt drei Möglichkeiten: den „Muse Code Beta Terminal Agent“, die „Meta Model API“ und „OpenRouter“. Im offiziellen Kochbuch wird ein OpenAI-SDK-kompatibler Client mit der Basis-URL https://api.meta.ai/v1 verwendet.