
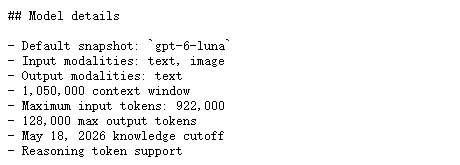
Kurze Antwort: GPT-6 Luna ist das auf hochvolumige Aufgaben spezialisierte Modell von OpenAI. Die offizielle API gibt die Standardtarife mit $0,10 pro 1 Million Eingabetoken und $0,50 pro 1 Million Ausgabetoken an, bei einem Kontextfenster von 1,05 Millionen Token und einer maximalen Ausgabe von 128.000 Token. Die wichtigste Kaufentscheidung ist, ob die Antworten des Modells Ihre Aufgabenanforderungen zu akzeptablen Gesamtkosten erfüllen.
OpenAI beschreibt GPT-6 Luna als sein effizientestes Modell für fokussierte Aufgaben mit hohem Durchsatz. Bei dieser Formulierung handelt es sich um eine Positionierung des Anbieters und nicht um einen gemessenen Qualitätswert. Diese Bewertung setzt die veröffentlichte Spezifikation in Kauf- und Architekturentscheidungen um und dokumentiert anschließend die öffentlichen Reaktionen mit Quellenangabe. Außerdem haben wir drei kleine Aufgaben mit dem Modell durchgeführt, wobei ID, Route, Prompt-Set, Rohausgabe und Nutzung beibehalten wurden. Die Ergebnisse der Aufgaben werden im Folgenden als ein beobachteter Durchlauf dargestellt, nicht als offizieller Benchmark.
Kurzfazit
Luna ist die pragmatische, kostengünstige Option in der offiziellen Preisliste: Sie bietet denselben Hauptkontext und dieselben Ausgabegrenzen wie Sol, verlangt jedoch nur einen Bruchteil der Token-Gebühren. Das macht sie für gezielte, wiederholte Aufrufe attraktiv, doch der niedrige Preis ist ohne einen kontrollierten Test kein Beweis für geringere Latenz oder geringere Qualität.
Die wichtigste Unterscheidung ist nicht einfach nur “intelligent” versus “schnell”, sondern die Art der Arbeitslast. GPT-6 Luna verfügt über denselben Kontextumfang und dieselben Ausgabegrenzen wie sein Schwestermodell, doch aufgrund seiner Positionierung und seines Preises ist ein anderer Einsatzbereich sinnvoll. Vergleichen Sie die umfassendere Leitfaden zur Auswahl von KI-Modellen und die bestes AI-Modell für die Codierung Leitfaden für den Fall, dass die Aufgabe mehrere Anbieter betrifft.
GPT-6 Luna auf einen Blick
Die folgende Tabelle entspricht dem aktuellen Offizielle Seite zum GPT-6-Modell „Luna“. Die Kontextkapazität ist nicht mit der empfohlenen Prompt-Größe gleichzusetzen, und die maximale Eingabe ist unabhängig vom Kontextfenster der Überschrift.
gpt-6-lunaBeide Schwestermodelle unterstützen laut dokumentiertem Funktionsumfang strukturierte Ausgaben, Funktionsaufrufe, Streaming, Prompt-Caching, Bild-Eingaben, Dateisuche und Websuche. Das genaue Verhalten des Tools hängt weiterhin vom Endpunkt, dem Konto und der Konfiguration der Anfrage ab; schließen Sie einen erfolgreichen Tool-Lauf nicht allein aufgrund eines aktivierten Kontrollkästchens für eine bestimmte Funktion ab.
Was den familiären Kontext betrifft, so ist die Testbericht zum GPT-6 Astra zeigt, wie ein verwandter GPT-6-Artikel die Dokumentation des Anbieters, die Plattformwege und die zugeordneten Reaktionen voneinander trennt.
Preise für GPT-6 Luna und die 272K-Regel
Zu den Standardtarifen beträgt die Preisseite für OpenAI Gibt $0,10 Eingaben, $0,01 zwischengespeicherte Eingaben, $0,125 Cache-Schreibvorgänge und $0,50 Ausgaben pro 1 Mio. Tokens an. Cache-Schreibvorgänge betragen das 1,25-Fache der nicht zwischengespeicherten Eingaben. Die Preise für „Batch“ und „Flex“ betragen 501 TP40T im Standardmodus, der „Fast“-Modus kostet das Doppelte des geltenden Tarifs, und für die regionale Verarbeitung fallen, sofern verfügbar, zusätzlich 101 TP40T an.
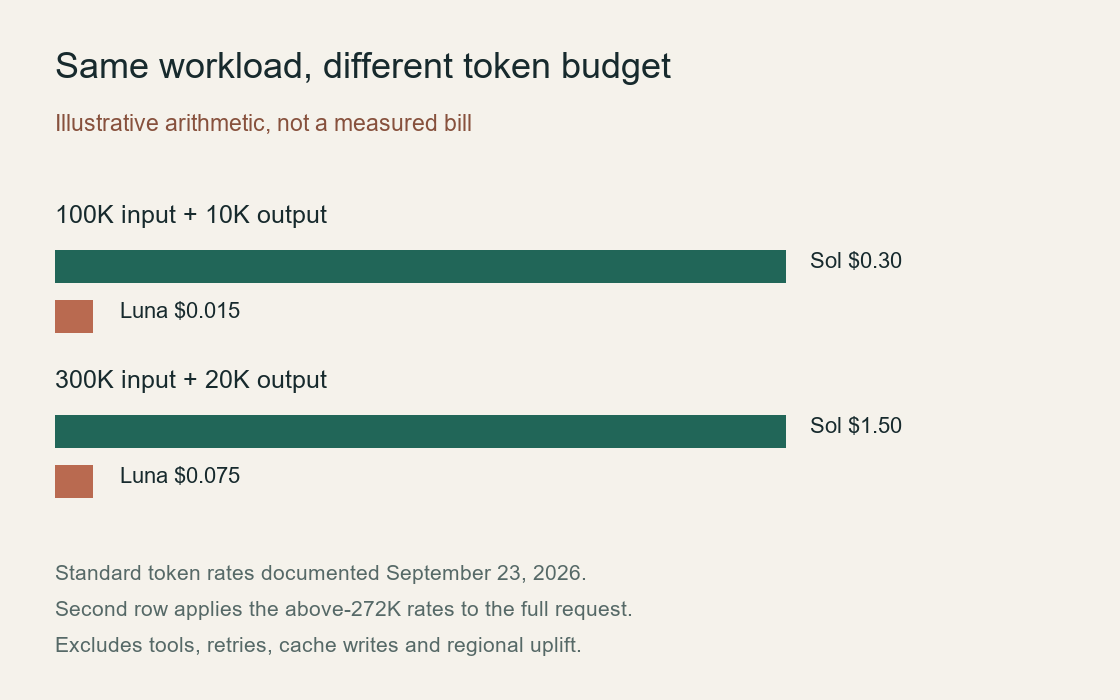
Die Spalte „Long-Context“ wird anhand der Regel von OpenAI berechnet: Bei einer Eingabe von über 272K verdoppeln sich die Eingabe- und Cache-Raten, und die Ausgabe wird für die gesamte Anfrage mit 1,5 multipliziert. Es handelt sich nicht um eine Abrechnung mit gemischten Raten. Als praktische Budget-Richtwert gilt: 100.000 Eingaben plus 10.000 Ausgaben kosten etwa $0.015 vor Tools oder regionaler Wertsteigerung; ein Beispiel mit 300.000 Eingaben und 20.000 Ausgaben kostet etwa $0.075 zu den Langzeit-Konditionen.
Ein großes Kontextfenster kann nützlich sein, auch wenn es nicht einfach zu füllen ist. Das Abrufen von Daten, die Auswahl von Datenblöcken, die Wiederverwendung von Cache-Daten und die Begrenzung der Ausgabe sind wichtiger als die Zahl von 1,05 Millionen in der Überschrift. Siehe den Preisaufschlüsselung für GPT-6 Astra für eine entsprechende Erläuterung zu Kontext-Schwellenwerten und Cache-Mechanismen.
GPT-6 Luna: API-Eignung, Tools und Einschränkungen
OpenAI empfiehlt die Responses-API für integrierte Tools und den Aufruf von Funktionen. Chat Completions unterstützt den Aufruf von Funktionen nur, wenn logisches_Denken ist auf keine. Das ist ein Implementierungsdetail, das man vor der Migration beachten sollte: Eine Anfrage kann zwar syntaktisch korrekt sein, aber dennoch nicht dem Verhalten des Tools entsprechen, das Ihre aktuelle Integration erwartet.
Die aktuelle Tabelle zu den Ratenbeschränkungen enthält die folgenden Standardstufen. RPM steht für „Requests pro Minute“, TPM für „Tokens pro Minute“ und der Wert „Queue“ bezeichnet das Limit für Batch-Tokens.
Überprüfen Sie vor dem Produktionsstart die genaue Stufe, den Endpunkt, den Streaming-Modus und den Tool-Vertrag in Ihrem eigenen Konto. Die Leitfaden zu den Nutzungsbeschränkungen des Codex Dies liefert einen nützlichen Kontext dafür, warum die veröffentlichte Obergrenze eines Modells nicht mit dem tatsächlichen Kontingent eines Kontos übereinstimmt.
Was die technischen Daten von GPT-6 Luna vermuten lassen
Dies ist eine Anpassungskarte, kein Benchmark. Verwenden Sie die Leitfaden zum Workflow für All-in-One-KI-Modelle wenn es eigentlich darum geht, wie man innerhalb eines wiederholbaren Prozesses zwischen Modellen wechselt, und nicht darum, welches einzelne Modell am überzeugendsten klingt.
In unseren Tests: GPT-6 Luna bei drei praktischen Aufgaben
Am 23. September 2026 haben wir eine kleine JavaScript-Korrektur, ein dreizeiliges Entscheidungsmemo und die JSON-Extraktion getestet. Die unten aufgeführten Ergebnisse sind vollständige Antworten für die Modell-ID gpt-6-luna. Bei früheren Versuchen traten vorübergehende Überlastungsfehler auf, daher sollten diese Ergebnisse nicht als Zuverlässigkeitsmessungen aus dem ersten Versuch gewertet werden. Wir untersuchen, was die Antworten enthalten, was ein Leser wiederverwenden kann und was noch nicht getestet wurde.
Code-Überarbeitung: Beibehaltung des Wertes Null ohne Neuschreiben der Funktion
Die Programmieraufgabe umfasste eine Fehlerdiagnose, einen minimalen Patch und zwei Regressionstests. Das gezeigte Ergebnis ist der abgeschlossene Wiederholungsversuch; der genaue Wortlaut der Eingabeaufforderung ist nicht verfügbar.
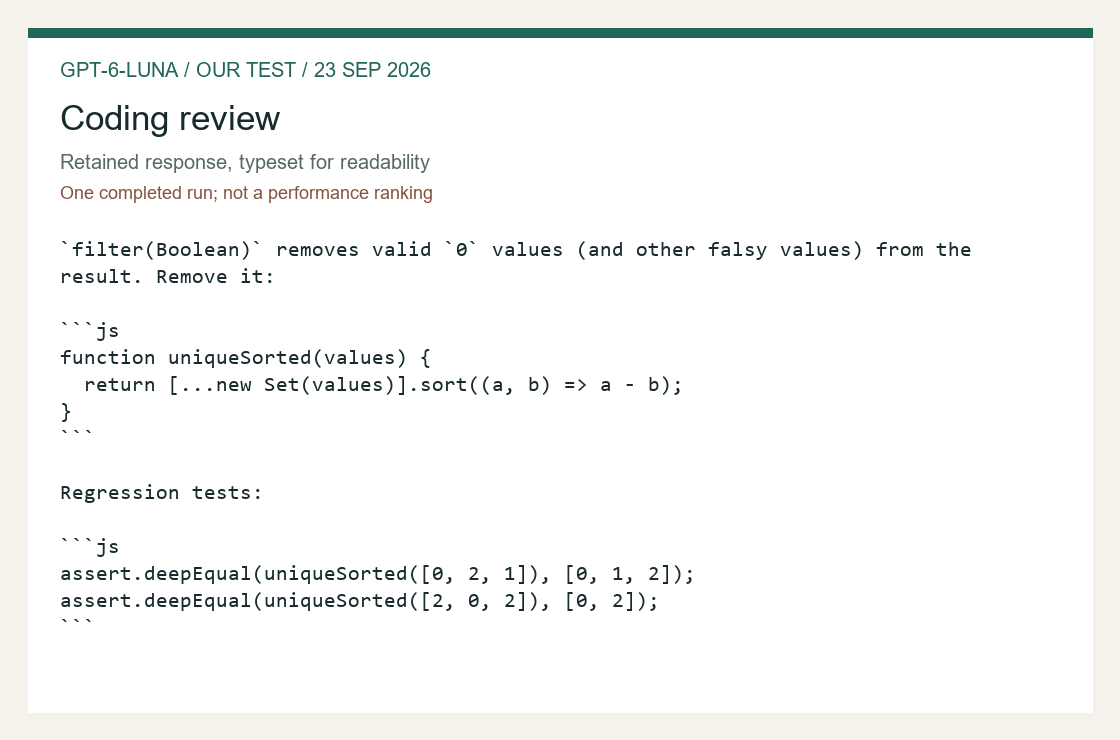
`filter(Boolean)` entfernt gültige `0`-Werte (und andere „falsy“-Werte) aus dem Ergebnis. Entferne diese Funktion:

```js
function uniqueSorted(values) {
  return [...new Set(values)].sort((a, b) => a - b);
}
```

Regressionstests:

```js
assert.deepEqual(uniqueSorted([0, 2, 1]), [0, 1, 2]);
assert.deepEqual(uniqueSorted([2, 0, 2]), [0, 2]);
```
Gemeldete Nutzung für diese abgeschlossene Antwort: 61 Eingabetoken, 317 Vervollständigungstoken, insgesamt 378 Token. Die Länge der vollständigen Antwort kann auch Logik-Token enthalten; es handelt sich nicht lediglich um die Länge der sichtbaren Antwort.
In Lunas vollständiger Antwort wurde korrekt festgestellt, dass filter(Boolean) löscht gültige Nullwerte und hat diesen letzten Schritt entfernt. In der Antwort wurden die bestehende setbasierte Deduplizierung und der numerische Komparator beibehalten. Für ein Wartungsticket mit eng gefasstem Umfang ist dies eine nützliche Darstellungsform: eine kurze Erläuterung, gefolgt von der genauen Funktion. Es gab keine unnötige Neugestaltung der API, keine neuen Paketabhängigkeiten und keine irrelevanten Formatierungsänderungen, die die Korrektur verschleiern könnten.
Die Integrationslücke liegt in den Tests. Luna hat assert.deepEqual zweimal, ohne jedoch einen „assert“-Import einzufügen. Würde man diese Anweisungen in eine neue Node.js-Datei einfügen, würde die Ausführung fehlschlagen, noch bevor eine der Assertions ausgeführt wird. Die Assertions selbst zielen auf relevante Kombinationen aus Null, Sortierung und Duplikaten ab, doch das Beispiel ist nicht in sich geschlossen. Fügen Sie einen strikten „assert“-Import hinzu oder passen Sie die Anweisungen an Ihren bestehenden Testrunner an. Das ist zwar nur eine kleine Korrektur, verdeutlicht jedoch, warum eine plausible Code-Lösung und ein ausführungsbereites Artefakt unterschiedliche Akzeptanzkriterien sind.
Die gespeicherte Programmierantwort ist ein Wiederholungsversuch. Ein früherer Versuch hatte die Ausgabegrenze von 900 Token erreicht; der abgeschlossene Wiederholungsversuch verwendete eine kürzere Eingabeaufforderung und eine Obergrenze von 1.200 Token. Der genaue Wortlaut des erneuten Versuchs wurde nicht gespeichert, daher stellen wir die ursprüngliche Programmieraufforderung nicht so dar, als hätte sie diese Antwort erzeugt. Dies verhindert einen sauberen, direkten Vergleich hinsichtlich Qualität oder Latenz mit Sol. Außerdem ergibt sich daraus eine praktische Erkenntnis für den Einsatz: Zeichnen Sie die Version der Aufforderung und den Grund für den Abschluss auf, und behandeln Sie eine abgeschnittene Antwort niemals als erfolgreichen Code-Patch.
Dreiklang-Synthese: Die Entscheidung bedingt halten
Fassen Sie die folgenden drei Notizen zu einem prägnanten Entscheidungsmemo zusammen, das folgende Punkte enthält: Entscheidung, Begründung, Risiken und nächster Schritt. Anmerkung A: Ein Kontextfenster von 1,05 Millionen Token kann große Quelldatensätze aufnehmen, macht jedoch nicht jede Anfrage kostengünstig. Anmerkung B: Ab 272.000 Eingabetoken steigen die dokumentierten Eingabe-/Cache-Raten, und die Ausgabe wird für die gesamte Anfrage multipliziert. Anmerkung C: Das Abrufen und die Wiederverwendung von Cache-Daten können die Kosten für wiederholte Prompts senken, doch die Akzeptanzkriterien müssen weiterhin getestet werden.
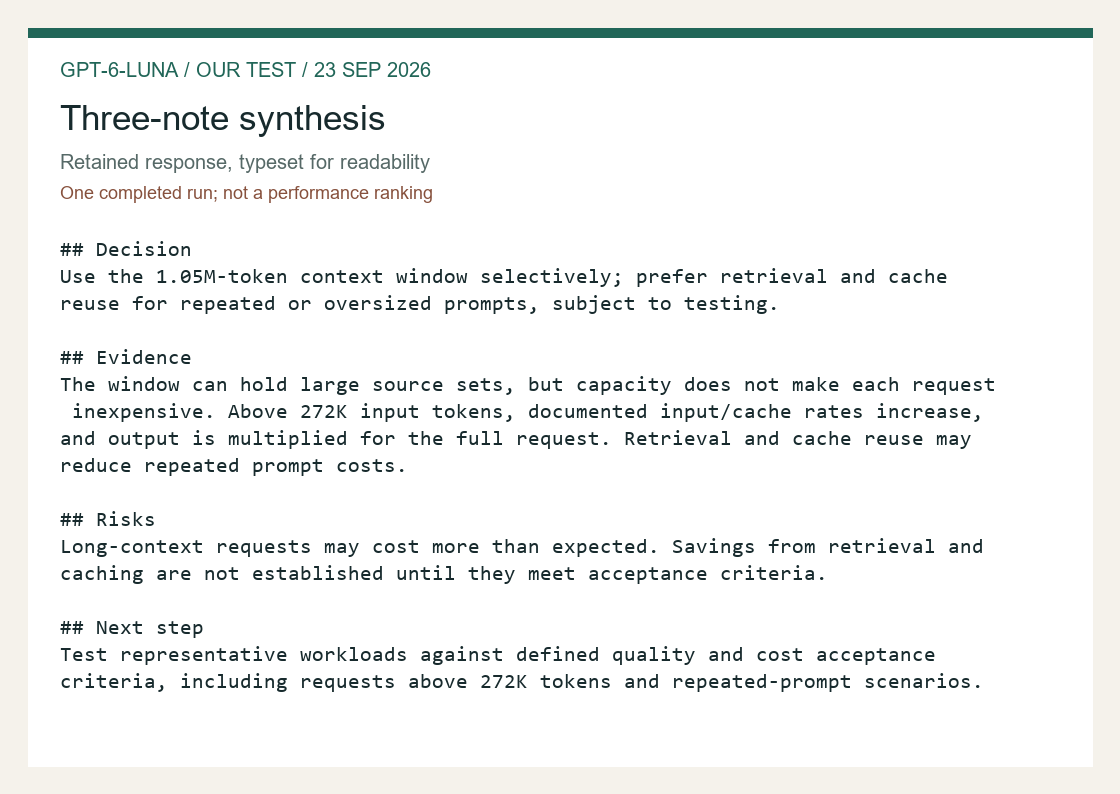
## Entscheidung
Das Kontextfenster mit 1,05 Millionen Token sollte selektiv eingesetzt werden; bei wiederholten oder übergroßen Eingabeaufforderungen sind Abruf und Cache-Wiederverwendung zu bevorzugen, vorbehaltlich entsprechender Tests.

## Begründung
Das Fenster kann große Quelldatensätze aufnehmen, doch die Kapazität allein macht nicht jede Anfrage kostengünstig. Ab 272.000 Eingabetoken steigen die dokumentierten Eingabe-/Cache-Raten, und die Ausgabe für die gesamte Anfrage vervielfacht sich. Abruf und Cache-Wiederverwendung können die Kosten für wiederholte Eingabeaufforderungen senken.

## Risiken
Anfragen mit langem Kontext können mehr kosten als erwartet. Einsparungen durch Abruf und Zwischenspeicherung gelten erst dann als gesichert, wenn sie die Akzeptanzkriterien erfüllen.

## Nächster Schritt
Testen Sie repräsentative Arbeitslasten anhand definierter Qualitäts- und Kostenakzeptanzkriterien, einschließlich Anfragen mit mehr als 272.000 Token und Szenarien mit wiederholten Eingabeaufforderungen.
Gemeldete Nutzung für diese abgeschlossene Antwort: 99 Eingabe-Token, 223 Vervollständigungs-Token, insgesamt 322 Token. Die Länge der vollständigen Antwort kann auch Logik-Token enthalten; es handelt sich nicht lediglich um die Länge der sichtbaren Antwort.
Luna behielt alle vier angeforderten Abschnitte des Memos bei und knüpfte seine Empfehlung an die Durchführung von Tests. Das Unternehmen behielt die Unterscheidung zwischen dem Vorhalten eines großen Quelldatensatzes und dessen wirtschaftlicher Verarbeitung bei. Außerdem wies es darauf hin, dass Einsparungen bei der Abfrage und beim Caching erst dann als gesichert gelten, wenn sie die Akzeptanzkriterien erfüllen. Diese Zurückhaltung ist bei wiederkehrenden internen Zusammenfassungen sinnvoll, bei denen eine attraktive Empfehlung andernfalls nach mehreren Überarbeitungsrunden zu einem unbegründeten Versprechen werden könnte.
Die Aufgabe umfasste drei kurze Notizen und lediglich 99 gemeldete Prompt-Token. Es als Long-Context-Benchmark zu bezeichnen, würde das Geschehene überbewerten. Die Antwort zeigt, dass Luna in diesem Durchlauf ein winziges Paket an bereitgestellten Belegen strukturieren kann; es belegt jedoch weder die Wiederauffindbarkeit noch die Dokumentabdeckung, die Widerstandsfähigkeit gegenüber widersprüchlichen Anweisungen oder die Korrektheit bei nahezu maximaler Eingabegröße. Bevor Sie das System für wiederkehrende Zusammenfassungen einsetzen, sollten Sie Fälle mit widersprüchlichen Datumsangaben und fehlenden Eigentümern einbeziehen und anschließend prüfen, ob die Unsicherheit in der endgültigen Formulierung bestehen bleibt.
JSON-Extraktion: Unbekannte explizit behandeln
Extrahieren Sie die folgenden Felder aus dieser Aufgabenbeschreibung und geben Sie ausschließlich gültiges JSON mit den Schlüsseln „customer“, „priority“, „deadline“ und „unknowns“ zurück. Aufgabenbeschreibung: Kunde: Northwind Labs. Priorität: hoch. Frist: 04.10.2026. Der Verantwortliche ist nicht genannt und das Budget ist nicht bestätigt.
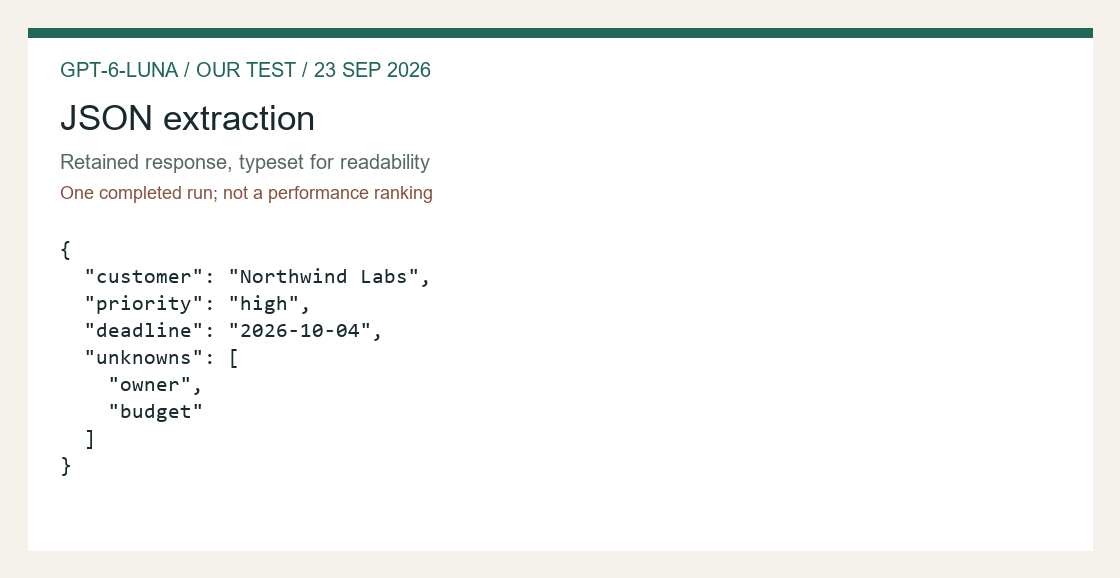
{"Kunde":"Northwind Labs","Priorität":"hoch","Frist":"04.10.2026","Unbekannte":["Verantwortlicher","Budget"]}Gemeldete Nutzung für diese abgeschlossene Antwort: 64 Eingabetoken, 63 Vervollständigungstoken, insgesamt 127 Token. Die Länge der vollständigen Antwort kann auch Logik-Token enthalten; es handelt sich nicht lediglich um die Länge der sichtbaren Antwort.
Die Extraktionsergebnisse sind in dieser kleinen Stichprobe der stichhaltigste Grund, Luna für eng gefasste, wiederholbare Aufgaben in Betracht zu ziehen. Das Modell lieferte gültiges JSON mit den angeforderten Schlüsseln, kopierte „Northwind Labs“ und die Frist im ISO-Format korrekt und behielt „Eigentümer“ und „Budget“ als unbekannte Werte bei. Es gab kein Konversationspräfix, das entfernt werden musste. Sol erzeugte bei derselben Extraktionsaufforderung identische JSON-Daten, sodass die vorliegenden Erkenntnisse keinen Vorteil des teureren Modells bei diesem Datensatz belegen.
Die syntaktische Gültigkeit ist nur die erste Hürde. Ein JSON-Parser akzeptiert problemlos einen erfundenen Eigentümer, den falschen Kunden oder ein gültig aussehendes, aber falsches Datum. Ein Schema kann Felder und Typen einschränken; es kann jedoch nicht nachweisen, dass der Inhalt der Quelle entspricht. Für diese Aufgabe bildet die Überprüfung der drei bekannten Werte anhand des Briefings sowie die Feststellung, dass die beiden fehlenden Felder weiterhin unbekannt bleiben, die semantische Hürde. Bei großem Umfang sollten Konflikte und unklare Daten zur Überprüfung weitergeleitet werden, anstatt sie durch Vermutungen zu beheben.
Eine Validierungsprüfung, die über analysierbares JSON hinausgeht
Das Folgende ist ein Beispiel für eine redaktionelle Validierung und keine zusätzliche Modellantwort. Es wird lokal in Node.js ausgeführt und führt keine Modellabfrage durch. Es überprüft die oben beschriebene spezifische Fixture; es handelt sich nicht um eine allgemeine Bewertung des Modells.
const assert = require('node:assert/strict');
const response = '{"customer":"Northwind Labs","priority":"high","deadline":"2026-10-04","unknowns":["owner","budget"]}';
const value = JSON.parse(response);
assert.deepStrictEqual(Object.keys(value).sort(), ['customer', 'deadline', 'priority', 'unknowns']);
assert.equal(value.customer, 'Northwind Labs');
assert.equal(value.priority, 'high');
assert.equal(value.deadline, '2026-10-04');
assert.deepStrictEqual(value.unknowns, ['owner', 'budget']);
console.log('Diese Testfallbeschreibung entspricht der Vorgabe. Neue Eingaben benötigen eigene erwartete Werte.');
Der Validator überprüft gezielt sowohl die erwarteten Fakten als auch den Schlüsselsatz. Er lehnt eine Antwort ab, die ein Feld „confident owner“ hinzufügt oder das Datum ändert, obwohl die Antwort weiterhin gültiges JSON ist. Genau diese Werte gehören zu dieser Fixture; ein Produktionsvalidator muss die Erwartungen aus dem Eingabevertrag ableiten und darf nicht für jeden Kunden „Northwind Labs“ fest einprogrammieren. Die Kalendervalidierung und die Berechtigung zur Aktualisierung eines Datensatzes sind separate Prüfungen. Das Bestehen dieses Beispiels bedeutet, dass die gespeicherte Antwort dieser Beschreibung entspricht, nicht jedoch, dass jede zukünftige Extraktion korrekt sein wird.
Wie GPT-6 Luna einen realen Arbeitsablauf verändert
Die technischen Hauptspezifikationen spielen nur dann eine Rolle, wenn sie die Arbeitsweise eines Teams verändern. GPT-6 Luna ist für fokussierte Aufgaben mit hohem Durchsatz ausgelegt, daher lautet die erste Frage: Profitiert Ihr Arbeitsaufkommen von dieser Ausrichtung? Wenn jede Anfrage eine kurze Eingabe, einen eng gefassten Ausgabekontext und einen klaren Abnahmetest hat, lässt sich das Modell in eine wiederholbare Pipeline integrieren. Ist die Aufgabe jedoch mehrdeutig, erfordern sie den Einsatz zahlreicher Tools oder sind mehrere Korrekturrunden wahrscheinlich, ist die umgebende Orchestrierung ebenso wichtig wie der Name des Modells.
Für GPT-6 Luna ist ein zweistufiger Ablauf ein nützliches Produktionsmuster: Zunächst wird eine kompakte Antwort mit expliziter Unsicherheit angefordert, anschließend wird nur der umstrittene oder unvollständige Teil in einen zweiten Durchlauf gesendet. Dies begrenzt die Anzahl überflüssiger Ausgabetoken und macht Fehler sichtbar. Außerdem bietet es einen besseren Vergleichspunkt zu GPT-6 Sol: Die Frage ist nicht, welcher Name stärker klingt, sondern welcher Ansatz die Akzeptanzkriterien mit weniger Wiederholungsversuchen erfüllt.
Ein einfaches Kostenmodell vor dem Versand
Die offizielle Preistabelle sollte in die Einheiten umgerechnet werden, die Ihr Team tatsächlich kauft: Anfragen pro Tag, durchschnittliche Eingabetoken, Anteil an zwischengespeicherten Präfixen, Ausgabetoken und der Prozentsatz der Aufrufe, bei denen die Eingabe 272.000 überschreitet. Eine Tabelle, die nur den angegebenen Eingabepreis erfasst, lässt den Multiplikator für den Langzeitkontext und die Kosten für Wiederholungsversuche außer Acht.
Diese Berechnung ist besonders relevant, wenn man GPT-6 Luna mit GPT-6 Sol vergleicht. Eine kostengünstigere Anfrage kann teuer werden, wenn sie wiederholte Korrekturdurchläufe erfordert; eine leistungsfähigere Anfrage kann hingegen verschwenderisch sein, wenn es sich um eine deterministische Extraktion handelt. Die richtige Vergleichsgrundlage ist eine kleine Stichprobe Ihres eigenen Datenverkehrs mit denselben Eingabeaufforderungen, demselben Schema und denselben Überprüfungsregeln.
Vor der Einführung zu prüfende Fehlerarten
Eine Modellseite gibt Auskunft darüber, welche Endpunkte und Modalitäten dokumentiert sind, kann jedoch nicht garantieren, dass sich Ihre bestehende Anwendung nach der Migration genauso verhält wie zuvor. Überprüfen Sie, ob Streaming-Ereignisse korrekt geparst werden, ob Tool-Aufrufe den Status über mehrere Wiederholungsversuche hinweg beibehalten, ob die strukturierte Ausgabe fehlerhaft formatierte Felder zurückweist und ob Ihre Logging-Pipeline die Modell-ID und die Schlussfolgerungseinstellung für jede Anfrage aufzeichnet.
Genau diese Kriterien machen die praktischen Beobachtungen in diesem Testbericht nützlich, ohne dass sie zu einer Rangliste werden. Unsere drei Aufgaben zeigen, wie die Route mit einem kleinen Codefehler, einem Entscheidungsmemo und einer strengen JSON-Extraktion umgegangen ist. Sie liefern jedoch keine Aussagen zur Latenz, zur Zuverlässigkeit bei hoher Auslastung oder zu einer allgemeinen Qualitätsbewertung.
Ein Entscheidungsrahmen für echte Teams
Eine Modellüberprüfung ist dann sinnvoll, wenn sie jemandem hilft, unter bestimmten Einschränkungen eine Entscheidung zu treffen. Für GPT-6 Luna sind die relevantesten Einschränkungen die Form der Anfrage, die Kosten der Überprüfung, die Kontextgröße, das Ausgabeformat und die Folgen einer falschen Antwort. Die Beschreibung des Anbieters deutet auf fokussierte Aufgaben mit hohem Durchsatz hin, doch ein Team muss diese Beschreibung noch in einen Plan umsetzen, den es überwachen kann. Beginnen Sie damit, die Aufgabe in einem Satz zu formulieren, die Eingabe, die das Modell erhalten wird, die von einem anderen System erwartete Ausgabe sowie den menschlichen Kontrollpunkt, der einen unbemerkten Fehler verhindert.
Der erste Fehler besteht darin, ein Modell aus einer Demo-Eingabe auszuwählen. Eine Demo belohnt flüssiges Schreiben und verschleiert operative Details wie Wiederholungsversuche, Token-Verwaltung, Tool-Berechtigungen und Schemafehler. Ein besserer Vergleich stützt sich auf drei repräsentative Aufträge: eine gewöhnliche Anfrage, eine schwierige Anfrage und eine Anfrage, die abgelehnt oder eskaliert werden sollte. Das Ergebnis ist keine einzelne Punktzahl. Es ist eine kleine Übersicht darüber, wo das Modell Zeit spart, wo es Überwachung benötigt und wo ein anderes Modell – oft GPT-6 Sol – die kostengünstigere oder sicherere Wahl ist.
Beginnen Sie mit dem Abnahmetest
Schreiben Sie den Abnahmetest, bevor Sie die Eingabeaufforderung verfassen. Bei Code kann der Test ein erfolgreicher Unit-Test oder ein Patch sein, der die öffentliche API unverändert lässt. Bei der Datenextraktion kann es sich um gültiges JSON handeln, in dem alle erforderlichen Schlüssel vorhanden sind und unbekannte Werte explizit beibehalten werden. Bei einem Entscheidungsmemo kann es sich um eine festgelegte Struktur handeln, die Belege, Risiken, Verantwortliche und nächste Schritte enthält. Das Modell kann nur anhand eines sichtbaren Ziels bewertet werden. Ohne dieses Ziel kann ein ausgefeilter Absatz erfolgreich wirken, während er stillschweigend genau das eine Feld auslässt, das der nachgelagerte Prozess benötigt.
Ein guter Abnahmetest ist eng genug gefasst, um automatisch ausgeführt zu werden, und aussagekräftig genug, um den Nutzer zu schützen. Er sollte zudem Unstimmigkeiten deutlich machen. Wenn sich zwei Ergebnisse unterscheiden, sollte das Team in der Lage sein, auf eine fehlende Tatsache, eine unbegründete Annahme, ein fehlerhaftes Feld oder eine falsche Berechnung hinzuweisen. Das ist umsetzbarer, als zu sagen, eine Antwort habe sich “klüger angefühlt”. Das ist auch der Unterschied zwischen einer Überprüfung, die die Beschaffung unterstützt, und einer Überprüfung, die lediglich die Formulierungen aus der Markteinführung wiederholt.
Wählen Sie anhand des Modellnamens eine Ausgangshypothese aus. Entscheiden Sie anhand Ihres Abnahmetests, ob die Hypothese den Einsatz in der Produktion besteht.
Ein Prompt-Design, das zum Modellprofil passt
Die gleiche Eingabe sollte nicht unverändert zwischen den einzelnen Modellen kopiert werden. Der Aufgabenvertrag kann zwar unverändert bleiben, doch der Umfang des Kontexts, der Anweisungen zur Schlussfolgerung und der Ausgabebeschränkungen sollte an den jeweiligen Anwendungsfall angepasst werden. Bei GPT-6 Luna sollten die Systemanweisungen so kurz gehalten werden, dass sie nicht mit dem Ausgangsmaterial konkurrieren. Geben Sie die Rolle, die Entscheidungsregel, die erforderliche Ausgabeform sowie die Bedingungen an, unter denen eine explizite Unbekannte oder eine Eskalation erforderlich ist.
Bei langen Dokumenten sollte die Entnahme aus dem Urteilstext getrennt erfolgen. Zunächst sind die Passagen zu identifizieren, die die Frage beantworten; anschließend ist die Schlussfolgerung ausschließlich anhand dieser Passagen und der genannten Kriterien zu ermitteln. Dies verringert die Wahrscheinlichkeit, dass ein sicherer Satz aus einem weit entfernten, irrelevanten Detail gebildet wird. Außerdem wird dadurch ein Kontextfenster von 1,05 Millionen Token zu einem Werkzeug und nicht zur Standardeinstellung. Ein großer Kontext ist wertvoll, wenn die Beziehung zwischen weit voneinander entfernten Beweisstücken von Bedeutung ist. Er ist hingegen überflüssig, wenn die Aufgabe mit einem kleinen, gut ausgewählten Ausschnitt gelöst werden kann.
Bei Workflows, die Tools verwenden, beschreiben Sie die Grenze zwischen dem Modell und dem Tool. Das Modell sollte entscheiden, ob ein Tool benötigt wird, Argumente in einem strengen Schema bereitstellen und erläutern, was es mit dem Rückgabewert tun wird. Die Anwendung sollte Berechtigungen durchsetzen, Argumente validieren, den Aufruf protokollieren und entscheiden, ob ein fehlgeschlagener Tool-Aufruf wiederholt werden kann. Die Betrachtung des Modells als gesamte Anwendung erschwert die Fehlersuche und vergrößert den Auswirkungsbereich einer falschen Annahme.
Eine wiederverwendbare, vierteilige Eingabeaufforderung
Kontext: Geben Sie nur die Fakten und Unterlagen an, die für die Aufgabe erforderlich sind. Das Ziel: Fassen Sie die Entscheidung oder Veränderung in einem Satz zusammen. Einschränkungen: Legen Sie das Format, Ausschlüsse, den Umgang mit Unsicherheiten und die Werkzeuggrenzen fest. Überprüfen: Bitten Sie das Modell, fehlende Eingaben oder Widersprüche aufzulisten, bevor es die Antwort fertigstellt. Diese Struktur ist kurz genug für wiederholte Aufrufe und konkret genug, um Modelle miteinander zu vergleichen.
Wenn ein großes Kontextfenster hilfreich ist
Die Angabe von 1,05 Millionen Token lässt sich leicht wiederholen und leicht missbrauchen. Ein Kontextfenster gibt Auskunft darüber, wie viel Material in eine Anfrage passt; es sagt jedoch nichts darüber aus, wie viel Material gesendet werden sollte, wie gut das Modell jeden Textabschnitt verwerten wird oder welche Kosten die Anfrage verursacht. Eine umfangreiche Anfrage kann zudem die Überprüfung verlangsamen, da das Team mehr Material prüfen muss und die Wahrscheinlichkeit subtiler Konflikte bei den Anweisungen steigt.
Nutzen Sie das Vollfenster, wenn die Aufgabe tatsächlich von entfernten Verweisen abhängt: ein Vertrag, bei dem Definitionen von Ausnahmen getrennt sind, ein Repository, in dem Schnittstellen und Implementierungen weit voneinander entfernt sind, oder ein umfangreiches Forschungsarchiv, in dem die Antwort das Zurückverfolgen einer Abfolge erfordert. Verwenden Sie die Abfrage, wenn die Frage lokal ist, wenn sich die Quellenmenge häufig ändert oder wenn Sie einen kompakten Zitierpfad wünschen. Verwenden Sie das Caching, wenn ein stabiles Präfix über viele Anfragen hinweg wiederverwendet wird und die Plattform genügend Nutzungsdetails bereitstellt, um nachzuweisen, dass der Cache funktioniert.
Der Schwellenwert von 272.000 sollte Teil des Architekturdiagramms sein und nicht als Fußnote im Abschnitt zur Preisgestaltung erscheinen. Eine Anfrage, die unterhalb des Schwellenwerts unbedenklich ist, kann oberhalb dieses Wertes erheblich teurer werden. Teams sollten Eingabetoken, zwischengespeicherte Token, Ausgabetoken, die Modell-ID, die Inferenz-Einstellung sowie die Information protokollieren, ob die Anfrage den Schwellenwert überschritten hat. Dieses Protokoll unterstützt ein realistisches Kostenmodell und ermöglicht es, unbeabsichtigte Kontextinflation zu erkennen, bevor sie zu einer monatlichen Überraschung wird.
Fragen zur API-Migration, die einen Staging-Lauf rechtfertigen
Bevor Sie eine bestehende Integration auf GPT-6 Luna umstellen, erstellen Sie ein Staging-Harness, das eine kleine, anonymisierte Stichprobe nachstellt. Vergleichen Sie den endgültigen Text, die strukturierten Felder, die Tool-Aufrufe, die Abbruchgründe und die Token-Verwendung. Vergleichen Sie nicht nur den ersten Bildschirm der Antwort. Ein Modell kann die sichtbare Schlussfolgerung beibehalten, während es gleichzeitig einen Feldnamen ändert, eine Fehlerbedingung auslässt oder ein Tool-Argument zurückgibt, das die Anwendung nicht sicher ausführen kann.
„Antworten“ und „Chat-Abschlüsse“ sind in einem Integrationsplan keine austauschbaren Bezeichnungen. Endpunktunterstützung, Einstellungen für die Schlussfolgerung, Tool-Verhalten, Streaming-Ereignisse und Fehlerobjekte wirken sich alle auf den Adapter aus. Legen Sie die Modell-ID in der Konfiguration fest, lassen Sie sie jedoch in Protokollen und Testberichten sichtbar. Wenn eine Anfrage fehlschlägt, sollte der Datensatz den Endpunkt, das Modell, den Aufwand für die Schlussfolgerung, die Prompt-Version, die Anfragegröße und die Entscheidung über einen erneuten Versuch anzeigen. Anhand dieser Informationen kann ein Entwickler einen Fehler reproduzieren, anstatt darüber zu diskutieren, ob das Modell einfach nur einen schlechten Tag hatte.
Die Stapelverarbeitung verändert die Wirtschaftlichkeit und den Betriebsrhythmus. Sie kann für die Klassifizierung über Nacht, die Dokumentenaufbereitung oder eine Warteschlange von Transformationen mit geringer Dringlichkeit geeignet sein. Für interaktive Aktionen, die eine Rückmeldung an den Benutzer erfordern, ist sie hingegen ungeeignet. Auch die Modi „Schnell“ und „Regional“ beeinflussen die Preisberechnung. Behandeln Sie diese als explizite Konfigurationsoptionen und tragen Sie sie in die Budgetkalkulation ein, anstatt sie in einer Standardeinstellung zu verbergen.
Wiederholen Sie repräsentative Eingaben, überprüfen Sie strukturierte Ausgaben, erfassen Sie Tool-Argumente, vergleichen Sie Abbruchgründe, messen Sie die Token-Nutzung und testen Sie einen Fehlerpfad, bevor Sie die Standardwerte in der Produktion ändern.
Qualität, Sicherheit und Kosten der Überprüfung
Ein niedrigerer Token-Preis bedeutet nicht automatisch geringere Gesamtkosten, und ein teureres Modell führt nicht automatisch zu einem besseren Geschäftsergebnis. Zu den Gesamtkosten zählen Wiederholungsversuche, manuelle Überprüfung, die Bearbeitung von Vorfällen sowie der Aufwand für die Korrektur nachgelagerter Daten. Die aussagekräftige Kennzahl sind die Kosten pro akzeptiertem Ergebnis, aufgeschlüsselt nach Aufgabengruppen. Ein Ansatz, der pro Anfrage etwas teurer ist, kann dennoch vorteilhaft sein, wenn er den Korrekturaufwand bei Aufgaben mit hoher Auswirkung reduziert; ein sehr kostengünstiger Ansatz kann bei deterministischer Extraktion mit strenger Validierung entscheidend den Vorzug erhalten.
Risiken sollten nach der jeweiligen Maßnahme klassifiziert werden, nicht nach dem Markennamen des Modells. Das Lesen eines öffentlichen Dokuments und das Verfassen einer Zusammenfassung unterscheiden sich von der Änderung eines Kundendatensatzes, der Genehmigung einer Zahlung, dem Löschen von Daten oder der Veröffentlichung einer rechtlichen Erklärung. Unumkehrbare Aktionen sollten einer menschlichen Überprüfung oder einem zweiten unabhängigen Validierungsschritt unterliegen. Fordern Sie das Modell auf, Unsicherheiten zu identifizieren, aber behandeln Sie einen Satz, der nach Gewissheit klingt, niemals als Genehmigungssystem.
Fragen zum Datenschutz und zur Aufbewahrungsdauer gehören in die Bereitstellungsprüfung. Klären Sie, welche Daten übermittelt werden, wie lange Protokolle aufbewahrt werden, wer die Eingabeaufforderungen einsehen kann und ob die Anfrage vertrauliche Informationen oder personenbezogene Daten enthält. Schwärzen Sie Daten, wo dies möglich ist, reduzieren Sie den Kontext auf ein Minimum und führen Sie klare Aufzeichnungen darüber, welche Felder entfernt wurden. Diese Kontrollmaßnahmen gelten unabhängig davon, ob das Modell über eine offizielle API oder einen anderen kompatiblen Weg genutzt wird.
So vergleicht man GPT-6 Luna mit GPT-6 Sol
Bei einem fairen Vergleich werden die Aufgabe und die Akzeptanzregel konstant gehalten, während jedes Modell seine dokumentierten Stärken ausspielen kann. Führen Sie dasselbe Eingabepaket aus, und halten Sie dabei fest, ob ein Modell eine andere Schlussfolgerungseinstellung oder einen anderen Endpunkt benötigt. Stellen Sie die Unterschiede klar dar: Das eine Modell erzeugt möglicherweise einen vollständigeren Patch, ein anderes ist bei wiederholter Extraktion kostengünstiger, und ein drittes lässt sich möglicherweise leichter integrieren, da sein Tool-Vertrag zu Ihrem aktuellen Adapter passt.
Leiten Sie aus einer erfolgreichen Aufgabe keine allgemeine Rangfolge ab. Drei kleine Aufgaben dienen dazu, Fragen zum Arbeitsablauf aufzudecken, nicht dazu, einen universellen Sieger zu ermitteln. Wiederholen Sie die Aufgabe mit mehreren realistischen Eingaben, beziehen Sie mindestens einen adversarischen oder unvollständigen Fall mit ein und legen Sie im Voraus fest, was als „bestanden“ gilt. Wenn die Stichprobe zu klein ist, um eine Schlussfolgerung zu stützen, geben Sie dies an. Diese Einschränkung stärkt das Vertrauen, anstatt die Bewertung zu schwächen.
Eine schrittweise Einführung, bei der die Entscheidung rückgängig gemacht werden kann
Beginnen Sie mit Schattenverkehr oder einer unkritischen Warteschlange. Lassen Sie die neue Route eine Antwort generieren, während die bestehende Route weiterhin als Referenz dient. Vergleichen Sie über einen festgelegten Zeitraum hinweg die Akzeptanzrate, die Token-Kosten, die Überprüfungszeit und die Fehlerkategorien. Verschieben Sie dann jeweils eine Aufgabenfamilie nach der anderen und behalten Sie dabei einen Rollback-Schalter sowie ein aktuelles Versionskennzeichen bei. Durch eine schrittweise Einführung wird die Modellauswahl zu einer beobachtbaren technischen Änderung statt zu einem eintägigen Austausch.
Achten Sie während der Einführung auf Veränderungen, die sich nicht in einer einfachen Erfolgsquote widerspiegeln: längere Ausgabedauer, mehr Tool-Aufrufe, mehr Eskalationen oder mehr Anfragen, die den Schwellenwert für den Langzeitkontext überschreiten. Ein Modell kann zwar genau erscheinen, dabei jedoch mehr Budget verbrauchen oder die Arbeitsbelastung der Bediener erhöhen. Richten Sie Warnmeldungen für diese Aspekte ein und besprechen Sie diese mit den Mitarbeitern, die Ausnahmen tatsächlich bearbeiten.
Wie Erfolg aussieht
Erfolg ist ein stabiler Weg mit bekannten Kosten, einem erkennbaren Fehlermodus und einem Überprüfungsprozess, den jeder nachvollziehen kann. Dabei muss nicht so getan werden, als sei das Modell perfekt. Es ist vielmehr wichtig zu wissen, welche Aufgaben es gut bewältigt, für welche Aufgaben ein anderer Weg erforderlich ist und wie man den Prozess stoppen oder korrigieren kann, wenn die Eingaben unvollständig sind. Das ist der praktische Maßstab, der den in dieser Überprüfung gesammelten Beobachtungen und Unterlagen zugrunde liegt.
Was öffentliche Reaktionen aussagen können und was nicht
Die folgenden Quellen werden als dokumentierte öffentliche Reaktionen aufgeführt, nicht als offizielle Unterlagen oder kontrollierte Vergleichsdaten. Ihre Titel geben wieder, was die jeweiligen Autoren getestet oder erläutert haben; sie stellen kein marktweites Ergebnis dar.
- Chase AI: GPT 6 Sol & Luna sind da (und 50% ist GÜNSTIGER!). Betrachten Sie die Darstellung und etwaige Beispiele als die Erfahrungen des jeweiligen Urhebers und nicht als allgemeingültige Regel.
- Rob, der KI-Experte: ChatGPT hat GPT-6 Sol und GPT-6 Luna veröffentlicht (neue ChatGPT-Modelle und -Agenten). Betrachten Sie die Darstellung und etwaige Beispiele als die Erfahrungen des jeweiligen Urhebers und nicht als allgemeingültige Regel.
- KI mit Surya: GPT-6 Soul vs. Luna vs. Claude Opus 5.5: Was sollten Sie verwenden?. Betrachten Sie die Darstellung und etwaige Beispiele als die Erfahrungen des jeweiligen Urhebers und nicht als allgemeingültige Regel.
Hier spielt noch ein weiteres Problem hinsichtlich der Bezeichnung eine Rolle: In mehreren öffentlich zugänglichen Videos werden die Bezeichnungen “GPT-6” und “GPT-5.6” in den Titeln synonym verwendet. Geben Sie bei der Wiedergabe einer Behauptung stets die genaue Modell-ID an. Die Vergleich zwischen GPT-6 Astra und GPT-5.6 Sol ist ein anschauliches Beispiel dafür, warum die Identität des Anbieters, die Plattformbezeichnung und die Route getrennt erfasst werden sollten.
So greifen Sie auf GPT-6 Luna zu
Öffnen Sie die GPT-6 Luna-Arbeitsbereich Beginnen Sie mit einer Aufgabe, die Sie bewerten können: einem kleinen Code-Beispiel, einem kurzen Quellcode-Paket oder einer strukturierten Extraktionsanweisung. Behalten Sie die geforderten Ergebnisse und die Abnahmeregeln im Blick, während Sie die verschiedenen Versionen vergleichen. Die oben genannten offiziellen Token-Preise beziehen sich auf die direkte Nutzung der API und stellen keine Zusage hinsichtlich Workspace-Guthaben oder Abonnementkontingenten dar.
Informationen zur aktuellen Plattformbezeichnung und zum Kontext der separaten Nennung finden Sie unter GPT-5.6-Preisliste und die Modellvergleich GPT-5.6. Diese Seiten dienen als plattformspezifischer bzw. redaktioneller Kontext; sie haben keinen Vorrang vor der API-Preistabelle von OpenAI.
Bringen Sie eine repräsentative Aufgabe mit und vergleichen Sie das Ergebnis mit Ihren eigenen Akzeptanzkriterien.
GPT-6-Luna-Arbeitsbereich öffnenFür wen ist GPT-6 Luna geeignet?
Falls Ihre Auswahlliste kostengünstigere Alternativen enthält, vergleichen Sie die umfassenderer Modellkatalog anstatt davon auszugehen, dass das neueste Modell automatisch das beste Preis-Leistungs-Verhältnis bietet. Wenn Sie datenintensive Aufgaben bewerten, ist die Leitfaden zum Datenanalysemodell bietet eine eigene Workflow-Perspektive.
Häufig gestellte Fragen
Was ist GPT-6 Luna?
GPT-6 Luna ist das auf hochvolumige Aufgaben spezialisierte Modell von OpenAI. Seine offizielle API-Modell-ID lautet „gpt-6-luna“.
Wie viel kostet GPT-6 Luna?
OpenAI gibt für GPT-6 Luna $0,10 pro 1 Mio. Eingabetoken, $0,01 pro 1 Mio. zwischengespeicherte Eingabetoken, $0,125 pro 1 Million Cache-Schreibvorgänge und $0,50 pro 1 Million Ausgabetoken zu Standardtarifen.
Was passiert, wenn die Anzahl der eingegebenen Token 272.000 übersteigt?
Wenn eine Anfrage mehr als 272.000 Eingabetoken umfasst, wendet OpenAI auf die gesamte Anfrage die doppelte Eingabe- und Cache-Rate sowie die 1,5-fache Ausgaberate an.
Wie lauten die Kontext- und Ausgabebeschränkungen?
GPT-6 Luna verfügt über ein Kontextfenster von 1.050.000 Token, eine maximale Eingabe von 922.000 Token und eine maximale Ausgabe von 128.000 Token.
Wo liegt die Wissensgrenze?
Auf der aktuellen Modellseite zu OpenAI wird der 18. Mai 2026 als Stichtag für den Wissensstand von GPT-6 Luna angegeben.
Welche Einstellungen für die Logik stehen zur Verfügung?
Die API dokumentiert die Aufwandsstufen „none“, „low“, „medium“, „high“, „xhigh“ und „max“, wobei „medium“ als Standardwert gilt.
Welche API-Endpunkte werden unterstützt?
GPT-6 Luna unterstützt Chat-Vervollständigungen, Antworten und Batch-Verarbeitung. Auf der Modellseite werden Echtzeit, Assistenten, Audio, Video, Bildgenerierung, Embeddings, Feinabstimmung, Moderation oder ältere Vervollständigungsfunktionen nicht als unterstützt aufgeführt.
Kann GPT-6 Luna Bilder verarbeiten?
Ja. Auf der Modellseite sind Text- und Bildeingaben sowie Textausgaben aufgeführt. Das macht es jedoch noch nicht zu einem Modell zur Bilderzeugung.
Ist GPT-6 Luna in GlobalGPT verfügbar?
Nutzen Sie die oben verlinkte spezielle Modellseite für GPT-6 Luna. Die Gutschriften für den Workspace und die im Tarif enthaltenen Kontingente sind unabhängig von den in diesem Testbericht beschriebenen Tarifen für direkte API-Token.
Enthält dieser Artikel einen Vergleichstest?
Es umfasst drei kleine Aufgabenbeobachtungen, keinen kontrollierten Benchmark. Luna benötigte beim erneuten Versuch eine überarbeitete Programmieraufgabe. Diese Ergebnisse lassen keinen eindeutigen Sieger oder eine Leistung im großen Maßstab erkennen.
Endgültiges Urteil
Luna ist die pragmatische, kostenorientierte Option in der offiziellen Preisliste: Sie bietet denselben Kontext und dieselben Ausgabegrenzen wie Sol, verlangt aber nur einen Bruchteil der Token-Gebühren. Das macht sie für gezielte, wiederholte Aufrufe attraktiv, doch der niedrige Preis ist ohne einen kontrollierten Test kein Beweis für eine geringere Latenz oder geringere Qualität. Treffen Sie Ihre Entscheidung auf der Grundlage der akzeptierten Ausgabewerte und der Gesamtbetriebskosten und überprüfen Sie diese Wahl erneut, wenn sich Ihre Arbeitslast ändert.
Überprüft am 23. September 2026. Offizielle Angaben: OpenAI Developers. Benennung der Plattformroute: GlobalGPT. Öffentliche Reaktion: Verlinkte Urheber und Veröffentlichungen, nur mit Quellenangabe.









