
Grok 4.7 stellt eine bedeutende Verbesserung im Bereich der Programmierung und der Wissensarbeit dar, doch die Beweislage ist noch nicht eindeutig: Offizielle Angaben zum Produktstart und unabhängige Benchmark-Ergebnisse deuten zwar auf eine Verbesserung hin, aber nicht auf einen durchgängigen Erfolg.
Kurze Antwort
Grok 4.7 ist das Upgrade von xAI vom 21. September 2026, das auf Programmierung und anspruchsvolle Wissensarbeit ausgerichtet ist. Laut xAI widmet das Modell schwierigen Problemen mehr Zeit, überprüft seine Arbeit sorgfältiger und verfügt über einen neuen Sicherheitsmechanismus, während Preis und Geschwindigkeit gegenüber Grok 4.6 unverändert bleiben. Auf der Einführungsseite wird es zudem als doppelt so schnell und halb so teuer wie vergleichbare Modelle dargestellt – ein Herstellervergleich, der im Zusammenhang mit den zugrunde liegenden Aufgaben und Abläufen betrachtet werden muss. Unabhängige Daten von Artificial Analysis bescheinigen ihm eine leichte Gesamtverbesserung gegenüber Grok 4.6 und verzeichnen ein Kontextfenster von 500.000 Zeichen. In unserem API-Test mit drei Aufgaben zeigte sich Grok 4.7 am stärksten beim Debugging und bei der Einhaltung von Quellcode-Grenzen; sein Projektplan berücksichtigte Unsicherheiten gut, war jedoch weniger umsetzbar als gefordert. Das ist ein nützlicher praktischer Beleg, jedoch kein Beweis dafür, dass es jedes konkurrierende Modell übertrifft.
Was ist Grok 4.7?
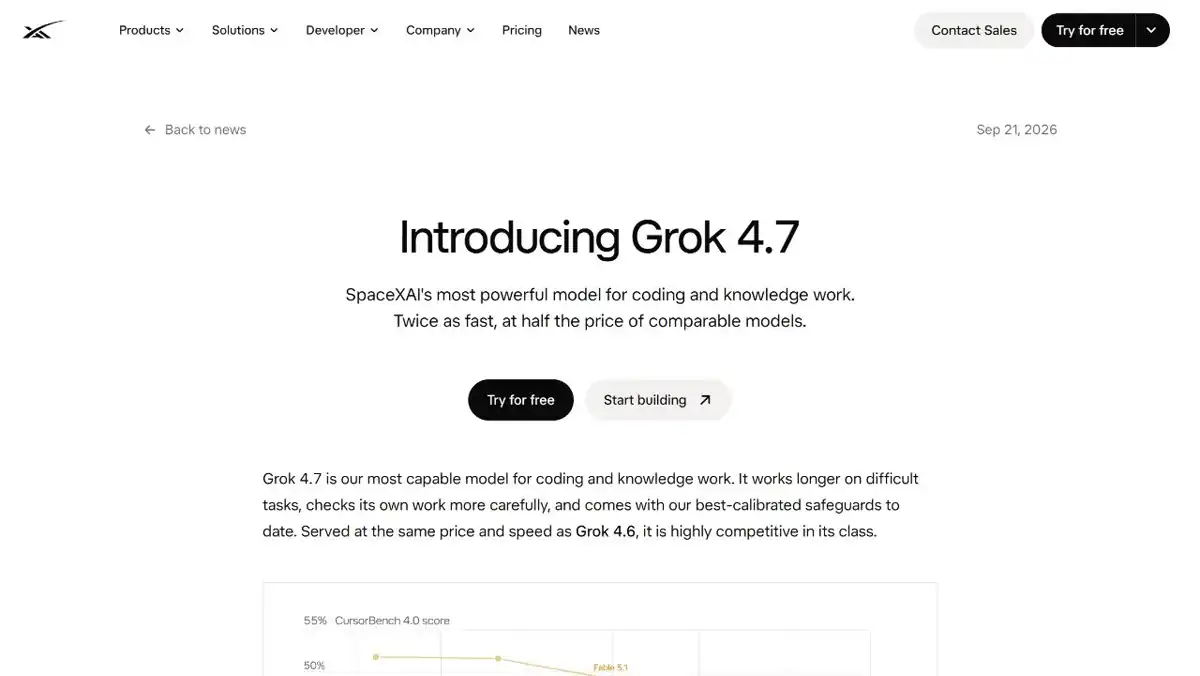
Der Grok 4.7 ist das neueste Modell der Grok-Reihe von xAI, das am 21. September 2026 vorgestellt wurde. Der Offizielle Ankündigung von xAI Damit wird es als das leistungsstärkste Modell des Unternehmens für Programmierung und Wissensarbeit positioniert. Die wesentliche Veränderung besteht nicht in einer neuen Liste von Funktionen für Endnutzer. Es handelt sich vielmehr um eine Veränderung hinsichtlich der Art und Weise, wie das Modell seine Rechenleistung einsetzen soll: mehr Zeit für schwierige Aufgaben, mehr Selbstüberprüfung und eine Sicherheitsebene, die diese zusätzliche Leistungsfähigkeit besser kontrollierbar machen soll.
Diese Positionierung ist von Bedeutung, da sie eher ein Arbeitsablaufmodell als eine Chatbot-Persönlichkeit beschreibt. Grok 4.7 wird als Modell für Aufgaben vermarktet, bei denen eine kontinuierliche Analyse von Vorteil ist: Fehlerbehebung, Planung, technisches Schreiben, Zusammenfassung von Forschungsergebnissen sowie lange Eingabeaufforderungen, bei denen das Modell mehrere Einschränkungen im Blick behalten muss.
Die Abgrenzung ist ebenso wichtig. Die Ankündigung von xAI ist eine Aussage des Anbieters über das beabsichtigte Verhalten. Sie ist kein unabhängiger Beweis dafür, dass Grok 4.7 jedes konkurrierende Modell, jede Eingabeaufforderung oder jedes Code-Repository übertrifft. Betrachten Sie die Startseite als Quelle für die Aussagen von xAI und nutzen Sie dann unabhängige Messungen sowie Ihre eigene Aufgabe, um zu entscheiden, ob diese Behauptungen von Bedeutung sind.
Grok 4.7 vs. Grok 4.6: Was hat sich eigentlich geändert?
Die stichhaltigste Zusammenfassung lautet: Es handelt sich um eine Verbesserung in Bezug auf Aufwand und Zuverlässigkeit, nicht um ein völlig anderes Produkt.
| Fläche | Grok 4,7 | Was die Beweislage belegt |
|---|---|---|
| Freigabe | 21. September 2026 | Auf der offiziellen xAI-Startseite angegebenes Datum |
| Hauptpositionierung | Programmierung und Wissensarbeit | Offizielle Positionierung von xAI |
| Schwierige Aufgaben | Mehr Zeitaufwand und sorgfältigere Selbstkontrolle | Offizielle xAI-Beschreibung; unser API-Test mit drei Aufgaben dient lediglich als kleiner praktischer Test und stellt keinen direkten Vergleich dar. |
| Sicherheit | Neuer Schutzstapel | Offizielle Beschreibung von xAI |
| Preis und Geschwindigkeit | Entspricht Grok 4.6, laut xAI | Eine Markteinführungsbehauptung, keine Preisprüfung durch Dritte |
| Kontext | 500.000 Token im Profil „Artificial Analysis“ | Profil eines unabhängigen Models; überprüfen Sie die von Ihnen genutzte Route |
| Logiksteuerung | Tiefst- bis Höchstkurs in der Auflistung von Artificial Analysis | Unabhängige Routen-/Modell-Metadaten |
Für Käufer ist dies eine nützliche Unterscheidung. Wenn Grok 4.6 bereits zu Ihrem Arbeitsablauf passt, ist 4.7 ein reibungsloses Upgrade, das Sie in Betracht ziehen sollten. Wenn 4.6 aufgrund von Einschränkungen hinsichtlich des Ökosystems, der Latenz, der Zuverlässigkeit oder des Zugriffs nicht geeignet war, löst ein höherer Benchmark-Wert allein diese Probleme nicht.
Für einen umfassenderen Rahmen beim Kauf von Modellen gilt die GPT-5.6-Preisliste und Vergleich GPT-5.6 sind nützliche Hinweise darauf, die Modellqualität von den wirtschaftlichen Aspekten des Plans und der Eignung für den Arbeitsablauf zu trennen.
Fähigkeiten: Hier sollte Grok 4.7 helfen
Programmierung und Fehlerbehebung
Der stärkste Ansatzpunkt für die Markteinführung von xAI ist das Programmieren. Das Versprechen besteht nicht einfach darin, dass Grok 4.7 mehr Code schreibt, sondern darin, dass es sich länger mit einem schwierigen technischen Problem auseinandersetzen, seine eigene Antwort überprüfen und einen durchdachteren Patch oder eine fundiertere Erklärung liefern kann. Genau dieses Verhalten sollte man in einem echten Repository erwarten: Bewahrt es das bestehende Design, identifiziert es die Grundursache, fügt es nützliche Tests hinzu und gibt es an, was es noch nicht wissen kann?
Bewerten Sie das Modell nicht anhand einer “Greenfield”-Aufgabe wie „Entwickeln Sie eine To-Do-App“. Geben Sie ihm stattdessen einen abgegrenzten Fehler mit einem fehlgeschlagenen Test, eine kleine Anzahl von Dateien und explizite Einschränkungen. Bitten Sie um eine Diagnose, bevor Sie einen Patch anfordern. So lässt sich leichter erkennen, ob die ausführlichere Begründung tatsächlich weniger Überprüfungsaufwand verursacht oder lediglich zu einem längeren Text führt.
Das Gleiche gilt für Teams, die verschiedene Programmieransätze miteinander vergleichen. A Testbericht zum DeepSeek V4 Pro und die Überprüfung des GLM-Kodierungsplans Sie bieten zwar einen nützlichen Vergleichsrahmen, sollten jedoch keinesfalls als Ersatz für das Testen des Repositorys und der Toolchain dienen, die Sie tatsächlich verwenden.
Wissensarbeit mit langem Kontext
„Artificial Analysis“ gibt für Grok 4.7 ein Kontextfenster von 500.000 Token an. Das ist groß genug, um Ihre Herangehensweise an aufwendige Aufgaben zu verändern: Eine lange technische Spezifikation, eine Reihe von Besprechungsnotizen, ein Ausschnitt aus dem Quellcode oder ein Forschungspaket können in einer einzigen Konversation verbleiben, anstatt immer wieder zusammengefasst zu werden.
Die Kontextkapazität ist nicht dasselbe wie die Kontextqualität. Ein Modell kann zwar umfangreiche Eingaben verarbeiten, dabei aber dennoch eine Einschränkung in der Mitte übersehen, dem letzten Absatz zu viel Gewicht beimessen oder eine überzeugende Zusammenfassung erstellen, die einer Quellenprüfung bedarf. Der praktische Test besteht darin, das Modell unter Druck auf seine Informationsgewinnung zu prüfen: Platzieren Sie einige entscheidende Fakten an verschiedenen Stellen eines langen Dokuments, fordern Sie eine Entscheidung unter bestimmten Vorgaben an und prüfen Sie, ob die Antwort die richtigen Passagen zitiert.
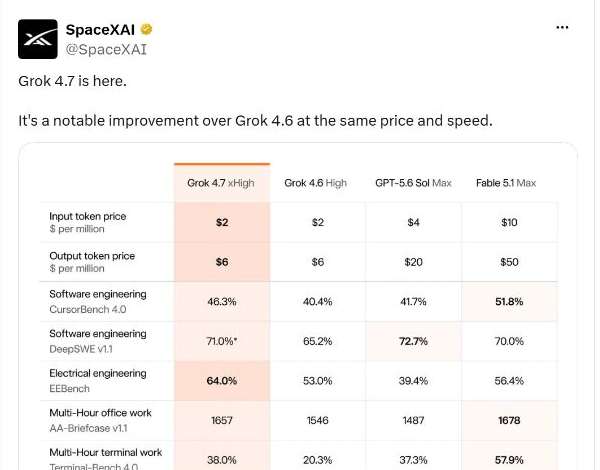
Der offizielle X-Account von SpaceXAI griff am 22. September die Darstellung des Starts erneut auf und bezeichnete Grok 4.7 als bemerkenswerte Verbesserung gegenüber Grok 4.6 bei gleichem Preis und gleicher Geschwindigkeit und teilte die Grafik zum Modellvergleich. Dieser Beitrag ist ein aussagekräftiger Beleg für die öffentliche Positionierung des Unternehmens, jedoch keine unabhängige Bestätigung oder ein Konsens der Community.
Wenn das Modell für Forschungszwecke verwendet wird, sollte der Evidenzkreis sichtbar bleiben. Unser Vergleich zwischen Gemini und Perplexity und Leitfaden zu Alternativen zu Perplexity Sie bringen denselben praktischen Punkt zum Ausdruck: Eine ausgefeilte Antwort ist keine Quellenprüfung.
Selbstkontrolle und Sicherheit
Laut xAI überprüft Grok 4.7 seine Arbeit sorgfältiger und führt einen neuen Sicherheitsstapel ein. Das sind wertvolle Ziele, insbesondere wenn das Modell eine lange Kette von Entscheidungen treffen soll. Sie stellen jedoch keine Garantie dafür dar, dass die Ausgabe korrekt oder für die automatische Ausführung sicher ist.
Behalten Sie im produktiven Einsatz die üblichen Kontrollmechanismen rund um das Modell bei: Tests, Berechtigungen, manuelle Überprüfung, Zitierprüfungen und eine klare Stoppbedingung. Die Selbstprüfung des Modells ist ein weiteres Signal, das es zu überprüfen gilt, jedoch kein Ersatz für die umgebenden Kontrollmechanismen.
Grok 4.7-Benchmarks: Was die Zahlen belegen
Ein starkes Ergebnis bei der Codierung: In der offiziellen Tabelle liegt Grok 4.7 vor Grok 4.6.
Der Vergleich der größeren Modelle zeigt bei diesem Benchmark für Wissensarbeit einen deutlichen Leistungsgewinn.
Ein nützliches Indiz für Arbeitsabläufe mit Werkzeuggebrauch, aber dennoch eher eine Einzelbewertung als eine allgemeingültige Bewertung.
Der unabhängige Index bestätigt denselben Trend: eine Verbesserung, jedoch kein Beweis für einen allgemeinen Erfolg.
Betrachten Sie diese Karten als Anhaltspunkte. Die Zusammensetzung des Datensatzes, der Zugriff auf Tools, die Stichprobenauswahl und die Modelleinstellungen können die Rangfolge beeinflussen.
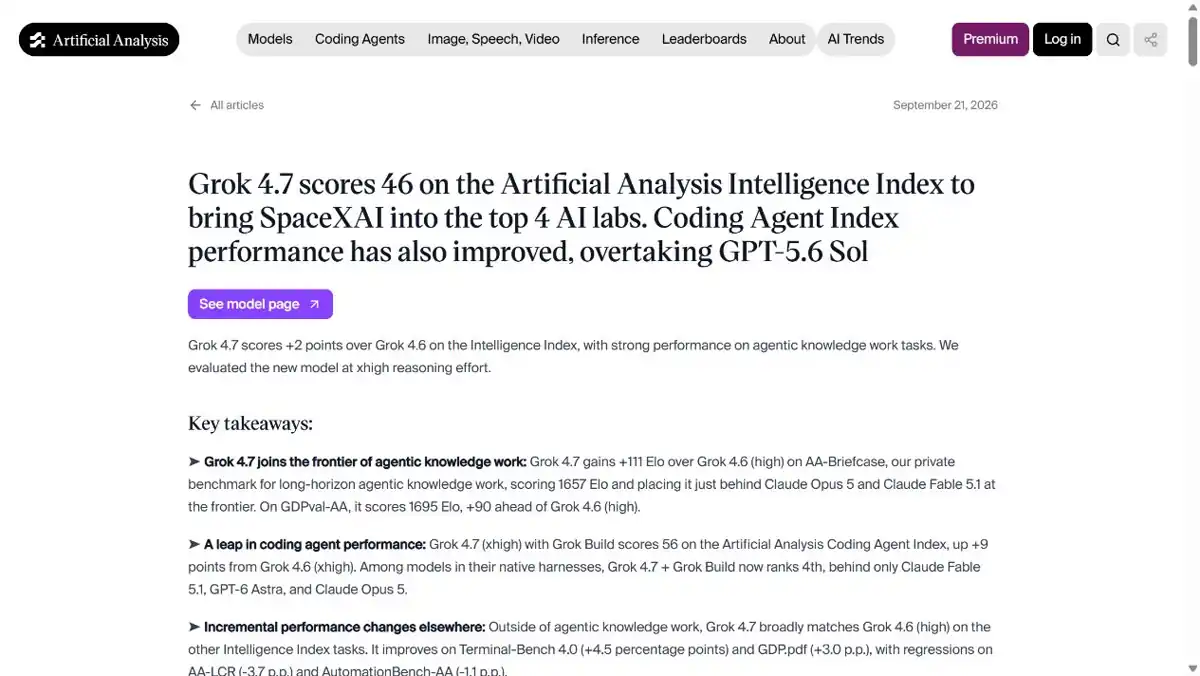
Die derzeit aussagekräftigste unabhängige Momentaufnahme stammt von Benchmark-Artikel ’Grok 4.7“ von Artificial Analysis, vom 21. September 2026.
| Maß | Ausgewiesenes Ergebnis | Wie man es liest |
|---|---|---|
| Index für künstliche Intelligenz in der Analyse | 46 | Zwei Punkte mehr als Grok 4,6 im selben Index |
| AA-Aktentasche | 1.657 Elo | 111 Elo über Grok 4,6 in dieser Bewertung |
| Kontextfenster | 500.000 Token | Ein Modell-Profil-Feld – kein Beweis für eine perfekte Abfrage im langen Kontext |
| Argumentationsaufwand | Niedrig bis xhoch | Eine von Artificial Analysis aufgeführte Steuerung auf Routenebene |
Die Entwicklung ist vielversprechend: Der unabhängige Index zeigt eine Verbesserung gegenüber der vorherigen Version, und die größere Elo-Differenz bei „AA-Briefcase“ deutet auf einen deutlicheren Zuwachs bei dieser speziellen Bewertung hin. Die Tabelle gibt jedoch nach wie vor zwei Datensätze wieder und stellt keine allgemeingültige Rangliste dar. Die Zusammensetzung der Benchmarks, der Zugriff auf Tools, die Stichprobenauswahl und die Modelleinstellungen können das Ergebnis beeinflussen.
Auf der offiziellen xAI-Startseite wird Grok 4.7 unter 46,31 TP40T auf CursorBench 4.0 in seiner Vergleichstabelle, neben Grok 4,6 bei 40,4%, GPT-5.6 Sol bei 41,7% und Fable 5.1 bei 51,8%. Die Seite zeigt außerdem 71,01 TP40T bei DeepSWE v1.1 mit hohem Aufwand, 64,01 TP40T bei EEBench und 1.657 bei AA-Briefcase v1.1. Da es sich hierbei um vom Anbieter vorgelegte Vergleichszahlen handelt, sollten sie als offiziell gemeldete Ergebnisse betrachtet werden und nicht als Ersatz für unabhängige Nachprüfungen. Die sicherere Schlussfolgerung lautet, dass xAI auf anspruchsvolle Programmier- und fachliche Wissensarbeit abzielt, während unabhängige Messungen bei einigen Aufgaben eine deutliche Verbesserung und bei anderen eher verhaltene Ergebnisse zeigen.
Praxistest Grok 4.7: drei praktische Aufgaben
Wir haben drei festgelegte Eingabeaufforderungen mit dem grok-4.7 Modell-ID über eine OpenAI-kompatible Test-API am 23. September 2026. Hierbei handelte es sich um eine Bewertung mit einem einzigen Durchlauf, nicht um die direkte xAI-API und auch nicht um einen Vergleichstest mit einem Konkurrenten. Die sichtbare Antwort aus jedem Durchlauf ist unten aufgeführt; private Argumentationsverläufe wurden dabei ausgeblendet.
| Aufgabe | Beobachtete Zeit | Ergebnis |
|---|---|---|
| TypeScript-Fehler bei der Parallelität | 333,7 Sekunden, gestreamt | Gute Leistung: korrekte Diagnose des „shared-promise“-Problems, minimaler Patch, zwei nützliche Tests und eine sorgfältige Eingrenzung dessen, was das Snippet beweisen könnte |
| Widersprüchliche Forschungsergebnisse | 68,7 Sekunden | Erfolgreich bestanden: Zuordnung beibehalten, beide Ausgleichsszenarien berechnet und die Genehmigung verweigert, bis der Quellenkonflikt überprüft wurde |
| Ein chaotischer Wochenplan | 50,6 Sekunden | Teilweise bestanden: Fristen, Widersprüche, unbekannte Eigentümer und fünf Risiken wurden berücksichtigt, jedoch wurde aus der Arbeit kein klarer Tagesplan erstellt. |
Die Latenzwerte beziehen sich ausschließlich auf diese Route und diese Abfragen. Bei der Codierungsaufgabe trat zunächst ein Timeout des Nicht-Streaming-Gateways auf, anschließend wurde die Aufgabe mit aktiviertem Streaming abgeschlossen. Dies ist eine praktische Warnung für den Einsatz hinsichtlich der Transport- und Timeout-Behandlung und kein allgemeiner Grok-Geschwindigkeitswert von 4,7.
Test 1: Debugging von Parallelität in TypeScript
Aufgabe 1 – Debugging der Parallelität eines TypeScript-API-Handlers

Ein kleiner TypeScript-Handler gibt zeitweise einen HTTP-200-Status mit leerem Body zurück, wenn zwei Anfragen kurz nacheinander eingehen.

Bereitgestellte Dateien:

src/cache.ts
```ts
let current: Promise | null = null;

export async function getPayload(load: () => Promise): Promise {
  if (!current) {
    current = load();
  }
  const value = await current;
  current = null;
  return value;
}
```

src/handler.ts
```ts
import { getPayload } from './cache';

export async function handler(load: () => Promise) {
  const payload = await getPayload(load);
  return { status: 200, body: payload };
}
```

Das Symptom tritt in der Produktion nur sporadisch auf, wenn sich zwei Anfragen überschneiden. Der Loader selbst kann sicher parallel aufgerufen werden und gibt für jede Anfrage eine andere Nutzlast zurück. Es sind keine weiteren Dateien verfügbar.

Geben Sie genau folgende Abschnitte an:
1. Grundursache
2. Kleinster sicherer Patch (zeigen Sie einen einheitlichen Diff an)
3. Zwei Regressionstests (Code im TypeScript- oder Jest-Stil)
4. Annahmen und Einschränkungen
Geben Sie nicht an, den Code ausgeführt zu haben.1. Grundursache
`current` ist ein Zustand auf Modulebene, der von jedem Aufruf gemeinsam genutzt wird. In einem JavaScript-Durchlauf sind die Null-Prüfung und die Zuweisung atomar, sodass bei zwei sich überschneidenden Aufrufen nicht beide `load()` ausführen. Der erste Aufruf speichert sein Promise; ein zweiter Aufruf, der eintrifft, bevor dieses Promise abgearbeitet ist, überspringt sein eigenes `load()` und wartet auf dasselbe Promise. `handler` gibt dann einen HTTP-200-Status zurück, dessen `body` die Zeichenkette des ersten Aufrufs ist, nicht die Nutzdaten der zweiten Anfrage. Dieses Zeitfenster besteht nur, solange ein Aufruf läuft; daher tritt der Fehler nur auf, wenn sich Anfragen überschneiden.
`current = null` wird in jeder Fortsetzung ausgeführt, nachdem `await` das Promise bereits abgefangen hat. Dies bewirkt nicht, dass der andere Wartende die Variable erneut ausliest, sodass diese Dateien allein diesen Wartenden nicht auf `null` oder `""` auflösen. Was sie bei einer Überlappung jedoch bewirken, ist eine gemeinsame Auflösung und ein übersprungenes Laden pro Anfrage. Das Löschen macht den Slot zudem zu einem ungeeigneten Single-Flight-Cache: Die erste Fortsetzung, die fortgesetzt wird, verwirft `current`, und ein späterer Aufrufer kann ein anderes `load()` starten, während ein anderer Aufrufer noch abgearbeitet wird.
2. Kleinster sicherer Patch (vereinheitlichten Diff anzeigen)
Jede Anfrage muss `load()` selbst aufrufen. Parallele `load()`-Aufrufe sind zulässig, und jeder gibt eine andere Nutzlast zurück, sodass eine Duplikatsbereinigung anhand eines gemeinsamen Promises unsicher ist. `handler.ts` muss nicht geändert werden.
```diff
--- a/src/cache.ts
+++ b/src/cache.ts
@@ -1,10 +1,3 @@
-let current: Promise | null = null;
-
export async function getPayload(load: () => Promise): Promise {
- if (!current) {
- current = load();
- }
- const value = await current;
- current = null;
- return value;
+ return await load();
}
```
3. Zwei Regressionstests (Code im TypeScript- oder Jest-Stil)
```ts
import { handler } from '../src/handler';
function deferred() {
let resolve!: (value: T) => void;
let reject!: (reason: unknown) => void;
const promise = new Promise((res, rej) => {
resolve = res;
reject = rej;
});
return { promise, resolve, reject };
}
test('überlappende Anfragen werden jeweils ausgeführt und behalten ihren eigenen Körper', async () => {
const first = deferred();
const second = deferred();
const started: string[] = [];
const p1 = handler(() => {
started.push('a');
return first.promise;
});
const p2 = handler(() => {
started.push('b');
return second.promise;
});
expect(started).toEqual(['a', 'b']);
second.resolve('payload-b');
first.resolve('payload-a');
await expect(p1).resolves.toEqual({ status: 200, body: 'payload-a' });
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
test('Eine abgelehnte überlappende Last ändert die andere Antwort nicht', async () => {
const failed = deferred();
const ok = deferred();
let started = 0;
const p1 = handler(() => {
started += 1;
return failed.promise;
});
const p2 = handler(() => {
started += 1;
return ok.promise;
});
expect(started).toBe(2);
failed.reject(new Error('upstream failed'));
ok.resolve('payload-b');
await expect(p1).rejects.toThrow('upstream failed');
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
```
4. Annahmen und Einschränkungen
Ich habe weder diesen Code noch die Tests ausgeführt. Die Tests setzen einen Runner im Jest-Stil und eine Datei in einem Unterverzeichnis von `src/` voraus (zum Beispiel `test/cache.test.ts`).
Ich habe “unterschiedliche Payloads für jede Anfrage” als Anforderung so interpretiert, dass sich überschneidende `getPayload`-Aufrufe nicht dasselbe `load()`-Ergebnis teilen dürfen. Eine korrekte „Single-Flight“-Umschreibung (`load().finally(() => { current = null; }); return current`) würde diese Anfragen weiterhin koppeln, daher habe ich sie nicht verwendet. Es ist kein Cache-Schlüssel vorhanden, und es wird keine Anforderung zur Duplikatsbereinigung gestellt.
Ein buchstäblich leerer HTTP-Body wird durch die gezeigten Anweisungen nicht geschrieben, wenn `load` eine nicht leere Zeichenkette zurückgibt. Sollte dieses Symptom von einem Adapter außerhalb dieser Dateien stammen, ist es hier nicht sichtbar. Der Patch beseitigt lediglich die Überlappung, die diese Dateien tatsächlich implementieren. Er fügt weder Sperren noch Wiederholungsversuche noch einen schlüsselbasierten Cache hinzu.Grok 4.7 hat zu Recht festgestellt, dass auf Modulebene aktuell Das „Promise“ führt dazu, dass sich überschneidende Anfragen sich ein und dasselbe Loader-Ergebnis teilen, obwohl jede Anfrage ihre eigene Nutzlast benötigt. Es wurde die kleinste sichere Änderung vorgeschlagen: das gemeinsam genutzte „Promise“ entfernen und load() auf Anfrage. Die beiden Regressionstests deckten unterschiedliche parallele Nutzdaten und die Isolation ab, wenn ein Loader eine Anfrage ablehnt. Die größte Stärke der Antwort lag in ihrer Zurückhaltung: Es wurde ausdrücklich darauf hingewiesen, dass der gezeigte Code zwar eine Kopplung zwischen Anfragen belegt, jedoch für sich genommen keinen buchstäblich leeren Hauptteil erklärt, wenn der Loader stets eine nicht leere Zeichenkette zurückgibt.
Fazit: Hervorragendes Ergebnis hinsichtlich der Genauigkeit bei der Ermittlung der Grundursache, des Patch-Umfangs, der Regressionsabdeckung und des Umgangs mit Unsicherheiten.
Test 2: Forschungsnotiz zu widersprüchlichen Quellen
Aufgabe 2 – Führen Sie widersprüchliche Forschungsnotizen zu einem Entscheidungsmemo zusammen.

Verwenden Sie ausschließlich diese sechs Notizen und geben Sie neben jeder Tatsachenaussage die Quelle an:

- Anbieter A, Preisseite, 20.09.2026: Der Team-Tarif kostet monatlich $40 pro Arbeitsplatz und umfasst 100.000 inbegriffene Aktionen.
- Anbieter B, Vergleichsbeitrag, 21.09.2026: Der Team-Tarif von Anbieter A umfasst monatlich 120.000 Aktionen pro Arbeitsplatz.
- Kundeninterview, 18.09.2026: Unser Team verfügt über 8 Plätze und hat im letzten Monat 710.000 Aktionen genutzt.
- Finanz-Tabelle, 19.09.2026: Die aktuelle Budgetobergrenze liegt bei $360 pro Monat.
- Anbieter A, Seite „Limits“, 20.09.2026: Überschreitungen werden nach Ausschöpfung des inbegriffenen Kontingents mit $0,004 pro Aktion abgerechnet.
- Beschaffungshinweis, 22.09.2026: Ein Wechsel ist nur zulässig, wenn die monatliche Gesamtsumme im Rahmen des Budgets bleibt und das Kontingent überprüft wurde.

Geben Sie genau diese Abschnitte zurück:
1. Überprüfte Fakten
2. Zugeschriebene Ansprüche
3. Konflikttabelle
4. Unabhängige Berechnungen (berechnen Sie sowohl das 8 × 100.000- als auch das 8 × 120.000-Szenario sowie etwaige Überschreitungen)
5. Empfehlung
6. Eine klärende Frage nur, wenn der Konflikt die Empfehlung beeinflusst
Lösen Sie den Konflikt zwischen 100.000 und 120.000 nicht stillschweigend.
1. Überprüfte Fakten
- Der Team-Tarif kostet monatlich $40 pro Arbeitsplatz (Anbieter A, Preisseite, 20.09.2026).
- Das Team verfügt über 8 Plätze und hat im letzten Monat 710.000 Aktionen genutzt (Kundenbefragung, 18.09.2026).
- Die aktuelle Budgetobergrenze beträgt $360 pro Monat (Finanz-Tabelle, 19.09.2026).
- Überschreitungen werden nach Ausschöpfung des inbegriffenen Kontingents mit $0,004 pro Aktion in Rechnung gestellt (Anbieter A, Seite “Limits”, 20.09.2026).
- Ein Wechsel ist nur zulässig, wenn die monatliche Gesamtsumme im Rahmen des Budgets bleibt und das Inklusivkontingent überprüft wurde (Beschaffungsvermerk, 22.09.2026).

2. Zugeordnete Ansprüche
- Das Team umfasst 100.000 inbegriffene Aktionen (Anbieter A, Preisseite, 20.09.2026). In diesem Hinweis wird nicht ausdrücklich “pro Arbeitsplatz” angegeben.
- Das Team von Anbieter A umfasst monatlich 120.000 Aktionen pro Arbeitsplatz (Anbieter B, Vergleichsbeitrag, 21.09.2026).

3. Konflikttabelle
| Element | Behauptung | Quelle | Status |
| --- | --- | --- | --- |
| Enthaltene Aktionen | 100.000 enthaltene Aktionen; „pro Arbeitsplatz“ wird nicht angegeben | Anbieter A, Preisseite, 20.09.2026 | Ungeklärt |
| Enthaltene Aktionen | 120.000 Aktionen pro Arbeitsplatz monatlich | Anbieter B, Vergleichsbeitrag, 21.09.2026 | Ungeklärt |

Der Widerspruch zwischen 100.000 und 120.000 ist nicht geklärt. Aus diesen Anmerkungen geht nicht hervor, welche Zahl korrekt ist.

4. Unabhängige Berechnungen
Grundkosten pro Arbeitsplatz, in beiden Szenarien gleich: 8 Arbeitsplätze (Kundenbefragung, 18.09.2026) × $40 pro Arbeitsplatz monatlich (Anbieter A, Preisseite, 20.09.2026) = $320 pro Monat.

Beide nachstehenden Multiplikatoren wurden wie angefordert berechnet. Sie stellen keine Feststellung dar, dass Anbieter A einen Pauschalbetrag pro Sitz angegeben hat.

- 8 × 100.000 = 800.000 inbegriffene Aktionen, unter Verwendung der Zahl 100.000 (Anbieter A, Preisseite, 20.09.2026).
- Die Nutzung von 710.000 (Kundenbefragung, 18.09.2026) liegt um 90.000 unter 800.000, daher beträgt die Anzahl der überzähligen Aktionen = 0.
- Überziehungsgebühr = 0 × $0,004 = $0 (Anbieter A, Seite „Limits“, 20.09.2026).
- Monatliche Gesamtsumme = $320 + $0 = $320, was innerhalb der Obergrenze von $360 liegt (Finanz-Tabelle, 19.09.2026).

- 8 × 120.000 = 960.000 erfasste Aktionen, unter Verwendung des Wertes 120.000 (Anbieter B, Vergleichsbeitrag, 21.09.2026).
- Die Nutzung von 710.000 (Kundenbefragung, 18.09.2026) liegt um 250.000 unter 960.000, daher beträgt die Anzahl der überzähligen Aktionen = 0.
- Überziehungsgebühr = 0 × $0,004 = $0 (Anbieter A, Seite „Limits“, 20.09.2026).
- Monatliche Gesamtsumme = $320 + $0 = $320, was innerhalb der Obergrenze von $360 liegt (Finanz-Tabelle, 19.09.2026).

5. Empfehlung
Den Wechsel noch nicht genehmigen. Bei beiden berechneten Kontingenten ergeben die 710.000 Aktionen des letzten Monats (Kundenbefragung, 18.09.2026) keine Überschreitung und eine monatliche Gesamtsumme von $320 ergeben, was innerhalb der Obergrenze von $360 liegt (Finanz-Tabelle, 19.09.2026). Dieses Kostenergebnis hängt nicht davon ab, ob 100.000 oder 120.000 gewählt werden. Der Wechsel erfüllt nach wie vor nicht die zweite Bedingung: Das Kontingent muss verifiziert werden (Beschaffungsnotiz, 22.09.2026), und diese Angaben weisen 100.000 (Anbieter A, Preisliste, 20.09.2026) im Widerspruch zu 120.000 (Anbieter B, Vergleichsbeitrag, 21.09.2026).

6. Nur eine klärende Frage, wenn der Konflikt die Empfehlung ändert
Keine klärende Frage. Der Konflikt zwischen 100.000 und 120.000 ändert nichts an der Empfehlung.
In den Forschungsunterlagen gab es bewusst widersprüchliche Angaben dazu, ob das Kontingent 100.000 oder 120.000 Aktionen pro Sitzplatz betrug. Grok 4.7 hielt die beiden Quellen getrennt, stellte fest, dass die erste Quelle nicht ausdrücklich “pro Arbeitsplatz” angab, berechnete beide Szenarien mit acht Arbeitsplätzen und zeigte, dass beide bei $320 blieben, ohne dass es bei der angegebenen Nutzung zu einer Überschreitung kam. Dennoch wurde empfohlen, die Genehmigung zurückzuhalten, da die Beschaffungsabteilung eine Überprüfung des Kontingents verlangte. Das ist die richtige Unterscheidung zwischen einer Empfehlung, die zahlenmäßig stabil ist, und einer ungeklärten vertraglichen Tatsache.
Fazit: Gute Note in den Bereichen Zuordnung, Arithmetik, Konfliktbewältigung und Entscheidungsdisziplin.
Test 3: Unübersichtliche Notizen zum Ausführungsplan
Aufgabe 3 – Wandeln Sie diese unübersichtlichen Projektnotizen in einen einwöchigen Umsetzungsplan mit maximal 700 Wörtern um.

Anmerkungen:
- Start der Landingpage am Freitag um 17:00 Uhr; der Product Owner gibt in einer späteren Notiz den Donnerstagvormittag an.
- Mina: Überschrift und Preistabelle verfassen. Mina gibt außerdem an, dass sie den Text erst am Mittwochnachmittag prüfen kann.
- Arjun: Analyse-Events; in einer doppelten Notiz heißt es, der Verantwortliche für die Analyse stehe noch nicht fest.
- Im Bereich Design gibt es zwei doppelte Aufgaben: “mobile hero crop” und “mobile hero crop final”.
- Die rechtliche Prüfung muss vor jedem öffentlichen Start erfolgen.
- Die Qualitätssicherung benötigt einen ganzen Tag, nachdem die Analytics-Ereignisse verfügbar sind.
- Omar ist am Dienstagnachmittag abwesend.
- Die Start-E-Mail ist für Freitag, 16:00 Uhr, geplant.
- Unbekannt: Wer trifft die endgültige Go/No-Go-Entscheidung?

Anforderungen: Doppelte Aufgaben bündeln, unbekannte Verantwortliche als „noch zu bestimmen“ kennzeichnen, beide festen Fristen beibehalten, Widersprüche markieren, anstatt sie stillschweigend aufzulösen, und mit einer Liste von fünf Risiken abschließen.

Geben Sie genau diese Abschnitte zurück:
1. Ein-Wochen-Plan
2. Widersprüche und Unbekannte
3. Fünf Risiken
Erfinden Sie keine Verantwortlichen oder Termine.
1. Wochenplan

Da die Notizen keine Kalendertermine enthalten, werden keine hinzugefügt. Es werden nur die angegebenen Ankerpunkte und Abhängigkeiten verwendet. Doppelte Designarbeiten werden als eine Aufgabe zusammengefasst. Unbekannte Verantwortliche bleiben “TBD” (noch zu bestimmen). Konflikte bei den Startterminen werden beide beibehalten.

- Text: Mina verfasst die Überschrift und die Preistabelle. Die Textprüfung durch sie erfolgt erst am Mittwochnachmittag.
- Design: eine Aufgabe, Zuschneiden des mobilen Hero-Banners, einschließlich des “letzten” Durchgangs. Es wird kein separater Verantwortlicher genannt.
- Analyse-Events: müssen vor der Qualitätssicherung (QA) vorhanden sein. Der Verantwortliche steht noch nicht fest (in einer Notiz ist Arjun genannt, in einer anderen „TBD“).
- Qualitätssicherung (QA): ein ganzer Tag, erst nachdem die Analytics-Ereignisse verfügbar sind. Verantwortlicher noch offen. Hier ist kein QA-Tag zugewiesen.
- Rechtliche Prüfung: vor jedem öffentlichen Start erforderlich. Verantwortlicher noch offen. In den Notizen nicht terminiert.
- Go/No-Go: Verantwortlicher noch offen. Wird nicht als entschieden behandelt.
- Zeitpunkte für den öffentlichen Start, beide beibehalten: Donnerstagvormittag (Produktverantwortlicher) und Freitag 17:00 Uhr (Landingpage).
- Start-E-Mail: Freitag 16:00 Uhr. Verantwortlicher noch zu bestimmen.
- Omar ist am Dienstagnachmittag abwesend. Da Omar in diesen Notizen keine Aufgabe zugewiesen ist, wird keine verschoben.

Reihenfolge, ohne neue Termine: Minas Entwurf muss für die Überprüfung am Mittwochnachmittag fertig sein; das Design stellt den „Single Hero Crop“ fertig; die Analytics-Events werden vom noch nicht festgelegten Verantwortlichen bereitgestellt; die Qualitätssicherung erhält anschließend einen ganzen Tag Zeit; die rechtliche Prüfung wird vor jedem öffentlichen Start abgeschlossen; „Go/No-Go“ (noch nicht festgelegt) ist weiterhin ohne Verantwortlichen. Donnerstagvormittag, Freitag 17:00 Uhr oder Freitag 16:00 Uhr nicht streichen.

2. Widersprüche und Unbekannte

Widersprüche (noch nicht geklärt):
- Der Start der Landingpage ist am Freitag um 17:00 Uhr, während eine spätere Notiz des Product Owners Donnerstagvormittag angibt.
- Der Verantwortliche für die Analytik ist in einer Notiz Arjun und in einer doppelten Notiz „noch zu klären“ (TBD).

Unbekannte Punkte, gekennzeichnet als „noch zu klären“ (TBD):
- Endgültiger Verantwortlicher für die Go/No-Go-Entscheidung.
- Festgelegter Verantwortlicher für die Analytik.
- Verantwortlicher für die rechtliche Prüfung.
- Verantwortlicher für die Qualitätssicherung (QA).
- Verantwortlicher für die Launch-E-Mail.
- Namentlich benannter Verantwortlicher für das Design, über „Design“ hinaus.
- Omars Rolle; es wird lediglich seine Abwesenheit am Dienstagnachmittag angegeben.
- Welche Startzeit maßgeblich ist und ob die E-Mail am Freitag um 16:00 Uhr mit einer der beiden Zeiten übereinstimmt. Es werden keine Termine außerhalb dieser Wochentagszeiten angegeben.

3. Fünf Risiken

1. Donnerstagvormittag und Freitag 17:00 Uhr können nicht beide als Startzeitpunkt für die Landingpage dienen; die Verwendung einer der beiden Zeiten ohne Entscheidung kann zu einem vorzeitigen Start führen oder die andere Frist verpassen.
2. Der Versand der Start-E-Mail ist für Freitag, 16:00 Uhr, festgelegt – vor Freitag, 17:00 Uhr – und in den Notizen nicht mit Donnerstagvormittag abgestimmt; daher könnte sie für eine Seite versendet werden, die sich noch nicht oder nicht mehr im beabsichtigten Zustand befindet.
3. Die Zuständigkeit für die Analytik ist umstritten, sodass Ereignisse verschoben werden könnten; Die Qualitätssicherung benötigt nach den Ereignissen noch einen ganzen Tag und passt möglicherweise nicht vor einen der beiden Starttermine.
4. Vor jeder öffentlichen Veröffentlichung muss eine rechtliche Prüfung erfolgen, für die es jedoch weder einen Verantwortlichen noch einen Zeitrahmen gibt; daher könnte der Start blockiert werden oder ohne Prüfung erfolgen.
5. Es wurde kein Verantwortlicher für die Go/No-Go-Entscheidung benannt, sodass für keine der beiden festen Fristen eine bestimmte Person festgelegt ist, die den Start genehmigen oder stoppen kann.
Grok 4.7 hat die doppelte „mobile-hero“-Aufgabe zusammengeführt, den Terminkonflikt am Donnerstagvormittag und am Freitag um 17:00 Uhr beibehalten, die E-Mail-Frist am Freitag um 16:00 Uhr beibehalten, ungelöste Verantwortliche als „TBD“ gekennzeichnet und endete mit genau fünf Risiken. Es wurden weder Kalendertermine noch Verantwortliche neu festgelegt. Die Schwäche lag in der Umsetzbarkeit: Anstatt die Arbeit über eine Abfolge von Montag bis Freitag zu verteilen, lieferte das System eine geordnete Liste von Abhängigkeiten und gab an, dass kein QA-Tag zugewiesen werden könne. Diese Vorsicht ist zwar vertretbar, doch da die Eingabeaufforderung einen einwöchigen Ausführungsplan verlangte, entsprach die Antwort nur teilweise dem gewünschten Format.
Fazit: Teilweise bestanden: hervorragende Erhaltung der Nebenbedingungen, geringere Nützlichkeit für die Terminierung.
Welche Änderungen bringt Grok 4.7 in der Praxis mit sich?
Am sinnvollsten lässt sich die Einführung als Frage zum Arbeitsablauf betrachten: Wo reduziert eine fundierte Argumentation den Überprüfungsaufwand, und wo führt sie lediglich zu einer längeren Antwort? Die drei API-Aufgaben lassen ein praktisches Muster erkennen. Grok 4.7 hat keine Probleme damit, mehrere Einschränkungen gleichzeitig im Blick zu behalten, insbesondere wenn die Eingabeaufforderung verlangt, Fakten von Annahmen zu trennen. Weniger überzeugend ist es, wenn die Aufgabe einen konkreten Zeitplan oder eine Ausführungsreihenfolge erfordert, die in den Quellnotizen nicht vollständig angegeben sind.
Programmierung und Fehlerbehebung
Bei der Arbeit mit Repositorys eignet sich das Modell besser für eine abgegrenzte Diagnose als für eine offen formulierte Anfrage vom Typ “Erstelle eine App”. Geben Sie ihm den kleinsten nützlichen Dateisatz, beschreiben Sie das Fehlersymptom und verlangen Sie eine Ursachenanalyse, bevor ein Patch erstellt wird. Fordern Sie Tests an, die vor der Änderung fehlschlagen und danach erfolgreich sind. In unserem Handler-Test blieb die Antwort nah am bereitgestellten Code und widerstand der Versuchung, eine externe Ursache für das Symptom des leeren Körpers zu erfinden.
Dieses Verhalten ist von Bedeutung, da es bei der Programmierqualität nicht nur um die Code-Generierung geht. Eine sinnvolle Programmierlösung sollte das lokale Design bewahren, den Diff begrenzen, Annahmen identifizieren und die Verifizierung kostengünstig gestalten. Grok 4.7 hat all dies in einer einzigen kleinen Aufgabe umgesetzt, doch eine einzelne Aufgabe reicht nicht aus, um Zuverlässigkeit auf Repository-Ebene zu gewährleisten. Teams sollten dieselbe Bewertungsvorlage auf einen echten Fehler, eine Refaktorisierung, eine Änderung in mehreren Dateien und einen sicherheitsrelevanten Pfad anwenden, bevor sie die Arbeit in die Produktion übernehmen.
Forschung und Zusammenfassung der Quellen
Die Forschungsaufgabe brachte eine weitere Stärke zum Vorschein: die Disziplin bei der Abgrenzung von Quellen. Grok 4.7 hat die vom Anbieter angegebene Zahl von 100.000 Aktionen nicht einfach stillschweigend mit der Zahl von 120.000 aus dem Vergleichsbeitrag zusammengeführt. Zudem unterschied es zwischen einer Berechnung, die unter beiden Szenarien stabil ist, und einer Beschaffungsbedingung, die noch einer Überprüfung bedarf.
Dies ist das richtige Muster für recherchierungsintensive Arbeiten. Weisen Sie das Modell an, verifizierte Fakten, zugeschriebene Behauptungen, ungelöste Konflikte, Berechnungen und Empfehlungen separat zu kennzeichnen. Selbst ein ausgefeiltes Memo kann falsch sein, wenn es eine sekundäre Behauptung als nicht zitierte Tatsache tarnt. Die Antwort von Grok 4.7 war hilfreich, da sie den Konflikt sichtbar hielt, obwohl sich das rechnerische Ergebnis nicht änderte.
Planung und Betrieb
Bei der Planung wurden die Grenzen deutlicher. Das Modell berücksichtigte zwar alle Termine und unbekannten Verantwortlichen, ging jedoch nicht so weit, einen Zeitplan von Montag bis Freitag zu erstellen. Das ist zwar sicherer, als Termine frei zu erfinden, bedeutet aber auch, dass der Nutzer die Abhängigkeiten weiterhin in Kalendertermine umsetzen muss.
Bei operativen Anweisungen sollten Sie den Planungshorizont, die verfügbaren Arbeitstage, die Verfügbarkeit des Eigentümers und den Entscheidungsträger angeben. Falls diese Felder fehlen, fragen Sie zunächst nach einer Abhängigkeitsübersicht und anschließend nach einem Kalender. Durch diesen zweistufigen Arbeitsablauf wird die Vorsicht des Modells sinnvoll genutzt, anstatt sie als Unentschlossenheit zu betrachten.
Abruf mit langem Kontext
Ein Kontextfenster von 500K verändert zwar, was in eine einzelne Anfrage passt, aber nicht, was ohne Überprüfung als vertrauenswürdig angesehen werden kann. Bei Aufgaben mit großem Kontext sollten Abruf-Tests verwendet werden: Platzieren Sie entscheidende Fakten am Anfang, in der Mitte und am Ende eines Pakets; fügen Sie einen absichtlichen Konflikt hinzu; bitten Sie dann um eine Entscheidung unter Angabe der Quellenpositionen. Messen Sie sowohl den Recall als auch die Grenzdisziplin.
Beurteilen Sie einen Routenverlauf mit langem Kontext nicht danach, ob er eine große Anfrage akzeptiert. Halten Sie fest, wo dem Modell Fakten fehlen, ob es den letzten Abschnitt übergewichtet, wie stark die Latenz mit der Eingabegröße zunimmt und ob der Anbieter die Anfrage abschneidet oder umwandelt. Ein großes angegebenes Fenster ist eine Kapazitätsangabe, keine Garantie für stabiles Schlussfolgern am Grenzwert.
So bewerten Sie Grok 4.7 selbst
Verwenden Sie einen kleinen, wiederholbaren Testdatensatz, bevor Sie eine Standard-Einstellung in der Produktion ändern. Das Ziel besteht nicht darin, eine Rangliste neu zu erstellen, sondern das Modell mit dem bereits von Ihnen bezahlten Bewertungs- und Überprüfungsverfahren zu vergleichen.
- Die Eingaben einfrieren. Speichern Sie die genaue Eingabeaufforderung, die Dateien, das Quellpaket, die Modell-ID, die Temperatur, die Einstellungen für die Argumentation und die Tool-Berechtigungen. Vergleichen Sie keine direkte Route mit einer Anbieter-Route, während Sie gleichzeitig die Eingabeaufforderung ändern.
- Bewerten Sie das Werk, nicht den Schreibstil. Bei der Programmierung werden die Genauigkeit der Ursachenanalyse, der Umfang des Patches, die Tests und die Annahmen bewertet. Bei der Forschung werden die Grenzen der Zitierung, die Rechenoperationen, Konflikte und die Qualität der Empfehlungen bewertet. Bei der Planung werden die Einhaltung von Fristen, die Verantwortlichkeiten, die Abhängigkeiten und die Umsetzbarkeit bewertet.
- Den Transport separat erfassen. Erfassen Sie die Zeit bis zum ersten Token, die Gesamtzeit, den Stream-/Nicht-Stream-Modus, den HTTP-Status und das Wiederholungsverhalten in einem Routenprotokoll. Ein Gateway-Timeout ist nicht automatisch ein Fehler auf Modellebene, verursacht aber dennoch Produktionskosten.
- Überprüfen Sie das Verhalten bei einem Fehler. Fügen Sie eine mehrdeutige Eingabe, eine widersprüchliche Quelle und einen absichtlich unvollständigen Datensatz hinzu. Die relevante Frage ist, ob das Modell die Unsicherheit kennzeichnet oder die Lücke mit einer sicheren Schätzung füllt.
- Prüfen Sie Kosten und Aufwand gemeinsam. Erfassen Sie Eingabetoken, Ausgabetoken, zwischengespeicherte Eingaben, Argumentationstoken (sofern diese offengelegt werden) sowie die für die manuelle Überprüfung aufgewendeten Minuten. Eine kostengünstigere Antwort, deren Überprüfung doppelt so lange dauert, ist in der Praxis möglicherweise nicht kostengünstiger.
- Vor dem Umschalten wiederholen. Führen Sie jede Aufgabe mindestens zweimal oder anhand mehrerer repräsentativer Beispiele durch, bevor Sie eine Team-Standardeinstellung ändern. Bewahren Sie die sichtbare Rohantwort und die Bewertungsnotizen auf, damit ein anderer Prüfer die Entscheidung nachvollziehen kann.
Die drei Durchläufe in diesem Testbericht stellen lediglich eine erste Stichprobe dar und sind kein Ersatz für die Bewertungsdaten einer Mannschaft. Sie zeigen, wie sich Grok 4.7 bei einer Codierungsaufgabe, einem Memo mit Quellenkonflikten und einem Planungspaket verhält; sie stellen jedoch keine allgemeingültige Rangfolge dar.
Grok 4.7 – Preise und API-Zugriff
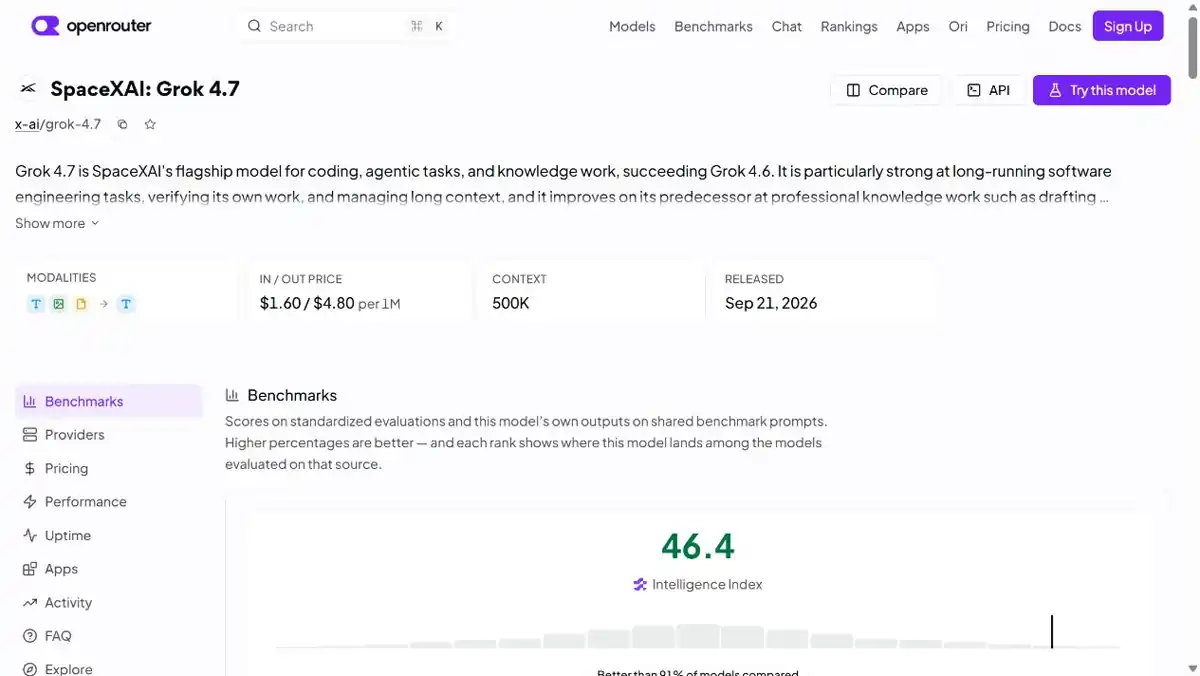
Gerade beim Thema Preisgestaltung können Modellbewertungen oft irreführend sein. Es gibt mindestens drei verschiedene Zahlen, die einem Leser begegnen können: den direkten API-Preis von xAI, den Routenpreis eines Aggregators und den Abonnementpreis für Endverbraucher. Diese sind nicht austauschbar.
Laut der Ankündigung von xAI wird Grok 4.7 zum gleichen Preis und mit derselben Geschwindigkeit angeboten wie Grok 4.6. Auf der Einführungsseite heißt es, dass das Standardmodell ab $2 pro 1 Million Eingabe-Token und $6 pro 1 Million ausgegebener Token; „Artificial Analysis“ führt dieselben Zahlen zur direkten Route separat auf und $0,50 pro 1 Million zwischengespeicherte Eingabetoken. xAI gibt außerdem an, dass eine schnelle Variante die Ausgabegeschwindigkeit verdoppelt – zum doppelten Preis. Verwenden Sie die offizielle Entwicklerdokumentation Informieren Sie sich über die aktuellen API-Vertragsbedingungen und die kontospezifische Verfügbarkeit, bevor Sie Produktionsdaten übertragen.
OpenRouter: Grok, Seite 4,7 zeigt $1,60 pro 1 Million eingehende Token und $4,80 pro 1 Million ausgegebener Token für die jeweilige Route. Dabei handelt es sich um einen OpenRouter-/Anbieterpreis, nicht um eine Korrektur des direkten Listenpreises von xAI. Routing, Aufschläge, Caching, Limits und Verfügbarkeit können je nach Anbieter variieren.
Auf die Frage “Wie viel kostet Grok 4,7?” lässt sich keine verlässliche Antwort geben, ohne die Route zu nennen. Für einen API-Käufer gilt: Vergleichen Sie:
- Eingabe- und Ausgabetokenraten;
- Behandlung mit zwischengespeicherten Eingaben;
- Kontext- und Ausgabebeschränkungen;
- Nutzungsbeschränkungen und regionale Verfügbarkeit;
- ob der Anbieter Steuerelemente zur Begründung bereitstellt;
- Bestimmungen zur Protokollierung, Aufbewahrung und Datenverarbeitung.
Was den Kundenzugang betrifft, sollten Sie nicht davon ausgehen, dass ein API-Preis den Preis für ein X- oder Grok-Abonnement angibt. Für den Kunden-Tarif, den API-Zugang und den Aggregator eines Drittanbieters können unterschiedliche Zugangsregeln gelten.
Welche API-Route sollten Sie wählen?
| Route | Am besten für | Was vor der Verwendung zu überprüfen ist | Wichtigster Kompromiss |
|---|---|---|---|
| Direct xAI-API | Produktionssysteme, für die ein eigener Vertrag des Anbieters erforderlich ist | Offizielle Modell-ID, Ratenbeschränkungen, Datenbedingungen, Regionen, Streaming und aktueller Preis | Die transparenteste Herkunft, aber Sie kümmern sich selbst um die Abrechnung und die Verfügbarkeit |
| OpenRouter | Schneller Anbietervergleich und Routenoptimierung | Tatsächlicher Upstream-Anbieter, Routenpreis, Caching, Datenschutz, Kontext und Fallback-Verhalten | Der Wechsel ist einfacher, aber die Route entspricht nicht der des direkten xAI-Dienstes |
| OpenAI-kompatible Test-API | Interne Auswertung oder ein Alt-Client, der das OpenAI-Schema bereits unterstützt | Modellzuordnung, Zeitüberschreitungsgrenzen, Streaming-Unterstützung, Nutzungsfelder, Aufbewahrungsfristen und Fehlersemantik | Einfache Integration, doch Kompatibilität garantiert kein identisches Verhalten der Anbieter |
Die für den praktischen Teil verwendete kompatible Route ergab grok-4.7 und unterstützte das Streaming. Die Anforderung für die Nicht-Streaming-Codierung überschritt das Wartefenster des Gateways, bevor der Streaming-Wiederholungsversuch abgeschlossen war. Diese Beobachtung ist bei der Entwicklung eines Clients nützlich, sollte jedoch nicht in eine direkte Aussage zur xAI-Latenz übernommen werden.
So greifen Sie auf Grok 4.7 zu
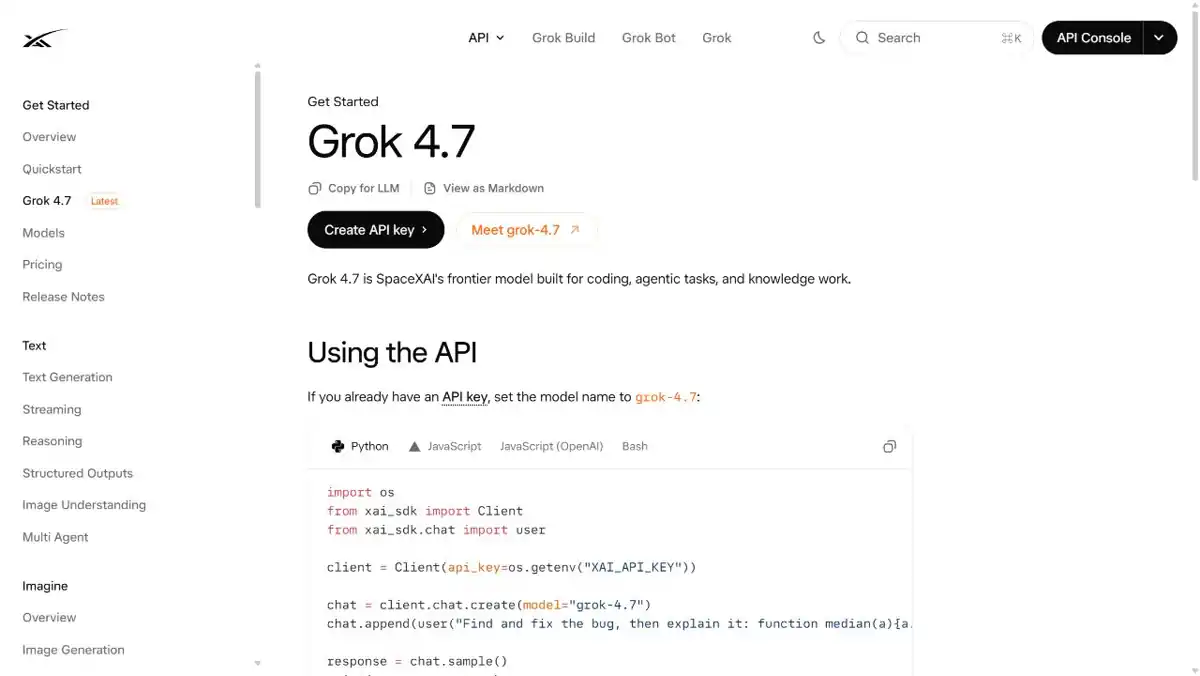
Am einfachsten ist es, mit dem xAI-Ankündigung und xAI-Entwicklerseite, und prüfen Sie anschließend, ob Sie Grok Build, Cursor, die direkte API oder einen Aggregator benötigen. Laut xAI ist Grok 4.7 in Cursor und Grok Build, über die Grok-API sowie über Programmier-Harnesses, Modell-Router und Cloud-Plattformen von Drittanbietern verfügbar. Diese Unterscheidung bestimmt die Abrechnung, die Modellsteuerung, die Datenschutzbestimmungen und die verfügbaren Tools.
Wenn Sie einen Aggregator verwenden, öffnen Sie dessen Modellseite und überprüfen Sie die Anbieter-Route, die Token-Preise, das Kontextlimit und die Modell-ID, bevor Sie darauf aufbauen. OpenRouter ist eine dokumentierte Route, deren Preise jedoch nicht in eine xAI-Abrechnungstabelle übernommen werden sollten.
Für Leser, die mehrere Modellfamilien in einem Arbeitsbereich vergleichen möchten, Der Multi-Modell-Arbeitsbereich von GlobalGPT kann für die parallele Bewertung von Eingabeaufforderungen nützlich sein. Dieser Artikel behandelt nicht behaupten, dass eine Grok 4.7-Route dort bereits verfügbar ist. Die im Katalog angegebene Route ist eine separate Frage der Verfügbarkeit und sollte vor dem Kauf in der Produkt-Benutzeroberfläche überprüft werden.
Grok 4,7 im Vergleich zu ChatGPT, Claude und Gemini
Diese Auswertung umfasst drei Testergebnisse für Grok 4.7, jedoch keine Vergleichstests mit ChatGPT, Claude oder Gemini. Eine pauschale Schlussfolgerung wie “Grok 4.7 ist besser” wäre nach wie vor eher Marketing als Analyse. Eine bessere Wahl hängt von den Arbeiten rund um das Modell ab:
| Wenn Ihre Priorität ist... | Beginnen Sie damit, … zu bewerten… | Warum |
|---|---|---|
| Lange technische Pakete | Grok 4.7 und andere Routen mit großem Kontext | Überprüfen Sie die Genauigkeit der Abfrage, nicht nur das angegebene Zeitfenster |
| Debugging im Repository | Grok 4.7, ein auf die Codierung ausgerichtetes Modell, und Ihre übliche Testschleife | Vergleich der Qualität der Ursachenanalyse und der Überprüfungszeit |
| Forschung, bei der die Quellen im Vordergrund stehen | Ein forschungsorientierter Arbeitsablauf sowie ein allgemeines Schlussfolgerungsmodell | Überprüfen Sie die Quellenangaben, bevor Sie Schlussfolgerungen akzeptieren |
| Bestehende Produktivitätsintegrationen | Das Modell, das bereits in Ihre Tools integriert ist | Wechselkosten können einen Benchmark-Gewinn überwiegen |
| Niedrigste API-Rechnung | Direkte und Aggregator-Routen im direkten Vergleich | Die Preise variieren je nach Anbieter und Cache-Verhalten |
Die “Leitfaden ”Für welche KI lohnt es sich, Geld auszugeben?“ stellt die richtige Kaufentscheidungsfrage: Welche wiederkehrende Aufgabe wird so viel besser, dass sich die Kosten für das Abonnement oder die API-Gebühr lohnen? Das ist eine nachhaltigere Entscheidungsgrundlage als dem neuesten Eintrag in der Rangliste hinterherzujagen.
Einschränkungen und offene Fragen
Grok 4.7 ist zu neu, als dass sich bereits ein breiter unabhängiger Konsens bilden könnte. Die vorliegenden Erkenntnisse lassen mehrere Fragen offen:
- Inwieweit ist die Verbesserung bei den Aufgaben in den Bereichen Programmierung, Recherche, Schreiben und multimodalen Aufgaben einheitlich?
- Bleibt der 500K-Kontext auch nahe der Grenze zuverlässig, oder verschlechtert sich die Abrufqualität bereits früher?
- Wie viel zusätzliche Latenz entsteht durch den höchsten Denkaufwand?
- Durch welche Consumer-Pläne, Regionen, Tools und Ratenbeschränkungen wird das Modell offengelegt?
- Wie wirken sich die neuen Sicherheitsvorkehrungen auf legitime, aber sensible technische Arbeiten aus?
- Liefern direct xAI, OpenRouter und andere Anbieter wesentlich unterschiedliche Ergebnisse oder Grenzwerte?
Diese Fragen sind kein Grund, das Modell abzulehnen. Sie sind vielmehr der Grund dafür, vor der Umstellung eines Arbeitsablaufs oder dem Versprechen von Kosteneinsparungen eine kleine, repräsentative Bewertung durchzuführen.
Für wen ist Grok 4.7 geeignet?
Grok 4.7 sollten Sie zunächst testen, wenn Sie:
- über längere Zeiträume hinweg Code zu debuggen oder technisches Material zu analysieren;
- mit Quellpaketen arbeiten, die über die Größe gewöhnlicher Chat-Fenster hinausgehen;
- ein Modell schätzen, das bereit ist, mehr Aufwand in eine schwierige Eingabe zu investieren;
- kann die Ergebnisse überprüfen, anstatt sie direkt in die Produktion zu schicken;
- vergleichen die Wirtschaftlichkeit von direkten API-Lösungen und Aggregatoren.
Die Lösung ist weniger geeignet, wenn Sie eine ausgereifte Integration, einen klar dokumentierten Nutzungsplan oder einen nachgewiesenen Leistungsvorteil bei derselben Aufgabe gegenüber dem bereits in Ihrem Stack vorhandenen Modell benötigen. In diesen Fällen können die Zugriffs- und Workflow-Ebene wichtiger sein als ein Indexgewinn von zwei Punkten.
FAQ
Was ist Grok 4.7?
Grok 4.7 ist die am 21. September 2026 von xAI veröffentlichte Modellversion für Programmierung und Wissensarbeit. Laut xAI arbeitet das Modell bei schwierigen Aufgaben länger, überprüft seine Ergebnisse sorgfältiger und verfügt über einen neuen Sicherheitsmechanismus, wobei Preis und Geschwindigkeit gegenüber Grok 4.6 unverändert bleiben.
Wann wurde Grok 4.7 veröffentlicht?
xAI hat am 21. September 2026 Grok 4.7 angekündigt. Die offizielle Startseite und die Entwicklerdokumentation sind die besten Quellen für Informationen zum Veröffentlichungsstatus, zur Modellverfügbarkeit und zu API-Änderungen.
Ist Grok 4.7 besser als Grok 4.6?
Artificial Analysis meldet einen Intelligenzindex von 46, zwei Punkte über dem Wert von Grok 4,6, sowie einen AA-Briefcase-Elo-Wert von 1.657, 111 Punkte über dem Wert von 4,6. Dies sind nützliche Anhaltspunkte, jedoch kein allgemeingültiges Ergebnis für jeden Arbeitsablauf.
Was ist das Kontextfenster von Grok 4.7?
In der „Artificial Analysis“-Liste ist für Grok 4.7 ein Kontextfenster von 500.000 Tokens angegeben. Ein großes Fenster garantiert keine perfekte Recherche; testen Sie das Modell daher mit Fakten an verschiedenen Stellen in einem langen Dokument, bevor Sie es für aufquellenintensive Aufgaben einsetzen.
Wie viel kostet der Grok 4.7 API?
Laut „Artificial Analysis“ beträgt die direkte API-Rate $2 pro 1 Million Eingabetoken und $6 pro 1 Million Ausgabetoken, bei zwischengespeicherten Eingaben liegt sie bei $0,50 pro 1 Million Token. Bitte überprüfen Sie die aktuelle xAI-Dokumentation, bevor Sie das System in der Produktion einsetzen.
Entspricht der Preis von OpenRouter für das Modell Grok 4.7 dem von xAI?
Nein. OpenRouter gibt für seine Route $1,60 pro 1 Million Eingabetoken und $4,80 pro 1 Million Ausgabetoken an. Dies ist ein anbieterspezifischer Preis und sollte getrennt von den direkten API-Preisen von xAI betrachtet werden. OpenRouter zeigt außerdem anbieterspezifische Felder zu Cache, Latenz, Durchsatz und Datenschutz an, die die tatsächlichen Kosten einer Route beeinflussen können.
Wie kann ich auf Grok 4.7 zugreifen?
Beginnen Sie mit der offiziellen Ankündigung und der Entwicklerdokumentation von xAI und wählen Sie anschließend das Verbraucherprodukt Grok, die direkte xAI-API oder einen Aggregator wie OpenRouter aus. Überprüfen Sie die Modell-ID, die Region, die Ratenbegrenzungen, den Kontext und die Abrechnung für die Route, die Sie tatsächlich nutzen möchten.
Ist Grok 4.7 auf GlobalGPT verfügbar?
Dieser Testbericht erhebt keinen Anspruch auf eine verifizierte 4.7-Route für Grok auf GlobalGPT. GlobalGPT kann zum Vergleich der verfügbaren Modellfamilien herangezogen werden, jedoch sollten der aktuelle Katalog und die genaue Modellverfügbarkeit vor dem Kauf in der Produkt-Benutzeroberfläche überprüft werden.
Eignet sich Grok 4.7 gut für Codierungsmittel?
Es lohnt sich, den Agenten in den Bereichen begrenztes Debugging, Code-Review und Schlussfolgerungen über mehrere Dateien hinweg zu testen, bei denen er Annahmen erläutern und Tests erstellen muss. Die praktische Programmieraufgabe war anspruchsvoll, testete jedoch weder die Ausführung von Tools noch die Bearbeitung des Repositorys, noch Berechtigungen oder einen vollständigen Agentenzyklus.
Warum war für den Programmiertest ein Streaming erforderlich?
Die erste Anfrage ohne Streaming überschritt das Wartefenster des Gateways der Testroute. Die gleiche Abfrage wurde bei aktiviertem Streaming erfolgreich abgeschlossen. Dies zeigt, warum Produktionsclients Streaming und explizite Timeouts unterstützen sollten; es beweist jedoch nicht, dass jede Grok-4.7-Route das gleiche Latenzverhalten aufweist.
Wie sollte ich das 500K-Kontextfenster testen?
Verwenden Sie ein festes Paket mit entscheidenden Fakten, die am Anfang, in der Mitte und am Ende platziert sind, sowie einem absichtlich eingebauten Konflikt. Fragen Sie nach den Quellenangaben und bewerten Sie das Erinnerungsvermögen, den Umgang mit Konflikten und die Latenz bei verschiedenen Eingabegrößen, anstatt sich allein auf das angegebene Maximum zu verlassen.
Lohnt sich ein Upgrade von Grok 4.6 auf Grok 4.7?
Die ersten Ergebnisse deuten auf eine sinnvolle, wenn auch schrittweise Verbesserung hin: Die unabhängigen Messwerte haben sich verbessert, und der praktische Test zeigte starke Leistungen bei der Fehlerbehebung und der Quellcodesynthese. Führen Sie das Upgrade erst dann durch, wenn Ihre eigenen Aufgaben einen geringeren Überprüfungsaufwand oder eine höhere Genauigkeit bei routenspezifischen Kosten aufweisen, die Sie rechtfertigen können.
Endgültiges Urteil
Grok 4.7 scheint ein ernstzunehmendes, schrittweises Modell-Upgrade mit einem klaren Ziel zu sein: Programmier- und Wissensarbeit, die anhaltenden Einsatz belohnt. Die offizielle Veröffentlichung liefert eine glaubwürdige Erklärung für die Änderung, die ersten Zahlen von Artificial Analysis zeigen eine Verbesserung gegenüber Grok 4.6 statt eines Rückschritts, und unser API-Test liefert ein weiteres, wenn auch schwächeres praktisches Indiz. Das Modell ging besonders gut mit einem Parallelitätsfehler und einem Memo mit widersprüchlichen Quellen um; seine Planungsantwort war sorgfältig, aber nicht so umsetzbar wie gefordert.
Das ehrliche Urteil ist noch vorläufig. Es handelte sich um drei einzelne Durchläufe einer Teststrecke, wobei die langsamste Aufgabe das Streaming nach Ablauf eines Gateway-Timeouts ohne Streaming erforderte, und es gibt weder einen vergleichbaren Durchlauf eines Mitbewerbers noch einen breiten unabhängigen Konsens. Beginnen Sie mit einer schwierigen Aufgabe aus Ihrem tatsächlichen Arbeitsablauf, vergleichen Sie die Ausgabe und die Bearbeitungszeit mit dem Modell, das Sie bereits verwenden, und entscheiden Sie dann, ob das Upgrade die routenspezifischen Kosten wert ist.









