
Claude Fable 5.2 مقابل Opus 5.5: البرمجة والتكلفة وأيهما تستخدم
خمس مهام بنفس المطالبات تقارن بين Claude Fable 5.2 وOpus 5.5 في البحث وتصميم واجهة الذكاء الاصطناعي والكتابة والبيانات وتخطيط المنتج، مع لقطات شاشة أصلية واستخدام مسجل للوقت والرموز.
 Chloe Murphy

Opus 5.5 هو نقطة البداية المعقولة للعمل الروتيني؛ اختبر Fable 5.2 عندما تحتاج مهمة محددة إلى تحسين. في أزواج المهام النصية الأربعة المكتملة لدينا، نجح كلا النموذجين في إجراء الحساب البحثي الأساسي ومقاييس البيانات بشكل صحيح. تعاملت خطة منتج Fable مع حالة عدم يقين واحدة بعناية أكبر؛ وقد استوفى كلا الناتجين الكتابيين القيود الرئيسية.
تستخدم مقارنة التصميم تشغيلًا مطابقًا جديدًا يبلغ 32,768 رمزًا. تظهر لقطات الشاشة وفحوصات التفاعل والقيود في مهمة التصميم أدناه.
Fable 5.2 أحدث وأعلى تكلفة لكل رمز. لكن هل يمنحك نتيجة أفضل، أم مجرد فاتورة أكبر؟ قارنّا البحث وتصميم واجهة الذكاء الاصطناعي والكتابة وتحليل البيانات وقرارات المنتج باستخدام نفس موجز المهمة لكل نموذج.
إذا كنت تفضل مقارنة النماذج دون إدارة إعدادات API منفصلة، تقدم GlobalGPT مساحة عمل متعددة النماذج. لا تثبت اختبارات API الواردة هنا توفر Fable 5.2 داخل GlobalGPT.
المقارنة العملية
| القرار | Fable 5.2 | Opus 5.5 |
|---|---|---|
| الإدخال / الإخراج القياسي لكل مليون رمز | $8 / $40 | $4 / $20 |
| اختبار البحث | الحساب صحيح؛ الصياغة السببية تحتاج إلى تحرير | الحساب صحيح؛ تفاصيل تصميم الدراسة غير مدعومة |
| اختبار المحتوى | شرح من 180 كلمة؛ تعليق صوتي أقصر | شرح من 180 كلمة؛ مثال أكثر اكتمالاً |
| اختبار البيانات | جميع المقاييس المطلوبة صحيحة | جميع المقاييس المطلوبة صحيحة |
| اختبار المنتج | تمييز دقيق بين الضرر المؤكد والضرر المحتمل | خطة مفيدة؛ ادعاء غير مدعوم بفقدان العمل |
| محاولة التصميم الأصلية | لا توجد قطعة أثرية: فشل HTTP | HTML كامل بعد تنظيف كتل التعليمات البرمجية |
كيف اختبرنا النموذجين
استخدمت كل مهمة مادة مصدرية متطابقة، ومحادثة جديدة، ونفس حد الإخراج لكلا النموذجين. استخدمت المهام النصية سقفًا قدره 16000 رمز؛ واستخدمت عملية التصميم النهائية 32768. تظهر المطالبات والإعدادات والوقت والاستخدام مع المهمة المقابلة أدناه.
كانت جميع الدراسات والمنتجات وبيانات الطلبات والملاحظات الواردة في الملخصات عبارة عن تركيبات اختبار وهمية. قمنا بفحص الحسابات مقابل مفتاح إجابة مُعد مسبقًا. بقي جهد الاستدلال عند الإعداد الافتراضي للمنصة، لذا فإن هذا ليس معيارًا متساوي الجهد. لا تُثبت تسميات النماذج التي أعادتها البوابة الخارجية التوجيه العلوي بشكل مستقل.
باحث: توليف دون مبالغة في الأدلة
نفس الموجه · اختبار الباحث
You are a researcher. Use only these FICTIONAL study summaries about an AI writing assistant. A: randomized 120 adults, 60 per arm, intervention mean score baseline70 followup78, control baseline69 followup74, four weeks; no standard deviations, uncertainty intervals, or attrition information reported. B: observational 300 adults, usage correlated with writing scores r=.32, no confounder adjustment. C: interviews with12 users reporting perceived improvement. In under650 words synthesize evidence with A/B/C citations, calculate difference in changes, explain what cannot be inferred, and propose a feasible preregistered followup study with primary endpoint and analysis. Do not invent citations or statistical significance.
طلبت مهمة الباحث توليف ثلاث دراسات وهمية، بما في ذلك تجربة عشوائية ذات تقارير غير مكتملة. كان الحساب الأساسي هو (78 − 70) − (74 − 69) = 3 نقاط. كلا النموذجين أجابا بشكل صحيح ورفضا اختلاق دلالة إحصائية.
Fable 5.2
اقترح تقييمًا للكتابة معماة وغير مدعومة، وتحليل نية العلاج، وفحوصات حساسية للبيانات المفقودة. كما قدم مثالًا افتراضيًا صريحًا لحجم العينة.
“فقط فرق الثلاث نقاط يُعزى إلى المساعد”
كانت تلك الصياغة واثقة أكثر من اللازم نظرًا للتسرب غير المعروف وفجوات الإبلاغ، حتى وإن كانت الفقرات اللاحقة تؤهل التقدير. كما تكهن بأن المشاركين في المقابلات كانوا على الأرجح مختارين ذاتيًا.
Opus 5.5
فصل بوضوح بين الأدلة العشوائية والرصدية وأدلة المقابلات. اقترح تجربة معدلة حسب خط الأساس وأبقى حساب حجم العينة معتمدًا على تباين الدراسة التجريبية.
“ذات طبيعة مقطعية كما هو موصوف”
الملخص الرصدي المقدم لم يحدد تصميمًا مقطعيًا. كان ينبغي أن تظل هذه التفاصيل غير معروفة.
إذا قمت بتكييف هذا الموجز، فحافظ على ثبات الأدلة واطلب من كل نموذج فصل الحقائق المبلغ عنها عن الاستدلالات. مطالبات Claude للبحث والبرمجة تقدم المزيد من الأمثلة على القيود الخاصة بالمهمة.
Designer: مساحة عمل متعددة النماذج بالذكاء الاصطناعي
نفس المطالبة · اختبار Designer
You are a product designer and frontend builder. Return only one complete self-contained HTML file with inline CSS and JavaScript, no external assets/CDNs. Build a polished AI multi-model workspace called Parallel. Give it a distinctive cohesive visual identity with excellent typography, whitespace, hierarchy and responsive layout; choose your own palette. Include sidebar, model A/B selectors, prompt textarea, compare button, two side-by-side result cards, loading state, clear button, per-result copy button, empty-input validation, keyboard-accessible controls and mobile stacking. Models A/B are FICTIONAL; all outputs must be locally simulated and explicitly labeled demo. No real API calls or fake live performance metrics. Compare must work repeatedly and preserve the submitted prompt in both outputs. Copy must report success only after actual success, otherwise provide an error. Aim for a complete compact artifact, not an explanation.
طلب موجز المصمم من كلا النموذجين بناء موازي: مساحة عمل مستقلة لمقارنة الذكاء الاصطناعي مع شريط جانبي، ومحددات النماذج، وإدخال المطالبة، وبطاقات نتائج محاكاة، والتحقق، وعناصر تحكم النسخ، وتخطيط للجوال. لقد تركنا لوحة الألوان والهوية البصرية مفتوحة.
استخدم التشغيل المطابق النهائي نفس المطالبة، ونقل البث، وسقفًا مشتركًا يبلغ 32,768 رمزًا. وصل كلا الردين إلى توقف طبيعي. تظل القطع الأثرية المصدر غير محررة؛ حفظ HTML يزيل فقط سياج Markdown المحيط عند وجوده.
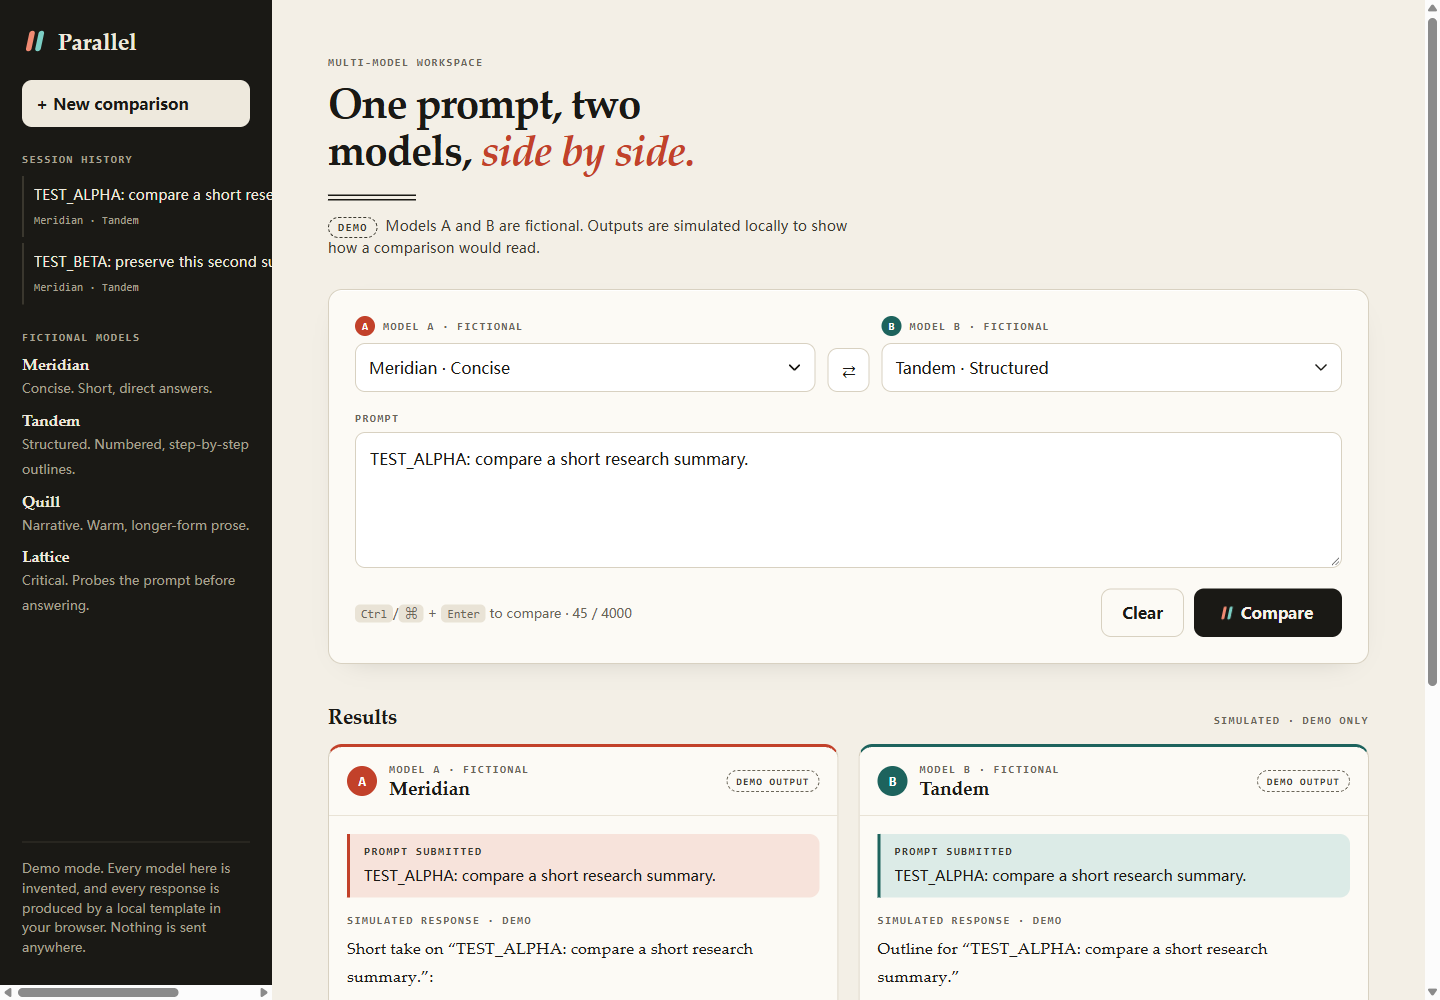
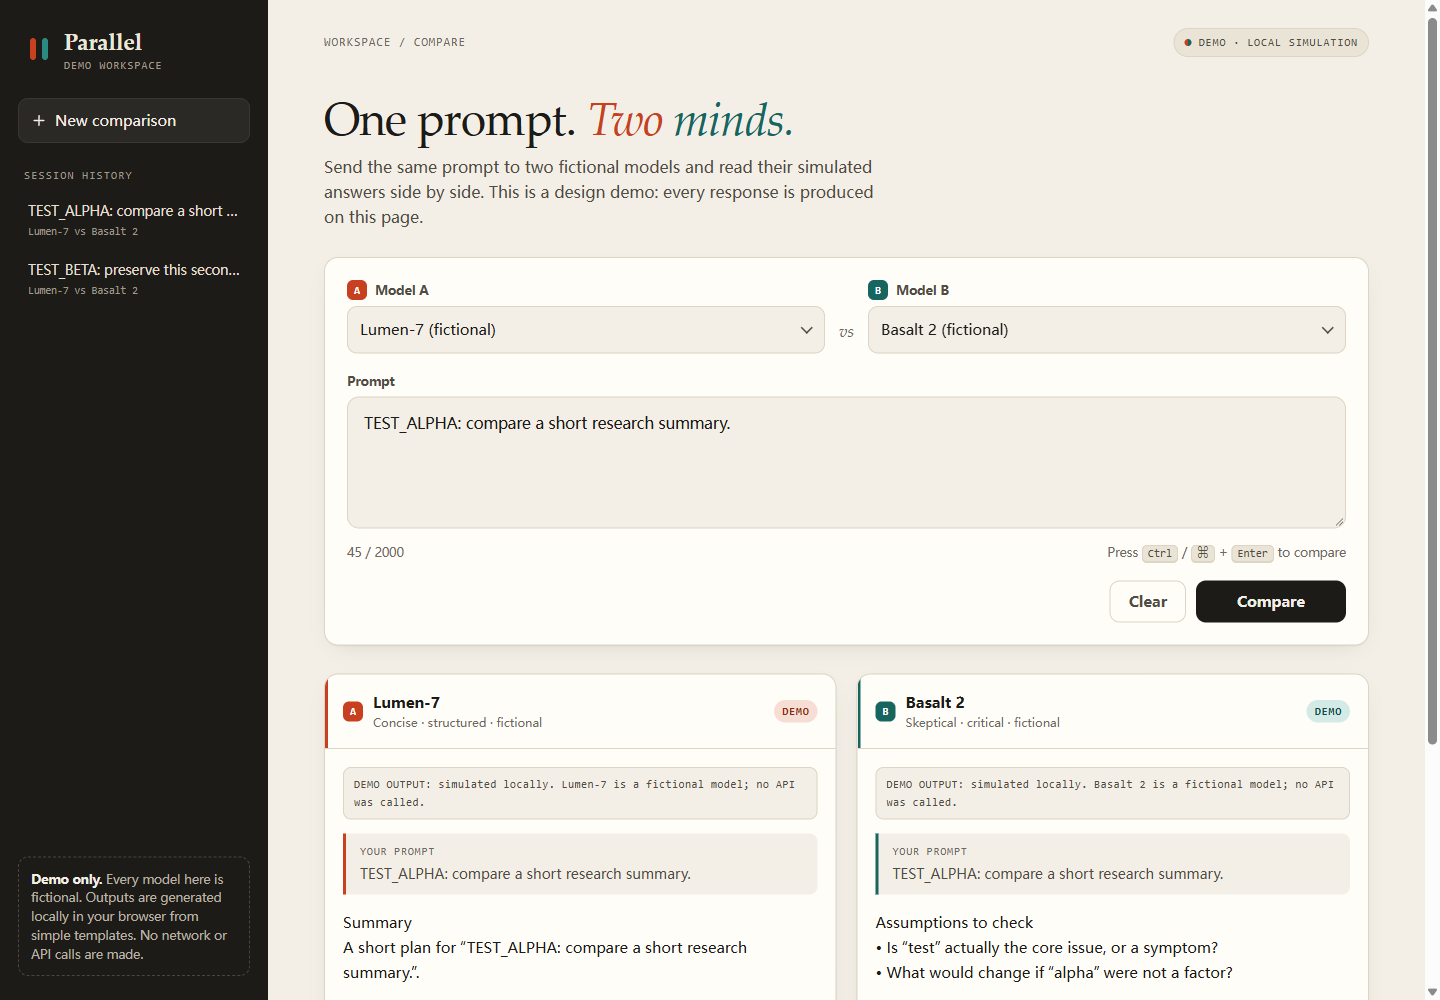
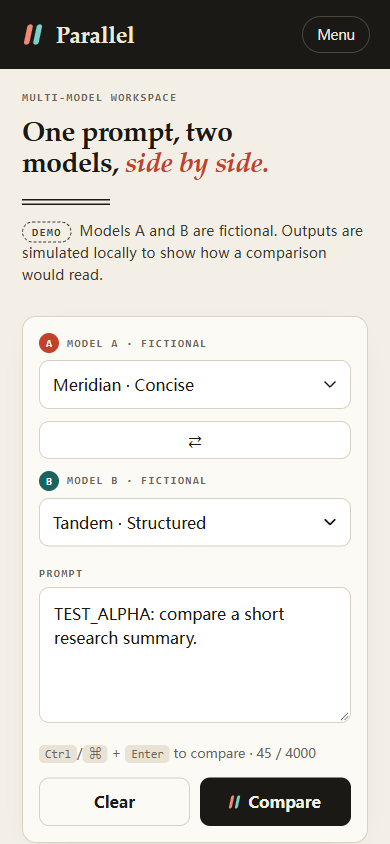
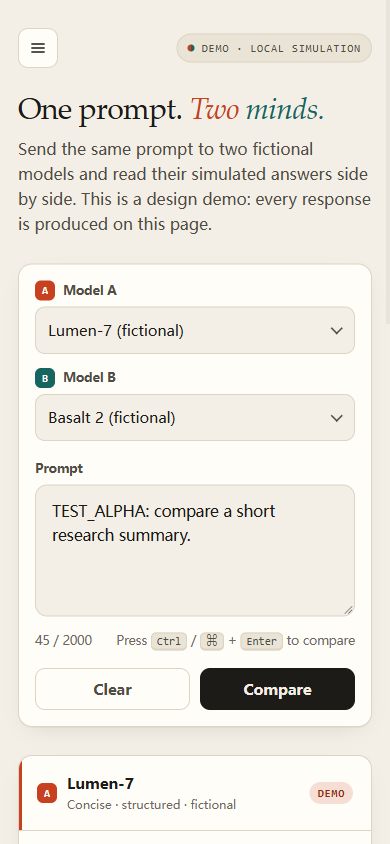
كيف بدت الصفحات المعروضة فعليًا
مثال Fable 5.2
عنوان serif أثقل، وتأكيد أحمر مائل، وشريط جانبي عالي التباين يمنح هذه الصفحة هوية تحريرية أقوى. عنصر التحكم في تبديل النموذج هو إضافة مفيدة، لكنه يشغل صفًا كاملاً على الهاتف المحمول ويدفع المطالبة والنتائج إلى الأسفل.
مثال Opus 5.5
العنوان الأخف ومنطقة اختيار النموذج الأبسط يبدوان أكثر تحفظًا. في نفس إطار العرض المحمول، ينتهي زر المقارنة عند حوالي 710 بكسل من الأعلى، مقابل 826 بكسل في عينة Fable، مما يترك مساحة لظهور بطاقة النتيجة الأولى في وقت أقرب.
اختار كلاهما درجات ورق دافئة وأشرطة جانبية داكنة وعناوين serif. الفرق هنا في التسلسل الهرمي والكثافة، وليس لغة تصميم مختلفة تمامًا.بالنسبة لمساحة العمل المحددة هذه، نفضل التخطيط المضغوط لعينة Opus.إذا كانت الأولوية لعنوان تحريري أكثر بروزًا، فإن عينة Fable تتمتع بهذا الجاذبية. هذا تفضيل شخصي بين هذه القطع الأثرية المُعادة، وليس تصنيفًا جماليًا عامًا للنماذج الأساسية.
فحوصات المتصفح: المظهر والسلوك بشكل منفصل
| تحقق | عينة Fable | عينة Opus |
|---|---|---|
| التحقق من الإدخال الفارغ | نجح | نجح |
| المقارنات المتكررة تحافظ على المطالبة المقدمة | نجح | نجح |
| ملاحظات تحميل مرئية | نجح | نجح |
| مسح الإدخال | نجح | نجح |
| تجاوز الصفحة عند عرض 390 بكسل | لم يتم قياس أي شيء | لم يتم قياس أي شيء |
| فشل النسخ يبلغ عن خطأ بصدق | نجح | نجح |
| نسخ ناجح إلى الحافظة | لم يتم التحقق | لم يتم التحقق |
فتحنا المخرجات غير المحررة في Chrome واستخدمنا عناصر تحكم DOM لتشغيل الفحوصات. تستخدم لقطات شاشة سطح المكتب 1440 × 1000؛ وتستخدم لقطات شاشة الجوال 390 × 844. تعرض الأربعة جميعها نفس الموجه المقدم بعد المقارنة وقبل فحص النسخ. لم يتم التقاط أي استثناءات وقت التشغيل خلال هذه الخطوات. لم تنجح عمليات الكتابة إلى الحافظة في الجلسة الآلية، ولم يتم اختبار التنقل الكامل باستخدام لوحة المفاتيح فقط.
يعطي استخدام زوج التصميم النهائي وكيلاً بمعدل قياسي قدره $0.8826 لـ Fable و $0.2918 لـ Opus. يستخدم هذا أسعار المزودين والرموز المبلغ عنها من البوابة، ويستبعد المحاولات السابقة، وليس الفاتورة الفعلية للبوابة.
المحاولات السابقة وحدود الأدلة
منشئ المحتوى: نسخة دقيقة بتنسيقين
نفس الموجه · اختبار منشئ المحتوى
You are a content creator. Based ONLY on these FICTIONAL product facts, write a180-word plain-English explainer and a45-second video script with timestamps, then a five-item fact-check checklist. Facts: Lumen is a fictional AI workspace; it lets users compare two AI text drafts side by side, save prompts locally in their browser, and manually copy a chosen result. It does not publish content automatically, browse the web, or verify facts. No prices, launch dates, speed metrics, supported model names, or privacy guarantees are provided. Audience: freelancers who struggle to choose a usable first draft. Explain a practical example, avoid hype and invented claims, and distinguish local prompt saving from an unproven no-training guarantee.
قدم موجز المبدع مساحة عمل خيالية بثلاث ميزات فقط: مقارنة المسودات جنبًا إلى جنب، وحفظ المطالبات محليًا، والنسخ اليدوي. وطلب نصًا توضيحيًا من 180 كلمة، وسيناريو مدته 45 ثانية، وقائمة تحقق من الحقائق من خمسة عناصر.
استوفى كلا النصين التوضيحيين متطلب 180 كلمةوفقًا لقاعدة عد الكلمات لدينا، التي تُبقي الفواصل العلوية والواصلات الداخلية داخل الكلمة. حافظ كلاهما على حدود الميزات وتجنبا بشكل صحيح معاملة التخزين المحلي كضمان لعدم التدريب.
Fable 5.2
بدأ بصعوبة المستقل في اختيار مسودة، ثم شرح الميزات الثلاث في جمل قصيرة. احتوى التعليق الصوتي للفيديو على 101 كلمة: حوالي 135 كلمة في الدقيقة إذا تم إلقاؤها في 45 ثانية.
Opus 5.5
استخدم مثالاً أكثر تفصيلاً لكاتب الإعلانات، يقارن بين افتتاحية أقوى وشروحات أوضح للميزات. احتوى التعليق الصوتي على 109 كلمات: حوالي 145 كلمة في الدقيقة خلال الفترة الزمنية نفسها.
تأتي تقديرات السرعة هذه من التعليق الصوتي المكتوب، وليس من تسجيل موقوت. يترك Fable مساحة أكبر للتوقفات؛ بينما يستخدم Opus وقتًا أطول من الفترة لشرح المثال.
بالنسبة للمقالات الأطول، دليلنا استخدام Claude للكتابة الطويلة يشرح كيفية فصل الصياغة عن التحقق والتحرير.
محلل بيانات: المبالغ المستردة، الإسناد المفقود، وعائد الإنفاق الإعلاني
نفس الموجه · اختبار محلل البيانات
You are a data analyst. Use only this synthetic data. Orders CSV(order_id,updated,status,channel,amount): o1,1,paid,Search,100; o2,1,paid,Social,80; o2,2,refunded,Social,80; o3,1,paid,Search,120; o4,1,pending,Email,60; o5,1,paid,,50; o6,1,paid,Partner,90; o7,1,paid,Email,70; o8,1,paid,Social,60; o9,1,paid,Partner,110. Channel spend/clicks: Search200/100; Social100/80; Email50/40; Partner0/20. Deduplicate by order_id keeping greatest updated. Paid orders count and revenue use latest paid only; refunded/pending contribute zero. Blank channel must remain Unknown and cannot inherit spend/clicks. Calculate overall paid count, revenue, each channel paid count/revenue/conversion rate per click/ROAS, and measurable ROAS ranking; zero or missing denominator is N/A. Show arithmetic and propose a cautious next-budget decision without inferring causality. Return table and explanation under600 words.
تم تصميم مهمة المحلل لاكتشاف الأخطاء التي قد يخفيها جدول أنيق: معرفات طلبات مكررة، واسترداد لاحق، وطلب معلق، وقناة غير معروفة، وقناة شريك بدون إنفاق.
تطابق كلا النموذجين مع مفتاح الإجابة المُعد: 7 طلبات مدفوعة و600 إيرادات بعد الاحتفاظ بأحدث حالة للطلب. استبعدوا السجلات المستردة والمعلقة، وأبقوا الإسناد المفقود تحت غير معروف، ووضعوا علامة على النسب غير المحددة كـ N/A.
| القناة | الطلبات المدفوعة | الإيرادات | التحويل / النقر | ROAS |
|---|---|---|---|---|
| بحث | 2 | 220 | 2.00% | 1.10 |
| اجتماعي | 1 | 60 | 1.25% | 0.60 |
| البريد الإلكتروني | 1 | 70 | 2.50% | 1.40 |
| شريك | 2 | 200 | 10.00% | N/A: إنفاق صفري |
| غير معروف | 1 | 50 | N/A | N/A |
عرض Fable الحسابات الحسابية للإيرادات في جدول القنوات واقترح التحقق من المبالغ المستردة والطلبات المعلقة والعلامات المفقودة وتكاليف الشركاء غير المسجلة قبل إجراء تغييرات كبيرة. أضاف Opus جدول إزالة التكرار سجلًا بسجل وحسب أن الإيرادات غير المنسوبة بلغت 8.3% من الإجمالي.
أوصى كلاهما بإجراء اختبار بميزانية محددة بدلاً من التعامل مع عائد الإنفاق الإعلاني المرصود كدليل سببي. ملاحظة Opus الجانبية بأن عملية بيع اجتماعية إضافية واحدة ستضاعف عائد الإنفاق الإعلاني تقريبًا تفترض مبلغ طلب مماثل؛ ولم تكن حقيقة جديدة في المدخلات.
مدير المنتج: الضرر قبل التصويت على الميزات
نفس الموجه · اختبار مدير المنتج
You are a product manager for a FICTIONAL AI subscription workspace. Feedback: 2 users report duplicate charges after retrying checkout; billing logs confirm one duplicate captured charge. 30 users request dark mode. 8 report one model unavailable and no warning before using a prompt; outage reproduced. 1 requests account/data deletion; request pending for20 days, governing deadline unknown. 12 request reusable saved prompts. 4 want team seats; no revenue commitment. Two engineers available for one week; effort estimates unknown. Produce a one-week priority plan with rationale, explicit unknowns, scope boundaries, owner roles, acceptance criteria, instrumentation and rollback/containment steps. Do not fabricate legal deadlines, revenue, effort or certainty. Distinguish immediate containment from permanent fixes; do not rank purely by vote count. Under700 words.
جمع موجز المنتج بين رسوم مكررة مؤكدة وطلب حذف متأخر للمستخدم وانقطاع نموذج مُعاد إنتاجه والمزيد من طلبات الميزات الشائعة. كان الفخ هو إعطاء الأولوية لـ 30 صوتًا للوضع الداكن على الضرر المُثبت.
وضع كلا النموذجين الفوترة ومتابعة الحذف واحتواء الانقطاع قبل بناء الميزات. لم يخترع أي منهما موعدًا قانونيًا للحذف. كلاهما عيّن أدوار المالك، وفصل الاحتواء الفوري عن الإصلاحات الدائمة، واقترح فحوصات القبول والمراقبة.
Fable 5.2
حدد تسوية المبالغ المستردة وإصلاحًا لمنع الرسوم المتكررة واحتواء الانقطاع يدويًا. لقد تعامل صراحةً مع فقدان الحصة المحتمل كشيء يجب تأكيده ووضع علامة على الحذف بأنه لا رجعة فيه.
Opus 5.5
تمت إضافة تحذير قبل الإرسال، والحفاظ على المطالبات، وقاعدة صريحة ضد تبديل النماذج بصمت. كان جدول الأولويات سريع المسح.
ومع ذلك، فقد ذكر أن المستخدمين "يفقدون العمل والمطالبات بصمت". أثبتت الملاحظات المقدمة حدوث انقطاع وتحذير مفقود، وليس فقدانًا مثبتًا للمطالبات.
أسعار Fable 5.2 مقابل Opus 5.5
بالنسبة لطلبات واجهة برمجة التطبيقات القياسية، تبلغ تكلفة Fable 5.2 ضعف تكلفة Opus 5.5 لكل رمز. وهذا يجعل Opus نقطة البداية الأرخص عندما يقدم كلا النموذجين نتيجة مقبولة مع استخدام مماثل للرموز.
الإدخال / الإخراج
الإدخال / الإخراج
هذه هي معدلات الإدخال/الإخراج القياسية لشركة Anthropic، تم التحقق منها في 11 نوفمبر 2026، منمواصفات Fable.
المواصفات Opus يسرد المعدل القياسي المقابل. الوضع السريع والتخزين المؤقت وخصومات الدُفعات واشتراكات المستهلكين وفوترة الطرف الثالث لها شروط مختلفة.
بالنسبة لطلب توضيحي يحتوي على 10,000 رمز إدخال و5,000 رمز إخراج، فإن الحساب بالمعدل القياسي هو 0.28 دولار لـ Fable و0.14 دولار لـ Opus. هذا مثال توضيحي، وليس فاتورة من اختباراتنا.
لا يعني معدل الرمز الأعلى تكلفة أعلى لكل مهمة ناجحة. يمكن أن تؤدي الإجابة الأقصر أو جولات المراجعة الأقل أو التفكير الأقل إلى تغيير الإجمالي. لا يمكن لاختباراتنا ذات الجولة الواحدة إثبات وفورات طويلة الأجل.
إذا كنت تدمج أيًا من النموذجين في تطبيق، دليل إعداد Claude API يغطي أسئلة الإعداد بشكل منفصل عن مقارنة معدلات الرمز هنا.
بضرب الاستخدام المُبلغ عنه من البوابة في المعدلات القياسية لشركة Anthropic، نحصل على وكيل قائم على المعدل قدره 0.4291 دولار لـ Fable مقابل 0.1799 دولار لـ Opus عبر تلك المهام الأربع. الصيغة هي رموز الإدخال × معدل الإدخال + رموز الإخراج × معدل الإخراج، مقسومًا على مليون. هذا يستبعد جميع طلبات التصميم والمكالمات الفاشلة.وكيل قائم على المعدل بقيمة 0.4291 دولار لـ Fable مقابل 0.1799 دولار لـ Opus عبر هذه المهام الأربع. الصيغة هي رموز الإدخال × معدل الإدخال + رموز الإخراج × معدل الإخراج، مقسومة على مليون. هذا يستبعد جميع طلبات التصميم والمكالمات الفاشلة.
هذا الوكيل هو ليس الرسوم الفعلية للبوابة. لم نتحقق من فاتورته أو تكافؤ محاسبة الرموز أو هامش الربح. كما أنه لا يقيس تكلفة التحرير البشري اللاحق أو المحاولات الإضافية.
ما تثبته المعايير الرسمية
يمنح تقييم الإطلاق من Anthropic لـ Fable ميزة في عدة مهام صعبة. يعيد الجدول أدناه إنتاج ثلاث درجات مُبلغ عنها؛ هذه تقييمات من المزود، منفصلة عن اختباراتنا القائمة على الأدوار.
| التقييم | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0 | 49.1% | 45.5% |
| FrontierSWE v2 | 69.9% | 62.3% |
| Terminal-Bench-Science 0.1 | 74.6% | 58.7% |
تقرير الإطلاق يستخدم أعلى جهد متاح لكل نموذج ما لم يُذكر خلاف ذلك. تدعم هذه الدرجات تجربة Fable في الأعمال التقنية الصعبة؛ لكنها لا تثبت ميزة عالمية في الكتابة أو الحكم على المنتج أو الذوق البصري.
يذكر كلا النموذجين نافذة سياق تبلغ مليون رمز وحد إخراج يبلغ 128,000 رمز. لم يتم اختبار هذه الحدود تحت الضغط هنا.
الأسئلة الشائعة
هل Fable 5.2 أفضل من Opus 5.5 في البرمجة؟
تفيد Anthropic بأن Fable يحقق درجات أعلى في عدة تقييمات برمجة صعبة. تمرين البرمجة لدينا هو مساحة عمل ذكاء اصطناعي بملف واحد، وليس معيارًا لمستودع، لذا لا يمكنه تحديد فائز عام في البرمجة.
هل تكلفة Fable 5.2 أعلى؟
معدلات الإدخال والإخراج القياسية لواجهة برمجة التطبيقات الخاصة به هي ضعف معدلات Opus 5.5: 8 دولارات/40 دولارًا مقابل 4 دولارات/20 دولارًا لكل مليون رمز. تعتمد تكلفة المهمة الفعلية أيضًا على الاستخدام والاستدلال وإعادة المحاولة والتخزين المؤقت والخدمة التي تحاسبك.
هل أُجريت هذه الاختبارات داخل GlobalGPT؟
لا. لقد استخدموا النماذج المسماة عبر بوابة API تابعة لجهة خارجية. إنهم لا يثبتون توفر النموذج أو الفوترة أو الميزات الأصلية داخل GlobalGPT أو تطبيقات Claude الخاصة.
هل يمكن الوثوق بأي من النموذجين لتلخيص البحث دون التحقق؟
حسبت إجابتا البحث النتيجة الرئيسية بشكل صحيح، لكن كل منهما قدم استنتاجًا واحدًا على الأقل يحتاج إلى تحرير. تحقق من كل تفاصيل تصميم الدراسة وافصل التقديرات عن ادعاءات الأهمية.
هل تثبت الصفحة المولدة ذات المظهر الأفضل قدرة ترميز أفضل؟
لا. التصميم المرئي والتفاعلات العاملة وإمكانية الوصول وقابلية الصيانة هي أبعاد منفصلة. لا يمكن لصفحة جذابة واحدة أن تثبت موثوقية الترميز على مستوى المستودع.
هل أُعطيت النماذج جهدًا استدلاليًا متساويًا؟
استخدمنا مدخلات وحدود إخراج متطابقة، مع ترك إعدادات الاستدلال على الوضع الافتراضي للمنصة. لم يتم التحقق من تعيين البوابة بشكل مستقل، لذا فإن هذا ليس معيارًا متساوي الجهد.
هل يجب أن أنقل كل أعمالي إلى Fable 5.2؟
استخدم أولاً اختبار قبول خاص بالمهمة. ابدأ بالنموذج الأقل تكلفة الذي يلبي ذلك، ثم انقل المهمة الصعبة إلى Fable عندما تتمكن من تحديد تحسين جدير بالاهتمام.
الحكم النهائي: أي نموذج يجب أن تستخدم؟
ابدأ بـ Opus 5.5 عندما يكون الهدف هو مسودة أولى مقبولة. معدل الرمز القياسي المنخفض يجعله الأساس العملي للكتابة الروتينية وتنظيف البيانات والتخطيط. لمزيد من السياق، راجع مراجعتنا لـ Claude Opus 5.5.
جرّب Fable 5.2 عندما لا تزال مهمة صعبة محددة تفشل في تلبية معايير القبول الخاصة بك. حافظ على نفس المدخلات وتحقق مما إذا كان يعالج الفشل الفعلي. إرشادات اختيار النموذج يوصي كذلك بالبدء بأحدث Opus والتصعيد عندما يكون Opus ذو الجهد الأعلى غير كافٍ.
إذا لم يكن أي من النموذجين المتميزين ضروريًا، Sonnet 5.5 vs Opus 5.5 هو مقارنة التكلفة الأكثر صلة.
للحصول على مجموعة أوسع من المزودين، راجع اختبارات مولد النصوص بالذكاء الاصطناعي لدينا.
بالنسبة للعمل على المستودعات، فإن العرض التوضيحي بملف واحد في هذه المراجعة ليس سوى نقطة بداية. فهو لا يختبر الوصول إلى الصدفة أو التعديلات متعددة الملفات أو استخدام الأدوات لفترات طويلة أو سلوك الاسترداد لوكيل الترميز. للحصول على تفاصيل التكوين، راجع دليلنا اختيار نموذج في Claude Code قبل التعامل مع إكمال الدردشة كبديل لبيئة تطوير كاملة.



