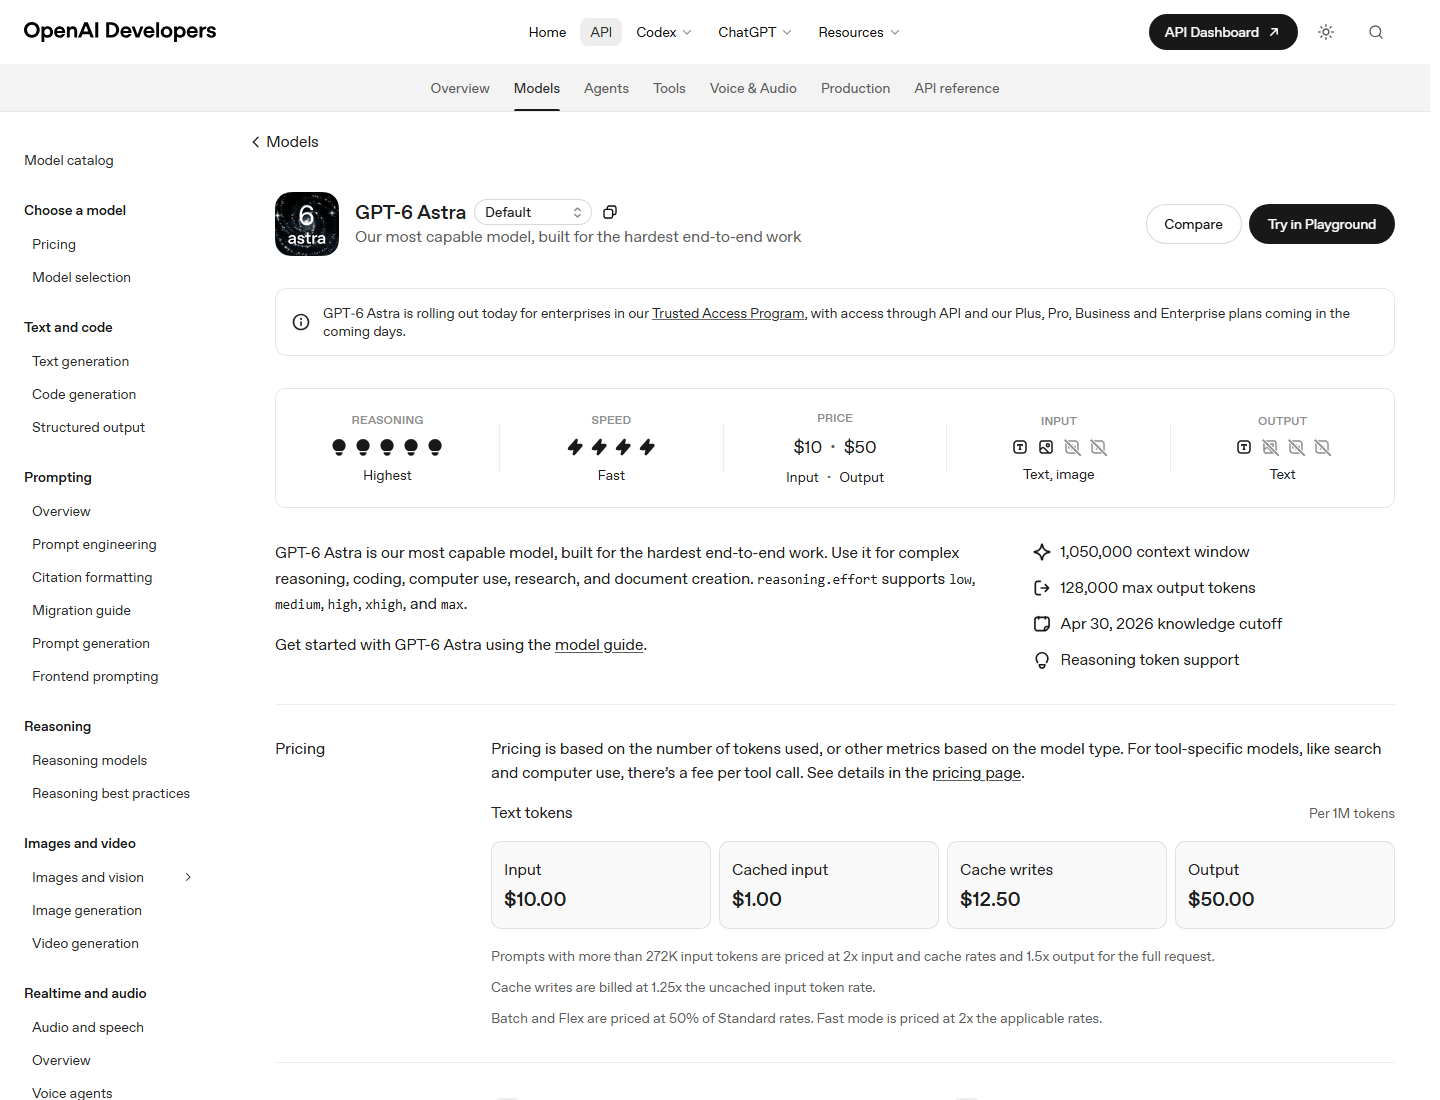
GPT-6.1 Sol es el valor por defecto; GPT-6 Astra es el nivel máximo de calidad. Ambos ofrecen la misma ventana de contexto de 1 050 000 tokens, un límite de salida de 128 000 tokens, entrada multimodal y un amplio conjunto de herramientas. La diferencia decisiva radica en el posicionamiento y el precio: Sol cuesta $2 por cada millón de tokens de entrada y $10 por cada millón de tokens de salida, mientras que Astra cuesta $10 y $50. En otras palabras, Astra debe generar suficiente valor añadido para justificar un coste en tokens Standard cinco veces superior.
Eso no convierte al Sol en “el mismo modelo por menos dinero”. OpenAI califica al Astra como su modelo más capaz para los trabajos más exigentes de principio a fin y describe al Sol como un modelo con un rendimiento casi igual al del Astra para trabajos complejos, pero a un coste menor. Por lo tanto, tomar la decisión correcta es una cuestión de evaluación, no un ejercicio de clasificación de marcas. Esta comparación utiliza los datos actuales Documentación de GPT-6.1 Sol, El Página del modelo GPT-6 Astra, y escenarios de costes idénticos consultados el 9 de octubre de 2026.
GPT-6.1 Sol frente a GPT-6 Astra: comparación rápida
La tabla facilita la primera decisión: si aún no se dispone de datos específicos sobre la tarea, Sol es la mejor opción para la primera prueba, ya que conserva las principales características de interfaz y capacidad, al tiempo que reduce drásticamente el coste de los tokens. Astra se convierte en la opción racional cuando el trabajo es inusualmente difícil, las consecuencias de una respuesta errónea son graves o su resultado más sólido evita varias rondas de revisión por parte de personas o modelos.
Esto no es lo mismo que comparar el Sol con un modelo pequeño y rápido. Según las previsiones actuales de la marca para la gama OpenAI, el Sol se sitúa cerca de la parte alta de la gama, no en el nivel más bajo. Los lectores que estén valorando toda la gama también pueden utilizar nuestro Guía de los mejores modelos de IA y el Reseña del GPT-6 Luna para saber cuándo basta con un modelo más ligero.
Lo que tienen en común GPT-6.1 Sol y GPT-6 Astra
Las dos páginas oficiales de los modelos muestran la misma ventana de contexto, la entrada máxima, la salida máxima y el límite de conocimiento. Ambos aceptan texto e imágenes y generan texto. Ninguna de ellas incluye el audio ni el vídeo como entrada o salida nativa del modelo. También comparten los niveles de esfuerzo de razonamiento «bajo», «medio», «alto», «xalto» y «máximo», siendo «medio» el valor por defecto. Esa simetría simplifica las pruebas A/B, ya que una aplicación puede mantener constantes la mayoría de los parámetros de la solicitud y cambiar únicamente el ID del modelo.
Ambos modelos admiten resultados estructurados, llamadas a funciones, búsqueda en la web, búsqueda de archivos, generación de imágenes, intérprete de código, shell alojado, aplicación de parches, uso del ordenador, MCP, habilidades y búsqueda de herramientas. OpenAI incluye la llamada a herramientas a través de la API de respuestas; la función «Chat Completions» está disponible cuando no intervienen herramientas. El ajuste fino no está disponible en ninguna de las páginas de los modelos. Se trata de declaraciones de capacidades, no de promesas de que los dos modelos elegirán herramientas con la misma precisión.
Una ventana de contexto de un millón de tokens es una cuestión de capacidad, no un permiso para ignorar el diseño de la recuperación. Las solicitudes muy largas son más costosas, más difíciles de depurar y están sujetas al escalón de precios por encima de los 272 000 tokens de entrada. La segmentación, la recuperación, los resúmenes y el almacenamiento en caché de las indicaciones siguen siendo importantes. La misma advertencia se aplica al límite máximo de 128 000 en la salida: los artefactos verificables más pequeños suelen ser más seguros que una única respuesta masiva.
Precios: la diferencia de cinco veces
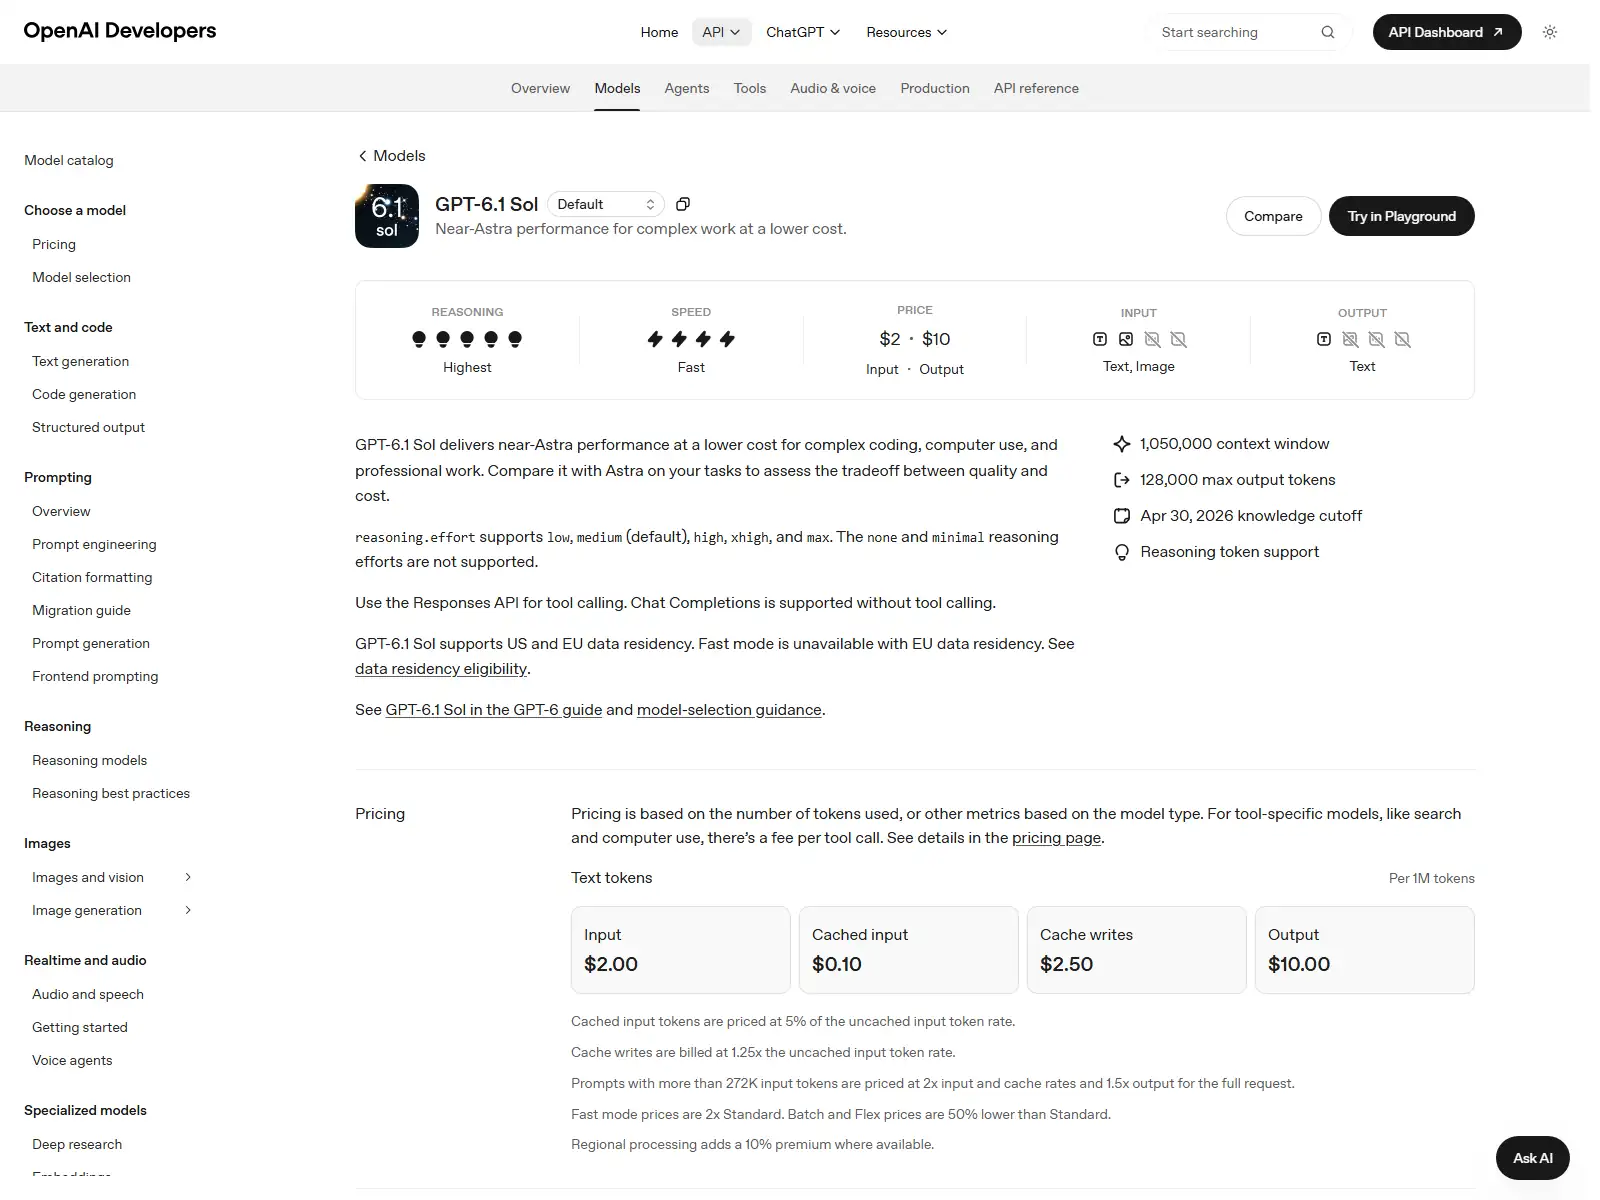
Según las tarifas estándar, GPT-6.1 Sol cuesta $2 por cada millón de tokens de entrada sin almacenar en caché, $0,10 por los de entrada almacenados en caché, $2,50 por las escrituras en caché y $10 por la salida. GPT-6 Astra cuesta $10, $1, $12,50 y $50, respectivamente. Sol es cinco veces más barato para la entrada sin almacenar en caché, las escrituras en caché y la salida; la entrada almacenada en caché es diez veces más barata. Las cifras actuales proceden directamente de las páginas del modelo de OpenAI y Documentación sobre los precios de la API.
La tarifa indicada en el titular no es la única que se aplica. Cuando una solicitud supera los 272 000 tokens de entrada, OpenAI aplica el doble de las tarifas normales de entrada y caché, y 1,5 veces la tarifa normal de salida, a la solicitud completa. Los planes Batch y Flex tienen un precio de 50% del plan Standard, mientras que el plan Fast duplica la tarifa aplicable. Astra también ofrece un nivel Ultrafast. Compara lo comparable: una solicitud Sol Batch y una solicitud Astra Fast no revelan la relación modelo-precio subyacente.
Para obtener un desglose más detallado del nivel «flagship», consulta nuestro Guía de precios del GPT-6 Astra. El anterior Análisis de precios de Sol con GPT-6 Resulta útil a la hora de planificar una migración desde la generación anterior de Sol, pero las estimaciones de producción deben basarse en el ID exacto del modelo actual y en las tarifas vigentes.
Diseño a largo plazo: misma capacidad, dinámica económica diferente
La ventana de contexto idéntica de 1.050.000 tokens puede hacer que Sol y Astra parezcan intercambiables para trabajos con gran volumen de documentos, pero la capacidad es solo la primera limitación. Una consulta que se acerque al límite debe seguir localizando la evidencia adecuada, distinguiendo las instrucciones del material citado, conservando las relaciones entre numerosos archivos y devolviendo un resultado que una persona o un programa puedan verificar. El modelo con el nombre más sonoro no elimina la necesidad de una arquitectura de la información. Hay que organizar las fuentes, etiquetar los límites y solicitar citas que remitan a identificadores de documentos estables.
La tarifa reducida de Sol hace que los experimentos de contexto extenso resulten económicamente viables. Un equipo puede probar varias estrategias de agrupación, umbrales de recuperación y formatos de resumen por el coste de una sola ejecución de Astra. Esa búsqueda más amplia puede mejorar el sistema incluso si Astra obtiene mejores resultados en una sola consulta. Astra resulta más atractiva una vez que el flujo de trabajo se ha estabilizado y los errores sin resolver se deben realmente a limitaciones del modelo. En las primeras fases de desarrollo, destinar todo el presupuesto a unas pocas llamadas emblemáticas puede generar menos aprendizaje que llevar a cabo una evaluación disciplinada con Sol en numerosos casos representativos.
El umbral de 272K merece una supervisión específica. Una solicitud con 271K tokens de entrada y otra con 273K tienen un tamaño muy similar, pero la segunda hace que toda la solicitud pase a la banda superior. Realiza una estimación previa del número de tokens y registra en qué banda se ha situado cada trabajo. Si una entrada supera ligeramente el límite, eliminar el código repetitivo, el historial de conversaciones obsoleto o los fragmentos recuperados de escaso valor puede reducir considerablemente el coste sin perjudicar la calidad. Esta optimización se aplica a ambos modelos, aunque las tarifas base más elevadas de Astra hacen que los errores resulten más costosos.
El almacenamiento en caché de comandos resulta más útil cuando un prefijo extenso se mantiene estable entre llamadas. Algunos ejemplos son los manuales de políticas, las normas de codificación, un catálogo de productos o un esquema de herramientas compartido por muchas tareas. Coloca primero el contenido estable y las instrucciones variables después, siempre que el comportamiento de almacenamiento en caché de la API admita esa disposición. A continuación, mide los aciertos en la caché en lugar de darles por sentados. La ventaja de la entrada almacenada en caché de Sol es especialmente notable, pero un prefijo en constante cambio puede anularla. El diseño de la caché debe figurar en el informe de pruebas de rendimiento junto con la precisión y la latencia.
Para la investigación y el análisis de documentos, utiliza un flujo de trabajo por etapas: recopila las pruebas probables, solicita al modelo un mapa estructurado de las pruebas, valida las citas y, solo entonces, solicita la síntesis. Utiliza Astra cuando la síntesis siga siendo deficiente a pesar de que el proceso de obtención de pruebas sea sólido, o cuando el conjunto de fuentes contenga contradicciones inusualmente sutiles. Esto permite diferenciar los fallos de recuperación de los fallos de razonamiento. Sin esa distinción, los equipos suelen acabar invirtiendo en un modelo más potente para compensar un problema evitable de construcción del contexto.
Codificación y uso de herramientas
En lo que respecta a la programación, la pregunta relevante no es “¿qué modelo es capaz de escribir código?”. Ambos pueden hacerlo. La pregunta es en qué aspectos la capacidad adicional de Astra cambia el resultado. Sol resulta atractivo para el trabajo habitual con repositorios: implementar funcionalidades con alcance limitado, diagnosticar errores reproducibles, revisar solicitudes de incorporación de cambios, escribir pruebas, transformar datos y ejecutar bucles iterativos de herramientas. Su tarifa más baja permite realizar más intentos, más verificaciones y conjuntos de evaluación más amplios con el mismo presupuesto.
Es mejor reservar Astra para tareas en las que predominan la ambigüedad y la coordinación: una migración a un monorepo con el que no se está familiarizado, una revisión de una arquitectura sensible en materia de seguridad, el uso de ordenadores a largo plazo, una adaptación entre lenguajes complicada o un incidente en producción con pruebas incompletas. El modelo más potente puede merecer la pena su coste adicional cuando un plan correcto evita horas de trabajo adicional. Nuestro El mejor modelo de IA para comparar códigos explica por qué las pruebas del repositorio son más importantes que las impresiones generales sobre la programación.
- Funcionalidades definidas con pruebas de aceptación claras
- Depuración rutinaria y revisión del código
- Bucles de agentes de gran volumen
- Borradores de migraciones y refactorizaciones
- Generación de pruebas y documentación
- Fallos graves tras un intento de Sol
- Cambios en la seguridad o en los datos que entrañan un alto riesgo
- Arquitectura ambigua entre sistemas
- Tareas prolongadas que requieren el uso autónomo del ordenador
- Revisión final cuando los errores salen caros
No evalúes ninguno de los dos modelos basándote únicamente en un código que parezca plausible. Proporciona a ambos la misma instantánea del repositorio, las mismas instrucciones, herramientas, tiempo disponible y pruebas. Registra la tasa de éxito, las correcciones humanas, los fallos en las llamadas a las herramientas, los tokens, la latencia y el coste. Un modelo que cueste cinco veces más pero que reduzca a la mitad el número de intentos fallidos puede estar justificado; un modelo que mejore el estilo sin mejorar la aceptación, no lo está.
Datos sobre el rendimiento: lo que podemos y lo que no podemos concluir
El posicionamiento de OpenAI ofrece el resumen más sólido y defendible: Astra es el modelo más capaz para las tareas de extremo a extremo más exigentes, mientras que GPT-6.1 Sol aspira a alcanzar un rendimiento similar al de Astra en tareas complejas a un coste menor. Estas afirmaciones respaldan una hipótesis de selección, no una diferencia porcentual universal. Ninguna prueba de rendimiento pública por sí sola puede predecir el rendimiento con tus documentos, herramientas, políticas o código fuente propios.
Los vídeos de presentación son muy útiles para comprender cómo presenta una empresa un producto, pero no constituyen evaluaciones independientes. Del mismo modo, las reseñas de los creadores muestran interfaces reales y ejemplos útiles, aunque cada reseña refleja un conjunto concreto de instrucciones, una configuración específica de la herramienta y un plazo de publicación determinado. Considera una miniatura atractiva o una primera impresión positiva como una pista para tu propio plan de pruebas, no como una prueba de que Astra o Sol ganen en todas las categorías.
El vídeo oficial de OpenAI que se muestra arriba recoge las imágenes del lanzamiento de Astra. La página independiente de Matt Wolfe que aparece a continuación muestra que la atención del público se centró rápidamente en la magnitud del lanzamiento. Ninguna de las dos capturas de pantalla se utiliza aquí como referencia numérica. El artículo evita deliberadamente convertir el entusiasmo, las visualizaciones o el título de un creador en una puntuación de rendimiento sin fundamento.
Una comparación válida utiliza un conjunto de evaluación privado que se asemeje al entorno de producción. Incluye tareas sencillas, tareas típicas y casos de fallo costosos. Oculta los resultados cuando la preferencia humana sea relevante. En el caso de los agentes, evalúa la finalización y la recuperación, más que la primera respuesta. OpenAI’s orientación sobre la selección de modelos Asimismo, recomienda comparar modelos en tareas idénticas y quedarse con el modelo más ligero y el esfuerzo de razonamiento que supere el umbral de calidad.
Cómo realizar una evaluación imparcial entre Sol y Astra
Empieza por definir la decisión que tomará la evaluación. “¿Qué modelo es más inteligente?” es demasiado vago. Una pregunta útil es “¿Qué modelo debería encargarse de las revisiones de pull requests para este repositorio con un nivel de razonamiento medio?” o “¿Debería la síntesis final del contrato pasar de Sol a Astra?”. Establece la familia de tareas, el nivel de servicio, el esfuerzo de razonamiento, las herramientas, el plazo y los criterios de aceptación antes de generar resultados. De lo contrario, un resultado favorable podría atribuirse a la configuración en lugar de al modelo.
Crea un conjunto lo suficientemente amplio como para incluir casos habituales y casos extremos significativos. Veinte ejemplos cuidadosamente seleccionados pueden revelar fallos evidentes, pero una política de enrutamiento en producción suele necesitar más. Toma una muestra de trabajos reales recientes tras eliminar los datos confidenciales y, a continuación, clasifica cada caso según su dificultad y riesgo. Mantén un conjunto de validación bloqueado para que el ajuste rápido del sistema no provoque un sobreajuste gradual a los ejemplos que todo el mundo ya ha visto. Gestiona las versiones del conjunto de datos y del evaluador del mismo modo que gestionas las versiones del código de la aplicación.
Da prioridad a las comprobaciones determinísticas siempre que la tarea lo permita. Compila el código, ejecuta pruebas, valida el JSON con un esquema, compara los campos extraídos con las etiquetas y verifica los pasajes citados. Los evaluadores humanos deben centrarse en cualidades que la automatización no puede captar bien, como la claridad, el criterio y si una recomendación respeta el contexto empresarial. Oculta la identidad del modelo y aleatoriza el orden de los resultados. Si los evaluadores saben qué respuesta procede de Astra, el precio y la reputación pueden influir en la puntuación sin que nadie pretenda sesgarla.
Haz un seguimiento de la gravedad, no solo de los promedios. Diez ventajas menores de estilo no deberían pesar más que una recomendación crítica relacionada con la pérdida de datos. Define los vetos absolutos, como las citas inventadas, los comandos inseguros, la falta de campos obligatorios o el incumplimiento de una restricción legal. Presenta la distribución por categoría de dificultad y riesgo. Es posible que Sol empate con Astra en el trabajo habitual y solo se quede atrás en el cinco por ciento más difícil; ese resultado respalda firmemente el uso de un enrutador en lugar de una migración «todo o nada».
Por último, calcula la incertidumbre y vuelve a ejecutar los casos inestables. Los resultados del modelo pueden variar, por lo que una comparación única exagera el factor suerte. Repite un subconjunto, investiga las discrepancias entre los evaluadores y conserva los resultados sin procesar para su auditoría. La recomendación final debe indicar la fecha de la prueba, los identificadores de los modelos, los parámetros, la versión del conjunto de datos, los precios utilizados y las lagunas conocidas. Revísala tras una actualización del modelo, un cambio en las instrucciones o una variación significativa en la carga de trabajo. La elección de un modelo es una decisión de producción que requiere mantenimiento, no un trofeo permanente.
No permitas que el evaluador se convierta en el modelo de decisión oculto. Si un juez automatizado muestra una clara preferencia por un resultado concreto, selecciona esas decisiones para que las revisen expertos y compara al juez con los resultados de aceptación definitivos. Separa la calidad de la presentación de la corrección de la tarea: una explicación pulida puede ocultar un requisito no cumplido, mientras que una respuesta concisa puede superar todas las pruebas. Informa también de las abstenciones y los empates en lugar de forzar un ganador. Esos detalles hacen que el resultado sea menos llamativo, pero mucho más útil para la elaboración de presupuestos y el enrutamiento. El objetivo es una regla operativa repetible que otro miembro del equipo pueda examinar y reproducir. Registra también los resultados rechazados; los ejemplos de fallos suelen explicar los límites del enrutamiento con mayor claridad que una tabla de puntuaciones medias.
Ejemplos de costes reales
Consideremos una ejecución de un agente de codificación con 200 000 tokens de entrada no almacenados en caché y 20 000 tokens de salida. El coste total es de aproximadamente $0,60: $0,40 para la entrada y $0,20 para la salida. Astra cuesta aproximadamente $3,00: $2,00 más $1,00. En 10 000 ejecuciones, la diferencia es de aproximadamente $24 000 antes de las tarifas de las herramientas, el almacenamiento en caché, los recargos regionales o los ajustes por nivel de servicio.
Ahora consideremos una solicitud de contexto largo con 300 000 tokens de entrada y 30 000 tokens de salida. Dado que la entrada supera los 272 000, se aplican las tarifas más altas a toda la solicitud. La tarifa efectiva de entrada de Sol pasa a ser de $4 por millón y la de salida, de $15, lo que da como resultado aproximadamente $1,65. En el caso de Astra, la tasa de entrada es de $20 y la de salida de $75, lo que da como resultado aproximadamente $8,25. La relación de cinco a uno se mantiene, pero la diferencia absoluta aumenta.
El almacenamiento en caché puede inclinar aún más el cálculo hacia Sol, ya que su tasa de entradas en caché es una décima parte de la de Astra. Esto es importante para las instrucciones estables del sistema, las referencias repetidas de gran tamaño y la estructura de los agentes. Sin embargo, las escrituras en caché siguen teniendo un coste, y cambiar el prefijo puede reducir la reutilización. Realiza una estimación a partir de los registros de uso reales, en lugar de dar por sentado que cada token recibirá la tasa de caché.
Cómo comparar los modelos en la API
Utiliza la API de respuestas para las aplicaciones que utilizan herramientas y mantén la configuración de la comparación idéntica. El entorno de prueba más sencillo y útil envía la misma entrada a ambos ID de modelo, registra los metadatos de respuesta y ejecuta el mismo evaluador. No reveles las claves de la API en el código fuente; utiliza una variable de entorno y tu gestor de claves secretas habitual.
La muestra es deliberadamente pequeña. Un entorno de producción debería guardar los ID de las solicitudes, las versiones del evaluador, las confirmaciones del repositorio, los registros de las herramientas, el número de reintentos y los resultados de aceptación. También debería calcular el precio en función del nivel de servicio y la banda de contexto largo realmente utilizados. Evita que un modelo vea información de retroalimentación que el otro no haya recibido, a menos que estés probando explícitamente una secuencia de enrutamiento.
Una estrategia práctica para trazar rutas de Sol a Astra
Un enrutador de dos etapas recoge el argumento económico más sólido a favor de Sol sin pretender que todas las solicitudes sean iguales. Envía el tráfico normal a Sol con un nivel de razonamiento medio. Escala el nivel cuando fallen las pruebas determinísticas, el modelo indique un bajo nivel de confianza, la tarea se corresponda con una categoría de alto riesgo o un humano solicite explícitamente una revisión por parte del equipo principal. Mantén las reglas de escalado transparentes para que los costes no varíen de forma silenciosa.
Utiliza el mismo guion, las mismas herramientas y las mismas pruebas de aceptación.
Pruebas, fiabilidad, clase de riesgo y revisión humana.
Envía los trabajos fallidos o de alto riesgo a Astra.
Realiza un seguimiento de la aceptación, las modificaciones, la latencia y el coste total.
El enrutamiento también ofrece a los equipos una forma controlada de actualizar los valores predeterminados. Si la tasa de aceptación de Sol mejora en una familia de tareas, amplía su participación. Si Astra evita repetidamente defectos costosos, enruta esa categoría directamente. La comparación se convierte en una política operativa respaldada por datos, en lugar de un debate puntual sobre el modelo. Para consultar una referencia de una generación anterior, véase GPT-6 Astra frente a GPT-5.6 Sol.
La latencia y la fiabilidad deben formar parte de la misma política de enrutamiento. Un modelo puede ofrecer una respuesta más sólida y, aun así, ser una opción predeterminada inadecuada si su tiempo de respuesta interrumpe un flujo de trabajo interactivo o si su razonamiento más prolongado provoca que los trabajos agoten el tiempo de espera. Mide la latencia del primer token, la duración total, la recuperación tras una llamada a la herramienta y la finalización satisfactoria en condiciones de concurrencia realistas. A continuación, define un objetivo de servicio para cada clase de tarea. Sol puede encargarse del tráfico de producción urgente, mientras que Astra se ocupa de la revisión asíncrona; o bien puede justificarse lo contrario si una tarea difícil falla habitualmente antes de que se escale. La decisión del modelo es operativa, no meramente editorial.
¿Quién debería elegir Sol y quién debería elegir Astra?
Elige GPT-6.1 Sol para una producción que tenga en cuenta los costes
Sol es ideal para equipos de producto, agencias, investigadores y desarrolladores que gestionan grandes volúmenes de trabajo complejo, pero que cuentan con criterios de aceptación cuantificables. Resulta especialmente atractivo cuando la iteración forma parte del proceso: ciclos de «codificar-probar-corregir», revisión de documentos, extracción con validación, síntesis de investigaciones y agentes internos de varios pasos. Su precio más bajo permite una mayor cobertura de evaluación y un mayor margen para reintentos.
Elige GPT-6 Astra para los trabajos más exigentes en los que la calidad es fundamental
Astra es ideal para equipos cuyas tareas más complejas conllevan un alto coste por error o cuentan con controles automatizados deficientes. Una decisión arquitectónica compleja, una revisión final de seguridad, una tarea de razonamiento científico novedosa o una secuencia prolongada de uso del ordenador pueden justificar la inversión en el modelo insignia. Además, es la opción predeterminada más adecuada durante las primeras fases de descubrimiento, cuando el equipo aún no sabe qué se le escapa a un modelo más pequeño y el coste no supone una limitación inmediata.
Utilízalas ambas cuando la dificultad de la tarea varíe
La mayoría de los sistemas maduros no deberían imponer un único modelo a todas las solicitudes. Utiliza Sol para el amplio segmento intermedio y Astra como capa de escalación. Añade Luna u otro modelo más pequeño para la clasificación y la transformación predecibles. Este diseño por niveles refleja la diversidad real de las cargas de trabajo y suele resultar más económico que debatir sobre un único modelo definitivo. Nuestro metodología de pruebas de modelos ofrece un marco útil para distinguir entre los datos contrastados y las impresiones.
Cómo utilizar GPT-6.1 Sol y GPT-6 Astra en GlobalGPT
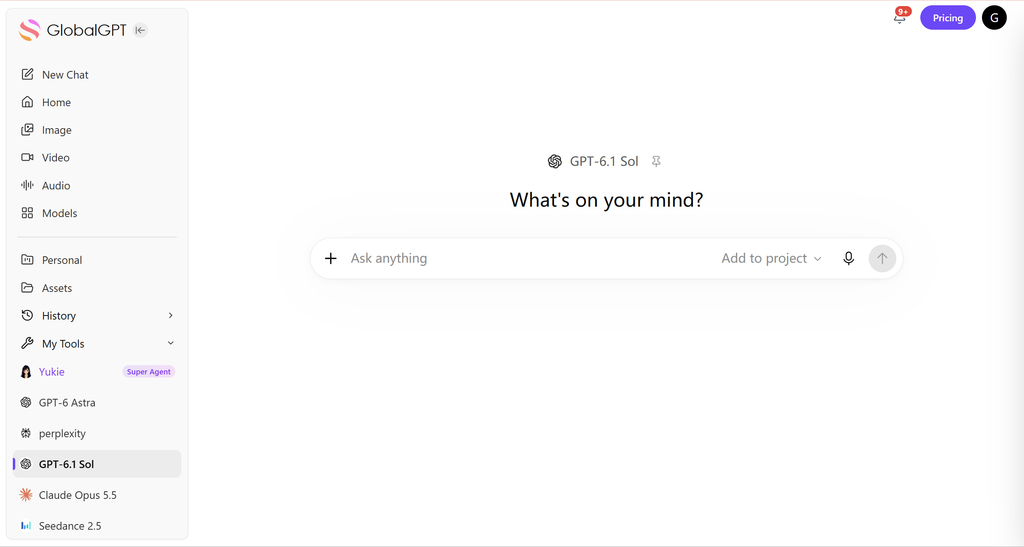
GlobalGPT ofrece rutas de producto en tiempo real para ambos modelos dentro de un único espacio de trabajo multimodelo. Abre el espacio de trabajo, inicia una nueva conversación y comprueba el selector de modelos actual para GPT-6.1 Sol o GPT-6 Astra. Mantener ambos modelos en una misma interfaz resulta útil para el trabajo exploratorio en paralelo, mientras que la evaluación mediante API sigue siendo la mejor opción para la puntuación automatizada, el registro exacto del uso y los controles de implementación.
Empieza con Sol en la primera pasada; después, vuelve a ejecutar la instrucción más difícil con Astra y compara qué ha cambiado sustancialmente.
Abierto GlobalGPTPara obtener más información específica sobre cada modelo, consulta nuestro Guía explicativa de GPT-6.1 Sol y Reseña del GPT-6 Astra. Esas páginas tratan cada modelo por separado; esta página se centra en la decisión de compra y en la elección de la ruta entre ellos.
Preguntas frecuentes
¿Es GPT-6.1 Sol mejor que GPT-6 Astra?
No en términos absolutos. OpenAI posiciona a GPT-6 Astra como su modelo más potente y a GPT-6.1 Sol como un modelo más económico con un rendimiento similar al de Astra para tareas complejas. Sol ofrece una mejor relación calidad-precio cuando cumple con tus requisitos de calidad; Astra es la opción más segura, que prioriza la calidad, para las tareas más exigentes.
¿Cuánto más barato es el GPT-6.1 Sol que el GPT-6 Astra?
Con las tarifas estándar, Sol cuesta $2 por cada millón de tokens de entrada y $10 por cada millón de tokens de salida, frente a Astra, que cuesta $10 y $50. Por lo tanto, Sol es cinco veces más barato para entradas y salidas sin caché. Su precio de $0,10 para entradas con caché es una décima parte de la tarifa de Astra, que es de $1.
¿Tienen GPT-6.1 Sol y GPT-6 Astra la misma ventana de contexto?
Sí. En OpenAI se especifica una ventana de contexto de 1 050 000 tokens, una entrada máxima de 922 000 y una salida máxima de 128 000 para ambos modelos. Las solicitudes con más de 272 000 tokens de entrada se transfieren íntegramente a tarifas de contexto largo más elevadas.
¿Qué modelo es mejor para programar?
Astra es la opción que prioriza la calidad para tareas de repositorio especialmente difíciles, ambiguas o de alto riesgo. Sol es la opción predeterminada más práctica para tareas rutinarias relacionadas con funcionalidades, depuración, revisiones y bucles de agentes, ya que su menor coste permite realizar más iteraciones. Prueba ambos con las mismas pruebas de repositorio antes de decidirte por uno.
¿Ambos modelos admiten herramientas y la introducción de imágenes?
Sí. En sus páginas oficiales de modelos se enumeran las siguientes funciones: introducción de texto e imágenes, generación de texto, salidas estructuradas, llamada a funciones, búsqueda en la web, búsqueda de archivos, intérprete de código, shell alojado, aplicación de parches, uso del ordenador, MCP, habilidades y búsqueda de herramientas. Para llamar a herramientas se debe utilizar la API de respuestas.
¿Cuándo debo pagar por GPT-6 Astra?
Utiliza Astra cuando un error resulte muy costoso, la tarea sea verdaderamente pionera o una evaluación comparativa demuestre que su calidad superior reduce el trabajo de corrección lo suficiente como para justificar un precio cinco veces superior al del token. Algunos ejemplos son las migraciones críticas, el uso complejo de sistemas informáticos autónomos y la revisión final de entregables de gran importancia.
¿Qué ejercicio de razonamiento debería elegir?
Empieza por el nivel medio, que es el valor predeterminado documentado para ambos modelos. Baja el nivel para transformaciones sencillas y súbelo solo cuando la dificultad de la tarea o el coste de los errores lo requieran. El ajuste óptimo es aquel que, con el menor esfuerzo posible, supera de forma constante tus pruebas de aceptación.
¿Puedo utilizar GPT-6.1 Sol y GPT-6 Astra en GlobalGPT?
GlobalGPT cuenta con rutas activas tanto para GPT-6.1 Sol como para GPT-6 Astra en su espacio de trabajo multimodelo. La disponibilidad puede variar según la cuenta y la interfaz, por lo que te recomendamos que abras el espacio de trabajo y compruebes el selector de modelos actual antes de iniciar un flujo de trabajo de producción.
¿Debería dirigir todas las solicitudes a un único modelo?
Normalmente no. Un router sencillo puede enviar el trabajo habitual a Sol y derivar a Astra los casos de baja confianza, aquellos en los que las pruebas han fallado o los de alto riesgo. De este modo se aprovecha la mayor parte de la ventaja en términos de costes que ofrece Sol, al tiempo que se reserva Astra para aquellas solicitudes en las que la capacidad marginal tiene un valor cuantificable.
Veredicto final
GPT-6.1 Sol debería ser el primer modelo que evalúen los equipos más preocupados por los costes; GPT-6 Astra debería seguir siendo el objetivo al que recurrir para las tareas más complejas. Su contexto común, su límite de producción, sus modalidades, sus controles de razonamiento y su catálogo de herramientas hacen que la comparación resulte excepcionalmente clara. Sol ofrece la ventaja económica. Astra cuenta con la ventaja oficial en cuanto a capacidades.
El criterio decisivo no es únicamente el precio del token ni el prestigio del modelo. Hay que medir el coste por resultado aceptado bajo restricciones operativas y presupuestos reales. Si Sol supera las pruebas a un ritmo similar, resulta difícil pasar por alto que sus tasas de entrada y salida sin caché son cinco veces menores. Si Astra evita fallos, reduce la revisión por parte de expertos o resuelve tareas que Sol no puede resolver, la prima puede estar justificada. Empieza con tareas idénticas, mantén la evaluación a ciegas siempre que sea posible y promociona únicamente el modelo y el esfuerzo de razonamiento que se gane su lugar.