Bei unseren Tests am 7. Juli 2026 erwies sich Claude Sonnet 5 als die bessere erste Wahl für Code-Reviews, Ursachenanalysen, Architekturplanung und Schlussfolgerungen im langen Kontext. GPT-5.5 war die bessere erste Wahl, wenn ein vollständiger Implementierungsentwurf, ein lauffähiges Testgerüst oder kopierfertige Beispiele benötigt wurden. Für Arbeiten auf Repository-Ebene sollten Sie Claude Code mit Codex vergleichen, anstatt eines der beiden Unternehmen allein anhand des Chat-Fensters zu beurteilen.
Die sinnvolle Einteilung lautet nicht einfach “Claude gewinnt” oder “ChatGPT gewinnt”. Stand 27. September 2026 umfasst die Produktpalette von Anthropic die Modelle Claude Fable 5.1, Opus 5.5, Sonnet 5 und Haiku 4.5; die GPT-6-Familie von OpenAI umfasst Astra, Sol und Luna. Der Produktzugang spielt eine Rolle: Sol und Luna wurden in ChatGPT Work, Codex und der API eingeführt, wobei der normale Chat in der Ankündigung ausdrücklich ausgeschlossen wurde. Die folgenden praktischen Abschnitte stellen nach wie vor einen veralteten Vergleich zwischen Claude Sonnet 5 und GPT-5.5 dar, der am 7. Juli 2026 mit denselben Eingabeaufforderungen getestet wurde. Einen aktuellen Vergleich finden Sie unter Claude Opus 5.5 vs. GPT-6 Sol.
Wenn Sie verschiedene Modelle vergleichen möchten, ohne sich mit mehreren Abonnements herumschlagen zu müssen, ist GlobalGPT ein praktischer Arbeitsbereich für mehrere Modelle mit GPT-6 Astra und Claude Opus 5,5 verfügbar in der Modellauswahl. Es eignet sich zum Vergleichen von Code-Antworten, zur Planung, zum Schreiben und zur Recherche, ersetzt jedoch weder den Claude-Code noch den Codex, offizielle APIs, eine IDE noch einen Repo-orientierten Entwicklungsworkflow.

Inhaltsverzeichnis
- Claude vs. ChatGPT beim Programmieren: kurze Antwort
- Was sich im Jahr 2026 geändert hat
- Aktuelles Angebot an Kodierungsmodellen
- Benchmark-Übersicht: SWE-Bench, Terminal-Bench und was sie bedeuten
- Wie wir Claude und ChatGPT beim Programmieren getestet haben
- Test 1: Fehlerbehebung und Ursachenanalyse
- Test 2: Refactoring und Wartbarkeit
- Test 3: Schlussfolgerungen und Planung anhand mehrerer Dateien
- Test 4: Komponententests und Verifizierung
- Test 5: Überprüfung der Sicherheit und Zuverlässigkeit
- Claude Code und Codex: Wenn Chatten nicht ausreicht
- Preise: Claude, ChatGPT, Codex und GlobalGPT
- Für welche Programmierumgebung sollten Sie sich entscheiden?
- Warum viele Entwickler immer noch beides verwenden
- FAQ
Claude vs. ChatGPT beim Programmieren: Kurze Antwort
Bei unseren Chat-Tests vom 7. Juli mit derselben Eingabe erwies sich Claude Sonnet 5 als der überzeugendere erste Durchlauf, wenn das Problem mehrdeutig war: Es priorisierte wahrscheinliche Ursachen, filterte Störfaktoren heraus und erläuterte Risiken klar und deutlich. GPT-5.5 schnitt besser ab, wenn der nächste Schritt ein umfassenderer Implementierungsentwurf mit Importen, Testgerüsten und mehr Code-Details war. Diese Beobachtungen beziehen sich auf diesen Test und nicht auf jede zukünftige Modellversion.
Für die tägliche Entwicklungsarbeit sieht der optimale Arbeitsablauf in der Regel wie folgt aus:
- Setze Claude zuerst ein für Code-Reviews, die Fehlerpriorisierung, Architekturentscheidungen und Fragen wie “Was sollte ich zuerst überprüfen?”.
- Verwenden Sie zunächst ChatGPT zum Erstellen einer ersten Implementierung, zum Schreiben von Testgerüsten, zum Erstellen von Beispielen und zum Umsetzen eines Plans in Code.
- Beides verwenden für Migrationen, sicherheitsrelevante Änderungen, Zahlungen, Authentifizierung, Datei-Uploads und alles, was zu einer Beschädigung von Produktionsdaten führen könnte.
| Bedarf an Programmierkenntnissen | Bessere erste Wahl | Warum |
|---|---|---|
| Die Fehlersuche bei einem kniffligen Fehler | Claude zuerst | In unserem Test hat Claude die wahrscheinlichste Ursache ermittelt und den Fehlerverlauf klar erläutert. |
| Erstellung eines vollständigen Implementierungsentwurfs | ChatGPT zuerst | In unserem Test lieferte GPT-5.5 umfassenderen Code und mehr gebrauchsfertige Scaffolding-Strukturen. |
| Prüfung von Sicherheits- oder Zuverlässigkeitsrisiken | Zuerst Claude, dann ChatGPT | Claude hat die Schweregrade klar eingestuft; ChatGPT hat konkrete Implementierungsmuster hinzugefügt. |
| Dateien in einem Repository ändern | Claude Code oder Codex | Der Repo-Kontext, die Befehlsausführung, Tests und Diffs sind wichtiger als eine Antwort, die sich ausschließlich auf den Chat beschränkt. |
Wenn Ihre Hauptfrage lautet, welche Modellfamilie sich insgesamt am besten zum Programmieren eignet, dann ist die allgemeinere bestes AI-Modell für die Codierung Dieser Vergleich ist eine nützliche weiterführende Lektüre. Wenn sich Ihre Entscheidung hauptsächlich auf das OpenAI-Ökosystem bezieht, finden Sie im Leitfaden „Das beste ChatGPT-Modell für die Codierung“ weitere Einzelheiten zur Auswahl von GPT-Modellen.
Was sich im Jahr 2026 geändert hat
Ein aussagekräftiger Vergleich für das Jahr 2026 muss drei Veränderungen berücksichtigen.
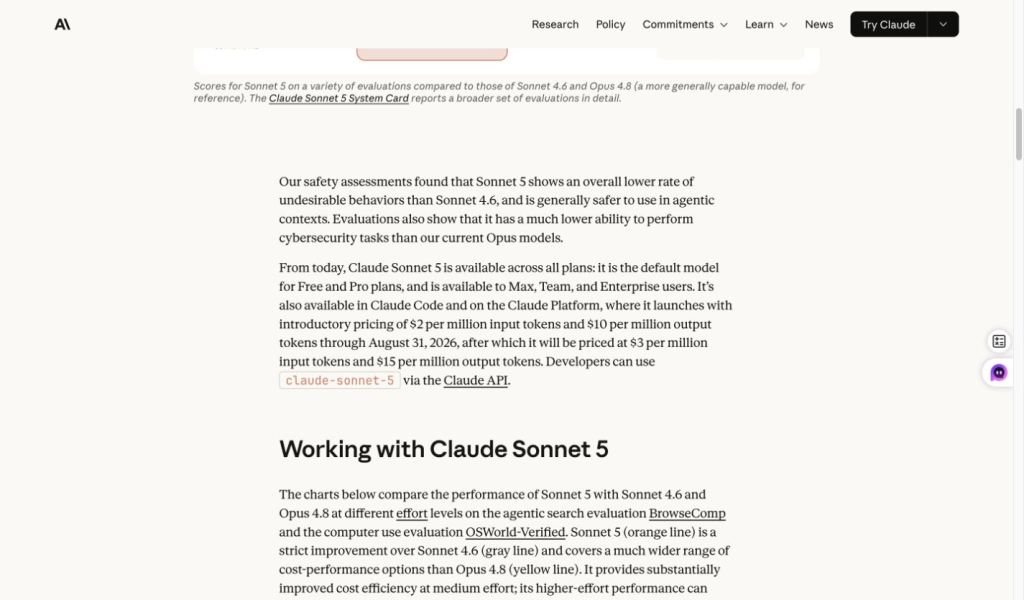
Zunächst hat „Claude Sonnet 5“ die Claude-Seite der Entscheidung verändert. Anthropic beschreibt Sonnet 5 als in allen Tarifen und im Claude-Code verfügbar, mit Zugang zur Claude-Plattform für Entwickler. Das ist von Bedeutung, da Claude nicht mehr nur ein Chat-Assistent für Erklärungen zum Programmieren ist, sondern Teil des Workflows des Programmier-Agenten von Anthropic ist.
Zweitens ist GPT-6 nun die aktuelle Modellfamilie von OpenAI für Programmierarbeiten. Astra zielt auf komplexe Softwareentwicklung ab; Sol und Luna bieten kostengünstigere Alternativen. Ankündigung der Veröffentlichung von OpenAI am 22. September Führt Sol und Luna in ChatGPT Work und Codex für die Tarife Plus, Pro, Business, Enterprise und Edu auf, wobei Luna auch für Nutzer der Tarife Free und Go in der Desktop-App verfügbar ist. Es wird ausdrücklich darauf hingewiesen, dass diese Modelle in Chat noch nicht verfügbar sind. Der API-Zugang wird separat abgerechnet.
Drittens übernehmen Chat-Assistenten und Programmieragenten verschiedene Aufgabenbereiche. Einfacher Chat eignet sich gut für Code-Schnipsel, Fehlerbehebung, Erläuterungen und Planung. Claude Code und Codex sind Repo-fähige Workflows, die dazu dienen, Dateien zu prüfen, Befehle auszuführen, Änderungen zu testen und im Rahmen größerer Aufgaben zu arbeiten. Ein fairer Vergleich unterscheidet die Qualität der Chat-Ausgabe von den Funktionen des „Coding-Agent“-Produkts.
Aktuelles Angebot an Kodierungsmodellen
Stand 27. September 2026 handelt es sich bei dem Kodierungsvergleich eher um eine Aufstellungsentscheidung als um einen direkten Vergleich zwischen Claude und ChatGPT:
| Seite | Aktuelle Modelle, die in Betracht kommen | Optimale Programmierpraxis |
|---|---|---|
| Claude | Claude Fable 5,1, Claude Opus 5,5, Claude Sonnet 5 und Claude Haiku 4,5 | Überprüfung im Langzeitkontext, Planung, Fehlerbehebung, agentische Programmierung und Claude-Code-Workflows. |
| ChatGPT / OpenAI | GPT-6 Astra, GPT-6 Sol und GPT-6 Luna; die Verfügbarkeit variiert zwischen ChatGPT Work, Chat, Codex und API | Implementierung, Frontend-Arbeiten, Tests, Workflows unter Einsatz von Tools und Codex-Aufgaben. |
| GlobalGPT | GPT-6 Astra und Claude Opus 5.5, verifiziert in GlobalGPT; hierbei handelt es sich um ein separates Plattform-Abonnement | Direkter Vergleich von Eingabeaufforderungen, alltägliche Fragen zum Code, Recherche und Bewertung von Lösungsansätzen. |
Wenn Sie die Zugriffe von Claude und die Details zu den Plänen nachverfolgen möchten, lesen Sie den separaten Claude AI plant für 2026 Leitfaden und der ausführlichere Leitfaden zu den Claude-AI-Preisen. Wenn Sie OpenAI-Tarife vergleichen möchten, ist die Aufschlüsselung der ChatGPT-Abonnementtarife für 2026 die übersichtlichere Ergänzung.
Benchmark-Übersicht: SWE-Bench, Terminal-Bench und was sie bedeuten
Benchmarks sind nützlich, da sie zeigen, wie sich Modelle bei kontrollierten Programmieraufgaben verhalten. Entscheidend ist, bei jedem Benchmark zu berücksichtigen, was er tatsächlich misst. Ein Repository-Issue-Benchmark, ein Terminal-Agent-Benchmark und eine offizielle Tabelle zur Modellveröffentlichung liefern nicht dieselben Informationen und sollten daher in Verbindung mit den unten aufgeführten praktischen Tests herangezogen werden.
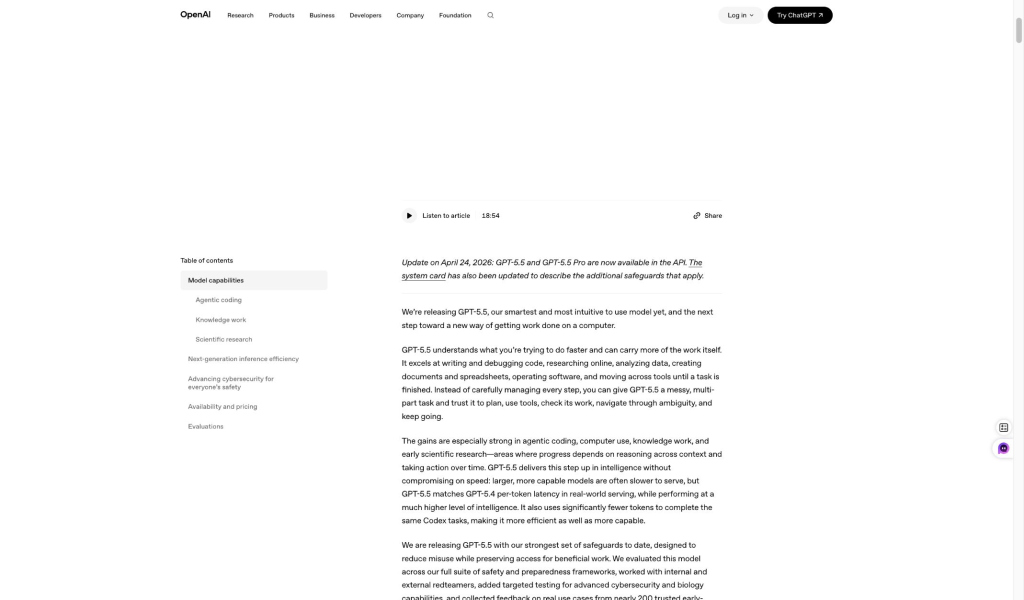
GPT-5.5 – Kodierung der Nachweise anhand des Testdatums
Der nachstehende Text zu GPT-5.5 wird beibehalten, da er mit dem im Praxistest vom 7. Juli verwendeten Modell übereinstimmt. Es untermauert die auf die Implementierung bezogenen Beobachtungen des Testabschnitts, sollte jedoch nicht als aktuelle OpenAI-Modellpalette verstanden werden; GPT-6 ist nun die aktive Modellfamilie, wobei der Zugriff zwischen ChatGPT Work, dem regulären Chat, Codex und der API variiert.
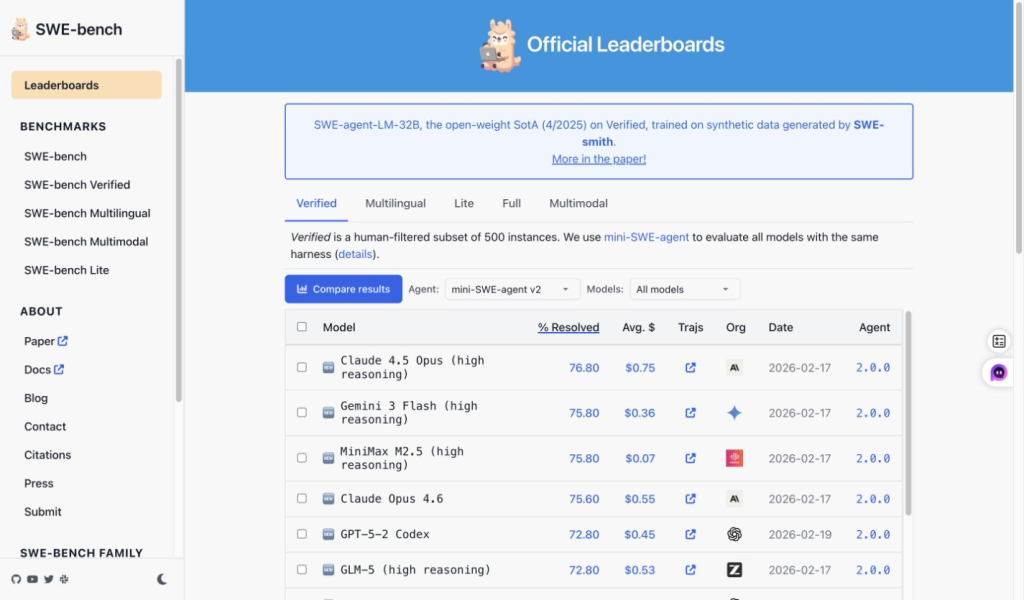
SWE-Bench: Behebung von Problemen im Repository
SWE-Bench ist nützlich, weil es näher an der tatsächlichen Softwarewartung liegt als eine kurze Code-Snippet-Eingabeaufforderung. Es berücksichtigt Issues im Repository und prüft, ob ein Modell Änderungen generieren kann, die die Aufgabe lösen. Im Vergleich zwischen Claude und ChatGPT gibt dies zwar Aufschluss über die Stärke im Bereich Software-Engineering, sagt aber noch nicht alles über die Qualität der Erklärungen, die Beurteilung bei der Überprüfung oder darüber aus, wie hilfreich eine Antwort in einem Chat-Workflow empfunden wird.
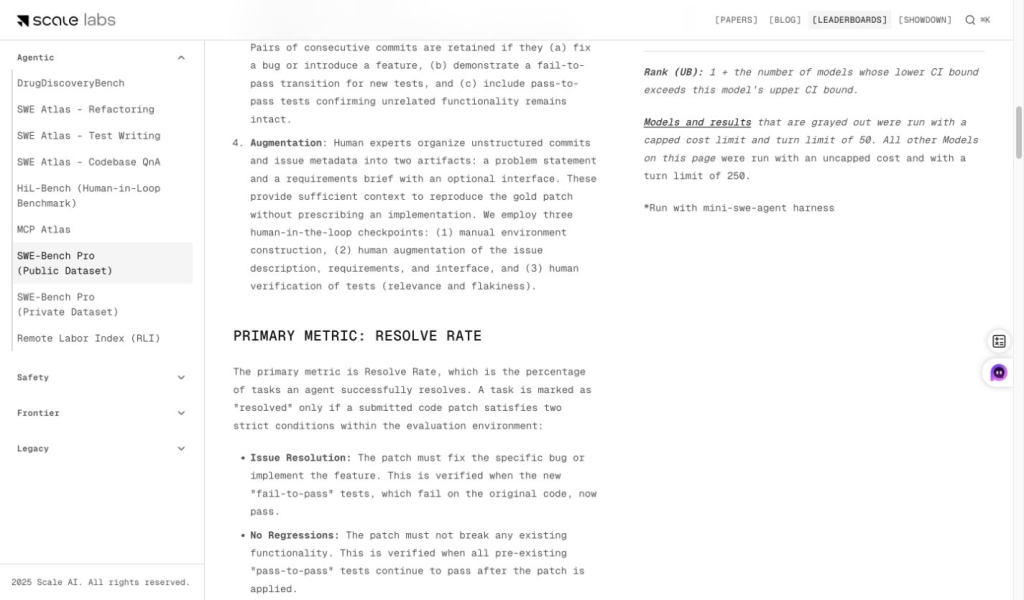
SWE-Bench Pro: anspruchsvollere Programmieraufgaben und Lösungsquote
Die öffentliche Rangliste von Scale für SWE-Bench Pro ist ein anspruchsvollerer Indikator, da er sich auf komplexere Repository-Aufgaben konzentriert und die Fehlerbehebungsrate als Hauptkennzahl heranzieht. Dies ist besonders hilfreich, wenn es um die tatsächliche Leistungsfähigkeit eines Programmieragenten geht: Es geht nicht nur darum, ob das Modell einen Fehler erklären kann, sondern auch darum, ob es unter Benchmark-Bedingungen dazu beitragen kann, das Repository zu einer funktionierenden Fehlerbehebung zu führen.
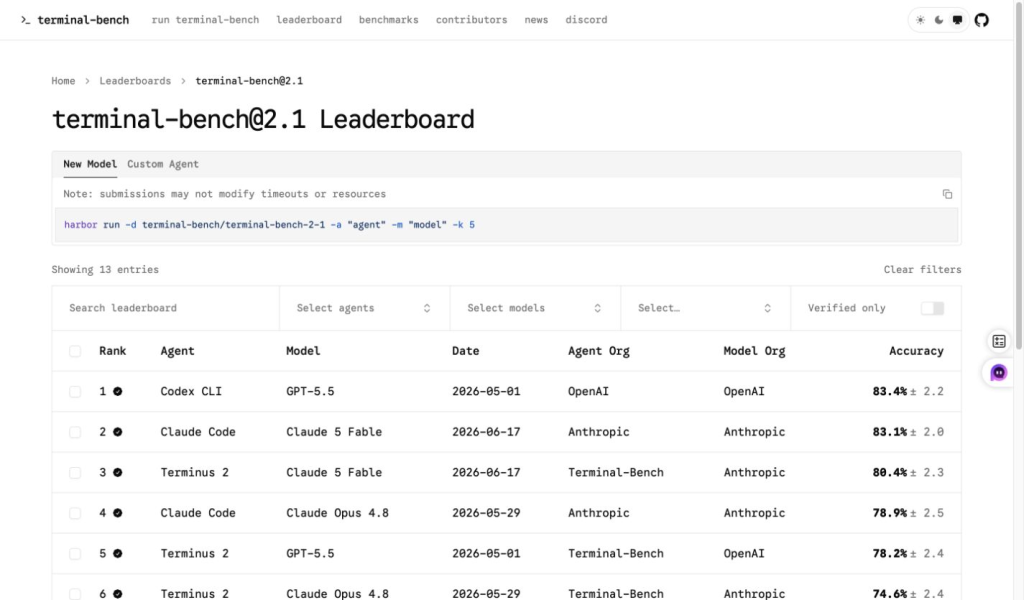
Terminal-Bench: Befehlszeilen- und Agent-Workflow-Aufgaben
Terminal-Bench 2.1 unterscheidet sich von SWE-Bench dadurch, dass es sich auf die Ausführung von Aufgaben im Terminal und über die Befehlszeile durch Agent- bzw. Modellkonfigurationen konzentriert. Dadurch ist es für Workflows im Stil von Claude Code und ChatGPT Codex relevanter als für eine einfache Chat-Aufforderung wie “Schreibe diese Funktion”. Wenn Sie einen Programmierassistenten für die Arbeit auf Repo-Ebene oder über die Befehlszeile auswählen, sollte dieser Benchmark in Ihre Entscheidung einfließen.
| Beweise | Empfohlene Lektüre für | Praktische Erkenntnisse |
|---|---|---|
| OpenAI GPT-5.5 – Materialien zum Programmieren | GPT-5.5-Programmierung und agentische Softwareentwicklung. | Starke Unterstützung für ChatGPT als implementierungsintensiven Programmierassistenten. |
| SWE-Bench | Behebung von Problemen im Repository und Aufgaben zur Softwarewartung. | Ein gutes Indiz für Programmierfähigkeiten, insbesondere wenn der Repository-Kontext eine Rolle spielt. |
| SWE-Bench Pro | Anspruchsvollere Repository-Aufgaben und Vergleich der Lösungsquote. | Nützlich zur Beurteilung der tatsächlichen agentischen Kodierungsfähigkeit. |
| Terminal-Bench 2.1 | Terminalaufgaben, Befehlsausführung und Einrichtung von Agenten und Modellen. | Für Claude Code und Codex-Workflows relevanter als einfache Chat-Aufforderungen. |
Die Vergleichstests machen beide Modellfamilien zu glaubwürdigen Programmieroptionen, entscheiden jedoch nicht über die Wahl im täglichen Arbeitsablauf. In den folgenden Abschnitten werden für die Fehlerbehebung, die Refaktorisierung, die Planung, die Komponententests und die Sicherheitsüberprüfung dieselben Aufgaben gestellt, damit Sie sehen können, wo sich die Antworten in der Praxis unterschieden haben.
Wie wir Claude und ChatGPT beim Programmieren getestet haben
Wir haben GPT-5.5 und Claude Sonnet 5 am 7. Juli 2026 in GlobalGPT getestet und dabei dieselbe Benutzeroberfläche sowie dieselben Eingabeaufforderungen verwendet. Das Ziel bestand nicht darin, einen vollständigen IDE-Agenten-Benchmark nachzubilden, sondern alltägliche Unterstützung beim Programmieren zu vergleichen: Debugging, Refactoring, das Verarbeiten mehrerer Dateien, das Schreiben von Tests und Sicherheitsüberprüfungen.
Die Bewertung war einfach: Korrektheit, Ermittlung der Grundursache, Wartbarkeit, Abdeckung von Randfällen, Verifizierung und Befolgung von Anweisungen. Dadurch entspricht der Vergleich weitgehend der tatsächlichen Nutzung von KI-Codierungsassistenten durch Entwickler.
Test 1: Fehlerbehebung und Ursachenanalyse
In der ersten Aufgabe wurden beide Modelle gebeten, eine JavaScript-Funktion zu überprüfen, die Tickets nach Priorität gruppiert. Der Fehler ist subtil, aber häufig anzutreffen: Die Funktion versucht, in acc[ticket.priority] bevor dieses Array existiert.
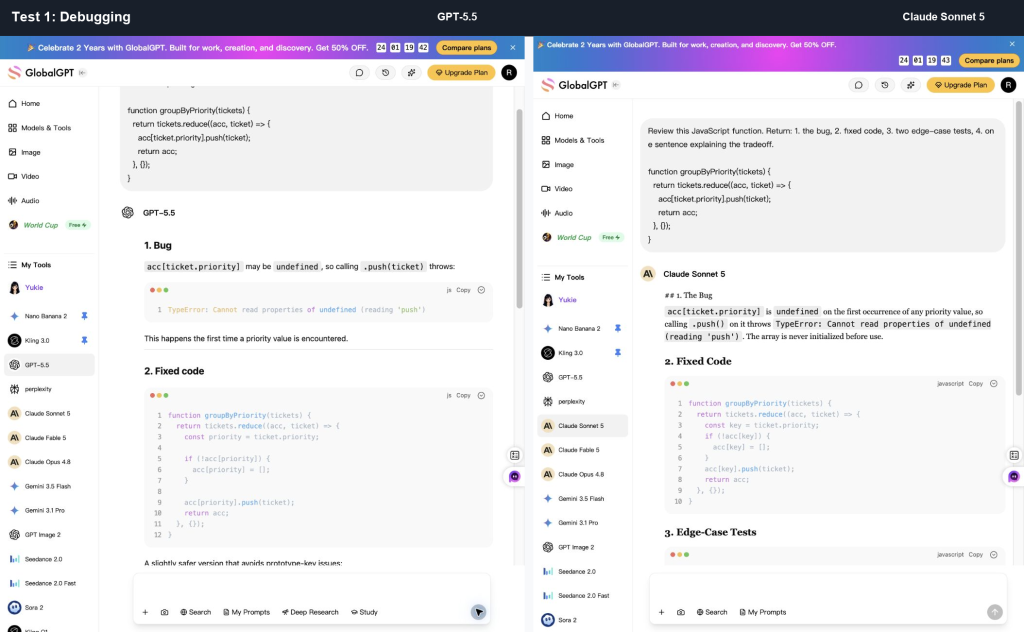
Was ChatGPT gut gemacht hat: GPT-5.5 hat den Fehler gefunden, den korrigierten Code bereitgestellt, Tests für Randfälle hinzugefügt und eine defensivere Vorgehensweise integriert. Object.create(null) Variante. Dieses zusätzliche Implementierungsdetail ist nützlich, wenn Objektschlüssel mit geerbten Eigenschaften kollidieren könnten.
Was Claude gut gemacht hat: Claude Sonnet 5 hat denselben Fehler entdeckt und eine präzisere Antwort gegeben. Dabei wurde auch ein Randfall mit undefinierter Priorität angesprochen – genau die Art von praktischen Grenzfällen, die ein Prüfer berücksichtigen sollte.
Der Gewinner: Unentschieden, wobei ChatGPT bei den Feinheiten der Umsetzung leicht die Nase vorn hat. Claude war übersichtlicher; GPT-5.5 war umfassender.
Test 2: Refactoring und Wartbarkeit
In der zweiten Aufgabe wurde eine Refaktorisierung zur Verbesserung der Lesbarkeit gefordert, ohne das Verhalten zu verändern. Dies ist ein guter Test, da viele von KI erstellte Programmierlösungen kleine Hilfsprogramme übermäßig refaktorisieren und mehr bewegliche Teile erzeugen, als der ursprüngliche Code benötigt.
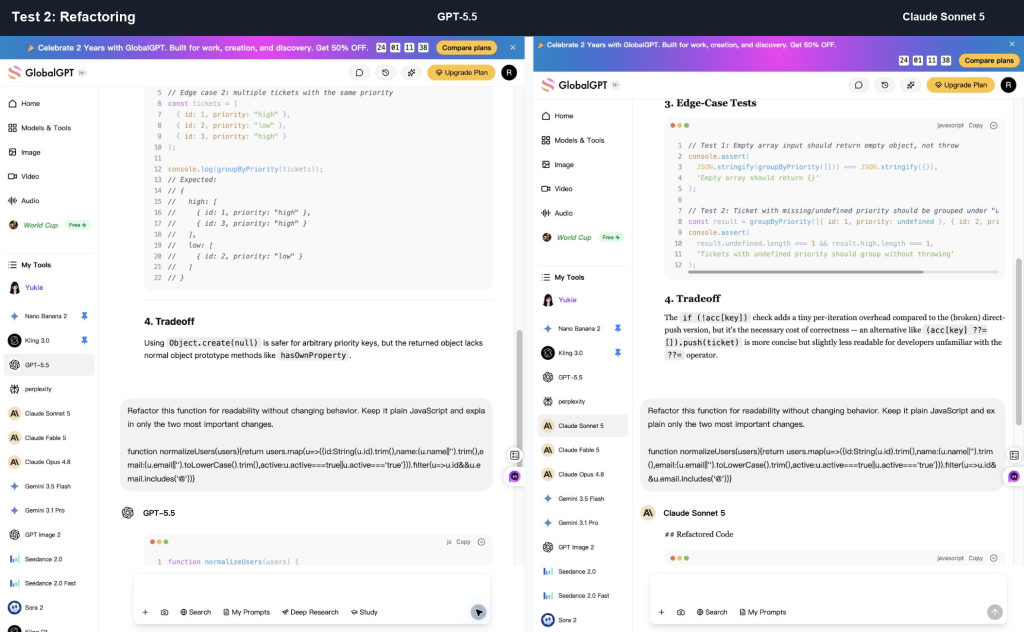
Was ChatGPT gut gemacht hat: GPT-5.5 hat die Struktur weitgehend beibehalten, benannte Zwischenwerte eingeführt und die Vorgabe “nur zwei wichtige Änderungen” konsequent befolgt. Das ist von großem Nutzen, wenn der Benutzer eine konservative Umgestaltung wünscht.
Was Claude gut gemacht hat: Claude Sonnet 5 hat Hilfsfunktionen wie einen Normalisierer und einen Validator extrahiert. Dadurch ließ sich der Text zwar leichter überfliegen, doch die Struktur wurde stärker verändert als bei GPT-5.5.
Der Gewinner: ChatGPT für Zurückhaltung; Claude für modulare Lesbarkeit. Wenn Sie eine sichere, minimale Umstrukturierung benötigen, beginnen Sie mit ChatGPT. Wenn Sie eine klarere Benennung der Domänen wünschen, bitten Sie Claude um einen zweiten Durchgang.
Test 3: Schlussfolgerungen und Planung anhand mehrerer Dateien
Die dritte Aufgabe enthielt eine kleine Next.js-Dateistruktur und einen Fehlerbericht: Angemeldete Benutzer können kleine Dateien hochladen, aber bei Dateien, die größer als 8 MB sind, schlägt der Upload stillschweigend fehl, sobald der Fortschrittsbalken den Wert 100% erreicht.
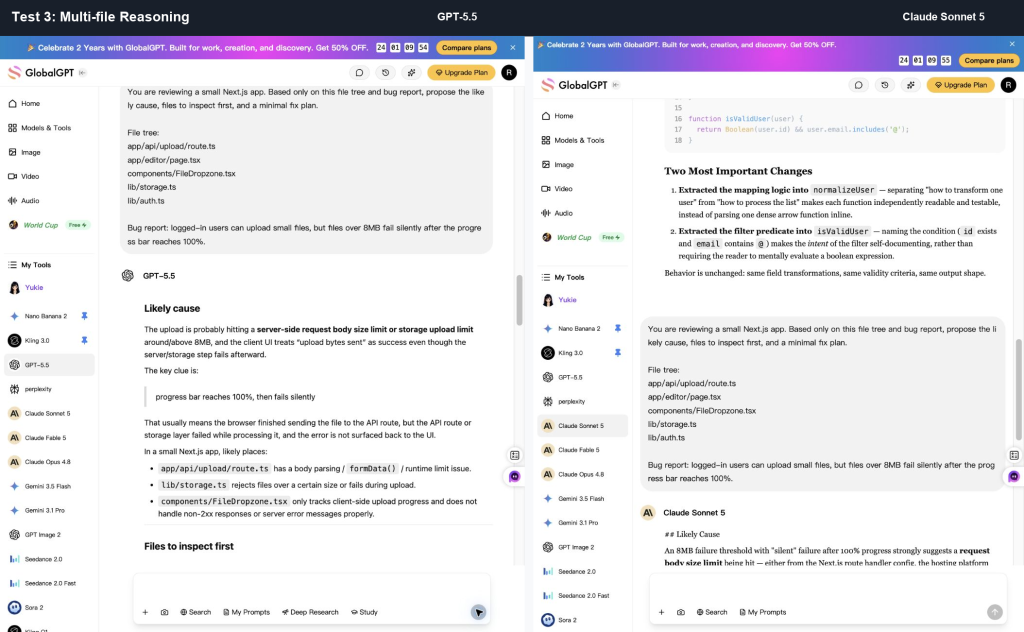
Was ChatGPT gut gemacht hat: GPT-5.5 erstellte einen detaillierten, umsetzungsorientierten Plan. Darin wurden Überprüfungen der Servergröße, die Verarbeitung von Client-Antworten und die Weitergabe von Speicherfehlern erwähnt.
Was Claude gut gemacht hat: Claude Sonnet 5 konzentrierte sich sofort auf die 8-MB-Schwelle, vermutlich auf Plattform- oder Größenbeschränkungen, die Semantik des Fortschrittsbalkens und einen Überprüfungsablauf für 7 MB, 8 MB und 9 MB. Es wirkte eher wie eine Anmerkung eines leitenden Prüfers.
Der Gewinner: Claude. Es hat die wahrscheinliche Ursache schneller ermittelt und einen präziseren, auf das Nötigste beschränkten Prüfpfad vorgegeben.
Test 4: Komponententests und Verifizierung
In der vierten Aufgabe wurden beide Modelle gebeten, TypeScript-Unit-Tests für eine Hilfsfunktion zu schreiben, die die Plan-Limits für Uploads und den Codex-Zugriff zurückgibt. Damit wird geprüft, ob das Modell die Verzweigungslogik vor zukünftigen Regressionen schützen kann.
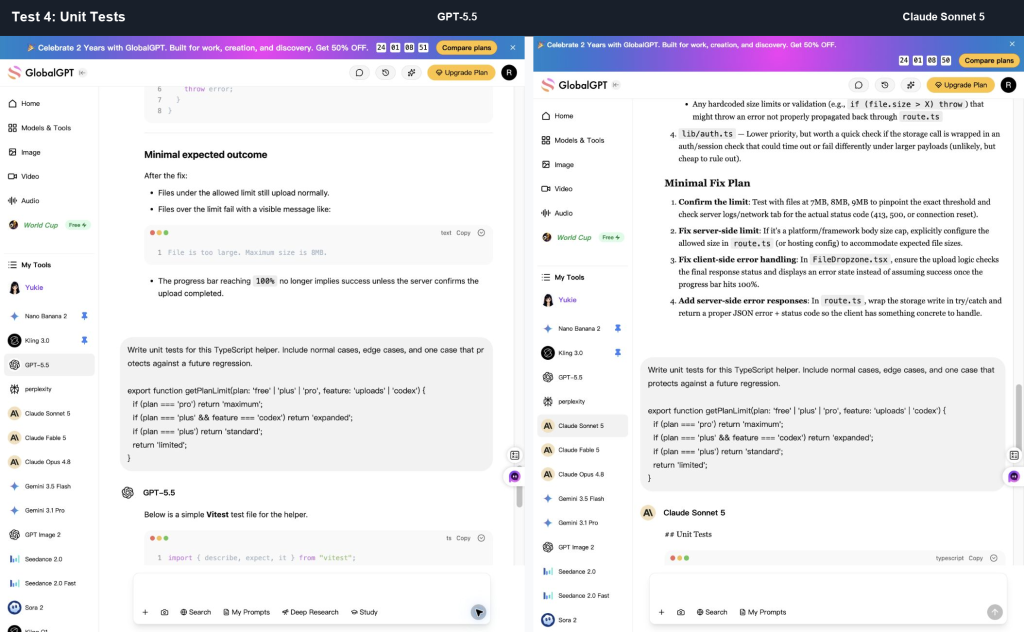
Was ChatGPT gut gemacht hat: GPT-5.5 importierte das Test-Framework und erzeugte eine Vitest-Datei, die aussehend lauffähig war. Sie deckte die erwarteten Kombinationen ab und ermöglichte es, die Antwort einfach in ein Projekt einzufügen.
Was Claude gut gemacht hat: Claude Sonnet 5 hat das tatsächliche Rückfallrisiko besser erläutert: pro + Codex muss vor den funktionsspezifischen Prüfungen einen Kurzschluss auslösen. Es war eine überzeugendere Lösung, auch wenn sie als Datei weniger einfach zu integrieren war.
Der Gewinner: Claude für die Testkonzeption; ChatGPT für die Erstellung von Ausgangsdateien. In der Praxis sollte man ChatGPT für den ersten Testentwurf verwenden und mit Claude prüfen, ob die Tests das gewünschte Verhalten abdecken.
Test 5: Überprüfung der Sicherheit und Zuverlässigkeit
In der fünften Aufgabe wurden beide Modelle gebeten, einen Express-Webhook-Endpunkt zu überprüfen. Eine gute Antwort sollte die Signaturüberprüfung, die Anforderungen an den Raw-Body, die Idempotenz, die Validierung, die Behandlung von Datenbankfehlern sowie die Begrenzungen der Anforderungsgröße berücksichtigen.
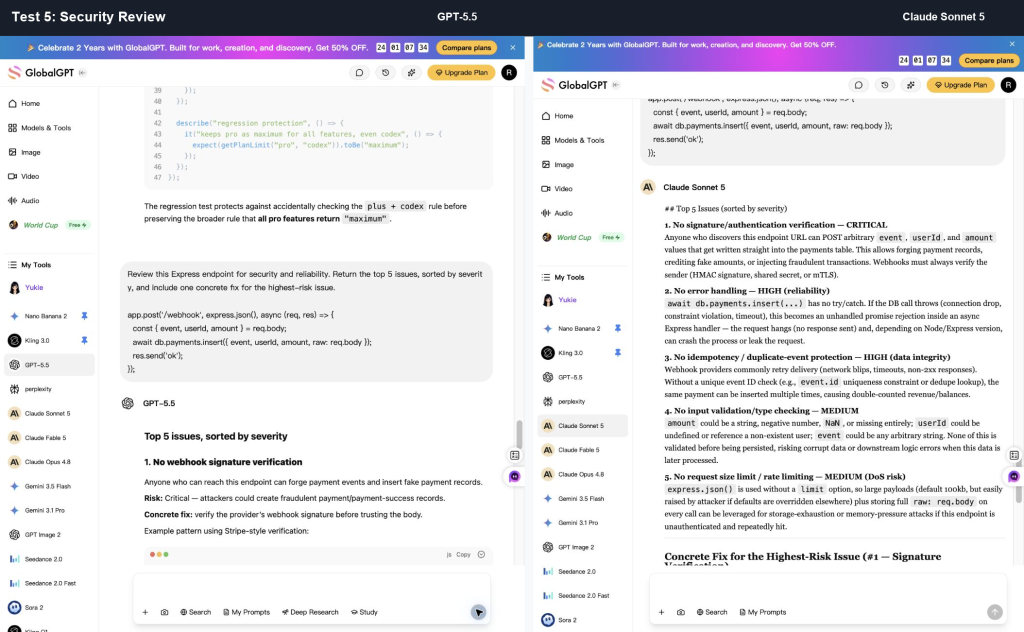
Was ChatGPT gut gemacht hat: GPT-5.5 lieferte eine Lösung im Stil eines Anbieters, einschließlich einer Stripe-ähnlichen express.raw() Muster. Das ist nützlich, wenn im nächsten Schritt ein konkreter Webhook-Handler implementiert werden soll.
Was Claude gut gemacht hat: Claude Sonnet 5 lieferte eine klarere Begründung der Schweregrade und enthielt zuverlässigere Details zum Signaturvergleich, wobei Konzepte des Vergleichs in konstanter Zeit zum Einsatz kamen. Dadurch wirkte die Risikoeinstufung präziser.
Der Gewinner: Unentschieden, wobei Claude in puncto Sicherheitserklärung leicht die Nase vorn hat. Beide Modelle waren leistungsfähig genug, um nützlich zu sein, doch keine der beiden Antworten sollte eine echte Sicherheitsüberprüfung von Zahlungs- oder Authentifizierungsabläufen ersetzen.
Claude Code vs. ChatGPT Codex
Die Chat-Ausgabe ist nur ein Aspekt der Entscheidung bezüglich der Programmierung. Claude Code und Codex sind separate Arbeitsabläufe zur agentenbasierten Entwicklung für Aufgaben, die Dateien, Befehle, Tests, Pull-Anfragen oder umfassendere Änderungen an der Codebasis betreffen.
| Arbeitsablauf | Beste Passform | Wichtige Grenze |
|---|---|---|
| Claude-Chat | Logisches Denken, Fehlerbehebung, Überprüfung, Erläuterung und Planung. | Es erkennt nur den von Ihnen angegebenen Kontext, sofern es nicht mit Tools oder einem umfassenderen Arbeitsablauf verknüpft ist. |
| ChatGPT-Chat | Implementierungsentwürfe, Tests, Beispiele und Fragen zur API-Nutzung. | Selbst eine überzeugende Antwort muss in Ihrem Projekt noch überprüft werden. |
| Claude-Code | Repo-orientierte Programmierung, Navigation in der Codebasis, Tests und Planung größerer Aufgaben. | Überprüfen Sie die Berechtigungen, die Sicherheitsrichtlinie und den vorgeschlagenen Diff, bevor Sie die Änderungen akzeptieren. |
| Codex | Repo-orientierte Implementierung, Fehlerbehebung, Tests, Code-Review und in OpenAI integrierte Programmier-Workflows. | Der Zugriff, die Nutzung und die Verfügbarkeit des Modells unterscheiden sich von denen eines gewöhnlichen Chats und können sich im Laufe der Zeit ändern. |
Der praktische Ansatz: Nutze Chat-Modelle zum Nachdenken, für Erklärungen und für kleine Aufgaben; setze Claude Code oder Codex ein, wenn die Arbeit den Kontext eines Repositorys und ausführbare Schritte erfordert.
Preise: Claude, ChatGPT, Codex und GlobalGPT
Fragen Sie sich zunächst, wofür Sie bezahlen. Mit einem Chat-Tarif erhalten Sie tägliche interaktive Hilfe beim Programmieren. Ein „Coding-Agent“-Workflow deckt Repo-bezogene Aufgaben wie CLI-, IDE-, Web- und Cloud-Aufgaben sowie Integrationen ab. Bei der API-Abrechnung wird pro Million Token abgerechnet. Ein Multi-Modell-Arbeitsbereich ermöglicht einen einfacheren Wechsel zwischen Claude, GPT, Gemini, Perplexity und anderen Modellen an einem Ort.
Die am 27. September 2026 ermittelten Preise sind in US-Dollar vor anfallenden Steuern angegeben. In der Tabelle werden Verbraucherabonnements, Standardtarife für API-Token und die eigenen Jahresabonnements von GlobalGPT getrennt aufgeführt. Die Preisseite von Claude Das entspricht bei „rounds Pro“ umgerechnet $17 pro Monat; bei einer Vorauszahlung von $200 ergibt sich ein Betrag von $16,67 pro Monat.
| Produkt oder Tarif | Angezeigter Preis | Was das für das Programmieren bedeutet |
|---|---|---|
| Privatkunden · Claude kostenlos | $0 | Das reicht für einfache Programmierfragen und um den Stil von Claude auszuprobieren, bevor man bezahlt. |
| Privatkunden · Claude Pro | $20/Monat; $200/Jahr im Voraus (entspricht $16,67/Monat) | Claude-Code enthalten; Nutzung des kostenpflichtigen Tarifs für Chat und Claude-Code-Sharing. |
| Verbraucher · Claude Max | Ab $100/Monat | Optionen für höhere Nutzungsvolumina; Claude-Code enthalten. Die Abrechnung über die API-Konsole erfolgt separat. |
| Verbraucher · ChatGPT Kostenlos | $0/Monat | Leichter Chat; der Desktop-Zugriff auf GPT-6 Luna unterscheidet sich vom gewöhnlichen Chat. |
| Verbraucher · ChatGPT Go | $8/Monat in der ursprünglichen US-Referenz; die Preise vor Ort können abweichen | Monatliches Abonnement; den Preis für Ihren Markt finden Sie auf der lokalen Preisseite. |
| Verbraucher · ChatGPT Plus | 1 TP4T20 pro Monat, monatliche Abrechnung | Regelmäßige Programmier-Hinweise und berechtigter Zugriff auf Codex/Work; die Nutzung der API wird separat abgerechnet. |
| Verbraucher · ChatGPT Pro | $100/Monat; bestehende Abonnements mit $200/Monat laufen weiter | Neue Anmeldungen für $200 sowie Upgrades werden ab dem 10. September 2026 ausgesetzt. Abonnements für $100 sind weiterhin verfügbar. |
| API · Claude Sonett 5 | $2/M-Eingang; $10/M-Ausgang | Standard-API-Tarif für Programmierwerkzeuge und Workflows mit großem Kontextumfang. |
| API · Claude Opus 5,5 | $4/M-Eingang; $20/M-Ausgang | Standardgeschwindigkeit. Im Schnellmodus beträgt die Eingangsleistung $8/M und die Ausgangsleistung $40/M. |
| API · GPT-6 Astra | $10/M Eingang; $50/M Ausgang | Standard-API-Tarif; unabhängig vom ChatGPT-Tarif. |
| API · GPT-6 Sol / Luna | Sol: Eingang $2/M, Ausgang $10/M; Luna: Eingang $0.10/M, Ausgang $0.50/M | Separate Abrechnung für Entwickler; geben Sie die genaue Modell-ID und den genauen Tarif an. |
| Plattform · GlobalGPT Basic | entspricht $5,80 pro Monat; $69,60 wird jährlich in Rechnung gestellt | Eine kostengünstige Möglichkeit, verschiedene Modellfamilien für alltägliche Programmieraufgaben und Forschungszwecke miteinander zu vergleichen. |
| Plattform · GlobalGPT Pro | $10,80 pro Monat; $129,60 jährlich in Rechnung gestellt | Eine bessere Anpassung, wenn Sie im Arbeitsalltag zwischen mehreren Modellfamilien wechseln. |
| Plattform · GlobalGPT Unlimited | entspricht $25/Monat; $300 wird jährlich in Rechnung gestellt | Für den häufigen Vergleich mehrerer Modelle in einem Arbeitsbereich. Diese Tarife beinhalten keine offiziellen API-Guthaben und keine nativen Claude-Code-/Codex-Abonnements. |
Für die meisten einzelnen Entwickler lautet die Frage nicht: “Welches Unternehmen ist am günstigsten?”, sondern: “Welcher Preis passt zum Arbeitsablauf?” Wenn Sie hauptsächlich Fragen stellen und Code-Schnipsel einfügen, dann ist Claude Pro oder ChatGPT Plus Das könnte ausreichen. Wenn Sie eine Repo-fähige Implementierung wünschen, vergleichen Sie den Claude-Code mit dem Codex-Zugang. Wenn Sie täglich mehrere Modelle vergleichen, kann GlobalGPT die übersichtlichere tägliche Arbeitsumgebung sein, da die Kosten an einen einzigen Multi-Modell-Tarif gebunden sind und nicht an mehrere separate Abonnements.
Bei API-intensiven Programmierwerkzeugen sind die Abonnementpreise kein geeigneter Vergleichsmaßstab. Die Preisgestaltung pro Token ist wichtiger, da der Code-Kontext umfangreich ist. Claude Sonett 5 kostet $2/M als Eingabe und $10/M als Ausgabe, während Opus 5.5 bei Standardgeschwindigkeit $4/M und $20/M kostet. Eine Million Eingabetoken plus eine Million Ausgabetoken kosten daher $12 auf Sonnet 5 oder $24 auf Opus 5.5. Bei OpenAI kostet dieselbe Nutzung $60 auf Astra, $12 auf Sol oder $0,60 auf Luna zu Standardtarifen. Hierbei handelt es sich um API-Gebühren, nicht um Kontingente, die in den Abonnements ChatGPT, Claude oder GlobalGPT enthalten sind.
Für welche Programmierumgebung sollten Sie sich entscheiden?
Entscheiden Sie sich nicht allein anhand des Modellnamens. Wählen Sie das Modell entsprechend der Art der Programmierarbeit, die Sie tatsächlich ausführen. Ein und dieselbe Person kann im Alltag ChatGPT für eine erste Implementierung, Claude zur Überprüfung, Codex für die Arbeit an ausführbaren Repos und GlobalGPT für schnelle Modellvergleiche nebeneinander nutzen.
Anfänger, die das Programmieren lernen: Fang mit ChatGPT an. Dort findest du in der Regel mehr Beispiele, mehr Hilfestellungen und einen einfacheren Weg von “Ich verstehe diesen Fehler nicht” hin zu “So sieht die funktionierende Form aus”.”
Ein Junior-Entwickler, der Fehler behebt: Fangen Sie mit Claude an, wenn das Problem noch unklar ist. Claude ist besonders gut darin, die wahrscheinlichen Ursachen einzugrenzen, anzugeben, was zuerst überprüft werden sollte, und die Erklärung auf das Wesentliche zu konzentrieren. Nutzen Sie anschließend ChatGPT, wenn Sie einen konkreten Patch, einen Testfall oder ein Implementierungsbeispiel benötigen.
Ein leitender Ingenieur, der eine Änderung prüft: Beginnen Sie mit Claude. Das Modell eignet sich besser für Kompromissfindungen, die Einstufung des Schweregrads, architektonische Überlegungen und prägnante Kritik. Bei Aufgaben, die einen größeren Code-Umfang betreffen, wechseln Sie vom Chat zu „Claude Code“ oder „Codex“, damit das Modell mit Dateien und Befehlen arbeiten kann, anstatt nur ein eingefügtes Fragment zu verarbeiten.
Frontend- oder UI-Generator: Beginnen Sie mit ChatGPT für den ersten Durchgang. Das Programm neigt dazu, umfassenderen Komponentencode, Zustandsverwaltung und Testgerüste zu generieren. Nutzen Sie anschließend Claude, um die Barrierefreiheit, die Komponentengrenzen, die Namensgebung und die Frage zu überprüfen, ob der Code für das Design zu ausgeklügelt ist.
Verantwortlicher für die Pflege eines umfangreichen Code-Bestands: Entscheiden Sie sich je nach Ihrer Infrastruktur, Ihrem Kontozugriff, Ihren Sicherheitsrichtlinien und Ihrem bevorzugten Arbeitsablauf für „Claude Code“ oder „Codex“. Sobald eine Aufgabe mehrere Dateien umfasst, ist der Arbeitsablauf des Agenten in der Regel wichtiger als die Frage, welche Antwort im Chat besser klingt.
Alleinunternehmer oder kleines Team: Verwenden Sie beide Modellfamilien, sofern das Budget dies zulässt. Eine praktische Konfiguration besteht aus GlobalGPT für den täglichen Modellvergleich und die Umwandlung von Ideen in Code sowie Claude Code oder Codex, wenn für eine Aufgabe Zugriff auf ein Repository und ausführbare Schritte erforderlich sind.
| Entwicklertyp | Die beste erste Wahl | Warum |
|---|---|---|
| Anfänger, der das Programmieren lernt | ChatGPT | Weitere Beispiele, ausführlichere Erklärungen und anfängerfreundliche Hilfestellungen. |
| Junior-Entwickler, der Fehler behebt | Claude zuerst | Ein klareres Denken in Bezug auf die Grundursachen und bessere Anleitungen zum Thema “Das sollte man zuerst überprüfen”. |
| Leitender Ingenieur, der eine Änderung prüft | Claude | Bessere Eignung für Kompromissfindungen, Risikoeinstufungen und prägnante Kritik. |
| Frontend-/UI-Entwickler | Zuerst ChatGPT, dann Claude | ChatGPT erstellt den Entwurf; Claude überprüft Barrierefreiheit, Struktur und Wartbarkeit. |
| Verantwortlicher für die Pflege eines umfangreichen Quellcodes | Claude Code oder Codex, je nach Stapel und Zugriff | Dateien, Befehle, Tests und Berechtigungen sind wichtiger als eine einzelne Antwort im Chat. |
| Gründer von Solo | Beides, oft über einen einzigen modellübergreifenden Arbeitsbereich | Schnelle Entwürfe, sorgfältige Überprüfung und schneller Modellwechsel – all das ist wichtig, wenn eine Person für das Produkt verantwortlich ist. |
Wenn Sie zwischen den neueren Modellreihen Claude und GPT abwägen, bietet der Vergleich zwischen Claude Opus 5.5 und GPT-6 Sol weitere modellspezifische Informationen. Wenn Sie kostenpflichtige OpenAI-Tarife in Betracht ziehen, bietet der ChatGPT Plus vs. Pro Ein Vergleich kann dabei helfen, einzuschätzen, ob sich eine intensivere Nutzung lohnt.
Warum viele Entwickler immer noch beides nutzen
Die gleichzeitige Nutzung von Claude und ChatGPT ist kein Zeichen von Unentschlossenheit. Es ist ein besserer Qualitätskontrollkreislauf.
- Mit Claude planen, mit ChatGPT umsetzen: Nützlich, wenn Sie mit Claude das Risiko eingrenzen und mit ChatGPT die erste Implementierung erstellen möchten.
- Mit ChatGPT entwerfen, mit Claude überprüfen: Nützlich, wenn man schnellen Code benötigt, aber eine strengere zweite Meinung einholen möchte.
- Fragen Sie beides, bevor Sie die Produktion in Angriff nehmen: nützlich für Zahlungen, Authentifizierung, Uploads, Migrationen, Caching und destruktive Datenbankänderungen.
- Verwenden Sie einen Agenten, wenn für die Aufgabe Dateien benötigt werden: „Claude Code“ oder „Codex“ kann wichtiger sein als einfacher Chat, wenn das Modell den Kontext des Repositorys benötigt.
GlobalGPT entspricht dem Muster “Beides nutzen”, wenn es um den schnellen Vergleich von Aufgaben, alltägliche Unterstützung beim Programmieren, Planung oder Recherche geht. Es eignet sich besonders gut für den täglichen Modellvergleich, die Überarbeitung von Entwürfen, schnelle Zweitmeinungen und die Auswahl des Modellstils, der am besten zum nächsten Projekt passt.
Wenn Sie ausschließlich den Zugriff auf Claude prüfen, dann ist die beste Claude AI Alternativen Die Liste dient als allgemeiner Leitfaden für den Fall, dass andere Lösungen nicht funktionieren.
FAQ
Was eignet sich im Jahr 2026 besser zum Programmieren: Claude oder ChatGPT?
Wählen Sie zunächst Claude für Code-Reviews, die Fehlerbehebung bei unklaren Problemen, die Architekturplanung und das Schlussfolgern in langen Kontexten. Wählen Sie ChatGPT als erste Option für Implementierungsentwürfe, Beispiele, Frontend-Arbeiten und das Erstellen von Testgerüsten. Wenn die Aufgabe Repository-Zugriff, Befehle, Tests oder die Bearbeitung mehrerer Dateien erfordert, vergleichen Sie Claude Code mit Codex, anstatt sich allein auf den Chat zu verlassen.
Ist Claude besser als ChatGPT, wenn es um das Debuggen geht?
Claude eignet sich oft besser für den ersten Debugging-Durchlauf, da es in der Regel die wahrscheinlichste Ursache priorisiert und den Fehlerpfad klar erläutert. Bei unseren JavaScript- und Next.js-Tests zeigte sich Claude Sonnet 5 besonders stark bei der prägnanten Diagnose. ChatGPT schnitt weiterhin gut ab, wenn die Fehlerbehebung umfassendere Implementierungsdetails erforderte.
Ist ChatGPT Codex besser als Claude Code?
Keine der beiden Varianten ist automatisch für jedes Team besser geeignet. Der ChatGPT-Codex eignet sich für OpenAI-zentrierte Arbeitsabläufe und implementierungsintensive Agentenaufgaben. Der Claude-Code ist dann besonders stark, wenn die Arbeit vom Planungs-, Überprüfungs- und langkontextbezogenen Denkansatz des Claude profitiert. Die bessere Wahl hängt vom Repository-Zugriff, der Preisgestaltung, dem Stack, den Berechtigungen und den Teamrichtlinien ab.
Was eignet sich besser für eine umfangreiche Codebasis?
Bei einer umfangreichen Codebasis ist der Arbeitsablauf des Agenten wichtiger als das Chat-Modell allein. Verwenden Sie „Claude Code“ oder „Codex“, wenn der Assistent Dateien prüfen, Befehle ausführen, Tests durchführen oder das Verhalten über mehrere Module hinweg nachverfolgen muss. Behalten Sie die menschliche Überprüfung in Bezug auf Berechtigungen, riskante Befehle und den endgültigen Diff bei.
Was eignet sich besser für Anfänger, die das Programmieren lernen möchten?
ChatGPT ist für Anfänger in der Regel einfacher zu handhaben, da es tendenziell mehr Beispiele, ausführlichere Erklärungen und sofort einsatzbereite Code-Schnipsel liefert. Claude kann besser geeignet sein, wenn Anfänger nicht weiterkommen, weil sie nicht verstehen, warum etwas nicht funktioniert, und eine klarere konzeptionelle Erklärung benötigen.
Was eignet sich besser für Frontend-HTML- und UI-Code?
ChatGPT eignet sich oft besser für die Erstellung eines ersten Entwurfs für HTML, CSS oder Komponenten. Claude ist nützlich, um die Struktur zu überprüfen, das Layout zu vereinfachen und Probleme hinsichtlich Barrierefreiheit oder Wartbarkeit aufzudecken. Für ausgefeilte Frontend-Arbeiten sollten Sie ChatGPT zum Entwerfen und Claude zum Überprüfen verwenden.
Welches Modell eignet sich besser zum Schreiben von Tests?
ChatGPT eignet sich besser, wenn Sie eine vollständige Testdatei mit Importen und einer ausführenbaren Struktur benötigen. Claude ist besser geeignet, wenn Sie verstehen möchten, welches Verhalten geschützt werden muss und warum ein Regressionstest wichtig ist. Ein bewährter Arbeitsablauf besteht darin, Tests mit ChatGPT zu generieren und anschließend Claude zu fragen, welche Randfälle noch fehlen.
Zeigen Benchmarks wie SWE-Bench, welcher Programmierassistent besser ist?
Nein. SWE-Bench, SWE-Bench Pro und Terminal-Bench sind wertvolle Indikatoren, insbesondere für agentische Kodierungs-Workflows, aber sie lassen keine vollständige Vorhersage über die tägliche Unterstützung bei der Kodierung zu. Benchmarks messen einen kontrollierten Testumfang; echte Entwickler benötigen darüber hinaus klare Argumentation, benutzerfreundlichen Code, wartbare Änderungen und gute Verifizierungsschritte.
Sollten Entwickler sowohl Claude als auch ChatGPT nutzen?
Ja, vor allem bei anspruchsvollen Aufgaben. Nutzen Sie Claude für die Planung, die Risikoprüfung und die Diagnose. Nutzen Sie ChatGPT für Entwürfe zur Umsetzung, Beispiele und Testgerüste. Führen Sie anschließend den Code aus, überprüfen Sie die Änderungen und verifizieren Sie das Verhalten in Ihrem eigenen Projekt.
Kann ich Claude und ChatGPT in GlobalGPT miteinander vergleichen?
Ja. GlobalGPT eignet sich gut, um Antworten aus Claude und ChatGPT in einem Arbeitsbereich zu vergleichen, sofern die benötigten Modelle dort verfügbar sind. Es eignet sich gut für alltägliche Fragen zum Code, zur Planung, zur Recherche und für Zweitmeinungen. Es ersetzt jedoch weder Claude Code, Codex, eine IDE, offizielle APIs noch Tools auf Repository-Ebene.