Análise do Claude Opus 5.5: Preço, benchmarks e testes reais de API
O Claude Opus 5.5 combina uma janela de contexto de 1 milhão de tokens com um preço de API de $4 / $20 por milhão de tokens. Esta análise separa as alegações publicadas pela Anthropic, instantâneos de benchmarks independentes e cinco execuções diretas de tarefas por meio da rota da API de Mensagens.
O resultado da medição é específico. Três tarefas geraram respostas corretas e utilizáveis; a tarefa de codificação gerou uma resposta útil, mas atingiu o limite máximo de 1.024 tokens; a execução da escrita em chinês produziu um texto ilegível na rota testada. A amostra mostra um comportamento concreto e os limites da rota, e não uma taxa de sucesso universal.
Resposta rápida
- Desempenho: O Anthropic apresenta desempenho no nível Fable 5.1 na maioria das tarefas, enquanto o Artificial Analysis registrou uma pontuação de 58 no Índice de Inteligência em esforço máximo. As evidências mais restritas do METR relativas à capacidade de julgamento não demonstraram uma grande melhora em relação ao Fable 5.1.
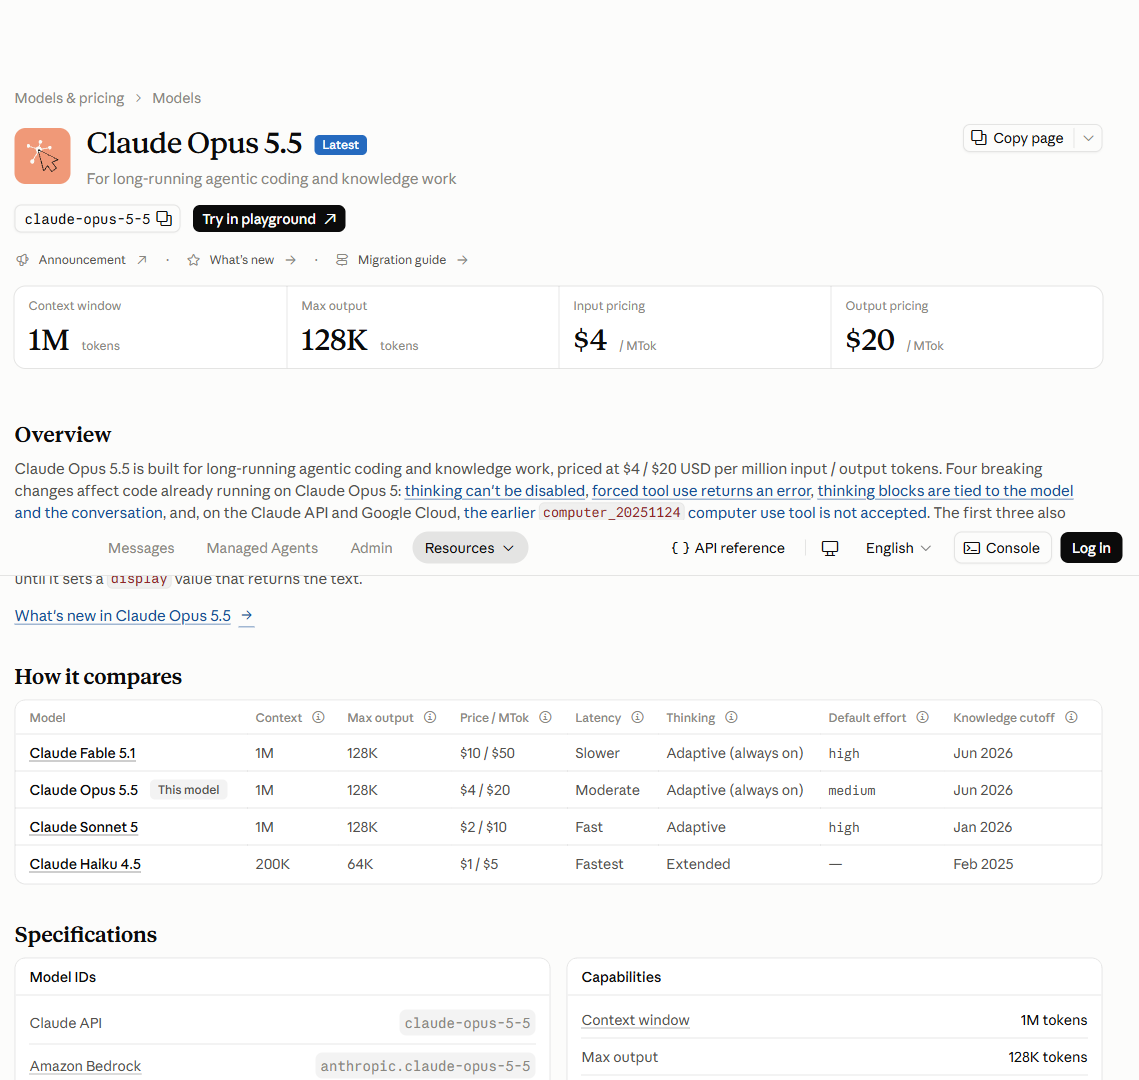
- Preço: a taxa oficial da API é $4 por milhão de tokens de entrada e $20 por milhão de tokens de saída. As leituras de cache custam $0,20 por milhão; as gravações de cache a cada 5 minutos custam $5 por milhão.
- Resultado prático: A extração de textos longos, o JSON estrito e o raciocínio aritmético foram aprovados nas execuções registradas. A codificação foi útil, mas ficou limitada ao limite inicial. O resultado em chinês foi registrado como um problema de rota/codificação, e não como um veredicto de idioma no nível do modelo.
- Aviso da API: o pensamento não pode ser desativado, a tentativa forçada de usar uma ferramenta gera um erro, os blocos de pensamento estão vinculados ao modelo e à conversa, e o antigo
computador_20251124A ferramenta não é aceita na API Claude e na rota do Google Cloud.
O que dizem os documentos oficiais
A página de lançamento do Anthropic indica que o Claude Opus 5.5 será lançado em 22 de setembro de 2026 e o descreve como o primeiro modelo da família Claude 5.5. O anúncio afirma que o desempenho é comparável ao do Claude Fable 5.1 na maioria das tarefas, com um custo típico de carga de trabalho 40% menor do que o do Opus 5 e uma produção mais de 30% mais rápida do que a do Opus 5. Essas são alegações do fornecedor; portanto, são apresentadas separadamente das evidências independentes e práticas apresentadas a seguir.
O Documentação da plataforma Claude indique o ID do modelo da API como claude-opus-5-5, uma janela de contexto de 1 milhão de tokens, uma saída máxima de 128 mil e um raciocínio adaptativo sempre ativo. A documentação também lista as alterações que afetam as integrações existentes do Opus 5, abordadas na seção sobre migração abaixo.
Evidências de desempenho
Não há um único indicador de “desempenho” aqui. As três fontes públicas medem aspectos diferentes; por isso, cada ficha mantém visíveis sua métrica e seu âmbito de referência.
Anúncio do Anthropic
Sinal publicado: A Anthropic afirma que o Opus 5.5 apresenta desempenho comparável ao do Claude Fable 5.1 na maioria das tarefas, custa 40% a menos que o Opus 5 em cargas de trabalho típicas e gera resultados mais de 30% mais rapidamente.
Limite: exemplos de posicionamento e testes divulgados pelo provedor, e não um benchmark independente.
Análise Artificial
Sinal publicado: O snapshot de esforço máximo apresenta 59,61 TP40T no Terminal-Bench 4.0, 61,41 TP40T no Humanity’s Last Exam e 66,91 TP40T no SciCode.
Limite: As pontuações dependem do esforço, do ambiente de teste, da data e da definição das métricas. Elas não prevêem todas as solicitações da API.
Avaliação pré-implantação do METR
Sinal publicado: A METR afirma que suas evidências não demonstraram uma grande melhoria em relação ao Fable 5.1 nas habilidades de julgamento analisadas, embora ainda espere uma aceleração significativa em alguns trabalhos de P&D.
Limite: Trata-se de uma avaliação mais restrita do julgamento e da agilidade na execução de tarefas, e não de uma classificação completa de qualidade.
Quando analisados em conjunto, os dados apontam para uma conclusão limitada: o Opus 5.5 é o modelo líder em várias avaliações públicas já realizadas, mas a magnitude da vantagem varia de acordo com a tarefa, o nível de esforço e o desenho da avaliação. Os dados não indicam um resultado universal de “melhor modelo”.
Claude Opus 5.5: unidades de preço e faturamento
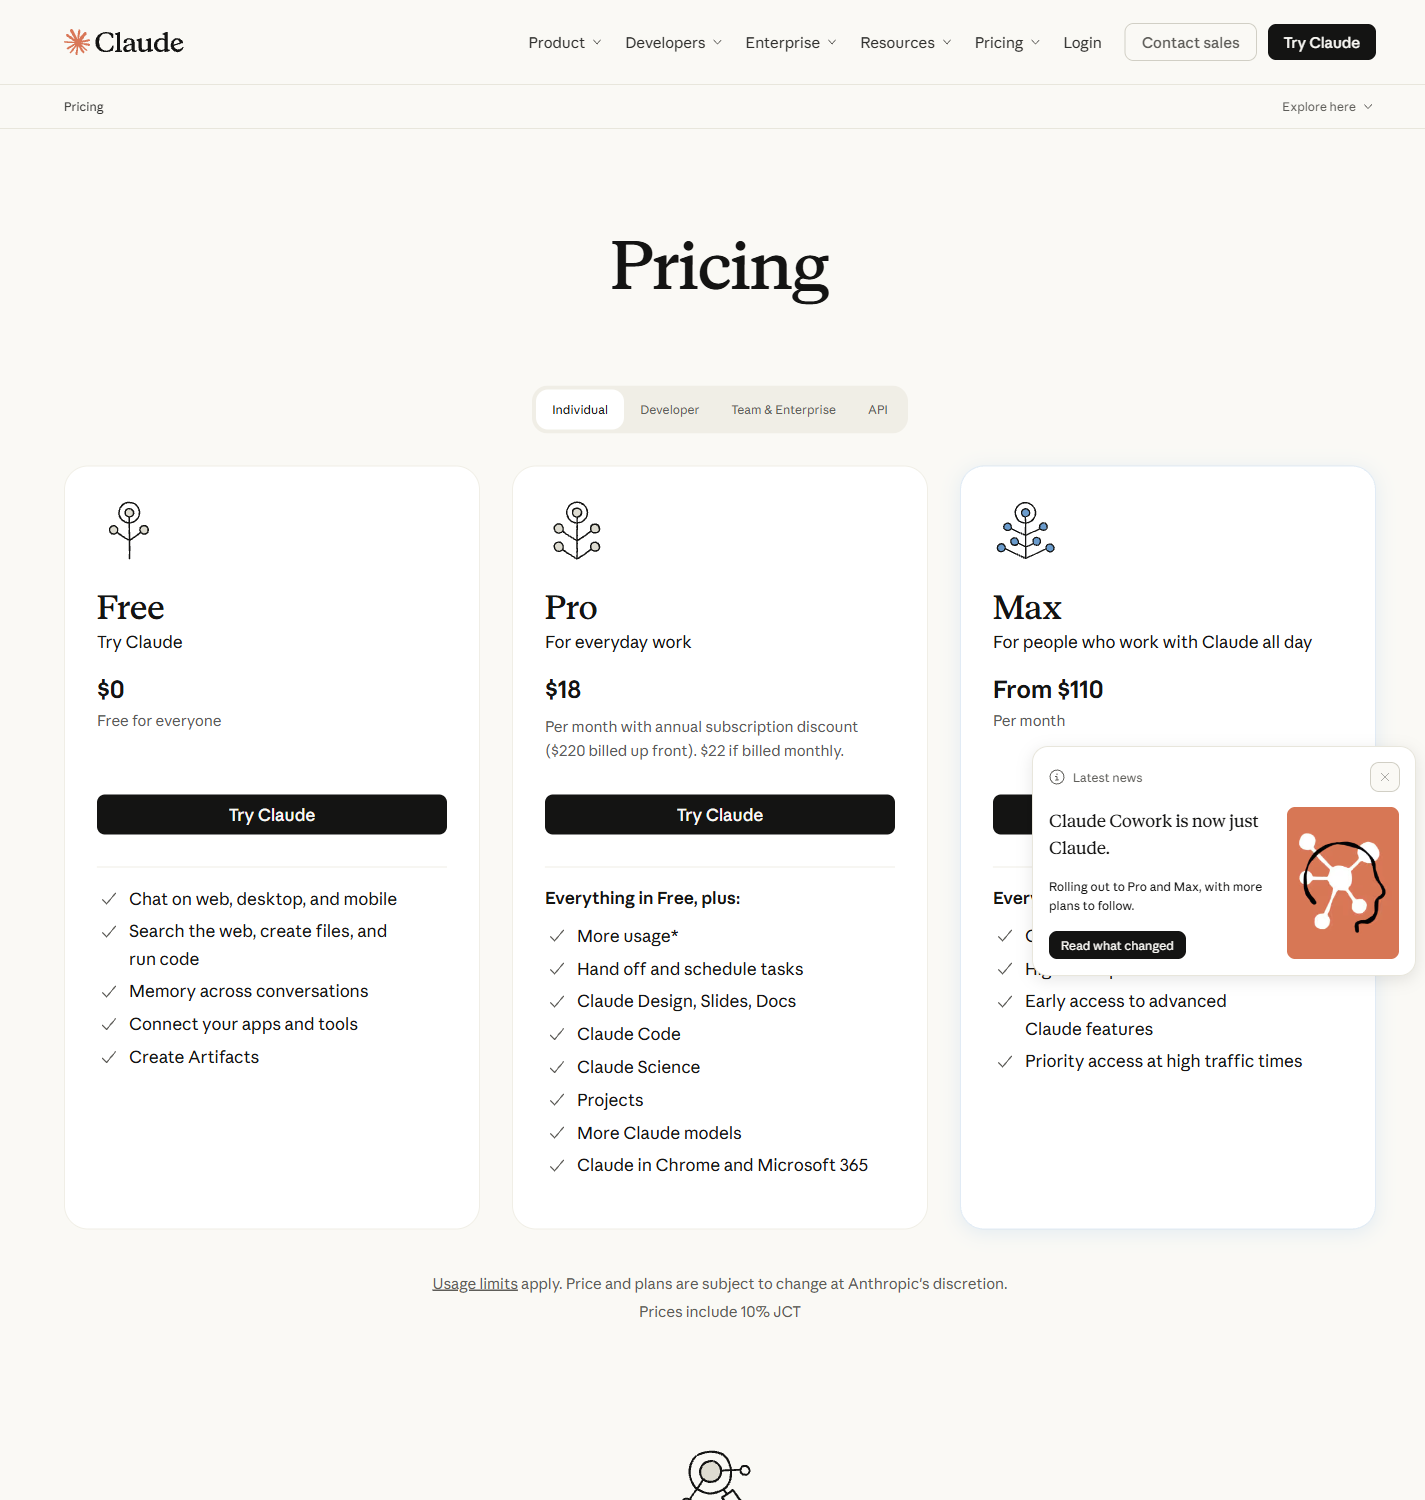
O preço da API e o preço da assinatura do consumidor são produtos diferentes. Os valores da API abaixo são os preços unitários utilizados para o orçamento de tokens; os valores do consumidor são os planos exibidos na área capturada do navegador.
Preços oficiais da API
Estimativa simples: 10.000 tokens de entrada mais 2.000 tokens de saída equivalem a cerca de $0,08 às taxas padrão, antes do cache, do lote, dos impostos ou da margem de lucro da plataforma.
Captura de tela do plano do consumidor
A página capturada também mostra uma nota JCT 10%. Esses valores exibidos variam de acordo com a região e não representam uma garantia de preço global.
Para obter uma explicação detalhada sobre o faturamento por token e o custo da janela de contexto, consulte o Guia de preços e contexto do GPT-5.5. A taxa da API do provedor, o preço da assinatura e qualquer saldo de crédito da plataforma multimodelo devem ser mantidos separadamente no seu orçamento.
Teste prático: cinco cartões de resultados de tarefas
Enviamos cinco solicitações independentes pela mesma rota controlada da API de Mensagens em 23 de setembro de 2026, com o ID do modelo claude-opus-5-5. A primeira etapa utilizou max_tokens: 1024. Registramos o tempo decorrido local, os tokens de entrada/saída, o motivo da interrupção, a correção e a conformidade com o formato literal. A tarefa de escrita em chinês foi repetida com um limite máximo de 4.096 tokens, após a primeira execução ter revelado o problema na saída da rota. Trata-se de uma amostra de cinco tarefas, e não de uma estimativa de confiabilidade.
É possível corrigir uma função de deduplicação de tipo misto?
Configuração da tarefa
Encontre o erro no código Python deduplicação função, lidar com valores que não sejam strings e que não possam ser transformados em hash, preservar a grafia original e fornecer testes.
A resposta identificou o .lower() falha ao processar valores que não eram strings; alterou as strings para casefold(), adicionei uma alternativa que não pode ser hashada e retornei o código corrigido, juntamente com os casos de teste.
A resposta atingiu o limite máximo de 1.024 tokens. A correção foi útil, mas a configuração era pequena demais para uma revisão completa do código.
Avaliação do cartão: Resposta tecnicamente válida foi retornada; esta execução não permite avaliar a latência ou a completude, pois o limite máximo de tokens interrompeu o processo.
Será que ele consegue preservar os fatos e testar as limitações?
Configuração da tarefa
Extraia cinco conclusões numeradas de um breve memorando de avaliação, incluindo o método utilizado e o que não foi avaliado na rodada seguinte.
Apresentou exatamente cinco pontos numerados. Manteve as comparações com os assistentes, o método das 20 perguntas e as lacunas relacionadas à retenção de longo prazo e à conversão de clientes.
Este foi um pacote de código-fonte curto, portanto, ele não testa a janela de contexto de 1M.
Avaliação do cartão: extração limpa com a contagem solicitada e o limite de evidência do memorando de origem preservado.
É possível obter uma saída legível por máquina sem precisar fazer limpeza?
Configuração da tarefa
Retorne um objeto JSON fixo contendo um título, um público-alvo, dois pontos positivos, dois pontos negativos e um veredicto. Não foi permitido o uso de balizas de Markdown.
Retornou um JSON analisável com as chaves solicitadas, dois pontos positivos, dois pontos negativos e uma recomendação concisa. Não havia nenhum contêiner Markdown.
Uma resposta válida não comprova a confiabilidade do esquema em objetos maiores ou aninhados.
Avaliação do cartão: A conformidade literal com o JSON foi aprovada nesta execução.
Será que ele consegue aplicar corretamente uma regra de arredondamento repetido?
Configuração da tarefa
Comece com 12 itens, multiplique cada lote seguinte por 1,25, arredonde para baixo após cada lote e informe o total das quatro séries.
Retornou 12, 15, 18 e 22 e, em seguida, somou esses valores para obter 67. Os cálculos intermediários estavam visíveis.
A tarefa é determinística e de pequena escala; ela não reflete o desempenho geral em raciocínio.
Avaliação do cartão: resultado correto e etapas intermediárias transparentes.
A rota testada retornou um texto em chinês que pudesse ser utilizado?
Configuração da tarefa
Elabore uma introdução para uma resenha em chinês que separe as alegações oficiais, o preço, as evidências de referência e os testes práticos.
A estrutura da resposta estava presente, mas os caracteres chineses apareceram distorcidos no resultado salvo, na rota testada.
Os dados não distinguem a qualidade da linguagem do modelo do comportamento de rota ou de codificação. Não é atribuída nenhuma pontuação de qualidade para o chinês.
Avaliação do cartão: O texto retornado nesta rota está inválido; execute novamente com um caminho UTF-8 verificado antes de fazer qualquer afirmação sobre a qualidade do idioma.
Nas quatro execuções em idioma neutro ou em inglês, a média local foi de 6,24 segundos. Esse número refere-se a cinco solicitações sequenciais em uma rota e não representa a latência do lado do provedor. Os comportamentos mais destacados observados foram a extração concisa, a conformidade literal com JSON e a aritmética correta; as duas questões não resolvidas foram a pressão do orçamento de saída sobre a codificação e a saída em chinês ilegível na rota testada.
Considerações sobre API e migração
A resposta rápida inclui esses fatores porque eles podem alterar uma integração, mesmo quando a qualidade do texto do modelo parece boa.
- O pensamento está sempre em ação. Utilize o parâmetro de esforço documentado para controlar a profundidade, a latência e o custo; não há como desligá-lo.
- O uso forçado da ferramenta gera um erro. O código existente que exige a seleção obrigatória de ferramentas precisa de um teste de migração específico.
- Os blocos de pensamento estão ligados ao modelo e à conversa. Não presuma que um bloco lógico possa ser reutilizado após a troca de modelos.
computador_20251124não é aceito sobre a API Claude e a rota do Google Cloud indicadas na documentação.- Os limites máximos de produção são importantes. O cartão de codificação mostra que uma resposta útil ainda pode ser interrompida por um pequeno
max_tokensvalor. - Os modos em lote e rápido são formas distintas de cobrança. Mantenha os descontos ou sobretaxas separados dos preços padrão dos tokens.
Veredicto baseado em evidências
O Claude Opus 5.5 apresenta fortes evidências de benchmarks públicos datados e uma taxa padrão de API publicada inferior aos números do Opus 5 apresentados no anúncio do Anthropic. Nas cinco execuções de tarefas registradas, ele produziu extração precisa, JSON rigoroso e cálculos aritméticos; a resposta de codificação foi útil, mas truncada pelo limite máximo inicial; e a saída em chinês não foi utilizável pela rota testada.
A conclusão que se pode defender é, portanto, restrita: o modelo demonstrou um forte aprendizado em várias tarefas de pequena escala, enquanto a rota e a configuração apresentaram limites visíveis. Qualquer decisão de migração deve repetir os mesmos comandos com um orçamento de saída adequado, verificar as chamadas de ferramentas e manter as taxas oficiais de tokens separadas dos créditos de assinatura ou da plataforma.
Se você quiser uma segunda rota para comparação, a Formato de teste DeepSeek V4 Pro vs Flash mostra como os veredictos no nível da tarefa podem permanecer separados das afirmações relativas ao modelo como um todo. O Guia de casos de uso do GPT-5.5 acrescenta um ponto de referência voltado para as tarefas, enquanto Notas sobre o teste de desempenho do Gemini Flash e o Guia de comparação de modelos de IA fornecer o contexto do modelo mais próximo. Para acesso a múltiplos modelos, consulte assinaturas de IA com tudo incluído e a comparação entre plataformas multimodelo.
Perguntas frequentes
Quanto custa o Claude Opus 5.5?
A taxa oficial da API é de $4 por milhão de tokens de entrada e $20 por milhão de tokens de saída. As leituras do cache custam $0,20 por milhão de tokens, e as gravações no cache a cada 5 minutos custam $5 por milhão de tokens.
O que é a janela de contexto Claude Opus 5.5?
A documentação da plataforma Claude indica uma janela de contexto de 1 milhão de tokens e uma saída máxima de 128 mil tokens. Uma versão beta documentada separadamente suporta até 300 mil tokens de saída para lotes de mensagens.
O Claude Opus 5.5 é melhor que o Opus 5?
O Anthropic apresenta um custo típico de carga de trabalho menor e uma produção mais rápida, enquanto avaliações independentes mostram resultados sólidos em diversas tarefas antigas. A magnitude de qualquer ganho de qualidade depende do benchmark, da configuração de esforço, do prompt e da rota.
É possível desligar o pensamento?
Não. A documentação atual do modelo indica que o raciocínio adaptativo está sempre ativado. Use o parâmetro de esforço para controlar a profundidade do raciocínio, a latência e o custo.
As cinco tarefas da API demonstraram confiabilidade?
Não. Os cartões mostram comportamentos concretos e limites de configuração, mas cinco tarefas não são suficientes para estimar uma taxa geral de sucesso. As questões relacionadas ao teto de codificação e à rota chinesa são relatadas separadamente.
Essa análise comprovou a qualidade chinesa?
Não. A rota testada retornou um texto em chinês ilegível; portanto, o resultado foi registrado como um problema de codificação ou de rota, aguardando uma nova execução com codificação UTF-8 verificada.