
Resposta rápida: O GPT-6 Luna é o modelo da OpenAI voltado para tarefas de alto volume. A API oficial indica $0,10 por 1 milhão de tokens de entrada e $0,50 por 1 milhão de tokens de saída nas tarifas padrão, com uma janela de contexto de 1,05 milhão de tokens e saída máxima de 128 mil. A questão mais importante na decisão de compra é se as respostas atendem aos requisitos da sua tarefa a um custo total aceitável.
A OpenAI descreve o GPT-6 Luna como seu modelo mais eficiente para tarefas específicas e de alto volume. Essa afirmação reflete o posicionamento do provedor, não uma pontuação de qualidade mensurada. Esta análise traduz as especificações publicadas em decisões de compra e arquitetura e, em seguida, registra a reação do público com a devida atribuição. Também executamos três pequenas tarefas, mantendo o ID do modelo, a rota, o conjunto de prompts, a saída bruta e o uso. Os resultados das tarefas são apresentados abaixo como uma execução observada, e não como um benchmark oficial.
Opinião rápida
A Luna é a opção pragmática que prioriza o custo na tabela de preços oficial: ela mantém o mesmo contexto geral e os mesmos limites máximos de saída que a Sol, mas cobra uma fração das taxas dos tokens. Isso a torna atraente para chamadas específicas e repetidas, mas o preço baixo não é garantia de menor latência ou qualidade inferior sem um teste controlado.
A distinção mais útil não é simplesmente entre “inteligente” e “rápido”. É a forma da carga de trabalho. O GPT-6 Luna tem os mesmos limites máximos de contexto e saída que seu irmão, mas seu posicionamento e preço tornam sensato um ponto de operação diferente. Compare o mais amplo Guia de seleção de modelos de IA e o melhor modelo de IA para codificação orientação para quando a tarefa envolver mais de um provedor.
Visão geral do GPT-6 Luna
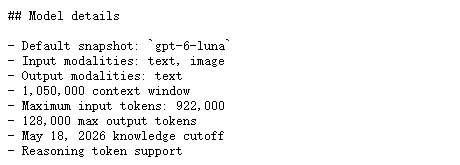
A tabela abaixo segue o atual página oficial do modelo GPT-6 Luna. A capacidade de contexto não é a mesma coisa que o tamanho recomendado para o prompt, e a entrada máxima é independente da janela de contexto do título.
gpt-6-lunaAmbos os modelos irmãos oferecem suporte a saídas estruturadas, chamada de funções, streaming, armazenamento em cache de prompts, entrada de imagens, pesquisa de arquivos e pesquisa na web, conforme descrito no conjunto de recursos documentado. O comportamento exato da ferramenta ainda depende da configuração do endpoint, da conta e da solicitação; não se deve inferir que a execução da ferramenta foi bem-sucedida apenas com base na marcação de uma caixa de seleção de recurso.
No que diz respeito ao contexto familiar, o Análise do GPT-6 Astra mostra como um artigo relacionado ao GPT-6 separa a documentação do provedor, as rotas da plataforma e as reações atribuídas.
Preços do GPT-6 Luna e a regra dos 272 mil
De acordo com as tarifas padrão, o Página de preços do OpenAI apresenta $0,10 de entrada, $0,01 de entrada em cache, $0,125 de gravações em cache e $0,50 de saída por 1 milhão de tokens. As gravações em cache correspondem a 1,25 vezes a entrada sem cache. Os modos Batch e Flex têm preço de 501 TP40T do Standard; o modo Fast custa 2x a taxa aplicável; e o processamento regional acrescenta 101 TP40T, quando disponível.
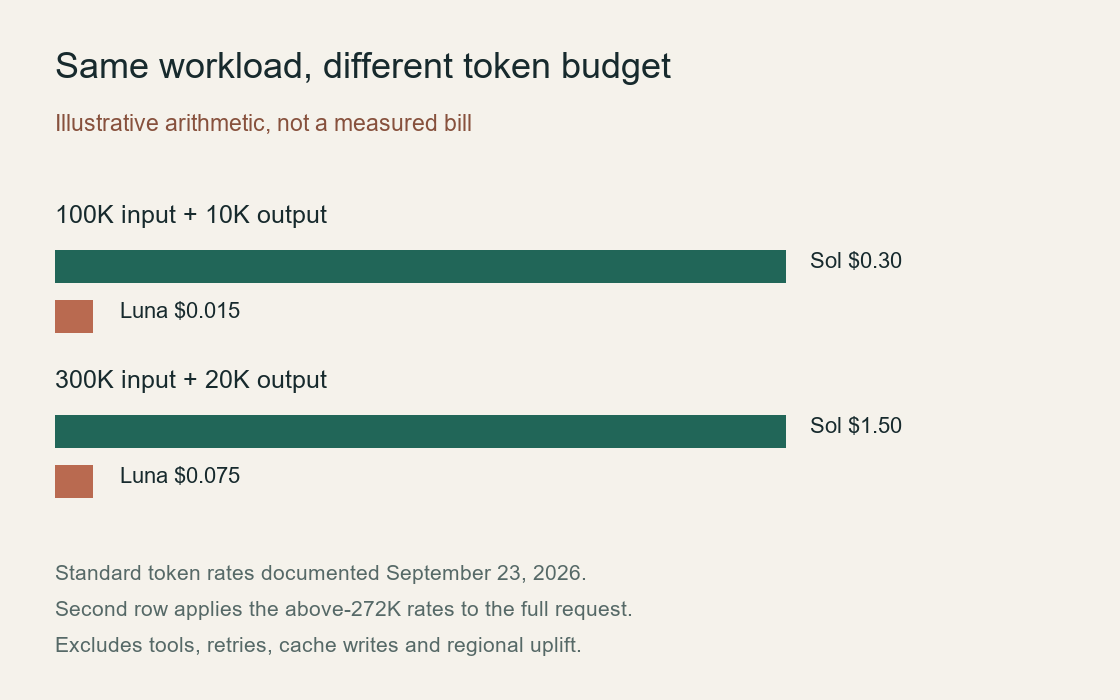
A coluna “contexto longo” é calculada com base na regra do OpenAI: acima de 272 mil de entrada, as taxas de entrada e de cache dobram, e a saída é multiplicada por 1,5 para a solicitação completa. Não se trata de uma cobrança com taxas mistas. Para uma referência prática de orçamento, 100 mil de entrada mais 10 mil de saída custam cerca de $0.015 antes das ferramentas ou do aumento regional; um exemplo com entrada de 300 mil e saída de 20 mil custa cerca de $0.075 com base nas taxas de contexto longo.
Uma janela de contexto ampla pode ser útil, mesmo que não seja fácil preenchê-la. A recuperação, a seleção de blocos, a reutilização do cache e os limites de saída são mais importantes do que o número de 1,05 milhão apresentado na manchete. Consulte o Detalhamento dos preços do GPT-6 Astra para uma explicação relacionada aos limites de contexto e ao funcionamento do cache.
Adaptação, ferramentas e limites da API do GPT-6 Luna
O OpenAI recomenda a API Responses para ferramentas integradas e chamadas de função. O Chat Completions suporta chamadas de função apenas quando esforço_de_raciocínio está definido como nenhum. Esse é um detalhe de implementação que vale a pena observar antes da migração: uma solicitação pode ser sintaticamente válida, mas não corresponder ao comportamento da ferramenta que sua integração atual espera.
A tabela atual de limites de taxa apresenta os seguintes níveis padrão. RPM significa solicitações por minuto, TPM significa tokens por minuto e o valor da fila é o limite de tokens por lote.
Antes de iniciar a produção, verifique o nível exato, o endpoint, o modo de streaming e o contrato da ferramenta em sua própria conta. O Guia de limites de uso do Codex é um contexto útil para explicar por que o limite máximo publicado de um modelo não é o mesmo que a cota ativa de uma conta.
O que as especificações do GPT-6 Luna sugerem
Este é um mapa de ajuste, não um ponto de referência. Use o Guia de fluxo de trabalho para modelos de IA “tudo em um” quando a sua verdadeira decisão é como alternar entre modelos dentro de um processo repetível, em vez de qual modelo específico parece mais convincente.
Em nossos testes: o GPT-6 Luna em três tarefas práticas
Testamos uma pequena correção em JavaScript, um memorando de decisão com três pontos e a extração de JSON em 23 de setembro de 2026. Os resultados apresentados a seguir são respostas completas para o ID do modelo gpt-6-luna. Tentativas anteriores encontraram erros temporários de sobrecarga; portanto, esses resultados não devem ser interpretados como medições de confiabilidade da primeira tentativa. Analisamos o que as respostas contêm, o que um leitor pode reutilizar e o que ainda não foi testado.
Correção de código: preservando o valor zero sem reescrever a função
A tarefa de programação exigia o diagnóstico de um bug, um patch mínimo e dois testes de regressão. O resultado apresentado é a tentativa repetida concluída; o texto exato do prompt não está disponível.
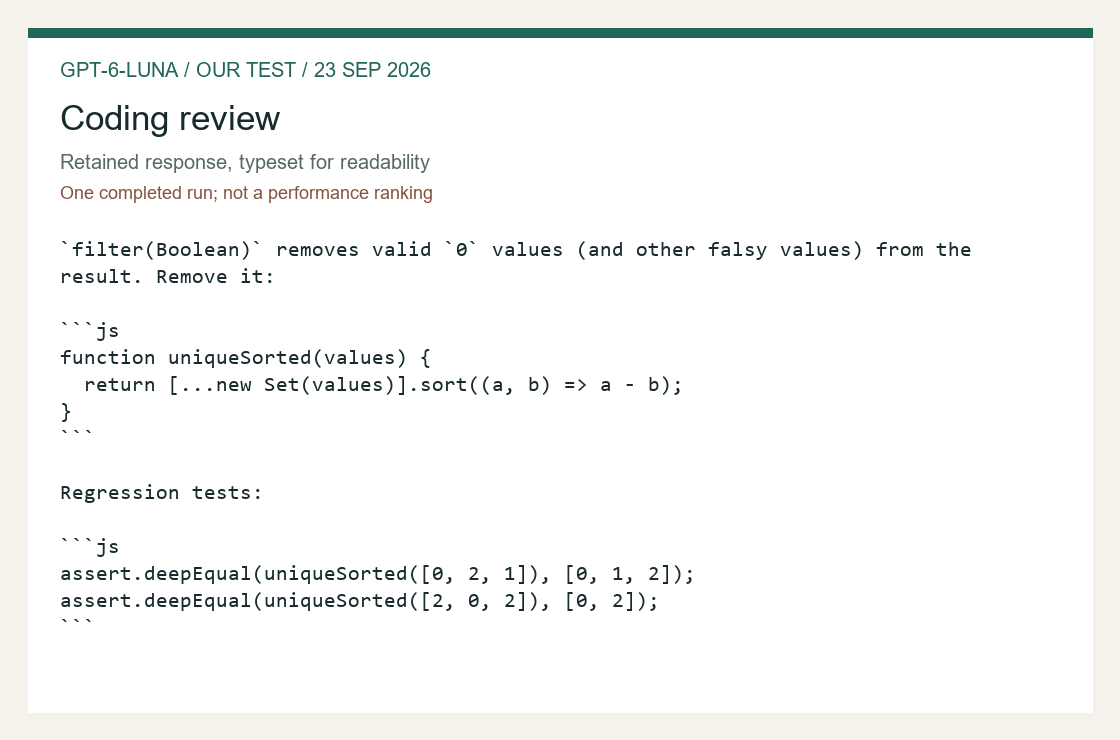
`filter(Boolean)` remove os valores `0` válidos (e outros valores que retornam falso) do resultado. Remova-o:

```js
function uniqueSorted(values) {
  return [...new Set(values)].sort((a, b) => a - b);
}
```

Testes de regressão:

```js
assert.deepEqual(uniqueSorted([0, 2, 1]), [0, 1, 2]);
assert.deepEqual(uniqueSorted([2, 0, 2]), [0, 2]);
```
Uso relatado para esta resposta concluída: 61 tokens de entrada, 317 tokens de conclusão, 378 tokens no total. O uso do preenchimento pode incluir tokens de raciocínio; não se trata apenas do comprimento da resposta visível.
A resposta completa de Luna identificou corretamente que filtro(Booleano) exclui valores zero válidos e removeu essa operação final. A resposta manteve a deduplicação baseada em conjuntos e o comparador numérico já existentes. Para um ticket de manutenção com escopo restrito, esse é um formato de saída útil: uma breve explicação seguida pela função exata. Não houve nenhuma reformulação desnecessária da API, nova dependência de pacote ou ajuste de formatação não relevante que obscurecesse o reparo.
A falha na integração está nos testes. Luna usou assert.deepEqual duas vezes, mas não incluiu uma importação de assert. Colar essas instruções em um novo arquivo Node.js resultaria em falha antes mesmo de qualquer uma das asserções ser executada. As próprias asserções visam combinações relevantes de zero, ordenação e duplicatas, mas o exemplo não é autônomo. Adicione uma importação de assertiva estrita ou adapte as instruções ao seu executor de testes existente. Trata-se de uma pequena correção, mas ilustra por que uma resposta de código plausível e um artefato pronto para execução são critérios de aceitação diferentes.
A resposta de codificação mantida é uma nova tentativa. Uma tentativa anterior atingiu seu limite de saída de 900 tokens; a nova tentativa concluída utilizou um prompt mais curto e um limite de 1.200 tokens. O texto exato da nova tentativa não foi registrado, portanto, não apresentamos o prompt de codificação original como se ele tivesse gerado essa resposta. Isso impede uma comparação direta e precisa de qualidade ou latência com o Sol. Além disso, isso oferece uma lição prática de implantação: registre a versão do prompt e o motivo da conclusão, e nunca trate uma resposta truncada como uma correção de código bem-sucedida.
Síntese de três notas: mantendo a decisão condicional
Sintetize as três notas a seguir em um memorando de decisão conciso, incluindo: decisão, evidências, riscos e próximo passo. Nota A: Uma janela de contexto de 1,05 milhão de tokens pode acomodar grandes conjuntos de dados de origem, mas não torna todas as solicitações econômicas. Nota B: Acima de 272 mil tokens de entrada, as taxas documentadas de entrada/cache aumentam e a saída é multiplicada para a solicitação completa. Nota C: A recuperação e a reutilização do cache podem reduzir o custo de prompts repetidos, mas os critérios de aceitação ainda precisam ser testados.
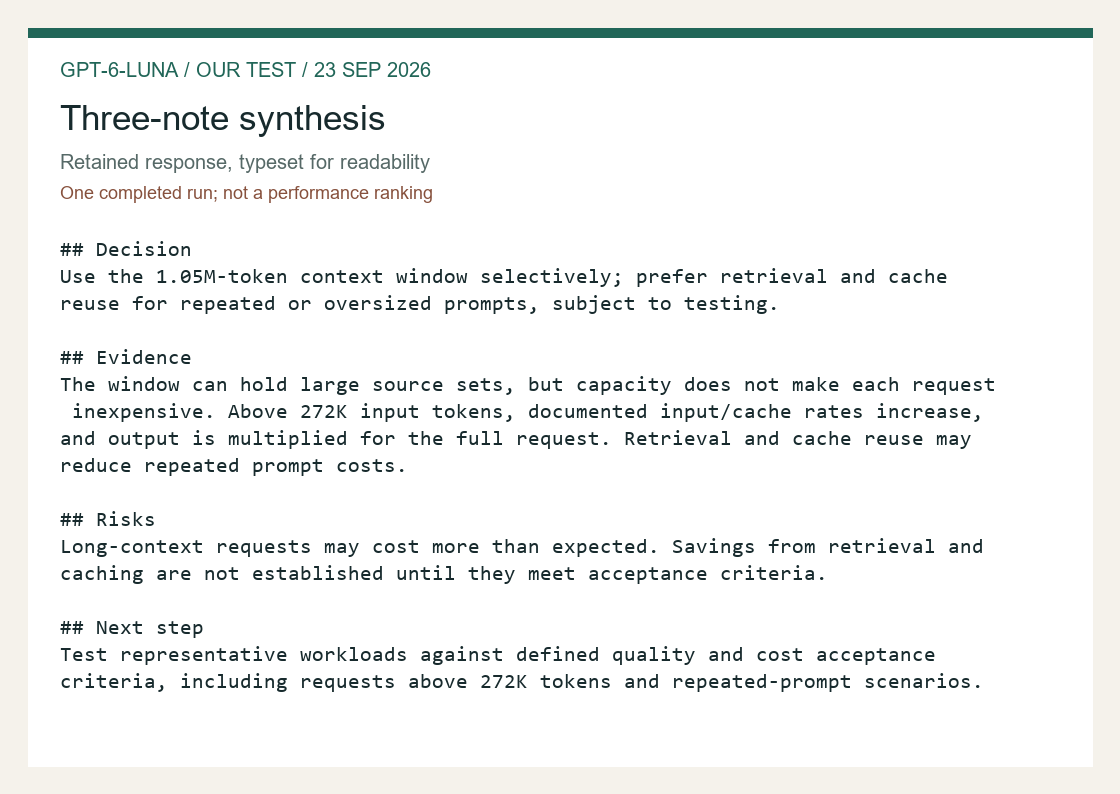
## Decisão
Utilize a janela de contexto de 1,05 milhão de tokens de forma seletiva; dê preferência à recuperação e à reutilização do cache para prompts repetidos ou muito grandes, sujeito a testes.

## Evidência
A janela pode conter grandes conjuntos de fontes, mas a capacidade não torna cada solicitação econômica. Acima de 272 mil tokens de entrada, as taxas documentadas de entrada/cache aumentam, e a saída é multiplicada para a solicitação completa. A recuperação e a reutilização do cache podem reduzir os custos de prompts repetidos.

## Riscos
Solicitações com contexto longo podem custar mais do que o esperado. As economias decorrentes da recuperação e do armazenamento em cache não são comprovadas até que atendam aos critérios de aceitação.

## Próximo passo
Teste cargas de trabalho representativas em relação a critérios definidos de aceitação de qualidade e custo, incluindo solicitações acima de 272 mil tokens e cenários de prompts repetidos.
Uso relatado para esta resposta concluída: 99 tokens de entrada, 223 tokens de conclusão, 322 tokens no total. O uso do preenchimento pode incluir tokens de raciocínio; não se trata apenas do comprimento da resposta visível.
A Luna manteve todas as quatro seções do memorando solicitadas e condicionou sua recomendação à realização de testes. Ela preservou a distinção entre manter um grande conjunto de fontes e processá-lo de forma econômica. Além disso, afirmou que as economias relacionadas à recuperação e ao armazenamento em cache não são comprovadas até que atendam aos critérios de aceitação. Essa cautela é útil para resumos internos recorrentes, nos quais uma recomendação atraente pode, de outra forma, tornar-se uma promessa sem fundamento após várias rodadas de reescrita.
A tarefa continha três notas curtas e apenas 99 tokens de prompt registrados. Chamar isso de benchmark de contexto longo seria exagerar o que aconteceu. A resposta mostra que o Luna consegue organizar um pequeno conjunto de evidências fornecidas nesta execução; ele não demonstra recall de recuperação, cobertura de documentos, resistência a instruções conflitantes nem precisão próxima ao tamanho máximo de entrada. Antes de usá-lo para resumos recorrentes, inclua casos com datas contraditórias e proprietários ausentes e, em seguida, verifique se a incerteza persiste na redação final.
Extração de JSON: mantendo as incógnitas explícitas
Extraia os seguintes campos deste briefing e retorne apenas um JSON válido com as chaves customer, priority, deadline e unknowns. Briefing: Cliente: Northwind Labs. Prioridade: alta. Prazo: 04/10/2026. O responsável não está identificado e o orçamento não está confirmado.
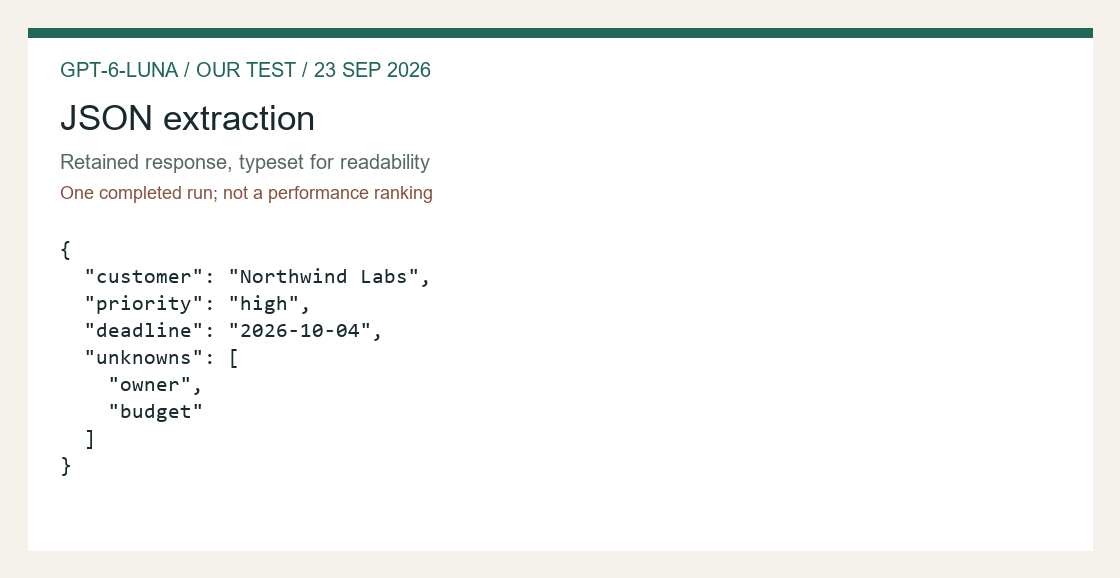
{"cliente":"Northwind Labs","prioridade":"alta","prazo":"04/10/2026","incógnitas":["responsável","orçamento"]}Uso relatado para esta resposta concluída: 64 tokens de entrada, 63 tokens de conclusão, 127 tokens no total. O uso do preenchimento pode incluir tokens de raciocínio; não se trata apenas do comprimento da resposta visível.
O resultado da extração é o argumento concreto mais forte, nesta pequena amostra, para considerar o Luna em tarefas específicas e repetitivas. Ele retornou um JSON válido com as chaves solicitadas, copiou corretamente o Northwind Labs e o prazo no formato ISO, e manteve “proprietário” e “orçamento” como valores desconhecidos. Não havia nenhum prefixo conversacional a ser removido. O Sol produziu o mesmo JSON na mesma solicitação de extração; portanto, as evidências disponíveis não indicam uma vantagem do modelo mais caro neste registro.
A validade sintática é apenas a primeira barreira. Um analisador JSON aceitará sem problemas um proprietário inventado, um cliente errado ou uma data que pareça válida, mas esteja incorreta. Um esquema pode restringir campos e tipos; ele não pode provar que o conteúdo segue a fonte. Para essa tarefa, comparar os três valores conhecidos com o briefing e verificar se os dois campos ausentes permanecem desconhecidos constitui a barreira semântica. Em grande escala, encaminhe conflitos e datas incertas para revisão, em vez de corrigi-los com base em suposições.
Uma verificação de validação que vai além do JSON analisável
O que se segue é um exemplo de validação editorial, não uma resposta adicional do modelo. Ele é executado localmente no Node.js e não faz nenhuma solicitação ao modelo. Ele verifica o fixture específico discutido acima; não se trata de uma avaliação geral do modelo.
const assert = require('node:assert/strict');
const resposta = '{"cliente":"Northwind Labs","prioridade":"alta","prazo":"2026-10-04","desconhecidos":["proprietário","orçamento"]}';
const value = JSON.parse(response);
assert.deepStrictEqual(Object.keys(value).sort(), ['customer','deadline','priority','unknowns']);
assert.equal(value.customer, 'Northwind Labs');
assert.equal(value.priority, 'alta');
assert.equal(value.deadline, '2026-10-04');
assert.deepStrictEqual(value.unknowns, ['owner', 'budget']);
console.log('Este fixture está de acordo com o briefing. Novas entradas precisam de seus próprios valores esperados.');
O validador verifica deliberadamente os dados esperados, bem como o conjunto de chaves. Ele rejeitará uma resposta que adicione um campo “owner” com valor “confident” ou altere a data, mesmo que continue sendo um JSON válido. Esses valores exatos pertencem a este fixture; um validador de produção deve obter as expectativas a partir do contrato de entrada, e não codificar “Northwind Labs” para cada cliente. A validação do calendário e a permissão para atualizar um registro são verificações distintas. Ser aprovado neste exemplo significa que a resposta obtida está de acordo com este resumo, e não que todas as extrações futuras estarão corretas.
Como o GPT-6 Luna transforma um fluxo de trabalho real
As especificações principais só importam quando alteram a forma como uma equipe trabalha. O GPT-6 Luna está posicionado para tarefas específicas e de alto volume; portanto, a primeira questão é se a sua carga de trabalho se beneficia desse perfil. Se cada solicitação tiver uma entrada curta, um contrato de saída restrito e um teste de aceitação claro, o modelo pode ser integrado a um pipeline repetível. Se a tarefa for ambígua, exigir muitas ferramentas ou provavelmente requerer várias rodadas de correção, a orquestração em torno dela é tão importante quanto o nome do modelo.
Para o GPT-6 Luna, um padrão de produção útil é um processo em duas etapas: primeiro, solicite uma resposta concisa com incerteza explícita; depois, envie apenas a parte contestada ou incompleta para uma segunda etapa. Isso limita o desperdício de tokens de saída e torna a falha visível. Além disso, oferece um ponto de comparação melhor em relação ao GPT-6 Sol: a questão não é qual nome soa mais forte, mas qual rota atinge os critérios de aceitação com menos tentativas.
Um modelo de custos simples antes do envio
A tabela oficial de preços deve ser convertida para as unidades que sua equipe realmente adquire: solicitações por dia, média de tokens de entrada, participação no prefixo em cache, tokens de saída e a porcentagem de chamadas que ultrapassam 272 mil de entrada. Uma planilha que registra apenas o preço de entrada nominal oculta o multiplicador de contexto de longo prazo e o custo das tentativas de repetição.
Esse cálculo é especialmente relevante ao comparar o GPT-6 Luna com o GPT-6 Sol. Uma solicitação mais barata pode se tornar cara se precisar de várias iterações de correção; uma solicitação mais avançada pode representar um desperdício quando a tarefa envolve extração determinística. A linha de base adequada é uma pequena amostra do seu próprio tráfego, com os mesmos prompts, o mesmo esquema e a mesma regra de revisão.
Modos de falha a serem verificados antes da adoção
Uma página de modelo pode indicar quais endpoints e modalidades estão documentados, mas não pode garantir que seu aplicativo atual se comportará da mesma forma após a migração. Verifique se os eventos de streaming são analisados corretamente, se as chamadas às ferramentas preservam o estado entre as tentativas, se a saída estruturada rejeita campos malformados e se seu pipeline de registro em log registra o ID do modelo e a configuração de raciocínio para cada solicitação.
Esses mesmos critérios tornam as observações práticas desta análise úteis, sem transformá-las em um ranking. Nossas três tarefas mostram como a plataforma lidou com um pequeno defeito de código, um memorando de decisão e uma extração rigorosa de JSON. Elas não determinam a latência, a confiabilidade em escala nem um ranking universal de qualidade.
Um modelo de tomada de decisão para equipes reais
A revisão de um modelo é útil quando ajuda alguém a tomar uma decisão sob restrições. Para o GPT-6 Luna, as restrições mais relevantes são o formato da solicitação, o custo da revisão, o tamanho do contexto, o formato da saída e as consequências de uma resposta errada. A descrição do provedor aponta para tarefas específicas e de alto volume, mas a equipe ainda precisa transformar essa descrição em um plano de ação que possa ser monitorado. Comece definindo a tarefa em uma única frase, a entrada que o modelo receberá, a saída esperada por outro sistema e o ponto de verificação humano que evita erros ocultos.
O primeiro erro é escolher um modelo a partir de um prompt de demonstração. Uma demonstração valoriza a fluência e oculta detalhes operacionais, como novas tentativas, contagem de tokens, permissões de ferramentas e falhas de esquema. Uma comparação mais adequada utiliza três tarefas representativas: uma solicitação comum, uma solicitação difícil e uma solicitação que deve ser rejeitada ou encaminhada para um nível superior. O resultado não é uma pontuação única. Trata-se de um pequeno mapa que mostra onde o modelo economiza tempo, onde precisa de supervisão e onde outro modelo — frequentemente o GPT-6 Sol — é a opção mais econômica ou segura.
Comece pelo teste de aceitação
Escreva o teste de aceitação antes de escrever o prompt. No caso de código, o teste pode ser um teste de unidade aprovado ou um patch que não altere a API pública. Para extração de dados, pode ser um JSON válido, com todas as chaves obrigatórias presentes e valores desconhecidos preservados explicitamente. Para um memorando de decisão, pode ser uma estrutura fixa contendo evidências, riscos, responsável e próximo passo. O modelo só pode ser avaliado em relação a uma meta visível. Sem essa meta, um parágrafo bem elaborado pode parecer bem-sucedido, embora omita discretamente o único campo de que o processo posterior precisa.
Um bom teste de aceitação é específico o suficiente para ser executado automaticamente e significativo o suficiente para proteger o usuário. Ele também deve tornar as divergências claras. Se dois resultados forem diferentes, a equipe deve ser capaz de identificar um fato ausente, uma suposição sem fundamento, um campo preenchido incorretamente ou um cálculo errado. Isso é mais prático do que dizer que uma resposta “parecia mais inteligente”. É também a diferença entre uma revisão que auxilia o processo de aquisição e uma revisão que se limita a repetir o discurso de lançamento.
Use o nome do modelo para escolher uma hipótese inicial. Use seu teste de aceitação para decidir se a hipótese se mantém válida ao ser implementada em produção.
Projeto de prompt que se adapte ao perfil do modelo
A mesma solicitação não deve ser copiada sem alterações entre todos os modelos. O contrato da tarefa pode permanecer estável, mas a quantidade de contexto, as instruções de raciocínio e as restrições de saída devem corresponder à rota. Para o GPT-6 Luna, mantenha a instrução do sistema curta o suficiente para que ela não entre em conflito com o material de origem. Especifique a função, a regra de decisão, o formato de saída exigido e as condições que exigem uma incógnita explícita ou uma escalação.
Para documentos longos, separe a extração de informações da avaliação. Primeiro, identifique as passagens que respondem à pergunta; depois, solicite a conclusão utilizando apenas essas passagens e os critérios estabelecidos. Isso reduz a chance de que uma frase com alto grau de confiança seja construída a partir de um detalhe distante e irrelevante. Além disso, faz com que uma janela de contexto de 1,05 milhão de tokens seja uma ferramenta, em vez de um padrão padrão. Um contexto amplo é valioso quando a relação entre evidências distantes é importante. É um desperdício quando a tarefa pode ser resolvida com um conjunto pequeno e bem selecionado.
Para fluxos de trabalho que utilizam ferramentas, descreva o limite entre o modelo e a ferramenta. O modelo deve determinar se uma ferramenta é necessária, fornecer argumentos em um esquema rígido e explicar o que fará com o valor retornado. O aplicativo deve aplicar permissões, validar argumentos, registrar a chamada e decidir se uma chamada de ferramenta com falha pode ser repetida. Tratar o modelo como se fosse o aplicativo inteiro dificulta a depuração e aumenta o alcance de uma suposição incorreta.
Um modelo reutilizável de quatro partes
Contexto: apresente apenas os fatos e documentos necessários para a tarefa. Objetivo: descreva a decisão ou a transformação em uma frase. Restrições: especificar o formato, as exclusões, o tratamento da incerteza e os limites da ferramenta. Verifique: peça ao modelo para listar os dados que faltam ou as contradições antes de finalizar a resposta. Essa estrutura é concisa o suficiente para chamadas repetidas e clara o suficiente para permitir comparações entre modelos.
Quando uma janela de contexto ampla ajuda
A referência aos 1,05 milhão de tokens é fácil de repetir e fácil de usar incorretamente. Uma janela de contexto informa a quantidade de material que cabe em uma solicitação; ela não informa quanto material deve ser enviado, com que eficiência o modelo utilizará cada trecho nem quanto custará a solicitação. Uma solicitação longa também pode tornar a revisão mais lenta, pois a equipe tem mais evidências para analisar e mais margem para um conflito sutil de instruções.
Use a janela completa quando a tarefa depender efetivamente de referências distantes: um contrato com definições separadas das exceções, um repositório em que interfaces e implementações estejam distantes umas das outras ou um extenso arquivo de pesquisa em que a resposta exija o rastreamento de uma sequência. Use a recuperação quando a questão for local, quando o conjunto de fontes mudar com frequência ou quando você desejar um rastro de citações compacto. Use o cache quando um prefixo estável for reutilizado em muitas solicitações e a plataforma expor detalhes de uso suficientes para comprovar que o cache está funcionando.
O limite de 272 mil deve constar no diagrama da arquitetura, e não como uma nota de rodapé no parágrafo sobre preços. Uma solicitação que é segura abaixo desse limite pode se tornar significativamente mais cara acima dele. As equipes devem registrar em log os tokens de entrada, os tokens em cache, os tokens de saída, o ID do modelo, a configuração de raciocínio e se a solicitação ultrapassou o limite. Esse registro de log sustenta um modelo de custo real e possibilita identificar inflações acidentais de contexto antes que elas se tornem uma surpresa mensal.
Perguntas sobre migração de API que merecem um teste em ambiente de preparação
Antes de migrar uma integração existente para o GPT-6 Luna, crie um ambiente de teste que reproduza uma pequena amostra anônima. Compare o texto final, os campos estruturados, as chamadas de ferramentas, os motivos de interrupção e o uso de tokens. Não compare apenas a primeira tela da resposta. Um modelo pode preservar a conclusão visível enquanto altera o nome de um campo, omite uma condição de erro ou retorna um argumento de ferramenta que o aplicativo não pode executar com segurança.
Respostas e Conclusões de bate-papo não são rótulos intercambiáveis em um plano de integração. O suporte a endpoints, as configurações de raciocínio, o comportamento da ferramenta, os eventos de streaming e os objetos de erro afetam o adaptador. Fixe o ID do modelo na configuração, mas mantenha-o visível nos logs e nos relatórios de teste. Quando uma solicitação falha, o registro deve mostrar o endpoint, o modelo, o esforço de raciocínio, a versão do prompt, o tamanho da solicitação e a decisão de repetição da tentativa. Essas evidências permitem que um engenheiro reproduza uma falha, em vez de ficar discutindo se o modelo estava simplesmente tendo um dia ruim.
O processamento em lote altera a economia e o ritmo operacional. Ele pode ser adequado para classificação noturna, preparação de documentos ou uma fila de transformações de baixa urgência. Não é adequado para uma ação interativa que exija uma resposta direta ao usuário. Os modos “rápido” e “regional” também alteram o cálculo do preço. Trate-os como opções de configuração explícitas e reflita-os na planilha de orçamento, em vez de ocultá-los em uma configuração padrão.
Reproduza entradas representativas, valide saídas estruturadas, capture argumentos da ferramenta, compare motivos de interrupção, avalie o uso de tokens e teste um caminho de falha antes de alterar o padrão de produção.
Qualidade, segurança e custo da revisão
Um preço mais baixo do token não significa automaticamente um custo total menor, e um modelo mais caro não produz automaticamente um resultado comercial melhor. O custo total inclui novas tentativas, revisão humana, tratamento de incidentes e o trabalho necessário para reparar dados a jusante. A métrica útil é o custo por resultado aceito, separado por família de tarefas. Uma rota que seja um pouco mais cara por solicitação ainda pode ser vantajosa se reduzir o trabalho de correção em tarefas de alto impacto; uma rota muito barata pode ser decisivamente vantajosa para extração determinística com validação robusta.
O risco deve ser classificado por ação, e não pela marca do modelo. Ler um documento público e redigir um resumo é diferente de alterar um registro de cliente, aprovar um pagamento, excluir dados ou publicar uma declaração jurídica. Coloque as ações irreversíveis sob a supervisão de um ser humano ou em uma segunda etapa de validação independente. Peça ao modelo para identificar incertezas, mas nunca trate uma frase que soe como uma afirmação de confiança como um sistema de permissão.
Questões relacionadas à privacidade e à retenção devem ser abordadas na revisão da implantação. Confirme quais dados são enviados, por quanto tempo os registros são mantidos, quem pode inspecionar as solicitações e se a solicitação contém informações confidenciais ou dados pessoais. Ocultem as informações sempre que possível, minimizem o contexto e mantenham um registro claro dos campos que foram removidos. Esses controles se aplicam independentemente de o modelo ser utilizado por meio de uma API oficial ou de outra via compatível.
Como comparar o GPT-6 Luna com o GPT-6 Sol
Uma comparação justa mantém a tarefa e a regra de aceitação constantes, ao mesmo tempo em que permite que cada modelo utilize seus pontos fortes documentados. Execute o mesmo pacote de entrada, mas registre se um modelo precisa de uma configuração de raciocínio diferente ou de um endpoint diferente. Relate as diferenças de forma clara: um pode produzir um patch mais completo, outro pode ser mais econômico para extrações repetidas e um terceiro pode ser mais fácil de integrar, pois seu contrato de ferramenta é compatível com seu adaptador atual.
Não transforme uma tarefa bem-sucedida em uma classificação geral. Três pequenas tarefas são úteis para identificar questões relacionadas ao fluxo de trabalho, não para comprovar um vencedor universal. Repita a tarefa com várias entradas realistas, inclua pelo menos um caso adversário ou incompleto e decida com antecedência o que conta como aprovação. Se a amostra for pequena demais para sustentar uma conclusão, diga isso. Esse limite aumenta a confiança, em vez de enfraquecer a avaliação.
Uma implementação em etapas que permite reverter a decisão
Comece com tráfego simulado ou uma fila não crítica. Deixe que a nova rota gere uma resposta enquanto a rota existente continua sendo a fonte de referência. Compare a taxa de aceitação, o custo do token, o tempo de revisão e as categorias de falha por um período fixo. Em seguida, migre uma família de tarefas por vez, mantendo um botão de reversão e uma tag de versão imediata. Uma implantação em etapas transforma a escolha de um modelo em uma mudança de engenharia observável, em vez de uma substituição feita em um único dia.
Durante a implantação, fique atento a mudanças que não aparecem em uma simples taxa de aprovação: resultados mais longos, mais chamadas de ferramentas, mais escalações ou mais solicitações que ultrapassam o limite de contexto longo. Um modelo pode parecer preciso, mas, ao mesmo tempo, consumir mais orçamento ou aumentar a carga de trabalho dos operadores. Adicione alertas para essas dimensões e analise-as com as pessoas que realmente lidam com as exceções.
Como é o sucesso
O sucesso é um caminho estável com um custo conhecido, um modo de falha visível e um processo de revisão que as pessoas possam seguir. Isso não exige fingir que o modelo é perfeito. Exige saber quais tarefas ele lida bem, quais precisam de outro caminho e como interrompê-lo ou corrigi-lo quando a entrada estiver incompleta. Esse é o padrão prático por trás das observações e da documentação coletadas nesta revisão.
O que as reações do público podem e não podem revelar
As fontes a seguir são incluídas como reações públicas atribuídas, e não como documentação oficial ou evidência de referência controlada. Seus títulos mostram o que cada criador escolheu testar ou explicar; eles não estabelecem um resultado para todo o mercado.
- Chase AI: O GPT 6 Sol & Luna já chegou (e o 50% está MAIS BARATO!). Encare a forma como a obra foi apresentada e qualquer demonstração como a experiência desse criador, e não como uma referência universal.
- Rob, o especialista em IA: A ChatGPT lançou o GPT-6 Sol e o GPT-6 Luna (novos modelos e agentes da ChatGPT). Encare a forma como a obra foi apresentada e qualquer demonstração como a experiência desse criador, e não como uma referência universal.
- IA com Surya: GPT-6 Soul x Luna x Claude Opus 5.5: Qual você deve usar?. Encare a forma como a obra foi apresentada e qualquer demonstração como a experiência desse criador, e não como uma referência universal.
Há aqui uma questão específica relacionada à nomenclatura: vários vídeos públicos utilizam “GPT-6” e “GPT-5.6” de forma intercambiável nos títulos. Mantenha o ID exato do modelo visível ao reproduzir uma afirmação. O Comparação entre o GPT-6 Astra e o GPT-5.6 Sol é um exemplo útil de por que a identidade do provedor, o rótulo da plataforma e a rota devem ser registrados separadamente.
Como acessar o GPT-6 Luna
Abra o Espaço de trabalho do GPT-6 Luna Comece com uma tarefa que você possa avaliar: um pequeno exemplo de código, um pacote de código-fonte curto ou um briefing estruturado de extração. Mantenha o resultado solicitado e a regra de aceitação visíveis ao comparar as revisões. Os preços oficiais dos tokens acima se referem ao uso direto da API, e não a uma promessa sobre créditos do espaço de trabalho ou cotas de assinatura.
Para obter informações sobre a nomenclatura atual das plataformas e o contexto dos créditos separados, consulte o Guia de preços do GPT-5.6 e o Comparação do modelo GPT-5.6. Essas páginas referem-se ao contexto da plataforma/editorial; elas não se sobrepõem à tabela de preços da API do OpenAI.
Traga uma tarefa representativa e compare o resultado com seus próprios critérios de aceitação.
Abrir o espaço de trabalho do GPT-6 LunaQuem deve optar pelo GPT-6 Luna?
Se sua lista de finalistas incluir alternativas de menor custo, compare as catálogo de modelos mais abrangente em vez de presumir que o modelo mais recente seja automaticamente a melhor opção em termos de custo-benefício. Se você estiver avaliando tarefas que envolvem grande volume de dados, o guia de modelos de análise de dados oferece uma perspectiva específica para o fluxo de trabalho.
Perguntas frequentes
O que é o GPT-6 Luna?
O GPT-6 Luna é o modelo da OpenAI voltado para tarefas específicas e de alto volume. Seu ID oficial de modelo na API é gpt-6-luna.
Quanto custa o GPT-6 Luna?
O OpenAI indica que o GPT-6 Luna custa $0,10 por 1 milhão de tokens de entrada, $0,01 por 1 milhão de tokens de entrada em cache, $0,125 por 1 milhão de gravações no cache e $0,50 por 1 milhão de tokens de saída, de acordo com as tarifas padrão.
O que acontece quando o número de tokens de entrada ultrapassa 272 mil?
Quando uma solicitação ultrapassa 272 mil tokens de entrada, o OpenAI aplica taxas de entrada e de cache duas vezes maiores e taxas de saída 1,5 vezes maiores à solicitação completa.
Quais são os limites de contexto e de saída?
O GPT-6 Luna apresenta uma janela de contexto de 1.050.000 tokens, uma entrada máxima de 922.000 tokens e uma saída máxima de 128.000 tokens.
Qual é o limite mínimo de conhecimento?
A página atual do modelo OpenAI indica 18 de maio de 2026 como a data de corte de conhecimento para o GPT-6 Luna.
Quais configurações de raciocínio estão disponíveis?
A API documenta os níveis de esforço de raciocínio “nenhum”, “baixo”, “médio”, “alto”, “xalto” e “máximo”, sendo “médio” o padrão.
Quais pontos de extremidade da API são compatíveis?
O GPT-6 Luna oferece suporte a “Chat Completions”, respostas e processamento em lote. A página do modelo não indica que os recursos “Realtime”, “Assistants”, áudio, vídeo, geração de imagens, embeddings, ajuste fino, moderação ou “Completions” legadas sejam suportados.
O GPT-6 Luna aceita imagens?
Sim. A página do modelo apresenta entradas de texto e imagens com saída de texto. Isso não significa que seja um modelo de geração de imagens.
O GPT-6 Luna está disponível no GlobalGPT?
Utilize a página dedicada ao modelo GPT-6 Luna, cujo link está acima. Os créditos do Workspace e as cotas dos planos são distintos das tarifas diretas dos tokens de API descritas nesta análise.
Este artigo inclui um benchmark?
Isso inclui três pequenas observações de tarefas, e não um teste comparativo controlado. O Luna precisou de uma orientação de programação revisada na nova tentativa. Esses resultados não determinam um vencedor universal nem o desempenho em grande escala.
Veredicto final
A Luna é a opção pragmática que prioriza o custo na tabela de preços oficial: ela mantém o mesmo contexto geral e os mesmos limites máximos de saída que a Sol, mas cobra uma fração das taxas por token. Isso a torna atraente para chamadas específicas e repetidas, mas o preço baixo não é garantia de menor latência ou menor qualidade sem um teste controlado. Escolha com base nos resultados aceitáveis e no custo operacional total e, em seguida, reavalie a escolha quando sua carga de trabalho mudar.
Verificado em 23 de setembro de 2026. Dados oficiais: OpenAI Developers. Nome da rota na plataforma: GlobalGPT. Reação do público: criadores e publicações mencionados apenas por meio de links, com os devidos créditos.









