

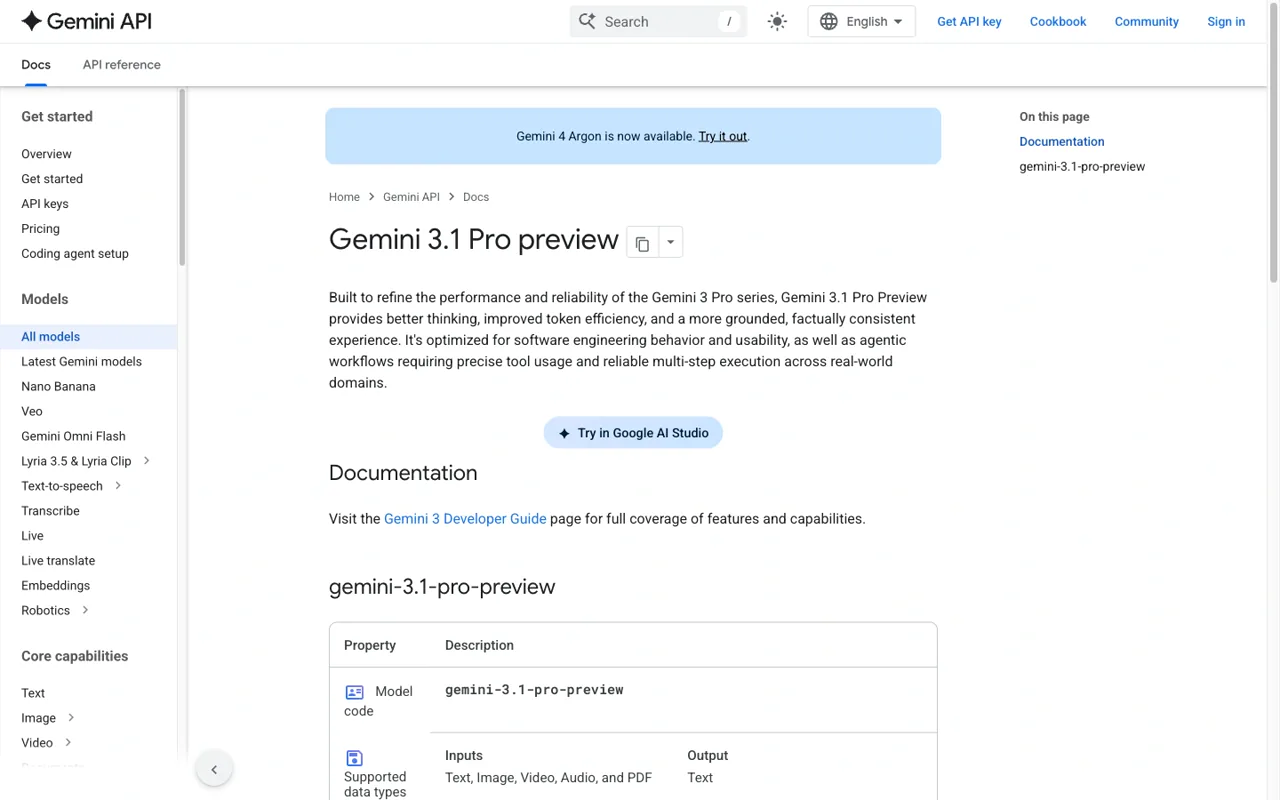
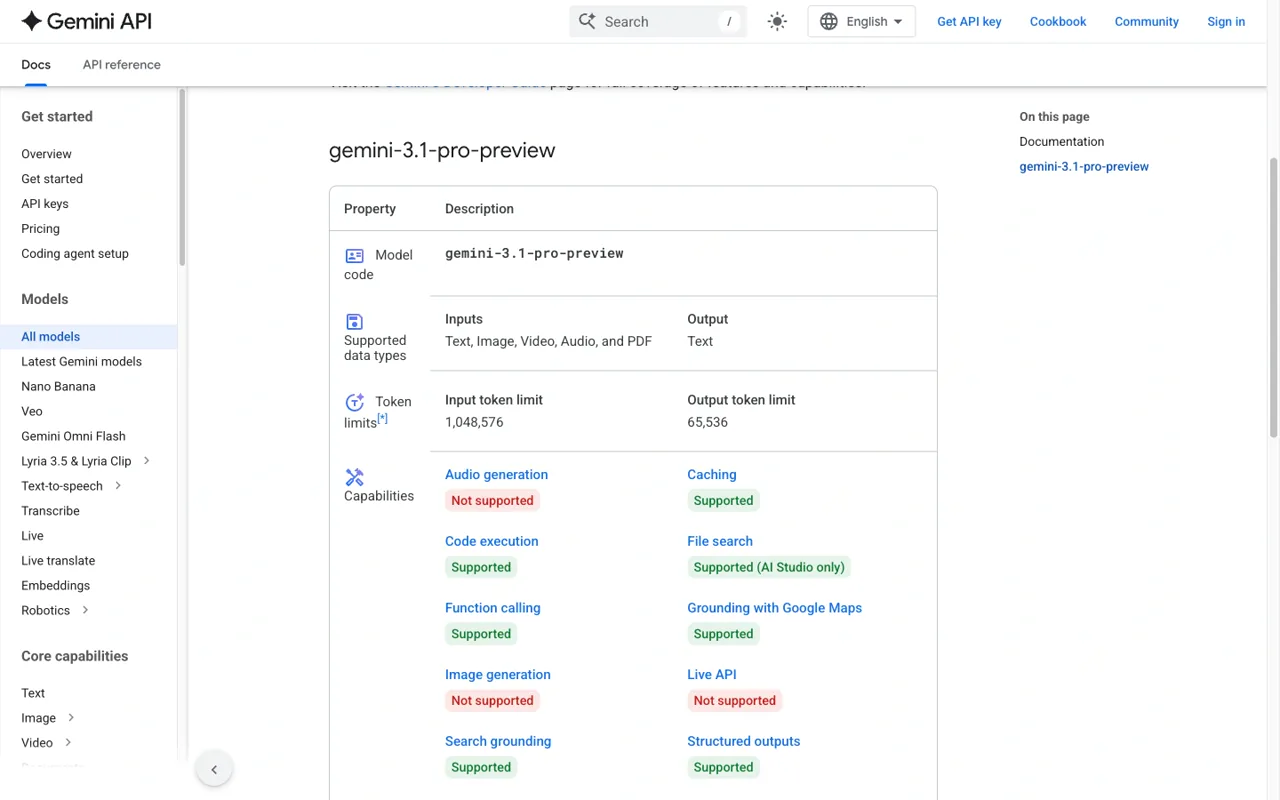
Het duidelijkste cijfer op dit moment is de limiet voor de modelcontext: Gemini 3.1 Pro Preview accepteert maximaal 1.048.576 invoertokens en levert maximaal 65.536 uitvoertokens op. Dat is niet hetzelfde als een API-account zonder beperkingen. Je project kan nog steeds te maken krijgen met een snelheidslimiet, een quotum, een beperking op basis van het facturatieniveau of een gebruikslimiet van Google Gemini Apps.
In deze handleiding worden die lagen van elkaar gescheiden en wordt de oude “bypass”-aanpak vervangen door praktische oplossingen: stel de limiet vast, verkort het verzoek of verdeel het in batches, probeer het opnieuw met een backoff-strategie als er sprake is van een transportprobleem, en kies de juiste route voor de taak.
Als je een langdurige programmeer- of onderzoeksworkflow moet voortzetten terwijl één verbinding wordt afgeremd, GlobalGPT brengt Gemini 3.1 Pro samen met andere modellen en AI-functies onder in één werkruimte. De API, CLI, MCP en Yukie-agent-routes zijn handig wanneer een taak een herhaalbare overdracht vereist; ze hebben geen invloed op de eigen quota van Google.
Wat zijn de beperkingen van de Gemini 3.1 Pro?
| Grenslaag | Huidig bewijs | Wat het regelt |
|---|---|---|
| Context van de modelinvoer | 1.048.576 tokens | Hoeveel tekst, media en gesprekscontext één verzoek kan bevatten. |
| Modelresultaten | 65.536 tokens | Hoeveel tekst, inclusief eventuele ‘thinking tokens’, een antwoord kan bevatten. |
| Prijsgrens voor API’s | 200.000 invoertokens | Welke in- en uitvoersnelheden gelden voor het standaard betaalde abonnement?. |
| Projectquotum | Hangt af van de facturering en quota van Google Cloud / AI Studio | Hoeveel verzoeken of tokens het project binnen een bepaalde periode kan verzenden. |
| Gemini: gebruik van apps | Op rekenkracht gebaseerd; wordt elke 5 uur vernieuwd totdat de wekelijkse limiet is bereikt | Toegang tot consumentenapps, functies en gebruik per abonnement. |
Er bestaat niet één specifieke “Gemini 3.1 Pro limit”-schakelaar. Een verzoek kan binnen het contextvenster vallen en toch een 429-foutmelding ontvangen omdat het project te veel verzoeken verstuurt, de quota van het account is opgebruikt of de dienst tijdelijk bezet is.
Beperkingen op tokens en context
Op de modelpagina van Google wordt het eindpunt aangeduid als gemini-3.1-pro-preview. Het accepteert tekst, afbeeldingen, video, audio en PDF-bestanden als invoer en geeft tekst als uitvoer. Op de pagina wordt ondersteuning vermeld voor denkprocessen, caching, het uitvoeren van code, het aanroepen van functies, koppeling met Google Zoeken en Google Maps, URL-context, gestructureerde uitvoer, de Batch API, Flex en prioriteitsopties.


API-limieten en quotumlagen
API-limieten worden vastgesteld op project- en factureringsniveau, en niet alleen op basis van de modelnaam. Raadpleeg de quotapagina van het project voor het aantal verzoeken per minuut, het aantal tokens per minuut, de dagelijkse limieten en het actieve factureringsniveau. Google kan de beschikbare waarden per regio, account en serviceniveau aanpassen, dus een oud cijfer uit een blogartikel is geen betrouwbare indicatie van de huidige quota.
- Toerental: verzoeken per minuut. Bij veel kleine verzoeken kan deze limiet al worden bereikt voordat de tokencapaciteit is opgebruikt.
- TPM: tokens per minuut. Een paar verzoeken met een grote context kunnen dit snel opgebruiken.
- Dagelijks of maandelijks quotum: een toelage voor een langere periode die na een korte herpoging uitgeput kan blijven.
- Factureringsstatus: Voor een project moet facturering mogelijk zijn ingeschakeld om hogere limieten of toegang tot de productomgeving te krijgen.
- Gebruik van het gereedschap: Zoekopdrachten naar gronding, kaarten van gronding, functieaanroepen en andere hulpmiddelen kunnen extra werk en kosten met zich meebrengen.
De prijsdrempel van 200.000 is een factureringsgrens, geen strikte contextlimiet. Een verzoek van 250.000 tokens kan binnen het contextvenster van 1 miljoen vallen, terwijl hiervoor de hogere standaardtarieven in rekening worden gebracht.
Hoe los je een Gemini 3.1 Pro 429-fout op?

- Lees de details van het antwoord. Noteer de model-ID, het project, de statuscode, de waarde voor ‘retry-after’ en de naam van de quota, indien de API deze retourneert.
- Stop de uitbarsting. Verzend hetzelfde verzoek niet herhaaldelijk in een strakke lus; dat kan de duur van de beperking verlengen.
- Probeer het opnieuw met exponentiële backoff. Gebruik een beperkt aantal herpogingen en houd rekening met de Retry-After-instelling, indien aanwezig.
- Verklein de aanvraag. Verkort de tijdlijn, verwijder dubbele bestanden, verlaag het productiebudget of verdeel het werk in fasen.
- Controleer de projectquota en de facturering. Een nieuwe poging kan een quotum dat al is opgebruikt niet herstellen.
- Voer de taak zorgvuldig uit. Bij een interactieve opdracht waarbij de deadline van belang is, kun je de opdracht in een ander model of een andere werkruimte voortzetten, in plaats van te doen alsof de limiet van de aanbieder is verdwenen.
Deze stappen lossen transport- en werkbelastingproblemen op. Ze omzeilen de controles van de provider niet en mogen niet worden gebruikt om veiligheids- of accountbeperkingen te omzeilen.
Hoe je omvangrijke opdrachten kunt versturen zonder het budget te verspillen
Een uitgebreide context werkt het beste wanneer de aanvraag een duidelijke opdracht heeft. Plaats het gedeelde referentiemateriaal in een stabiele prefix, vraag eerst om een index of uittreksel en stuur vervolgens alleen de relevante delen door naar de volgende fase.
- Begin met een overzicht of het samenvatten van de belangrijkste punten, in plaats van meteen te vragen om een volledige herschrijving.
- Zorg voor een stabiele projectopdracht en geef tussen de verschillende stappen een beknopte samenvatting van de huidige stand van zaken door.
- Gebruik caching wanneer hetzelfde lange voorvoegsel herhaaldelijk wordt verzonden en uit de factureringsgegevens van de provider blijkt dat er cache-hits zijn.
- Gebruik ‘Batch’ of ‘Flex’ wanneer het werk asynchroon verloopt en je servicelaag dit ondersteunt.
- Zorg ervoor dat de uitvoerlimieten hoog genoeg zijn voor de taak, maar laag genoeg om onbedoelde extreem grote reacties te voorkomen.

Wanneer een API-, CLI-, MCP- of werkruimteroute geschikt is
Gebruik de API wanneer je applicatie programmeerbare oproepen, logbestanden en een factuur van de provider nodig heeft. Gebruik de CLI wanneer het model naast een terminal of repository moet werken. Gebruik MCP wanneer de taak goedgekeurde tools vereist, zoals het zoeken naar bestanden, toegang tot code of interne diensten. Gebruik een Yukie-agent wanneer het werk zich uitstrekt over planning, tooloproepen en overdrachten.

GlobalGPT is hier vooral nuttig als continuïteitslaag: vergelijk een reactie, ga door met het opstellen van het ontwerp, geef de opdracht door aan de programmeurs of creatieve teams, en houd de kostenbeslissing gescheiden van een Google API-quotum. Zie voor de huidige prijsberekening de prijslijst voor de Gemini 3.1 Pro.
FAQ
Wat is de maximale ingangsstroom van de Gemini 3.1 Pro?
Op de huidige modelpagina van Google staan 1.048.576 invoertokens vermeld voor gemini-3.1-pro-preview.
Wat is het maximale vermogen?
Op diezelfde pagina staan 65.536 output-tokens vermeld. Zowel output- als thinking-tokens moeten worden meegenomen in de besprekingen over planning en facturering.
Betekent een contextvenster van 1M onbeperkt gebruik?
Nee. Het geeft de omvang van de context van één verzoek aan. Projectquota’s, verwerkingslimieten, facturering en regels voor app-gebruik blijven van toepassing.
Hoe los ik de foutmelding 429 Too Many Requests op?
Lees de details van de reactie, houd rekening met de Retry-After-waarde, wacht even, verklein de omvang of verminder de frequentie van de verzoeken, en controleer de projectquota’s en de facturering. Een herhalingslus betekent niet dat het quotum wordt verhoogd.
Kan GlobalGPT de beperkingen van Gemini 3.1 Pro opheffen?
Het kan de beperkingen van Google niet veranderen. Het kan wel een alternatief model en een alternatieve werkwijze bieden wanneer het werk moet worden voortgezet.
Stel eerst de laag vast: Contextcapaciteit, outputbudget, projectquotum, app-gebruik en tijdelijke beperkingen vereisen verschillende oplossingen.





