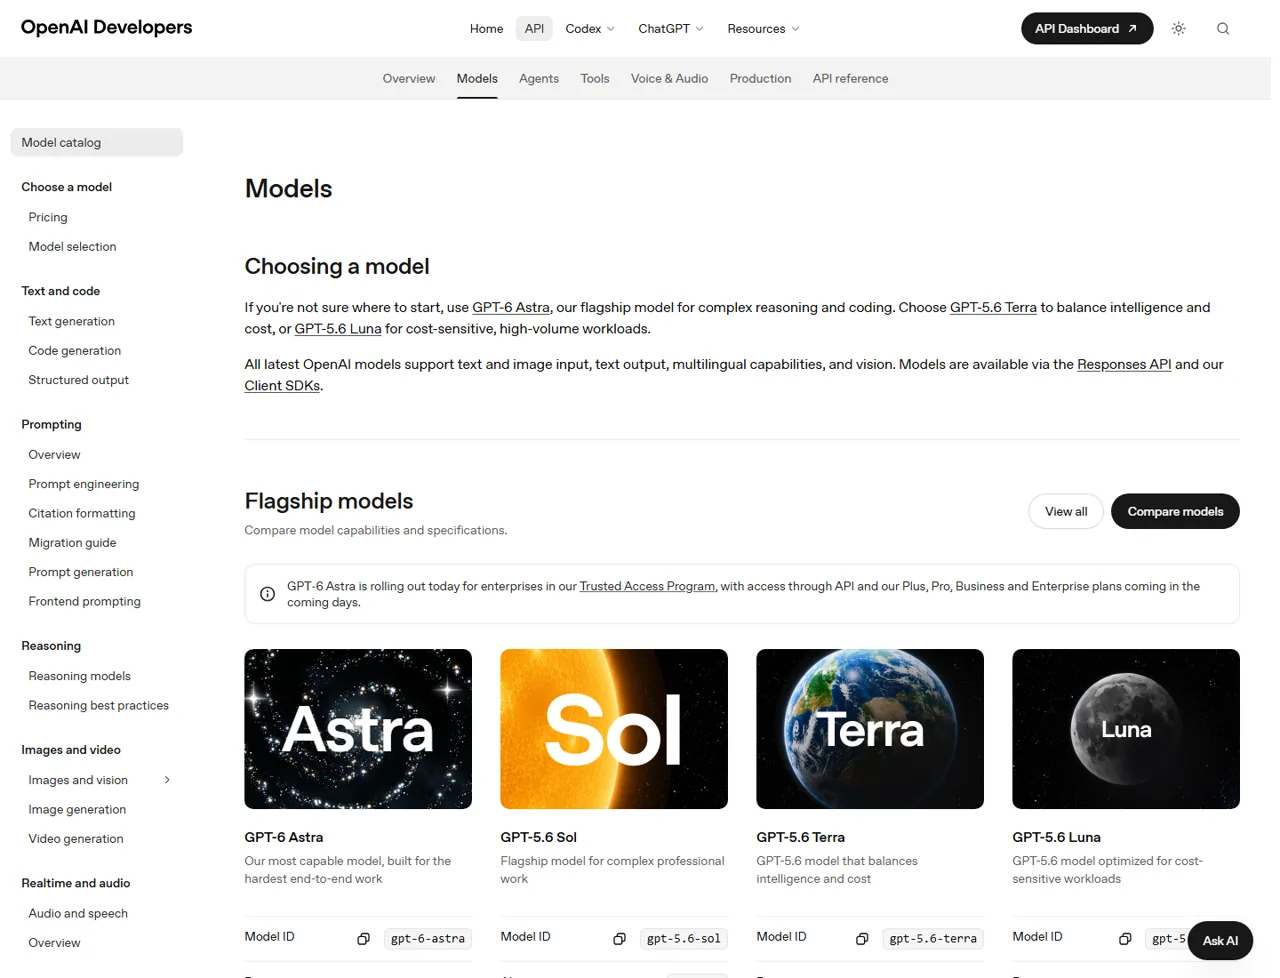
快速回答: GPT-6 Astra 的费用 每100万个输入代币为$10, 每100万个缓存输入令牌消耗$1, 每100万个缓存写入令牌为$12.50, 和 每100万个输出代币为$50 当提示词的输入令牌数在272K及以下时,按标准费率计费。 超过272K时,整个请求将转为长上下文定价:每100万个令牌对应$20输入、$2缓存输入、$25缓存写入以及$75输出。 OpenAI 规定了 1.05M 令牌的上下文窗口和 128K 的最大输出量。.
这些数据表明,Astra 虽然功能强大,但成本较高,因此需要提前规划。当缓存生效时,重复的提示请求成本会大幅降低;而输入令牌数刚超过 272K 的请求,成本则可能急剧上升。本指南将官方定价、计算示例以及我们于 2026 年 9 月 5 日对 API 的实际测试结果区分开来。.

GPT-6 Astra API 定价
OpenAI 将标准定价分为短期和长期两种情况。该阈值基于 输入标记, ,而不是输入和输出的总和。短上下文适用于输入令牌数不超过 272K 的提示;长上下文则适用于超过该阈值的情况。.
每100万个代币的成本
较高档位适用于整个请求。所示价格为每100万个代币的价格。.
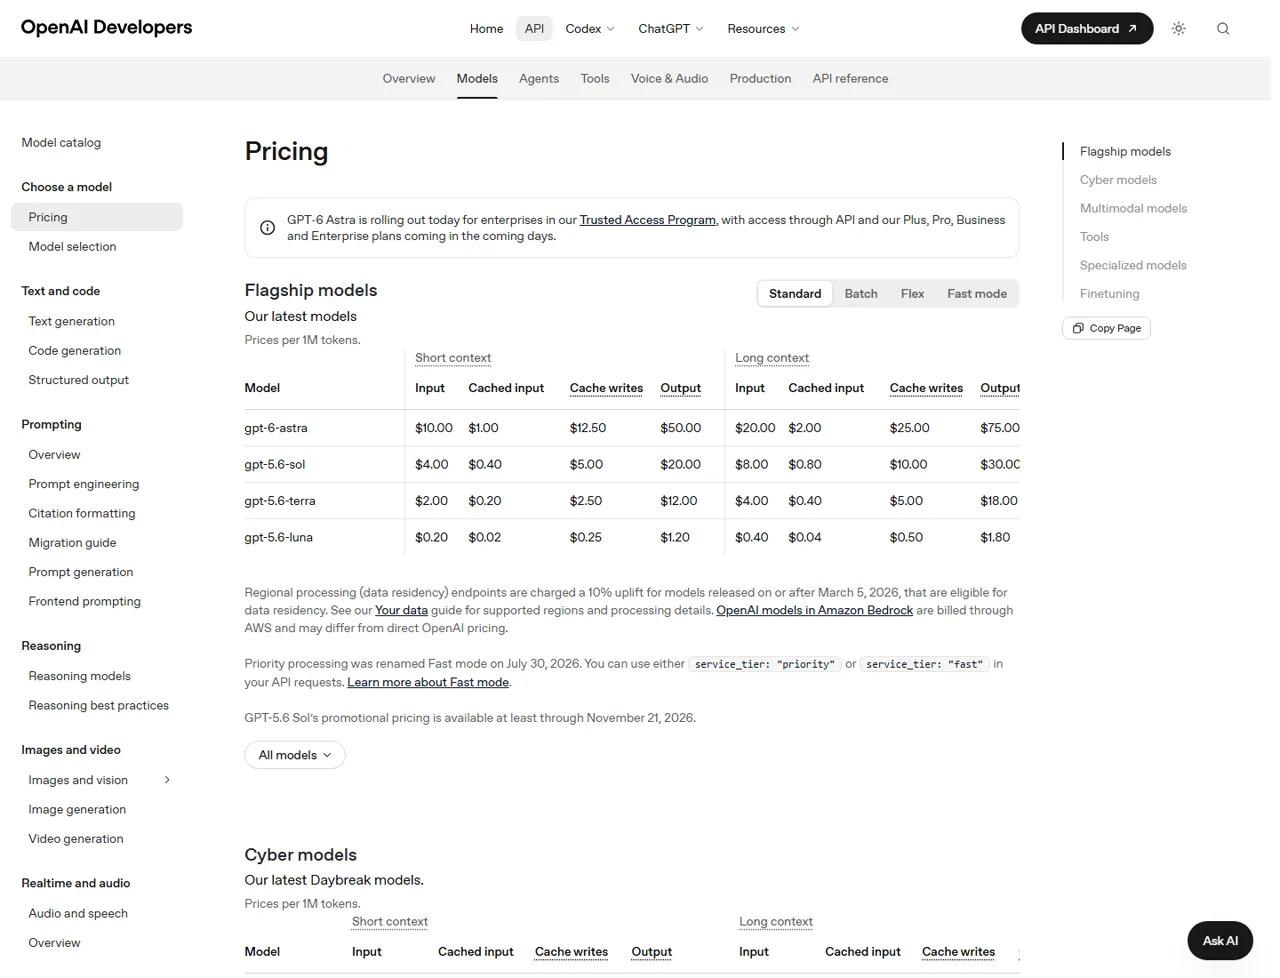
最关键的一点是,超过272K并不会产生混合税率的账单。根据 OpenAI 的 API 定价文档, ,当输入量超过阈值时,更高费率将适用于整个请求。因此,将Astra与此前旗舰产品进行对比的团队不应仅关注标称的输入价格;我们的 GPT-5.6 定价指南 为该预算讨论提供了有用的背景信息。.
提示缓存可以大幅降低重复输入的成本,但创建缓存并非免费。 一次缓存写入的消耗相当于适用未缓存输入速率的1.25倍。批量和Flex处理的消耗为50%的标准资源,而Fast处理的消耗则是适用速率的两倍。符合条件的区域处理会额外增加10%的消耗,且Astra服务在采用欧盟数据驻留模式时无法使用Fast处理。.
一次 GPT-6 Astra API 调用需要多少钱?
对于标准请求,请分别计算每个计费令牌类别的费用,然后将结果相加:
总成本 = 未缓存输入成本 + 缓存输入成本 + 缓存写入成本 + 输出成本。.
(0.0125 × $10) + (0.002 × $50)$0.225(0.1 × $10) + (0.005 × $50)$1.25(0.1 × $1) + (0.005 × $50)$0.35(0.3 × $20) + (0.01 × $75)$6.75标准费率估算不包括工具、区域性附加费及其他单独计费的服务。.
这10万个示例说明了可重用前缀的重要性:当所有输入都符合缓存条件时,模型令牌的预估值从$1.25降至$0.35。这仅是定价示例,并非承诺每次重复的提示都会产生缓存命中。 若要进行更广泛的多模型预算规划,请对比我们 全能型 AI 模型指南.
GPT-6 的 Astra 代币、上下文窗口和输出限制
"(《世界人权宣言》) GPT-6 Astra 官方模型页面 记录了a 1 050 000 个令牌上下文窗口 和一个 最大输出为 128,000 个代币. 其知识截止日期为2026年4月30日。它支持文本和图像输入,返回文本结果,并支持推理强度设置 低, 中等, 高, xhigh, 和 max.
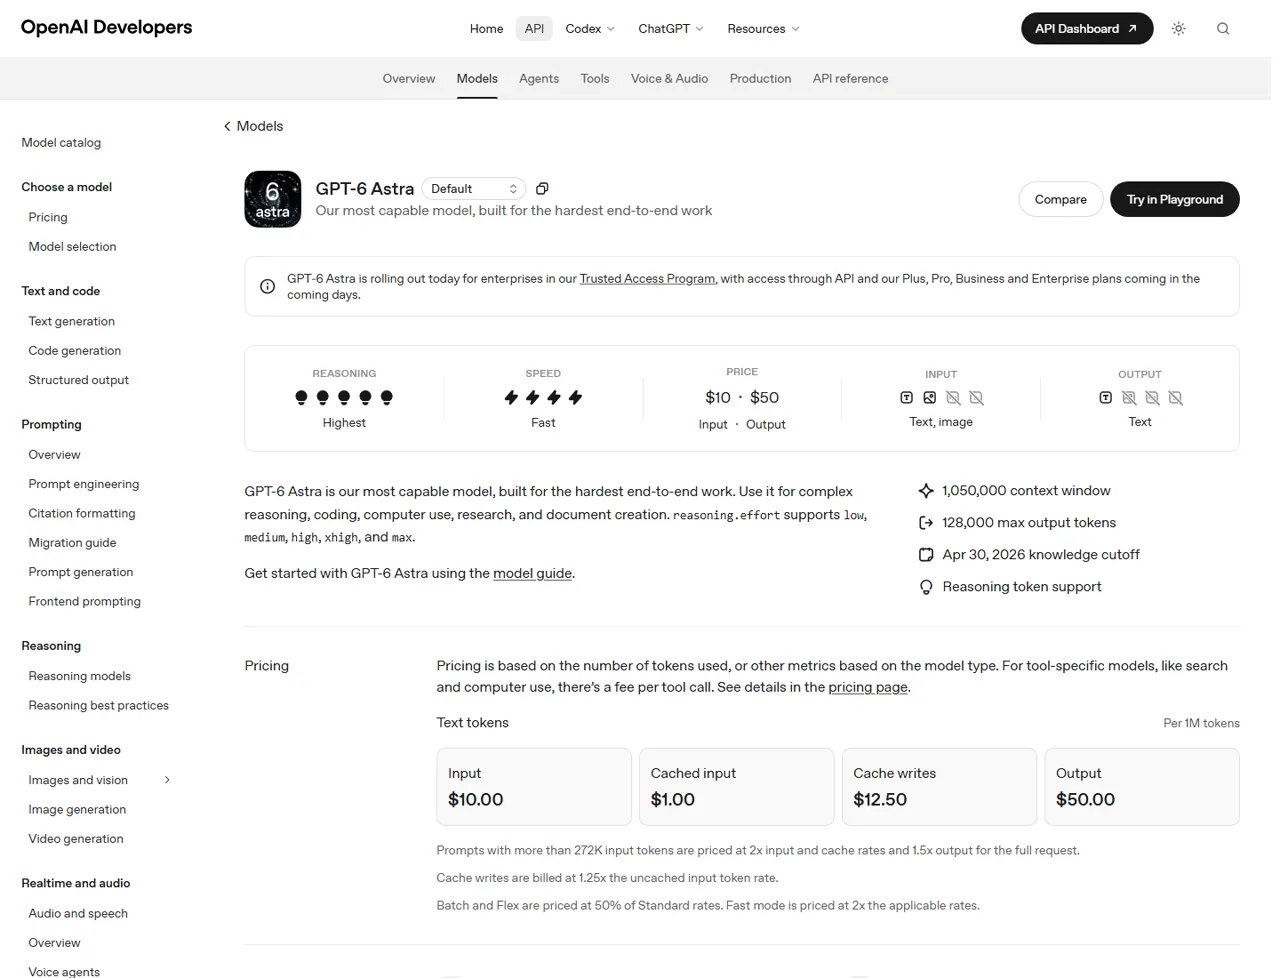
大型上下文窗口是一种容量,而非建议必须满足每个请求。通过检索、文档筛选、摘要生成和提示词结构,可以将输入量控制在272K的阈值以下。模型选择也很重要:专注于编程的开发者可以在我们的 最适合编码的人工智能模型 应进行分析,而不是假设窗口最大的模型就自动是最合适的。.
六个实用的 GPT-6 Astra API 测试任务
测试状态: GPT-6 Astra 已于 2026 年 9 月 5 日通过 Broly Anywhere 兼容性 API 正式上线。我们运行了以下六项已公开的任务。其中五项返回了可用的 HTTP 200 响应;而 272K 边界请求因传输故障而失败,目前仍处于未验证状态。.
提示语和观察结果
型号 ID gpt-6-astra. 每个结果代表一次实际测试,并非官方基准测试。实际耗时包含网关和上游延迟。.
基本代币核算
该模型得出的结果与预期的理论计算结果一致。实际的API调用消耗了54个输入令牌和26个输出令牌。.
提示缓存
这两次查询结果均正确,但在两条响应中,重复的前缀均显示缓存令牌数为零,缓存写入令牌数也为零。.
272K定价界限
该大型合成请求在收到 HTTP 响应之前就已结束。由于未返回任何使用对象,因此速率区间和计费行为仍无法被测量。.
“低”与“最高”的推理
两次运行均计算出结果为 $265.20。Max 耗时较长,并返回了 88 个推理令牌;这项单一的算术任务并未显示出答案质量的提升。.
128K 输出参数
兼容性端点返回了“OK”,而非拒绝超出官方最大值的一个令牌。这是网关的行为,并不表明支持更大的输出窗口。.
资费表头和服务等级
正常响应中不包含 remaining-request 或 remaining-token 头部。Flex 和 priority 探针均成功,但返回的 service_tier 为 default。.
GPT-6 Astra API 速率限制
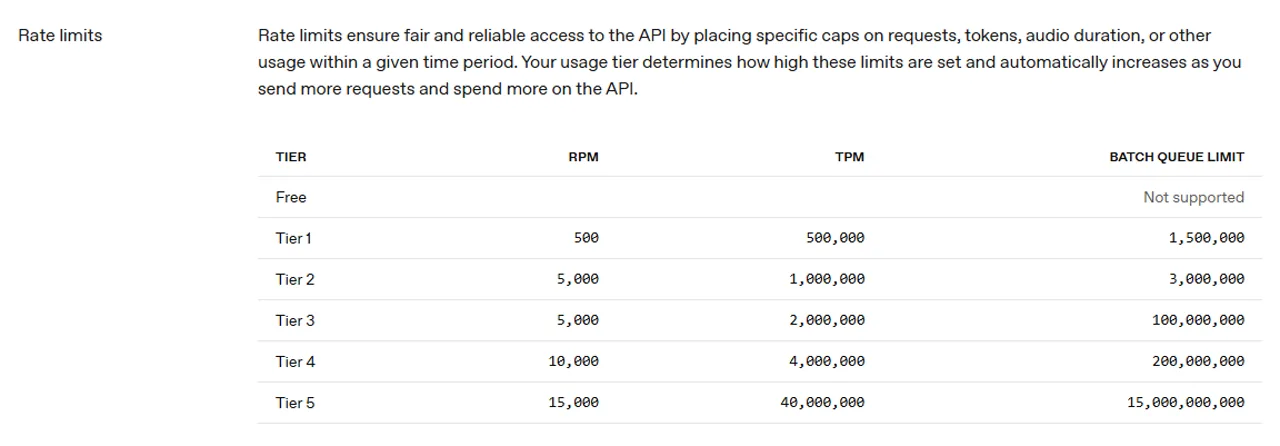
免费套餐不支持 GPT-6 Astra。发布配额会随使用层级提高而增加,但实际剩余配额和重置时间仍需参考生产环境项目的标头信息。.
第5级产能大幅增长
条形图的高度仅供说明。上述RPM、TPM和批处理队列的具体数值才是控制因素。.
当无需即时响应时,Batch 或 Flex 模式可将模型令牌费率降低一半。Fast 模式虽适合对延迟敏感的工作负载,但相关费用会翻倍,且在 Astra 的欧盟数据驻留方案中不可用。在将生产工作负载投入运行之前,请将模型成本与相关平台费用进行比较;我们的 《Codex》定价指南 说明了为什么不应将产品订阅与 API 计费混为一谈。.
早期评论者的反馈显示
独立创作者马特·沃尔夫(Matt Wolfe)发布了一段早期预览视频,内容涵盖编程、计算机使用、Blender 以及虚幻引擎(Unreal Engine)的演示。这些示例有助于理解评测人员正在探索的工作流程类型,但它们并非受控的基准测试证据,也不能替代上文提到的 API 测试。更广泛的比较,例如 ChatGPT 与 Claude 与 Gemini 同样应将其视为针对特定工作负载的指导,而非通用的排行榜。.
哪些人适合使用 GPT-6 Astra?
对于复杂的编码任务、基于代理的工作流、大文档分析以及多模态任务,Astra 是一个值得考虑的选择——在这些场景中,更强的推理能力或超大的上下文窗口可以抵消高昂的令牌费用。团队应先在范围有限且可量化的任务上进行试点,并比较每美元的产出质量,而不仅仅是输出质量。我们的 最佳人工智能模型概述 提供了更广泛的选择框架。.
- 在以下情况下请使用Astra: 任务较为复杂、错误代价高昂、需要长上下文,或者该模型可以替代多个较弱的处理步骤。.
- 在以下情况下,请使用更便宜的型号: 该工作属于常规的分类、提取、改写或大规模生成任务,质量要求较为简单。.
- 在以下情况下应优先进行优化: 提示信息多次超过 272K,大型静态前缀可以被缓存,或者延迟情况无需使用标准或快速处理。.
对于正在比较相邻保费选项的读者来说, GPT-5.6 与 Fable 5 与 GPT-5.5 的对比 从成本、性能和工作负载匹配性方面提供了另一种视角。GlobalGPT 配备了一个专用的 GPT-6 Astra 落地页. 我们通过 Broly Anywhere 的兼容性端点单独记录了 API 监测数据。.
常见问题
GPT-6 Astra API 的价格是多少?
标准短上下文定价为:$10/M 输入、$1/M 缓存输入、$12.50/M 缓存写入和 $50/M 输出。 当输入令牌数超过 272K 时,完整请求的资源消耗为:$20/M 输入、$2/M 缓存输入、$25/M 缓存写入和 $75/M 输出。.
当提示词的输入令牌数超过 272K 时会发生什么?
OpenAI 将整个请求移至长上下文带。这并非一种混合计费方式,即仅对超过 272K 的令牌收取更高费用。.
GPT-6 Astra 的上下文窗口是什么?
OpenAI 指定的上下文窗口长度为 1,050,000 个令牌,最大输入长度为 922,000 个令牌,最大输出长度为 128,000 个令牌。推理令牌也会占用上下文空间,并计入输出量。.
GPT-6 Astra 支持图像输入吗?
是的。该模型的文档中列出了文本和图像输入,以及文本输出。音频和视频并未被列为该模型的输入模态。.
这些费用示例是正式发票吗?
不,这些是根据已记录费率计算的算术示例。您的账单中还可能包含缓存令牌计费、处理模式、区域处理以及其他单独计费的服务。.
有哪些处理模式可供选择?
“标准”、“批量”、“灵活”、“快速”和“超快速”均已公布Astra价格。在同一上下文带宽范围内,“批量”和“灵活”的价格为“标准”的一半,“快速”的价格是“标准”的两倍,“超快速”的价格是“标准”的六倍。符合条件的区域处理将增加10%;具体可用性取决于模式和端点。.
GPT-6 Astra 通过 GlobalGPT 如何计费?
GlobalGPT 的 API 显示,GPT-6 Astra 的计费标准为每 1K 个输入令牌 23 个积分,每 1K 个输出令牌 117 个积分。推理令牌按输出计费。以上为 GlobalGPT 的积分费率;OpenAI API 的使用则采用其自身的美元定价。.
最终结论
GPT-6 Astra 结合了 1.05M 令牌的上下文窗口和 128K 的最大输出量,并采用高级定价模式。 其短上下文标准费率起价为每1M输入令牌$10,每1M输出令牌$50,但272K的限制、推理令牌、缓存写入、处理模式以及区域溢价可能会显著影响最终账单金额。 在发送大型提示词前请预估令牌数量,通过使用数据验证缓存情况,并根据任务完成后的实际价值而非仅凭标价来评估Astra的性能。.