Muse Spark 1.2 結合了異常低廉的代幣定價與 100 萬代幣的上下文視窗,並在我們首次測試的 API 套件中,成功通過了所有三項基礎模型編碼任務。. Meta 於 2026年8月5日, ,具備 100 萬個代幣的上下文視窗、兩種 API 定價層級,以及一個名為 Muse Code 的獨立終端代理程式。Meta 的基準測試結果令人鼓舞;但獨立的公開程式設計排行榜尚未驗證相同的模型與代理程式組合。.
本評測將模型與代理程式、官方評分與獨立證據,以及標準定價與「貢獻者」層級的資料使用權衡區分開來。 在我們的測試中,該模型成功完成了 Python 冪等性修正、保留相容性的 TypeScript 重構,以及涵蓋整個儲存庫的 JSONL 功能,且無需重試。我們並未測試 Muse Code 代理程式的執行情況,亦未測試工具呼叫的可靠性。若您希望先比較更廣泛的領域,請參閱我們的 最適合編碼的 AI 模型 闡述了更廣泛的競爭背景。.
Muse Spark 1.2 評測:快速評析
簡而言之: Muse Spark 1.2 是一款以程式設計為核心的 Meta 模型,具備 100 萬個標記的視窗、相容於 OpenAI SDK 的 API 存取功能,以及極具吸引力的「貢獻者」層級。 其最突出的公開亮點在於性價比:在「貢獻者」級別模型中,每百萬個標記的輸入成本為 $0.10,輸出成本為 $0.20。該級別可用於改進 Meta 的產品,而成本更高的標準模型則不適用於此目的。.
關於效能的描述需要更加謹慎。Meta 報告指出,在 Terminal-Bench 2.1 測試中,搭載 Muse Code 的 Muse Spark 1.2 獲得 82.9% 的成績,而在 DeepSWE 測試中則為 59.3%。這些是 Meta 自行執行的測試結果。 截至 2026 年 8 月 26 日查閱,公開的 Terminal-Bench 和 DeepSWE 評測平台仍未列出 Muse Spark 1.2。. 人工分析 提供了獨立的交叉核對:其智慧指數維持在 57,高於同類型號 35 的中位數。.
- 現在就試試看的最棒理由: 低廉的貢獻者定價、龐大的語境,以及遵循熟悉的 OpenAI 客戶端模式的 API。.
- 保持謹慎的最佳理由: 這三項受控的基礎模型任務,並未能證實 Muse Code 代理程式在大型生產儲存庫中的可靠性、工具呼叫品質或效能。.
- 重要的隱私權選擇: 對於您不希望用於改善 Meta 產品的程式碼或提示字串,請使用標準模型。.
Muse Spark 1.2 功能一覽
經核實的規格
Meta 將 Muse Spark 1.2 描述為一款相較於 Muse Spark 1.1,首次嘗試編碼的準確度更高、工具調用更可靠的模型。這些是來自 Muse Spark 官方產品頁面, ,而非我們自己編碼環節得出的結論。.
Muse Spark 1.2 與 Muse Code 比較
Muse Spark 1.2 即是該模型。Muse Code 則是由該模型驅動的獨立 beta 版終端代理程式。. 這項區別之所以重要,是因為代理程式可以在底層模型周圍加入規劃、工具協調、儲存庫導覽、工作樹隔離、記錄及重試行為等功能。.
將各層分開
Muse Spark 1.2
上下文、推理、API 行為、代幣計費、輸出結果,以及工具呼叫決策。.
模型識別碼1M 上下文API 定價
繆斯程式碼
終端機使用者體驗、子代理、Git 工作樹、事件日誌、流程恢復、捆綁技能以及協調機制。.
代理工作流程Meta-run 系統結果
的 Muse Code 官方頁面 將該產品稱為「beta 編碼劑」。這使得與 Claude Code 和 Codex 等產品的比較,比假設所有觀察到的流程差異皆源自於單純的模型調用,來得更有參考價值。我們的 Codex 與 Claude 程式碼比較 解釋了為何周邊環境對開發者體驗的影響,竟能與模型本身同樣深遠。.
Muse Spark 1.2 效能測試:這些分數究竟透露了什麼
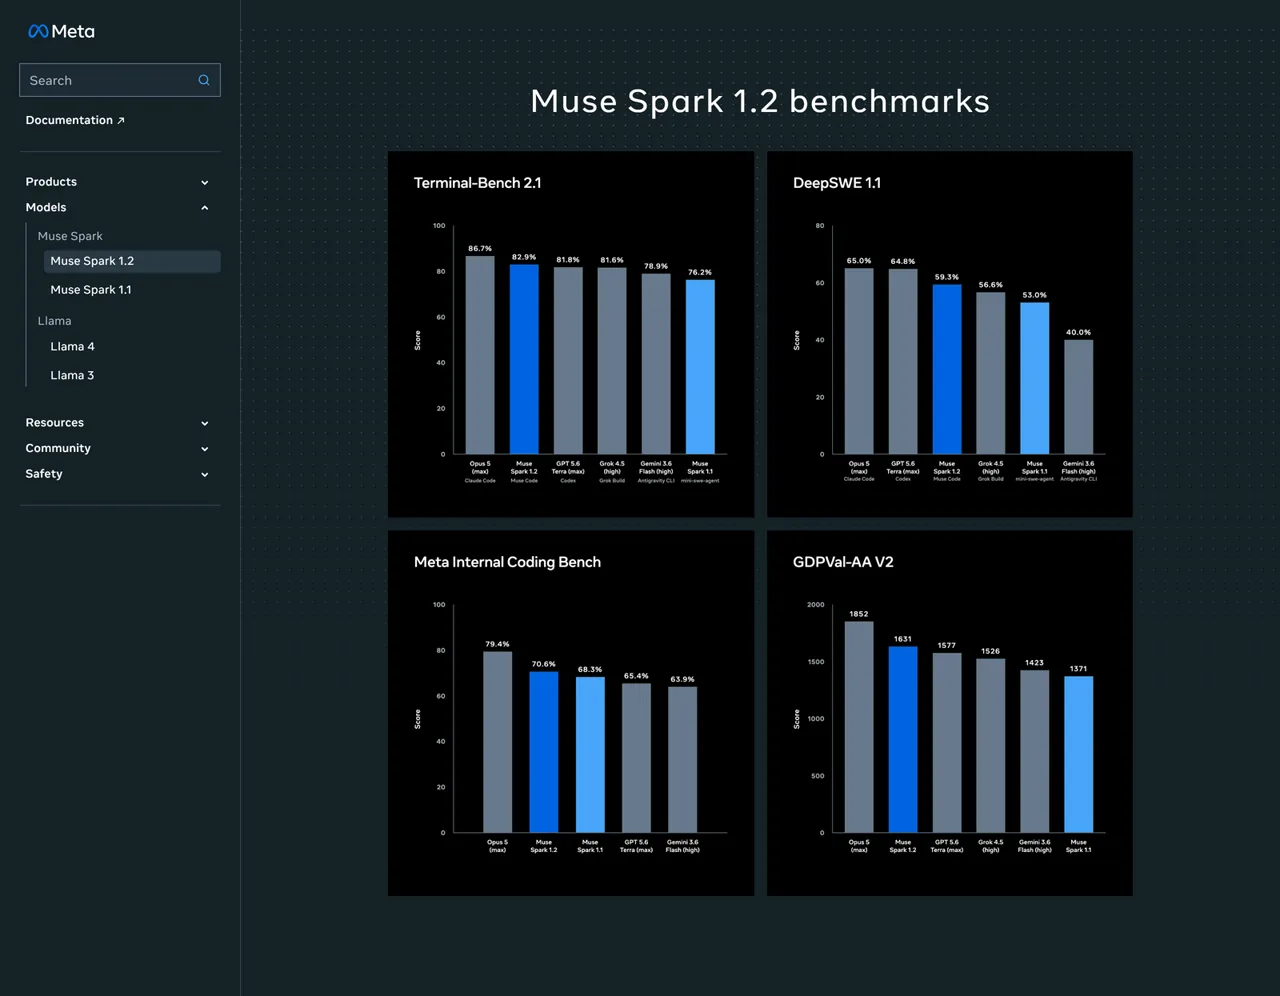
根據 Meta 的基準測試圖表,Muse Spark 1.2 在多項編碼評估中名列前茅。這些數據值得深入探討,但並不能單純作為衡量模型原始品質的明確排名。模型、代理、測試框架、推理能力以及任務協議等要素,都可能同時發生變化。.
Meta 報導的 Terminal-Bench 2.1
Meta 基準測試面板
Terminal-Bench 2.1
全部 89 項任務 · 經過五次嘗試後,在 pass@1 條件下通過 · 選定的模型與代理組合
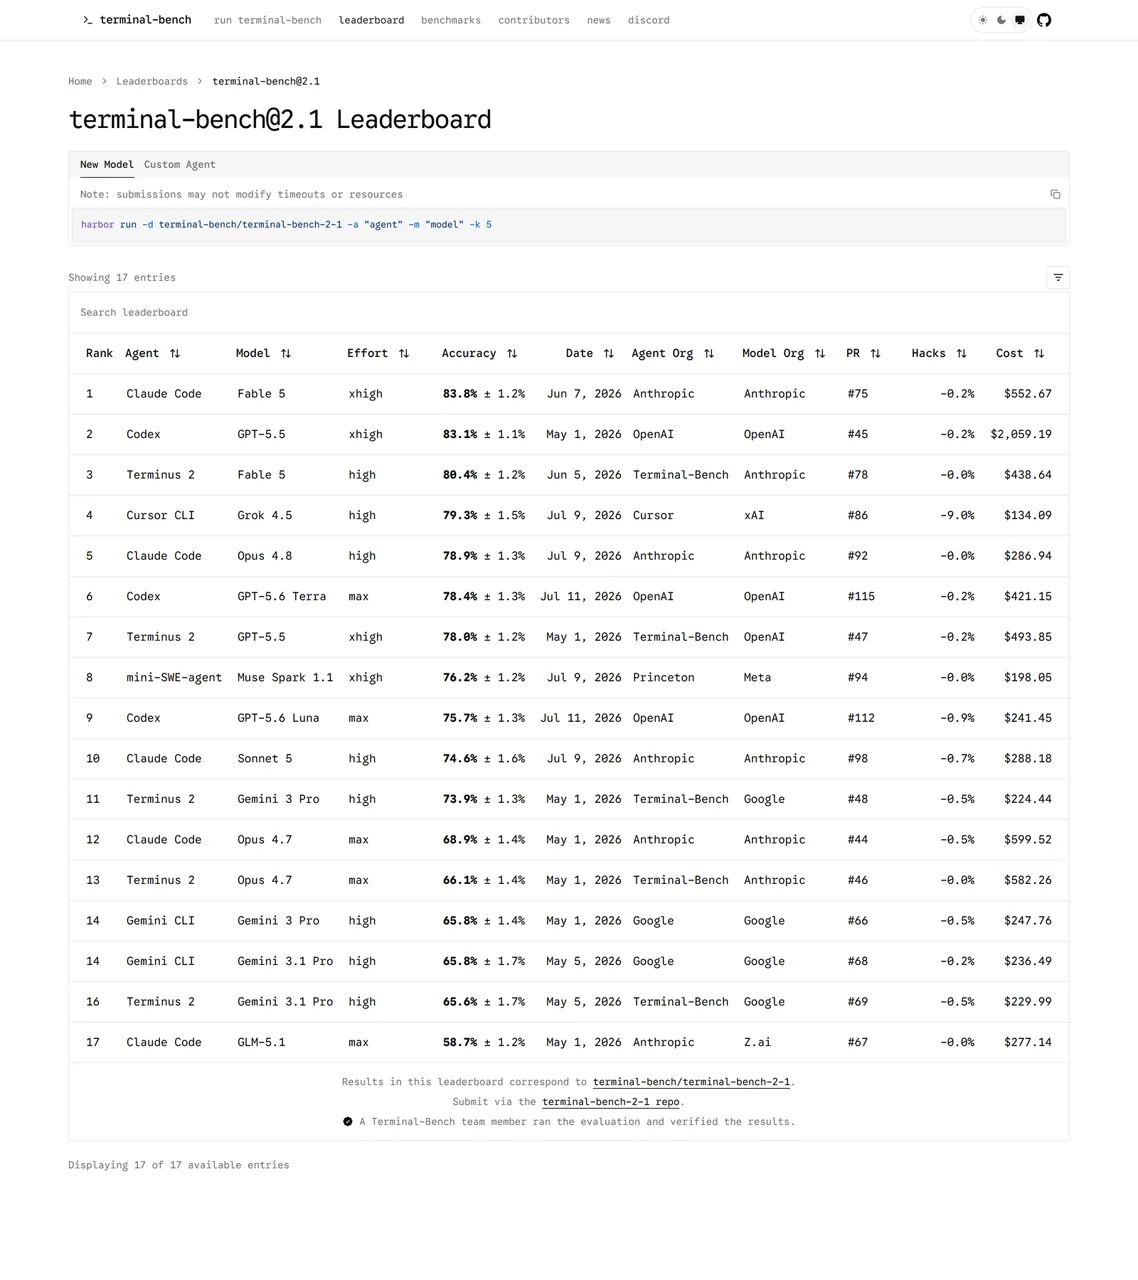
82.9% 這個數字是 Meta-run Muse Code 執行結果. . 公開版 Terminal-Bench 2.1 排行榜 在 2026 年 8 月 26 日並未列出 Muse Spark 1.2,因此它 非經核實的公開排行榜紀錄. 公開資料庫確實列出了配備 mini-SWE-agent 的 Muse Spark 1.1,其數值為 76.2% ±1.2%。.
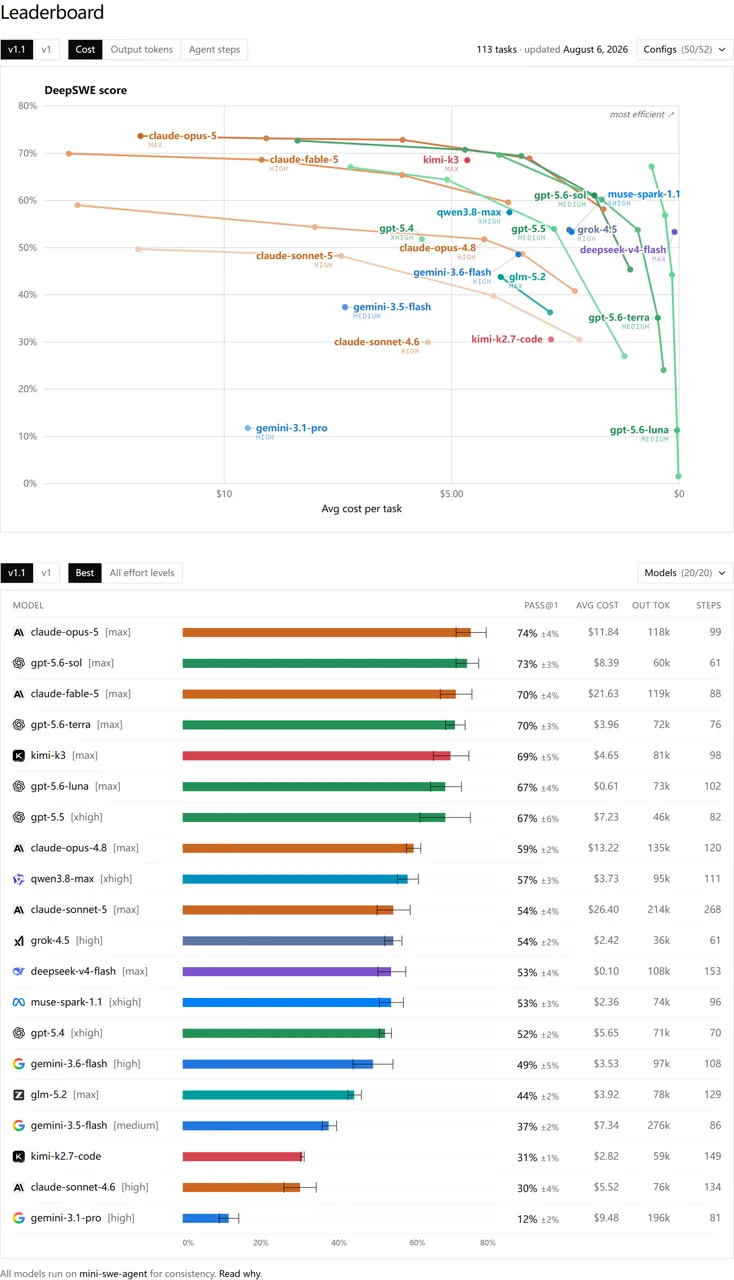
DeepSWE 1.1 的元報告
Meta 基準測試面板
DeepSWE 1.1
113 項任務 · 91 個儲存庫 · 五種語言 · 五次嘗試中通過 1 次
的 公開版 DeepSWE v1.1 排行榜 為保持一致性,該公司在其列出的所有型號中均採用 mini-swe-agent。經查,當時尚未將 Muse Spark 1.2 納入其中;Muse Spark 1.1 的測試結果為 53%。Meta 的 59.3% 結果則採用 Muse Code,因此這兩組數值並非來自相同的測試框架。.
Meta 的內部評估與通用代理評估
兩種不同的評量量表
Meta 內部編碼基準測試
440 項內部任務 · 每項任務可嘗試兩次
| 模型 | 得分 |
|---|---|
| 作品第5號 | 79.4% |
| Muse Spark 1.2 | 70.6% |
| GPT-5.6 Terra | 65.4% |
| Gemini 3.6 閃光燈 | 63.9% |
| Grok 4.5 | 未顯示 |
GDPVal-AA v2
一般代理任務評估 · Elo 式數值
| 模型 | 得分 |
|---|---|
| 作品第5號 | 1852 |
| Muse Spark 1.2 | 1631 |
| GPT-5.6 Terra | 1577 |
| Grok 4.5 | 1526 |
| Gemini 3.6 閃光燈 | 1423 |
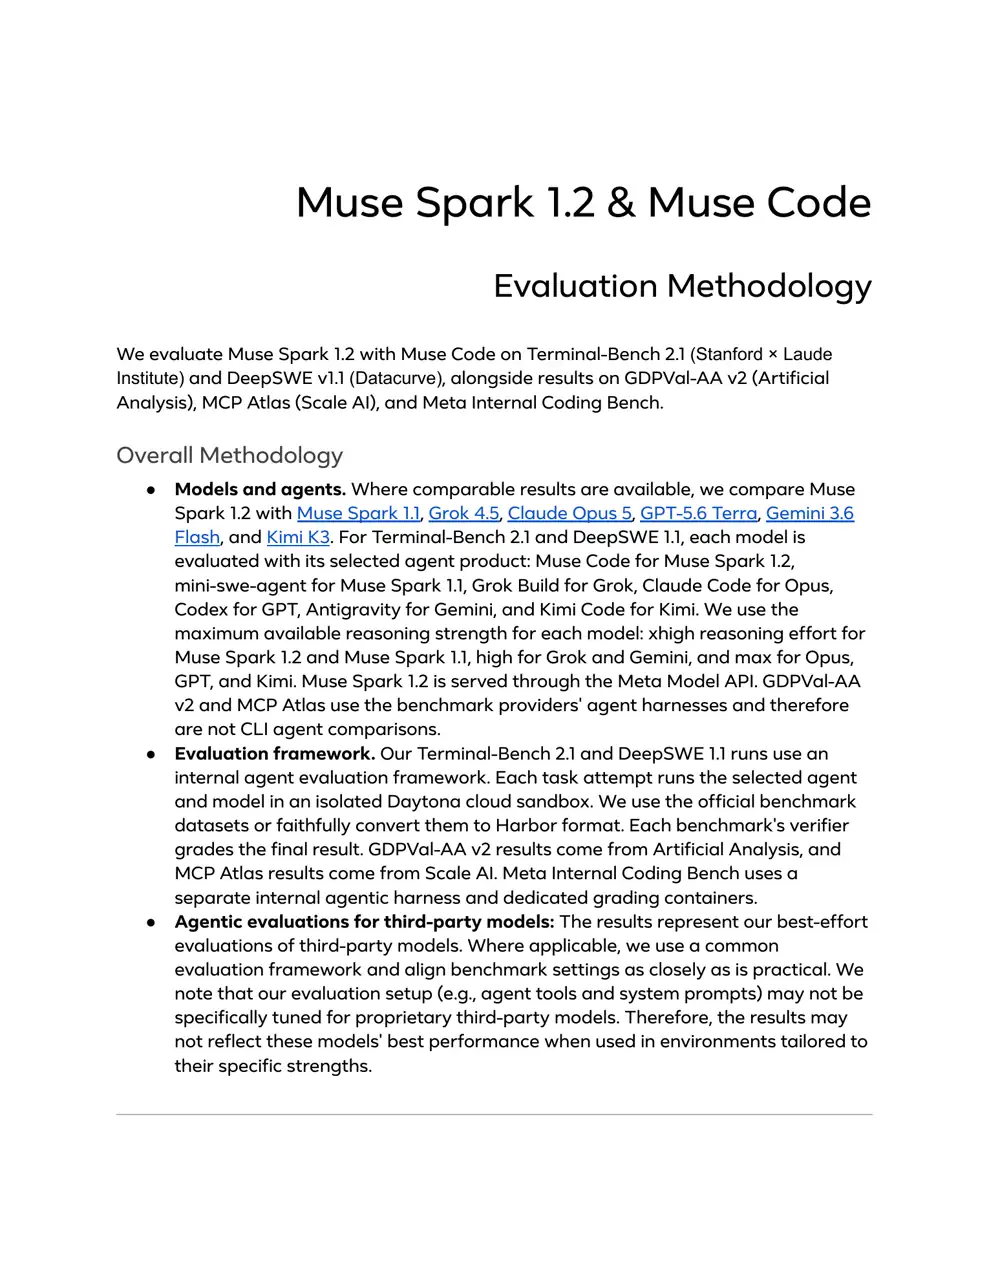
Meta 的 評估方法 指出,Terminal-Bench 在五次嘗試中均通過了所有 89 項任務,且 pass@1 達標。DeepSWE 涵蓋 91 個儲存庫及五種語言共計 113 項任務,同樣在五次嘗試中均通過了所有任務,且 pass@1 達標。 Meta 同時指出,其設定可能尚未針對第三方模型進行最佳化調整。若要了解基於實際產品決策所進行的最新競爭對手比較,請參閱 Claude Opus 5 對 GPT-5.6.
方法論改變了意義
車型 + 選定的經銷商
89 項任務、五次嘗試、推理設定各不相同,且 Meta 的測試框架可能未針對第三方系統進行同等調校。.
已驗證的條目
檢查時發現 Muse Spark 1.2 缺席。該板卡的配置與驗證狀態必須從 Meta 的表格中另行查閱。.
常見的 mini-swe-agent
橫跨 91 個儲存庫及五種語言的 113 項任務。其中未包含 Muse Spark 1.2;Muse Spark 1.1 的列出數為 53%。.
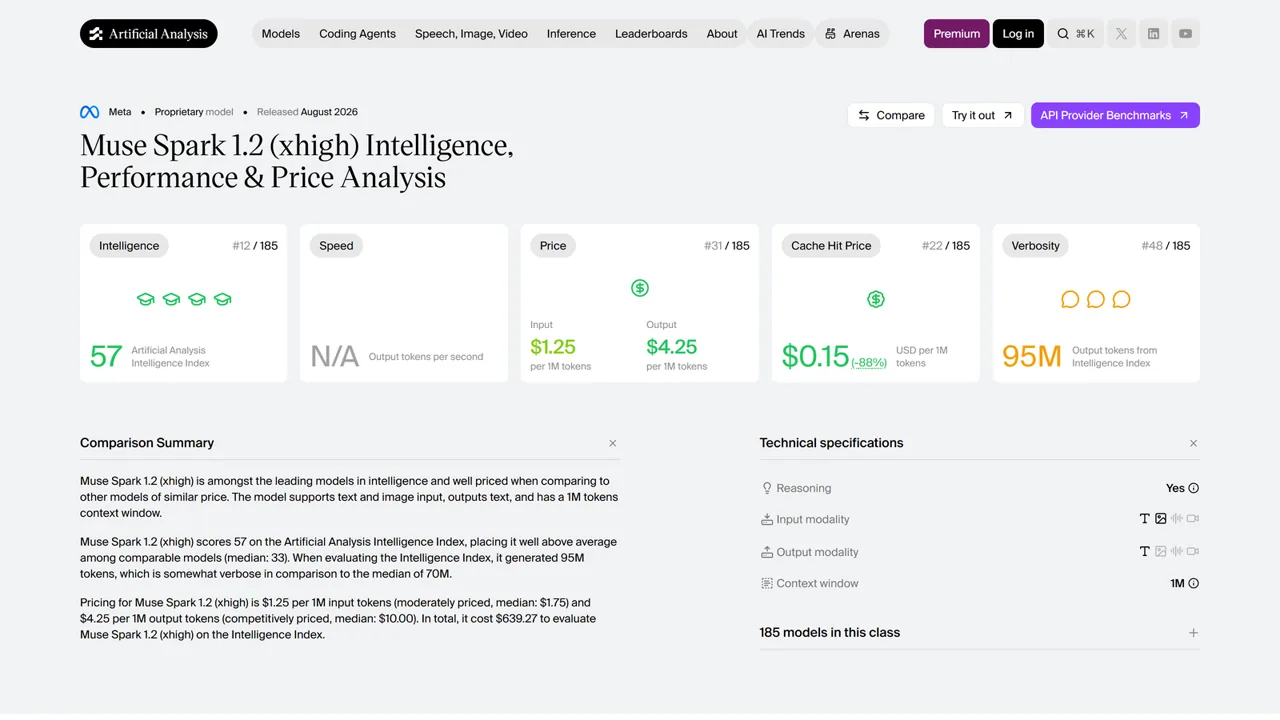
人工分析:有用的獨立背景
的 人工分析模型頁面 賦予 Muse Spark 1.2 的智慧指數為 57, ,高於 2026 年 8 月 26 日查詢時同級車型 35 的中位數。 其評測數據顯示:在 Terminal-Bench v2.1 上為 80%;經 GDPVal-AA v2 正規化後為 57%;在 SciCode 上為 56%;而在 AA-LCR 長上下文評估中則為 83%。.
人工分析版本漂移
實際的教訓很簡單:Muse Spark 1.2 看似具備競爭力,但沒有任何單一評分能孤立評估該模型。應將 Meta 的圖表視為 Muse Code 系統的佐證,將公開排行榜視為另一種交叉驗證,並將 Artificial Analysis 視為一種獨立但配置方式不同的評估方式。.
Muse Spark 1.2 的定價與隱私權權衡
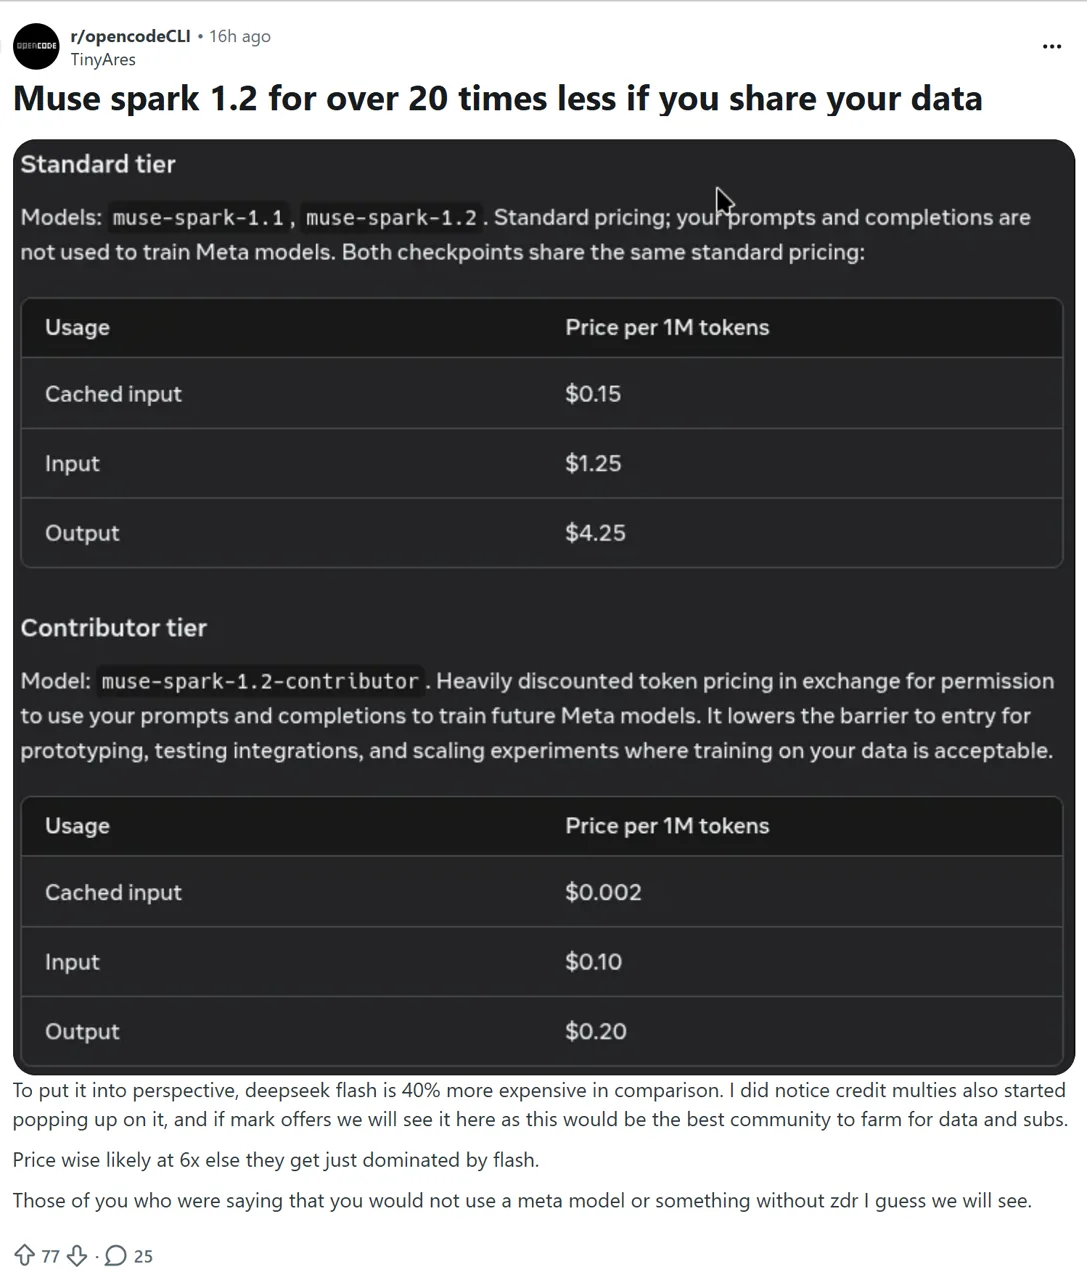
Meta 提供了兩種價格差異極大的 API 模型 ID。較便宜的選項不僅僅是價格優惠:它還會改變提交資料的使用方式。.
每百萬枚代幣的美元價格 · 1M 語境
不適用於產品改進
不適用於改進 Meta 產品
價格更便宜,但需在數據用量上做出取捨
資料 可用於改善 Meta 的產品
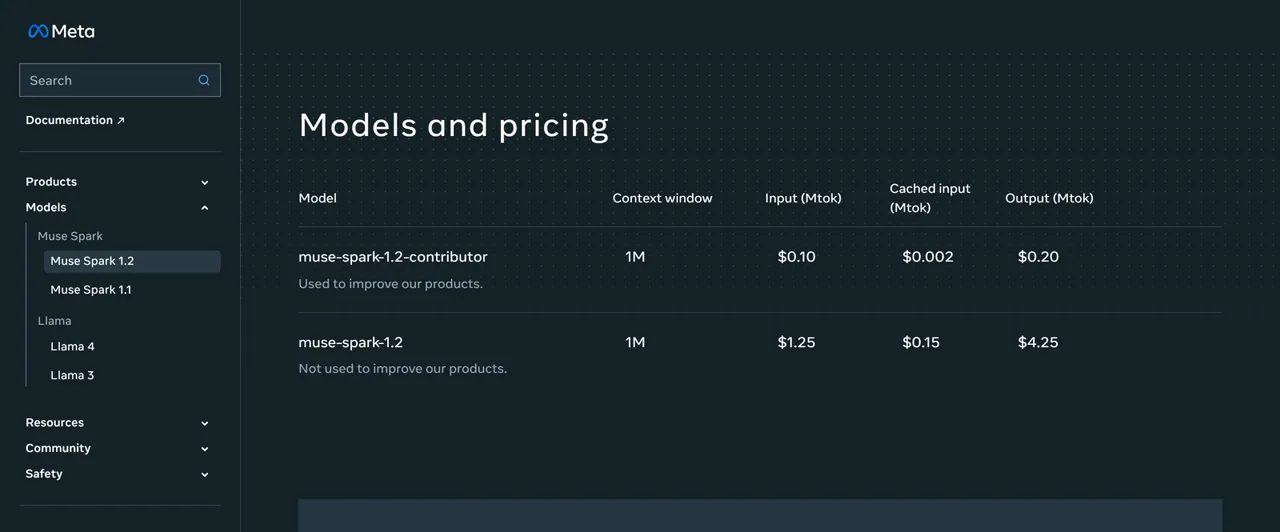
相較於標準層級,貢獻者層級的定價在輸入方面便宜 12.5 倍、快取輸入方面便宜 75 倍,而在輸出方面則便宜 21.25 倍。並沒有一個單一的折扣百分比能準確描述所有代幣類型。.
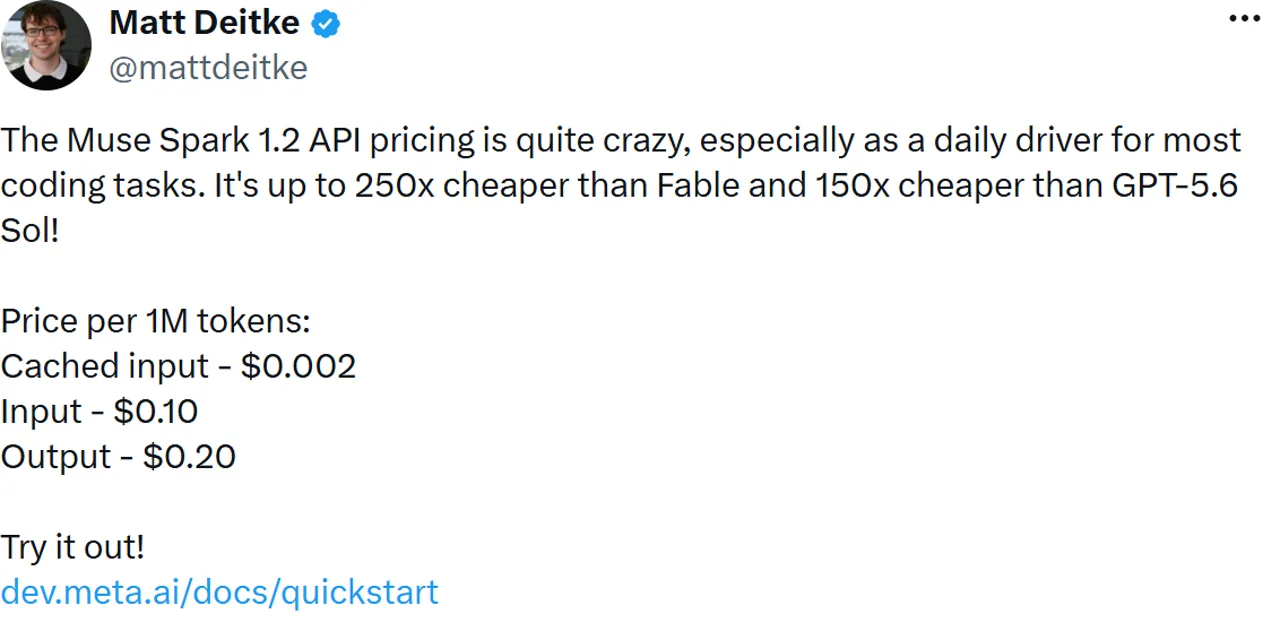
一位 Meta 研究員宣傳「貢獻者」級別,稱其比 Fable「便宜多達 250 倍」,比 GPT-5.6 Sol「便宜 150 倍」。那 社會比較 採用「貢獻者」定價,而非標準定價模式,且應始終附帶「數據使用」的限定條件。讀者若要比較當前競爭對手的成本,可參考我們另行的 GPT-5.6 定價指南 和 Claude 代碼定價明細.
對於公開儲存庫、合成任務或一次性評估環境,貢獻者層級(Contributor tier)可能頗具吸引力。至於私有程式碼、客戶資料、憑證或專有架構,標準層級則是更安全的預設選項。 Meta 還表示,已開始透過銷售管道受理「零資料保留」請求,這是一條獨立的存取途徑,而非預設的自助服務設定。.
Muse Spark 1.2 API 存取與範例
三條官方通行路線
官方食譜網站的基礎網址: https://api.meta.ai/v1 · 本次審查中的第 1.2 項要求:未執行
的 元模型 API 支援與 OpenAI SDK 相容的工作流程。Meta 的官方實作指南使用以下基礎網址: https://api.meta.ai/v1 並從 MODEL_API_KEY. 產品頁面亦介紹了搜尋錨定機制,而這本實作指南則涵蓋了聊天對話自動完成、串流處理、工具呼叫、結構化輸出、提示詞快取、推理控制、視覺處理、長上下文、重試機制,以及搜尋實作範例。.
官方食譜範例 — 擷取版本: 的 官方 GitHub 實戰指南 仍在使用 muse-spark-1.1. 這僅證明了客戶端結構和基礎 URL,並不表示此範例已針對 1.2 版本進行更新。.
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.1",
    messages=[{"role": "user", "content": "Hello, world!"}],
)

print(response.choices[0].message.content)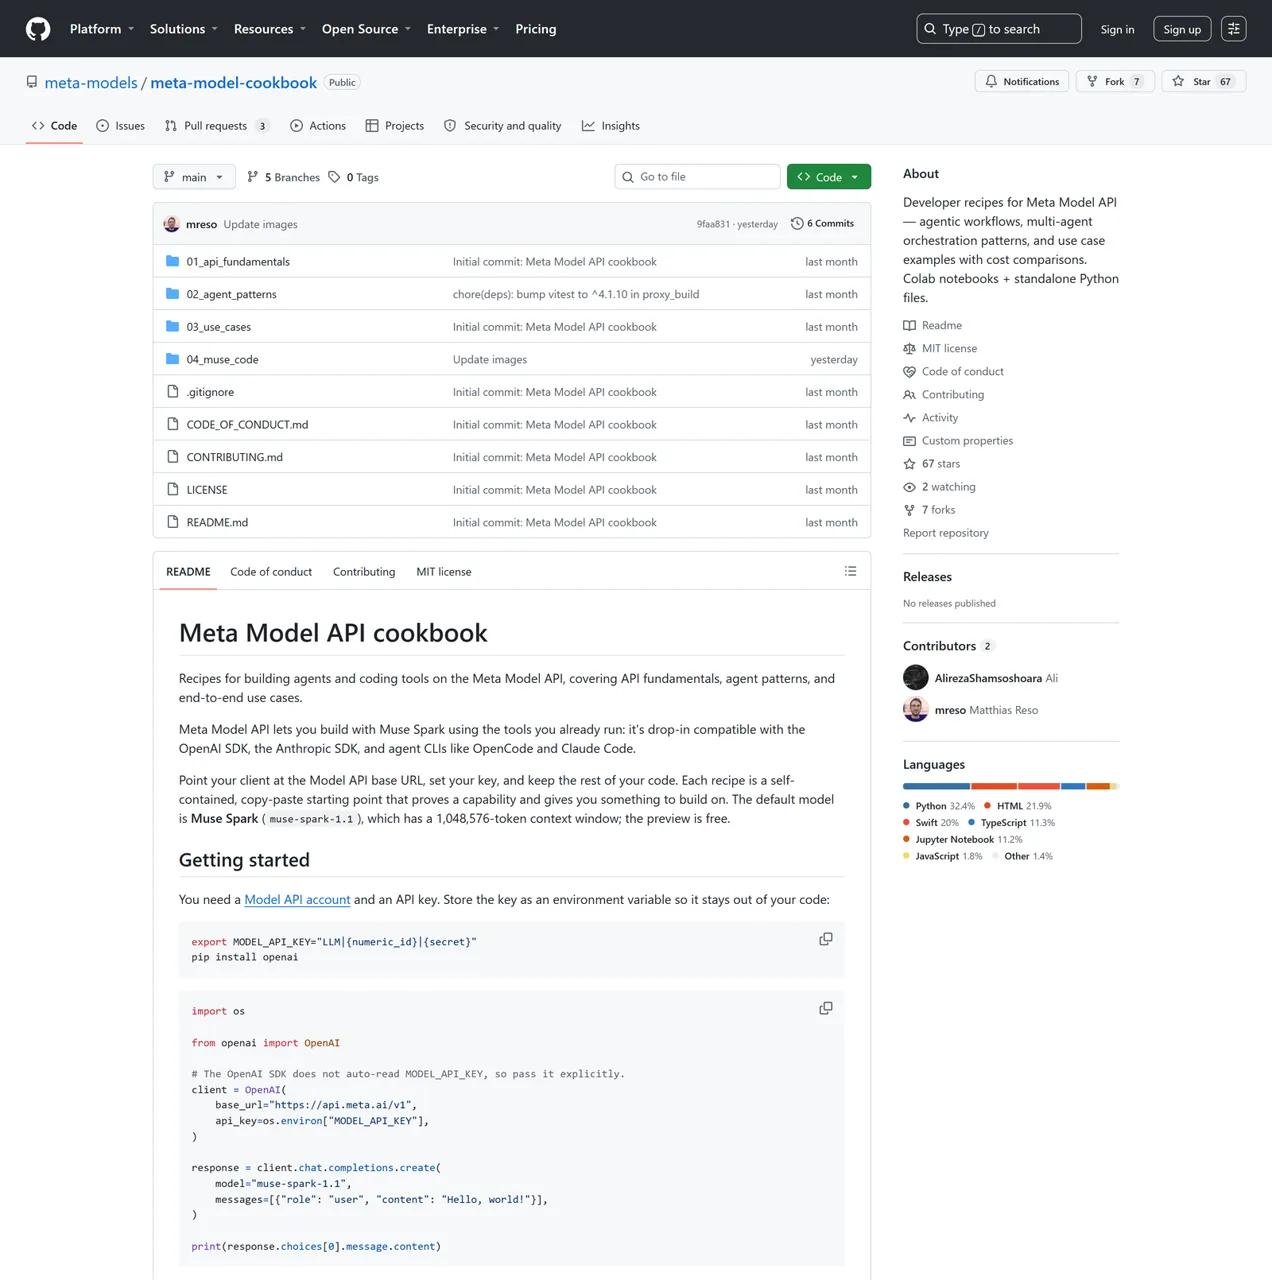
已記錄的調整 — 未執行: Meta 另行列出 muse-spark-1.2 作為標準的 1.2 型號 ID。下方的最小替換結合了兩項官方事實,但在本次審查期間並未發出任何付費請求。.
response = client.chat.completions.create(
    model="muse-spark-1.2",
    messages=[{"role": "user", "content": "Hello, world!"}],
)
Muse Spark 是一個推理模型,而且 推理代幣會作為輸出進行計費. 這使得 $4.25 標準輸出速率比乍看之下更為重要:看似簡短的回答,仍可能蘊含隱藏的推理邏輯。實際延遲、首次標記時間、重試率以及每項任務的成本,在此仍未被量化。.
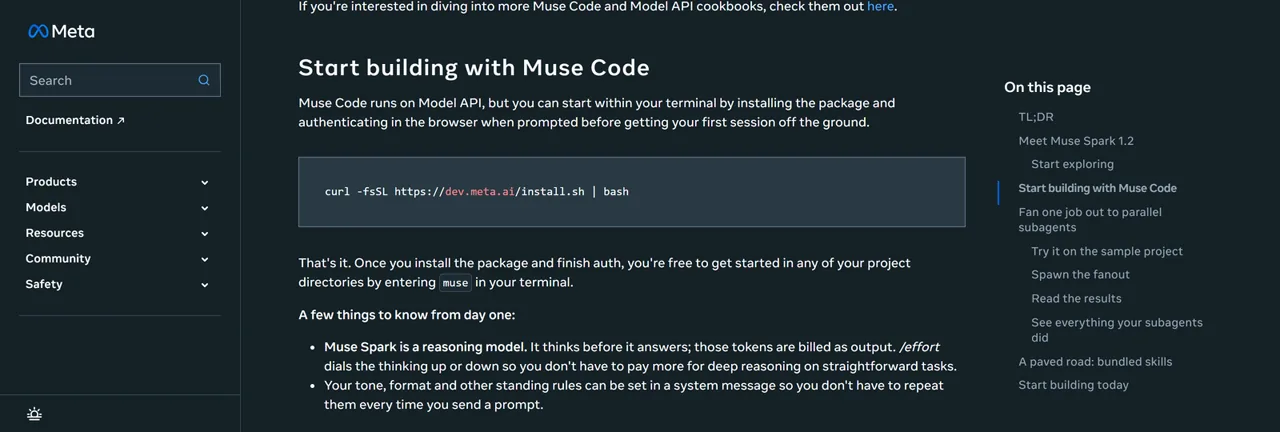
/努力 該指令會改變推理的深度。. 來源:Meta 開發者指南.Muse Code 帶來了什麼
Muse Code 需透過終端機安裝,並將 Muse Spark 1.2 整合至代理程式工作流程中。Meta 的 開發者深度解析 描述了幾種不屬於純 API 呼叫的行為:
- 並行代理: 任務可以在隔離的 Git 工作樹中執行。.
- 僅追加式事件日誌: 會話和操作會寫入本機 JSONL 檔案,以供稽核和重播之用。.
- 履歷流程:
繆斯履歷可以繼續中斷的會話。. - 推理控制: the
/努力此指令用於調整推理強度。. - 明確技能: 元名稱
/口味,/燒烤,/帶說明文件的烤架, 以及/plan.
代理產品功能
次級代理人
獨立任務可能會呈扇形擴散。.
工作樹
在並行作業期間,各分支會保持分離。.
JSONL 日誌
僅追加的本地事件支援重播功能。.
履歷表
繆斯履歷 繼續進行中斷的會議。.
技術
/口味, /燒烤, /帶說明文件的烤架, /plan.
這套功能使 Muse Code 能在更廣泛的程式設計代理市場中佔有一席之地,在該市場中,規劃、隔離、重播及工具紀律與模型智慧同樣至關重要。該 OpenClaw 與 Claude:Code 與 OpenCode 對比指南 這對於理解這些產品層面的差異而言,是一個有用的背景資訊。.
上市聲明與早期社群反饋
反應不等於認可
培訓 + 長遠視野
更強大的程式碼運算能力、環境多樣性、協同訓練,以及一項涉及超過 1,000 個工具呼叫的壓力測試。.
價格與 OpenCode
一位 Reddit 用戶盛讚自己早年的程式設計經驗及其價值。.
隱私權 + 可靠性
其他使用者則對數據用量、標準價格、產品供應狀況以及初期可靠性等問題表達了擔憂。.
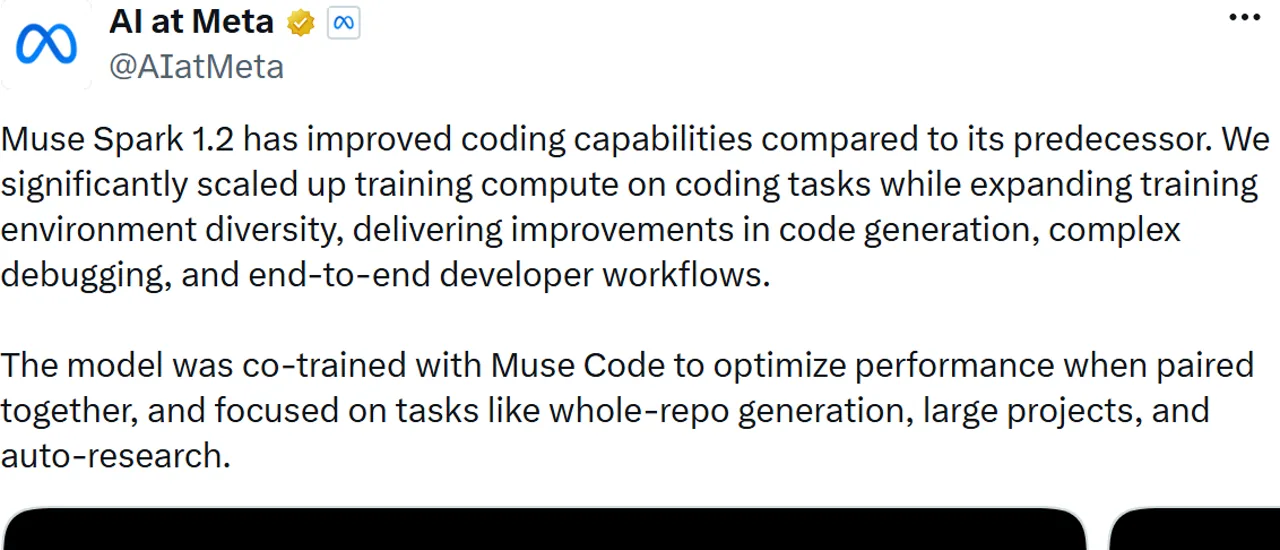
Meta 的 AI 團隊表示,Muse Spark 1.2 獲得了更多的程式碼訓練運算資源、更豐富多樣的環境,並更著重於整個儲存庫的生成與除錯,同時還與 Muse Code 進行了協同訓練。另一份 發起討論串 描述了一項在 NVIDIA Hopper GPU 上進行、持續長達 24 小時且包含超過 1,000 次工具呼叫的壓力測試。.
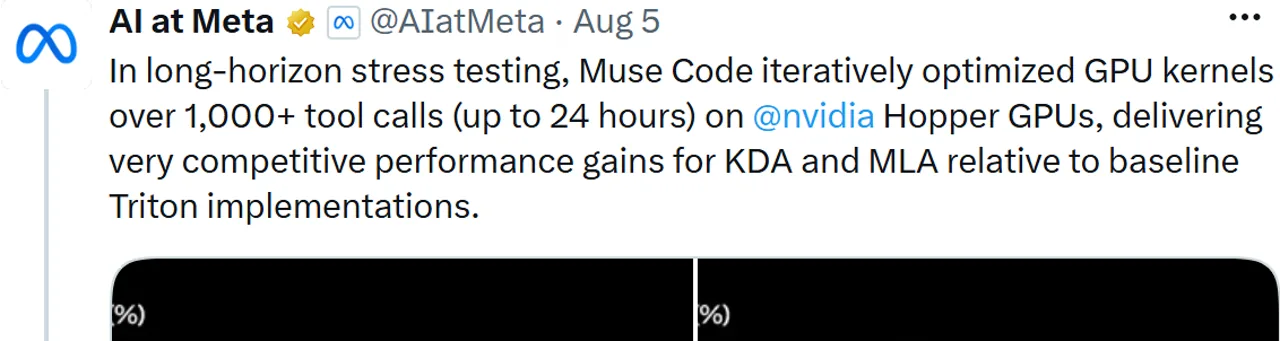
這雖然是一次令人印象深刻的示範,但並非經過量測的整體成功率。它並未告訴我們,該代理程式選擇正確工具、從錯誤中恢復、避免重複呼叫,或是無需引導即可完成一般儲存庫任務的頻率。.
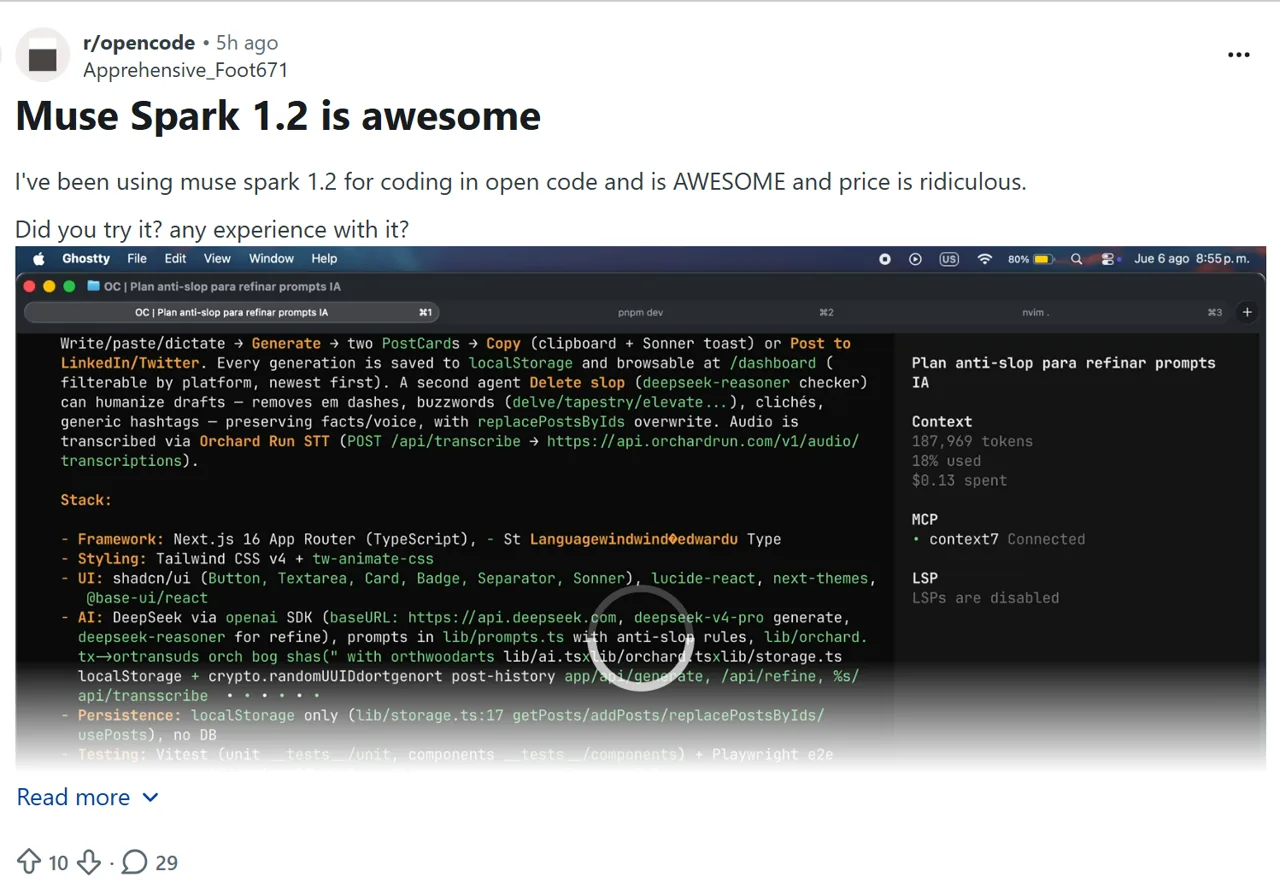
Reddit 上早期的貼文反應同樣褒貶不一。其中一篇 r/opencode 的一位使用者分享了其使用 OpenCode 的正面體驗 並稱讚了價格。另一篇 關於貢獻者定價的討論 引發了關於資料使用量、標準方案費用、可用性及可靠性的質疑。這些僅為個人反應,並非社群共識。.
Muse Spark 1.2 編程測驗:3/3 項任務通過
在我們的測試中,基礎版 Muse Spark 1.2 模型透過一個相容於 OpenAI 的聊天補全 API,完成了三項受控的編碼任務。. 每項任務僅允許一次嘗試,不允許重試,且不進行人工干預。我們針對一次性儲存庫中回傳的檔案,依據公開與隱藏的檢查標準進行評估。本次測試未驗證 Muse Code 代理程式的執行情況,亦未測試工具呼叫的可靠性,因此這些結果不應被視為代理程式的基準測試。.
單次嘗試結果
這些回應共使用了 6,618 個推理標記。這三項最終理由分別是 停止, ,且「提供者」欄位顯示為 Meta。.
測試 1:Python 冪等性錯誤修正 — 通過
在不修改公開 API 的情況下,阻止重複轉帳
該模型識別出缺失的 request-ID 保護機制,添加了最小的安全修正,並在維持原子性平衡更新的前提下,提供了回歸測試。.
原始的隱藏評估器錯誤地要求必須重複呼叫一次才能返回 錯誤, ,儘管該任務僅要求不得向發送者收取雙重費用。在修正了這項虛構的回傳值要求後,未經修改的首次回應通過了全部六項測試。我們並未重新嘗試,也未編輯模型的輸出結果。.
測試 2:TypeScript 多檔案重構 — 通過
將驗證、持久化與稽核記錄分開處理
回傳的檔案保留了公開的路徑合約、嚴格的 TypeScript 規範,以及涵蓋訂單與稽核寫入的單一交易。此外,還新增了針對性強的驗證測試,且不依賴任何執行時元件。.
第一位評審將物件與原始資料進行了比較 JSON.stringify, 因此,具有相同內容但鍵值插入順序不同的物件會被視為不相等;其 Windows npx 在進行類型檢查之前,執行程序也失敗了。透過使用不區分順序的比較運算子,並以 Windows 安全模式呼叫指令,原始的回應通過了所有檢查。同樣地,系統並未進行模型重試。.
測試 3:JSONL 儲存庫功能 — 通過
遵循整個儲存庫的指示
新增 JSONL 功能,同時不影響 CSV 格式
該模型實作了擴充功能偵測、以 1 為起點的格式錯誤檢查、原子式輸出、模擬執行安全性、針對性測試、說明文字,以及一個 README 範例。.
測試結果顯示: Muse Spark 1.2 能夠在單次執行中,產出可用的多檔案修補程式、遵守相容性限制、新增測試,並處理整個儲存庫範圍內規模適中的功能。據報告顯示,每項任務的平均成本約為 $0.0151,但這些測試案例規模較小,不應以此來預測大型程式碼庫所需的成本。.
哪些人適合使用 Muse Spark 1.2?
決策指南
受控評估
公開或合成程式碼、可量化的任務、大規模情境需求,以及一項令人期待的 3/3 基礎模型結果。.
需提供代理人證明
Muse Code 的運作行為、穩定的速率限制、重複的工具呼叫,或是廣泛的儲存庫基準測試,皆為決策門檻。.
敏感代碼或高輸出
當隱私與推理代幣成本成為主要考量時,請使用標準層級,或比較其他替代方案。.
除非貴組織已另行核准「貢獻者條款」,否則請針對敏感代碼使用標準範本。若標準輸出價格會影響數值計算,請將其與當前 Codex 定價, Claude 編碼及其他編碼劑成本,再決定是否採用該工作流程。.
Muse Spark 1.2 評測結論
Muse Spark 1.2 成功入圍評估候選名單,但這並不代表自動獲得生產推薦。. 100 萬枚代幣的發行規模、熟悉的 API 架構、低廉的貢獻者定價、三次首次嘗試的編碼審核機會,以及在 Meta-run Muse Code 評分中表現優異,這些因素都讓人難以忽視。此外,Meta 在公布方法論細節方面,也比許多其他發行專案做得更為周全。.
相關注意事項同樣具體明確。貢獻者定價模式伴隨著數據使用量的權衡取捨。標準輸出與推理代幣可能會推高實際成本。 Meta 公布的頂尖編碼數據,尚未在公開的 Terminal-Bench 或 DeepSWE 排行榜上出現相應的對應紀錄,且我們的實測樣本涵蓋三項基礎模型任務,而非 Muse Code 代理程式執行。.
明智的做法是針對非敏感程式碼進行受控測試,並保存原始使用情況及本地驗證結果。將測量出的成本和延遲視為小型任務的樣本,然後在將其投入生產環境之前,先測試您自身的儲存庫規模、故障恢復能力以及代理程式工作流程。.
Muse Spark 1.2 常見問題集
什麼是 Muse Spark 1.2?
Muse Spark 1.2 是 Meta 專注於程式設計的模型,於 2026 年 8 月 5 日推出,具備 100 萬個代幣的上下文視窗,並可透過 Muse Code、Meta Model API 以及 OpenRouter 進行存取。.
Muse Spark 1.2 和 Muse Code 是同一款軟體嗎?
不,Muse Spark 1.2 是該模型;Muse Code 則是基於該模型運作的獨立 beta 版終端代理程式。Muse Code 增加了諸如子代理程式、隔離的 Git 工作樹、事件記錄、恢復功能以及捆綁式技能等產品功能。.
Muse Spark 1.2 API 的價格是多少?
標準模型每百萬個標記的輸入成本為 $1.25、快取輸入成本為 $0.15,輸出成本為 $4.25。 「貢獻者」模型的成本為每百萬個標記 $0.10 輸入、$0.002 快取輸入,以及 $0.20 輸出。.
Meta 是否使用 Muse Spark API 的資料進行訓練?
Meta 表示,標準層級的資料不會用於改善 Meta 產品。貢獻者層級的資料可能會用於改善 Meta 產品,因此除非組織另有批准,否則私有或專有程式碼應採用標準途徑。.
Muse Spark 1.2 是否出現在 Terminal-Bench 或 DeepSWE 的公開排行榜上?
於 2026 年 8 月 7 日查閱時,該項目並未出現在任何公開論壇上。Meta 報告指出,在搭配 Muse Code 的 Terminal-Bench 2.1 測試平台上,其成績為 82.9%;而在 DeepSWE 測試平台上則為 59.3%,但這些均為 Meta 自行執行測試所得的結果。.
這篇評測中是否實際測試過 Muse Spark 1.2?
是的。在三項單次嘗試的基礎模型測試中,Muse Spark 1.2 成功處理了一項 Python 錯誤修復、一項 TypeScript 重構,以及一項 JSONL 儲存庫功能。平均延遲為 12.98 秒,總報告成本為 $0.045362。 Muse Code 代理程式及工具呼叫的可靠性並未進行測試。.
開發人員該如何取得 Muse Spark 1.2?
Meta 列出了三種途徑:Muse Code 測試版終端代理程式、Meta Model API 以及 OpenRouter。官方實作指南使用的是與 OpenAI SDK 相容的客戶端,其基礎網址為 https://api.meta.ai/v1。.