一個模型便能建構出完整的聲音場景。.
Seed Audio 1.0 能夠將人聲、音效、環境音、節奏與器樂融合在一起。我們的測試發現,其創意發揮空間異常寬廣——但同時也存在一個不容忽視的可重複性問題。.
Seed Audio 1.0 是我測試過的首批音訊模型之一,它給人的感覺是圍繞著完整的場景來設計,而非僅針對單一輸出類型。它能夠說話、表演、添加環境音、製作音效、將對白置入時間軸,並根據單一提示生成器樂音樂。.
簡短結論: Seed Audio 1.0 在統一的音訊創作方面擁有極高的潛力,特別是在時序對白與電影級音效場景的製作上。其弱點在於可重複性。. 一次表現出色的生成結果聽起來可能非常完整,而針對同一提示產生的另一組結果,則可能會出現語音失真、遺漏某個事件,或是變更了指定語音。.
我透過 Anywhere/BrolyAI 測試環境生成了 23 個帶有評分標記的樣本。這些樣本涵蓋了旁白、雙人對話、帶時間戳的語音、純音效片段、人聲加音樂場景、獨立音樂、多語言表演、兩分鐘獨白,以及參考音訊延續等類型。.
Seed Audio 1.0 評測:快速總結
| 類別 | 我們的測試結果 |
|---|---|
| 富有表現力的嗓音 | 在最佳運行時品質優異,但在重複運行時表現不穩定 |
| 多角色對話 | 精準的劇本與出色的講者分離度 |
| 對話時機 | 在我們的測試集裡最可靠的特徵 |
| 音效 | 空間與事件順序的真實性;在精確計算事件數量方面較弱 |
| 人聲 + 音效 + 音樂 | 當每個預期的事件都如期發生時,整段場景便顯得極具說服力 |
| 獨立音樂 | 表現比預期更出色;產出了結構化的 30 秒提示音 |
| 多語言語音 | 這是極佳的最佳情況,但其中一次執行中出現了額外的對話內容 |
| 兩分鐘的音訊 | 兩次運行中均展現出鮮明的語調特色與敘事連貫性 |
| 參考音訊 | 在我們的測試場地中表現不穩定;語音相似度較低 |
最適合 創作者們製作廣播劇、遊戲場景、播客企劃、電影原型,以及以音訊為主的故事板。.
較不適合: 需要確定性表述、精確的重複事件計數,或能透過單次無人值守生成即可實現可靠語音複製的工作。.
什麼是 Seed Audio 1.0?
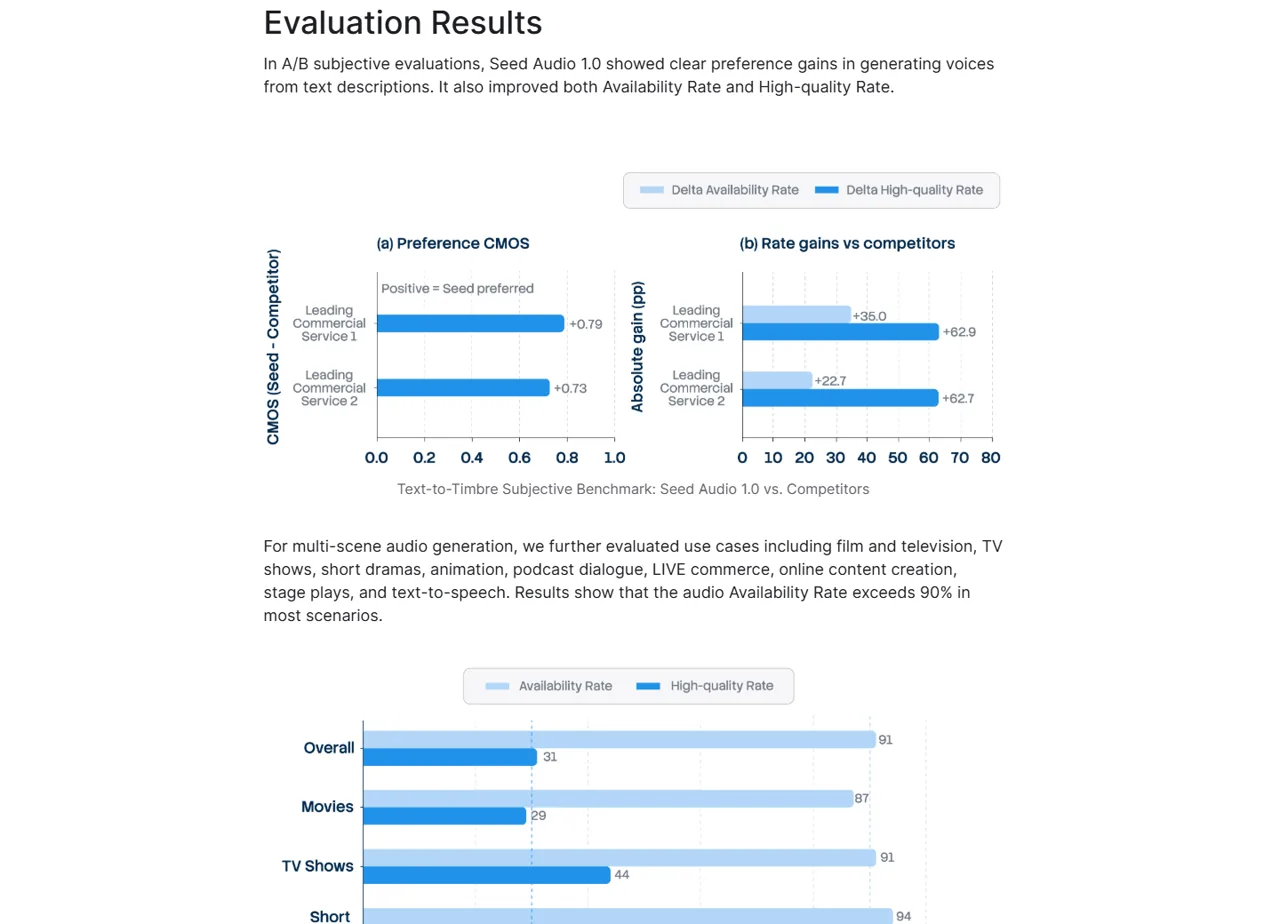
Seed Audio 1.0 是字節跳動 Seed 旗下的一體化文字轉語音生成模型。它不再將語音、環境音、音效和音樂視為獨立的任務,而是能將它們整合生成一個完整的聲音場景。 官方產品頁面指出,該模型支援以 100 毫秒為間隔的對話時序控制,且單次處理即可生成長達兩分鐘的內容。.
這種統一的設計才是真正的魅力所在。一個提示語可以描述說話者是誰、他們的聲音聽起來如何、房間裡發生了什麼、哪些音效會在後面加入,以及場景背景中播放著什麼樣的音樂。若執行得當,最終效果聽起來會像是一首精心譜寫的樂曲,而非拼湊而成的片段。.
這裡存在一個重要的區別。字節跳動自身的發展藍圖指出,目前細緻的時序控制主要集中於角色對白。對於音效、環境音及配樂的更精確控制,仍是需要進一步發展的領域。我們的測試結果也印證了這項區別:對白時序表現極佳,但音效的精確計數則較不穩定。.
2026年8月6日查證的官方資料:
我們如何測試 Seed Audio 1.0
我們設計了九項任務,並執行了 23 次計分生成。大多數能力測試都進行了兩到三次重複測試,因為單一經過潤飾的樣本幾乎無法反映量產可靠性。.
| 測試 | 任務 | 跑壘 |
|---|---|---|
| T01 | 富有表現力的英語旁白 | 3 |
| T02 | 兩位角色的無線電對話 | 3 |
| T03 | 0、4 和 9 秒處的對話 | 3 |
| T04 | 僅含特效的走廊場景 | 2 |
| T05 | 人聲、環境音、音效及音樂 | 3 |
| T06 | 獨立器樂作品 | 3 |
| T07 | 英、日、德三種語言中的一個字元 | 2 |
| T08 | 120 秒的播客獨白 | 2 |
| T09 | 接續自參考語音 | 2 |
這 23 項預定產出包含約 12.5 分鐘的生成音訊,並透過測試環境回報上游生成成本為 $1.7504。Seed Audio 未回傳文字代幣的使用量。計費是根據生成的秒數計算,因此生成代幣被記錄為「不適用」。.
所有經評分處理的輸出皆為 40 kHz、16 位元、立體聲 PCM WAV 檔案。當無法進行直接自動播放時,Gemini 3.6 Flash 會接收這些 WAV 檔案作為音訊輸入,並回傳結構化轉錄本、事件檢查結果、時間估算值及人工痕跡註記。 這些判斷結果屬於自動化聆聽評估,而非人工 MOS 評分。.
聲音表現:高音令人印象深刻,但重複性不穩定
T01 · 富有表現力的敘述
高變異度其中一段聽起來像是幻聽般的冗長獨白,一段聽起來生硬做作,而另一段則自然流暢且完整。.
使用的提示詞
一位語調平穩的女旁白說出兩句完全相同的台詞,情緒從擔憂轉為自信。沒有配樂或音效。.旁白提示要求一位語調平穩的女性旁白員,在沒有背景聲音的情況下,朗讀兩句完全相同的句子,情緒從克制的擔憂逐漸轉為日益增強的自信。.
這三輪測試的表現截然不同:
- 第 1 輪: 說出了要求的句子,隨後又繼續說了幾秒鐘含糊不清、未經預先準備的話。.
- 第 2 輪: 雖然說出的內容與原文完全一致,但語速較慢,且帶有斷續的語調。.
- 第 3 輪: 以自然流暢的方式完整演繹了整段台詞,節奏掌控得恰到好處,且語調始終如一。.
這是本評測的核心要點。Seed Audio 1.0 雖能呈現出色的語音表現,但對於措辭極為關鍵的工作而言,單次生成結果並不足夠。在發布前,請生成多種替代方案,並仔細聆聽整個語音片段。.
該模型在所有三次敘述測試中均遵守了負面指示:未偵測到任何音樂、音效或不必要的背景噪音。.
多角色對話與說話者分離
T02 · 雙人廣播劇
3/3 完整腳本這三份劇本的內容完全一致。各次拍攝的現場環境音及引言長度則有所不同。.
使用的提示詞
瑪雅輕聲低語,伊萊沉著地回應,而冰箱的嗡嗡聲則在三段固定的對話輪次中隱隱作響。.這段便利商店場景使用了兩位成年角色和三句固定台詞。瑪雅必須緊張地低語,而伊萊則試圖讓語氣聽起來平靜。唯一要求的背景音效,是冰箱輕微的嗡嗡聲。.
這三段播放都以正確的順序呈現了對話,且有兩種截然不同的聲音。表現最佳的那段播放,不僅台詞精準無誤、講者聲音分明、情感傳達真摯,還伴隨著持續不斷的冰箱嗡嗡聲。.
其餘的片段則出現了較輕微的場景層級問題。其中一個片段在30秒的片長中,大約花了前半段時間播放環境音,才開始對話;另一個則省略了要求加入的冰箱運轉聲。雖然這兩處失誤並未破壞對話場景的效果,但都降低了剪輯效率。.
就有聲劇而言,實際效果令人鼓舞:Seed Audio 能掌握角色轉折與聲線對比。您可能仍需剪去冗長的開場白,或重新生成以獲得合適的環境音。.
對話的節奏掌控是表現最出色的一項
T03 · 提示層級的計時
最可靠這三組運行結果均將線段定位在指定點附近,且位置落在評估器的時間不確定性範圍內。.
使用的提示詞
請在 0.0、4.0 和 9.0 秒處放置三條廣播對白,分別由男性、女性和男性配音員配音。.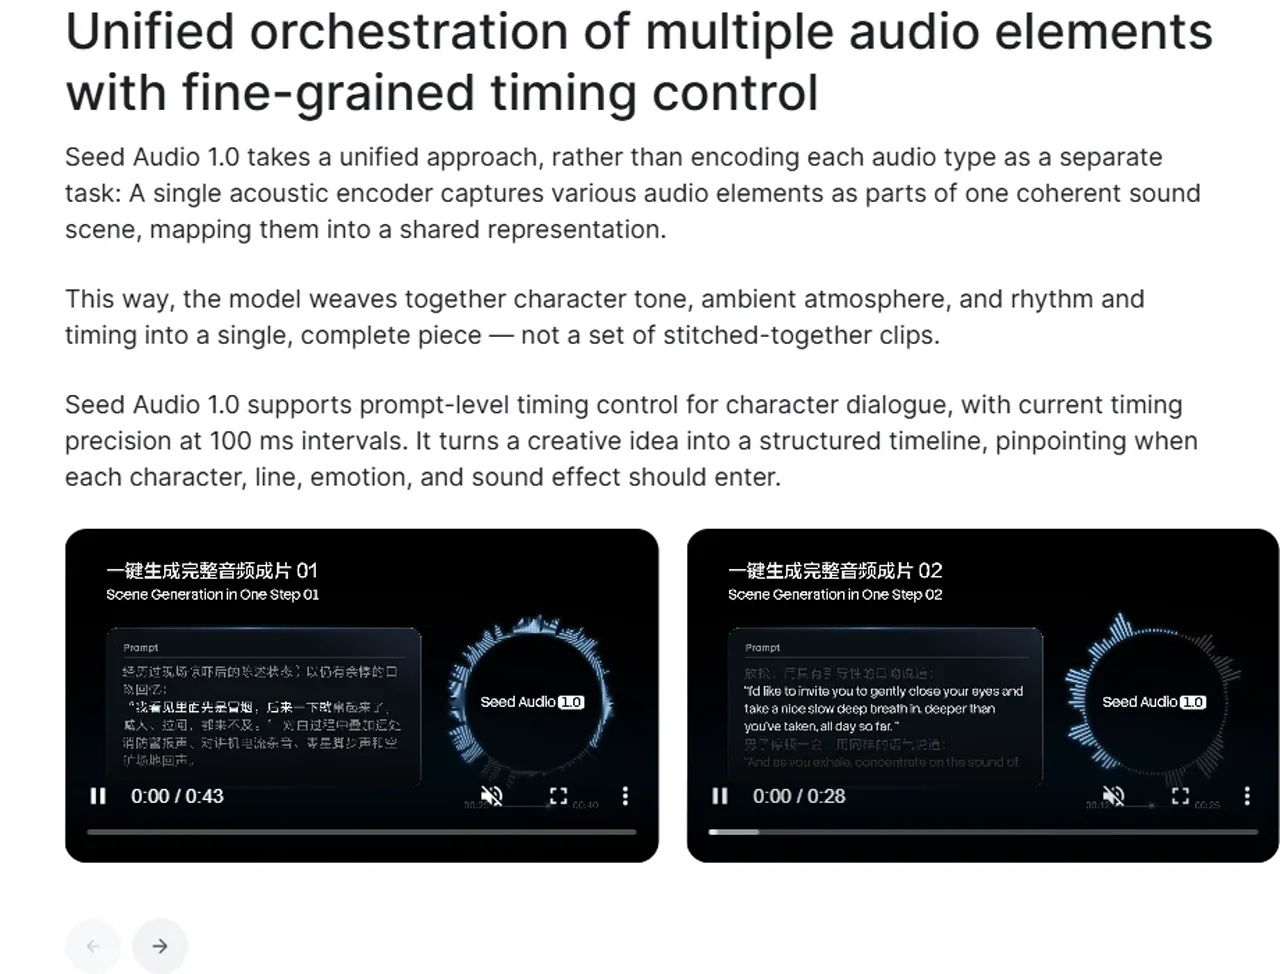
該時序測試要求三條無線電線路:
- “「第七小組,報告。」於 0.0 秒時。.
- “「北側入口已確保安全。」於 4.0 秒時。.
- “9.0 秒時出現「保持原地」。.
在全部三輪測試中,語句、順序以及「男-女-男」的發言者模式均正確無誤。Gemini 的音訊估算結果顯示,重複測試的起始時間約為 0.1、4.0 及 9.0 秒。 第一輪的估計值分別約為 0.1、3.9 和 8.9 秒。.
這些測量結果不應被視為具備 100 毫秒精度的實驗室級證據——評估工具本身就指出其不確定度約為 0.1 秒。即便有此限制,這仍是我們測試中重複性最佳的功能。若您需要讓對話精準插入至接近預定時間軸的位置,Seed Audio 1.0 展現出非比尋常的潛力。.
特效生成:逼真的場景,計數不精確
T04 · 僅含音效的走廊
計數失敗空間感與秩序感都令人信服,但這兩次奔跑分別產生了四聲腳步聲和兩聲腳步聲。.
使用的提示詞
鑰匙聲、一扇沉重的門、正好三步的腳步聲、雷鳴,以及最後一聲砰然關門聲。沒有人聲,也沒有音樂。.這則僅限音效的提示描述了一條鋪著磁磚的小走廊:麥克風旁有鑰匙,一扇厚重的木門打開,三聲緩慢的腳步聲逐漸遠去,遠處傳來雷聲,最後是門被重重關上的聲音。禁止出現對話和音樂。.
這兩種輸出方式均營造出逼真的聲學空間,保留了事件的發生順序,並避免了人聲或音樂的滲漏。其效果被評為逼真,且具備良好的距離感與空間一致性。.
這兩次播放的音效數量都不完全吻合。一次產生了四個腳步聲;另一次則產生了兩個。這使得 Seed Audio 雖然能用於生成令人信服的音效概念,但當剪輯師需要精確的三次撞擊聲、敲擊聲、腳步聲或槍聲時,其可靠性便稍顯不足。.
最佳的工作流程是先使用單次處理的 SFX 生成技術來營造氛圍並進行快速原型製作,接著在數位音訊工作站(DAW)中替換或編輯那些對計數要求嚴格的事件。.
單一場景中的配音、環境音、音效及音樂
T05 · 完整電影版混音
已完成 2/3每組提示中,有兩組都完成了三輪。其中一組錯過了最後的金屬撞擊。.
使用的提示詞
雨巷、車流、警笛聲、偵探的低語、弦樂的脈動、急促的腳步聲,以及金屬撞擊的聲響。.
這場完整場景的測試刻意營造出擁擠的氛圍。其中包含潮濕的夜間小巷、水滴聲、車流聲、遠處傳來的警笛聲、偵探的低語、克制的弦樂、急促的腳步聲,以及金屬門被重重關上的聲響。.
三段播放中,有兩段完整呈現了事件的整個序列。對話在環境音與音樂的襯托下依然清晰可辨,且場景在空間上具有連貫性,而非像幾段無關的片段疊加在一起。其中一段播放雖在其他方面成功營造出正確的氛圍並精準重現了台詞,卻遺漏了最後那聲金屬撞擊聲。.
這正是統一模型展現最大優勢之處。在分鏡腳本製作與創意構思方面,從單一提示生成完整的混合場景,比分別蒐集每個組成部分來得更快且更具表現力。至於最終製作階段,重要的結尾提示仍需進行驗證。.
Seed Audio 1.0 能生成音樂嗎?
T06 · 獨立音樂
音樂作品這三首作品皆屬結構性音樂。其中一首讓帶弱音器的鋼琴聲難以辨識。.
使用的提示詞
一首每分鐘 72 拍的懸疑配樂,包含大提琴固定音型、弱音鋼琴、類比持續音、漸強段落,以及未解決的結尾。.
是的。在我們的測試中,Seed Audio 1.0 生成的是一段可辨識的獨立器樂作品,而非僅僅是模糊的環境音效。.
創作提示要求製作一段 30 秒的懸疑配樂,節拍為 72 BPM,包含低音大提琴的固定音型、帶弱音器的鋼琴脈動、柔和的類比持續音、清晰的漸強,以及未解決的終結和弦。這三段試作均形成了一段連貫的音樂片段,具備要求的節奏感與結尾。 其中兩段包含所有要求的元素;但在其中一段中,弱音鋼琴的聲部較難辨識。.
這並不代表 Seed Audio 就能自動取代專用的歌曲生成器。我們的任務是製作一段簡短的電影配樂,而非帶有歌詞的副歌與主歌結構的歌曲。儘管如此,其音樂生成能力仍相當強大,足以支援遊戲場景、預告片、播客以及預視化製作——特別是在音樂必須與語音及音效設計在同一生成過程中相互配合的情況下。.
多語言效能:最佳情況下表現優異,最差情況下則較弱
T07 · 一個聲音,三種語言
1/2 已清理其中一次執行過程完美無瑕;另一次則在語言切換時出現了重複和語無倫次的現象。.
使用的提示詞
某位女性角色以相同的身份和沉穩的情緒,流利地說著英語、日語和德語。.
這項多語言任務要求一位女性角色以英語、日語和德語詮釋同一個錄音場景中的角色。兩次錄製呈現出截然不同的印象。.
表現較佳的執行結果準確地呈現了這三句話,保留了相同的語調,情緒保持平穩,並運用了流暢的停頓。表現較差的執行結果雖然以英文開頭時正確無誤,但在日文段落處卻出現重複與語音失真,並破壞了德文開頭的部分。其跨語言語調的一致性明顯下降。.
這意味著 Seed Audio 1.0 能夠呈現令人信服的多語言角色表現,但此功能需要多個候選方案,並需進行具備語言意識的審核。請勿僅透過檢查第一種語言來核准多語言輸出結果。.
兩分鐘內生成與長篇語音的穩定性
T08 · 120 秒獨白
2/2 穩定版這兩份檔案的錄音時間均達 120 秒,且均以穩定的語調進行。其中一份檔案有短暫的發音磕絆。.
使用的提示詞
一位男性播客主持人講述了一個結構清晰的氣象站故事,其中包含三項發現,但未提及任何背景。.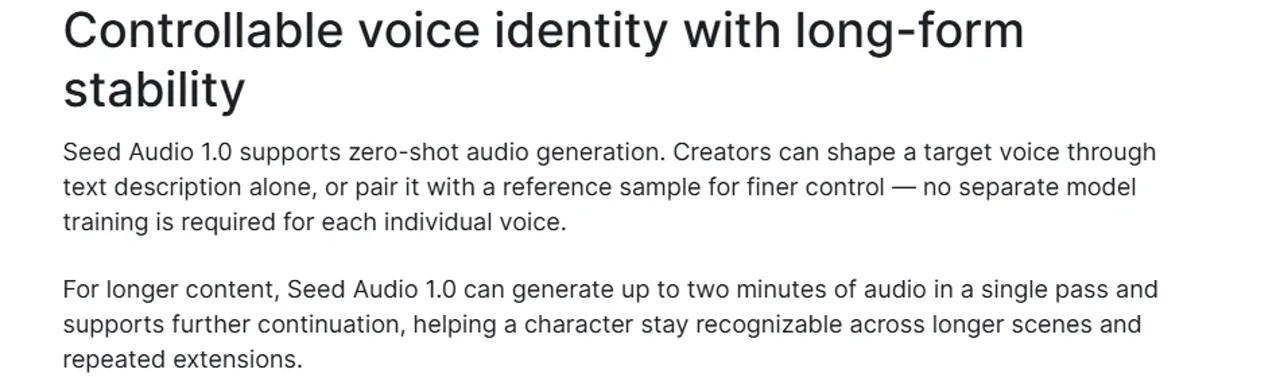
這兩項長篇任務所產生的 WAV 檔案長度均精確為 120 秒。兩者皆採用一名男性播客主持人的聲音,背景為簡潔的錄音室音效,沒有音樂,也沒有音效。.
首次運行過程中,敘事語調始終如一,且調查結構連貫:開場清晰明瞭,隨後依時間順序揭露三項發現,情緒從好奇逐漸轉為不安,最後留下一個未解之謎。未發現明顯的語調偏移或內容混亂的段落。.
第二次生成同樣連貫且穩定,僅在 1:31 左右出現一次短暫的發音磕絆。對於一段長達兩分鐘、僅經單次生成的獨白而言,這已是一項優異的成果。這顯示 Seed Audio 所宣稱的「長篇內容」能力並非僅止於時長限制;該模型能夠在整個時間區間內維持角色特質與敘事結構。.
參考音訊的連續性需謹慎處理
T09 · 參考資料續篇
路線未定文字內容完全正確,但語音相似度較低;其中一項輸出結果被改為男性聲音,並添加了音效。.
使用的提示詞
延續自一位經授權的女性敘述者,同時保留其聲音特質與親密的敘述風格。.該參考測試採用了敘事風格最強烈的樣本作為授權輸入,並要求以相同的大致女性身份及親密錄音風格來進行後續敘述。.
兩組輸出結果雖完全符合要求的續接內容,但均未能與參考音檔良好匹配。第一組轉為帶有氣音的低語,其聲音相似度評分為保守的 2/5;第二組則被判定為使用男性聲音,相似度評分為 1/5,且在開始說話前還附加了約 17 秒的不必要音效。.
此處存在一項重要的環境限制。Anywhere 任務端點雖然接受了參考欄位,但並未回傳確認訊息,說明上游模型如何使用該參考。這些結果證明,透過我們的測試路徑,參考的連續性並不可靠;但並不能證明 BytePlus 的原生 API 總是會以相同方式運作。.
Seed Audio 1.0 的定價與限制
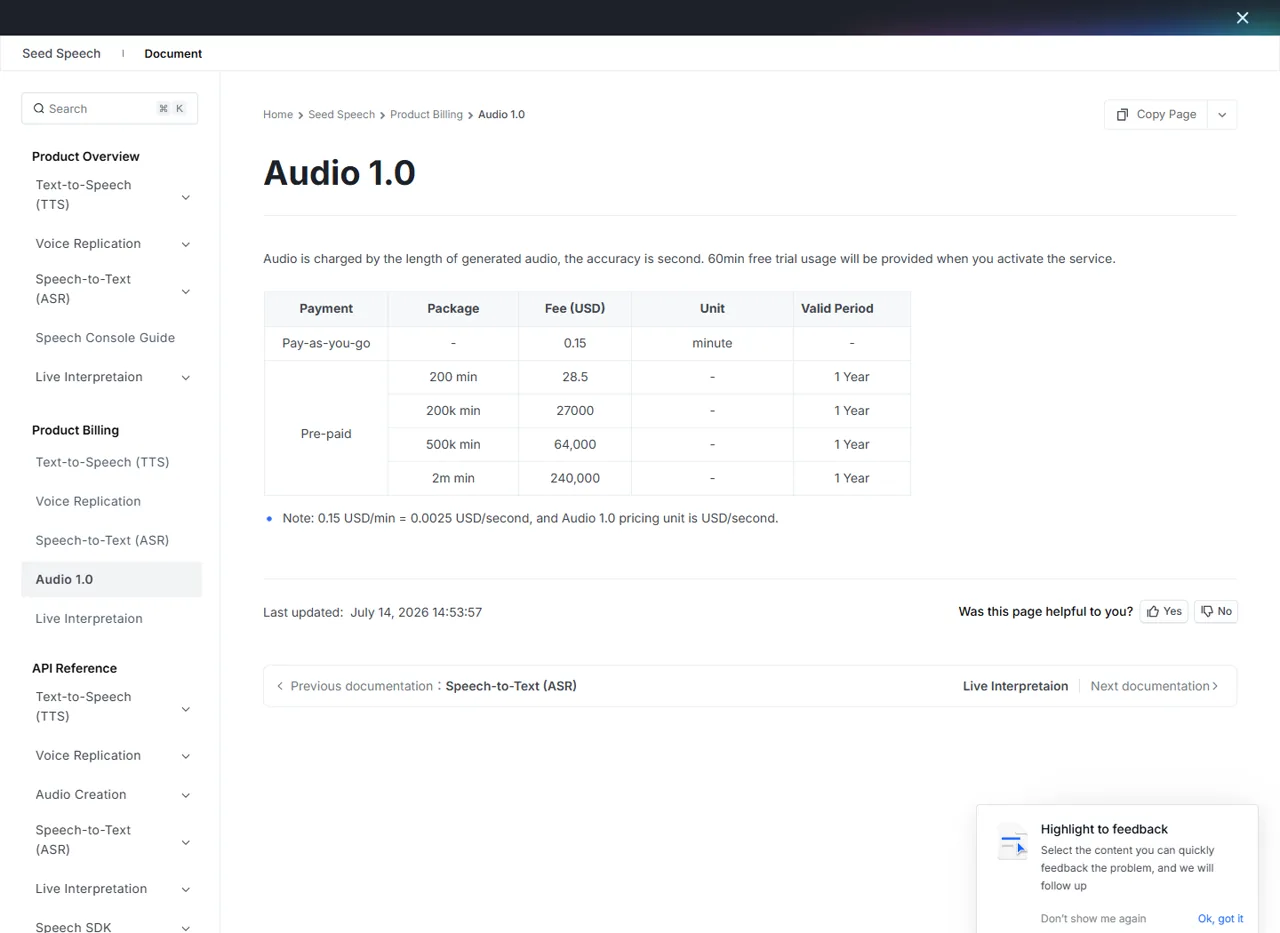
按秒計費,啟用服務時可享 60 分鐘免費試用。.
最大輸出
提示字元
音訊參考資料
參考圖片
BytePlus 列出的官方隨用隨付價格為 每產生一分鐘 $0.15, ,按秒計費,並以 60 分鐘免費試用 當服務啟用時。API 文件中設定了 120 秒的最大輸出, 支援長度最高達 3,000 字元, 最多可容納 三個參考音訊片段, ,並接受一張參考圖片。.
每個參考音訊片段最長可達 30 秒,檔案大小上限為 10 MB。參考圖片的上限為 10 MB。這些是 BytePlus 本身的限制;第三方平台可能會提供較小的輸入表單,或採用不同的定價方式。.
我們的 Anywhere/BrolyAI 測試路線將上行成本單獨列出,平均每生成一分鐘約為 $0.14。請勿將該測試環境的數據與 BytePlus 的零售定價或其它平台的最終價格混為一談。.
Seed Audio 1.0 的優缺點
其優勢所在
- 統一的配音、音效、環境音及配樂
- 絕佳的對白節奏
- 鮮明的長篇敘事風格
- 實用的電影配樂
斷裂之處
- 各次採樣間的變異性較大
- 偶爾會出現語音失真
- 弱精確 SFX 計數
- 我們路線上的參考連續性不可靠
優點
- 一次處理即可生成人聲、環境音、音效及音樂。.
- 在我們反覆進行的測試中,對話的時機掌握得非常出色。.
- 強烈的雙揚聲器分離感與精準的劇本演繹。.
- 創作實用的獨立電影配樂。.
- 在兩分鐘內保持語調一致性與敘事連貫性。.
- 透過我們的測試路徑輸出清晰的 40 kHz 立體聲 WAV 檔案。.
優點
- 重複執行結果在自然度與可靠性方面可能存在極大差異。.
- 偶爾會出現幻聽或語無倫次的情況。.
- 音效的確切次數並不可靠。.
- 某些完整的場景缺少了最後一個要求的事件。.
- 多語言表現需要仔細審查。.
- 在我們的測試環境中,參考語音的連續性較差。.
- 高並行提交觸發了上游的並發錯誤,儘管失敗的任務並未被計費。.
哪些人適合使用 Seed Audio 1.0?
Seed Audio 1.0 非常適合那些以「場景」而非「獨立素材」來構思的音訊創作者。它特別適用於廣播劇、遊戲對白、電影原型、音訊分鏡腳本、播客概念以及短篇懸疑配樂。.
若將其視為「一鍵式最終交付」系統,說服力則稍顯不足。若精確的措辭、聲音特質或事件次數在法律或創意層面上至關重要,請預留反覆生成與人工審核的流程。當您將此模型視為一位能提供數次錄音版本的「快速音訊導演」——而非確定性的渲染器——時,其效能方能發揮最佳效果。.
常見問題
Seed Audio 1.0 是否為文字轉語音模型?
Seed Audio 1.0 能否產生不含語音的音效?
Seed Audio 1.0 能生成音樂嗎?
Seed Audio 1.0 最多能生成多久?
Seed Audio 1.0 是否支援參考音訊?
Seed Audio 1.0 的售價是多少?
最終裁決
Seed Audio 1.0 是一個真正引人入勝的統一音訊模型。它能夠僅憑一個提示語便生成逼真的語音、音效、環境音及音樂,這不僅僅是上市時的宣傳口號:我們的混合場景與音樂測試顯示,這些元素確實能夠完美融合。.
該模型最突出的優點在於對話的節奏掌控,而最大的弱點則在於一致性。在 23 個樣本中,該模型屢次展現出極佳的最佳表現,但備用版本的表現卻明顯較弱。.
對於創意原型製作而言,這種取捨很容易接受。生成多個版本,保留最出色的版本,並仔細檢視每個結尾。至於確定性的量產、精確的語音匹配,或是對事件計數敏感的工作,則應在工作流程中保留人工審核與編輯的階段。.
總體評價: Seed Audio 1.0 是我們測試過的功能最強大的場景級音訊生成器之一,但它最適合用作多段式創作工具,而非一次性最終渲染器。.