

快速回答: 一份可靠的 Kling 3.0 提示應描述觀眾應看到和聽到的內容:主體、可見的動作、攝影機的運作方式、場景、燈光以及音效。請將其視為實用的檢查清單,而非僵化的正式公式。對於包含多個鏡頭的片段,請為每個鏡頭標註名稱並註明其時間範圍。.
然而,若試圖直接在影片生成器中憑直覺猜測這套公式,會迅速耗盡昂貴的點數。每當你的提示語失敗,或是被嚴格的安全過濾器攔下時,你不僅會損失金錢,更會打斷創作的勢頭。.
即使提示語含糊不清,仍可能產生一幅引人注目的畫面,但這會使 Kling 獲得較少的關於動作、連續性、對話及聲音的線索。了解如何 AI 影片片尾字幕功能 讓預留付費生成量額給已準備好進行測試的提示語變得更加容易。.
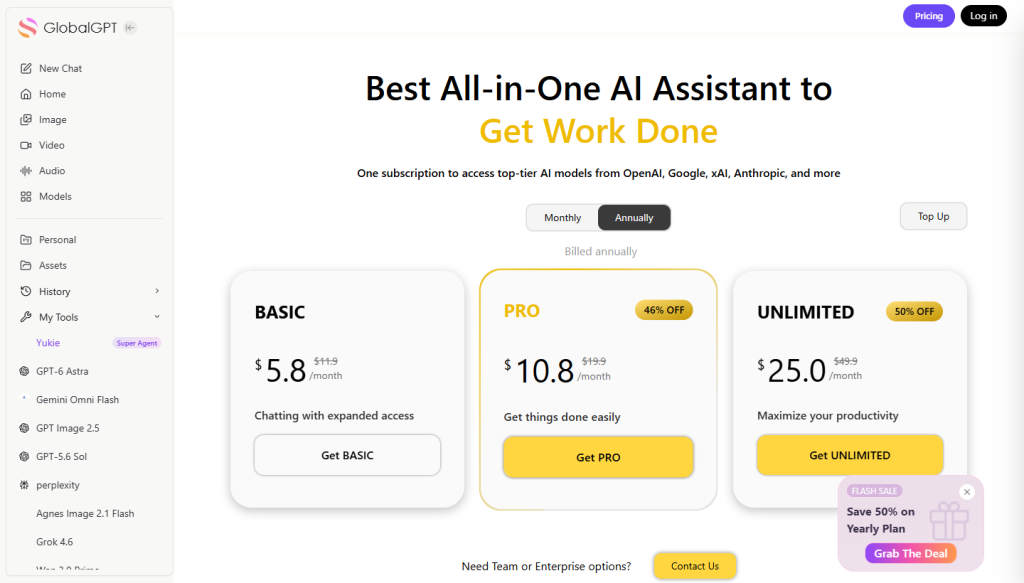
GlobalGPT 將規劃與生成步驟整合於同一個工作區中。您可以使用 GPT-5.6 Sol 若要精簡鏡頭清單,請使用受支援的圖像模型建立參考圖像,然後透過 Kling 3.0 為其製作動畫。 GlobalGPT 列出的 Pro 方案,若以年繳方式計費,每月費用為 $10.8;價格與信用規則可能有所變動,因此訂閱前請先確認訂購頁面。.

Kling 3.0 提示指南,創造更好的 AI 影片:什麼是「導演心態」?
所謂的「導演思維」,是指在撰寫文字提示時,應彷彿正在真實的電影片場中,向攝影師和演員下達具體的拍攝指示,而非僅是描述一幅畫的樣貌。.
- 擺脫依賴圖片提示的習慣: 像「美女、4K、傑作、極致細膩」這樣的清單,雖然能描述外觀,卻未能說明隨時間推移會發生什麼變化。請加入一項明確的動作和一項攝影機指示。.
- 優先採取可見的行動: 與其寫「地板上有一片碎玻璃」,不如寫「一個玻璃杯從桌上掉落,摔得四分五裂散落在地板上」。具體的動詞能讓模特兒有具體的場景可演繹。這 Kling AI 攝影機移動指南 在選擇該事件發生時鏡頭的反應方式時,這點非常有用。.
- 盡早確立主題: 在加入背景細節之前,先確定主要的人物或物體。這樣能提高畫面將觀眾注意力集中於預定主體的機率,儘管無法保證完全一致。.
如何構建一個有力的 Kling 3.0 提示語?
一個實用的單鏡頭提示可以遵循五部分的骨架結構:鏡頭 + 場景 + 主角動作 + 視角/光線 + 音效。這是一個實用的寫作框架,並非僅適用於 Kling 的正式規則。若您希望撰寫更長的片段,請改用標註鏡頭的方式,而非硬將每項指示都塞進同一句中。工作流程在 如何像專業人士一樣使用 Kling 3.0 說明了這些選擇如何融入完整的生成流程中。.
- 先從相機說起: 畫面構圖與鏡頭運動,例如「靜態特寫」或「緩慢向前推的推車鏡頭」。除非過場效果至關重要,否則每個鏡頭應僅使用一種主要鏡頭運動。.
- 設定場景與情節: 請描述場景、主角,以及主角當下的動作:「在東京一條霧氣瀰漫的街道上,一名賽博龐克偵探舉起紙杯,凝視著街上的車流。」“
- 以視覺與聽覺效果收尾: 加入可描繪的燈光、氛圍及聽覺細節:「霓虹燈的倒影、雨夜的午夜、遠處的車流聲、雨水敲打遮陽篷的聲響。」“
- 請根據鏡頭的需求,盡可能提供詳細的資訊: 並不存在經證實的「20至50字」最佳範圍。應刪除矛盾之處與冗贅的修飾語,但須保留那些涉及時間節奏、對白、音效或情節連貫性的細節。.
單次拍攝範本:
[鏡頭與構圖]。[主角] 在 [場景] 中進行 [可見的動作]。[燈光與視覺風格]。音效:[對白、環境音及音效]。請確保 [重要的連續性細節] 保持一致。.多幀模板:
鏡頭 1(0-2 秒),[構圖/運動]:[主體與動作]。
鏡頭 2(2-5 秒),[構圖/運動]:[下一動作與對白]。
音效:[環境音]、[特定音效]、[發言者與語調]。
連續性:確保兩個鏡頭中 [臉部/服裝/道具/場景佈局/光線方向] 保持一致。.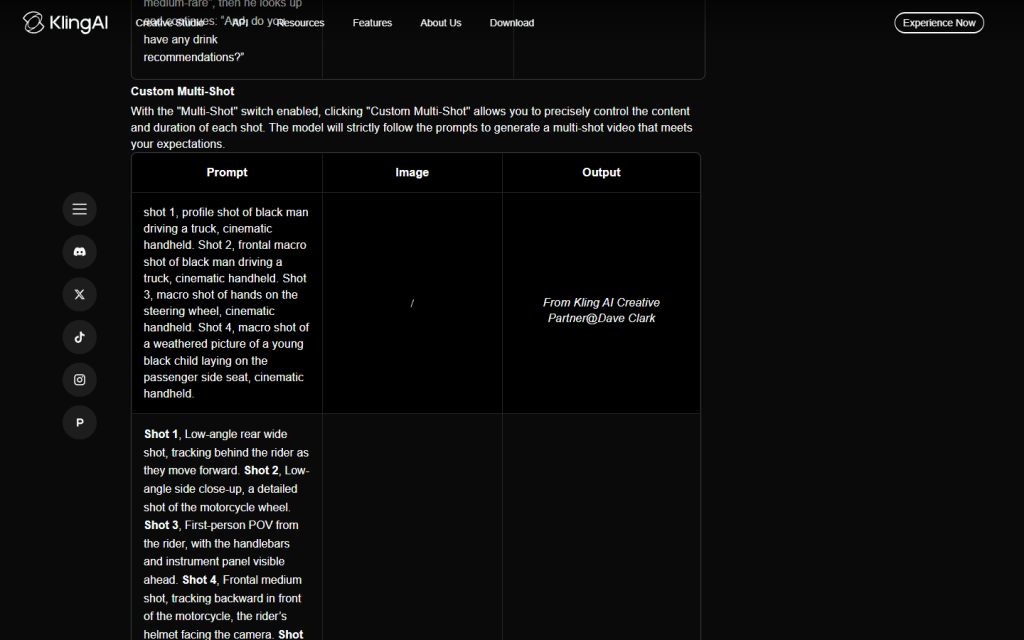
什麼是攝影機移動和原生音訊的最佳提示?
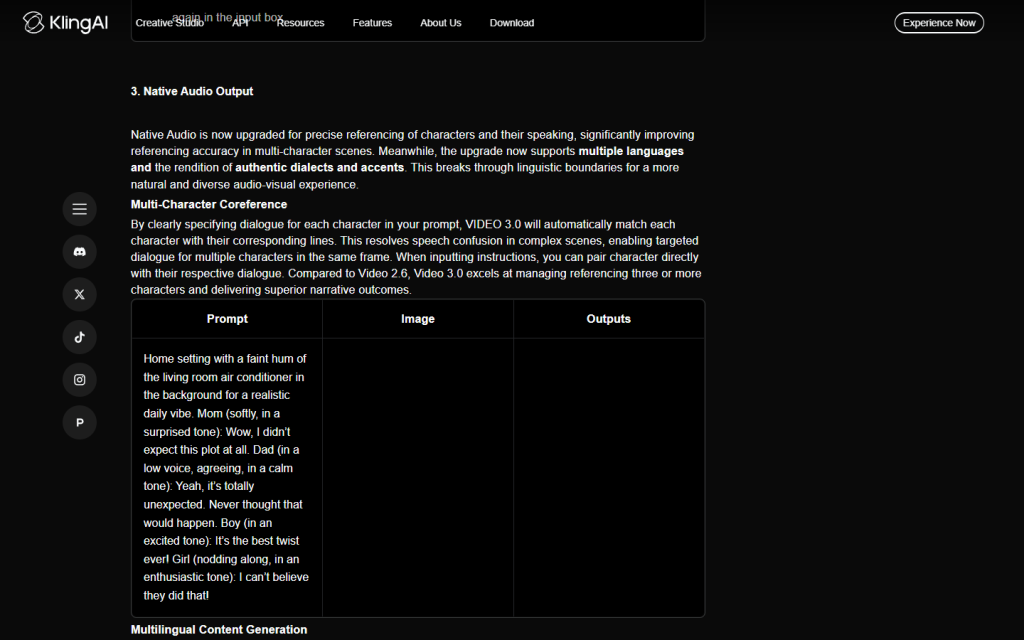
最理想的攝影機運動提示應使用「跟拍」或「平移」等傳統好萊塢術語,而原聲效果則可透過將對白置於引號內並描述音效來觸發。.
為了更清楚地判斷聲音來源方向,請辨識說話者、說話方式、環境音及音效。根據 官方 Kling 影片 3.0 指南, VIDEO 3.0 支援原生音訊與自訂多鏡頭生成;原生音訊不僅限於 Omni 模型。.
- 使用準確的相機用語: “「跟拍」是指讓攝影機跟隨拍攝對象移動。「無人機俯拍」則能呈現高空俯瞰視角。「三腳架靜態拍攝」是指在畫面內發生動作時,攝影機保持靜止不動。.
- 讓每個鏡頭只負責一項任務: 若需要一個廣角鏡頭和一個細膩的反應鏡頭,請將它們分別列為「鏡頭 1」和「鏡頭 2」。這樣比在同一個時間點同時要求拍攝廣角鏡頭和極度特寫鏡頭更為清晰。.
- 環境音效名稱: 加入可感知的聲音,例如「濕潤礫石上的沉重腳步聲」、「雨簾上穩定的雨聲」,或是「遠處的雷聲」。對於以質感為主導的場景,同樣的原則也適用於一個 Kling ASMR 影片製作流程.
- 將對白指派給角色: 請寫下角色名稱、精確台詞以及說台詞的方式:
那名士兵以低沉而疲憊的聲音輕聲低語:「我們終於要回家了。」" - 請選擇一種受支援的對話語言: Kling 的《VIDEO 3.0》指南列出了中文、英文、日文、韓文和西班牙文,其中中文和英文還標註了數種口音或方言。.
專業級 Kling 3.0 提示範本 (複製與貼上)
[動作與對白提示]
靜態特寫鏡頭,一名身處泥濘戰壕中的疲憊士兵抬頭望向天空,大雨傾盆而下,他低聲說道:「我們終於要回家了。」畫面採用電影式的暗調光影,氛圍沉鬱。.
[物理與運動提示]
慢動作跟拍鏡頭,一輛跑車在陡峭的山路彎道上漂移,輪胎冒著煙並將碎石濺向鏡頭,午後的陽光燦爛,逼真的 8K 畫質。.[導向式多鏡頭對話提示]
鏡頭 1(0-2 秒),靜態特寫:一名身處泥濘戰壕中的疲憊士兵緩緩抬頭,大雨正沿著他的頭盔流下。 第二鏡(2-5 秒),輕柔的手持推近鏡頭:他呼出一口氣,目光仍注視著天空,以低沉而疲憊的聲音輕聲低語:「我們終於要回家了。」音效:雨水穩穩地打在帆布上,遠處的雷聲,以及布料輕微晃動的聲音。採用電影式的低調照明,營造沉鬱的氛圍。 兩個鏡頭中,臉部、軍裝、戰壕佈局及雨勢方向均需保持一致。.參考圖像如何提升 AI 影片的一致性?
參考圖片為 Kling 提供了關於臉部、服裝、道具及風格的視覺起點。它們能提升一致性並減少重複的視覺描述,但並不會永久鎖定每個細節。優質的參考圖片搭配針對性的動作提示,效果仍最佳。如需更多關於連貫性的技巧,請參閱這篇關於 Kling 人工智慧角色的一致性.
- 移除重複的外觀細節: 一旦附上了合適的角色圖像,請將提示詞的篇幅多花在動作、鏡頭運用和聲音上,而不是重複描述頭髮、服裝和臉部特徵。.
- 請描述符合該來源的運動: 特寫肖像適合表現克制的面部表情;全身照則能為模特兒提供更多關於走姿或手勢的資訊。這 Kling 圖像轉影片工作流程 更詳細地說明了原始圖像的準備工作。.
- 重申連續性優先事項: 如果臉部、服裝、道具或光線方向是最重要的,請明確指出。參考資料能提高連貫性的機率;但並不能完全避免形變或場景偏移。.
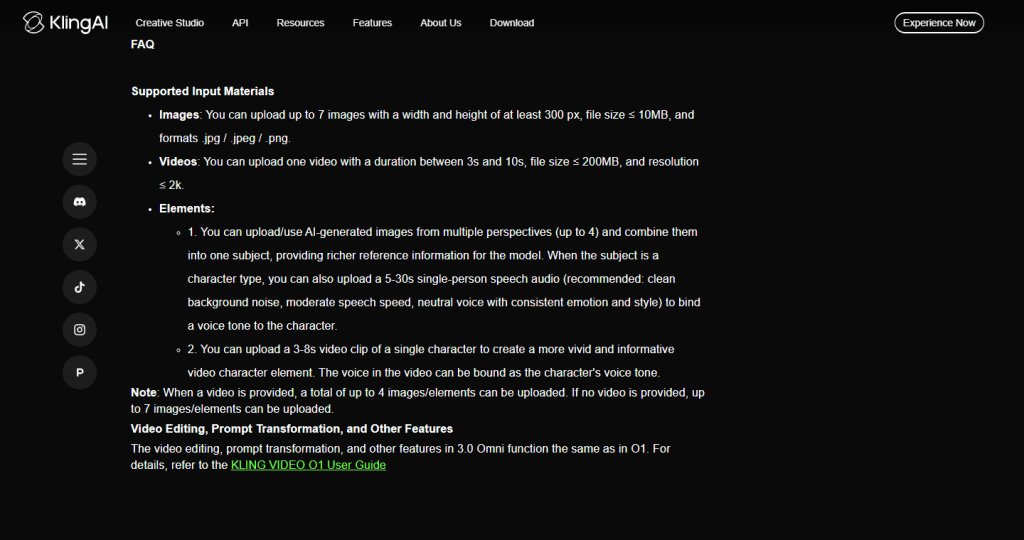
的 官方《VIDEO 3.0 Omni》指南 支援最多上傳七張圖片或一段 3 至 10 秒的影片。若上傳影片,本指南將額外圖片/元素的數量限制為四項。此外,檔案大小與最小尺寸的規定同樣適用,因此在準備大量檔案前,請先確認當前的上傳面板設定。.
| 輸入 | 最適合用於 | 提示重點 | 主要注意事項 |
|---|---|---|---|
| 僅文字 | 概念探索與沒有固定角色的場景 | 主題、動作、攝影機、場景、燈光、音效 | 必須描述更多視覺細節 |
| 參考圖片 | 已知的角色、物品、服裝或視覺風格 | 動作、攝影、表演、聲音 | 一致性雖有改善,但無法保證 |
| Omni 中的參考影片 | 來自現有片段的動作或連續性線索 | 該保留什麼、該改變什麼 | 現行時長限制及同伴參與限制依然適用 |
如何建立多模型工作流程以節省世代點數?
您可以使用快速的文字 AI 來撰寫腳本,使用高品質的影像 AI 來產生參考圖片,最後只使用 Kling AI 來製作實際動畫,以建立多模型的工作流程,大幅降低成本。 浪費信用額.
節省的成本會因專案而異,但此流程將低成本的修改工作提前至影片製作之前進行。在這個工作流程中,同樣的準備邏輯也體現在 將圖片轉為電影般的 Kling 影片.
- 撰寫鏡頭簡報: 請請 GPT-5.6 Sol 或其他能力出色的文本模型,標記出矛盾的敘事框架、對話歸屬不明確、過渡段落缺失,以及鏡頭過度堆砌等問題。請將這份草稿視為一位剪輯師,而非 Kling 當前限制的權威。.
- 建立參考資料: 生成或選擇一張能清楚呈現該動作所需的主體、服裝、道具及構圖的圖片。.
- 在 Kling 3.0 中製作動畫: 加入參考資料後,請將提示語主要用於動作、鏡頭、時機及音效。在擴展場景之前,先生成一個受控的變體。.
- 檢視可觀察到的故障: 請注意角色形象偏離、漏拍動作、鏡頭移動不當、音訊平衡及情節連貫性。每次只調整一項因素。.
觀看:如何像導演一樣提示 AI 影片
在這個深入探討的教學中,看看專業的 AI 電影製作人如何使用特定的電影提示和參考影像來控制複雜的攝影機動作:
如何修正常見的 AI 提示錯誤和幻覺?
首先,應移除相互衝突的指示,並決定哪種失敗情況最為關鍵。有些平台提供「負向提示」欄位,有些則沒有;即使有此欄位,它雖能減少不想要的模式,卻無法確保渲染結果絕對乾淨。若您同時在比較模型行為與提示內容,這 Seedance 2.0 與 Kling 3.0 比較 提供了有用的背景資訊。.
| 問題 | 可能的原因 | 值得一試 |
|---|---|---|
| 變形的框架 | 該提示要求同時呈現相互矛盾的畫面,例如極度特寫與全身鏡頭 | 每張鏡頭選擇一種畫框尺寸,或將畫面拆分為標有名稱的鏡頭 |
| 錯過的動作 | 在短時間內有太多行動相互競合 | 每個鏡頭應保留一個主要動作節點,並將次要動作移至下一個鏡頭 |
| 情感平淡 | 該提示詞僅命名了一種情緒,卻未展現該情緒 | 描述可見的行為,例如手部顫抖、視線低垂,或臉頰上流下的淚水 |
| 錯誤的講者 | 對話內容未明確標示 | 請指出發言者姓名、引用確切的台詞,並描述其表達方式 |
| 字符漂移 | 外觀細節或參考優先權尚不明確 | 請使用明確的參考依據,並僅重複最關鍵的連續性細節 |
| 背景模糊或畫面抖動 | 快速動作、鏡頭複雜度,或場景切換過於頻繁 | 簡化動作;若介面提供負面提示,請描述該具體物件,但不要期待獲得保證 |
常見問題
Kling 3.0 的最佳提示格式是什麼?
最好的格式是結構化的電影公式:攝影機移動 + 場景描述 + 主體動作 + 照明/氣氛 + 音訊/時間標記。.
如何讓 Kling AI 角色說話?
請列出角色名稱,將對話內容精確地用引號標出,並描述其說話方式。Kling VIDEO 3.0 與 VIDEO 3.0 Omni 均支援原生音訊;目前的 VIDEO 3.0 指南中列出的對話語言包括中文、英文、日文、韓文及西班牙文。.
Kling VIDEO 3.0 的影片片段最長可以多長?
Kling 目前的《VIDEO 3.0》及《VIDEO 3.0 Omni》指南中,列出的影片生成時間介於 3 至 15 秒之間。可用的選項可能取決於所選模式及平台介面。.
Kling VIDEO 3.0 與 VIDEO 3.0 Omni 之間有什麼區別?
這兩款模型均支援原生音訊與多張影像工作流程。VIDEO 3.0 Omni 新增了一項「一體化」參考工作流程,可在現行輸入限制範圍內,將文字與圖片、影片及可重複使用的元素結合。.
我可以在 Kling VIDEO 3.0 Omni 上新增多少個參考資料?
官方 Omni 指南列出最多可上傳七張圖片或一段 3 至 10 秒的影片。若提供影片,則可額外使用最多四張圖片或元素。請查閱當前介面以確認檔案大小與尺寸要求。.
為什麼我的 Kling AI 影片會出現變形或融化的現象?
影片扭曲通常是因為您的提示包含太多指示、相襯的攝影機動作,或是缺乏穩定的參考影像來固定角色的身體細節。.
參考圖片是否比純文字提示更好?
當角色身分、服裝、道具或視覺風格必須保持可辨識時,參考圖像便十分有用。純文字提示則在概念探索方面仍具實用價值。參考圖像雖能提升一致性,但無法保證角色形象能被完美鎖定。.
我可以使用 Kling 3.0 到 GlobalGPT 嗎?
是的。GlobalGPT 具備一個 Kling 3.0 影片工作區,其中包含參考、原生音訊、時長及解析度控制功能。平台定價與信用規則可能有所變更,因此在生成大量批次前,請先確認當前設定。.
總結
更好的 Kling 3.0 提示,重點不在於「魔法關鍵字」,而在於引導可觀察的選擇。 明確界定主題、為每個鏡頭設定清晰的動作與攝影任務、分配對白,並在視覺風格至關重要時運用參考素材。分階段的工作流程能減少可避免的重拍次數,而最終審查仍應檢查連續性、畫面瑕疵及音效。在發布客戶作品前,也請參閱當前的指引,內容關於 Kling 人工智慧商用版.





