GPT-6 Astra 與 Claude Fable 5.1 的標示 API 價格起點相同,但在我們的相容性 API 對比測試中,兩者的表現卻不盡相同。. 在推理、寫作、編碼、長文脈絡檢索及策略制定等領域,Astra 產出了更多可用的可見輸出結果。Fable 在長文脈絡準確度測試中與 Astra 並列第一,並寫出了具說服力的宣傳文案,但在這條特定路徑中,其數次運行結果卻出現截斷或空白的情況。.

簡評
GPT-6 Astra · 43/50
長上下文檢索 · 每題 10/10
相容性路由可能是導致 Fable 輸出為空的原因。.
當您需要在兼具分析與技術性質的工作中獲得可靠的第一輪答案時,請選擇 GPT-6 Astra。 若您的終端裝置已通過可見輸出處理的驗證,且您重視其長上下文解讀能力或精準的行文風格,請選擇 Claude Fable 5.1。此並非通用模型排名:這是 2026 年 9 月 8 日透過 Broly Anywhere 進行的一次受控測試。.
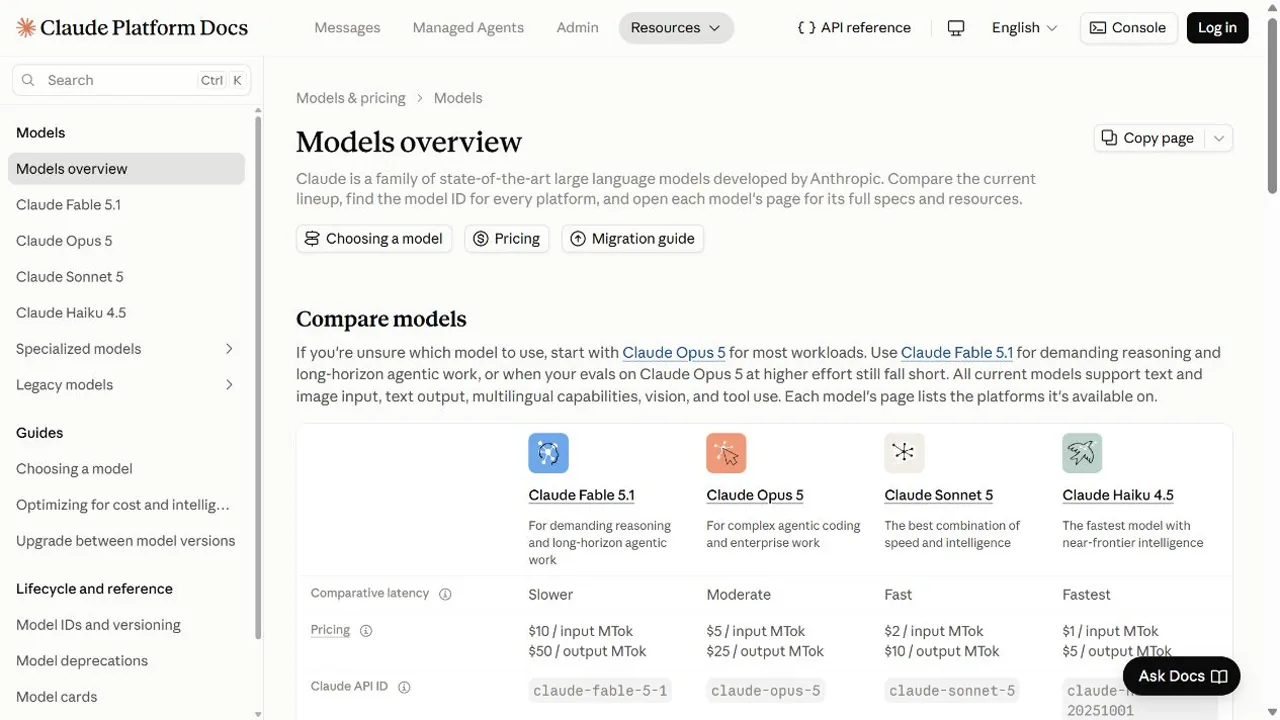
GPT-6 Astra 與 Claude Fable 5.1 規格一覽
| 領域 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| API 識別碼 | gpt-6-astra | 克勞德寓言 5-1 |
| 上下文 | 1.05M 代幣 | 100萬枚代幣 |
| 最大輸出 | 128K 代幣 | 128K 代幣 |
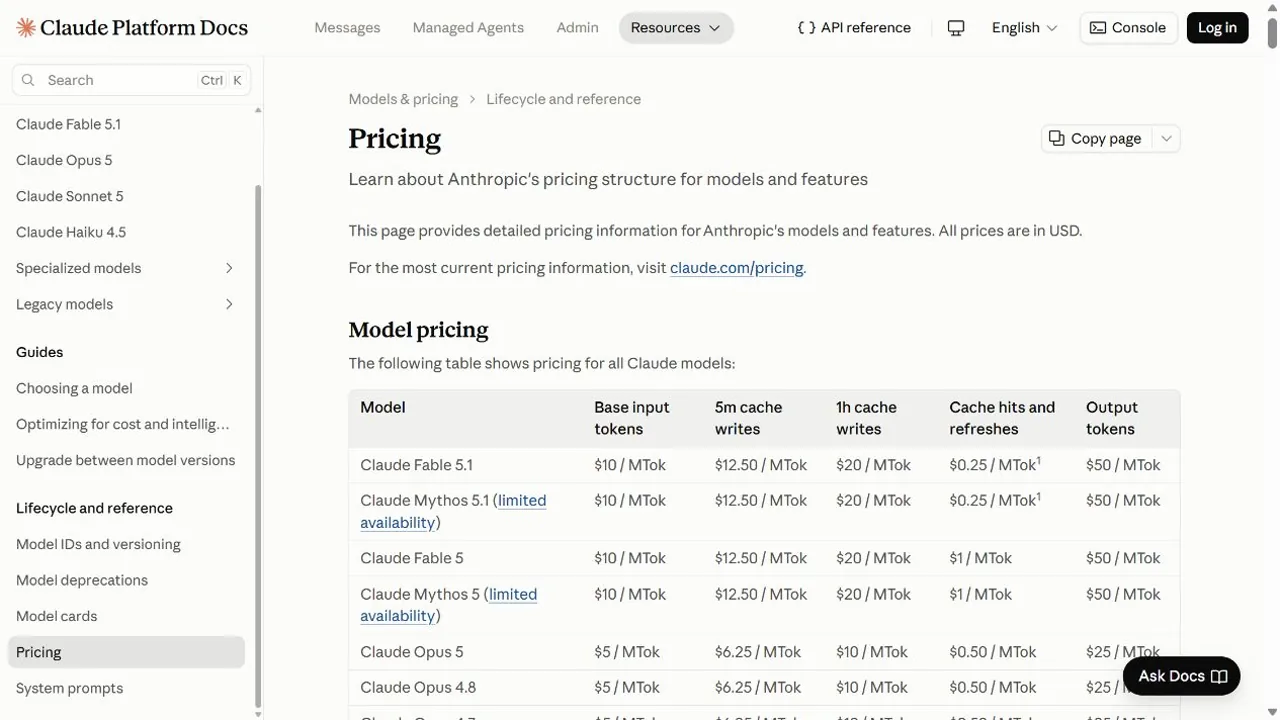
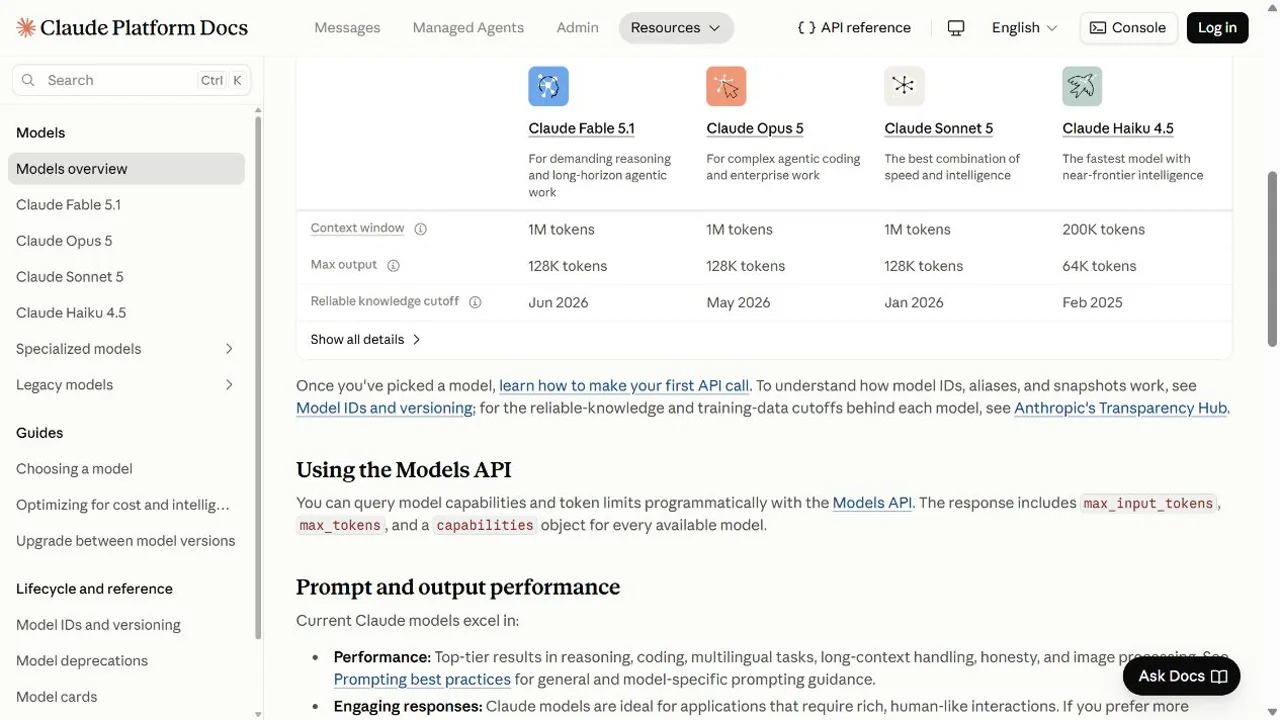
| 基礎輸入 | $10 / 1M | $10 / 1M |
| 快取輸入/命中 | $1 / 1M | $0.25 / 1M |
| 輸出 | $50 / 1M | $50 / 1M |
| 批次 | 50% 標準規格 | 每 1M 包含 $5 輸入 / $25 輸出 |
| 推理 | 可配置的推理工作量 | 適應性思維,時刻保持;高預設值 |
| 實際測驗分數 | 43/50 | 19/50 |
如需更深入了解模型背景,請參閱我們的 GPT-6 Astra 評測, Claude Fable 5.1 指南, 以及 Claude 模型比較.
定價、快取、上下文與限制
這兩款模型均標示每百萬個基礎輸入令牌的緩存命中率為 $10,每百萬個輸出令牌的緩存命中率為 $50。兩者的運作差異在於緩存機制。GPT-6 Astra 標示每百萬個緩存輸入令牌的緩存命中率為 $1,緩存寫入速率為 $12.50。 Fable 5.1 則標示每百萬個 token 的快取命中率為 $0.25,每五分鐘寫入率為 $12.50,每小時寫入率為 $20。 Anthropic 表示完整的 100 萬個上下文仍維持標準定價;當輸入超過 27.2 萬個標記時,Astra 將採用較高的定價。.
閱讀全文 GPT-6 Astra 價格明細 或與我們的 Claude Fable 定價指南. 服務供應商的定價並不自動等同於 GlobalGPT 積分或相容性層計費。.
五項匹配的 API 測試
我們透過同一個相容於 OpenAI 的端點,將相同的任務傳送至每個模型 ID。測試 1 至 4 允許最多 2,000 個輸出標記。測試 5 則將兩者皆設為 1,200,因為閘道器會在約 30 秒後中斷較長的非串流請求。 每項評分均採用測試前定義的五項規則。若結果為空白,則其隱形工作將不獲計分。.
推理:SaaS 成本決策
Astra 完成了財務模型;Fable 則在假設設定階段停滯不前。.
檢視確切的任務
HTTP 200 · 28.98 秒 · 242 項輸入 · 1,427 項完成 · 得分 10/10
HTTP 200 · 26.01 秒 · 357 個輸入 · 2,000 個完成 · 分數 1/10
撰稿:產品發表稿編輯
兩者都產出了可用的稿件,但《Fable》補充了筆記中未提及的細節。.
檢視確切的任務
HTTP 200 · 15.47 秒 · 165 個輸入 · 500 個完成 · 得分 10/10
HTTP 200 · 26.01 秒 · 263 項輸入 · 1,881 項完成 · 得分 8/10
程式設計:TypeScript 並行處理
Astra 回傳了明確的診斷結果及部分測試結果;Fable 在此路徑中則未回傳任何可見的結果。.
檢視確切的任務
HTTP 200 · 41.54 秒 · 181 項輸入 · 2,000 項完成 · 分數 9/10
HTTP 200 · 29.44 秒 · 277 項輸入 · 2,000 項完成 · 分數 0/10
長篇背景:種植修正案
兩者均查閱並援引了具有約束力的第417條修正案。.
檢視確切的任務
HTTP 200 · 14.96 秒 · 99,495 個輸入 · 244 個完成 · 得分 10/10
HTTP 200 · 22.24 秒 · 295,912 個輸入 · 1,053 個完成 · 得分 10/10
策略:90 天市場進入計畫
Astra 啟動了一項務實的計畫,但中途被中斷;Fable 則未給予任何明確的回應。.
檢視確切的任務
HTTP 200 · 34.27 秒 · 210 項輸入 · 1,200 項完成 · 得分 4/10
HTTP 200 · 21.09 秒 · 338 項輸入 · 1,200 項完成 · 分數 0/10
您應該選擇哪一款型號呢?
- 推理與運作決策: 在這次試跑中,Astra 的表現要完整得多。.
- 寫作: 兩者都可使用;Astra 更貼近原始樂譜,而 Fable 雖然聽起來更為淬鍊,但對介面細節的處理則略顯主觀。.
- 編碼: Astra 提供了更明確的視覺診斷結果。請比較我們 Claude 與 ChatGPT 編碼指南.
- 長篇文件: 兩者都精確地發現了這項矛盾。代幣核算方式存在顯著差異,因此請使用您自己的文件進行測試。.
- 代理策略: 兩者皆未能在最終期限內完成受限任務;但 Astra 仍回傳了可用的部分成果。.
如需另一個基準幀,請參閱 GPT-6 Astra 對決 GPT-5.6 Sol 或 克勞德·法布爾 5 對決 GPT-5.5.
如何在 GlobalGPT 中比較這兩者
GlobalGPT 針對兩種模型分別提供獨立的生成路徑。使用相同的提示詞、輸出限制及原始素材,並在評估風格之前先判斷可見正確性。當介面或 API 回傳延遲時間與標記使用量時,請一併記錄。對於長篇文件,應分別測量各路徑的結果,因為相同的文字在不同路徑下可能產生不同的標記結果。.
常見問題
GPT-6 Astra 的價格是否比 Claude Fable 5.1 更便宜?
兩者的基本輸入與輸出定價相同。快取命中定價與長上下文規則有所不同,而 GlobalGPT 計費方式可能會使用獨立的信用額度。.
哪個模型的上下文視窗較大?
GPT-6 Astra 列出 105 萬個代幣,而 Claude Fable 5.1 則列出 100 萬個。兩者均設定最大輸出量為 12.8 萬個。.
哪一種更適合寫程式?
在我們的單一 TypeScript 測試中,GPT-6 Astra 給出了更明確的可見答案。Fable 透過此相容性途徑未返回任何可見內容,因此這並非基於提供者原生功能的結論。.
在長上下文檢索方面,哪一種效果更好?
雙方以 10/10 打成平手,皆找到了同一項預先安排的修正案並予以引用。Fable 針對這份完全相同的檔案所報告的輸入代幣數量,幾乎是對方的三倍。.
為什麼《Fable》的評分較低?
幾個 Fable 呼叫雖然消耗了完成標記,卻回傳了內容被截斷或為空的可視內容。這可能是相容性層或輸出序列化方面的问题。.
我可以在 GlobalGPT 中同時使用這兩種模型嗎?
是的。根據 2026 年 9 月 8 日的查證結果,這兩條專用的 GlobalGPT 路線均已啟用。.
最終裁決
從這組測試來看,GPT-6 Astra 是更安全的預設選擇:它產出的結果更完整、更實用,最終得分為 43/50,相較之下 Claude Fable 5.1 僅得 19/50。不過在長上下文準確度任務中,Claude Fable 5.1 仍與 Astra 表現相當,並產出了穩健的行銷文案。 在排除 Fable 之前,請透過您的生產端點重複執行測試;出現兩次空白輸出,這不僅是模型行為的問題,同時也是對整合行為的警示。.