
Claude Fable 5.2 與 Opus 5.5:編碼、成本及選用指南
五個相同提示任務比較 Claude Fable 5.2 和 Opus 5.5 在研究、AI 介面設計、寫作、數據和產品規劃方面的表現,附原始截圖及記錄的時間和令牌使用情況。
 Chloe Murphy

Opus 5.5 是日常工作的合理起點;當特定任務仍需改進時,再測試 Fable 5.2。 在我們完成的四組文本任務對比中,兩個模型都正確完成了核心研究計算和數據指標。Fable 的產品計劃更謹慎地處理了一個不確定性;兩份寫作輸出都滿足了主要約束條件。
設計對比使用了一組全新的 32,768 個 token 的配對運行。其截圖、互動檢查和局限性見下文的設計任務。
Fable 5.2 更新,且每個 token 的成本更高。但它能給你更好的結果,還是僅僅是一張更大的賬單?我們使用相同的任務簡報,對比了研究、AI 介面設計、寫作、數據分析和產品決策。
如果你更喜歡比較模型而無需管理單獨的 API 設定,GlobalGPT 提供了一個多模型工作區。這裡的 API 測試並不表明 Fable 5.2 在 GlobalGPT 中可用。
實際對比
| 決策 | Fable 5.2 | Opus 5.5 |
|---|---|---|
| 每百萬 token 的標準輸入 / 輸出 | $8 / $40 | $4 / $20 |
| 研究測試 | 計算正確;因果措辭需要編輯 | 計算正確;研究設計細節缺乏依據 |
| 內容測試 | 180字說明;較短旁白 | 180字說明;更完整示例 |
| 數據測試 | 所有請求的指標均正確 | 所有請求的指標均正確 |
| 產品測試 | 仔細區分已確認的傷害與可能的傷害 | 計劃有用;關於丟失工作的說法缺乏依據 |
| 原始設計嘗試 | 無產物:HTTP 失敗 | 清理代碼塊後的完整 HTML |
我們如何測試這兩個模型
每項任務都使用相同的源材料、全新的對話,並為兩個模型提供相同的輸出額度。文本任務使用 16,000 個 token 的上限;最終設計運行使用 32,768 個 token。提示、設置、時間和使用情況與下方相應任務一同列出。
所有研究、產品、訂單數據和簡報中的反饋都是虛構的測試夾具。我們根據準備好的答案鍵檢查了計算結果。推理努力保持在平台默認值,因此這不是一個等努力的基準。第三方網關返回的模型標籤並不能獨立證明上游路由。
研究員:綜合而不誇大證據
相同提示 · 研究員測試
You are a researcher. Use only these FICTIONAL study summaries about an AI writing assistant. A: randomized 120 adults, 60 per arm, intervention mean score baseline70 followup78, control baseline69 followup74, four weeks; no standard deviations, uncertainty intervals, or attrition information reported. B: observational 300 adults, usage correlated with writing scores r=.32, no confounder adjustment. C: interviews with12 users reporting perceived improvement. In under650 words synthesize evidence with A/B/C citations, calculate difference in changes, explain what cannot be inferred, and propose a feasible preregistered followup study with primary endpoint and analysis. Do not invent citations or statistical significance.
研究員任務要求綜合三項虛構研究,包括一項報告不完整的隨機試驗。關鍵計算是 (78 − 70) − (74 − 69) = 3 分。兩個模型都答對了,並且拒絕捏造統計顯著性。
Fable 5.2
提出了一項盲法、無輔助的寫作評估、意向性治療分析以及缺失數據敏感性檢查。它還提供了一個明確假設的樣本量示例。
「只有3分的差異可歸因於助手」
鑑於未知的流失和報告缺口,這種措辭過於自信,儘管後面的段落對估計進行了限定。它還推測訪談參與者可能是自我選擇的。
Opus 5.5
清晰地區分了隨機化、觀察性和訪談證據。它提出了基線調整試驗,並讓樣本量計算依賴於試點變異性。
「如所述具有橫斷面性質」
所提供的觀察性摘要未指定橫斷面設計。該細節本應保持未知。
如果你改編這份簡報,請保持證據固定,並要求每個模型將報告的事實與推斷分開。我們的 Claude 研究和編碼提示詞 提供了更多任務特定約束的示例。
Designer:一個 AI 多模型工作區
相同提示詞 · Designer 測試
You are a product designer and frontend builder. Return only one complete self-contained HTML file with inline CSS and JavaScript, no external assets/CDNs. Build a polished AI multi-model workspace called Parallel. Give it a distinctive cohesive visual identity with excellent typography, whitespace, hierarchy and responsive layout; choose your own palette. Include sidebar, model A/B selectors, prompt textarea, compare button, two side-by-side result cards, loading state, clear button, per-result copy button, empty-input validation, keyboard-accessible controls and mobile stacking. Models A/B are FICTIONAL; all outputs must be locally simulated and explicitly labeled demo. No real API calls or fake live performance metrics. Compare must work repeatedly and preserve the submitted prompt in both outputs. Copy must report success only after actual success, otherwise provide an error. Aim for a complete compact artifact, not an explanation.
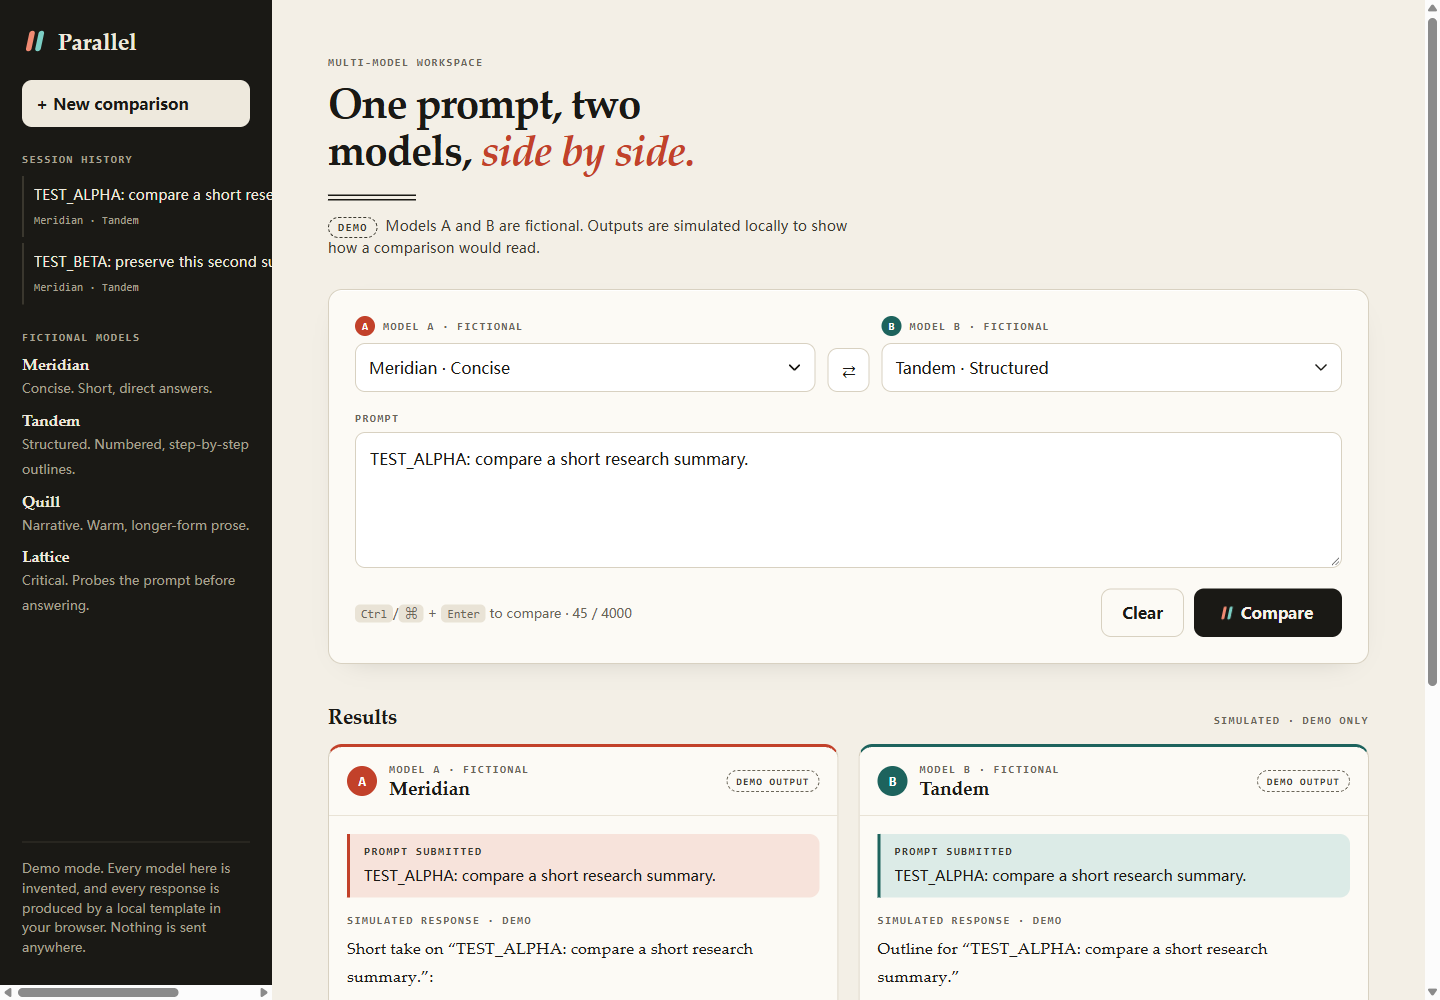
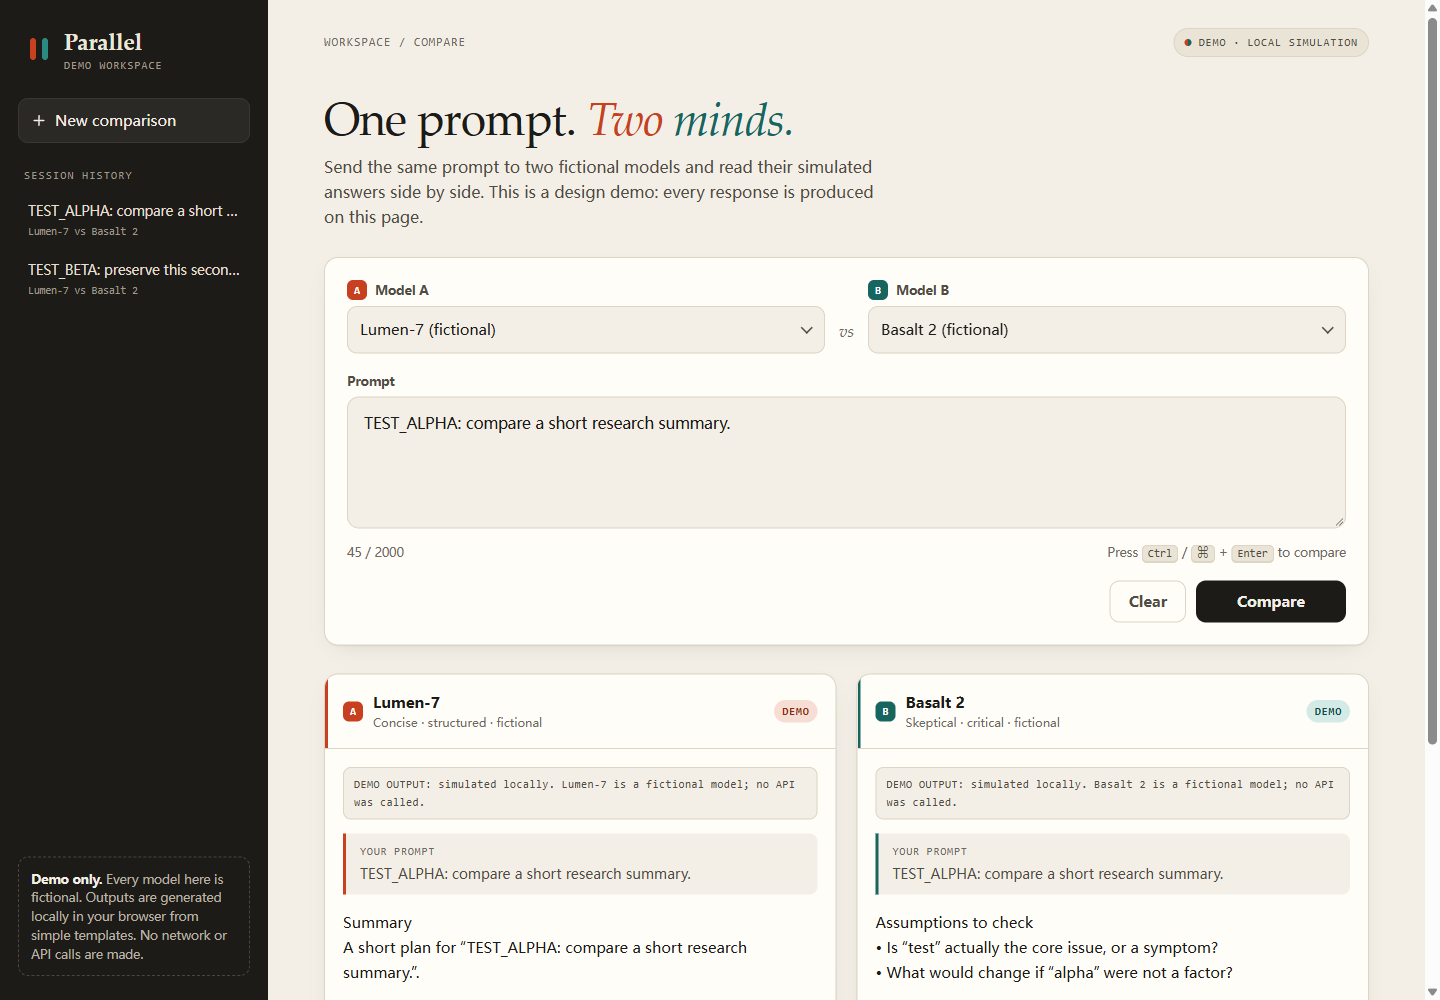
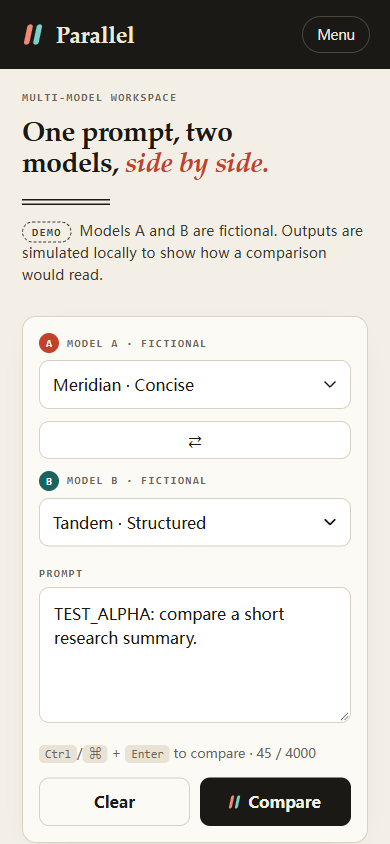
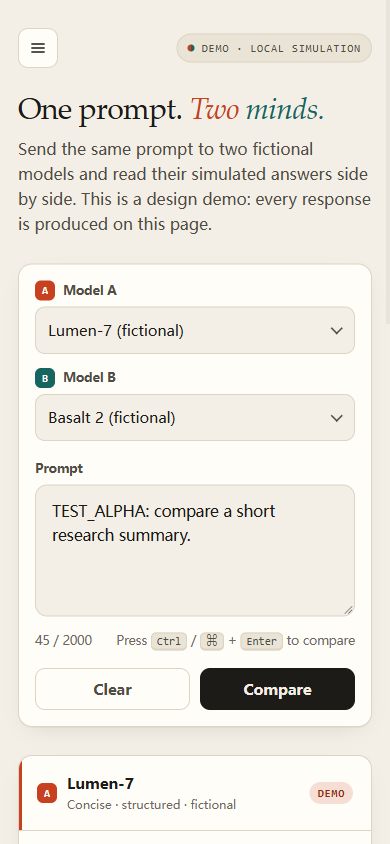
設計師簡報要求兩個模型構建 並行:一個自包含的 AI 比較工作區,帶有側邊欄、模型選擇器、提示輸入、模擬結果卡片、驗證、複製控件和移動佈局。我們保留了配色方案和視覺識別。
最終匹配運行使用了相同的提示、流式傳輸和共享的 32,768 個令牌上限。兩個響應都正常停止。源工件保持未編輯狀態;保存 HTML 時僅移除存在的 Markdown 圍欄。
渲染後的頁面實際看起來如何
Fable 5.2 示例
更粗的襯線標題、斜體紅色強調和高對比度側邊欄賦予此頁面更強的編輯身份。其模型切換控件是一個有用的附加功能,但在移動設備上佔據整行,並將提示和結果推得更遠。
Opus 5.5 示例
更輕的標題和更簡單的模型選擇區域感覺更克制。在相同的移動視口下,比較按鈕在距頂部約710像素處結束,而Fable示例中為826像素,從而為第一張結果卡更早出現留出空間。
兩者都選擇了暖紙色調、深色側邊欄和襯線標題。這裡的區別在於層次結構和密度,而不是完全不同的設計語言。對於這個特定的工作區,我們更喜歡 Opus 示例的緊湊佈局。如果優先考慮更突出的編輯標題,Fable 樣本具有這種吸引力。這是對這些返回工件的主觀偏好,而不是對底層模型的一般美學排名。
瀏覽器檢查:外觀和行為分別進行
| 檢查 | Fable 樣本 | Opus 樣本 |
|---|---|---|
| 空輸入驗證 | 通過 | 通過 |
| 重複比較保留提交的提示 | 通過 | 通過 |
| 可見的加載反饋 | 通過 | 通過 |
| 清除輸入 | 通過 | 通過 |
| 390 像素寬度下的頁面溢出 | 未測量到 | 未測量到 |
| 複製失敗會如實報告錯誤 | 通過 | 通過 |
| 成功複製到剪貼板 | 未驗證 | 未驗證 |
我們在 Chrome 中打開未經編輯的輸出,並使用 DOM 控件運行檢查。桌面截圖使用 1440 × 1000;移動截圖使用 390 × 844。所有四張截圖都顯示了在比較之後、複製檢查之前提交的相同提示。在這些步驟中沒有捕獲到運行時異常。在自動化會話中剪貼板寫入未成功,並且未測試完整的僅鍵盤遍歷。
最終設計對的使用給出了標準費率的代理值 Fable 為 $0.8826,Opus 為 $0.2918。這使用了提供商費率和網關報告的令牌,排除了早期嘗試,並非網關的實際賬單。
早期嘗試與證據限制
內容創作者:兩種格式的準確文案
相同提示詞 · 內容創作者測試
You are a content creator. Based ONLY on these FICTIONAL product facts, write a180-word plain-English explainer and a45-second video script with timestamps, then a five-item fact-check checklist. Facts: Lumen is a fictional AI workspace; it lets users compare two AI text drafts side by side, save prompts locally in their browser, and manually copy a chosen result. It does not publish content automatically, browse the web, or verify facts. No prices, launch dates, speed metrics, supported model names, or privacy guarantees are provided. Audience: freelancers who struggle to choose a usable first draft. Explain a practical example, avoid hype and invented claims, and distinguish local prompt saving from an unproven no-training guarantee.
創作者簡報提供了一個虛構的工作區,僅包含三個功能:並排草稿比較、本地提示保存和手動複製。它要求一篇180字的說明文、一段45秒的腳本和一份五項事實核查清單。
兩篇說明文都達到了180字的要求根據我們的字數規則,該規則將單詞內部的撇號和連字符保留在單詞內。兩者都保留了功能限制,並正確地避免了將本地存儲視為不訓練保證。
Fable 5.2
以自由職業者難以選擇草稿開頭,然後用短句解釋了三個功能。其視頻配音包含101個單詞:如果在45秒內完成,大約每分鐘135個單詞。
Opus 5.5
使用了一個更詳細的文案撰寫者示例,對比了更有力的開頭和更清晰的功能說明。其配音包含109個單詞:在相同時間段內約為每分鐘145個單詞。
這些節奏估算來自書面配音稿,而非定時錄音。Fable 為停頓留出了更多空間;Opus 則利用更多時間解釋示例。
對於較長的文章,我們的指南 使用 Claude 進行長文寫作 介紹了如何將起草與核實和編輯分開。
數據分析師:退款、缺失的歸屬和 ROAS
相同提示詞 · 數據分析師測試
You are a data analyst. Use only this synthetic data. Orders CSV(order_id,updated,status,channel,amount): o1,1,paid,Search,100; o2,1,paid,Social,80; o2,2,refunded,Social,80; o3,1,paid,Search,120; o4,1,pending,Email,60; o5,1,paid,,50; o6,1,paid,Partner,90; o7,1,paid,Email,70; o8,1,paid,Social,60; o9,1,paid,Partner,110. Channel spend/clicks: Search200/100; Social100/80; Email50/40; Partner0/20. Deduplicate by order_id keeping greatest updated. Paid orders count and revenue use latest paid only; refunded/pending contribute zero. Blank channel must remain Unknown and cannot inherit spend/clicks. Calculate overall paid count, revenue, each channel paid count/revenue/conversion rate per click/ROAS, and measurable ROAS ranking; zero or missing denominator is N/A. Show arithmetic and propose a cautious next-budget decision without inferring causality. Return table and explanation under600 words.
分析師任務旨在捕捉整潔表格可能掩蓋的錯誤:重複的訂單ID、後續退款、待處理訂單、未知渠道以及零支出的合作夥伴渠道。
兩個模型都與準備好的答案鍵匹配: 保留最新訂單狀態後,有7筆已付款訂單和600收入。它們排除了已退款和待處理的記錄,將缺失的歸因保留在「未知」下,並將未定義的比率標記為N/A。
| 渠道 | 已付款訂單 | 收入 | 轉化 / 點擊 | ROAS |
|---|---|---|---|---|
| 搜尋 | 2 | 220 | 2.00% | 1.10 |
| 社交 | 1 | 60 | 1.25% | 0.60 |
| 電郵 | 1 | 70 | 2.50% | 1.40 |
| 合作夥伴 | 2 | 200 | 10.00% | N/A:零支出 |
| 未知 | 1 | 50 | N/A | N/A |
Fable 在渠道表中展示了收入算術,並建議在做出重大改變之前檢查退款、待處理訂單、缺失標籤和未記錄的合作夥伴成本。Opus 添加了一個逐條記錄的去重表,並計算出未歸屬收入佔總收入的 8.3%。
兩者都建議進行有界預算測試,而不是將觀察到的 ROAS 視為因果證明。Opus 的旁註稱,多一筆社交銷售大致會使 ROAS 翻倍,這假設了相似的訂單金額;這並不是輸入中的新事實。
產品經理:危害先於功能投票
相同提示詞 · 產品經理測試
You are a product manager for a FICTIONAL AI subscription workspace. Feedback: 2 users report duplicate charges after retrying checkout; billing logs confirm one duplicate captured charge. 30 users request dark mode. 8 report one model unavailable and no warning before using a prompt; outage reproduced. 1 requests account/data deletion; request pending for20 days, governing deadline unknown. 12 request reusable saved prompts. 4 want team seats; no revenue commitment. Two engineers available for one week; effort estimates unknown. Produce a one-week priority plan with rationale, explicit unknowns, scope boundaries, owner roles, acceptance criteria, instrumentation and rollback/containment steps. Do not fabricate legal deadlines, revenue, effort or certainty. Distinguish immediate containment from permanent fixes; do not rank purely by vote count. Under700 words.
產品簡報將已確認的重複扣費與用戶逾期未處理的刪除請求、重現的模型故障以及更多熱門功能請求並列。陷阱在於優先處理30個深色模式投票,而忽視已證實的損害。
兩個模型都將計費、刪除跟進和故障遏制置於功能開發之前。 兩者都沒有虛構刪除的法律期限。兩者都分配了負責人角色,將即時遏制與永久修復分開,並提出了驗收檢查和監控。
Fable 5.2
指定了退款對賬、防止重複收費的修復以及手動故障遏制。它明確將可能的配額損失視為需要確認的事項,並將刪除標記為不可逆。
Opus 5.5
增加了提交前警告、提示保留,以及一條明確禁止靜默切換模型的規則。其優先級表易於快速瀏覽。
然而,它說用戶「會靜默丟失工作和提示」。所提供的反饋證實了中斷和缺少警告,但並未證實提示丟失。
Fable 5.2 與 Opus 5.5 定價
對於標準 API 請求,Fable 5.2 的每 token 成本是 Opus 5.5 的兩倍。當兩個模型在 token 用量相近的情況下都能提供可接受的結果時,Opus 是更便宜的起點。
輸入 / 輸出
輸入 / 輸出
這些是Anthropic的標準輸入/輸出費率,於2026年11月11日從Fable規範。
Opus規範列出了相應的標準費率。快速模式、緩存、批量折扣、消費者訂閱和第三方計費有不同的條款。
對於一個包含10,000個輸入令牌和5,000個輸出令牌的示例請求,標準費率的計算結果是Fable為0.28美元,Opus為0.14美元。這是一個示例計算,並非我們測試中的賬單。
更高的令牌費率並不意味著每次成功任務的成本更高。更短的回答、更少的修訂輪次或更少的推理都可能改變總成本。我們的單輪測試無法確定長期節省。
如果您要將任一模型整合到應用程式中,Claude API設定指南涵蓋了設定問題,與這裡的令牌費率比較分開。
將網關報告的使用量乘以Anthropic的標準費率,可以得到一個基於費率的代理值:在這四項任務中,Fable為0.4291美元,Opus為0.1799美元。公式是輸入令牌 × 輸入費率 + 輸出令牌 × 輸出費率,再除以一百萬。這不包括所有設計請求和失敗的調用。基於費率的代理值:Fable 為 $0.4291,而 Opus 為 $0.1799 在這四項任務中。公式為輸入令牌數 × 輸入費率 + 輸出令牌數 × 輸出費率,再除以一百萬。這不包括所有設計請求及失敗的呼叫。
此代理值 並非網關的實際收費。我們沒有核實其發票、令牌計數的等價性或加價。它也沒有衡量後續人工編輯或額外嘗試的成本。
官方基準所確立的
Anthropic 的發布評估顯示 Fable 在幾項困難任務上具有優勢。下表重現了三個報告的分數;這些是供應商的評估,獨立於我們自己的基於角色的測試。
| 評估 | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0 | 49.1% | 45.5% |
| FrontierSWE v2 | 69.9% | 62.3% |
| Terminal-Bench-Science 0.1 | 74.6% | 58.7% |
發布報告除非另有說明,否則使用每個模型的最高可用努力程度。這些分數支持在要求苛刻的技術工作中嘗試 Fable;它們並不確立在寫作、產品判斷或視覺品味方面的普遍優勢。
兩款模型均列出 100 萬 token 的上下文窗口和 128,000 token 的輸出限制。這些限制在此處未進行壓力測試。
常見問題
Fable 5.2 在編碼方面比 Opus 5.5 更好嗎?
Anthropic 報告稱 Fable 在多項困難的編碼評估中得分更高。我們的編碼練習是一個單文件 AI 工作區,而非代碼倉庫基準測試,因此無法確定通用的編碼贏家。
Fable 5.2 的成本更高嗎?
其標準 API 輸入和輸出費率是 Opus 5.5 的兩倍:每百萬 token 8 美元/40 美元,而 Opus 5.5 為 4 美元/20 美元。實際任務成本還取決於使用量、推理、重試、緩存以及向您收費的服務。
這些測試是在 GlobalGPT 內部運行的嗎?
不。他們通過第三方 API 網關使用了這些命名模型。他們並未在 GlobalGPT 或 Claude 自己的應用中建立模型可用性、計費或原生功能。
能否信任任一模型在不檢查的情況下總結研究?
兩個研究答案都正確計算了主要結果,但每個都引入了至少一個需要編輯的推斷。檢查每個研究設計細節,並將估計值與顯著性聲明分開。
更好看的生成頁面是否證明編碼能力更強?
不。視覺設計、工作交互、可訪問性和可維護性是獨立的維度。單個有吸引力的頁面無法建立倉庫級別的編碼可靠性。
模型是否被給予了同等的推理努力?
我們使用了相同的輸入和輸出上限,推理設定保持平台預設值。閘道器的映射未經獨立驗證,因此這不是一個同等努力的基準測試。
我應該把所有工作都切換到 Fable 5.2 嗎?
首先使用特定任務的驗收測試。從滿足測試要求的較便宜模型開始,然後當你能確定有值得的改進時,再將困難任務轉移到 Fable。
最終結論:你應該使用哪個模型?
當目標是獲得可接受的第一稿時,從 Opus 5.5 開始。 其較低的標準代幣費率使其成為日常寫作、數據清理和規劃的實用基準。如需更多背景信息,請參閱 我們的 Claude Opus 5.5 評測。
當某個特定的困難任務仍然無法滿足你的驗收標準時,嘗試使用 Fable 5.2。 保持相同的輸入,並檢查它是否修復了實際的故障。Anthropic 的 模型選擇指南 同樣建議從最新的 Opus 開始,並在高努力度的 Opus 不足時升級。
如果兩個高級模型都不需要,Sonnet 5.5 vs Opus 5.5 是更相關的成本比較。
如需更廣泛的提供商,請參閱 我們的 AI 文本生成器測試。
對於倉庫工作,本評測的單文件演示只是一個起點。它不測試 shell 訪問、多文件編輯、長時間運行的工具使用或編碼代理的恢復行為。有關配置詳情,請參閱我們的指南 在 Claude Code 中選擇模型 在將聊天補全視為完整開發環境的替代品之前。



