
快速回答: GPT-6 Sol 是 OpenAI 的複雜編碼與代理工作流程模型。 官方 API 列出標準費率為每 100 萬輸入標記 OpenAI,每 100 萬輸出標記 $10.00,具備 105 萬標記的上下文視窗,且最大輸出為 128K。 最關鍵的考量在於:其回答能否在可接受的總成本下,滿足您的任務需求。.
OpenAI 將 GPT-6 Sol 定位為適用於複雜編碼與代理型工作流程的解決方案。此表述屬供應商定位,並非經量化的品質評分。本評測將已發布的規格轉化為採購與架構決策,並附上來源標註地記錄公眾反應。 我們還針對該模型執行了三項小型任務,並保留了模型 ID、執行路徑、提示詞集、原始輸出及使用方式。以下呈現的任務結果僅為一次觀察到的執行結果,並非官方基準測試。.
簡評
當工作內容確實複雜、高度依賴工具或以程式碼為核心,且能接受較高的代幣成本時,Sol 便是值得考量的選擇。此處的論據結合了官方文件與我們的小型任務樣本,並非經過嚴謹控制的基準測試,因此合理的結論是「適用」,而非「普遍排名」。.
最實用的區別並非僅僅在於「聰明」與「快速」之間,而是工作負載的型態。GPT-6 Sol 與其姊妹產品擁有相同的標榜情境與輸出上限,但其定位與定價使得選擇不同的運作點更為合理。比較更廣泛的 AI 模型選擇指南 和 最適合編碼的 AI 模型 當任務涉及多個服務供應商時,請參閱此指南。.
GPT-6 Sol 一覽
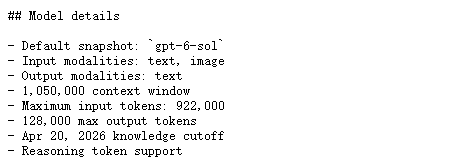
下表遵循現行 GPT-6 Sol 的官方模型頁面. 上下文容量不等同於建議的提示字串長度,且最大輸入量與標題上下文視窗是分開的。.
gpt-6-sol這兩款姊妹模型在文件記載的功能集內,均支援結構化輸出、函式呼叫、串流處理、提示詞快取、影像輸入、檔案搜尋及網路搜尋。工具的實際運作行為仍取決於端點、帳戶及請求設定;請勿僅憑功能選項的勾選狀態,便推斷工具執行成功。.
就家庭層面的背景而言,該 GPT-6 Astra 評測 說明一篇相關的 GPT-6 文章如何將供應商文件、平台路徑及歸因反應加以區分。.
GPT-6 Sol 的定價與 272K 法則
按標準費率計算,該 OpenAI 定價頁面 每 100 萬個標記,包含 $2.00 的輸入、$0.20 的快取輸入、$2.50 的快寫入,以及 $10.00 的輸出。快寫入量為未快取輸入量的 1.25 倍。 Batch 和 Flex 的定價為 50% 的 Standard 資源;Fast 模式的費率為適用費率的 2 倍;若該區域支援區域處理,則額外增加 10%。.
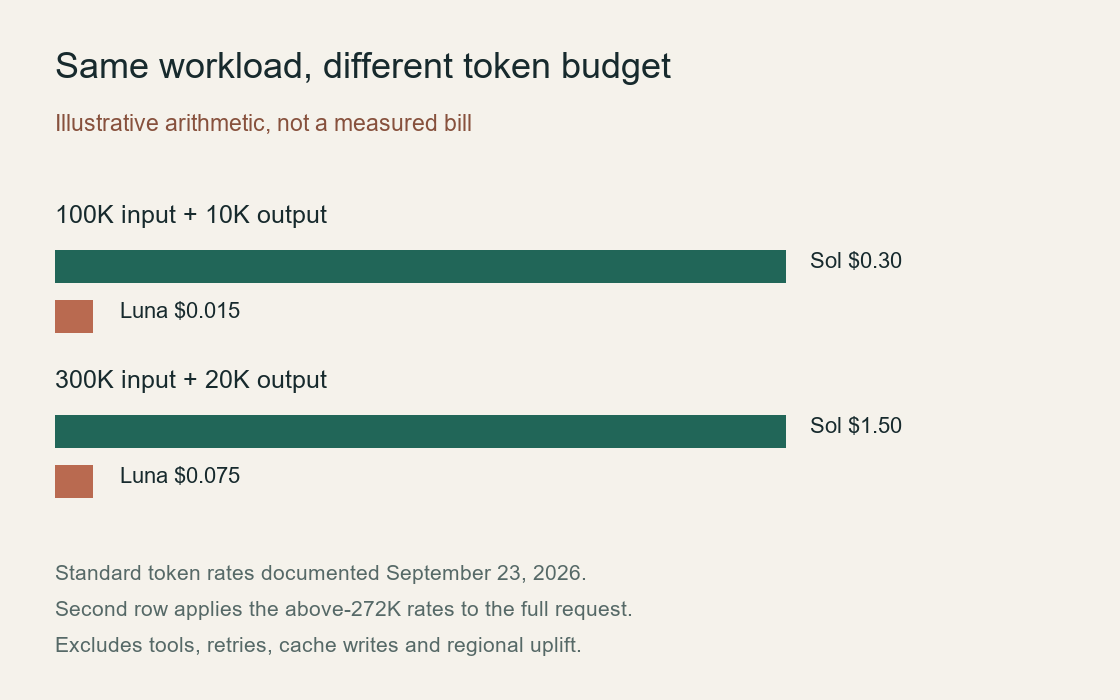
「長上下文」欄位是根據 OpenAI 的規則計算得出:當輸入量超過 272K 時,輸入速率與快取速率會翻倍,而整個請求的輸出量則乘以 1.5。這並非混合速率計費模式。 若以實際預算基準而言,100K 輸入加上 10K 輸出的成本約為 $0.30 在工具或區域性提升之前;一個 30 萬輸入加上 2 萬輸出的範例,成本約為 $1.50 以長上下文費率計算。.
一個大型的上下文視窗雖有其用處,但要填滿它卻非易事。檢索、區塊選取、快取重複利用以及輸出限制,這些因素比那個 1.05M 的標頭數字更為重要。請參閱 GPT-6 Astra 價格明細 有關上下文閾值與快取運作原理的相關說明,請參閱此處。.
GPT-6 Sol API 的適用範圍、工具與限制
OpenAI 建議在內建工具和函式呼叫中使用 Responses API。Chat Completions 僅在以下情況下支援函式呼叫: 推理_努力 已設定為 無. 這是一項在遷移前值得留意實作細節:某個請求雖然在語法上有效,卻可能無法符合您當前整合所預期的工具行為。.
目前的速率限制表列出了以下標準層級。RPM 代表每分鐘請求數,TPM 代表每分鐘代幣數,而佇列值則是批次代幣上限。.
在正式上線前,請在您自己的帳戶中驗證確切的層級、端點、串流模式及工具合約。該 《Codex》使用限制指南 這有助於說明,為何模型所公布的上限與帳戶的實際可用額度並不相同。.
GPT-6 Sol 的規格所透露的訊息
這是一張適配圖,而非基準圖。請使用 全功能 AI 模型工作流程指南 當你真正需要決定的,是如何在一個可重複的流程中切換模型,而非哪一個單一模型聽起來最有力。.
在我們的測試中:GPT-6 Sol 在三項實務任務中的表現
我們於 2026 年 9 月 23 日測試了一項小型 JavaScript 修復、一份三點決策備忘錄,以及 JSON 擷取功能。以下保留的結果是針對模型 ID 的完整回應: gpt-6-sol. 先前嘗試曾遇到暫時性的負載過載錯誤,因此不應將這些結果視為首次嘗試的可靠性測量。我們將檢視這些答案包含哪些內容、讀者可以重複利用哪些部分,以及哪些部分尚未經過測試。.
程式碼修復:在不重寫函式的情況下保留零值
請將這個小型 JavaScript 函式視為生產環境儲存庫的一部分來審查。找出錯誤、說明失敗模式,並提出一個最簡化的修補程式,以及兩項針對性的回歸測試。 函式:function uniqueSorted(values) { return [...new Set(values)].sort((a, b) => a - b).filter(Boolean); }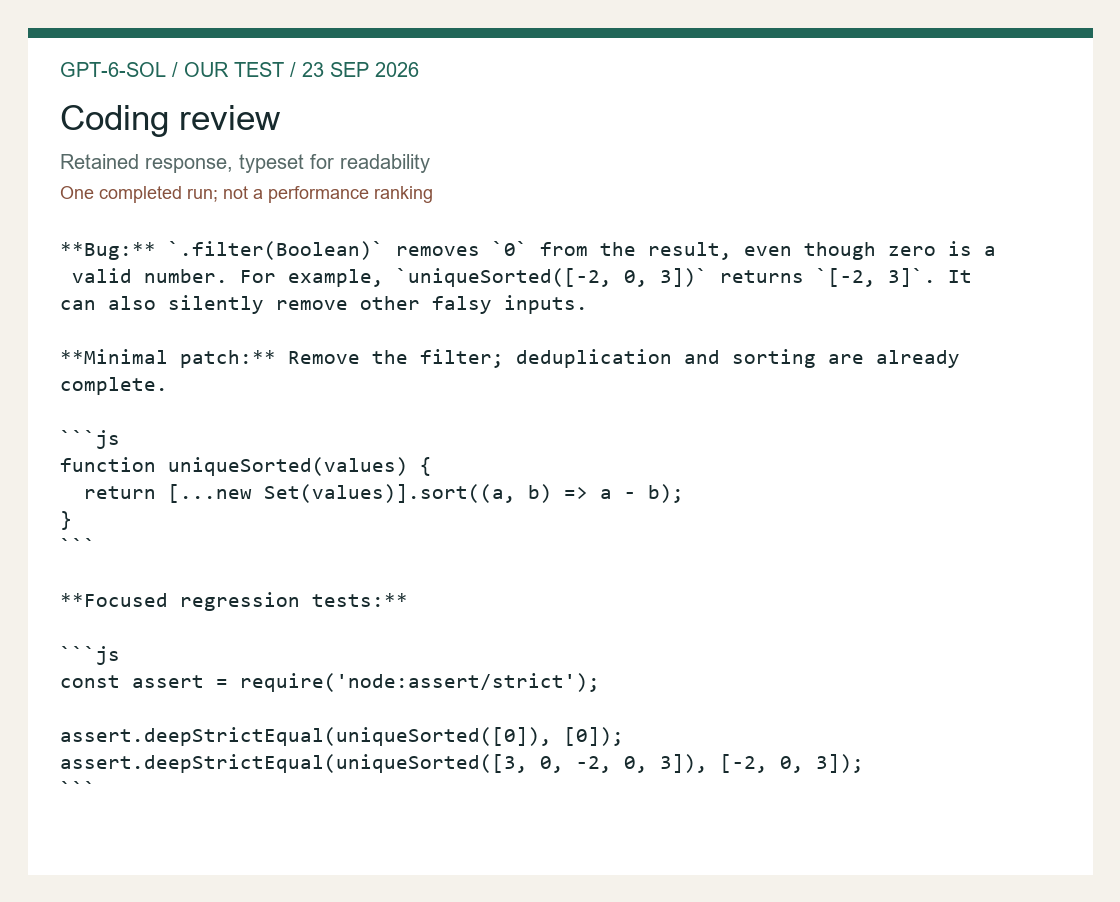
**錯誤:** `.filter(Boolean)` 會從結果中移除 `0`,儘管零是個有效的數字。例如,`uniqueSorted([-2, 0, 3])` 會傳回 `[-2, 3]`。它也會在未發出任何提示的情況下移除其他被視為假值的輸入。

**最簡修補程式:** 移除 `filter` 函式;去重與排序已然完成。

```js
function uniqueSorted(values) {
  return [...new Set(values)].sort((a, b) => a - b);
}
```

**重點回歸測試:**

```js
const assert = require('node:assert/strict');

assert.deepStrictEqual(uniqueSorted([0]), [0]);
assert.deepStrictEqual(uniqueSorted([3, 0, -2, 0, 3]), [-2, 0, 3]);
```
此已完成回覆的回報使用情況: 71 個輸入標記、409 個完成標記、共 480 個標記. 完成數可能包含推理標記;它並非僅指可見答案的長度。.
Sol 找到了實際的缺陷,而不是為了配合某個無關的偏好而重寫該函式。最終的 .filter(布林值) 會捨棄零,因為 JavaScript 會將零轉換為 false。 在該篩選器之前,系統已執行去重及數字升序排序。因此,僅移除該篩選器即可修復示範中的錯誤,同時保留演算法的其餘部分。這正是審查者能迅速理解的小型修補程式:說明指出了導致錯誤的數值,修改針對的是造成問題的操作,而測試則驗證了預期行為。.
這兩項迴歸斷言各自負責不同的任務。單例的情況 [0] 可隔離「消失的零」缺陷。混合案例結合了負數、零、正數以及重複值,用以驗證去重與數值排序在編輯後仍能維持正確。Sol 還包含 require('node:assert/strict'), ,因此該斷言的依賴關係是可見的。這些細節使得這份回覆比附帶模糊建議「添加測試」的修補程式更具實用性。不過,這些內容仍未能說明 Sol 將如何檢查儲存庫、解析跨檔案的導入,或是處理建置失敗的情況。.
除了已證實的錯誤之外,還存在一個合約層面的問題。此函式原本應僅接受有限數值,還是任意的 JavaScript 值?移除篩選機制後,若呼叫者傳入其他偽值輸入,系統仍會保留這些值。對於 NaN、負零、無窮大、數值字串及 null,需要做出有意的政策決策。 在沒有相關政策的情況下,我們不會在這個修補程式中默默地加入型別轉換或驗證機制。最小的修復之所以有價值,正是因為它將已確認的缺陷與更廣泛的重新設計區分開來。.
三音符合成:保持決策的條件性
請將以下三則備忘錄整合成一份簡明扼要的決策備忘錄,內容應包含:決策、依據、風險及後續步驟。備忘錄 A:105 萬個標記的上下文視窗雖能容納大量來源資料集,但並非每項請求的成本都低廉。 備註 B:當輸入令牌數超過 272K 時,已記錄的輸入/快取率會增加,且完整請求的輸出量會隨之倍增。備註 C:檢索與快取重複利用可降低重複提示的成本,但仍需測試接受標準。.
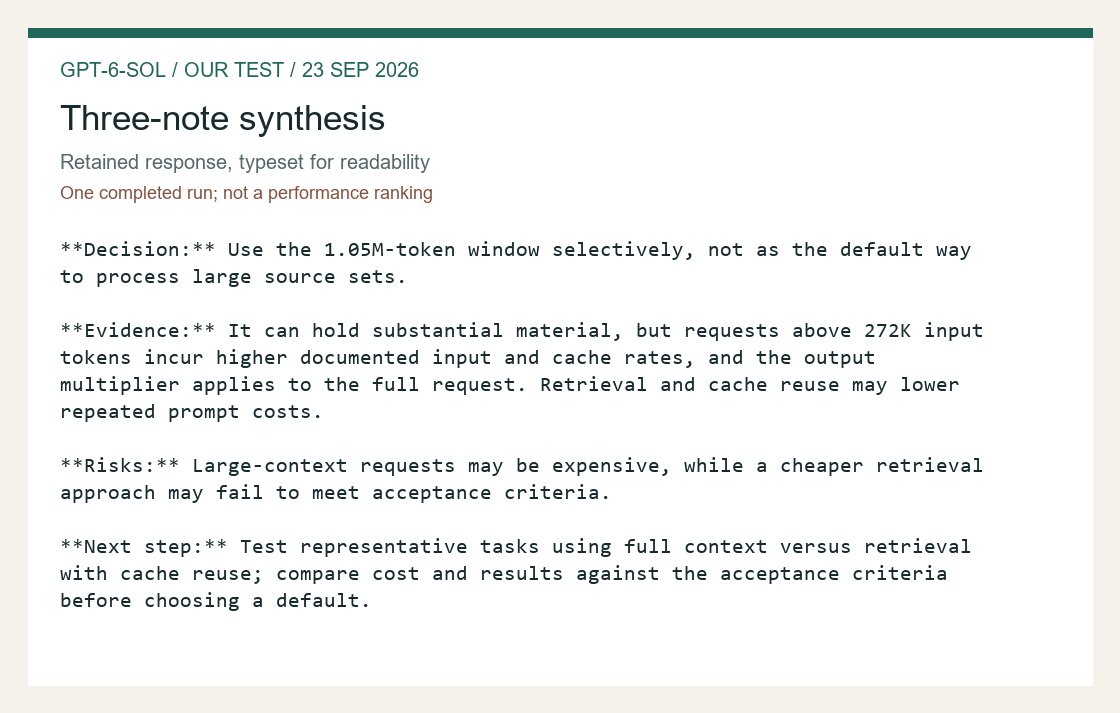
**決策:** 應有選擇性地使用 1.05M 令牌的視窗,而非將其作為處理大型來源資料集的預設方式。

**依據:** 雖然該視窗可容納大量資料,但輸入標記超過 272K 的請求會導致已記錄的輸入與快取率升高,且輸出倍數將套用至整個請求。透過檢索與快取重複使用,可降低重複提示的成本。

**風險:** 大型語境請求可能成本高昂,而成本較低的檢索方法則可能無法滿足接受標準。

**下一步:** 針對具代表性的任務,分別測試「完整語境」與「搭配快取再利用的檢索」兩種方式;在選擇預設方式前,將成本與結果與接受標準進行比較。.
此已完成回覆的回報使用情況: 99 個輸入標記、186 個完成標記、共 285 個標記. 完成數可能包含推理標記;它並非僅指可見答案的長度。.
Sol 將這三份備忘錄歸類為「決策」、「證據」、「風險」及「下一步」。其建議是選擇性地使用大型視窗,並依據接受標準評估檢索與快取重複利用的情況。有用的行為在於保留條件性表述:檢索或許能降低成本,但唯有透過工作負載測試,才能確定其是否保留了決策所需的信息。 該回應並未提出具體的節省百分比、量化的召回率,亦未建議始終傳送最大量的上下文。.
這份輸入資料僅包含 99 個已報告的提示標記。其目的在於測試簡短筆記的合成能力與遵循指示的能力,而非從數十萬個標記中檢索隱藏事實的能力。定價聲明已載於筆記中;正確重複這些聲明並不構成對定價的獨立驗證。 若為真正的架構備忘錄,我們會加入來源標識、決策負責人,以及明確的預算假設。這些補充內容將使每句話都能接受審計,同時也不致誤導地聲稱這項簡短練習已涵蓋完整的上下文範圍。.
JSON 擷取:明確標示未知項目
從此簡報中擷取以下欄位,並僅回傳包含鍵值 customer、priority、deadline 及 unknowns 的有效 JSON 格式資料。簡報內容:客戶:Northwind Labs。優先級:高。截止日期:2026-10-04。負責人未列名,且預算尚未確認。.
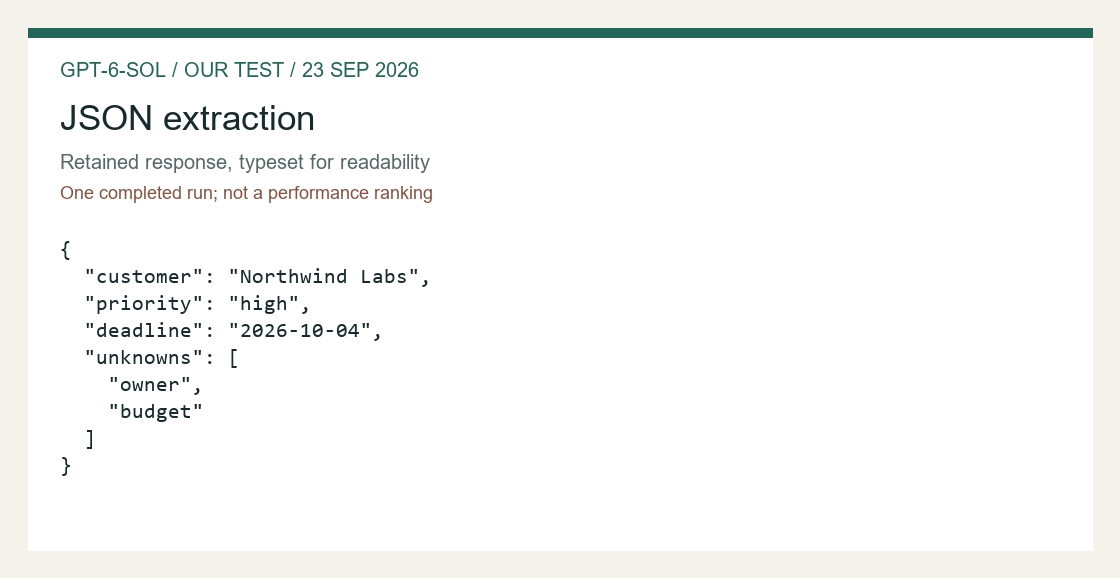
{"客戶":"Northwind Labs","優先級":"高","截止日期":"2026-10-04","未知項目":["負責人","預算"]}此已完成回覆的回報使用情況: 64 個輸入詞元、64 個完成詞元、共 128 個詞元. 完成數可能包含推理標記;它並非僅指可見答案的長度。.
Sol 精確地回傳了所要求的客戶、優先級、截止日期以及未知欄位。未知項目清單保留了「所有者缺失」與「預算未確認」的狀態,而非以合理推測來填補這些欄位。對於這項小型任務而言,這是一項具有實質意義的成功:下游系統能夠區分已知的截止日期與資訊缺失的情況。 輸出內容中亦未包含 Markdown 分隔符或說明性引言,因此可直接作為 JSON 進行解析。.
相同的 JSON 出現在 Luna 的保留結果中。 在此情境下,未觀察到足以證明為此特定輸入資料而支付 Sol 較高費率所應得的萃取品質優勢。當萃取作業需解決跨多份文件之間的矛盾時,Sol 仍值得評估,但那屬於不同的任務。我們的實際起點應是採用成本較低的經驗證萃取途徑,並在遇到證據衝突時進行升級處理,而非對每筆記錄都使用最昂貴的模型。.
針對已示範的缺陷所進行的可執行回歸測試
以下是一個編輯驗證範例,並非額外的模型回應。它於本地端在 Node.js 中執行,且不會向模型發出任何請求。它用於檢查上文所述的特定測試資料;並非對該模型的一般性評估。.
const assert = require('node:assert/strict');
function uniqueSorted(values) {
  return [...new Set(values)].sort((a, b) => a - b);
}
assert.deepStrictEqual(uniqueSorted([0]), [0]);
assert.deepStrictEqual(uniqueSorted([3, 0, -2, 0, 3]), [-2, 0, 3]);
assert.deepStrictEqual(uniqueSorted([]), []);
const original = values => [...new Set(values)].sort((a, b) => a - b).filter(Boolean);
assert.notDeepStrictEqual(original([0]), [0]);
console.log('修補程式通過測試;原始的零值缺陷已重現。');
最後的否定斷言確認了原始函式會遺漏零。這使該檢查具備「對失敗敏感」的特性:此測試不僅僅是接受新的實作,更會顯現出該變更原本旨在修正的症狀。 空陣列的情況屬於額外的編寫檢查,與模型提供的兩項斷言明確區分。對於生產代碼,應將測試置於實際函式旁,並執行專案的實際測試指令;將函式複製到獨立的測試檔案中,無法偵測到整合錯誤。.
GPT-6 Sol 如何改變實際的工作流程
主要規格僅在改變團隊的工作方式時才顯得重要。GPT-6 Sol 專為複雜的編碼與主動式工作流程而設計,因此首要問題是:您的工作負載是否能從這種架構中受益? 若每個請求都具備簡短的輸入、明確的輸出規範以及清晰的驗收測試,該模型便可整合至可重複執行的處理流程中。若任務內容模糊不清、需大量工具輔助,或可能需要經過數輪修正,那麼周邊的協調機制就與模型名稱同樣重要。.
對於 GPT-6 Sol 而言,一種實用的生成模式是採用兩階段流程:首先要求提供包含明確不確定性的簡潔答案,接著僅將有爭議或不完整的部分送入第二階段處理。 此舉既能減少浪費的輸出代號,又能讓失敗情況顯而易見。同時,這也為您提供了與 GPT-6 Luna 進行比較更佳的基準:關鍵不在於哪個名稱聽起來更強勁,而在於哪種流程能在較少的重試次數下達到接受標準。.
出貨前的簡易成本模型
官方價格表應轉換為貴團隊實際採購的單位:每日請求數、平均輸入代幣數、快取前綴佔用率、輸出代幣數,以及輸入量超過 272K 的呼叫所佔比例。若試算表僅追蹤標示的輸入單價,便會掩蓋長期情境下的乘數效應以及重試的成本。.
在比較 GPT-6 Sol 與 GPT-6 Luna 時,這項計算尤為重要。若某個請求需要反覆進行修復處理,原本成本較低的請求可能會變得昂貴;而當任務屬於確定性提取時,功能更強大的請求則可能造成資源浪費。合適的基準應是取自您自身流量的小樣本,且須採用相同的提示詞、相同的資料結構以及相同的審核規則。.
採用前應檢查的失效模式
範例頁面可以告訴您哪些端點和模態已收錄於文件中,但無法保證您的現有應用程式在遷移後仍會表現得與原先相同。請檢查:串流事件是否被正確解析、工具呼叫在多次重試時是否能保留狀態、結構化輸出是否會拒絕格式不正確的欄位,以及您的記錄管道是否會針對每個請求記錄模型 ID 和推理設定。.
正是這些限制,使得本評測中的實作觀察結果具有參考價值,同時又不會將其轉變為排行榜。我們的三項任務展示了該方案如何處理一個小規模的程式碼缺陷、一份決策備忘錄,以及嚴格的 JSON 擷取。這些任務並未針對延遲、大規模運作時的可靠性,或普遍的品質排名進行評估。.
適用於真實團隊的決策框架
當模型評估能協助某人在特定限制條件下做出決策時,便具有實用價值。對於 GPT-6 Sol 而言,最相關的限制條件包括請求格式、評估成本、上下文大小、輸出格式,以及錯誤答案可能帶來的後果。 供應商的描述雖指向複雜的程式碼與主動式工作流程,但團隊仍需將該描述轉化為可監控的執行路徑。首先,請用一句話寫下任務內容、模型將接收的輸入、其他系統所期待的輸出,以及用以防止無聲錯誤的人工檢查點。.
第一個錯誤是從示範提示中選擇模型。示範會獎勵流暢度,並隱藏重試、令牌計數、工具權限以及模式錯誤等運作細節。 較佳的比較方式應採用三項具代表性的任務:一項普通請求、一項困難請求,以及一項應被拒絕或升級處理的請求。結果並非單一分數,而是一張小型地圖,標示出模型在哪些環節能節省時間、哪些環節需要監督,以及哪些情況下另一款模型(通常是 GPT-6 Luna)是更經濟或更安全的選擇。.
從驗收測試開始
在撰寫提示語之前,請先撰寫驗收測試。對於程式碼而言,測試可能是通過的單元測試,或是不會變更公開 API 的修補程式;對於資料擷取而言,測試可能是包含所有必要鍵值且明確保留未知值的有效 JSON 檔;對於決策備忘錄而言,測試則可能是包含證據、風險、負責人及後續步驟的固定結構。 模型只能根據可見的目標來進行評估。若缺乏該目標,一段文筆流暢的段落看似成功,卻可能悄然省略了下游流程所需的某個欄位。.
一份好的驗收測試,既要範圍足夠狹窄以利自動執行,又要足夠具實質意義,才能保障使用者權益。它還應能讓分歧清晰可辨。若兩組輸出結果不同,團隊應能指出是因事實遺漏、假設缺乏依據、欄位格式錯誤,或是計算有誤所致。這比單純說某個答案「感覺更聰明」更具可操作性。 這也是「有助於採購的審查」與「僅是重複發布話術的審查」之間的區別。.
利用模型名稱來選擇一個起始假設。透過接受性測試來判斷該假設能否經得起實際生產環境的考驗。.
設計符合模型特徵的提示詞
不應將相同的提示語不加修改地複製到每個模型中。任務契約可以保持穩定,但上下文的份量、推理指示以及輸出限制應與該路徑相符。 針對 GPT-6 Sol,請將系統指示保持在足夠簡短的程度,以免與來源資料產生競爭。請明確說明角色、決策規則、所需的輸出格式,以及哪些情況需要明確的未知數或升級處理。.
對於長篇文件,應將檢索與判斷分開進行。首先找出能回答問題的段落;接著僅利用這些段落及既定的評斷標準來推導結論。此舉能降低因遠離問題且無關的細節而構建出「確信句」的機率,同時也使 1.05M 令牌的上下文視窗成為一種工具,而非預設選項。 當遠處證據之間的關聯性至關重要時,大範圍上下文便具有價值;若任務可透過精選的小範圍資料包解決,則使用大範圍上下文便屬資源浪費。.
對於使用工具的工作流程,請說明模型與工具之間的界限。模型應決定是否需要使用工具、依照嚴格的架構提供參數,並說明將如何處理返回的值。 應用程式應執行權限檢查、驗證參數、記錄呼叫紀錄,並判斷失敗的工具呼叫是否可重試。若將模型視為整個應用程式,將使除錯更加困難,並擴大錯誤假設所造成的影響範圍。.
一個可重複使用的四部分提示
上下文: 請僅提供該任務所需的事實與文件。. 目標: 請用一句話說明該決定或轉變。. 限制條件: 指定格式、排除項目、不確定度處理方式及工具限制。. 請檢查: 請模型在確定答案之前,先列出缺失的輸入或矛盾之處。此結構既簡短到足以支援重複呼叫,又足夠明確,便於在不同模型之間進行比較。.
何時需要使用大型上下文視窗
「105萬個代幣」這個標題雖然容易被引用,但也容易被誤用。上下文視窗僅會告訴你單次請求能容納多少資料;它並不會告訴你應該傳送多少資料、模型會如何有效利用每段文字,或是該請求會產生多少成本。 過長的請求也可能導致審查速度變慢,因為團隊需要檢視的資料更多,且更容易出現細微的指令衝突。.
當任務確實取決於遠端參考時,請使用「完整視窗」:例如定義與例外情況分開的合約、介面與實作相距甚遠的儲存庫,或是需要追溯一連串步驟才能找到答案的長篇研究檔案。當問題屬局部性質、來源集頻繁變更,或您希望獲得簡潔的引用路徑時,請使用「檢索」功能。 當多個請求重複使用穩定的前綴,且平台提供足夠的使用細節以證明快取正常運作時,請使用快取。.
272K 的閾值應列於架構圖中,而非僅作為定價段落中的腳註。在閾值以下安全的請求,一旦超過閾值,成本可能會大幅增加。 團隊應記錄輸入令牌、快取令牌、輸出令牌、模型 ID、推理設定,以及該請求是否超過閾值。此日誌有助於建立真實的成本模型,並能在意外的上下文膨脹演變成每月帳單驚喜之前及時發現問題。.
值得進行預備環境測試的 API 遷移相關問題
在將現有的整合功能移轉至 GPT-6 Sol 之前,請先建立一個可重播小型匿名化樣本的測試框架。比較最終產出的文字、結構化欄位、工具呼叫、中止原因以及標記使用情況。 請勿僅比較回應的第一個畫面。模型可能會保留可見的結論,同時變更欄位名稱、省略錯誤狀況,或傳回應用程式無法安全執行的工具參數。.
在整合計畫中,「回應」與「對話完成」並非可互換的標籤。端點支援、推理設定、工具行為、串流事件及錯誤物件,都會影響適配器。請在配置中固定模型 ID,但應使其在日誌和測試報告中保持可見。 當請求失敗時,記錄應顯示端點、模型、推理工作量、提示版本、請求大小及重試決策。這些證據能讓工程師重現失敗狀況,而非爭論模型是否只是「狀態不佳」。.
批次處理會改變經濟效益與運作節奏。它適用於夜間分類、文件準備,或是一連串緊急程度較低的轉換作業。但對於需要向使用者提供回應的互動式操作而言,批次處理則不太合適。 「快速」與「區域」模式也會改變價格計算方式。應將其視為明確的配置選項,並在預算試算表中明確反映,而非將其隱藏在預設設定中。.
在變更生產環境預設值之前,請重現代表性輸入、驗證結構化輸出、擷取工具參數、比對中止原因、測量標記使用情況,並測試一條失敗路徑。.
品質、安全與審查成本
較低的代幣價格並不一定代表總成本較低,而較昂貴的模型也不一定能帶來更好的業務成果。總成本包含重試、人工審查、事件處理,以及修復下游資料所需的工作。有用的指標是「每項被接受結果的成本」,並應按任務類別分別計算。 若某種路徑雖然每筆請求的成本略高,但能減少高影響度任務的修復工作,仍可能勝出;而對於具有強效驗證機制的確定性資料擷取,成本極低的路徑則能取得壓倒性優勢。.
風險應依據行動來分類,而非依據模型的品牌名稱。 閱讀公開文件並起草摘要,與修改客戶紀錄、核准付款、刪除資料或發布法律聲明是截然不同的。應將不可逆的操作置於人工審核點或第二個獨立驗證步驟之後。應要求模型識別不確定性,但絕不可將聽起來充滿自信的句子視為授權機制。.
有關隱私權與資料保留的問題應納入部署審查範圍。請確認傳送的資料內容、日誌的保留期限、哪些人可以檢視提示文字,以及請求中是否包含機密資訊或個人資料。 應在可行範圍內進行遮蔽處理、盡量減少上下文資訊,並清楚記錄已移除的欄位。無論是透過官方 API 還是其他相容途徑使用模型,這些控制措施均適用。.
如何比較 GPT-6 Sol 與 GPT-6 Luna
公平的比較應保持任務與接受規則不變,同時允許每個模型發揮其已記錄的優勢。執行相同的輸入封包,但記錄該模型是否需要不同的推理設定或不同的終點。 請清晰地報告這些差異:某個模型可能產生更完整的修補程式;另一個模型在重複擷取時成本可能更低;而第三個模型則可能更容易整合,因為其工具合約與您目前的適配器相容。.
切勿將一項成功的任務視為普遍性的排名。這三項小型任務的用途在於發現工作流程中的問題,而非證明存在一個通用的優勝者。 請使用數個切合實際的輸入資料重複執行該任務,其中應包含至少一個對抗性或不完整的案例,並預先界定何謂「通過」。若樣本過小而無法支持任何結論,請如實說明。這項界定反而能增強信任,而非削弱審查的效力。.
分階段推行,使決策仍可逆轉
從影子流量或非關鍵佇列開始。讓新路由產生結果,同時維持現有路由作為「最終權威」。 在固定期間內,比較接受率、代幣成本、審查時間及失敗類別。接著一次遷移一組任務,並保留回滾開關與明確的版本標籤。分階段部署能將模型選擇轉化為可觀察的工程變更,而非一日內完成的全盤替換。.
在部署過程中,請留意那些無法單憑通過率反映出的變化:輸出內容變長、工具呼叫次數增加、升級處理的案例增多,或是跨越長上下文閾值的請求增加。模型看似準確,卻可能消耗更多預算或增加操作員的工作量。針對這些面向設定警示,並與實際處理例外情況的人員共同檢視這些警示。.
成功的模樣
成功是一條成本明確、失敗模式清晰可見,且人們能夠遵循的審查流程所構成的穩定路徑。 這並非要求我們假裝該模型是完美的,而是需要清楚了解它能妥善處理哪些任務、哪些任務需要另闢蹊徑,以及當輸入資料不完整時該如何停止或修正該模型。這正是本次審查中所彙整的觀察結果與文件背後所遵循的實務標準。.
公眾反應能告訴你什麼、不能告訴你什麼
以下來源係作為經註明的公眾反應納入,而非官方文件或經控管的基準證據。其標題顯示各創作者選擇測試或闡釋的內容;這些內容並不能代表整個市場的結果。.
- 奈特·赫克 | 人工智慧自動化: 我針對 10 個實際應用案例,對比測試了 Opus 5.5 與 GPT-6 Sol. 請將這種敘事框架及任何示範視為該創作者的個人經驗,而非放諸四海皆準的標準。.
- Arena AI: GPT-6 Sol | 初印象. 請將這種敘事框架及任何示範視為該創作者的個人經驗,而非放諸四海皆準的標準。.
- Chase AI: GPT 6 Sol 與 Luna 正式登場(而且 50% 更便宜了!). 請將這種敘事框架及任何示範視為該創作者的個人經驗,而非放諸四海皆準的標準。.
這裡還有一個獨立的命名問題:數支公開影片在標題中將「GPT-6」與「GPT-5.6」混用。當您重現某項主張時,請確保精確的模型 ID 清晰可見。該 GPT-6 Astra 與 GPT-5.6 Sol 比較 這是一個很好的例子,說明為何應分別記錄服務提供者身分、平台標籤和路由。.
如何存取 GPT-6 Sol
開啟 GPT-6 Sol 工作區 不妨從一個可以評估的任務開始:一個小型程式碼範例、一個簡短的原始資料封包,或是結構化的資料擷取簡報。在比較各版本時,請務必將要求的輸出結果和接受準則置於顯眼處。上述官方代幣價格描述的是直接使用 API 的情況,並非針對工作區積分或訂閱配額的承諾。.
關於當前平台的命名及獨立署名相關內容,請參閱 GPT-5.6 定價指南 和 GPT-5.6 型號比較. 這些頁面屬於平台/編輯背景資訊;它們不會覆寫 OpenAI 的 API 定價表。.
請帶一份具有代表性的任務,並將結果與您自己的驗收標準進行比對。.
開啟 GPT-6 Sol 工作區哪些人適合選擇 GPT-6 Sol?
如果您的候選名單中包含較低成本的替代方案,請比較 更廣泛的型號目錄 與其假設最新型號就必然最具性價比。若您正在評估涉及大量資料的作業,那麼 資料分析模型指南 提供了一個獨立的工作流程視圖。.
常見問題
什麼是 GPT-6 Sol?
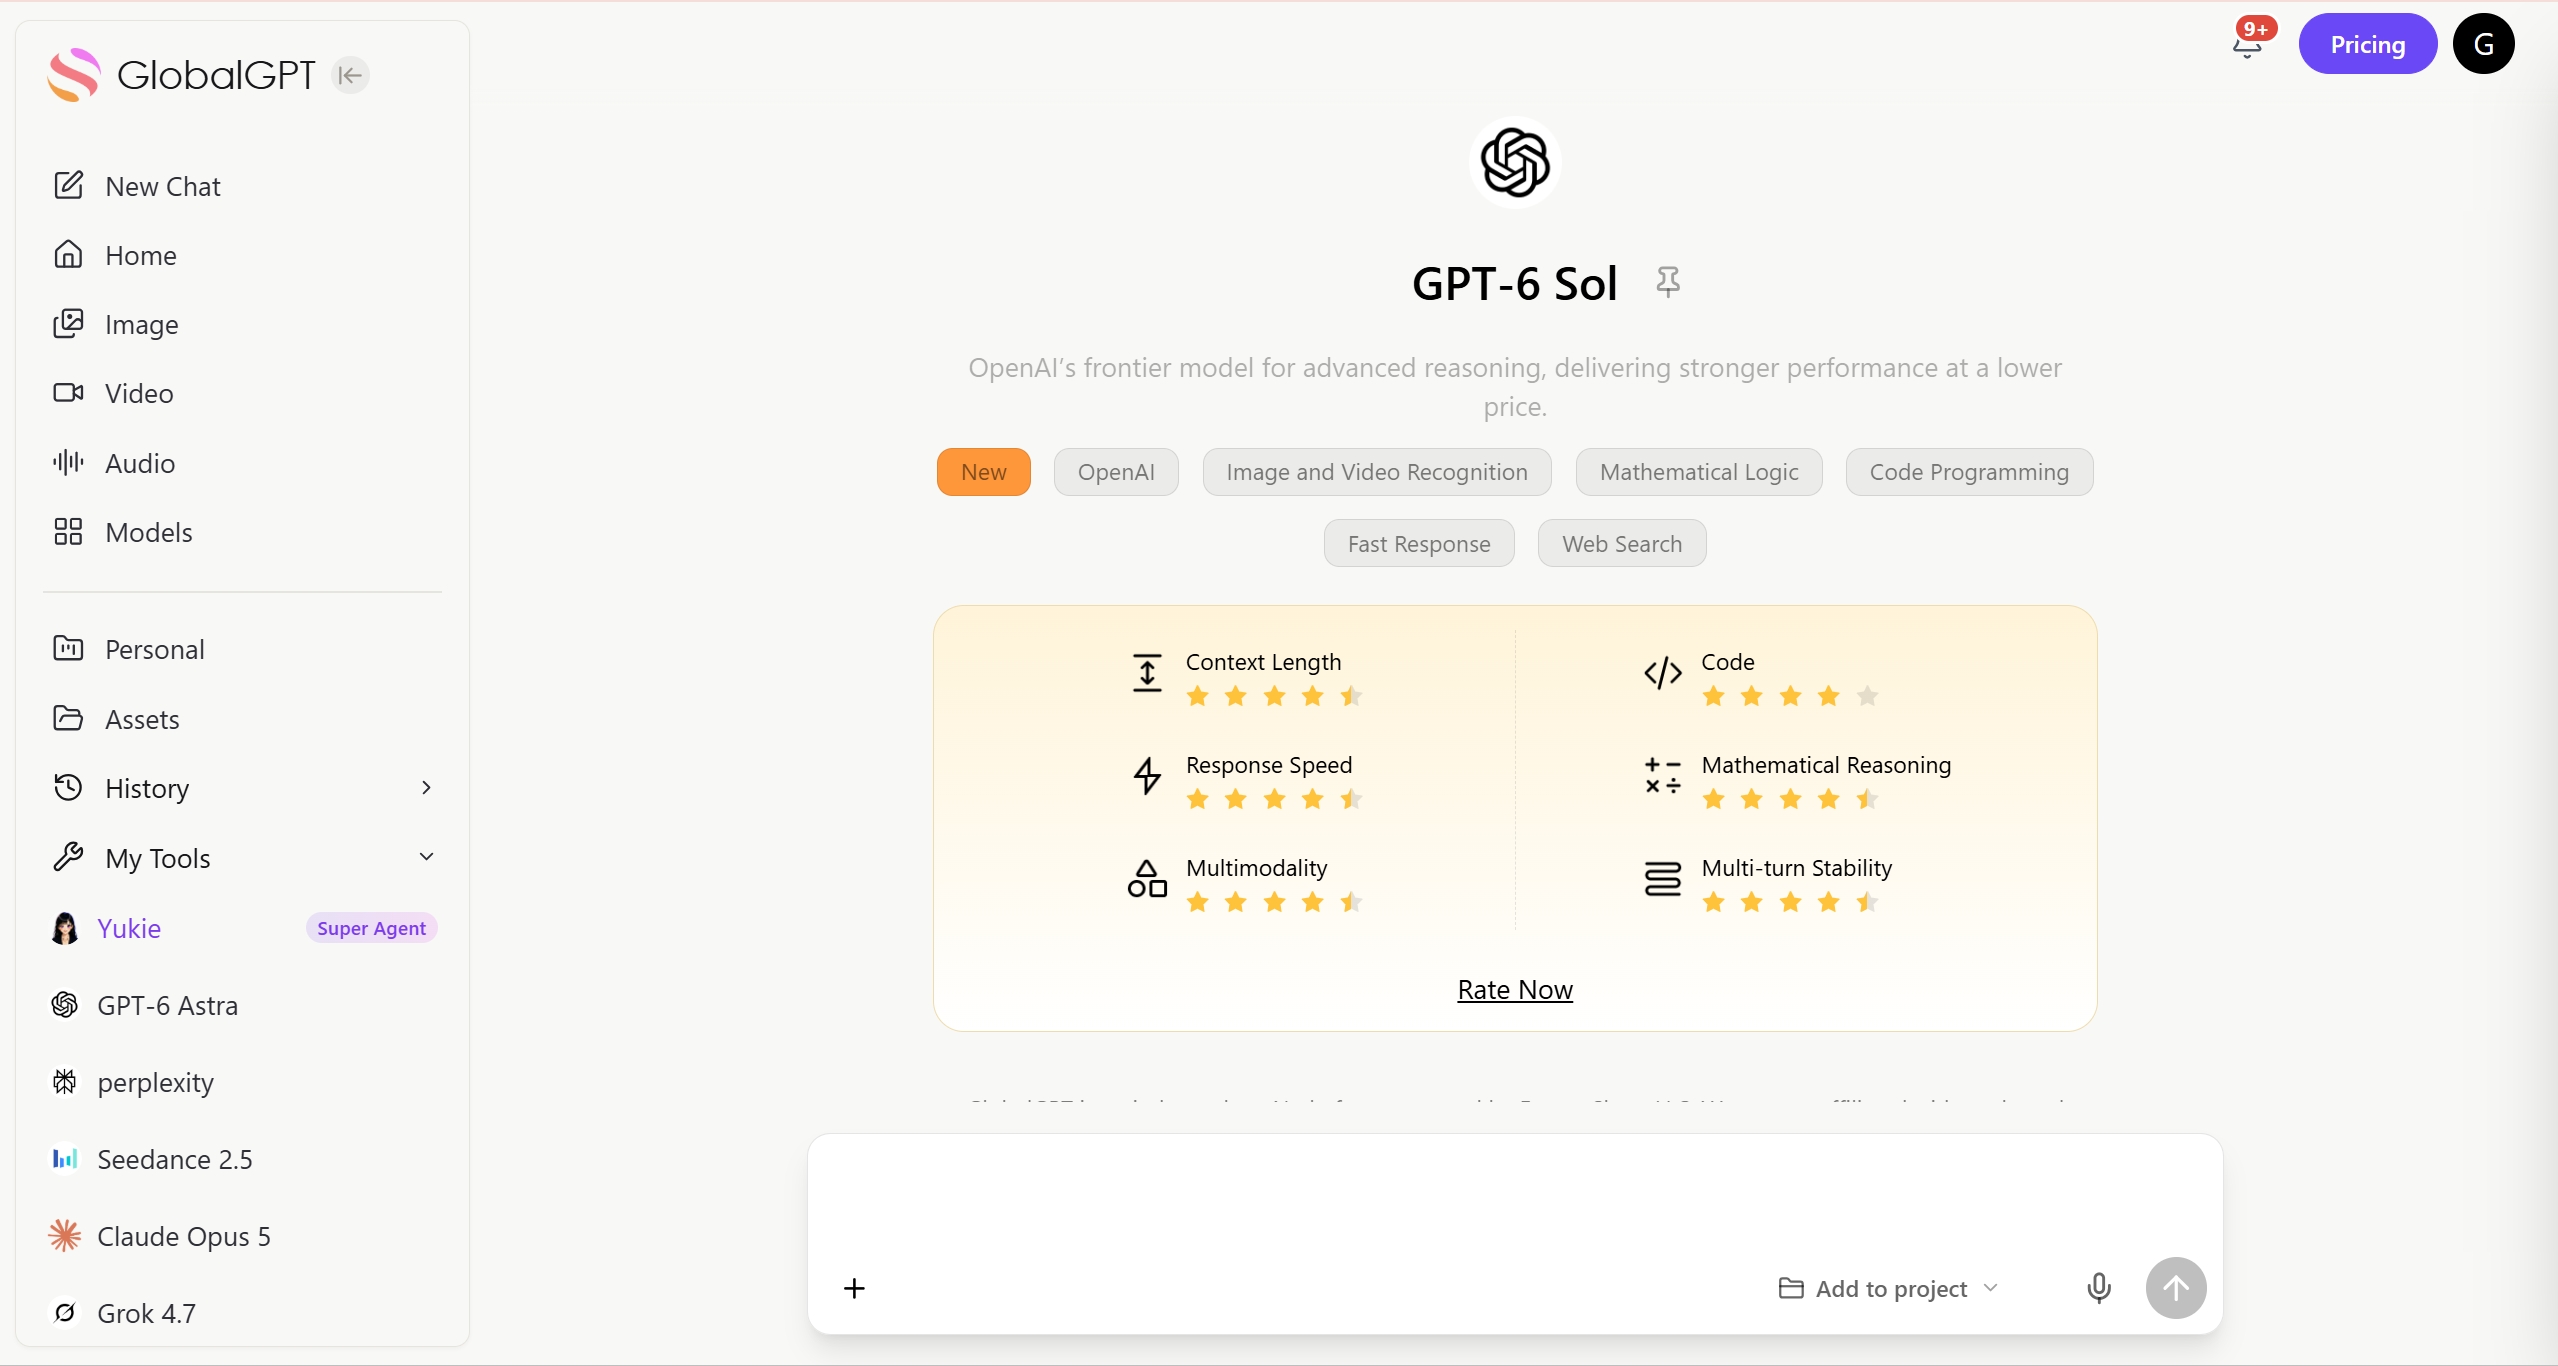
GPT-6 Sol 是 OpenAI 所開發的複雜編碼與代理工作流程模型。其官方 API 模型 ID 為 gpt-6-sol。.
GPT-6 Sol 的價格是多少?
OpenAI 列出 GPT-6 Sol 的定價為:每 100 萬個輸入標記 $2.00、每 100 萬個快取輸入標記 $0.20, 每 100 萬次快取寫入為 $2.50,以及每 100 萬個輸出標記為 $10.00,均按標準費率計費。.
當輸入代幣數量超過 272K 時會發生什麼情況?
當請求的輸入標記數超過 272K 時,OpenAI 會對整個請求套用 2 倍的輸入與快取速率,以及 1.5 倍的輸出速率。.
背景與輸出限制有哪些?
GPT-6 Sol 列出的上下文視窗為 1,050,000 個標記,最大輸入為 922,000 個標記,最大輸出為 128,000 個標記。.
知識門檻是多少?
目前的 OpenAI 模型頁面將 2026 年 4 月 20 日列為 GPT-6 Sol 的知識截止日期。.
有哪些推理設定可供選擇?
該 API 記載了「無」、「低」、「中」、「高」、「x高」及「最大」等推理難度等級,其中「中」為預設值。.
支援哪些 API 端點?
GPT-6 Sol 支援對話補全、回應及批次處理功能。該模型頁面並未將即時處理、助理功能、音訊、影片、影像生成、嵌入向量、微調、內容審核或舊版補全列為支援功能。.
GPT-6 Sol 能否接受圖片?
是的。該模型頁面列出了文字和圖像輸入,以及文字輸出。這並不代表它是一個圖像生成模型。.
GlobalGPT 是否支援 GPT-6 Sol?
請使用上方連結的 GPT-6 Sol 專用模型頁面。工作區配額與方案配額,與本評測中所述的直接 API 憑證費率是分開計算的。.
這篇文章有包含基準測試嗎?
這包含三項小型任務的觀察結果,並非受控的基準測試。Luna 在重新嘗試時需要修改編碼提示。這些結果並不能確定一個通用的勝出者,也無法反映大規模運作時的表現。.
最終裁決
當工作負載真正複雜、高度依賴工具或以程式碼為核心,且能接受較高的代幣成本時,Sol 便是值得考量的選擇。 此處的佐證結合了官方文件與我們的小型任務樣本,並非經過嚴格控制的基準測試,因此審慎的結論是「適用」,而非「通用排名」。請根據可接受的輸出結果與總營運成本進行選擇,並在工作負載發生變化時重新評估該選擇。.
查證日期:2026年9月23日。官方資料:OpenAI 開發團隊。平台路線命名:GlobalGPT。公眾反應:僅標註相關創作者及出版物的來源。.









