Qwen 3.8 Max เป็นรุ่นเรือธงใหม่ของ Alibaba Qwen ที่ออกแบบมาสำหรับการเขียนโค้ด งานระดับมืออาชีพ การทำงานของเอเจนต์ในระยะยาว และงานแบบมัลติโมดัล ชื่ออย่างเป็นทางการคือ Qwen3.8-Max, ได้มีการประกาศเมื่อวันที่ 3 สิงหาคม 2569 ว่ามีพารามิเตอร์รวม 2.4 ล้านล้านพารามิเตอร์ พารามิเตอร์ที่ใช้งานได้ 95 พันล้านพารามิเตอร์ และหน้าต่างบริบทขนาด 1 ล้านโทเคน.
การเปิดตัวครั้งนี้มีความสำคัญมากกว่าการอัปเดตมาตรฐานทั่วไป Qwen กำลังกำหนดตำแหน่งของโมเดลนี้ให้เป็นตัวแทนที่สามารถวางแผน ใช้เครื่องมือ ตรวจสอบข้อมูลย้อนกลับทางภาพ และทำงานต่อเนื่องในชุดงานที่ยาว — ไม่ใช่เพียงแค่อุปกรณ์แชทบอทที่ตอบคำถามทีละข้อเท่านั้น ซึ่งทำให้โมเดลนี้อยู่ในกลุ่มการสนทนาด้านการซื้อที่เทียบเท่ากับ โมเดล AI ที่ดีที่สุดสำหรับงานจริง, แต่ราคา API, แผนแบบไม่จำกัดน้ำหนัก และข้อกำหนดในการติดตั้ง ควรได้รับการพิจารณาอย่างละเอียดก่อนที่คุณจะเปลี่ยนไปใช้.
Qwen3.8-Max คืออะไร?
Qwen3.8-Max เป็นโมเดลผสมผู้เชี่ยวชาญขนาดใหญ่ที่พัฒนาโดยทีม Qwen ของ Alibaba โมเดลนี้มีพารามิเตอร์รวมทั้งหมด 2.4 ล้านล้าน แต่จะเปิดใช้งานพารามิเตอร์ 95 พันล้าน สำหรับแต่ละโทเคน โมเดลนี้รวมการเข้าใจข้อความ รหัสโปรแกรม การเข้าใจภาพ การใช้เครื่องมือ และการวางแผนระยะยาวไว้ในระบบเดียว ซึ่งออกแบบมาเพื่อดำเนินการงานที่ซับซ้อนตั้งแต่ต้นจนจบ.
The การเปิดตัวอย่างเป็นทางการของ Qwen อธิบายถึงสี่เป้าหมายหลัก ได้แก่: การเขียนโค้ดแบบอัตโนมัติที่แข็งแกร่งขึ้น, ผลลัพธ์งานระดับมืออาชีพที่พร้อมใช้งานในสภาพแวดล้อมจริง, งานแบบวงจรปิดที่มีระยะเวลาดำเนินการยาวนานขึ้น, และเอเจนต์แบบมัลติโมดัลที่ทำงานได้โดยตรง ในทางปฏิบัติ Qwen ต้องการให้โมเดลเปลี่ยนจาก “ตอบคำถามนี้” ไปสู่ “รับเป้าหมายนี้ สร้างแผน ใช้เครื่องมือที่มีอยู่ ตรวจสอบผลลัพธ์ และดำเนินการต่อจนงานเสร็จสิ้น”
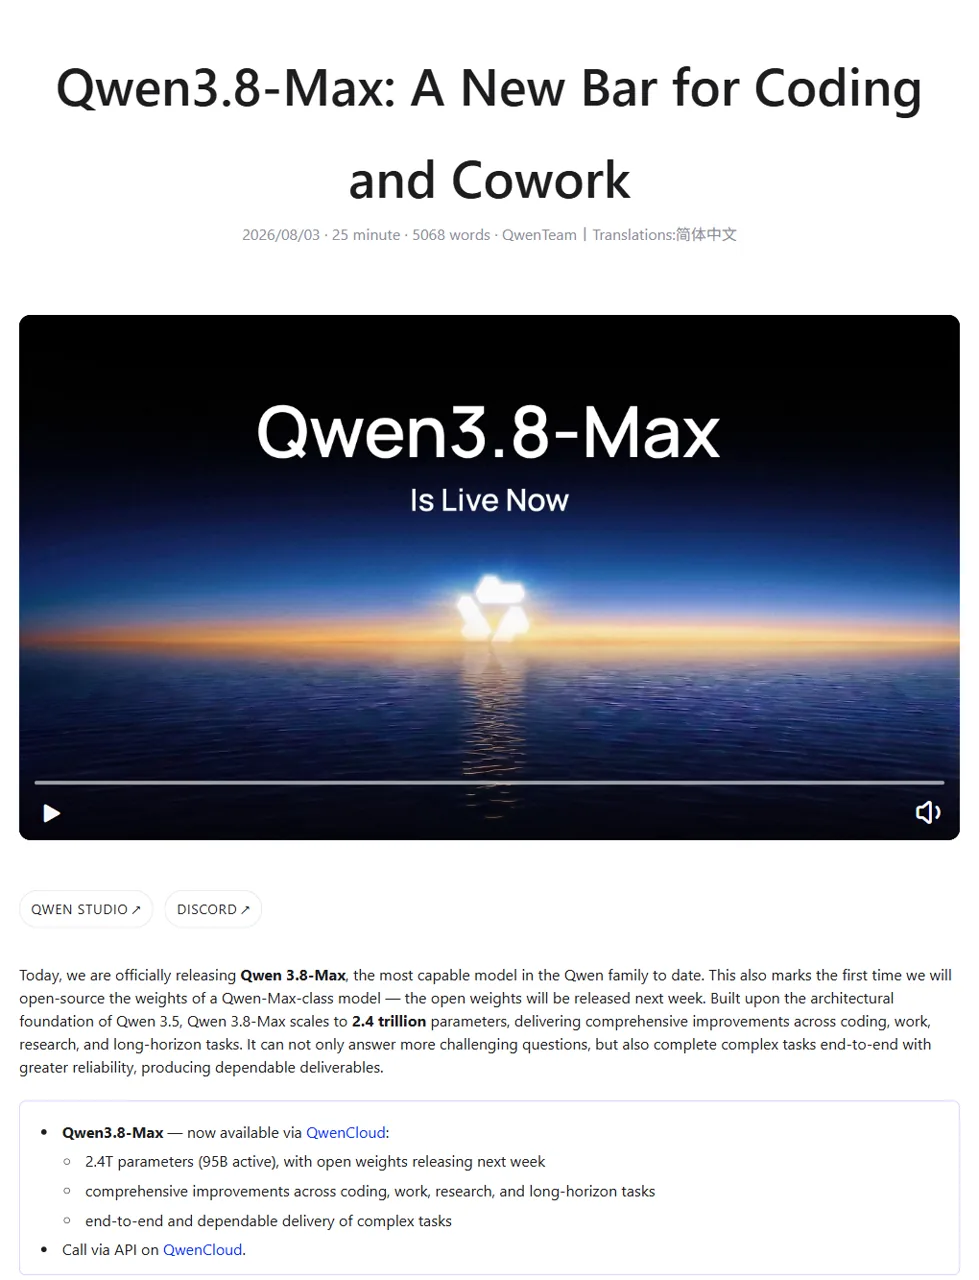
Qwen 3.8 Max ข้อมูลจำเพาะ
จำนวนพารามิเตอร์ต้องพิจารณาในบริบทที่เหมาะสม โมเดลที่มีพารามิเตอร์ 2.4 ล้านล้านตัวนั้นถือว่าใหญ่มาก แต่โมเดล Qwen3.8-Max ไม่ได้ใช้พารามิเตอร์ทุกตัวกับทุกโทเคน การออกแบบแบบ mixture-of-experts ของมันจะนำแต่ละโทเคนผ่านส่วนที่ทำงานอยู่ของเครือข่าย ซึ่งมีขนาดเล็กกว่า ดังนั้น ตัวเลข 95 พันล้านพารามิเตอร์ที่ใช้งานอยู่จึงมีประโยชน์มากกว่าในการเข้าใจพฤติกรรมของการอนุมาน เมื่อเทียบกับจำนวนพารามิเตอร์รวมเพียงอย่างเดียว แม้ว่าทั้งสองตัวเลขนี้จะไม่บอกคุณถึงเวลาแฝงที่แท้จริงหรือความต้องการด้านฮาร์ดแวร์ได้ด้วยตัวเอง.
หน้าต่างบริบทขนาด 1 ล้านโทเคนมีประโยชน์ในทันทีมากกว่า มันสามารถเก็บข้อมูลจากรีโพสิตอรีขนาดใหญ่ ชุดเอกสารที่ยาว ประวัติการทำงานของเอเจนต์ที่ขยายออกไป หรือบันทึกการดำเนินงานเป็นเวลาหลายเดือนได้ภายในคำขอเดียว สิ่งนี้ไม่รับประกันการเรียกคืนข้อมูลที่สมบูรณ์แบบสำหรับทุกโทเคน แต่ให้พื้นที่แก่ผู้พัฒนาได้มากขึ้นในการเก็บรักษาคำสั่ง ผลลัพธ์จากเครื่องมือ โค้ด และการตัดสินใจระหว่างทาง โดยไม่ต้องตัดทอนข้อมูลอย่างรุนแรง.
Qwen3.8-Max สามารถทำอะไรได้บ้าง?
การเขียนโค้ดแบบอัตโนมัติ
เอกสารประชาสัมพันธ์ของ Qwen เน้นย้ำถึงโครงการที่ดำเนินการไปไกลกว่าการขอสร้างโค้ดเพียงครั้งเดียว บริษัทอธิบายถึงการพัฒนาแบบอัตโนมัติที่ใช้เวลามากกว่า 10 วัน โดยเริ่มจากโฟลเดอร์ว่างเปล่าจนกลายเป็นโครงการผลิตจริง พร้อมทั้งปรับตัวให้เข้ากับข้อผิดพลาดและข้อกำหนดใหม่ นี่คือทิศทางที่ถูกต้องสำหรับเอเจนต์ระดับรีโพสิตอรี แม้ว่าผู้ซื้อควรตรวจสอบความเหมาะสมของโมเดลนี้กับภาษาโปรแกรม ชุดทดสอบ กฎความปลอดภัย และสภาพแวดล้อมการปรับใช้ของตนเอง.
สำหรับงานวิศวกรรมในชีวิตประจำวัน คำถามทางปฏิบัติจะเรียบง่ายกว่า: โมเดลนี้สามารถเข้าใจไฟล์หลายไฟล์พร้อมกันได้หรือไม่? มันจะรักษาอินเทอร์เฟซไว้ได้หรือไม่ระหว่างการรีแฟคเตอร์? มันจะเขียนการทดสอบ ตรวจสอบข้อผิดพลาด และแก้ไขแพตช์ของตัวเองได้หรือไม่? เกณฑ์เหล่านี้มีความสำคัญมากกว่าคะแนนบนกระดานผู้นำเพียงอย่างเดียวเมื่อเลือก โมเดล AI ที่ดีที่สุดสำหรับการเขียนโค้ด.
งาน “cowork” แบบมืออาชีพ
คำว่า “cowork” หมายถึงผลงานการทำงาน ไม่ใช่การสนทนาแบบไม่เป็นทางการ Qwen เน้นย้ำถึงรายงาน การวิจัย การนำเสนอ การวิเคราะห์ เอกสาร และผลงานอื่น ๆ ในหลายร้อยสาขาอาชีพ แบบอย่าง cowork ที่ดีต้องปฏิบัติตามข้อกำหนดอย่างชัดเจน จัดระเบียบข้อมูลหลักฐาน ใช้รูปแบบที่ถูกต้อง และส่งมอบผลลัพธ์ที่ผู้รับสามารถแก้ไขหรือนำไปใช้งานต่อได้ — ไม่ใช่เพียงย่อหน้าที่ฟังดูน่าเชื่อถือเท่านั้น.
ตัวแทนที่มีมุมมองระยะยาว
Qwen ยังรายงานว่างานระดับระบบสามารถทำงานต่อเนื่องได้หลายร้อยรอบ ตัวอย่างของมันรวมถึงการเพิ่มประสิทธิภาพการออกแบบชิปกว่า 500 รอบ และการจำลองกลยุทธ์อีคอมเมิร์ซที่ใช้เวลาหนึ่งปี นี่เป็นการสาธิตจากผู้ผลิต ไม่ใช่คำสัญญาว่าทุกเอเจนต์จะทำงานได้โดยไม่ต้องดูแลเป็นเวลาหลายวัน แต่สิ่งเหล่านี้แสดงให้เห็นว่าผลิตภัณฑ์นี้มุ่งเน้นไปที่อะไร: การวางแผนอย่างต่อเนื่อง การประเมินผลแบบวงจรปิด และการปรับปรุงซ้ำๆ แทนที่จะเป็นคำตอบที่แยกส่วน.
การวางแผนแบบหลายรูปแบบและข้อมูลย้อนกลับทางภาพ
Qwen3.8-Max ถือภาพและหน้าจอเป็นส่วนหนึ่งของวงจรการทำงานของเอเจนต์ เอเจนต์เชิงภาพสามารถตรวจสอบหน้าเว็บ เลือกการกระทำ สังเกตสิ่งที่เปลี่ยนแปลง และปรับแผนการทำงานได้ ซึ่งช่วยสนับสนุนงานที่เกี่ยวข้องกับการใช้คอมพิวเตอร์ การเข้าใจเอกสาร การทดสอบอินเทอร์เฟซ การเขียนโค้ดแบบภาพ การวิเคราะห์แผนภูมิ และการคิดเชิงพื้นที่ ส่วนที่ยากไม่ใช่เพียงการจดจำภาพเท่านั้น แต่คือการรักษาความเชื่อมโยงระหว่างการสังเกตทางภาพกับเป้าหมายของเอเจนต์ตลอดหลายขั้นตอน.
การทดสอบแบบปฏิบัติจริง: ผลลัพธ์ที่มีประโยชน์, การตอบสนองช้า, และการทดสอบหนึ่งครั้งที่ไม่มีผลลัพธ์
ผมได้ส่งคำขอสามรายการที่แยกกันไปยัง qwen3.8-max ID ของโมเดลผ่าน API ที่รองรับ Anywhere OpenAI ในวันที่ 4 สิงหาคม 2026 การตรวจสอบเหล่านี้เป็นการตรวจสอบแบบง่าย ๆ ที่ใช้งานได้จริง ไม่ใช่การทดสอบประสิทธิภาพแบบอิสระหรือการยืนยันเกี่ยวกับการปรับใช้ Qwen ทุกกรณี การตรวจสอบเหล่านี้มีประโยชน์เพราะแสดงทั้งคุณภาพของคำตอบที่ปรากฏและพฤติกรรมของเส้นทางเกตเวย์ที่ได้รับการทดสอบ.
การดีบักด้วย Retry-helper
งานแรกใช้ฟังก์ชัน retry ที่ไม่ทำงานถูกต้องจากสถานการณ์ webhook การชำระเงิน ข้อกำหนดในคำสั่งให้จำกัดโมเดลไว้ที่ 3 ครั้งการลองใหม่ 2 ช่วงเวลารอที่แน่นอน การกลับทันทีเมื่อสำเร็จ และการสร้างข้อยกเว้นครั้งที่สามขึ้นใหม่หลังจากล้มเหลวโดยสิ้นเชิง.
คำตอบได้ระบุข้อบกพร่องสามประการที่แยกจากกัน ได้แก่ การเข้าสู่โหมดนอนหลับโดยไม่มีเงื่อนไขหลังจากทุกครั้งที่พยายาม และส่วนที่ยังไม่ได้รับการกำหนด ผลลัพธ์ หลังจากเกิดข้อยกเว้น และการตรวจสอบความถูกต้องที่ส่งผลให้ความสำเร็จถูกเลื่อนออกไปหรือจัดการผิดพลาด บรรทัดที่คาดไว้คือ "paid" พร้อมด้วยพารามิเตอร์ sleep_fn [0.1, 0.2].
จากนั้นผมจึงรันโค้ดบนเครื่องตัวเองแทนที่จะเชื่อคำอธิบายนั้น โค้ดผ่านได้สามกรณี: สองกรณีที่ล้มเหลวตามด้วยความสำเร็จ และค่าที่ดูเหมือนสำเร็จแต่จริงแล้วเป็น falsey ในการเรียกครั้งแรกคือ 0, และสามกรณีที่ผลลัพธ์สุดท้าย RuntimeError("failure-3") ต้องถูกปรับให้สูงขึ้นอีกครั้ง นี่เป็นคำตอบทางวิศวกรรมที่ดี แต่ต้องแลกมาด้วยความล่าช้า: เวลาตอบสนองที่สังเกตได้ใช้เวลา 51.577 วินาที ผ่านเกตเวย์ที่ทดสอบ.
การสังเคราะห์หลักฐานที่ขัดแย้งกัน
งานที่สองมีวัตถุประสงค์เพื่อทดสอบว่าโมเดลสามารถแยกข้อมูลทางการล่าสุดออกจากบันทึกเก่า ข้อเรียกร้องของผู้ขาย ความคิดเห็นจากชุมชน และเส้นทางบนแพลตฟอร์มที่ยังไม่ได้รับการยืนยันได้หรือไม่.
โมเดลนี้ได้จัดการกับความขัดแย้งที่ถูกสร้างขึ้นอย่างถูกต้อง มันไม่ซ้ำบริบท 256K หรือราคาป้อนเข้า $1.20 เป็นค่าปัจจุบัน ไม่แปลงคำอธิบายเกี่ยวกับ GPU สี่ตัวเป็นข้อกำหนดด้านฮาร์ดแวร์ และไม่อ้างว่า GlobalGPT มีเส้นทาง Qwen3.8-Max ที่กำหนดไว้แล้ว นอกจากนี้ ยังระบุตารางผลการทดสอบประสิทธิภาพอย่างเป็นทางการว่าเป็นข้อมูลที่ผู้ผลิตแจ้งมาด้วย การตอบสนองใช้เวลา 94.973 วินาที ดังนั้นนี่จึงเป็นผลลัพธ์ที่เน้นคุณภาพเป็นหลักอีกครั้ง แทนที่จะเป็นผลลัพธ์จากการสกัดข้อมูลที่รวดเร็ว.
ส่วนใดที่ล้มเหลวในการทดสอบการวางแผน?
คำขอที่สามขอให้จัดทำแผนการย้ายระบบ CMS ที่ใช้เวลาสองชั่วโมง โดยมีวิศวกรสองคน พร้อมกำหนดจุดตัดสินใจชัดเจนว่าจะดำเนินการต่อหรือไม่ และจุดที่สามารถย้อนกลับได้ คำขอแรกสิ้นสุดลงหลังจาก 133.682 วินาที เมื่อการเชื่อมต่อกับระบบต้นทางถูกตัดขาด การตั้งค่าการลองใหม่ที่สั้นลง จำนวนโทเค็นสูงสุดที่เสร็จสมบูรณ์ เป็น 1,200 แต่ API รายงานว่า finish_reason: "ความยาว", ใช้หมดงบประมาณการวิเคราะห์ทั้งหมด และไม่แสดงผลลัพธ์ใดๆ หลังจาก 32.899 วินาที.
นี่เป็นคำเตือนในการทำงานที่มีประโยชน์ แต่ไม่ใช่หลักฐานที่แสดงว่า Qwen3.8-Max ไม่สามารถวางแผนการย้ายข้อมูลได้ เนื่องจากไม่มีแผนใดที่พร้อมให้ประเมินผล ผ่านเกตเวย์นี้ การวางแผนที่ซับซ้อนจำเป็นต้องมีเวลาเผื่อสำหรับการเสร็จสิ้นที่มากขึ้น การสตรีมมิ่ง หรือการส่งคำสั่งแบบเป็นขั้นตอน เพื่อไม่ให้กระบวนการคิดภายในใช้ทรัพยากรการตอบสนองทั้งหมดก่อนที่จะแสดงข้อความที่มองเห็นได้.
Qwen 3.8 ผลทดสอบประสิทธิภาพสูงสุด
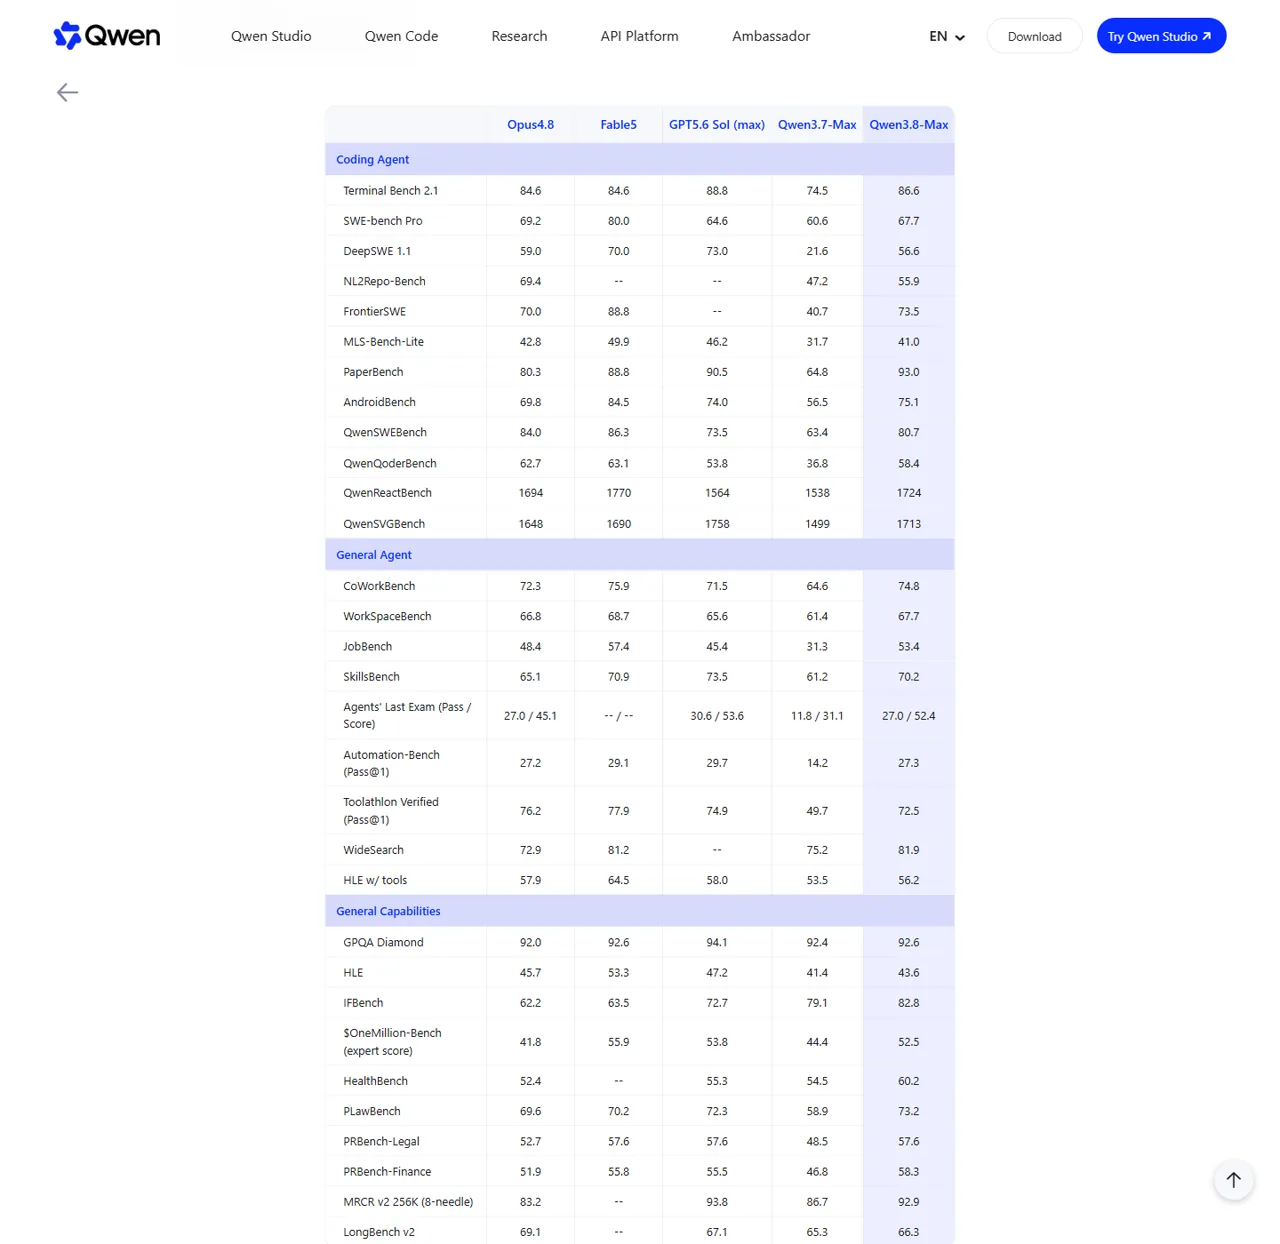
ชุดทดสอบมาตรฐานอย่างเป็นทางการของ Qwen แสดงให้เห็นว่า Qwen3.8-Max เป็นเอเจนต์ที่มีความสามารถในการเขียนโค้ดและทำงานแบบมัลติโมดัลที่แข็งแกร่ง แต่ผลลัพธ์ที่ได้กลับเป็นแบบผสมผสาน แทนที่จะชนะอย่างขาดลอย มันนำหน้าโมเดลที่ระบุไว้ในบางการทดสอบ อยู่ในระดับใกล้เคียงกับผู้นำในบางการทดสอบ และตามหลัง GPT-5.6 Sol หรือ Fable 5 ในหลายหมวดหมู่ ซึ่งเป็นการวิเคราะห์ที่สมดุลกว่าการลดการทดสอบหลายสิบครั้งลงเหลือเพียงป้ายกำกับ “โมเดลที่ดีที่สุด” เพียงหนึ่งเดียว.
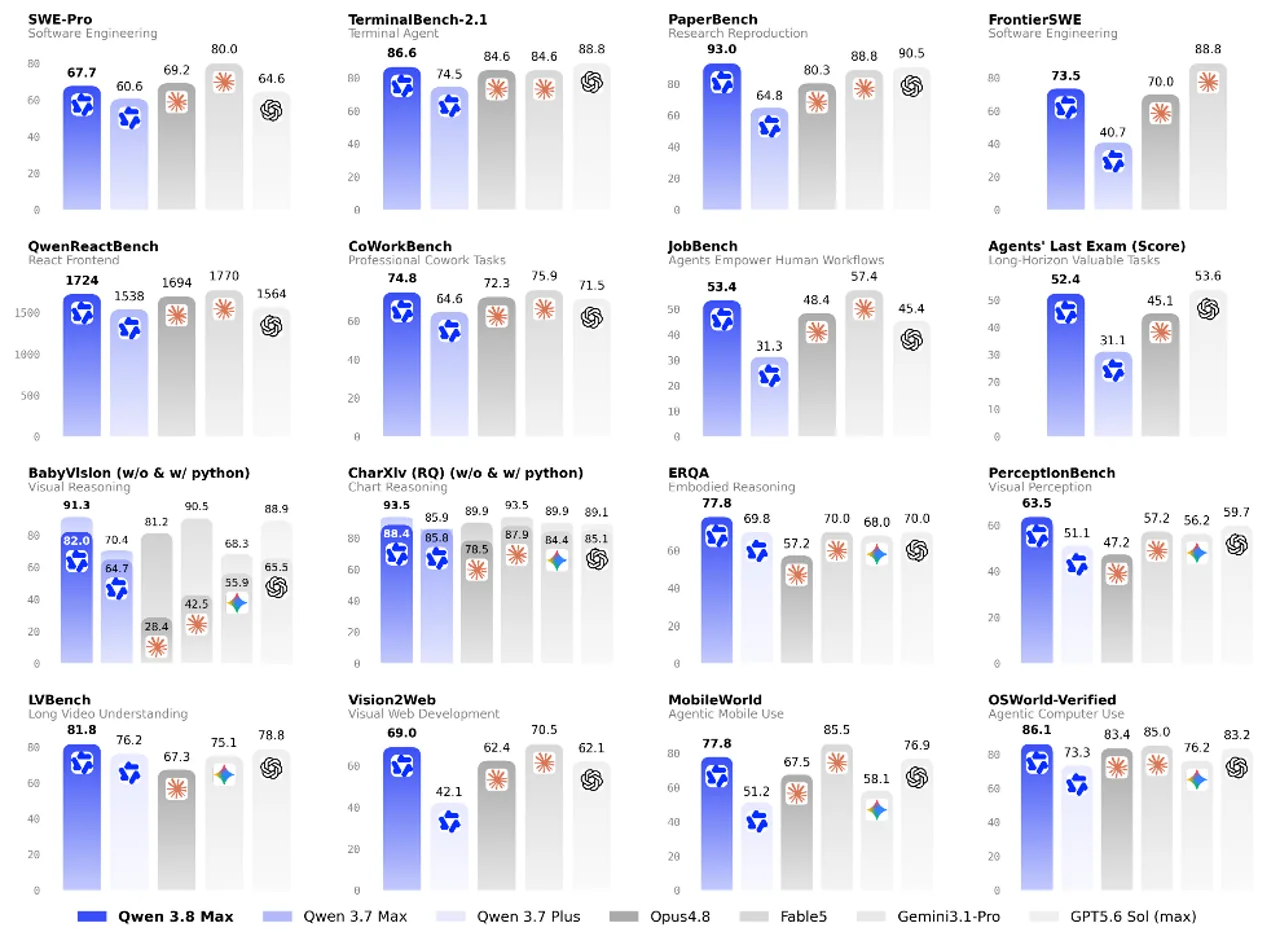
ผลการแข่งขันที่คัดสรรจากตารางคะแนนอย่างเป็นทางการของ Qwen
ตัวเลขเหล่านี้มาจากเอกสารเผยแพร่ของ Qwen เอง หมายเหตุในตารางแสดงว่าข้อมูลในตารางนี้รวมข้อมูลจากรายงานรุ่นอย่างเป็นทางการ บัตรระบบ บอร์ดจัดอันดับสาธารณะ และการประเมินภายในของ Qwen นอกจากนี้ ระบบสายรัดและตั้งค่ายังแตกต่างกันระหว่างรุ่นบางรุ่นด้วย ดังนั้น ให้ใช้ตารางนี้เพื่อระบุจุดแข็งที่มีศักยภาพ แล้วตรวจสอบรายชื่อที่คัดเลือกไว้ด้วยตนเองก่อนที่จะตัดสินใจลงทุนที่มีค่าใช้จ่ายสูง.
ความหมายของผลการวิเคราะห์โค้ด
ข้อได้เปรียบที่ชัดเจนที่สุดคือความสมดุล Qwen3.8-Max อยู่ในอันดับต้นๆ ในด้านงานที่สถานีทำงาน วิศวกรรมซอฟต์แวร์ การนำเอกสารไปใช้จริง งานร่วมกับเพื่อนร่วมงาน การค้นหาบนเว็บ และการปฏิบัติตามคำสั่ง มันไม่จำเป็นต้องชนะทุกแถวเพื่อจะมีประโยชน์; ตัวแทนที่รักษาความแข็งแกร่งอย่างสม่ำเสมอในด้านการวางแผน การเขียนโค้ด การใช้เครื่องมือ และการตรวจสอบทางภาพ อาจน่าเชื่อถือกว่าโมเดลที่ได้รับการปรับแต่งให้เหมาะสมกับการทดสอบเฉพาะด้านหนึ่งเท่านั้น.
ตารางอย่างเป็นทางการยังแสดงให้เห็นด้วยว่าทำไมการทดสอบแบบเปรียบเทียบกันจึงสำคัญ GPT-5.6 Sol นำหน้าในหลายแถวที่เกี่ยวข้องกับการให้เหตุผลหรือการทำงานกับเทอร์มินัล ในขณะที่ Fable 5 ยังคงมีความสามารถในการแข่งขันสูงเป็นพิเศษใน任务ที่เกี่ยวข้องกับการทำงานร่วมกัน การใช้งานอินเทอร์เฟซ และงานด้านภาพ นอกจากนี้ยังมีตารางแยกต่างหาก การเปรียบเทียบระหว่าง GPT-5.6 และ Fable 5 สามารถช่วยคุณนำกลุ่มโมเดลเหล่านั้นมาประยุกต์ใช้ในสถานการณ์จริงก่อนที่จะนำ Qwen3.8-Max เข้าสู่รายชื่อตัวเลือกสุดท้าย.
ความหมายของผลการวิเคราะห์แบบหลายรูปแบบ
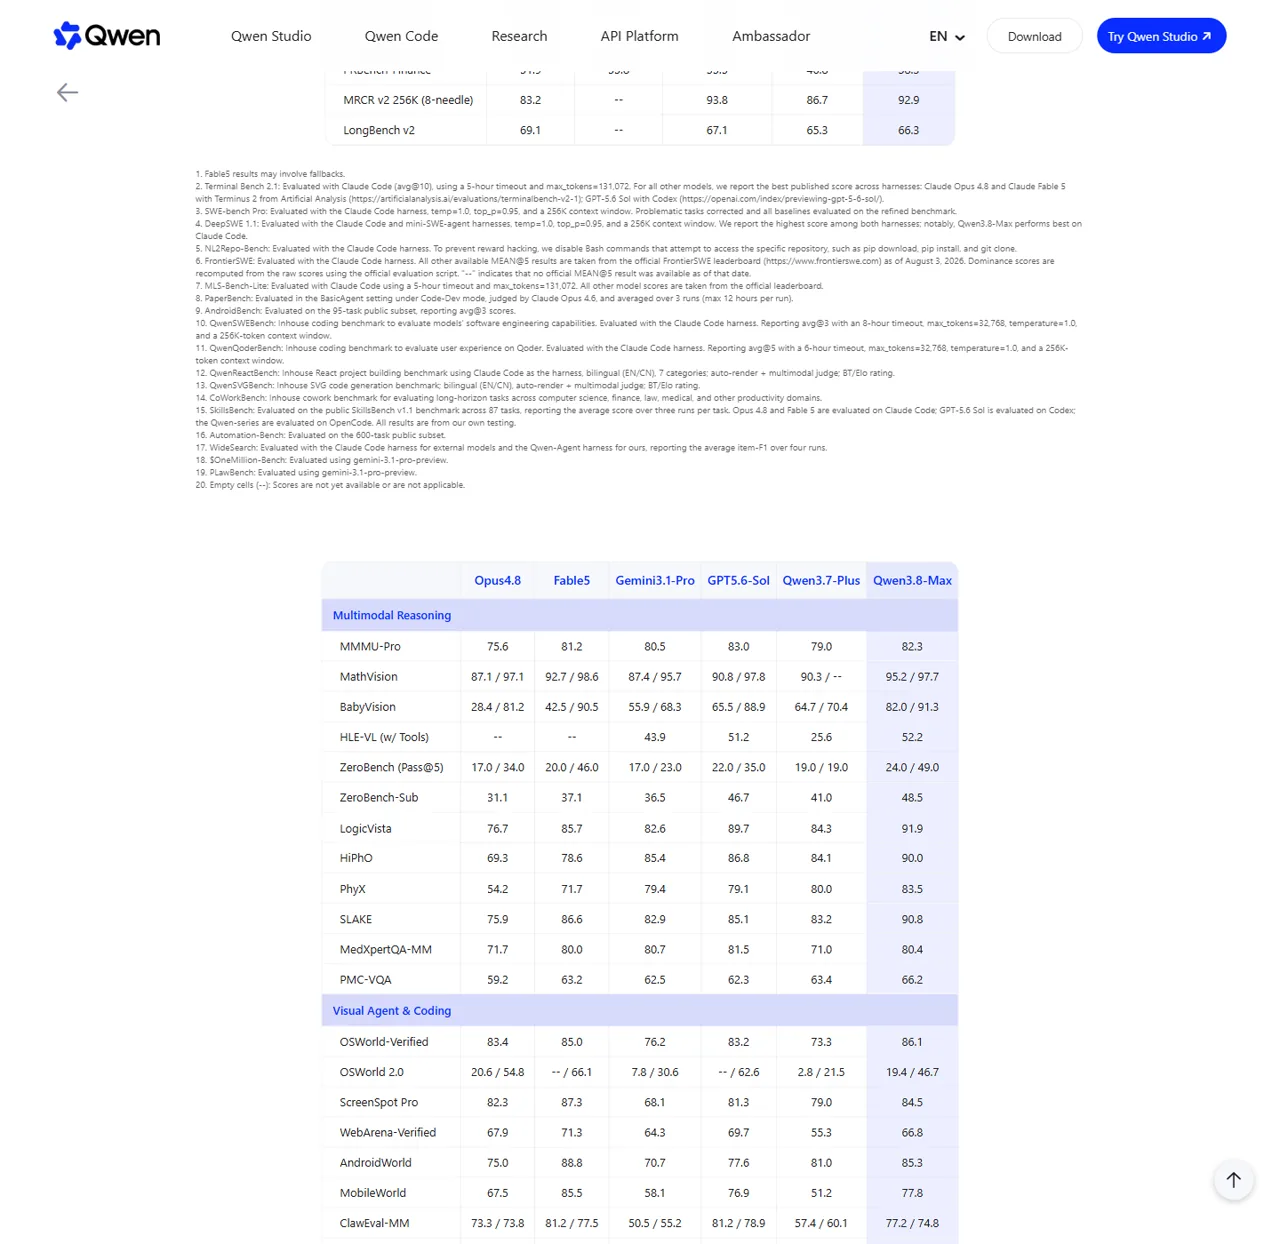
Qwen3.8-Max ได้แสดงผลการทดสอบอย่างเป็นทางการที่แข็งแกร่งในด้านการให้เหตุผลแบบหลายรูปแบบ (multimodal reasoning), การเชื่อมโยงภาพกับข้อมูลจริง (visual grounding), การใช้คอมพิวเตอร์, การทำงานกับเอกสาร และความเข้าใจด้านพื้นที่ คะแนน 86.1 บน OSWorld-Verified มีความสำคัญเป็นพิเศษสำหรับเอเจนต์ที่ทำงานผ่านหน้าจอ เนื่องจากคะแนนนี้วัดความสามารถในการทำงานให้เสร็จสิ้นภายในสภาพแวดล้อมเดสก์ท็อป ไม่ใช่เพียงการอธิบายภาพเท่านั้น.
การเปรียบเทียบ Qwen3.8-Max
ไม่มีคำตอบสั้นๆ ที่ชัดเจนสำหรับคำถามว่า “Qwen3.8-Max ดีกว่า GPT, Claude หรือ Gemini หรือไม่?” ข้อมูลของ Qwen เองแสดงให้เห็นว่าผู้นำในแต่ละหมวดหมู่เปลี่ยนไปจากแถวหนึ่งไปยังแถวอื่น ความเหมาะสมของผลิตภัณฑ์ยังขึ้นอยู่กับความน่าเชื่อถือของเครื่องมือ คุณภาพผลลัพธ์ ความล่าช้า ความพร้อมใช้งานในแต่ละภูมิภาค การควบคุมความเป็นส่วนตัว และส่วนติดต่อผู้ใช้ที่เกี่ยวข้องกับโมเดล.
Qwen3.8-Max ดูน่าสนใจที่สุดเมื่อคุณต้องการใช้โมเดลเดียวเพื่อครอบคลุมงานเขียนโค้ด เอกสาร การวิจัย งานที่ใช้เวลานาน และเอเจนต์แบบภาพ GPT-5.6 Sol อาจยังคงเป็นตัวเลือกที่ดีกว่าสำหรับงานที่ความสามารถในการให้เหตุผลที่แข็งแกร่งที่สุดและผลลัพธ์สุดท้ายของมันสามารถนำไปใช้ในสภาพแวดล้อมของคุณได้ Fable 5 ควรได้รับการพิจารณาอย่างละเอียดสำหรับงานร่วมกับเพื่อนร่วมงานและงานที่เน้นส่วนติดต่อผู้ใช้ (UI); ส่วน การเปรียบเทียบระหว่าง Fable 5 และ Opus 4.8 ให้ข้อมูลเพิ่มเติมเกี่ยวกับส่วนนั้นของคำตัดสิน.
น้ำหนักแบบเปิดที่วางแผนไว้ของโมเดลนี้อาจกลายเป็นข้อได้เปรียบทางโครงสร้างที่ใหญ่ที่สุดของมัน แม้ว่าประสิทธิภาพที่ทำงานผ่าน API เท่านั้นจะมีความสำคัญในปัจจุบัน แต่น้ำหนักแบบเปิดที่สามารถดาวน์โหลดได้จะสร้างตัวเลือกสำหรับการปรับแต่งอย่างละเอียด โครงสร้างพื้นฐานส่วนตัว การวิจัย และการนำไปใช้ในระดับภูมิภาค มูลค่าสุดท้ายจะขึ้นอยู่กับใบอนุญาตที่เผยแพร่ รูปแบบน้ำหนัก การสนับสนุนการควอนไทเซชัน และฮาร์ดแวร์ที่จำเป็นเพื่อรันโมเดลด้วยความเร็วที่มีประโยชน์.
Qwen3.8-Max ราคา API
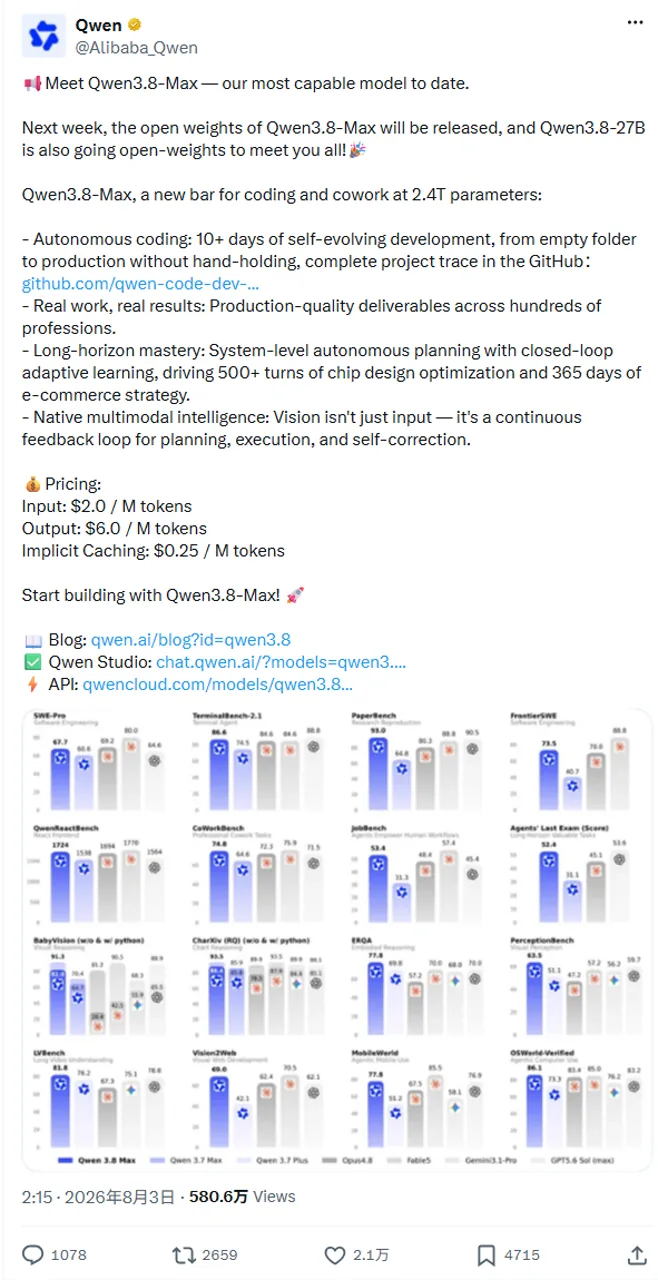
Qwen ได้ระบุราคาเปิดตัวดังต่อไปนี้ใน ประกาศอย่างเป็นทางการ:
การประมาณการอย่างง่ายๆ คือ:
ค่าใช้จ่ายประมาณ = ข้อมูลเข้าที่ยังไม่ถูกเก็บในแคช × $2/M + ข้อมูลเข้าที่ถูกเก็บในแคช × $0.25/M + ข้อมูลออก × $6/M
ตัวอย่างเช่น การดำเนินการที่ใช้โทเคนอินพุต 10 ล้านโทเคนที่ไม่ได้เก็บไว้ในแคช และโทเคนเอาต์พุต 2 ล้านโทเคน จะมีค่าใช้จ่ายประมาณ $32 ตามอัตราค่าบริการในช่วงเปิดตัว ก่อนที่จะมีค่าใช้จ่ายจากแพลตฟอร์มอื่น ๆ: $20 สำหรับอินพุต และ $12 สำหรับเอาต์พุต เอเจนต์ที่อ่านซ้ำรีโพสิตอรีขนาดใหญ่ในทุกรอบอาจใช้ค่าใช้จ่ายสูงกว่ามาก ซึ่งทำให้การแคชและการจัดการบริบทมีความสำคัญไม่แพ้กับราคาอินพุตหลัก.
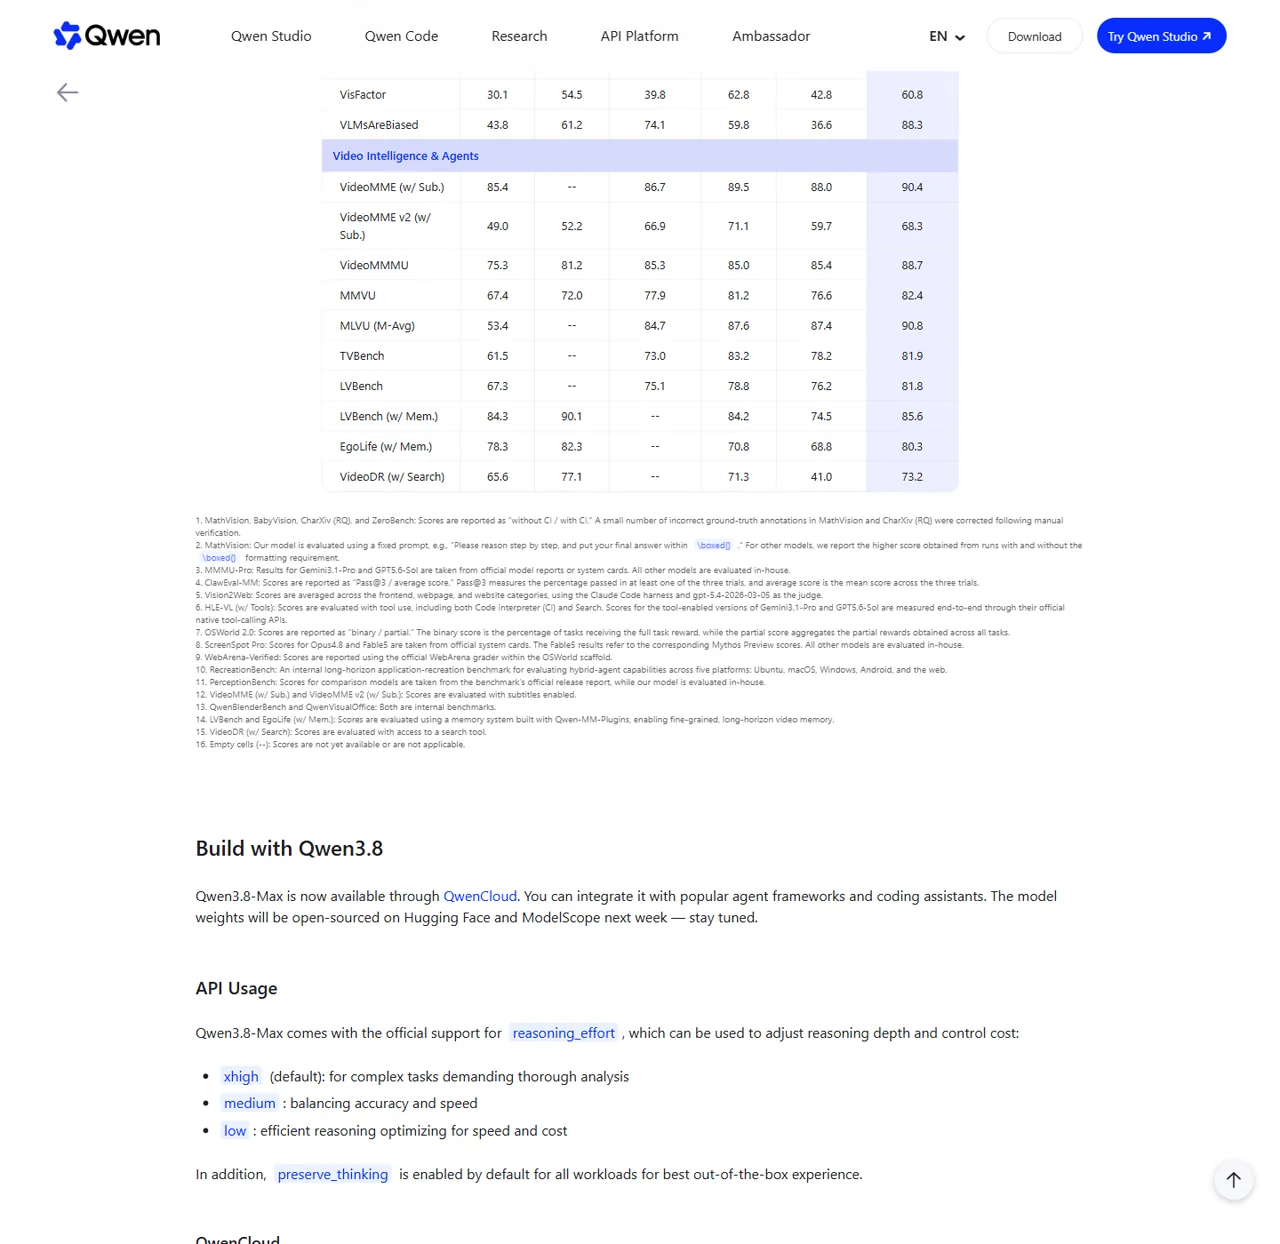
Qwen3.8-Max ยังสนับสนุน การคิดวิเคราะห์และความพยายาม ปุ่มควบคุม ส่วน API อย่างเป็นทางการระบุไว้ว่า xสูง เป็นค่าเริ่มต้นสำหรับการวิเคราะห์เชิงซ้อน, ปานกลาง เพื่อหาจุดสมดุลระหว่างความแม่นยำและความเร็ว และ ต่ำ เพื่อทำงานได้เร็วขึ้นและมีประสิทธิภาพมากขึ้น. การรักษาความคิด ถูกเปิดใช้งานโดยค่าเริ่มต้น การควบคุมเหล่านี้สามารถช่วยลดค่าใช้จ่ายได้ แต่ควรทดสอบเพื่อประเมินคุณภาพของงาน แทนที่จะถือว่าเป็นการตั้งค่าที่สามารถใช้แทนกันได้.
การกำหนดราคาข้ามผู้ให้บริการก็จำเป็นต้องระมัดระวังในลักษณะเดียวกัน โมเดลที่มีอัตราโทเคนต่ำกว่าอาจมีค่าใช้จ่ายสูงกว่าได้ หากจำเป็นต้องใช้ข้อความคำสั่งที่ยาวขึ้น ต้องลองใหม่หลายครั้ง หรือต้องเรียกใช้เครื่องมือเพิ่มเติม คู่มือราคา API Gemini 3.1 Pro เป็นตัวอย่างที่แสดงให้เห็นว่าทำไมความยาวของบริบทและระดับการใช้งานจึงมีความสำคัญควบคู่กับอัตราพื้นฐาน.
วิธีเข้าถึง Qwen3.8-Max
1. ใช้ Qwen Studio เพื่อประเมินผลโดยตรง
ทางที่เร็วที่สุดเพื่อได้เห็นกันครั้งแรกคือ Qwen Studio. เริ่มด้วยงานจริงแทนที่จะใช้คำถามแบบความรู้ทั่วไป: ให้โจทย์ที่ซับซ้อน ปัญหาการเขียนโค้ดที่มีหลายไฟล์ ชุดเอกสาร หรือกระบวนการทำงานที่อิงจากภาพ ตรวจสอบว่าผลลัพธ์นั้นถูกต้อง สามารถแก้ไขได้ และครบถ้วนพอที่จะช่วยประหยัดเวลา.
2. ใช้ API QwenCloud สำหรับแอปพลิเคชัน
Qwen3.8-Max สามารถหาซื้อได้ผ่าน QwenCloud. หน้าประกาศระบุว่า API ของมันสนับสนุนโปรโตคอลการเติมข้อความอัตโนมัติและการตอบกลับตามมาตรฐานอุตสาหกรรม ซึ่งสอดคล้องกับข้อกำหนดของ OpenAI รวมถึงอินเทอร์เฟซที่สอดคล้องกับ Anthropic สิ่งนี้ช่วยให้การย้ายระบบเป็นไปอย่างง่ายดายขึ้น แต่คุณควรตรวจสอบชื่อโมเดล พารามิเตอร์ พฤติกรรมการสตรีม สคีมาของเครื่องมือ และวิธีการจัดการข้อผิดพลาดในเอกสารอย่างเป็นทางการ.
3. เชื่อมต่อกับเครื่องมือการเขียนโค้ดและเครื่องมือเอเจนต์
หน้าเปิดตัวของ Qwen มีการสนับสนุนการผสานรวมกับ Qwen Code, Claude Code, Codex และ OpenClaw ดังนั้น โมเดลนี้จึงสามารถผสานเข้ากับกระบวนการทำงานของเทอร์มินัลหรือเอเจนต์ที่มีอยู่ได้ โดยไม่ต้องสร้างอินเทอร์เฟซใหม่ การสนับสนุนการผสานรวมไม่ช่วยลดค่าใช้จ่ายของเครื่องมือที่เกี่ยวข้อง ดังนั้นควรเปรียบเทียบใบแจ้งหนี้ของโมเดลกับค่าใช้จ่ายของเครื่องมืออื่น ๆ ที่แยกต่างหาก โครงสร้างราคาของ Codex ก่อนที่จะกำหนดมาตรฐานกระบวนการทำงานของทีม.
ผู้ใช้รหัส Claude ควรแยกค่าใช้จ่ายของผลิตภัณฑ์การเขียนโค้ดออกจาก API ของโมเดลภายนอกด้วย แผนบริการและวิธีการเรียกเก็บเงินที่มีอยู่ได้สรุปไว้ใน คู่มือกำหนดราคาตามรหัส Claude.
ผู้ใช้ OpenClaw มีคำถามเพิ่มเติมว่า: รุ่นใดที่ให้สมดุลที่ดีที่สุดระหว่างการใช้งานเครื่องมือ ความเร็ว และราคา สำหรับตัวแทนเฉพาะตัวนั้น การเปรียบเทียบรุ่น OpenClaw ให้กรอบการทำงานที่ใช้งานได้จริงสำหรับการตัดสินใจนั้น แทนที่จะเลือกใช้โมเดลที่ใหญ่ที่สุดโดยอัตโนมัติ.
4. รักษาความโปร่งใสของกระบวนการทำงานแบบหลายโมเดล
เมื่อเปิดตัว QwenCloud เป็นเส้นทางผลิตที่ได้รับการยืนยันแล้วสำหรับ Qwen3.8-Max หากเปรียบเทียบกับ GPT, Claude, Gemini หรือตัวเลือกอื่น ๆ ของ Fable แล้ว พื้นที่ทำงานแบบหลายโมเดล GlobalGPT สามารถลดการเปลี่ยนแท็บระหว่างรุ่นต่าง ๆ ที่ระบบรองรับได้ ให้ใช้เส้นทาง Qwen อย่างเป็นทางการสำหรับ Qwen3.8-Max จนกว่าหน้าโมเดล GlobalGPT ที่เฉพาะเจาะจงจะได้รับการยืนยัน; อย่าสมมติว่า URL ของโมเดลใหม่มีอยู่เพียงเพราะโมเดลนั้นได้รับการประกาศแล้ว.
Qwen3.8 - น้ำหนักสูงสุดเมื่อเปิด
Qwen ประกาศว่า รุ่น Qwen3.8-Max จะถูกเปิดตัวในสัปดาห์ถัดไปหลังจากงานเปิดตัวเมื่อวันที่ 3 สิงหาคม รุ่นเดียวกัน โพสต์อย่างเป็นทางการบน X ยังกล่าวด้วยว่า Qwen3.8-27B จะกลายเป็นระบบแบบ open-weight ซึ่งถือเป็นข่าวดีสำหรับการนำไปใช้และวิจัยในท้องถิ่น แต่การประกาศเพียงอย่างเดียวนั้นยังไม่เพียงพอที่จะวางแผนสร้างคลัสเตอร์สำหรับการผลิต.
ก่อนที่จะดาวน์โหลดหรือจัดงบประมาณสำหรับอุปกรณ์ฮาร์ดแวร์ ให้ตรวจสอบห้าข้อจากบัตรรุ่นสุดท้าย:
- เงื่อนไขใบอนุญาตและเงื่อนไขการใช้ในเชิงพาณิชย์อย่างละเอียด.
- URL ของ repositori Hugging Face หรือ ModelScope อย่างเป็นทางการ.
- รูปแบบความแม่นยำและรูปแบบการควอนไทเซชันที่มีอยู่.
- ข้อกำหนดขั้นต่ำและที่แนะนำสำหรับ CPU, GPU, RAM และพื้นที่จัดเก็บข้อมูล.
- ว่ารุ่นที่ปล่อยออกมาตรงกับพฤติกรรมของ API ที่โฮสต์และความยาวของบริบทหรือไม่.
“Open weight” และ “open source” ไม่เสมอเป็นสิ่งเดียวกัน Open weight หมายถึงว่าคุณสามารถดาวน์โหลดพารามิเตอร์ของโมเดลได้ ส่วนใบอนุญาตจะกำหนดว่าคุณสามารถปรับเปลี่ยน แจกจ่ายต่อ หรือใช้ในเชิงพาณิชย์ได้หรือไม่ จนกว่าคลังข้อมูลและใบอนุญาตจะพร้อมใช้งาน หน้าเว็บที่สัญญาว่าจะให้ดาวน์โหลด Qwen3.8-Max การสร้าง GGUF หรือข้อกำหนดฮาร์ดแวร์ท้องถิ่นที่แม่นยำ กำลังให้ข้อมูลเกินกว่าหลักฐานที่มีอยู่.
การประกาศรุ่น 27B ควรได้รับการจัดการในลักษณะเดียวกัน มันอาจกลายเป็นตัวเลือกที่สมจริงยิ่งขึ้นสำหรับผู้ใช้ท้องถิ่น แต่สถาปัตยกรรม ความยาวของบริบท ความต้องการด้านหน่วยความจำ และคะแนนการทดสอบประสิทธิภาพ ควรมาจากบัตรข้อมูลโมเดลอย่างเป็นทางการของรุ่นนี้เอง — ไม่ใช่คัดลอกจากโมเดล Max.
Qwen3.8 - ข้อจำกัดสูงสุดและค่าที่เหมาะสมที่สุด
ข้อจำกัดที่ควรพิจารณา
- ข้อมูลส่วนใหญ่เกี่ยวกับการปล่อยจรวดมาจาก Qwen. การประเมินแบบอิสระอาจใช้คำถามนำทาง เครื่องมือ หรือกฎการให้คะแนนที่แตกต่างกัน.
- บริบทที่ยาวไม่ได้หมายความว่าเป็นความจำที่สมบูรณ์. โมเดลสามารถรับข้อมูลได้ถึง 1 ล้านโทเคน แต่ยังคงอาจพลาดรายละเอียดบางอย่าง หรือปฏิบัติตามคำสั่งที่ไม่ชัดเจน.
- เอเจนต์ที่มีปริมาณข้อมูลออกสูงอาจมีค่าใช้จ่ายสูง. อัตราการออกผล $6 ต่อหนึ่งล้านมีความสำคัญเมื่อกระบวนการทำงานสร้างรหัสที่ยาว รายงาน หรือรอยติดตามการให้เหตุผลที่ซ้ำกัน.
- รายละเอียดการติดตั้งในท้องถิ่นจะยังไม่ครบถ้วนจนกว่าน้ำหนักและบัตรโมเดลจะถึง. ระบบ 2.4T แบบพารามิเตอร์รวมจะไม่ทำงานเหมือนรุ่นเดสก์ท็อปขนาดเล็ก.
- การใช้เครื่องมือทำให้มีความเสี่ยงเพิ่มเติมอีกขั้นหนึ่ง. สถานะของเบราว์เซอร์ สิทธิ์การใช้งาน ข้อผิดพลาดของเครือข่าย และโครงสร้างข้อมูลเครื่องมือที่กำหนดไว้ไม่ชัดเจน อาจทำให้โมเดลที่เดิมมีประสิทธิภาพดีเกิดข้อผิดพลาดได้.
- ข้อมูลการเปิดตัวเปลี่ยนแปลงอย่างรวดเร็ว. ควรตรวจสอบราคา ที่เก็บข้อมูล การบูรณาการ และความพร้อมใช้งานอีกครั้งก่อนการเผยแพร่หรือการจัดซื้อ.
ใครควรลองใช้ตอนนี้?
จุดสำคัญคือ Qwen3.8-Max สมควรได้รับการทดสอบอย่างจริงจัง แต่ไม่ควรนำไปใช้โดยไม่มีการประเมินอย่างละเอียด ให้ใช้ภารกิจที่ท้าทายหนึ่งงานที่มีเงื่อนไขความสำเร็จที่ชัดเจน บันทึกจำนวนโทเคนรวมและจำนวนครั้งที่ลองใหม่ แล้วเปรียบเทียบผลลัพธ์สุดท้าย — ไม่ใช่เพียงคำตอบแรกเท่านั้น.
คำถามที่พบบ่อย
Qwen 3.8 Max ออกเมื่อไหร่?
Qwen3.8-Max ได้รับการประกาศอย่างเป็นทางการเมื่อวันที่ 3 สิงหาคม 2569 รุ่นที่โฮสต์ได้เริ่มใช้งานได้ผ่าน Qwen Studio และ QwenCloud ตั้งแต่การเปิดตัว Qwen ระบุว่าจะปล่อยน้ำหนักแบบเปิด (open weights) ในสัปดาห์ถัดไป ดังนั้น การเปิดใช้งาน API และการดาวน์โหลดน้ำหนักควรถือเป็นจุดสำคัญที่แยกกัน.
Qwen3.8-Max เป็นซอฟต์แวร์โอเพนซอร์สหรือไม่?
Qwen ได้ประกาศเวอร์ชัน open-weight สำหรับ Qwen3.8-Max แต่ที่เก็บโค้ดและใบอนุญาตฉบับสุดท้ายจะเป็นตัวกำหนดว่าผู้ใช้สามารถรัน ปรับเปลี่ยน แจกจ่ายต่อ หรือใช้ในเชิงพาณิชย์ได้หรือไม่ จนกว่าไฟล์เหล่านั้นจะถูกเผยแพร่และตรวจสอบแล้ว การระบุว่า “ประกาศเวอร์ชัน open-weight” จะมีความแม่นยำมากกว่าการสมมติว่าสิทธิ์การใช้งานแบบโอเพนซอร์สหรือรูปแบบท้องถิ่นทุกประเภทมีให้ใช้งานแล้ว.
Qwen3.8-Max มีพารามิเตอร์กี่ตัว?
Qwen3.8-Max มีพารามิเตอร์รวมทั้งหมด 2.4 ล้านล้าน และเปิดใช้งานพารามิเตอร์ 95 พันล้านต่อโทเคน มันใช้สถาปัตยกรรมแบบผสมผู้เชี่ยวชาญ (mixture-of-experts) ดังนั้น จำนวนพารามิเตอร์รวมและจำนวนพารามิเตอร์ที่เปิดใช้งานจึงอธิบายส่วนต่าง ๆ ของระบบ ตัวเลขทั้งสองนี้เมื่อพิจารณาแยกกันไม่สามารถคาดการณ์ความเร็วในการใช้งานจริงหรือความต้องการด้านฮาร์ดแวร์ได้.
หน้าต่างบริบท Qwen3.8-Max คืออะไร?
ในประกาศอย่างเป็นทางการระบุว่าหน้าต่างบริบทมีขนาด 1 ล้านโทเคน ซึ่งขนาดนี้เพียงพอสำหรับโค้ดที่กว้างขวาง เอกสาร ผลลัพธ์จากเครื่องมือ และประวัติของเอเจนต์ แต่ขนาดบริบทสูงสุดไม่รับประกันว่าการเรียกข้อมูลจะสมบูรณ์แบบ ดังนั้น ควรทดสอบโมเดลในตำแหน่ง รูปแบบ และความหนาแน่นของข้อมูลที่ใช้ในกระบวนการทำงานจริงของคุณ.
ราคาของ API Qwen3.8-Max เป็นเท่าไร?
เมื่อเปิดตัว Qwen ได้กำหนดราคาไว้ที่ $2 ต่อหนึ่งล้านโทเคนอินพุต, $6 ต่อหนึ่งล้านโทเคนเอาต์พุต และ $0.25 ต่อหนึ่งล้านโทเคนที่ถูกเก็บไว้ในแคชโดยอัตโนมัติ โปรดพิจารณาค่าเหล่านี้เป็นราคาเปิดตัวและตรวจสอบให้แน่ใจก่อนที่จะจัดทำงบประมาณ ค่าใช้จ่ายของเอเจนต์ยังขึ้นอยู่กับระดับการนำบริบทมาใช้ซ้ำ ความพยายามในการวิเคราะห์ การลองใหม่ และความยาวของผลลัพธ์ที่สร้างขึ้น.
Qwen3.8-Max ดีกว่า GPT-5.6 Sol หรือ Fable 5 หรือไม่?
ไม่ใช่ในทุกการทดสอบ ตารางอย่างเป็นทางการของ Qwen แสดงว่า Qwen3.8-Max นำหน้าในบางเกณฑ์การทดสอบด้านการเขียนโค้ด การค้นหา การปฏิบัติตามคำสั่ง และการใช้คอมพิวเตอร์ ในขณะที่ GPT-5.6 Sol หรือ Fable 5 นำหน้าในเกณฑ์การทดสอบอื่น ๆ รุ่นที่เหมาะที่สุดขึ้นอยู่กับงาน สภาพแวดล้อมของเครื่องมือ ความล่าช้า ราคา และคุณภาพของผลลัพธ์สุดท้าย.
ผมสามารถรัน Qwen3.8-Max บนเครื่องท้องถิ่นได้ไหม?
Qwen ได้ประกาศว่าสามารถดาวน์โหลดข้อมูลน้ำหนัก (weights) ได้ในสัปดาห์หลังการเปิดตัว แต่ความเป็นไปได้ในท้องถิ่นจะขึ้นอยู่กับไฟล์สุดท้าย ความแม่นยำ การสนับสนุนการควอนไทเซชัน ใบอนุญาต และคำแนะนำด้านฮาร์ดแวร์ โปรดรอจนกว่าจะมีบัตรโมเดลอย่างเป็นทางการก่อนที่จะเชื่อถือการประมาณการ RAM, VRAM หรือพื้นที่จัดเก็บข้อมูลที่แม่นยำ รุ่น Qwen3.8 ที่มีขนาดเล็กกว่าอาจใช้งานได้จริงมากขึ้นเมื่อมีเอกสารอย่างเป็นทางการ.
Qwen3.8-27B คืออะไร?
ในโพสต์ประกาศเปิดตัว Qwen ระบุว่า Qwen3.8-27B จะถูกปล่อยออกมาพร้อมน้ำหนักแบบเปิด (open weights) ด้วย แต่บทความประกาศปล่อยเวอร์ชัน Max ไม่ได้ให้รายละเอียดเพียงพอที่จะนำข้อมูลจำเพาะของโมเดล Max มาใช้ซ้ำกับเวอร์ชัน 27B โปรดตรวจสอบบัตรรุ่นเฉพาะเพื่อดูข้อมูลเกี่ยวกับสถาปัตยกรรม หน้าต่างบริบท ผลการทดสอบประสิทธิภาพ ใบอนุญาต และคำแนะนำการดาวน์โหลด.
สามารถใช้ Qwen3.8-Max บน GlobalGPT ได้หรือไม่?
เส้นทาง GlobalGPT ที่จัดไว้เฉพาะสำหรับ Qwen3.8-Max ยังไม่ได้รับการยืนยัน ณ เวลาที่เผยแพร่ ใช้ Qwen Studio หรือ QwenCloud เพื่อเข้าถึงโดยตรง GlobalGPT ยังคงมีประโยชน์สำหรับการเปรียบเทียบโมเดล GPT, Claude, Gemini และ Fable อื่นๆ ที่มีอยู่ โดยไม่ต้องเปลี่ยนแพลตฟอร์ม.
คำตัดสินสุดท้าย
ใช้ Qwen Studio หรือ QwenCloud เพื่อประเมิน Qwen3.8-Max โดยตรง ใช้ GlobalGPT เพื่อเปรียบเทียบโมเดลอื่นที่ได้รับการตรวจสอบแล้ว โดยไม่ถือว่าเส้นทาง Qwen3.8-Max ที่เฉพาะเจาะจงนั้นมีอยู่แล้ว.
เปรียบเทียบรุ่นที่มีอยู่Qwen 3.8 Max เป็นหนึ่งในโมเดลที่เปิดตัวในปี 2026 ด้วยความทะเยอทะยานสูงสุด: มีพารามิเตอร์รวม 2.4 ล้านล้านพารามิเตอร์ พารามิเตอร์ที่ใช้งานได้ 95 พันล้านพารามิเตอร์ หน้าต่างบริบทขนาด 1 ล้านโทเคน ผลลัพธ์อย่างเป็นทางการที่แข็งแกร่งในด้านการเขียนโค้ดและเอเจนต์แบบมัลติโมดัล รวมถึงแผนการเปิดเผยน้ำหนักแบบเปิดที่ได้ประกาศไว้แล้ว ราคา API สำหรับการเปิดตัวนี้มีความแข่งขันสูงพอที่จะนำไปทดสอบได้ โดยเฉพาะเมื่อการใช้แคชช่วยลดค่าใช้จ่ายจากบริบทที่ซ้ำกัน.
เหตุผลสำคัญที่สุดที่ควรให้ความสนใจไม่ใช่การชนะในการทดสอบประสิทธิภาพเพียงครั้งเดียว แต่เป็นความพยายามที่จะรวมการเขียนโค้ด ผลงานมืออาชีพ การวางแผนระยะยาว การให้ข้อเสนอแนะทางภาพ และการใช้เครื่องมือไว้ในโมเดลเดียว เริ่มต้นด้วย Qwen Studio หรือการประเมิน QwenCloud แบบควบคุม วัดคุณภาพของงานที่เสร็จสิ้นและค่าใช้จ่ายรวม แล้วรอจนกว่าจะมีน้ำหนักและใบอนุญาตอย่างเป็นทางการ ก่อนที่จะให้คำมั่นสัญญาเกี่ยวกับการปรับใช้ในท้องถิ่น.
แหล่งข้อมูลหลักที่ตรวจสอบเมื่อวันที่ 4 สิงหาคม 2026: Qwen3.8-Max เวอร์ชันอย่างเป็นทางการ และ โพสต์อย่างเป็นทางการเกี่ยวกับการเปิดตัว @Alibaba_Qwen.