Muse Spark 1.2 ผสมผสานราคาโทเคนที่ต่ำอย่างผิดปกติกับหน้าต่างบริบทขนาด 1 ล้านโทเคน และได้ผ่านทั้งสามภารกิจเขียนโค้ดของโมเดลพื้นฐานในชุด API ครั้งแรกของเรา. Meta ได้เปิดตัวโมเดลนี้บน 5 สิงหาคม 2569, ด้วยหน้าต่างบริบทขนาด 1 ล้านโทเคน, สองระดับราคา API และเอเจนต์เทอร์มินัลแยกต่างหากที่เรียกว่า Muse Code ผลลัพธ์การทดสอบประสิทธิภาพของ Meta ดูมีแนวโน้มที่ดี; แต่ตารางอันดับการเขียนโค้ดสาธารณะที่เป็นอิสระยังไม่ได้ตรวจสอบการผสมผสานระหว่างโมเดลและเอเจนต์เดียวกันนี้.
การวิเคราะห์ครั้งนี้แยกโมเดลออกจากเอเจนต์ แยกคะแนนอย่างเป็นทางการออกจากหลักฐานอิสระ และแยกการกำหนดราคาตามมาตรฐานออกจากความสมดุลระหว่างการใช้ข้อมูลกับระดับ Contributor ในการทดสอบของเรา โมเดลได้ดำเนินการแก้ไขปัญหา idempotency ใน Python การปรับโครงสร้าง TypeScript ที่รักษาความเข้ากันได้ และการเพิ่มฟีเจอร์ JSONL ทั่วทั้งรีโพสิตอรี โดยไม่จำเป็นต้องลองใหม่ Muse Code agent ยังไม่ได้รับการทดสอบ และการทำงานของเครื่องมือยังไม่ได้รับการตรวจสอบความน่าเชื่อถือ หากคุณกำลังเปรียบเทียบกับกลุ่มผลิตภัณฑ์ที่กว้างขึ้นก่อน โปรดดูคู่มือของเราเกี่ยวกับ โมเดล AI ที่ดีที่สุดสำหรับการเขียนโค้ด ให้ภาพรวมของบริบทการแข่งขันที่กว้างขึ้น.
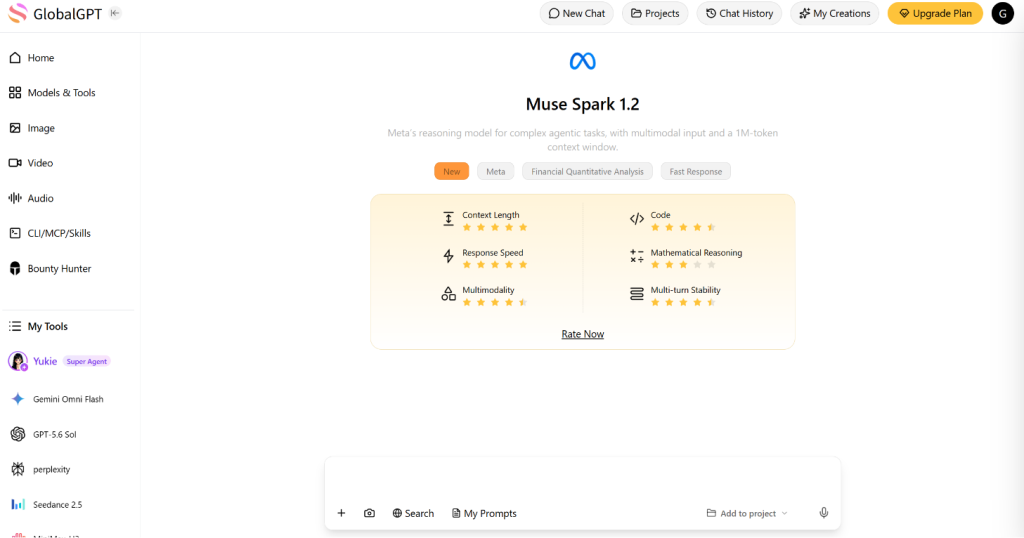
รีวิว Muse Spark 1.2: คำตอบสั้นๆ
ฉบับสั้น: Muse Spark 1.2 เป็นโมเดล Meta ที่เน้นด้านการเขียนโค้ด โดยมีหน้าต่างขนาด 1 ล้านโทเคน การเข้าถึง API ที่เข้ากันได้กับ SDK OpenAI และระดับ Contributor ที่ดึงดูดความสนใจ จุดเด่นที่สุดที่เปิดเผยต่อสาธารณะคือด้านมูลค่า: $0.10 สำหรับข้อมูลเข้า และ $0.20 สำหรับข้อมูลออก ต่อหนึ่งล้านโทเคน ในโมเดล Contributor ระดับนี้สามารถใช้เพื่อปรับปรุงผลิตภัณฑ์ของ Meta ได้ ในขณะที่โมเดลมาตรฐานที่มีราคาแพงกว่านั้นไม่ถูกใช้เพื่อวัตถุประสงค์ดังกล่าว.
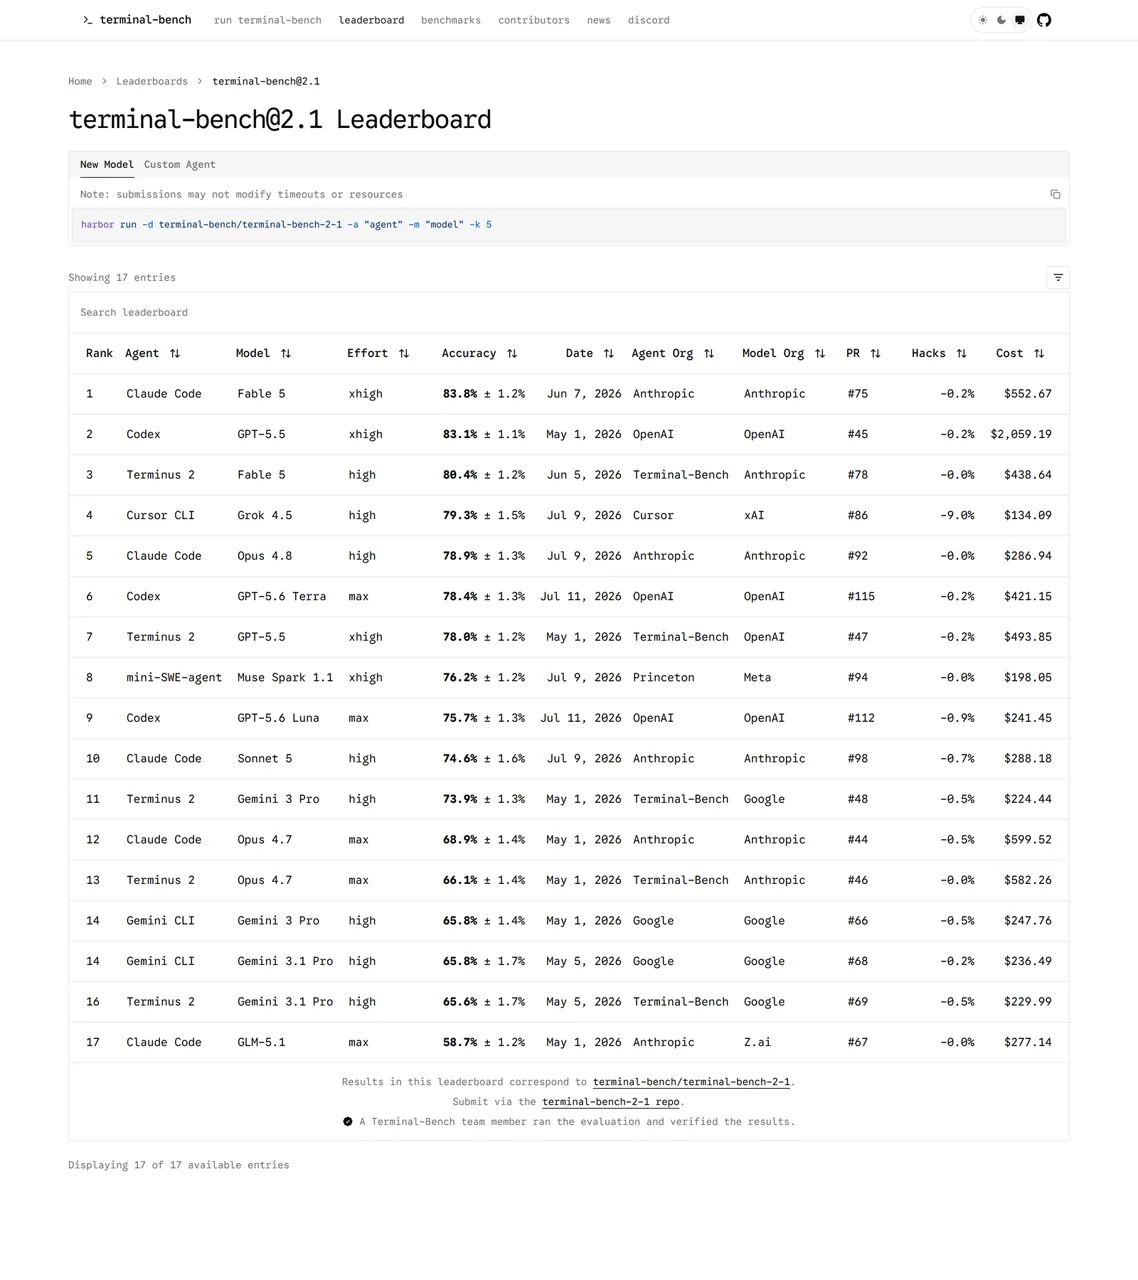
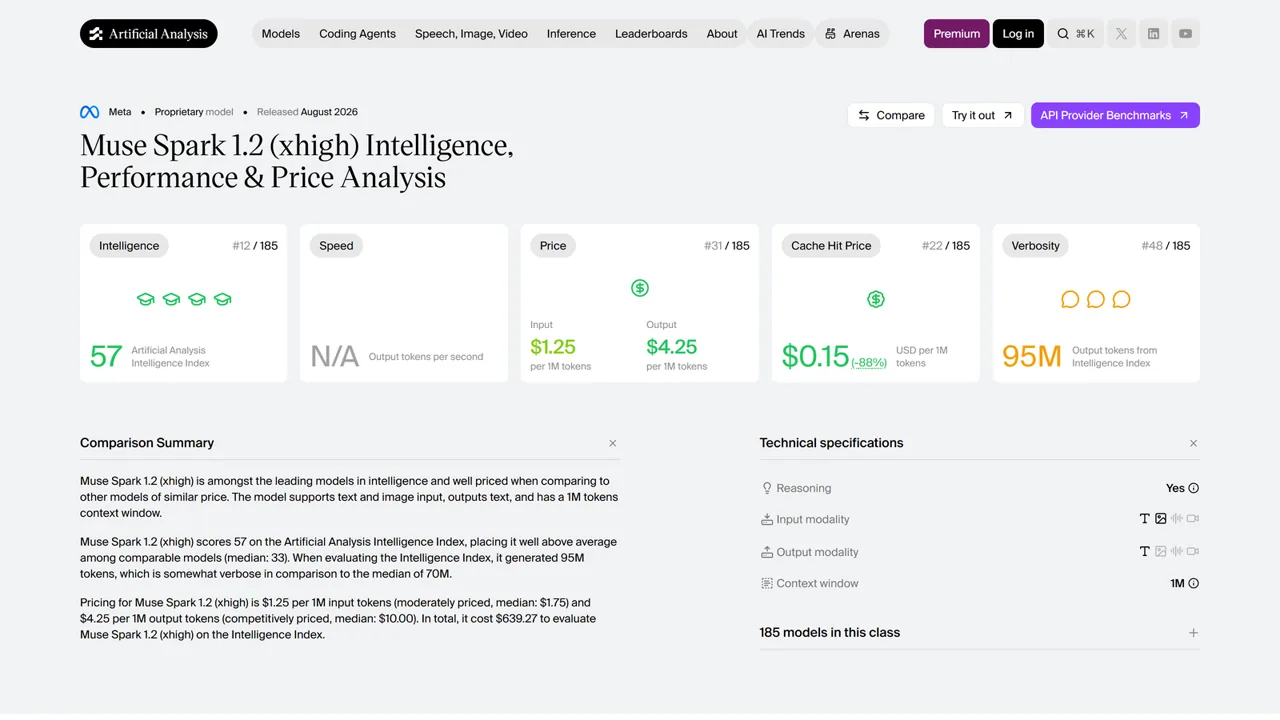
ข้อมูลเกี่ยวกับประสิทธิภาพยังจำเป็นต้องมีการควบคุมให้มากขึ้น Meta รายงานผล 82.9% บน Terminal-Bench 2.1 สำหรับ Muse Spark 1.2 ที่ใช้ Muse Code และ 59.3% บน DeepSWE นี่เป็นผลการทดสอบที่ Meta ดำเนินการเอง เมื่อตรวจสอบเมื่อวันที่ 26 สิงหาคม 2569 บอร์ด Terminal-Bench และ DeepSWE ที่เปิดให้สาธารณะใช้ ยังไม่มีการระบุ Muse Spark 1.2 อยู่ในรายการ. การวิเคราะห์เทียม เป็นข้อมูลอ้างอิงที่อิสระ: ดัชนีความฉลาด (Intelligence Index) ของมันยังคงอยู่ที่ 57 ซึ่งสูงกว่าค่ามัธยฐานของรุ่นที่เทียบเคียงได้ ซึ่งอยู่ที่ 35.
- เหตุผลที่ดีที่สุดที่จะลองใช้ทันที: ราคาสำหรับผู้ร่วมสร้างเนื้อหาที่ต่ำ, บริบทที่กว้างใหญ่ และ API ที่ใช้รูปแบบไคลเอนต์ OpenAI ที่คุ้นเคย.
- เหตุผลที่ดีที่สุดที่ควรระมัดระวัง: งานทดลองสามงานที่ใช้แบบจำลองพื้นฐานแบบควบคุมยังไม่สามารถยืนยันความน่าเชื่อถือของเอเจนต์ Muse Code คุณภาพการเรียกใช้เครื่องมือ หรือประสิทธิภาพในการทำงานภายในคลังข้อมูลการผลิตขนาดใหญ่.
- ตัวเลือกสำคัญเกี่ยวกับความเป็นส่วนตัว: ใช้แบบมาตรฐานสำหรับโค้ดหรือข้อความที่คุณไม่ต้องการให้ถูกใช้เพื่อปรับปรุงผลิตภัณฑ์ของ Meta.
Muse Spark 1.2: ภาพรวม
ข้อมูลจำเพาะที่ได้รับการยืนยัน
Meta อธิบายว่า Muse Spark 1.2 เป็นโมเดลที่มีความแม่นยำในการเขียนโค้ดตั้งแต่ครั้งแรกสูงขึ้น และมีความน่าเชื่อถือในการเรียกใช้เครื่องมือมากกว่า Muse Spark 1.1 นี่คือคำกล่าวอ้างจากผู้ให้บริการ หน้าแบบอย่าง Muse Spark อย่างเป็นทางการ, ไม่ใช่ข้อสรุปจากเซสชันการเขียนโค้ดของเราเอง.
Muse Spark 1.2 เทียบกับ Muse Code
Muse Spark 1.2 คือโมเดลนั้น ส่วน Muse Code เป็นเอเจนต์เทอร์มินัลเบต้าที่ทำงานแยกต่างหาก ซึ่งใช้โมเดลดังกล่าวเป็นพื้นฐาน. ความแตกต่างนี้มีความสำคัญ เพราะเอเจนต์สามารถเพิ่มฟังก์ชันการวางแผน การจัดการเครื่องมือ การนำทางในรีโพซิทอรี การแยกงานในเวิร์กทรี การบันทึกข้อมูล และพฤติกรรมการลองใหม่รอบโมเดลพื้นฐานได้.
ให้แต่ละชั้นแยกกัน
Muse Spark 1.2
บริบท, การวิเคราะห์เหตุผล, พฤติกรรมของ API, การคิดค่าบริการตามโทเคน, ผลลัพธ์ และการตัดสินใจในการเรียกใช้เครื่องมือ.
รหัสแบบ1M บริบทราคา API
Muse Code
UX ของเทอร์มินัล, ตัวแทนย่อย, git worktrees, บันทึกเหตุการณ์, กระบวนการต่อการทำงาน, ทักษะที่รวมไว้, และการประสานงาน.
กระบวนการทำงานของตัวแทนผลระบบ Meta-run
The หน้า Muse Code อย่างเป็นทางการ เรียกผลิตภัณฑ์นี้ว่า “เบต้า โคดดิ้ง เอเจนต์” ซึ่งทำให้การเปรียบเทียบกับผลิตภัณฑ์อื่น ๆ เช่น Claude Code และ Codex มีประโยชน์มากกว่าการสมมติว่าความแตกต่างในกระบวนการทำงานที่สังเกตได้ทั้งหมดเกิดจากการเรียกโมเดลแบบพื้นฐานเท่านั้น ของเรา การเปรียบเทียบรหัสระหว่าง Codex และ Claude อธิบายว่าทำไมสภาพแวดล้อมการทำงานจึงสามารถเปลี่ยนแปลงประสบการณ์ของผู้พัฒนาได้มากเท่ากับตัวโมเดล.
ผลการทดสอบประสิทธิภาพ Muse Spark 1.2: สิ่งที่คะแนนเหล่านั้นแสดงให้เห็นจริง ๆ
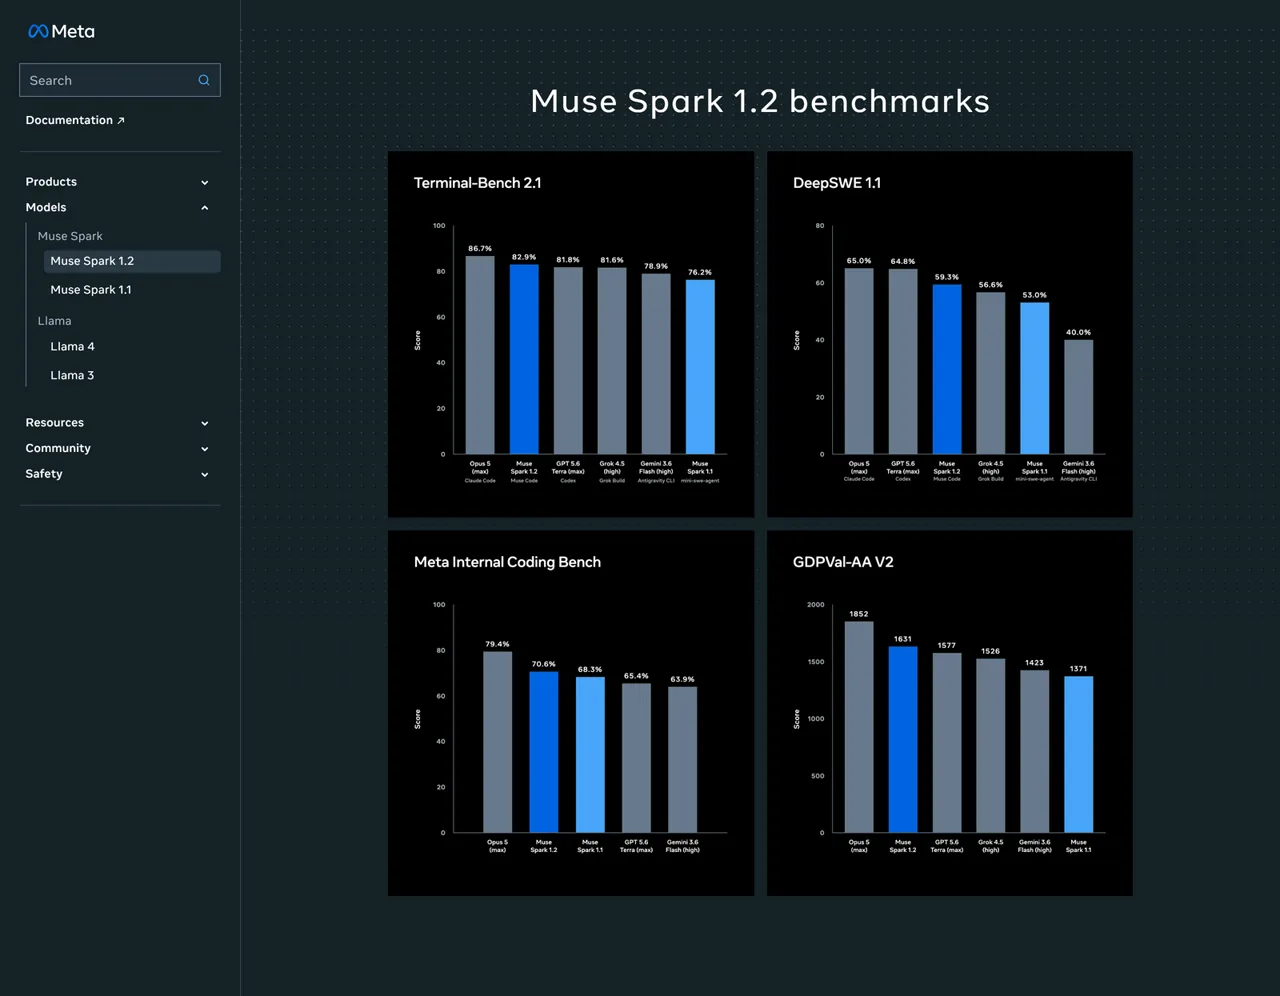
แผนภูมิเปรียบเทียบของ Meta แสดงให้เห็นว่า Muse Spark 1.2 อยู่ในอันดับต้นๆ ของการประเมินด้านการเขียนโค้ดหลายรายการ ตัวเลขเหล่านี้ควรค่าแก่การพิจารณา แต่ไม่ใช่การจัดอันดับที่ชัดเจนและสมบูรณ์เกี่ยวกับคุณภาพของโมเดลแบบดิบ โมเดล ตัวแทน ระบบการควบคุม ความสามารถในการให้เหตุผล และโปรโตคอลของงาน ล้วนสามารถเปลี่ยนแปลงไปพร้อมกันได้.
Terminal-Bench 2.1 ที่รายงานผ่าน Meta
คณะกรรมการประเมินมาตรฐาน Meta
เทอร์มินอล-เบนช์ 2.1
งานทั้ง 89 งาน · ผ่าน@1 ใน 5 ครั้ง · การเลือกชุดโมเดลและเอเจนต์
ตัวเลข 82.9% เป็น ผลลัพธ์ของ Meta-run Muse Code. . bảngจัดอันดับ Terminal-Bench 2.1 สำหรับสาธารณะ ไม่ได้ระบุ Muse Spark 1.2 ในวันที่ 26 สิงหาคม 2026 ดังนั้นจึง ไม่ใช่ข้อมูลที่ได้รับการยืนยันในตารางอันดับสาธารณะ. คณะกรรมการสาธารณะได้ระบุ Muse Spark 1.1 พร้อม mini-SWE-agent ไว้ที่ 76.2% ±1.2%.
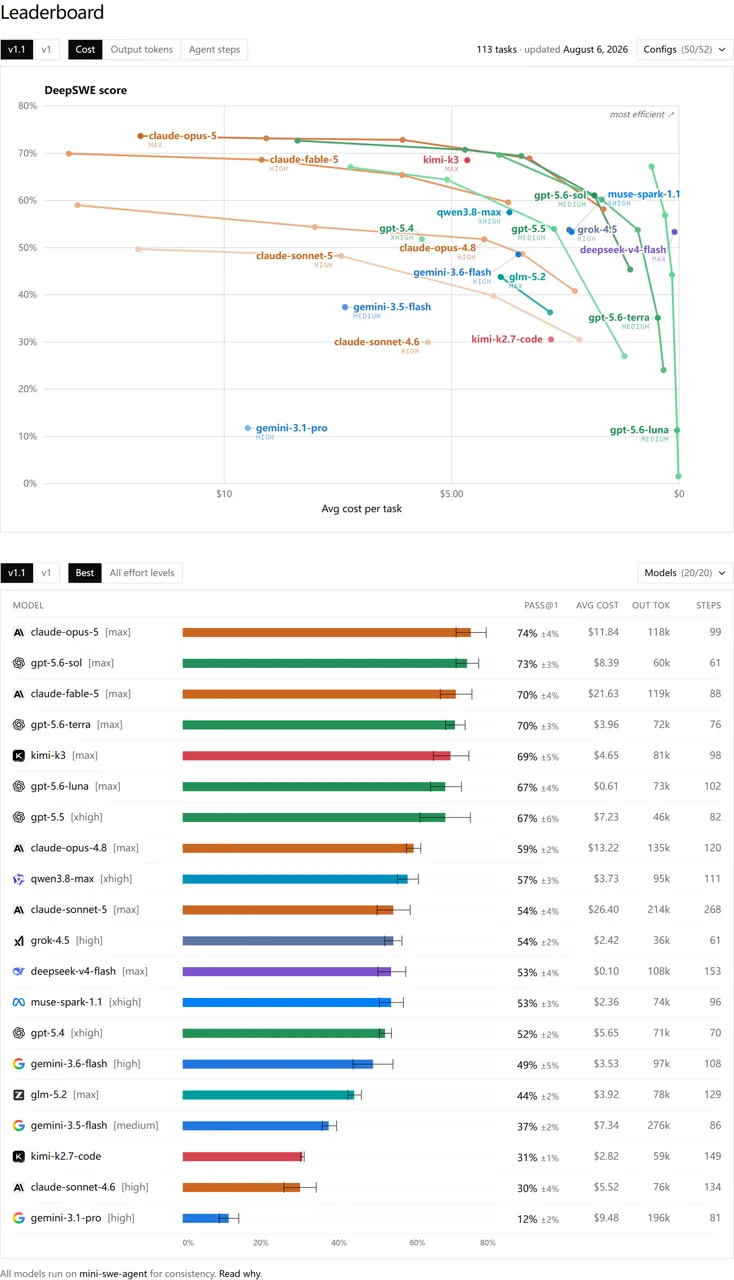
DeepSWE 1.1 ตามรายงานของ Meta
คณะกรรมการประเมินมาตรฐาน Meta
DeepSWE 1.1
113 งาน · 91 ที่เก็บ · 5 ภาษา · ผ่าน@1 ใน 5 ครั้งที่ลอง
The bảngจัดอันดับ DeepSWE v1.1 แบบสาธารณะ ใช้ mini-swe-agent ในทุกรุ่นที่ระบุไว้เพื่อความสม่ำเสมอ เมื่อตรวจสอบแล้ว ยังไม่ได้เพิ่ม Muse Spark 1.2; Muse Spark 1.1 ถูกระบุไว้ที่ 53% ส่วนผล 59.3% ของ Meta ใช้ Muse Code ดังนั้นทั้งสองตัวเลขจึงไม่เหมือนกันในแง่ของ harness.
การประเมินภายในและโดยตัวแทนทั่วไปของ Meta
สองระบบการประเมินที่แตกต่างกัน
Meta Internal Coding Bench
440 งานภายใน · 2 ครั้งต่องาน
| แบบจำลอง | คะแนน |
|---|---|
| Opus 5 | 79.4% |
| Muse Spark 1.2 | 70.6% |
| GPT-5.6 Terra | 65.4% |
| Gemini 3.6 Flash | 63.9% |
| Grok 4.5 | ไม่แสดง |
GDPVal-AA v2
การประเมินงานแบบตัวแทนทั่วไป · ค่าแบบ Elo
| แบบจำลอง | คะแนน |
|---|---|
| Opus 5 | 1852 |
| Muse Spark 1.2 | 1631 |
| GPT-5.6 Terra | 1577 |
| Grok 4.5 | 1526 |
| Gemini 3.6 Flash | 1423 |
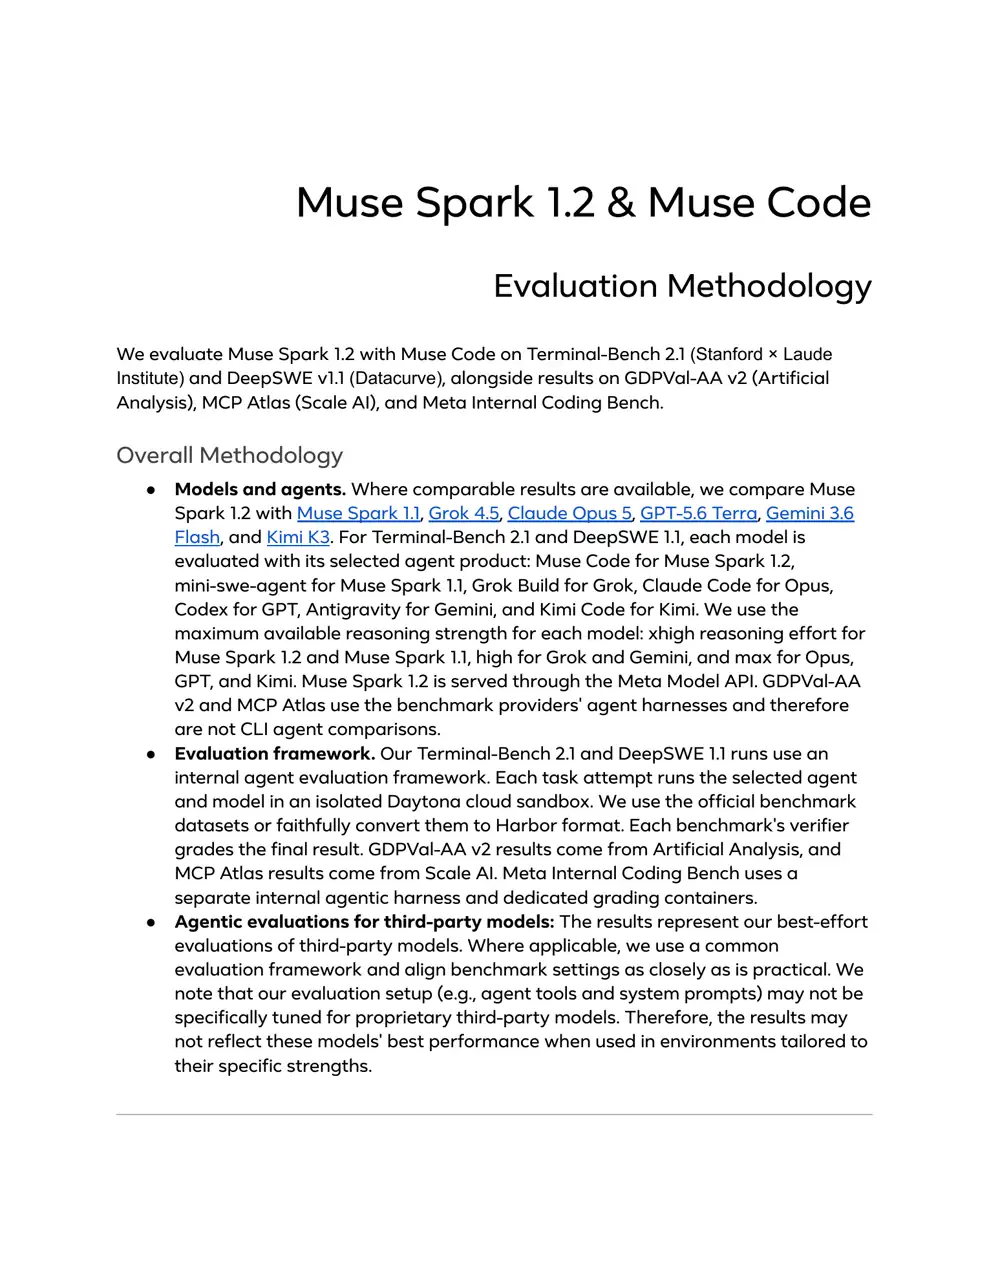
Meta’s วิธีการประเมิน ระบุว่า Terminal-Bench ใช้ทั้ง 89 งานและผ่านเกณฑ์ pass@1 ใน 5 ครั้ง DeepSWE ครอบคลุม 113 งานใน 91 รีโพสิตอรีและ 5 ภาษา ซึ่งก็ผ่านเกณฑ์ pass@1 ใน 5 ครั้งเช่นกัน Meta ยังชี้ให้เห็นว่า การตั้งค่าของพวกเขายังอาจไม่ได้รับการปรับแต่งให้เหมาะสมที่สุดสำหรับโมเดลของฝ่ายที่สาม สำหรับการเปรียบเทียบคู่แข่งล่าสุดที่สร้างขึ้นบนพื้นฐานของการตัดสินใจผลิตภัณฑ์จริง โปรดดู Claude Opus 5 เทียบกับ GPT-5.6.
วิธีการวิจัยทำให้ความหมายเปลี่ยนแปลงไป
โมเดล + ตัวแทนที่เลือก
89 ภารกิจ, 5 ครั้งลอง, การตั้งค่าการให้เหตุผลสูงสุดแตกต่างกัน และระบบ Meta อาจไม่ได้รับการปรับแต่งให้เหมาะสมกับระบบของฝ่ายที่สามอย่างเท่าเทียมกัน.
ข้อมูลที่ได้รับการยืนยัน
เมื่อตรวจสอบแล้ว พบว่า Muse Spark 1.2 ไม่ปรากฏอยู่ ดังนั้น ต้องอ่านการตั้งค่าและสถานะการตรวจสอบของบอร์ดจากตารางของ Meta แยกต่างหาก.
มินิ-สวี-เอเจนต์ทั่วไป
113 งานใน 91 รีโพสิตอรี และ 5 ภาษา Muse Spark 1.2 ไม่ปรากฏในรายชื่อ ส่วน Muse Spark 1.1 ถูกระบุไว้ที่ 53%.
การวิเคราะห์แบบจำลอง:บริบทอิสระที่มีประโยชน์
The หน้าแบบจำลองการวิเคราะห์เทียม ทำให้ Muse Spark 1.2 มีดัชนีความฉลาดอยู่ที่ 57, สูงกว่าค่ามัธยฐานของรุ่นที่เทียบเคียงได้ซึ่งอยู่ที่ 35 เมื่อตรวจสอบเมื่อวันที่ 26 สิงหาคม 2026. ผลการทดสอบของระบบนี้แสดงค่า 80% บน Terminal-Bench v2.1, 57% (ค่าที่ปรับมาตรฐานแล้ว) บน GDPVal-AA v2, 56% บน SciCode และ 83% ในการประเมินบริบทยาว AA-LCR.
ความเปลี่ยนแปลงของเวอร์ชันในระบบวิเคราะห์เทียม
บทเรียนจากประสบการณ์จริงนั้นเรียบง่าย: Muse Spark 1.2 ดูมีศักยภาพในการแข่งขัน แต่ไม่มีคะแนนใดที่สามารถใช้ประเมินโมเดลนี้ได้อย่างแยกเดี่ยว ควรใช้แผนภูมิของ Meta เป็นหลักฐานสำหรับระบบ Muse Code ใช้ตารางอันดับสาธารณะเป็นข้อมูลตรวจสอบเพิ่มเติม และใช้ Artificial Analysis เป็นวิธีการประเมินที่อิสระแต่มีการตั้งค่าที่แตกต่างออกไป.
Muse Spark 1.2: การเปรียบเทียบระหว่างราคาและความเป็นส่วนตัว
Meta ให้บริการสองรหัสแบบ API ที่มีราคาต่างกันอย่างมาก ตัวเลือกที่มีราคาถูกกว่าไม่ใช่เพียงการลดราคาเท่านั้น แต่ยังส่งผลต่อวิธีการใช้ข้อมูลที่ส่งเข้ามาด้วย.
USD ต่อหนึ่งล้านโทเคน · บริบท 1M
ไม่ใช้เพื่อปรับปรุงผลิตภัณฑ์
ไม่ใช้เพื่อปรับปรุงผลิตภัณฑ์ของ Meta
ราคาถูกกว่า แต่ต้องแลกกับการใช้ข้อมูล
ข้อมูล อาจถูกใช้เพื่อปรับปรุงผลิตภัณฑ์ของ Meta
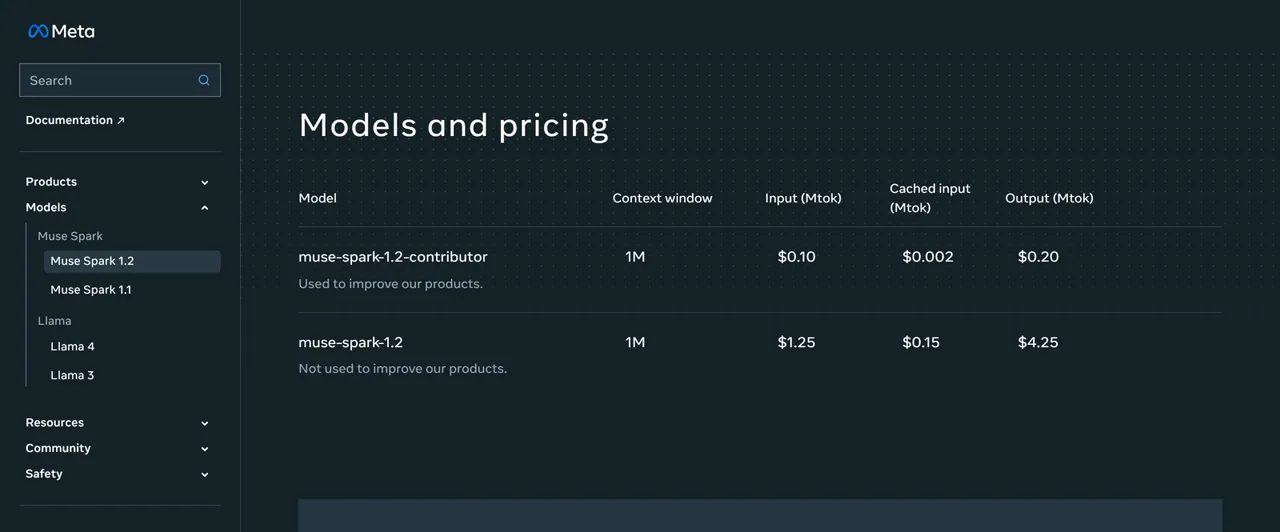
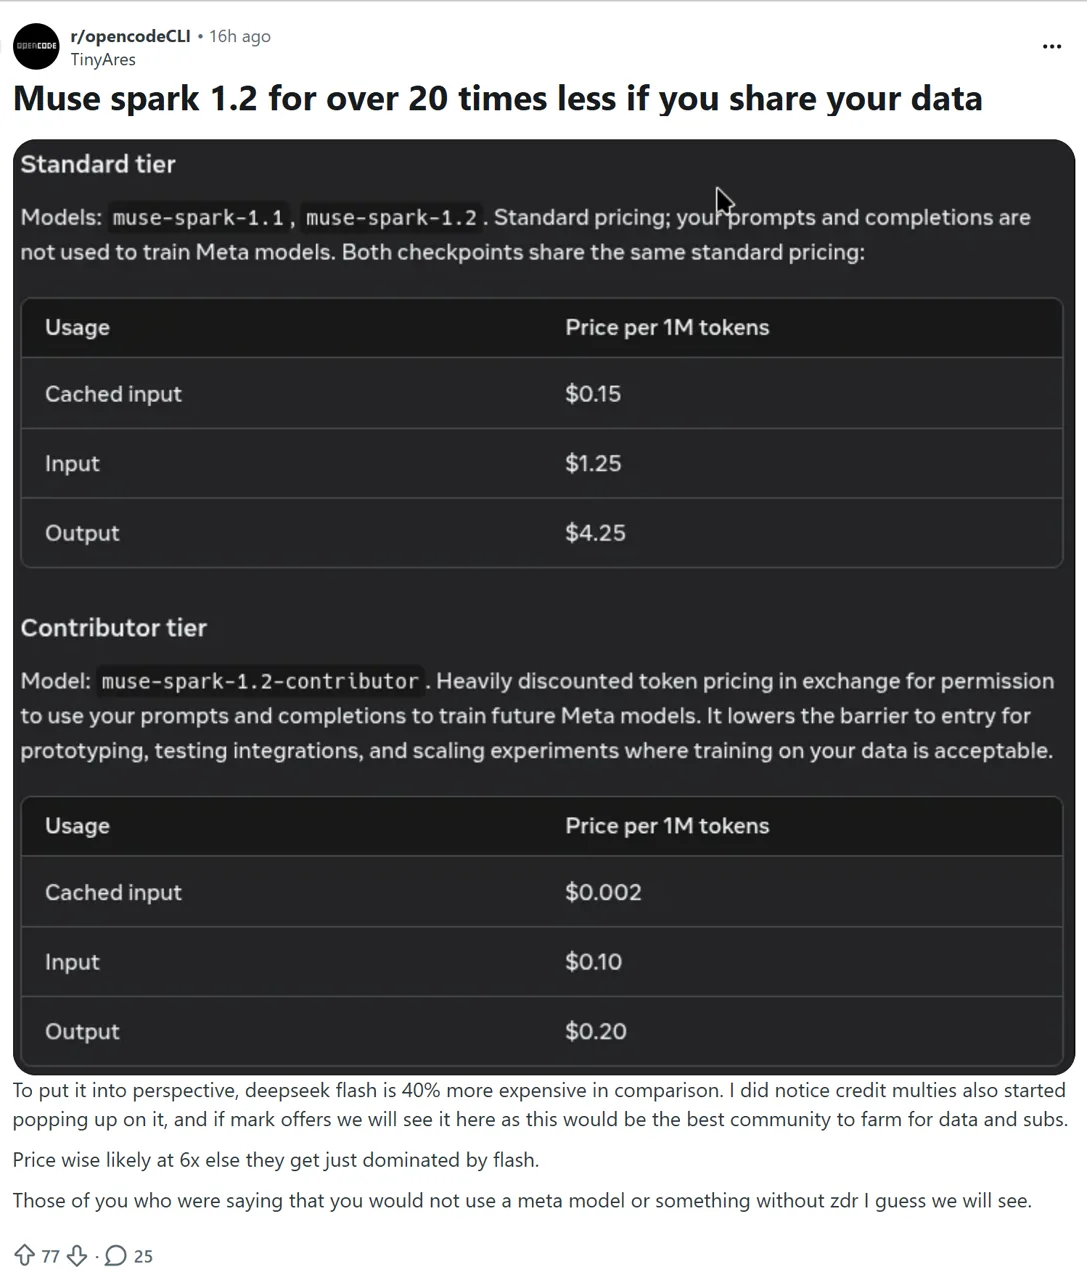
ราคาสำหรับผู้ร่วมสร้าง (Contributor) ถูกกว่า 12.5 เท่า สำหรับข้อมูลเข้า, ถูกกว่า 75 เท่า สำหรับข้อมูลเข้าที่เก็บไว้ในแคช และถูกกว่า 21.25 เท่า สำหรับข้อมูลออก เมื่อเทียบกับระดับมาตรฐาน ไม่มีอัตราส่วนลดเดียวที่ชัดเจนซึ่งสามารถอธิบายได้ทุกประเภทโทเคน.
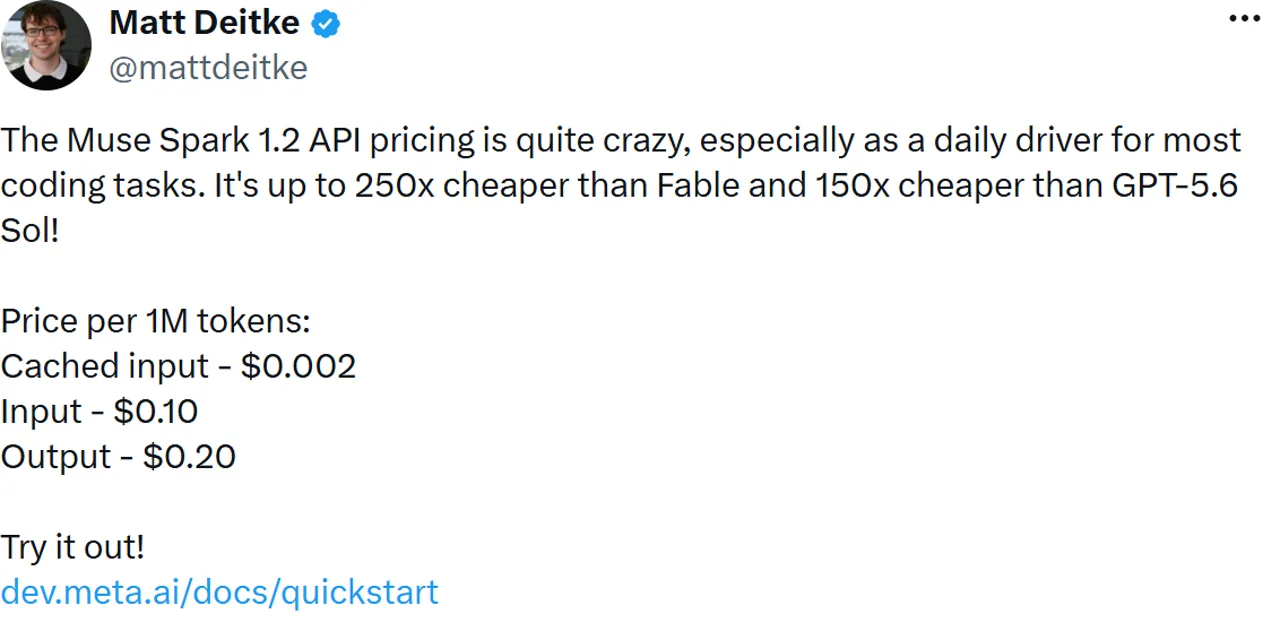
นักวิจัยของ Meta ได้ประชาสัมพันธ์ระดับ Contributor ว่า “ถูกกว่า Fable ถึง 250 เท่า” และ “ถูกกว่า GPT-5.6 Sol ถึง 150 เท่า” ซึ่ง การเปรียบเทียบทางสังคม ใช้ราคาสำหรับผู้ร่วมสร้างเนื้อหา (Contributor) ไม่ใช่แบบมาตรฐาน และควรระบุเงื่อนไขการใช้ข้อมูล (data-use qualification) ไว้เสมอ ผู้อ่านที่ต้องการเปรียบเทียบค่าใช้จ่ายของคู่แข่งในปัจจุบันสามารถใช้ข้อมูลแยกต่างหากของเรา คู่มือราคา GPT-5.6 และ รายละเอียดการกำหนดราคาตามรหัส Claude.
สำหรับ repositories สาธารณะ งานสังเคราะห์ หรืออุปกรณ์ประเมินผลแบบใช้แล้วทิ้ง ระดับ Contributor อาจเป็นตัวเลือกที่น่าสนใจ ส่วนสำหรับโค้ดส่วนตัว ข้อมูลลูกค้า ข้อมูลรับรอง หรือสถาปัตยกรรมที่เป็นกรรมสิทธิ์ ระดับ Standard เป็นตัวเลือกเริ่มต้นที่ปลอดภัยกว่า Meta ยังระบุว่ากำลังเริ่มรับคำขอไม่เก็บข้อมูล (zero-data-retention) ผ่านฝ่ายขาย ซึ่งถือเป็นช่องทางเข้าถึงที่แยกต่างหาก ไม่ใช่การตั้งค่าบริการตนเองตามค่าเริ่มต้น.
การเข้าถึง API ของ Muse Spark 1.2 และตัวอย่างการใช้งาน
สามเส้นทางเข้าอย่างเป็นทางการ
URL หลักของหนังสือสูตรอาหารอย่างเป็นทางการ: https://api.meta.ai/v1 · 1.2 ข้อเสนอในรายงานนี้: ยังไม่ได้รับการดำเนินการ
The API ของ Meta Model สนับสนุนกระบวนการทำงานที่เข้ากันได้กับ SDK ของ OpenAI คู่มืออย่างเป็นทางการของ Meta ใช้ URL หลัก https://api.meta.ai/v1 และอ่านคีย์จาก MODEL_API_KEY. หน้าผลิตภัณฑ์ยังอธิบายถึงการกำหนดพื้นฐานการค้นหา ส่วนหนังสือคู่มือการใช้งานนั้นครอบคลุมเรื่องการเติมข้อความอัตโนมัติในแชท การสตรีม การเรียกใช้เครื่องมือ ผลลัพธ์ที่มีโครงสร้าง การเก็บแคชคำสั่ง การควบคุมการให้เหตุผล การประมวลผลภาพบริบทที่ยาว การลองใหม่ และสูตรการค้นหา.
ตัวอย่างหนังสือสูตรอาหารอย่างเป็นทางการ — เวอร์ชันที่บันทึกไว้: The หนังสือสูตรอาหารอย่างเป็นทางการของ GitHub ยังคงใช้ muse-spark-1.1. สิ่งนี้แสดงให้เห็นโครงสร้างของไคลเอนต์และ URL ฐาน ไม่ใช่ว่าตัวอย่างนี้ได้ถูกอัปเดตให้สอดคล้องกับเวอร์ชัน 1.2.
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.1",
    messages=[{"role": "user", "content": "Hello, world!"}],
)

print(response.choices[0].message.content)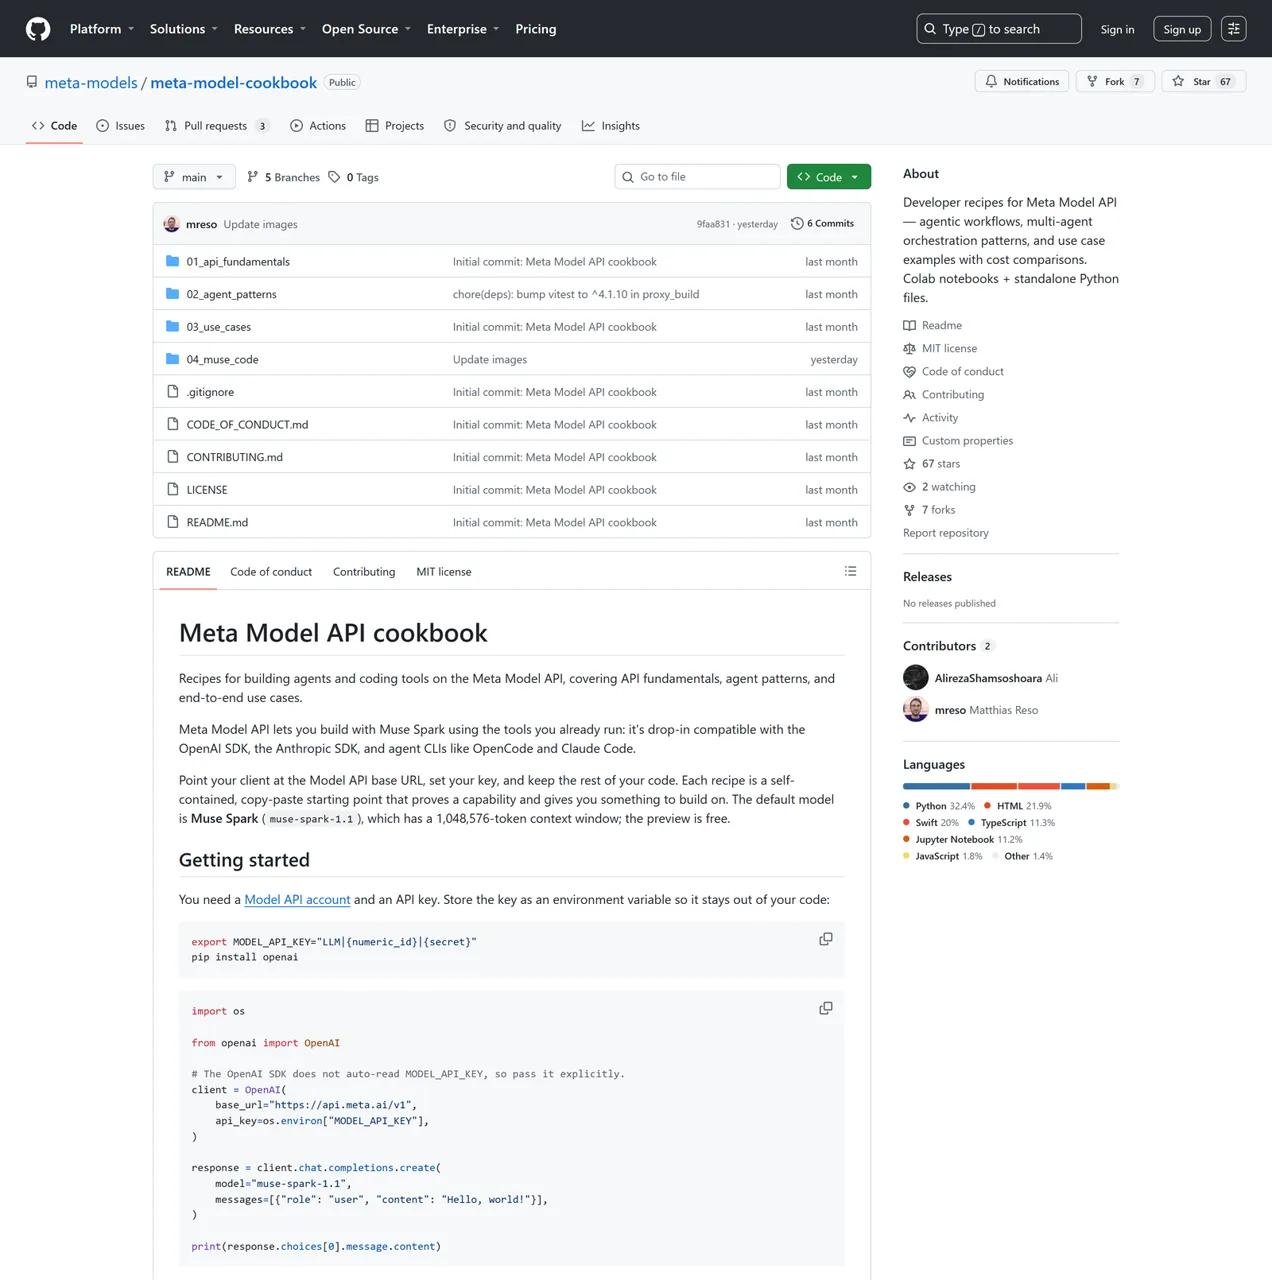
การปรับเปลี่ยนที่บันทึกไว้ — แต่ยังไม่ดำเนินการ: Meta แสดงรายการแยกต่างหาก muse-spark-1.2 เป็นรุ่น ID 1.2 มาตรฐาน การแทนที่แบบเรียบง่ายด้านล่างนี้รวมข้อมูลอย่างเป็นทางการสองข้อ แต่ไม่มีการส่งคำขอแบบชำระเงินใด ๆ ระหว่างการตรวจสอบครั้งนี้.
response = client.chat.completions.create(
    model="muse-spark-1.2",
    messages=[{"role": "user", "content": "Hello, world!"}],
)
Muse Spark เป็นแบบจำลองการให้เหตุผล และ โทเคนเหตุผลจะถูกคิดค่าตามผลลัพธ์. ซึ่งทำให้อัตราการส่งออกมาตรฐาน $4.25 มีความสำคัญมากกว่าที่เห็นในเบื้องต้น: คำตอบที่ดูเหมือนสั้นๆ ก็อาจแฝงการใช้เหตุผลที่สำคัญไว้ได้ ความล่าช้าจริง เวลาจนถึงโทเคนแรก อัตราการลองใหม่ และค่าใช้จ่ายต่องาน ยังไม่ได้ถูกวัดในที่นี้.
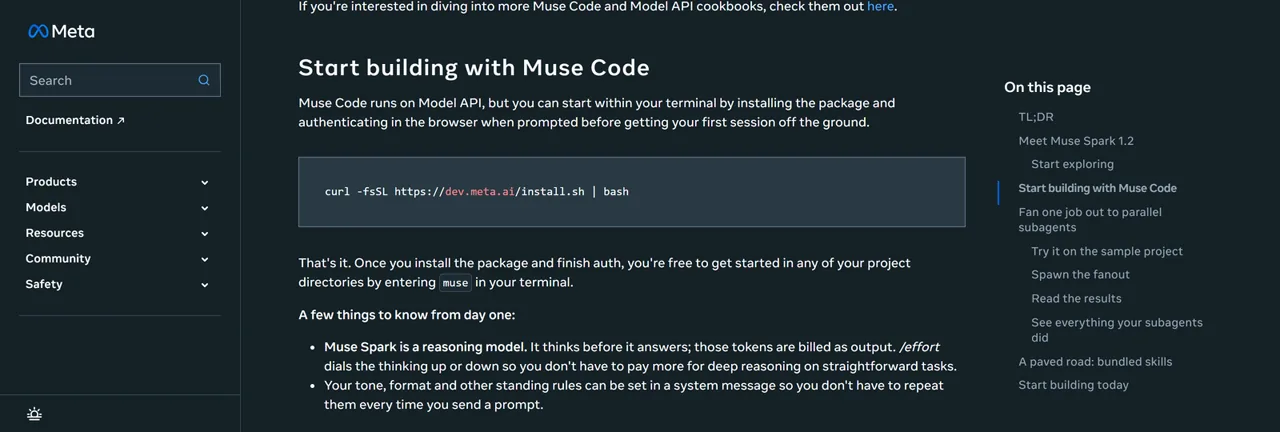
/ความพยายาม คำสั่งนี้ปรับระดับความลึกของการวิเคราะห์. แหล่งที่มา: คู่มือผู้พัฒนา Meta.คุณสมบัติเพิ่มเติมของ Muse Code
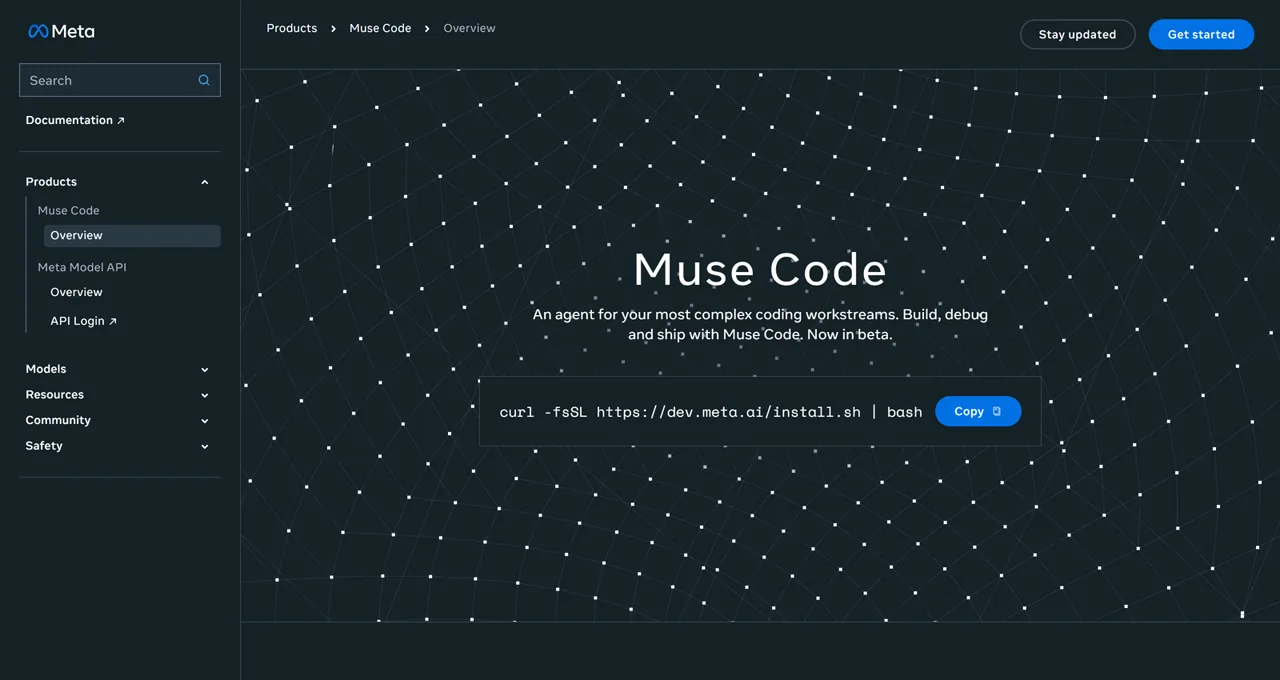
Muse Code ติดตั้งผ่านเทอร์มินัล และนำ Muse Spark 1.2 มาใช้ในกระบวนการทำงานของเอเจนต์ Meta’s วิเคราะห์เชิงลึกสำหรับนักพัฒนา อธิบายพฤติกรรมหลายอย่างที่ไม่ได้เป็นส่วนหนึ่งของการเรียก API แบบพื้นฐาน:
- ตัวแทนแบบขนาน: งานสามารถทำงานใน git worktrees ที่แยกกัน.
- บันทึกเหตุการณ์แบบเพิ่มข้อมูลเท่านั้น: เซสชันและกิจกรรมจะถูกบันทึกไว้ในไฟล์ JSONL ในเครื่อง เพื่อวัตถุประสงค์ในการตรวจสอบและเล่นซ้ำ.
- ขั้นตอนการดำเนินการต่อ:
ตัวอย่างประวัติการทำงานของ Museสามารถต่อเซสชันที่ถูกขัดจังหวะได้. - การควบคุมการให้เหตุผล: การ
/ความพยายามคำสั่งนี้ปรับระดับความเข้มของการให้เหตุผล. - ทักษะที่ชัดเจน: ชื่อเมตา
/รสชาติ,/การย่าง,/เตาย่างพร้อมเอกสาร, และ/แผน.
คุณสมบัติของผลิตภัณฑ์เอเจนต์
ตัวแทนย่อย
งานแต่ละงานสามารถกระจายออกไปได้.
โครงสร้างงาน
สาขาจะยังคงแยกกันอยู่ระหว่างการทำงานแบบขนาน.
บันทึก JSONL
เหตุการณ์ท้องถิ่นแบบเพิ่มข้อมูลเท่านั้น รองรับการเล่นซ้ำ.
ประวัติการทำงาน
ตัวอย่างประวัติการทำงานของ Muse ต่อเซสชันที่ถูกขัดจังหวะ.
ทักษะ
/รสชาติ, /การย่าง, /เตาย่างพร้อมเอกสาร, /แผน.
ชุดคุณสมบัติดังกล่าวทำให้ Muse Code มีความสำคัญต่อตลาดเอเจนต์การเขียนโค้ดที่กว้างขึ้น ซึ่งการวางแผน การแยกส่วน การเล่นซ้ำ และวินัยในการใช้เครื่องมือ เป็นปัจจัยสำคัญควบคู่กับความฉลาดของโมเดล The คู่มือเปรียบเทียบ OpenClaw vs Claude Code vs OpenCode เป็นข้อมูลบริบทที่มีประโยชน์สำหรับความแตกต่างในระดับผลิตภัณฑ์เหล่านั้น.
การเปิดตัวการเรียกร้องและสัญญาณเบื้องต้นจากชุมชน
การตอบสนองไม่ใช่การยอมรับ
การฝึกอบรม + ระยะเวลายาว
กำลังการประมวลผลที่มากขึ้น ความหลากหลายของสภาพแวดล้อม การฝึกอบรมร่วม และการทดสอบความทนทานด้วยการเรียกใช้เครื่องมือมากกว่า 1,000 รายการ.
ราคาและ OpenCode
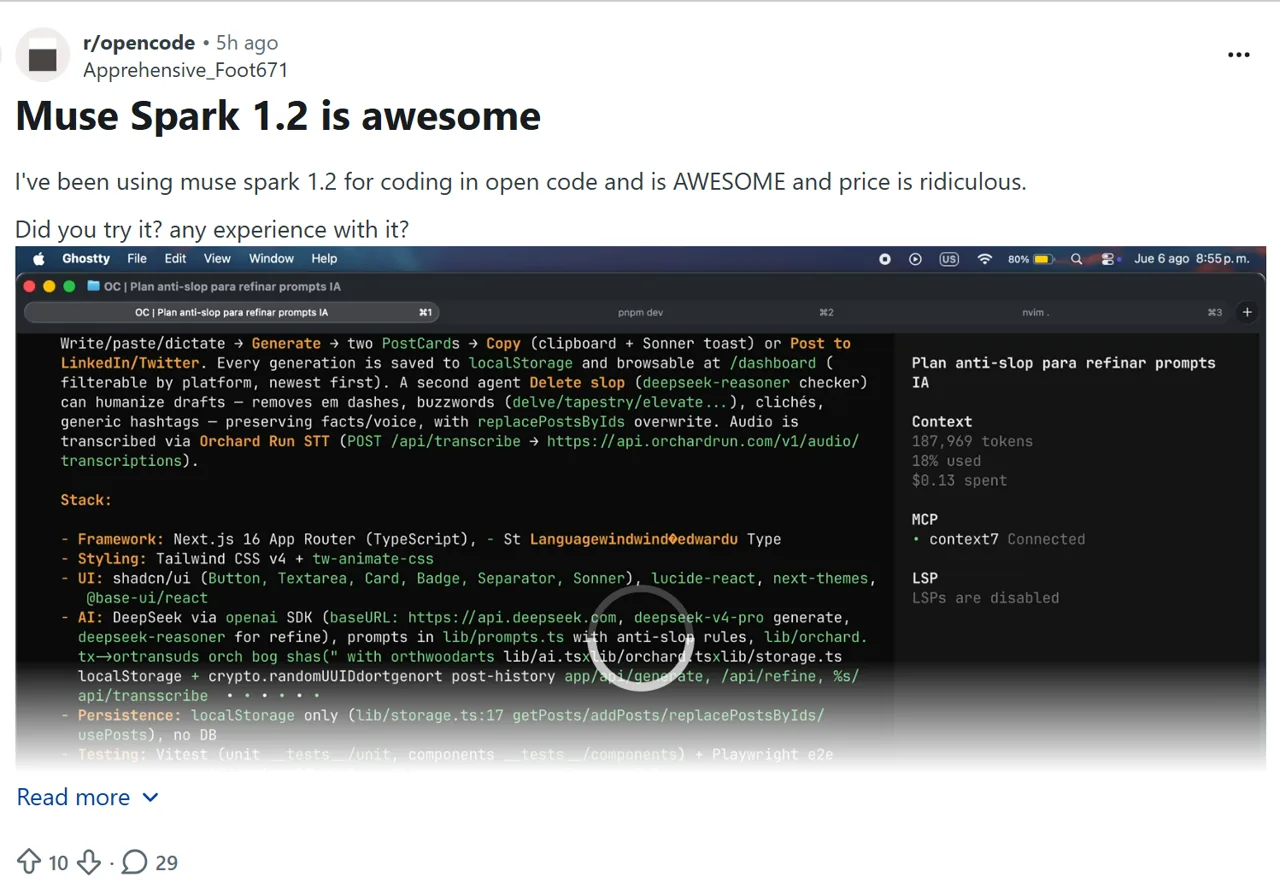
ผู้ใช้ Reddit คนหนึ่งได้ชื่นชมประสบการณ์การเขียนโค้ดในช่วงแรกๆ และประโยชน์ที่ได้รับจากมัน.
ความเป็นส่วนตัว + ความน่าเชื่อถือ
ผู้ใช้รายอื่นได้แสดงความกังวลเกี่ยวกับปริมาณการใช้ข้อมูล ราคาปกติ ความพร้อมใช้งาน และความน่าเชื่อถือในช่วงแรก.
ทีม AI ของ Meta ระบุว่า Muse Spark 1.2 ได้รับการเพิ่มกำลังการคำนวณสำหรับการฝึกอบรมการเขียนโค้ด สภาพแวดล้อมที่หลากหลายยิ่งขึ้น การเน้นหนักมากขึ้นในการสร้างและแก้ไขข้อผิดพลาดของรีโพสิตอรีทั้งชุด รวมถึงการฝึกอบรมร่วม (co-training) กับ Muse Code นอกจากนี้ยังมี เปิดหัวข้อ อธิบายถึงการทดสอบความทนทาน (stress test) ที่ดำเนินไปนานถึง 24 ชั่วโมง พร้อมกับการเรียกใช้เครื่องมือมากกว่า 1,000 ครั้งบน GPU NVIDIA Hopper.
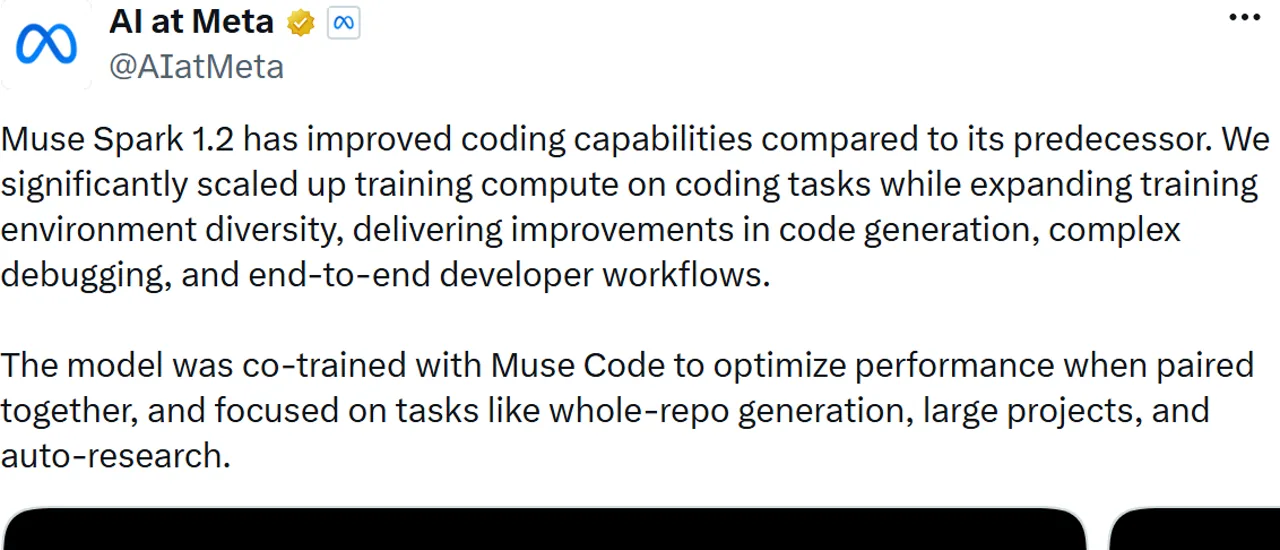
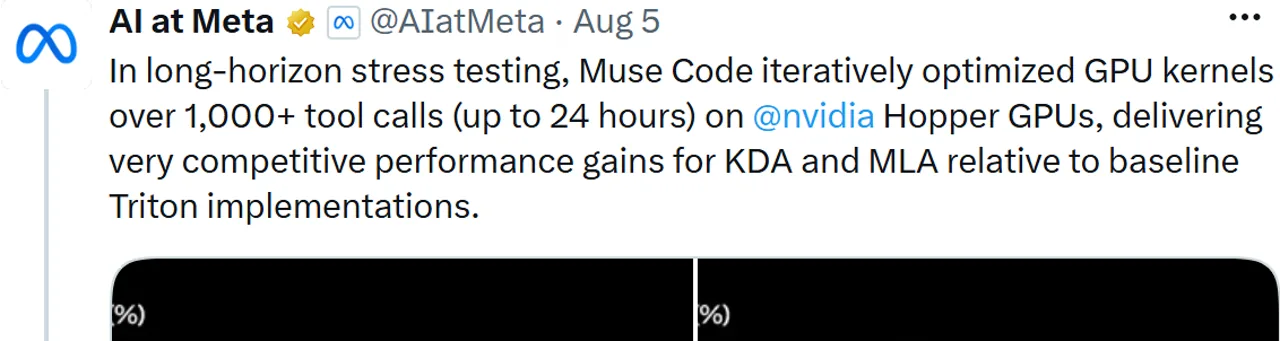
นี่เป็นการสาธิตที่น่าประทับใจ แต่ไม่ใช่ค่าอัตราความสำเร็จโดยรวมที่วัดได้ มันไม่ได้บอกเราว่าเอเจนต์เลือกเครื่องมือที่ถูกต้องบ่อยแค่ไหน สามารถกู้คืนจากข้อผิดพลาดได้หรือไม่ หลีกเลี่ยงการเรียกซ้ำได้หรือไม่ หรือสามารถเสร็จสิ้นงานในรีโพสิตอรีปกติได้โดยไม่ต้องมีการชี้นำ.
โพสต์บน Reddit ในช่วงแรกก็มีทั้งความคิดเห็นเชิงบวกและเชิงลบเช่นกัน หนึ่ง ผู้ใช้ r/opencode รายงานว่าได้รับประสบการณ์ที่ดีจาก OpenCode และชื่นชมราคา ส่วนอีกส่วนหนึ่ง การหารือเรื่องราคาสำหรับผู้ร่วมสร้างเนื้อหา ได้ก่อให้เกิดข้อสงสัยเกี่ยวกับการใช้ข้อมูลที่เพิ่มขึ้น ค่าใช้จ่ายของแพ็กเกจมาตรฐาน ความพร้อมใช้งาน และความน่าเชื่อถือ นี่เป็นความคิดเห็นส่วนตัว ไม่ใช่ความเห็นพ้องของชุมชน.
การทดสอบการเขียนโค้ด Muse Spark 1.2: ผ่าน 3/3 ภารกิจ
ในการทดสอบของเรา รุ่น Muse Spark 1.2 รุ่นพื้นฐานได้ดำเนินการเสร็จสิ้นสามงานการเขียนโค้ดที่ได้รับการควบคุม ผ่าน API การเติมข้อความในแชทที่รองรับ OpenAI. แต่ละงานได้รับโอกาสทำเพียงครั้งเดียว โดยไม่มีการลองใหม่และไม่มีการควบคุมจากมนุษย์ เราได้ประเมินไฟล์ที่ส่งกลับมาใน repositories แบบใช้แล้วทิ้ง โดยเปรียบเทียบกับชุดตรวจสอบสาธารณะและชุดตรวจสอบที่ซ่อนไว้ การทำงานของเอเจนต์ Muse Code ยังไม่ได้รับการทดสอบ และความน่าเชื่อถือในการเรียกใช้เครื่องมือยังไม่ได้รับการทดสอบ ดังนั้นผลลัพธ์เหล่านี้ไม่ควรถูกตีความว่าเป็นเกณฑ์มาตรฐานของเอเจนต์.
ผลจากการลองครั้งเดียว
คำตอบดังกล่าวใช้โทเค็นการให้เหตุผลจำนวน 6,618 โทเค็น เหตุผลทั้งสามข้อที่ระบุไว้คือ หยุด, และในช่องผู้ให้บริการได้รายงานว่า Meta.
การทดสอบ 1: การแก้ไขข้อผิดพลาดด้านคุณสมบัติ idempotency ของ Python — ผ่าน
หยุดการโอนเงินซ้ำโดยไม่จำเป็นต้องเปลี่ยนแปลง API สาธารณะ
โมเดลดังกล่าวได้ระบุตัวป้องกัน request-ID ที่ขาดหายไป เพิ่มการแก้ไขที่ปลอดภัยและเรียบง่ายที่สุด พร้อมทั้งจัดเตรียมการทดสอบการถดถอย โดยยังคงรักษาการอัปเดตสมดุลอะตอมิกไว้.
ตัวประเมินที่ซ่อนอยู่เดิมได้กำหนดอย่างผิดพลาดว่าต้องมีการเรียกซ้ำเพื่อคืนค่า ผิด, ถึงแม้ว่าการทำงานนั้นจะต้องการเพียงไม่ให้เรียกเก็บเงินจากผู้ส่งสองครั้งเท่านั้น หลังจากแก้ไขข้อกำหนดเกี่ยวกับค่าคืนที่สร้างขึ้นนั้นแล้ว คำตอบแรกที่ยังไม่มีการเปลี่ยนแปลงก็ผ่านการทดสอบทั้งหกข้อได้ทั้งหมด เราไม่ได้ลองใหม่หรือแก้ไขผลลัพธ์ของโมเดล.
การทดสอบ 2: การปรับโครงสร้างโค้ดแบบหลายไฟล์ใน TypeScript — ผ่าน
การตรวจสอบความถูกต้อง การเก็บข้อมูล และการบันทึกการตรวจสอบอย่างแยกกัน
ไฟล์ที่ส่งกลับมาได้รักษาสัญญาเส้นทางสาธารณะ (public route contract) การใช้ TypeScript อย่างเคร่งครัด และธุรกรรมเดียวที่ครอบคลุมทั้งการเขียนข้อมูลคำสั่งซื้อและการตรวจสอบ นอกจากนี้ ยังเพิ่มการทดสอบการตรวจสอบความถูกต้องที่มุ่งเน้นเฉพาะด้าน โดยไม่มีความพึ่งพาในระหว่างการทำงาน.
ผู้ประเมินคนแรกได้เปรียบเทียบวัตถุกับข้อมูลดิบ JSON.stringify, ดังนั้นวัตถุที่เทียบเท่ากันแต่มีลำดับการแทรกคีย์ต่างกันจึงดูเหมือนไม่เท่ากัน; ใน Windows npx การเรียกใช้โปรแกรมก็ล้มเหลวก่อนขั้นตอนการตรวจสอบประเภทข้อมูล ด้วยตัวเปรียบเทียบที่ไม่คำนึงถึงลำดับและการเรียกใช้คำสั่งที่ปลอดภัยสำหรับ Windows ผลตอบกลับเดิมผ่านการตรวจสอบทุกขั้นตอน แต่ครั้งนี้ก็ไม่มีกระบวนการลองใหม่ของโมเดล.
การทดสอบ 3: คุณสมบัติ repositories ของ JSONL — ผ่าน
การปฏิบัติตามคำแนะนำสำหรับทั้งระบบจัดเก็บ
เพิ่ม JSONL โดยไม่ทำให้ CSV เสียหาย
โมเดลนี้ได้นำคุณสมบัติต่าง ๆ มาใช้ ได้แก่ การตรวจจับส่วนขยาย, ข้อผิดพลาดของบรรทัดที่ผิดรูปแบบแบบนับจาก 1, ผลลัพธ์แบบอะตอมิก, ความปลอดภัยในการรันแบบ dry-run, การทดสอบแบบมุ่งเน้น, ข้อความช่วยเหลือ และตัวอย่างไฟล์ README.
ผลการทดสอบแสดงให้เห็นว่า: Muse Spark 1.2 สามารถสร้างแพตช์หลายไฟล์ที่ใช้งานได้จริง ปฏิบัติตามข้อจำกัดด้านความเข้ากันได้ เพิ่มการทดสอบ และจัดการคุณสมบัติระดับรีโพสิตอรีในขอบเขตที่พอเหมาะได้ภายในครั้งเดียว ค่าใช้จ่ายเฉลี่ยที่รายงานมาอยู่ที่ประมาณ $0.0151 ต่องาน แต่ชุดทดสอบเหล่านี้มีขนาดเล็ก จึงไม่ควรนำมาใช้เพื่อคาดการณ์ค่าใช้จ่ายสำหรับฐานโค้ดขนาดใหญ่.
ใครควรใช้ Muse Spark 1.2?
คู่มือการตัดสินใจ
การประเมินแบบควบคุม
รหัสสาธารณะหรือรหัสสังเคราะห์, งานที่วัดได้, ความต้องการในบริบทที่กว้างใหญ่, และผลลัพธ์ของโมเดลพื้นฐาน 3/3 ที่ดูมีแนวโน้มดี.
ต้องแสดงหลักฐานการเป็นตัวแทน
พฤติกรรมของ Muse Code, การจำกัดอัตราที่เสถียร, การเรียกใช้เครื่องมือซ้ำๆ หรือการทดสอบประสิทธิภาพของรีโพสิตอรีในวงกว้าง เป็นปัจจัยสำคัญในการตัดสินใจ.
รหัสที่ละเอียดอ่อน หรือปริมาณผลผลิตสูง
ใช้ระดับมาตรฐาน หรือเปรียบเทียบตัวเลือกอื่น ๆ เมื่อเรื่องความเป็นส่วนตัวและค่าใช้จ่ายของโทเค็นการให้เหตุผลเป็นปัจจัยหลัก.
ใช้แบบมาตรฐานสำหรับรหัสที่ละเอียดอ่อน เว้นแต่องค์กรของคุณจะอนุมัติเงื่อนไขของผู้ร่วมสร้างไว้เป็นกรณีพิเศษ หากราคาขายมาตรฐานเปลี่ยนแปลงการคำนวณค่า ให้เปรียบเทียบกับราคาปัจจุบัน ราคาตาม Codex, รหัส Claude และค่าใช้จ่ายอื่นๆ ที่เกี่ยวข้องกับตัวแทนการเข้ารหัส ก่อนที่จะตัดสินใจใช้กระบวนการทำงาน.
บทสรุปการรีวิว Muse Spark 1.2
Muse Spark 1.2 ได้รับการคัดเลือกเข้าสู่รายชื่อสั้นสำหรับการประเมิน แต่ไม่ใช่คำแนะนำให้ผลิตโดยอัตโนมัติ. บริบทของโทเคน 1M, รูปแบบ API ที่คุ้นเคย, ราคาสำหรับผู้ร่วมสร้างที่ต่ำ, การเขียนโค้ดในสามรอบแรกที่สำเร็จ, และคะแนน Muse Code จาก Meta ที่สูง ทำให้ยากที่จะมองข้ามได้ นอกจากนี้ Meta ยังทำได้ดีกว่าการเปิดตัวหลายโครงการอื่น ๆ ในด้านการเปิดเผยรายละเอียดของวิธีการทำงาน.
ข้อควรระวังก็ชัดเจนไม่แพ้กัน การกำหนดราคาสำหรับผู้ร่วมสร้างมาพร้อมกับการแลกเปลี่ยนในการใช้ข้อมูล โทเค็นผลลัพธ์มาตรฐานและโทเค็นการให้เหตุผลอาจทำให้ต้นทุนจริงเพิ่มขึ้น ตัวเลขการเขียนโค้ดระดับสูงของ Meta ยังไม่ได้รับการยืนยันว่าเป็นผลลัพธ์ที่ตรงกันบนกระดาน Terminal-Bench หรือ DeepSWE ที่เปิดให้สาธารณะใช้งาน และตัวอย่างการทดสอบของเราครอบคลุมงานสามประเภทของโมเดลพื้นฐาน แทนที่จะเป็นการดำเนินการของเอเจนต์ Muse Code.
วิธีที่เหมาะสมคือการดำเนินการทดลองแบบควบคุมบนโค้ดที่ไม่สำคัญ โดยบันทึกข้อมูลการใช้งานแบบดิบและผลการตรวจสอบในระบบท้องถิ่นไว้ ใช้ค่าใช้จ่ายและความล่าช้าที่วัดได้เป็นตัวอย่างจากงานขนาดเล็ก แล้วทดสอบขนาดรีโพสิตอรีของคุณเอง การกู้คืนหลังความล้มเหลว และกระบวนการทำงานของเอเจนต์ ก่อนที่จะเลือกใช้ในระบบผลิตจริง.
คำถามที่พบบ่อยเกี่ยวกับ Muse Spark 1.2
Muse Spark 1.2 คืออะไร?
Muse Spark 1.2 เป็นโมเดลของ Meta ที่เน้นด้านการเขียนโค้ด ซึ่งเปิดตัวเมื่อวันที่ 5 สิงหาคม 2026 โดยมีหน้าต่างบริบทขนาด 1 ล้านโทเคน และสามารถเข้าถึงได้ผ่าน Muse Code, Meta Model API และ OpenRouter.
Muse Spark 1.2 เป็นเวอร์ชันเดียวกันกับ Muse Code หรือไม่?
ไม่ครับ Muse Spark 1.2 คือรุ่นหลัก ส่วน Muse Code เป็นเอเจนต์เทอร์มินัลเบต้าที่ทำงานแยกต่างหาก ซึ่งใช้ Muse Spark 1.2 เป็นพื้นฐาน Muse Code เพิ่มคุณสมบัติของผลิตภัณฑ์ เช่น เอเจนต์ย่อย (subagents), โครงสร้าง git ที่แยกเป็นอิสระ, การบันทึกเหตุการณ์ (event logging), การต่อการทำงาน (resume), และทักษะที่รวมเป็นชุด (bundled skills).
ค่าบริการของ Muse Spark 1.2 API มีราคาเท่าไร?
โมเดลมาตรฐานใช้ทรัพยากร $1.25 สำหรับข้อมูลเข้า $0.15 สำหรับข้อมูลเข้าที่เก็บไว้ในแคช และ $4.25 สำหรับข้อมูลออก ต่อหนึ่งล้านโทเคน โมเดล Contributor มีค่าใช้จ่าย $0.10 สำหรับข้อมูลเข้า $0.002 สำหรับข้อมูลเข้าที่เก็บไว้ในแคช และ $0.20 สำหรับข้อมูลออก.
Meta ใช้ข้อมูลจาก Muse Spark API ในการฝึกอบรมหรือไม่?
Meta ระบุว่าข้อมูลระดับมาตรฐานไม่ถูกใช้เพื่อปรับปรุงผลิตภัณฑ์ของ Meta ส่วนข้อมูลระดับผู้ร่วมสร้างอาจถูกใช้เพื่อปรับปรุงผลิตภัณฑ์ของ Meta ดังนั้น โค้ดส่วนตัวหรือโค้ดที่เป็นกรรมสิทธิ์ควรใช้เส้นทางมาตรฐาน เว้นแต่องค์กรจะอนุมัติเป็นอย่างอื่น.
Muse Spark 1.2 ปรากฏอยู่ในตารางอันดับของ Terminal-Bench หรือ DeepSWE ที่เปิดให้สาธารณะใช้หรือไม่?
เมื่อตรวจสอบเมื่อวันที่ 7 สิงหาคม 2026 ระบบนี้ยังไม่ปรากฏอยู่ในรายชื่อของทั้งสองบอร์ดสาธารณะ Meta รายงานผล 82.9% บน Terminal-Bench 2.1 ด้วย Muse Code และ 59.3% บน DeepSWE แต่ผลดังกล่าวเป็นผลการทดสอบที่ Meta ดำเนินการเอง.
ในบทความรีวิวนี้ ได้มีการทดสอบ Muse Spark 1.2 ด้วยตัวเองแล้วหรือไม่?
ใช่ ในการทดสอบแบบโมเดลพื้นฐาน 3 ครั้งที่ดำเนินการเพียงครั้งเดียว Muse Spark 1.2 ได้ผ่านการทดสอบการแก้ไขข้อผิดพลาดใน Python การปรับโครงสร้างโค้ดใน TypeScript และคุณสมบัติ repositori JSONL ความล่าช้าเฉลี่ยอยู่ที่ 12.98 วินาที และค่าใช้จ่ายรวมที่รายงานคือ $0.045362 ความน่าเชื่อถือของ Muse Code agent และการเรียกใช้เครื่องมือยังไม่ได้รับการทดสอบ.
นักพัฒนาสามารถเข้าถึง Muse Spark 1.2 ได้อย่างไร?
Meta ระบุไว้สามวิธี ได้แก่ ตัวแทนเทอร์มินัล Muse Code เวอร์ชันเบต้า, Meta Model API และ OpenRouter คู่มือการใช้งานอย่างเป็นทางการใช้ไคลเอนต์ที่เข้ากันได้กับ SDK OpenAI โดยมี URL หลักคือ https://api.meta.ai/v1.