
คำตอบด่วน: GPT-6 Luna เป็นโมเดลของ OpenAI ที่ออกแบบมาเพื่อทำงานกับงานที่มีปริมาณสูงและต้องการความแม่นยำสูง API อย่างเป็นทางการระบุอัตราค่าบริการมาตรฐานที่ $0.10 ต่อ 1 ล้านโทเคนข้อมูลเข้า และ $0.50 ต่อ 1 ล้านโทเคนข้อมูลออก พร้อมหน้าต่างบริบทขนาด 1.05 ล้านโทเคน และปริมาณข้อมูลออกสูงสุด 128K คำถามสำคัญที่สุดในการตัดสินใจซื้อคือว่าคำตอบของมันจะตรงกับความต้องการของงานคุณหรือไม่ ด้วยค่าใช้จ่ายรวมที่อยู่ในระดับที่ยอมรับได้.
OpenAI อธิบาย GPT-6 Luna ว่าเป็นโมเดลที่มีประสิทธิภาพสูงสุดสำหรับงานที่ต้องการความแม่นยำและปริมาณงานสูง คำกล่าวนี้เป็นการกำหนดตำแหน่งทางการตลาดของผู้ให้บริการ ไม่ใช่คะแนนคุณภาพที่วัดได้จริง บทความนี้แปลข้อมูลจำเพาะที่เผยแพร่มาเป็นข้อตัดสินใจด้านการซื้อและสถาปัตยกรรม จากนั้นบันทึกปฏิกิริยาของสาธารณชนพร้อมระบุแหล่งที่มา เรายังได้ดำเนินการทดสอบสามงานขนาดเล็ก โดยรักษา ID ของโมเดล เส้นทาง ชุดคำสั่ง ผลลัพธ์ดิบ และข้อมูลการใช้งานไว้ ผลลัพธ์ของงานดังกล่าวแสดงไว้ด้านล่างในฐานะการทดสอบที่สังเกตได้หนึ่งครั้ง ไม่ใช่การวัดประสิทธิภาพอย่างเป็นทางการ.
บทสรุปสั้นๆ
Luna เป็นตัวเลือกที่เน้นความประหยัดและคำนึงถึงต้นทุนเป็นอันดับแรกในตารางราคาอย่างเป็นทางการ: มันรักษาบริบทหลักและขีดจำกัดผลลัพธ์ไว้เหมือนกับ Sol แต่คิดค่าบริการเพียงส่วนเล็กน้อยของอัตราโทเคนของ Sol ซึ่งทำให้มันเป็นตัวเลือกที่น่าสนใจสำหรับการเรียกใช้ที่มุ่งเน้นและทำซ้ำบ่อยครั้ง แต่ราคาที่ต่ำนี้ไม่ได้เป็นหลักฐานว่ามีความหน่วงต่ำลงหรือคุณภาพต่ำลง หากไม่มีการทดสอบอย่างควบคุม.
การแบ่งประเภทที่มีประโยชน์ที่สุดไม่ใช่เพียงการเปรียบเทียบระหว่าง “ฉลาด” กับ “เร็ว” แต่คือรูปแบบของงาน GPT-6 Luna มีบริบทหลักและขีดจำกัดผลลัพธ์ที่เท่ากันกับรุ่นพี่ แต่การวางตำแหน่งและราคาของมันทำให้จุดใช้งานที่แตกต่างกันดูเหมาะสมกว่า เมื่อเปรียบเทียบในภาพรวม คู่มือการเลือกโมเดล AI และ โมเดล AI ที่ดีที่สุดสำหรับการเขียนโค้ด คู่มือสำหรับกรณีที่งานเกี่ยวข้องกับผู้ให้บริการมากกว่าหนึ่งราย.
ภาพรวมของ GPT-6 Luna
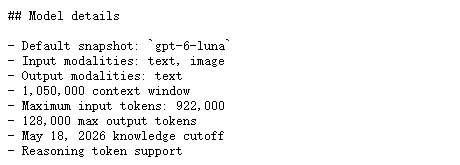
ตารางด้านล่างนี้สอดคล้องกับ หน้าหลักอย่างเป็นทางการของโมเดล GPT-6 Luna. ความจุของบริบทไม่ใช่สิ่งเดียวกันกับขนาดข้อความที่แนะนำ และปริมาณข้อมูลเข้าสูงสุดนั้นแยกต่างหากจากหน้าต่างบริบทของหัวข้อ.
gpt-6-lunaทั้งสองรุ่นของเครื่องมือนี้สนับสนุนผลลัพธ์ที่มีโครงสร้าง การเรียกใช้ฟังก์ชัน การสตรีม การเก็บแคชคำสั่ง การรับข้อมูลภาพ การค้นหาไฟล์ และการค้นหาบนเว็บ ตามชุดคุณสมบัติที่ระบุไว้ในเอกสาร อย่างไรก็ตาม พฤติกรรมที่แท้จริงของเครื่องมือยังคงขึ้นอยู่กับจุดปลายทาง บัญชี และการตั้งค่าคำขอ ดังนั้น อย่าสันนิษฐานว่าการทำงานของเครื่องมือสำเร็จเพียงเพราะมีช่องทำเครื่องหมายแสดงความสามารถ.
สำหรับบริบทในระดับครอบครัว, รีวิว GPT-6 Astra แสดงให้เห็นว่าบทความเกี่ยวกับ GPT-6 ที่เกี่ยวข้องนี้แยกเอกสารของผู้ให้บริการ เส้นทางของแพลตฟอร์ม และปฏิกิริยาที่ระบุไว้อย่างไร.
ราคา GPT-6 Luna และกฎ 272K
ตามอัตราปกติ, หน้ากำหนดราคา OpenAI แสดงข้อมูลดังนี้: $0.10 สำหรับข้อมูลเข้า, $0.01 สำหรับข้อมูลเข้าที่เก็บในแคช, $0.125 สำหรับการเขียนข้อมูลเข้าแคช, และ $0.50 สำหรับข้อมูลออกต่อ 1 ล้านโทเคน การเขียนข้อมูลเข้าแคชมีค่าเท่ากับ 1.25 เท่าของข้อมูลเข้าที่ไม่เก็บในแคช ราคาของ Batch และ Flex คือ 50% ของ Standard, โหมด Fast มีราคา 2 เท่าของอัตราที่บังคับใช้, และการประมวลผลในภูมิภาคจะเพิ่ม 10% ในพื้นที่ที่มีให้บริการ.
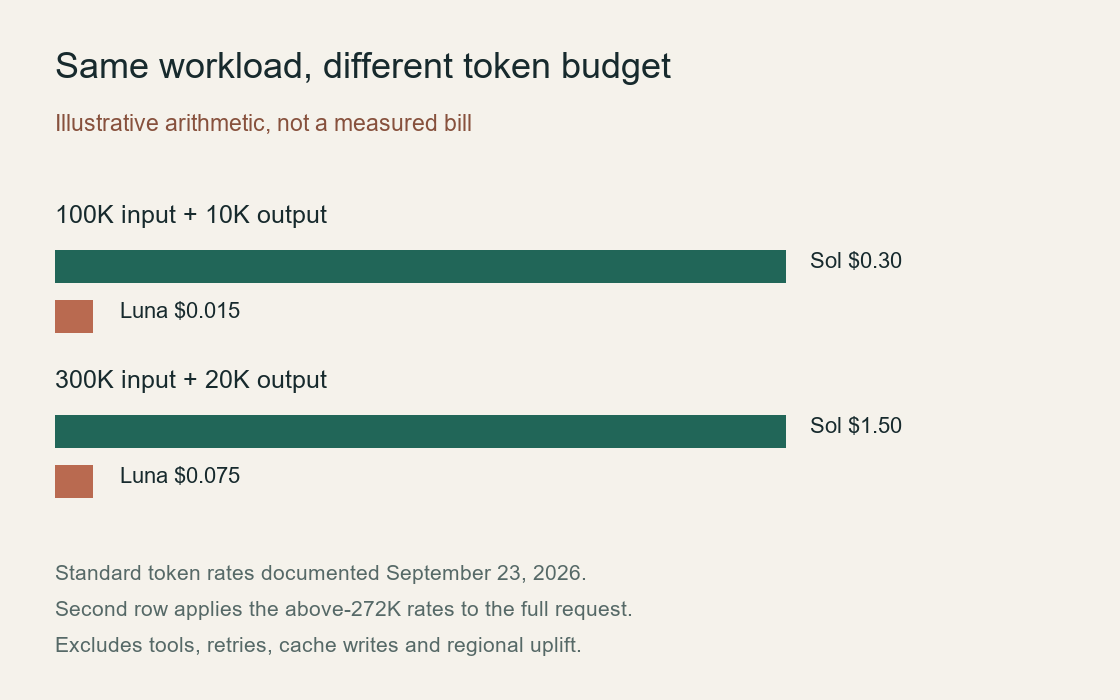
คอลัมน์ long-context คำนวณตามกฎของ OpenAI: เมื่อปริมาณข้อมูลเข้าเกิน 272K อัตราข้อมูลเข้าและอัตราแคชจะเพิ่มขึ้นเป็นสองเท่า และปริมาณข้อมูลออกจะถูกคูณด้วย 1.5 สำหรับคำขอทั้งหมด นี่ไม่ใช่การคิดค่าตามอัตราผสม เพื่อเป็นเกณฑ์พื้นฐานที่ใช้งานได้จริง การป้อนข้อมูล 100K บวกกับการส่งออก 10K จะมีค่าใช้จ่ายประมาณ $0.015 ก่อนการใช้เครื่องมือหรือการยกตัวของพื้นที่; ตัวอย่างที่มีข้อมูลเข้า 300K และข้อมูลออก 20K มีค่าใช้จ่ายประมาณ $0.075 ตามอัตราดอกเบี้ยในบริบทระยะยาว.
หน้าต่างบริบทขนาดใหญ่สามารถมีประโยชน์ได้ แม้การเติมข้อมูลให้เต็มหน้าต่างนั้นอาจไม่ประหยัดทรัพยากร การค้นหาข้อมูล การเลือกส่วนข้อมูล การใช้ซ้ำข้อมูลในแคช และขีดจำกัดการส่งออกข้อมูล มีความสำคัญมากกว่าตัวเลข 1.05M ที่ปรากฏในหัวข้อ ดูเพิ่มเติมที่ รายละเอียดราคา GPT-6 Astra เพื่อดูคำอธิบายที่เกี่ยวข้องเกี่ยวกับค่าขีดจำกัดของบริบทและกลไกการทำงานของแคช.
ความเหมาะสม เครื่องมือ และข้อจำกัดของ GPT-6 Luna API
OpenAI แนะนำให้ใช้ Responses API สำหรับเครื่องมือในตัวและเรียกใช้ฟังก์ชัน Chat Completions รองรับการเรียกใช้ฟังก์ชันได้เฉพาะเมื่อ การคิดวิเคราะห์และความพยายาม จะตั้งไว้ที่ ไม่มี. นี่คือรายละเอียดการดำเนินการที่ควรตรวจสอบก่อนการย้ายระบบ: คำขออาจถูกต้องตามโครงสร้างทางไวยากรณ์ แต่กลับไม่สอดคล้องกับพฤติกรรมของเครื่องมือที่ระบบการบูรณาการปัจจุบันของคุณคาดหวัง.
ตารางจำกัดอัตราปัจจุบันแสดงระดับมาตรฐานดังต่อไปนี้ RPM หมายถึงจำนวนคำขอต่อนาที TPM หมายถึงจำนวนโทเคนต่อนาที และค่าคิวคือขีดจำกัดโทเคนต่อชุด.
ก่อนเริ่มดำเนินการผลิต ให้ตรวจสอบให้แน่ใจว่าระดับ (tier) จุดปลายทาง (endpoint) โหมดการสตรีม (streaming mode) และสัญญาเครื่องมือ (tool contract) ในบัญชีของคุณถูกต้องตามที่ต้องการ คู่มือจำกัดการใช้งาน Codex เป็นข้อมูลบริบทที่มีประโยชน์ในการอธิบายว่าทำไมขีดจำกัดสูงสุดที่ประกาศของโมเดลจึงไม่เท่ากับขีดจำกัดการใช้งานจริงของบัญชี.
สิ่งที่ข้อมูลทางเทคนิคของ GPT-6 Luna บ่งชี้
นี่คือแผนที่ความเหมาะสม ไม่ใช่การเปรียบเทียบประสิทธิภาพ ใช้ คู่มือขั้นตอนการทำงานของโมเดล AI แบบครบวงจร เมื่อการตัดสินใจที่แท้จริงของคุณคือวิธีการเปลี่ยนโมเดลภายในกระบวนการที่สามารถทำซ้ำได้หนึ่งกระบวนการ แทนที่จะเป็นโมเดลใดที่ฟังดูมีประสิทธิภาพที่สุด.
ในผลการทดสอบของเรา: GPT-6 Luna ในการทำงานสามงานที่ใช้งานได้จริง
เราได้ทดสอบการแก้ไข JavaScript เล็กๆ บันทึกการตัดสินใจ 3 ข้อ และการสกัดข้อมูล JSON เมื่อวันที่ 23 กันยายน 2026 ผลลัพธ์ที่เก็บไว้ด้านล่างนี้เป็นคำตอบครบถ้วนสำหรับ ID ของโมเดล gpt-6-luna. การทดลองก่อนหน้านี้พบข้อผิดพลาดจากการโอเวอร์โหลดชั่วคราว ดังนั้นผลลัพธ์เหล่านี้จึงไม่ควรถูกตีความว่าเป็นการวัดความน่าเชื่อถือจากการทดลองครั้งแรก เราจะวิเคราะห์ว่าคำตอบเหล่านั้นประกอบด้วยอะไรบ้าง ผู้อ่านสามารถนำส่วนใดไปใช้ต่อได้ และส่วนใดที่ยังไม่ได้ทดสอบ.
การแก้ไขโค้ด: การรักษาค่าศูนย์ไว้โดยไม่เขียนฟังก์ชันใหม่
งานเขียนโค้ดนี้ต้องการการวินิจฉัยข้อผิดพลาด การแก้ไขด้วยแพตช์ที่น้อยที่สุด และการทดสอบการถดถอยสองครั้ง ผลลัพธ์ที่แสดงคือกระบวนการลองใหม่ที่เสร็จสิ้นแล้ว แต่ข้อความคำสั่งที่แม่นยำนั้นไม่มีอยู่.
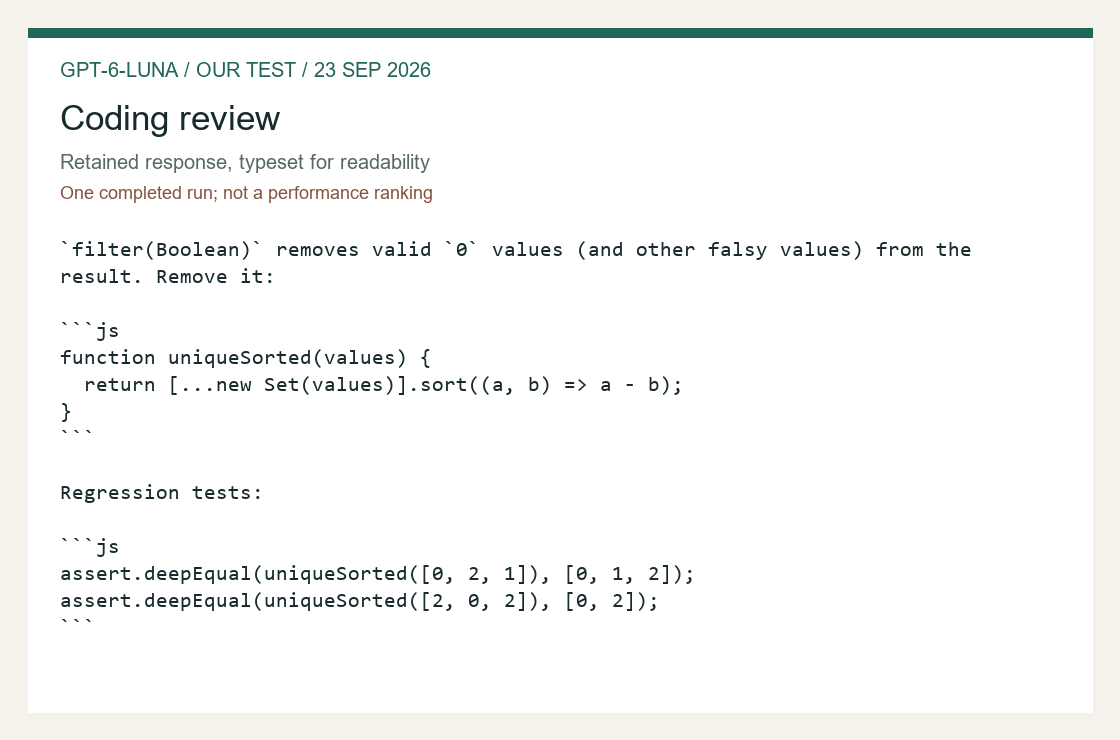
`filter(Boolean)` จะลบค่า `0` ที่ถูกต้อง (และค่าอื่น ๆ ที่ถูกพิจารณาเป็นเท็จ) ออกจากผลลัพธ์ ให้ลบส่วนนี้ออก:

```js
function uniqueSorted(values) {
  return [...new Set(values)].sort((a, b) => a - b);
}
```

การทดสอบการถดถอย:

```js
assert.deepEqual(uniqueSorted([0, 2, 1]), [0, 1, 2]);
assert.deepEqual(uniqueSorted([2, 0, 2]), [0, 2]);
```
ข้อมูลการใช้งานที่รายงานสำหรับคำตอบที่เสร็จสิ้นนี้: 61 โทเคนข้อมูลเข้า, 317 โทเคนข้อมูลออก, 378 โทเคนรวม. การใช้การเติมคำอาจรวมถึงโทเค็นที่ใช้ในการให้เหตุผล; ไม่ใช่เพียงความยาวของคำตอบที่มองเห็นได้เท่านั้น.
คำตอบที่สมบูรณ์ของลูนาได้ระบุอย่างถูกต้องว่า filter(Boolean) ลบค่าศูนย์ที่ถูกต้องและลบขั้นตอนสุดท้ายนั้นออกไป ผลลัพธ์ยังคงรักษาการกำจัดข้อมูลซ้ำแบบ Set-based และตัวเปรียบเทียบตัวเลขที่มีอยู่เดิม สำหรับตั๋วการบำรุงรักษาที่มีขอบเขตจำกัด นี่เป็นรูปแบบผลลัพธ์ที่มีประโยชน์: คำอธิบายสั้นๆ ตามด้วยฟังก์ชันที่แม่นยำ ไม่มีการออกแบบ API ใหม่ที่ไม่จำเป็น ไม่มีการพึ่งพาแพ็กเกจใหม่ หรือขั้นตอนการจัดรูปแบบที่ไม่เกี่ยวข้องเพื่อทำให้การแก้ไขดูซับซ้อน.
ช่องว่างในการบูรณาการอยู่ที่การทดสอบ Luna ได้ใช้ assert.deepEqual สองครั้ง แต่ไม่ได้รวมการนำเข้า assert เข้ามาด้วย การคัดลอกคำสั่งเหล่านั้นไปวางในไฟล์ Node.js ใหม่จะทำให้เกิดข้อผิดพลาดก่อนที่การตรวจสอบทั้งสองจะทำงาน การตรวจสอบเองมุ่งเป้าไปที่การผสมผสานที่เกี่ยวข้องระหว่างค่าศูนย์ การจัดเรียง และข้อมูลซ้ำ แต่ตัวอย่างนี้ไม่ครบถ้วน เพิ่มการนำเข้า assert แบบ strict หรือปรับคำสั่งเหล่านั้นให้เข้ากับตัวรันทดสอบที่มีอยู่ของคุณ นี่เป็นการแก้ไขเล็กน้อย แต่แสดงให้เห็นว่าทำไมคำตอบโค้ดที่สมเหตุสมผลและอาร์ติแฟกต์ที่พร้อมรันจึงเป็นเกณฑ์การยอมรับที่แตกต่างกัน.
คำตอบการเขียนโค้ดที่เก็บไว้เป็นผลลัพธ์จากการลองใหม่ ครั้งก่อนหน้านี้ถึงขีดจำกัดผลลัพธ์ 900 โทเคน ส่วนการลองใหม่ที่เสร็จสิ้นแล้วใช้คำสั่งสั้นกว่าและขีดจำกัด 1,200 โทเคน ข้อความของคำขอทำใหม่ไม่ได้ถูกเก็บไว้ ดังนั้นเราจึงไม่นำเสนอข้อความคำสั่งต้นฉบับเหมือนว่ามันได้สร้างคำตอบนี้ขึ้นมา สิ่งนี้ทำให้ไม่สามารถเปรียบเทียบคุณภาพหรือความล่าช้าแบบตรงกันข้ามกับ Sol ได้อย่างชัดเจน นอกจากนี้ยังให้บทเรียนด้านการนำไปใช้จริง: ให้บันทึกเวอร์ชันของข้อความคำสั่งและเหตุผลที่เสร็จสิ้น และอย่าถือว่าการตอบที่ถูกตัดทอนเป็นแพตช์โค้ดที่สำเร็จ.
การสังเคราะห์สามโน้ต: การรักษาการตัดสินใจให้เป็นแบบมีเงื่อนไข
รวมสามข้อสังเกตต่อไปนี้เข้าเป็นบันทึกการตัดสินใจที่กระชับ โดยระบุ: การตัดสินใจ, หลักฐาน, ความเสี่ยง และขั้นตอนต่อไป หมายเหตุ A: หน้าต่างบริบทขนาด 1.05M โทเคนสามารถเก็บชุดข้อมูลต้นทางขนาดใหญ่ได้ แต่ไม่ทำให้ทุกคำขอมีค่าใช้จ่ายต่ำ หมายเหตุ B: เมื่อจำนวนโทเคนอินพุตเกิน 272K อัตราการอ่านข้อมูลจากแคชและอัตราการใช้แคชที่บันทึกไว้จะเพิ่มขึ้น และผลลัพธ์จะถูกคูณตามปริมาณคำขอทั้งหมด หมายเหตุ C: การเรียกข้อมูลและการใช้ซ้ำแคชสามารถลดค่าใช้จ่ายจากการส่งคำสั่งซ้ำได้ แต่เกณฑ์การยอมรับยังคงต้องผ่านการทดสอบ.
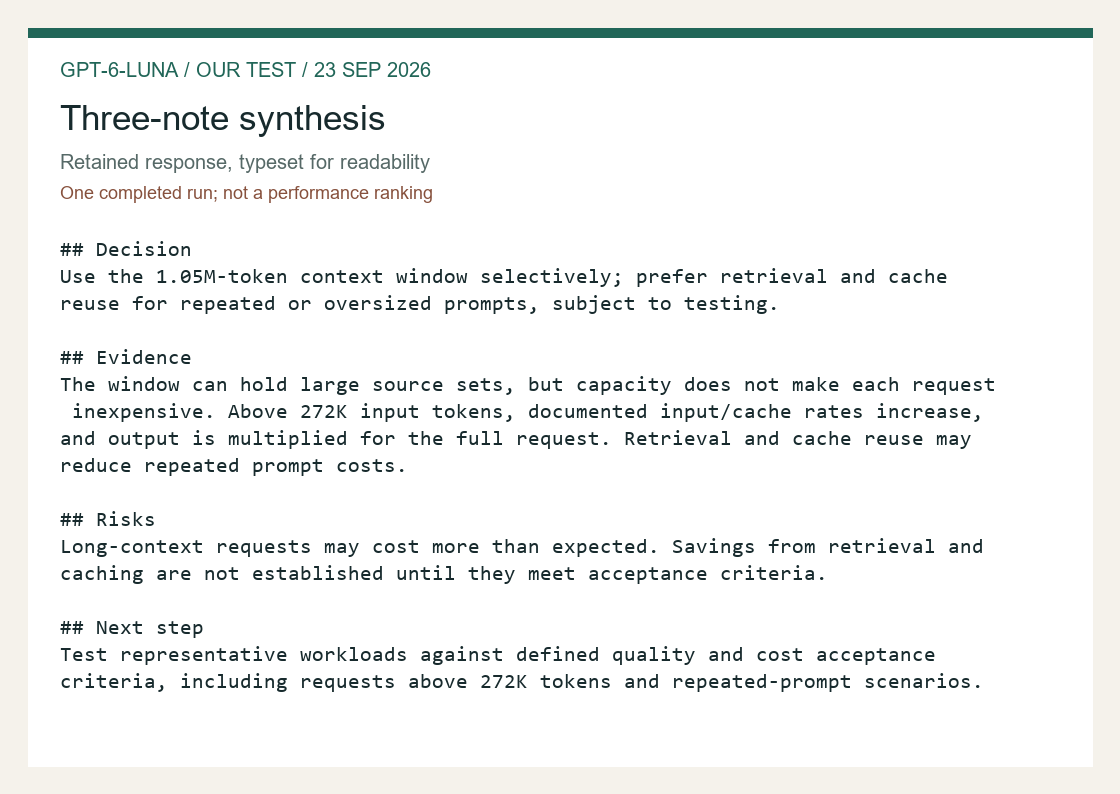
## การตัดสินใจ
ใช้หน้าต่างบริบท 1.05M-token อย่างเลือกสรร; ให้ความสำคัญกับการเรียกข้อมูลและการใช้ซ้ำแคชสำหรับคำสั่งที่ซ้ำกันหรือมีขนาดใหญ่เกินไป โดยต้องผ่านการทดสอบก่อน

## หลักฐาน
หน้าต่างนี้สามารถเก็บชุดข้อมูลต้นทางขนาดใหญ่ได้ แต่ความจุดังกล่าวไม่ทำให้แต่ละคำขอมีค่าใช้จ่ายต่ำ เมื่อจำนวนโทเคนอินพุตเกิน 272K อัตราการอ่านข้อมูล/แคชที่บันทึกไว้จะเพิ่มขึ้น และผลลัพธ์จะถูกคูณตามคำขอทั้งหมด การเรียกข้อมูลและการใช้ซ้ำแคชอาจช่วยลดค่าใช้จ่ายของคำขอที่ซ้ำกัน

## ความเสี่ยง
คำขอที่มีบริบทยาวอาจมีค่าใช้จ่ายสูงกว่าที่คาดไว้ การประหยัดค่าใช้จ่ายจากการเรียกข้อมูลและใช้แคชซ้ำจะยังไม่ได้รับการยืนยันจนกว่าจะผ่านเกณฑ์การยอมรับ

## ขั้นตอนต่อไป
ทดสอบโหลดงานที่เป็นตัวแทนตามเกณฑ์การยอมรับด้านคุณภาพและค่าใช้จ่ายที่กำหนดไว้ รวมถึงคำขอที่มีโทเคนมากกว่า 272K และสถานการณ์ที่มีพรอมต์ซ้ำ.
ข้อมูลการใช้งานที่รายงานสำหรับคำตอบที่เสร็จสิ้นนี้: 99 โทเคนข้อมูลเข้า, 223 โทเคนผลลัพธ์, 322 โทเคนรวม. การใช้การเติมคำอาจรวมถึงโทเค็นที่ใช้ในการให้เหตุผล; ไม่ใช่เพียงความยาวของคำตอบที่มองเห็นได้เท่านั้น.
Luna ได้รักษาส่วนทั้งสี่ของบันทึกที่ขอไว้ทั้งหมด และกำหนดข้อเสนอแนะของตนขึ้นอยู่กับการทดสอบ มันยังคงรักษาความแตกต่างระหว่างการเก็บชุดข้อมูลต้นทางขนาดใหญ่กับการประมวลผลอย่างมีประสิทธิภาพ นอกจากนี้ ยังระบุว่า การประหยัดจากการค้นหาข้อมูลและการเก็บไว้ในแคชจะยังไม่ได้รับการยืนยันจนกว่าจะผ่านเกณฑ์การยอมรับ ความระมัดระวังนี้มีประโยชน์สำหรับรายงานสรุปภายในที่เกิดขึ้นซ้ำๆ ซึ่งคำแนะนำที่ดูน่าสนใจอาจกลายเป็นคำสัญญาที่ไม่มีหลักฐานสนับสนุนได้ หลังจากผ่านกระบวนการเขียนใหม่หลายรอบ.
งานนี้ประกอบด้วยบันทึกสั้นสามชิ้น และมีโทเคนคำสั่งที่รายงานเพียง 99 โทเคนเท่านั้น การเรียกมันว่าเป็นมาตรฐานการทดสอบบริบทยาว (long-context benchmark) จะเป็นการกล่าวเกินจริง ผลลัพธ์แสดงให้เห็นว่า Luna สามารถจัดระเบียบชุดข้อมูลหลักฐานขนาดเล็กที่ให้มาได้ในการทดสอบครั้งนี้; แต่ยังไม่ยืนยันความสามารถในการเรียกคืนข้อมูล (retrieval recall), ความครอบคลุมของเอกสาร (document coverage), ความทนทานต่อคำสั่งที่ขัดแย้งกัน หรือความถูกต้องเมื่อเข้าใกล้ขนาดข้อมูลเข้าสูงสุด ก่อนที่จะนำไปใช้สำหรับการสรุปเนื้อหาแบบต่อเนื่อง ควรรวมกรณีที่มีวันที่ขัดแย้งกันและเจ้าของที่ขาดหายไป แล้วตรวจสอบว่าความไม่แน่นอนยังคงอยู่หรือไม่ในข้อความสรุปขั้นสุดท้าย.
การสกัดข้อมูล JSON: การระบุค่าที่ไม่ทราบอย่างชัดเจน
สกัดข้อมูลจากส่วนต่อไปนี้ในเอกสารสรุปนี้ และส่งคืน JSON ที่ถูกต้องเท่านั้น โดยใช้คีย์ customer, priority, deadline และ unknowns เท่านั้น เอกสารสรุป: ลูกค้า: Northwind Labs. ระดับความสำคัญ: สูง. กำหนดเวลา: 2026-10-04. ไม่ระบุชื่อผู้รับผิดชอบ และงบประมาณยังไม่ได้รับการยืนยัน.
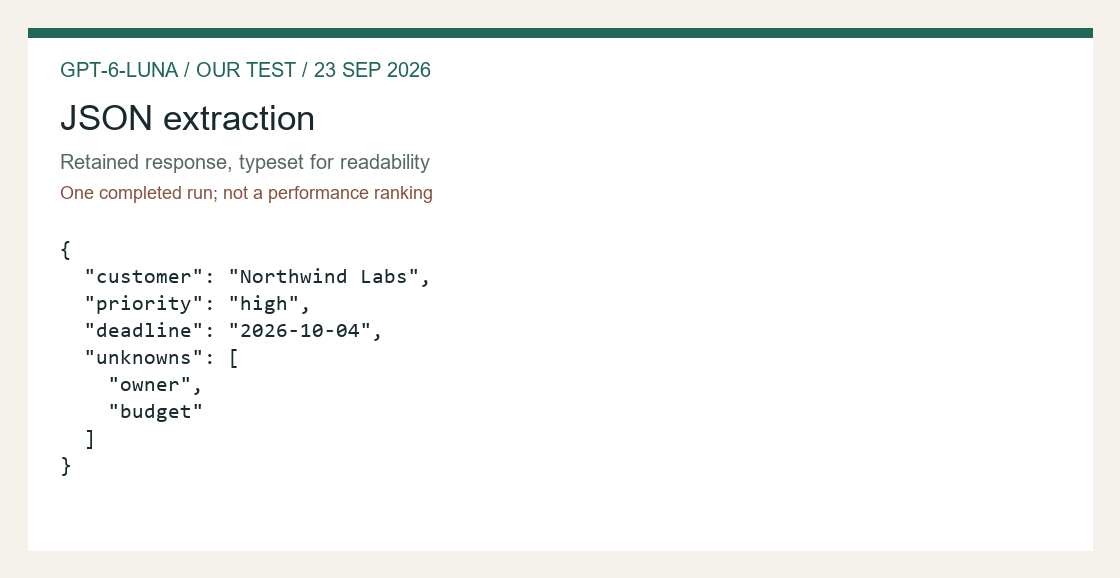
{"ลูกค้า":"Northwind Labs","ระดับความสำคัญ":"สูง","วันครบกำหนด":"2026-10-04","ข้อมูลที่ยังไม่ทราบ":["ผู้รับผิดชอบ","งบประมาณ"]}ข้อมูลการใช้งานที่รายงานสำหรับคำตอบที่เสร็จสิ้นนี้: 64 โทเคนข้อมูลเข้า, 63 โทเคนผลลัพธ์, รวมทั้งหมด 127 โทเคน. การใช้การเติมคำอาจรวมถึงโทเค็นที่ใช้ในการให้เหตุผล; ไม่ใช่เพียงความยาวของคำตอบที่มองเห็นได้เท่านั้น.
ผลลัพธ์จากการสกัดข้อมูลเป็นเหตุผลที่ชัดเจนที่สุดจากตัวอย่างขนาดเล็กนี้ ที่ทำให้ควรพิจารณาใช้ Luna สำหรับงานที่มีขอบเขตแคบและสามารถทำซ้ำได้ มันส่งคืน JSON ที่ถูกต้องพร้อมด้วยคีย์ที่ร้องขอ คัดลอก Northwind Labs และกำหนดเวลาตามมาตรฐาน ISO ได้อย่างถูกต้อง และรักษาข้อมูลเจ้าของและงบประมาณไว้เป็นค่าไม่ทราบ ไม่มีคำนำหน้าแบบสนทนาที่ต้องตัดออก Sol สร้าง JSON ที่เหมือนกันเมื่อใช้คำสั่งการสกัดข้อมูลเดียวกัน ดังนั้นข้อมูลที่มีอยู่ไม่แสดงให้เห็นถึงข้อได้เปรียบของโมเดลที่มีราคาแพงกว่าในชุดข้อมูลนี้.
ความถูกต้องทางไวยากรณ์เป็นเพียงขั้นตอนแรกเท่านั้น โปรแกรมวิเคราะห์ JSON จะยอมรับชื่อเจ้าของที่ถูกสร้างขึ้นเอง ลูกค้าที่ผิด หรือวันที่ที่ดูถูกต้องแต่ไม่ถูกต้องได้โดยไม่มีปัญหา สคีมาสามารถจำกัดฟิลด์และประเภทข้อมูลได้ แต่ไม่สามารถพิสูจน์ได้ว่าเนื้อหาสอดคล้องกับแหล่งที่มา สำหรับงานนี้ การตรวจสอบค่าสามค่าที่ทราบแล้วเทียบกับเอกสารสรุปงาน และการตรวจสอบว่าฟิลด์สองฟิลด์ที่ขาดหายไปยังคงเป็นค่าที่ไม่ทราบอยู่ จะทำหน้าที่เป็นด่านความหมาย เมื่อทำงานในขนาดใหญ่ ให้ส่งความขัดแย้งของเส้นทางและวันที่ที่ไม่แน่นอนไปเพื่อตรวจสอบแทนที่จะแก้ไขด้วยการคาดเดา.
การตรวจสอบความถูกต้องที่ไปไกลกว่า JSON ที่สามารถวิเคราะห์ได้
ต่อไปนี้คือตัวอย่างการตรวจสอบความถูกต้องของโมเดล ไม่ใช่คำตอบเพิ่มเติมจากโมเดล มันทำงานบนเครื่องท้องถิ่นใน Node.js และไม่ส่งคำขอไปยังโมเดล มันตรวจสอบ fixture ที่กล่าวถึงข้างต้นเท่านั้น; ไม่ใช่การประเมินโมเดลโดยทั่วไป.
const assert = require('node:assert/strict');
const response = '{"customer":"Northwind Labs","priority":"high","deadline":"2026-10-04","unknowns":["owner","budget"]}';
const value = JSON.parse(response);
assert.deepStrictEqual(Object.keys(value).sort(), ['customer','deadline','priority','unknowns']);
assert.equal(value.customer, 'Northwind Labs');
assert.equal(value.priority, 'high');
assert.equal(value.deadline, '2026-10-04');
assert.deepStrictEqual(value.unknowns, ['owner', 'budget']);
console.log('ฟิกเจอร์นี้ตรงกับข้อกำหนดแล้ว ข้อมูลเข้าใหม่ต้องมีค่าที่คาดหวังของตัวเอง');
ตัวตรวจสอบความถูกต้องจะตรวจสอบข้อมูลที่คาดไว้และชุดคีย์อย่างตั้งใจ มันจะปฏิเสธคำตอบที่เพิ่มฟิลด์เจ้าของที่มั่นใจหรือเปลี่ยนแปลงวันที่ แม้คำตอบนั้นจะยังคงเป็น JSON ที่ถูกต้องก็ตาม ค่าเหล่านั้นเป็นค่าเฉพาะของ fixture นี้เท่านั้น ตัวตรวจสอบความถูกต้องในระบบผลิตจริงต้องรับข้อมูลที่คาดไว้จากสัญญาอินพุต ไม่ใช่กำหนด Northwind Labs ไว้อย่างตายตัวสำหรับลูกค้าทุกคน การตรวจสอบความถูกต้องของปฏิทินและสิทธิ์ในการอัปเดตบันทึกเป็นการตรวจสอบที่แยกกัน การผ่านตัวอย่างนี้หมายความว่าคำตอบที่เก็บไว้ตรงกับข้อกำหนดนี้ ไม่ใช่ว่าการดึงข้อมูลทุกครั้งในอนาคตจะถูกต้อง.
GPT-6 Luna เปลี่ยนกระบวนการทำงานจริงอย่างไร
ข้อกำหนดหลักจะมีความสำคัญก็ต่อเมื่อมันเปลี่ยนแปลงวิธีการทำงานของทีม GPT-6 Luna ได้รับการออกแบบมาเพื่อทำงานกับงานที่มีปริมาณมากและต้องการความแม่นยำสูง ดังนั้นคำถามแรกคือ งานของคุณจะได้รับประโยชน์จากรูปแบบนี้หรือไม่ หากทุกคำขอมีข้อมูลเข้าที่สั้น ข้อตกลงผลลัพธ์ที่จำกัด และเกณฑ์การรับยอมรับที่ชัดเจน โมเดลนี้สามารถทำงานภายในกระบวนการที่สามารถทำซ้ำได้ แต่หากงานนั้นไม่ชัดเจน ต้องใช้เครื่องมือมาก หรือมีแนวโน้มที่จะต้องการการแก้ไขหลายรอบ การจัดการระบบโดยรอบก็สำคัญไม่แพ้ชื่อโมเดล.
สำหรับ GPT-6 Luna รูปแบบการทำงานที่มีประโยชน์คือกระบวนการสองขั้นตอน: ขั้นแรก ขอคำตอบที่กระชับพร้อมระบุความไม่แน่นอนอย่างชัดเจน แล้วส่งเฉพาะส่วนที่มีข้อโต้แย้งหรือไม่สมบูรณ์ไปยังขั้นตอนที่สอง วิธีนี้ช่วยลดจำนวนโทเคนผลลัพธ์ที่สูญเปล่าและทำให้ความล้มเหลวปรากฏชัดเจนขึ้น นอกจากนี้ยังให้จุดเปรียบเทียบที่ดีกว่ากับ GPT-6 Sol: คำถามไม่ใช่ว่าชื่อใดฟังดูแข็งแกร่งกว่า แต่เป็นว่าเส้นทางใดจะบรรลุเกณฑ์การยอมรับด้วยจำนวนการลองใหม่ที่น้อยที่สุด.
แบบจำลองค่าใช้จ่ายแบบง่ายๆ ก่อนส่งสินค้า
ตารางราคาอย่างเป็นทางการควรถูกแปลงเป็นหน่วยที่ทีมของคุณใช้จริง ได้แก่ จำนวนคำขอต่อวัน, จำนวนโทเคนอินพุตเฉลี่ย, ส่วนแบ่งพรีฟิกซ์ที่เก็บไว้ในแคช, จำนวนโทเคนเอาต์พุต และเปอร์เซ็นต์ของคำขอที่มีอินพุตเกิน 272K การใช้สเปรดชีตที่ติดตามเพียงราคาอินพุตหลักเท่านั้น จะทำให้ไม่สามารถมองเห็นตัวคูณในบริบทระยะยาวและค่าใช้จ่ายจากการลองใหม่ได้.
การคำนวณนี้มีความสำคัญเป็นพิเศษเมื่อเปรียบเทียบ GPT-6 Luna กับ GPT-6 Sol คำขอที่มีค่าใช้จ่ายต่ำอาจกลายเป็นค่าใช้จ่ายสูงหากต้องผ่านขั้นตอนการแก้ไขซ้ำหลายครั้ง ส่วนคำขอที่มีประสิทธิภาพสูงกว่าอาจก่อให้เกิดการสิ้นเปลืองเมื่องานนั้นเป็นการสกัดข้อมูลแบบกำหนดได้ (deterministic extraction) มาตรฐานอ้างอิงที่เหมาะสมคือตัวอย่างขนาดเล็กจากปริมาณการรับส่งข้อมูลของคุณเอง โดยใช้คำสั่ง (prompts) แบบเดียวกัน โครงสร้างข้อมูล (schema) แบบเดียวกัน และกฎการตรวจสอบ (review rule) แบบเดียวกัน.
รูปแบบความล้มเหลวที่ควรตรวจสอบก่อนนำไปใช้
หน้าแบบตัวอย่างสามารถบอกคุณได้ว่ามีจุดปลายทาง (endpoints) และรูปแบบการสื่อสาร (modalities) ใดที่ได้รับการบันทึกไว้ แต่ไม่สามารถรับประกันได้ว่าแอปพลิเคชันที่มีอยู่ของคุณจะทำงานเหมือนเดิมหลังการย้ายระบบ ตรวจสอบว่าเหตุการณ์สตรีมมิ่ง (streaming events) ถูกวิเคราะห์อย่างถูกต้องหรือไม่ การเรียกใช้เครื่องมือ (tool calls) รักษาสถานะไว้ระหว่างการลองใหม่ (retries) หรือไม่ ผลลัพธ์ที่มีโครงสร้าง (structured output) ปฏิเสธฟิลด์ที่มีรูปแบบไม่ถูกต้องหรือไม่ และระบบบันทึก (logging pipeline) ของคุณบันทึก ID ของแบบจำลอง (model ID) และการตั้งค่าการให้เหตุผล (reasoning setting) สำหรับทุกคำขอหรือไม่.
ประตูเดียวกันนี้ทำให้การสังเกตการณ์แบบปฏิบัติจริงในบทรีวิวนี้มีประโยชน์ โดยไม่ทำให้มันกลายเป็นตารางอันดับ ภารกิจทั้งสามของเราแสดงให้เห็นว่าเส้นทางนี้จัดการกับข้อบกพร่องเล็กๆ ในโค้ด บันทึกการตัดสินใจ และการสกัดข้อมูล JSON อย่างเคร่งครัดได้อย่างไร ภารกิจเหล่านี้ไม่ได้กำหนดค่าความล่าช้า ความน่าเชื่อถือเมื่อขยายขนาด หรือการจัดอันดับคุณภาพแบบสากล.
กรอบการตัดสินใจสำหรับทีมจริง
การทบทวนแบบจำลองจะมีประโยชน์เมื่อช่วยผู้ใช้งานตัดสินใจภายใต้ข้อจำกัดต่าง ๆ สำหรับ GPT-6 Luna ข้อจำกัดที่สำคัญที่สุด ได้แก่ รูปแบบคำขอ ค่าใช้จ่ายในการทบทวน ขนาดของบริบท รูปแบบผลลัพธ์ และผลที่ตามมาหากคำตอบผิด คำอธิบายของผู้ให้บริการชี้ให้เห็นถึงงานที่เน้นความเฉพาะเจาะจงและมีปริมาณสูง แต่ทีมยังต้องแปลงคำอธิบายนั้นให้เป็นขั้นตอนที่สามารถติดตามได้ เริ่มต้นด้วยการเขียนงานนั้นลงในหนึ่งประโยค รวมถึงข้อมูลเข้าที่โมเดลจะได้รับ ผลลัพธ์ที่ระบบอื่นคาดหวัง และจุดตรวจสอบของมนุษย์ที่ช่วยป้องกันข้อผิดพลาดที่อาจเกิดขึ้นโดยไม่รู้ตัว.
ข้อผิดพลาดแรกคือการเลือกโมเดลจากคำสั่งในเวอร์ชันเดโม เวอร์ชันเดโมจะให้คะแนนสูงกับความลื่นไหลของผลลัพธ์ และซ่อนรายละเอียดการดำเนินงาน เช่น การลองใหม่ การจัดการโทเคน สิทธิ์การใช้งานเครื่องมือ และข้อผิดพลาดของสคีมา การเปรียบเทียบที่ดีกว่าจะใช้งานสามประเภทที่เป็นตัวแทน ได้แก่ คำขอทั่วไปหนึ่งรายการ คำขอที่ยากหนึ่งรายการ และคำขอที่ควรถูกปฏิเสธหรือส่งต่อไปยังระดับที่สูงขึ้น ผลลัพธ์ไม่ใช่คะแนนเดียว แต่เป็นแผนที่ขนาดเล็กที่แสดงให้เห็นว่าโมเดลประหยัดเวลาในส่วนใด ต้องการการกำกับดูแลในส่วนใด และในส่วนใดที่โมเดลอื่น — ซึ่งมักเป็น GPT-6 Sol — เป็นตัวเลือกที่ประหยัดกว่าหรือปลอดภัยกว่า.
เริ่มด้วยการทดสอบการยอมรับ
เขียนการทดสอบการยอมรับก่อนที่จะเขียนคำสั่ง สำหรับโค้ด การทดสอบอาจเป็นการทดสอบหน่วยที่ผ่านได้ หรือแพตช์ที่ไม่เปลี่ยนแปลง API สาธารณะ สำหรับการสกัดข้อมูล การทดสอบอาจเป็น JSON ที่ถูกต้อง ซึ่งมีคีย์ที่จำเป็นทั้งหมดอยู่ครบถ้วน และค่าที่ไม่ทราบถูกรักษาไว้อย่างชัดเจน สำหรับบันทึกการตัดสินใจ การทดสอบอาจเป็นโครงสร้างที่คงที่ ซึ่งประกอบด้วยหลักฐาน ความเสี่ยง ผู้รับผิดชอบ และขั้นตอนต่อไป โมเดลสามารถถูกประเมินได้เฉพาะเมื่อมีเป้าหมายที่ชัดเจนเท่านั้น หากไม่มีเป้าหมายนั้น ย่อหน้าที่เขียนอย่างประณีตอาจดูเหมือนประสบความสำเร็จ แต่กลับละเว้นฟิลด์เดียวที่กระบวนการต่อตามต้องการไปอย่างเงียบๆ.
การทดสอบการรับมอบที่ดีควรมีขอบเขตที่แคบพอที่จะดำเนินการได้โดยอัตโนมัติ และมีความหมายเพียงพอที่จะปกป้องผู้ใช้ นอกจากนี้ยังควรทำให้ความไม่เห็นด้วยสามารถเข้าใจได้ชัดเจน หากผลลัพธ์สองอย่างแตกต่างกัน ทีมควรสามารถชี้ให้เห็นถึงข้อมูลที่ขาดหายไป สมมติฐานที่ไม่มีหลักฐานสนับสนุน ฟิลด์ที่มีรูปแบบไม่ถูกต้อง หรือการคำนวณที่ผิดพลาด ซึ่งสิ่งนี้สามารถนำไปปฏิบัติได้มากกว่าการกล่าวว่าคำตอบหนึ่ง “ดูฉลาดกว่า” นี่คือความแตกต่างระหว่างการตรวจสอบที่ช่วยสนับสนุนกระบวนการจัดซื้อจัดจ้าง กับการตรวจสอบที่เพียงแต่ทวนซ้ำข้อความที่ใช้ในการเปิดตัวเท่านั้น.
ใช้ชื่อโมเดลเพื่อเลือกสมมติฐานเริ่มต้น ใช้การทดสอบการยอมรับเพื่อตัดสินว่าสมมติฐานนั้นจะผ่านขั้นตอนการนำไปใช้ในระบบผลิตได้หรือไม่.
ออกแบบข้อความที่สอดคล้องกับโปรไฟล์ของโมเดล
ไม่ควรคัดลอกคำสั่งเดียวกันโดยไม่มีการปรับเปลี่ยนระหว่างโมเดลต่าง ๆ สัญญาการทำงานสามารถคงที่ไว้ได้ แต่ปริมาณบริบท คำแนะนำในการให้เหตุผล และข้อจำกัดของผลลัพธ์ควรสอดคล้องกับเส้นทาง สำหรับ GPT-6 Luna ให้รักษาคำสั่งระบบให้สั้นพอเพื่อไม่ให้ทับซ้อนกับเนื้อหาต้นฉบับ ระบุบทบาท กฎการตัดสินใจ รูปแบบผลลัพธ์ที่ต้องการ และเงื่อนไขที่จำเป็นต้องระบุสิ่งที่ไม่ทราบอย่างชัดเจนหรือการยกระดับ.
สำหรับเอกสารที่ยาว ให้แยกขั้นตอนการค้นหาข้อมูลออกจากขั้นตอนการตัดสิน ก่อนอื่น ให้ระบุส่วนข้อความที่ตอบคำถามได้ก่อน แล้วจึงสรุปผลโดยใช้เพียงส่วนข้อความเหล่านั้นและเกณฑ์ที่กำหนดไว้เท่านั้น วิธีนี้ช่วยลดโอกาสที่ประโยคที่ดูน่าเชื่อถือจะถูกสร้างขึ้นจากรายละเอียดที่ไม่เกี่ยวข้องและอยู่ห่างไกล นอกจากนี้ ยังทำให้หน้าต่างบริบทขนาด 1.05M-token กลายเป็นเครื่องมือแทนที่จะเป็นค่าเริ่มต้น บริบทที่กว้างมีประโยชน์เมื่อความสัมพันธ์ระหว่างหลักฐานที่อยู่ห่างกันมีความสำคัญ แต่จะกลายเป็นการสิ้นเปลืองเมื่อสามารถแก้ปัญหาได้ด้วยชุดข้อมูลขนาดเล็กที่คัดเลือกมาอย่างดี.
สำหรับกระบวนการทำงานที่ใช้เครื่องมือ ให้อธิบายขอบเขตระหว่างโมเดลและเครื่องมือ โมเดลควรตัดสินใจว่าจำเป็นต้องใช้เครื่องมือหรือไม่ ให้ข้อมูลอาร์กิวเมนต์ตามโครงสร้างที่กำหนดไว้อย่างเคร่งครัด และอธิบายว่าจะดำเนินการกับค่าที่ส่งกลับมาอย่างไร แอปพลิเคชันควรบังคับใช้สิทธิ์, ตรวจสอบความถูกต้องของอาร์กิวเมนต์, บันทึกการเรียกใช้, และตัดสินใจว่าการเรียกใช้เครื่องมือที่ล้มเหลวสามารถลองใหม่ได้หรือไม่ การมองโมเดลเป็นแอปพลิเคชันทั้งหมดจะทำให้การดีบักยากขึ้น และเพิ่มขอบเขตผลกระทบของสมมติฐานที่ผิด.
ข้อความนำทางแบบสี่ส่วนที่สามารถใช้ซ้ำได้
บริบท: ให้เฉพาะข้อมูลและเอกสารที่จำเป็นสำหรับงานนี้เท่านั้น. เป้าหมาย: อธิบายการตัดสินใจหรือการเปลี่ยนแปลงนั้นในหนึ่งประโยค. ข้อจำกัด: กำหนดรูปแบบข้อมูล การยกเว้น การจัดการความไม่แน่นอน และขีดจำกัดของเครื่องมือ. ตรวจสอบ: ขอให้โมเดลระบุข้อมูลที่ขาดหรือความขัดแย้งก่อนที่จะสรุปคำตอบ โครงสร้างนี้สั้นพอที่จะเรียกใช้ซ้ำได้ และชัดเจนพอที่จะเปรียบเทียบระหว่างโมเดลต่าง ๆ.
เมื่อหน้าต่างบริบทขนาดใหญ่มีประโยชน์
หัวข้อ "1.05M-token" นั้นง่ายที่จะนำกลับมาใช้ซ้ำและง่ายที่จะใช้ผิดวัตถุประสงค์ หน้าต่างบริบทจะบอกคุณว่าข้อมูลสามารถใส่ลงในคำขอได้เท่าใด แต่ไม่บอกคุณว่าควรส่งข้อมูลเท่าใด โมเดลจะใช้แต่ละส่วนข้อความได้ดีเพียงใด หรือค่าใช้จ่ายของคำขอจะเป็นเท่าใด คำขอที่ยาวอาจทำให้กระบวนการตรวจสอบช้าลงได้ เนื่องจากทีมมีข้อมูลเพิ่มเติมที่ต้องตรวจสอบ และมีโอกาสเกิดการขัดแย้งในคำสั่งที่ละเอียดอ่อนมากขึ้น.
ใช้หน้าต่างแบบเต็มเมื่องานนั้นขึ้นอยู่กับข้อมูลอ้างอิงที่อยู่ห่างไกลอย่างแท้จริง: เช่น สัญญาที่มีคำนิยามแยกจากข้อยกเว้น, ที่เก็บข้อมูลที่อินเทอร์เฟซและการนำไปใช้อยู่ห่างกันมาก, หรือคลังข้อมูลวิจัยที่ยาวซึ่งคำตอบต้องติดตามลำดับขั้นตอน ใช้การเรียกข้อมูลเมื่อคำถามเป็นเรื่องเฉพาะที่, เมื่อชุดข้อมูลต้นทางเปลี่ยนแปลงบ่อยครั้ง, หรือเมื่อคุณต้องการเส้นทางการอ้างอิงที่กระชับ ใช้การเก็บไว้ในแคช (caching) เมื่อมีคำนำหน้า (prefix) ที่เสถียรถูกใช้ซ้ำในหลายคำขอ และแพลตฟอร์มเปิดเผยรายละเอียดการใช้งานเพียงพอเพื่อพิสูจน์ว่าแคชกำลังทำงาน.
ค่าขีดจำกัด 272K ควรเป็นส่วนหนึ่งของแผนผังสถาปัตยกรรม ไม่ใช่เพียงหมายเหตุท้ายหน้าในส่วนราคา คำขอที่อยู่ในระดับปลอดภัยเมื่ออยู่ต่ำกว่าขีดจำกัดนี้ อาจมีค่าใช้จ่ายสูงขึ้นอย่างมีนัยสำคัญเมื่อเกินขีดจำกัดดังกล่าว ทีมควรบันทึกข้อมูลเกี่ยวกับโทเค็นอินพุต โทเค็นที่เก็บไว้ในแคช โทเค็นเอาต์พุต ID ของโมเดล การตั้งค่าการให้เหตุผล และว่าคำขอได้ข้ามเกณฑ์ดังกล่าวหรือไม่ การบันทึกข้อมูลดังกล่าวจะสนับสนุนการสร้างโมเดลค่าใช้จ่ายที่สะท้อนความเป็นจริง และช่วยให้สามารถตรวจพบการเพิ่มขึ้นของบริบทที่เกิดขึ้นโดยไม่ได้ตั้งใจ ก่อนที่จะกลายเป็นค่าใช้จ่ายที่ไม่คาดคิดในแต่ละเดือน.
คำถามเกี่ยวกับการย้าย API ที่ควรดำเนินการทดสอบในสภาพแวดล้อม staging
ก่อนที่จะย้ายการบูรณาการที่มีอยู่ไปยัง GPT-6 Luna ให้สร้างระบบทดสอบชั่วคราว (staging harness) ที่สามารถเล่นซ้ำตัวอย่างขนาดเล็กที่ได้รับการทำให้ไม่ระบุตัวตนได้ เปรียบเทียบข้อความสุดท้าย ฟิลด์ที่มีโครงสร้าง การเรียกใช้เครื่องมือ เหตุผลที่หยุดการทำงาน และการใช้โทเคน อย่าเปรียบเทียบเพียงหน้าจอแรกของคำตอบเท่านั้น เพราะโมเดลอาจรักษาข้อสรุปที่ปรากฏให้เห็นไว้ได้ ในขณะที่เปลี่ยนชื่อฟิลด์ ละเว้นเงื่อนไขข้อผิดพลาด หรือส่งอาร์กิวเมนต์ของเครื่องมือที่แอปพลิเคชันไม่สามารถดำเนินการได้อย่างปลอดภัย.
"Responses" และ "Chat Completions" ไม่ใช่ชื่อที่สามารถใช้แทนกันได้ภายในแผนการบูรณาการ การสนับสนุนจุดปลายทาง (Endpoint), การตั้งค่าการให้เหตุผล, พฤติกรรมของเครื่องมือ, เหตุการณ์แบบสตรีมมิ่ง (streaming events) และอ็อบเจ็กต์ข้อผิดพลาด ล้วนมีผลกระทบต่อตัวเชื่อมต่อ (adapter) ให้กำหนด ID ของโมเดลในส่วนการตั้งค่า แต่ต้องให้มันปรากฏอยู่ในบันทึก (logs) และรายงานการทดสอบ เมื่อคำขอไม่สำเร็จ บันทึกควรแสดงจุดปลายทาง (endpoint) แบบจำลอง (model) ระดับความพยายามในการให้เหตุผล (reasoning effort) เวอร์ชันของข้อความนำ (prompt version) ขนาดคำขอ (request size) และการตัดสินใจในการลองใหม่ (retry decision) ข้อมูลเหล่านี้ช่วยให้วิศวกรสามารถจำลองความล้มเหลวได้ แทนที่จะต้องถกเถียงกันว่าแบบจำลองนั้นเพียงแค่มีวันที่ไม่ดีเท่านั้น.
การประมวลผลแบบกลุ่ม (Batch processing) เปลี่ยนแปลงด้านเศรษฐกิจและจังหวะการดำเนินงาน ซึ่งอาจเหมาะสมสำหรับการจัดประเภทข้อมูลในช่วงกลางคืน การเตรียมเอกสาร หรือคิวการแปลงข้อมูลที่มีความเร่งด่วนต่ำ แต่ไม่เหมาะสมสำหรับการดำเนินการแบบโต้ตอบที่ต้องการการตอบสนองต่อผู้ใช้ โหมดเร็วและโหมดระดับภูมิภาคยังส่งผลต่อการคำนวณราคาด้วย ควรพิจารณาตัวเลือกเหล่านี้เป็นตัวเลือกการตั้งค่าที่ชัดเจน และสะท้อนให้เห็นในแผ่นงานงบประมาณ แทนที่จะซ่อนไว้ในการตั้งค่าเริ่มต้น.
เล่นซ้ำข้อมูลนำเข้าจากตัวแทน ตรวจสอบความถูกต้องของผลลัพธ์ที่มีโครงสร้าง บันทึกอาร์กิวเมนต์ของเครื่องมือ เปรียบเทียบเหตุผลการหยุดทำงาน วัดการใช้โทเค็น และทดสอบเส้นทางความล้มเหลวหนึ่งทาง ก่อนที่จะเปลี่ยนค่าเริ่มต้นในระบบผลิต.
คุณภาพ ความปลอดภัย และค่าใช้จ่ายในการตรวจสอบ
ราคาโทเคนที่ต่ำลงไม่หมายความว่ารวมค่าใช้จ่ายจะต่ำลงโดยอัตโนมัติ และโมเดลที่มีราคาสูงลงไม่หมายความว่าจะให้ผลลัพธ์ทางธุรกิจที่ดีขึ้นโดยอัตโนมัติ รวมค่าใช้จ่ายนั้นรวมถึงการลองใหม่ การตรวจสอบโดยมนุษย์ การจัดการเหตุการณ์ และงานที่จำเป็นเพื่อซ่อมแซมข้อมูลในขั้นตอนต่อไป ตัวชี้วัดที่มีประโยชน์คือค่าใช้จ่ายต่อผลลัพธ์ที่ได้รับการยอมรับ โดยแบ่งตามกลุ่มงาน เส้นทางที่มีค่าใช้จ่ายต่อคำขอสูงกว่าเล็กน้อยก็ยังสามารถชนะได้หากช่วยลดงานซ่อมแซมในภารกิจที่มีผลกระทบสูง; ส่วนเส้นทางที่มีค่าใช้จ่ายต่ำมากสามารถชนะได้อย่างเด็ดขาดสำหรับการสกัดข้อมูลแบบกำหนดได้ (deterministic extraction) ที่มีการตรวจสอบความถูกต้องอย่างเข้มงวด.
ความเสี่ยงควรถูกจัดประเภทตามการดำเนินการ ไม่ใช่ตามแบรนด์ของโมเดล การอ่านเอกสารสาธารณะและการร่างสรุปนั้นแตกต่างจากการแก้ไขข้อมูลลูกค้า การอนุมัติการชำระเงิน การลบข้อมูล หรือการเผยแพร่คำแถลงทางกฎหมาย ให้วางการดำเนินการที่ไม่สามารถย้อนกลับได้ไว้หลังจุดตรวจสอบโดยมนุษย์ หรือขั้นตอนการตรวจสอบยืนยันอิสระครั้งที่สอง ให้ระบบโมเดลระบุความไม่แน่นอน แต่อย่าใช้ประโยคที่ฟังดูเหมือนมีความมั่นใจเป็นระบบอนุญาต.
คำถามเกี่ยวกับความเป็นส่วนตัวและการเก็บรักษาข้อมูลควรถูกนำเข้าสู่ขั้นตอนการตรวจสอบการปรับใช้ ให้ยืนยันว่าข้อมูลใดถูกส่งไป บันทึกถูกเก็บรักษาไว้นานเท่าใด ใครสามารถตรวจสอบข้อความคำสั่งได้ และคำขอมีข้อมูลลับหรือข้อมูลส่วนตัวหรือไม่ ให้ลบข้อมูลที่ระบุตัวตนได้เมื่อเป็นไปได้ ลดบริบทให้น้อยที่สุด และเก็บบันทึกไว้อย่างชัดเจนว่าสนามข้อมูลใดถูกลบออก การควบคุมเหล่านี้มีผลไม่ว่าโมเดลจะถูกใช้งานผ่าน API อย่างเป็นทางการหรือช่องทางอื่นที่เข้ากันได้.
วิธีเปรียบเทียบ GPT-6 Luna กับ GPT-6 Sol
การเปรียบเทียบที่ยุติธรรมจะรักษาให้งานและกฎการยอมรับคงที่ พร้อมทั้งให้แต่ละโมเดลได้ใช้จุดแข็งที่ระบุไว้ในเอกสารได้ ใช้แพ็กเก็ตข้อมูลเข้าเดียวกัน แต่บันทึกว่าโมเดลใดต้องการการตั้งค่าการให้เหตุผลที่ต่างกัน หรือจุดปลายทางที่ต่างกัน รายงานความแตกต่างอย่างชัดเจน: โมเดลหนึ่งอาจสร้างแพตช์ที่สมบูรณ์ยิ่งขึ้น โมเดลอื่นอาจมีค่าใช้จ่ายต่ำกว่าสำหรับการสกัดซ้ำ และโมเดลที่สามอาจง่ายต่อการบูรณาการมากขึ้น เนื่องจากสัญญาเครื่องมือของมันสอดคล้องกับอะแดปเตอร์ปัจจุบันของคุณ.
อย่าแปลงงานที่สำเร็จหนึ่งงานให้เป็นอันดับทั่วไป งานเล็กสามงานมีประโยชน์ในการค้นพบปัญหาเกี่ยวกับกระบวนการทำงาน ไม่ใช่เพื่อพิสูจน์ผู้ชนะที่เหมาะกับทุกกรณี ทำซ้ำงานด้วยข้อมูลนำเข้าที่สมจริงหลายชุด รวมถึงกรณีที่ขัดแย้งหรือไม่สมบูรณ์อย่างน้อยหนึ่งกรณี และกำหนดไว้ล่วงหน้าว่าอะไรถือว่าผ่าน หากตัวอย่างมีขนาดเล็กเกินไปที่จะสนับสนุนข้อสรุป ก็ควรระบุไว้อย่างชัดเจน ขอบเขตดังกล่าวจะช่วยเพิ่มความเชื่อถือแทนที่จะทำให้การประเมินอ่อนแอลง.
การเปิดตัวแบบเป็นขั้นตอนที่ช่วยให้การตัดสินใจสามารถย้อนกลับได้
เริ่มด้วยทราฟฟิกเงาหรือคิวที่ไม่สำคัญ ให้เส้นทางใหม่สร้างผลลัพธ์ออกมา ในขณะที่เส้นทางเดิมยังคงเป็นแหล่งข้อมูลหลัก เปรียบเทียบอัตราการยอมรับ ค่าใช้จ่ายโทเคน เวลาตรวจสอบ และประเภทความล้มเหลวในช่วงเวลาที่กำหนด จากนั้นย้ายกลุ่มงานทีละกลุ่ม โดยรักษาสวิตช์ย้อนกลับและแท็กเวอร์ชันที่ชัดเจน การเปิดตัวแบบเป็นขั้นตอนจะเปลี่ยนการเลือกโมเดลให้เป็นการเปลี่ยนแปลงทางวิศวกรรมที่สามารถสังเกตได้ แทนที่จะเป็นการเปลี่ยนแทนแบบวันเดียว.
ระหว่างการนำระบบไปใช้งาน ให้สังเกตการเปลี่ยนแปลงที่อาจไม่ปรากฏในอัตราผ่านแบบง่ายๆ เช่น ผลลัพธ์ที่ยาวขึ้น การเรียกใช้เครื่องมือมากขึ้น การส่งต่อปัญหาไปยังระดับที่สูงขึ้น หรือจำนวนคำขอที่เกินเกณฑ์บริบทยาว โมเดลอาจดูแม่นยำ แต่กลับใช้ทรัพยากรมากขึ้นหรือเพิ่มภาระงานของผู้ปฏิบัติงาน ให้ตั้งค่าการแจ้งเตือนสำหรับปัจจัยเหล่านี้ และตรวจสอบร่วมกับผู้ที่รับผิดชอบการจัดการกรณีผิดปกติโดยตรง.
ความสำเร็จนั้นเป็นอย่างไร
ความสำเร็จคือเส้นทางที่มั่นคง ซึ่งมีค่าใช้จ่ายที่ทราบได้ รูปแบบความล้มเหลวที่ชัดเจน และกระบวนการตรวจสอบที่ทุกคนสามารถปฏิบัติตามได้ มันไม่จำเป็นต้องแสร้งทำเป็นว่าโมเดลนั้นสมบูรณ์แบบ แต่ต้องรู้ว่างานใดที่โมเดลนี้จัดการได้ดี งานใดที่จำเป็นต้องใช้เส้นทางอื่น และวิธีหยุดหรือแก้ไขเมื่อข้อมูลเข้าไม่ครบถ้วน นั่นคือมาตรฐานทางปฏิบัติที่อยู่เบื้องหลังการสังเกตและเอกสารที่รวบรวมไว้ในการทบทวนครั้งนี้.
ปฏิกิริยาของสาธารณชนสามารถบอกคุณได้และบอกคุณไม่ได้อะไรบ้าง
แหล่งข้อมูลต่อไปนี้ถูกรวมไว้เพื่อแสดงปฏิกิริยาของสาธารณชนที่มีการระบุแหล่งที่มา ไม่ใช่เอกสารทางการหรือหลักฐานมาตรฐานที่ได้รับการควบคุม ชื่อของแต่ละแหล่งข้อมูลแสดงถึงสิ่งที่ผู้สร้างแต่ละคนเลือกที่จะทดสอบหรืออธิบาย; และไม่ได้แสดงถึงผลลัพธ์ของตลาดโดยรวม.
- Chase AI: GPT 6 Sol & Luna ได้เปิดตัวแล้ว (และ 50% ราคาถูกกว่า!). ให้มองการนำเสนอและทุกการสาธิตเป็นประสบการณ์ของผู้สร้างนั้นเอง ไม่ใช่เป็นมาตรฐานสากล.
- Rob The AI Guy: ChatGPT ได้เปิดตัว GPT-6 Sol และ GPT-6 Luna (รุ่นและเอเจนต์ใหม่ของ ChatGPT). ให้มองการนำเสนอและทุกการสาธิตเป็นประสบการณ์ของผู้สร้างนั้นเอง ไม่ใช่เป็นมาตรฐานสากล.
- AI ร่วมกับ Surya: GPT-6 Soul vs Luna vs Claude Opus 5.5: คุณควรใช้ตัวไหน?. ให้มองการนำเสนอและทุกการสาธิตเป็นประสบการณ์ของผู้สร้างนั้นเอง ไม่ใช่เป็นมาตรฐานสากล.
มีปัญหาเรื่องการตั้งชื่ออีกประเด็นหนึ่งที่สำคัญในที่นี้: วิดีโอสาธารณะหลายคลิปใช้ชื่อ “GPT-6” และ “GPT-5.6” สลับกันในหัวข้อวิดีโอ โปรดระบุรหัสโมเดลที่ถูกต้องให้ชัดเจนเมื่ออ้างอิงข้อมูลดังกล่าว การเปรียบเทียบระหว่าง GPT-6 Astra และ GPT-5.6 Sol เป็นตัวอย่างที่แสดงให้เห็นอย่างชัดเจนว่าทำไมข้อมูลเกี่ยวกับผู้ให้บริการ ชื่อแพลตฟอร์ม และเส้นทางจึงควรถูกบันทึกแยกกัน.
วิธีเข้าถึง GPT-6 Luna
เปิด พื้นที่ทำงาน GPT-6 Luna เริ่มด้วยงานที่คุณสามารถประเมินได้: ตัวอย่างโค้ดสั้นๆ แพ็กเก็ตต้นทางสั้นๆ หรือเอกสารสรุปการสกัดข้อมูลที่มีโครงสร้างชัดเจน ให้รักษาผลลัพธ์ที่ขอและกฎการยอมรับให้เห็นได้ชัดเจนขณะเปรียบเทียบเวอร์ชันต่างๆ ราคาโทเคนอย่างเป็นทางการข้างต้นอธิบายถึงการใช้งาน API โดยตรง ไม่ใช่คำสัญญาเกี่ยวกับเครดิตพื้นที่ทำงานหรือโควตาการสมัครสมาชิก.
สำหรับระบบการตั้งชื่อแพลตฟอร์มปัจจุบันและบริบทเครดิตที่แยกกัน โปรดดูที่ คู่มือราคา GPT-5.6 และ การเปรียบเทียบรุ่น GPT-5.6. หน้าเหล่านั้นเป็นบริบทของแพลตฟอร์ม/การบรรณาธิการ; พวกมันไม่ทับซ้อนกับตารางราคา API ของ OpenAI.
นำงานตัวอย่างมาและเปรียบเทียบผลลัพธ์กับเกณฑ์การยอมรับของคุณเอง.
เปิดพื้นที่ทำงาน GPT-6 Lunaใครควรเลือก GPT-6 Luna?
หากรายชื่อตัวเลือกของคุณมีตัวเลือกที่มีราคาถูกกว่าอยู่ด้วย ให้เปรียบเทียบ แคตตาล็อกรุ่นที่กว้างขึ้น แทนที่จะสมมติว่ารุ่นใหม่ที่สุดนั้นย่อมเป็นตัวเลือกที่คุ้มค่าที่สุดโดยอัตโนมัติ หากคุณกำลังประเมินงานที่ใช้ข้อมูลจำนวนมาก, แล้ว คู่มือแบบจำลองการวิเคราะห์ข้อมูล ให้มุมมองเกี่ยวกับกระบวนการทำงานที่แยกต่างหาก.
คำถามที่มักถูกถาม
GPT-6 Luna คืออะไร?
GPT-6 Luna เป็นโมเดลของ OpenAI ที่ออกแบบมาเพื่อทำงานเฉพาะทางและรองรับปริมาณงานสูง โดยรหัสโมเดล API อย่างเป็นทางการคือ gpt-6-luna.
GPT-6 Luna มีราคาเท่าไร?
OpenAI ระบุราคา GPT-6 Luna เป็น $0.10 ต่อ 1 ล้านโทเคนข้อมูลเข้า, $0.01 ต่อ 1 ล้านโทเคนข้อมูลเข้าที่เก็บในแคช, $0.125 ต่อ 1 ล้านครั้งเขียนแคช และ $0.50 ต่อ 1 ล้านโทเคนเอาต์พุต ตามอัตราค่าบริการมาตรฐาน.
จะเกิดอะไรขึ้นเมื่อจำนวนโทเคนเข้าเกิน 272K?
เมื่อคำขอมีจำนวนโทเคนอินพุตเกิน 272K OpenAI จะปรับใช้อัตราอินพุตและแคชเป็น 2 เท่า และอัตราเอาต์พุตเป็น 1.5 เท่า สำหรับคำขอทั้งหมด.
ข้อจำกัดด้านบริบทและผลลัพธ์คืออะไร?
GPT-6 Luna มีหน้าต่างบริบทขนาด 1,050,000 โทเคน ปริมาณข้อมูลเข้าสูงสุด 922,000 โทเคน และปริมาณข้อมูลออกสูงสุด 128,000 โทเคน.
เกณฑ์การตัดความรู้คืออะไร?
หน้าข้อมูลรุ่น OpenAI ปัจจุบันระบุวันที่ 18 พฤษภาคม 2026 เป็นวันที่ตัดข้อมูลความรู้ของ GPT-6 Luna.
มีตัวเลือกการตั้งค่าการให้เหตุผลใดบ้าง?
เอกสาร API ระบุระดับความยากในการวิเคราะห์เป็น none, low, medium, high, xhigh และ max โดย medium เป็นค่าเริ่มต้น.
API endpoints ใดที่ได้รับการสนับสนุน?
GPT-6 Luna รองรับฟังก์ชัน Chat Completions, Responses และ Batch อย่างไรก็ตาม หน้าข้อมูลของโมเดลนี้ไม่ได้ระบุว่ารองรับฟังก์ชัน Realtime, Assistants, audio, video, image generation, embeddings, fine-tuning, moderation หรือ Completions เวอร์ชันเก่า.
GPT-6 Luna สามารถรับภาพได้หรือไม่?
ใช่ครับ หน้าโมเดลดังกล่าวแสดงการป้อนข้อมูลแบบข้อความและภาพ พร้อมผลลัพธ์เป็นข้อความ ซึ่งสิ่งนี้ไม่ได้หมายความว่าโมเดลดังกล่าวเป็นโมเดลสร้างภาพ.
GPT-6 Luna มีให้ใช้ใน GlobalGPT หรือไม่?
ใช้หน้าโมเดล GPT-6 Luna ที่ระบุไว้ข้างต้น เครดิตพื้นที่ทำงานและโควตาตามแผนบริการนั้นแยกต่างหากจากอัตราค่าโทเคน API โดยตรงที่อธิบายไว้ในบทรีวิวนี้.
บทความนี้มีข้อมูลการเปรียบเทียบประสิทธิภาพหรือไม่?
ผลการทดลองนี้รวมถึงการสังเกตงานสามงานขนาดเล็ก ไม่ใช่การทดสอบมาตรฐานที่มีการควบคุม Luna จำเป็นต้องปรับคำสั่งการเขียนโค้ดใหม่เมื่อลองทำใหม่ ผลลัพธ์เหล่านี้ไม่ได้ชี้ให้เห็นผู้ชนะที่ชัดเจนหรือประสิทธิภาพในการใช้งานในขนาดใหญ่.
คำตัดสินสุดท้าย
Luna เป็นตัวเลือกที่เน้นความประหยัดและปฏิบัติได้จริงในตารางราคาอย่างเป็นทางการ: มันรักษาบริบทหลักและขีดจำกัดผลลัพธ์ไว้เหมือน Sol แต่คิดค่าบริการเพียงส่วนเล็กของอัตราโทเคน ซึ่งทำให้มันเป็นตัวเลือกที่น่าสนใจสำหรับการเรียกใช้ที่มุ่งเน้นและทำซ้ำบ่อยครั้ง แต่ราคาที่ต่ำนี้ไม่ใช่หลักฐานว่ามีความหน่วงเวลาที่ต่ำกว่าหรือคุณภาพที่ต่ำกว่า หากไม่มีการทดสอบอย่างควบคุม เลือกตามผลลัพธ์ที่ยอมรับได้และค่าใช้จ่ายการดำเนินงานรวม แล้วพิจารณาเลือกใหม่เมื่อปริมาณงานของคุณเปลี่ยนแปลง.
ตรวจสอบเมื่อวันที่ 23 กันยายน 2026 ข้อมูลอย่างเป็นทางการ: OpenAI Developers การตั้งชื่อเส้นทางบนแพลตฟอร์ม: GlobalGPT ปฏิกิริยาของสาธารณชน: ผู้สร้างและสื่อที่เกี่ยวข้อง ระบุแหล่งที่มาเท่านั้น.









