
Grok 4.7 เป็นการอัปเกรดที่สำคัญสำหรับงานเขียนโค้ดและงานด้านความรู้ แต่ข้อมูลยังอยู่ในขั้นเริ่มต้น: ทั้งคำกล่าวอ้างจากทางการเมื่อเปิดตัวและผลการทดสอบประสิทธิภาพจากแหล่งอิสระต่างชี้ให้เห็นถึงการปรับปรุง แต่ไม่ใช่ชัยชนะที่ครอบคลุมทุกด้าน.
คำตอบสั้นๆ
Grok 4.7 คือการอัปเกรดของ xAI ที่กำหนดเปิดตัวในวันที่ 21 กันยายน 2569 ซึ่งมุ่งเน้นไปที่งานเขียนโค้ดและงานความรู้ที่ซับซ้อน xAI ระบุว่าเวอร์ชันนี้ใช้เวลานานขึ้นในการแก้ปัญหาที่ยาก ตรวจสอบงานอย่างละเอียดมากขึ้น และเพิ่มชุดระบบป้องกันใหม่ โดยยังคงราคาและความเร็วเท่ากับ Grok 4.6 หน้าเปิดตัวยังนำเสนอว่าเวอร์ชันนี้เร็วกว่าสองเท่าและราคาถูกกว่าครึ่งหนึ่งของโมเดลที่เทียบเคียงได้ ซึ่งการเปรียบเทียบระหว่างผู้ผลิตนี้ควรอ่านควบคู่กับงานและวิธีการที่รองรับอยู่เบื้องหลัง ข้อมูลจาก Independent Artificial Analysis แสดงให้เห็นว่าโมเดลนี้มีการปรับปรุงประสิทธิภาพโดยรวมเล็กน้อยเมื่อเทียบกับ Grok 4.6 และบันทึกหน้าต่างบริบทขนาด 500K ในการทดสอบ API สามงานของเรา Grok 4.7 แสดงประสิทธิภาพสูงสุดในการดีบักและการรักษาขอบเขตของซอร์สโค้ด; แผนโครงการของมันรักษาความไม่แน่นอนได้ดี แต่มีความสามารถในการนำไปปฏิบัติได้น้อยกว่าที่ร้องขอ นี่เป็นหลักฐานเชิงปฏิบัติที่มีประโยชน์ ไม่ใช่หลักฐานที่แสดงว่ามันเอาชนะทุกโมเดลคู่แข่งได้.
Grok 4.7 คืออะไร?
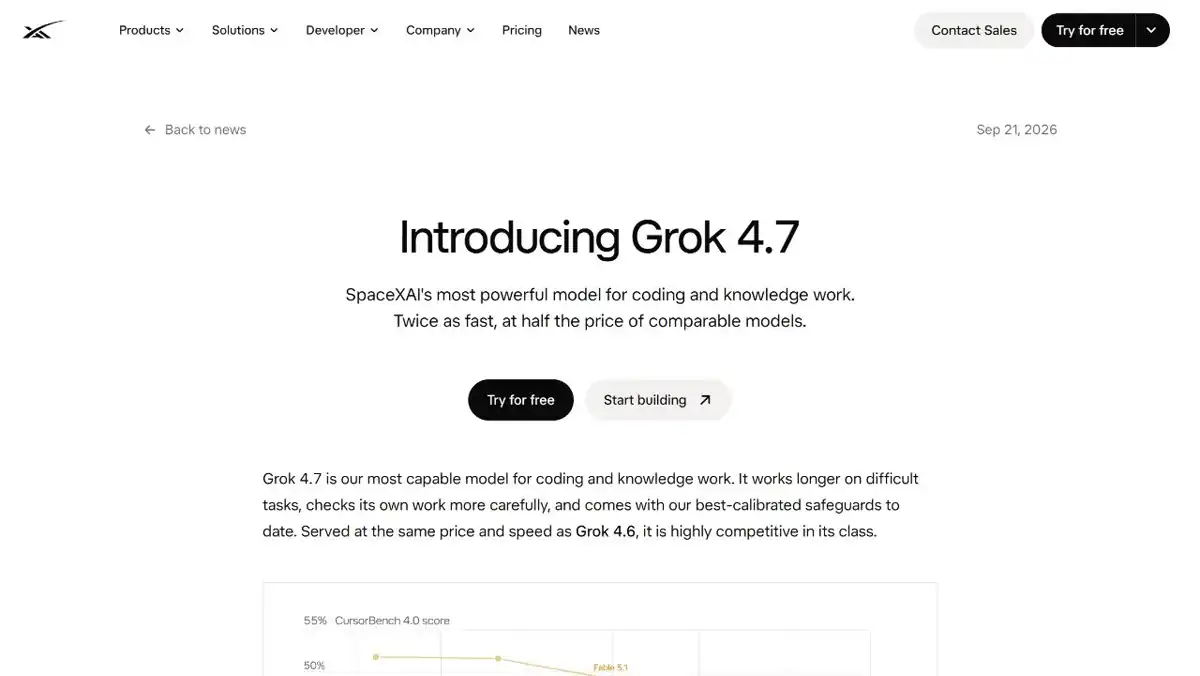
Grok 4.7 เป็นรุ่นล่าสุดในซีรีส์ Grok ของ xAI ซึ่งได้ประกาศออกเมื่อวันที่ 21 กันยายน 2026 รุ่นนี้ ประกาศอย่างเป็นทางการจาก xAI ซึ่งทำให้โมเดลนี้กลายเป็นโมเดลที่มีประสิทธิภาพสูงสุดของบริษัทสำหรับการเขียนโค้ดและงานด้านความรู้ การเปลี่ยนแปลงที่มีความหมายนี้ไม่ใช่การเพิ่มรายการคุณสมบัติใหม่ที่มุ่งเน้นผู้ใช้ แต่เป็นการเปลี่ยนแปลงในวิธีที่โมเดลนี้ถูกคาดหวังให้ใช้ความพยายาม: ใช้เวลามากขึ้นกับงานที่ยากขึ้น ตรวจสอบตัวเองบ่อยขึ้น และมีชั้นความปลอดภัยที่ออกแบบมาเพื่อทำให้ความสามารถเพิ่มเติมนี้สามารถควบคุมได้ดียิ่งขึ้น.
การกำหนดตำแหน่งนี้มีความสำคัญ เพราะมันอธิบายถึงโมเดลกระบวนการทำงานมากกว่าที่จะเป็นบุคลิกภาพของแชทบอท Grok 4.7 ถูกนำเสนอในฐานะโมเดลสำหรับงานที่เหมาะกับการวิเคราะห์อย่างต่อเนื่อง เช่น การแก้ไขข้อผิดพลาด การวางแผน การเขียนทางเทคนิค การสังเคราะห์ผลการวิจัย และคำสั่งที่ยาว ซึ่งต้องการให้โมเดลสามารถพิจารณาข้อจำกัดหลายประการไปพร้อมกัน.
ขอบเขตนี้มีความสำคัญไม่แพ้กัน การประกาศของ xAI เป็นคำชี้แจงจากผู้ผลิตเกี่ยวกับพฤติกรรมที่ตั้งใจไว้ ไม่ใช่หลักฐานอิสระที่พิสูจน์ว่า Grok 4.7 สามารถเอาชนะโมเดลคู่แข่งทุกตัว คำคำสั่งทุกแบบ หรือคลังโค้ดทุกแห่งได้ โปรดพิจารณาหน้าเปิดตัวเป็นแหล่งข้อมูลสำหรับสิ่งที่ xAI อ้างไว้ แล้วใช้การวัดผลอิสระและงานของคุณเองเพื่อตัดสินว่าคำกล่าวอ้างเหล่านั้นมีความสำคัญหรือไม่.
Grok 4.7 เทียบกับ Grok 4.6: มีอะไรที่เปลี่ยนแปลงไปบ้าง?
สรุปที่สามารถอธิบายได้อย่างชัดเจนที่สุดคือ การปรับปรุงด้านความพยายามและความน่าเชื่อถือ ไม่ใช่ผลิตภัณฑ์ที่แตกต่างไปอย่างสิ้นเชิง.
| พื้นที่ | Grok 4.7 | สิ่งที่หลักฐานสนับสนุน |
|---|---|---|
| ปล่อย | 21 กันยายน 2026 | วันที่ระบุไว้บนหน้าเปิดตัวอย่างเป็นทางการของ xAI |
| ตำแหน่งหลัก | งานเขียนโค้ดและงานด้านความรู้ | ตำแหน่งทางการของ xAI |
| งานที่ยาก | ต้องใช้เวลามากขึ้นและตรวจสอบตัวเองอย่างละเอียดมากขึ้น | คำอธิบายอย่างเป็นทางการจาก xAI; การทดสอบ API ของเราที่ประกอบด้วยสามงานนี้เป็นการทดลองใช้งานแบบสั้นๆ ไม่ใช่การเปรียบเทียบที่ตรงกัน |
| ความปลอดภัย | ชุดมาตรการป้องกันใหม่ | คำอธิบายอย่างเป็นทางการของ xAI |
| ราคาและความเร็ว | เหมือนกับ Grok 4.6 ตามข้อมูลจาก xAI | เป็นคำกล่าวอ้างเกี่ยวกับการเปิดตัว ไม่ใช่การตรวจสอบราคาจากฝ่ายที่สาม |
| บริบท | 500K โทเคนในโปรไฟล์ Artificial Analysis | โปรไฟล์แบบอิสระ; ตรวจสอบเส้นทางที่คุณใช้ |
| การควบคุมการให้เหตุผล | จากระดับต่ำถึงระดับสูงในรายชื่อของ Artificial Analysis | ข้อมูลเมตาดาต้าของเส้นทาง/โมเดลแบบอิสระ |
นี่เป็นจุดแตกต่างที่มีประโยชน์สำหรับผู้ซื้อ หาก Grok 4.6 ตรงกับกระบวนการทำงานของคุณแล้ว 4.7 ก็เป็นการอัปเกรดที่ราบรื่นและควรพิจารณา แต่หาก 4.6 ไม่ตรงกับความต้องการของคุณเนื่องจากปัญหาเกี่ยวกับระบบนิเวศ ความล่าช้า ความน่าเชื่อถือ หรือข้อจำกัดในการเข้าถึง การที่คะแนนเบนช์มาร์กสูงขึ้นเพียงอย่างเดียวก็ไม่สามารถแก้ไขปัญหาเหล่านั้นได้.
เพื่อสร้างกรอบงานการซื้อแบบจำลองที่กว้างขึ้น, คู่มือราคา GPT-5.6 และ การเปรียบเทียบ GPT-5.6 เป็นข้อเตือนที่มีประโยชน์ในการแยกคุณภาพของโมเดลออกจากด้านเศรษฐกิจของแผนงานและความเหมาะสมกับกระบวนการทำงาน.
คุณสมบัติ: Grok 4.7 ควรช่วยได้
การเขียนโค้ดและการแก้ไขข้อผิดพลาด
จุดเด่นที่สุดในการเปิดตัว xAI คือด้านการเขียนโค้ด คำสัญญาไม่ได้อยู่ที่เพียงว่า Grok 4.7 จะเขียนโค้ดได้มากขึ้น แต่ยังอยู่ที่ความสามารถที่จะจัดการกับปัญหาทางวิศวกรรมที่ซับซ้อนได้นานขึ้น ตรวจสอบคำตอบของตัวเอง และส่งคืนแพตช์หรือคำอธิบายที่ผ่านการพิจารณาอย่างรอบคอบมากขึ้น นี่คือพฤติกรรมที่ควรสังเกตในรีโพสิตอรีจริง: มันรักษาการออกแบบที่มีอยู่ไว้ได้หรือไม่, ระบุสาเหตุหลักได้หรือไม่, เพิ่มการทดสอบที่มีประโยชน์ได้หรือไม่, และระบุสิ่งที่มันยังไม่สามารถรู้ได้หรือไม่?
อย่าประเมินโมเดลด้วยคำสั่งแบบ greenfield เช่น “สร้างแอป To-Do” ให้มันรับข้อผิดพลาดที่มีขอบเขตชัดเจนพร้อมการทดสอบที่ล้มเหลว ชุดไฟล์ขนาดเล็ก และข้อจำกัดที่ชัดเจน ขอให้มันให้ผลการวินิจฉัยก่อนที่จะส่งแพตช์ สิ่งนี้ช่วยให้เห็นได้ง่ายขึ้นว่า การให้เหตุผลที่ยาวขึ้นนั้นช่วยลดงานตรวจสอบได้จริง หรือเพียงแต่ทำให้ข้อความยาวขึ้นเท่านั้น.
กฎเดียวกันนี้ใช้กับทีมที่เปรียบเทียบวิธีการเขียนโค้ดที่แตกต่างกันด้วย A รีวิว DeepSeek V4 Pro และ การทบทวนแผนการเขียนโค้ด GLM ให้บริบทการเปรียบเทียบที่มีประโยชน์ แต่ทั้งสองอย่างนี้ไม่ควรถูกใช้แทนการทดสอบรีโพสิตอรีและชุดเครื่องมือที่คุณใช้จริง.
งานที่ใช้ความรู้ในบริบทที่กว้างขวาง
Artificial Analysis ระบุว่ามีหน้าต่างบริบทขนาด 500K โทเคนสำหรับ Grok 4.7 ซึ่งขนาดนี้ใหญ่พอที่จะเปลี่ยนวิธีที่คุณจัดการกับงานที่มีข้อมูลต้นฉบับจำนวนมาก: ไม่ว่าจะเป็นข้อกำหนดทางเทคนิคที่ยาว ชุดบันทึกการประชุม ส่วนหนึ่งของฐานโค้ด หรือชุดข้อมูลวิจัย ก็สามารถอยู่ในบทสนทนาเดียวได้ โดยไม่ต้องสรุปซ้ำไปซ้ำมา.
ความจุของบริบทไม่เท่ากันกับคุณภาพของบริบท โมเดลอาจรับข้อมูลเข้าจำนวนมากได้ แต่ยังอาจพลาดข้อจำกัดที่อยู่ใกล้ส่วนกลาง ให้ความสำคัญมากเกินไปกับย่อหน้าสุดท้าย หรือสร้างบทสรุปที่ดูน่าเชื่อถือแต่จำเป็นต้องตรวจสอบแหล่งข้อมูล การทดสอบในทางปฏิบัติคือการค้นหาข้อมูลภายใต้ความกดดัน: วางข้อเท็จจริงสำคัญไม่กี่ข้อในส่วนต่าง ๆ ของเอกสารยาว ขอให้ตัดสินใจภายใต้ข้อจำกัด และตรวจสอบว่าคำตอบอ้างอิงถึงส่วนข้อความที่ถูกต้องหรือไม่.
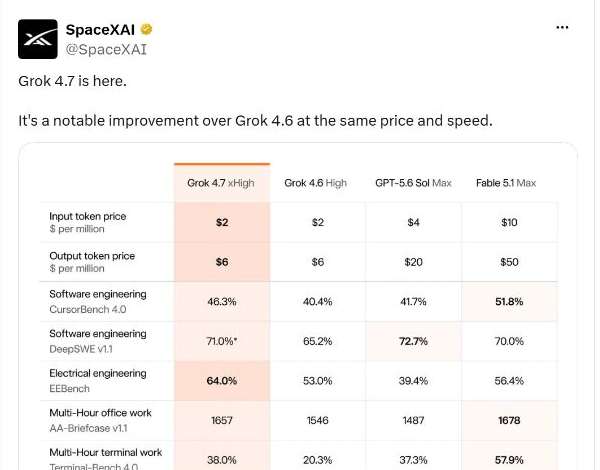
บัญชี X อย่างเป็นทางการของ SpaceXAI ได้นำกรอบการเปิดตัวมาเผยแพร่ซ้ำเมื่อวันที่ 22 กันยายน โดยระบุว่า Grok 4.7 เป็นความปรับปรุงที่โดดเด่นเมื่อเทียบกับ Grok 4.6 ในราคาและความเร็วที่เท่ากัน พร้อมทั้งแชร์ภาพเปรียบเทียบรุ่นต่าง ๆ โพสต์ดังกล่าวเป็นหลักฐานที่มีประโยชน์เกี่ยวกับตำแหน่งทางการตลาดของบริษัทต่อสาธารณะ ไม่ใช่การตรวจสอบจากฝ่ายอิสระหรือความเห็นพ้องของชุมชน.
หากใช้โมเดลนี้ในการวิจัย ให้รักษาวงจรหลักฐานให้เห็นได้ชัดเจน การเปรียบเทียบระหว่าง Gemini และ Perplexity และ คู่มือทางเลือกสำหรับ Perplexity ชี้ให้เห็นประเด็นทางปฏิบัติเดียวกัน: คำตอบที่เรียบเรียงอย่างดีนั้นไม่ใช่การตรวจสอบแหล่งข้อมูล.
การตรวจสอบด้วยตนเองและความปลอดภัย
xAI ระบุว่า Grok 4.7 ตรวจสอบงานของตัวเองอย่างละเอียดยิ่งขึ้น และนำระบบป้องกันใหม่มาใช้ ซึ่งเป้าหมายเหล่านี้มีค่ามาก โดยเฉพาะเมื่อโมเดลต้องตัดสินใจในกระบวนการที่ซับซ้อนและต่อเนื่องยาวนาน อย่างไรก็ตาม สิ่งเหล่านี้ไม่ใช่การรับประกันว่าผลลัพธ์จะถูกต้องหรือปลอดภัยสำหรับการดำเนินการอัตโนมัติ.
สำหรับการใช้งานในสภาพแวดล้อมการผลิต ให้รักษาขั้นตอนการควบคุมปกติไว้รอบตัวโมเดล ได้แก่ การทดสอบ การอนุญาต การตรวจสอบโดยมนุษย์ การตรวจสอบการอ้างอิง และเงื่อนไขการหยุดที่ชัดเจน การตรวจสอบตัวเองของโมเดลเป็นสัญญาณอีกหนึ่งที่ต้องตรวจสอบ ไม่ใช่สิ่งที่จะมาแทนที่ขั้นตอนการควบคุมรอบตัวโมเดล.
ผลการทดสอบประสิทธิภาพ Grok 4.7: ตัวเลขบอกอะไร
ผลการจัดอันดับที่แข็งแกร่ง โดยตารางอย่างเป็นทางการระบุว่า Grok 4.7 อยู่ในอันดับที่สูงกว่า Grok 4.6.
การเปรียบเทียบระหว่างรุ่นที่มีขนาดใหญ่กว่าแสดงให้เห็นถึงการปรับปรุงอย่างมีนัยสำคัญในเกณฑ์วัดประสิทธิภาพสำหรับงานที่ใช้ความรู้.
เป็นสัญญาณที่มีประโยชน์สำหรับกระบวนการทำงานที่ใช้เครื่องมือ แต่ยังคงเป็นการประเมินเพียงครั้งเดียวเท่านั้น ไม่ใช่คะแนนที่ใช้ได้ทั่วไป.
ดัชนีอิสระนี้ชี้ไปในทิศทางเดียวกัน: การปรับปรุง ไม่ใช่หลักฐานของการชนะอย่างทั่วถึง.
โปรดพิจารณาบัตรเหล่านี้เป็นข้อมูลชี้ทิศทาง การจัดองค์ประกอบของชุดข้อมูล การเข้าถึงเครื่องมือ การสุ่มตัวอย่าง และการตั้งค่าโมเดล อาจส่งผลให้อันดับเปลี่ยนแปลงได้.
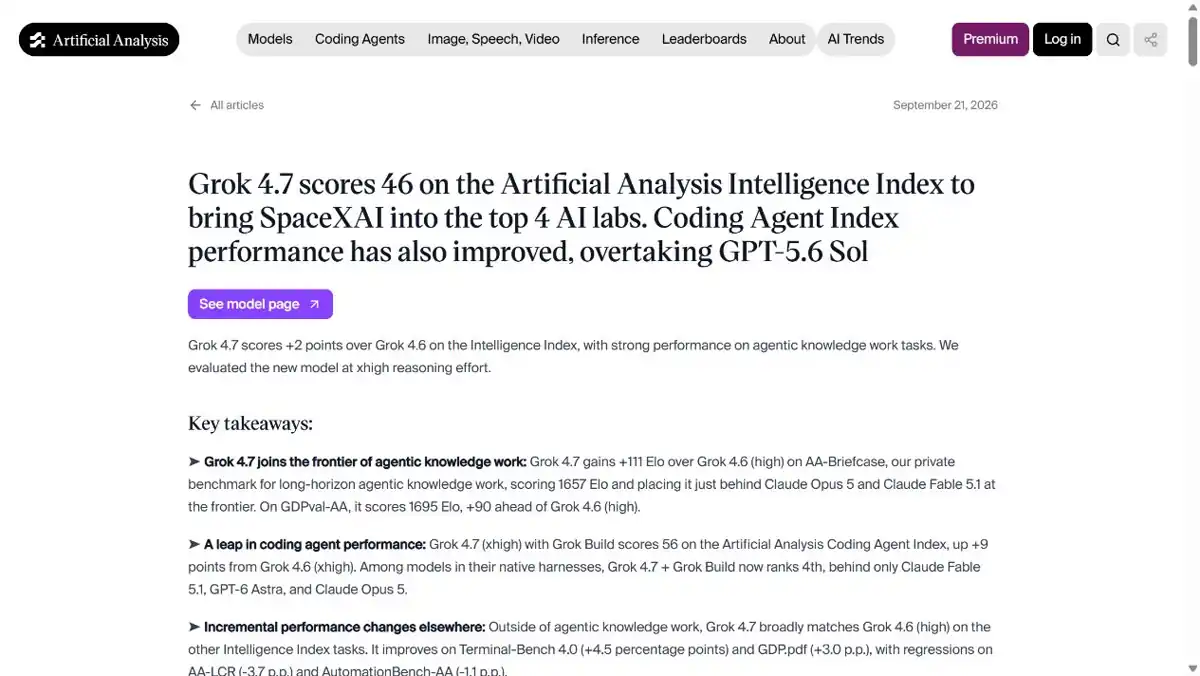
ภาพรวมอิสระที่มีประโยชน์ที่สุดในปัจจุบันมาจาก บทความเปรียบเทียบประสิทธิภาพของ Grok 4.7 จาก Artificial Analysis, ลงวันที่ 21 กันยายน 2569.
| วัด | ผลการรายงาน | วิธีอ่าน |
|---|---|---|
| ดัชนีปัญญาประดิษฐ์ด้านการวิเคราะห์ | 46 | สูงกว่า Grok 4.6 ในดัชนีเดียวกัน 2 จุด |
| AA-กระเป๋าเอกสาร | 1,657 Elo | 111 Elo สูงกว่า Grok 4.6 ในการประเมินนั้น |
| หน้าต่างบริบท | 500K โทเคน | สนามข้อมูลโปรไฟล์ของโมเดล ไม่ใช่หลักฐานที่แสดงถึงความสามารถในการค้นหาข้อมูลในบริบทยาวได้อย่างสมบูรณ์ |
| ความพยายามในการใช้เหตุผล | ต่ำ ถึง สูงสุด | การควบคุมระดับเส้นทางที่ระบุโดย Artificial Analysis |
ทิศทางนี้ดูน่าหวัง: ดัชนีอิสระแสดงให้เห็นถึงการปรับปรุงเมื่อเทียบกับเวอร์ชันก่อนหน้า และช่องว่าง Elo ที่กว้างขึ้นใน AA-Briefcase ชี้ให้เห็นถึงการปรับปรุงที่ชัดเจนยิ่งขึ้นในการประเมินนั้น แต่ตารางนี้ยังคงแสดงข้อมูลจากสองชุดข้อมูลเท่านั้น ไม่ใช่การจัดอันดับแบบสากล การจัดองค์ประกอบของข้อมูลอ้างอิง การเข้าถึงเครื่องมือ การสุ่มตัวอย่าง และการตั้งค่าโมเดล อาจส่งผลให้ผลลัพธ์เปลี่ยนแปลงได้.
หน้าเปิดตัวอย่างเป็นทางการของ xAI แสดง Grok 4.7 ที่ 46.3% บน CursorBench 4.0 ในตารางเปรียบเทียบของมัน พร้อมกับ Grok 4.6 ที่ 40.4%, GPT-5.6 Sol ที่ 41.7%, และ Fable 5.1 ที่ 51.8%. หน้านี้ยังแสดงผล 71.0% บน DeepSWE v1.1 ในระดับความพยายามสูง, 64.0% บน EEBench, และ 1,657 บน AA-Briefcase v1.1. ตัวเลขเหล่านี้เป็นข้อมูลเปรียบเทียบที่ผู้ผลิตนำเสนอ ดังนั้นควรพิจารณาว่าเป็นผลการรายงานอย่างเป็นทางการ ไม่ใช่การแทนที่การทดสอบซ้ำอย่างอิสระ ข้อสรุปที่ปลอดภัยกว่าคือ xAI มุ่งเน้นไปที่งานเขียนโค้ดระดับสูงและงานความรู้ระดับมืออาชีพ ในขณะที่การวัดผลอย่างอิสระแสดงให้เห็นการปรับปรุงอย่างมีนัยสำคัญในบางงาน และผลลัพธ์ที่ค่อนข้างคงที่ในงานอื่น ๆ.
บททดสอบ Grok 4.7 แบบปฏิบัติจริง: สามภารกิจปฏิบัติจริง
เราได้ใช้คำสั่งสามข้อที่กำหนดไว้ล่วงหน้ากับ grok-4.7 ID ของโมเดลผ่าน API การทดสอบที่รองรับ OpenAI เมื่อวันที่ 23 กันยายน 2026 นี่เป็นการประเมินแบบเส้นทางเดียว ไม่ใช่ API xAI แบบตรง และไม่ใช่การทดสอบกับคู่แข่งที่เทียบเท่า ผลลัพธ์ที่มองเห็นได้จากการทดสอบแต่ละครั้งถูกเก็บไว้ด้านล่างนี้ ส่วนบันทึกกระบวนการคิดที่เป็นข้อมูลส่วนตัวถูกยกเว้น.
| งาน | เวลาที่สังเกตได้ | ผลลัพธ์ |
|---|---|---|
| ข้อผิดพลาดด้านการทำงานพร้อมกันใน TypeScript | 333.7 วินาที, ถ่ายทอดสด | ผ่านการทดสอบอย่างสมบูรณ์: การวินิจฉัย shared-promise ที่ถูกต้อง, การแก้ไขโค้ดที่น้อยที่สุด, การทดสอบที่มีประโยชน์สองข้อ, และการกำหนดขอบเขตอย่างระมัดระวังเกี่ยวกับสิ่งที่โค้ดตัวอย่างนี้สามารถพิสูจน์ได้ |
| บันทึกการวิจัยที่ขัดแย้งกัน | 68.7 วินาที | ผ่านการตรวจสอบอย่างเข้มงวด: รักษาที่มาของข้อมูลไว้ คำนวณทั้งสองกรณีของค่าเผื่อ และปฏิเสธการอนุมัติจนกว่าจะตรวจสอบความขัดแย้งของแหล่งข้อมูลได้ |
| แผนหนึ่งสัปดาห์ที่ยุ่งเหยิง | 50.6 วินาที | ผ่านบางส่วน: ยังคงรักษากำหนดเวลาไว้, มีความขัดแย้ง, เจ้าของไม่ชัดเจน, และมีความเสี่ยง 5 ประการ แต่ยังไม่ได้แปลงงานเป็นแผนงานรายวันที่ชัดเจน |
ตัวเลขความล่าช้านี้อธิบายเฉพาะเส้นทางและคำสั่งเหล่านี้เท่านั้น งานการเขียนโค้ดนี้ถูกขัดจังหวะด้วยเวลาหมดอายุของเกตเวย์ที่ไม่ใช้การสตรีมมิ่งก่อน จากนั้นจึงเสร็จสิ้นเมื่อเปิดใช้งานการสตรีมมิ่ง นี่เป็นคำเตือนในการใช้งานจริงเกี่ยวกับการจัดการการส่งข้อมูลและเวลาหมดอายุ ไม่ใช่คะแนนความเร็วทั่วไปของ Grok ที่ 4.7.
การทดสอบ 1: การดีบักการทำงานพร้อมกันใน TypeScript
งาน 1 — การดีบักการทำงานพร้อมกันของตัวจัดการ API ใน TypeScript

ตัวจัดการ TypeScript ขนาดเล็กจะส่งคืน HTTP 200 พร้อมเนื้อหาที่ว่างเป็นระยะๆ เมื่อมีคำขอสองคำมาถึงในเวลาที่ใกล้กัน

ไฟล์ที่ให้มา:

src/cache.ts
```ts
let current: Promise | null = null;

export async function getPayload(load: () => Promise): Promise {
  if (!current) {
    current = load();
  }
  const value = await current;
  current = null;
  return value;
}
```

src/handler.ts
```ts
import { getPayload } from './cache';

export async function handler(load: () => Promise) {
  const payload = await getPayload(load);
  return { status: 200, body: payload };
}
```

อาการที่เกิดขึ้นในระบบผลิตจะเกิดขึ้นเป็นช่วงๆ เฉพาะเมื่อมีคำขอสองคำขอทับซ้อนกันเท่านั้น ตัวโหลดเองสามารถเรียกใช้พร้อมกันได้อย่างปลอดภัย และคืนค่า payload ที่ต่างกันสำหรับคำขอแต่ละคำขอ ไม่มีไฟล์อื่นใดที่พร้อมใช้งาน

ส่งส่วนต่อไปนี้เท่านั้น:
1. สาเหตุหลัก
2. แพตช์ที่ปลอดภัยและเล็กที่สุด (แสดง diff แบบรวม)
3. การทดสอบการถดถอยสองรายการ (โค้ดแบบ TypeScript หรือ Jest)
4. สมมติฐานและข้อจำกัด
อย่าอ้างว่าได้รันโค้ดแล้ว.1. สาเหตุหลัก
`current` เป็นสถานะระดับโมดูลที่ทุกการเรียกใช้ร่วมกัน ในรอบการทำงานของ JavaScript ครั้งหนึ่ง การตรวจสอบค่า null และการกำหนดค่าเป็นกระบวนการที่ดำเนินการพร้อมกัน (atomic) ดังนั้น การเรียกใช้สองครั้งที่ทับซ้อนกันจะไม่เรียก `load()` ทั้งสองครั้ง การเรียกใช้ครั้งแรกจะเก็บ promise ของตัวเองไว้ ส่วนการเรียกใช้ครั้งที่สองที่เข้ามา ก่อนที่ promise นั้นจะเสร็จสิ้น จะข้ามการเรียก `load()` ของตัวเองไป และรอรับ promise เดียวกันนั้น `handler` จะส่งคืน HTTP 200 ที่มี `body` เป็นสตริงจากการเรียกครั้งแรก ไม่ใช่ข้อมูลของคำขอครั้งที่สอง หน้าต่างนี้จะมีอยู่เฉพาะเมื่อคำขออยู่ระหว่างการประมวลผล ดังนั้นความล้มเหลวจึงปรากฏขึ้นเฉพาะเมื่อคำขอทับซ้อนกัน
`current = null` ทำงานในทุกการต่อเนื่องหลังจากที่ `await` ได้จับสัญญาไว้แล้ว มันไม่ทำให้ผู้รออีกคนต้องอ่านตัวแปรใหม่อีกครั้ง ดังนั้นไฟล์เหล่านี้เพียงอย่างเดียวจึงไม่ทำให้ผู้รอคนนั้นถูกกำหนดค่าเป็น `null` หรือ `""` สิ่งที่มันสร้างขึ้นเมื่อมีการทับซ้อนคือการกำหนดค่าที่แชร์กันและการข้ามการโหลดต่อคำขอ การเคลียร์นี้ยังทำให้สล็อตกลายเป็นแคชที่ไม่เหมาะสมสำหรับการเรียกใช้ครั้งเดียว: การต่อเนื่องครั้งแรกที่กลับมาทำงานจะทิ้ง `current` ไป และผู้เรียกใช้ในภายหลังสามารถเริ่ม `load()` ที่ต่างออกไปได้ ในขณะที่ผู้เรียกใช้อีกคนยังอยู่ในขั้นตอนการคลายตัว
2. การแก้ไขที่ปลอดภัยที่สุด (แสดง diff แบบรวม)
แต่ละคำขอต้องเรียก `load()` ด้วยตัวเอง การเรียก `load()` พร้อมกันได้รับอนุญาต และแต่ละครั้งจะคืนค่า payload ที่ต่างกัน ดังนั้นการลบข้อมูลซ้ำบน promise ที่แชร์ร่วมกันจึงไม่ปลอดภัย `handler.ts` ไม่จำเป็นต้องเปลี่ยนแปลง
```diff
--- a/src/cache.ts
+++ b/src/cache.ts
@@ -1,10 +1,3 @@
-let current: Promise | null = null;
-
export async function getPayload(load: () => Promise): Promise {
- if (!current) {
- current = load();
- }
- const value = await current;
- current = null;
- return value;
+ return await load();
}
```
3. การทดสอบการถดถอยสองรายการ (โค้ดแบบ TypeScript หรือ Jest)
```ts
import { handler } from '../src/handler';
function deferred() {
let resolve!: (value: T) => void;
let reject!: (reason: unknown) => void;
const promise = new Promise((res, rej) => {
resolve = res;
reject = rej;
});
return { promise, resolve, reject };
}
test('คำขอที่ทับซ้อนกันจะโหลดและเก็บเนื้อหาของตัวเองในแต่ละครั้งที่รัน', async () => {
const first = deferred();
const second = deferred();
const started: string[] = [];
const p1 = handler(() => {
started.push('a');
return first.promise;
});
const p2 = handler(() => {
started.push('b');
return second.promise;
});
expect(started).toEqual(['a', 'b']);
second.resolve('payload-b');
first.resolve('payload-a');
await expect(p1).resolves.toEqual({ status: 200, body: 'payload-a' });
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
test('การโหลดที่ทับซ้อนกันและถูกปฏิเสธจะไม่ส่งผลต่อการตอบสนองอื่น', async () => {
const failed = deferred();
const ok = deferred();
let started = 0;
const p1 = handler(() => {
started += 1;
return failed.promise;
});
const p2 = handler(() => {
started += 1;
return ok.promise;
});
expect(started).toBe(2);
failed.reject(new Error('upstream failed'));
ok.resolve('payload-b');
await expect(p1).rejects.toThrow('upstream failed');
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
```
4. ข้อสมมติและข้อจำกัด
ผมไม่ได้รันโค้ดนี้หรือการทดสอบ การทดสอบนี้สมมติว่าใช้ตัวรันแบบ Jest และมีไฟล์อยู่ในโฟลเดอร์พี่น้องของ `src/` (เช่น `test/cache.test.ts`)
ผมถือว่า “payload ที่ต่างกันสำหรับแต่ละคำขอ” เป็นข้อกำหนดที่การเรียก `getPayload` ที่ทับซ้อนกันต้องไม่ใช้ผลลัพธ์ `load()` เดียวกัน การเขียนใหม่แบบ single-flight ที่ถูกต้อง (`load().finally(() => { current = null; }); return current`) จะยังคงทำให้คำขอเหล่านั้นมีความเชื่อมโยงกัน ดังนั้นผมจึงไม่ใช้วิธีนี้ ไม่มีคีย์แคช และไม่มีการระบุข้อกำหนดการกำจัดข้อมูลซ้ำ
ตัวข้อความ HTTP ที่ว่างเปล่าตามค่าคงที่ (literal empty HTTP body) จะไม่ถูกเขียนโดยคำสั่งที่แสดงไว้ หาก `load` ส่งคืนสตริงที่ไม่ว่างเปล่า หากอาการดังกล่าวเกิดจากตัวปรับ (adapter) นอกไฟล์เหล่านี้ มันจะไม่ปรากฏให้เห็นที่นี่ แพตช์นี้เพียงแต่ลบการเชื่อมโยงที่ทับซ้อนกัน ซึ่งไฟล์เหล่านี้ได้นำไปใช้จริงเท่านั้น มันไม่เพิ่มการล็อก (locking), การลองใหม่ (retries) หรือแคชที่มีคีย์ (keyed cache).Grok 4.7 ได้ระบุอย่างถูกต้องว่าในระดับโมดูล ปัจจุบัน promise ทำให้คำขอที่ทับซ้อนกันต้องใช้ผลลัพธ์ของ loader เดียวกัน แม้ว่าคำขอแต่ละคำจะต้องการ payload ของตัวเองก็ตาม มันได้เสนอการเปลี่ยนแปลงที่ปลอดภัยและน้อยที่สุด: ลบ promise ที่ใช้ร่วมกันออก และเรียก load() ตามคำขอ การทดสอบการถดถอยทั้งสองครั้งนี้ครอบคลุมถึง payload ที่ทำงานพร้อมกันแต่แตกต่างกัน และการแยกกันเมื่อตัวโหลดตัวหนึ่งปฏิเสธ ส่วนที่แข็งแกร่งที่สุดของคำตอบคือความระมัดระวังของมัน: มันระบุอย่างชัดเจนว่าโค้ดที่แสดงมาพิสูจน์การเชื่อมโยงระหว่างคำขอ แต่ตัวมันเองไม่สามารถอธิบายได้ถึงกรณีที่ตัวเนื้อหาว่างเปล่าโดยแท้จริง หากตัวโหลดส่งคืนสตริงที่ไม่ว่างเสมอ.
คำตัดสิน: ผ่านการประเมินอย่างเข้มงวดในด้านความแม่นยำของสาเหตุหลัก ขอบเขตการแก้ไข ความครอบคลุมของการทดสอบการถดถอย และการจัดการความไม่แน่นอน.
การทดสอบที่ 2: บันทึกการวิจัยจากแหล่งข้อมูลที่ขัดแย้งกัน
งานที่ 2 — รวมบันทึกการวิจัยที่มีความขัดแย้งกันเป็นบันทึกการตัดสินใจ

ใช้บันทึกทั้งหกข้อนี้เท่านั้น และระบุชื่อแหล่งที่มาไว้ข้างๆ ทุกข้อความที่เป็นข้อเท็จจริง:

- ผู้ขาย A, หน้ากำหนดราคา, 2026-09-20: แพ็กเกจ Team มีราคา $40 ต่อที่นั่งต่อเดือน และรวม 100,000 การดำเนินการ
- ผู้ขาย B, บทความเปรียบเทียบ, 2026-09-21: แพ็กเกจ Team ของผู้ขาย A รวม 120,000 การดำเนินการต่อที่นั่งต่อเดือน
- สัมภาษณ์ลูกค้า, 2026-09-18: ทีมของเรา มี 8 ที่นั่ง และใช้ 710,000 การดำเนินการ เมื่อเดือนที่แล้ว
- สเปรดชีตการเงิน, 2026-09-19: วงเงินงบประมาณปัจจุบันคือ $360 ต่อเดือน
- ผู้ขาย A, หน้าจำกัด, 2026-09-20: การใช้งานเกินโควตาจะถูกคิดค่าบริการ $0.004 ต่อการดำเนินการ หลังจากใช้โควตาที่รวมไว้แล้ว
- หมายเหตุการจัดซื้อ, 22 กันยายน 2026: การเปลี่ยนผู้ให้บริการจะได้รับการยอมรับก็ต่อเมื่อยอดรวมรายเดือนอยู่ภายในงบประมาณและโควตาได้รับการยืนยันแล้ว

ส่งกลับส่วนต่อไปนี้ให้ตรงตามนี้:
1. ข้อเท็จจริงที่ได้รับการยืนยัน
2. ข้อเรียกร้องที่ได้รับการระบุ
3. ตารางความขัดแย้ง
4. การคำนวณอิสระ (คำนวณทั้ง 8 x 100,000 และ 8 x 120,000 พร้อมทั้งส่วนที่เกิน)
5. ข้อเสนอแนะ
6. คำถามเพื่อชี้แจงเพียงหนึ่งข้อเท่านั้น หากความขัดแย้งส่งผลต่อข้อเสนอแนะ
อย่าแก้ไขความขัดแย้งระหว่าง 100,000 กับ 120,000 โดยไม่แจ้งให้ทราบ.
1. ข้อมูลที่ได้รับการยืนยัน
- แพ็กเกจ Team มีราคา $40 ต่อที่นั่งต่อเดือน (ผู้จำหน่าย A, หน้ากำหนดราคา, 2026-09-20).
- ทีมมี 8 ที่นั่ง และใช้ 710,000 actions เมื่อเดือนที่แล้ว (การสัมภาษณ์ลูกค้า, 2026-09-18).
- วงเงินงบประมาณสูงสุดปัจจุบันคือ $360 ต่อเดือน (สเปรดชีตฝ่ายการเงิน, 2026-09-19)
- การใช้งานเกินโควตาจะถูกคิดค่าบริการ $0.004 ต่อแอคชัน หลังจากใช้โควตาที่กำหนด (ผู้ขาย A, หน้าข้อจำกัด, 2026-09-20)
- การเปลี่ยนผู้ให้บริการจะได้รับการยอมรับก็ต่อเมื่อยอดรวมรายเดือนอยู่ภายในงบประมาณและได้รับการยืนยันว่าใช้สิทธิ์ฟรีครบถ้วนแล้ว (บันทึกการจัดซื้อ, 22 กันยายน 2026)

2. ข้อเรียกร้องที่ระบุ
- ทีมรวม 100,000 การดำเนินการที่รวมอยู่ในแพ็กเกจ (ผู้ขาย A, หน้ากำหนดราคา, 2026-09-20) หมายเหตุดังกล่าวไม่ได้ระบุอย่างชัดเจนว่า “ต่อที่นั่ง”
- ทีมของผู้ขาย A มี 120,000 การดำเนินการต่อที่นั่งต่อเดือน (ผู้ขาย B, โพสต์เปรียบเทียบ, 2026-09-21).

3. ตารางความขัดแย้ง
| รายการ | ข้อเรียกร้อง | แหล่งที่มา | สถานะ |
| --- | --- | --- | --- |
| การดำเนินการที่รวม | 100,000 การดำเนินการที่รวม; ไม่ระบุ “ต่อที่นั่ง” | ผู้จำหน่าย A, หน้ากำหนดราคา, 2026-09-20 | ยังไม่ได้รับการแก้ไข |
| จำนวนการดำเนินการที่รวม | 120,000 การดำเนินการต่อที่นั่งต่อเดือน | ผู้จำหน่าย B, บทความเปรียบเทียบ, 21 กันยายน 2026 | ยังไม่ได้รับการแก้ไข |

ความขัดแย้งระหว่าง 100,000 กับ 120,000 ยังไม่ได้รับการแก้ไข หมายเหตุเหล่านี้ไม่ชี้ให้เห็นว่าตัวเลขใดถูกต้อง

4. การคำนวณอิสระ
ค่าใช้จ่ายพื้นฐานต่อที่นั่ง, เหมือนกันในทั้งสองสถานการณ์: 8 ที่นั่ง (การสัมภาษณ์ลูกค้า, 2026-09-18) × $40 ต่อที่นั่งต่อเดือน (ผู้ขาย A, หน้ากำหนดราคา, 2026-09-20) = $320 ต่อเดือน

ตัวคูณทั้งสองด้านล่างนี้ถูกคำนวณตามคำขอ ไม่ใช่ข้อค้นพบว่าผู้ขาย A ได้ระบุค่าจัดสรรต่อที่นั่ง

- 8 × 100,000 = 800,000 การดำเนินการที่รวมอยู่ โดยใช้ตัวเลข 100,000 (ผู้ขาย A, หน้ากำหนดราคา, 2026-09-20)
- การใช้งาน 710,000 (การสัมภาษณ์ลูกค้า, 2026-09-18) น้อยกว่า 800,000 จำนวน 90,000 ดังนั้น จำนวนการดำเนินการเกินโควตา = 0.
- ค่าเกิน = 0 × $0.004 = $0 (ผู้ขาย A, หน้าขีดจำกัด, 2026-09-20).
- รวมรายเดือน = $320 + $0 = $320 ซึ่งอยู่ภายในขีดจำกัดสูงสุด $360 (สเปรดชีตฝ่ายการเงิน, 2026-09-19)

- 8 × 120,000 = 960,000 ครั้งที่รวมไว้ โดยใช้ตัวเลข 120,000 (ผู้ขาย B, โพสต์เปรียบเทียบ, 2026-09-21).
- การใช้งาน 710,000 (การสัมภาษณ์ลูกค้า, 2026-09-18) ต่ำกว่า 960,000 เป็น 250,000 ดังนั้น จำนวนการดำเนินการเกิน = 0.
- ค่าเกิน = 0 × $0.004 = $0 (ผู้ขาย A, หน้าขีดจำกัด, 2026-09-20).
- รวมรายเดือน = $320 + $0 = $320 ซึ่งอยู่ภายในขีดจำกัดสูงสุด $360 (สเปรดชีตฝ่ายการเงิน, 2026-09-19)

5. ข้อเสนอแนะ
ยังไม่ควรอนุมัติการเปลี่ยนระบบในขณะนี้ ตามทั้งสองค่าจำกัดที่คำนวณไว้ การดำเนินการ 710,000 ครั้งของเดือนที่แล้ว (การสัมภาษณ์ลูกค้า, 2026-09-18) ไม่ก่อให้เกิดการเกินโควตา และผลรวมรายเดือนอยู่ที่ $320 ซึ่งอยู่ภายในขีดจำกัดสูงสุด $360 (สเปรดชีตฝ่ายการเงิน, 2026-09-19) ผลลัพธ์ด้านค่าใช้จ่ายนี้ไม่ขึ้นอยู่กับการเลือก 100,000 หรือ 120,000 การเปลี่ยนผู้ให้บริการยังคงไม่ผ่านเงื่อนไขข้อที่สอง: ต้องมีการตรวจสอบโควตา (บันทึกฝ่ายจัดซื้อ, 22 กันยายน 2026) และบันทึกเหล่านี้ระบุว่า 100,000 (ผู้ขาย A, หน้ากำหนดราคา, 2026-09-20) ยังคงขัดแย้งกับ 120,000 (ผู้ขาย B, โพสต์เปรียบเทียบ, 2026-09-21)

6. ถามเพื่อชี้แจงได้เพียงหนึ่งคำถามเท่านั้น หากความขัดแย้งดังกล่าวส่งผลให้คำแนะนำเปลี่ยนแปลง
ไม่มีคำถามเพื่อชี้แจง ความขัดแย้งระหว่าง 100,000 กับ 120,000 ไม่ส่งผลให้คำแนะนำเปลี่ยนแปลง.
ชุดข้อมูลการวิจัยได้สร้างความขัดแย้งอย่างจงใจเกี่ยวกับเรื่องว่าจำนวนการดำเนินการที่ได้รับอนุญาตคือ 100,000 หรือ 120,000 ครั้งต่อที่นั่ง Grok 4.7 ได้แยกแหล่งข้อมูลทั้งสองออกจากกัน สังเกตว่าแหล่งข้อมูลแรกไม่ได้ระบุอย่างชัดเจนว่า “ต่อที่นั่ง” ได้คำนวณทั้งสองสถานการณ์ที่มี 8 ที่นั่ง และแสดงให้เห็นว่าทั้งสองสถานการณ์ยังคงอยู่ที่ $320 โดยไม่มีการใช้เกินสำหรับปริมาณการใช้งานที่จัดหา มันยังคงแนะนำให้ระงับการอนุมัติ เนื่องจากฝ่ายจัดซื้อต้องการให้มีการตรวจสอบโควตาให้ชัดเจน นี่คือความแตกต่างที่ถูกต้องระหว่างคำแนะนำที่มีตัวเลขคงที่ กับข้อเท็จจริงทางสัญญาที่ยังไม่ได้รับการแก้ไข.
คำตัดสิน: ผ่านอย่างยอดเยี่ยมในด้านการระบุที่มา การคำนวณ การจัดการความขัดแย้ง และวินัยในการตัดสินใจ.
การทดสอบที่ 3: การแปลงบันทึกที่สับสนเป็นแผนการดำเนินการ
งานที่ 3 — แปลงบันทึกโครงการที่สับสนนี้ให้เป็นแผนการดำเนินการในหนึ่งสัปดาห์ โดยใช้ไม่เกิน 700 คำ

หมายเหตุ:
- เปิดหน้าแลนดิ้งเพจวันศุกร์เวลา 17:00; เจ้าของผลิตภัณฑ์ระบุในบันทึกต่อมาว่าวันพฤหัสบดีตอนเช้า
- Mina: เขียนหัวข้อและตารางราคา Mina ยังระบุว่าเธอสามารถตรวจสอบเนื้อหาได้เฉพาะวันพุธตอนบ่ายเท่านั้น
- Arjun: เหตุการณ์วิเคราะห์ข้อมูล; บันทึกซ้ำระบุว่าผู้รับผิดชอบด้านการวิเคราะห์ข้อมูลยังไม่ได้กำหนด
- ฝ่ายออกแบบมีงานซ้ำสองรายการ: “mobile hero crop” และ “mobile hero crop final”
- การตรวจสอบทางกฎหมายต้องดำเนินการก่อนการเปิดตัวสู่สาธารณะ
- ทีม QA ต้องการเวลาหนึ่งวันเต็มหลังจากที่เหตุการณ์วิเคราะห์พร้อมใช้งาน
- Omar จะไม่อยู่ในวันอังคารช่วงบ่าย
- อีเมลเปิดตัวกำหนดส่งในวันศุกร์เวลา 16:00
- ไม่ทราบ: ใครเป็นผู้ตัดสินใจขั้นสุดท้ายว่าจะดำเนินการต่อหรือไม่

ข้อกำหนด: รวมงานที่ซ้ำกัน, หมายเหตุผู้รับผิดชอบที่ยังไม่ทราบเป็น TBD, รักษาทั้งสองกำหนดเวลาที่ตายตัว, ชี้ให้เห็นความขัดแย้งแทนที่จะแก้ไขอย่างเงียบๆ, และจบด้วยรายการความเสี่ยง 5 ข้อ

ส่งกลับส่วนเหล่านี้เท่านั้น:
1. แผนหนึ่งสัปดาห์
2. ความขัดแย้งและข้อไม่ทราบ
3. ความเสี่ยง 5 ข้อ
อย่าสร้างผู้รับผิดชอบหรือวันที่ขึ้นมาเอง.
1. แผนงานหนึ่งสัปดาห์

ไม่มีวันที่ในบันทึก จึงไม่มีการเพิ่มวันที่ใดๆ ใช้เพียงจุดยึดและข้อพึ่งพาที่ระบุไว้เท่านั้น งานออกแบบที่ซ้ำกันถือเป็นงานหนึ่ง เจ้าหน้าที่ที่ยังไม่ทราบยังคงเป็น TBD เวลาเปิดตัวที่ขัดแย้งกันยังคงไว้ทั้งสอง

- เนื้อหา: Mina เป็นผู้เขียนหัวข้อและตารางราคา การตรวจสอบเนื้อหาของเธอจะดำเนินการเฉพาะวันพุธช่วงบ่ายเท่านั้น
- การออกแบบ: เป็นงานหนึ่งเดียว คือการตัดภาพส่วนหลักบนมือถือ (mobile hero crop) รวมถึงขั้นตอน “สุดท้าย” (final pass) ไม่มีการระบุผู้รับผิดชอบแยกต่างหาก
- เหตุการณ์วิเคราะห์ (Analytics events): ต้องมีอยู่ก่อนขั้นตอน QA ผู้รับผิดชอบยังไม่ได้รับการกำหนด (Arjun ในบันทึกหนึ่ง; TBD ในบันทึกอีกฉบับ)
- QA: หนึ่งวันเต็ม และทำเฉพาะเมื่อเหตุการณ์วิเคราะห์มีพร้อมแล้ว ผู้รับผิดชอบยังไม่ได้กำหนด (TBD) ยังไม่มีการกำหนดวัน QA ที่นี่
- การตรวจสอบทางกฎหมาย: จำเป็นต้องทำก่อนการเปิดตัวสู่สาธารณะ ผู้รับผิดชอบยังไม่ได้กำหนด (TBD) ยังไม่มีการกำหนดเวลาในบันทึก
- Go/no-go: ผู้รับผิดชอบยังไม่ได้กำหนด (TBD) ยังไม่ถือว่ามีการตัดสินใจแล้ว
- จุดยึดสำหรับการเปิดตัวสู่สาธารณะ ทั้งสองจุดยังคงเดิม: เช้าวันพฤหัสบดี (เจ้าของผลิตภัณฑ์) และวันศุกร์ 17:00 (หน้าแลนดิ้งเพจ)
- อีเมลแจ้งการเปิดตัว: วันศุกร์ 16:00 ผู้รับผิดชอบยังไม่ได้กำหนด
- Omar จะไม่อยู่ในวันอังคารช่วงบ่าย ไม่มีงานใดในบันทึกนี้ที่มอบหมายให้ Omar ดังนั้นจึงไม่มีการย้ายงานใดๆ

ลำดับขั้นตอน โดยไม่กำหนดวันที่ใหม่: ร่างของ Mina ต้องพร้อมสำหรับการทบทวนในวันพุธตอนบ่าย; ทีมออกแบบต้องเสร็จสิ้นการตัดภาพ Hero เดี่ยว; เหตุการณ์วิเคราะห์ต้องส่งโดยผู้รับผิดชอบที่ยังไม่กำหนด; QA จะได้รับเวลาหนึ่งวันเต็ม; การทบทวนทางกฎหมายต้องเสร็จสิ้นก่อนการเปิดตัวสู่สาธารณะ; การตัดสินใจ Go/No-Go (TBD) ยังไม่มีผู้รับผิดชอบ อย่าลบวันพฤหัสบดีเช้า วันศุกร์ 17:00 หรือวันศุกร์ 16:00

2. ความขัดแย้งและเรื่องที่ยังไม่ชัดเจน

ความขัดแย้ง (ยังไม่ได้รับการแก้ไข):
- การเปิดตัวหน้าแลนดิ้งเพจกำหนดไว้ที่วันศุกร์ 17:00 แต่ในบันทึกของเจ้าของผลิตภัณฑ์ที่เขียนภายหลังระบุว่าวันพฤหัสบดีเช้า
- ผู้รับผิดชอบด้านวิเคราะห์ข้อมูลในบันทึกหนึ่งคือ Arjun แต่ในบันทึกที่ซ้ำกันระบุว่า TBD

สิ่งที่ยังไม่ชัดเจน (ทำเครื่องหมาย TBD):
- ผู้รับผิดชอบการตัดสินใจขั้นสุดท้ายว่าจะดำเนินการหรือไม่
- ผู้รับผิดชอบด้านวิเคราะห์ข้อมูลที่ได้รับการยืนยันแล้ว
- ผู้รับผิดชอบการตรวจสอบทางกฎหมาย
- ผู้รับผิดชอบ QA
- ผู้รับผิดชอบอีเมลเปิดตัว
- ผู้รับผิดชอบด้านการออกแบบที่ระบุชื่อชัดเจนนอกเหนือจาก “Design”
- บทบาทของ Omar; ระบุเพียงว่าเขาจะขาดงานเฉพาะช่วงบ่ายวันอังคารเท่านั้น
- เวลาเปิดตัวใดเป็นเวลาที่ถูกต้อง และอีเมลวันศุกร์เวลา 16:00 ตรงกับเวลาใดหรือไม่ ไม่มีการระบุวันที่นอกเหนือจากเวลาในวันทำงานดังกล่าว

3. ห้าความเสี่ยง

1. ไม่สามารถกำหนดให้ทั้งวันพฤหัสบดีเช้าและวันศุกร์เวลา 17:00 เป็นเวลาเปิดตัวหน้าแลนดิ้งเพจได้พร้อมกัน; การใช้เวลาใดเวลาหนึ่งโดยไม่มีการตัดสินใจอาจทำให้เปิดตัวเร็วเกินไปหรือพลาดกำหนดเวลาอีกเวลาหนึ่ง
2. อีเมลแจ้งการเปิดตัวถูกกำหนดไว้สำหรับวันศุกร์เวลา 16:00 ก่อนเวลา 17:00 ของวันศุกร์ และไม่สอดคล้องกับบันทึกเกี่ยวกับเช้าวันพฤหัสบดี ดังนั้นอาจส่งไปพร้อมกับหน้าเว็บที่ยังไม่ถึงหรือไม่อยู่ในสถานะที่ตั้งใจไว้แล้ว
3. ความรับผิดชอบด้านวิเคราะห์ข้อมูล (Analytics) ยังมีการโต้แย้งกัน ดังนั้นเหตุการณ์อาจล่าช้า; ทีม QA ยังต้องการเวลาหนึ่งวันเต็มหลังการบันทึกเหตุการณ์ และอาจไม่ทันก่อนทั้งสองจุดกำหนดเวลาเปิดตัว
4. การตรวจสอบทางกฎหมายต้องดำเนินการก่อนการเปิดตัวสู่สาธารณะ แต่ยังไม่มีผู้รับผิดชอบหรือช่วงเวลาที่กำหนดไว้ ดังนั้นการเปิดตัวอาจถูกระงับหรือเกิดขึ้นโดยไม่ผ่านการตรวจสอบ
5. ยังไม่มีการกำหนดผู้รับผิดชอบในการตัดสินใจว่าจะดำเนินการต่อหรือยกเลิก ดังนั้นทั้งสองกำหนดเวลาที่เคร่งครัดจึงไม่มีบุคคลที่ระบุไว้เพื่ออนุมัติหรือหยุดการเปิดตัว.
Grok 4.7 ได้รวมงาน mobile-hero ที่ซ้ำกันไว้ รักษาความขัดแย้งในการเปิดตัวในวันพฤหัสบดีเช้าและวันศุกร์เวลา 17:00 ไว้ รักษาเส้นตายการส่งอีเมลวันศุกร์เวลา 16:00 ไว้ กำหนดผู้รับผิดชอบที่ยังไม่ได้รับการแก้ไขเป็น TBD และสิ้นสุดด้วยจำนวนความเสี่ยงที่พอดี 5 ข้อ โดยไม่สร้างวันที่ในปฏิทินหรือผู้รับผิดชอบใหม่ จุดอ่อนอยู่ที่ความสามารถในการดำเนินการ: แทนที่จะจัดสรรงานตามลำดับวันจันทร์ถึงวันศุกร์ มันกลับส่งคืนรายชื่อความพึ่งพาที่เรียงลำดับแล้ว และระบุว่าไม่สามารถกำหนดวัน QA ได้ ความระมัดระวังนี้สามารถอธิบายได้ แต่คำสั่งให้สร้างแผนการดำเนินการหนึ่งสัปดาห์ ดังนั้นคำตอบจึงตรงกับรูปแบบที่ขอมาเพียงบางส่วนเท่านั้น.
คำตัดสิน: ผ่านบางส่วน: การรักษาข้อจำกัดได้ดีมาก แต่ความมีประโยชน์ในการจัดตารางเวลาลดลง.
การเปลี่ยนแปลงของ Grok 4.7 ในกระบวนการทำงานจริง
วิธีที่มีประโยชน์ที่สุดในการวิเคราะห์การเปิดตัวนี้คือมองมันเป็นคำถามเกี่ยวกับกระบวนการทำงาน: ในจุดใดที่การให้เหตุผลอย่างต่อเนื่องช่วยลดงานตรวจสอบ และในจุดใดที่มันเพียงแต่สร้างคำตอบที่ยาวขึ้น? สามงาน API ดังกล่าวชี้ให้เห็นถึงรูปแบบการใช้งานที่ปฏิบัติได้จริง Grok 4.7 สามารถแสดงข้อจำกัดหลายข้อพร้อมกันได้อย่างสะดวกสบาย โดยเฉพาะเมื่อคำสั่งให้แยกข้อเท็จจริงออกจากสมมติฐาน อย่างไรก็ตาม ระบบนี้มีความน่าเชื่อถือน้อยลงเมื่องานต้องการปฏิทินหรือลำดับการดำเนินการที่ชัดเจน ซึ่งบันทึกต้นฉบับไม่ได้ระบุไว้อย่างครบถ้วน.
การเขียนโค้ดและการแก้ไขข้อผิดพลาด
สำหรับงานที่เกี่ยวข้องกับรีโพสิตอรี โมเดลนี้เหมาะสมกว่าสำหรับการวินิจฉัยที่มีขอบเขตชัดเจน มากกว่าสำหรับคำขอแบบเปิดกว้างอย่าง “สร้างแอป” ให้ชุดไฟล์ที่มีประโยชน์น้อยที่สุด อธิบายอาการความผิดพลาด และกำหนดให้ระบุสาเหตุหลักก่อนที่จะออกแพตช์ ขอให้ระบุการทดสอบที่จะล้มเหลวก่อนการเปลี่ยนแปลงและผ่านหลังการเปลี่ยนแปลง ในการทดสอบตัวจัดการของเรา คำตอบยังคงใกล้เคียงกับโค้ดที่ให้มา และไม่พยายามสร้างสาเหตุจากภายนอกสำหรับอาการตัวเนื้อหาว่าง.
พฤติกรรมดังกล่าวมีความสำคัญ เพราะคุณภาพการเขียนโค้ดไม่ใช่เพียงการสร้างโค้ดเท่านั้น การเขียนโค้ดที่มีประโยชน์ควรรักษาการออกแบบในส่วนท้องถิ่น จำกัดความแตกต่าง (diff) ระบุสมมติฐาน และทำให้การตรวจสอบเป็นไปได้อย่างประหยัด Grok 4.7 ได้ทำสิ่งเหล่านั้นในภารกิจเล็กๆ หนึ่ง แต่ภารกิจเดียวไม่สามารถสร้างความน่าเชื่อถือในระดับรีโพสิตอรีได้ ทีมควรใช้เกณฑ์การประเมินเดียวกันนี้กับข้อผิดพลาดจริง การปรับโครงสร้างโค้ด การเปลี่ยนแปลงหลายไฟล์ และเส้นทางที่เกี่ยวกับความปลอดภัย ก่อนที่จะย้ายงานไปยังระบบผลิตจริง.
การวิจัยและการสังเคราะห์ข้อมูลจากแหล่งต่าง ๆ
งานวิจัยนี้ได้เผยให้เห็นจุดแข็งอีกประการหนึ่ง: ความเคร่งครัดในการกำหนดขอบเขตของแหล่งข้อมูล Grok 4.7 ไม่ได้รวมข้อมูลการดำเนินการ 100,000 ครั้งที่ผู้ขายอ้างไว้กับตัวเลข 120,000 ครั้งของโพสต์เปรียบเทียบอย่างเงียบๆ นอกจากนี้ ยังสามารถแยกแยะการคำนวณที่คงที่ในทั้งสองสถานการณ์ออกจากเงื่อนไขการจัดซื้อที่ยังจำเป็นต้องตรวจสอบ.
นี่คือรูปแบบที่เหมาะสมสำหรับงานที่เน้นการวิจัย ให้ขอให้โมเดลติดป้ายกำกับข้อเท็จจริงที่ได้รับการยืนยัน ข้ออ้างที่มีแหล่งอ้างอิง ความขัดแย้งที่ยังไม่ได้รับการแก้ไข การคำนวณ และคำแนะนำอย่างแยกกัน บันทึกที่เขียนอย่างประณีตก็อาจผิดได้ หากมันแปลงข้ออ้างรองให้กลายเป็นข้อเท็จจริงที่ไม่ได้อ้างอิง Grok คำตอบของ 4.7 มีประโยชน์เพราะมันทำให้ความขัดแย้งยังคงปรากฏอยู่ แม้ว่าผลลัพธ์ทางคณิตศาสตร์จะไม่เปลี่ยนแปลง.
การวางแผนและการดำเนินงาน
ขั้นตอนการวางแผนคือจุดที่ข้อจำกัดเริ่มชัดเจนขึ้น โมเดลนี้ยังคงรักษาทุกกำหนดเวลาและเจ้าของที่ไม่ทราบชื่อไว้ แต่ยังไม่ถึงขั้นกำหนดตารางงานจากวันจันทร์ถึงวันศุกร์ ซึ่งวิธีนี้ปลอดภัยกว่าการกำหนดวันที่ขึ้นมาเอง แต่หมายความว่าผู้ใช้ยังคงต้องแปลงความสัมพันธ์แบบพึ่งพาเป็นการจัดสรรเวลาในปฏิทินเอง.
สำหรับคำแนะนำด้านการดำเนินงาน ให้ระบุช่วงเวลาการวางแผน วันทำงานที่มีอยู่ ความพร้อมของเจ้าของโครงการ และผู้ตัดสินใจ หากข้อมูลเหล่านี้ขาดหายไป ให้ขอแผนผังความสัมพันธ์ก่อน แล้วจึงขอปฏิทินในขั้นตอนถัดไป กระบวนการทำงานสองขั้นตอนนี้ช่วยให้คำเตือนของโมเดลมีประโยชน์ แทนที่จะมองว่าเป็นความล้มเหลวในการตัดสินใจ.
การค้นหาข้อมูลในบริบทที่ยาว
หน้าต่างบริบทขนาด 500K จะเปลี่ยนปริมาณข้อมูลที่สามารถรวมไว้ในคำขอเดียวได้ แต่ไม่เปลี่ยนสิ่งที่สามารถเชื่อถือได้โดยไม่ต้องตรวจสอบ งานที่มีบริบทยาวควรใช้การตรวจสอบการเรียกข้อมูล (retrieval probes): วางข้อเท็จจริงที่ชัดเจนไว้ใกล้ส่วนต้น ส่วนกลาง และส่วนท้ายของแพ็กเก็ต; เพิ่มความขัดแย้งที่ตั้งใจไว้หนึ่งจุด; แล้วขอการตัดสินใจพร้อมระบุตำแหน่งแหล่งที่มา วัดทั้งอัตราการเรียกคืน (recall) และวินัยขอบเขต (boundary discipline).
อย่าตัดสินเส้นทางที่มีบริบทยาวเพียงจากความสามารถในการรับคำขอขนาดใหญ่ ให้บันทึกจุดที่โมเดลพลาดข้อมูล ข้อเท็จจริง ว่ามันให้น้ำหนักมากเกินไปกับส่วนสุดท้ายหรือไม่ ความล่าช้าเพิ่มขึ้นเท่าใดตามขนาดข้อมูลเข้า และผู้ให้บริการตัดทอนหรือแปลงคำขอหรือไม่ หน้าต่างที่ประกาศไว้ขนาดใหญ่เป็นเพียงการอ้างอิงถึงขีดความสามารถ ไม่ใช่การรับประกันว่ากระบวนการให้เหตุผลจะคงที่เมื่อถึงขีดจำกัด.
วิธีประเมิน Grok 4.7 ด้วยตัวเอง
ใช้ชุดข้อมูลทดสอบขนาดเล็กที่สามารถทำซ้ำได้ ก่อนที่จะเปลี่ยนค่าเริ่มต้นในระบบผลิตจริง เป้าหมายไม่ใช่เพื่อสร้างตารางอันดับใหม่ แต่เพื่อเปรียบเทียบโมเดลกับกระบวนการกำหนดเส้นทางและตรวจสอบที่คุณได้ลงทุนไปแล้ว.
- ล็อคค่าอินพุต. บันทึกข้อความคำสั่งที่แม่นยำ ไฟล์ แพ็กเก็ตต้นทาง รหัสโมเดล อุณหภูมิ การตั้งค่าการให้เหตุผล และสิทธิ์การใช้งานเครื่องมือ อย่าเปรียบเทียบเส้นทางตรงกับเส้นทางของผู้ให้บริการ ขณะที่กำลังเปลี่ยนข้อความคำสั่งไปด้วย.
- ให้คะแนนผลงาน ไม่ใช่ข้อความ. สำหรับการเขียนโค้ด ให้ประเมินความแม่นยำในการระบุสาเหตุหลัก ขอบเขตการแก้ไข การทดสอบ และสมมติฐาน สำหรับการวิจัย ให้ประเมินขอบเขตการอ้างอิง การคำนวณ ความขัดแย้ง และคุณภาพของคำแนะนำ สำหรับการวางแผน ให้ประเมินการรักษาเส้นตาย ความรับผิดชอบ ความสัมพันธ์ระหว่างองค์ประกอบ และความสามารถในการนำไปปฏิบัติ.
- บันทึกการขนส่งแยกกัน. บันทึกเวลาจนถึงโทเค็นแรก (time-to-first-token), เวลารวม, โหมดสตรีม/ไม่สตรีม, สถานะ HTTP และพฤติกรรมการลองใหม่ลงในบันทึกเส้นทาง (route log) การหมดเวลาของเกตเวย์ (gateway timeout) ไม่ถือเป็นความล้มเหลวในระดับโมเดลโดยอัตโนมัติ แต่ยังคงเป็นค่าใช้จ่ายในการผลิต.
- ตรวจสอบพฤติกรรมเมื่อเกิดข้อผิดพลาด. ให้รวมข้อมูลเข้าที่คลุมเครือหนึ่งชุด แหล่งข้อมูลที่ขัดแย้งกันหนึ่งชุด และชุดข้อมูลที่ตั้งใจให้ไม่ครบถ้วนหนึ่งชุด คำถามที่สำคัญคือว่าโมเดลจะระบุความไม่แน่นอนหรือจะเติมช่องว่างด้วยการคาดการณ์ที่มั่นใจ.
- พิจารณาค่าใช้จ่ายและแรงงานไปพร้อมกัน. ติดตามโทเคนข้อมูลเข้า โทเคนข้อมูลออก ข้อมูลเข้าที่เก็บไว้ในแคช โทเคนการวิเคราะห์เมื่อถูกเปิดเผย และเวลาที่ใช้ในการตรวจสอบโดยมนุษย์ การตอบสนองที่มีค่าใช้จ่ายต่ำกว่าแต่ใช้เวลานานขึ้นสองเท่าในการตรวจสอบ อาจไม่ประหยัดกว่าในทางปฏิบัติ.
- ทำซ้ำก่อนที่จะเปลี่ยน. ให้รันแต่ละงานอย่างน้อยสองครั้ง หรือบนตัวอย่างที่แสดงถึงสถานการณ์ต่าง ๆ ก่อนที่จะเปลี่ยนค่าเริ่มต้นของทีม ให้เก็บคำตอบต้นฉบับที่แสดงอยู่และบันทึกการให้คะแนนไว้ เพื่อให้ผู้ตรวจสอบคนอื่นสามารถทำซ้ำการตัดสินใจได้.
การทดสอบสามครั้งในบทวิเคราะห์นี้ถือเป็นตัวอย่างเบื้องต้นเท่านั้น ไม่ใช่เพื่อแทนที่ชุดข้อมูลการประเมินของทีม มันแสดงให้เห็นว่า Grok 4.7 ทำงานอย่างไรในภารกิจเขียนโค้ดหนึ่งงาน บันทึกความขัดแย้งของแหล่งข้อมูลหนึ่งฉบับ และชุดข้อมูลการวางแผนหนึ่งชุด แต่ไม่ได้กำหนดอันดับทั่วไป.
Grok 4.7 ราคาและการเข้าถึง API
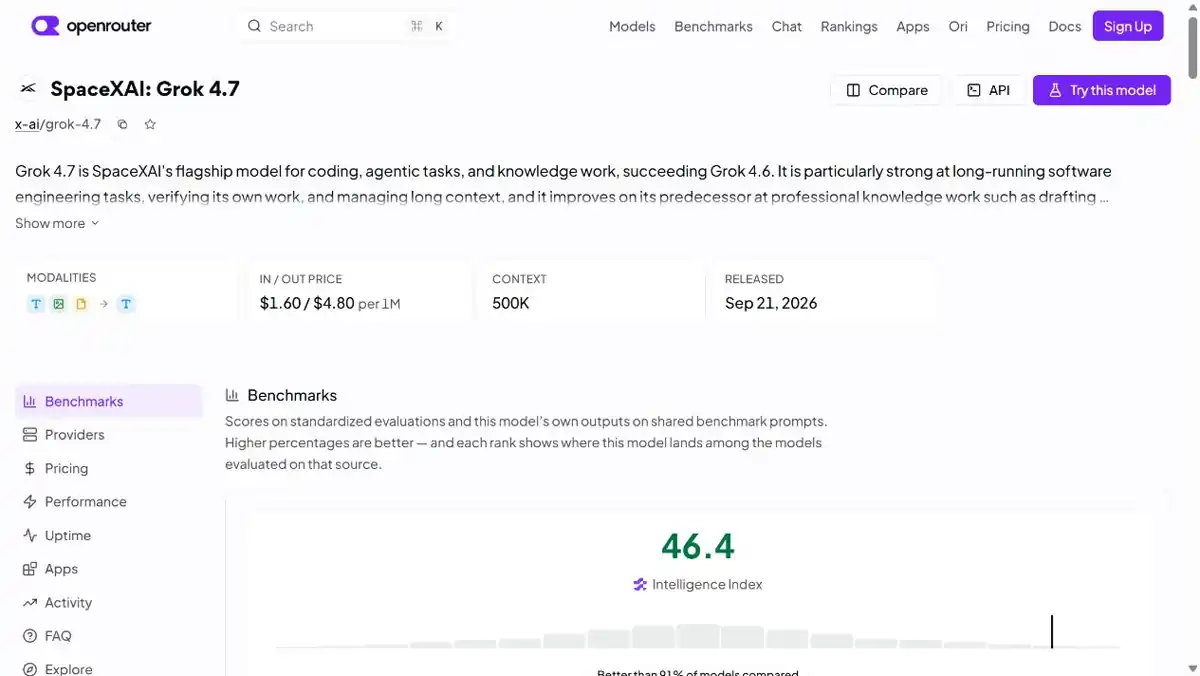
เรื่องราคาคือจุดที่บทวิจารณ์โมเดลมักก่อให้เกิดความเข้าใจผิด ผู้อ่านอาจเห็นตัวเลขที่แตกต่างกันอย่างน้อยสามประเภท ได้แก่ ราคา API โดยตรงของ xAI ราคาเส้นทางจากผู้ให้บริการรวมข้อมูล และราคาสมัครสมาชิกสำหรับผู้บริโภค ตัวเลขเหล่านี้ไม่สามารถใช้แทนกันได้.
ตามประกาศของ xAI รุ่น Grok 4.7 มีราคาและความเร็วที่เท่ากันกับรุ่น Grok 4.6 หน้าเปิดตัวระบุว่า รุ่นมาตรฐานมีราคาเริ่มต้นที่ $2 ต่อ 1 ล้านโทเคนเข้า และ $6 ต่อ 1 ล้านโทเคนออก; Artificial Analysis ได้แสดงข้อมูลเกี่ยวกับเส้นทางตรงเดียวกันนี้อย่างเป็นอิสระและ $0.50 ต่อ 1 ล้านโทเคนข้อมูลเข้าที่เก็บไว้ในแคช. xAI ยังระบุว่า รุ่นความเร็วสูงสามารถเพิ่มความเร็วในการประมวลผลเป็นสองเท่า แต่ราคาสูงขึ้นเป็นสองเท่าด้วย ใช้ เอกสารคู่มืออย่างเป็นทางการสำหรับผู้พัฒนา เพื่อตรวจสอบสัญญา API ปัจจุบันและความพร้อมใช้งานของบัญชีเฉพาะ ก่อนส่งข้อมูลจริง.
หน้า 4.7 ของ OpenRouter รุ่น Grok แสดง $1.60 ต่อ 1 ล้านโทเคนเข้า และ $4.80 ต่อ 1 ล้านโทเคนออก สำหรับเส้นทางนั้น นี่เป็นราคาของ OpenRouter/ผู้ให้บริการ ไม่ใช่การปรับราคาจากราคาขายตรงของ xAI การกำหนดเส้นทาง การเพิ่มราคา การเก็บข้อมูลในแคช ข้อจำกัด และความพร้อมใช้งานอาจแตกต่างกันไปตามผู้ให้บริการ.
ไม่มีคำตอบที่ถูกต้องเพียงคำตอบเดียวสำหรับคำถาม “Grok 4.7 ราคาเท่าไร?” โดยไม่ระบุเส้นทาง สำหรับผู้ซื้อ API ให้เปรียบเทียบ:
- อัตราโทเคนเข้าและออก;
- การประมวลผลข้อมูลที่เก็บไว้ในแคช;
- ข้อจำกัดด้านบริบทและผลลัพธ์;
- ขีดจำกัดอัตราและความพร้อมใช้งานตามภูมิภาค;
- ผู้ให้บริการเปิดเผยกลไกการควบคุมการให้เหตุผลหรือไม่;
- คำศัพท์เกี่ยวกับการบันทึก การเก็บรักษา และการประมวลผลข้อมูล.
สำหรับการเข้าถึงของผู้ใช้ อย่าสมมติว่าราคา API จะบอกราคาของแพ็กเกจ X หรือ Grok แผนบริการสำหรับผู้ใช้งาน เส้นทาง API และผู้ให้บริการรวมข้อมูลจากบุคคลที่สาม อาจมีกฎการเข้าถึงที่แตกต่างกัน.
คุณควรเลือก API route ใด?
| เส้นทาง | เหมาะที่สุดสำหรับ | สิ่งที่ต้องตรวจสอบก่อนใช้งาน | ข้อแลกเปลี่ยนหลัก |
|---|---|---|---|
| API Direct xAI | ระบบการผลิตที่จำเป็นต้องใช้สัญญาของผู้ให้บริการเอง | รหัสแบบอย่างอย่างเป็นทางการ, ข้อจำกัดอัตรา, เงื่อนไขข้อมูล, พื้นที่ให้บริการ, การสตรีมมิ่ง และราคาปัจจุบัน | ที่มาที่ชัดเจนที่สุด แต่คุณจัดการการเรียกเก็บเงินและสถานะความพร้อมใช้งานได้โดยตรง |
| โอเพ่นรูเตอร์ | การเปรียบเทียบผู้ให้บริการและทดลองเส้นทางอย่างรวดเร็ว | ผู้ให้บริการต้นทางจริง ราคาเส้นทาง การเก็บไว้ในแคช ความเป็นส่วนตัว บริบท และพฤติกรรมสำรอง | การเปลี่ยนบริการทำได้ง่ายขึ้น แต่เส้นทางไม่เหมือนกับบริการ xAI แบบตรง |
| API สำหรับการทดสอบที่รองรับ OpenAI | การประเมินภายใน หรือลูกค้าเดิมที่รองรับสคีมา OpenAI แล้ว | การแมปแบบจำลอง, ขีดจำกัดเวลาหมดอายุ, การสนับสนุนการสตรีม, สนามข้อมูลการใช้งาน, การเก็บรักษาข้อมูล, และนิยามข้อผิดพลาด | การผสานรวมที่สะดวก แต่ความเข้ากันได้ไม่รับประกันว่าผู้ให้บริการจะทำงานเหมือนกันทุกประการ |
เส้นทางที่สอดคล้องกันซึ่งใช้ในส่วนปฏิบัติได้ถูกส่งคืน grok-4.7 และสนับสนุนการสตรีมมิ่ง คำขอการเข้ารหัสแบบไม่สตรีมมิ่งได้เกินระยะเวลาการรอของเกตเวย์ ก่อนที่การลองใหม่แบบสตรีมมิ่งจะเสร็จสิ้น การสังเกตนี้มีประโยชน์ในการออกแบบไคลเอนต์ แต่ไม่ควรนำไปใช้โดยตรงในการอ้างอิงความล่าช้าของ xAI.
วิธีเข้าถึง Grok 4.7
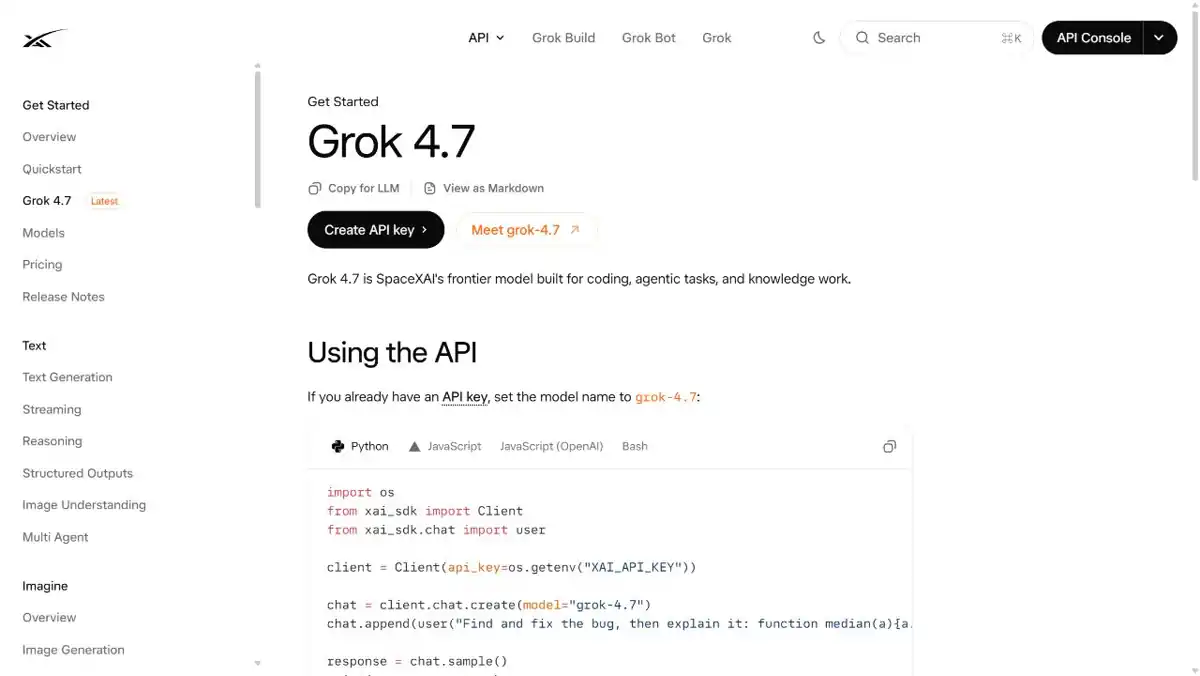
วิธีที่เรียบง่ายที่สุดคือเริ่มด้วย ประกาศจาก xAI และ หน้าผู้พัฒนา xAI, แล้วตรวจสอบว่าคุณต้องการ Grok Build, Cursor, API โดยตรง หรือตัวรวมข้อมูล xAI ระบุว่า Grok 4.7 มีให้บริการใน Cursor และ Grok Build ผ่าน API ของ Grok รวมถึงผ่านชุดเครื่องมือเขียนโค้ดของบุคคลที่สาม ตัวจัดการโมเดล และแพลตฟอร์มคลาวด์ ความแตกต่างเหล่านี้จะกำหนดวิธีการเรียกเก็บเงิน การควบคุมโมเดล เงื่อนไขความเป็นส่วนตัว และเครื่องมือที่มีให้ใช้งาน.
หากคุณใช้ตัวรวมข้อมูล (aggregator) ให้เปิดหน้าโมเดลของมันและตรวจสอบเส้นทางของผู้ให้บริการ ราคาโทเคน ขีดจำกัดบริบท และตัวระบุโมเดล ก่อนที่จะสร้างระบบขึ้นบนพื้นฐานนั้น OpenRouter เป็นหนึ่งในเส้นทางที่มีเอกสารบันทึกไว้ แต่ราคาของมันไม่ควรถูกคัดลอกเข้าไปในตารางการเรียกเก็บเงินของ xAI.
สำหรับผู้อ่านที่ต้องการเปรียบเทียบหลายกลุ่มรุ่นในพื้นที่ทำงานเดียวกัน, พื้นที่ทำงานแบบหลายโมเดลของ GlobalGPT สามารถเป็นประโยชน์ในการประเมินคำสั่งแบบเปรียบเทียบได้ บทความนี้ ไม่ ระบุว่าเส้นทาง Grok 4.7 มีให้บริการที่นั่นแล้ว อย่างไรก็ตาม ความพร้อมให้บริการของเส้นทางที่ระบุในแคตตาล็อกนั้นเป็นเรื่องที่แยกต่างหาก และควรตรวจสอบในหน้าผู้ใช้ของผลิตภัณฑ์ก่อนการซื้อ.
Grok 4.7 เทียบกับ ChatGPT, Claude และ Gemini
การวิเคราะห์นี้รวมถึงผลการทำงาน 3 ครั้งของ Grok 4.7 แต่ไม่มีผลการทดสอบที่เทียบเคียงกับ ChatGPT, Claude หรือ Gemini การสรุปแบบทั่วไปว่า “Grok 4.7 ชนะ” ยังคงเป็นการตลาด ไม่ใช่การวิเคราะห์ การเลือกที่เหมาะสมยิ่งขึ้นขึ้นอยู่กับงานที่เกี่ยวข้องกับโมเดล:
| หากสิ่งที่คุณให้ความสำคัญคือ... | เริ่มด้วยการประเมิน… | ทำไม |
|---|---|---|
| แพ็กเก็ตทางเทคนิคที่ยาว | Grok 4.7 และเส้นทางอื่น ๆ ที่มีบริบทกว้าง | ตรวจสอบความแม่นยำในการค้นหา ไม่ใช่เพียงช่วงเวลาที่โฆษณาไว้เท่านั้น |
| การแก้ไขข้อผิดพลาดใน Repository | Grok 4.7 ซึ่งเป็นโมเดลที่เน้นการเขียนโค้ด และวงจรทดสอบปกติของคุณ | เปรียบเทียบคุณภาพการวิเคราะห์สาเหตุหลักและเวลาการตรวจสอบ |
| การวิจัยที่ให้ความสำคัญกับแหล่งข้อมูลเป็นอันดับแรก | กระบวนการทำงานที่เน้นการวิจัย ร่วมกับแบบจำลองการให้เหตุผลทั่วไป | ตรวจสอบแหล่งอ้างอิงก่อนที่จะยอมรับข้อสรุป |
| การบูรณาการด้านประสิทธิภาพการทำงานที่มีอยู่ | แบบจำลองที่ได้รับการฝังไว้ในเครื่องมือของคุณแล้ว | ค่าใช้จ่ายในการเปลี่ยนผู้ให้บริการอาจสูงกว่าผลตอบแทนจากดัชนีอ้างอิง |
| ค่าบริการ API ต่ำที่สุด | เส้นทางตรงและเส้นทางผ่านผู้รวบรวมอยู่เคียงข้างกัน | ราคาจะแตกต่างกันไปตามผู้ให้บริการและพฤติกรรมการเก็บข้อมูลในแคช |
The “คู่มือ ”AI ตัวไหนที่คุ้มค่าที่จะจ่ายเงินซื้อ?” ใช้คำถามที่ถูกต้องในการตัดสินใจซื้อ: งานประจำใดที่จะพัฒนาขึ้นจนคุ้มค่ากับค่าสมัครสมาชิกหรือค่าบริการ API? นี่คือหลักการตัดสินใจที่มั่นคงกว่าการไล่ตามอันดับใหม่ล่าสุดในตารางผู้นำ.
ข้อจำกัดและคำถามที่ยังไม่มีคำตอบ
Grok 4.7 ยังใหม่เกินไปที่จะมีความเห็นพ้องต้องกันที่กว้างขวางและเป็นอิสระ ข้อมูลที่มีอยู่ยังทิ้งคำถามหลายข้อไว้:
- การปรับปรุงนี้มีความสม่ำเสมอเพียงใดในด้านการเขียนโค้ด การวิจัย การเขียน และงานแบบหลายรูปแบบ?
- บริบท 500K ยังคงเชื่อถือได้เมื่อใกล้ถึงขีดจำกัดหรือไม่ หรือว่าการดึงข้อมูลจะเริ่มเสื่อมลงก่อนถึงขีดจำกัดนั้น?
- ความล่าช้าเพิ่มเติมที่เกิดขึ้นจากความพยายามในการวิเคราะห์ระดับสูงสุดนั้นอยู่ที่เท่าใด?
- แผนบริการสำหรับผู้บริโภค ภูมิภาค เครื่องมือ และขีดจำกัดอัตราใดที่เปิดเผยโมเดลนี้?
- ระบบป้องกันใหม่ทำงานอย่างไรเมื่อใช้กับงานทางเทคนิคที่ถูกต้องตามกฎหมายแต่มีความละเอียดอ่อน?
- Direct xAI, OpenRouter และผู้ให้บริการอื่น ๆ ให้ผลลัพธ์หรือขีดจำกัดที่แตกต่างกันอย่างมีนัยสำคัญหรือไม่?
คำถามเหล่านั้นไม่ใช่เหตุผลที่จะปฏิเสธโมเดลดังกล่าว แต่เป็นเหตุผลที่ควรดำเนินการประเมินผลในขนาดเล็กแต่มีตัวแทนที่เพียงพอ ก่อนที่จะย้ายกระบวนการทำงานหรือสัญญาว่าจะประหยัดค่าใช้จ่าย.
ใครควรใช้ Grok 4.7?
Grok 4.7 ควรลองใช้ก่อนหากคุณ:
- ทำงานกับโค้ดเพื่อแก้ไขข้อผิดพลาดหรือวิเคราะห์เอกสารทางเทคนิคเป็นเวลานาน;
- ทำงานกับแพ็กเก็ตต้นทางที่มีขนาดเกินกว่าหน้าต่างแชทปกติ;
- ให้ค่ากับโมเดลที่พร้อมทุ่มเทความพยายามมากขึ้นกับคำสั่งที่ท้าทาย;
- สามารถตรวจสอบผลลัพธ์ก่อนที่จะส่งไปผลิตทันที;
- กำลังเปรียบเทียบด้านเศรษฐกิจของ API แบบตรงกับแบบผู้รวบรวมข้อมูล.
นี่อาจไม่ใช่ตัวเลือกที่เหมาะสมที่สุด หากคุณต้องการการบูรณาการที่สมบูรณ์ แผนการใช้งานที่ได้รับการบันทึกไว้อย่างชัดเจน หรือข้อได้เปรียบที่พิสูจน์แล้วในการทำงานเดียวกันเมื่อเทียบกับโมเดลที่มีอยู่ในระบบของคุณอยู่แล้ว ในกรณีดังกล่าว ชั้นการเข้าถึงและชั้นกระบวนการทำงานอาจมีความสำคัญมากกว่าการเพิ่มดัชนีเพียงสองจุด.
คำถามที่พบบ่อย
Grok 4.7 คืออะไร?
Grok 4.7 เป็นรุ่นที่ xAI ปล่อยออกมาเมื่อวันที่ 21 กันยายน 2026 สำหรับงานเขียนโค้ดและงานด้านความรู้ xAI ระบุว่า รุ่นนี้ทำงานได้นานขึ้นกับงานที่ยาก ตรวจสอบงานอย่างละเอียดยิ่งขึ้น และเพิ่มชุดระบบป้องกันใหม่ โดยยังคงราคาและความเร็วไว้เหมือนรุ่น Grok 4.6.
เวอร์ชัน Grok 4.7 ถูกปล่อยออกมาเมื่อไหร่?
xAI ได้ประกาศเปิดตัว Grok 4.7 เมื่อวันที่ 21 กันยายน 2569 หน้าเปิดตัวอย่างเป็นทางการและเอกสารสำหรับนักพัฒนาเป็นแหล่งข้อมูลที่ดีที่สุดเกี่ยวกับสถานะการปล่อยเวอร์ชัน ความพร้อมใช้งานของโมเดล และการเปลี่ยนแปลง API.
Grok 4.7 ดีกว่า Grok 4.6 หรือไม่?
Artificial Analysis รายงานว่าดัชนีความฉลาด (Intelligence Index) อยู่ที่ 46 ซึ่งสูงกว่า Grok 4.6 สองจุด และคะแนน Elo ของ AA-Briefcase อยู่ที่ 1,657 ซึ่งสูงกว่า 4.6 111 จุด นี่เป็นสัญญาณที่มีประโยชน์ แต่ไม่ใช่ผลลัพธ์ที่นำไปใช้ได้กับทุกกระบวนการทำงาน.
หน้าต่างบริบทของ Grok 4.7 คืออะไร?
Artificial Analysis ระบุว่ามีหน้าต่างบริบทขนาด 500K โทเคน สำหรับ Grok 4.7 หน้าต่างขนาดใหญ่ไม่รับประกันการค้นหาข้อมูลที่สมบูรณ์แบบ ดังนั้นควรทดสอบโมเดลด้วยข้อมูลที่วางอยู่ในจุดต่าง ๆ ของเอกสารยาว ก่อนที่จะใช้มันในงานที่มีข้อมูลต้นฉบับจำนวนมาก.
ราคาของ Grok 4.7 API เป็นเท่าไร?
Artificial Analysis ระบุว่าการเรียก API แบบตรงมีค่าใช้จ่าย $2 ต่อ 1 ล้านโทเคนอินพุต และ $6 ต่อ 1 ล้านโทเคนเอาต์พุต ส่วนการเรียก API ที่ใช้ข้อมูลอินพุตจากแคชมีค่าใช้จ่าย $0.50 ต่อ 1 ล้านโทเคน โปรดตรวจสอบเอกสาร xAI เวอร์ชันล่าสุดก่อนนำไปใช้ในระบบผลิตจริง.
ราคาของ OpenRouter รุ่น Grok 4.7 เท่ากับของ xAI หรือไม่?
ไม่ OpenRouter ระบุราคา $1.60 ต่อ 1 ล้านโทเคนเข้า และ $4.80 ต่อ 1 ล้านโทเคนออก สำหรับเส้นทางดังกล่าว นี่เป็นราคาเฉพาะของผู้ให้บริการ และควรเปรียบเทียบแยกต่างหากจากราคา API โดยตรงของ xAI OpenRouter ยังแสดงข้อมูลเฉพาะของผู้ให้บริการ เช่น แคช ความล่าช้า ปริมาณข้อมูลที่ผ่าน และข้อมูลด้านความเป็นส่วนตัว ซึ่งอาจส่งผลให้ต้นทุนจริงของเส้นทางเปลี่ยนแปลงได้.
ทำอย่างไรจึงสามารถเข้าถึง Grok 4.7 ได้?
เริ่มจากประกาศอย่างเป็นทางการและเอกสารสำหรับนักพัฒนาของ xAI แล้วเลือกผลิตภัณฑ์ Grok สำหรับผู้บริโภค API ของ xAI โดยตรง หรือตัวรวมบริการ (aggregator) เช่น OpenRouter ตรวจสอบ ID ของโมเดล ภูมิภาค ข้อจำกัดอัตราการใช้งาน (rate limits) บริบท (context) และระบบการเรียกเก็บเงินบนเส้นทางที่คุณวางแผนจะใช้จริง.
รุ่น Grok 4.7 มีให้ใช้บนรุ่น GlobalGPT ได้หรือไม่?
บทรีวิวนี้ไม่ได้ยืนยันว่าเส้นทาง Grok 4.7 บน GlobalGPT ได้รับการตรวจสอบแล้ว GlobalGPT สามารถใช้เพื่อเปรียบเทียบกลุ่มรุ่นที่มีอยู่ได้ แต่ควรตรวจสอบแคตตาล็อกปัจจุบันและความพร้อมของรุ่นที่แน่นอนในหน้าผู้ใช้ของผลิตภัณฑ์ก่อนการซื้อ.
Grok 4.7 เหมาะสำหรับการเขียนโค้ดเอเจนต์หรือไม่?
การทดสอบนี้มีความสำคัญสำหรับการดีบักแบบจำกัดขอบเขต การตรวจสอบโค้ด และการวิเคราะห์หลายไฟล์ ซึ่งเอเจนต์ต้องอธิบายสมมติฐานและสร้างการทดสอบได้ งานเขียนโค้ดแบบปฏิบัติจริงนั้นมีความเข้มข้น แต่ไม่ได้ทดสอบการดำเนินการของเครื่องมือ การแก้ไขรีโพสิตอรี สิทธิ์การเข้าถึง หรือวงจรการทำงานของเอเจนต์อย่างครบถ้วน.
ทำไมการทดสอบการเขียนโค้ดจึงต้องใช้การสตรีมมิ่ง?
คำขอแรกที่ไม่ใช้การสตรีมได้เกินระยะเวลาการรอของเกตเวย์ในเส้นทางทดสอบ ส่วนคำขอเดียวกันนี้เสร็จสิ้นได้เมื่อเปิดใช้งานการสตรีม สิ่งนี้แสดงให้เห็นว่าทำไมลูกค้าในระบบผลิตจึงควรสนับสนุนการสตรีมและกำหนดเวลาหมดอายุอย่างชัดเจน แต่ไม่ได้พิสูจน์ว่าทุกเส้นทาง Grok 4.7 จะมีพฤติกรรมความล่าช้าที่เหมือนกัน.
ควรทดสอบหน้าต่างบริบท 500K อย่างไร?
ใช้แพ็กเก็ตคงที่ที่มีข้อมูลสำคัญจัดวางไว้ที่ต้น กลาง และท้าย พร้อมทั้งความขัดแย้งที่สร้างขึ้นอย่างจงใจ หนึ่งจุด ตรวจสอบตำแหน่งแหล่งข้อมูลและให้คะแนนด้านการจดจำ การจัดการความขัดแย้ง และเวลาตอบสนอง สำหรับขนาดข้อมูลเข้าหลายระดับ แทนที่จะพึ่งพาเพียงค่าสูงสุดที่โฆษณาไว้เท่านั้น.
Grok 4.7 คุ้มค่าที่จะอัปเกรดจาก Grok 4.6 หรือไม่?
ข้อมูลเบื้องต้นชี้ให้เห็นว่าการอัปเกรดครั้งนี้มีประโยชน์อย่างมีนัยสำคัญแต่เป็นแบบค่อยเป็นค่อยไป: ผลการวัดแบบอิสระดีขึ้น และผลการทดสอบจริงแสดงให้เห็นประสิทธิภาพที่ดีในการแก้ไขข้อผิดพลาดและการสังเคราะห์แหล่งที่มา ควรอัปเกรดก็ต่อเมื่องานของคุณเองแสดงให้เห็นว่าความพยายามในการตรวจสอบลดลง หรือความแม่นยำเพิ่มขึ้น ด้วยค่าใช้จ่ายที่เฉพาะเจาะจงต่อเส้นทาง ซึ่งคุณสามารถอธิบายเหตุผลได้.
คำตัดสินสุดท้าย
Grok 4.7 ดูเหมือนเป็นการอัปเกรดโมเดลที่จริงจังและค่อยเป็นค่อยไป โดยมีเป้าหมายที่ชัดเจน: งานเขียนโค้ดและงานด้านความรู้ที่ให้ผลตอบแทนจากความพยายามอย่างต่อเนื่อง การประกาศอย่างเป็นทางการให้คำอธิบายที่น่าเชื่อถือสำหรับความเปลี่ยนแปลงนี้ ตัวเลขเบื้องต้นจาก Artificial Analysis แสดงให้เห็นถึงการปรับปรุงเมื่อเทียบกับ Grok 4.6 แทนที่จะเป็นการถดถอย และการทดสอบ API ของเรายังเพิ่มสัญญาณเชิงปฏิบัติที่เล็กน้อยอีกด้วย โมเดลนี้จัดการกับข้อผิดพลาดด้านการทำงานพร้อมกันและเมโมที่มีแหล่งข้อมูลขัดแย้งได้อย่างดีเป็นพิเศษ; คำตอบด้านการวางแผนของมันมีความระมัดระวัง แต่ยังไม่เป็นไปตามความต้องการในด้านการปฏิบัติเท่าที่ควร.
ผลประเมินที่ตรงไปตรงมายังคงเป็นเพียงผลเบื้องต้นเท่านั้น นี่คือการทดสอบสามครั้งบนเส้นทางทดสอบเดียวกัน โดยงานที่ช้าที่สุดต้องใช้การสตรีมมิ่งหลังจากเวลาหมดอายุของเกตเวย์ที่ไม่รองรับการสตรีมมิ่ง และยังไม่มีผลการทดสอบจากคู่แข่งที่เทียบเคียงได้ หรือความเห็นพ้องต้องกันจากแหล่งอิสระที่กว้างขวาง เริ่มด้วยงานที่ยากหนึ่งงานจากกระบวนการทำงานจริงของคุณ เปรียบเทียบผลลัพธ์และเวลาตรวจสอบกับโมเดลที่คุณใช้อยู่แล้ว แล้วจึงตัดสินใจว่าการอัปเกรดนี้คุ้มค่ากับค่าใช้จ่ายเฉพาะเส้นทางหรือไม่.









