คู่มือปฏิบัติปี 2026 สำหรับการเลือกตามความเร็ว ค่าใช้จ่าย API บริบท ความซับซ้อนของงาน และค่าใช้จ่ายจากการตอบผิด.
สำหรับงานเขียน การวิเคราะห์ การเขียนโค้ด และการใช้เครื่องมือในชีวิตประจำวันส่วนใหญ่ ให้เริ่มต้นด้วย Claude Sonnet 5 ให้เลือก Haiku 4.5 เมื่อความหน่วงต่ำและปริมาณงานสูงมีความสำคัญมากกว่าการจัดการกรณีขอบที่ยาก เลือก Opus 5 เมื่องานมีความซับซ้อน ยากต่อการตรวจสอบ หรือมีค่าใช้จ่ายสูงหากเกิดข้อผิดพลาด Fable 5.1 อยู่เหนือ Opus ในฐานะเส้นทางปรับระดับสำหรับกรณีเฉพาะ ไม่ใช่ค่าเริ่มต้น.
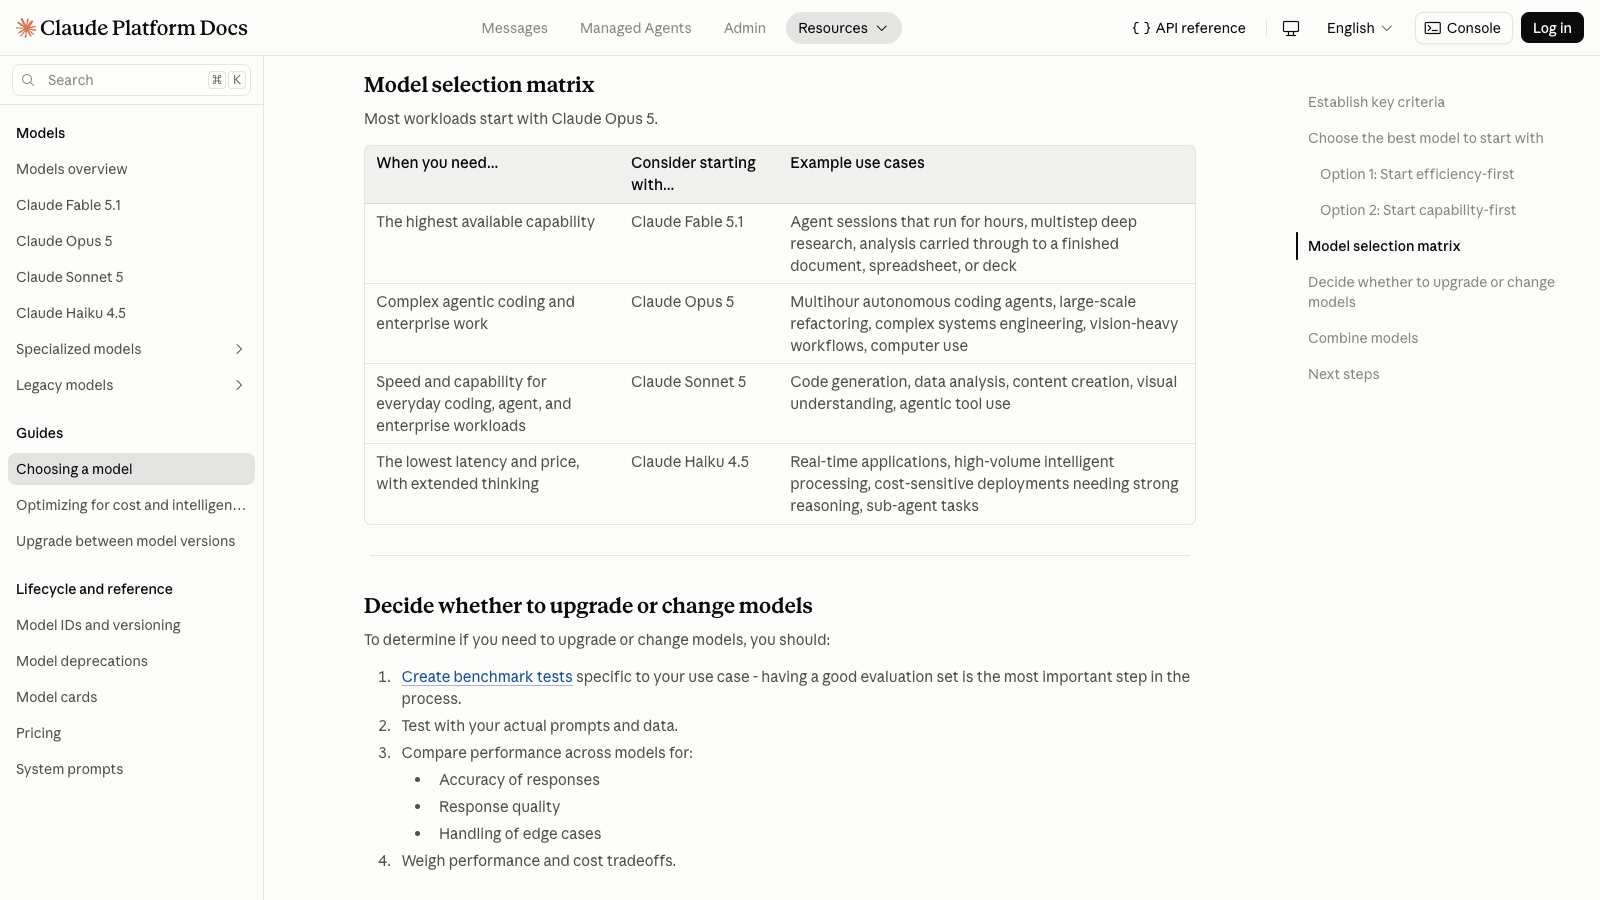
คำแนะนำดังกล่าวเหมาะสำหรับงานที่มีลักษณะผสมทั่วไป ตามคู่มือการใช้งานในสภาพแวดล้อมการผลิตของ Anthropic ระบุว่า งานส่วนใหญ่ควรเริ่มต้นด้วย Opus 5 ส่วนแมทริกซ์งานของระบบเองได้กำหนดให้ Sonnet เหมาะสำหรับงานประจำวันที่ต้องการความเร็วและความสามารถ ดังนั้น จุดเริ่มต้นที่เหมาะสมจึงขึ้นอยู่กับระดับความยอมรับความเสี่ยงและกระบวนการประเมินของคุณ ไม่ใช่เพียงชื่อรุ่นเท่านั้น.
GlobalGPT ช่วยทำให้กระบวนการทำงานโดยรวมเป็นไปอย่างราบรื่นยิ่งขึ้น ใช้งานได้จริงด้วยแพ็กเกจสมัครสมาชิกราคาประหยัดเพียงหนึ่งเดียว: Claude, GPT-5.6 Sol, Gemini 3 Pro, Kimi K3 และฟังก์ชัน AI หลากหลายใช้แดชบอร์ดเดียวกันสำหรับการวิจัย การเขียน การวิเคราะห์ การเขียนโค้ด และการปรับปรุง CLI ของมันยังสามารถนำการเข้าถึงโมเดลเหล่านั้นเข้าสู่เทอร์มินัลของคุณ กระบวนการทำงานในการพัฒนา และเครื่องมือผลิตที่มีอยู่ได้ การเปรียบเทียบผลลัพธ์เป็นส่วนที่มีประโยชน์หนึ่งของกระบวนการทำงานนี้; สำหรับตัวเลือกในระดับครอบครัวที่กว้างขึ้น โปรดดู การเปรียบเทียบระหว่าง ChatGPT, Claude และ Gemini . ส่วนที่เหลือของคู่มือนี้จะเน้นไปที่การเลือกภายในช่วง Claude.
ในคู่มือนี้
คำตอบสั้นๆ รุ่น Claude ปัจจุบัน ไฮกุ vs โซเน็ต vs ออปัส เลือกตามงาน ต้นทุนของความล้มเหลว อัปเกรดหรือดาวน์เกรด ตัวอย่างค่าใช้จ่าย API แบบคงที่ การทดสอบแบบปฏิบัติจริง GlobalGPT เหมาะสำหรับกรณีใด คำถามที่พบบ่อย คำตัดสินสุดท้าย
รุ่น Claude: คำตอบสั้นๆ
ระดับทั้งสี่ในปัจจุบันช่วยแก้ปัญหาทางเศรษฐกิจที่แตกต่างกัน การโทรที่มีค่าใช้จ่ายต่ำที่สุดไม่เสมอไปจะเป็นงานที่เสร็จสิ้นด้วยค่าใช้จ่ายต่ำที่สุด และโมเดลที่ทรงพลังที่สุดก็ไม่ได้หมายความว่าจะเป็นการใช้งบประมาณได้อย่างมีประสิทธิภาพที่สุดโดยอัตโนมัติ.
คู่มือการตัดสินใจสำหรับรุ่น Claude
เลือกตามปริมาณงานและค่าใช้จ่ายจากความล้มเหลว ใช้ Sonnet สำหรับงานประจำวันที่มีความสมดุล ปรับระดับลงเพื่อเพิ่มประสิทธิภาพ และปรับระดับขึ้นเมื่อการตรวจสอบยากหรือความผิดพลาดมีค่าใช้จ่ายสูง.
ไฮกุ 4.5 ประสิทธิภาพเป็นอันดับแรก เริ่มต้นจากที่นี่สำหรับงานที่มีปริมาณสูง ไวต่อความล่าช้า และมีขอบเขตที่ชัดเจน ซึ่งการตรวจหาและแก้ไขข้อผิดพลาดมีค่าใช้จ่ายต่ำ.
เลื่อนขึ้นเมื่อ กรณีพิเศษหรือเวลาที่ใช้ในการแก้ไขของผู้ตรวจสอบจะทำให้ข้อได้เปรียบด้านราคาโทเคนหายไป.
โซเน็ต 5 ความสมดุลในชีวิตประจำวัน ใช้สำหรับงานเขียนแบบผสมผสาน การวิเคราะห์ การเขียนโค้ด การเข้าใจด้วยภาพ และงานที่ใช้เครื่องมือ ซึ่งยังคงได้รับการตรวจสอบตามปกติ.
เลื่อนขึ้นเมื่อ การวิเคราะห์ในระยะยาว การตรวจสอบ หรือค่าใช้จ่ายจากความล้มเหลว จะกลายเป็นปัจจัยที่จำกัด.
Opus 5 ความสามารถเป็นอันดับแรก เริ่มต้นจากที่นี่ สำหรับการเขียนโค้ดที่ซับซ้อนแบบเอเจนต์ งานระดับองค์กร การวินิจฉัยที่ยาก หรือการตัดสินใจที่หากผิดพลาดจะก่อให้เกิดค่าใช้จ่ายสูง.
เลื่อนลงเมื่อ รุ่นที่มีราคาถูกกว่าผ่านการตรวจสอบการรับมอบซ้ำแล้วซ้ำเล่า.
Fable 5.1 เส้นทางข้อยกเว้น ให้ส่งต่อระดับปัญหาขึ้นเฉพาะเมื่อต้องการเหตุผลที่ละเอียดหรือการทำงานของเอเจนต์ที่ใช้เวลานานเท่านั้น หาก Opus ที่ใช้ความพยายามมากขึ้นแล้วยังไม่ผ่านการประเมินของคุณ.
อย่าสันนิษฐาน เมื่อพิจารณาถึงคุณภาพ เวลาการตรวจสอบ และจำนวนครั้งที่สามารถลองใหม่แล้ว ระดับที่สูงขึ้นจะมีราคาถูกกว่าโดยอัตโนมัติ.
กฎปฏิบัติ กำหนดงานตัวอย่างหนึ่งและขั้นตอนการตรวจสอบการยอมรับให้คงที่ เลือกโมเดลที่มีค่าใช้จ่ายต่ำที่สุดและผ่านการตรวจสอบได้อย่างน่าเชื่อถือ จากนั้นคำนวณเวลาที่ใช้ในการแก้ไขและตรวจสอบก่อนที่จะกำหนดว่าเป็นตัวเลือกที่มีค่าใช้จ่ายต่ำที่สุด.
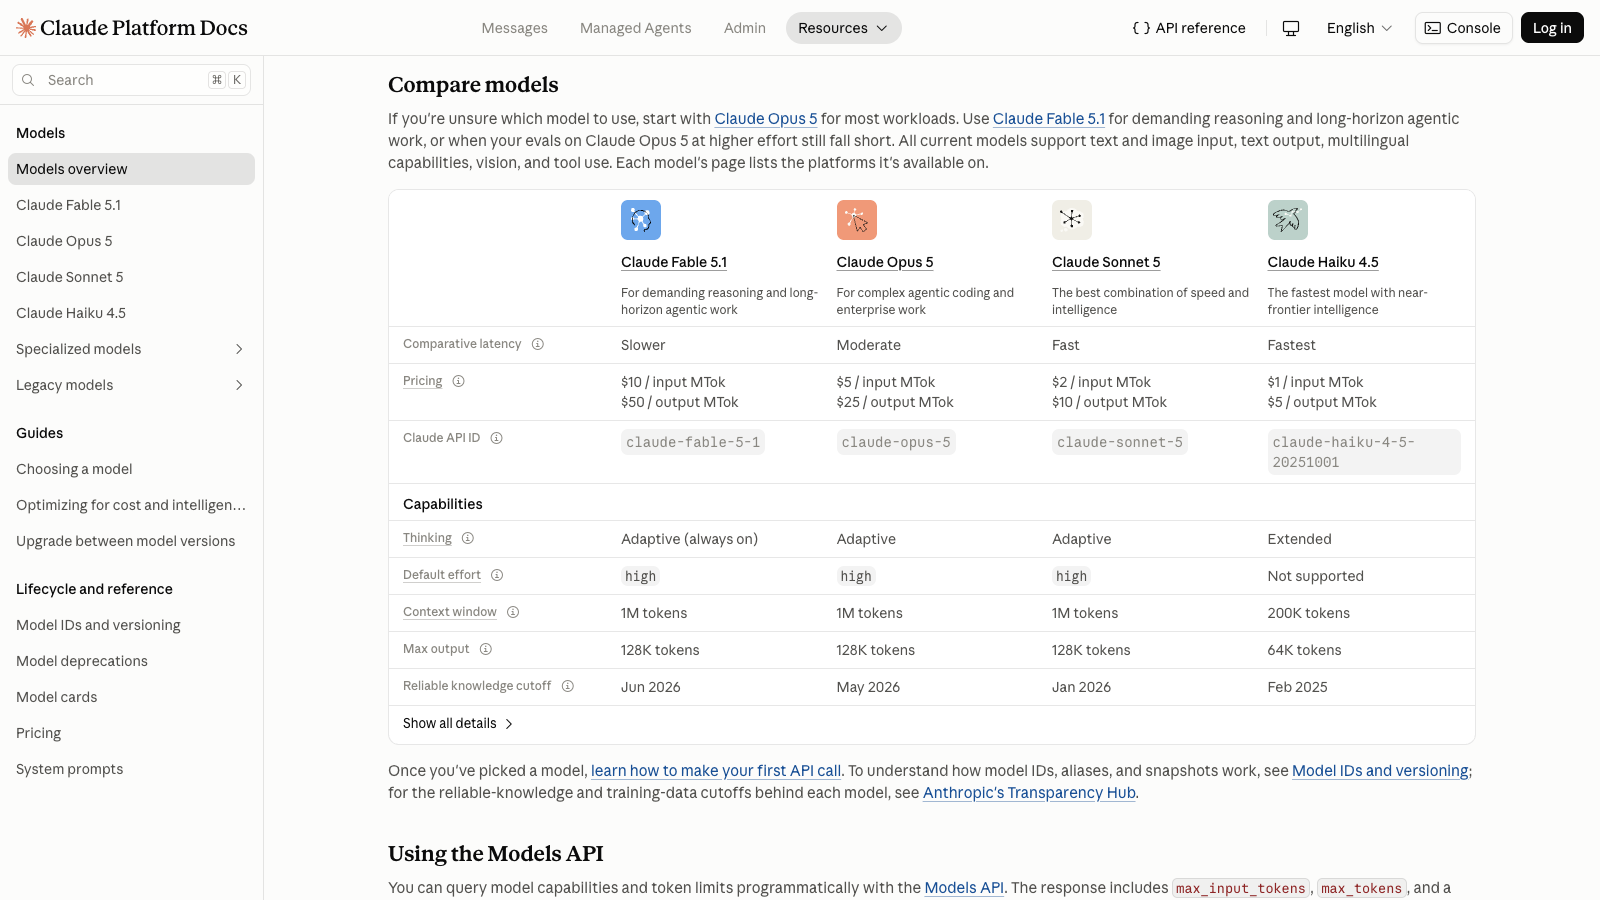
ภาพถ่ายแหล่งข้อมูล: Anthropic’s การเลือกรุ่นที่เหมาะสม และ ภาพรวมของรุ่น , ตรวจสอบเมื่อวันที่ 8 กันยายน 2026 Anthropic ระบุว่างานส่วนใหญ่เริ่มต้นด้วย Opus 5; ในตารางงานของมัน Sonnet 5 ถูกจัดไว้สำหรับงานประจำวัน ส่วน Haiku 4.5 ถูกจัดไว้สำหรับความหน่วงต่ำที่สุดและราคาถูกที่สุด.
รุ่น Claude ที่มีอยู่ในปัจจุบัน
ตั้งแต่วันที่ 8 กันยายน 2026 ไลน์ผลิตภัณฑ์ที่ใช้งานอยู่ของ Anthropic ประกอบด้วย Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5 และ Claude Fable 5.1 Haiku, Sonnet และ Opus เป็นชื่อตระกูลที่คงที่ แต่เวอร์ชันที่แนบมากับแต่ละตระกูลจะเปลี่ยนแปลงไปตามเวลา ดังนั้น ให้ระบุ ID รุ่นที่แม่นยำซึ่งคุณได้ประเมินในสภาพแวดล้อมการผลิต แทนที่จะสมมติว่าชื่อตระกูลจะชี้ไปยังสแนปช็อตเดียวกันเสมอ.
รุ่นปัจจุบัน ป้ายความเร็วอย่างเป็นทางการ บริบทของ API กำลังออกสูงสุด ข้อมูลเข้า/ออกของ API พื้นฐาน ไฮกุ 4.5 เร็วที่สุด 200,000 64K $1 / $5 ต่อ MTok โซเน็ต 5 รวดเร็ว 1 ล้าน 128 กิโลไบต์ $2 / $10 ต่อ MTok Opus 5 ปานกลาง 1 ล้าน 128 กิโลไบต์ $5 / $25 ต่อ MTok Fable 5.1 ช้าลง 1 ล้าน 128 กิโลไบต์ $10 / $50 ต่อ MTok
ในส่วนสรุปข้อมูลรุ่นของ Anthropic ระบุว่า Haiku 4.5, Sonnet 5, Opus 5 และ Fable 5.1 เป็นผลิตภัณฑ์ที่มีอยู่ในปัจจุบัน ณ วันที่ 8 กันยายน 2026. การเข้าถึง Claude.ai ไม่เหมือนกับข้อกำหนดของ API
ตารางแผน Claude.ai อธิบายการเข้าถึงของผู้ใช้ และปัจจุบันระบุว่ามีหน้าต่างบริบท (context window) ขนาด 200K สำหรับแผนแต่ละแผน ส่วนเอกสาร API ระบุขีดจำกัดของบริบทและผลลัพธ์ที่เฉพาะสำหรับแต่ละโมเดล รวมถึงบริบทขนาด 1M สำหรับ Sonnet 5, Opus 5 และ Fable 5.1. อย่าใช้ตาราง API เพื่อคาดการณ์ว่าแผน Claude.ai เฉพาะตัวนั้นรวมถึงอะไร หรือใช้ตารางแผนผู้บริโภคเพื่อคาดการณ์ขีดจำกัดของโมเดล API ดู คู่มือราคาและแพ็กเกจ Claude เพื่อความแตกต่างในระดับแผน.
Claude Haiku vs Sonnet vs Opus: ความแตกต่างหลัก
การแลกเปลี่ยนหลักไม่ใช่การจัดอันดับคุณภาพอย่างง่ายๆ การเลื่อนขึ้นในลำดับจะเพิ่มความสามารถในการทำงานที่ซับซ้อน แต่ก็จะทำให้ค่าใช้จ่ายโทเคนพื้นฐานเพิ่มขึ้น และโดยทั่วไปจะลดความเร็วลงด้วย นอกจากนี้ ข้อจำกัดของบริบทและกลไกการควบคุมการให้เหตุผลก็แตกต่างกันด้วย.
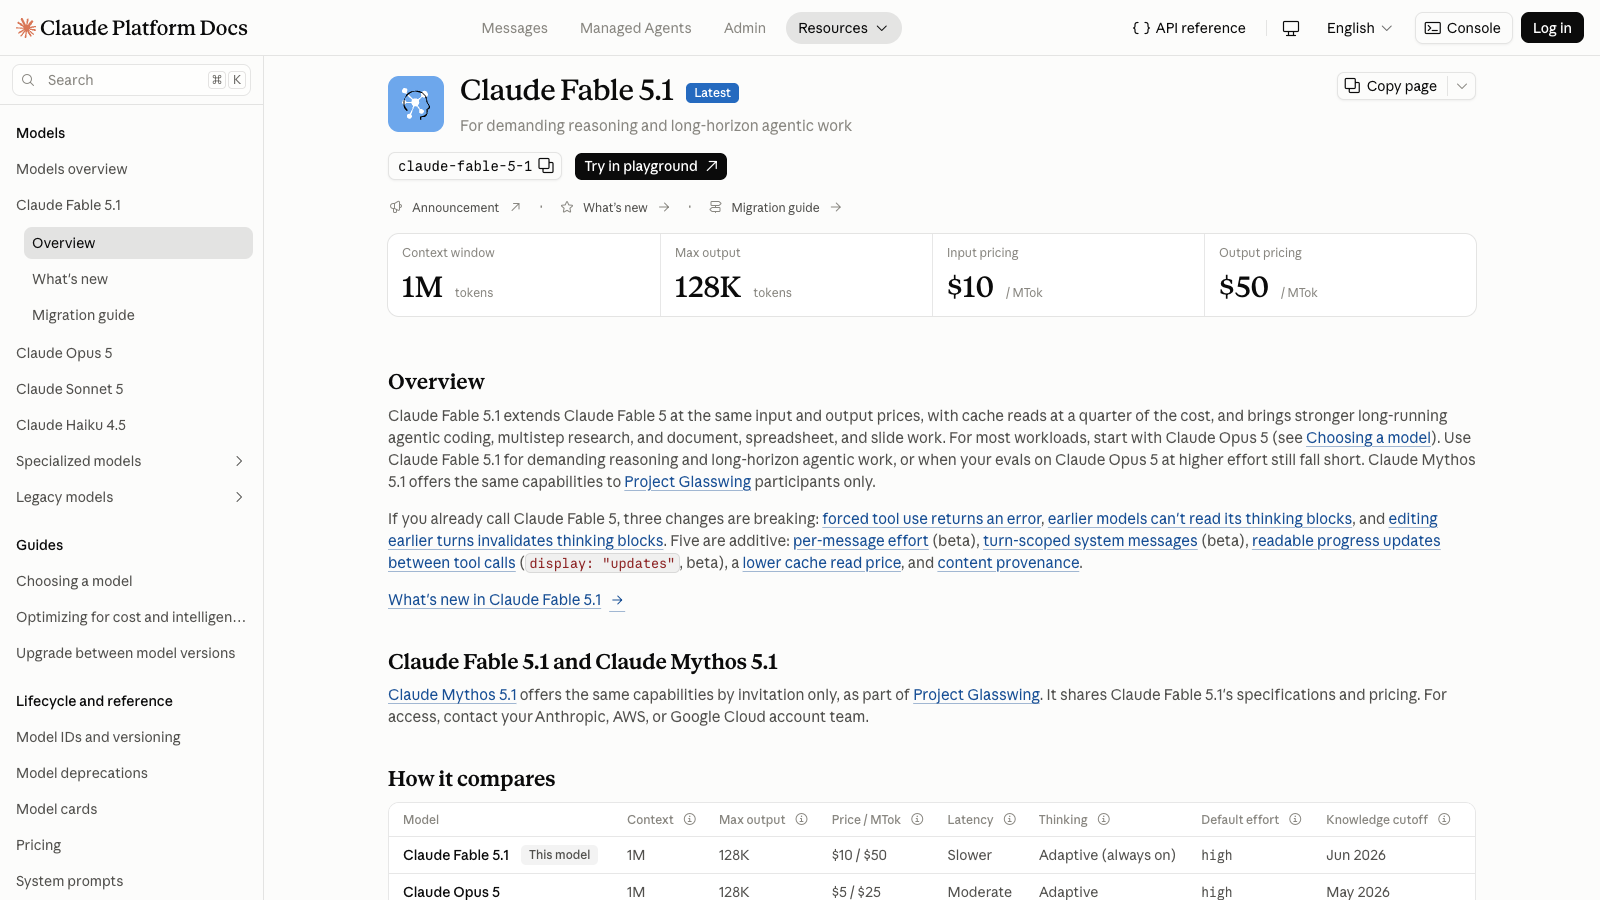
Fable เหมาะกับ: Fable 5.1 ได้รับการกำหนดอย่างเป็นทางการว่า "Slower" โดยมีบริบท 1M, ผลลัพธ์สูงสุด 128K และราคาพื้นฐานสำหรับอินพุต/เอาต์พุตที่ $10 / $50 ต่อหนึ่งล้านโทเคน ให้พิจารณาใช้เป็นระดับการปรับเพิ่มเมื่อ Opus ที่ใช้ความพยายามมากขึ้นยังคงไม่ผ่านการประเมินของคุณ.
ความเร็วและความหน่วง
Anthropic ระบุว่า Haiku 4.5 “เร็วที่สุด”, Sonnet 5 “เร็ว”, Opus 5 “ระดับกลาง” และ Fable 5.1 “ช้ากว่า” นี่เป็นป้ายกำกับคุณภาพของผลิตภัณฑ์ ไม่ใช่ค่าที่วัดด้วยมิลลิวินาทีหรือโทเคนต่อวินาที ความล่าช้าจริงขึ้นอยู่กับขนาดคำขอ การตั้งค่าการวิเคราะห์ เครื่องมือ ภาระงาน และโหมดการให้บริการ.
การควบคุมบริบท ผลลัพธ์ และกระบวนการให้เหตุผล
บริบท API ขนาดเล็กของ Haiku ที่ 200K และผลลัพธ์สูงสุด 64K ยังคงเพียงพอสำหรับงานหลายประเภทที่มีข้อจำกัด Sonnet และ Opus ขยายทั้งสองขีดจำกัดเป็น 1M และ 128K Haiku 4.5 ใช้การคิดแบบขยายด้วยมือ ในขณะที่ Sonnet 5 และ Opus 5 รองรับการคิดแบบปรับตัวและการควบคุมความพยายาม ความแตกต่างนี้คือหนึ่งในเหตุผลที่การตั้งค่าการให้เหตุผลที่เหมือนกันเพียงชุดเดียวไม่สามารถสร้างการทดสอบที่เทียบเท่ากันอย่างสมบูรณ์ได้สำหรับทุกโมเดล.
ควรใช้รุ่น Claude แบบใดสำหรับแต่ละงาน?
ปริมาณงาน เริ่มต้นด้วย ทำไม อัปเกรดเมื่อ การจัดประเภท การสกัดข้อมูล การกำหนดเส้นทาง และการคัดกรองผู้ป่วย ไฮกุ 4.5 ความหน่วงต่ำและต้นทุนโทเคนพื้นฐานที่ต่ำเหมาะสำหรับงานที่ชัดเจนและสามารถทำซ้ำได้. กรณีพิเศษหรือเวลาที่ใช้ในการแก้ไขจะทำให้เงินที่ประหยัดได้หายไป. การเขียน การวิเคราะห์ การเข้าใจภาพ การเขียนโค้ดในชีวิตประจำวัน โซเน็ต 5 ความสมดุลระหว่างความเร็ว ความสามารถ ความเหมาะสมกับบริบท และค่าใช้จ่าย สำหรับงานที่หลากหลาย. การวิเคราะห์หรือการตรวจสอบในระยะยาวกลายเป็นจุดคอขวด. การเขียนโค้ดที่ซับซ้อน การวินิจฉัยที่ยาก ตัวแทนอัตโนมัติ Opus 5 ความสามารถนั้นสำคัญกว่าราคาต่อโทเคนที่ต่ำที่สุด. Opus ที่ใช้ความพยายามมากขึ้นยังคงไม่ผ่านการประเมินแบบตัวแทนที่เข้มงวด. ผลงานที่มีระยะเวลาดำเนินการยาวนานเป็นพิเศษ หรือผลงานที่เน้นการวิเคราะห์อย่างลึกซึ้ง Fable 5.1 นี่คือเส้นทางขยายตัวปัจจุบันที่อยู่เหนือ Opus. ใช้เฉพาะเมื่อประโยชน์ที่วัดได้นั้นคุ้มค่ากับค่าใช้จ่ายที่สูงขึ้น.
นี่เป็นจุดเริ่มต้นเท่านั้น ไม่ใช่ตัวเลือกที่ดีที่สุดในทุกกรณี ตัวอย่างเช่น การเปลี่ยนแปลงโค้ดที่สั้นแต่มีความสำคัญสูงอาจเหมาะสมกับ Opus ในขณะที่งานการสกัดข้อมูลที่ยาวแต่มีโครงสร้างชัดเจนอาจยังคงเหมาะกับ Haiku สำหรับตัวอย่างกระบวนการทำงานในปฏิบัติ โปรดดูคู่มือของเราที่ ใช้ Claude สำหรับการเขียนโค้ด .
เมื่อรายชื่อตัวเลือกของคุณมีมากกว่า Claude, GlobalGPT จะช่วยให้คุณใช้คำสั่งที่แสดงถึงตัวอย่างเดียวกันกับ Claude, GPT-5.6 Sol, Gemini 3 Pro และ Kimi K3 ในพื้นที่ทำงานเดียว รักษาเกณฑ์การตรวจสอบความถูกต้องให้คงที่: ความเร็วเป็นปัจจัยสำคัญสำหรับงานที่ทำซ้ำๆ ส่วนคุณภาพคำตอบและเวลาการแก้ไขจะเป็นตัวกำหนดว่าผลลัพธ์ที่มีต้นทุนต่ำกว่านั้นจะประหยัดจริงหรือไม่.
เลือกตามต้นทุนของความล้มเหลว ไม่ใช่เพียงประเภทงานเท่านั้น
ป้ายกำกับงานมักทำให้ตัวแปรที่สำคัญที่สุดถูกมองข้ามไป: จะเกิดอะไรขึ้นหากคำตอบผิด? กรอบงานด้านล่างนี้เป็นเครื่องมือช่วยตัดสินใจในการบรรณาธิการ ซึ่งอิงตามแนวทางของ Anthropic ที่ให้ความสำคัญกับประสิทธิภาพและความสามารถเป็นอันดับแรก มันไม่ใช่เกณฑ์มาตรฐานของ Anthropic.
ราคาถูก
ตัวอย่าง
เริ่ม
ยกระดับ
วัสดุ
ตัวอย่าง
เริ่ม
ยกระดับ
แพง
ตัวอย่าง
เริ่ม
ยกระดับ
เมื่อใดควรอัปเกรดหรือดาวน์เกรดรุ่น Claude ของคุณ
ให้เลื่อนขึ้นเฉพาะเมื่อมีขีดจำกัดที่วัดได้ปรากฏขึ้น
จากไฮกุสู่โซเน็ต ควรอัปเกรดเมื่อกรณีพิเศษ การพลาดคำสั่ง หรือเวลาที่ใช้ในการแก้ไขของผู้ตรวจสอบ เกินกว่าประโยชน์ที่ประหยัดได้.
โซเน็ตถึงโอปัส ควรอัปเกรดเมื่อการดำเนินการในระยะยาว การวิเคราะห์ที่ซับซ้อน การตรวจสอบ หรือค่าใช้จ่ายจากความล้มเหลวกลายเป็นข้อจำกัด.
Opus ที่ใช้ความพยายามมากขึ้น ทดสอบโหลดงานที่หนักด้วยการตรวจสอบการยอมรับในสภาพแวดล้อมที่ถูกแช่แข็ง ก่อนที่จะย้ายไปยังระดับสูงสุด.
จาก Opus ถึง Fable ให้ดำเนินการขั้นต่อไปก็ต่อเมื่อ Opus ที่ใช้ความพยายามมากขึ้นแล้วยังไม่ผ่านการประเมินตัวอย่าง และประโยชน์ที่ได้รับคุ้มค่ากับค่าใช้จ่าย.
กฎการลดระดับ: ให้ปรับระดับลงเมื่อรุ่นที่มีราคาถูกกว่าผ่านการตรวจสอบความยอมรับเดียวกันซ้ำๆ ได้ตามค่าความล่าช้าและความน่าเชื่อถือที่กำหนด.
แมทริกซ์ของ Anthropic แสดงการเปรียบเทียบระหว่างรุ่น Claude สี่รุ่นที่มีอยู่ปัจจุบัน กับความต้องการด้านความสามารถ ความเร็ว และปริมาณงานที่แตกต่างกัน. ตัวอย่างค่าใช้จ่าย API แบบคงที่ Claude
สำหรับปริมาณงานรวมที่คงที่ 1 ล้านโทเคนเข้า และ 100,000 โทเคนออก ผ่านคำขอ API มาตรฐานหลายครั้ง ค่าโทเคนพื้นฐานมีช่วงตั้งแต่ $1.50 สำหรับ Haiku 4.5 ไปจนถึง $15.00 สำหรับ Fable 5.1 นี่ไม่ใช่คำขอเดียว และไม่ทับซ้อนกับขีดจำกัดผลออกต่อคำขอ.
รวม: อัตราโทเคนเข้าและออกมาตรฐานจากภาพถ่ายราคา Anthropic หนึ่งครั้ง.
ไม่รวม: การเก็บข้อมูลในแคชแบบทันที, Batch API, โหมดเร็ว, ข้อมูลทางภูมิศาสตร์, ค่าบริการเครื่องมือ, ภาษี, ส่วนลด และเครดิต GlobalGPT.
อัตราพื้นฐานใน USD ต่อหนึ่งล้านโทเคน จาก Anthropic’s ราคาตามแบบ , ตรวจสอบเมื่อวันที่ 8 กันยายน 2026 อัตราค่าบริการสำหรับอินพุต $2 / เอาต์พุต $10 ของ Sonnet 5 เป็นราคาตามมาตรฐาน.
ตารางราคาแสดงราคาของโทเคนเท่านั้น ไม่ใช่ราคาของผลลัพธ์ที่เสร็จสมบูรณ์ โมเดลที่มีราคาถูกกว่าอาจกลายเป็นโมเดลที่มีราคาแพงกว่าได้ หากการลองใหม่ การแก้ไข และการตรวจสอบใช้เวลาของพนักงานมากกว่าจำนวนเงินที่ประหยัดได้จากโทเคน.
การทดสอบแบบปฏิบัติจริงกับโมเดล Claude: คำกระตุ้นเดียวกัน แต่รูปแบบความล้มเหลวต่างกัน
เมื่อวันที่ 9 กันยายน 2026 เราได้ส่งคำสั่งสามข้อเดียวกันผ่าน Anywhere API ไปยัง Claude Haiku 4.5, Sonnet 5, Opus 5 และ Fable 5.1 งานที่ดำเนินการรวมถึงการคัดกรองการสนับสนุนแบบมีโครงสร้าง การเขียนที่อิงหลักฐาน และการดีบัก JavaScript ที่สามารถตรวจสอบได้ เราเก็บผลลัพธ์ที่ถูกต้องครั้งแรกของแต่ละโมเดล และประเมินผลลัพธ์เหล่านั้นตามกฎที่กำหนดไว้ก่อนที่จะมีการตรวจสอบคำตอบ.
ผลลัพธ์ที่ได้ไม่ใช่การจัดอันดับแบบง่ายๆ Sonnet, Opus และ Fable ต่างได้คะแนน 26.5 จาก 30 คะแนน แต่จุดแข็งและจุดอ่อนของแต่ละโปรแกรมนั้นแตกต่างกันอย่างชัดเจน ส่วน Haiku ส่งคืน HTTP 503 ในทั้งสองครั้งที่ได้รับอนุญาตให้ลองสำหรับทุกงาน ดังนั้นคุณภาพผลลัพธ์ของมันจึงยังไม่เป็นที่ทราบแน่ชัดในการทดสอบครั้งนี้.
การตั้งค่าการทดสอบและผลรวม คำสั่งที่ถูกตรึงไว้สามข้อ, ข้อจำกัดจำนวนโทเคนในระดับงานที่เท่ากัน, ไม่ใช้เครื่องมือหรือการค้นหา, และเก็บผลลัพธ์ที่ถูกต้องแรกไว้สำหรับแต่ละโมเดล.
สถานที่จัดงาน API Anywhere
วันที่ 9 กันยายน 2569
งาน การคัดกรองผู้ป่วยแบบมีโครงสร้าง, บันทึกการเปิดตัว, การแก้ไขข้อผิดพลาดใน JavaScript
กฎการลองใหม่ เกิดข้อผิดพลาดในการส่งข้อมูล 429/5xx, เนื้อหาว่าง หรือการตอบกลับไม่ถูกต้อง
ทั้งสามโมเดลที่ได้รับคะแนนมีคะแนนเท่ากันที่ 26.5/30 แต่ด้วยเหตุผลที่แตกต่างกัน นี่เป็นผลจากโปรไฟล์งาน ไม่ใช่การจัดอันดับโมเดลแบบทั่วไป Haiku ไม่ถูกนับในการเสมอกันครั้งนี้ เนื่องจากไม่มีผลลัพธ์ที่สามารถนำมาประเมินคะแนนได้.
ผลลัพธ์ที่มีโครงสร้าง
การทดสอบ 1: การจัดประเภทคำขอสนับสนุน ผลลัพธ์ของงาน: Fable 5.1, 10/10 Fable เป็นโมเดลเดียวที่ส่งคืน JSON ที่สามารถวิเคราะห์ได้โดยตรง โดยทั้งหกป้ายกำกับและคำสั่งต่างถูกต้องทั้งหมด ส่วน Opus และ Sonnet ระบุป้ายกำกับได้ถูกต้อง แต่เพิ่มเครื่องหมายขอบเขต Markdown เข้าไป ทั้งสองยังได้กำหนดเส้นตายที่ระบุไว้ให้เข้มงวดขึ้น และ Sonnet ยังให้คำมั่นว่าจะแก้ไขหรือคืนเงินก่อนกำหนด.
ข้อมูลทดสอบแบบเต็ม คุณกำลังจัดการกล่องรับข้อความสนับสนุนของ SaaS จัดประเภททุกตั๋วด้านล่างนี้ ให้ส่งคืน JSON ที่มีเพียงฟิลด์ระดับบนสุดเดียวชื่อ tickets เท่านั้น โดย tickets ต้องเป็นอาร์เรย์ตามลำดับเดิม และทุกองค์ประกอบต้องประกอบด้วย ticket_id, category, urgency และ action อย่างครบถ้วน โดย category ต้องเป็นหนึ่งใน billing, access, bug, feature ส่วน urgency ต้องเป็นหนึ่งใน low, medium, high ใช้เฉพาะข้อความในตั๋วเท่านั้น; ห้ามสร้างผลลัพธ์ตามนโยบายหรือข้อมูลลูกค้าขึ้นมาเอง
#481: เราถูกเรียกเก็บเงินสองครั้งสำหรับการต่ออายุรายปีเดียวกัน ระบบจ่ายเงินเดือนจะปิดในวันศุกร์ และผมต้องการให้เรื่องนี้ได้รับการตรวจสอบก่อนวันนั้น
#482: ระบบรีเซ็ตรหัสผ่านแจ้งว่าอีเมลได้ส่งไปแล้ว แต่ไม่ได้รับอะไรเลย ผมได้ตรวจสอบในโฟลเดอร์สแปมและลองส่งใหม่หนึ่งครั้ง
#483: การส่งออกไฟล์ CSV จะปัดเศษทุกจำนวนเงินเป็นดอลลาร์เต็ม ในขณะที่แดชบอร์ดยังคงแสดงเซนต์
#484: โปรดเพิ่มโหมดมืด (dark mode) ให้กับแดชบอร์ดวิเคราะห์
#485: หลังจากที่โดเมนของบริษัทเราเปลี่ยนไปเมื่อเช้านี้ พนักงานทุกคนได้รับข้อความว่าถูกปฏิเสธการเข้าถึง SSO
#486: คุณสามารถส่งสำเนาใบแจ้งหนี้ของเดือนที่แล้วให้ผมได้ไหม? Claude Haiku 4.5: ผลลัพธ์การดำเนินงานเต็มรูปแบบ ไม่มีการสร้างผลลัพธ์จากโมเดล ทั้งสองครั้งที่พยายามใช้ Anywhere API ที่ได้รับอนุญาตต่างก็ได้รับรหัสสถานะ HTTP 503 ดังนั้นเส้นทางนี้จึงถูกทำเครื่องหมายว่าไม่สามารถใช้งานได้ และถูกยกเว้นจากการประเมินคุณภาพ. Claude Sonnet 5: กำลังออกเต็ม ```json
{
"tickets": [
{
"ticket_id": "#481",
"category": "billing",
"urgency": "high",
"action": "ตรวจสอบค่าต่ออายุรายปีที่ซ้ำกัน และดำเนินการแก้ไข/คืนเงินก่อนที่ระบบจ่ายเงินเดือนของลูกค้าจะปิดในวันศุกร์."
},
{
"ticket_id": "#482",
"category": "access",
"urgency": "medium",
"action": "ตรวจสอบที่อยู่อีเมลของบัญชีและความสามารถในการส่งอีเมล จากนั้นกระตุ้นหรือส่งอีเมลรีเซ็ตรหัสผ่านใหม่ด้วยตนเอง"
},
{
"ticket_id": "#483",
"category": "bug",
"urgency": "medium",
"action": "ส่งต่อให้ทีมวิศวกรรมแก้ไขปัญหาการปัดเศษในการส่งออกไฟล์ CSV เพื่อให้ค่าสกุลเงินตรงกับความแม่นยำระดับเซนต์ที่แสดงบนแดชบอร์ด."
},
{
"ticket_id": "#484",
"category": "feature",
"urgency": "low",
"action": "บันทึกคำขอโหมดมืดสำหรับแดชบอร์ดวิเคราะห์และเพิ่มมันเข้าไปในรายการงานพัฒนาคุณสมบัติของผลิตภัณฑ์."
},
{
"ticket_id": "#485",
"category": "access",
"urgency": "high",
"action": "ตรวจสอบการตั้งค่า SSO ที่เชื่อมโยงกับโดเมนบริษัทที่เปลี่ยนแปลงทันที และคืนสิทธิ์การเข้าถึงให้กับพนักงานทุกคนที่ได้รับผลกระทบ."
},
{
"ticket_id": "#486",
"category": "billing",
"urgency": "low",
"action": "ค้นหาใบแจ้งหนี้ของเดือนที่แล้วและส่งสำเนาให้ลูกค้า."
}
]
}
``` Claude Opus 5: กำลังออกเต็ม ```json
{
"tickets": [
{
"ticket_id": "481",
"category": "billing",
"urgency": "high",
"action": "ส่งต่อให้ฝ่ายบิลลิ่งเพื่อตรวจสอบค่าต่ออายุรายปีที่ซ้ำกัน และยืนยันการแก้ไขก่อนที่ระบบจ่ายเงินเดือนของลูกค้าจะปิดในวันศุกร์"
},
{
"ticket_id": "482",
"category": "access",
"urgency": "medium",
"action": "ตรวจสอบบันทึกการส่งอีเมลสำหรับข้อความรีเซ็ตที่ส่งไปยังที่อยู่นั้น และหากไม่ส่งถึง ให้เปิดใช้งานขั้นตอนรีเซ็ตที่ได้รับการยืนยันสำหรับผู้ใช้."
},
{
"ticket_id": "483",
"category": "bug",
"urgency": "medium",
"action": "สร้างรายงานข้อผิดพลาดเกี่ยวกับการปัดเศษสกุลเงินในการส่งออก CSV โดยระบุความไม่ตรงกันกับค่าบนแดชบอร์ด และขอขั้นตอนการจำลองปัญหาหรือตัวอย่างไฟล์ส่งออก."
},
{
"ticket_id": "484",
"category": "feature",
"urgency": "low",
"action": "บันทึกเป็นคำขอฟีเจอร์โหมดมืดสำหรับแดชบอร์ดวิเคราะห์ และยืนยันการรับทราบโดยไม่กำหนดกรอบเวลา"
},
{
"ticket_id": "485",
"category": "access",
"urgency": "high",
"action": "ยกระดับเป็นปัญหาการหยุดทำงานของ SSO ทั่วทั้งองค์กรที่เกี่ยวข้องกับการเปลี่ยนแปลงโดเมน; ให้ทีมอัตลักษณ์/การรับรองความถูกต้องตรวจสอบการตั้งค่าโดเมน SSO ทันที."
},
{
"ticket_id": "486",
"category": "billing",
"urgency": "low",
"action": "ส่งสำเนาใบแจ้งหนี้ของเดือนก่อนตามที่ขอไปยังผู้ติดต่อบัญชีที่ได้รับการยืนยันแล้ว."
}
]
}
``` Claude Fable 5.1: ผลลัพธ์เต็มรูปแบบ {"tickets":[{"ticket_id":"481","category":"billing","urgency":"high","action":"ตรวจสอบกรณีที่รายงานว่ามีการเรียกเก็บค่าต่ออายุรายปีซ้ำ และตอบกลับก่อนวันศุกร์ ซึ่งเป็นวันปิดบัญชีเงินเดือนของลูกค้า."},{"ticket_id":"482","category":"access","urgency":"medium","action":"ตรวจสอบบันทึกการส่งอีเมลรีเซ็ตรหัสผ่านเพื่อหาที่อยู่อีเมลของผู้ใช้ และส่งใหม่หรือให้วิธีการรีเซ็ตอื่น ๆ"},{"ticket_id":"483","category":"bug","urgency":"medium","action":"ลองทำซ้ำปัญหาการปัดเศษจำนวนเงินสกุลเงินเป็นดอลลาร์เต็มในการส่งออก CSV และส่งต่อให้ทีมวิศวกรรมเพื่อแก้ไข."},{"ticket_id":"484","category":"feature","urgency":"low","action":"บันทึกคำขอโหมดมืดสำหรับแดชบอร์ดวิเคราะห์กับทีมผลิตภัณฑ์และยืนยันการรับคำขอ."},{"ticket_id":"485","category":"access","urgency":"สูง","action":"ส่งต่อข้อผิดพลาดการปฏิเสธการเข้าถึง SSO ทั่วทั้งบริษัทที่เกิดขึ้นหลังจากการเปลี่ยนโดเมน และตรวจสอบการตั้งค่าโดเมน SSO."},{"ticket_id":"486","category":"billing","urgency":"low","action":"ค้นหาและส่งสำเนาใบแจ้งหนี้ของเดือนที่แล้วให้ลูกค้า."}]} นโยบายผลลัพธ์ที่ถูกต้องครั้งแรก (First-valid-output policy) ความล่าช้าคือเวลาตามนาฬิกาจริง (wall-clock time) ที่ผ่าน Anywhere ไม่ใช่ความล่าช้าแบบ Anthropic ของระบบต้นทาง จำนวนโทเคนเป็นข้อมูลที่ผู้ให้บริการรายงาน; ไม่มีการคำนวณค่าใช้จ่าย API โดยตรงจากเส้นทางนี้.
การปฏิบัติตามข้อจำกัด
การทดสอบ 2: บันทึกการเปิดตัวที่อิงจากหลักฐาน ผลลัพธ์ของงาน: Sonnet 5, 10/10 Sonnet เป็นรุ่นเดียวที่ตอบสนองทุกข้อกำหนดของระบบ Frozen ได้อย่างครบถ้วน Opus ส่งข้อความที่ชัดเจน แต่เกินขีดจำกัดจำนวนคำ และสันนิษฐานว่าผู้ที่ไม่ได้ตอบกลับทั้งหมดเป็นนักศึกษาที่ลงทะเบียนแล้ว ส่วน Fable ในการตอบกลับครั้งแรกไม่มีข้อความใดเลย และเมื่อได้รับสิทธิ์ลองใหม่ ก็ส่งข้อความที่ถูกตัดทอนอย่างชัดเจน โดยไม่มีคำแนะนำหรือคำเตือนใดๆ.
ข้อมูลทดสอบแบบเต็ม เขียนบันทึกการเปิดตัวภายในจำนวน 180-220 คำ สำหรับผู้อำนวยการผลิตภัณฑ์ โดยใช้ข้อมูลต่อไปนี้เท่านั้น ให้รวม: หัวข้อ, ย่อหน้าเปิดสั้นๆ, จุดสำคัญสามข้อเท่านั้น, คำแนะนำ และข้อควรระวังหนึ่งข้อที่ระบุไว้อย่างชัดเจน ห้ามสร้างมติเกี่ยวกับงบประมาณ, เปอร์เซ็นต์, ความสำคัญทางสถิติ หรือผลเชิงสาเหตุขึ้นเอง
ข้อมูล:
- โครงการนำร่องมีนักเรียนเข้าร่วม 120 คน
- ณ จุดตรวจสอบวันที่ 31 มีนาคม มีนักเรียน 96 คนที่เข้าร่วมอย่างน้อย 3 ครั้ง
- คะแนนจากการสำรวจมีค่าเฉลี่ย 4.3 จาก 5 จากผู้ตอบแบบสอบถาม 71 คน
- ใบงานการดำเนินงานของโครงการระบุงบประมาณเป็น $18,000
- บันทึกการอนุมัติงบประมาณระบุ $20,000 แต่ไม่ได้ระบุว่าความแตกต่างนี้เกิดจากการแก้ไขหรือข้อผิดพลาดในการบันทึก
- ผู้เข้าร่วมไม่ได้ถูกจัดกลุ่มแบบสุ่ม และไม่มีการเก็บคะแนนพื้นฐาน
- การตัดสินใจครั้งนี้คือว่าจะดำเนินการโครงการนำร่องครั้งที่สองหรือไม่ ไม่ใช่ว่าจะนำโครงการไปใช้อย่างถาวร. Claude Haiku 4.5: ผลลัพธ์การดำเนินงานเต็มรูปแบบ ไม่มีการสร้างผลลัพธ์จากโมเดล ทั้งสองครั้งที่พยายามใช้ Anywhere API ที่ได้รับอนุญาตต่างก็ได้รับรหัสสถานะ HTTP 503 ดังนั้นเส้นทางนี้จึงถูกทำเครื่องหมายว่าไม่สามารถใช้งานได้ และถูกยกเว้นจากการประเมินคุณภาพ. Claude Sonnet 5: กำลังออกเต็ม **หัวข้อ: ผลลัพธ์ของโครงการทดลอง — ข้อเสนอแนะให้ดำเนินการโครงการทดลองครั้งที่สอง**
โครงการทดลองครั้งแรกได้เสร็จสิ้นช่วงตรวจสอบขั้นต้นแล้ว และตัวชี้วัดเบื้องต้นเกี่ยวกับระดับการมีส่วนร่วมและความพึงพอใจดูเป็นไปในทางที่ดี ก่อนที่จะตัดสินใจดำเนินการโครงการทดลองครั้งที่สอง ทีมควรร่วมกันทบทวนข้อมูลและประเด็นที่ยังค้างอยู่บางประการ
- จากนักเรียน 120 คนที่ลงทะเบียน มี 96 คนที่เข้าร่วมอย่างน้อย 3 ครั้ง ณ จุดตรวจสอบวันที่ 31 มีนาคม
- การสำรวจหลังการเรียนที่ผู้ตอบ 71 คนได้กรอกให้ผลคะแนนเฉลี่ย 4.3 จาก 5
- ตัวเลขงบประมาณไม่สอดคล้องกันระหว่างเอกสารต่าง ๆ: ใบงานการดำเนินงานของโครงการระบุ $18,000 ในขณะที่บันทึกการอนุมัติทางการเงินระบุ $20,000; ไม่ชัดเจนว่านี่เป็นการแก้ไขหรือข้อผิดพลาดในการบันทึก
**ข้อเสนอแนะ:** จากผลการเข้าร่วมและผลสำรวจ เราแนะนำให้ดำเนินการโครงการนำร่องครั้งที่สองเพื่อรวบรวมข้อมูลที่มีโครงสร้างชัดเจนยิ่งขึ้น — โดยควรมีกลุ่มเปรียบเทียบที่กำหนดไว้อย่างชัดเจนและการวัดค่าพื้นฐาน — ก่อนที่จะพิจารณาการขยายโครงการในวงกว้าง โครงการนำร่องครั้งที่สองนี้ควรเป็นโอกาสในการปรับความคลาดเคลื่อนของงบประมาณให้สอดคล้องกับฝ่ายการเงินก่อนที่งบประมาณจะได้รับการอนุมัติอย่างเป็นทางการ
**ข้อควรระวัง:** ควรตีความผลลัพธ์เหล่านี้อย่างระมัดระวัง ผู้เข้าร่วมไม่ได้ถูกจัดกลุ่มแบบสุ่ม และไม่มีการเก็บคะแนนพื้นฐาน ดังนั้นเราจึงไม่สามารถระบุได้ว่าผลการสำรวจหรือรูปแบบการเข้าร่วมเป็นผลมาจากโครงการนี้เอง นี่เป็นการตัดสินใจเพื่อกำหนดขอบเขตของโครงการนำร่องครั้งที่สอง ไม่ใช่การตัดสินใจเกี่ยวกับการดำเนินการอย่างถาวร. Claude Opus 5: กำลังออกเต็ม **หัวข้อ: ผลลัพธ์จากโครงการทดลองและข้อเสนอแนะเกี่ยวกับกลุ่มทดลองครั้งที่สอง**
โครงการทดลองครั้งแรกได้เสร็จสิ้นการตรวจสอบ ณ วันที่ 31 มีนาคม และขณะนี้เรามีข้อมูลเพียงพอเพื่อตัดสินใจว่าจะดำเนินการโครงการทดลองครั้งที่สองหรือไม่ บันทึกนี้สรุปสิ่งที่เราสังเกตได้ ข้อเสนอแนะของเรา และข้อจำกัดหลักในการตีความ ในขั้นนี้ ยังไม่มีข้อตัดสินใจใดเกี่ยวกับการนำโครงการไปใช้อย่างถาวร
- **การลงทะเบียนและการมีส่วนร่วม:** มีนักศึกษาลงทะเบียน 120 คน ณ จุดตรวจสอบวันที่ 31 มีนาคม มี 96 คนที่เข้าร่วมอย่างน้อย 3 ครั้ง
- **ความคิดเห็นของผู้เข้าร่วม:** ผลสำรวจหลังการเข้าร่วมมีคะแนนเฉลี่ย 4.3 จาก 5 คะแนน โดยอิงจากผู้ตอบแบบสอบถาม 71 คน นักศึกษาที่ลงทะเบียนแต่ไม่ตอบแบบสอบถามไม่รวมอยู่ในผลคะแนนนี้ ดังนั้นคะแนนดังกล่าวจึงสะท้อนเฉพาะกลุ่มผู้ตอบแบบสอบถามเท่านั้น
- **ความแตกต่างของงบประมาณ:** ใบงานการดำเนินงานโครงการระบุงบประมาณ $18,000 ในขณะที่บันทึกการอนุมัติทางการเงินระบุ $20,000 เอกสารอนุมัติงบประมาณไม่ได้ระบุว่าความแตกต่างนี้เกิดจากการปรับแก้หรือข้อผิดพลาดในการบันทึก และเรายังไม่ได้กำหนดว่าตัวเลขใดเป็นตัวเลขที่ใช้บังคับ
**ข้อเสนอแนะ:** ให้ดำเนินการวางแผนโครงการนำร่องครั้งที่สอง โดยมีเงื่อนไขว่าฝ่ายการเงินและฝ่ายปฏิบัติการโครงการต้องปรับให้ตัวเลขงบประมาณทั้งสองสอดคล้องกัน และยืนยันตัวเลขเดียวที่ใช้บังคับก่อนที่จะอนุมัติการใช้จ่าย โครงการนำร่องครั้งที่สองควรเก็บคะแนนพื้นฐานตั้งแต่ขั้นตอนการรับผู้เข้าร่วมด้วย
**ข้อควรระวัง:** ผู้เข้าร่วมไม่ได้ถูกจัดกลุ่มแบบสุ่ม และไม่มีการเก็บคะแนนพื้นฐาน ดังนั้น ตัวเลขเกี่ยวกับระดับการมีส่วนร่วมและผลสำรวจจึงสะท้อนเพียงสิ่งที่กลุ่มนี้ทำและรายงานเท่านั้น; ตัวเลขเหล่านี้ไม่สามารถบอกได้ว่าโครงการนี้ส่งผลอย่างไร หรือจะทำงานได้ดีเพียงใดหากนำไปใช้กับกลุ่มประชากรที่ต่างออกไป. Claude Fable 5.1: ผลลัพธ์เต็มรูปแบบ **หัวข้อ:** สรุปผลการตรวจสอบโครงการนำร่องและข้อเสนอแนะเกี่ยวกับโครงการนำร่องครั้งที่สอง
สวัสดี [ผู้อำนวยการ],
ด้านล่างนี้คือสรุปสถานะของโครงการนำร่อง ณ จุดตรวจสอบวันที่ 31 มีนาคม พร้อมด้วยข้อเสนอแนะเกี่ยวกับความเหมาะสมในการดำเนินการโครงการนำร่องครั้งที่สอง หมายเหตุนี้ครอบคลุมเฉพาะการตัดสินใจเกี่ยวกับโครงการนำร่องครั้งที่สองเท่านั้น ไม่รวมถึงการขยายใช้อย่างถาวร
- **การสมัครและเข้าร่วม:** มีนักเรียนสมัคร 120 คน ณ จุดตรวจสอบวันที่ 31 มีนาคม มี 96 คนที่เข้าร่วมอย่างน้อย 3 ครั้ง
- **ความคิดเห็นของผู้เข้าร่วม:** ผลสำรวจจากผู้ตอบ 71 คน ให้คะแนนเฉลี่ย 4.3 จาก 5
- **บันทึกงบประมาณ:** ใบงานปฏิบัติการโครงการระบุงบประมาณ $18,000 ในขณะที่บันทึกการอนุมัติทางการเงินระบุ $20,000 บันทึกการอนุมัติทางการเงินไม่ได้ระบุว่าความแตกต่างนี้เกิดจากการปรับแก้หรือข้อผิดพลาดในการบันทึก
** นโยบายผลลัพธ์ที่ถูกต้องครั้งแรก (First-valid-output policy) ความล่าช้าคือเวลาตามนาฬิกาจริง (wall-clock time) ที่ผ่าน Anywhere ไม่ใช่ความล่าช้าแบบ Anthropic ของระบบต้นทาง จำนวนโทเคนเป็นข้อมูลที่ผู้ให้บริการรายงาน; ไม่มีการคำนวณค่าใช้จ่าย API โดยตรงจากเส้นทางนี้.
ความถูกต้องของโค้ด
การทดสอบที่ 3: การดีบัก JavaScript ที่สามารถตรวจสอบได้ ผลภารกิจ: Opus 5 และ Fable 5.1 เสมอกัน, 10/10 ทั้งสามรุ่นที่มีอยู่ล้วนพบข้อผิดพลาดและสร้างโค้ดทดแทนที่ผ่านการทดสอบใน 8 กรณีที่สามารถรันได้ Opus และ Fable ส่งคืน JSON ที่ถูกต้องและได้คะแนนเท่ากันที่ 10/10 ส่วนโค้ดของ Sonnet ก็ผ่านการทดสอบเช่นกัน แต่ส่วน Markdown ที่ล้อมรอบทำให้ไม่ผ่านข้อกำหนดที่ต้องส่งคืน JSON โดยตรง.
ข้อมูลทดสอบแบบเต็ม วินิจฉัยและแก้ไขฟังก์ชัน JavaScript นี้ ให้คืนค่า JSON ที่มีเพียงสี่ฟิลด์เท่านั้น ได้แก่ root_cause (สตริง), replacement (สตริงที่ประกอบด้วยฟังก์ชันแทนที่แบบครบถ้วน), tests (อาร์เรย์ของสตริงกรณีทดสอบ), และ remaining_risk (สตริง) อย่าอ้างว่าคุณได้ดำเนินการทดสอบแล้ว ให้ทำการแก้ไขที่เรียบง่ายที่สุดแต่ชัดเจน ซึ่งตรงตามเงื่อนไขสัญญา
สัญญา:
- tasks เป็นอาร์เรย์ของฟังก์ชันที่ไม่มีอาร์กิวเมนต์และคืนค่าเป็น Promise
- คืนค่าแรกที่สำเร็จตามลำดับการป้อนข้อมูล แม้ค่านั้นจะเป็น 0, false หรือสตริงว่าง
- ละเว้นงานที่ถูกปฏิเสธ
- คืนค่า null เมื่องานทุกงานถูกปฏิเสธหรืออาร์เรย์ว่าง
รหัสปัจจุบัน:
async function firstSuccessful(tasks) {
const results = await Promise.all(tasks.map((task) => task()));
return results.find(Boolean) || null;
} Claude Haiku 4.5: ผลลัพธ์การดำเนินงานเต็มรูปแบบ ไม่มีการสร้างผลลัพธ์จากโมเดล ทั้งสองครั้งที่พยายามใช้ Anywhere API ที่ได้รับอนุญาตต่างก็ได้รับรหัสสถานะ HTTP 503 ดังนั้นเส้นทางนี้จึงถูกทำเครื่องหมายว่าไม่สามารถใช้งานได้ และถูกยกเว้นจากการประเมินคุณภาพ. Claude Sonnet 5: กำลังออกเต็ม ```json
{
"root_cause": "Two bugs: (1) Promise.all rejects immediately if any task rejects, instead of ignoring rejected tasks; (2) results.find(Boolean) incorrectly treats falsy fulfilled values (0, false, '') as failures, causing them to be skipped in favor of null.",
"replacement": "async function firstSuccessful(tasks) {\n const settled = await Promise.allSettled(tasks.map((task) => task()));\n const firstFulfilled = settled.find((r) => r.status === 'fulfilled');\n return firstFulfilled ? firstFulfilled.value : null;\n}",
"tests": [
"test('returns null for empty array', async () => { expect(await firstSuccessful([])).toBeNull(); });",
"test('returns null when all tasks reject', async () => { const tasks = [() => Promise.reject('err1'), () => Promise.reject('err2')]; expect(await firstSuccessful(tasks)).toBeNull(); });",
"test('returns first fulfilled value even if falsy (0)', async () => { const tasks = [() => Promise.resolve(0), () => Promise.resolve(42)]; expect(await firstSuccessful(tasks)).toBe(0); });",
"test('returns first fulfilled value even if false', async () => { const tasks = [() => Promise.resolve(false), () => Promise.resolve(true)]; expect(await firstSuccessful(tasks)).toBe(false); });",
"test('returns first fulfilled value even if empty string', async () => { const tasks = [() => Promise.resolve(''), () => Promise.resolve('nonempty')]; expect(await firstSuccessful(tasks)).toBe(''); });",
"test('ignores leading rejected tasks and returns first fulfilled in order', async () => { const tasks = [() => Promise.reject('err'), () => Promise.resolve('second'), () => Promise.resolve('third')]; expect(await firstSuccessful(tasks)).toBe('second'); });",
"test('preserves input order even if later task resolves faster', async () => { const tasks = [() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => new Promise((res) => setTimeout(() => res('fast-second'), 5))]; expect(await firstSuccessful(tasks)).toBe('slow-first'); });"
],
"remaining_risk": "The fix assumes 'first fulfilled value in input order' means the first task by array index that fulfills, regardless of timing, which matches the contract wording but await Promise.allSettled waits for all tasks to complete (including slow ones) before returning, which may not be desired if early-exit performance is needed; also unhandled promise rejection warnings are avoided by allSettled, but if tasks throw synchronously instead of returning rejected promises, this is not explicitly tested here beyond the reject cases."
}
``` Claude Opus 5: กำลังออกเต็ม {
"root_cause": "Two defects. (1) `Promise.all` rejects as soon as any task rejects, so a single rejected task makes the whole function reject instead of ignoring it and returning a later fulfilled value. (2) `results.find(Boolean) || null` selects by truthiness rather than by fulfillment, so legitimate fulfilled values such as 0, false, '', NaN, null, or undefined are skipped and/or coerced to null. Using `Promise.allSettled` plus a status check on the settled records fixes both, and returning `record.value` directly preserves falsy results.",
"replacement": "async function firstSuccessful(tasks) {\n const results = await Promise.allSettled(tasks.map((task) => task()));\n const firstFulfilled = results.find((result) => result.status === 'fulfilled');\n return firstFulfilled ? firstFulfilled.value : null;\n}",
"tests": [
"firstSuccessful([]) resolves to null (empty input).",
"firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a' (input order, not completion order).",
"firstSuccessful([() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => Promise.resolve('fast-second')]) resolves to 'slow-first' (order is by index, not by who settles first).",
"firstSuccessful([() => Promise.reject(new Error('boom')), () => Promise.resolve('second')]) resolves to 'second' (rejection ignored, does not propagate).",
"firstSuccessful([() => Promise.reject(new Error('a')), () => Promise.reject(new Error('b'))]) resolves to null (all reject).",
"firstSuccessful([() => Promise.resolve(0)]) resolves to 0, not null (falsy number preserved).",
"firstSuccessful([() => Promise.resolve(false)]) resolves to false (falsy boolean preserved).",
"firstSuccessful([() => Promise.resolve('')]) resolves to '' (empty string preserved).",
"firstSuccessful([() => Promise.resolve(undefined), () => Promise.resolve('later')]) resolves to undefined (first fulfilled wins even if its value is undefined).",
"firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null), () => Promise.resolve('third')]) resolves to null because index 1 fulfilled with null — verifying null-as-value is not confused with the all-rejected sentinel by inspecting status.",
"firstSuccessful([() => Promise.resolve(NaN)]) resolves to NaN (Number.isNaN on the result is true)."
],
"remaining_risk": "The function still starts every task and awaits all of them, so there is no short-circuiting: a slow or never-settling later task delays or blocks the result, and side effects of later tasks always occur. A task that throws synchronously (rather than returning a rejected promise) will throw inside `tasks.map`, causing the returned promise to reject instead of being ignored; wrap the invocation in `Promise.resolve().then(task)` if that must also be tolerated. `null` is still returned both for all-rejected/empty input and when a task genuinely fulfills with `null`, so callers cannot distinguish those cases. Non-array or non-function inputs are not validated, and rejection reasons are discarded rather than aggregated (no AggregateError), which can hide diagnostics."
} Claude Fable 5.1: ผลลัพธ์เต็มรูปแบบ {"root_cause":"Two defects: (1) Promise.all rejects as soon as any task rejects, so rejected tasks are not ignored and the function throws instead of skipping them; (2) results.find(Boolean) skips legitimate falsy fulfilled values (0, false, '') and the trailing '|| null' also converts such values to null, violating the requirement to return the first fulfilled value even when it is falsy.","replacement":"async function firstSuccessful(tasks) {\n const results = await Promise.allSettled(tasks.map((task) => task()));\n const first = results.find((result) => result.status === 'fulfilled');\n return first ? first.value : null;\n}","tests":["firstSuccessful([]) resolves to null","firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a'","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve('b')]) resolves to 'b' and does not throw","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.reject(new Error('y'))]) resolves to null","firstSuccessful([() => Promise.resolve(0), () => Promise.resolve(5)]) resolves to 0","firstSuccessful([() => Promise.resolve(false), () => Promise.resolve(true)]) resolves to false","firstSuccessful([() => Promise.resolve(''), () => Promise.resolve('z')]) resolves to ''","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null)]) resolves to null (fulfilled null is returned as-is)","firstSuccessful([() => new Promise(r => setTimeout(() => r('slow'), 50)), () => Promise.resolve('fast')]) resolves to 'slow' (input order wins over settlement order)"],"remaining_risk":"All tasks are started concurrently and the function waits for every task to settle before returning, so a slow task delays the result even when an earlier task has already fulfilled; a sequential or early-exit strategy would be needed if latency matters. A task that throws synchronously (rather than returning a rejected promise) will still cause the function to reject, since the contract assumes tasks return promises. Promise.allSettled requires ES2020 or a polyfill."} นโยบายผลลัพธ์ที่ถูกต้องครั้งแรก (First-valid-output policy) ความล่าช้าคือเวลาตามนาฬิกาจริง (wall-clock time) ที่ผ่าน Anywhere ไม่ใช่ความล่าช้าแบบ Anthropic ของระบบต้นทาง จำนวนโทเคนเป็นข้อมูลที่ผู้ให้บริการรายงาน; ไม่มีการคำนวณค่าใช้จ่าย API โดยตรงจากเส้นทางนี้.
ผลลัพธ์จาก Anywhere เหล่านี้แสดงให้เห็นว่า การเลือกโมเดลควรขึ้นอยู่กับงานที่ต้องทำ แทนที่จะยึดตามอันดับใน leaderboard เดียว ใน GlobalGPT คุณสามารถใช้วิธีการเปรียบเทียบเดียวกันกับ prompt ของคุณเอง เมื่อเทียบกับ Claude และโมเดลชั้นนำอื่น ๆ แล้วเลือกผลลัพธ์ที่ตรงกับมาตรฐานคุณภาพ ความต้องการด้านความเร็ว และปริมาณงานการตรวจสอบของคุณมากที่สุด.
วิธีดำเนินการเปรียบเทียบอย่างยุติธรรม
หยุดงานตัวอย่างหนึ่งไว้. ใช้เจตนา วัสดุต้นแบบ การเข้าถึงเครื่องมือ และการตรวจสอบการยอมรับเป้าหมายเดียวกัน.บันทึกผลลัพธ์ที่ถูกต้องครั้งแรก. อย่าให้รุ่นหนึ่งได้รับโอกาสลองใหม่เพิ่มเติมอย่างเงียบๆ ในการเปรียบเทียบหลัก.แยกคุณภาพออกจากความพร้อมใช้งาน. ข้อผิดพลาดในการตรวจสอบความถูกต้อง ความจุ และเส้นทางควรระบุไว้ในหมายเหตุเกี่ยวกับความพร้อมใช้งาน ไม่ใช่ในคะแนนคุณภาพ.วัดผลกระบวนการทำงานทั้งหมด. นับเวลาที่ผ่านไป ความพยายามของผู้ตรวจสอบ เวลาที่ใช้ในการแก้ไข และการกู้คืนงานที่ล้มเหลว.เลือกแบบการส่งผ่านที่มีราคาถูกที่สุด. ทำการทดสอบใหม่เมื่อมีคำแจ้งเตือน เครื่องมือ เวอร์ชันของโมเดล หรือค่าใช้จ่ายจากการล้มเหลวเปลี่ยนแปลง.
GlobalGPT เหมาะสำหรับกรณีใด
ดำเนินการเวิร์กโฟลว์ AI ทั้งหมดจากแดชบอร์ดเดียว
GlobalGPT รวมบริการสมัครสมาชิกหลายแบบในราคาที่คุ้มค่ากับชุดฟังก์ชัน AI ที่หลากหลายไว้ในแดชบอร์ดเดียว คุณสามารถใช้ Claude, GPT-5.6 Sol, Gemini 3 Pro, Kimi K3 และโมเดลชั้นนำอื่นๆ ได้ในทุกด้าน เช่น การวิจัย การเขียน การวางแผน การวิเคราะห์ การเขียนโค้ด และการปรับปรุง โดยไม่ต้องย้ายงานระหว่างผลิตภัณฑ์ที่แยกกัน.
CLI ของมันช่วยขยายพื้นที่ทำงานเดียวกันนี้ไปยังเทอร์มินัลของคุณ กระบวนการทำงานในการพัฒนา และเครื่องมือการผลิตที่มีอยู่. ลองใช้ข้อความคำสั่งของคุณเองกับโมเดลชั้นนำต่าง ๆ เมื่อการเปรียบเทียบมีประโยชน์ ก็ควรเก็บโมเดลที่เลือกไว้ภายในกระบวนการทำงานที่ใหญ่กว่า แทนที่จะถือว่าผลลัพธ์ที่แสดงแบบเคียงข้างกันเป็นจุดหมายปลายทาง.
Anthropic ใช้ Fable 5.1 สำหรับงานที่ต้องการประสิทธิภาพสูง เมื่อการประเมิน Opus 5 ที่ใช้ความพยายามมากขึ้นยังคงไม่เพียงพอ. หากต้องการศึกษาชั้นบนอย่างละเอียดยิ่งขึ้น โปรดติดตามต่อที่ การเปรียบเทียบรุ่น Claude ขั้นสูง หรือสำรวจหน้าเว็บที่จัดไว้โดยเฉพาะ คู่มือ Claude Fable 5.1 .
คำถามที่พบบ่อย
รุ่น Claude ที่มีอยู่ในปัจจุบันมีอะไรบ้าง? ตั้งแต่วันที่ 8 กันยายน 2026 ไลน์ผลิตภัณฑ์ที่ยังใช้งานอยู่ของ Anthropic ประกอบด้วย Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5 และ Claude Fable 5.1 เวอร์ชันและรหัสโมเดลที่แน่นอนอาจมีการเปลี่ยนแปลง ดังนั้นโปรดตรวจสอบข้อมูลสรุปโมเดลอย่างเป็นทางการอีกครั้งก่อนการปรับใช้.
ความแตกต่างระหว่าง Claude Haiku, Sonnet และ Opus คืออะไร? Haiku ให้ความสำคัญกับความเร็วและค่าใช้จ่ายโทเคนพื้นฐานที่ต่ำ Sonnet สร้างสมดุลระหว่างความเร็วและความสามารถสำหรับงานประจำวัน ส่วน Opus ให้ความสำคัญกับความสามารถในการจัดการงานที่ซับซ้อนหรือมีผลกระทบสูง การเลือกที่เหมาะสมขึ้นอยู่กับปริมาณงานและค่าใช้จ่ายในการตรวจสอบของคุณ ไม่ใช่การจัดอันดับแบบสัมบูรณ์.
ควรใช้รุ่น Claude รุ่นไหนสำหรับงานส่วนใหญ่? เริ่มต้นด้วย Sonnet 5 สำหรับงานเขียนทั่วไป การวิเคราะห์ การเขียนโค้ด การเข้าใจข้อมูลแบบภาพ และงานที่ใช้เครื่องมือ ส่วนเมื่อความผิดพลาดอาจก่อให้เกิดความเสียหายสูง หรืองานนั้นต้องการการวิเคราะห์เชิงลึกและการตรวจสอบที่ซับซ้อนยิ่งขึ้น ให้เริ่มต้นด้วย Opus 5 แทน.
รุ่น Claude รุ่นไหนเหมาะที่สุดสำหรับการเขียนโค้ด? Sonnet 5 เป็นจุดเริ่มต้นที่ใช้งานได้จริงสำหรับการเขียนโค้ดในชีวิตประจำวัน พร้อมกับการตรวจสอบและทดสอบตามปกติ ใช้ Opus 5 สำหรับการวินิจฉัยที่ซับซ้อน การเขียนโค้ดแบบเอเจนต์ที่ซับซ้อน การดำเนินการในระยะยาว หรือการเปลี่ยนแปลงที่อาจก่อให้เกิดค่าใช้จ่ายสูงหากเกิดข้อผิดพลาด.
รุ่น Claude รุ่นไหนเหมาะที่สุดสำหรับการเขียน? Sonnet 5 เป็นจุดเริ่มต้นที่สมดุลสำหรับงานเขียนและแก้ไขส่วนใหญ่ Haiku 4.5 สามารถจัดการกับเนื้อหาที่มีปริมาณมากและโครงสร้างที่แน่นหนาได้ ส่วน Opus 5 อาจคุ้มค่าที่จะลองใช้สำหรับงานสังเคราะห์ที่ซับซ้อนหรือเนื้อหาที่มีความสำคัญสูงและยากต่อการตรวจสอบ.
Claude Sonnet ดีกว่า Opus หรือไม่? ไม่ใช่ทุกกรณี Sonnet 5 มีอัตราเร็วกว่าและราคาถูกกว่าตามอัตรา API พื้นฐาน ส่วน Anthropic ช่วยให้ Opus 5 สามารถรับมือกับงานที่ซับซ้อนมากขึ้นได้ โมเดลที่ดีที่สุดคือตัวเลือกที่มีราคาถูกที่สุดและผ่านการตรวจสอบความถูกต้องของคุณได้อย่างน่าเชื่อถือ.
Claude Fable จะมาแทนที่ Opus หรือไม่? No. Anthropic กำหนดให้ Fable 5.1 เป็นระดับการขยายตัวสำหรับงานที่ต้องการการวิเคราะห์อย่างละเอียดหรืองานของเอเจนต์ที่ใช้เวลานาน เมื่อ Opus 5 ที่ต้องการความพยายามมากขึ้นยังไม่เพียงพอ ไม่ใช่เพื่อใช้แทน Opus อย่างทั่วไป.
Claude.ai และ API ของ Claude มีหน้าต่างบริบทที่เหมือนกันหรือไม่? ข้อจำกัดของแผน Claude.ai และข้อกำหนดของโมเดล API เป็นสองสิ่งที่แยกกันอยู่ ตารางแผนแต่ละแผนของ Anthropic ปัจจุบันระบุว่ามีหน้าต่างบริบท (context window) ขนาด 200K ในขณะที่เอกสาร API ระบุว่ามีหน้าต่างบริบทขนาด 1M สำหรับ Sonnet 5, Opus 5 และ Fable 5.1.
เมื่อไหร่ควรอัปเกรดจาก Haiku ไปยัง Sonnet หรือ Opus? ควรอัปเกรดเมื่อการตรวจสอบการยอมรับไม่ผ่าน กรณีขอบที่ยากลำบาก เวลาที่ใช้ในการแก้ไข ความพยายามในการตรวจสอบ หรือค่าใช้จ่ายจากข้อผิดพลาด มีน้ำหนักมากกว่าความเร็วและข้อได้เปรียบด้านราคาต่อโทเคนของโมเดลระดับต่ำ ให้ลดระดับโมเดลลงเมื่อโมเดลที่มีค่าใช้จ่ายต่ำกว่าผ่านการตรวจสอบแบบคงที่เดียวกันซ้ำแล้วซ้ำเล่า.
ราคาของ Claude Haiku, Sonnet และ Opus ผ่าน API เป็นเท่าใด? ตามอัตราพื้นฐานของ Anthropic ที่ได้รับการยืนยันเมื่อวันที่ 8 กันยายน 2026 Haiku 4.5 ใช้ $1 เป็นค่าป้อนเข้าและ $5 เป็นค่าออก Sonnet 5 ใช้ $2 และ $10, ส่วน Opus 5 มีค่าใช้จ่าย $5 และ $25 ต่อหนึ่งล้านโทเคน ดูข้อมูลของ Anthropic’s หน้าเว็บไซต์ราคาอย่างเป็นทางการ เพื่อดูอัตราปัจจุบันและรูปแบบการกำหนดราคาอื่นๆ.
คำตัดสินสุดท้าย: เริ่มด้วยรุ่นที่ถูกที่สุดที่ผ่านการทดสอบ
สำหรับงานผสมทั่วไป Sonnet 5 ยังคงเป็นค่าเริ่มต้นที่ใช้งานได้จริงที่สุด และเป็นรุ่นเดียวที่ผ่านการทดสอบทุกข้อจำกัดของ launch-note ในการทดสอบของเรา Opus 5 และ Fable 5.1 มีคะแนนรวม 26.5/30 เท่ากับ Sonnet โดยใช้ความแข็งแกร่งที่แตกต่างกัน ส่วน Haiku 4.5 ไม่สามารถให้คะแนนได้ เนื่องจากเส้นทาง Anywhere ส่งคืนรหัส 503 สำหรับทุกครั้งที่พยายามตามเงื่อนไขที่อนุญาต โปรดพิจารณาผลลัพธ์เหล่านี้เป็นหลักฐานเกี่ยวกับปริมาณงาน ไม่ใช่การจัดอันดับสากลที่ถาวร.
ขั้นตอนต่อไปของคุณนั้นง่ายมาก: กำหนดงานจริงหนึ่งงานให้คงที่ กำหนดว่าผลลัพธ์ที่ผ่านเกณฑ์ควรเป็นอย่างไร ทดสอบผู้สมัครที่มีศักยภาพสูงแต่ละรายภายใต้เงื่อนไขที่เทียบเคียงได้ และรวมเวลาการแก้ไขเข้าไปในต้นทุนสุดท้าย โมเดลที่ชนะคือโมเดลที่มีต้นทุนต่ำที่สุดและผ่านเกณฑ์ได้อย่างน่าเชื่อถือ ไม่ใช่โมเดลที่มีอัตราโทเคนต่ำที่สุดหรือชื่อระดับสูงที่สุด.
GlobalGPT ทำให้วิธีการดังกล่าวเป็นส่วนหนึ่งของกระบวนการทำงาน AI ที่กว้างขวางและราคาไม่แพง ใช้ Claude, GPT-5.6 Sol, Gemini 3 Pro, Kimi K3 และโมเดลชั้นนำอื่นๆ ที่มีฟังก์ชัน AI หลายอย่างในแดชบอร์ดเดียว แล้วนำงานไปใช้ในเทอร์มินัล กระบวนการพัฒนา และเครื่องมือผลิตที่มีอยู่ผ่าน CLI ของ GlobalGPT การทดสอบแบบเปรียบเทียบช่วยคุณในการเลือก; ข้อได้เปรียบที่ใหญ่กว่าคือการรักษาความเชื่อมต่อของกระบวนการทำงานทั้งหมด.