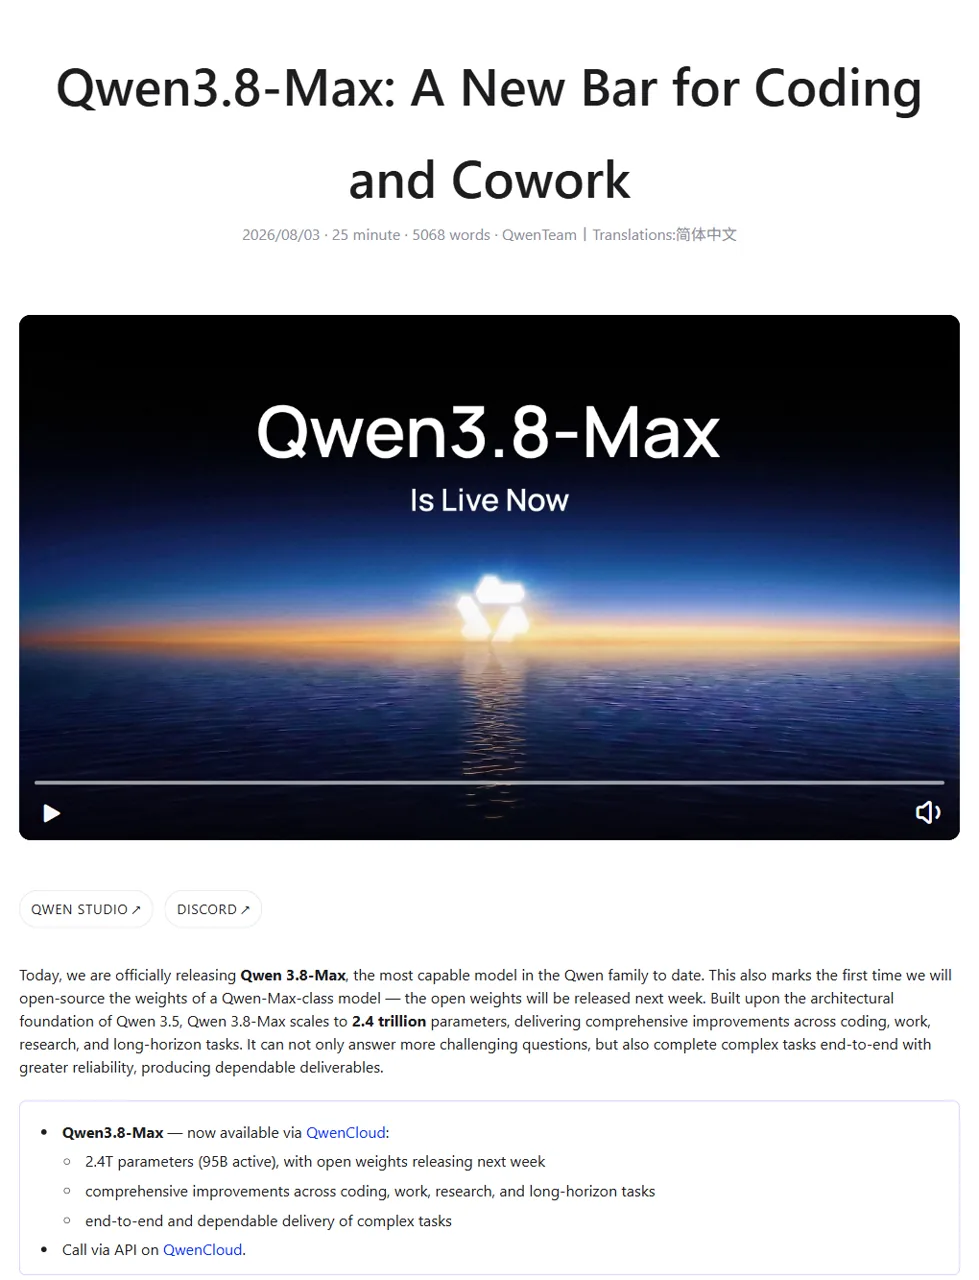
Qwen 3.8 Max — это новая флагманская модель Alibaba Qwen, предназначенная для программирования, профессиональной работы, запуска долго работающих агентов и решения мультимодальных задач. Официальное название Qwen3.8-Max, о чем было объявлено 3 августа 2026 года: модель насчитывает 2,4 триллиона параметров, 95 миллиардов активных параметров и контекстное окно объемом 1 миллион токенов.
Этот запуск — нечто большее, чем просто очередное обновление набора эталонных задач. Компания Qwen позиционирует эту модель как агента, способного планировать действия, использовать инструменты, анализировать визуальную обратную связь и продолжать работу в рамках длинных цепочек задач — а не просто как чат-бота, отвечающего на один запрос за раз. Это ставит её в один ряд с лучшие модели искусственного интеллекта для реальной работы, однако перед переходом стоит более внимательно изучить стоимость API, тарифный план с неограниченным трафиком и требования к развертыванию.
Что такое Qwen3.8-Max?
Qwen3.8-Max — это крупная модель типа «смесь экспертов», разработанная командой Qwen компании Alibaba. Общее количество параметров модели составляет 2,4 триллиона, однако при обработке каждого токена активируется 95 миллиардов параметров. Модель объединяет в одной системе анализ текста, кода, визуальное понимание, использование инструментов и долгосрочное планирование, что позволяет ей выполнять сложные задачи от начала до конца.
Сайт официальный релиз Qwen описывает четыре основные цели: более автономное программирование, профессиональные результаты производственного качества, более длительные задачи с замкнутым циклом и нативные мультимодальные агенты. С практической точки зрения, Qwen стремится к тому, чтобы модель перешла от задачи “ответить на этот вопрос” к задаче “взять эту цель, составить план, использовать доступные инструменты, проверить результат и продолжать, пока работа не будет выполнена”.”
Qwen 3.8 Максимальные технические характеристики
Число параметров следует рассматривать с учётом контекста. Модель с 2,4 триллионами параметров — это огромно, но модель Qwen3.8-Max не использует все параметры для каждого токена. Её архитектура «смеси экспертов» направляет каждый токен через меньшую активную часть сети. Поэтому показатель в 95 миллиардов активных параметров более полезен для понимания поведения модели при инференсе, чем просто общее количество параметров, хотя ни одна из этих цифр сама по себе не дает представления о реальной задержке или аппаратных требованиях.
Контекстное окно объемом 1 миллион токенов более практично в повседневной работе. Оно позволяет в рамках одного запроса обрабатывать большие репозитории, обширные наборы документов, развернутую историю действий агентов или операционные записи за несколько месяцев. Это не гарантирует полного воспроизведения информации по каждому токену, но дает разработчикам гораздо больше возможностей для сохранения инструкций, результатов работы инструментов, кода и промежуточных решений без необходимости агрессивного сокращения данных.
На что способен Qwen3.8-Max?
Автономное кодирование
В рекламных материалах Qwen особое внимание уделяется проектам, выходящим далеко за рамки простого запроса на генерацию кода. Компания описывает автономный процесс разработки, продолжающийся более 10 дней, в ходе которого проект проходит путь от пустой папки до проекта, готового к развертыванию в производственной среде, с адаптацией к ошибкам и новым требованиям. Это правильное направление развития для агентов, работающих с репозиториями, хотя покупателям всё же следует проверить работоспособность модели с учётом своих языков программирования, наборов тестов, правил безопасности и среды развертывания.
В повседневной инженерной практике практические вопросы гораздо проще: способна ли модель обрабатывать сразу несколько файлов? Сохраняет ли она интерфейсы при рефакторинге? Будет ли она писать тесты, анализировать сбои и исправлять собственные патчи? При выборе эти критерии важнее, чем один результат в рейтинге, когда речь идет о Лучшая модель искусственного интеллекта для кодирования.
Профессиональные задачи в рамках “коворкинга”
Термин “cowork” относится к результатам работы, а не к непринуждённому общению. Qwen освещает отчёты, исследования, презентации, аналитические материалы, документы и другие конечные результаты в сотнях различных профессий. Хорошая модель «cowork» должна следовать техническому заданию, систематизировать факты, использовать правильный формат и предоставлять результат, который можно отредактировать или передать дальше — а не просто убедительный абзац.
Агенты с длительным горизонтом
Qwen также демонстрирует выполнение задач системного уровня, продолжающихся сотни циклов. В качестве примеров приводятся оптимизация проектирования микросхем, занимающая более 500 шагов, и годовое моделирование стратегии электронной коммерции. Это демонстрации поставщика, а не обещание того, что каждый агент будет работать в автоматическом режиме в течение нескольких дней. Однако они наглядно показывают, на что ориентирован продукт: на непрерывное планирование, оценку по замкнутому циклу и постоянное совершенствование, а не на единичные решения.
Мультимодальное планирование и визуальная обратная связь
Qwen3.8-Max рассматривает изображения и экраны как часть цикла работы агента. Визуальный агент может проанализировать страницу, выбрать действие, отследить, что изменилось, и скорректировать свой план. Это позволяет решать задачи, связанные с использованием компьютера, пониманием документов, тестированием интерфейсов, визуальным программированием, работой с диаграммами и пространственным мышлением. Сложность заключается не просто в распознавании изображения, а в том, чтобы на протяжении многих шагов поддерживать связь между визуальными наблюдениями и целью агента.
Практические тесты: полезные результаты, медленные ответы и один проход без результатов
Я отправил три независимых запроса к qwen3.8-max идентификатор модели через API, совместимый с Anywhere OpenAI, 4 августа 2026 года. Речь идет о небольших практических проверках, а не о независимом тестировании производительности или утверждении, касающемся всех развертываний Qwen. Они полезны тем, что демонстрируют как качество отображаемого ответа, так и поведение тестируемого маршрута шлюза.
Отладка с помощью Retry-helper
В первой задаче использовалась неисправная функция повторных попыток из сценария платежного веб-хука. В задании были заданы следующие ограничения: три попытки, две точные задержки повторной попытки, немедленное завершение при успехе и повторное генерация третьего исключения в случае полного сбоя.
В ответе были выявлены три отдельных дефекта: безусловный переход в режим сна после каждой попытки, неназначенный результат после исключений, а также проверка «правдоподобия», которая задерживала или некорректно обрабатывала успешные результаты. Ожидаемая строка выглядела следующим образом: "paid" с аргументами sleep_fn [0.1, 0.2].
Тогда я запустил код локально, вместо того чтобы полагаться на объяснение. Он прошел три тестовых случая: два сбоя, за которыми последовал успех, а также значение, которое при первом вызове было ложноположительным, равное 0, а также три неудачных попытки, в которых итоговый RuntimeError("failure-3") пришлось повторно инициировать запрос. Это было удачное инженерное решение. Компромиссом стала задержка: видимый отклик занял 51,577 секунды при прохождении через тестируемый шлюз.
Синтез противоречивых данных
В рамках второй задачи проверялась способность модели отделять актуальные официальные факты от старых заметок, заявлений поставщиков, комментариев сообщества и непроверенного маршрута на платформе.
Модель правильно обработала искусственно созданный конфликт. Она не повторила контекст 256K или входную цену $1.20 в качестве текущей, не преобразовала комментарий о четырёх графических процессорах в требование к аппаратному обеспечению и не утверждала, что GlobalGPT уже имеет выделенный маршрут Qwen3.8-Max. Кроме того, она обозначила официальную таблицу результатов тестирования как предоставленную поставщиком. Ответ занял 94,973 секунды, так что это был ещё один результат, в котором приоритет отдавался качеству, а не скорости извлечения информации.
Что не удалось в ходе проверки плана?
В третьем запросе содержалась просьба предоставить двухчасовой план миграции CMS, разработанный двумя инженерами, с четко обозначенными контрольными точками «продолжить/прекратить» и «откат». Первый запрос завершился через 133,682 секунды, когда соединение с вышестоящим сервером было прервано. Более короткий набор попыток max_completion_tokens до 1 200, но API сообщил, что finish_reason: "длина", исчерпал весь выделенный объем ресурсов для вычислений и не вернул видимого результата по истечении 32,899 секунд.
Это полезное оперативное предупреждение, но оно не является доказательством того, что Qwen3.8-Max не способен планировать миграции. Для оценки не было доступно никакого плана. При использовании этого шлюза для сложного планирования требуется увеличить запас времени на выполнение, использовать потоковую обработку или поэтапные подсказки, чтобы внутреннее рассуждение не исчерпало весь бюджет ответа до вывода видимого текста.
Qwen: максимальные показатели производительности 3.8
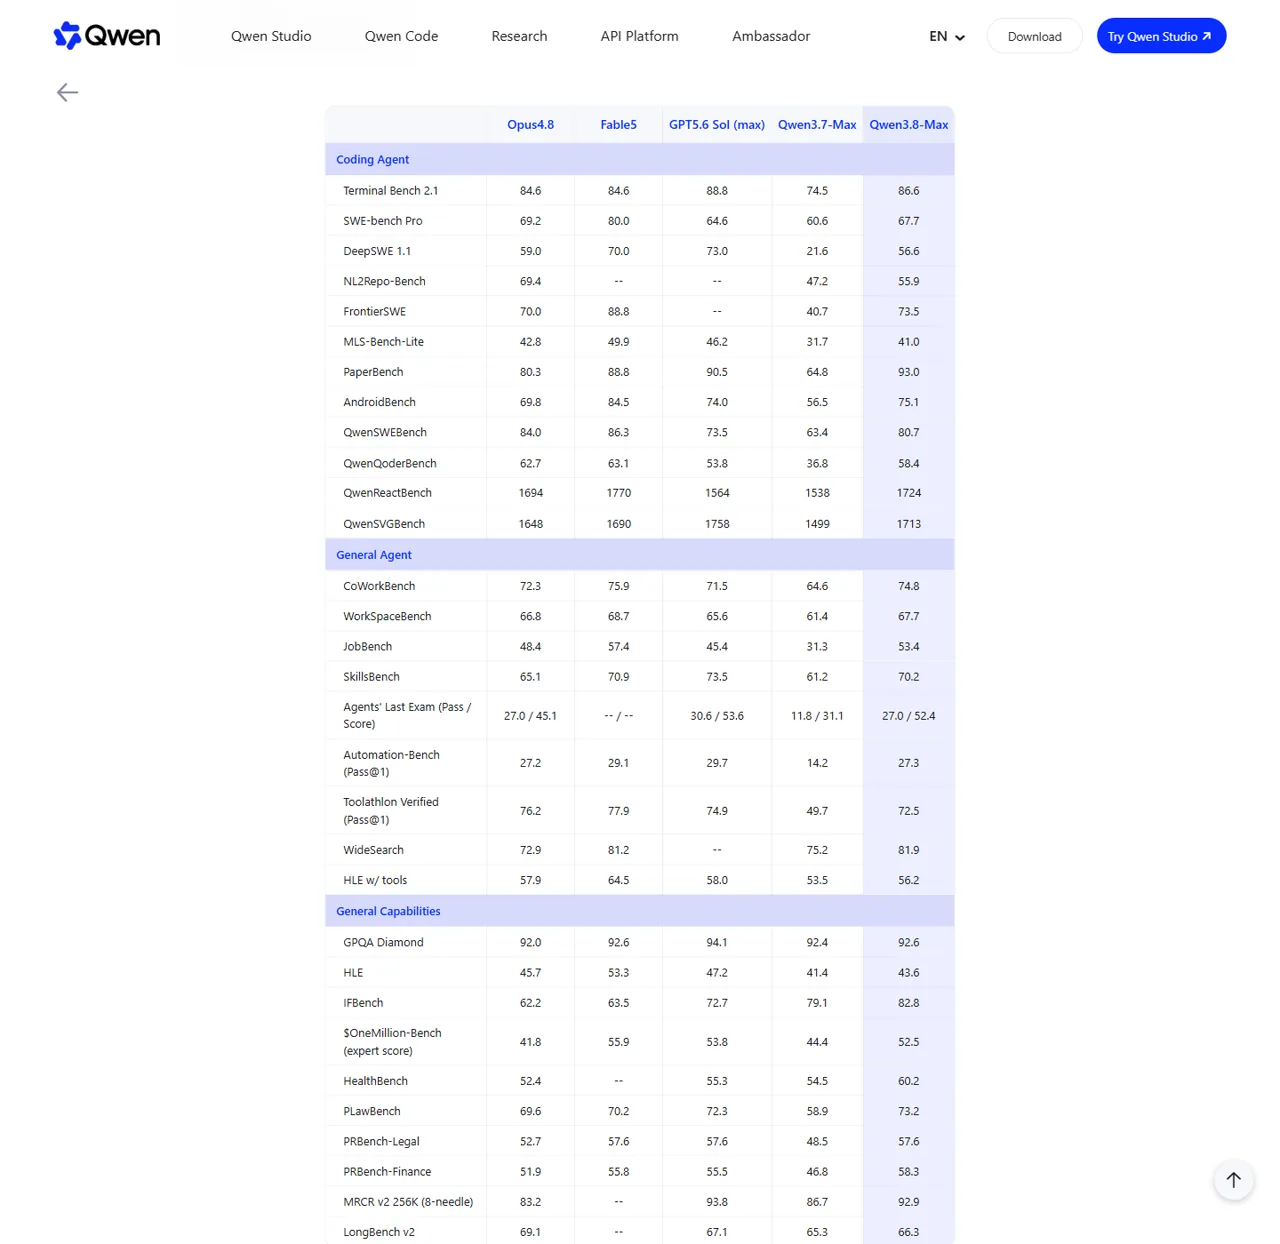
Официальный набор тестов Qwen демонстрирует, что Qwen3.8-Max является мощным кодирующим и мультимодальным агентом, однако результаты скорее неоднозначны, чем однозначно превосходны. В некоторых тестах он опережает перечисленные модели, в других находится рядом с лидером, а в нескольких категориях отстает от GPT-5.6 Sol или Fable 5. Такой подход даёт более объективную картину, чем сведение десятков тестов к одному ярлыку “лучшая модель”.
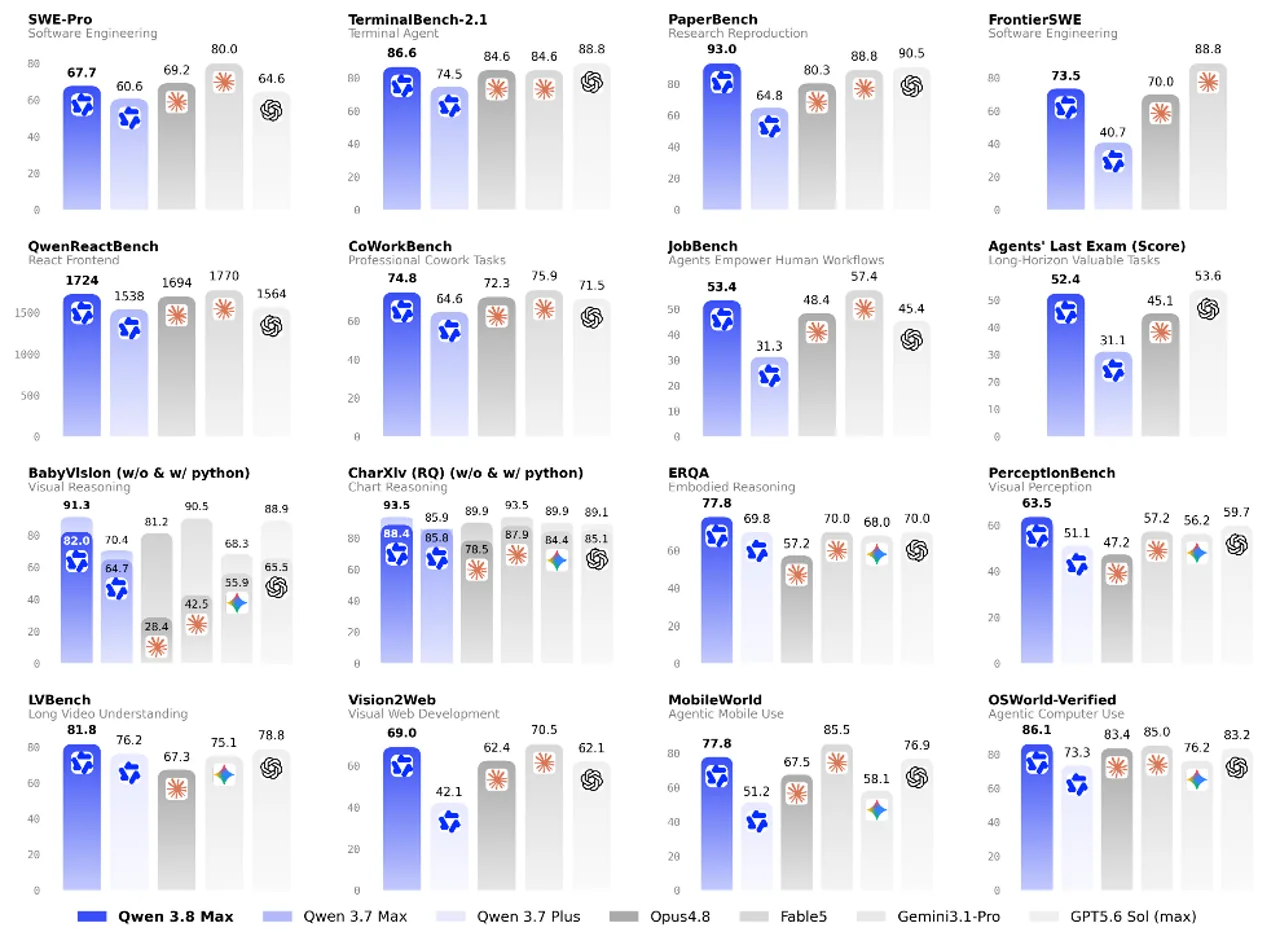
Избранные результаты из официальной таблицы Qwen
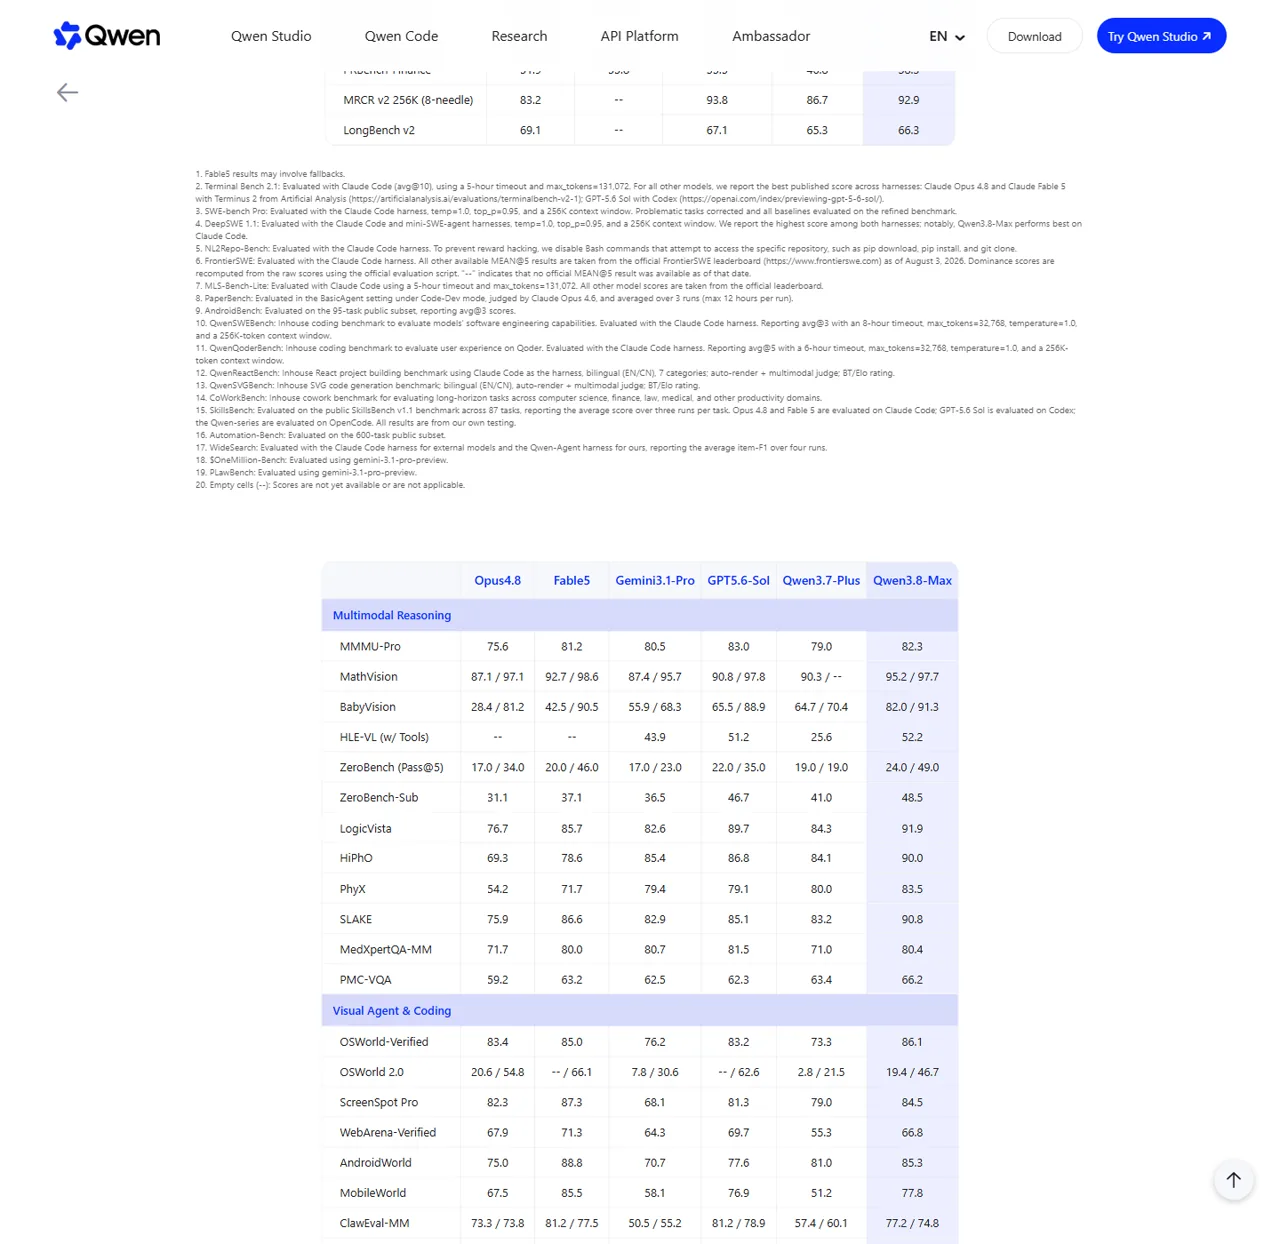
Эти данные взяты из официальных пресс-релизов компании Qwen. Из сносок следует, что в таблице смешаны данные из официальных отчетов по моделям, системных карт, общедоступных рейтингов и внутренних оценок компании Qwen. Кроме того, у некоторых моделей различаются комплектации и настройки. Воспользуйтесь таблицей, чтобы выявить перспективные преимущества, а затем проверьте отобранные варианты в ходе собственной работы, прежде чем принимать решение, связанное с большими затратами.
Что означают результаты кодирования
Самым очевидным преимуществом является сбалансированность. Модель Qwen3.8-Max демонстрирует одни из лучших результатов в таких задачах, как работа с терминалами, разработка программного обеспечения, выполнение задач на бумаге, совместная работа, поиск в Интернете и выполнение инструкций. Ему не нужно побеждать во всех категориях, чтобы быть полезным; агент, демонстрирующий стабильно высокие результаты в планировании, программировании, работе с инструментами и визуальной проверке, может оказаться более надежным, чем модель, оптимизированная для одного узкого теста.
Официальная таблица также демонстрирует, почему сравнительное тестирование имеет такое большое значение. Модель GPT-5.6 Sol лидирует в нескольких строках, связанных с логическим мышлением или работой с терминалами, в то время как модель Fable 5 сохраняет высокую конкурентоспособность в задачах, связанных с совместной работой, взаимодействием с интерфейсом и визуальными задачами. Отдельный Сравнение моделей GPT-5.6 и Fable 5 поможет вам применить эти семейства моделей к реальным повседневным сценариям использования, прежде чем включить модель Qwen3.8-Max в короткий список.
Что означают результаты мультимодального анализа
Система Qwen3.8-Max продемонстрировала высокие официальные результаты в таких областях, как мультимодальное мышление, визуальная привязка, работа с компьютером, работа с документами и пространственное восприятие. Её результат в 86,1 балла по тесту OSWorld-Verified особенно актуален для агентов, взаимодействующих с экраном, поскольку он оценивает выполнение задач в среде рабочего стола, а не просто описание изображения.
Сравнение модели Qwen3.8-Max с другими моделями
На вопрос “Лучше ли Qwen3.8-Max, чем GPT, Claude или Gemini?” нет однозначного ответа. Согласно собственным данным Qwen, лидеры в различных категориях меняются от строки к строке. Подходящий вариант также зависит от надёжности инструмента, качества результатов, задержки, региональной доступности, средств контроля конфиденциальности и интерфейса, окружающего модель.
Модель Qwen3.8-Max выглядит наиболее привлекательной, если вам нужна одна модель, способная справляться с программированием, обработкой документов, исследованиями, длительными задачами и визуальными агентами. Модель GPT-5.6 Sol по-прежнему может быть лучшим выбором для тех рабочих нагрузок, где её сильные стороны — способность к логическому мышлению и конечные результаты — находят применение в вашей среде. Модель Fable 5 заслуживает более пристального внимания при решении задач, связанных с совместной работой и интенсивным использованием пользовательского интерфейса; Сравнение моделей Fable 5 и Opus 4.8 содержит дополнительную информацию по этой части решения.
Планируемая возможность открытого доступа к весам модели может стать её главным структурным преимуществом. Сегодня важна только производительность на уровне API, но возможность загрузки весов открывает возможности для тонкой настройки, создания частной инфраструктуры, проведения исследований и регионального развертывания. Окончательная ценность будет зависеть от условий лицензии, форматов весов, поддержки квантования и аппаратного обеспечения, необходимого для работы модели с приемлемой скоростью.
Цены на API Qwen3.8-Max
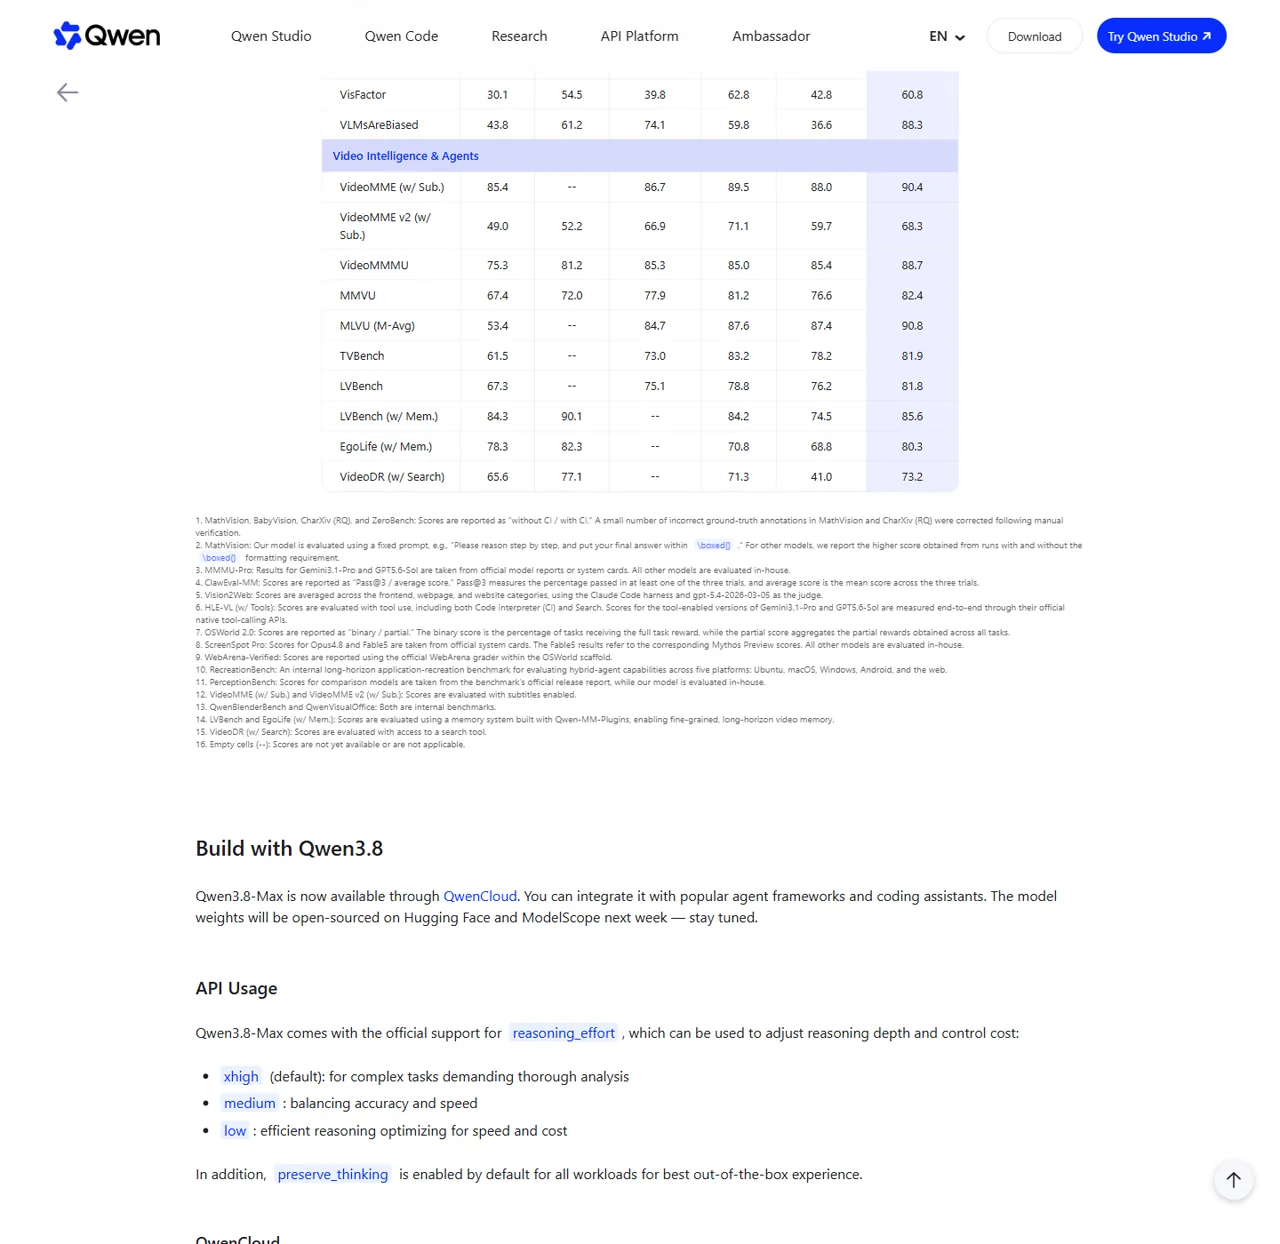
Компания Qwen указала в своём отчете следующие стартовые цены: официальное заявление:
Простая оценка выглядит следующим образом:
расчетная стоимость = входные данные, не находящиеся в кэше × $2/M + входные данные, находящиеся в кэше × $0,25/M + выходные данные × $6/M
Например, запуск с использованием 10 миллионов некешированных входных токенов и 2 миллионов выходных токенов обошёлся бы примерно в $32 по стартовым тарифам до начисления комиссий других платформ: $20 за вход плюс $12 за выход. Агент, который перечитывает большой репозиторий в каждом ходу, может потратить гораздо больше, что делает кэширование и управление контекстом столь же важными, как и базовая цена ввода.
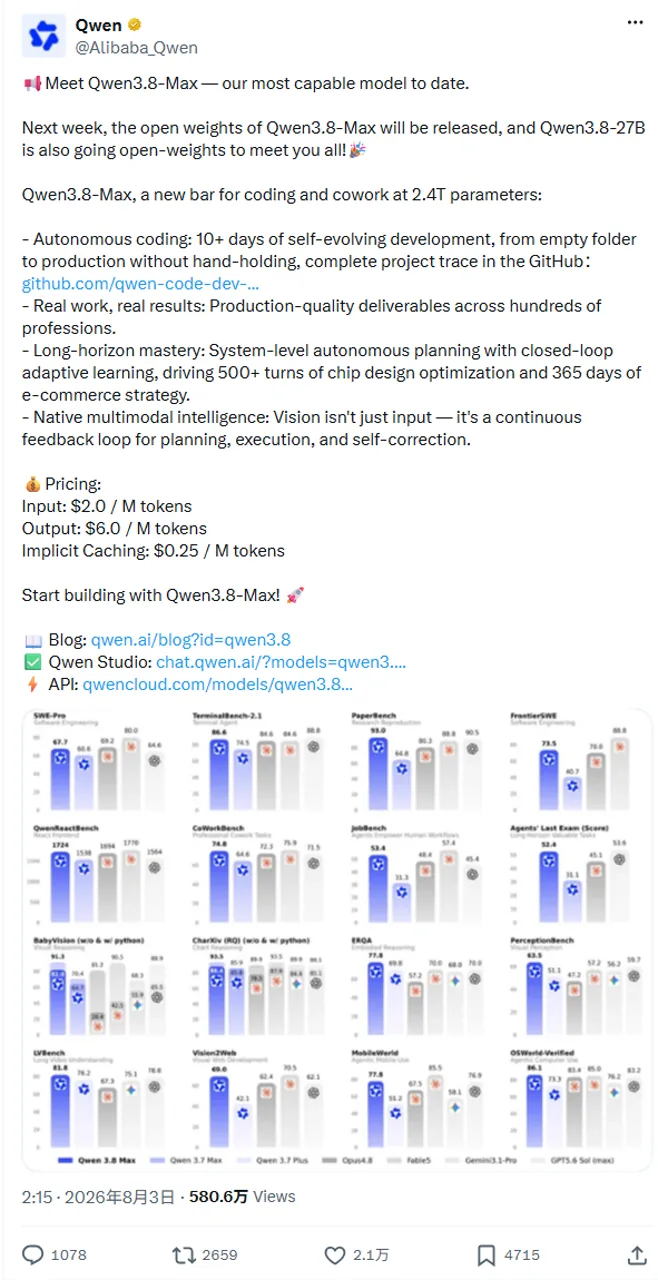
Qwen3.8-Max также поддерживает логическое_усилие элементы управления. В разделе, посвящённом официальному API, перечислены xhigh в качестве значения по умолчанию для комплексного анализа, средний для обеспечения баланса между точностью и скоростью, а также низкий для более быстрой и эффективной работы. сохранить_мышление включена по умолчанию. Эти средства управления позволяют сократить затраты, однако их следует тестировать с точки зрения качества выполнения задач, а не рассматривать как взаимозаменяемые режимы.
При сравнении цен разных поставщиков следует проявлять такую же осторожность. Модель с более низкой стоимостью токена может в итоге обойтись дороже, если для её работы требуются более длинные подсказки, большее количество повторных попыток или дополнительные вызовы инструментов. Руководство по ценам на API Gemini 3.1 Pro является наглядным примером того, почему наряду с базовой частотой важны также длина контекста и уровни использования.
Как получить доступ к Qwen3.8-Max
1. Используйте Qwen Studio для непосредственной оценки
Самый быстрый способ увидеть друг друга впервые — это Студия Qwen. Начните с реальной задачи, а не с тривиального вопроса: предоставьте неструктурированное техническое задание, задачу по программированию с несколькими файлами, набор документов или рабочий процесс, основанный на изображениях. Проверьте, является ли результат точным, редактируемым и достаточно полным, чтобы сэкономить время.
2. Использование API QwenCloud в приложениях
Модель Qwen3.8-Max можно приобрести через QwenCloud. На странице анонса указано, что API данного продукта поддерживает стандартные для отрасли протоколы автозаполнения чата и отправки ответов, совместимые со спецификацией OpenAI, а также интерфейс, совместимый со спецификацией Anthropic. Это упрощает миграцию, однако вам всё же следует ознакомиться с названиями моделей, параметрами, особенностями потоковой передачи данных, схемами инструментов и обработкой ошибок в официальной документации.
3. Подключить его к инструментам для программирования и работе с агентами
На странице выпуска Qwen перечислены возможности интеграции с Qwen Code, Claude Code, Codex и OpenClaw. Таким образом, данная модель может быть встроена в существующий рабочий процесс терминала или агента без необходимости разработки нового интерфейса. Поддержка интеграции не снижает затрат на сопутствующие инструменты, поэтому сравните стоимость модели с отдельной Структура ценообразования Codex прежде чем стандартизировать рабочий процесс команды.
Пользователям кода Claude также следует отдельно учитывать стоимость продукта для кодирования от API внешней модели. Доступные тарифные планы и способы выставления счетов приведены в Руководство по ценообразованию по коду Claude.
У пользователей OpenClaw возникает ещё один вопрос: какая модель обеспечивает оптимальное соотношение возможностей инструментов, скорости работы и цены для конкретного агента. Сравнение моделей OpenClaw предоставляет практическую основу для принятия такого решения, вместо того чтобы по умолчанию выбирать самую большую модель.
4. Обеспечить достоверность мультимодельного рабочего процесса
На момент запуска QwenCloud является проверенной технологической линией для Qwen3.8-Max. Если также сравнить альтернативные варианты GPT, Claude, Gemini или Fable, то Мультимодельная рабочая среда GlobalGPT может сократить количество переключений между вкладками при работе с поддерживаемыми моделями. Для модели Qwen3.8-Max используйте официальный маршрут Qwen до тех пор, пока не будет проверена специальная страница модели GlobalGPT; не следует предполагать, что URL новой модели существует только потому, что о ней было объявлено.
Qwen3.8 — Максимальные веса в открытом состоянии
Компания Qwen объявила, что весовые категории Qwen3.8-Max будут представлены в течение недели после запуска 3 августа. То же самое официальный пост в X Также было заявлено, что Qwen3.8-27B станет платформой с открытым весом. Это хорошая новость для локального внедрения и научных исследований, однако одного лишь этого объявления недостаточно для планирования создания производственного кластера.
Прежде чем загружать оборудование или составлять бюджет на его приобретение, проверьте пять пунктов из окончательной спецификации модели:
- Точные условия лицензии и коммерческого использования.
- Официальные URL-адреса репозиториев Hugging Face или ModelScope.
- Доступные форматы точности и квантования.
- Минимальные и рекомендуемые требования к процессору, видеокарте, оперативной памяти и хранилищу.
- Соответствует ли выпущенная модель поведению размещенного API и длине контекста.
“Открытый вес” и “открытый исходный код” — это не всегда одно и то же. Термин «открытые веса» означает, что параметры модели можно скачать; лицензия же определяет, что именно вы можете изменять, распространять или использовать в коммерческих целях. Пока репозитории и лицензия не будут доступны, страницы, обещающие скачивание Qwen3.8-Max, сборку GGUF или точные требования к локальному оборудованию, опережают реальность.
С анонсом модели 27B следует поступить точно так же. Возможно, она станет более реалистичным выбором для местных пользователей, но данные об её архитектуре, длине контекста, требованиях к памяти и результатах тестов должны быть взяты из официальной спецификации именно этой модели, а не скопированы из спецификации модели Max.
Qwen3.8 — Максимальные ограничения и оптимальный подбор
Ограничения, которые следует учитывать
- Большая часть данных о запуске получена из источника Qwen. В ходе независимых оценок могут использоваться различные задания, инструменты или правила выставления оценок.
- Длинный контекст — это не идеальная память. Модель может обработать 1 миллион токенов и при этом упустить какую-то деталь или выполнить неточное указание.
- Агенты с большим объемом вывода данных могут обходиться дорого. Показатель производительности $6 на миллион имеет значение, когда в рамках рабочего процесса генерируются длинные коды, отчеты или повторяющиеся трассировки рассуждений.
- Информация о локальном развертывании будет неполной до тех пор, пока не поступят веса и карта модели. Система с полным набором параметров 2.4T не будет работать так же, как небольшая настольная модель.
- Использование инструментов создает дополнительный уровень риска. Состояние браузера, разрешения, сетевые ошибки и некорректно определенные схемы инструментов могут привести к сбою даже вполне работоспособной модели.
- Информация о запуске быстро меняется. Перед публикацией или закупкой следует еще раз проверить цены, репозитории, возможности интеграции и доступность.
Кому стоит попробовать это прямо сейчас?
Суть в том, что Qwen3.8-Max заслуживает тщательного тестирования, но не слепого перехода на него. Используйте одну ресурсоемкую задачу с чётко определённым критерием успешного выполнения, зафиксируйте общее количество токенов и повторных попыток, а затем сравните конечный результат — а не только первый ответ.
Часто задаваемые вопросы
Когда вышла версия Qwen 3.8 Max?
Официальный анонс Qwen3.8-Max состоялся 3 августа 2026 года. С момента запуска хостируемая модель стала доступна через Qwen Studio и QwenCloud. Компания Qwen сообщила, что открытые веса будут выпущены на следующей неделе, поэтому доступность API и возможность загрузки весов следует рассматривать как отдельные этапы.
Является ли Qwen3.8-Max проектом с открытым исходным кодом?
Компания Qwen объявила об открытых весовых коэффициентах для версии Qwen3.8-Max, однако окончательные условия хранилища и лицензии определяют, что именно пользователи могут запускать, изменять, распространять или использовать в коммерческих целях. До тех пор, пока эти файлы не будут опубликованы и проверены, формулировка “объявлено о выпуске с открытыми весовыми коэффициентами” будет более точной, чем предположение о том, что все разрешения на использование открытого исходного кода или локальные форматы уже доступны.
Сколько параметров имеет модель Qwen3.8-Max?
Модель Qwen3.8-Max имеет в общей сложности 2,4 триллиона параметров и активирует 95 миллиардов параметров на каждый токен. Она использует архитектуру «микс экспертов», поэтому общее количество параметров и количество активных параметров отражают разные аспекты системы. Ни один из этих показателей в отдельности не позволяет предсказать реальную скорость работы или требования к аппаратному обеспечению.
Что такое контекстное окно Qwen3.8-Max?
В официальном релизе указано, что окно контекста составляет 1 миллион токенов. Этого вполне достаточно для обширного кода, документов, вывода инструментов и истории действий агента, однако максимальный размер контекста не гарантирует идеального поиска. Протестируйте модель с учетом расположения, формата и плотности информации, используемой в вашем реальном рабочем процессе.
Сколько стоит API Qwen3.8-Max?
На момент запуска стоимость Qwen составляла $2 за миллион входных токенов, $6 за миллион выходных токенов и $0,25 за миллион неявно кэшированных токенов. Рассматривайте эти значения как стартовые цены и проверьте их перед составлением бюджета. Стоимость агента также зависит от повторного использования контекста, затрат на вывод заключений, количества повторных попыток и длины сгенерированных выходов.
Модель Qwen3.8-Max лучше, чем GPT-5.6 Sol или Fable 5?
Не во всех тестах. Согласно официальной таблице Qwen, модель Qwen3.8-Max лидирует в некоторых тестах по программированию, поиску, выполнению инструкций и работе с компьютером, тогда как в других тестах лидируют модели GPT-5.6 Sol или Fable 5. Выбор более подходящей модели зависит от задачи, среды разработки, задержки, цены и качества конечного результата.
Можно ли запустить Qwen3.8-Max локально?
Компания Qwen объявила о возможности загрузки весовых коэффициентов на неделю после запуска, однако возможность их применения в конкретных условиях зависит от окончательного вида файлов, точности, поддержки квантования, лицензии и рекомендаций по аппаратному обеспечению. Не стоит полагаться на точные оценки объёмов оперативной памяти (RAM), видеопамяти (VRAM) или объёма хранилища до появления официальной спецификации модели. Более компактные варианты Qwen3.8 могут оказаться более практичными после публикации официальной документации.
Что такое Qwen3.8-27B?
В анонсе Qwen говорится, что версия Qwen3.8-27B также будет выпущена с открытыми весами. В статье о выпуске Max не приводится достаточно подробной информации, чтобы использовать технические характеристики модели Max для версии 27B. Ознакомьтесь со специальной карточкой модели, чтобы узнать о её архитектуре, контекстном окне, результатах тестирования, лицензии и инструкциях по загрузке.
Можно ли использовать Qwen3.8-Max на GlobalGPT?
На момент публикации специальный маршрут GlobalGPT для Qwen3.8-Max не был проверен. Для прямого доступа используйте Qwen Studio или QwenCloud. GlobalGPT по-прежнему полезен для сравнения других доступных моделей GPT, Claude, Gemini и Fable без смены платформы.
Окончательный вердикт
Для непосредственной оценки модели Qwen3.8-Max используйте Qwen Studio или QwenCloud. Для сравнения с другими проверенными моделями используйте GlobalGPT, не предполагая при этом, что специальный маршрут Qwen3.8-Max уже существует.
Сравнить доступные моделиQwen 3.8 Max — один из самых амбициозных запусков моделей 2026 года: 2,4 триллиона параметров всего, 95 миллиардов активных параметров, контекстное окно объёмом 1 миллион токенов, впечатляющие официальные результаты в задачах программирования и мультимодальных агентов, а также объявленный план перехода к открытому весовому пространству. Цены на API при запуске достаточно конкурентоспособны для тестирования, особенно с учётом того, что кэширование снижает затраты на повторное использование контекста.
Самая весомая причина, по которой стоит обратить на это внимание, — это не просто победа в одном тесте производительности. Это попытка объединить в одной модели программирование, профессиональные результаты, долгосрочное планирование, визуальную обратную связь и использование инструментов. Начните с Qwen Studio или контролируемого тестирования QwenCloud, оцените качество выполненных задач и общую стоимость, а затем дождитесь официальных весовых коэффициентов и лицензии, прежде чем давать обещания по локальному развертыванию.
Первоисточники, проверенные 4 августа 2026 года: Официальный выпуск Qwen3.8-Max и Официальный пост о запуске @Alibaba_Qwen.