Muse Spark 1.2 сочетает в себе необычно низкую стоимость токенов с контекстным окном объемом 1 млн токенов и успешно выполнила все три задачи по кодированию базовых моделей в нашем наборе тестов API «с первой попытки». Meta запустила эту модель на 5 августа 2026 года, с контекстным окном объемом 1 миллион токенов, двумя тарифными планами API и отдельным терминальным агентом под названием Muse Code. Результаты тестирования Meta выглядят многообещающими; независимые открытые рейтинги по программированию пока не проверили те же комбинации моделей и агентов.
В данном обзоре проводится разграничение между моделью и агентом, официальными оценками и независимыми данными, а также стандартной ценовой политикой и компромиссом между использованием данных и уровнем «Contributor». В ходе наших тестов модель выполнила исправление идемпотентности в Python, рефакторинг TypeScript с сохранением совместимости и реализацию функции JSONL для всего репозитория без повторных попыток. Выполнение агента Muse Code не тестировалось, а надежность вызова инструментов не проверялась. Если вы сначала сравниваете более широкую область, наше руководство по Лучшие модели искусственного интеллекта для кодирования позволяет увидеть более широкий контекст конкуренции.
Обзор Muse Spark 1.2: краткий обзор
Вкратце: Muse Spark 1.2 — это модель Meta, ориентированная на программирование, с окном длиной 1 млн токенов, доступом к API, совместимым с SDK OpenAI, и привлекательным уровнем «Contributor». Её главным преимуществом является стоимость: $0.10 на входе и $0.20 на выходе на миллион токенов в модели «Contributor». Этот уровень может использоваться для улучшения продуктов Meta, в то время как более дорогая стандартная модель для этих целей не применяется.
Что касается производительности, здесь следует проявлять большую сдержанность. Компания Meta сообщает о результатах 82,91 TP40T в тесте Terminal-Bench 2.1 для Muse Spark 1.2 с Muse Code и 59,31 TP40T в тесте DeepSWE. Это результаты, полученные компанией Meta. На общедоступных досках Terminal-Bench и DeepSWE Muse Spark 1.2 по-прежнему не фигурировала при проверке 26 августа 2026 года. Искусственный анализ позволяет провести независимую перепроверку: его индекс интеллекта по-прежнему составляет 57, что выше медианы для сопоставимых моделей, равной 35.
- Лучшая причина попробовать это прямо сейчас: Низкие цены для авторов, обширный контекст и API, построенный по знакомой схеме клиента OpenAI.
- Главная причина для осторожности: Три контролируемых теста на базовой модели не позволяют оценить надежность агента Muse Code, качество вызовов инструментов или производительность в условиях большого производственного репозитория.
- Важный выбор, касающийся конфиденциальности: Используйте стандартную модель для кода или подсказок, которые вы не хотите, чтобы использовались для улучшения продуктов Meta.
Краткий обзор Muse Spark 1.2
Подтвержденные технические характеристики
Компания Meta описывает Muse Spark 1.2 как модель, отличающуюся более высокой точностью кодирования с первой попытки и более надежным вызовом инструментов по сравнению с Muse Spark 1.1. Это заявления разработчика, взятые из официальная страница модели Muse Spark, а не выводы, сделанные по итогам нашей собственной сессии по кодированию.
Muse Spark 1.2 против Muse Code
Muse Spark 1.2 — это модель. Muse Code — это отдельный бета-версия терминального агента, работающего на основе этой модели. Это различие имеет значение, поскольку агент может реализовать функции планирования, координации работы инструментов, навигации по репозиторию, изоляции рабочего дерева, ведения журнала и повторных попыток в рамках базовой модели.
Держите слои отдельно
Muse Spark 1.2
Контекст, логика, поведение API, тарификация по токенам, выходные данные и решения о вызове инструментов.
Идентификаторы моделей1M контекстЦенообразование API
Код «Муза»
Пользовательский интерфейс терминала, субагенты, рабочие дерево Git, журнал событий, возобновление потока, встроенные навыки и оркестрация.
Рабочий процесс агентаРезультаты работы системы Meta-run
Сайт официальная страница «Muse Code» называет данный продукт «бета-кодирующим агентом». Поэтому сравнение с такими продуктами, как Claude Code и Codex, оказывается более полезным, чем предположение, что каждое наблюдаемое различие в рабочем процессе обусловлено исключительно вызовом базовой модели. Наш Сравнение кодов Codex и Claude объясняет, почему среда разработки может повлиять на опыт разработчика не меньше, чем сама модель.
Тесты Muse Spark 1.2: что на самом деле показывают результаты
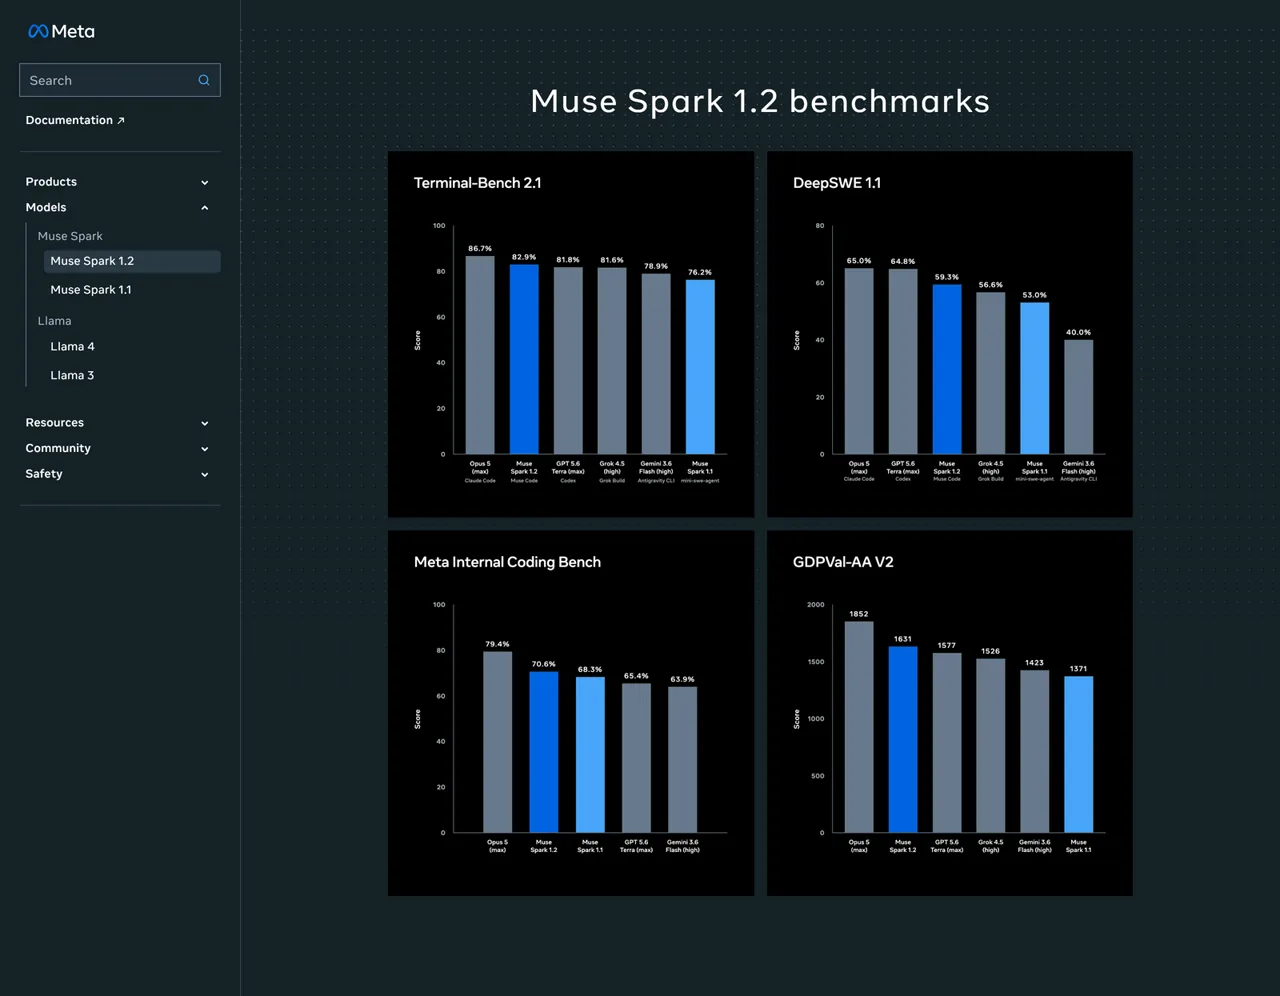
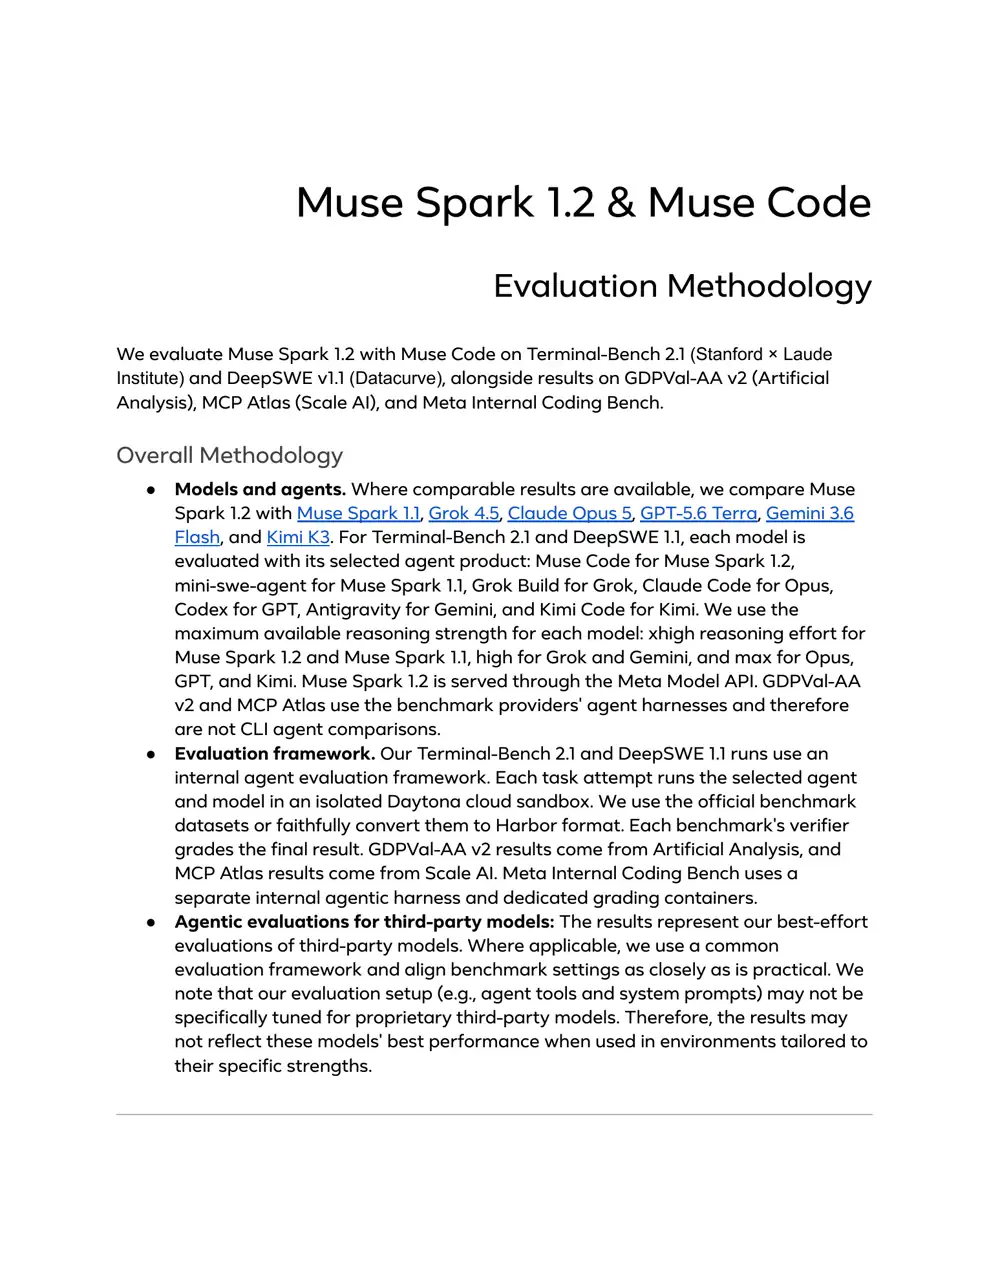
Согласно сравнительной таблице Meta, Muse Spark 1.2 занимает одно из лидирующих мест в нескольких тестах по программированию. Эти цифры заслуживают внимания, но они не отражают единого четкого рейтинга исходного качества модели. Модель, агент, набор тестов, способность к рассуждению и протокол задачи могут меняться одновременно.
Мета-отчет по Terminal-Bench 2.1
Панель мета-тестов
Terminal-Bench 2.1
Все 89 задач · pass@1 за пять попыток · выбранные комбинации моделей и агентов
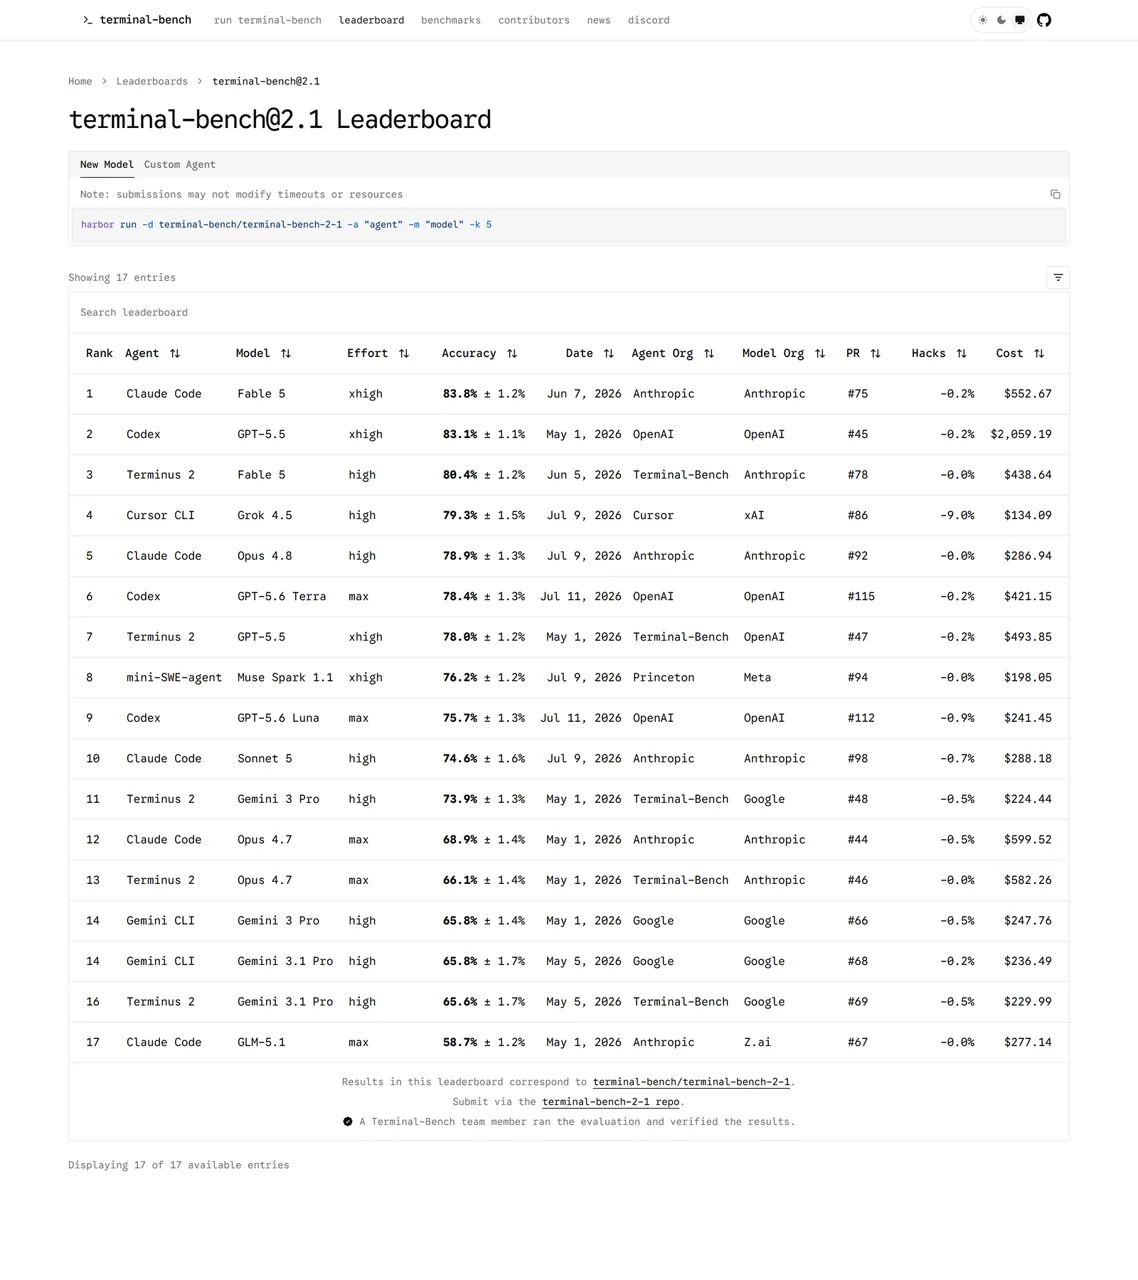
Показатель 82,9% представляет собой Результат выполнения кода Muse в режиме Meta-run. . Публичная таблица лидеров Terminal-Bench 2.1 26 августа 2026 года Muse Spark 1.2 не был включен в список, поэтому он непроверенная запись в общедоступном рейтинге. В общедоступной таблице действительно указан Muse Spark 1.1 с мини-SWE-агентом со значениями 76,21 TP40T ±1,21 TP40T.
Мета-отчет по DeepSWE 1.1
Панель мета-тестов
DeepSWE 1.1
113 заданий · 91 репозиторий · пять языков · pass@1 за пять попыток
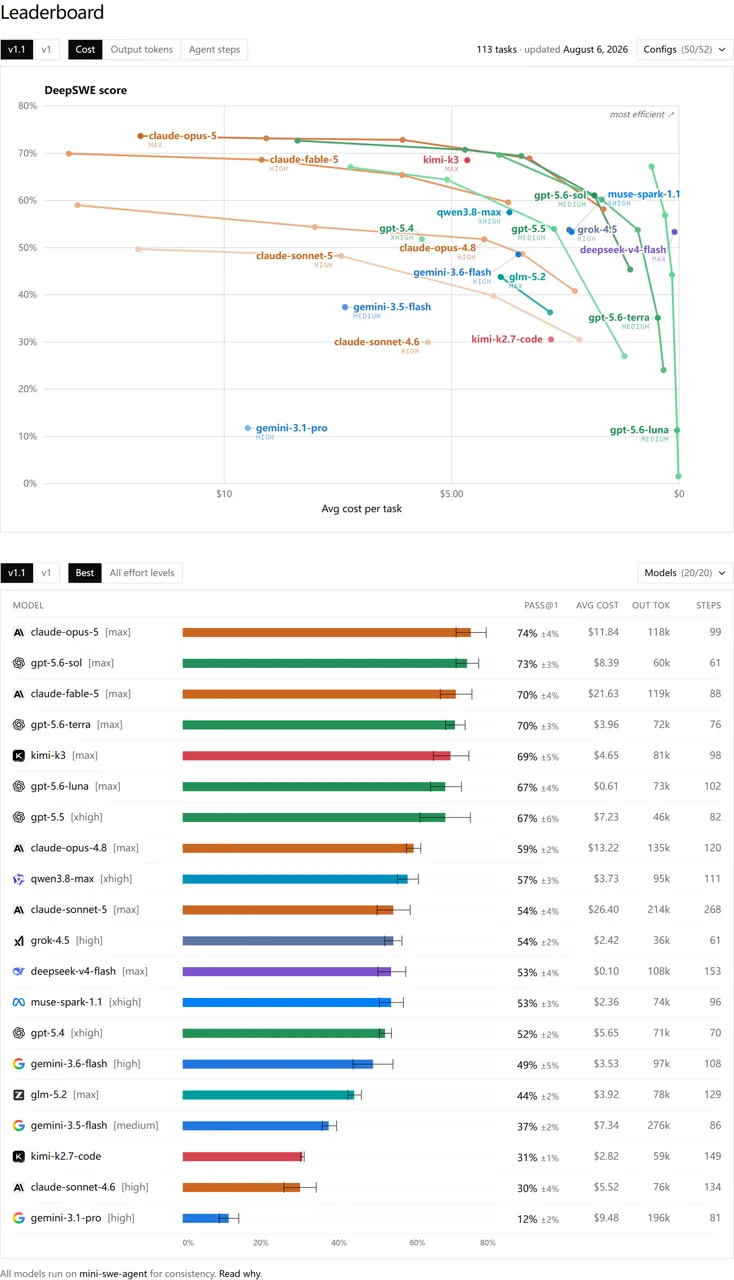
Сайт публичная таблица лидеров DeepSWE v1.1 для обеспечения единообразия во всех перечисленных моделях используется мини-swe-agent. На момент проверки модель Muse Spark 1.2 не была добавлена в список; модель Muse Spark 1.1 была указана с показателем 53%. Результат Meta (59,3%) получен с использованием Muse Code, поэтому эти два показателя не являются идентичными с точки зрения тестовой платформы.
Оценки Meta: внутренние и общие
Две разные шкалы оценки
Внутренняя платформа Meta для кодирования
440 внутренних заданий · по две попытки на каждое задание
| Модель | Счет |
|---|---|
| Опус № 5 | 79.4% |
| Muse Spark 1.2 | 70.6% |
| GPT-5.6 Terra | 65.4% |
| Gemini 3.6 Flash | 63.9% |
| Grok 4,5 | Не показано |
GDPVal-AA v2
Общая оценка агентных задач · Значения в стиле Elo
| Модель | Счет |
|---|---|
| Опус № 5 | 1852 |
| Muse Spark 1.2 | 1631 |
| GPT-5.6 Terra | 1577 |
| Grok 4,5 | 1526 |
| Gemini 3.6 Flash | 1423 |
Meta’s методология оценки Согласно данным, Terminal-Bench использует все 89 задач и показывает результат pass@1 за пять попыток. DeepSWE охватывает 113 задач из 91 репозитория и на пяти языках программирования, также демонстрируя результат pass@1 за пять попыток. В Meta также отмечают, что их конфигурация, возможно, не оптимально настроена для сторонних моделей. Актуальное сравнение с конкурентами, основанное на реальных решениях по продуктам, см. Claude Opus 5 против GPT-5.6.
Методология меняет смысл
Модель + выбранный агент
89 задач, пять попыток, различные настройки максимального уровня логического мышления, а набор тестов Meta может быть не одинаково адаптирован для сторонних систем.
Проверенные записи
При проверке было обнаружено отсутствие Muse Spark 1.2. Параметры конфигурации платы и статус проверки необходимо извлекать отдельно из таблицы Meta.
Распространенный мини-све-агент
113 задач в 91 репозитории на пяти языках. Версия Muse Spark 1.2 отсутствовала; версия Muse Spark 1.1 была указана с показателем 53%.
Анализ искусственного интеллекта: полезный независимый контекст
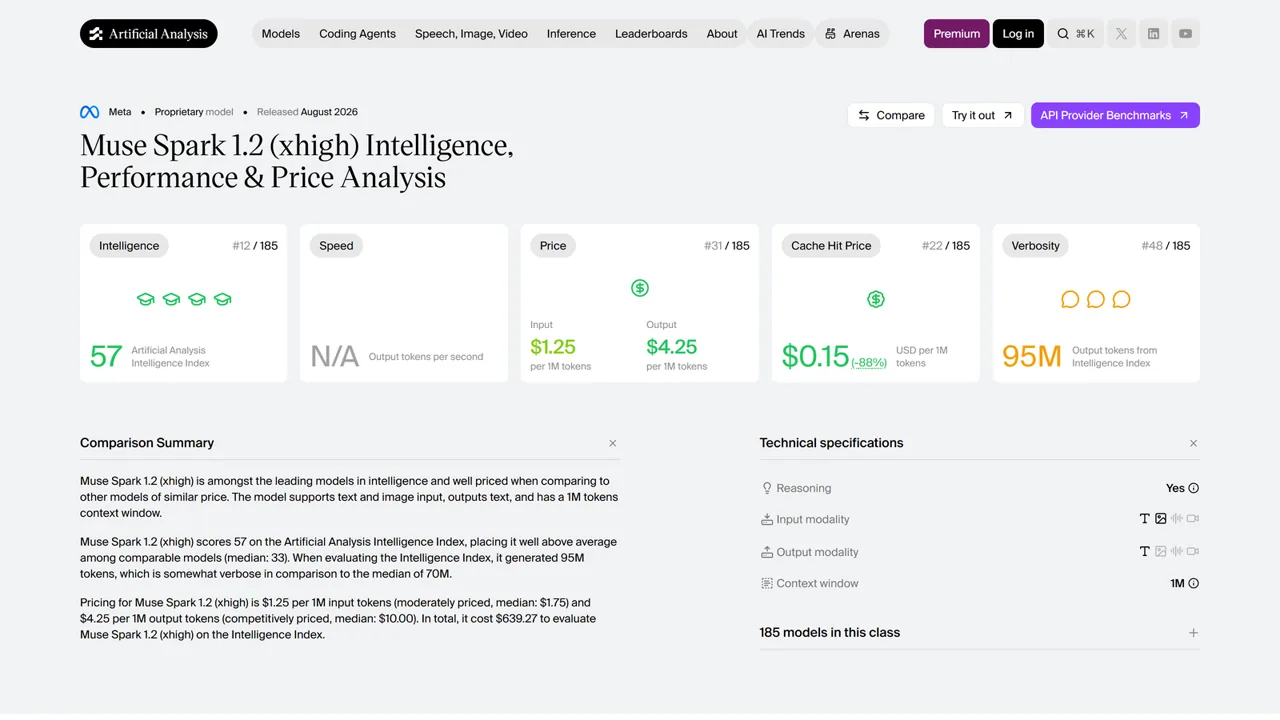
Сайт Страница модели «Искусственный анализ» присваивает Muse Spark 1.2 индекс интеллекта, равный 57, что превышает медиану показателя для аналогичных моделей, равную 35, по данным на 26 августа 2026 года. Его набор тестов показывает результаты 80% в Terminal-Bench v2.1, 57% (нормализованные по GDPVal-AA v2), 56% в SciCode и 83% в оценке AA-LCR с длинным контекстом.
Сдвиг версии в искусственном анализе
Практический вывод прост: Muse Spark 1.2 выглядит конкурентоспособной моделью, но ни один отдельный показатель не может дать полного представления о ней. Рассматривайте график Meta как подтверждение эффективности системы Muse Code, публичные рейтинги — как отдельную перепроверку, а Artificial Analysis — как независимую, но настроенную по-другому систему оценки.
Muse Spark 1.2: соотношение цены и конфиденциальности
Meta предлагает два идентификатора моделей API с кардинально разными ценами. Более дешевый вариант — это не просто скидка: он меняет условия использования предоставляемых данных.
долларов США за один миллион токенов · в контексте 1 млн
Не используется для улучшения продукта
Не используется для улучшения продуктов Meta
Дешевле, но с ограничением по трафику
Данные может использоваться для улучшения продуктов Meta
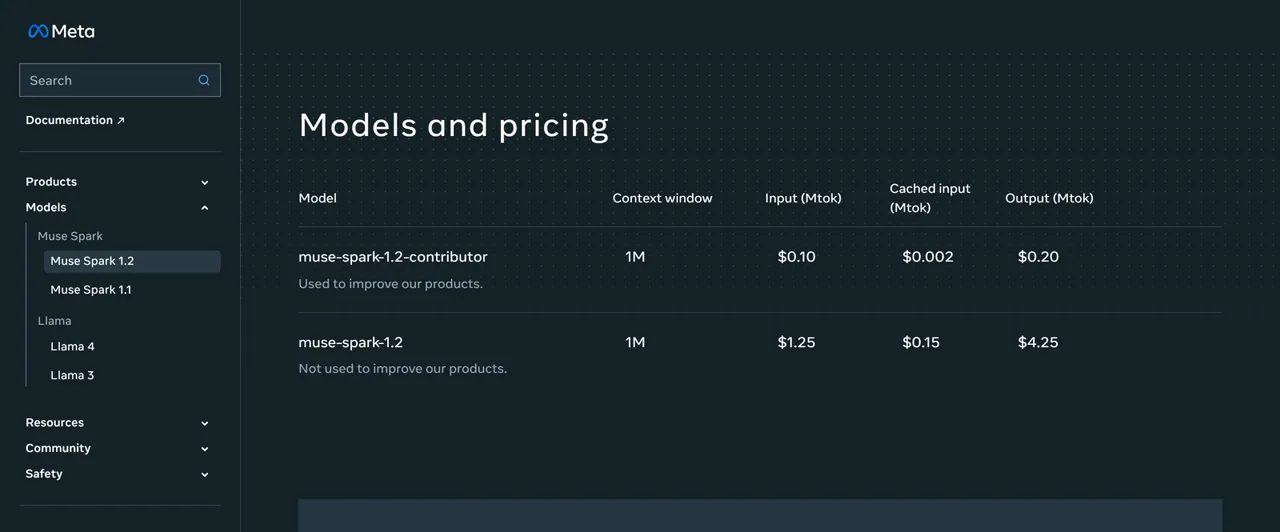
Стоимость для участников в 12,5 раз ниже по входу, в 75 раз ниже по кэшированному входу и в 21,25 раз ниже по выходу по сравнению со стандартным тарифным планом. Не существует единого процентного значения скидки, которое бы точно отражало все типы токенов.
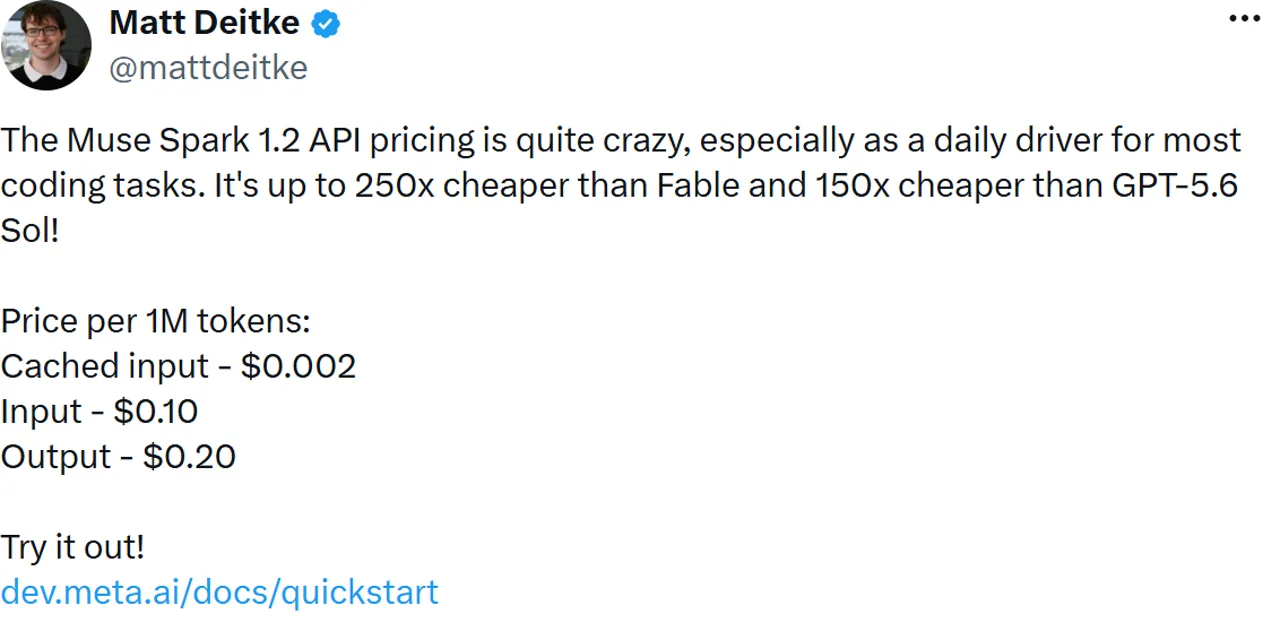
Один из исследователей Meta назвал уровень “Contributor” “до 250 раз дешевле”, чем Fable, и «в 150 раз дешевле», чем GPT-5.6 Sol. Это социальное сравнение использует цены для участников программы, а не стандартную модель, и всегда должно сопровождаться оговоркой об использовании данных. Читатели, сравнивающие текущие расходы конкурентов, могут воспользоваться нашим отдельным Руководство по ценам на GPT-5.6 и Разбивка цены по коду Claude.
Для публичных репозиториев, синтетических задач или одноразовых тестовых сред уровень «Contributor» может оказаться привлекательным вариантом. В случае с частным кодом, данными клиентов, учетными данными или проприетарной архитектурой более безопасным выбором по умолчанию является стандартный уровень. Meta также сообщает, что начинает принимать запросы на нулевое хранение данных через отдел продаж, что представляет собой отдельный канал доступа, отличающийся от стандартной настройки самообслуживания.
Доступ к API Muse Spark 1.2 и примеры использования
Три официальных маршрута доступа
Базовый URL официальной кулинарной книги: https://api.meta.ai/v1 · 1.2. Запрос, указанный в данном отзыве: не выполнен
Сайт API метамодели поддерживает рабочий процесс, совместимый с SDK OpenAI. В официальном руководстве Meta используется базовый URL https://api.meta.ai/v1 и считывает ключ из MODEL_API_KEY. На странице продукта также описана основа поиска, а в руководстве по применению рассматриваются такие темы, как автодополнение в чате, потоковая обработка, вызов инструментов, структурированный вывод, кэширование подсказок, управление процессом рассуждений, визуализация, длинный контекст, повторные попытки и рецепты поиска.
Пример официальной кулинарной книги — отредактированная версия: Сайт официальное руководство по GitHub по-прежнему использует muse-spark-1.1. Это подтверждает структуру клиента и базовый URL, а не то, что пример был обновлён для версии 1.2.
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.1",
    messages=[{"role": "user", "content": "Hello, world!"}],
)

print(response.choices[0].message.content)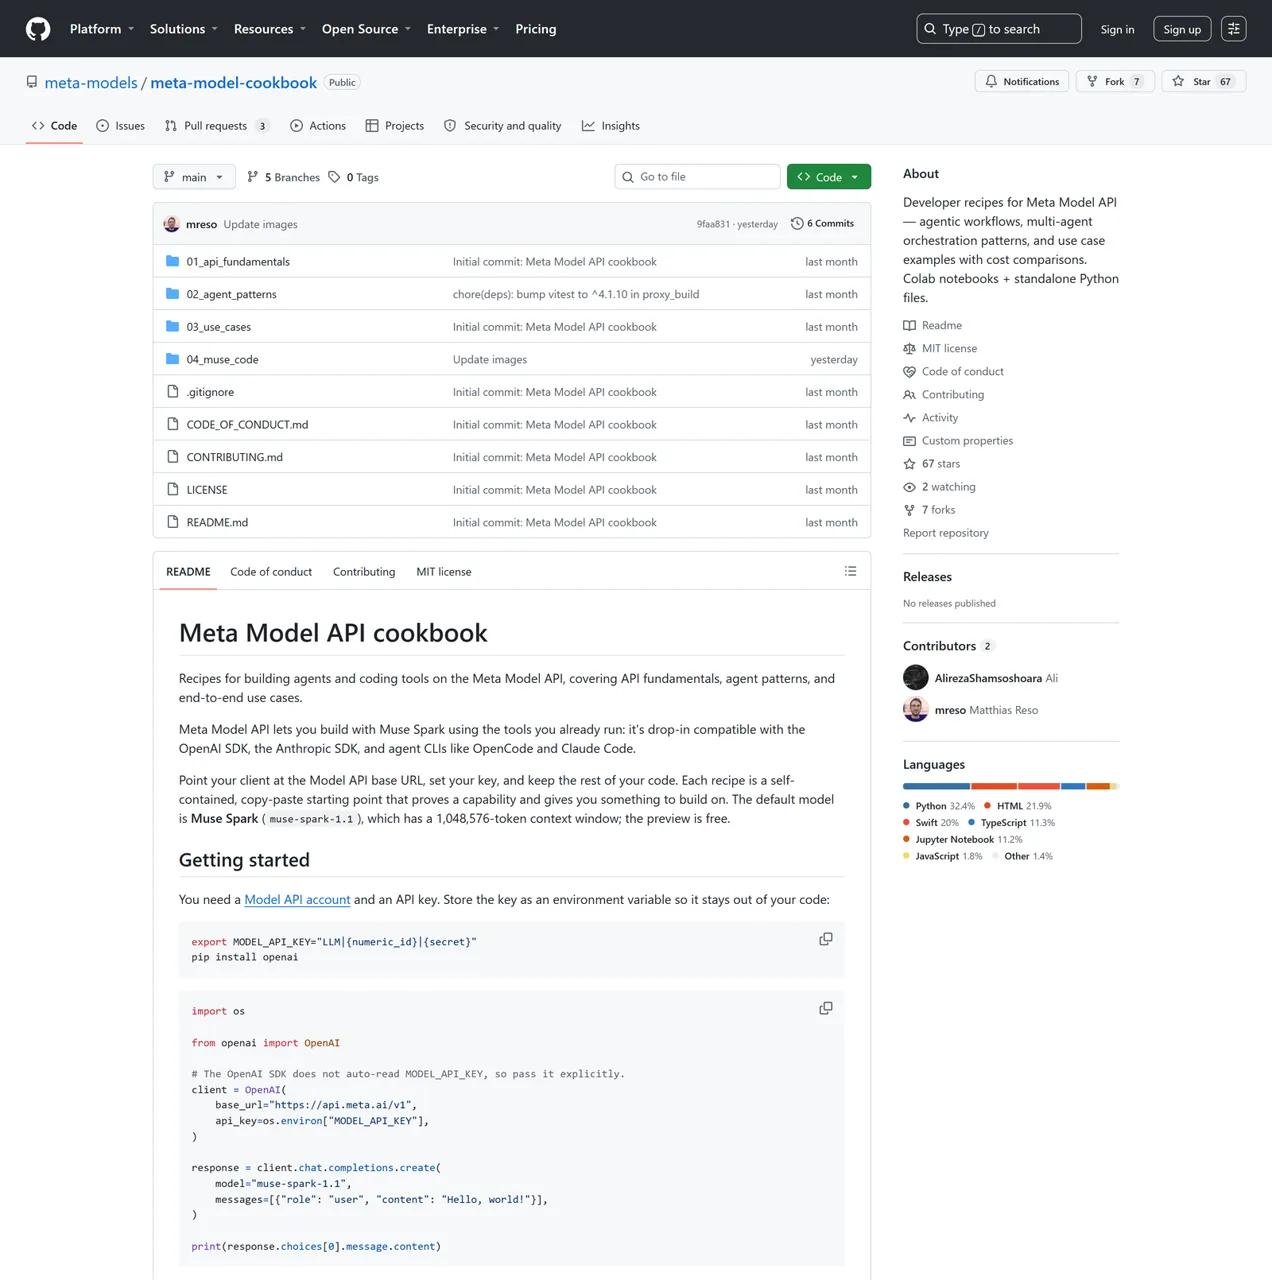
Адаптация зафиксирована — не выполнена: Meta отдельно перечисляет muse-spark-1.2 в качестве стандартного идентификатора модели 1.2. Приведенная ниже минимальная замена объединяет два официальных факта, однако в ходе данного рассмотрения платный запрос не отправлялся.
response = client.chat.completions.create(
    model="muse-spark-1.2",
    messages=[{"role": "user", "content": "Hello, world!"}],
)
Muse Spark — это модель логического вывода, и токены за логические выводы учитываются в выручке. Это делает стандартный показатель производительности $4.25 более важным, чем может показаться на первый взгляд: даже в кажущемся кратким ответе может скрываться значительный объем логических выводов. Реальная задержка, время до появления первого токена, частота повторных попыток и затраты на каждую задачу здесь пока не измеряются.
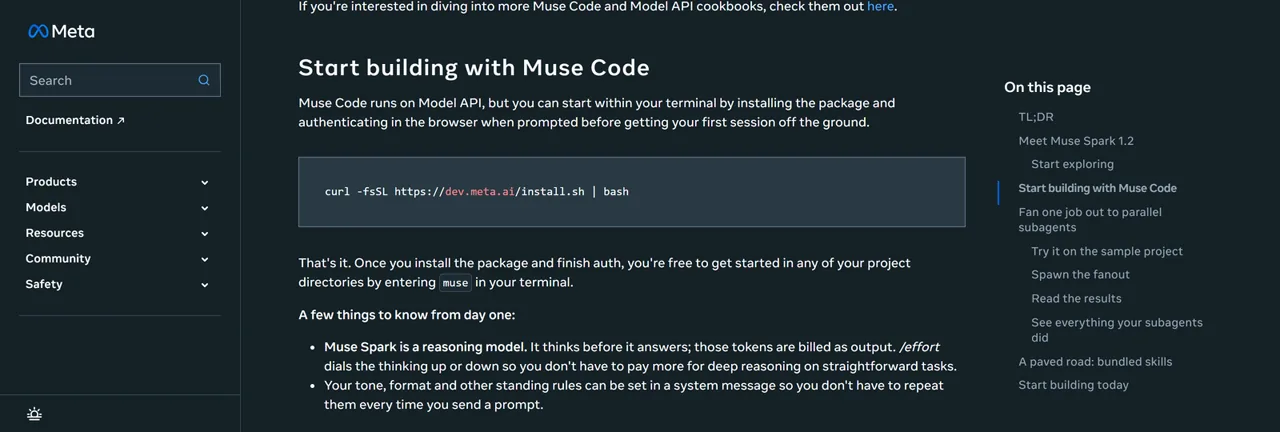
/усилия Команда изменяет глубину рассуждений. Источник: Руководство для разработчиков Meta.Что дает Muse Code
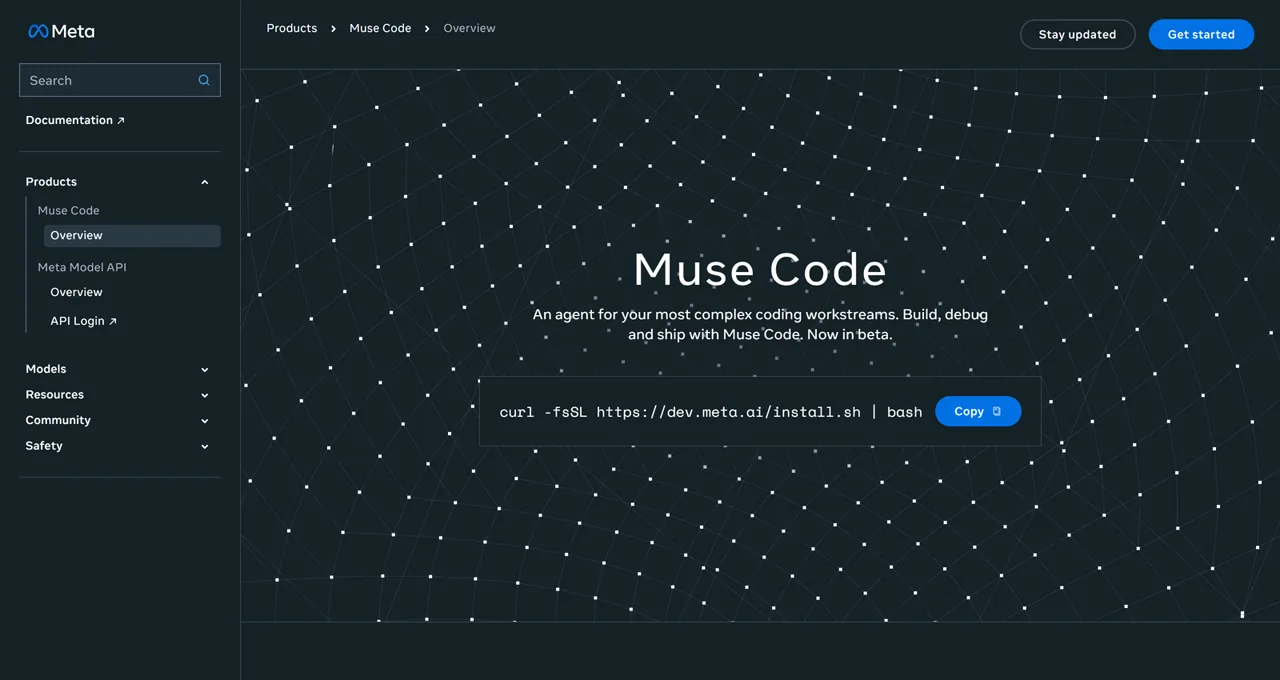
Muse Code устанавливается из терминала и интегрирует Muse Spark 1.2 в рабочий процесс агента. Meta’s подробный анализ разработчика описывает несколько типов поведения, которые не относятся к простому вызову API:
- Параллельные агенты: Задачи могут выполняться в изолированных рабочих деревьях Git.
- Журнал событий, в который записи добавляются только в конец: Сеансы и действия записываются в локальный файл JSONL для аудита и воспроизведения.
- Ход работы:
резюме Museможно возобновить прерванные сеансы. - Контроль логических выводов: the
/усилияЭта команда регулирует силу аргументации. - Конкретные навыки: Мета-имена
/вкус,/приготовление на гриле,/гриль-с-документацией, и/план.
Характеристики продукта «Агент»
Субагенты
Независимые задачи могут разветвляться.
Рабочие деревья
В ходе параллельной работы ветви остаются разделенными.
Журнал JSONL
Локальные события, доступные только для добавления, поддерживают повторное воспроизведение.
Резюме
резюме Muse продолжает прерванные сеансы.
Навыки
/вкус, /приготовление на гриле, /гриль-с-документацией, /план.
Благодаря этому набору функций Muse Code становится актуальным для более широкого рынка агентов программирования, где наряду с интеллектуальными возможностями моделей важную роль играют планирование, изоляция, воспроизведение и дисциплина использования инструментов. Данный Руководство по сравнению OpenClaw и Claude: Code и OpenCode помогает понять эти различия на уровне продуктов.
Заявления о запуске и первые отзывы сообщества
Реакция — это не одобрение
Обучение + долгосрочная перспектива
Расширение возможностей программирования, разнообразие среды, совместное обучение и стресс-тест с вызовом более 1 000 инструментов.
Price и OpenCode
Один из пользователей Reddit высоко оценил свой первый опыт программирования и его ценность.
Конфиденциальность + надежность
Другие пользователи выразили опасения по поводу объема передачи данных, стандартной цены, доступности и надежности устройства на ранних этапах.
В отделе искусственного интеллекта компании Meta сообщают, что в версии Muse Spark 1.2 было увеличено вычислительное время, выделенное на обучение программированию, добавлены более разнообразные среды, уделено больше внимания генерации кода на основе всего репозитория и отладке, а также реализовано совместное обучение с Muse Code. Отдельный тема для обсуждения описывает стресс-тест продолжительностью до 24 часов с более чем 1 000 вызовов инструментов на графических процессорах NVIDIA Hopper.
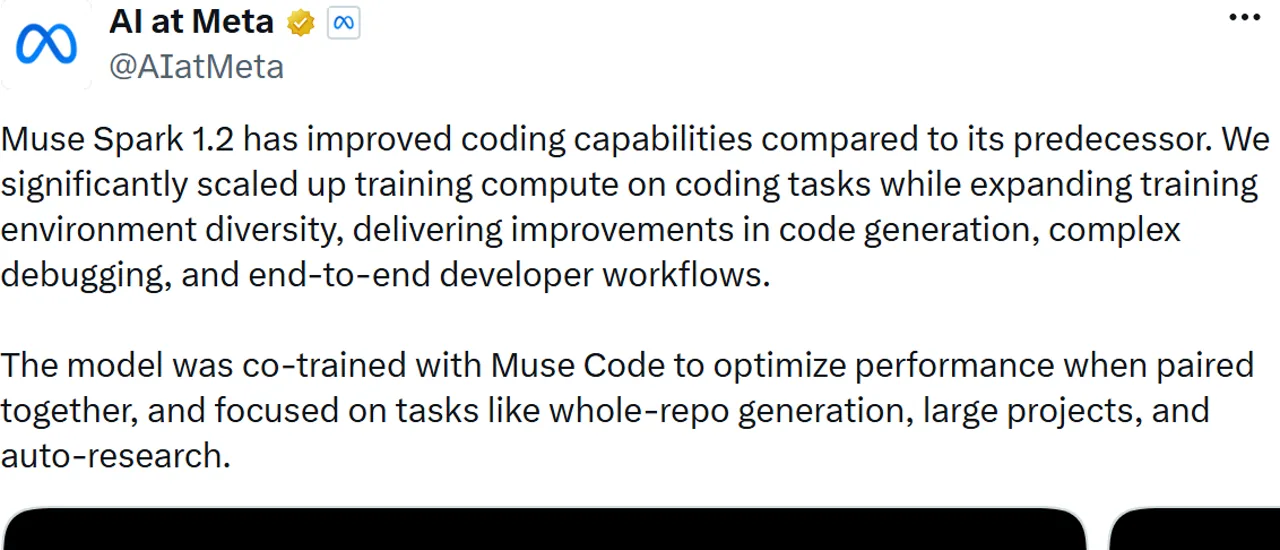
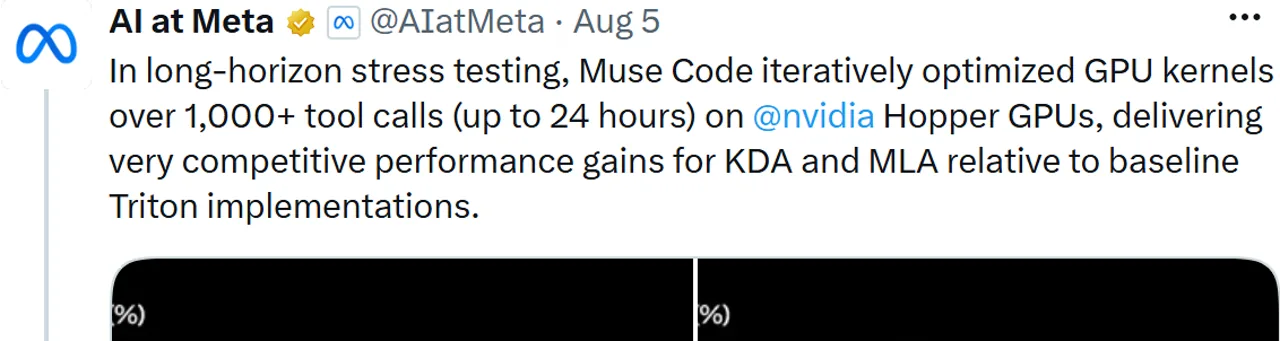
Это впечатляющая демонстрация, но она не отражает общий показатель успешности. Она не дает представления о том, как часто агент выбирал правильный инструмент, исправлял ошибки, избегал повторных вызовов или выполнял стандартную задачу с репозиторием без вмешательства со стороны оператора.
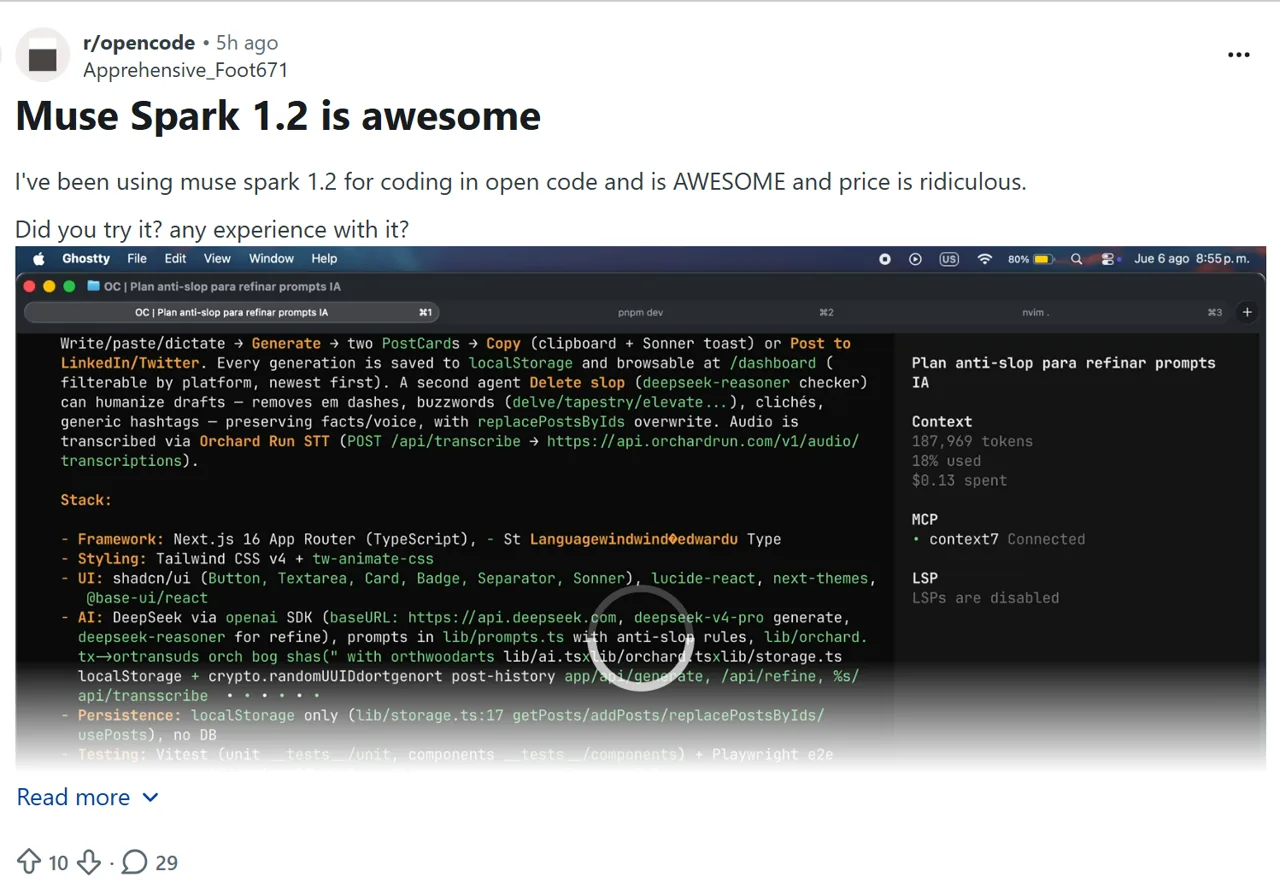
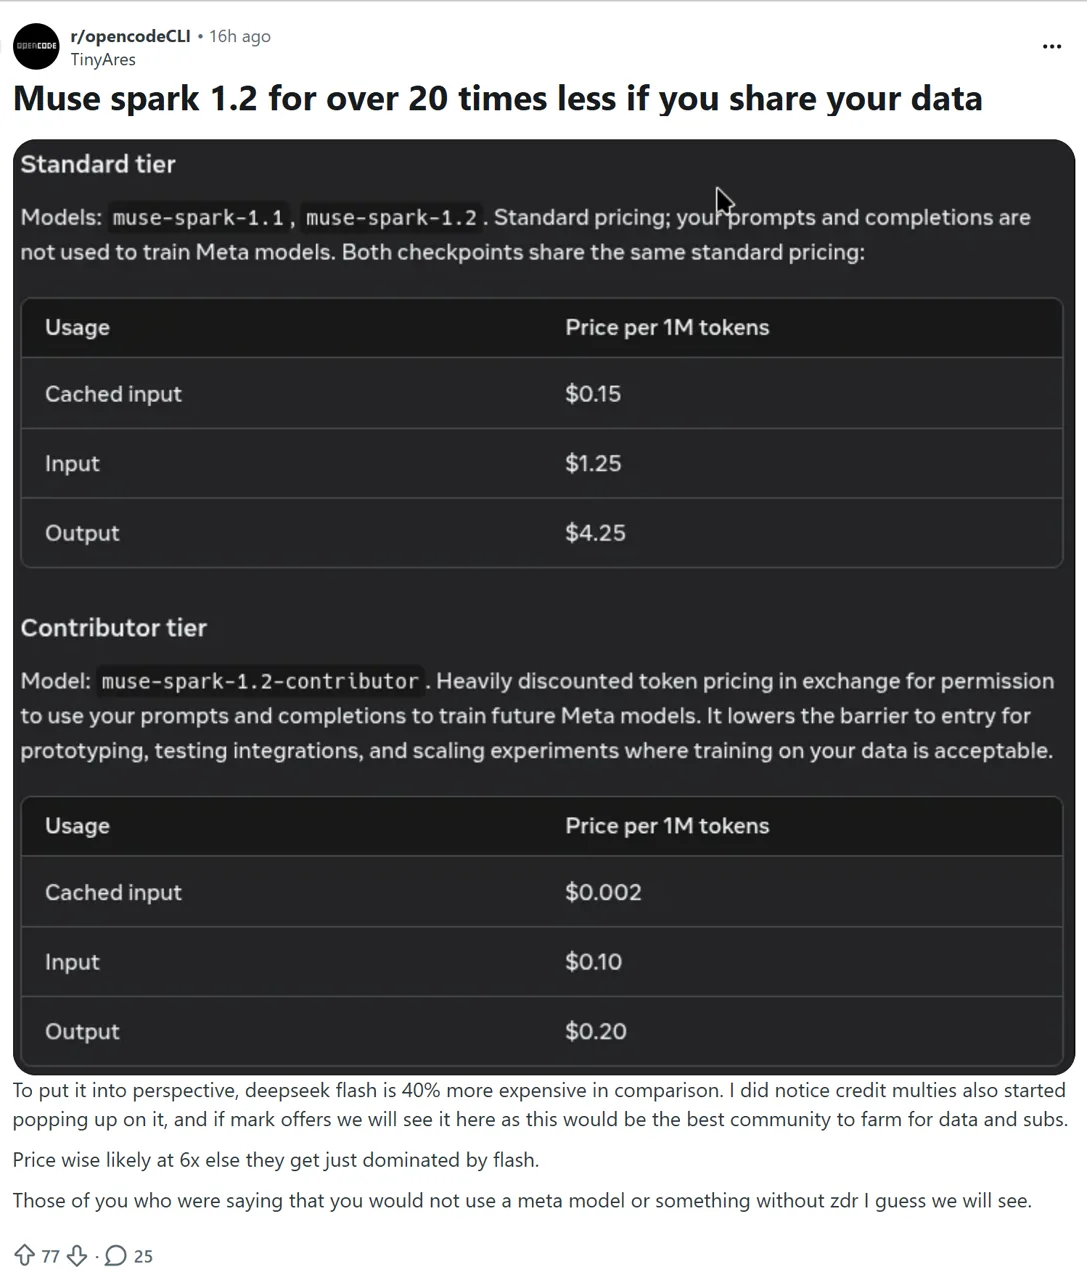
Ранние посты на Reddit также носят неоднозначный характер. Один из них Пользователь r/opencode поделился положительным опытом использования OpenCode и высоко оценил цену. Отдельно Обсуждение ценообразования для авторов вызвали вопросы, касающиеся объема использования данных, стоимости стандартного тарифа, доступности и надежности. Это отдельные мнения, а не общее мнение сообщества.
Тесты по программированию в Muse Spark 1.2: 3 из 3 заданий выполнены
В ходе наших тестов базовая модель Muse Spark 1.2 выполнила три контролируемых задачи по программированию с помощью API для автозаполнения в чате, совместимого со стандартом OpenAI. На выполнение каждой задачи отводилась одна попытка без повторных попыток и без вмешательства со стороны человека. Мы оценивали файлы, возвращенные в одноразовые репозитории, по сравнению с открытыми и скрытыми контрольными наборами. Выполнение агента Muse Code не тестировалось, равно как и надежность вызова инструментов, поэтому эти результаты не следует рассматривать как тест производительности агента.
Результат за одну попытку
В ответах было использовано 6 618 токенов аргументации. Все три причины завершения были следующими: остановиться, а в поле «Поставщик» было указано «Meta».
Тест 1: Исправление ошибки идемпотентности в Python — Пройден
Предотвратите дублирование переводов без изменения публичного API
Модель выявила отсутствующий защитный механизм для идентификатора запроса, внесла минимально необходимое исправление и предоставила регрессионный тест, сохранив при этом атомарность обновлений баланса.
Исходный скрытый вычислитель ошибочно требовал повторного вызова для возврата результата Неверно, хотя в задаче требовалось лишь, чтобы отправщику не начислялась плата дважды. После исправления этого вымышленного требования к возвращаемому значению неизменённый первый ответ прошел все шесть тестов. Мы не повторяли попытки и не редактировали результаты модели.
Тест 2: Рефакторинг многофайлового кода на TypeScript — Пройден
Разделение валидации, сохранения данных и ведения журнала аудита
Вернутые файлы сохранили открытый контракт маршрута, строгий TypeScript и единую транзакцию, охватывающую как записи заказов, так и записи аудита. Кроме того, в них были добавлены целенаправленные тесты валидации, не зависящие от среды выполнения.
Первый эксперт сравнивал объекты с необработанными JSON.stringify, поэтому эквивалентные объекты с разным порядком вставки ключей выглядели как неравные; в Windows npx Запуск также завершился неудачей ещё до проверки типов. При использовании компаратора, нечувствительного к порядку, и вызова команды, безопасного для Windows, исходный ответ прошел все проверки. И вновь повторная попытка не была выполнена.
Тест 3: Функция хранилища JSONL — Пройден
Соблюдение инструкций на уровне всего репозитория
Добавить JSONL без нарушения структуры CSV
В модели реализованы следующие функции: обнаружение расширений, ошибки в строках с неправильным форматом (счисляя с единицы), атомарный вывод, безопасность в режиме пробного запуска, целенаправленные тесты, справочный текст и пример в файле README.
Что показывают тесты: Muse Spark 1.2 способен за один проход генерировать пригодные для использования многофайловые патчи, учитывать ограничения совместимости, добавлять тесты и обрабатывать небольшую функцию, затрагивающую весь репозиторий. Средняя заявленная стоимость составила около $0.0151 на задачу, однако эти тестовые наборы были небольшими и не должны использоваться для прогнозирования затрат на обработку крупной кодовой базы.
Кому рекомендуется использовать Muse Spark 1.2?
Руководство по принятию решений
Контролируемая оценка
Открытый или синтетический код, измеримые задачи, потребности в широком контексте и многообещающий результат базовой модели 3/3.
Требуется подтверждение агента
Поведение Muse Code, стабильные ограничения пропускной способности, повторные вызовы инструментов или обширные тесты производительности репозиториев являются критериями для принятия решений.
Чувствительный код или высокая производительность
Используйте стандартный уровень или сравните альтернативы, если приоритетными факторами являются конфиденциальность и затраты на токены рассуждений.
Используйте стандартную модель для конфиденциального кода, если только ваша организация не утвердила отдельно условия для авторов. Если стандартная цена реализации влияет на расчет стоимости, сравните её с текущей Цены на Codex, код Claude и другие расходы, связанные с кодирующим агентом, прежде чем утверждать рабочий процесс.
Итоги обзора Muse Spark 1.2
Muse Spark 1.2 вошла в шорт-лист для оценки, но это не означает автоматической рекомендации к внедрению. Контекст токена 1M, привычная структура API, низкие цены для участников, три попытки написания кода с первого раза и высокие оценки Muse Code по результатам тестирования Meta — все это делает проект трудноигнорируемым. Кроме того, Meta лучше, чем многие другие проекты на этапе запуска, раскрыла детали своей методологии.
Ограничения также вполне конкретны. Тарифы для авторов сопряжены с компромиссом в плане использования данных. Стандартные токены вывода и рассуждений могут увеличить реальную стоимость. Лучшие результаты Meta по программированию не были воспроизведены в виде соответствующих записей на публичных досках Terminal-Bench или DeepSWE, а наш практический пример охватывает три задачи базовой модели, а не выполнение агента Muse Code.
Разумным шагом будет проведение контролируемого тестирования на некритичном коде с сохранением данных об исходном использовании и результатов локальной проверки. Рассмотрите полученные данные о затратах и задержках как выборку по небольшим задачам, а затем протестируйте репозиторий своего собственного размера, механизмы восстановления после сбоев и рабочий процесс агента, прежде чем внедрять решение в производственную среду.
Часто задаваемые вопросы по Muse Spark 1.2
Что такое Muse Spark 1.2?
Muse Spark 1.2 — это модель компании Meta, ориентированная на программирование, запущенная 5 августа 2026 года с контекстным окном объемом 1 млн токенов и доступом через Muse Code, Meta Model API и OpenRouter.
Muse Spark 1.2 — это то же самое, что и Muse Code?
Нет. Muse Spark 1.2 — это модель; Muse Code — это отдельный бета-версионный терминальный агент, работающий на её основе. Muse Code добавляет такие функции продукта, как субагенты, изолированные рабочие дерева Git, ведение журнала событий, возобновление работы и встроенные навыки.
Сколько стоит API Muse Spark 1.2?
Стандартная модель потребляет $1,25 на входе, $0,15 на кэшированном входе и $4,25 на выходе на миллион токенов. Модель «Contributor» требует $0,10 входных операций, $0,002 кэшированных входных операций и $0,20 выходных операций.
Использует ли Meta данные API Muse Spark для обучения?
Meta заявляет, что данные уровня «Standard» не используются для улучшения продуктов Meta. Данные уровня «Contributor» могут использоваться для улучшения продуктов Meta, поэтому в частном или проприетарном коде следует использовать стандартный канал передачи данных, если только организация не одобрит иное.
Входит ли Muse Spark 1.2 в общедоступные рейтинги Terminal-Bench или DeepSWE?
При проверке 7 августа 2026 года он не был указан ни на одной из общедоступных досок объявлений. Meta сообщает о результатах 82,91 TP40T на Terminal-Bench 2.1 с использованием Muse Code и 59,31 TP40T на DeepSWE, но это результаты тестирования, проведенного Meta.
Была ли версия Muse Spark 1.2 протестирована в ходе данного обзора?
Да. В ходе трёх тестов базовой модели с одной попыткой Muse Spark 1.2 успешно выполнил исправление ошибки в Python, рефакторинг в TypeScript и реализацию функции репозитория JSONL. Средняя задержка составила 12,98 секунд, а общая заявленная стоимость — $0,045362. Надёжность агента Muse Code и вызовов инструментов не тестировалась.
Как разработчики могут получить доступ к Muse Spark 1.2?
Meta перечисляет три способа: бета-версию терминального агента Muse Code, API Meta Model и OpenRouter. В официальном руководстве используется клиент, совместимый с SDK OpenAI, с базовым URL-адресом https://api.meta.ai/v1.