
Preços da API Grok 4: Custos, limites e como começar

Está desenvolvendo um aplicativo ou elaborando o orçamento de um agente? Comece pelo modelo que você realmente vai executar. O Aviso de migração de 15 de maio de 2026 afirma que o ID original Grok 4 agora é mapeado para Grok 4.3 com baixo esforço de raciocínio. Uma chamada bem-sucedida a um ID antigo não prova mais que o modelo original o atendia.

O uso da API é cobrado separadamente das assinaturas dos consumidores do Grok. Preços de assinatura e acesso ao Grok abrange os planos de chat; essas mensalidades não são créditos simbólicos para uma integração direta com o xAI.

Quer testar um prompt antes de integrá-lo a um aplicativo? Experimente o Grok 4.6 no GlobalGPT para um fluxo de trabalho baseado em chat. Use uma chave de API do xAI para sua própria integração e faturamento direto do xAI. Este artigo foi publicado pela GlobalGPT; os links dos produtos utilizam rastreamento de indicação.
Preços do Grok 4 API: taxas atuais e a versão original descontinuada

A tabela abaixo utiliza Preços de tabela da xAI verificados em 8 de setembro de 2026. Cada valor é expresso em dólares americanos por um milhão de tokens. Entrada, entrada em cache e saída são categorias de cobrança distintas; portanto, um único “preço por milhão” combinado oculta o custo da carga de trabalho.

USD por 1 milhão de tokens · processamento padrão

grok-4.3

Destino de redirecionamento original Grok 4

Contexto: 1.000.000 de tokens

Prompt < 200 mil

Entrada
$1.25
Entrada em cache
$0.20
Resultado / raciocínio
$2.50

Prompt >= 200 mil

Entrada
$2.50
Entrada em cache
$0.40
Resultado / raciocínio
$5.00

grok-4.6

Carro-chefe atual

Contexto: 500.000 tokens

Prompt < 200 mil

Entrada
$2.00
Entrada em cache
$0.50
Resultado / raciocínio
$6.00

Prompt >= 200 mil

Entrada
$4.00
Entrada em cache
$1.00
Resultado / raciocínio
$12.00

grok-4.5

Opção anterior da geração atual

Contexto: 500.000 tokens

Prompt < 200 mil

Entrada
$2.00
Entrada em cache
$0.30
Resultado / raciocínio
$6.00

Prompt >= 200 mil

Entrada
$4.00
Entrada em cache
$0.60
Resultado / raciocínio
$12.00

Quando a solicitação atingir 200 mil tokens, as tarifas para contexto longo passarão a ser aplicadas a todos os tokens dessa solicitação, incluindo a saída.

Os outros IDs da família 4 do Grok listados são grok-4.20-0309-raciocínio, grok-4.20-0309-sem-raciocínio e grok-4.20-multi-agent-0309. Cada um possui uma janela de contexto de 1 milhão de tokens e as mesmas taxas de tokens curtas/longas listadas para o Grok 4.3. O preço unitário correspondente não implica que o consumo total de tokens seja o mesmo, especialmente no caso de trabalhos com múltiplos agentes.

Para uma alternativa específica para programação, grok-build-0.1 possui uma janela de contexto de 256K e taxas de entrada/cache/saída em contexto curto de $1.00/$0.20/$2.00, aumentando para $2,00/$0,40/$4,00 no limiar de prompt de 200K. Para um comportamento mais abrangente e casos de uso, consulte nosso Avaliação do Grok 4.6.
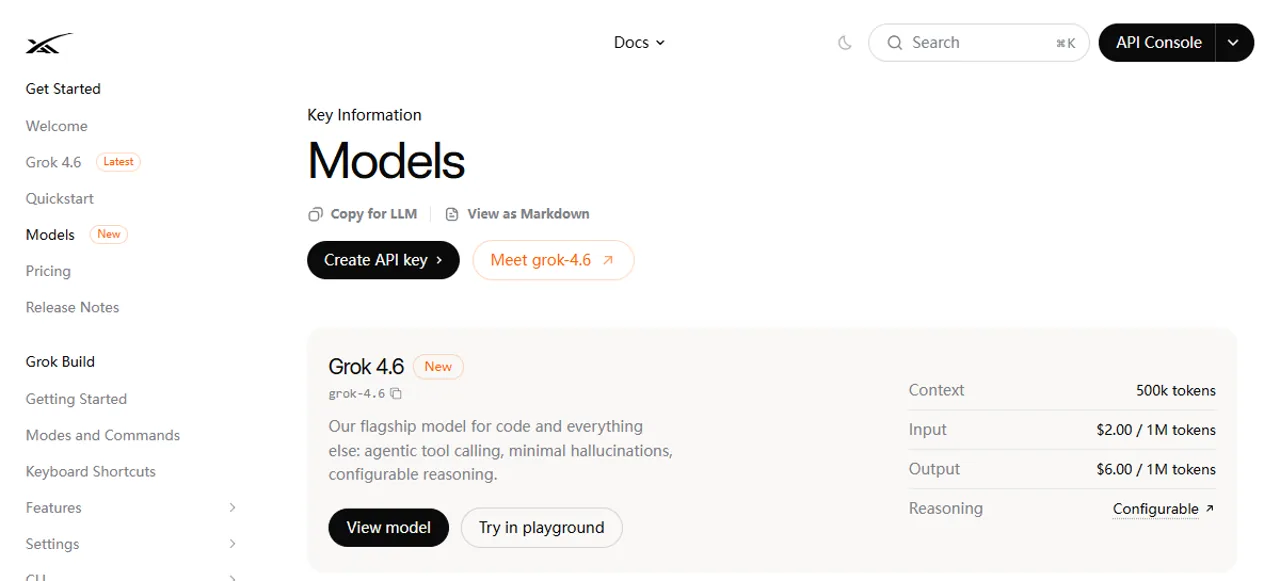
Documentação oficial da xAI que apresenta o Grok 4.6, seu ID de modelo, contexto de 500 mil e raciocínio configurável.
Catálogo oficial de modelos da xAI, coletados em 7 de setembro e verificados novamente em 8 de setembro de 2026. O título $2/$6 refere-se ao preço de entrada/saída Grok 4,6 para contexto curto; as taxas de cache e de contexto longo estão listadas acima.

O que aconteceu com o preço original do $3 / $15?

Referências mais antigas, incluindo a nossa Guia de integração da API Grok 4, cotação de $3 por milhão de tokens de entrada e $15 por milhão de tokens de saída para o Grok original 4. Considere isso como uma cotação histórica, não como a fatura de hoje para um ID desativado. A antiga URL oficial do modelo agora leva ao catálogo geral de modelos; portanto, esta não é uma tabela de preços de arquivo recém-verificada.

O Anúncio original Grok 4 descreve uma janela de contexto de 256.000 tokens. Essa capacidade histórica, bem como preços ou limites mais antigos do modelo Fast, não devem ser copiados para um orçamento destinado à substituição. A regra exata para grok-4-0709 agora é Grok 4.3 com baixo esforço de raciocínio, cobrado às taxas de Grok 4.3.
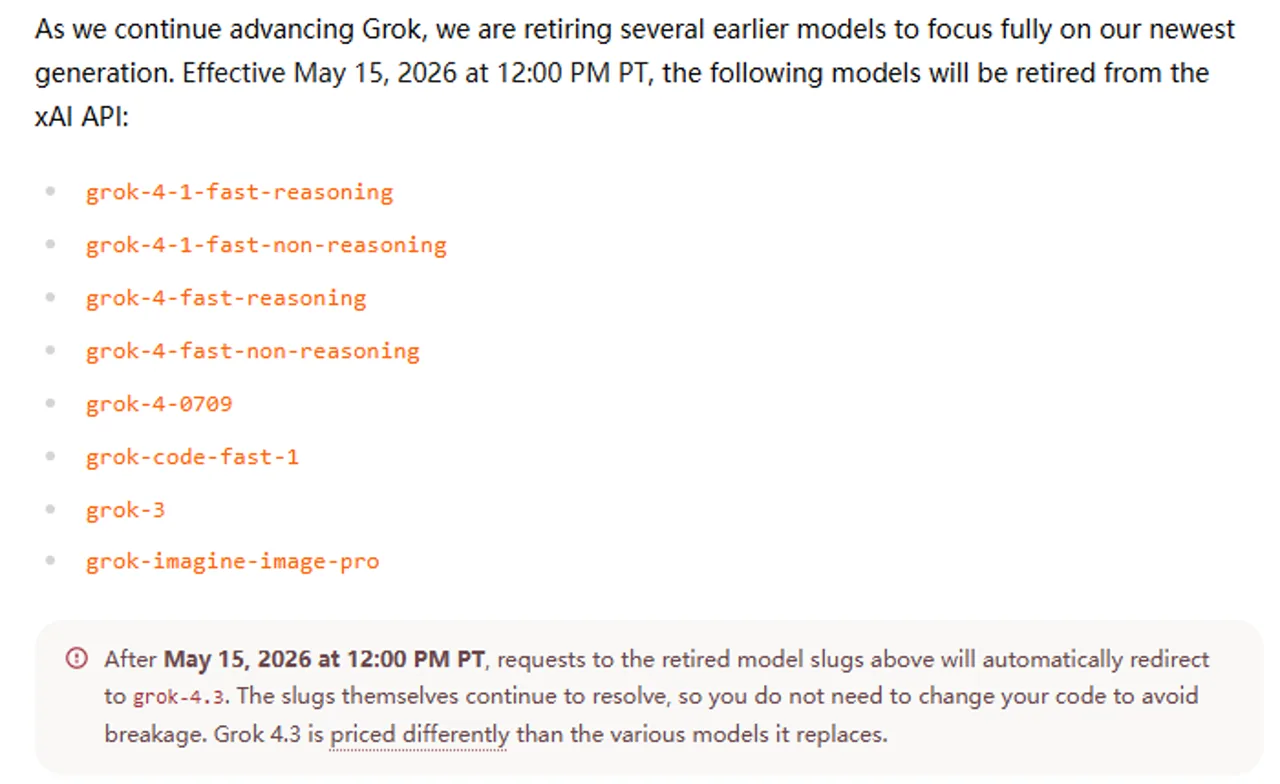
Aviso oficial de descontinuação, listando o grok-4-0709 e seu redirecionamento para o grok-4.3
Aviso de aposentadoria da xAI, capturado em 7 de setembro de 2026; texto revisado em 8 de setembro. O redirecionamento original listado Grok 4 ID remete para Grok 4.3. O aviso completo identifica separadamente as exceções para modelos de codificação e de imagem.

Grok 4 é uma geração de modelos, enquanto Grok também é o nome de um produto de consumo. O nosso explicação do que é Grok 4 fornece essas informações básicas sobre o produto. Para códigos novos, selecione explicitamente um modelo compatível, em vez de confiar em um redirecionamento por descontinuação ou presumir que o alias de um provedor permaneça inalterado.

Como os dados de entrada, os dados de entrada armazenados em cache e o raciocínio afetam o projeto de lei

Uma solicitação, três cobranças simbólicas

Entrada não armazenada em cache

(I – C) × taxa de entrada

I = todos os tokens de prompt; C = tokens de prompt armazenados em cache.

Entrada em cache

C × taxa de cache

Os tokens armazenados em cache fazem parte da entrada, não são uma entrada adicional.

Produção faturável

O × taxa de produção

O inclui o raciocínio quando o endpoint o relata na saída.

Estimativa do valor do token em dólares americanos (USD) = [(I – C) × taxa de entrada + C × taxa de entrada em cache + O × taxa de saída] / 1.000.000. Em seguida, acrescente as taxas aplicáveis de ferramentas, armazenamento ou outras. Selecione as taxas de contexto longo usando o prompt do total, incluindo os tokens armazenados em cache, antes de fazer os cálculos.

A entrada inclui as mensagens, instruções e o histórico de conversas enviadas ao modelo. O armazenamento em cache reutiliza um prefixo inicial idêntico em todas as solicitações; esse processo é automático, e o xAI recomenda um identificador de conversa para melhorar a reutilização. Um prompt com aparência semelhante não garante que haja um acerto no cache. O documentação sobre o armazenamento em cache de prompts explica o comportamento da correspondência.

Em “Preenchimentos de bate-papo”, leia prompt_tokens_details.cached_tokens; em “Respostas”, leia input_tokens_details.cached_tokens. O Referência sobre uso do cache e preços cobra tokens de raciocínio com a taxa de conclusão total. Se o total da produção já incluir o raciocínio, adicionar tokens_de_raciocínio Isso significaria contar duas vezes.

O Grok 4.6 oferece suporte aos níveis de esforço de raciocínio baixo, médio, alto e xalto; seu padrão documentado é alto, e o raciocínio não pode ser desativado. O Grok 4.3 oferece suporte aos níveis nenhum, baixo, médio e alto. Isso faz com que valha a pena avaliar o Grok 4.3 com o nível “nenhum” para tarefas de extração rigorosas, enquanto o Grok 4.6 pode gastar mais tokens mesmo quando sua resposta visível é curta. Consulte o configurações de raciocínio e a entrada do modelo Grok 4.3 acima.

Chamadas de ferramentas, trabalho em lote e solicitações prioritárias

De acordo com o tabela oficial de preços de ferramentas, a Pesquisa na Web, a Pesquisa X e a Execução de Código custam, cada uma, $5 por 1.000 chamadas, ou $0,005 por chamada, além do consumo de tokens. Uma solicitação pode invocar ferramentas mais de uma vez. Dez chamadas de pesquisa somam $0,05 antes dos tokens do modelo; ativar uma ferramenta não indica quantas vezes ela será utilizada.

A pesquisa de anexos custa $10 por 1.000 chamadas; a pesquisa de coleções custa $2,50 por 1.000. Arquivos e coleções armazenados também têm taxas diárias de armazenamento e download. Imagens e vídeos utilizam suas próprias unidades de preço; portanto, não os inclua em uma estimativa de tokens baseada apenas em texto. Nossa Tutorial sobre o fluxo de trabalho de imagens e vídeos do Grok abrange essa rota de geração separada.

O API em lote oferece um desconto de 20% para o Grok 4.3 e as três variantes listadas do Grok 4.20. O desconto abrange tokens de entrada, entrada em cache, saída e raciocínio. A página do modelo Grok 4.6 indica que a API de lote não é compatível. Não aplique um desconto genérico de 50% nem presuma que todos os modelos listados suportam processamento em lote.

Processamento prioritário custa o dobro das taxas padrão de tokens, incluindo tokens em cache e de raciocínio, quando o resultado retornado nível_de_serviço confirma prioridade. No caso de recurso ao nível padrão, são aplicadas as tarifas padrão. A prioridade se aplica às conclusões e respostas de chat, e não à API em lote.

Três exemplos de custos transparentes de API

Essas são estimativas de preço de tabela, não valores observados em faturas. Todas as solicitações a seguir utilizam processamento padrão, apenas texto, sem ferramentas, sem armazenamento, sem novas tentativas e sem impostos. “Saída” inclui qualquer raciocínio faturável. As duas primeiras cargas de trabalho pressupõem prompts com menos de 200 mil tokens.

Custo por solicitação e por 10.000 solicitações

Grok 4,3 · sem cache

$0.005 / solicitação

2.000 entradas × $1,25 + 1.000 saídas × $2,50, dividido por 1M. 10.000 solicitações = $50.

Grok 4,6 · sem cache

$0.010 / solicitação

2.000 entradas × $2 + 1.000 saídas × $6, dividido por 1M. 10.000 solicitações = $100.

Grok 4,6 · 90% entrada armazenada em cache

$0.0073 / solicitação

200 sem cache × $2 + 1.800 com cache × $0,50 + 1.000 de saída × $6, dividido por 1M. 10.000 solicitações = $73.

Uma alta taxa de acertos no cache é mais útil quando a entrada domina a carga de trabalho. Nesse exemplo de Grok 4,6, o armazenamento em cache economiza $0,0027 por chamada, ou 27% do total, mesmo que 90% de tokens de entrada estejam armazenados em cache. A carga de saída permanece em $0,006. Avalie a economia em relação à solicitação como um todo, não apenas à parte armazenada em cache.

O limite de 200 mil para o prompt pode alterar toda a solicitação

Mais um token de entrada ultrapassa o limite de preço

199.999 tokens de prompt

$0.459998

Grok 4.6: (199.999 × $2 + 10.000 de saída × $6) / 1M. Sem cache.

200.000 tokens de prompt

$0.920000

Grok 4,6: (200.000 × $4 + 10.000 de saída × $12) / 1M. Sem cache.

O principal A tabela de preços utiliza explicitamente a expressão “Contexto longo >= 200 mil tokens” e afirma que todos os tokens passam a ser cobrados pela tarifa mais alta assim que o prompt atingir o limite. Um trecho da descrição do modelo menciona “ultrapassar” 200 mil. Para fazer um orçamento exatamente de 200.000, use o limite explícito da tabela de preços; não presuma que a tarifa mais barata ainda se aplique.

Para uma previsão mensal, calcule o volume de solicitações separadamente para cada carga de trabalho, faixa de contexto, padrão de acertos em cache e configuração de raciocínio. Some as tentativas de repetição e as invocações de ferramentas previstas. Em seguida, compare essa estimativa com os dados de custo obtidos após um pequeno projeto piloto. Um valor em centavos por chamada só é útil quando suas premissas correspondem às condições de produção.

Contexto, saída, limites de taxa e limites de gastos são conceitos diferentes

Quatro limites a serem verificados antes do redimensionamento

Janela de contexto

Conforme solicitado

Grok 4.3: 1 milhão de tokens. Grok 4.6: 500 mil. Isso não é uma cota mensal.

Orçamento de despesas

Por resposta

Defina um limite de saída compatível. A capacidade do contexto não garante uma saída tão visível assim.

RPS / TPM

Rendimento

Solicitações por segundo e tokens por minuto. Ambos devem permanecer dentro do limite do plano da equipe.

Controles de gastos

Dinheiro

O saldo pré-pago, a recarga automática e os limites de faturamento controlam o comportamento de recarga de forma independente.

O público tabela de limitação de taxa A tabela indica que o Nível 0 tem 37 solicitações por segundo e 10 milhões de tokens por minuto para o Grok 4.3; o Grok 4.6 está listado com 150 solicitações por segundo e 50 milhões de tokens por minuto. Essas são entradas de nível publicadas com data específica, não uma garantia de que todas as chaves tenham a mesma capacidade útil. O Console da sua equipe é a fonte oficial de informações sobre o acesso e os limites do modelo atual.

Os níveis são baseados nos gastos acumulados com a API desde 1º de janeiro de 2026: $0, $50, $250, $1.000 e $5.000 para os níveis 0 a 4. As solicitações são limitadas por segundo usando o orçamento de solicitações por minuto dividido por 60; portanto, não é possível usar toda a alocação de um minuto de uma só vez. Tokens de entrada, saída, raciocínio e em cache contam para o TPM, mesmo que alguns tenham custo menor.

As páginas dos modelos Grok 4.3 e 4.6, que foram verificadas, fornecem os tamanhos de contexto sem indicar um valor máximo de saída definido. A atual Referência do endpoint de respostas define max_output_tokens como o orçamento combinado de saída e raciocínio: o valor padrão é 128.000 quando não definido e aceita um valor maior para gerações mais longas. Esse valor padrão não garante 128.000 tokens de resposta visíveis nem uma cota ilimitada de contexto. Defina um orçamento explícito e verifique as respostas incompletas.

Documentação de faturamento da xAI Separa os créditos pré-pagos da cobrança mensal por fatura, que vem desativada por padrão. A recarga automática pode reabastecer os créditos pré-pagos e possui seus próprios limites e cota mensal. Um limite de cobrança por fatura controla o uso pós-pago; isso não é o mesmo que um limite único e abrangente para compras, recargas e solicitações no plano pré-pago.

Para sua primeira integração, comece com um saldo pré-pago limitado e analise cuidadosamente qualquer configuração de recarga automática. Para acessar o chat no dia a dia sem precisar criar uma integração, a opção separada Guia de uso do Grok abrange o fluxo de trabalho do produto. Uma assinatura de chat e uma equipe de API têm controles diferentes.

Duas tarefas reais do Grok 4.6: o que revelam os registros de uso

Reutilizamos dois testes concluídos em 7 de setembro de 2026 por meio da API de agregação do Broly em https://anywhere.broly.ai/v1, utilizando o recurso de autocompletar do chat. Tanto os pedidos quanto as respostas grok-4.6; a identidade do modelo anterior não foi verificada de forma independente. Estes são os resultados do gateway Grok 4.6, e não os testes originais do Grok 4 nem uma comparação entre modelos.

Cada tarefa foi executada uma vez com temperatura=0, max_tokens=2048 e stream=false. Não foram enviadas ferramentas nem configurações explícitas de esforço de raciocínio. A mesma instrução do sistema foi utilizada para ambas as solicitações:


Instrução de sistema compartilhado

Extração de despesas

A tarefa converteu cinco notas de despesas sintéticas em JSON ordenado com centavos expressos em números inteiros, incluindo um reembolso negativo. A resposta preservou todos os campos solicitados e gerou o total líquido correto de $209,00.

Prompt exato: Extração de despesas

Saída completa do resultado: Extração de despesas

{
  "moeda": "USD",
  "itens": [
    {
 "rótulo": "trem",
 "valor_em_centavos": 4680
    },
    {
 "label": "hotel",
 "amount_cents": 12800
    },
    {
      "label": "jantar",
 "amount_cents": 2745
    },
    {
 "label": "reembolso",
 "amount_cents": -1250
    },
    {
 "label": "táxi",
 "amount_cents": 1925
    }
  ],
  "net_total_cents": 20900
}

Uso relatado · Extração de despesas

Entrada / em cache

364 / 192

Os tokens armazenados em cache são incluídos na contagem de entradas.

Conclusão / raciocínio

991 / 857

A justificativa é apresentada nos detalhes da conclusão.

Hora do relógio de parede

22,753 segundos

Inclui sobrecarga de rede e do gateway; uma execução.

Programação com restrições

A tarefa consistia em selecionar trabalhos indivisíveis dentro de um orçamento de oito horas, com pré-requisitos. A resposta escolheu A, B, C e E, totalizando oito horas e valor 24. Enumeramos de forma independente todos os 64 subconjuntos: 17 eram viáveis, e esse foi o único conjunto ótimo.

Prompt exato: Programação com restrições

Saída completa: Programação com restrições

{
  "selecionados": ["A", "B", "C", "E"],
  "ordem": ["A", "B", "C", "E"],
  "total_hours": 8,
  "total_value": 24
}

Uso relatado · Programação restrita

Entrada / em cache

428 / 192

Os tokens armazenados em cache são incluídos na contagem de entradas.

Conclusão / raciocínio

4267 / 4217

A justificativa é apresentada nos detalhes da conclusão.

Hora do relógio de parede

61,980 segundos

Inclui sobrecarga de rede e do gateway; uma execução.

A resposta de agendamento é mais curta do que o JSON de despesas, mas seu total de conclusão relatado é de 4.267 tokens, incluindo 4.217 tokens de raciocínio. Essa é a lição sobre orçamento: o comprimento visível da resposta é um indicador inadequado do consumo do modelo de raciocínio. Essas duas tarefas são exemplos úteis do padrão de uso, não um benchmark de latência nem uma classificação geral de qualidade.

Trecho sobre o uso do gateway: programação restrita

{
  "prompt_tokens": 428,
  "completion_tokens": 4267,
  "total_tokens": 4695,
  "prompt_tokens_details": {
    "cached_tokens": 192
  },
  "completion_tokens_details": {
    "reasoning_tokens": 4217
  }
}

O gateway também retornou um valor zero tokens_de_entrada e tokens_de_saída campos, apesar dos contadores de “Conclusões de bate-papo” serem diferentes de zero. Para esses registros, utilizamos prompt_tokens e tokens_de_conclusão. Não tratamos os aliases com valor zero como uma solicitação gratuita nem inferimos contagens de tokens visíveis a partir de outros campos com valor zero.

Aplicar tarifas oficiais sem chamá-las de fatura

Se essas contagens de gateway fossem faturadas com base nos preços de tabela atuais do xAI para contexto curto do Grok 4.6, a tarefa de extração custaria [(364 – 192) × $2 + 192 × $0,50 + 991 × $6] / 1M = $0,006386. A programação seria [(428 – 192) × $2 + 192 × $0,50 + 4.267 × $6] / 1M = $0,026170. Trata-se de estimativas hipotéticas da taxa de xAI, e não de valores observados no Broly.

A resposta de agendamento indicou 4.267 tokens de conclusão, embora a solicitação enviada max_tokens=2048. A semântica do limite do gateway não foi verificada. Essa discrepância não esclarece como funciona o próprio limite de saída do xAI, e o limite solicitado não pode ser considerado um teto de gastos comprovado para este gateway.

As respostas diretas do xAI apresentam um sinal de faturamento mais útil: custo_em_dólares_ticks. A documentação oficial define um USD como 10.000.000.000 de ticks e informa que o campo inclui as cobranças do token, os descontos e as chamadas de ferramentas do lado do servidor referentes àquela solicitação. As respostas reutilizadas do gateway não contêm esse campo. Para uma conversa, some os valores de ticks por solicitação, em vez de presumir que cada resposta contenha um total da sessão.

O que os usuários independentes da API perceberam

Em 21 de agosto de 2026, um usuário do Hacker News mediaman salientaram que a taxa de entradas em cache de $0,50 por milhão do Grok 4,6 equivale a 25% de sua taxa de entradas não armazenadas em cache de $2. A preocupação deles era com as leituras repetidas em cache no trabalho agênico. As duas taxas Grok correspondem à tabela oficial atual; as comparações mais amplas e as especulações do comentarista são avaliações pessoais.

mediaman no Hacker News discutindo os preços do cache da API Grok
mediaman sobre os preços da cache do Grok 4.6, 21 de agosto de 2026. Avaliação pessoal de custos; as comparações e especulações são de responsabilidade do autor do comentário. Capturado em 8 de setembro de 2026.

Antes disso, em 9 de novembro de 2025, XCSme descrito utilizando o Grok 4 Fast via API para análise e extração de dados, caracterizando-o como econômico e rápido. Trata-se de um relatório histórico sobre um modelo Fast já descontinuado. Ele não estabelece o preço, a velocidade ou a qualidade atuais do Grok 4.3 ou do Grok 4.6.

XCSme no Hacker News discutindo a extração de dados da API Grok
XCSme sobre o uso do Grok 4 Fast para extração, 9 de novembro de 2025. Experiência pessoal passada com um modelo já descontinuado. Capturado em 8 de setembro de 2026.

Essas duas experiências individuais sugerem algumas perguntas-guia úteis: qual a parcela da sua conta que se deve ao contexto armazenado em cache e qual a parcela que se deve ao raciocínio e às tentativas repetidas? Elas não estabelecem um consenso entre os desenvolvedores. Se você também estiver comparando o trabalho resultante, nosso Comparação entre os métodos Grok e ChatGPT: trabalho, pesquisa e codificação aborda essa decisão específica.

Como começar a usar a API oficial da xAI

O Guia rápido oficial do xAI utiliza a API de Respostas em https://api.x.ai/v1/responses. Trata-se de um endpoint e de uma conta diferentes daqueles utilizados na plataforma de agregação em nossos testes de 7 de setembro.

  1. Crie ou faça login na sua conta do xAI Console e selecione a equipe correta.
  2. Adicione créditos da API e verifique as configurações de gastos. Confirme se o modelo selecionado está disponível para sua equipe.
  3. Crie uma chave de API e forneça-a ao seu processo de servidor como XAI_API_KEY. Evite incluí-la no código do navegador, no controle de versão, em capturas de tela e em registros de log.
  4. Envie uma pequena solicitação utilizando um ID de modelo atual explícito e, em seguida, registre o modelo retornado, o uso, o nível de serviço e o identificador da solicitação.

O exemplo abaixo utiliza o Node.js 18 ou posterior e seu `fetch` integrado, portanto, não é necessária a instalação de nenhum SDK. Defina a variável XAI_API_KEY no ambiente do seu processo antes de executá-lo. Ele utiliza o formato oficial atual de solicitação “Responses” e baixo nível de esforço de raciocínio; o código foi verificado localmente, sem o envio de outra solicitação paga à API.

Primeira solicitação oficial · Node.js

Verifique se o status está como “concluído” e analise o objeto de uso antes de aumentar a escala. Este exemplo prevê 2.048 tokens de saída e raciocínio por meio do campo oficial “Respostas”. Um tempo limite é um prazo do lado do cliente, não uma prova de que o trabalho do lado do servidor foi cancelado ou não foi cobrado. O exemplo não tenta novamente automaticamente; o limite de tokens não é um limite monetário abrangente para um aplicativo que também envia entradas ou invoca ferramentas.

Para um SDK compatível com OpenAI, a URL base é https://api.x.ai/v1 e a credencial ainda é a sua xAI Chave da API. A API de Respostas utiliza entrada e raciocínio: { esforço: "baixo" }; O recurso “Autocompletar mensagens” utiliza mensagens e seus próprios nomes de parâmetros. Copiar uma solicitação de gateway sem alterações para um endpoint diferente pode resultar em falha, mesmo quando ambos aceitam JSON.

Erros comuns de integração e controles de custos

  • 401 Não autorizado: verifique o cabeçalho “Bearer”, a chave e o ambiente de execução. Um código de erro 403 pode indicar problemas com permissões da equipe ou restrições de acesso. Repetir a mesma solicitação inválida não resolve o problema.
  • 404 Não encontrado: verifique o endpoint exato e o ID do modelo. Distinga um ID inválido de um ID descontinuado, conforme documentado, que ainda pode ser acessado por meio de um redirecionamento.
  • 400 ou 422: valide o esquema da solicitação e as configurações suportadas. Por exemplo, a documentação atual sobre raciocínio rejeita penalidades de presença/frequência e configurações de interrupção para modelos de raciocínio.
  • 429 Solicitações em excesso: coloque o trabalho em fila, suavize picos de tráfego e utilize o backoff exponencial limitado com jitter. Monitore tanto a RPS quanto o TPM e inclua as tentativas de repetição no orçamento da carga de trabalho.
  • Saída inesperada ou status incompleto: verifique a resposta, a configuração do raciocínio e o limite de saída aplicável. Valide a saída legível por máquina antes de utilizá-la; uma resposta HTTP bem-sucedida não é garantia da qualidade da tarefa.

Para controlar os custos, escolha o modelo e a configuração de raciocínio mais econômicos que atendam aos seus próprios critérios de verificação de tarefas; mantenha instruções estáveis no início para reutilização do cache; remova o histórico irrelevante; monitore o limite de 200 mil prompts e limite os loops da ferramenta do agente. Use o processamento em lote somente quando o modelo for compatível com isso e o trabalho puder esperar. Considere a prioridade como uma opção de compra à parte.

Mantenha estimativas de tokens para planejamento e registros de custo devolvidos para reconciliação. Armazene registros inteiros ao agregar muitas solicitações e compare os totais das solicitações com o uso no Console e as faturas. Um campo de custo ausente significa “desconhecido”, não zero; uma resposta pequena e visível não comprova que a fatura seja baixa.

Para os preços atuais do Grok 4 API, elabore seu orçamento com base no modelo que realmente atende à solicitação, na faixa de preço do prompt e no volume total faturável. Comece com uma pequena solicitação oficial, analise os campos de uso e custo e, em seguida, dimensione a carga de trabalho que for aprovada em suas próprias verificações. Para explorar prompts em um espaço de trabalho de bate-papo, abrir Grok 4,6 em GlobalGPT.

Grok 4 – Perguntas frequentes sobre preços da API

Quanto custa atualmente o Grok 4 API?

A partir de 8 de setembro de 2026, o ID grok-4-0709, que foi descontinuado, redireciona para Grok 4.3. Para menos de 200 mil tokens de prompt, suas taxas em dólares por milhão são: $1,25 para entrada, $0,20 para entrada em cache e $2,50 para saída. As taxas para contextos longos dobram.

O API Grok 4 original ainda está disponível?

O modelo original grok-4-0709 foi descontinuado da API do xAI em 15 de maio de 2026. Seu ID continua a ser reconhecido, mas as solicitações são atendidas pelo Grok 4.3 com baixo esforço de raciocínio e faturadas de acordo com as tarifas do modelo substituto.

Quanto custa o Grok 4.6 API?

Grok 4,6 custa $2 de entrada, $0,50 de entrada em cache e $6 de saída por milhão de tokens abaixo de 200 mil tokens de prompt. A partir de 200 mil, as taxas são $4, $1 e $12. Chamadas de ferramentas e outras cobranças aplicáveis são cobradas separadamente.

Os tokens de raciocínio são cobrados?

Sim. A xAI cobra os tokens de raciocínio com base na taxa de conclusão. Quando o raciocínio já estiver incluído na saída relatada ou no total de conclusões, não o adicione uma segunda vez à sua estimativa.

As entradas armazenadas em cache contam para o limite de 200 mil?

Sim. Conte o prompt completo, incluindo os tokens armazenados em cache. A tabela oficial de preços classifica um prompt de 200 mil tokens ou mais na faixa de contexto longo, e as taxas mais altas se aplicam a todos os tokens dessa solicitação.

Existe uma cota gratuita de API Grok com uma assinatura de chat?

Não presuma que uma assinatura do chat inclua créditos da API do xAI. O guia rápido oficial da API utiliza uma conta do Console e créditos distintos. Qualquer promoção deve ser verificada para essa equipe da API; o acesso gratuito para usuários finais é uma oferta diferente.

Quais são os limites de taxa da API Grok?

Os limites dependem do modelo e do nível da equipe. A tabela do Nível 0 consultada lista o Grok 4.3 com 37 RPS e 10M TPM, e o Grok 4.6 com 150 RPS e 50M TPM. Use o Console da sua equipe para confirmar os limites aplicáveis à sua chave.

Posso usar o Grok 4.6 no GlobalGPT?

Sim. O GlobalGPT possui uma entrada de chat Grok 4.6 verificada. Trata-se de um fluxo de trabalho de plataforma independente; ele não substitui uma chave de API do xAI, o faturamento direto da API nem os controles no seu Console do xAI.

Como posso verificar o custo real de uma solicitação ao xAI?

Leia o valor `usage.cost_in_usd_ticks` da resposta oficial e divida por 10.000.000.000 para obter o valor em dólares americanos. Esse campo abrange essa solicitação, incluindo descontos de tokens e ferramentas do lado do servidor. Some as solicitações para acompanhar uma conversa.

Compartilhe a postagem:

Publicações relacionadas