
Snel antwoord: GPT-6 Sol is het model van OpenAI voor complexe codering en agentgebaseerde workflows. De officiële API vermeldt $2,00 per 1 miljoen invoertokens en $10,00 per 1 miljoen uitvoertokens tegen standaardtarieven, met een contextvenster van 1,05 miljoen tokens en een maximale uitvoer van 128.000. De belangrijkste afweging bij de aankoop is of de antwoorden voldoen aan uw taakvereisten tegen aanvaardbare totale kosten.
OpenAI positioneert GPT-6 Sol voor complexe codering en agentgebaseerde workflows. Deze zin betreft de positionering door de aanbieder, niet een gemeten kwaliteitsscore. Deze beoordeling vertaalt de gepubliceerde specificatie naar aankoop- en architectuurbeslissingen en legt vervolgens de publieke reacties vast met bronvermelding. We hebben ook drie kleine taken uitgevoerd waarbij de model-ID, route, promptset, ruwe output en het gebruik behouden bleven. De taakresultaten worden hieronder weergegeven als één waargenomen run, niet als een officiële benchmark.
Kort oordeel
Sol is het model dat je moet overwegen wanneer het werk echt complex, gereedschapintensief of codegericht is en de hogere kosten per token aanvaardbaar zijn. De bevindingen hier zijn gebaseerd op een combinatie van officiële documentatie en onze kleine steekproef van taken – het gaat dus niet om een gecontroleerde benchmark – dus het verantwoord oordeel is dat het model geschikt is, en niet dat het een universele ranglijst vormt.
Het meest nuttige onderscheid is niet simpelweg “slim” versus “snel”, maar de vorm van de werklast. GPT-6 Sol heeft dezelfde context- en outputlimieten als zijn broertje, maar gezien zijn positionering en prijs is een ander werkpunt zinvoller. Vergelijk de bredere Handleiding voor het kiezen van een AI-model en de beste AI-model voor codering richtlijn wanneer de taak bij meer dan één dienstverlener valt.
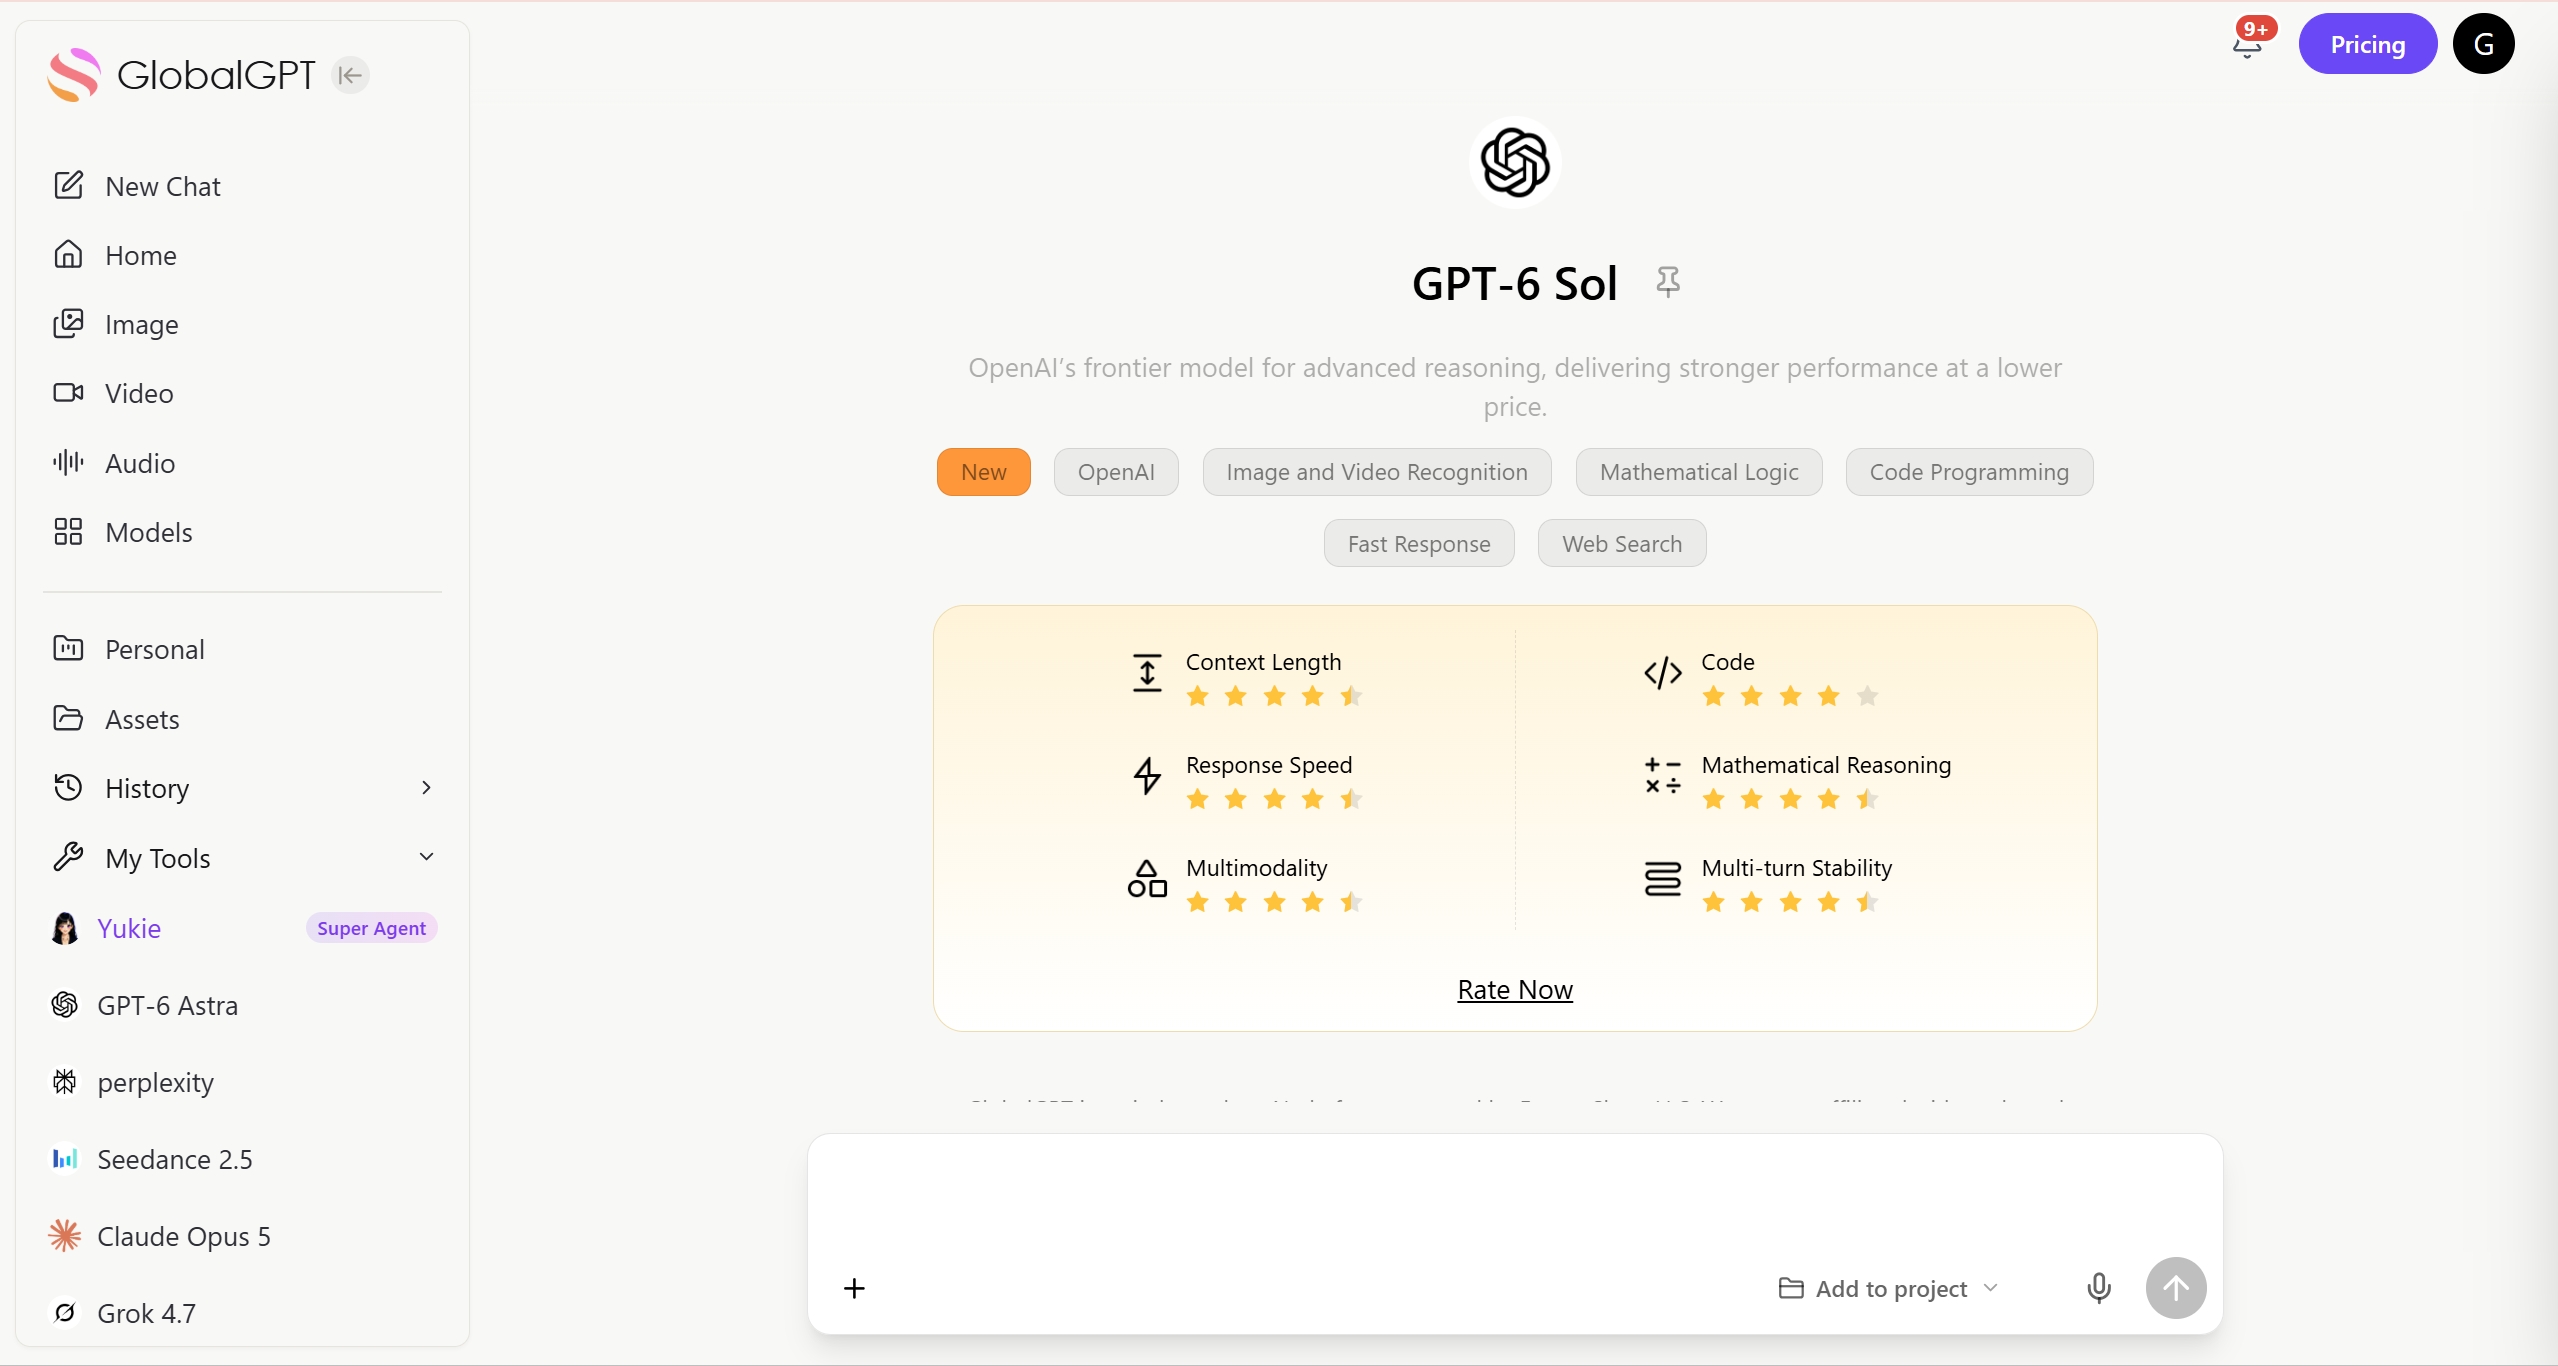
GPT-6 Sol in een oogopslag
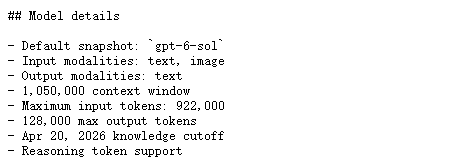
De onderstaande tabel volgt de huidige officiële GPT-6 Sol-modelpagina. De contextcapaciteit is niet hetzelfde als de aanbevolen promptgrootte, en de maximale invoer staat los van het contextvenster van de kop.
gpt-6-solBeide verwante modellen ondersteunen gestructureerde uitvoer, het aanroepen van functies, streaming, het in de cache opslaan van prompts, afbeeldingsinvoer, het zoeken in bestanden en het zoeken op internet, zoals beschreven in de gedocumenteerde functielijst. Het exacte gedrag van de tool hangt nog steeds af van het eindpunt, het account en de configuratie van het verzoek; trek geen conclusies over een succesvolle uitvoering van de tool op basis van een selectievakje dat de functionaliteit aangeeft.
Wat de context op gezinsniveau betreft, is de Recensie van de GPT-6 Astra laat zien hoe in een verwant GPT-6-artikel de documentatie van de aanbieder, de platformroutes en de toegeschreven reacties van elkaar worden gescheiden.
Prijzen voor GPT-6 Sol en de 272K-regel
Tegen standaardtarieven is de Prijspagina OpenAI vermeldt $2,00 invoer, $0,20 ingevoer in de cache, $2,50 schrijfbewerkingen naar de cache en $10,00 uitvoer per 1 miljoen tokens. Schrijfbewerkingen naar de cache bedragen 1,25 keer de niet-gecacheerde invoer. De prijzen voor Batch en Flex bedragen 50% in de standaardmodus, de snelle modus kost 2x het geldende tarief en regionale verwerking voegt 10% toe, indien beschikbaar.
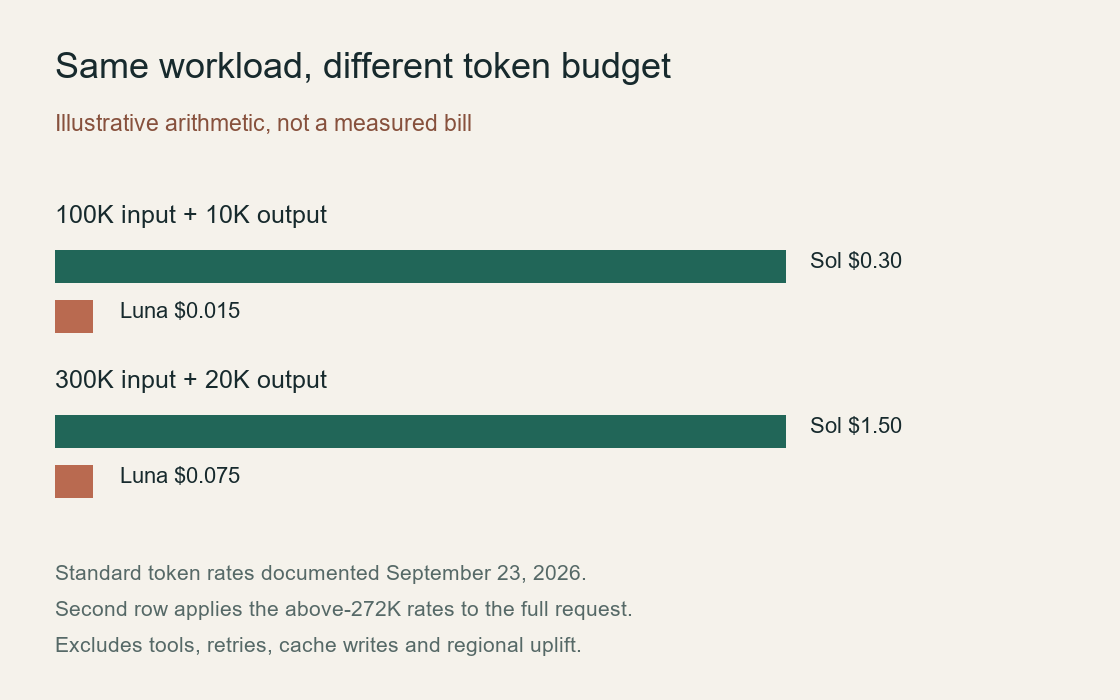
De kolom ‘lange context’ wordt berekend op basis van de regel van OpenAI: bij een invoer van meer dan 272K verdubbelen de invoer- en cache-tarieven en wordt de uitvoer voor het volledige verzoek met 1,5 vermenigvuldigd. Het gaat hier niet om een factuur met gemengde tarieven. Als praktische basis voor de begroting kost 100.000 input plus 10.000 output ongeveer $0.30 vóór tools of regionale opwaartse druk; een voorbeeld met 300.000 input en 20.000 output kost ongeveer $1.50 tegen de tarieven voor lange contracten.
Een groot contextvenster kan handig zijn, maar het is niet eenvoudig om het te vullen. Het ophalen van gegevens, het selecteren van fragmenten, het hergebruik van de cache en de uitvoerlimieten zijn belangrijker dan het cijfer van 1,05 miljoen in de kop. Zie de Prijsopbouw GPT-6 Astra voor een toelichting over contextdrempels en de werking van de cache.
GPT-6 Sol API: compatibiliteit, hulpmiddelen en beperkingen
OpenAI raadt de Responses API aan voor ingebouwde tools en het aanroepen van functies. Chat Completions ondersteunt het aanroepen van functies alleen wanneer redeneringsinspanning is ingesteld op geen. Dat is een implementatiedetail waar je vóór de migratie op moet letten: een verzoek kan syntactisch correct zijn, maar toch niet overeenkomen met het gedrag van de tool waarop je huidige integratie is afgestemd.
In de huidige tabel met limietwaarden staan de volgende standaardniveaus vermeld. RPM staat voor verzoeken per minuut, TPM voor tokens per minuut en de waarde bij ‘queue’ is de limiet voor batch-tokens.
Controleer vóór de productielancering in je eigen account welk niveau, welk eindpunt, welke streamingmodus en welk toolcontract precies van toepassing zijn. De Gids voor gebruiksbeperkingen van de Codex Dit geeft een nuttige toelichting op waarom het gepubliceerde maximum van een model niet hetzelfde is als de daadwerkelijke limiet van een account.
Wat de specificaties van GPT-6 Sol betekenen
Dit is een geschiktheidskaart, geen benchmark. Gebruik de Handleiding voor de workflow van alles-in-één AI-modellen wanneer je eigenlijk moet beslissen hoe je binnen één herhaalbaar proces van model kunt wisselen, in plaats van welk model op zich het sterkst klinkt.
In onze tests: GPT-6 Sol bij drie praktische taken
Op 23 september 2026 hebben we een kleine JavaScript-correctie, een besluitnota van drie punten en JSON-extractie getest. De onderstaande resultaten zijn de volledige antwoorden voor model-ID gpt-6-sol. Bij eerdere pogingen deden zich tijdelijke overbelastingsfouten voor, dus deze resultaten mogen niet worden opgevat als betrouwbaarheidsmetingen bij de eerste poging. We onderzoeken wat de antwoorden inhouden, wat een lezer kan hergebruiken en wat nog niet is getest.
Codeherstel: de waarde nul behouden zonder de functie te herschrijven
Beoordeel deze korte JavaScript-functie alsof deze deel uitmaakt van een productierepository. Stel de fout vast, leg uit hoe de fout zich voordoet en stel een minimale patch voor, samen met twee gerichte regressietests. Functie: function uniqueSorted(values) { return [...new Set(values)].sort((a, b) => a - b).filter(Boolean); }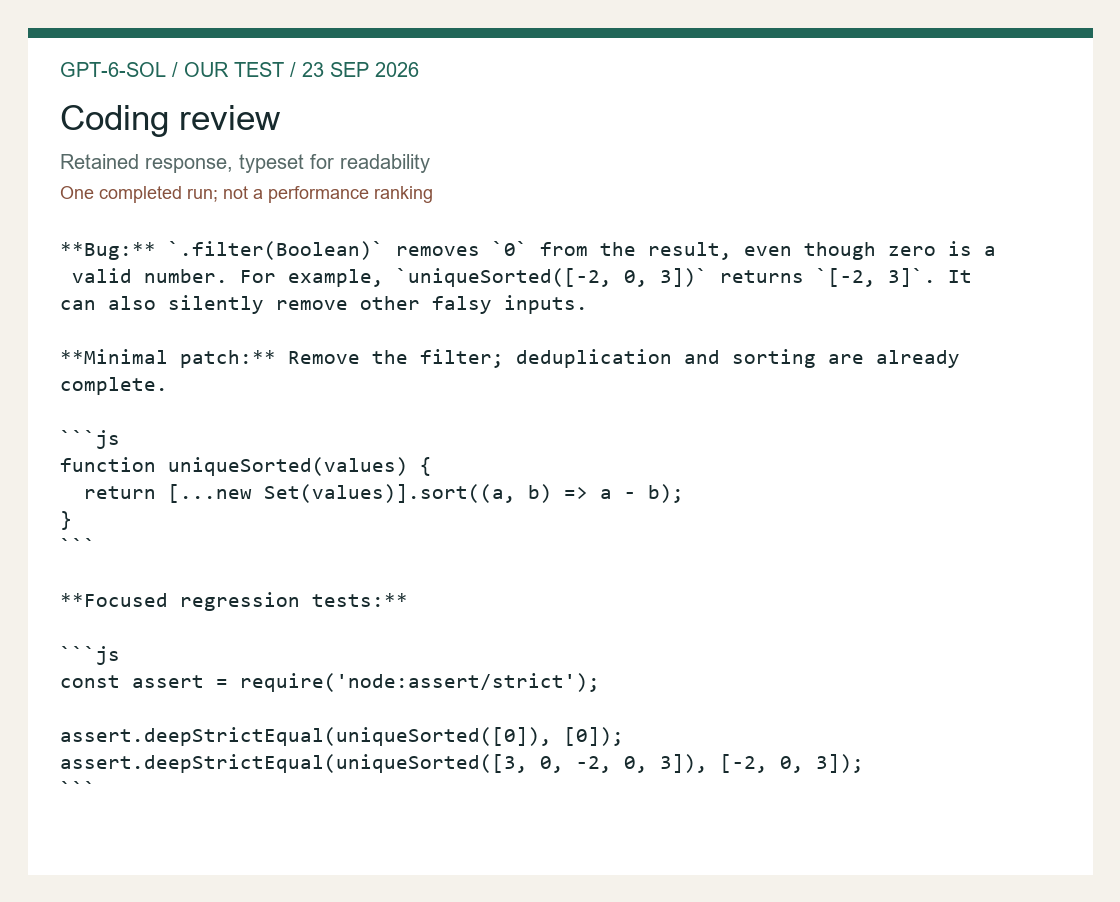
**Fout:** `.filter(Boolean)` verwijdert `0` uit het resultaat, hoewel nul een geldig getal is. Zo levert `uniqueSorted([-2, 0, 3])` bijvoorbeeld `[-2, 3]` op. Het kan ook andere 'falsy' invoerwaarden verwijderen zonder dit te melden.

**Minimale patch:** Verwijder de filter; het ontdubbelen en sorteren zijn al voltooid.

```js
function uniqueSorted(values) {
  return [...new Set(values)].sort((a, b) => a - b);
}
```

**Gerichte regressietests:**

```js
const assert = require('node:assert/strict');

assert.deepStrictEqual(uniqueSorted([0]), [0]);
assert.deepStrictEqual(uniqueSorted([3, 0, -2, 0, 3]), [-2, 0, 3]);
```
Gerapporteerd gebruik voor dit voltooide antwoord: 71 invoertokens, 409 voltooiingstokens, 480 tokens in totaal. Bij het gebruik van de aanvulling kunnen redeneertokens zijn meegerekend; het gaat niet alleen om de lengte van het zichtbare antwoord.
Sol heeft de daadwerkelijke fout opgespoord in plaats van de functie aan te passen op basis van een niet-relevante voorkeur. De uiteindelijke .filter(Boolean) negeert nul omdat JavaScript nul omzet naar false. Het verwijderen van dubbele waarden en het oplopend sorteren van getallen gebeurt al vóór dat filter. Door alleen het filter te verwijderen, wordt de aangetoonde fout dus verholpen, terwijl de rest van het algoritme intact blijft. Dit is het soort kleine patch dat een reviewer snel kan begrijpen: de uitleg identificeert de foutieve waarde, de wijziging richt zich op de verantwoordelijke bewerking en de tests tonen het beoogde gedrag.
De twee regressiebeweringen hebben verschillende functies. Het singleton-geval [0] isoleert de fout waarbij de nul verdwijnt. Het gemengde geval combineert een negatief getal, nul, een positief getal en dubbele waarden, waarbij wordt gecontroleerd of de ontdubbeling en de numerieke volgorde na de bewerking behouden blijven. Sol heeft ook het volgende opgenomen: require('node:assert/strict'), zodat de afhankelijkheid van de bewering duidelijk zichtbaar is. Dankzij deze details is het antwoord bruikbaarder dan een patch met daarbij vaag advies om tests toe te voegen. Er wordt echter nog steeds niet uitgelegd hoe Sol een repository zou inspecteren, imports tussen bestanden zou verwerken of zou omgaan met een mislukte build.
Naast de aangetoonde bug speelt er ook een contractuele kwestie. Moet deze functie alleen eindige getallen accepteren, of willekeurige JavaScript-waarden? Als het filter wordt verwijderd, blijven ook andere ‘falsy’ invoerwaarden behouden als aanroepers die versturen. Voor NaN, negatieve nul, oneindigheden, numerieke strings en null zijn weloverwogen beleidsbeslissingen nodig. Zonder dat beleid zouden we niet stilletjes coercion of validatie aan deze patch toevoegen. Een minimale reparatie is juist waardevol omdat deze het bevestigde defect scheidt van een bredere herontwerp.
Synthese met drie noten: de beslissing voorwaardelijk houden
Vat de volgende drie notities samen in een beknopte beslissingsnota met daarin: de beslissing, de onderbouwing, de risico’s en de volgende stap. Opmerking A: Een contextvenster van 1,05 miljoen tokens kan grote brondatasets bevatten, maar maakt niet elk verzoek goedkoop. Opmerking B: Boven 272K invoertokens stijgen de gedocumenteerde invoer-/cachepercentages en wordt de uitvoer vermenigvuldigd voor het volledige verzoek. Opmerking C: Het ophalen en hergebruiken van de cache kan de kosten van herhaalde prompts verlagen, maar de acceptatiecriteria moeten nog steeds worden getest.
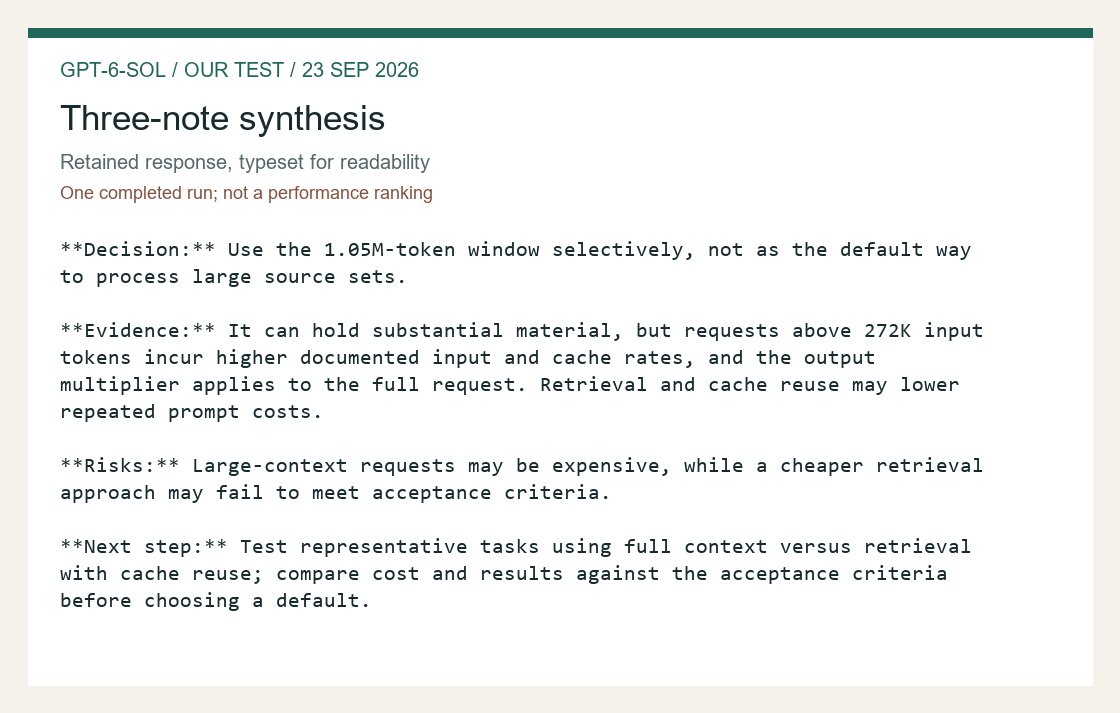
**Beslissing:** Gebruik het venster van 1,05 miljoen tokens selectief, en niet als standaardmethode voor het verwerken van grote bronsets.

**Beweis:** Het kan aanzienlijke hoeveelheden materiaal bevatten, maar verzoeken met meer dan 272K invoertokens leiden tot hogere gedocumenteerde invoer- en cachekosten, en de uitvoervermenigvuldigingsfactor is van toepassing op het volledige verzoek. Het ophalen en hergebruik van de cache kan de kosten van herhaalde prompts verlagen.

**Risico’s:** Verzoeken met een grote context kunnen duur zijn, terwijl een goedkopere opvraagaanpak mogelijk niet aan de acceptatiecriteria voldoet.

**Volgende stap:** Test representatieve taken met gebruik van de volledige context versus opvragen met hergebruik van de cache; vergelijk de kosten en resultaten met de acceptatiecriteria alvorens een standaardinstelling te kiezen.
Gerapporteerd gebruik voor dit voltooide antwoord: 99 invoertokens, 186 voltooiingstokens, 285 tokens in totaal. Bij het gebruik van de aanvulling kunnen redeneertokens zijn meegerekend; het gaat niet alleen om de lengte van het zichtbare antwoord.
Sol verdeelde de drie notities in de categorieën ‘beslissing’, ‘bewijs’, ‘risico’s’ en ‘volgende stap’. De aanbeveling luidde: selectief gebruik van het grote venster, waarbij het ophalen en hergebruik van de cache worden getoetst aan acceptatiecriteria. Het nuttige aspect was het behoud van de voorwaardelijke formulering: ophalen kan de kosten verlagen, maar alleen een werklasttest kan uitwijzen of de informatie die nodig is voor de beslissing daarbij behouden blijft. Het antwoord leverde geen besparingspercentage, geen gemeten recall-score en geen aanbeveling op om altijd de maximale context te verzenden.
Deze invoer bestond uit slechts 99 gerapporteerde prompt-tokens. Hiermee wordt de synthese van korte notities en het opvolgen van instructies getest, niet het vermogen om een verborgen feit uit honderdduizenden tokens op te halen. De prijsopgaven stonden in de notities; het correct herhalen ervan is geen onafhankelijke verificatie van de prijzen. Voor een echte architectuurmemo zouden we bronvermeldingen, een besluitvormer en een expliciete begrotingsaanname toevoegen. Die toevoegingen zouden elke zin controleerbaar maken, zonder te doen alsof deze korte oefening het volledige contextvenster benutte.
JSON-extractie: onbekende waarden expliciet houden
Haal de volgende velden uit deze opdrachtomschrijving en retourneer uitsluitend geldige JSON met de sleutels customer, priority, deadline en unknowns. Opdrachtomschrijving: Klant: Northwind Labs. Prioriteit: hoog. Deadline: 04-10-2026. De eigenaar is niet vermeld en het budget is niet bevestigd.
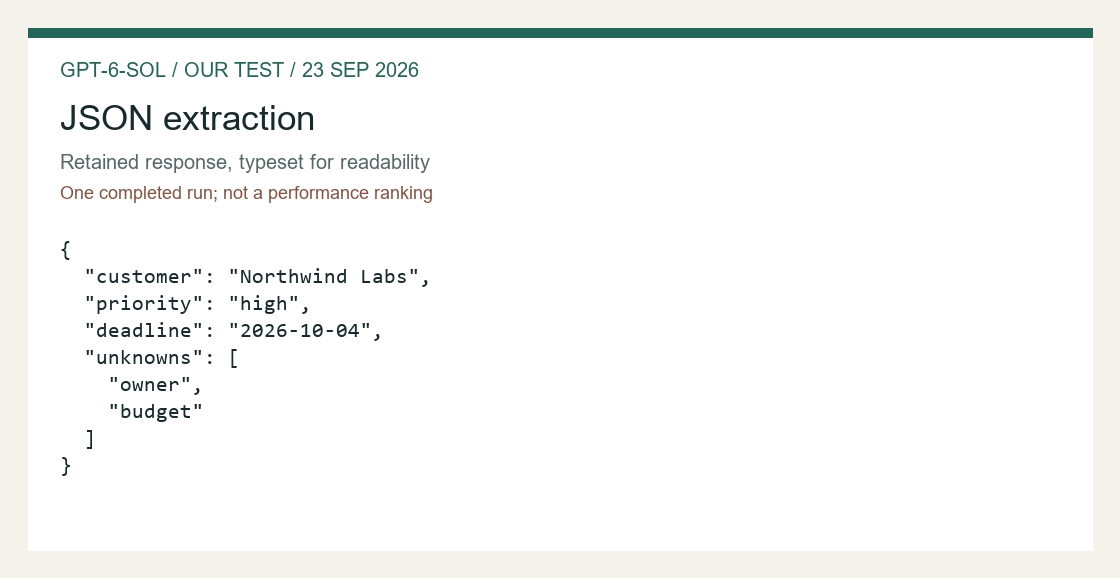
{"klant":"Northwind Labs","prioriteit":"hoog","deadline":"04-10-2026","onbekende gegevens":["verantwoordelijke","budget"]}Gerapporteerd gebruik voor dit voltooide antwoord: 64 invoertokens, 64 aanvultokens, 128 tokens in totaal. Bij het gebruik van de aanvulling kunnen redeneertokens zijn meegerekend; het gaat niet alleen om de lengte van het zichtbare antwoord.
Sol leverde precies de gevraagde velden op: klant, prioriteit, deadline en onbekende gegevens. In de lijst met onbekende gegevens bleven de ontbrekende eigenaar en het onbevestigde budget behouden, in plaats van dat ze werden opgevuld met aannemelijke schattingen. Dat is een belangrijk succes voor deze kleine taak: een downstream-systeem kan een bekende deadline onderscheiden van ontbrekende informatie. De uitvoer bevatte bovendien geen Markdown-omkasting of verklarende inleiding, waardoor deze direct als JSON kon worden geparseerd.
Dezelfde JSON kwam voor in het door Luna bewaarde resultaat. Er is hier geen waarneembaar voordeel in extractiekwaliteit dat het betalen van het hogere tarief van Sol voor deze specifieke invoer rechtvaardigt. Sol zou nog steeds de moeite waard kunnen zijn om te evalueren wanneer de extractie afhankelijk is van het oplossen van tegenstrijdigheden tussen verschillende documenten, maar dat is een andere taak. Ons praktische uitgangspunt zou een goedkopere, gevalideerde extractieroute zijn met escalatie bij tegenstrijdig bewijsmateriaal, in plaats van voor elk record het duurste model te gebruiken.
Een uitvoerbare regressietest voor de aangetoonde fout
Het volgende is een voorbeeld van een redactionele validatie, geen aanvullend modelantwoord. Het wordt lokaal uitgevoerd in Node.js en voert geen modelverzoek uit. Het controleert de hierboven besproken specifieke fixture; het is geen algemene beoordeling van het model.
const assert = require('node:assert/strict');
function uniqueSorted(values) {
  return [...new Set(values)].sort((a, b) => a - b);
}
assert.deepStrictEqual(uniqueSorted([0]), [0]);
assert.deepStrictEqual(uniqueSorted([3, 0, -2, 0, 3]), [-2, 0, 3]);
assert.deepStrictEqual(uniqueSorted([]), []);
const original = values => [...new Set(values)].sort((a, b) => a - b).filter(Boolean);
assert.notDeepStrictEqual(original([0]), [0]);
console.log('De patch is geslaagd; het oorspronkelijke defect met de waarde nul is gereproduceerd.');
De laatste negatieve bewering bevestigt dat de oorspronkelijke functie de waarde nul kwijtraakt. Daardoor wordt de controle gevoelig voor fouten: de test accepteert niet alleen de nieuwe implementatie, maar toont ook het symptoom aan dat met de wijziging moet worden verholpen. Het geval met de lege array is een extra redactionele controle, die duidelijk losstaat van de twee beweringen die door het model worden geleverd. Plaats de test voor productiecode naast de echte functie en voer het daadwerkelijke projecttestcommando uit; het kopiëren van een functie naar een afzonderlijk testbestand kan geen integratiefouten opsporen.
Hoe GPT-6 Sol een echte workflow verandert
De belangrijkste specificatie is alleen van belang als deze de manier waarop een team werkt verandert. GPT-6 Sol is bedoeld voor complexe programmeerwerkzaamheden en agentgebaseerde workflows, dus de eerste vraag is of uw werklast baat heeft bij die aanpak. Als elk verzoek een korte invoer, een beperkte uitvoerovereenkomst en een duidelijke acceptatietest heeft, kan het model in een herhaalbare pijplijn worden ingepast. Als de taak dubbelzinnig is, veel gebruik van tools vereist of waarschijnlijk meerdere correctierondes nodig heeft, is de omringende coördinatie net zo belangrijk als de naam van het model.
Voor GPT-6 Sol is een nuttig productieproces een route in twee fasen: vraag eerst om een beknopt antwoord met expliciete onzekerheid, en stuur vervolgens alleen het betwiste of onvolledige deel door naar een tweede fase. Dit beperkt het aantal verspilde output-tokens en maakt mislukkingen zichtbaar. Het biedt ook een beter vergelijkingspunt ten opzichte van GPT-6 Luna: de vraag is niet welke naam sterker klinkt, maar welke route met minder herpogingen aan de acceptatiecriteria voldoet.
Een eenvoudig kostenmodel voordat je je bestelling verstuurt
De officiële prijstabel moet worden omgerekend naar de eenheden die jouw team daadwerkelijk afneemt: verzoeken per dag, gemiddeld aantal invoertokens, aandeel in de cache van prefixen, uitvoertokens en het percentage oproepen waarbij de invoer de 272.000 overschrijdt. Een spreadsheet waarin alleen de basisprijs voor invoer wordt bijgehouden, laat de vermenigvuldigingsfactor voor lange contexten en de kosten van herhalingspogingen buiten beschouwing.
Deze berekening is met name relevant bij het vergelijken van GPT-6 Sol met GPT-6 Luna. Een goedkoper verzoek kan duur uitvallen als er herhaaldelijk herstelrondes nodig zijn; een krachtiger verzoek kan verspillend zijn wanneer het gaat om deterministische extractie. De juiste referentie is een kleine steekproef van je eigen verkeer met dezelfde prompts, hetzelfde schema en dezelfde beoordelingsregel.
Foutmodi die vóór de ingebruikname moeten worden gecontroleerd
Een modelpagina geeft aan welke eindpunten en modaliteiten zijn gedocumenteerd, maar biedt geen garantie dat uw bestaande applicatie zich na de migratie op dezelfde manier zal gedragen. Controleer of streaminggebeurtenissen correct worden geparseerd, of toolaanroepen de status behouden bij herhalingspogingen, of gestructureerde uitvoer ongeldige velden afwijst en of uw logpijplijn voor elk verzoek de model-ID en de redeneringsinstelling vastlegt.
Juist dankzij diezelfde criteria zijn de praktische observaties in deze evaluatie nuttig, zonder dat ze daardoor veranderen in een ranglijst. Onze drie taken laten zien hoe de route omging met een klein codefoutje, een beslissingsmemo en het nauwkeurig extraheren van JSON. Ze geven geen uitsluitsel over de latentie, de betrouwbaarheid op grote schaal of een algemene kwaliteitsranglijst.
Een besluitvormingskader voor echte teams
Een modelbeoordeling is nuttig wanneer deze iemand helpt een beslissing te nemen binnen bepaalde beperkingen. Voor GPT-6 Sol zijn de meest relevante beperkingen de vorm van het verzoek, de beoordelingskosten, de omvang van de context, het uitvoerformaat en de gevolgen van een verkeerd antwoord. De beschrijving van de aanbieder wijst op complexe codering en agentgebaseerde workflows, maar een team moet die beschrijving nog steeds vertalen naar een traject dat het kan monitoren. Begin met het in één zin opschrijven van de taak, de input die het model zal ontvangen, de output die een ander systeem verwacht, en het menselijke controlepunt dat een onopgemerkte fout voorkomt.
De eerste fout is het kiezen van een model op basis van een demo-prompt. Een demo beloont vloeiendheid en verbergt operationele details zoals herpogingen, tokenbeheer, tool-machtigingen en schemafouten. Een betere vergelijking maakt gebruik van drie representatieve taken: één gewoon verzoek, één moeilijk verzoek en één verzoek dat moet worden afgewezen of geëscaleerd. Het resultaat is geen enkele score. Het is een beknopt overzicht van waar het model tijd bespaart, waar het toezicht nodig heeft en waar een ander model – vaak GPT-6 Luna – de goedkopere of veiligere keuze is.
Begin met de acceptatietest
Schrijf de acceptatietest voordat je de prompt schrijft. Voor code kan de test bestaan uit een geslaagde unit-test of een patch die de openbare API ongewijzigd laat. Voor extractie kan het gaan om geldige JSON waarin alle vereiste sleutels aanwezig zijn en onbekende waarden expliciet behouden blijven. Voor een beslissingsmemo kan het een vaste structuur zijn met bewijs, risico, verantwoordelijke en volgende stap. Het model kan alleen worden geëvalueerd aan de hand van een zichtbaar doel. Zonder dat doel kan een verzorgde alinea er succesvol uitzien, terwijl stilletjes het enige veld wordt weggelaten dat het vervolgproces nodig heeft.
Een goede acceptatietest is beperkt genoeg om automatisch uit te voeren en zinvol genoeg om de gebruiker te beschermen. Hij moet ook duidelijk maken waar er onenigheid bestaat. Als twee uitkomsten van elkaar verschillen, moet het team kunnen wijzen op een ontbrekend feit, een ongefundeerde aanname, een onjuist ingevuld veld of een foutieve berekening. Dat levert meer concrete actiepunten op dan zeggen dat het ene antwoord “slimmer aanvoelde”. Het is ook het verschil tussen een beoordeling die de inkoop ondersteunt en een beoordeling die slechts de lanceringsretoriek herhaalt.
Gebruik de modelnaam om een uitgangshypothese te kiezen. Gebruik je acceptatietest om te bepalen of de hypothese de overgang naar de productieomgeving doorstaat.
Een ontwerp van de prompt dat aansluit bij het profiel van het model
Dezelfde prompt mag niet onveranderd tussen alle modellen worden gekopieerd. Het taakcontract kan stabiel blijven, maar de hoeveelheid context, de instructies voor de redenering en de beperkingen voor de uitvoer moeten aansluiten bij de route. Voor GPT-6 Sol moet de systeeminstructie kort genoeg worden gehouden, zodat deze niet concurreert met het bronmateriaal. Geef de rol, de beslissingsregel, de vereiste uitvoervorm en de voorwaarden aan die een expliciete onbekende of escalatie vereisen.
Bij lange documenten moet het zoeken los worden gezien van de beoordeling. Bepaal eerst welke passages de vraag beantwoorden; vraag vervolgens om de conclusie op basis van uitsluitend die passages en de opgegeven criteria. Dit verkleint de kans dat een zelfverzekerde conclusie wordt getrokken op basis van een verafgelegen, irrelevant detail. Het zorgt er ook voor dat een contextvenster van 1,05 miljoen tokens een hulpmiddel wordt in plaats van een standaardinstelling. Een grote context is waardevol wanneer de relatie tussen ver van elkaar verwijderde bewijsstukken van belang is. Het is verspilling wanneer de taak kan worden opgelost met een klein, zorgvuldig geselecteerd pakket.
Beschrijf bij workflows waarbij tools worden gebruikt de grens tussen het model en de tool. Het model moet bepalen of een tool nodig is, argumenten volgens een strikt schema aanleveren en uitleggen wat het met de geretourneerde waarde gaat doen. De applicatie moet de toegangsrechten handhaven, argumenten valideren, de aanroep registreren en bepalen of een mislukte toolaanroep opnieuw kan worden uitgevoerd. Door het model als de gehele applicatie te beschouwen, wordt het opsporen van fouten bemoeilijkt en neemt de impact van een verkeerde aanname toe.
Een herbruikbare, uit vier delen bestaande prompt
Context: Geef alleen de feiten en documenten die voor de opdracht nodig zijn. Doel: Geef de beslissing of verandering in één zin weer. Beperkingen: geef het formaat, de uitsluitingen, de omgang met onzekerheden en de grenzen van de tool op. Controleer: Vraag het model om ontbrekende invoergegevens of tegenstrijdigheden op te sommen voordat het het antwoord definitief vaststelt. Deze structuur is kort genoeg om herhaaldelijk te kunnen worden aangeroepen en expliciet genoeg om modellen met elkaar te vergelijken.
Wanneer een groot contextvenster van pas komt
De kop ‘1,05 miljoen tokens’ is makkelijk te herhalen en makkelijk te misbruiken. Een contextvenster geeft aan hoeveel materiaal er in een verzoek past; het geeft echter geen indicatie van hoeveel materiaal er moet worden verzonden, hoe goed het model elke passage zal gebruiken, of wat het verzoek zal kosten. Een lang verzoek kan de beoordeling ook vertragen, omdat het team meer bewijsmateriaal moet onderzoeken en er meer ruimte is voor subtiele instructieconflicten.
Gebruik het volledige venster wanneer de taak daadwerkelijk afhankelijk is van verwijzingen op afstand: een contract waarin definities en uitzonderingen gescheiden zijn, een repository waarin interfaces en implementaties ver uit elkaar liggen, of een uitgebreid onderzoeksarchief waarin het antwoord het doorlopen van een reeks vereist. Gebruik opzoekfunctie wanneer de vraag lokaal is, wanneer de bronverzameling vaak verandert, of wanneer je een compact citatiespoor wilt. Gebruik caching wanneer een stabiel prefix bij veel verzoeken wordt hergebruikt en het platform voldoende gebruiksgegevens beschikbaar stelt om aan te tonen dat de cache werkt.
De drempel van 272K zou in het architectuurdiagram moeten worden opgenomen, en niet als voetnoot in de paragraaf over de prijsstelling. Een verzoek dat onder de drempel veilig is, kan boven de drempel aanzienlijk duurder worden. Teams moeten invoertokens, in de cache opgeslagen tokens, uitvoertokens, de model-ID, de redeneringsinstelling en of het verzoek de drempelwaarde heeft overschreden, registreren. Dat logboek ondersteunt een realistisch kostenmodel en maakt het mogelijk om onbedoelde contextinflatie op te sporen voordat dit tot een maandelijkse verrassing leidt.
Vragen over API-migratie die een testrun rechtvaardigen
Voordat je een bestaande integratie naar GPT-6 Sol verplaatst, moet je een testomgeving opzetten waarin een kleine, geanonimiseerde steekproef wordt nagespeeld. Vergelijk de uiteindelijke tekst, de gestructureerde velden, de toolaanroepen, de redenen voor het stoppen en het tokengebruik. Vergelijk niet alleen het eerste scherm van het antwoord. Een model kan de zichtbare conclusie behouden terwijl het een veldnaam wijzigt, een foutconditie weglaat of een toolargument retourneert dat de applicatie niet veilig kan uitvoeren.
‘Responses’ en ‘Chat Completions’ zijn geen onderling uitwisselbare labels in een integratieplan. Ondersteuning van eindpunten, instellingen voor redenering, het gedrag van tools, streaminggebeurtenissen en foutobjecten hebben allemaal invloed op de adapter. Veranker de model-ID in de configuratie, maar houd deze zichtbaar in logbestanden en testrapporten. Wanneer een verzoek mislukt, moet het record het eindpunt, het model, de redeneringsinspanning, de promptversie, de omvang van het verzoek en de beslissing om het opnieuw te proberen weergeven. Aan de hand van dat bewijsmateriaal kan een engineer een storing reproduceren in plaats van te discussiëren of het model gewoon een slechte dag had.
Batchverwerking verandert de economische aspecten en het operationele ritme. Het kan geschikt zijn voor classificatie ’s nachts, het voorbereiden van documenten of een wachtrij met bewerkingen die niet zo urgent zijn. Het is echter niet geschikt voor interactieve handelingen waarbij een reactie naar de gebruiker nodig is. Ook de ‘snel’- en ‘regionaal’-modi beïnvloeden de prijsberekening. Beschouw deze als expliciete configuratiekeuzes en neem ze op in het budgetwerkblad, in plaats van ze te verbergen in een standaardinstelling.
Speel de invoer van vertegenwoordigers opnieuw af, controleer de gestructureerde uitvoer, leg de argumenten van de tool vast, vergelijk de redenen voor het afbreken, meet het gebruik van tokens en test één foutpad voordat u de standaardinstelling in de productieomgeving wijzigt.
Kwaliteit, veiligheid en beoordelingskosten
Een lagere tokenprijs betekent niet automatisch lagere totale kosten, en een duurder model leidt niet automatisch tot een beter bedrijfsresultaat. De totale kosten omvatten herhalingspogingen, menselijke controle, incidentafhandeling en het werk dat nodig is om gegevens verderop in het proces te herstellen. De bruikbare maatstaf is de kosten per geaccepteerd resultaat, uitgesplitst per taakgroep. Een route die per verzoek iets duurder is, kan nog steeds de voorkeur genieten als deze het herstelwerk bij taken met grote impact vermindert; een zeer goedkope route kan doorslaggevend zijn bij deterministische extractie met sterke validatie.
Risico’s moeten worden ingedeeld op basis van de handeling, niet op basis van de merknaam van het model. Het lezen van een openbaar document en het opstellen van een samenvatting is iets anders dan het wijzigen van een klantdossier, het goedkeuren van een betaling, het verwijderen van gegevens of het publiceren van een juridische verklaring. Laat onomkeerbare handelingen plaatsvinden na een menselijke controle of een tweede, onafhankelijke validatiestap. Vraag het model om onzekerheid te identificeren, maar beschouw een zin die vertrouwen wekt nooit als een toestemmingssysteem.
Vragen over privacy en bewaartermijnen horen thuis in de implementatiebeoordeling. Ga na welke gegevens worden verzonden, hoe lang logbestanden worden bewaard, wie de prompts kan inzien en of het verzoek vertrouwelijke informatie of persoonsgegevens bevat. Verberg waar mogelijk gevoelige informatie, beperk de context tot een minimum en houd duidelijk bij welke velden zijn verwijderd. Deze maatregelen gelden ongeacht of het model via een officiële API of een andere compatibele route wordt gebruikt.
Hoe vergelijk je GPT-6 Sol met GPT-6 Luna?
Bij een eerlijke vergelijking blijven de taak en de acceptatieregel constant, terwijl elk model zijn gedocumenteerde sterke punten kan benutten. Voer hetzelfde invoerpakket uit, maar noteer of een model een andere redeneringsinstelling of een ander eindpunt nodig heeft. Geef de verschillen duidelijk weer: het ene model levert wellicht een completere patch op, een ander is wellicht goedkoper bij herhaalde extractie, en een derde is wellicht eenvoudiger te integreren omdat het toolcontract overeenkomt met uw huidige adapter.
Maak van één geslaagde taak geen algemene ranglijst. Drie kleine taken zijn nuttig om vraagstukken in de workflow aan het licht te brengen, niet om een universele winnaar aan te wijzen. Herhaal de taak met verschillende realistische invoergegevens, neem ten minste één vijandig of onvolledig geval op en bepaal van tevoren wat als geslaagd geldt. Als de steekproef te klein is om een conclusie te onderbouwen, geef dat dan aan. Die afbakening versterkt het vertrouwen in plaats van de beoordeling te verzwakken.
Een gefaseerde invoering waarbij de beslissing nog kan worden teruggedraaid
Begin met schaduwverkeer of een niet-kritieke wachtrij. Laat de nieuwe route een resultaat opleveren, terwijl de bestaande route de ‘bron van de waarheid’ blijft. Vergelijk gedurende een vaste periode het acceptatiepercentage, de tokenkosten, de beoordelingstijd en de foutcategorieën. Verplaats vervolgens één taakgroep tegelijk, waarbij u een terugschakelknop en een duidelijke versietag bij de hand houdt. Een gefaseerde uitrol maakt van een modelkeuze een waarneembare technische wijziging in plaats van een vervanging die in één dag plaatsvindt.
Let tijdens de implementatie op veranderingen die niet tot uiting komen in een eenvoudig slagingspercentage: langere uitvoer, meer toolaanroepen, meer escalaties of meer verzoeken die de drempel voor een lange context overschrijden. Een model kan nauwkeurig lijken, terwijl het meer budget verbruikt of de werkdruk voor operators verhoogt. Stel waarschuwingen in voor die aspecten en bespreek ze met de mensen die daadwerkelijk uitzonderingen afhandelen.
Hoe succes eruitziet
Succes is een stabiel traject met bekende kosten, een zichtbare manier waarop het mis kan gaan en een evaluatieproces dat mensen kunnen volgen. Het vereist niet dat we doen alsof het model perfect is. Het vereist wel dat we weten welke taken het goed aankan, voor welke taken een andere route nodig is, en hoe we het moeten stoppen of corrigeren wanneer de invoer onvolledig is. Dat is de praktische norm die ten grondslag ligt aan de observaties en documentatie die in deze evaluatie zijn verzameld.
Wat reacties van het publiek je wel en niet kunnen vertellen
De volgende bronnen zijn opgenomen als toegeschreven reacties van het publiek, niet als officiële documentatie of gecontroleerd benchmarkmateriaal. Uit de titels blijkt wat elke maker heeft gekozen om te testen of uit te leggen; ze vormen geen marktbreed resultaat.
- Nate Herk | AI-automatisering: Ik heb Opus 5.5 en GPT-6 Sol getest aan de hand van 10 praktijkvoorbeelden. Beschouw de invalshoek en eventuele voorbeelden als de ervaring van die maker, niet als een algemeen geldende norm.
- Arena AI: GPT-6 Sol | Eerste indrukken. Beschouw de invalshoek en eventuele voorbeelden als de ervaring van die maker, niet als een algemeen geldende norm.
- Chase AI: GPT 6 Sol & Luna zijn er (en 50% is GOEDKOPER!). Beschouw de invalshoek en eventuele voorbeelden als de ervaring van die maker, niet als een algemeen geldende norm.
Er speelt hier nog een ander probleem met de naamgeving: in de titels van verschillende openbaar beschikbare video’s worden “GPT-6” en “GPT-5.6” door elkaar gebruikt. Vermeld de exacte model-ID wanneer je een bewering citeert. De Vergelijking tussen de GPT-6 Astra en de GPT-5.6 Sol is een goed voorbeeld van waarom de identiteit van de aanbieder, het platformlabel en de route afzonderlijk moeten worden geregistreerd.
Hoe krijg je toegang tot GPT-6 Sol?
Open de GPT-6 Sol-werkruimte Begin met een taak die je kunt beoordelen: een klein codevoorbeeld, een kort bronpakket of een gestructureerde opdrachtomschrijving. Houd de gevraagde output en de acceptatiecriteria in het oog terwijl je de verschillende versies vergelijkt. De hierboven genoemde officiële tokenprijzen hebben betrekking op direct API-gebruik en vormen geen toezegging met betrekking tot werkruimtekredieten of abonnementsquota.
Voor de huidige naamgeving van het platform en de context van afzonderlijke vermeldingen, zie de Prijsgids GPT-5.6 en de Vergelijking van het GPT-5.6-model. Die pagina’s hebben betrekking op de context van het platform en de redactie; ze hebben geen voorrang op de API-prijstabel van OpenAI.
Neem een representatieve taak mee en vergelijk het resultaat met je eigen acceptatiecriteria.
Open de GPT-6 Sol-werkruimteVoor wie is GPT-6 Sol geschikt?
Als er op je shortlist goedkopere alternatieven staan, vergelijk dan de uitgebreider modelassortiment in plaats van ervan uit te gaan dat het nieuwste model automatisch de beste prijs-kwaliteitverhouding biedt. Als je taken met grote hoeveelheden gegevens evalueert, dan is de handleiding voor data-analysemodellen biedt een aparte workflow-lens.
Veelgestelde vragen
Wat is GPT-6 Sol?
GPT-6 Sol is het model van OpenAI voor complexe codering en agentgebaseerde workflows. De officiële API-model-ID is gpt-6-sol.
Hoeveel kost GPT-6 Sol?
OpenAI vermeldt GPT-6 Sol tegen $2,00 per 1 miljoen invoertokens, $0,20 per 1 miljoen in de cache opgeslagen invoertokens, $2,50 per 1 miljoen cache-schrijfbewerkingen en $10,00 per 1 miljoen output-tokens tegen standaardtarieven.
Wat gebeurt er als er meer dan 272.000 invoertokens zijn?
Wanneer een verzoek meer dan 272K invoertokens omvat, past OpenAI voor het volledige verzoek de dubbele invoer- en cachesnelheden en 1,5 keer de uitvoersnelheden toe.
Wat zijn de context- en uitvoerbeperkingen?
GPT-6 Sol heeft een contextvenster van 1.050.000 tokens, een maximale invoer van 922.000 tokens en een maximale uitvoer van 128.000 tokens.
Wat is de kennisdrempel?
Op de huidige modelpagina van OpenAI wordt 20 april 2026 vermeld als de kennisafsluitdatum voor GPT-6 Sol.
Welke instellingen voor redeneren zijn er beschikbaar?
De API beschrijft de inspanningsniveaus ‘none’, ‘low’, ‘medium’, ‘high’, ‘xhigh’ en ‘max’, waarbij ‘medium’ de standaardinstelling is.
Welke API-eindpunten worden ondersteund?
GPT-6 Sol ondersteunt chat-aanvullingen, reacties en batchverwerking. Op de modelpagina worden realtime, assistenten, audio, video, het genereren van afbeeldingen, embeddings, fine-tuning, moderatie en verouderde aanvullingen niet vermeld als ondersteunde functies.
Kan GPT-6 Sol afbeeldingen verwerken?
Ja. Op de modelpagina staan tekst- en afbeeldingsinvoer vermeld, met tekst als uitvoer. Dat betekent nog niet dat het een model is voor het genereren van afbeeldingen.
Is GPT-6 Sol beschikbaar in GlobalGPT?
Gebruik de hierboven gelinkte speciale modelpagina van GPT-6 Sol. De credits voor de werkruimte en de limieten van het abonnement staan los van de tarieven voor directe API-tokens die in deze recensie worden beschreven.
Bevat dit artikel een benchmark?
Het omvat drie observaties van kleine taken, geen gecontroleerde benchmark. Luna had bij een nieuwe poging een aangepaste programmeeropdracht nodig. Deze resultaten wijzen niet op een algemene winnaar of prestaties op grote schaal.
Eindoordeel
Sol is het model dat je moet overwegen wanneer het werk echt complex, gereedschapintensief of codegericht is en de hogere kosten voor tokens aanvaardbaar zijn. Het bewijs hier is gebaseerd op een combinatie van officiële documentatie en onze kleine steekproef van taken, en niet op een gecontroleerde benchmark; daarom is het verantwoord oordeel dat het model geschikt is, en niet dat het een universele ranglijst vormt. Maak uw keuze op basis van de gewenste resultaten en de totale exploitatiekosten, en herzie deze keuze wanneer uw werklast verandert.
Gecontroleerd op 23 september 2026. Officiële gegevens: OpenAI Developers. Naamgeving van de platformroute: GlobalGPT. Reactie van het publiek: alleen met bronvermelding naar de makers en publicaties.









