
GPT-6.1 Sol is het uitgebalanceerde model van OpenAI voor complexe programmeertaken, computergebruik en professioneel werk. Het behoudt het contextvenster van 1.050.000 tokens en het uitvoersplafond van 128.000 tokens van GPT-6 Astra, maar de prijzen voor de Standard API dalen naar $2 per miljoen invoertokens en $10 per miljoen uitvoertokens. Dat is een vijfde van de huidige tokentarieven van Astra. De afweging is eenvoudig: Astra blijft het vlaggenschip, terwijl Sol erop gericht is voldoende van zijn mogelijkheden te bieden aan teams die belang hechten aan de kosten per voltooide taak.
In deze handleiding wordt een onderscheid gemaakt tussen wat OpenAI-documenten voor GPT-6.1 Sol op basis van wat onafhankelijke ontwikkelaars tijdens vroege tests hebben waargenomen. Het toont ook de prijsregel voor lange contexten, realistische kostenvoorbeelden, een werkend Responses API-patroon en een praktische manier om een keuze te maken tussen Sol, Astra, Luna en de eerdere GPT-6 Sol.
Wat is GPT-6.1 Sol?
GPT-6.1 Sol is het nieuwste Sol-model in de GPT-6-serie van OpenAI. Volgens de officiële beschrijving is het een model voor complexe programmeeropgaven, computergebruik en professioneel werk, met prestaties die dicht bij die van Astra liggen, maar tegen lagere kosten. In de hiërarchie van de reeks is Astra de keuze met de hoogste capaciteit, Luna de keuze voor efficiëntie en Sol de middenweg voor werk dat moeilijk genoeg is om sterk redeneervermogen te vereisen, maar vaak genoeg voorkomt om de kosten per eenheid belangrijk te maken.
Het model-ID is gpt-6.1-sol. Precies die tekenreeks is van belang bij API-aanroepen, testlogboeken, factureringsgegevens en de implementatieconfiguratie. De oudere gpt-6-sol blijft een ander model, ook al komen de niet-gecachete in- en uitprijzen overeen. De pagina van OpenAI voor het oudere model verwijst lezers nu naar de nieuwere versie, terwijl onze Beoordeling van GPT-6 Sol en API-limieten vormt het historische referentiepunt.
De belangrijkste reden om aandacht te besteden aan deze update is niet één enkel cijfer op het klassement. Het is de combinatie van een contextvenster ter grootte van een Frontier-venster, brede ondersteuning voor tools, vijf niveaus van redeneerinspanning en een prijs die tot breder gebruik uitnodigt dan bij Astra. Een model dat weliswaar iets minder krachtig is, maar betaalbaar genoeg om bij elk serieus ontwerp, elke codereview of elke meerstaps-workflow te worden ingezet, kan meer waarde opleveren dan een vlaggenschipmodel dat alleen voor zeldzame gelegenheden is weggelegd.
Die indeling moet nog worden getoetst aan je eigen taken. OpenAI’s richtlijnen voor modelkeuze raadt uitdrukkelijk aan om Sol en Astra met elkaar te vergelijken bij hetzelfde werk. Een workflow voor juridische documenten, een herstructurering van een repository, een browseragent en een presentatie voor het bestuur kunnen verschillende mogelijkheden op de proef stellen. Beschouw het modeletiket als een uitgangspunt en meet vervolgens de juistheid, het aantal herzieningen, de vertraging en de totale kosten per geaccepteerd resultaat.
Specificaties van de GPT-6.1 Sol
De officiële modelcatalogus geeft een overzicht van tekst- en afbeeldingsinvoer met tekstuitvoer. Audio en video worden door het model zelf niet ondersteund als invoer- of uitvoerformaten. Dit onderscheid is nuttig bij het ontwerpen van een product: je kunt screenshots, diagrammen, gescande pagina’s of andere afbeeldingen doorgeven, maar voor het transcriberen van audio en het begrijpen van video is een aparte component of tool nodig.
De maximale invoer is lager dan het contextvenster in de koptekst, omdat er binnen het totale budget ruimte moet blijven voor de uitvoer en de interne verwerking. Het maximum van 128.000 tokens voor de uitvoer is ruim, maar het opvragen van een enorm antwoord is zelden de beste ontwerpkeuze. Lange uitvoer kost meer, duurt langer om te controleren en kan afwijken. Voor de meeste softwareopdrachten zijn kleinere, gestructureerde outputs met controlepunten gemakkelijker te valideren.
Ondersteuning bij het redeneren laag, gemiddeld, hoog, xhoog, en max; 'medium' is de standaardinstelling. De geen en minimaal de instellingen zijn niet beschikbaar. Gebruik een lagere inspanningsgraad voor routinematige transformaties en verhoog deze alleen wanneer de foutkosten of complexiteit van een taak de extra tokens en tijd rechtvaardigen. Het praktische doel is de laagst mogelijke instelling waarmee je acceptatietests nog steeds worden doorstaan.
Ontwikkelaars die oudere prijsontwikkelingen en het gedrag van tokens met elkaar vergelijken, kunnen gebruikmaken van onze Prijzen en kostenvoorbeelden voor GPT-6 Sol als referentiepunt. De belangrijkste wijziging in de specificaties betreft niet de contextgrootte, die voor alle hier besproken GPT-6-modellen gelijk blijft. Het gaat om de aangepaste positionering van de nieuwere Sol en de goedkopere ingevoerde gegevens in de cache.
Prestaties: wat uit het officiële bewijsmateriaal blijkt
Volgens de lanceringsinformatie van OpenAI presteert GPT-6.1 Sol aanzienlijk beter dan GPT-6 Sol bij complexe professionele taken, zoals het schrijven en debuggen van code, het begrijpen van documenten en het uitvoeren van meerstaps zakelijke workflows. Het bedrijf stelt dat het bij verschillende evaluaties tegen lagere kosten in de buurt komt van GPT-6 Astra. Dit zijn officiële evaluatieclaims, geen garantie dat elke prompt even goed zal presteren als Astra.
De Aanvulling op de GPT-6.1-kaart van het zonnestelsel dit vormt een belangrijke beperking: de evaluaties werden uitgevoerd in de onderzoeksomgeving van OpenAI of via de API, en de productieversie ChatGPT kan hiervan afwijken omdat de systeemprompts, de beschikbare tools en de instellingen voor de inspanningsgraad niet identiek zijn. Daarom moet een objectief artikel officiële benchmarkresultaten gescheiden houden van tests door de maker en van interne evaluaties door het bedrijf.
Een concreet voorbeeld is HealthBench. In de gepubliceerde tabel behaalt GPT-6.1 Sol lengte-gecorrigeerde scores van 64,2 op HealthBench Professional, 58,5 op HealthBench, 36,2 op HealthBench Hard en 96,0 op HealthBench Consensus. De bijbehorende Astra-scores zijn 64,7, 58,3, 36,6 en 95,5. OpenAI beschrijft de modellen als modellen die binnen 0,5 procentpunt van elkaar liggen bij deze vier evaluaties.
Dat resultaat ondersteunt de omschrijving “in de buurt van Astra” binnen die evaluatiegroep. Het bewijst echter niet dat de kwaliteit van de softwareontwikkeling, de betrouwbaarheid van de browser of de weergavestijl gelijkwaardig zijn. Een prestatiebenchmark meet een andere capaciteit dan het verhelpen van een race condition of het coördineren van tools. Voor een diepgaander overzicht van het bredere testprofiel van het vlaggenschip, zie de GPT-6 Astra: review en praktijktests.
De meest aannemelijke praktische interpretatie is voorwaardelijk: GPT-6.1 Sol hoort thuis in de groep van kandidaten voor zware taken, vooral wanneer de prijs van Astra het gebruik zou beperken. Het verdient een vergelijkende evaluatie, geen automatische promotie. Meet het slagingspercentage, het aantal menselijke correcties, fouten van de tool, het aantal gegenereerde tokens en de tijd die nodig is om tot een geaccepteerd resultaat te komen. Die statistieken maken van een modelvergelijking een zakelijke beslissing.
Programmeren: wat GPT-6.1 Sol kan doen
GPT-6.1 Sol beschikt over de bouwstenen die van een modern programmeermodel worden verwacht: streaming, gestructureerde uitvoer, het aanroepen van functies, zoeken in bestanden, invoer van afbeeldingen, zoeken op het web en het in de cache opslaan van prompts. Via de Responses API biedt OpenAI bovendien een code-interpreter, een gehoste shell, het toepassen van patches, vaardigheden, computergebruik, MCP en het zoeken naar tools. Daardoor is het model geschikt voor workflows waarbij bestanden worden geïnspecteerd, wijzigingen worden voorgesteld, commando’s worden uitgevoerd en door de machine gecontroleerde output wordt geretourneerd.
Ondersteuning van functionaliteiten betekent niet dat elke omgeving automatisch alle tools beschikbaar stelt. Je applicatie bepaalt nog steeds welke tools er zijn, welke rechten ze krijgen, hoe de resultaten naar het model worden teruggestuurd en welke acties bevestiging vereisen. Chat Completions werkt voor GPT-6.1 Sol zonder dat er tools worden aangeroepen, terwijl OpenAI applicaties die tools gebruiken doorverwijst naar Responses. Nieuwe agentische systemen moeten die API-grens beschouwen als een architecturale keuze, niet als een klein syntactisch verschil.
Op het moment van publicatie was het exacte model niet vermeld in de chatcatalogus van de testlocatie, dus deze gids pretendeert geen nieuwe interne benchmark te bieden voor de vier geplande programmeertaken. De programmeerbeoordeling is gebaseerd op officiële prestatiegegevens en namaakte openbare runs. Dat is nuttiger dan stilletjes Astra of de oudere Sol te vervangen en de verkeerde modelnaam aan het resultaat toe te voegen.
Een gedegen evaluatie moet bestaan uit het opsporen van fouten met regressietests, een afgebakende functie voor meerdere bestanden, een beveiligingsbeoordeling en een technische beslissing binnen de beperkingen van het schema. Deze taken testen meer dan alleen het genereren van code. Ze laten zien of het model een API behoudt, randgevallen opspoort, uitvoerbeperkingen in acht neemt en aangeeft wat het niet kon verifiëren. Onze gids voor de beste AI-modellen voor programmeren in 2026 legt uit waarom de beste keuze per workflow verschilt.
Zoek het kleinste defect, behoud de API en voeg werkende tests toe.
Houd rekening met gelijktijdigheid, volgorde, validatie en het gedrag bij fouten.
Geef prioriteit aan exploitpaden, zorg voor een minimale oplossing en vermijd beweringen over verzonnen frameworks.
Wanneer je een opdracht als deze uitvoert, beoordeel het resultaat dan systematisch. Blijft de waarde nul behouden? Zijn dubbele waarden verwijderd? Is de numerieke sortering correct? Worden de tests uitgevoerd met node --test? Een goed geformuleerde uitleg kan een onjuiste bewering niet goedmaken. Hetzelfde geldt voor het werk aan de repository: stel eerst de acceptatievoorwaarden vast voordat je het model kiest, en beoordeel vervolgens de patch in plaats van te letten op hoe overtuigend de tekst is.
Prijzen voor GPT-6.1 Sol
De officiële API-prijspagina De kosten voor GPT-6.1 Sol worden berekend per miljoen tokens. De kosten voor invoer bedragen $2, die voor ingevoer uit de cache $0,10, die voor het schrijven naar de cache $2,50 en die voor uitvoer $10. De kosten voor ingevoer in de cache bedragen dus 5% van het tarief voor ingevoer zonder cache, terwijl het schrijven van nieuwe cache-inhoud 1,25 keer de kosten van gewone ingevoer bedraagt. Toolspecifieke kosten kunnen afzonderlijk worden toegevoegd, dus de tokenberekening is slechts een onderdeel van een workload waarbij tools worden gebruikt.
Het belangrijkste detail met betrekking tot de prijsstelling is de drempel van 272K. Zodra de invoer de 272.000 tokens overschrijdt, worden voor het gehele verzoek de invoer- en cache-snelheden verdubbeld en de uitvoersnelheid met een factor 1,5 verhoogd. Het gaat hier niet om een marginale toeslag die alleen van toepassing is op tokens boven deze drempel. Toepassingen die regelmatig dicht bij de grens zitten, moeten het aantal tokens tellen voordat ze deze verzenden en overwegen om de data op te splitsen in chunks, op te halen of te comprimeren.
In de Fast-modus worden de standaardprijzen verdubbeld. Bij Batch en Flex worden de standaardtarieven met 50% verlaagd, en bij regionale verwerking wordt, indien beschikbaar, een toeslag van 10% in rekening gebracht. Deze modi bieden oplossingen voor verschillende problemen: ‘Fast’ compenseert de latentie, ‘Batch’ ruilt onmiddellijkheid in voor lagere kosten, ‘Flex’ ruilt voorspelbaarheid in de planning in voor lagere kosten, en regionale verwerking speelt in op de behoefte aan lokale gegevensopslag. Vergelijk de prijzen niet zonder ook de operationele beperkingen te vergelijken.
De standaardtarieven van Astra bedragen $10 aan invoer en $50 aan uitvoer per miljoen tokens, precies vijf keer de nominale tarieven van Sol. De Prijzen en tokenlimieten voor de GPT-6 Astra API In deze gids wordt die premie nader belicht. Sol en de vorige GPT-6 Sol hanteren dezelfde niet-gecachete invoer- en uitvoerprijzen, maar bij GPT-6.1 Sol is de gecachete invoer teruggebracht van $0.20 naar $0.10 per miljoen tokens.
Voorbeelden van werkelijke kosten
Tokenprijzen zijn gemakkelijker in te schatten wanneer ze worden omgerekend naar volledige verzoeken. In de onderstaande voorbeelden wordt uitgegaan van standaardverwerking, zonder kosten voor het aanroepen van tools, zonder regionale toeslag en zonder ingevoerde gegevens uit de cache, tenzij anders vermeld. De daadwerkelijke lengte van de uitvoer is vaak bepalender voor de kosten dan ontwikkelaars verwachten, omdat uitvoer op GPT-6.1 Sol vijf keer zoveel kost als gewone invoer.
Voor de codereview met 100K invoer en 5K uitvoer bedragen de invoerkosten $0.20 en de uitvoerkosten $0.05, wat neerkomt op een schatting van $0.25. Als de volledige 100K-input in de cache wordt opgeslagen, daalt het inputgedeelte naar $0,01 en wordt het totaal $0,06. Als de applicatie dat prefix van 100K eerst naar de cache moet schrijven, bedraagt het cache-schrijfgedeelte $0,25 vóór de uitvoer.
Het voorbeeld met 300.000 invoergegevens overschrijdt de drempel. Voor invoer wordt een effectief tarief van $4 per miljoen in rekening gebracht, dus 300.000 kost $1,20. Uitvoer wordt in rekening gebracht tegen een effectief tarief van $15 per miljoen, dus 10.000 kost $0,15. Het totaal bedraagt $1,35. Een verzoek dat slechts iets boven de drempel ligt, kan daarom veel meer kosten dan een verzoek dat net eronder ligt, zelfs nog vóór de kosten voor tools.
Met ‘Batch’ of ‘Flex’ zou het in aanmerking komende ‘Standard’-totaal worden gehalveerd, terwijl het met ‘Fast’ zou worden verdubbeld. Voor het eerste voorbeeld betekent dit ongeveer $0,125 bij ‘Batch’ of ‘Flex’ en $0,50 bij ‘Fast’. Teams die nog steeds oudere GPT-5.6-modellen gebruiken, kunnen die aannames vergelijken met onze Prijzen voor GPT-5.6 en Codex-credits uitsplitsing.
Hoe gebruik je GPT-6.1 Sol?
De meest overzichtelijke manier voor ontwikkelaars is de Responses API. Installeer de huidige OpenAI SDK, voer de API-sleutel in via je omgeving en stel model naar gpt-6.1-sol. De officiële handleiding voor het genereren van tekst beveelt ‘Responses’ aan voor directe modelverzoeken, en de modelpagina vereist dit voor het aanroepen van tools.
1. Begin met een eenvoudig verzoek aan de Responses API
Houd het eerste verzoek eenvoudig. Controleer of de exacte model-ID beschikbaar is voor je project, leg de geretourneerde model- en gebruiksvelden vast en sla voldoende metagegevens op om de uitvoering te kunnen reproduceren. Begin niet meteen met een enorme toolketen. Een eenvoudig verzoek scheidt problemen met de toegang tot het model van problemen met de tooldefinitie, machtigingen en coördinatie.
2. Voeg tools alleen toe via de Responses API
Wanneer de workflow het doorzoeken van bestanden, zoeken op het web, het uitvoeren van code, shell-toegang, computergebruik, MCP of aangepaste functies vereist, moet u de kleinst mogelijke set aan benodigde tools definiëren. Beperk het bereik van bestanden en het netwerk, controleer de argumenten van de tools en bepaal welke acties door een gebruiker moeten worden bevestigd. Het model kan tools voorstellen en aanroepen, maar uw toepassing blijft verantwoordelijk voor het uitvoeren ervan en het handhaven van machtigingen.
3. Stem de inspanning die je in het redeneren steekt af op een evaluatie
Begin met de stand ‘medium’, de standaardinstelling. Voer een representatieve evaluatieset uit en vergelijk vervolgens de standen ‘low’, ‘high’ of ‘xhigh’ op basis van het acceptatiepercentage, het aantal output-tokens, de latentie en het aantal revisies. De stand ‘Max effort’ kan helpen bij de moeilijkste taken, maar als je deze overal gebruikt, kan dat het kostenvoordeel tenietdoen dat Sol zo aantrekkelijk maakte. Kies de lichtste instelling waarmee je betrouwbaar slaagt.
4. Gebruik GlobalGPT voor een interactieve vergelijking
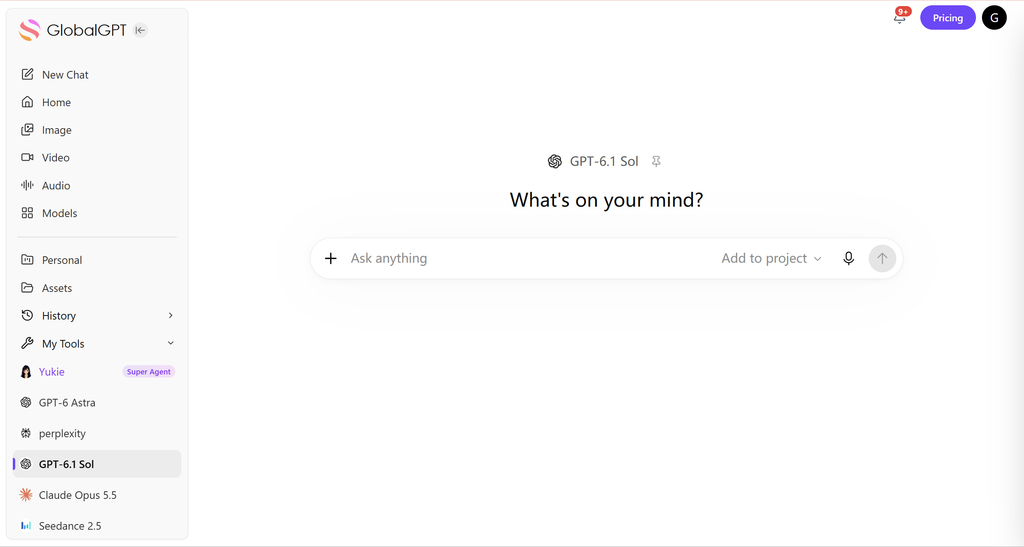
Voor interactief werk, open De multi-model-werkruimte van GlobalGPT en selecteer GPT-6.1 Sol zodra deze beschikbaar is in de keuzelijst van je account. Deze werkwijze is handig om antwoorden te vergelijken zonder dat je daarvoor aparte tabbladen en abonnementen hoeft bij te houden. Het is geen vervanging voor API-implementatiebeheer, repository-automatisering, Codex of een IDE. Onze handleiding voor ChatGPT-modelkeuzes voor codering gaat in op die verschillen in de werkwijze.
GPT-6.1 Sol versus GPT-6 Sol, Astra en Luna
Alle vier de modellen in deze vergelijking accepteren tekst en afbeeldingen, geven tekst als uitvoer en hebben een contextvenster van 1.050.000 tokens met een maximale uitvoer van 128.000. De wezenlijke verschillen zitten in de positie, de prijs, de afsluitdatum, de instellingen voor de redenering en het kwaliteitsniveau dat je bij een echte taak waarneemt. In de tabel zijn de huidige officiële standaardprijzen per token gebruikt, gecontroleerd op 1 oktober 2026.
| Model | Beste pasvorm | Ingang / 1M | In de cache opgeslagen / 1M | Uitgang / 1M | Afkapping |
|---|---|---|---|---|---|
| GPT-6.1 Sol | Complexe werkzaamheden met kostenbeheersing | $2 | $0.10 | $10 | 30 april 2026 |
| GPT-6 Astra | Werk waarbij kwaliteit voorop staat en de eisen zeer hoog zijn | $10 | $1 | $50 | 30 april 2026 |
| GPT-6 Sol | Bestaande, oudere Sol-integraties | $2 | $0.20 | $10 | 20 april 2026 |
| GPT-6 Luna | Gerichte taken met een hoog volume | $0.10 | $0.01 | $0.50 | 18 mei 2026 |
Kies voor Astra wanneer de taak zo moeilijk is dat een kleine kwaliteitswinst kostbare handmatige herbewerking kan voorkomen. Kies voor GPT-6.1 Sol wanneer het werk nog steeds complex maar veelvuldig is, vooral als de korting op ingeslagen invoer helpt. Kies voor Luna wanneer volume en latentie doorslaggevend zijn en de taak goed is afgebakend. Behoud de oudere Sol alleen wanneer migratierisico’s, bestaande evaluaties of compatibiliteitswerk een onmiddellijke overstap onaantrekkelijk maken.
Het prijsverschil van vijf keer tussen Sol en Astra is groot, maar de prijs per token is niet hetzelfde als de prijs per geaccepteerd resultaat. Een krachtiger model kan minder output-tokens gebruiken, minder tools aanroepen of minder revisies nodig hebben. Omgekeerd kan Sol zelfs met één extra revisie winnen als de eenheidsprijs van Astra dat verschil ruimschoots compenseert. Vergelijk volledige taaktrajecten in plaats van de lengte van één enkele prompt te vermenigvuldigen.
Lezers die overwegen of de overstap naar het vlaggenschip de moeite waard is, kunnen gebruikmaken van de Vergelijking tussen de GPT-6 Astra en de GPT-5.6 Sol voor de context van eerdere niveaus. Voor de goedkoopste variant van de huidige reeks geldt dat de GPT-6 Luna: review en de beste toepassingen geeft de relevante API-limieten en geschiktheid voor de werklast weer.
Wat recensenten zeggen
OpenAI heeft GPT-6.1 Sol op 29 september 2026 tijdens de keynote van de DevDay geïntroduceerd, samen met andere productlanceringen. Die officiële video geeft de lanceringstijdstip en -positionering weer; het is geen onafhankelijk bewijs. De waardevolle reacties van buitenaf komen van makers die een taak, een vergelijkingsset, een kostenberekeningsmethode en mislukkingen openbaar maken, in plaats van de lanceringsboodschap te herhalen.
Kan het programmeren? meldde dat Sol in een vergelijking tussen Blender en Godot over drie rondes aanzienlijk goedkoper en sneller presteerde, maar merkte op dat de kwaliteit van het spel in de loop van de rondes achteruitging.
Matt Johnston meldde een gewogen score van 96 en kosten van $2,63 voor de reeks in zijn opstelling met negen tests, waarbij hij duidelijk aangaf dat de pinguïntaak niet was gelukt.
Duncan Rogoff heeft Sol vergeleken met Sonnet 5.5 in zes builds en daarbij de tijd, het aantal tokens en de uiteindelijke kosten bijgehouden.
In De video van ’Can It Code?’ met drie rondes, waarbij de opdrachten evolueerden van een low-poly Blender-kerkerkit naar gemodelleerde en geanimeerde personages en vervolgens naar een speelbare Godot-game. De maker schatte de tijd voor Sol in alle rondes op $29.17 en 7 uur en 5 minuten, ver onder de vergelijkingsruns, maar vond het uiteindelijke spel minder prettig en zei dat Sol elke ronde slechter werd. De conclusie is: kosten en snelheid, met een waarschuwing over de kwaliteit, geen algemene ranglijst.
Het overzicht van Matt Johnston over negen testwedstrijden Hij vermeldt een gewogen score van 96, gelijk aan Sonnet 5.5 in zijn Stonelabs-tabel, en suite-kosten van $2.63, tegenover ongeveer $14 voor Astra en $12 voor Opus 5.5. Hij wijst ook op een fout bij de pinguïn-taak. Deze cijfers zijn afkomstig uit zijn benchmarkontwerp en kostenberekening; ze moeten worden geverifieerd voordat ze voor aanbestedingen worden gebruikt.
De vergelijking van zes modellen door Duncan Rogoff omvat landingspagina's, 3D-browsergames, Blender-scènes, interactieve uitlegvideo's en presentaties voor investeerders. Volgens de openbare beschrijving worden bij de tests de bouwtijd, het tokengebruik en de uiteindelijke kosten bijgehouden. Totdat het volledige, zichtbare resultaat is beoordeeld, wordt de video in deze gids gebruikt als voorbeeld van een praktische vergelijkingsmethode, en niet als bewijs dat een van beide modellen heeft gewonnen.
Deze vroege beoordelingen zijn het eens over één nuttige vraag: houdt de lage prijs van Sol stand bij een volledig project? Hun antwoorden zijn afhankelijk van de taak. De ene maker zag een opvallende kostenefficiëntie, maar een mindere kwaliteit van het uiteindelijke spel; een andere meldde een hoge score en lage kosten per set; een derde ontwierp een breed opgezet head-to-head-spel. Die diversiteit is informatiefder dan een samengestelde consensuszin.
Voor wie is GPT-6.1 Sol bedoeld?
GPT-6.1 Sol is geschikt voor teams die al zinvol werk verrichten en een evaluatiecyclus hebben. Het is met name aantrekkelijk wanneer dezelfde uitgebreide context wordt hergebruikt via prompt-caching, wanneer een Astra-implementatie te duur zou zijn om op te schalen, of wanneer Luna onvoldoende diepgang biedt voor de taak. Het model is minder aantrekkelijk wanneer een lichte extractie- of classificatietaak al betrouwbaar werkt op een goedkoper niveau.
- Coderen op repository-schaal
- Complexe professionele opdrachten
- Beoordeling met uitgebreide context en caching
- Workflows waarbij tools worden gebruikt, met evaluaties
- Veiligheidsrelevante beslissingen
- Taken waarbij fouten hoge kosten met zich meebrengen
- Werk in de buurt van de drempel van 272K
- Stromen die gevoelig zijn voor latentie
- Eenvoudig taggen
- Korte deterministische transformaties
- Extractie met grote volumes en laag risico
- Taken die Luna al heeft opgelost
Softwareteams zouden Sol moeten overwegen wanneer ze een model nodig hebben om over meerdere bestanden heen te redeneren, tests te genereren, beveiligingsproblemen te beoordelen of tools onder toezicht te gebruiken. Analisten kunnen het gebruiken voor het samenvoegen van meerdere documenten en het opstellen van gestructureerde rapportages. Operationele teams kunnen het inzetten voor workflows waarin gegevens, regels en zakelijke context worden geïntegreerd. In alle gevallen moet de workflow voorzien zijn van expliciete acceptatiecriteria en een handmatige of geautomatiseerde verificatiestap.
Individuele gebruikers en kleine teams geven wellicht de voorkeur aan een interactieve werkruimte voor meerdere modellen voordat ze een API-integratie opzetten. Zo kun je de vergelijking tussen Sol en Astra concreet maken zonder je vast te leggen op een bepaalde applicatiearchitectuur. Als je nog aan het twijfelen bent tussen verschillende aanbieders en modaliteiten, dan is onze gids over een AI-model kiezen op basis van taak, hulpmiddelen en kosten levert een uitgebreidere shortlist op.
Beperkingen en storingsmodi
Een contextvenster van één miljoen tokens is een capaciteit, geen perfect geheugen. Belangrijke instructies kunnen nog steeds worden verwaterd door rommelige documenten, dubbele regels of tegenstrijdige bewijzen. Breng lange invoergegevens in structuur, identificeer gezaghebbende bronnen en vraag het model om het bestand of de passage te vermelden waarop belangrijke conclusies zijn gebaseerd. Het ophalen en samenvatten van informatie kan beter zijn dan bij elke beurt alles door te sturen.
De prijsstap voor een lange context vormt een tweede risico. Voor een verzoek met 273.000 invoertokens wordt het hogere tarief voor het volledige verzoek in rekening gebracht, en niet alleen voor de laatste duizend tokens. Dit kan leiden tot onverwachte kosten bij toepassingen die de context dynamisch samenstellen. Voeg daarom vóór het verzoek token-telling en budgetcontroles toe, en registreer welke documenten ervoor hebben gezorgd dat een aanroep de grens overschreed.
Het gebruik van tools vergroot de mogelijkheden en het aanvalsoppervlak. Beschouw webpagina’s, opgehaalde bestanden en de uitvoer van tools als onbetrouwbare gegevens. Controleer functieargumenten, isoleer de uitvoering van code, beperk bestandspaden en netwerktoegang, en vereis bevestiging voor acties met grote gevolgen. Het feit dat het model ondersteuning biedt voor het gebruik van gehoste shells of computers is geen reden om ruime machtigingen te verlenen.
Tot slot kunnen vroege tests door makers weliswaar leerzaam zijn, maar zijn ze niet doorslaggevend. Verschillende systeemaanwijzingen, hulpmiddelen, ondersteuningsstructuren, tijdslimieten en beoordelingsschema’s kunnen ervoor zorgen dat een ogenschijnlijke winnaar alsnog afvalt. Gebruik openbare tests om je eigen evaluatie op te zetten, niet om deze over te slaan. Een model dat uitblinkt in het bouwen van een visueel spel, kan toch falen in je migratieplan, en het omgekeerde is eveneens mogelijk.
Veelgestelde vragen
Deze antwoorden geven een overzicht van de officiële API-gegevens en de hierboven besproken praktische afwegingen.
Wat is GPT-6.1 Sol?
GPT-6.1 Sol is een OpenAI-redeneringsmodel voor complexe programmeeropdrachten, computergebruik en professioneel werk. Met de OpenAI-classificatie bevindt het zich tussen het voordelige Luna-niveau en het vlaggenschipniveau Astra, en biedt het prestaties die bijna die van Astra evenaren tegen een lagere API-prijs.
Hoeveel kost GPT-6.1 Sol?
De standaardprijzen voor de API bedragen $2 per miljoen invoertokens, $0,10 per miljoen in de cache opgeslagen invoertokens, $2,50 per miljoen tokens die naar de cache worden geschreven, en $10 per miljoen uitvoertokens. Lange prompts, de snelle modus, regionale verwerking, batchverwerking en Flex kunnen het effectieve tarief beïnvloeden.
Wat is het contextvenster van GPT-6.1 Sol?
OpenAI heeft een contextvenster van 1.050.000 tokens, een maximale invoer van 922.000 tokens en maximaal 128.000 uitvoertokens. Een groot venster stelt het model in staat om een aanzienlijke hoeveelheid materiaal te doorzoeken, maar het garandeert geen perfecte recall en maakt niet elke grote aanvraag economisch verantwoord.
Is GPT-6.1 Sol geschikt voor het programmeren?
Het is ontworpen voor complexe codering en ondersteunt gestructureerde uitvoer, het aanroepen van functies, een code-interpreter, een gehoste shell, het toepassen van patches, vaardigheden, MCP en andere tools via de Responses API. Productieteams moeten nog steeds repository-specifieke tests uitvoeren voordat ze een kritieke workflow omzetten.
Moet ik GPT-6.1 Sol of GPT-6 Astra gebruiken?
Kies voor Sol wanneer de kosten een rol spelen en uit je eigen beoordeling blijkt dat het aan de kwaliteitsnorm voldoet. Kies voor Astra voor de meest veeleisende taken, wanneer een iets betere kwaliteit het vijf keer hogere standaardtarief waard is. Test beide op dezelfde representatieve taken voordat je een beslissing neemt.
Wat gebeurt er als een prompt meer dan 272K invoertokens bevat?
Volgens OpenAI wordt het volledige verzoek gefactureerd tegen tweemaal de normale invoer- en cache-tarieven en 1,5 keer het normale uitvoertarief zodra de invoer meer dan 272K tokens bedraagt. Deze sprong in de tarieven kan bij toepassingen met lange documenten van groter belang zijn dan de in de kop genoemde grootte van het contextvenster.
Ondersteunt GPT-6.1 Sol de Chat Completions API?
Ja, ‘Chat Completions’ wordt ondersteund voor verzoeken waarbij geen tool wordt aangeroepen. OpenAI verwijst ontwikkelaars naar de Responses-API voor het aanroepen van tools, dus nieuwe agentgebaseerde of toolgebaseerde toepassingen zouden normaal gesproken met de Responses-API moeten beginnen in plaats van gebruik te maken van de oudere interface.
Kan GPT-6.1 Sol afbeeldingen verwerken?
Ja. Op de officiële modelpagina wordt vermeld dat het model tekst- en afbeeldingsinvoer verwerkt en tekstuitvoer genereert. Audio en video worden niet ondersteund als modelmodaliteiten, hoewel een toepassing gebruik kan maken van andere diensten of hulpmiddelen rondom het model wanneer die mediatypen nodig zijn.
Hoe kan ik GPT-6.1 Sol gebruiken op de GlobalGPT?
Open GlobalGPT, start een nieuw chatgesprek en selecteer GPT-6.1 Sol zodra dit in de modelkiezer voor je account verschijnt. GlobalGPT is een handige werkruimte voor meerdere modellen; API-sleutels, implementatie-instellingen en repository-automatisering blijven afzonderlijke workflows voor ontwikkelaars.
Eindoordeel
GPT-6.1 Sol is de meest interessante GPT-6-optie voor kopers die behoefte hebben aan serieuze redeneer- en programmeercapaciteiten, maar niet bij elke run de kosten van Astra kunnen rechtvaardigen. Het evenaart de context- en outputlimieten van Astra, hanteert dezelfde kennisafsluiting op 30 april 2026 en kost volgens de standaardtarieven een vijfde van de prijs per niet-gecachet invoer- en uitvoertoken. De korting voor gecachete invoer is ook groter dan bij de vorige GPT-6 Sol.
Het model is niet automatisch de beste keuze. Luna blijft aanzienlijk goedkoper voor gerichte taken, en Astra kan bij de moeilijkste taken mogelijk nog steeds het aantal herzieningen verminderen. De juiste vergelijking is de totale kosten per geaccepteerd resultaat, gemeten met dezelfde prompt, tools, gegevens en beoordelingsregels. Bij meer dan 272.000 invoertokens moet je de prijsvermenigvuldigingsfactor meerekenen voordat je een beslissing neemt.
Open GlobalGPT, kies voor GPT-6.1 Sol zodra deze beschikbaar is, en vergelijk deze met Astra of Luna aan de hand van één praktische opdracht en één acceptatiechecklist.
Open GlobalGPTBegin voor het implementeren van de API met de officiële modelpagina en een klein verzoek aan de Responses API. Gebruik voor een interactieve vergelijking de bovenstaande route voor meerdere modellen. Bewaar in beide gevallen de uitvoer, het gebruik, de instellingen en eventuele fouten. De belofte van GPT-6.1 Sol is niet alleen goedkopere tokens; het is een betere kans om vaardig redeneren zo vaak uit te voeren dat het onderdeel wordt van de workflow.









