 Chloe Murphy
수소
관찰 시간55.21초입력 토큰4,273출력 토큰8,243
출력 평가
정답: A+C+D, 비용 16, 가치 31. 또한 가치가 30 이상인 다른 실행 가능한 포트폴리오로 A+C+E만 식별됨.
Google이 공개한 벤치마크와 API 가격을 비교하고, 세 모델을 동일한 작업에서 테스트하여 검증된 결과, 프롬프트, 시간, 토큰 사용량을 제공합니다.

Hydrogen은 공식 토큰 가격이 가장 낮고, Carbon은 가장 깊은 추론을 목표로 하며, Argon은 최첨단 추론과 효율성의 균형을 맞춥니다. 세 모델 모두 완료된 네 가지 작업을 통과했습니다. 가장 어려운 코드 테스트는 정확성의 승자보다는 형식과 설명의 차이를 드러냈습니다.
Google에는 이제 어떤 것을 선택해야 할지 거의 알려주지 않는 이름을 가진 세 가지 Gemini 4 모델이 있습니다. Hydrogen으로 시작해야 할까요, 까다로운 작업에는 Argon을 사용해야 할까요, 아니면 Carbon의 더 깊은 추론에 비용을 지불해야 할까요?
유용한 비교는 작업별 능력입니다. 각 모델이 무엇을 해결할 수 있는지, 얼마나 많은 추론을 사용하는지, 완성된 답변의 비용은 얼마인지. 공식 벤치마크 점수는 출발점을 제공합니다. 이러한 차이가 중요한 곳을 확인하려면 동일한 프롬프트를 사용하는 어려운 작업이 필요합니다.
GlobalGPT를 통해 동일한 작업에서 세 모델을 모두 테스트했습니다. 자신의 워크로드를 비교하려면 GlobalGPT에서 시작하여 계정의 현재 모델 옵션과 사용 약관을 확인하세요.
~을 위해 제작됨빠른 일상 코딩 및 에이전트 실행.
독립적으로 실행하거나 더 깊은 추론 모델과 함께 실행을 처리할 수 있습니다.
Google 보고 지수: 높은 사고에서 51, xhigh에서 54.
출처: Google의 Hydrogen 발표.
Google의 최고 성능의 Gemini 4 추론 모델.
어려운 디버깅, 과학 연구 및 확장 검증을 위한 것입니다.
토큰당 요금이 동일하더라도 Argon보다 더 많은 추론 토큰을 사용할 수 있습니다.
출처: Google의 Carbon 출시 발표.
효율적인 프런티어 추론 까다로운 코딩, 수학, 과학을 위한 것입니다.
Google은 Carbon보다 빠르고 토큰 집약도가 낮다고 포지셔닝합니다.
그 역할은 추론 깊이와 작업 비용 간의 균형입니다.
출처: Google의 모델 및 가격 문서.
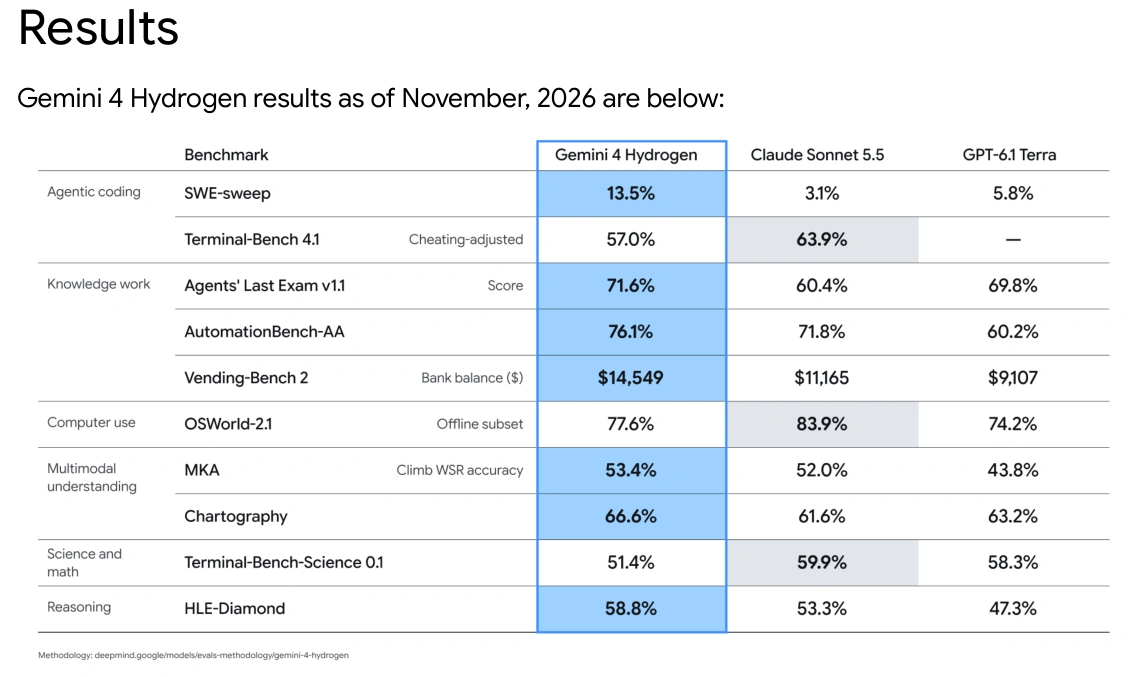
공개 벤치마크 · 높을수록 좋음
Google이 보고한 점수를 빠르게 확인하세요.
이는 Google이 보고한 게시된 결과로, 2026년 11월 15일에 확인되었습니다. 자체 테스트 점수가 아닙니다. Carbon의 수치는 해당 발표; Hydrogen 및 Argon 수치는 위의 Hydrogen 발표에서 가져온 것입니다. 이는 독립적으로 검증된 동일한 설정으로 새로 3개 모델 리더보드를 실행한 것이 아니라 발표 간 소스 비교입니다.
Terminal-Bench 4.0과 4.1 수치를 동일한 순위 열에 넣지 마십시오. 평가 버전이 변경되면 작업 난이도가 달라질 수 있으므로 백분율은 공정한 직접 비교를 뒷받침하지 못합니다.
표준 Gemini API 가격(백만 토큰당 USD), 2026년 11월 15일 확인:
표준 GEMINI API · 백만 토큰당 USD
입력
출력 · 사고 포함
입력
출력 · 사고 포함
입력
출력 · 사고 포함
*Hydrogen의 현재 공개 요금에는 12월 인상이 명시되어 있지 않습니다. 이는 향후 변경에 대한 보장이 아닙니다. 출력 청구에는 사고 토큰이 포함됩니다. 검색 및 기타 도구 요금은 별도입니다. 이는 GlobalGPT 구독 가격이나 크레딧 변환이 아닌 Google의 API 요금입니다.
고정 토큰 수에서 Hydrogen 비용은25% 저렴Carbon 또는 Argon의 도입 요금보다. 발표된 12월 요금과 비교하면 그 차이는62.5%. 실제 작업 비용은 추론 토큰, 재시도, 도구 사용에 따라 달라집니다.
예를 들어, 입력 토큰 100,000개와 청구 가능한 출력 토큰 20,000개는 Hydrogen에서 $0.30, 11월 30일까지 Carbon 또는 Argon에서 $0.40, 12월 1일부터 Carbon 또는 Argon에서 $0.80입니다. 이 계산에는 도구, 캐싱, 일괄 할인, 재시도가 포함되지 않으며 각 모델에 필요한 토큰 수를 예측하지 않습니다.
Hydrogen에는 속도 제한이 있는 무료 API 등급이 있습니다. Carbon과 Argon에는 없습니다. 소비자 구독은 자체 액세스 규칙이 있는 별도의 구매입니다.
출처: Google API 가격.
네 가지 동일한 작업에서 Hydrogen, Carbon, Argon을 테스트했습니다. 처음 세 가지는 핵심 정확도를 확인했고, 마지막 작업은 완전한 정확 검색 프로그램이 필요했으며 이를 실행하여 독립적으로 계산된 답과 대조했습니다.
각 작업에 동일한 입력과 시스템 지침을 사용합니다.
새 요청, 프로젝트 컨텍스트 비활성화, 모델 도구 사용 없음.
정확성, 출력 형식, 시간 및 토큰 사용량을 개별적으로 평가합니다.
테스트 1 · 정확도 기준선
최적의 포트폴리오를 선택하고 모든 적격 대안을 식별하세요.
Solve exactly, showing verifiable arithmetic and a proof of optimality. Six indivisible projects have (cost, value): A(7,13), B(6,12), C(5,10), D(4,8), E(3,7), F(2,4). Budget=16. C requires A. D and E cannot both be selected. B requires at least one of D or F. Select projects maximizing total value; break ties by lower cost then alphabetically sorted project-list. Give chosen list, cost, value and enumerate all feasible candidates with value at least 30. No external tools or web.
정답: A+C+D, 비용 16, 가치 31. 또한 가치가 30 이상인 다른 실행 가능한 포트폴리오로 A+C+E만 식별됨.
정답: A+C+D, 비용 16, 가치 31. 또한 가치가 30 이상인 다른 실행 가능한 포트폴리오로 A+C+E만 식별됨.
정답: A+C+D, 비용 16, 가치 31. 또한 가치가 최소 30인 다른 실행 가능한 포트폴리오로 A+C+E만을 식별했습니다.
작업 판정: 세 가지 모두 핵심 답변 확인을 통과했습니다.
테스트 2 · 정확도 기준선
기기 수준 효과와 표준화된 상승도에서 총 전환을 분리합니다.
Analyze a randomized experiment using only these counts. Variant A: mobile 90 purchases/900 visitors; desktop 80/100. Variant B: mobile 20/100; desktop 630/900. Show overall and device-specific conversion rates, absolute lifts B-A, and a standardized B-A lift using 50% mobile/50% desktop. Explain the reversal, distinguish observational aggregate from randomized causal interpretation, and state exactly what randomization details are missing. May we claim B wins overall and in both devices? Do not invent significance or revenue. No external tools or web.
정답: B는 전체적으로 48%포인트 앞서지만 데스크톱에서는 10포인트 뒤집니다. 일반적인 50/50 기기 혼합은 제로 리프트. 두 세그먼트 모두에서의 승리를 거부했습니다.
정답: B는 전체적으로 48%포인트 앞서지만 데스크톱에서는 10포인트 뒤집니다. 일반적인 50/50 기기 혼합은 제로 리프트. 두 세그먼트 모두에서 승리를 거부했습니다.
정답: B가 전체적으로 48%포인트 앞서지만 데스크톱에서는 10포인트 뒤집니다. 일반적인 50/50 기기 혼합은 제로 리프트. 두 세그먼트 모두에서 승리를 거부했습니다.
작업 판정: 세 가지 모두 핵심 답변 확인을 통과했습니다.
테스트 3 · 정확도 기준선
수정, 무효, 환불을 올바르게 적용한 다음 엄격한 JSON을 반환합니다.
Return valid JSON only, no Markdown. Reconcile event ledger by event_id: retain highest revision, then exclude void=true. Amounts are integer cents; refund amounts subtract from captured revenue even when received before capture; group by order_id; ignore pending. Ledger: [e1,r1,o1,capture,1000,false];[e1,r2,o1,capture,1200,false];[e2,r1,o1,refund,200,false];[e3,r1,o2,refund,300,false];[e4,r1,o2,capture,2000,false];[e5,r1,o3,capture,500,false];[e5,r2,o3,capture,500,true];[e6,r1,o3,pending,900,false];[e7,r1,o4,capture,700,false];[e8,r1,o4,refund,800,false];[e8,r2,o4,refund,600,false];[e9,r1,o2,refund,100,false]. Output keys orders (array sorted by order_id with order_id,net_cents,retained_event_ids sorted lexically), total_net_cents, excluded_event_ids (superseded event versions written as event_id:rN plus void and pending versions). Include o3 with zero net. No external tools or web.
정답: 주문 합계 1,000, 1,600, 0, 100센트; 총 2,700센트. 원시 출력은 정리 없이 JSON으로 구문 분석되었습니다.
정답: 주문 합계 1,000, 1,600, 0, 100센트; 총 2,700센트. 원시 출력은 정리 없이 JSON으로 구문 분석되었습니다.
정확함: 주문 합계 1,000, 1,600, 0, 100센트; 총 2,700센트. 원시 출력은 정리 없이 JSON으로 파싱되었습니다.
작업 판정: 세 가지 모두 핵심 답변 검사를 통과했습니다.
테스트 4 · 하드 코딩 작업
제약 검색을 위한 실행 가능한 Python을 생성하세요. 모든 프로그램을 독립적인 완전 탐색 참조와 비교 실행했습니다.
Find the EXACT top 5 feasible portfolios, ranked by highest total value, then lowest total cost, then lexicographic sorted ID string. Items (ID,cost,value): [('A', 9, 19), ('B', 7, 16), ('C', 11, 25), ('D', 6, 13), ('E', 8, 18), ('F', 5, 12), ('G', 10, 23), ('H', 4, 9), ('I', 12, 29), ('J', 3, 8), ('K', 7, 17), ('L', 6, 15), ('M', 9, 22), ('N', 5, 11), ('O', 8, 20), ('P', 4, 10), ('Q', 11, 27), ('R', 2, 5)]. Budget 55; choose between 6 and 9 items inclusive. Dependencies: C requires A; G requires B and D; I requires E; M requires F and H; Q requires J and K. Mutually exclusive pairs: (A,B),(E,F),(L,N),(O,Q). At least 2 of C,G,I,M,Q. Exactly 2 of D,H,L,P. At least one of B,F,J,N,R. If O is selected then P is selected and K is absent. If R is selected then exactly one of A,E is selected. Return ONLY executable Python 3 code, at most 120 lines. Implement an exact exhaustive search, print JSON with keys feasible_count and top5 (each row [sorted_ID_string,cost,value]). Do NOT manually calculate or hardcode the answer. State complexity in a code comment. Use only itertools and json; no filesystem, network, subprocess or other imports. The code will be executed and checked against an independent exhaustive reference.통과: 실행 가능한 코드가 반환했습니다 121개의 실현 가능한 포트폴리오 그리고 올바른 상위 5개. 올바른 조합 수와 더 자세한 복잡성 설명이 포함되었습니다.
통과: 실행 가능한 코드가 반환됨 121개의 실행 가능한 포트폴리오 그리고 올바른 상위 5개. 조합 수는 정확했지만 복잡성 설명에서 마지막 정렬 항이 누락되었습니다.
Markdown 펜스를 제거한 후 통과: 코드가 반환됨 121개의 실행 가능한 포트폴리오 그리고 올바른 상위 5개. 주석은 142,766개가 아닌 115,379개의 조합을 주장했고 복잡성 설명에서 정렬을 생략했습니다.
작업 평결: 기능적 정확성 동률. Hydrogen은 이번 실행에서 실행 가능한 형식과 설명의 가장 깔끔한 조합을 제공했습니다.
시간은 네트워크 및 대기 시간을 포함한 단일 실행 엔드투엔드 관찰값이며, 요청은 동시에 실행되었습니다. 토큰은 입력/출력 사용량을 보고하며 추론 또는 요청 래퍼 토큰을 포함할 수 있습니다. 이는 달러 요금이 아닙니다. 별도의 직접 답변 시도는 속도 제한 또는 로컬 타임아웃에 도달하여 품질 점수에서 제외되었습니다. 위의 코딩 작업은 새로운 일치 프롬프트를 사용했습니다.
Hydrogen의 낮은 공식 토큰 요금이 워크로드에 맞다면 Hydrogen부터 시작하세요. 효율적인 프런티어 추론을 중시한다면 비교에 Argon을 유지하세요. 포맷 정리 후 정확한 검색 코딩 작업을 올바르게 해결했습니다. 더 깊은 탐색이 필요한 작업에서는 Carbon을 평가하세요. 이 테스트 세트는 기본 선택을 정당화할 만한 정확성 이점을 보여주지 못했습니다. 표시된 플랫폼 요금은 Google API 요금과 별도로 확인하세요.
Hydrogen은 표준 API 요금이 가장 낮습니다: 입력 토큰 100만 개당 $1.50, 출력 토큰 100만 개당 $7.50이며, 2026년 11월 15일에 확인되었습니다.
표준 토큰 요금은 동일합니다. Carbon은 더 많은 추론 토큰이나 검증 단계를 사용하면 작업당 비용이 더 높을 수 있습니다.
아니요. 벤치마크 버전과 사고 설정을 확인한 다음, 독립적으로 검증 가능한 답변이 있는 대표적인 작업에서 모델을 테스트하세요.
생성된 각 Python 솔버를 실행하고 실행 가능한 개수와 상위 5개 포트폴리오를 독립적인 전체 탐색 참조와 비교했습니다.
Argon 액세스 가이드는 플랫폼 액세스, Google 구독, AI Studio, API 결제 간의 차이점을 설명합니다.
액세스 세부 정보는 Gemini 4 Argon 사용 방법. 한 계정에서 모델을 비교하려면 GlobalGPT에서 시작하여 선택한 모델과 표시된 사용 약관을 확인하세요.