
Claude Fable 5.2 vs Opus 5.5: 코딩, 비용, 선택 가이드
동일한 프롬프트의 5가지 작업으로 Claude Fable 5.2와 Opus 5.5를 연구, AI 인터페이스 디자인, 글쓰기, 데이터, 제품 기획 측면에서 비교합니다. 원본 스크린샷과 기록된 시간 및 토큰 사용량이 포함됩니다.
 Chloe Murphy

Opus 5.5는 일상적인 작업에 합리적인 출발점입니다. 특정 작업에 여전히 개선이 필요할 때 Fable 5.2를 테스트하세요. 완료된 네 쌍의 텍스트 작업에서 두 모델 모두 핵심 연구 계산과 데이터 지표를 정확히 처리했습니다. Fable의 제품 계획은 한 가지 불확실성을 더 신중하게 다루었고, 두 작성 결과물 모두 주요 제약 조건을 충족했습니다.
디자인 비교는 새로운 32,768토큰 매칭 실행을 사용합니다. 스크린샷, 상호작용 확인 및 제한 사항은 아래 디자인 작업에 나와 있습니다.
Fable 5.2는 더 새롭고 토큰당 비용이 더 높습니다. 하지만 더 나은 결과를 제공할까요, 아니면 단순히 더 큰 청구서를 안겨줄까요? 우리는 각 모델에 동일한 작업 브리핑을 사용하여 연구, AI 인터페이스 디자인, 글쓰기, 데이터 분석, 제품 결정을 비교했습니다.
별도의 API 설정을 관리하지 않고 모델을 비교하고 싶다면 GlobalGPT가 다중 모델 작업 공간을 제공합니다. 여기의 API 테스트는 GlobalGPT 내에서 Fable 5.2의 사용 가능성을 입증하지 않습니다.
실용적 비교
| 결정 | Fable 5.2 | Opus 5.5 |
|---|---|---|
| 백만 토큰당 표준 입력 / 출력 | $8 / $40 | $4 / $20 |
| 연구 테스트 | 계산은 정확하지만 인과적 표현은 수정 필요 | 계산은 정확하지만 연구 설계 세부 사항은 근거 부족 |
| 콘텐츠 테스트 | 180단어 설명, 더 짧은 보이스오버 | 180단어 설명, 더 풍부한 예시 |
| 데이터 테스트 | 요청된 모든 지표가 정확함 | 요청된 모든 지표가 정확함 |
| 제품 테스트 | 확인된 피해와 가능한 피해를 주의 깊게 구분 | 계획은 유용하지만 작업 손실 주장은 근거 부족 |
| 원래 디자인 시도 | 산출물 없음: HTTP 오류 | 코드 블록 정리 후 완전한 HTML |
두 모델을 테스트한 방법
각 작업은 동일한 소스 자료, 새로운 대화, 두 모델에 동일한 출력 한도를 사용했습니다. 텍스트 작업은 16,000토큰 한도를 사용했고, 최종 디자인 실행은 32,768을 사용했습니다. 프롬프트, 설정, 시간, 사용량은 아래 해당 작업과 함께 표시됩니다.
브리프의 모든 연구, 제품, 주문 데이터 및 피드백은 가상의 테스트 픽스처였습니다. 계산은 준비된 정답 키와 대조하여 확인했습니다. 추론 노력은 플랫폼 기본값으로 유지되었으므로 이는 동등한 노력의 벤치마크가 아닙니다. 타사 게이트웨이가 반환한 모델 라벨은 업스트림 라우팅을 독립적으로 입증하지 못합니다.
연구자: 증거를 과장하지 않고 종합
동일한 프롬프트 · 연구자 테스트
You are a researcher. Use only these FICTIONAL study summaries about an AI writing assistant. A: randomized 120 adults, 60 per arm, intervention mean score baseline70 followup78, control baseline69 followup74, four weeks; no standard deviations, uncertainty intervals, or attrition information reported. B: observational 300 adults, usage correlated with writing scores r=.32, no confounder adjustment. C: interviews with12 users reporting perceived improvement. In under650 words synthesize evidence with A/B/C citations, calculate difference in changes, explain what cannot be inferred, and propose a feasible preregistered followup study with primary endpoint and analysis. Do not invent citations or statistical significance.
연구자 과제는 보고가 불완전한 무작위 시험을 포함한 세 가지 가상 연구의 종합을 요구했습니다. 핵심 계산은 (78 − 70) − (74 − 69) = 3점. 두 모델 모두 정답을 맞혔고 통계적 유의성을 만들어내지 않았습니다.
Fable 5.2
맹검, 비보조 쓰기 평가, 치료의향 분석, 결측 데이터 민감도 검사를 제안했다. 또한 명시적으로 가상적인 표본 크기 예시를 제공했다.
“3점 차이만이 어시스턴트에 기인한다”
알려지지 않은 탈락과 보고 누락을 고려할 때 그 표현은 지나치게 자신만만했다. 이후 단락에서 추정치를 한정했음에도 불구하고. 또한 인터뷰 참가자들이 아마도 자기 선택되었을 것이라고 추측했다.
Opus 5.5
무작위, 관찰, 인터뷰 증거를 명확히 분리했다. 기준선 조정 시험을 제안하고 표본 크기 계산을 파일럿 변동성에 의존하도록 유지했다.
“설명된 대로 횡단면적 성격”
제공된 관찰 요약은 횡단면 설계를 명시하지 않았다. 그 세부 사항은 알려지지 않은 채로 남아 있어야 했다.
이 브리프를 조정한다면 증거를 고정하고 각 모델에 보고된 사실과 추론을 분리하도록 요청하세요. 우리의 연구 및 코딩을 위한 Claude 프롬프트 은(는) 작업별 제약 조건의 더 많은 예를 제공합니다.
Designer: AI 멀티모델 작업 공간
동일한 프롬프트 · Designer 테스트
You are a product designer and frontend builder. Return only one complete self-contained HTML file with inline CSS and JavaScript, no external assets/CDNs. Build a polished AI multi-model workspace called Parallel. Give it a distinctive cohesive visual identity with excellent typography, whitespace, hierarchy and responsive layout; choose your own palette. Include sidebar, model A/B selectors, prompt textarea, compare button, two side-by-side result cards, loading state, clear button, per-result copy button, empty-input validation, keyboard-accessible controls and mobile stacking. Models A/B are FICTIONAL; all outputs must be locally simulated and explicitly labeled demo. No real API calls or fake live performance metrics. Compare must work repeatedly and preserve the submitted prompt in both outputs. Copy must report success only after actual success, otherwise provide an error. Aim for a complete compact artifact, not an explanation.
디자이너 브리프는 두 모델 모두에게 패럴렐: 사이드바, 모델 선택기, 프롬프트 입력, 시뮬레이션된 결과 카드, 검증, 복사 컨트롤, 모바일 레이아웃을 갖춘 독립형 AI 비교 작업 공간. 색상 팔레트와 시각적 정체성은 열어 두었습니다.
최종 일치 실행은 동일한 프롬프트, 스트리밍 전송, 공유 32,768 토큰 한도를 사용했습니다. 두 응답 모두 정상적으로 중지되었습니다. 소스 아티팩트는 편집되지 않은 상태로 유지됩니다. HTML을 저장하면 존재하는 경우 둘러싸는 Markdown 펜스만 제거됩니다.
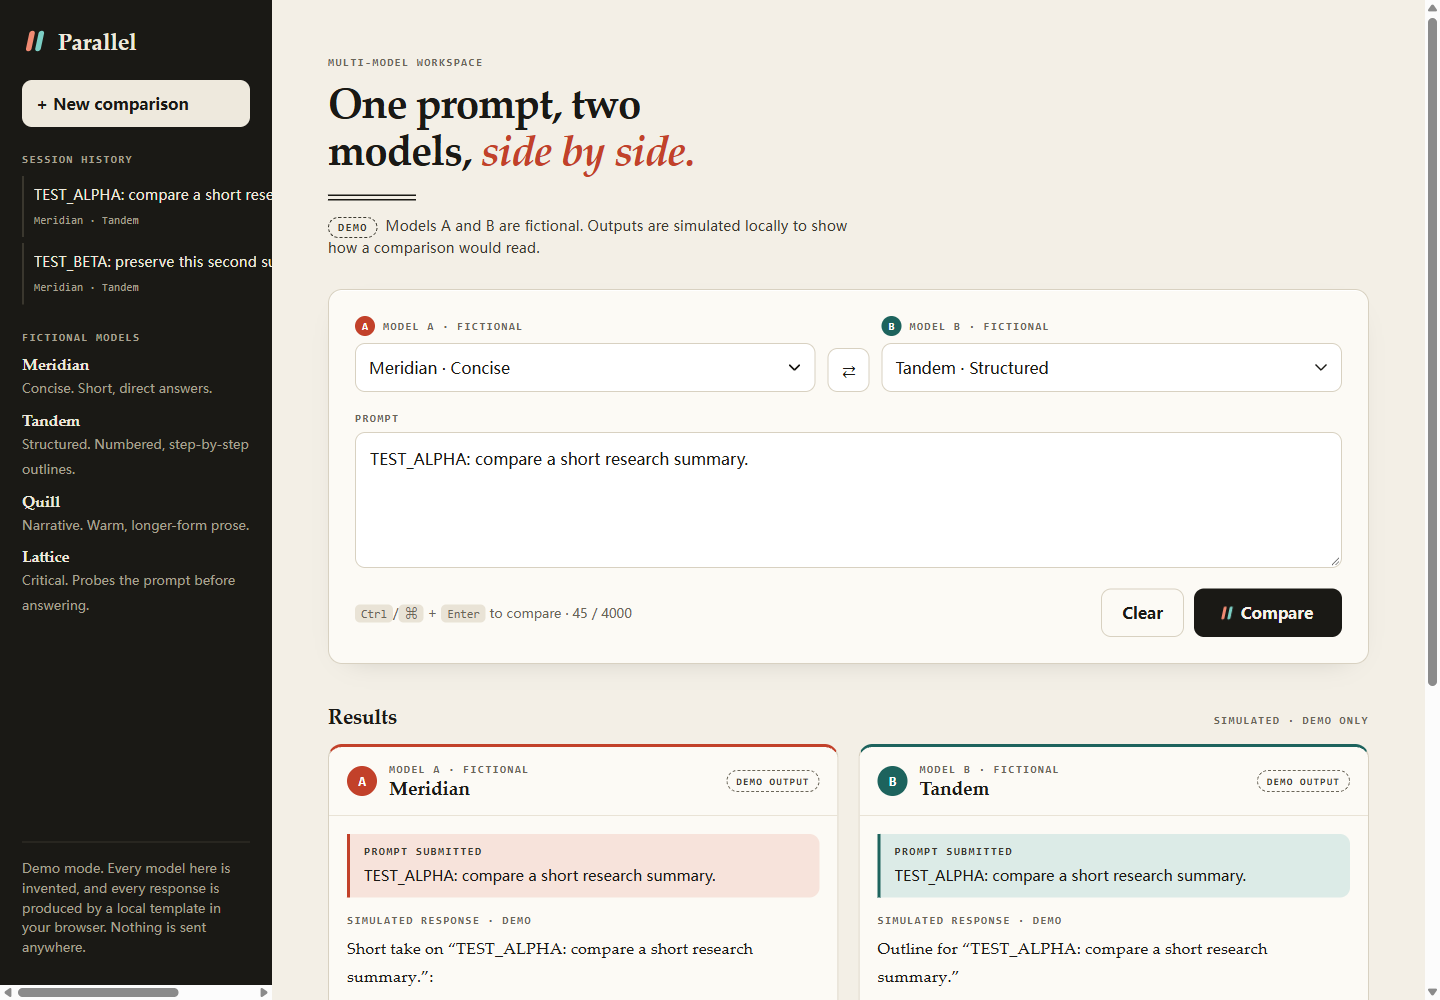
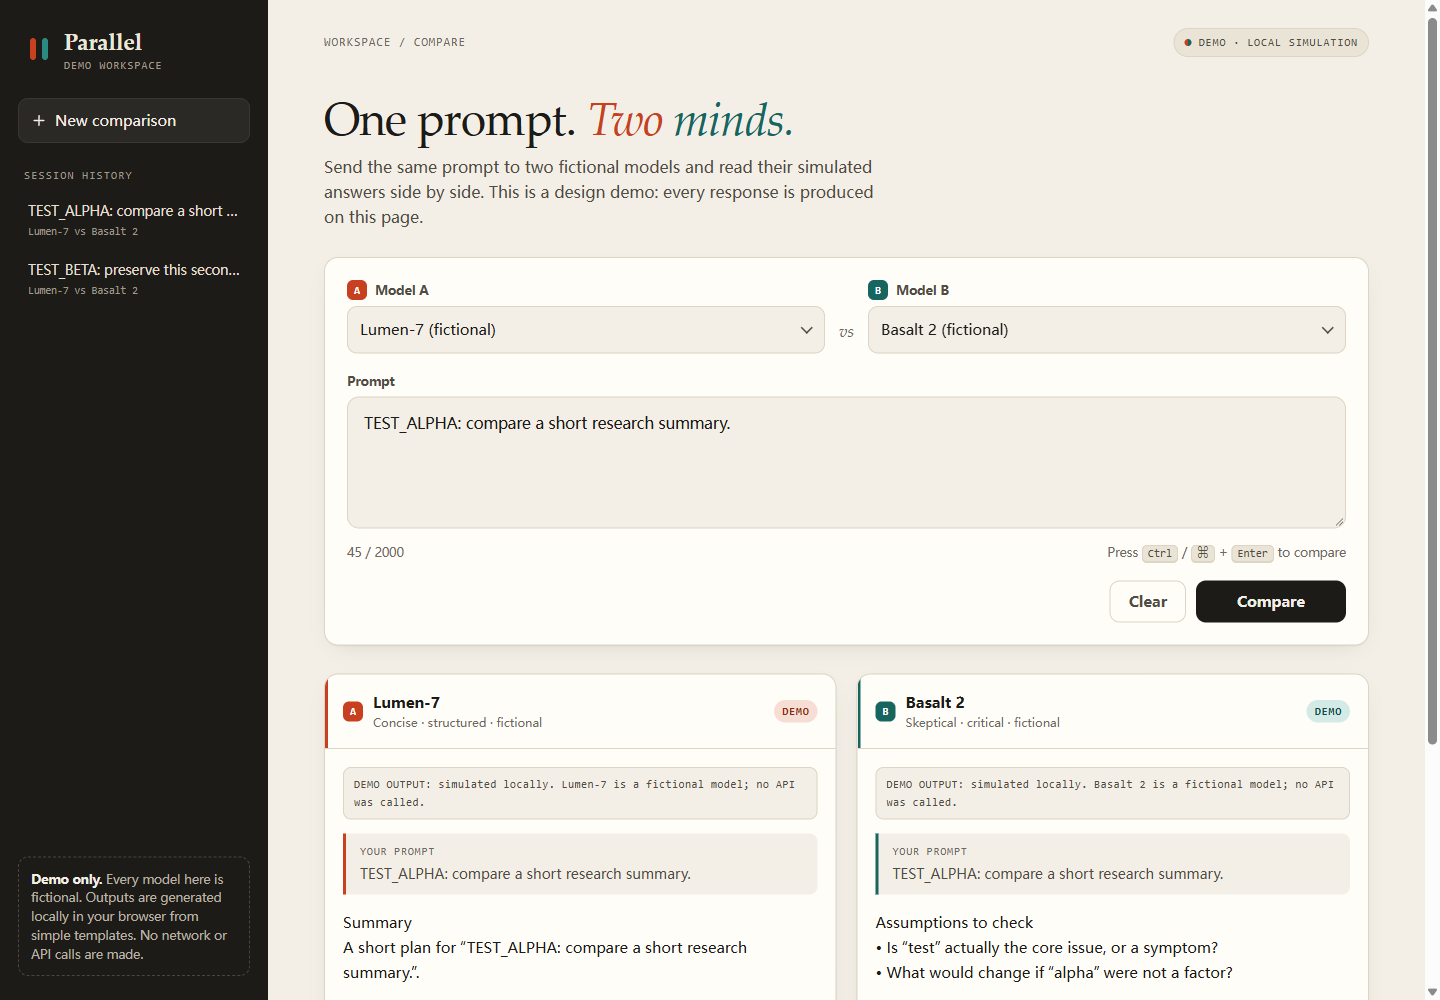
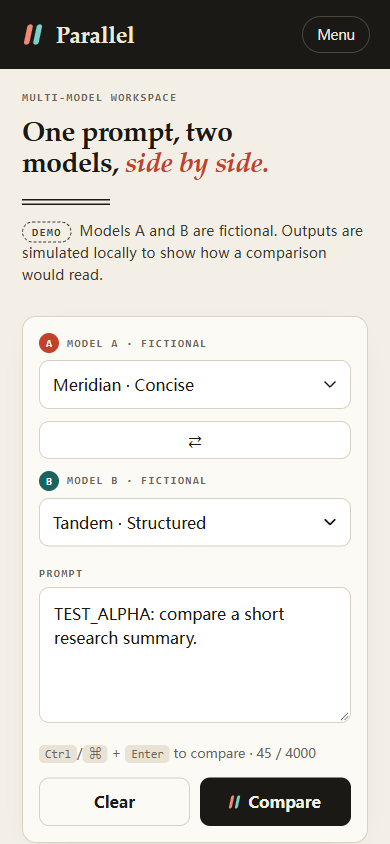
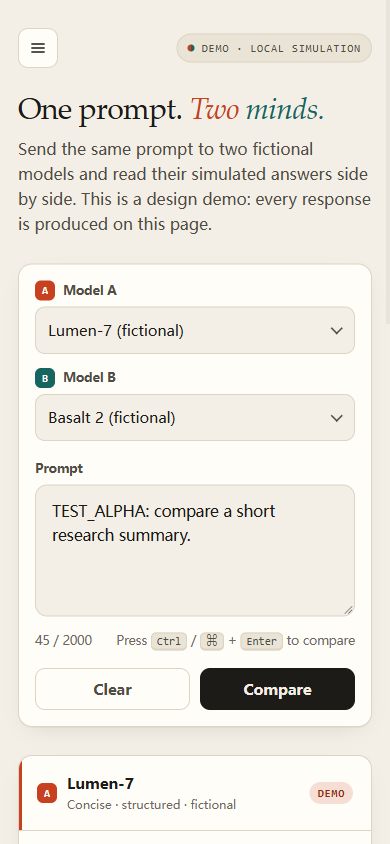
렌더링된 페이지가 실제로 어떻게 보였는지
Fable 5.2 샘플
더 무거운 세리프 헤드라인, 기울임꼴 빨간색 강조, 고대비 사이드바가 이 페이지에 더 강한 편집적 정체성을 부여합니다. 모델 교체 컨트롤은 유용한 추가 기능이지만 모바일에서 전체 행을 차지하여 프롬프트와 결과를 더 아래로 밀어냅니다.
Opus 5.5 샘플
더 가벼운 헤드라인과 더 단순한 모델 선택 영역은 더 절제된 느낌을 줍니다. 동일한 모바일 뷰포트에서 비교 버튼은 상단에서 약 710픽셀 지점에서 끝나며, Fable 샘플의 826픽셀과 비교하여 첫 번째 결과 카드가 더 빨리 나타날 여지를 남깁니다.
둘 다 따뜻한 종이 톤, 어두운 사이드바, 세리프 제목을 선택했습니다. 여기서 차이점은 완전히 다른 디자인 언어가 아니라 계층 구조와 밀도에 있습니다.이 특정 작업 공간에서는 Opus 샘플의 컴팩트한 레이아웃을 선호합니다.더 눈에 띄는 편집 헤드라인이 우선이라면 Fable 샘플이 그 매력을 가지고 있습니다. 이는 반환된 아티팩트 간의 주관적 선호도이지 기본 모델의 일반적인 미적 순위가 아닙니다.
브라우저 검사: 외관과 동작을 별도로
| 확인 | Fable 샘플 | Opus 샘플 |
|---|---|---|
| 빈 입력 검증 | 통과 | 통과 |
| 반복 비교는 제출된 프롬프트를 유지합니다 | 통과 | 통과 |
| 가시적인 로딩 피드백 | 통과 | 통과 |
| 입력 지우기 | 통과 | 통과 |
| 390픽셀 너비에서 페이지 오버플로 | 측정된 것 없음 | 측정된 것 없음 |
| 복사 실패는 오류를 정직하게 보고합니다 | 통과 | 통과 |
| 클립보드 복사 성공 | 검증되지 않음 | 검증되지 않음 |
Chrome에서 편집되지 않은 출력을 열고 DOM 컨트롤을 사용하여 검사를 실행했습니다. 데스크톱 스크린샷은 1440 × 1000을 사용하고 모바일 스크린샷은 390 × 844를 사용합니다. 네 개 모두 비교 후, 복사 검사 전에 제출된 동일한 프롬프트를 보여줍니다. 이 단계에서 런타임 예외가 캡처되지 않았습니다. 자동화된 세션에서 클립보드 쓰기가 성공하지 못했고 완전한 키보드 전용 탐색은 테스트되지 않았습니다.
최종 디자인 쌍의 사용량은 표준 요율의 대리 값을 제공합니다: Fable의 경우 $0.8826, Opus의 경우 $0.2918. 이는 공급자 요율과 게이트웨이가 보고한 토큰을 사용하며, 이전 시도를 제외하고 게이트웨이의 실제 청구서가 아닙니다.
이전 시도와 증거 한계
콘텐츠 제작자: 두 가지 형식의 정확한 카피
동일한 프롬프트 · 콘텐츠 제작자 테스트
You are a content creator. Based ONLY on these FICTIONAL product facts, write a180-word plain-English explainer and a45-second video script with timestamps, then a five-item fact-check checklist. Facts: Lumen is a fictional AI workspace; it lets users compare two AI text drafts side by side, save prompts locally in their browser, and manually copy a chosen result. It does not publish content automatically, browse the web, or verify facts. No prices, launch dates, speed metrics, supported model names, or privacy guarantees are provided. Audience: freelancers who struggle to choose a usable first draft. Explain a practical example, avoid hype and invented claims, and distinguish local prompt saving from an unproven no-training guarantee.
크리에이터 브리프는 세 가지 기능만 갖춘 가상의 작업 공간을 제공했습니다: 초안 나란히 비교, 로컬 프롬프트 저장, 수동 복사. 180단어 설명문, 45초 스크립트, 5개 항목의 사실 확인 체크리스트를 요구했습니다.
두 설명문 모두 180단어 요건을 충족했습니다단어 수 계산 규칙에 따라, 단어 내부의 아포스트로피와 하이픈은 단어 내에 유지됩니다. 둘 다 기능 제한을 유지했고 로컬 저장소를 학습 없음 보장으로 취급하는 것을 올바르게 피했습니다.
Fable 5.2
프리랜서가 초안을 선택하는 어려움으로 시작하여 세 가지 기능을 짧은 문장으로 설명했습니다. 비디오 음성 해설은 101단어로, 45초 안에 전달하면 분당 약 135단어입니다.
Opus 5.5
더 상세한 카피라이터 예시를 사용하여 더 강력한 도입부와 더 명확한 기능 설명을 대조했다. 음성 해설에는 109단어가 포함되었으며, 같은 시간 동안 분당 약 145단어였다.
이러한 속도 추정치는 시간을 잰 녹음이 아니라 작성된 음성 해설 원고에서 나온 것이다. Fable은 일시 정지를 위한 여유를 더 남기고, Opus는 예시를 설명하는 데 더 많은 시간을 사용한다.
더 긴 기사의 경우, Claude를 사용한 장문 글쓰기 초안 작성과 검증 및 편집을 분리하는 방법을 다룹니다.
데이터 분석가: 환불, 누락된 기여 분석, ROAS
동일한 프롬프트 · 데이터 분석가 테스트
You are a data analyst. Use only this synthetic data. Orders CSV(order_id,updated,status,channel,amount): o1,1,paid,Search,100; o2,1,paid,Social,80; o2,2,refunded,Social,80; o3,1,paid,Search,120; o4,1,pending,Email,60; o5,1,paid,,50; o6,1,paid,Partner,90; o7,1,paid,Email,70; o8,1,paid,Social,60; o9,1,paid,Partner,110. Channel spend/clicks: Search200/100; Social100/80; Email50/40; Partner0/20. Deduplicate by order_id keeping greatest updated. Paid orders count and revenue use latest paid only; refunded/pending contribute zero. Blank channel must remain Unknown and cannot inherit spend/clicks. Calculate overall paid count, revenue, each channel paid count/revenue/conversion rate per click/ROAS, and measurable ROAS ranking; zero or missing denominator is N/A. Show arithmetic and propose a cautious next-budget decision without inferring causality. Return table and explanation under600 words.
분석가 작업은 깔끔한 표가 숨길 수 있는 오류를 잡아내도록 설계되었습니다: 중복 주문 ID, 이후 환불, 보류 중인 주문, 알 수 없는 채널, 지출이 없는 파트너 채널.
두 모델 모두 준비된 정답 키와 일치했습니다: 최신 주문 상태를 유지한 후 7개의 유료 주문과 600의 수익. 환불 및 보류 중인 레코드를 제외하고, 누락된 속성을 '알 수 없음'으로 유지하고, 정의되지 않은 비율을 N/A로 표시했습니다.
| 채널 | 유료 주문 | 수익 | 전환 / 클릭 | ROAS |
|---|---|---|---|---|
| 검색 | 2 | 220 | 2.00% | 1.10 |
| 소셜 | 1 | 60 | 1.25% | 0.60 |
| 이메일 | 1 | 70 | 2.50% | 1.40 |
| 파트너 | 2 | 200 | 10.00% | N/A: 지출 없음 |
| 알 수 없음 | 1 | 50 | N/A | N/A |
Fable은 채널 표에서 수익 산술을 보여주고 큰 변경을 하기 전에 환불, 보류 중인 주문, 누락된 태그, 기록되지 않은 파트너 비용을 확인하라고 제안했다. Opus는 레코드별 중복 제거 표를 추가하고 미할당 수익이 전체의 8.3%라고 계산했다.
둘 다 관찰된 ROAS를 인과적 증거로 취급하기보다는 예산이 제한된 테스트를 권장했다. Opus가 소셜 판매가 하나 더 늘면 ROAS가 대략 두 배가 될 것이라고 한 부연은 비슷한 주문 금액을 가정한 것이며 입력에 있던 새로운 사실은 아니었다.
제품 관리자: 기능 투표보다 해악 우선
동일 프롬프트 · 제품 관리자 테스트
You are a product manager for a FICTIONAL AI subscription workspace. Feedback: 2 users report duplicate charges after retrying checkout; billing logs confirm one duplicate captured charge. 30 users request dark mode. 8 report one model unavailable and no warning before using a prompt; outage reproduced. 1 requests account/data deletion; request pending for20 days, governing deadline unknown. 12 request reusable saved prompts. 4 want team seats; no revenue commitment. Two engineers available for one week; effort estimates unknown. Produce a one-week priority plan with rationale, explicit unknowns, scope boundaries, owner roles, acceptance criteria, instrumentation and rollback/containment steps. Do not fabricate legal deadlines, revenue, effort or certainty. Distinguish immediate containment from permanent fixes; do not rank purely by vote count. Under700 words.
제품 브리핑은 확인된 중복 청구와 사용자에게 기한이 지난 삭제 요청, 재현된 모델 중단, 더 인기 있는 기능 요청을 함께 제시했습니다. 함정은 입증된 피해보다 다크 모드 30표를 우선시하는 것이었습니다.
두 모델 모두 청구, 삭제 후속 조치, 중단 억제를 기능 구축보다 우선시했습니다. 어느 쪽도 삭제에 대한 법적 기한을 만들어내지 않았습니다. 둘 다 소유자 역할을 할당하고, 즉각적인 억제와 영구적인 수정을 분리했으며, 승인 검사와 모니터링을 제안했습니다.
Fable 5.2
환불 조정, 반복 청구 방지 수정, 수동 중단 억제를 지정했습니다. 가능한 할당량 손실을 확인해야 할 사항으로 명시적으로 다루었고 삭제를 되돌릴 수 없는 것으로 표시했습니다.
Opus 5.5
제출 전 경고, 프롬프트 보존, 모델을 조용히 전환하는 것을 금지하는 명시적 규칙이 추가되었습니다. 우선순위 표는 빠르게 훑어볼 수 있었습니다.
그러나 사용자가 "작업과 프롬프트를 조용히 잃는다"고 말했습니다. 제공된 피드백은 중단과 경고 누락을 입증했지만 프롬프트 손실은 입증되지 않았습니다.
Fable 5.2 대 Opus 5.5 가격
표준 API 요청의 경우 Fable 5.2는 토큰당 비용이 Opus 5.5의 두 배입니다. 두 모델이 비슷한 토큰 사용량으로 허용 가능한 결과를 제공할 때 Opus가 더 저렴한 시작점이 됩니다.
입력 / 출력
입력 / 출력
이는 Anthropic의 표준 입력/출력 요금으로, 2026년 11월 11일에Fable 사양.
Opus 사양 해당 표준 요금을 나열합니다. 빠른 모드, 캐싱, 일괄 할인, 소비자 구독 및 제3자 청구에는 다른 조건이 있습니다.
10,000개의 입력 토큰과 5,000개의 출력 토큰을 사용하는 예시 요청의 경우, 표준 요금 계산은 Fable의 경우 $0.28, Opus의 경우 $0.14입니다. 이는 계산 예시이며 테스트에서 나온 청구서가 아닙니다.
토큰 요금이 높다고 해서 성공적인 작업당 비용이 높아지는 것은 아닙니다. 더 짧은 답변, 더 적은 수정 라운드 또는 더 적은 추론이 총 비용을 변경할 수 있습니다. 단일 턴 테스트로는 장기적인 절감을 입증할 수 없습니다.
두 모델 중 하나를 앱에 통합하는 경우, Claude API 설정 가이드 여기에서 토큰 요금 비교와 별도로 설정 질문을 다룹니다.
게이트웨이가 보고한 사용량에 Anthropic의 표준 요금을 곱하면 해당 네 가지 작업에서 Fable의 경우 $0.4291, Opus의 경우 $0.1799의 요금 기반 대리 값을 얻을 수 있습니다. 공식은 입력 토큰 × 입력 요금 + 출력 토큰 × 출력 요금을 100만으로 나눈 것입니다. 여기에는 모든 설계 요청과 실패한 호출이 제외됩니다.Fable의 요금 기반 프록시는 $0.4291, Opus는 $0.1799 이 네 가지 작업 전반에 걸쳐. 공식은 입력 토큰 × 입력 요율 + 출력 토큰 × 출력 요율을 100만으로 나눈 것입니다. 여기에는 모든 디자인 요청과 실패한 호출이 제외됩니다.
이 프록시는 게이트웨이의 실제 요금이 아닙니다. 송장, 토큰 회계 동등성 또는 마크업을 확인하지 않았습니다. 또한 이후 인간 편집이나 추가 시도의 비용도 측정하지 않습니다.
공식 벤치마크가 확립하는 것
Anthropic의 출시 평가는 여러 어려운 작업에서 Fable에게 우위를 제공합니다. 아래 표는 보고된 세 가지 점수를 재현한 것입니다. 이는 공급업체 평가이며, 자체 역할 기반 테스트와는 별개입니다.
| 평가 | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0 | 49.1% | 45.5% |
| FrontierSWE v2 | 69.9% | 62.3% |
| Terminal-Bench-Science 0.1 | 74.6% | 58.7% |
출시 보고서 달리 명시되지 않는 한 각 모델의 사용 가능한 최고 노력을 사용합니다. 이러한 점수는 까다로운 기술 작업에서 Fable을 시도하는 것을 뒷받침하지만, 글쓰기, 제품 판단 또는 시각적 취향에서 보편적인 우위를 확립하지는 않습니다.
두 모델 모두 100만 토큰의 컨텍스트 창과 128,000토큰의 출력 한도를 명시합니다. 이러한 한도는 여기서 스트레스 테스트되지 않았습니다.
자주 묻는 질문
Fable 5.2가 코딩에서 Opus 5.5보다 더 나은가요?
Anthropic은 여러 어려운 코딩 평가에서 Fable 점수가 더 높다고 보고합니다. 우리의 코딩 연습은 단일 파일 AI 작업 공간이지 저장소 벤치마크가 아니므로 일반적인 코딩 승자를 확립할 수 없습니다.
Fable 5.2의 비용이 더 많이 드나요?
표준 API 입력 및 출력 요금은 Opus 5.5의 두 배입니다: 백만 토큰당 $8/$40 대 $4/$20. 실제 작업 비용은 사용량, 추론, 재시도, 캐싱 및 청구하는 서비스에 따라 달라집니다.
이 테스트는 GlobalGPT 내부에서 실행되었나요?
아니요. 그들은 타사 API 게이트웨이를 통해 명명된 모델을 사용했습니다. 그들은 GlobalGPT나 Claude 자체 앱 내에서 모델 가용성, 청구 또는 네이티브 기능을 확립하지 않습니다.
어느 모델이든 확인 없이 연구를 요약하도록 신뢰할 수 있습니까?
두 연구 답변 모두 주요 결과를 올바르게 계산했지만, 각각 편집이 필요한 추론을 적어도 하나 도입했습니다. 모든 연구 설계 세부 사항을 확인하고 추정치를 유의성 주장과 분리하십시오.
더 보기 좋은 생성 페이지가 더 나은 코딩 능력을 증명합니까?
아니요. 시각적 디자인, 작동하는 상호작용, 접근성 및 유지보수성은 별개의 차원입니다. 단일 매력적인 페이지로는 저장소 수준의 코딩 신뢰성을 확립할 수 없습니다.
모델에 동등한 추론 노력이 주어졌습니까?
동일한 입력과 출력 상한을 사용했으며 추론 설정은 플랫폼 기본값으로 두었습니다. 게이트웨이의 매핑은 독립적으로 검증되지 않았으므로 이는 동등한 노력의 벤치마크가 아닙니다.
모든 작업을 Fable 5.2로 전환해야 할까요?
먼저 작업별 승인 테스트를 사용하세요. 이를 충족하는 더 저렴한 모델로 시작한 다음, 가치 있는 개선을 확인할 수 있을 때 어려운 작업을 Fable로 옮기세요.
최종 판단: 어떤 모델을 사용해야 할까요?
수용 가능한 초안이 목표일 때는 Opus 5.5로 시작하세요. 더 낮은 표준 토큰 요금으로 인해 일상적인 글쓰기, 데이터 정리, 계획 수립에 실용적인 기준이 됩니다. 자세한 내용은 Claude Opus 5.5 리뷰.
특정 어려운 작업이 여전히 승인 기준을 충족하지 못할 때 Fable 5.2를 사용해 보세요. 동일한 입력을 유지하고 실제 실패가 해결되는지 확인하세요. Anthropic의 모델 선택 지침 마찬가지로 최신 Opus로 시작하고 더 높은 노력의 Opus가 부족할 때 확대할 것을 권장합니다.
두 프리미엄 모델이 모두 필요하지 않다면, Sonnet 5.5 vs Opus 5.5 이 더 관련성 높은 비용 비교입니다.
더 넓은 범위의 제공업체에 대해서는 당사의 AI 텍스트 생성기 테스트.
저장소 작업의 경우, 이 리뷰의 단일 파일 데모는 시작점일 뿐입니다. 셸 액세스, 다중 파일 편집, 장기 실행 도구 사용 또는 코딩 에이전트의 복구 동작을 테스트하지 않습니다. 구성 세부 정보는 가이드를 참조하세요. Claude Code에서 모델 선택 채팅 완성을 전체 개발 환경의 대체물로 취급하기 전에.



