
Claude Fable 5.2 vs Opus 5.5:コーディング、コスト、使い分け
同じプロンプトによる5つのタスクで、Claude Fable 5.2とOpus 5.5を研究、AIインターフェースデザイン、ライティング、データ、製品計画について比較。オリジナルのスクリーンショットと記録された時間・トークン使用量付き。
 Chloe Murphy

Opus 5.5は日常業務の妥当な出発点です。特定のタスクにまだ改善が必要な場合はFable 5.2をテストしてください。 完了した4組のテキストタスクでは、両モデルとも中核となる研究計算とデータ指標を正しく処理しました。Fableの製品計画は1つの不確実性をより慎重に扱い、どちらの文章出力も主要な制約を満たしていました。
デザイン比較では、新たに32,768トークンのマッチした実行を使用しています。そのスクリーンショット、インタラクションチェック、制限事項は、下記のデザインタスクに記載されています。
Fable 5.2はより新しく、トークンあたりのコストも高くなっています。しかし、より良い結果をもたらすのか、それとも単に請求額が増えるだけなのか。私たちは各モデルに同じタスク概要を用いて、リサーチ、AIインターフェースデザイン、ライティング、データ分析、製品判断を比較しました。
個別のAPI設定を管理せずにモデルを比較したい場合は、GlobalGPTがマルチモデルワークスペースを提供しています。ここでのAPIテストは、GlobalGPT内でFable 5.2が利用可能であることを示すものではありません。
実用的な比較
| 判断 | Fable 5.2 | Opus 5.5 |
|---|---|---|
| 100万トークンあたりの標準入力 / 出力 | $8 / $40 | $4 / $20 |
| 研究テスト | 計算は正しいが、因果関係の表現は編集が必要 | 計算は正しいが、研究デザインの詳細に根拠がない |
| コンテンツテスト | 180語の説明、短めのナレーション | 180語の説明、より充実した例 |
| データテスト | 要求された指標はすべて正確 | 要求された指標はすべて正確 |
| 製品テスト | 確認された害と可能性のある害を注意深く区別 | 計画は有用だが、作業が失われたという主張は根拠がない |
| 当初のデザイン試行 | 成果物なし:HTTP エラー | コードブロック整理後の完全な HTML |
2つのモデルをどのようにテストしたか
各タスクでは、両モデルに同一のソース資料、新しい会話、同じ出力上限を使用しました。テキストタスクでは16,000トークンの上限を使用し、最終デザイン実行では32,768を使用しました。プロンプト、設定、時間、使用量は、下記の対応するタスクとともに表示されます。
ブリーフに含まれるすべての研究、製品、注文データ、フィードバックは架空のテストフィクスチャでした。計算は用意された解答キーと照合しました。推論努力はプラットフォームのデフォルトのままなので、これは等努力ベンチマークではありません。サードパーティゲートウェイが返すモデルラベルは、上流のルーティングを独立に証明するものではありません。
研究者:証拠を誇張せずに統合する
同じプロンプト · 研究者テスト
You are a researcher. Use only these FICTIONAL study summaries about an AI writing assistant. A: randomized 120 adults, 60 per arm, intervention mean score baseline70 followup78, control baseline69 followup74, four weeks; no standard deviations, uncertainty intervals, or attrition information reported. B: observational 300 adults, usage correlated with writing scores r=.32, no confounder adjustment. C: interviews with12 users reporting perceived improvement. In under650 words synthesize evidence with A/B/C citations, calculate difference in changes, explain what cannot be inferred, and propose a feasible preregistered followup study with primary endpoint and analysis. Do not invent citations or statistical significance.
研究者タスクは、不完全な報告を含むランダム化試験を含む3つの架空の研究の統合を求めました。重要な計算は (78 − 70) − (74 − 69) = 3 ポイント。両方のモデルは正しく答え、統計的有意性を捏造することを拒否しました。
Fable 5.2
盲検化された支援なしの筆記評価、治療意図分析、欠測データの感度チェックを提案した。また、明示的に仮想的なサンプルサイズの例も示した。
「3ポイントの差のみがアシスタントに起因する」
未知の脱落と報告の欠落を考えると、その表現は自信過剰だった。後の段落で推定が限定されていたとしても。また、インタビュー参加者はおそらく自己選択だったと推測した。
Opus 5.5
ランダム化、観察、インタビューのエビデンスを明確に分けた。ベースライン調整試験を提案し、サンプルサイズ計算をパイロットの変動性に依存させた。
「説明されているように横断的な性質」
提供された観察要約は横断的デザインを明記していなかった。その詳細は不明のままであるべきだった。
このブリーフを適応させる場合は、証拠を固定し、各モデルに報告された事実と推論を分けるよう求めてください。私たちの 研究とコーディングのためのClaudeプロンプト は、タスク固有の制約のより多くの例を提供します。
Designer:AIマルチモデルワークスペース
同じプロンプト · Designerテスト
You are a product designer and frontend builder. Return only one complete self-contained HTML file with inline CSS and JavaScript, no external assets/CDNs. Build a polished AI multi-model workspace called Parallel. Give it a distinctive cohesive visual identity with excellent typography, whitespace, hierarchy and responsive layout; choose your own palette. Include sidebar, model A/B selectors, prompt textarea, compare button, two side-by-side result cards, loading state, clear button, per-result copy button, empty-input validation, keyboard-accessible controls and mobile stacking. Models A/B are FICTIONAL; all outputs must be locally simulated and explicitly labeled demo. No real API calls or fake live performance metrics. Compare must work repeatedly and preserve the submitted prompt in both outputs. Copy must report success only after actual success, otherwise provide an error. Aim for a complete compact artifact, not an explanation.
デザイナーブリーフは両方のモデルに パラレル:サイドバー、モデルセレクター、プロンプト入力、シミュレートされた結果カード、検証、コピーコントロール、モバイルレイアウトを備えた自己完結型のAI比較ワークスペース。カラーパレットとビジュアルアイデンティティはオープンのままにしました。
最終的に一致した実行では、同じプロンプト、ストリーミング転送、共有の32,768トークン上限を使用しました。両方の応答は通常の停止に達しました。ソースアーティファクトは未編集のままです。HTMLを保存すると、存在する場合は囲んでいるMarkdownフェンスのみが削除されます。
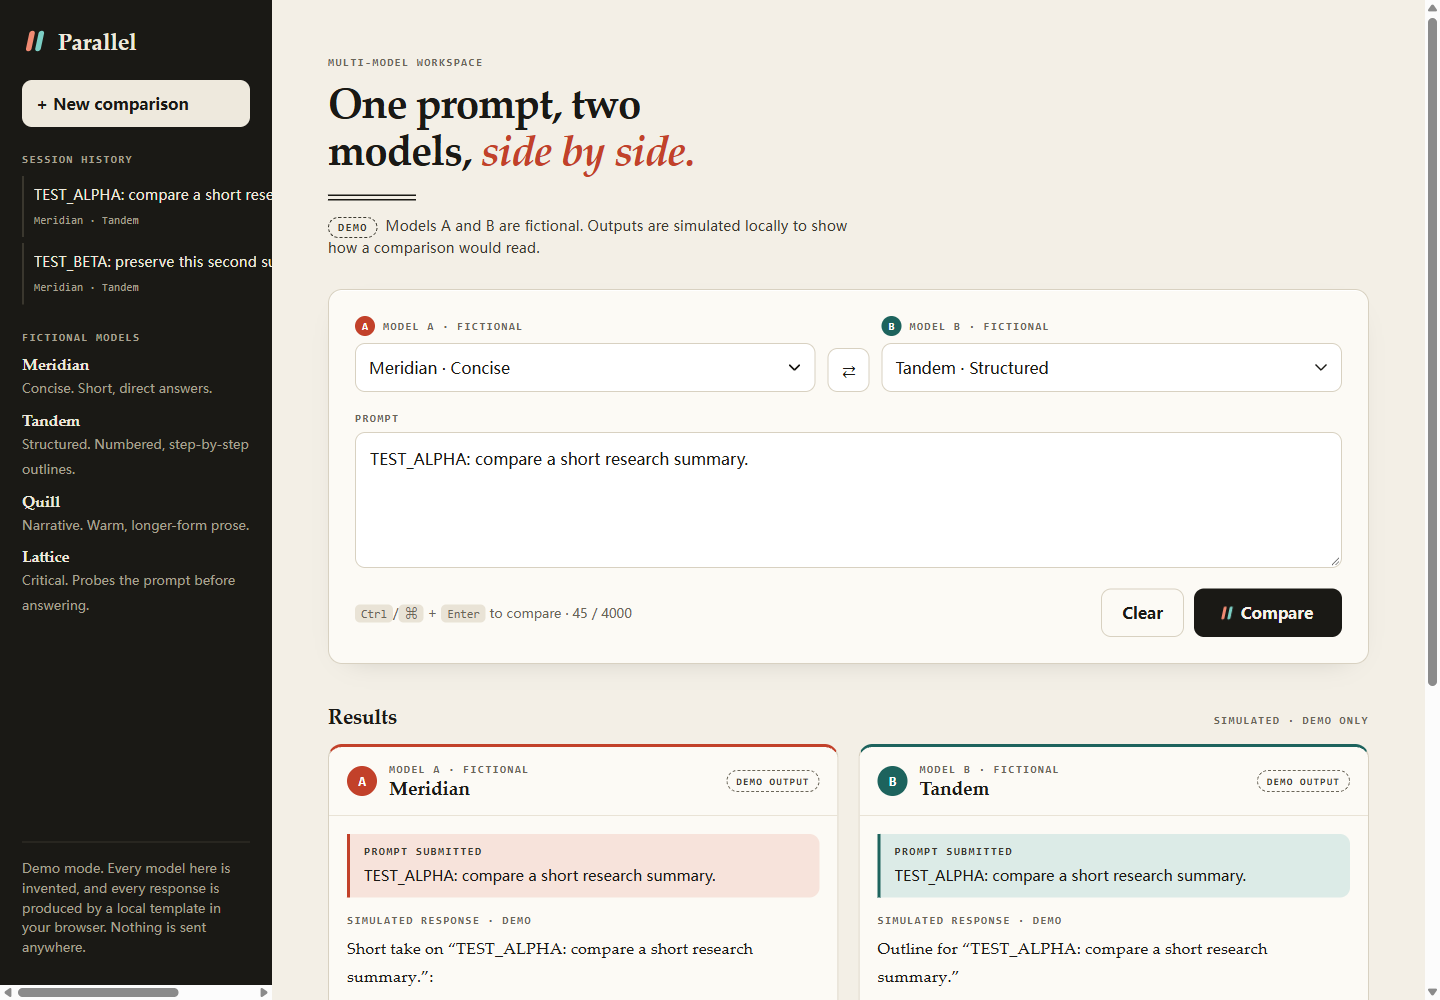
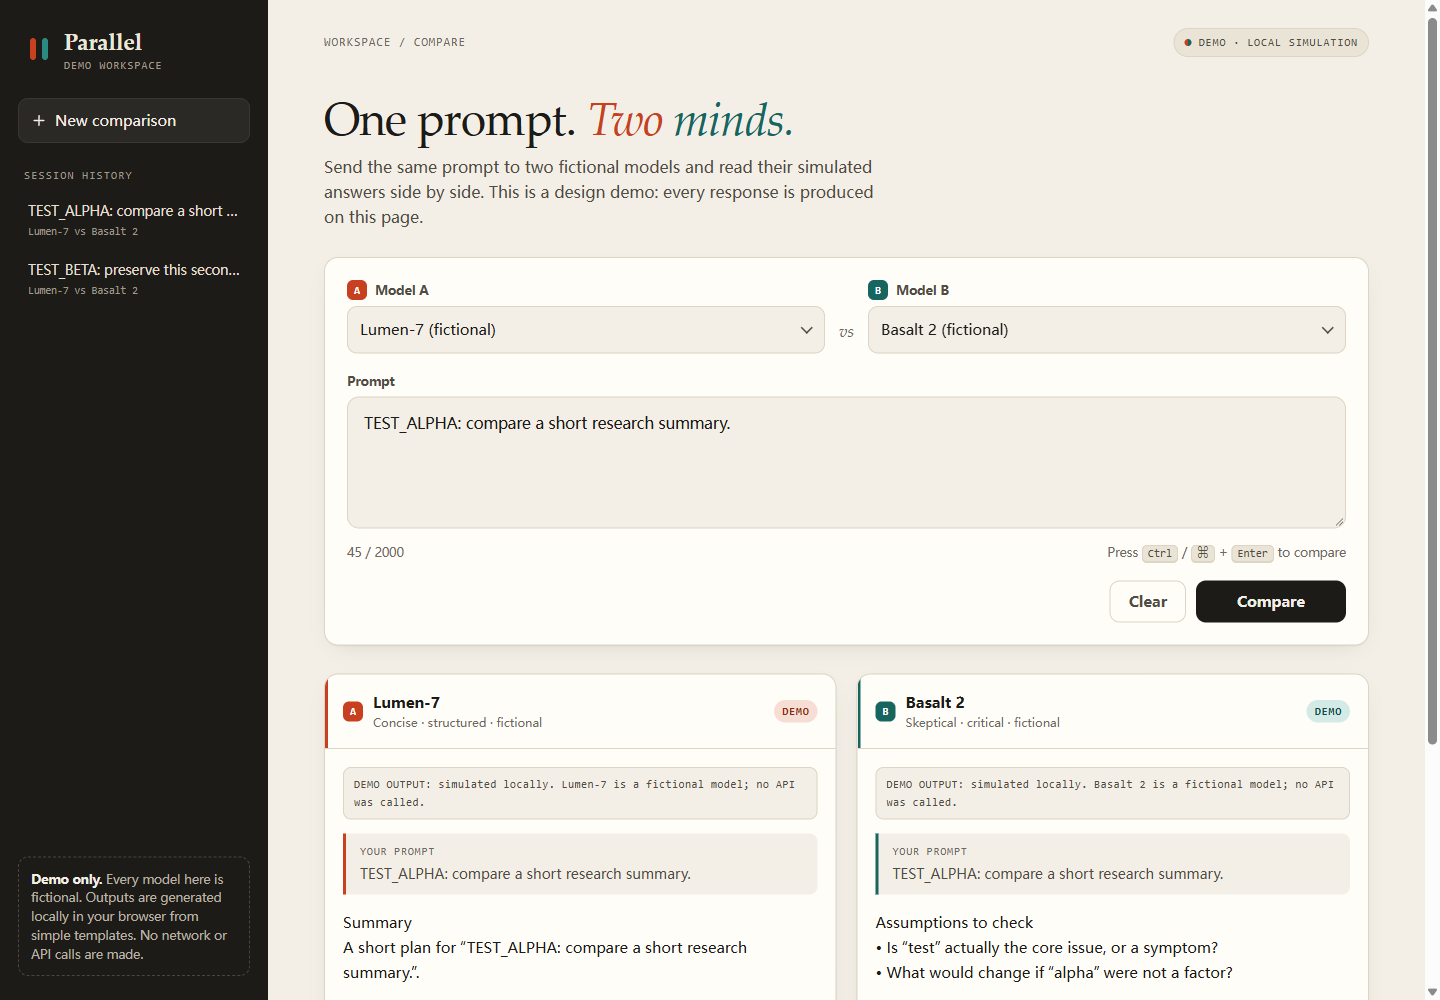
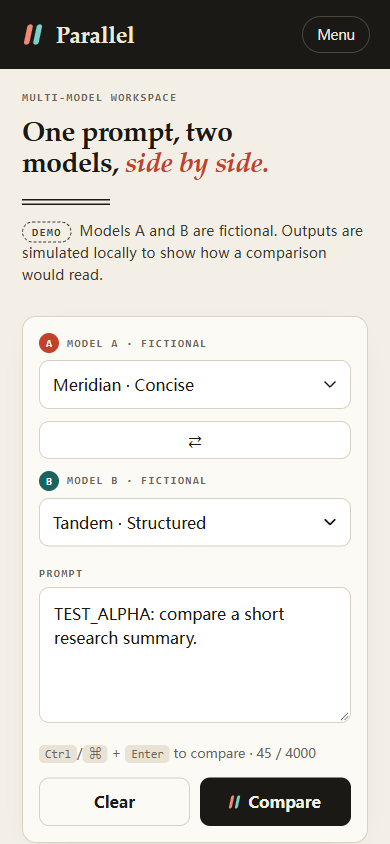
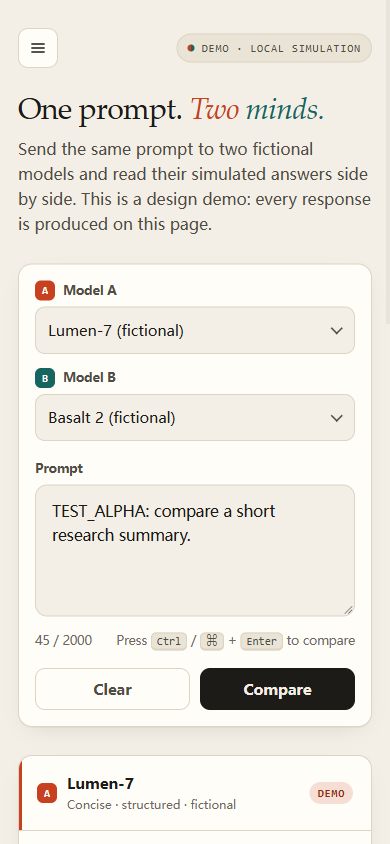
レンダリングされたページの実際の見た目
Fable 5.2 サンプル
より重いセリフの見出し、斜体の赤い強調、高コントラストのサイドバーが、このページにより強い編集上のアイデンティティを与えています。モデル切り替えコントロールは便利な追加機能ですが、モバイルでは1行全体を占め、プロンプトと結果をさらに下に押し下げます。
Opus 5.5 サンプル
より軽い見出しとシンプルなモデル選択エリアは、より控えめに感じられます。同じモバイルビューポートでは、比較ボタンは上部から約710ピクセルの位置で終わり、Fableサンプルの826ピクセルに対して、最初の結果カードがより早く表示される余地を残しています。
どちらも温かみのある紙の色調、暗いサイドバー、セリフの見出しを選びました。ここでの違いは階層と密度であり、まったく異なるデザイン言語ではありません。この特定のワークスペースでは、Opusサンプルのコンパクトなレイアウトを好みます。より目立つ編集上の見出しを優先するなら、Fable のサンプルにはその魅力があります。これは返された成果物間の主観的な好みであり、基盤となるモデルの一般的な美的ランキングではありません。
ブラウザチェック:外観と動作を別々に
| チェック | Fable サンプル | Opus サンプル |
|---|---|---|
| 空入力の検証 | 合格 | 合格 |
| 繰り返し比較で送信されたプロンプトが保持される | 合格 | 合格 |
| 目に見える読み込みフィードバック | 合格 | 合格 |
| 入力をクリア | 合格 | 合格 |
| 幅390ピクセルでのページオーバーフロー | 測定されず | 測定されず |
| コピー失敗はエラーを正直に報告する | 合格 | 合格 |
| クリップボードへのコピー成功 | 未検証 | 未検証 |
Chrome で未編集の出力を開き、DOM コントロールを使用してチェックを実行しました。デスクトップのスクリーンショットは 1440 × 1000、モバイルのスクリーンショットは 390 × 844 を使用しています。4 つすべてが、比較後、コピーチェック前に送信された同じプロンプトを示しています。これらの手順中にランタイム例外は記録されませんでした。自動化セッションではクリップボードへの書き込みは成功せず、キーボードのみの完全なトラバーサルはテストされませんでした。
最終デザインペアの使用量は、標準レートの代理値として Fable が $0.8826、Opus が $0.2918。これはプロバイダー料金とゲートウェイが報告したトークンを使用し、以前の試行を除外しており、ゲートウェイの実際の請求額ではありません。
以前の試みと証拠の限界
コンテンツクリエイター:2つの形式での正確なコピー
同じプロンプト · コンテンツクリエイターテスト
You are a content creator. Based ONLY on these FICTIONAL product facts, write a180-word plain-English explainer and a45-second video script with timestamps, then a five-item fact-check checklist. Facts: Lumen is a fictional AI workspace; it lets users compare two AI text drafts side by side, save prompts locally in their browser, and manually copy a chosen result. It does not publish content automatically, browse the web, or verify facts. No prices, launch dates, speed metrics, supported model names, or privacy guarantees are provided. Audience: freelancers who struggle to choose a usable first draft. Explain a practical example, avoid hype and invented claims, and distinguish local prompt saving from an unproven no-training guarantee.
クリエイター向けブリーフでは、3つの機能のみを備えた架空のワークスペースが提供されました:下書きの並列比較、ローカルでのプロンプト保存、手動コピーです。180語の説明文、45秒のスクリプト、5項目のファクトチェックリストが求められました。
両方の説明文は180語の要件を満たしました当社の単語カウント規則に基づき、単語内のアポストロフィとハイフンは単語内に保持されます。両方とも機能制限を維持し、ローカルストレージをトレーニングなしの保証として扱うことを正しく避けました。
Fable 5.2
フリーランサーが下書きを選ぶ難しさから始まり、その後3つの機能を短い文で説明しました。そのビデオのナレーションは101語で、45秒で配信すると約135語/分になります。
Opus 5.5
より詳細なコピーライターの例を使用し、より力強い冒頭とより明確な機能説明を対比させた。そのナレーションには109語が含まれ、同じ時間枠で約毎分145語だった。
これらのペース推定は、時間計測された録音ではなく、書かれたナレーション原稿に基づく。Fableはポーズのための余裕をより多く残し、Opusは例を説明するためにより多くの時間を使う。
長い記事については、私たちのガイド Claudeを使った長文の執筆 では、下書きを検証や編集から分離する方法を説明しています。
データアナリスト:返金、欠落したアトリビューション、ROAS
同じプロンプト · データアナリストテスト
You are a data analyst. Use only this synthetic data. Orders CSV(order_id,updated,status,channel,amount): o1,1,paid,Search,100; o2,1,paid,Social,80; o2,2,refunded,Social,80; o3,1,paid,Search,120; o4,1,pending,Email,60; o5,1,paid,,50; o6,1,paid,Partner,90; o7,1,paid,Email,70; o8,1,paid,Social,60; o9,1,paid,Partner,110. Channel spend/clicks: Search200/100; Social100/80; Email50/40; Partner0/20. Deduplicate by order_id keeping greatest updated. Paid orders count and revenue use latest paid only; refunded/pending contribute zero. Blank channel must remain Unknown and cannot inherit spend/clicks. Calculate overall paid count, revenue, each channel paid count/revenue/conversion rate per click/ROAS, and measurable ROAS ranking; zero or missing denominator is N/A. Show arithmetic and propose a cautious next-budget decision without inferring causality. Return table and explanation under600 words.
アナリストタスクは、整然とした表では隠れてしまうエラーを検出するために設計されました:重複する注文ID、後からの返金、保留中の注文、不明なチャネル、支出ゼロのパートナーチャネル。
両方のモデルが用意された解答キーと一致しました: 最新の注文ステータスを保持した後の7件の支払い済み注文と600の収益。返金済みおよび保留中のレコードを除外し、不明なアトリビューションを「不明」のままにし、未定義の比率をN/Aとマークしました。
| チャネル | 支払い済み注文 | 収益 | コンバージョン / クリック | ROAS |
|---|---|---|---|---|
| 検索 | 2 | 220 | 2.00% | 1.10 |
| ソーシャル | 1 | 60 | 1.25% | 0.60 |
| メール | 1 | 70 | 2.50% | 1.40 |
| パートナー | 2 | 200 | 10.00% | N/A:支出ゼロ |
| 不明 | 1 | 50 | N/A | N/A |
Fable はチャネル表で収益の計算を示し、大幅な変更を行う前に返金、保留中の注文、欠落タグ、未記録のパートナーコストを確認するよう提案した。Opus はレコードごとの重複排除テーブルを追加し、未帰属収益が全体の 8.3% であると計算した。
両者とも、観測された ROAS を因果関係の証明として扱うのではなく、予算を限定したテストを推奨した。Opus の、ソーシャルでの販売が 1 件増えれば ROAS がおよそ 2 倍になるという補足は、同様の注文金額を前提としており、入力に含まれる新たな事実ではなかった。
プロダクトマネージャー:機能投票より害を優先
同じプロンプト · プロダクトマネージャーテスト
You are a product manager for a FICTIONAL AI subscription workspace. Feedback: 2 users report duplicate charges after retrying checkout; billing logs confirm one duplicate captured charge. 30 users request dark mode. 8 report one model unavailable and no warning before using a prompt; outage reproduced. 1 requests account/data deletion; request pending for20 days, governing deadline unknown. 12 request reusable saved prompts. 4 want team seats; no revenue commitment. Two engineers available for one week; effort estimates unknown. Produce a one-week priority plan with rationale, explicit unknowns, scope boundaries, owner roles, acceptance criteria, instrumentation and rollback/containment steps. Do not fabricate legal deadlines, revenue, effort or certainty. Distinguish immediate containment from permanent fixes; do not rank purely by vote count. Under700 words.
製品概要では、確認済みの二重請求とユーザーへの期限切れの削除リクエスト、再現されたモデル障害、さらに人気の機能リクエストが並べられていました。罠は、実証された害よりも30件のダークモード投票を優先することでした。
両モデルとも、請求、削除のフォローアップ、障害の封じ込めを機能開発よりも優先しました。 どちらも削除の法的期限を捏造しませんでした。両方とも所有者の役割を割り当て、即時の封じ込めと恒久的な修正を分離し、受け入れチェックと監視を提案しました。
Fable 5.2
返金調整、繰り返し請求を防ぐ修正、手動による障害封じ込めを指定しました。可能性のあるクォータ損失を確認すべき事項として明示的に扱い、削除を不可逆とフラグ付けしました。
Opus 5.5
送信前の警告、プロンプトの保持、モデルを黙って切り替えることを禁じる明示的なルールが追加されました。優先順位表はすぐに確認できました。
しかし、ユーザーが「作業とプロンプトを静かに失う」と述べていました。提供されたフィードバックは停止と警告の欠如を立証しましたが、プロンプトの損失は証明されていませんでした。
Fable 5.2 と Opus 5.5 の価格
標準的なAPIリクエストでは、Fable 5.2のトークンあたりのコストはOpus 5.5の2倍です。両モデルが同程度のトークン使用量で許容できる結果を出す場合、Opusがより安価な出発点となります。
入力 / 出力
入力 / 出力
これらはAnthropicの標準入力/出力レートで、2026年11月11日にFable仕様。
Opus仕様 に対応する標準レートが記載されています。高速モード、キャッシング、バッチ割引、消費者向けサブスクリプション、サードパーティ請求には異なる条件があります。
10,000入力トークンと5,000出力トークンの例示的なリクエストの場合、標準レートの計算ではFableが0.28ドル、Opusが0.14ドルになります。これは計算例であり、テストからの請求書ではありません。
トークンレートが高いからといって、成功したタスクあたりのコストが高くなるわけではありません。回答が短い、修正ラウンドが少ない、推論が少ないなどの要因で合計は変わります。私たちの1ターンテストでは長期的な節約を確立できません。
どちらかのモデルをアプリに統合する場合、Claude APIセットアップガイド は、ここでのトークンレート比較とは別にセットアップに関する質問を扱っています。
ゲートウェイが報告した使用量にAnthropicの標準レートを掛けると、これら4つのタスクにおけるレートベースの代理値として、Fableが0.4291ドル、Opusが0.1799ドルとなります。計算式は、入力トークン × 入力レート + 出力トークン × 出力レートを100万で割ったものです。これにはすべての設計リクエストと失敗した呼び出しは含まれません。Fable のレートベースのプロキシは $0.4291、Opus は $0.1799 これら4つのタスク全体で。計算式は、入力トークン数 × 入力レート + 出力トークン数 × 出力レート を100万で割ったものです。これにはすべてのデザインリクエストと失敗した呼び出しは含まれません。
このプロキシは ゲートウェイの実際の料金ではありません。請求書、トークン会計の同等性、またはマークアップは検証していません。また、後で人間が編集するコストや追加の試行のコストも測定していません。
公式ベンチマークが確立するもの
Anthropic のローンチ評価では、Fable がいくつかの難しいタスクで優位に立っています。以下の表は報告された3つのスコアを再現したものです。これらはプロバイダーによる評価であり、当社独自のロールベースのテストとは別のものです。
| 評価 | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0 | 49.1% | 45.5% |
| FrontierSWE v2 | 69.9% | 62.3% |
| Terminal-Bench-Science 0.1 | 74.6% | 58.7% |
ローンチレポート 特に記載がない限り、各モデルの利用可能な最高の努力を使用します。これらのスコアは、要求の厳しい技術作業でFableを試すことを支持しますが、文章、製品判断、視覚的センスにおける普遍的な優位性を確立するものではありません。
両モデルとも100万トークンのコンテキストウィンドウと128,000トークンの出力制限を記載しています。これらの制限はここではストレステストされていません。
よくある質問
Fable 5.2はコーディングにおいてOpus 5.5より優れていますか?
Anthropicは、いくつかの難しいコーディング評価でFableのスコアが高いと報告しています。私たちのコーディング演習は単一ファイルのAIワークスペースであり、リポジトリのベンチマークではないため、一般的なコーディングの勝者を確立することはできません。
Fable 5.2のコストは高くなりますか?
標準API入力および出力レートはOpus 5.5の2倍です:100万トークンあたり8ドル/40ドルに対し、4ドル/20ドル。実際のタスクコストは、使用量、推論、再試行、キャッシング、請求するサービスにも依存します。
これらのテストはGlobalGPT内で実行されましたか?
いいえ。彼らはサードパーティのAPIゲートウェイを通じて指定されたモデルを使用しました。彼らはGlobalGPTやClaude自身のアプリ内でモデルの可用性、請求、ネイティブ機能を確立していません。
どちらかのモデルを、確認せずに研究を要約するために信頼できますか?
両方の研究回答は主な結果を正しく計算しましたが、それぞれ少なくとも1つの編集が必要な推論を導入しました。すべての研究デザインの詳細を確認し、推定値と有意性の主張を分けてください。
見た目が良い生成ページは、より優れたコーディング能力を証明しますか?
いいえ。ビジュアルデザイン、機能するインタラクション、アクセシビリティ、保守性は別々の次元です。単一の魅力的なページでは、リポジトリレベルのコーディング信頼性を確立できません。
モデルには同等の推論努力が与えられましたか?
同一の入力と出力上限を使用し、推論設定はプラットフォームのデフォルトのままにしました。ゲートウェイのマッピングは独立して検証されていないため、これは同等の労力によるベンチマークではありません。
すべての作業を Fable 5.2 に切り替えるべきでしょうか?
まずタスク固有の受け入れテストを使用してください。それを満たすより安価なモデルから始め、価値のある改善を特定できたら、難しいタスクを Fable に移行してください。
最終判断:どのモデルを使うべきか?
許容できる初稿が目標の場合は、Opus 5.5 から始めてください。 標準トークンレートが低いため、日常的な文章作成、データクレンジング、計画の実用的なベースラインとなります。詳細については、Claude Opus 5.5 のレビュー。
特定の難しいタスクがまだ受け入れ基準を満たしていない場合は、Fable 5.2 を試してください。 同じ入力を維持し、実際の失敗が修正されるかどうかを確認してください。Anthropic の モデル選択ガイダンス 同様に、最新の Opus から始め、より高い努力の Opus が不十分な場合にエスカレートすることを推奨しています。
どちらのプレミアムモデルも必要ない場合、Sonnet 5.5 vs Opus 5.5 がより関連性の高いコスト比較です。
より幅広いプロバイダーについては、当社の AI テキスト生成テスト。
リポジトリ作業の場合、このレビューの単一ファイルデモは出発点にすぎません。シェルアクセス、複数ファイルの編集、長時間実行されるツールの使用、コーディングエージェントの回復動作はテストしていません。設定の詳細については、ガイド「Claude Code でのモデル選択 チャット補完を完全な開発環境の代わりとして扱う前に。



