Qwen 3.8 Max è il nuovo modello di punta di Alibaba Qwen dedicato alla programmazione, alle attività professionali, agli agenti a esecuzione prolungata e alle attività multimodali. Il nome ufficiale è Qwen3.8-Max, è stato annunciato il 3 agosto 2026 con un totale di 2,4 trilioni di parametri, 95 miliardi di parametri attivi e una finestra di contesto di 1 milione di token.
Il lancio va ben oltre un semplice aggiornamento di routine dei benchmark. Qwen sta posizionando il modello come un agente in grado di pianificare, utilizzare strumenti, analizzare il feedback visivo e continuare a lavorare lungo lunghe catene di attività — non solo come un chatbot che risponde a una singola richiesta alla volta. Ciò lo colloca nella stessa fascia di mercato del i migliori modelli di IA per il lavoro vero e proprio, ma il costo dell’API, il piano a consumo e i requisiti di implementazione meritano un’analisi più approfondita prima di effettuare il passaggio.
Che cos’è Qwen3.8-Max?
Qwen3.8-Max è un modello di tipo “mixture-of-experts” di grandi dimensioni sviluppato dal team Qwen di Alibaba. Conta in totale 2,4 trilioni di parametri, ma ne attiva 95 miliardi per ogni token. Il modello combina testo, codice, comprensione visiva, utilizzo di strumenti e pianificazione a lungo termine in un unico sistema progettato per portare a termine lavori complessi dall’inizio alla fine.
Il Comunicato ufficiale Qwen descrive quattro obiettivi fondamentali: una programmazione autonoma più solida, risultati professionali di qualità produttiva, attività a ciclo chiuso più lunghe e agenti multimodali nativi. In termini pratici, Qwen mira a far evolvere il modello da un approccio del tipo “rispondi a questa domanda” a uno del tipo “prendi questo obiettivo, elabora un piano, utilizza gli strumenti disponibili, verifica il risultato e prosegui fino al completamento del lavoro”.”
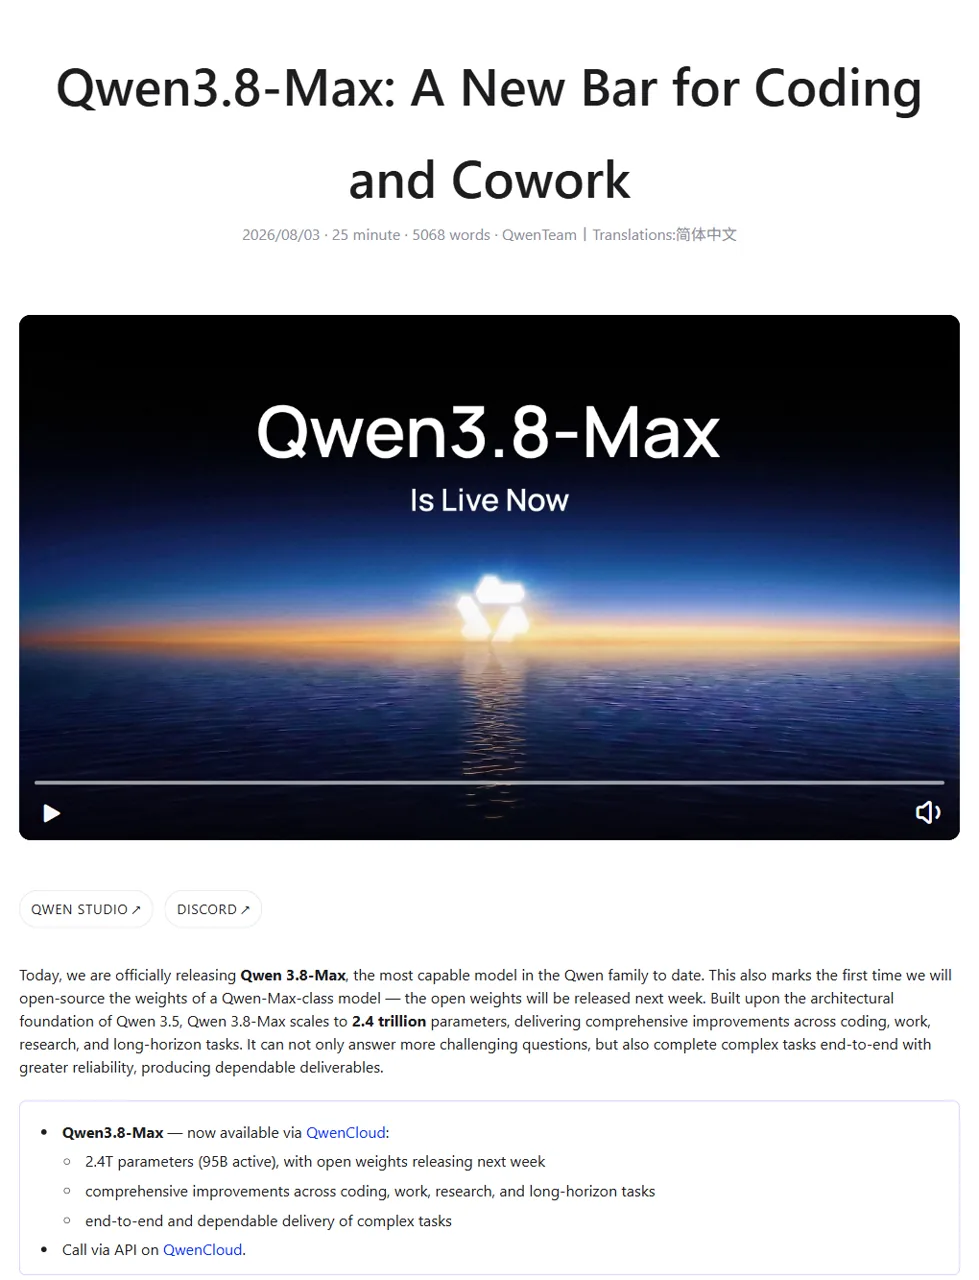
Qwen 3.8 Specifiche massime
Il numero di parametri va contestualizzato. Un modello da 2,4 trilioni di parametri è enorme, ma Qwen3.8-Max non utilizza tutti i parametri per ogni token. Il suo design “mixture-of-experts” instrada ogni token attraverso una porzione attiva più piccola della rete. La cifra di 95 miliardi di parametri attivi è quindi più utile per comprendere il comportamento di inferenza rispetto al solo numero totale, sebbene nessuno dei due valori indichi di per sé la latenza reale o i requisiti hardware.
La finestra di contesto da 1 milione di token risulta immediatamente più utile. È in grado di contenere repository di grandi dimensioni, insiemi di documenti lunghi, cronologie estese degli agenti o mesi di registrazioni operative in un’unica richiesta. Ciò non garantisce un recupero perfetto di ogni singolo token, ma offre agli sviluppatori molto più spazio per conservare istruzioni, output degli strumenti, codice e decisioni intermedie senza dover ricorrere a tagli drastici.
Cosa può fare Qwen3.8-Max?
Codifica autonoma
I materiali di lancio di Qwen mettono in risalto progetti che vanno ben oltre una singola richiesta di generazione di codice. L’azienda descrive uno sviluppo autonomo della durata di oltre 10 giorni, che parte da una cartella vuota per arrivare a un progetto di produzione, adattandosi nel contempo agli errori e ai nuovi requisiti. Questa è la direzione giusta per gli agenti su scala di repository, anche se gli acquirenti dovrebbero comunque verificare il modello in base ai propri linguaggi, suite di test, regole di sicurezza e ambiente di distribuzione.
Nell’ingegneria di tutti i giorni, le domande pratiche sono più semplici: il modello è in grado di elaborare più file contemporaneamente? Mantiene le interfacce durante il refactoring? È in grado di scrivere test, analizzare gli errori e correggere la propria patch? Questi criteri contano più di un semplice punteggio in classifica quando si sceglie il Il miglior modello di AI per la codifica.
Attività professionali di “coworking”
Il termine “cowork” si riferisce ai risultati del lavoro piuttosto che a una chiacchierata informale. Qwen mette in evidenza relazioni, ricerche, presentazioni, analisi, documenti e altri prodotti finali relativi a centinaia di professioni. Un buon modello di “cowork” deve attenersi a un brief, organizzare le prove, utilizzare il formato corretto e produrre qualcosa che una persona possa modificare o presentare, non solo un paragrafo plausibile.
Agenti con orizzonte temporale lungo
Qwen riporta inoltre attività a livello di sistema che si protraggono per centinaia di cicli. Tra gli esempi citati figurano oltre 500 turni di ottimizzazione della progettazione di chip e una simulazione della strategia di e-commerce della durata di un anno. Si tratta di dimostrazioni fornite dai produttori, non di una promessa che ogni agente funzionerà in modo autonomo per giorni. Tuttavia, mostrano chiaramente l’obiettivo del prodotto: pianificazione persistente, valutazione a ciclo chiuso e miglioramento continuo, piuttosto che risposte isolate.
Pianificazione multimodale e feedback visivo
Qwen3.8-Max considera le immagini e le schermate come parte integrante del ciclo dell’agente. Un agente visivo può esaminare una pagina, scegliere un’azione, osservare cosa è cambiato e rivedere il proprio piano. Ciò supporta attività legate all’uso del computer, la comprensione dei documenti, il collaudo delle interfacce, la programmazione visiva, i grafici e il ragionamento spaziale. La difficoltà non sta semplicemente nel riconoscere un’immagine, ma nel mantenere le osservazioni visive collegate all’obiettivo dell’agente nel corso di numerose fasi.
Test pratici: risultati utili, risposte lente e un'esecuzione a vuoto
Ho eseguito tre richieste indipendenti sul qwen3.8-max ID del modello tramite l'API compatibile con Anywhere OpenAI il 4 agosto 2026. Si tratta di piccoli controlli pratici, non di un benchmark indipendente né di un'affermazione relativa a ogni implementazione di Qwen. Sono utili perché mostrano sia la qualità della risposta visibile sia il comportamento del percorso del gateway testato.
Debug di Retry-helper
Il primo compito prevedeva l'utilizzo di una funzione di riprova non funzionante proveniente da uno scenario di payment-webhook. Il prompt limitava il modello a tre tentativi, due ritardi di backoff precisi, un ritorno immediato in caso di successo e il re-raising della terza eccezione in caso di fallimento totale.
La risposta ha individuato tre difetti distinti: il sonno incondizionato dopo ogni tentativo, un non assegnato risultato dopo le eccezioni e un controllo di "truthiness" che ha ritardato o gestito in modo errato il successo. La riga prevista era "paid" con argomenti sleep_fn [0.1, 0.2].
A quel punto ho eseguito il codice localmente, invece di fidarmi della spiegazione. Ha superato tre casi: due fallimenti seguiti da un successo, un valore di successo "falso" alla prima chiamata pari a 0, e tre casi in cui il risultato finale RuntimeError("failure-3") è stato necessario aumentarlo nuovamente. Si è trattato di una valida soluzione ingegneristica. Il compromesso è stato la latenza: la risposta visibile ha richiesto 51,577 secondi attraverso il gateway sottoposto a test.
Sintesi delle prove contrastanti
Il secondo compito mirava a verificare se il modello fosse in grado di distinguere i dati ufficiali aggiornati da vecchie note, affermazioni dei fornitori, un commento della comunità e un percorso della piattaforma non verificato.
Il modello ha gestito correttamente il conflitto inserito. Non ha ripetuto il contesto "256K" né il prezzo di input "$1.20" come valore attuale, non ha convertito un commento relativo a quattro GPU in un requisito hardware e non ha affermato che GlobalGPT disponesse già di una rotta dedicata Qwen3.8-Max. Ha inoltre contrassegnato la tabella ufficiale dei benchmark come «riportata dal fornitore». La risposta ha richiesto 94,973 secondi; si è trattato quindi di un altro risultato incentrato sulla qualità piuttosto che su una rapida estrazione dei dati.
Cosa non ha funzionato nel test di pianificazione?
Una terza richiesta prevedeva un piano di migrazione al CMS della durata di due ore, con due tecnici, che includesse criteri espliciti di approvazione/rifiuto e di rollback. La prima richiesta si è interrotta dopo 133,682 secondi, quando la connessione a monte si è chiusa. Una serie di tentativi più breve max_completamento_tokens a 1.200, ma l'API ha segnalato motivo_di_conclusione: "lunghezza", ha esaurito l'intero budget di ragionamento e non ha restituito alcuna risposta visibile dopo 32,899 secondi.
Si tratta di un utile avviso operativo, ma non costituisce una prova del fatto che Qwen3.8-Max non sia in grado di pianificare le migrazioni. Non era disponibile alcun piano da valutare. In questo contesto, una pianificazione complessa richiede un margine di completamento più ampio, lo streaming o un prompt a fasi, in modo che il ragionamento interno non esaurisca l’intero budget di risposta prima che venga emesso il testo visibile.
Qwen 3.8: benchmark massimi
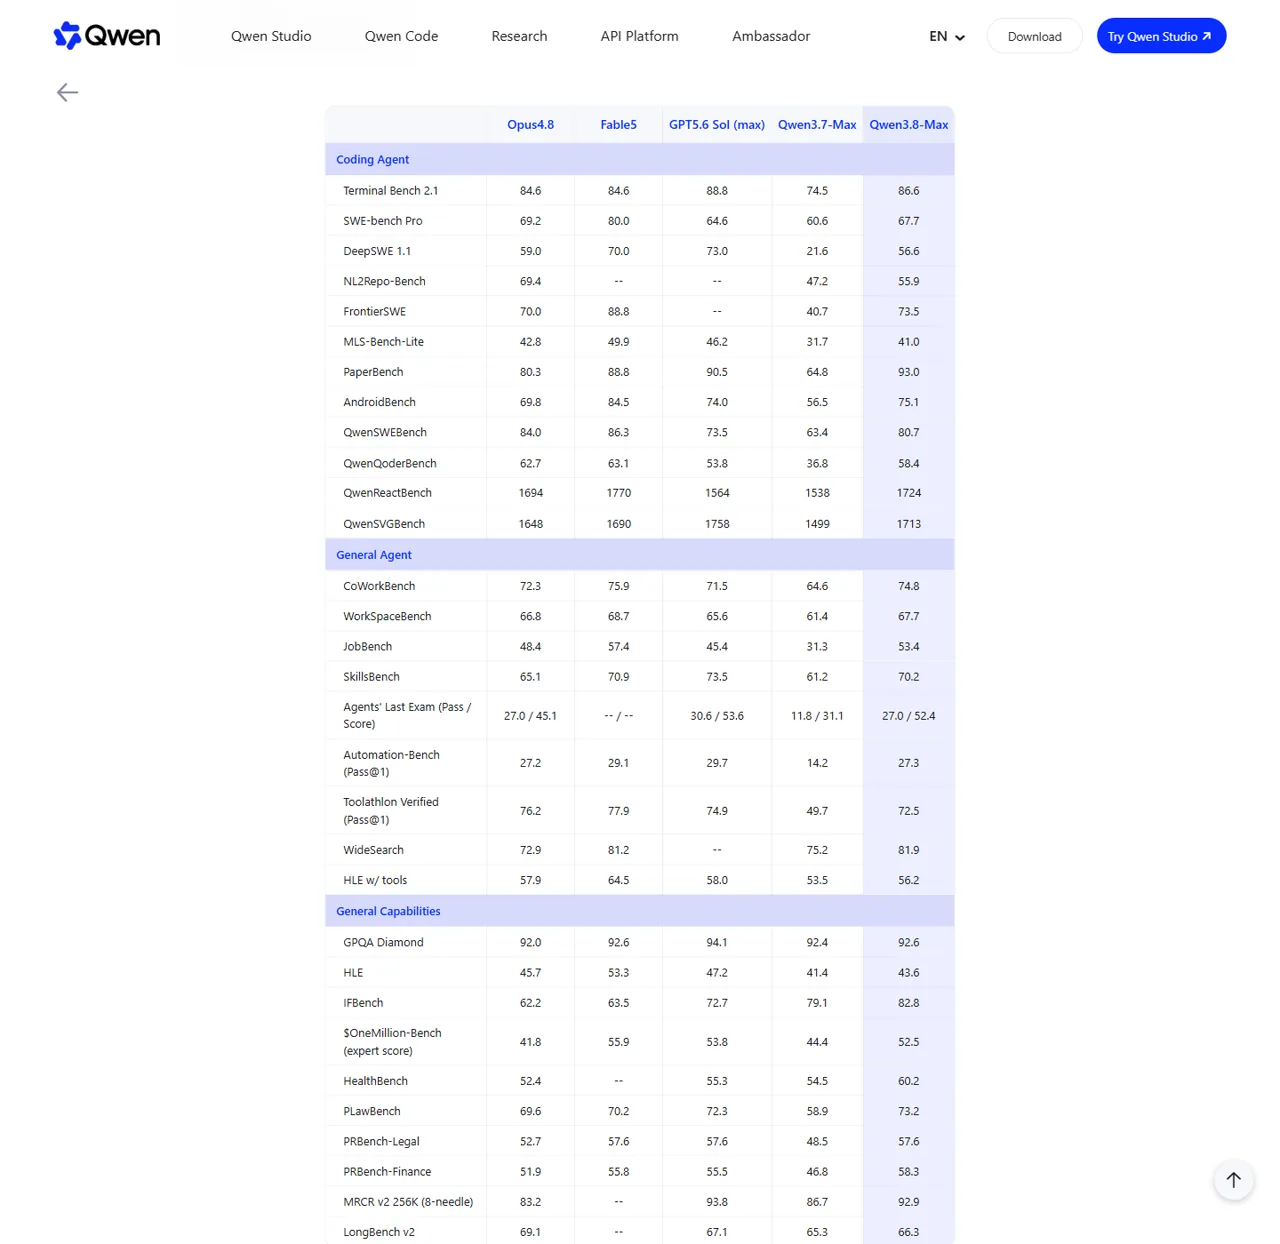
Il pacchetto di benchmark ufficiale di Qwen presenta Qwen3.8-Max come un agente multimodale e di codifica molto potente, ma i risultati sono contrastanti piuttosto che un successo schiacciante. In alcuni test è in testa rispetto ai modelli elencati, in altri si colloca vicino al leader, mentre in diverse categorie resta indietro rispetto a GPT-5.6 Sol o Fable 5. Si tratta di un quadro più equilibrato rispetto alla riduzione di decine di test a un’unica etichetta di “miglior modello”.
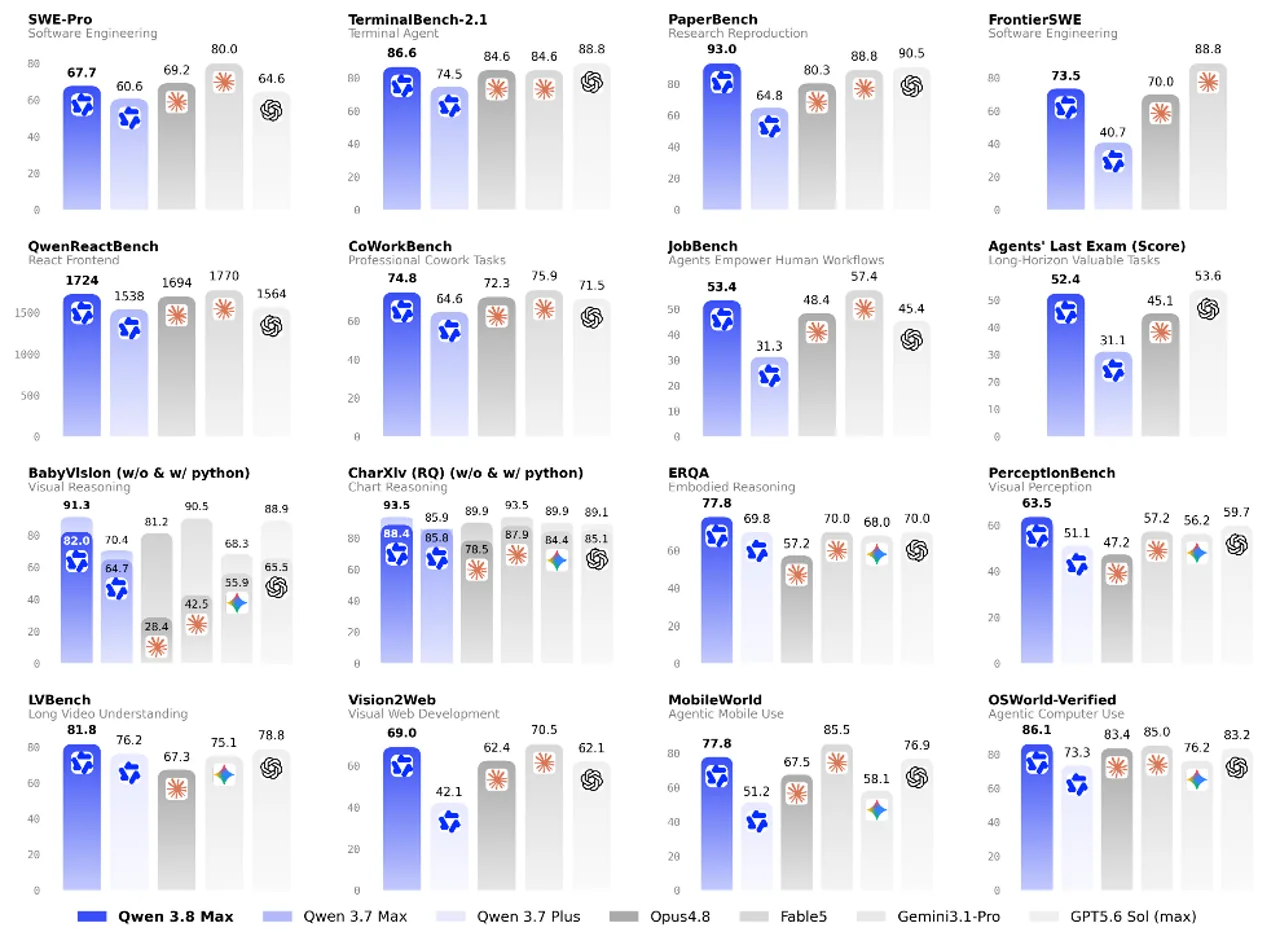
Risultati selezionati dalla classifica ufficiale della Qwen
Questi dati provengono dal materiale divulgativo fornito dalla stessa Qwen. Le note a piè di pagina indicano che la tabella combina rapporti ufficiali sui modelli, schede tecniche, classifiche pubbliche e valutazioni interne di Qwen. Anche i cablaggi e le impostazioni variano a seconda dei modelli. Utilizzate la tabella per individuare i punti di forza più promettenti, quindi verificate la rosa dei candidati con un lavoro autonomo prima di prendere una decisione che comporta costi elevati.
Cosa significano i risultati della codifica
Il vantaggio più evidente è l’equilibrio. Qwen3.8-Max si colloca ai vertici in attività quali l’utilizzo dei terminali, l’ingegneria del software, l’implementazione di documenti, le attività di collaborazione, la ricerca sul web e l’esecuzione di istruzioni. Non è necessario che eccella in ogni singolo aspetto per essere utile; un agente che mantenga prestazioni costantemente elevate in ambiti quali la pianificazione, la programmazione, l’utilizzo degli strumenti e i controlli visivi può risultare più affidabile di un modello ottimizzato per un singolo test specifico.
La tabella ufficiale mostra anche perché i test comparativi siano importanti. GPT-5.6 Sol è in testa in diverse righe relative al ragionamento o alle attività terminali, mentre Fable 5 rimane particolarmente competitivo nelle attività di collaborazione, interfaccia e visive. Un’altra Confronto tra GPT-5.6 e Fable 5 può aiutarti a tradurre quelle famiglie di modelli in casi d'uso quotidiani prima di aggiungere Qwen3.8-Max alla lista dei candidati.
Cosa significano i risultati multimodali
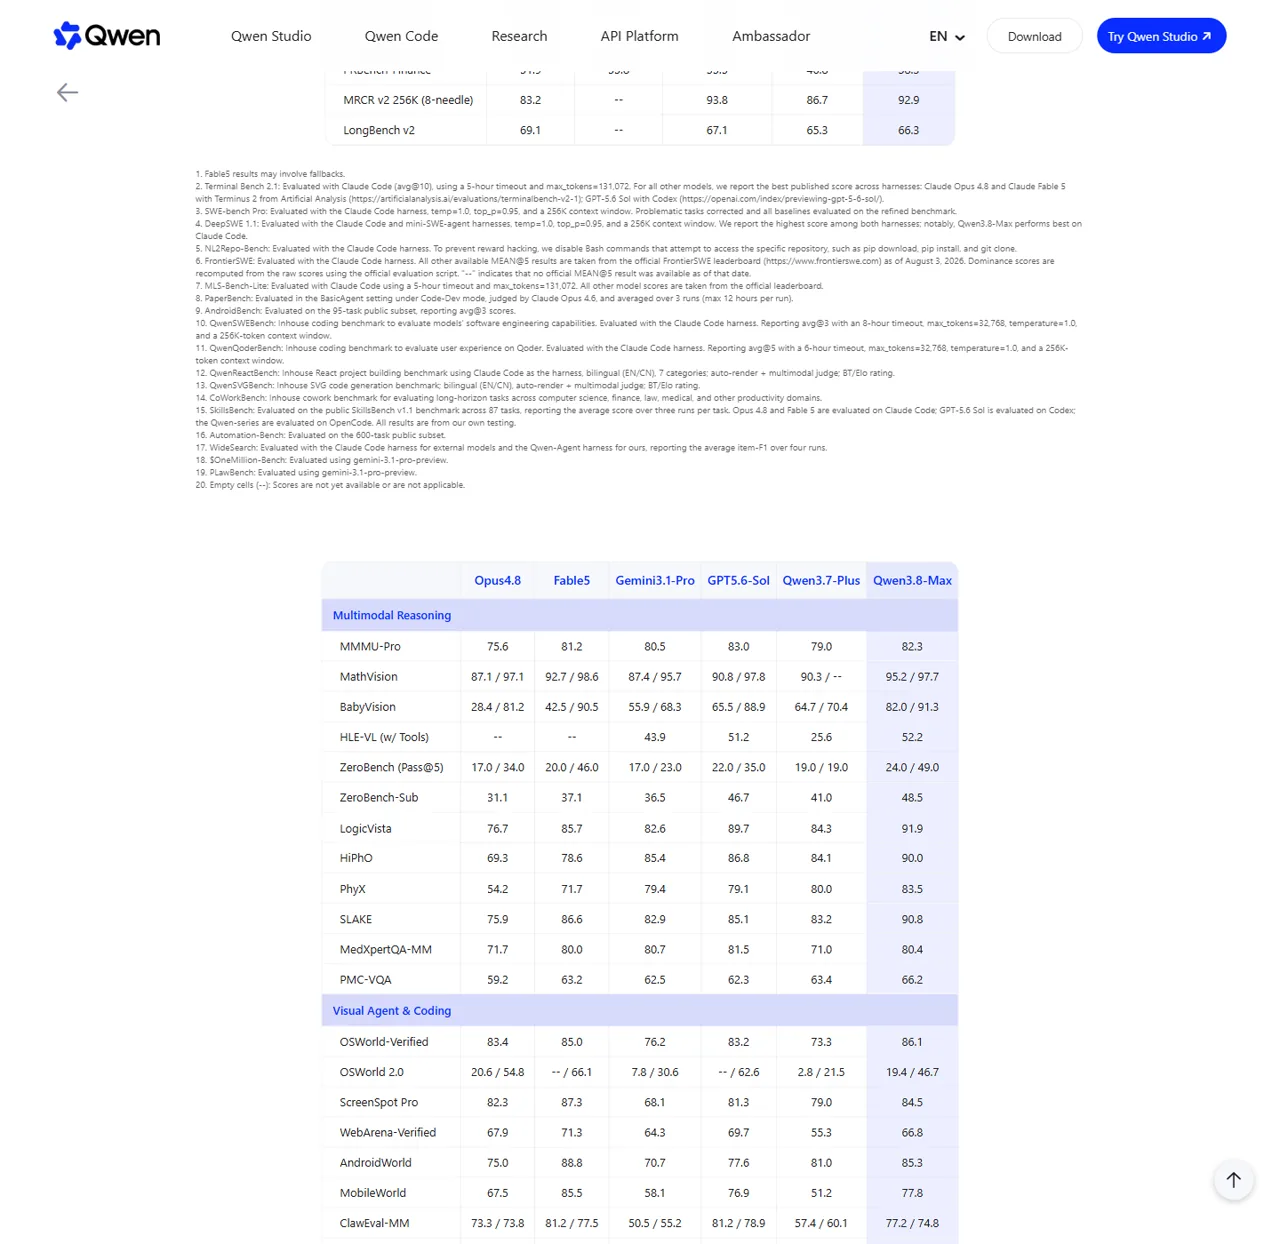
Qwen3.8-Max registra ottimi risultati ufficiali nei settori del ragionamento multimodale, dell’ancoraggio visivo, dell’uso del computer, della gestione dei documenti e della comprensione spaziale. Il suo punteggio di 86,1 su OSWorld-Verified è particolarmente rilevante per gli agenti che operano su schermo, poiché misura la capacità di portare a termine attività all’interno di ambienti desktop, non limitandosi alla semplice descrizione di un’immagine.
Confronto tra Qwen3.8-Max e altri modelli
Non esiste una risposta univoca e responsabile alla domanda: “Qwen3.8-Max è migliore di GPT, Claude o Gemini?”. I dati stessi di Qwen mostrano che i leader della categoria cambiano di riga in riga. L’idoneità del prodotto dipende anche dall’affidabilità dello strumento, dalla qualità dei risultati, dalla latenza, dalla disponibilità a livello regionale, dai controlli sulla privacy e dall’interfaccia che circonda il modello.
Qwen3.8-Max risulta la scelta più interessante quando si desidera un unico modello in grado di gestire codifica, documentazione, ricerca, attività di lunga durata e agenti visivi. GPT-5.6 Sol potrebbe comunque rappresentare la soluzione migliore per i carichi di lavoro in cui le sue capacità di ragionamento e i risultati finali più efficaci si adattano al proprio ambiente. Fable 5 merita un'analisi più approfondita per le attività di collaborazione e quelle che richiedono un uso intensivo dell'interfaccia utente; il Confronto tra Fable 5 e Opus 4.8 fornisce ulteriori chiarimenti su quella parte della decisione.
I pesi aperti previsti per il modello potrebbero rivelarsi il suo principale vantaggio strutturale. Oggi contano soprattutto le prestazioni basate esclusivamente sull’API, ma i pesi scaricabili offrono possibilità di ottimizzazione, infrastrutture private, ricerca e implementazione a livello regionale. Il valore finale dipenderà dalla licenza rilasciata, dai formati dei pesi, dal supporto alla quantizzazione e dall’hardware necessario per eseguire il modello a una velocità adeguata.
Prezzi API Qwen3.8-Max
Qwen ha indicato i seguenti prezzi di lancio nel suo comunicato ufficiale:
Una stima approssimativa è la seguente:
costo stimato = input non memorizzato nella cache × $2/M + input memorizzato nella cache × $0,25/M + output × $6/M
Ad esempio, un'esecuzione che utilizzi 10 milioni di token di input non memorizzati nella cache e 2 milioni di token di output costerebbe circa $32 alle tariffe di lancio, al netto di eventuali costi addebitati da altre piattaforme: $20 per l'input più $12 per l'output. Un agente che rilegge un repository di grandi dimensioni ad ogni turno può spendere molto di più, il che rende la memorizzazione nella cache e la gestione del contesto importanti quanto il prezzo di input indicato.
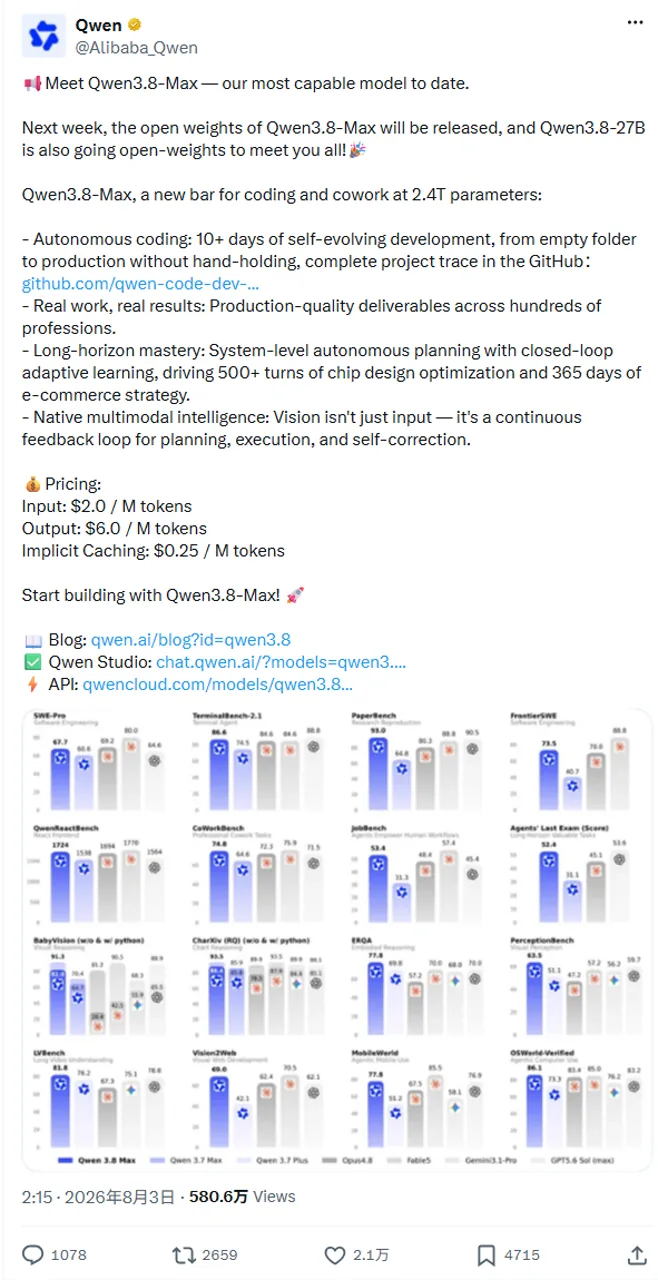
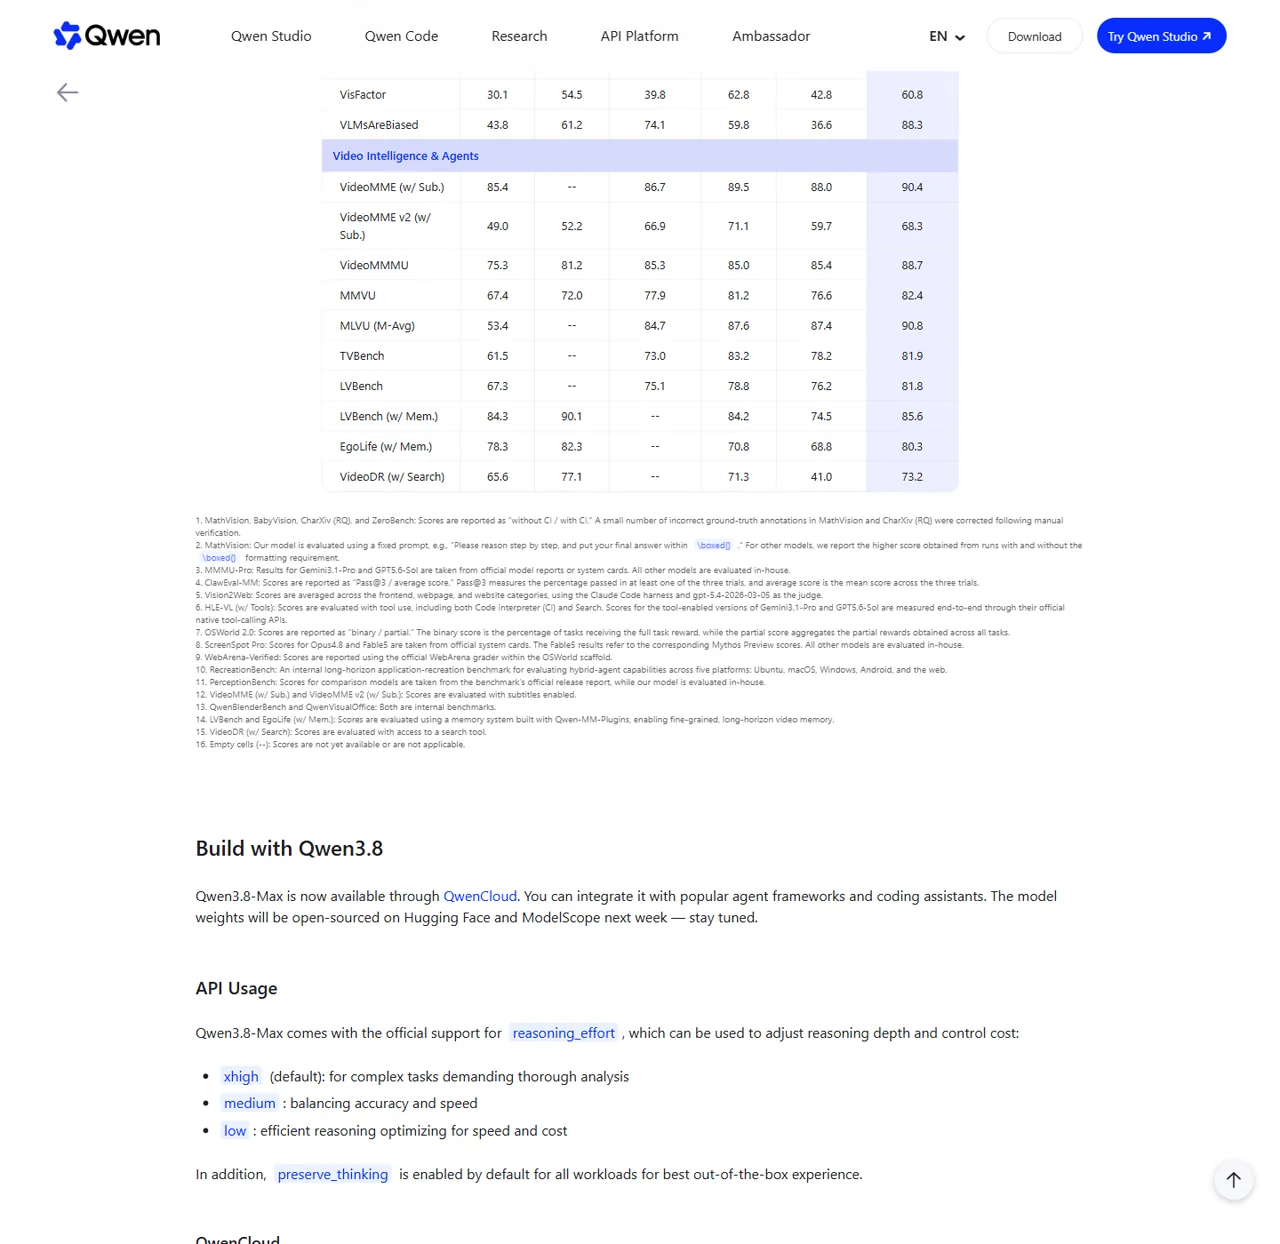
Qwen3.8-Max supporta anche sforzo_di_ragionamento comandi. La sezione ufficiale dedicata alle API elenca xhigh come impostazione predefinita per l'analisi complessa, medio per trovare il giusto equilibrio tra precisione e velocità, e basso per lavorare in modo più veloce ed efficiente. preservare_il_pensiero è abilitato per impostazione predefinita. Questi controlli possono ridurre i costi, ma dovrebbero essere valutati in base alla qualità delle attività piuttosto che essere considerati modalità intercambiabili.
Anche la valutazione dei prezzi tra diversi fornitori richiede la stessa cautela. Un modello con una tariffa per token più bassa può comunque risultare più costoso se richiede prompt più lunghi, un maggior numero di tentativi o chiamate aggiuntive agli strumenti. Il Guida ai prezzi dell'API Gemini 3.1 Pro è un esempio calzante del motivo per cui la lunghezza del contesto e i livelli di utilizzo sono importanti, oltre al tasso di base.
Come accedere a Qwen3.8-Max
1. Utilizzare Qwen Studio per una valutazione diretta
Il percorso più veloce per un primo sguardo è Qwen Studio. Inizia con un compito concreto piuttosto che con una domanda di cultura generale: proponi un brief disordinato, un problema di programmazione che coinvolge più file, una serie di documenti o un flusso di lavoro basato su immagini. Verifica se il risultato è accurato, modificabile e sufficientemente completo da consentire un risparmio di tempo.
2. Utilizzare l'API QwenCloud per le applicazioni
Qwen3.8-Max è disponibile tramite QwenCloud. La pagina dedicata al rilascio indica che la sua API supporta protocolli di completamento delle chat e di risposta conformi agli standard del settore e compatibili con le specifiche OpenAI, oltre a un'interfaccia compatibile con Anthropic. Ciò semplifica la migrazione, ma è comunque consigliabile verificare i nomi dei modelli, i parametri, il comportamento di streaming, gli schemi degli strumenti e la gestione degli errori nella documentazione ufficiale.
3. Collegarlo agli strumenti di programmazione e agli strumenti per gli agenti
La pagina di rilascio di Qwen include integrazioni per Qwen Code, Claude Code, Codex e OpenClaw. Il modello può quindi inserirsi in un flusso di lavoro esistente di terminali o agenti senza richiedere una nuova interfaccia. Il supporto all’integrazione non elimina il costo dello strumento correlato, pertanto è opportuno confrontare il costo del modello con quello separato Struttura dei prezzi di Codex prima di standardizzare il flusso di lavoro di un team.
Gli utenti del codice Claude dovrebbero inoltre separare il costo del prodotto di codifica dall'API del modello esterno. I piani disponibili e le modalità di fatturazione sono riassunti nel Guida ai prezzi con codice Claude.
Gli utenti di OpenClaw si pongono un’ulteriore domanda: quale modello offre il miglior equilibrio tra utilizzo degli strumenti, velocità e prezzo per un determinato agente? Il Confronto tra i modelli OpenClaw fornisce un quadro pratico per effettuare tale scelta, invece di ricorrere automaticamente al modello più grande.
4. Garantire l'integrità del flusso di lavoro multimodello
Al momento del lancio, QwenCloud rappresenta il percorso di produzione verificato per Qwen3.8-Max. Se si confrontano anche le alternative GPT, Claude, Gemini o Fable, il Area di lavoro multimodello GlobalGPT può ridurre il passaggio da una scheda all'altra tra i modelli supportati. Utilizzare la pagina ufficiale dedicata al modello Qwen per il modello Qwen3.8-Max fino a quando non sarà verificata l'esistenza di una pagina dedicata al modello GlobalGPT; non dare per scontato che esista un nuovo URL per il modello solo perché quest'ultimo è stato annunciato.
Qwen3.8 - Pesi massimi a pieno carico
Qwen ha annunciato che i pesi Qwen3.8-Max sarebbero stati messi in vendita nella settimana successiva al lancio del 3 agosto. Lo stesso post ufficiale su X ha inoltre affermato che il modello Qwen3.8-27B sarebbe diventato open-weight. Si tratta di una buona notizia per l'implementazione e la ricerca a livello locale, ma l'annuncio da solo non è sufficiente per pianificare un cluster di produzione.
Prima di scaricare o preventivare l'hardware, verificare i cinque elementi riportati nella scheda del modello definitivo:
- I termini esatti della licenza e dell'uso commerciale.
- URL ufficiali dei repository di Hugging Face o ModelScope.
- Formati di precisione e quantizzazione disponibili.
- Requisiti minimi e consigliati per CPU, GPU, RAM e spazio di archiviazione.
- Se il modello generato corrisponde al comportamento dell'API ospitata e alla lunghezza del contesto.
“I termini ”open weight“ e ”open source” non sono sempre sinonimi. Il termine “open weight” indica che i parametri del modello possono essere scaricati; è la licenza a determinare cosa è possibile modificare, ridistribuire o utilizzare a fini commerciali. Finché i repository e la licenza non saranno disponibili, le pagine che promettono il download di Qwen3.8-Max, la build GGUF o requisiti hardware locali precisi stanno anticipando i fatti.
L'annuncio relativo al modello 27B dovrebbe essere trattato allo stesso modo. Potrebbe diventare la scelta più realistica per gli utenti locali, ma i dati relativi all'architettura, alla lunghezza del contesto, ai requisiti di memoria e ai punteggi dei benchmark dovrebbero provenire dalla scheda tecnica ufficiale del modello stesso, senza essere copiati da quella del modello Max.
Qwen3.8 - Limiti massimi e soluzione ottimale
Limiti da tenere in considerazione
- La maggior parte delle prove relative al lancio proviene da Qwen. Le valutazioni indipendenti possono avvalersi di indicazioni, strumenti o criteri di valutazione diversi.
- Il contesto esteso non equivale a una memoria perfetta. Un modello può elaborare 1 milione di token e tuttavia trascurare un dettaglio o seguire un'istruzione poco chiara.
- Gli agenti che generano un volume elevato di output possono risultare costosi. Il tasso di output di $6 per milione è rilevante quando un flusso di lavoro genera codice di grandi dimensioni, report o tracce di ragionamento ripetute.
- I dettagli relativi all'implementazione locale non saranno completi fino all'arrivo dei pesi e della scheda del modello. Un sistema 2.4T a parametri totali non funzionerà come un piccolo modello da tavolo.
- L'uso degli strumenti aggiunge un ulteriore livello di rischio di errore. Lo stato del browser, le autorizzazioni, gli errori di rete e gli schemi degli strumenti definiti in modo inadeguato possono compromettere il funzionamento di un modello che altrimenti sarebbe efficace.
- Le informazioni relative al lancio cambiano rapidamente. Prima della pubblicazione o dell'acquisto è opportuno verificare nuovamente i prezzi, gli archivi, le integrazioni e la disponibilità.
Chi dovrebbe provarlo adesso?
Il punto è semplicemente questo: Qwen3.8-Max merita un test approfondito, ma non una migrazione alla cieca. Utilizzate un’attività impegnativa con una chiara condizione di successo, registrate il numero totale di token e di tentativi, e confrontate il risultato finale, non solo la prima risposta.
Domande frequenti
Quando è stato lanciato Qwen 3.8 Max?
Qwen3.8-Max è stato annunciato ufficialmente il 3 agosto 2026. Il modello ospitato è stato reso disponibile tramite Qwen Studio e QwenCloud al momento del lancio. Qwen ha dichiarato che i pesi aperti sarebbero stati rilasciati la settimana successiva, pertanto la disponibilità dell’API e quella dei pesi scaricabili dovrebbero essere considerate come tappe separate.
Qwen3.8-Max è open source?
Qwen ha annunciato la versione “open weights” per Qwen3.8-Max, ma saranno il repository definitivo e la licenza a determinare ciò che gli utenti potranno eseguire, modificare, ridistribuire o utilizzare a fini commerciali. Finché tali file non saranno disponibili online e verificati, l'affermazione "annunciata la versione 'open weights'" è più accurata rispetto al presupposto che ogni autorizzazione open source o formato locale sia già disponibile.
Quanti parametri ha il modello Qwen3.8-Max?
Qwen3.8-Max ha un totale di 2,4 trilioni di parametri e ne attiva 95 miliardi per ogni token. Utilizza un’architettura “mixture-of-experts”, pertanto il numero totale di parametri e quello dei parametri attivi descrivono parti diverse del sistema. Nessuna delle due cifre, da sola, è in grado di prevedere la velocità effettiva o il fabbisogno hardware.
Che cos’è la finestra di contesto Qwen3.8-Max?
Il comunicato ufficiale indica una finestra di contesto di 1 milione di token. Si tratta di una dimensione sufficientemente ampia per codice esteso, documenti, output degli strumenti e cronologia degli agenti, ma il contesto massimo non garantisce un recupero perfetto. Verifica il modello in base alla posizione, al formato e alla densità delle informazioni utilizzate nel tuo flusso di lavoro effettivo.
Quanto costa l'API Qwen3.8-Max?
Al momento del lancio, Qwen indicava $2 per milione di token in ingresso, $6 per milione di token in uscita e $0,25 per milione di token memorizzati implicitamente nella cache. Considerateli come prezzi di lancio e verificateli prima di definire il budget. I costi degli agenti dipendono anche dal riutilizzo del contesto, dallo sforzo di ragionamento, dai tentativi di ripetizione e dalla lunghezza degli output generati.
Il modello Qwen3.8-Max è migliore del GPT-5.6 Sol o del Fable 5?
Non in tutti i test. La tabella ufficiale di Qwen mostra che il modello Qwen3.8-Max è in testa in alcuni benchmark relativi alla programmazione, alla ricerca, all’esecuzione di istruzioni e all’uso del computer, mentre il GPT-5.6 Sol o il Fable 5 sono in testa in altri. Il modello migliore dipende dall’attività, dall’ambiente di lavoro, dalla latenza, dal prezzo e dalla qualità del risultato finale.
Posso eseguire Qwen3.8-Max in locale?
Qwen ha annunciato la disponibilità di pesi scaricabili per la settimana successiva al lancio, ma la fattibilità a livello locale dipenderà dai file definitivi, dalla precisione, dal supporto alla quantizzazione, dalla licenza e dalle indicazioni relative all’hardware. È consigliabile attendere la scheda tecnica ufficiale del modello prima di fare affidamento su stime precise relative a RAM, VRAM o spazio di archiviazione. Le varianti più piccole, come la Qwen3.8, potrebbero rivelarsi più pratiche una volta documentate ufficialmente.
Che cos'è il Qwen3.8-27B?
Il post di lancio di Qwen indica che anche la versione Qwen3.8-27B sarà rilasciata con pesi aperti. L'articolo sul rilascio di Max non fornisce dettagli sufficienti per riutilizzare le specifiche del modello Max nella versione 27B. Consultare la scheda dedicata al modello per informazioni su architettura, finestra di contesto, benchmark, licenza e istruzioni per il download.
Posso utilizzare il modello Qwen3.8-Max sul modello GlobalGPT?
Al momento della pubblicazione non era stata verificata l'esistenza di un percorso GlobalGPT dedicato per Qwen3.8-Max. Utilizzare Qwen Studio o QwenCloud per l'accesso diretto. GlobalGPT rimane utile per confrontare altri modelli GPT, Claude, Gemini e Fable disponibili senza dover cambiare piattaforma.
Verdetto finale
Utilizzare Qwen Studio o QwenCloud per una valutazione diretta di Qwen3.8-Max. Utilizzare GlobalGPT per confrontare altri modelli verificati, senza dare per scontato che esista già un percorso dedicato per Qwen3.8-Max.
Confronta i modelli disponibiliQwen 3.8 Max è uno dei lanci di modelli più ambiziosi del 2026: 2,4 trilioni di parametri totali, 95 miliardi di parametri attivi, una finestra di contesto da 1 milione di token, ottimi risultati ufficiali in ambito di programmazione e agenti multimodali, e un percorso di pesi aperti già annunciato. Il prezzo dell’API al momento del lancio è sufficientemente competitivo da consentirne la sperimentazione, soprattutto quando la memorizzazione nella cache riduce i costi legati alla ripetizione del contesto.
Il motivo principale per cui vale la pena interessarsene non è la vittoria in un singolo benchmark. È piuttosto il tentativo di combinare in un unico modello la programmazione, i risultati professionali, la pianificazione a lungo termine, il feedback visivo e l’uso degli strumenti. Iniziate con Qwen Studio o con una valutazione controllata di QwenCloud, misurate la qualità delle attività completate e il costo totale, e attendete i pesi ufficiali e la licenza prima di fare promesse relative all’implementazione locale.
Fonti primarie consultate il 4 agosto 2026: Versione ufficiale Qwen3.8-Max e Post ufficiale di lancio di @Alibaba_Qwen.