Un unico modello è in grado di ricreare l'intero panorama sonoro.
Seed Audio 1.0 è in grado di combinare voce, effetti sonori, rumori ambientali, tempistiche e musica strumentale. I nostri test hanno evidenziato un potenziale creativo insolitamente elevato, ma anche un problema di ripetibilità che non va ignorato.
Seed Audio 1.0 è uno dei primi modelli audio che ho testato che sembra essere stato progettato intorno a una scena completa piuttosto che a un singolo tipo di output. È in grado di parlare, recitare, aggiungere effetti ambientali, creare effetti sonori (Foley), inserire dialoghi su una timeline e produrre musica strumentale a partire da un unico prompt.
Il verdetto in breve: Seed Audio 1.0 offre un potenziale insolitamente elevato per la creazione audio integrata, in particolare per i dialoghi sincronizzati e le scene sonore cinematografiche. Il suo punto debole è la ripetibilità. Un'esecuzione ben riuscita può risultare straordinariamente completa, mentre un'altra esecuzione basata sullo stesso prompt potrebbe presentare un'elocuzione confusa, tralasciare un evento o modificare la voce richiesta.
Ho generato 23 campioni valutati tramite l'ambiente di test Anywhere/BrolyAI. Nel loro insieme, questi campioni coprivano la narrazione, dialoghi tra due personaggi, discorsi con indicazione temporale, sequenze composte esclusivamente da effetti sonori, scene con voce e musica, brani musicali autonomi, performance multilingue, monologhi di due minuti e continuazione di audio di riferimento.
Recensione di Seed Audio 1.0: il verdetto in breve
| Categoria | Risultati dei nostri test |
|---|---|
| Voce espressiva | Alta qualità nella corsa migliore, ma prestazioni incostanti nelle ripetute |
| Dialogo tra più personaggi | Script accurati e ottima separazione delle voci |
| Tempistica dei dialoghi | La caratteristica più affidabile nel nostro set di test |
| Effetti sonori | Rappresentazione realistica dello spazio e dell'ordine degli eventi; scarse capacità nel conteggio esatto degli eventi |
| Voce + effetti sonori + musica | Scene complete e convincenti in cui ogni evento previsto si verifica |
| Musica autonoma | Più efficiente del previsto; ha generato segnali strutturati della durata di 30 secondi |
| Voce multilingue | Un caso eccellente, ma in una delle due esecuzioni si è verificato un dialogo in più non previsto |
| Audio di due minuti | Una forte identità vocale e una coerenza narrativa in entrambe le sessioni |
| Audio di riferimento | Risultato inaffidabile nella nostra sede di test; la somiglianza vocale era scarsa |
Ideale per: creatori che realizzano radiodrammi, scene di videogiochi, idee per podcast, prototipi cinematografici e storyboard incentrati sull’audio.
Meno indicato per: attività che richiedono una formulazione deterministica, un conteggio esatto di eventi ripetuti o una clonazione affidabile della voce ottenuta da un'unica generazione automatica.
Che cos’è Seed Audio 1.0?
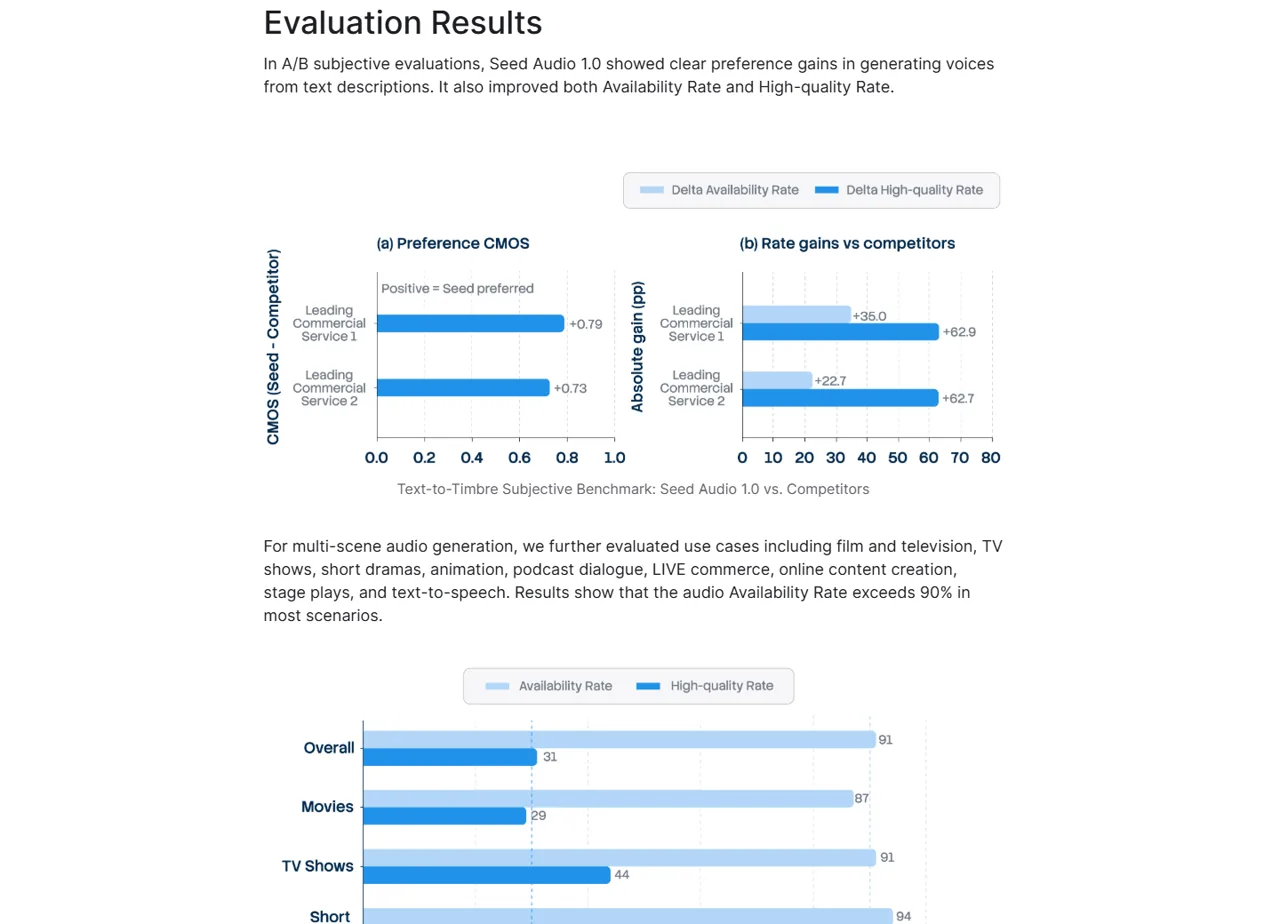
Seed Audio 1.0 è il modello unificato di creazione da testo ad audio di ByteDance Seed. Anziché trattare la voce, l’ambiente sonoro, gli effetti e la musica come elementi separati, è in grado di generarli insieme come un’unica scena sonora. La pagina ufficiale del prodotto indica che supporta la sincronizzazione dei dialoghi a intervalli di 100 millisecondi e può generare fino a due minuti di audio in un unico passaggio.
È proprio quel design coerente a costituire il vero punto di forza. Una descrizione può indicare chi parla, come suona la sua voce, cosa accade nella stanza, quali effetti vengono inseriti in seguito e quale tipo di musica fa da sottofondo alla scena. Quando tutto funziona bene, il risultato sembra il frutto di una composizione ben studiata, piuttosto che di un insieme di elementi messi insieme alla bell’e meglio.
C'è però un limite importante. Secondo la roadmap di ByteDance, la sincronizzazione dettagliata si concentra attualmente soprattutto sui dialoghi dei personaggi. Un controllo più preciso sugli effetti sonori, i rumori di sottofondo e la musica rimane un ambito da sviluppare ulteriormente. I nostri test hanno confermato questa distinzione: la sincronizzazione dei dialoghi era eccellente, mentre la precisione nel conteggio dei rumori di sottofondo era meno affidabile.
Fonti ufficiali verificate il 6 agosto 2026:
- Pagina del prodotto Seed Audio 1.0
- Presentazione di ByteDance Seed
- Documentazione dell'API BytePlus Audio 1.0
- Prezzi di BytePlus Audio 1.0
Come abbiamo testato Seed Audio 1.0
Abbiamo progettato nove attività e eseguito 23 generazioni valutate. La maggior parte dei test di capacità prevedeva due o tre ripetizioni, poiché un unico campione perfezionato fornisce informazioni molto limitate sull’affidabilità produttiva.
| Prova | Compito | Corse |
|---|---|---|
| T01 | Narrazione espressiva in inglese | 3 |
| T02 | Dialogo radiofonico tra due personaggi | 3 |
| T03 | Dialogo a 0, 4 e 9 secondi | 3 |
| T04 | Sequenza nel corridoio con soli effetti sonori | 2 |
| T05 | Voci, effetti ambientali, effetti sonori e musica | 3 |
| T06 | Musica strumentale autonoma | 3 |
| T07 | Un carattere comune all'inglese, al giapponese e al tedesco | 2 |
| T08 | Monologo di 120 secondi in un podcast | 2 |
| T09 | Proseguimento da una voce di riferimento | 2 |
I 23 output previsti contenevano circa 12,5 minuti di audio generato e hanno registrato un costo di generazione a monte pari a $1.7504 nell'ambiente di test. Seed Audio non ha fornito dati sull'utilizzo dei token di testo. La fatturazione si è basata sui secondi generati, pertanto i token di generazione sono stati registrati come "non applicabili".
Tutti i file di output valutati erano file WAV PCM stereo a 40 kHz e 16 bit. Quando la riproduzione automatica diretta non era disponibile, Gemini 3.6 Flash riceveva i file WAV come input audio e restituiva trascrizioni strutturate, verifiche degli eventi, stime temporali e note sugli artefatti. Tali valutazioni sono analisi automatiche dell’ascolto, non punteggi MOS assegnati da esseri umani.
Generazione della voce: alti impressionanti, ripetibilità incostante
T01 · Narrazione espressiva
Elevata varianzaUna versione sembrava un discorso in più frutto di un'allucinazione, un'altra suonava artificiosa, mentre un'altra ancora era naturale e completa.
Prompt utilizzato
Una voce femminile dal tono pacato pronuncia due frasi precise, passando da un tono preoccupato a uno sicuro. Nessuna musica né effetti sonori.Le indicazioni per la narrazione richiedevano che una voce femminile dal tono pacato pronunciasse due frasi identiche, passando da una preoccupazione contenuta a una crescente sicurezza, senza alcun rumore di sottofondo.
Le tre serie hanno dato risultati molto diversi:
- Gara 1: ha pronunciato la frase richiesta, poi ha proseguito con alcuni secondi di discorso confuso e improvvisato.
- Gara 2: Ha pronunciato il testo esatto, ma con un tono lento e a scatti.
- Terna 3: ha recitato l'intero copione in modo naturale, con un ritmo perfetto e una voce sempre coerente.
Questo è il principio fondamentale della recensione. Seed Audio 1.0 è in grado di produrre una resa vocale di grande impatto, ma un unico ciclo non è sufficiente per lavori in cui la formulazione è fondamentale. Generate delle alternative e ascoltate l’intera sequenza prima di pubblicarla.
Il modello ha rispettato le istruzioni negative in tutte e tre le sessioni di narrazione: non sono stati rilevati né musica, né effetti sonori, né rumori di sottofondo indesiderati.
Dialoghi con più personaggi e separazione dei parlanti
T02 · Radiodramma a due personaggi
3/3 script esattiTutte e tre le sceneggiature erano identiche. Il rumore di sottofondo e la durata dell’introduzione variavano da una ripresa all’altra.
Prompt utilizzato
Maya sussurra, Eli risponde con calma e il ronzio del frigorifero fa da sottofondo a tre battute fisse del dialogo.La scena ambientata nel minimarket prevedeva due personaggi adulti e tre battute fisse. Maya doveva sussurrare con tono teso, mentre Eli cercava di sembrare calmo. L’unico rumore di sottofondo richiesto era un leggero ronzio del frigorifero.
In tutte e tre le riproduzioni i dialoghi sono stati riprodotti nell'ordine corretto con due voci distinte. La riproduzione migliore ha combinato battute esatte, una netta separazione tra i parlanti, un'emozione convincente e un ronzio continuo del frigorifero.
Le altre registrazioni presentavano problemi minori a livello di scena. In una, circa la prima metà dei 30 secondi di durata era dedicata ai rumori di sottofondo prima dell’inizio del dialogo. In un’altra mancava il ronzio del frigorifero richiesto. Nessuno dei due errori ha compromesso la scena dialogata, ma entrambi riducono l’efficienza del montaggio.
Per quanto riguarda i radiodrammi, il risultato pratico è incoraggiante: Seed Audio è in grado di cogliere i cambiamenti dei personaggi e i contrasti vocali. Potrebbe comunque essere necessario tagliare le introduzioni troppo lunghe o rigenerare il file per ottenere il giusto rumore di fondo.
La sincronizzazione dei dialoghi è stato il risultato migliore
T03 · Tempi a livello di prompt
Il più affidabileIn tutte e tre le esecuzioni, le linee sono state posizionate in prossimità dei punti richiesti, entro i limiti dell’incertezza temporale del valutatore.
Prompt utilizzato
Inserisci tre linee radio a 0,0, 4,0 e 9,0 secondi con voci maschili/femminili/maschili.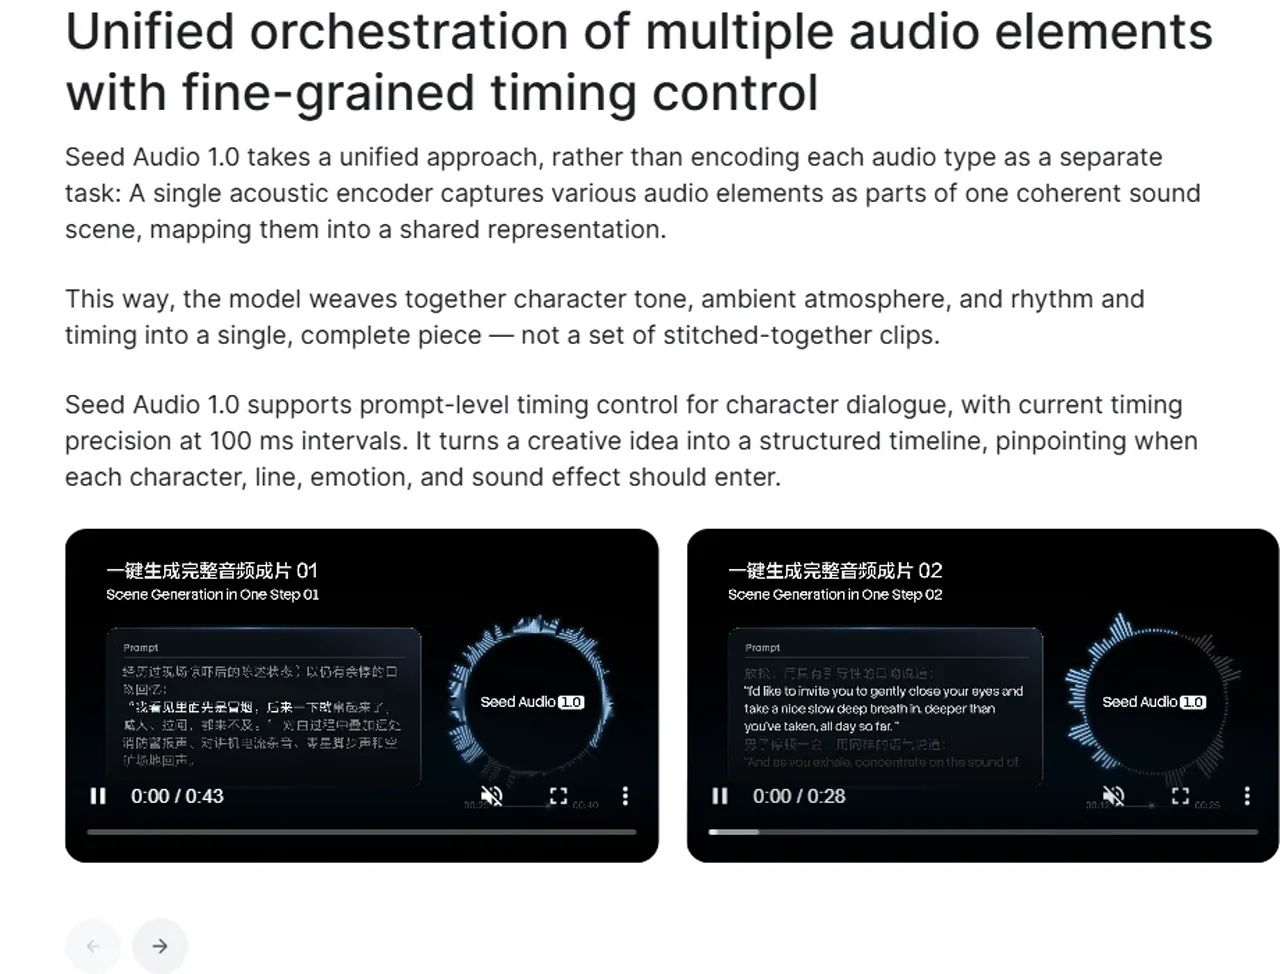
Il test di temporizzazione richiedeva tre linee radio:
- “Unità sette, in rapporto.” a 0,0 secondi.
- “Ingresso nord sotto controllo.” a 4,0 secondi.
- “Mantenere la posizione.” a 9,0 secondi.
In tutte e tre le esecuzioni, le linee, l’ordine e la sequenza di parlanti (maschio-femmina-maschio) erano corretti. Le stime audio di Gemini hanno individuato gli inizi delle esecuzioni ripetute intorno a 0,1, 4,0 e 9,0 secondi. La prima serie è stata stimata a circa 0,1, 3,9 e 8,9 secondi.
Tali misurazioni non dovrebbero essere presentate come prove di precisione da 100 millisecondi a livello di laboratorio: lo stesso valutatore ha indicato un’incertezza di circa 0,1 secondi. Anche tenendo conto di questa precisazione, si è trattato della funzionalità più ripetibile tra quelle che abbiamo testato. Se avete bisogno che i dialoghi vengano inseriti in posizioni vicine a quelle previste nella timeline, Seed Audio 1.0 è particolarmente promettente.
Generazione di effetti sonori: scene realistiche, conteggio imperfetto
T04 · Corridoio con soli effetti sonori
Conteggio non riuscitoLo spazio e l'ordine erano convincenti, ma le due serie hanno prodotto quattro passi e due passi.
Prompt utilizzato
Chiavi, una porta pesante, esattamente tre passi, un rombo e un ultimo sbattere. Nessuna voce né musica.Il prompt, che prevedeva solo effetti sonori, descriveva un piccolo corridoio piastrellato: chiavi vicino al microfono, una pesante porta di legno che si apriva, tre passi lenti che si allontanavano, un tuono in lontananza e, infine, uno sbattere di porta. Erano vietati sia i dialoghi che la musica.
Entrambe le uscite hanno ricreato uno spazio acustico credibile, hanno mantenuto l'ordine degli eventi e hanno evitato la fuoriuscita di voci o musica. Gli effetti sono stati giudicati realistici, con una buona percezione della distanza e una buona coerenza ambientale.
Nessuna delle due sequenze ha rispettato esattamente il conteggio. Una ha prodotto quattro passi; l’altra ne ha prodotti due. Ciò rende Seed Audio utile per generare un effetto sonoro convincente, ma meno affidabile quando un montatore ha bisogno esattamente di tre impatti, colpi, passi o spari.
Il flusso di lavoro ottimale consiste nell'utilizzare la generazione SFX in un unico passaggio per creare l'atmosfera e realizzare prototipi rapidi, per poi sostituire o modificare gli eventi in cui il conteggio è fondamentale all'interno di una DAW.
Voce, effetti ambientali, effetti sonori e musica in un'unica scena
T05 · Mix cinematografico completo
Completato al 2/3Due su tre hanno completato ogni mossa. Uno ha mancato l'ultimo colpo metallico.
Prompt utilizzato
Un vicolo bagnato dalla pioggia, traffico, una sirena, la voce sussurrata di un detective, un ritmo di archi, passi veloci e uno schianto metallico.
Il test della scena completa era volutamente ricco di elementi. Richiedeva un vicolo notturno bagnato, gocce d’acqua, traffico, una sirena della polizia in movimento, una battuta sussurrata da un detective, archi sommessi, passi rapidi e lo sbattere metallico di una porta.
Due delle tre esecuzioni hanno riprodotto la sequenza completa dell’evento. I dialoghi sono rimasti chiari nonostante il rumore di fondo e la musica, e la scena è risultata spazialmente coerente, anziché sembrare una serie di clip non collegate tra loro sovrapposte. In una delle esecuzioni è mancato lo schianto metallico finale, nonostante per il resto fosse stata ricreata l’atmosfera giusta e le battute fossero state pronunciate correttamente.
È proprio in questo ambito che il modello unificato dimostra appieno il proprio valore. Per lo storyboard e l’ideazione creativa, generare un’intera scena mista a partire da un unico prompt è più veloce e più espressivo rispetto a procurarsi ogni componente separatamente. Per la produzione finale, gli elementi chiave devono comunque essere verificati.
Can Seed Audio 1.0 è in grado di generare musica?
T06 · Musica autonoma
Opere musicaliTutti e tre hanno composto musica strutturata. Uno di loro ha reso difficile distinguere il suono del pianoforte con il sordino.
Prompt utilizzato
Un brano di suspense a 72 BPM con ostinato di violoncello, pianoforte con sordina, drone analogico, crescendo e finale in sospeso.
Sì. Nei nostri test, Seed Audio 1.0 ha generato musica strumentale autonoma e riconoscibile, anziché limitarsi a creare una vaga atmosfera ambientale.
La richiesta prevedeva un brano di suspense di 30 secondi a 72 BPM con un ostinato di violoncello in registro grave, impulsi di pianoforte con sordina, un leggero drone analogico, un crescendo ben definito e un accordo finale irrisolto. Tutte e tre le versioni hanno dato vita a un brano musicale coerente, con il tempo e il finale richiesti. Due di esse includevano tutti gli elementi richiesti; in una delle versioni, il pianoforte con sordina era difficile da distinguere.
Ciò non rende automaticamente Seed Audio un sostituto di un generatore di brani dedicato. Il nostro obiettivo era realizzare un breve brano strumentale di tipo cinematografico, non una canzone con strofa e ritornello e testo. Tuttavia, le funzionalità musicali sono sufficientemente avanzate da supportare scene di videogiochi, trailer, podcast e previsualizzazioni, specialmente quando la musica deve interagire con il parlato e il sound design nella stessa fase di generazione.
Prestazioni multilingue: eccellenti nel caso migliore, scarse nel caso peggiore
T07 · Una sola voce, tre lingue
1/2 pulitoUna esecuzione è stata impeccabile; l’altra ha presentato ripetizioni e distorsioni nel discorso in corrispondenza del cambio di lingua.
Prompt utilizzato
Un personaggio femminile parla inglese, giapponese e tedesco con la stessa naturalezza e la stessa calma.
Il compito multilingue prevedeva che un personaggio femminile interpretasse lo stesso ruolo in inglese, giapponese e tedesco. Le due registrazioni hanno suscitato impressioni opposte.
L'esecuzione migliore ha riprodotto accuratamente tutte e tre le frasi, ha mantenuto lo stesso tono di voce, ha conservato un'emotività pacata e ha utilizzato pause ben definite. L'esecuzione peggiore è partita correttamente in inglese, ma poi ha ripetuto e distorto il discorso nella sezione in giapponese, compromettendo l'inizio in tedesco. La percezione della coerenza del tono di voce tra le diverse lingue è diminuita drasticamente.
Ciò significa che Seed Audio 1.0 è in grado di produrre interpretazioni convincenti di personaggi multilingue, ma questa funzionalità richiede la presenza di più candidati e una revisione che tenga conto delle specificità linguistiche. Non approvare un output multilingue limitandosi a verificare solo la prima lingua.
Generazione in due minuti e stabilità delle registrazioni vocali di lunga durata
T08 · Monologo di 120 secondi
2/2 stabileEntrambi i file hanno raggiunto i 120 secondi con una voce stabile. In uno si è verificato un breve esitazione nella pronuncia.
Prompt utilizzato
Un conduttore di podcast racconta una storia ben strutturata su una stazione meteorologica, con tre scoperte e senza alcun contesto.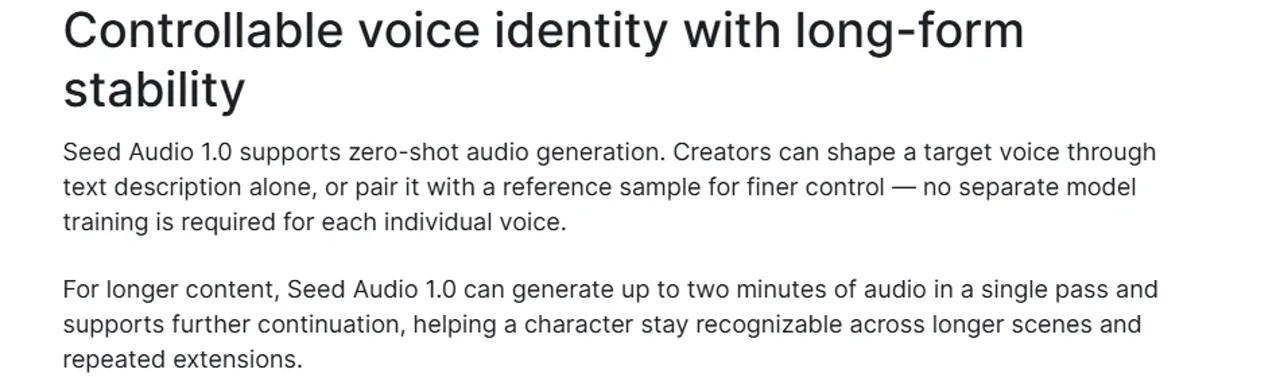
Entrambe le attività di lunga durata hanno prodotto file WAV della durata esatta di 120 secondi. Ciascuna prevedeva la voce di un conduttore di podcast di sesso maschile con audio da studio "secco", senza musica né effetti sonori.
La prima versione ha mantenuto per tutto il testo una voce unica e una struttura narrativa coerente: un’introduzione chiara, tre scoperte in ordine cronologico, un passaggio dalla curiosità al disagio e un interrogativo finale lasciato in sospeso. Non sono state rilevate evidenti variazioni di tono né segmenti confusi.
Anche la seconda esecuzione è risultata coerente e stabile, con un breve intoppo nella pronuncia intorno all’1:31. Si tratta di un risultato eccellente per un monologo di due minuti registrato in un’unica ripresa. Ciò suggerisce che l’affermazione di Seed Audio riguardo ai contenuti di lunga durata non sia semplicemente un limite di durata; il modello è in grado di mantenere l’identità e la struttura narrativa per l’intera durata del monologo.
La continuità audio di riferimento richiede cautela
T09 · Proseguimento del riferimento
Percorso incertoIl testo era esatto, ma la somiglianza vocale era scarsa; in un caso il risultato è stato modificato in una voce maschile e sono stati aggiunti effetti sonori.
Prompt utilizzato
Proseguire sulla scia di una voce femminile di riferimento autorizzata, preservando al contempo l’identità vocale e lo stile di registrazione intimo.Il test di riferimento ha utilizzato il campione narrativo più incisivo come input autorizzato e ha richiesto una continuazione che mantenesse la stessa identità femminile generale e lo stesso stile di registrazione intimo.
Entrambe le uscite hanno riprodotto esattamente il testo richiesto, ma nessuna delle due corrispondeva bene al riferimento. La prima è passata a un sussurro soffocato e ha ottenuto un punteggio di somiglianza vocale moderato pari a 2/5. La seconda è stata giudicata come una voce maschile, ha ottenuto un punteggio di somiglianza pari a 1/5 e ha aggiunto circa 17 secondi di effetti sonori indesiderati prima di iniziare a parlare.
In questo caso vi è un’importante limitazione legata all’ambiente. L’endpoint dell’attività Anywhere ha accettato il campo di riferimento, ma non ha restituito alcuna conferma che indicasse in che modo il modello a monte avesse utilizzato tale riferimento. Questi risultati dimostrano che la continuità del riferimento non era affidabile lungo il nostro percorso di test; non dimostrano invece che l’API nativa di BytePlus si comporti sempre allo stesso modo.
Prezzi e limiti di Seed Audio 1.0
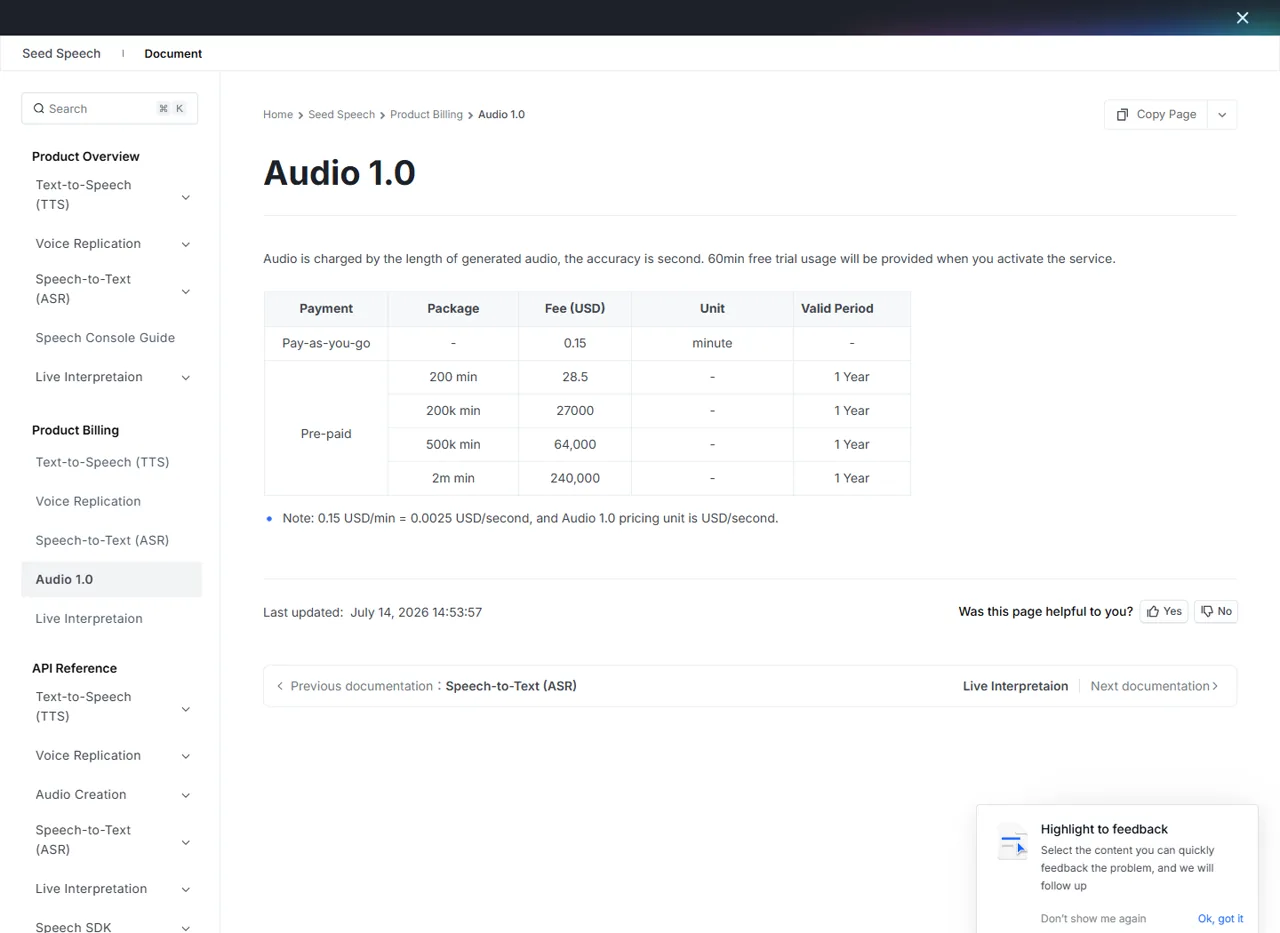
Addebito al secondo, con 60 minuti di prova gratuiti all’attivazione del servizio.
potenza massima
caratteri di prompt
riferimenti audio
immagine di riferimento
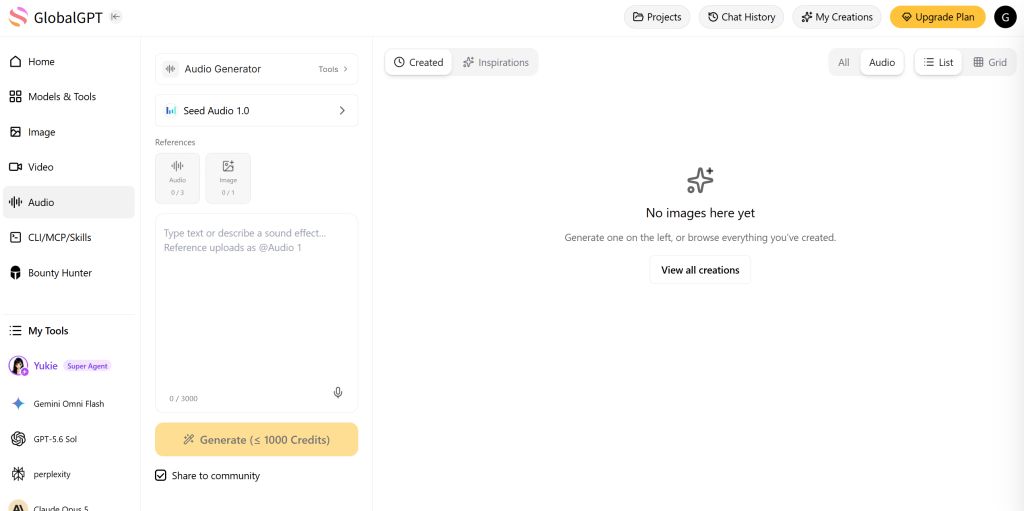
BytePlus indica il prezzo ufficiale del servizio a consumo a $0,15 per ogni minuto generato, addebitato al secondo, con 60 minuti di prova gratuita quando il servizio viene attivato. La documentazione dell'API specifica un Potenza massima per 120 secondi, supporta prompt fino a 3.000 caratteri, consente fino a tre clip audio di riferimento, e accetta un'immagine di riferimento.
Ogni clip audio di riferimento può avere una durata massima di 30 secondi e una dimensione massima di 10 MB. Il limite per le immagini di riferimento è di 10 MB. Si tratta di limiti propri di BytePlus; le piattaforme di terze parti potrebbero presentare un modulo di inserimento dati più ridotto o applicare tariffe diverse.
Il nostro percorso di test Anywhere/BrolyAI ha riportato separatamente i costi a monte, con una media di circa $0,14 per minuto generato. Tale campo relativo all’ambiente di test non deve essere confuso con i prezzi al dettaglio di BytePlus o con il prezzo finale di un’altra piattaforma.
Pro e contro di Seed Audio 1.0
I suoi punti di forza
- Voce, effetti sonori, rumori di sottofondo e musica integrati
- Ottimo tempismo nei dialoghi
- Una forte identità di lungo respiro
- Musica da film utile
Dove si rompe
- Elevata varianza tra i campionamenti
- Discorso occasionalmente incomprensibile
- Conteggio esatto debole degli effetti speciali (SFX)
- Continuità dei riferimenti inaffidabile lungo il nostro percorso
Pro
- Genera voci, effetti ambientali, effetti sonori e musica in un unico passaggio.
- Ottimo tempismo nei dialoghi, come dimostrato dai nostri ripetuti test.
- Ottima separazione tra i due altoparlanti e riproduzione fedele del copione.
- Crea musica cinematografica di grande effetto, perfetta per essere ascoltata da sola.
- Mantiene l'identità vocale e la coerenza narrativa per tutta la durata di due minuti.
- Durante il nostro percorso di test, emette un file WAV stereo pulito a 40 kHz.
Contro
- Le esecuzioni ripetute possono variare notevolmente in termini di naturalezza e affidabilità.
- Discorso occasionalmente allucinato o confuso.
- I conteggi esatti degli effetti sonori non sono affidabili.
- In alcune scene complete manca un evento finale richiesto.
- Le prestazioni multilingue richiedono un'attenta verifica.
- La continuità della voce di riferimento è risultata scarsa nel nostro ambiente di prova.
- Un numero elevato di invii in parallelo ha causato errori di concorrenza a monte, sebbene le attività non andate a buon fine non siano state fatturate.
A chi è destinato Seed Audio 1.0?
Seed Audio 1.0 è la soluzione ideale per i creatori di contenuti audio che ragionano in termini di scene piuttosto che di elementi isolati. È particolarmente utile per radiodrammi, dialoghi di videogiochi, prototipi cinematografici, storyboard audio, concept per podcast e brevi sequenze di suspense.
Come sistema di consegna finale con un solo clic, risulta meno convincente. Se la formulazione esatta, l’identità vocale o il numero di eventi sono fondamentali dal punto di vista legale o creativo, è opportuno prevedere più iterazioni e una revisione umana. Il modello funziona al meglio quando lo si considera come un “regista audio” veloce con diverse riprese, piuttosto che come un renderizzatore deterministico.
Domande frequenti
Seed Audio 1.0 è un modello di sintesi vocale?
Can Seed Audio 1.0 è in grado di generare effetti sonori senza voce?
Can Seed Audio 1.0 è in grado di generare musica?
Per quanto tempo Seed Audio 1.0 è in grado di generare suoni?
Seed Audio 1.0 supporta l'audio di riferimento?
Quanto costa Seed Audio 1.0?
Il verdetto finale
Seed Audio 1.0 è un modello audio unificato davvero interessante. La capacità di generare discorsi, effetti sonori, ambientazioni e musica convincenti a partire da un unico prompt non è solo una promessa di lancio: i nostri test su scene miste e musica hanno dimostrato che gli elementi possono funzionare insieme.
Il suo punto di forza principale era la sincronizzazione dei dialoghi. Il suo principale punto debole era la coerenza. Su 23 campioni, il modello ha mostrato ripetutamente un risultato eccellente nel caso migliore e una versione alternativa notevolmente più debole.
Nel caso della prototipazione creativa, questo compromesso è facile da accettare. È possibile generare diverse versioni, scegliere quella più efficace e valutare ogni possibile conclusione. Per la produzione deterministica, la corrispondenza esatta delle voci o i lavori in cui il conteggio degli eventi è fondamentale, è opportuno mantenere nel flusso di lavoro una fase di revisione e modifica da parte di un essere umano.
Giudizio complessivo: Seed Audio 1.0 è uno dei generatori audio a livello di scena più potenti che abbiamo testato, ma dà il meglio di sé come strumento creativo per più riprese piuttosto che come renderizzatore finale per una singola ripresa.