
Stai sviluppando un'app o pianificando il budget per un agente? Inizia dal modello che utilizzerai effettivamente. Il Avviso di migrazione del 15 maggio 2026 afferma che l'ID originale Grok 4 ora viene risolto in Grok 4.3 con uno sforzo di ragionamento minimo. Una chiamata riuscita a un vecchio ID non dimostra più che il modello originale lo abbia servito.
L'utilizzo dell'API viene conteggiato separatamente dagli abbonamenti consumer di Grok. Prezzi di abbonamento e accesso a Grok riguarda i piani di chat; tali canoni mensili non sono crediti simbolici per un’integrazione diretta con xAI.
Vuoi provare un prompt prima di integrarlo in un’app? Prova Grok 4.6 su GlobalGPT per un flusso di lavoro basato sulla chat. Utilizza una chiave API xAI per la tua integrazione e la fatturazione diretta di xAI. Questo articolo è pubblicato da GlobalGPT; i link ai prodotti utilizzano il tracciamento dei referral.
Prezzi Grok 4 API: tariffe attuali e versione originale fuori produzione
La tabella che segue utilizza Prezzi di listino xAI verificati l'8 settembre 2026. Ogni importo è espresso in USD per ogni milione di token. L'input, l'input memorizzato nella cache e l'output sono categorie fatturabili distinte, pertanto un unico “prezzo per milione” aggregato nasconde il costo effettivo del carico di lavoro.
USD per 1 milione di token · elaborazione standard
grok-4.3
Destinazione di reindirizzamento originale Grok 4
Contesto: 1.000.000 gettoni
Prompt < 200K
- Ingresso
- $1.25
- Input memorizzato nella cache
- $0.20
- Risultato / ragionamento
- $2.50
Prompt >= 200.000
- Ingresso
- $2.50
- Input memorizzato nella cache
- $0.40
- Risultato / ragionamento
- $5.00
grok-4.6
Bandiera attuale
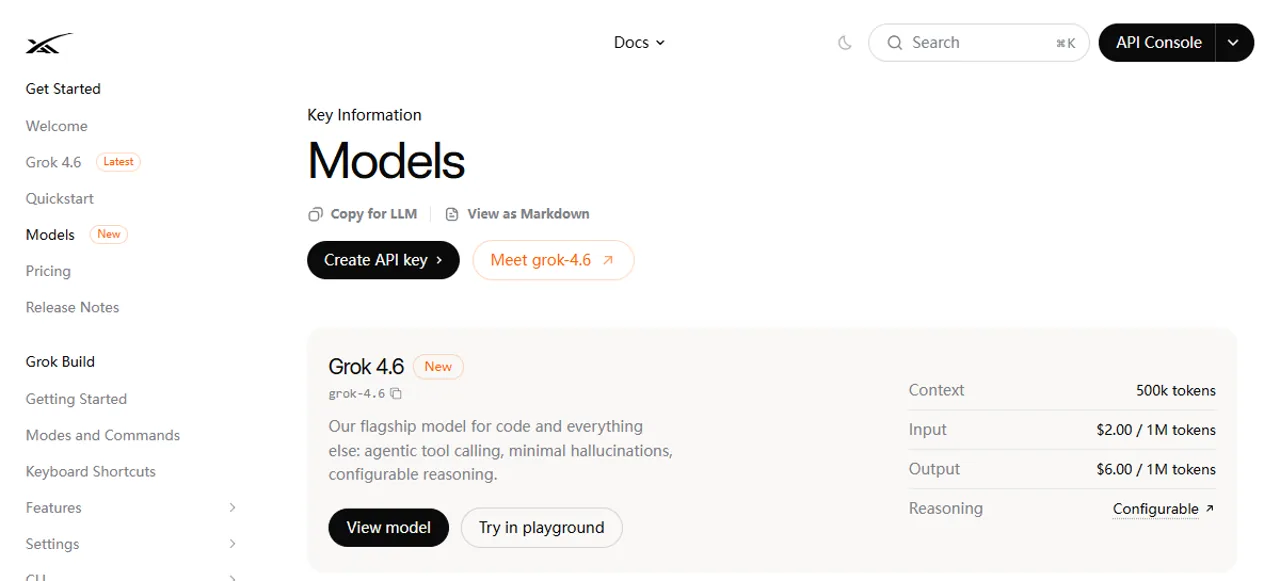
Contesto: 500.000 token
Prompt < 200K
- Ingresso
- $2.00
- Input memorizzato nella cache
- $0.50
- Risultato / ragionamento
- $6.00
Prompt >= 200.000
- Ingresso
- $4.00
- Input memorizzato nella cache
- $1.00
- Risultato / ragionamento
- $12.00
grok-4.5
Opzione precedente della generazione attuale
Contesto: 500.000 token
Prompt < 200K
- Ingresso
- $2.00
- Input memorizzato nella cache
- $0.30
- Risultato / ragionamento
- $6.00
Prompt >= 200.000
- Ingresso
- $4.00
- Input memorizzato nella cache
- $0.60
- Risultato / ragionamento
- $12.00
Quando il prompt raggiunge i 200.000 token, le tariffe per contesti lunghi si applicano a tutti i token di quella richiesta, compreso l'output.
Gli altri ID delle 4 famiglie Grok elencati sono grok-4.20-0309-ragionamento, grok-4.20-0309-senza ragionamento e grok-4.20-multi-agent-0309. Ciascuno dispone di una finestra di contesto di 1 milione di token e presenta gli stessi tassi di token short/long indicati per Grok 4.3. Il prezzo unitario corrispondente non implica un consumo totale di token corrispondente, specialmente nel caso di attività multi-agente.
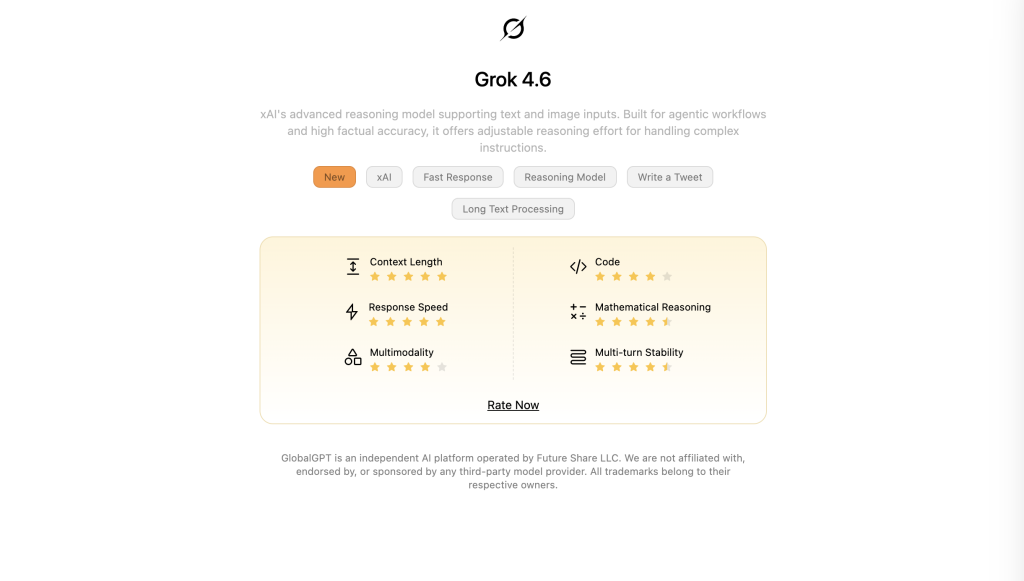
Per un'alternativa specifica per la programmazione, grok-build-0.1 dispone di una finestra di contesto da 256K e di velocità di input/cache/output a contesto breve pari a $1.00/$0.20/$2.00, che salgono a $2,00/$0,40/$4,00 alla soglia di prompt di 200K. Per informazioni più approfondite sul comportamento e sui casi d’uso, consulta il nostro Recensione di Grok 4.6.
Che fine ha fatto il prezzo originale del modello $3 / $15?
Riferimenti precedenti, tra cui il nostro Guida all'integrazione API Grok 4, quotazione $3 per milione di token in ingresso e $15 per milione di token in uscita per il modello originale Grok 4. Consideratela una quotazione storica, non la fattura odierna relativa a un ID fuori produzione. Il vecchio URL ufficiale del modello ora rimanda al catalogo generale dei modelli, quindi non si tratta di un listino prezzi d’archivio recentemente verificato.
Il Annuncio originale Grok 4 descrive una finestra di contesto di 256.000 token. Tale capacità storica, così come i prezzi o le soglie dei modelli Fast precedenti, non devono essere riportati nel budget destinato alla sostituzione. La regola precisa per grok-4-0709 è ora Grok 4.3 con un basso livello di complessità di ragionamento, fatturato alle tariffe Grok 4.3.
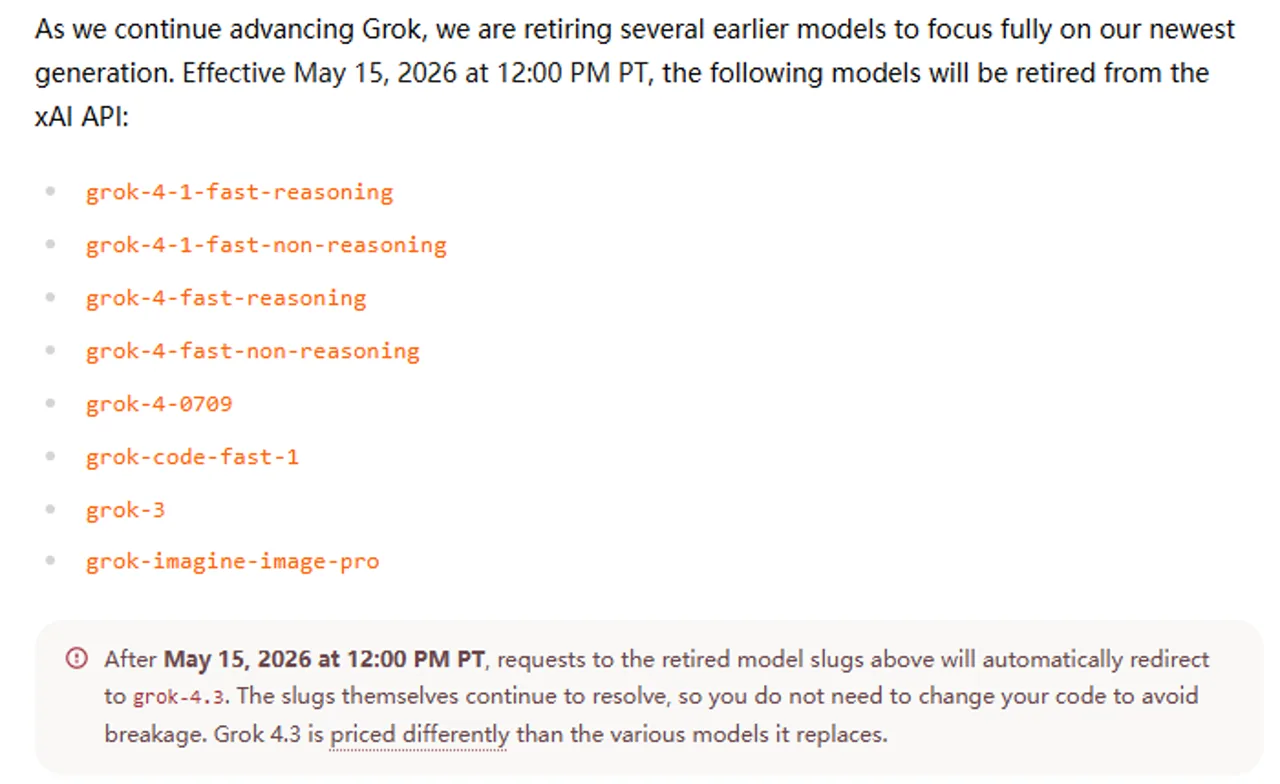
Grok 4 è una generazione di modelli, mentre Grok è anche il nome di un prodotto di consumo. Il nostro spiegazione del significato di Grok 4 fornisce queste informazioni di base sul prodotto. Per il nuovo codice, selezionare esplicitamente un modello supportato invece di affidarsi a un reindirizzamento dovuto alla dismissione o di dare per scontato che l’alias di un provider rimanga invariato.
In che modo i dati inseriti, quelli memorizzati nella cache e il ragionamento influenzano il conto
Una richiesta, tre addebiti simbolici
Dati di input non memorizzati nella cache
(I – C) × portata in ingresso
I = tutti i token di prompt; C = token di prompt memorizzati nella cache.
Input memorizzato nella cache
C × frequenza della cache
I token memorizzati nella cache fanno parte dell'input, non costituiscono un input aggiuntivo.
Produzione fatturabile
O × portata di uscita
O include il ragionamento quando l'endpoint lo riporta all'interno dell'output.
Stima del valore del token in USD = [(I – C) × tasso di input + C × tasso di input memorizzato nella cache + O × tasso di output] / 1.000.000. Aggiungere quindi gli eventuali costi relativi agli strumenti, allo stoccaggio o di altro tipo. Selezionare le tariffe a lungo termine utilizzando il totale indicato, inclusi i token memorizzati nella cache, prima di effettuare i calcoli.
L'input comprende i messaggi, le istruzioni e la cronologia delle conversazioni inviati al modello. La memorizzazione nella cache riutilizza un prefisso iniziale identico per tutte le richieste; si tratta di un processo automatico e xAI raccomanda l'uso di un identificatore di conversazione per migliorare il riutilizzo. Un prompt dall'aspetto simile non garantisce un risultato nella cache. Il Documentazione sulla memorizzazione nella cache dei prompt spiega il comportamento dell'abbinamento.
In "Completamenti chat", leggi prompt_tokens_details.cached_tokens; in "Risposte", leggi input_tokens_details.cached_tokens. Il Guida all'utilizzo della cache e ai prezzi calcola i token di ragionamento al tasso di completamento totale. Se il totale in uscita include già il ragionamento, l'aggiunta di token_di_ragionamento anche in questo caso lo conterebbe due volte.
Grok 4.6 supporta livelli di sforzo di ragionamento basso, medio, alto e xalto; il valore predefinito documentato è "alto" e il ragionamento non può essere disabilitato. Grok 4.3 supporta i livelli "nessuno", basso, medio e alto. Ciò rende la versione Grok 4.3 con impostazione “nessuno” degna di essere valutata per lavori di estrazione rigorosi, mentre la versione Grok 4.6 potrebbe consumare più token anche quando la risposta visibile è breve. Vedi il impostazioni di ragionamento e la voce relativa al modello Grok 4.3 riportata sopra.
Chiamate agli strumenti, elaborazione in batch e richieste prioritarie
Come da tabella ufficiale dei prezzi degli strumenti, Web Search, X Search e Code Execution costano ciascuna $5 ogni 1.000 chiamate, ovvero $0,005 per chiamata, più il consumo di token. Una richiesta può richiamare gli strumenti più di una volta. Dieci chiamate di ricerca aggiungono $0,05 prima dei token del modello; l’abilitazione di uno strumento non indica quante volte verrà utilizzato.
La ricerca degli allegati costa $10 ogni 1.000 chiamate; la ricerca nelle raccolte costa $2,50 ogni 1.000. I file archiviati e le raccolte comportano inoltre costi giornalieri di archiviazione e download. Le immagini e i video utilizzano unità di prezzo specifiche, pertanto è opportuno escluderli dal calcolo approssimativo basato sui token per il solo testo. Il nostro Tutorial sul flusso di lavoro per immagini e video con Grok coperture che separano quel percorso di generazione.
Il API batch offre uno sconto di 20% per Grok 4.3 e le tre varianti Grok 4.20 elencate. Lo sconto si applica ai token di input, di input memorizzati nella cache, di output e di ragionamento. La pagina del modello Grok 4.6 indica che l’API batch non è supportata. Non applicare uno sconto forfettario di 50% né dare per scontato che tutti i modelli elencati supportino l’elaborazione in batch.
Elaborazione prioritaria costa il doppio delle tariffe standard dei token, compresi i token di cache e di ragionamento, quando il risultato restituito livello_di_servizio conferma priorità. Il passaggio al livello predefinito comporta l'applicazione delle tariffe standard. La priorità si applica alle operazioni di completamento delle chat e alle risposte, non all'API batch.
Tre esempi chiari relativi ai costi delle API
Si tratta di stime basate sui prezzi di listino, non di fatture effettive. Tutte le richieste riportate di seguito prevedono un’elaborazione standard, solo testo, senza strumenti, senza archiviazione, senza tentativi ripetuti e senza tasse. Il termine “output” include qualsiasi ragionamento fatturabile. I primi due carichi di lavoro presuppongono prompt inferiori a 200.000 token.
Costo per richiesta e per 10.000 richieste
Grok 4.3 · senza cache
$0.005 / richiesta
2.000 input × $1.25 + 1.000 output × $2.50, diviso per 1M. 10.000 richieste = $50.
Grok 4,6 · senza cache
$0.010 / richiesta
2.000 ingressi × $2 + 1.000 uscite × $6, diviso per 1M. 10.000 richieste = $100.
Grok 4,6 · 90% memorizzato nella cache in ingresso
$0.0073 / richiesta
200 non memorizzati nella cache × $2 + 1.800 memorizzati nella cache × $0,50 + 1.000 in uscita × $6, diviso per 1 milione. 10.000 richieste = $73.
Un elevato tasso di cache-hit è particolarmente utile quando gli input costituiscono la parte predominante del carico di lavoro. Nell'esempio Grok 4.6, la cache consente un risparmio di $0.0027 per chiamata, ovvero 27% del totale, anche se 90% di token di input sono memorizzati nella cache. Il carico in uscita rimane a $0,006. Valutate i risparmi rispetto all’intera richiesta, non solo alla parte memorizzata nella cache.
La soglia di 200K per il prompt può modificare l'intera richiesta
Un altro token di input supera la soglia di prezzo
199.999 gettoni prompt
$0.459998
Grok 4.6: (199.999 × $2 + 10.000 output × $6) / 1M. Nessuna cache.
200.000 token di prompt
$0.920000
Grok 4.6: (200.000 × $4 + 10.000 in uscita × $12) / 1M. Nessuna cache.
Il principale La tabella dei prezzi riporta esplicitamente “Contesto lungo >= 200k token” e precisa che tutti i token applicano la tariffa più alta una volta che il prompt raggiunge la soglia. In una nota sui dettagli del modello si legge “supera” i 200.000. Per un budget pari esattamente a 200.000, utilizzare il limite esplicito indicato nella tabella dei prezzi; non dare per scontato che si applichi ancora la tariffa più conveniente.
Per una previsione mensile, stimare il volume delle richieste separatamente per ciascun carico di lavoro, fascia di contesto, modello di cache-hit e impostazione di ragionamento. Aggiungere i tentativi di ripetizione previsti e le chiamate agli strumenti. Quindi confrontare tale stima con i dati sui costi effettivi ottenuti dopo un piccolo progetto pilota. Il valore espresso in centesimi per chiamata è utile solo quando le ipotesi su cui si basa corrispondono alle condizioni di produzione.
Il contesto, l'output, i limiti di velocità e i limiti di spesa sono diversi
Quattro limiti da verificare prima di procedere al ridimensionamento
Finestra contestuale
Su richiesta
Grok 4.3: 1 milione di token. Grok 4.6: 500.000. Non si tratta di una quota mensile.
Bilancio delle uscite
Per risposta
Imposta un limite massimo di output supportato. La capacità contestuale non garantisce un output visibile di tale entità.
RPS / TPM
Portata
Richieste al secondo e token al minuto. Entrambi devono rientrare nei limiti previsti dal livello del team.
Controlli di spesa
Denaro
Il credito prepagato, la ricarica automatica e i limiti di fatturazione controllano in modo separato il comportamento di ricarica.
Il pubblico tabella dei limiti di velocità Il Tier 0 è indicato con 37 richieste al secondo e 10 milioni di token al minuto per il modello Grok 4.3; il modello Grok 4.6 è indicato con 150 richieste al secondo e 50 milioni di token al minuto. Si tratta di voci relative ai livelli pubblicate in passato, non di una garanzia che ogni chiave disponga della stessa capacità utilizzabile. La Console del vostro team è la fonte autorevole per quanto riguarda l’accesso e i limiti del modello attuale.
I livelli si basano sulla spesa cumulativa per le API a partire dal 1° gennaio 2026: $0, $50, $250, $1.000 e $5.000 per i livelli da 0 a 4. Le richieste vengono limitate al secondo utilizzando il budget di richieste al minuto diviso per 60, quindi non è possibile utilizzare l’intera quota di un minuto in un’unica sessione. I token di input, output, ragionamento e quelli memorizzati nella cache contribuiscono tutti al TPM, anche se alcuni hanno un costo inferiore.
Le schede tecniche dei modelli Grok 4.3 e 4.6 riportano le dimensioni del contesto senza indicare separatamente un valore massimo di output. L'attuale Riferimento all'endpoint delle risposte definisce max_output_tokens come budget combinato di output e ragionamento: se non viene impostato, il valore predefinito è 128.000 e accetta valori più elevati per generazioni più lunghe. Tale valore predefinito non garantisce la presenza di 128.000 token di risposta visibili né una quantità illimitata di contesto. Impostare un budget esplicito e verificare le risposte incomplete.
Documentazione relativa alla fatturazione xAI distingue i crediti prepagati dalla fatturazione mensile, che è disattivata per impostazione predefinita. La ricarica automatica consente di ricaricare i crediti prepagati e prevede soglie e un limite mensile propri. Un limite di fatturazione controlla l'utilizzo postpagato; non si tratta della stessa cosa di un unico limite forfettario che copre acquisti, ricariche e richieste prepagate.
Per la tua prima integrazione, inizia con un credito prepagato limitato e verifica attentamente le impostazioni di ricarica automatica. Per accedere alla chat quotidiana senza dover scrivere un'integrazione, utilizza la funzione separata Guida all'uso di Grok copre l'intero flusso di lavoro del prodotto. L'abbonamento alla chat e il team API dispongono di controlli diversi.
Due attività reali Grok 4.6: cosa rivelano i dati di utilizzo
Abbiamo riutilizzato due test completati il 7 settembre 2026 tramite l'API di aggregazione di Broly all'indirizzo https://anywhere.broly.ai/v1, utilizzando la funzione "Completamento chat". Sia le richieste che i risultati restituiti grok-4.6; l'identità del modello a monte non è stata verificata in modo indipendente. Si tratta dei risultati del gateway Grok 4.6, non dei test originali Grok 4 né di un confronto tra modelli.
Ogni attività è stata eseguita una volta con temperatura=0, max_tokens=2048 e stream=false. Non sono stati inviati strumenti né impostazioni relative a uno sforzo di ragionamento esplicito. Per entrambe le richieste è stata utilizzata la stessa istruzione di sistema:

