
GPT-6.1 Sol è il modello bilanciato di OpenAI pensato per la programmazione complessa, l'uso del computer e il lavoro professionale. Mantiene la finestra di contesto da 1.050.000 token e il limite massimo di output di 128.000 token di GPT-6 Astra, ma il prezzo dell’API Standard scende a $2 per milione di token in ingresso e a $10 per milione di token in uscita. Si tratta di un quinto delle attuali tariffe per token di Astra. Il compromesso è semplice: Astra rimane il prodotto di punta, mentre Sol mira a fornire funzionalità sufficienti ai team che prestano attenzione al costo per attività completata.
Questa guida distingue ciò che Documenti OpenAI per GPT-6.1 Sol in base a quanto osservato dai creatori indipendenti nei primi test. Mostra inoltre la regola dei prezzi basata sul contesto esteso, esempi realistici di costi, un modello funzionante dell’API Responses e un metodo pratico per scegliere tra Sol, Astra, Luna e il precedente GPT-6 Sol.
Che cos’è GPT-6.1 Sol?
GPT-6.1 Sol è il modello Sol più recente della famiglia GPT-6 di OpenAI. La descrizione ufficiale lo definisce un modello destinato alla programmazione complessa, all’uso del computer e al lavoro professionale, con prestazioni simili a quelle di Astra ma a un costo inferiore. Nella gerarchia della famiglia, Astra rappresenta la scelta con le capacità più elevate, Luna quella orientata all’efficienza, mentre Sol costituisce la via di mezzo per attività sufficientemente complesse da richiedere un forte ragionamento, ma abbastanza frequenti da rendere importante il costo unitario.
L'ID del modello è gpt-6.1-sol. Quella stringa specifica è importante nelle chiamate API, nei log di test, nei registri di fatturazione e nella configurazione della distribuzione. La versione precedente gpt-6-sol rimane un modello diverso, anche se i prezzi di input e output non memorizzati nella cache coincidono. La pagina di OpenAI dedicata al modello precedente ora reindirizza i lettori alla versione più recente, mentre la nostra Recensione di GPT-6 Sol e limiti dell'API fornisce il quadro di riferimento storico.
Il motivo più evidente per cui vale la pena interessarsi a questo aggiornamento non è un singolo dato della classifica. È piuttosto la combinazione di una finestra di contesto di dimensioni eccezionali, un ampio supporto agli strumenti, cinque livelli di complessità di ragionamento e un prezzo che ne favorisce un utilizzo più diffuso rispetto ad Astra. Un modello leggermente meno potente, ma abbastanza conveniente da poter essere utilizzato in ogni bozza seria, revisione del codice o flusso di lavoro in più fasi, può offrire più valore di un prodotto di punta riservato a rare occasioni.
Tale impostazione deve ancora essere verificata in relazione alle tue attività. OpenAI’s linee guida per la selezione dei modelli raccomanda espressamente di confrontare Sol con Astra sullo stesso lavoro. Un flusso di lavoro relativo a documenti legali, una rifattorizzazione di un repository, un agente browser e una presentazione su lavagna possono mettere alla prova capacità diverse. Considerate l’etichetta del modello come un’ipotesi di partenza, quindi misurate la correttezza, il numero di revisioni, la latenza e il costo totale per ogni risultato accettato.
Specifiche tecniche di GPT-6.1 Sol
Il catalogo ufficiale dei modelli elenca gli input di testo e immagini con output di testo. L'audio e il video non sono modalità di input o output supportate dal modello stesso. Questa distinzione è utile nella progettazione di un prodotto: è possibile fornire screenshot, diagrammi, pagine scansionate o altre immagini, ma la trascrizione audio e la comprensione dei video richiedono un componente o uno strumento separato.
Il suo input massimo è inferiore alla finestra di contesto indicata nel titolo, poiché l’output e l’elaborazione interna richiedono spazio all’interno del budget totale. Il limite massimo di 128.000 token per l’output è generoso, ma richiedere una risposta di dimensioni enormi raramente rappresenta la scelta progettuale migliore. Gli output lunghi costano di più, richiedono più tempo per essere revisionati e possono presentare deviazioni. Per la maggior parte dei lavori di sviluppo software, le uscite strutturate più piccole con punti di controllo sono più facili da convalidare.
Supporti per lo sviluppo del ragionamento basso, medio, alto, xhigh, e max; l'impostazione predefinita è "medium". Il nessuno e minimo Le impostazioni non sono disponibili. Utilizza uno sforzo minimo per le trasformazioni di routine e aumentalo solo quando il costo in termini di errore o la complessità di un'attività giustificano l'impiego di token e tempo aggiuntivi. L'obiettivo pratico è l'impostazione più leggera che consenta comunque di superare i test di accettazione.
Gli sviluppatori che desiderano confrontare i prezzi passati e l'andamento dei token possono utilizzare il nostro Esempi di prezzi e costi di GPT-6 Sol come punto di riferimento. La modifica chiave alle specifiche non riguarda la dimensione del contesto, che rimane invariata in tutti i modelli GPT-6 qui trattati. Si tratta piuttosto del posizionamento aggiornato del nuovo Sol e dell’input memorizzato nella cache, più economico.
Prestazioni: cosa emerge dai dati ufficiali
Secondo quanto dichiarato in occasione del lancio di OpenAI, GPT-6.1 Sol offre miglioramenti sostanziali rispetto a GPT-6 Sol nell’esecuzione di attività professionali complesse quali la scrittura e il debug di codice, la comprensione di documenti e l’esecuzione di flussi di lavoro aziendali in più fasi. L’azienda afferma che, in diverse valutazioni, il modello si avvicina a GPT-6 Astra a un costo inferiore. Si tratta di affermazioni ufficiali relative alle valutazioni, non di una garanzia che ogni prompt raggiunga prestazioni simili a quelle di Astra.
Il Appendice alla scheda del sistema solare GPT-6.1 fornisce un importante limite: le valutazioni sono state eseguite nell’ambiente di ricerca di OpenAI o tramite l’API, mentre la versione di produzione ChatGPT può presentare differenze poiché i prompt di sistema, gli strumenti disponibili e le impostazioni relative allo sforzo non sono identici. Ecco perché un articolo accurato dovrebbe tenere separate le prove ufficiali dei benchmark dai test effettuati dall’autore e dalle valutazioni interne dell’azienda.
Un esempio concreto è HealthBench. Nella tabella pubblicata, GPT-6.1 Sol registra punteggi corretti in base alla lunghezza pari a 64,2 su HealthBench Professional, 58,5 su HealthBench, 36,2 su HealthBench Hard e 96,0 su HealthBench Consensus. I punteggi corrispondenti di Astra sono 64,7, 58,3, 36,6 e 95,5. OpenAI descrive i modelli come compresi entro 0,5 punti percentuali in queste quattro valutazioni.
Tale risultato conferma l’affermazione “vicino ad Astra” all’interno di quella famiglia di valutazioni. Non dimostra però che la qualità dell’ingegneria del software, l’affidabilità del browser o lo stile di output siano equivalenti. Un benchmark di integrità misura una capacità diversa rispetto alla risoluzione di una condizione di competizione o al coordinamento degli strumenti. Per un’analisi più approfondita del profilo di test più ampio del modello di punta, consultare il Recensione e test pratici di GPT-6 Astra.
L'interpretazione pratica più plausibile è condizionata: GPT-6.1 Sol rientra tra i candidati ideali per i compiti impegnativi, soprattutto quando il prezzo di Astra ne limiterebbe l'utilizzo. Merita una valutazione comparativa, non una promozione automatica. Misurate la percentuale di successo, il numero di correzioni umane, gli errori dello strumento, i token generati e il tempo necessario per ottenere un risultato accettabile. Queste metriche trasformano il confronto tra modelli in una decisione aziendale.
Programmazione: cosa può fare GPT-6.1 Sol
GPT-6.1 Sol possiede gli elementi fondamentali che ci si aspetta da un moderno modello di programmazione: streaming, output strutturati, chiamata di funzioni, ricerca di file, input di immagini, ricerca sul web e memorizzazione dei prompt nella cache. Attraverso l’API Responses, OpenAI elenca anche l’interprete di codice, la shell ospitata, l’applicazione di patch, le competenze, l’uso del computer, MCP e la ricerca di strumenti. Ciò rende il modello adatto a flussi di lavoro che analizzano file, propongono modifiche, eseguono comandi e restituiscono output verificati dal sistema.
Il supporto delle funzionalità non implica che ogni ambiente esponga automaticamente tutti gli strumenti. È comunque l’applicazione a decidere quali strumenti sono disponibili, quali autorizzazioni ricevono, come i risultati vengono restituiti al modello e quali azioni richiedono conferma. La funzione “Chat Completions” funziona con GPT-6.1 Sol senza la necessità di richiamare strumenti, mentre OpenAI indirizza le applicazioni che utilizzano strumenti verso “Responses”. I nuovi sistemi agentici dovrebbero considerare tale confine dell’API come una scelta architettonica, non come una differenza sintattica minore.
Al momento della pubblicazione, il modello esatto non era indicato nel catalogo della chat della sede di prova, pertanto la presente guida non pretende di stabilire un nuovo benchmark interno per le quattro attività di codifica previste. La valutazione della codifica si basa su dati ufficiali relativi alle capacità e su esecuzioni pubbliche identificate. Ciò è più utile che sostituire di nascosto Astra o il precedente Sol e attribuire al risultato il nome di un modello errato.
Una valutazione approfondita dovrebbe includere il debug con test di regressione, una funzionalità multi-file circoscritta, una revisione della sicurezza e una decisione ingegneristica vincolata dallo schema. Queste attività non si limitano a testare la generazione del codice, ma rivelano se il modello preserva un’API, rileva i casi limite, rispetta i vincoli di output e indica ciò che non è stato possibile verificare. Il nostro Guida ai migliori modelli di intelligenza artificiale per la programmazione nel 2026 spiega perché la scelta migliore varia a seconda del flusso di lavoro.
Individua il difetto più piccolo, mantieni l'API e aggiungi test eseguibili.
Rispettare la concorrenza, l'ordinamento, la convalida e il comportamento in caso di errore.
Dare priorità ai percorsi di exploit, fornire una soluzione minima ed evitare affermazioni infondate sui framework.
Quando esegui un comando come questo, valuta il risultato in modo sistematico. Il valore zero viene mantenuto? I duplicati vengono eliminati? L'ordinamento numerico è corretto? I test vengono eseguiti con node --test? Una spiegazione ben articolata non può compensare un'affermazione errata. Lo stesso principio vale per il lavoro sui repository: definire le condizioni di accettazione prima di scegliere il modello, quindi esaminare la patch piuttosto che la credibilità del testo.
Prezzi di GPT-6.1 Sol
Il pagina ufficiale dei prezzi delle API misura i tassi di Sol di GPT-6.1 per ogni milione di token. L'input costa $2, l'input memorizzato nella cache costa $0,10, le scritture nella cache costano $2,50 e l'output costa $10. L'input memorizzato nella cache è quindi pari a 5% rispetto alla velocità di input non memorizzato nella cache, mentre la scrittura di nuovi contenuti nella cache costa 1,25 volte l'input ordinario. Le commissioni specifiche dello strumento possono essere aggiunte separatamente, quindi il calcolo dei token rappresenta solo una parte del carico di lavoro legato all'utilizzo dello strumento.
Il dettaglio più importante relativo ai prezzi è la soglia di 272K. Quando l’input supera i 272.000 token, l’intera richiesta passa a una velocità di input e di cache doppia rispetto a quella precedente e a una velocità di output pari a 1,5 volte quella precedente. Non si tratta di un sovrapprezzo marginale applicato solo ai token che superano tale soglia. Le applicazioni che si attestano regolarmente in prossimità di tale soglia dovrebbero contare i token prima dell’invio e valutare l’opportunità di ricorrere al chunking, al recupero o alla compattazione.
La modalità Fast raddoppia i prezzi Standard. Le modalità Batch e Flex riducono le tariffe Standard del 50%, mentre l’elaborazione regionale aggiunge un sovrapprezzo del 10%, ove disponibile. Queste modalità risolvono problemi diversi: la modalità «Fast» compensa la latenza, la modalità «Batch» baratta l’immediatezza con il costo, la modalità «Flex» baratta la prevedibilità della pianificazione con il costo, mentre l’elaborazione regionale risponde alle esigenze relative alla localizzazione dei dati. Non confrontare i loro prezzi senza considerare i rispettivi vincoli operativi.
I prezzi standard di Astra sono pari a $10 in ingresso e $50 in uscita per ogni milione di token, esattamente cinque volte le tariffe di riferimento di Sol. Il Prezzi e limiti dei token dell'API GPT-6 Astra La guida approfondisce ulteriormente tale premio. Sol e la precedente versione GPT-6 Sol condividono gli stessi prezzi di input e output non memorizzati nella cache, ma GPT-6.1 Sol riduce l'input memorizzato nella cache da $0.20 a $0.10 per milione di token.
Esempi di costi reali
I prezzi dei token risultano più facili da valutare se convertiti in richieste complete. Gli esempi riportati di seguito si basano sull’elaborazione Standard, senza costi per le chiamate agli strumenti, senza sovrapprezzo regionale e senza input memorizzati nella cache, salvo diversamente specificato. La lunghezza effettiva dell’output spesso incide sul costo finale più di quanto gli sviluppatori si aspettino, poiché su GPT-6.1 Sol l’output costa cinque volte di più rispetto a un input ordinario.
Per la revisione del codice con 100K di input e 5K di output, i costi di input ammontano a $0.20 e quelli di output a $0.05, per una stima complessiva di $0.25. Se l’intero input di 100K è considerato memorizzato nella cache, la sua porzione di input scende a $0.01 e il totale diventa $0.06. Se l’applicazione deve prima scrivere quel prefisso da 100K nella cache, la porzione relativa alla scrittura in cache è pari a $0,25 prima dell’uscita.
L'esempio con 300.000 input supera la soglia. Gli input vengono fatturati a un costo effettivo di $4 per milione, quindi 300.000 costano $1,20. L'output viene fatturato a un costo effettivo di $15 per milione, quindi 10.000 costano $0,15. Il totale è $1,35. Una richiesta solo leggermente superiore alla soglia può quindi costare molto di più di una appena al di sotto di essa, anche prima di considerare gli strumenti.
Le modalità Batch o Flex dimezzerebbero il totale Standard ammissibile, mentre la modalità Fast lo raddoppierebbe. Nel primo esempio, ciò significa circa $0,125 nelle modalità Batch o Flex e $0,50 nella modalità Fast. I team che utilizzano ancora i vecchi modelli GPT-5.6 possono confrontare tali ipotesi con le nostre Prezzi GPT-5.6 e crediti Codex suddivisione.
Come utilizzare GPT-6.1 Sol
Il metodo più semplice per gli sviluppatori è l'API Responses. Installa l'attuale SDK OpenAI, inserisci la chiave API tramite il tuo ambiente e imposta modello a gpt-6.1-sol. Il guida ufficiale alla generazione di testi consiglia di fornire delle risposte alle richieste dirette relative al modello, e la pagina del modello lo richiede per l'utilizzo degli strumenti.
1. Inizia con una semplice richiesta all'API Responses
Fai in modo che la prima richiesta sia semplice. Verifica che l’ID esatto del modello sia disponibile per il tuo progetto, acquisisci i campi relativi al modello e all’utilizzo restituiti e salva una quantità sufficiente di metadati per poter riprodurre l’esecuzione. Non iniziare con una catena di strumenti troppo complessa. Una richiesta semplice separa i problemi di accesso al modello da quelli relativi alla definizione degli strumenti, alle autorizzazioni e all’orchestrazione.
2. Aggiungere strumenti esclusivamente tramite l'API Responses
Quando il flusso di lavoro richiede la ricerca di file, la ricerca sul Web, l'esecuzione di codice, l'accesso alla shell, l'utilizzo del computer, MCP o funzioni personalizzate, definire il set di strumenti minimo necessario. Limitare l'ambito dei file e della rete, verificare gli argomenti degli strumenti e stabilire quali azioni richiedono la conferma da parte dell'utente. Il modello può proporre e richiamare gli strumenti, ma l'applicazione rimane responsabile della loro esecuzione e dell'applicazione delle autorizzazioni.
3. Adeguare lo sforzo di ragionamento in base a una valutazione
Inizia con l'impostazione "medium", che è quella predefinita. Esegui un set di valutazione rappresentativo, quindi confronta le impostazioni "low", "high" o "xhigh" in termini di tasso di accettazione, token in uscita, latenza e numero di revisioni. L'impostazione "Max effort" può essere utile per le attività più complesse, ma utilizzarla in ogni caso può annullare il vantaggio in termini di costi che ha reso Sol così interessante. Mantieni l'impostazione più leggera che garantisca un superamento affidabile del test.
4. Utilizzare GlobalGPT per un confronto interattivo
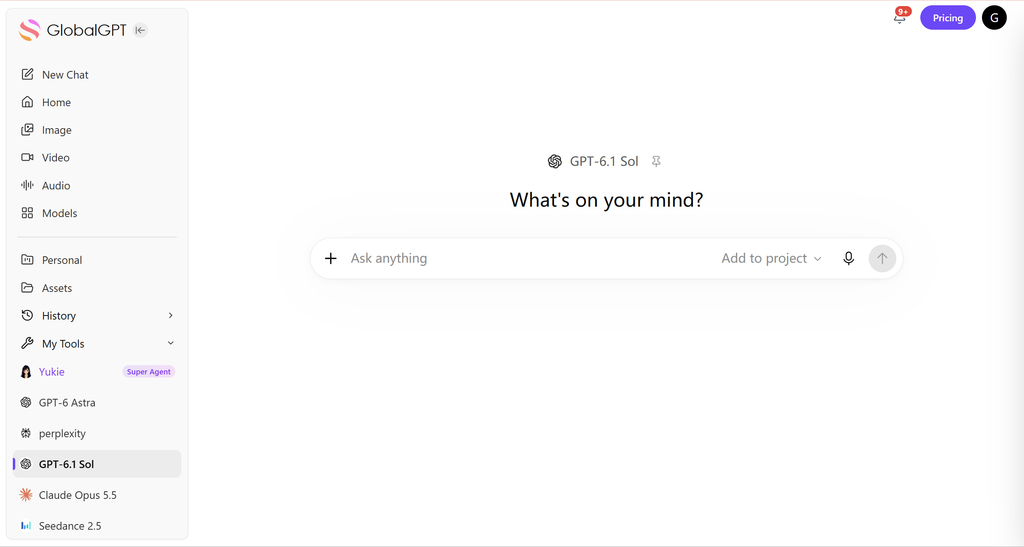
Per lavorare in modo interattivo, apri L'area di lavoro multimodello di GlobalGPT e seleziona GPT-6.1 Sol quando è disponibile nel menu di selezione del tuo account. Questo metodo è utile per confrontare le risposte senza dover gestire schede e abbonamenti separati. Non sostituisce i controlli di distribuzione delle API, l’automazione dei repository, Codex o un IDE. La nostra guida a Opzioni del modello ChatGPT per la codifica tratta tali differenze nel flusso di lavoro.
GPT-6.1 Sol vs GPT-6 Sol, Astra e Luna
Tutti e quattro i modelli oggetto di questo confronto accettano testo e immagini, restituiscono testo e presentano una finestra di contesto di 1.050.000 token con un output massimo di 128.000. Le differenze significative riguardano la posizione, il prezzo, la data di riferimento, le impostazioni di ragionamento e il livello di qualità osservabile in un compito reale. La tabella riporta i prezzi ufficiali attuali dei token Standard verificati il 1° ottobre 2026.
| Modello | La migliore vestibilità | Ingresso / 1M | In cache / 1M | Uscita / 1M | Soglia |
|---|---|---|---|---|---|
| GPT-6.1 Sol | Lavoro complesso con controllo dei costi | $2 | $0.10 | $10 | 30 aprile 2026 |
| GPT-6 Astra | Lavori particolarmente impegnativi in cui la qualità è prioritaria | $10 | $1 | $50 | 30 aprile 2026 |
| GPT-6 Sol | Integrazioni Sol precedenti già esistenti | $2 | $0.20 | $10 | 20 aprile 2026 |
| GPT-6 Luna | Attività mirate e ad alto volume | $0.10 | $0.01 | $0.50 | 18 maggio 2026 |
Scegliete Astra quando l’attività è talmente complessa che un piccolo miglioramento della qualità può evitare costose rielaborazioni manuali. Scegliete GPT-6.1 Sol quando il lavoro è comunque complesso ma frequente, specialmente se lo sconto sugli input memorizzati nella cache risulta utile. Scegliete Luna quando il volume e la latenza sono i fattori predominanti e l’attività è ben definita. Mantenete la versione precedente di Sol solo nei casi in cui il rischio di migrazione, le valutazioni esistenti o i lavori di compatibilità rendano poco vantaggioso un passaggio immediato.
Il divario di prezzo pari a cinque volte tra Sol e Astra è notevole, ma il prezzo per token non equivale al prezzo per risultato accettato. Un modello più performante potrebbe utilizzare un numero inferiore di token in output, richiamare meno strumenti o richiedere meno revisioni. Al contrario, Sol può risultare vincente anche con una revisione in più se il prezzo unitario di Astra supera tale differenza. È preferibile confrontare le tracce complete delle attività piuttosto che moltiplicare la lunghezza di un singolo prompt.
I lettori che stanno valutando se valga la pena passare al modello di punta possono utilizzare il Confronto tra GPT-6 Astra e GPT-5.6 Sol per il contesto del livello precedente. Per il ramo con il costo più basso della famiglia attuale, il Recensione di GPT-6 Luna e migliori utilizzi fornisce i limiti dell’API pertinenti e l’adeguatezza del carico di lavoro.
Cosa dicono i recensori
OpenAI ha presentato GPT-6.1 Sol durante il keynote del DevDay del 29 settembre 2026, insieme ad altri lanci di prodotti. Quel video ufficiale definisce i tempi e il posizionamento del lancio, ma non costituisce una prova indipendente. Le reazioni esterne più significative provengono dai creatori che descrivono un compito, una serie di confronti, il metodo di calcolo dei costi e gli insuccessi, anziché limitarsi a ripetere il messaggio ufficiale sul lancio.
Sa programmare? ha segnalato che Sol si è dimostrato molto più economico e veloce in un confronto in tre round tra Blender e Godot, ma ha aggiunto che la qualità del gioco è peggiorata nel corso dei round.
Matt Johnston ha riportato un punteggio ponderato di 96 e un costo della suite pari a $2,63 nella sua configurazione a nove test, segnalando chiaramente il fallimento di un compito relativo al pinguino.
Duncan Rogoff ha confrontato Sol con Sonnet 5.5 in sei build, monitorando il tempo, i token e il costo finale.
In Il video in tre parti di ’Can It Code?", le attività sono passate da un kit di dungeon low-poly realizzato con Blender a personaggi modellati e animati, per poi arrivare a un gioco giocabile realizzato con Godot. L’autore ha stimato per Sol un tempo complessivo di $29.17 e 7 ore e 5 minuti per tutti i round, ben al di sotto dei tempi delle prove di confronto, ma ha giudicato il gioco finale meno piacevole e ha affermato che Sol è peggiorato di round in round. La conclusione riguarda il costo e la velocità, con un avvertimento sulla qualità, non una classifica generale.
La rassegna delle nove partite di Matt Johnston riporta un punteggio ponderato di 96, a pari merito con Sonnet 5.5 nella sua tabella Stonelabs, e un costo della suite pari a $2.63 rispetto a circa $14 per Astra e $12 per Opus 5.5. Egli sottolinea inoltre un errore nel compito relativo al pinguino. Questi numeri appartengono al suo progetto di riferimento e alla sua contabilità dei costi; dovrebbero essere riprodotti prima di essere utilizzati per gli appalti.
Il confronto tra sei modelli di Duncan Rogoff comprende landing page, giochi 3D per browser, scene di Blender, video esplicativi interattivi e presentazioni per gli investitori. La descrizione pubblica indica che i test monitorano i tempi di creazione, l’utilizzo dei token e il costo finale. In attesa di un’analisi completa dei risultati visibili, questa guida utilizza il video come esempio di un metodo di confronto pratico, non come prova della superiorità di uno dei due modelli.
Queste prime recensioni concordano su una domanda utile: il prezzo contenuto di Sol regge il confronto con un progetto completo? Le loro risposte dipendono dal tipo di progetto. Un creatore ha riscontrato un’impressionante efficienza in termini di costi, ma una qualità finale del gioco inferiore; un altro ha segnalato un punteggio elevato e un costo contenuto del pacchetto; un terzo ha progettato un gioco competitivo su larga scala. Tale diversità è più significativa di una frase di consenso sintetico.
A chi è destinato GPT-6.1 Sol?
GPT-6.1 Sol è adatto a team che dispongono già di un carico di lavoro consistente e di un ciclo di valutazione. Risulta particolarmente interessante quando lo stesso contesto di grandi dimensioni viene riutilizzato tramite la memorizzazione nella cache dei prompt, quando l’implementazione di Astra risulterebbe troppo costosa da scalare o quando Luna non offre una profondità sufficiente per l’attività. Il modello risulta meno interessante quando un’attività leggera di estrazione o classificazione funziona già in modo affidabile su un livello più economico.
- Programmazione su scala di repository
- Risultati professionali complessi
- Revisione a lungo termine con memorizzazione nella cache
- Flussi di lavoro con utilizzo di strumenti e valutazioni
- Decisioni critiche per la sicurezza
- Attività che comportano errori costosi
- Lavoro in prossimità della soglia dei 272K
- Flussi sensibili alla latenza
- Etichettatura semplice
- Trasformazioni deterministiche brevi
- Estrazione ad alto volume e basso rischio
- Compiti già risolti da Luna
I team di sviluppo software dovrebbero prendere in considerazione Sol quando hanno bisogno di un modello per elaborare ragionamenti su più file, generare test, esaminare problemi di sicurezza o utilizzare strumenti sotto supervisione. Gli analisti possono utilizzarlo per la sintesi di più documenti e per la produzione di risultati strutturati. I team operativi possono utilizzarlo per flussi di lavoro che integrano dati, regole e contesto aziendale. In ogni caso, il flusso di lavoro richiede criteri di accettazione espliciti e una fase di verifica, sia manuale che automatizzata.
Gli utenti singoli e i piccoli team potrebbero preferire un ambiente di lavoro interattivo e multimodello prima di realizzare un’integrazione API. Ciò consente di concretizzare il confronto tra Sol e Astra senza dover definire in via definitiva l’architettura dell’applicazione. Se state ancora valutando i diversi fornitori e le diverse modalità, la nostra guida a scelta di un modello di IA in base all'attività, agli strumenti e al costo offre una rosa di candidati più ampia.
Limiti e modalità di guasto
Una finestra di contesto da un milione di token rappresenta una capacità, non una memoria perfetta. Le istruzioni importanti possono comunque essere offuscate da documenti rumorosi, regole duplicate o prove contraddittorie. Strutturate gli input lunghi, identificate le fonti autorevoli e chiedete al modello di citare il file o il passaggio alla base delle conclusioni rilevanti. Il recupero e la compressione dei dati possono rivelarsi più efficaci rispetto all’invio di tutto il materiale ad ogni turno.
Il "price step" basato sul contesto esteso rappresenta un secondo rischio. Una richiesta con 273.000 token in ingresso viene addebitata alla tariffa più alta prevista per l'intera richiesta, non solo per gli ultimi mille token. Ciò può generare fatture inaspettate nelle applicazioni che assemblano il contesto in modo dinamico. È opportuno aggiungere il conteggio dei token e i controlli sul budget prima della richiesta, oltre a registrare quali documenti hanno fatto superare il limite alla chiamata.
L'uso di strumenti amplia le funzionalità e la superficie di attacco. Considerare le pagine web, i file recuperati e i risultati prodotti dagli strumenti come dati non attendibili. Verificare gli argomenti delle funzioni, isolare l'esecuzione del codice, limitare i percorsi dei file e l'accesso alla rete e richiedere una conferma per le azioni ad alto impatto. Il supporto offerto dal modello per l'uso di shell ospitate o di computer non costituisce un motivo per concedere autorizzazioni estese.
Infine, i primi test condotti dai creatori possono fornire informazioni utili senza però essere definitivi. Diverse indicazioni di sistema, strumenti, strutture di supporto, limiti di tempo e griglie di valutazione possono ribaltare il risultato di un apparente vincitore. Utilizzate i test pubblici per progettare la vostra valutazione, non per evitarla. Un modello che eccelle nella creazione di un gioco visivo potrebbe comunque non superare il vostro piano di migrazione, e viceversa.
Domande frequenti
Queste risposte riassumono le informazioni ufficiali relative all’API e i criteri decisionali pratici trattati in precedenza.
Che cos’è GPT-6.1 Sol?
GPT-6.1 Sol è un modello di ragionamento OpenAI destinato alla programmazione complessa, all’uso del computer e alle attività professionali. La classificazione OpenAI lo colloca tra il livello Luna, a basso costo, e il livello Astra, di punta, offrendo prestazioni quasi pari a quelle di Astra a un prezzo per API inferiore.
Quanto costa GPT-6.1 Sol?
Il prezzo standard dell'API è di $2 per milione di token in ingresso, $0,10 per milione di token in ingresso memorizzati nella cache, $2,50 per milione di token scritti nella cache e $10 per milione di token in uscita. I prompt lunghi, la modalità Fast, l’elaborazione regionale, l’elaborazione in batch e Flex possono modificare la tariffa effettiva.
Che cos’è la finestra di contesto di GPT-6.1 Sol?
OpenAI prevede una finestra di contesto di 1.050.000 token, un input massimo di 922.000 token e fino a 128.000 token in output. Una finestra ampia consente al modello di esaminare una quantità considerevole di materiale, ma non garantisce un recall perfetto né rende ogni richiesta di grandi dimensioni economicamente vantaggiosa.
GPT-6.1 Sol è adatto alla programmazione?
È progettato per la programmazione complessa e supporta output strutturati, chiamate di funzione, interprete di codice, shell ospitata, applicazione di patch, competenze, MCP e altri strumenti tramite l'API Responses. I team di produzione dovrebbero comunque eseguire test specifici per il repository prima di passare a un flusso di lavoro critico.
È meglio usare GPT-6.1 Sol o GPT-6 Astra?
Scegliete Sol quando il costo è un fattore determinante e la vostra valutazione dimostra che soddisfa gli standard di qualità. Scegliete Astra per i lavori più impegnativi, quando la qualità marginale giustifica una tariffa standard cinque volte superiore. Provate entrambe le soluzioni su attività rappresentative simili prima di decidere.
Cosa succede quando un prompt supera i 272.000 token di input?
OpenAI afferma che la richiesta completa viene fatturata al doppio delle velocità normali di input e di cache e a 1,5 volte la velocità normale di output una volta che l'input supera i 272K token. Questo cambiamento repentino può avere un'importanza maggiore rispetto alla dimensione della finestra di contesto indicata nel titolo nelle applicazioni con documenti lunghi.
GPT-6.1 Sol supporta l'API Chat Completions?
Sì, la funzionalità "Chat Completions" è supportata per le richieste che non prevedono l'utilizzo di strumenti. OpenAI indirizza gli sviluppatori all'API "Responses" per l'utilizzo degli strumenti; pertanto, le nuove applicazioni basate su agenti o che utilizzano strumenti dovrebbero normalmente partire dall'API "Responses" anziché fare affidamento sull'interfaccia precedente.
GPT-6.1 Sol è in grado di accettare immagini?
Sì. La pagina ufficiale del modello indica come input testo e immagini e come output testo. L'audio e il video non sono modalità supportate dal modello, sebbene un'applicazione possa avvalersi di altri servizi o strumenti correlati al modello qualora fossero necessari tali tipi di contenuti multimediali.
Come posso utilizzare GPT-6.1 Sol su GlobalGPT?
Apri GlobalGPT, avvia una nuova chat e seleziona GPT-6.1 Sol quando compare nel selettore dei modelli del tuo account. GlobalGPT è un pratico spazio di lavoro multimodello; le chiavi API, i controlli di distribuzione e l'automazione del repository rimangono flussi di lavoro separati per gli sviluppatori.
Verdetto finale
GPT-6.1 Sol è l’opzione GPT-6 più interessante per gli acquirenti che necessitano di notevoli capacità di ragionamento e programmazione, ma non possono giustificare l’acquisto di Astra per ogni esecuzione. Eguaglia i limiti massimi di contesto e output di Astra, utilizza lo stesso cutoff di conoscenza fissato al 30 aprile 2026 e costa un quinto in meno per ogni token di input e output non memorizzato nella cache alle tariffe Standard. Lo sconto per gli input memorizzati nella cache è inoltre più consistente rispetto al precedente GPT-6 Sol.
Il modello non è automaticamente la scelta migliore. Luna rimane nettamente più economica per attività mirate, mentre Astra potrebbe comunque ridurre il numero di revisioni nei compiti più complessi. Il confronto corretto è il costo totale per risultato accettato, misurato utilizzando lo stesso prompt, gli stessi strumenti, gli stessi dati e le stesse regole di valutazione. Oltre i 272.000 token di input, occorre tenere conto del moltiplicatore di prezzo prima di prendere una decisione.
Apri GlobalGPT, seleziona GPT-6.1 Sol quando è disponibile e confrontalo con Astra o Luna utilizzando un’attività reale e una checklist di accettazione.
Apri GlobalGPTPer l'implementazione dell'API, inizia dalla pagina ufficiale del modello e da una piccola richiesta all'API Responses. Per un confronto interattivo, utilizza il percorso multi-modello sopra indicato. In entrambi i casi, conserva i risultati, l'utilizzo, le impostazioni e gli errori. La promessa di GPT-6.1 Sol non è semplicemente quella di token più economici; è piuttosto una maggiore opportunità di eseguire ragionamenti efficaci con una frequenza tale da renderli parte integrante del flusso di lavoro.









