 Chloe Murphy
Idrogeno
Tempo osservato55,21 sToken di input4,273Token di output8,243
Valutazione dell'output
Corretto: A+C+D, costo 16, valore 31. Identificato anche A+C+E come unico altro portafoglio ammissibile con valore almeno 30.
Confrontiamo i benchmark pubblicati da Google e i prezzi delle API, quindi testiamo tutti e tre i modelli su compiti identici con risultati verificati, prompt, tempo e utilizzo dei token.

Hydrogen ha il prezzo ufficiale dei token più basso; Carbon punta al ragionamento più profondo; Argon bilancia ragionamento all'avanguardia ed efficienza. Tutti e tre hanno superato i nostri quattro compiti completati. Il test di codice più difficile ha evidenziato differenze di formattazione e spiegazione piuttosto che un vincitore in correttezza.
Google ora ha tre modelli Gemini 4 con nomi che dicono molto poco su quale scegliere. Dovresti iniziare con Hydrogen, usare Argon per lavori impegnativi o pagare per il ragionamento più profondo di Carbon?
Il confronto utile è la capacità per attività: cosa ogni modello può risolvere, quanto ragionamento utilizza e quanto costa una risposta completa. I punteggi ufficiali dei benchmark ci danno un punto di partenza; sono necessari compiti difficili con lo stesso prompt per vedere dove queste differenze contano.
Abbiamo testato tutti e tre i modelli sugli stessi compiti tramite GlobalGPT. Se vuoi confrontare il tuo carico di lavoro, inizia con GlobalGPT e controlla le opzioni di modello e i termini di utilizzo attuali del tuo account.
Progettato per codifica quotidiana veloce ed esecuzione agentica.
Può essere eseguito autonomamente o gestire l'esecuzione insieme a modelli di ragionamento più profondo.
Indice riportato da Google: 51 a pensiero alto, 54 a xhigh.
Fonte: L'annuncio di Hydrogen di Google.
Il modello di ragionamento Gemini 4 più capace.
Pensato per debugging difficile, ricerca scientifica e verifica estesa.
Può usare più token di ragionamento di Argon nonostante tariffe per token uguali.
Fonte: L'annuncio di disponibilità di Carbon di Google.
Ragionamento di frontiera efficiente per codifica, matematica e scienza impegnative.
Google lo posiziona come più veloce e meno intensivo in token di Carbon.
Il suo ruolo è un equilibrio tra profondità di ragionamento e costo del compito.
Fonte: La documentazione su modelli e prezzi di Google.
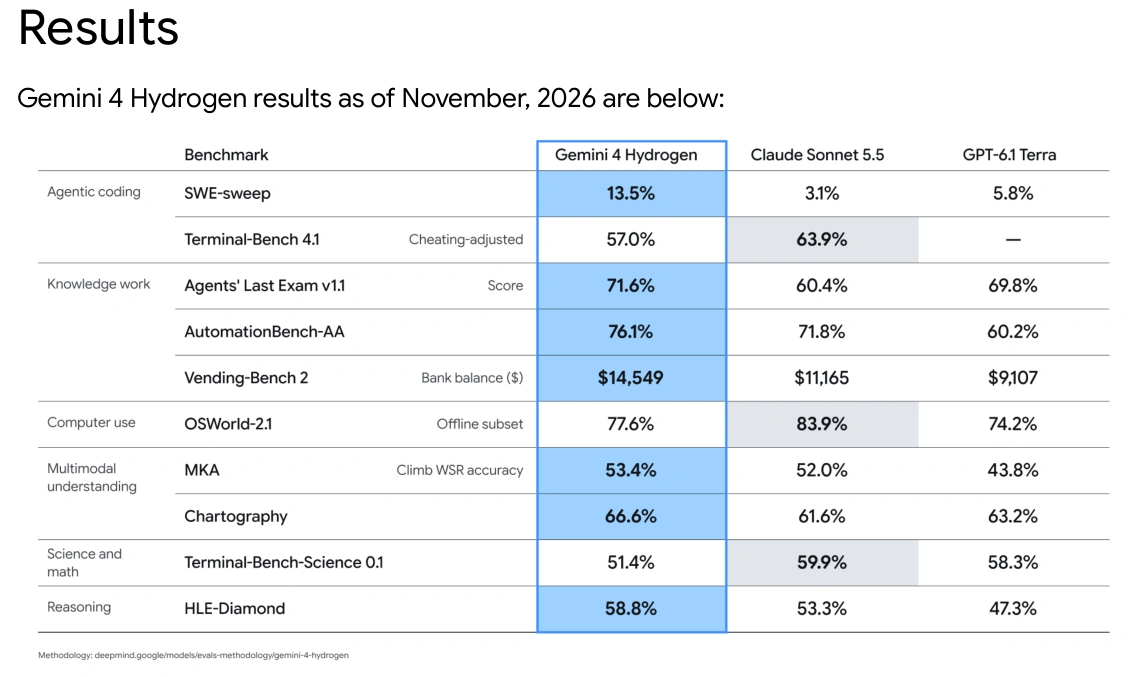
BENCHMARK PUBBLICATO · PIÙ ALTO È MEGLIO
Una rapida occhiata ai punteggi riportati da Google.
Questi sono risultati pubblicati riportati da Google, verificati il 15 novembre 2026. Non sono punteggi dei nostri test. La cifra di Carbon proviene dal suo annuncio; le cifre di Hydrogen e Argon provengono dall'annuncio di Hydrogen sopra. Si tratta di un confronto tra fonti di annunci diversi, piuttosto che di una nuova esecuzione di classifica a tre modelli con impostazioni identiche verificate in modo indipendente.
Non inserire i dati di Terminal-Bench 4.0 e 4.1 nella stessa colonna classificata. Una versione di valutazione modificata può cambiare la difficoltà dei compiti, quindi le percentuali non supporterebbero un confronto diretto equo.
Prezzi standard dell'API Gemini in USD per un milione di token, verificati il 15 novembre 2026:
API GEMINI STANDARD · USD PER 1 MILIONE DI TOKEN
Input
OUTPUT · INCLUSO PENSIERO
Input
OUTPUT · INCLUSO PENSIERO
Input
OUTPUT · INCLUSO PENSIERO
*Le tariffe pubblicate attuali di Hydrogen non specificano alcun aumento a dicembre; questa non è una garanzia contro modifiche future. La fatturazione dell'output include i token di pensiero. I costi di ricerca e altri strumenti sono separati. Queste sono le tariffe API di Google, non i prezzi di abbonamento o le conversioni di crediti di GlobalGPT.
A conteggi di token fissi, Hydrogen costa25% in meno rispetto a Carbon o Argon alle loro tariffe introduttive. Rispetto alle tariffe annunciate di dicembre, tale differenza diventa 62,5%. Il costo effettivo dell'attività dipende anche dai token di ragionamento, dai nuovi tentativi e dall'uso degli strumenti.
Ad esempio, 100.000 token di input e 20.000 token di output fatturabili costano $0,30 su Hydrogen, $0,40 su Carbon o Argon fino al 30 novembre e $0,80 su Carbon o Argon dal 1° dicembre. Questo calcolo esclude strumenti, caching, sconti per lotti e nuovi tentativi; non prevede quanti token richiede ciascun modello.
Hydrogen ha un livello API gratuito con limiti di velocità. Carbon e Argon non ce l'hanno. Gli abbonamenti consumer sono un acquisto separato con le proprie regole di accesso.
Fonte: Prezzi delle API di Google.
Abbiamo testato Hydrogen, Carbon e Argon su quattro compiti identici. I primi tre hanno verificato l'accuratezza di base; il compito finale richiedeva un programma completo di ricerca esatta che abbiamo eseguito e confrontato con una risposta calcolata in modo indipendente.
Stesso input e istruzione di sistema per ogni attività.
Nuove richieste, contesto del progetto disabilitato e nessun uso di strumenti del modello.
Correttezza, formato di output, tempo e utilizzo dei token valutati separatamente.
TEST 1 · BASELINE DI ACCURATEZZA
Seleziona il portafoglio ottimale e identifica ogni alternativa qualificante.
Solve exactly, showing verifiable arithmetic and a proof of optimality. Six indivisible projects have (cost, value): A(7,13), B(6,12), C(5,10), D(4,8), E(3,7), F(2,4). Budget=16. C requires A. D and E cannot both be selected. B requires at least one of D or F. Select projects maximizing total value; break ties by lower cost then alphabetically sorted project-list. Give chosen list, cost, value and enumerate all feasible candidates with value at least 30. No external tools or web.
Corretto: A+C+D, costo 16, valore 31. Identificato anche A+C+E come unico altro portafoglio ammissibile con valore almeno 30.
Corretto: A+C+D, costo 16, valore 31. Identificato anche A+C+E come unico altro portafoglio ammissibile con valore almeno 30.
Corretto: A+C+D, costo 16, valore 31. Ha inoltre identificato A+C+E come l'unico altro portafoglio ammissibile con valore almeno 30.
Verdetto del compito: Tutti e tre hanno superato i controlli fondamentali sulle risposte.
TEST 2 · BASELINE DI ACCURATEZZA
Separare la conversione aggregata dagli effetti a livello di dispositivo e dal lift standardizzato.
Analyze a randomized experiment using only these counts. Variant A: mobile 90 purchases/900 visitors; desktop 80/100. Variant B: mobile 20/100; desktop 630/900. Show overall and device-specific conversion rates, absolute lifts B-A, and a standardized B-A lift using 50% mobile/50% desktop. Explain the reversal, distinguish observational aggregate from randomized causal interpretation, and state exactly what randomization details are missing. May we claim B wins overall and in both devices? Do not invent significance or revenue. No external tools or web.
Corretto: B è in vantaggio di 48 punti percentuali complessivi, ma perde 10 punti su desktop. Un mix di dispositivi comune 50/50 dà lift nullo. Ha rifiutato una vittoria in entrambi i segmenti.
Corretto: B è in vantaggio di 48 punti percentuali complessivi, ma perde 10 punti su desktop. Un mix di dispositivi comune 50/50 dà lift nullo. Ha rifiutato una vittoria in entrambi i segmenti.
Corretto: B conduce di 48 punti percentuali in generale, ma perde 10 punti su desktop. Una comune miscela di dispositivi 50/50 dà zero incremento. Ha rifiutato una vittoria in entrambi i segmenti.
Verdetto dell'attività: Tutti e tre hanno superato i controlli di risposta principali.
TEST 3 · BASELINE DI ACCURATEZZA
Applica correttamente revisioni, annullamenti e rimborsi, quindi restituisci JSON rigoroso.
Return valid JSON only, no Markdown. Reconcile event ledger by event_id: retain highest revision, then exclude void=true. Amounts are integer cents; refund amounts subtract from captured revenue even when received before capture; group by order_id; ignore pending. Ledger: [e1,r1,o1,capture,1000,false];[e1,r2,o1,capture,1200,false];[e2,r1,o1,refund,200,false];[e3,r1,o2,refund,300,false];[e4,r1,o2,capture,2000,false];[e5,r1,o3,capture,500,false];[e5,r2,o3,capture,500,true];[e6,r1,o3,pending,900,false];[e7,r1,o4,capture,700,false];[e8,r1,o4,refund,800,false];[e8,r2,o4,refund,600,false];[e9,r1,o2,refund,100,false]. Output keys orders (array sorted by order_id with order_id,net_cents,retained_event_ids sorted lexically), total_net_cents, excluded_event_ids (superseded event versions written as event_id:rN plus void and pending versions). Include o3 with zero net. No external tools or web.
Corretto: totali ordine di 1.000, 1.600, 0 e 100 centesimi; totale 2.700 centesimi. Output grezzo analizzato come JSON senza pulizia.
Corretto: totali ordine di 1.000, 1.600, 0 e 100 centesimi; totale 2.700 centesimi. Output grezzo analizzato come JSON senza pulizia.
Corretto: totali ordine di 1.000, 1.600, 0 e 100 centesimi; totale 2.700 centesimi. Output grezzo analizzato come JSON senza pulizia.
Verdetto dell'attività: Tutti e tre hanno superato i controlli fondamentali sulle risposte.
TEST 4 · ATTIVITÀ DI CODIFICA HARD
Genera Python eseguibile per una ricerca vincolata; abbiamo eseguito ogni programma rispetto a un riferimento esaustivo indipendente.
Find the EXACT top 5 feasible portfolios, ranked by highest total value, then lowest total cost, then lexicographic sorted ID string. Items (ID,cost,value): [('A', 9, 19), ('B', 7, 16), ('C', 11, 25), ('D', 6, 13), ('E', 8, 18), ('F', 5, 12), ('G', 10, 23), ('H', 4, 9), ('I', 12, 29), ('J', 3, 8), ('K', 7, 17), ('L', 6, 15), ('M', 9, 22), ('N', 5, 11), ('O', 8, 20), ('P', 4, 10), ('Q', 11, 27), ('R', 2, 5)]. Budget 55; choose between 6 and 9 items inclusive. Dependencies: C requires A; G requires B and D; I requires E; M requires F and H; Q requires J and K. Mutually exclusive pairs: (A,B),(E,F),(L,N),(O,Q). At least 2 of C,G,I,M,Q. Exactly 2 of D,H,L,P. At least one of B,F,J,N,R. If O is selected then P is selected and K is absent. If R is selected then exactly one of A,E is selected. Return ONLY executable Python 3 code, at most 120 lines. Implement an exact exhaustive search, print JSON with keys feasible_count and top5 (each row [sorted_ID_string,cost,value]). Do NOT manually calculate or hardcode the answer. State complexity in a code comment. Use only itertools and json; no filesystem, network, subprocess or other imports. The code will be executed and checked against an independent exhaustive reference.Superato: il codice eseguibile ha restituito 121 portafogli fattibili e i i primi cinque corretti. Includeva il conteggio corretto delle combinazioni e una spiegazione più completa della complessità.
Superato: codice eseguibile restituito 121 portafogli fattibili e i i primi cinque corretti. Il conteggio delle combinazioni era corretto; la nota sulla complessità ha omesso il termine di ordinamento finale.
Superato dopo la rimozione di un recinto Markdown: codice restituito 121 portafogli fattibili e i i primi cinque corretti. Il commento sosteneva 115.379 combinazioni invece di 142.766 e ometteva l'ordinamento nella nota sulla complessità.
Verdetto del compito: Correttezza funzionale pari. Hydrogen ha fornito la combinazione più pulita di formattazione eseguibile e spiegazione in questa esecuzione.
I tempi sono osservazioni end-to-end di singole esecuzioni, inclusi tempo di rete e di coda, con richieste eseguite simultaneamente. I token riportano l'utilizzo di input/output e possono includere token di ragionamento o di wrapper della richiesta; non sono addebiti in dollari. Un tentativo separato di risposta diretta ha raggiunto i limiti di velocità o un timeout locale ed è stato escluso dal punteggio di qualità. L'attività di codifica sopra ha utilizzato un nuovo prompt abbinato.
Iniziate con Hydrogen quando le sue tariffe ufficiali per token più basse si adattano al vostro carico di lavoro. Mantenete Argon nel confronto se apprezzate il ragionamento di frontiera efficiente: ha risolto correttamente il nostro compito di codifica con ricerca esatta dopo la pulizia della formattazione. Valutate Carbon per lavori che richiedono un'esplorazione più approfondita; questo set di test non ha dimostrato un vantaggio di correttezza che giustificherebbe la scelta predefinita. Verificate il costo della piattaforma visualizzato separatamente dalle tariffe dell'API di Google.
Hydrogen ha le tariffe API standard elencate più basse: $1,50 per milione di token in input e $7,50 per milione di token in output, verificate il 15 novembre 2026.
Le loro tariffe standard per token elencate sono uguali. Carbon può comunque costare di più per attività se utilizza più token di ragionamento o passaggi di verifica.
No. Controlla la versione del benchmark e l'impostazione di ragionamento, quindi testa il modello su attività rappresentative con risposte verificabili in modo indipendente.
Abbiamo eseguito ogni risolutore Python generato e confrontato il conteggio delle soluzioni ammissibili e i primi cinque portafogli con un riferimento indipendente di ricerca esaustiva.
La nostra guida all'accesso ad Argon spiega le differenze tra accesso alla piattaforma, abbonamenti Google, AI Studio e fatturazione API.
Per i dettagli sull'accesso, leggi come usare Gemini 4 Argon. Per confrontare i modelli in un unico account, inizia con GlobalGPT e controlla il modello selezionato e le condizioni d'uso visualizzate.