
Claude Fable 5.2 vs Opus 5.5: programmazione, costi e quale usare
Cinque attività con gli stessi prompt confrontano Claude Fable 5.2 e Opus 5.5 su ricerca, progettazione di interfacce AI, scrittura, dati e pianificazione del prodotto, con screenshot originali e utilizzo registrato di tempo e token.
 Chloe Murphy

Opus 5.5 è il punto di partenza sensato per il lavoro di routine; testa Fable 5.2 quando un'attività specifica necessita ancora di miglioramenti. Nelle nostre quattro coppie di attività testuali completate, entrambi i modelli hanno risolto correttamente il calcolo di ricerca centrale e le metriche dei dati. Il piano prodotto di Fable ha gestito un'incertezza con maggiore attenzione; entrambi i testi prodotti rispettavano i vincoli principali.
Il confronto di progettazione utilizza una nuova esecuzione abbinata da 32.768 token. I suoi screenshot, i controlli delle interazioni e le limitazioni sono riportati nell'attività di progettazione qui sotto.
Fable 5.2 è più recente e costa di più per token. Ma offre un risultato migliore o semplicemente un conto più salato? Abbiamo confrontato ricerca, progettazione di interfacce IA, scrittura, analisi dei dati e decisioni di prodotto utilizzando lo stesso brief di attività per ciascun modello.
Se preferisci confrontare i modelli senza gestire configurazioni API separate, GlobalGPT offre uno spazio di lavoro multi-modello. I test API qui riportati non attestano la disponibilità di Fable 5.2 all'interno di GlobalGPT.
Il confronto pratico
| Decisione | Fable 5.2 | Opus 5.5 |
|---|---|---|
| Input / output standard per milione di token | $8 / $40 | $4 / $20 |
| Test di ricerca | Calcolo corretto; formulazione causale da rivedere | Calcolo corretto; dettaglio del disegno di studio non supportato |
| Test dei contenuti | Spiegazione di 180 parole; voce fuori campo più breve | Spiegazione di 180 parole; esempio più completo |
| Test dei dati | Tutti i parametri richiesti sono corretti | Tutti i parametri richiesti sono corretti |
| Test del prodotto | Attenta distinzione tra danno confermato e danno possibile | Piano utile; affermazione non supportata di lavoro perso |
| Tentativo di progettazione originale | Nessun artefatto: errore HTTP | HTML completo dopo la pulizia dei blocchi di codice |
Come abbiamo testato i due modelli
Ogni attività ha utilizzato materiale di origine identico, una nuova conversazione e lo stesso limite di output per entrambi i modelli. Le attività di testo hanno utilizzato un tetto di 16.000 token; l'esecuzione di progettazione finale ha utilizzato 32.768. Prompt, impostazioni, tempo e utilizzo compaiono con l'attività corrispondente di seguito.
Tutti gli studi, i prodotti, i dati degli ordini e i feedback nei brief erano fixture di test fittizie. Abbiamo verificato i calcoli rispetto a una chiave di risposta preparata. Lo sforzo di ragionamento è rimasto al valore predefinito della piattaforma, quindi non si tratta di un benchmark a pari sforzo. Le etichette dei modelli restituite dal gateway di terze parti non stabiliscono in modo indipendente il routing a monte.
Ricercatore: sintesi senza sopravvalutare le prove
Stesso prompt · Test del ricercatore
You are a researcher. Use only these FICTIONAL study summaries about an AI writing assistant. A: randomized 120 adults, 60 per arm, intervention mean score baseline70 followup78, control baseline69 followup74, four weeks; no standard deviations, uncertainty intervals, or attrition information reported. B: observational 300 adults, usage correlated with writing scores r=.32, no confounder adjustment. C: interviews with12 users reporting perceived improvement. In under650 words synthesize evidence with A/B/C citations, calculate difference in changes, explain what cannot be inferred, and propose a feasible preregistered followup study with primary endpoint and analysis. Do not invent citations or statistical significance.
Il compito del ricercatore richiedeva una sintesi di tre studi fittizi, incluso uno studio randomizzato con reporting incompleto. Il calcolo essenziale era (78 − 70) − (74 − 69) = 3 punti. Entrambi i modelli hanno risposto correttamente e si sono rifiutati di inventare la significatività statistica.
Fable 5.2
Ha proposto una valutazione di scrittura in cieco e senza assistenza, un'analisi intention-to-treat e controlli di sensibilità per i dati mancanti. Ha inoltre fornito un esempio esplicitamente ipotetico di dimensione del campione.
“Solo la differenza di 3 punti è attribuibile all'assistente”
Quella formulazione era troppo sicura dati l'abbandono sconosciuto e le lacune nella rendicontazione, anche se i paragrafi successivi qualificavano la stima. Ha anche ipotizzato che i partecipanti alle interviste fossero probabilmente autoselezionati.
Opus 5.5
Ha separato chiaramente le evidenze randomizzate, osservative e delle interviste. Ha proposto uno studio aggiustato per il basale e ha mantenuto il calcolo della dimensione del campione dipendente dalla variabilità pilota.
“di natura trasversale come descritto”
Il riassunto osservazionale fornito non specificava un disegno trasversale. Quel dettaglio sarebbe dovuto rimanere sconosciuto.
Se adatti questo brief, mantieni fisse le prove e chiedi a ciascun modello di separare i fatti riportati dalle inferenze. I nostri Prompt di Claude per ricerca e programmazione offrono più esempi di vincoli specifici per l'attività.
Designer: uno spazio di lavoro multi-modello AI
Stesso prompt · Test Designer
You are a product designer and frontend builder. Return only one complete self-contained HTML file with inline CSS and JavaScript, no external assets/CDNs. Build a polished AI multi-model workspace called Parallel. Give it a distinctive cohesive visual identity with excellent typography, whitespace, hierarchy and responsive layout; choose your own palette. Include sidebar, model A/B selectors, prompt textarea, compare button, two side-by-side result cards, loading state, clear button, per-result copy button, empty-input validation, keyboard-accessible controls and mobile stacking. Models A/B are FICTIONAL; all outputs must be locally simulated and explicitly labeled demo. No real API calls or fake live performance metrics. Compare must work repeatedly and preserve the submitted prompt in both outputs. Copy must report success only after actual success, otherwise provide an error. Aim for a complete compact artifact, not an explanation.
Il brief del designer chiedeva a entrambi i modelli di costruire Parallelo: uno spazio di lavoro autonomo per il confronto di IA con barra laterale, selettori di modello, input di prompt, schede di risultati simulate, validazione, controlli di copia e layout mobile. Abbiamo lasciato aperta la palette di colori e l'identità visiva.
L'esecuzione finale abbinata ha utilizzato lo stesso prompt, trasporto in streaming e un limite condiviso di 32.768 token. Entrambe le risposte hanno raggiunto un arresto normale. Gli artefatti sorgente rimangono non modificati; il salvataggio dell'HTML rimuove solo una recinzione Markdown racchiusa quando presente.
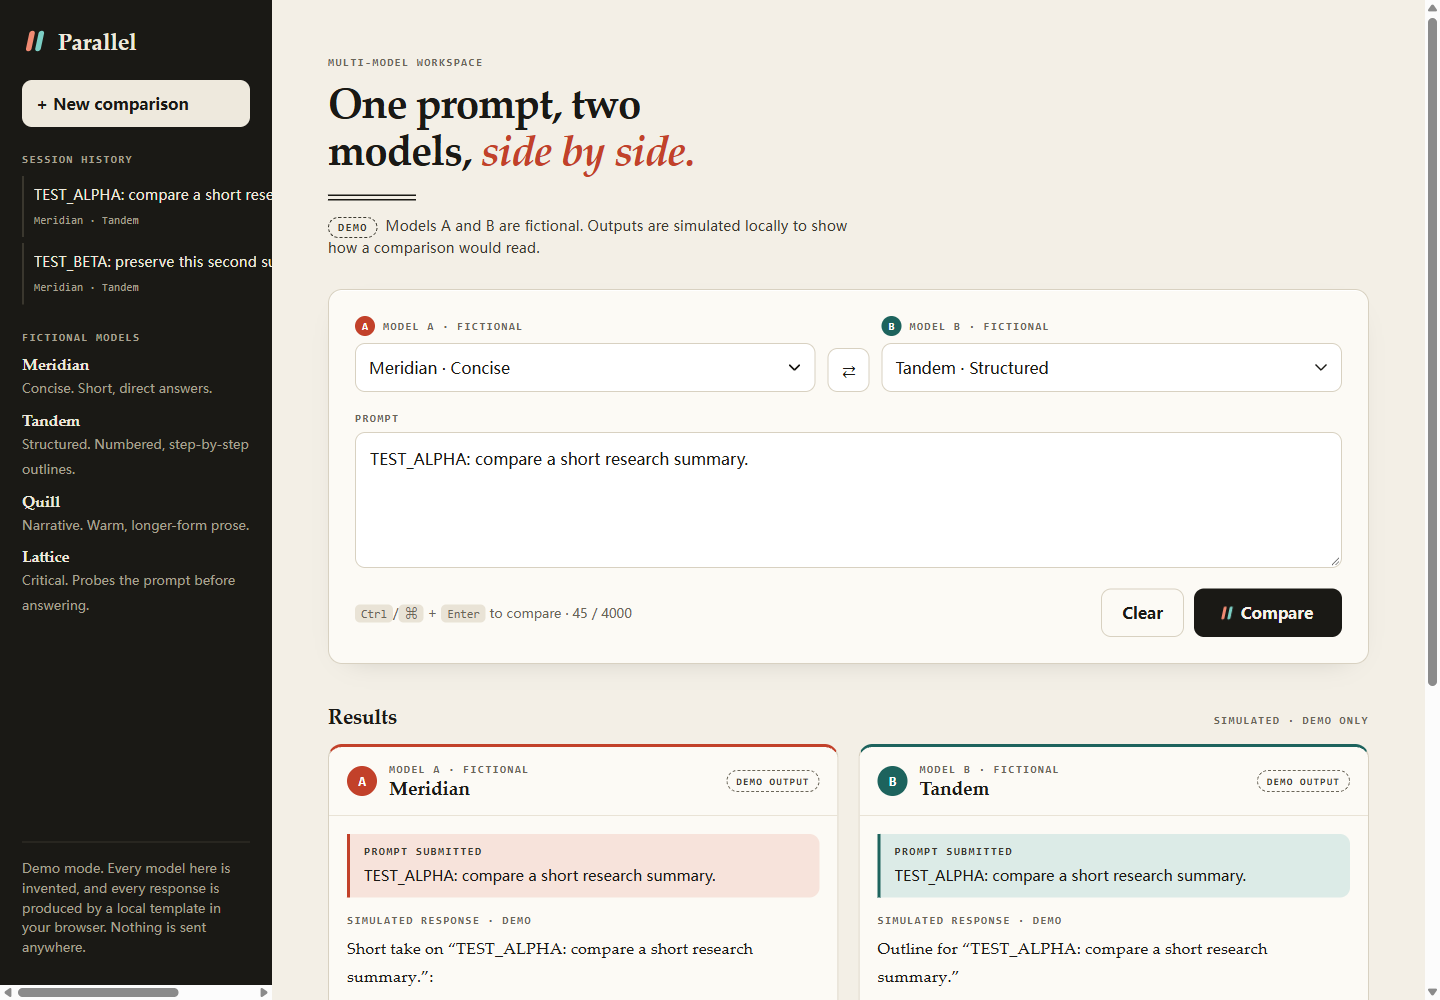
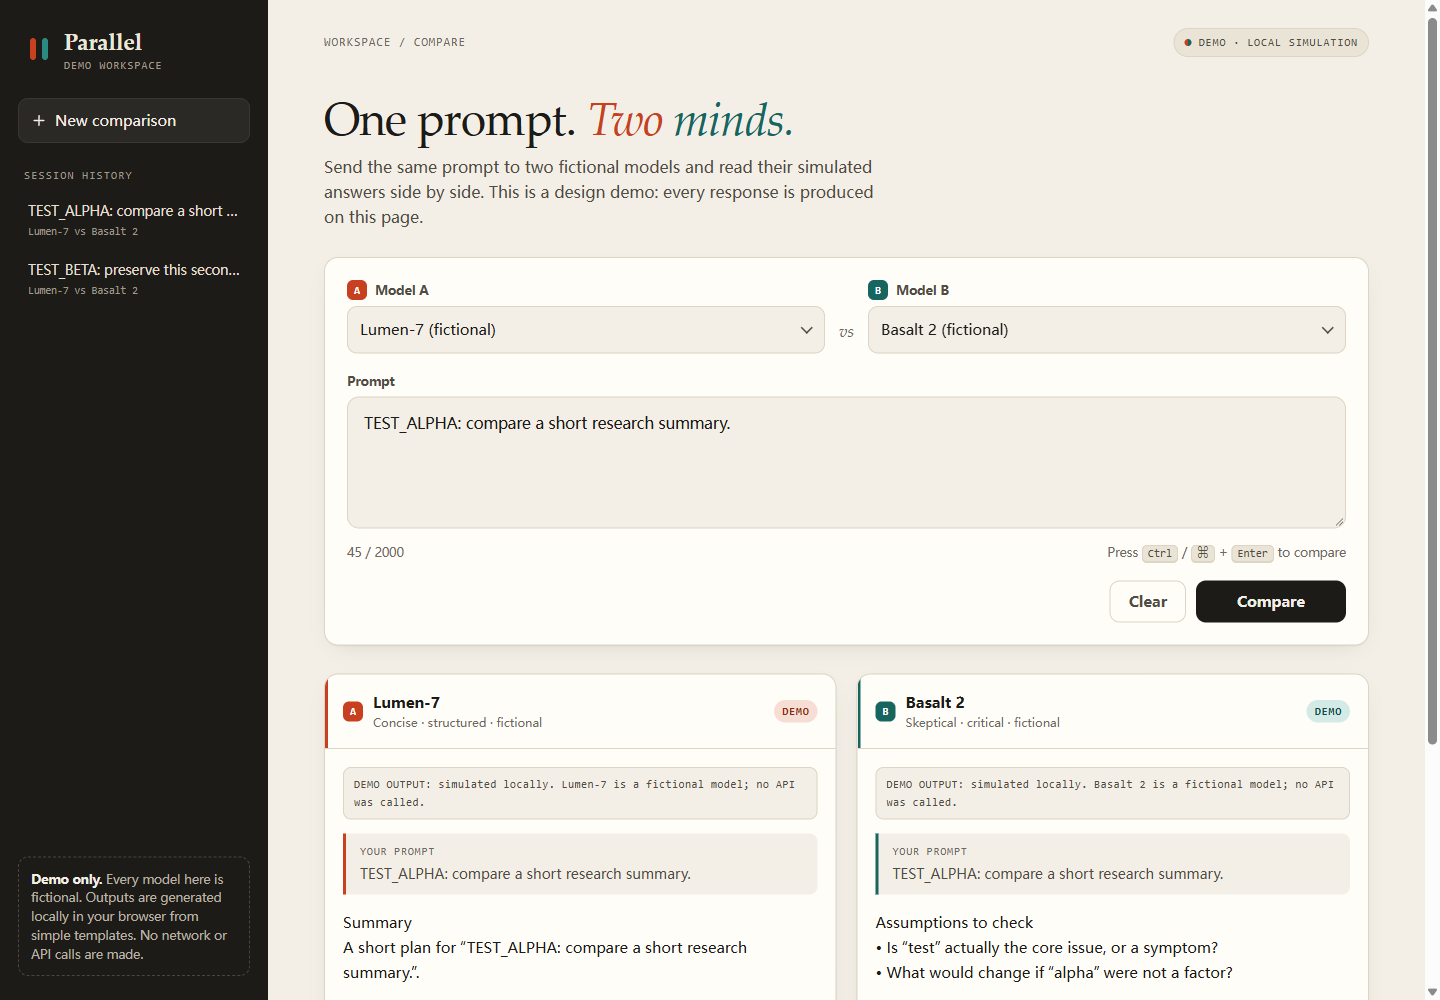
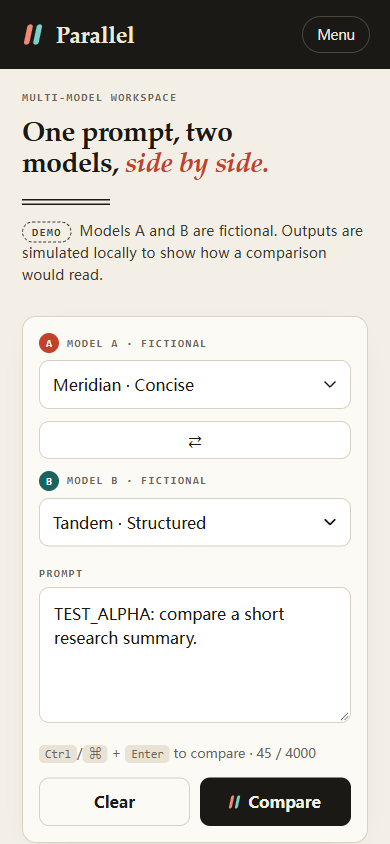
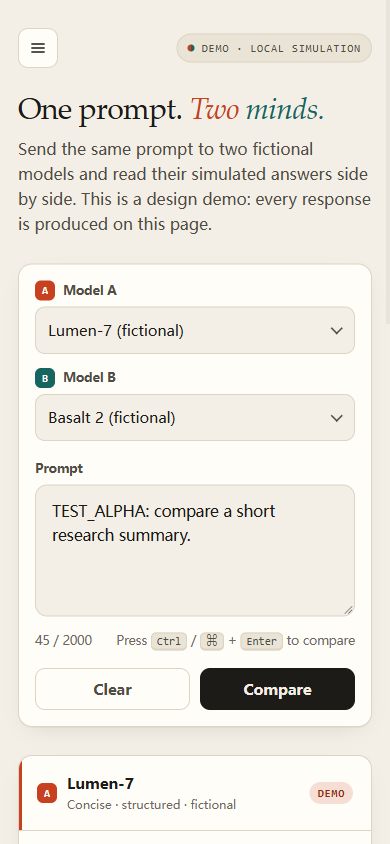
Come apparivano realmente le pagine renderizzate
Esempio Fable 5.2
Un titolo serif più pesante, enfasi rossa in corsivo e una barra laterale ad alto contrasto conferiscono a questa pagina un'identità editoriale più forte. Il controllo per il cambio di modello è un'utile aggiunta, ma occupa un'intera riga su mobile e spinge prompt e risultati più in basso.
Esempio Opus 5.5
Il titolo più leggero e l'area di selezione del modello più semplice risultano più sobri. Con lo stesso viewport mobile, il pulsante Confronta termina a circa 710 pixel dall'alto, contro gli 826 pixel del campione Fable, lasciando spazio affinché la prima scheda dei risultati appaia prima.
Entrambi hanno scelto tonalità di carta calde, barre laterali scure e titoli serif. La differenza qui sta nella gerarchia e nella densità, non in un linguaggio di design completamente diverso.Per questo particolare spazio di lavoro, preferiamo il layout compatto del campione Opus.Se la priorità è un titolo editoriale più evidente, il campione di Fable ha quel fascino. Questa è una preferenza soggettiva tra questi artefatti restituiti, non una classifica estetica generale dei modelli sottostanti.
Controlli del browser: aspetto e comportamento separatamente
| Controlla | Campione Fable | Campione Opus |
|---|---|---|
| Validazione input vuoto | Superato | Superato |
| I confronti ripetuti preservano il prompt inviato | Superato | Superato |
| Feedback di caricamento visibile | Superato | Superato |
| Cancella input | Superato | Superato |
| Overflow della pagina a larghezza 390 pixel | Nessuno misurato | Nessuno misurato |
| Il fallimento della copia segnala un errore onestamente | Superato | Superato |
| Copia negli appunti riuscita | Non verificato | Non verificato |
Abbiamo aperto gli output non modificati in Chrome e utilizzato i controlli DOM per eseguire i controlli. Gli screenshot desktop utilizzano 1440 × 1000; gli screenshot mobile utilizzano 390 × 844. Tutti e quattro mostrano lo stesso prompt inviato dopo il confronto e prima del controllo di copia. Non sono state catturate eccezioni di runtime durante questi passaggi. Le scritture negli appunti non sono riuscite nella sessione automatizzata e non è stato testato un attraversamento completo solo da tastiera.
L'utilizzo della coppia di design finale fornisce un proxy a tariffa standard di $0.8826 per Fable e $0.2918 per Opus. Questo utilizza le tariffe dei provider e i token riportati dal gateway, esclude i tentativi precedenti e non è la fattura effettiva del gateway.
Tentativi precedenti e limiti delle prove
Creatore di contenuti: testo accurato in due formati
Stesso prompt · Test del creatore di contenuti
You are a content creator. Based ONLY on these FICTIONAL product facts, write a180-word plain-English explainer and a45-second video script with timestamps, then a five-item fact-check checklist. Facts: Lumen is a fictional AI workspace; it lets users compare two AI text drafts side by side, save prompts locally in their browser, and manually copy a chosen result. It does not publish content automatically, browse the web, or verify facts. No prices, launch dates, speed metrics, supported model names, or privacy guarantees are provided. Audience: freelancers who struggle to choose a usable first draft. Explain a practical example, avoid hype and invented claims, and distinguish local prompt saving from an unproven no-training guarantee.
Il brief per il creatore forniva uno spazio di lavoro fittizio con solo tre funzionalità: confronto affiancato delle bozze, salvataggio locale dei prompt e copia manuale. Richiedeva un testo esplicativo di 180 parole, una sceneggiatura di 45 secondi e una checklist di verifica dei fatti in cinque punti.
Entrambi i testi esplicativi soddisfacevano il requisito di 180 parolesecondo la nostra regola di conteggio delle parole, che mantiene apostrofi e trattini interni all'interno di una parola. Entrambi hanno preservato i limiti delle funzionalità e hanno correttamente evitato di trattare l'archiviazione locale come una garanzia di non addestramento.
Fable 5.2
Ha aperto con la difficoltà del freelance nella scelta di una bozza, poi ha spiegato le tre funzionalità in frasi brevi. La voce fuori campo del video conteneva 101 parole: circa 135 parole al minuto se pronunciate in 45 secondi.
Opus 5.5
Ha usato un esempio di copywriter più dettagliato, contrapponendo un'apertura più forte a spiegazioni delle funzionalità più chiare. La sua voce fuori campo conteneva 109 parole: circa 145 parole al minuto nello stesso intervallo.
Quelle stime di ritmo provengono dalla voce fuori campo scritta, non da una registrazione cronometrata. Fable lascia più spazio per le pause; Opus usa più tempo per spiegare l'esempio.
Per articoli più lunghi, la nostra guida usare Claude per la scrittura di testi lunghi spiega come separare la stesura dalla verifica e dalla modifica.
Analista di dati: rimborsi, attribuzione mancante e ROAS
Stesso prompt · Test per analista di dati
You are a data analyst. Use only this synthetic data. Orders CSV(order_id,updated,status,channel,amount): o1,1,paid,Search,100; o2,1,paid,Social,80; o2,2,refunded,Social,80; o3,1,paid,Search,120; o4,1,pending,Email,60; o5,1,paid,,50; o6,1,paid,Partner,90; o7,1,paid,Email,70; o8,1,paid,Social,60; o9,1,paid,Partner,110. Channel spend/clicks: Search200/100; Social100/80; Email50/40; Partner0/20. Deduplicate by order_id keeping greatest updated. Paid orders count and revenue use latest paid only; refunded/pending contribute zero. Blank channel must remain Unknown and cannot inherit spend/clicks. Calculate overall paid count, revenue, each channel paid count/revenue/conversion rate per click/ROAS, and measurable ROAS ranking; zero or missing denominator is N/A. Show arithmetic and propose a cautious next-budget decision without inferring causality. Return table and explanation under600 words.
Il compito dell'analista è stato progettato per individuare errori che una tabella ordinata può nascondere: ID ordine duplicati, un rimborso successivo, un ordine in sospeso, un canale sconosciuto e un canale partner con spesa zero.
Entrambi i modelli corrispondevano alla chiave di risposta preparata: 7 ordini pagati e 600 di ricavi dopo aver mantenuto lo stato più recente dell'ordine. Hanno escluso i record rimborsati e in sospeso, mantenuto l'attribuzione mancante sotto Sconosciuto e contrassegnato i rapporti indefiniti come N/D.
| Canale | Ordini pagati | Ricavi | Conversione / clic | ROAS |
|---|---|---|---|---|
| Ricerca | 2 | 220 | 2.00% | 1.10 |
| Social | 1 | 60 | 1.25% | 0.60 |
| 1 | 70 | 2.50% | 1.40 | |
| Partner | 2 | 200 | 10.00% | N/D: spesa zero |
| Sconosciuto | 1 | 50 | N/D | N/D |
Fable ha mostrato l'aritmetica dei ricavi nella tabella dei canali e ha suggerito di controllare rimborsi, ordini in sospeso, tag mancanti e costi partner non registrati prima di apportare modifiche sostanziali. Opus ha aggiunto una tabella di deduplicazione record per record e ha calcolato che i ricavi non attribuiti erano l'8,3% del totale.
Entrambi hanno raccomandato un test con budget limitato piuttosto che trattare il ROAS osservato come prova causale. L'osservazione di Opus secondo cui una vendita social in più raddoppierebbe all'incirca il ROAS presuppone un importo d'ordine simile; non era un fatto nuovo nell'input.
Product manager: il danno prima dei voti sulle funzionalità
Stesso prompt · Test del product manager
You are a product manager for a FICTIONAL AI subscription workspace. Feedback: 2 users report duplicate charges after retrying checkout; billing logs confirm one duplicate captured charge. 30 users request dark mode. 8 report one model unavailable and no warning before using a prompt; outage reproduced. 1 requests account/data deletion; request pending for20 days, governing deadline unknown. 12 request reusable saved prompts. 4 want team seats; no revenue commitment. Two engineers available for one week; effort estimates unknown. Produce a one-week priority plan with rationale, explicit unknowns, scope boundaries, owner roles, acceptance criteria, instrumentation and rollback/containment steps. Do not fabricate legal deadlines, revenue, effort or certainty. Distinguish immediate containment from permanent fixes; do not rank purely by vote count. Under700 words.
Il brief del prodotto associava un addebito duplicato confermato a una richiesta di cancellazione scaduta per l'utente, un'interruzione del modello riprodotta e altre richieste di funzionalità popolari. La trappola era dare priorità a 30 voti per la modalità scura rispetto al danno dimostrato.
Entrambi i modelli hanno messo la fatturazione, il follow-up della cancellazione e il contenimento delle interruzioni prima della creazione di funzionalità. Nessuno dei due ha inventato una scadenza legale per la cancellazione. Entrambi hanno assegnato ruoli di proprietario, separato il contenimento immediato dalle correzioni permanenti e proposto controlli di accettazione e monitoraggio.
Fable 5.2
Ha specificato la riconciliazione dei rimborsi, una correzione per prevenire addebiti ripetuti e il contenimento manuale delle interruzioni. Ha trattato esplicitamente la possibile perdita di quota come qualcosa da confermare e ha contrassegnato la cancellazione come irreversibile.
Opus 5.5
È stato aggiunto un avviso prima dell'invio, la conservazione dei prompt e una regola esplicita contro il cambio silenzioso di modello. La tabella delle priorità era rapida da consultare.
Tuttavia, affermava che gli utenti “perdono lavoro e prompt in silenzio”. Il feedback fornito stabiliva un'interruzione e un avviso mancante, non una perdita comprovata di prompt.
Prezzi di Fable 5.2 rispetto a Opus 5.5
Per le richieste API standard, Fable 5.2 costa il doppio per token rispetto a Opus 5.5. Questo rende Opus il punto di partenza più economico quando entrambi i modelli offrono un risultato accettabile con un uso di token simile.
Input / output
Input / output
Queste sono le tariffe standard di input/output di Anthropic, verificate l'11 novembre 2026, dallaspecifica Fable.
La specifica Opus elenca la tariffa standard corrispondente. La modalità veloce, la memorizzazione nella cache, gli sconti per lotti, gli abbonamenti consumer e la fatturazione di terze parti hanno termini diversi.
Per una richiesta illustrativa con 10.000 token di input e 5.000 token di output, il calcolo alla tariffa standard è di $0,28 per Fable e $0,14 per Opus. Questo è un esempio elaborato, non una fattura dei nostri test.
Una tariffa per token più alta non implica un costo più elevato per attività riuscita. Una risposta più breve, meno cicli di revisione o meno ragionamento possono modificare il totale. I nostri test a turno singolo non possono stabilire risparmi a lungo termine.
Se stai integrando uno dei due modelli in un'app, guida alla configurazione dell'API Claude copre le domande di configurazione separatamente dal confronto delle tariffe dei token qui.
Moltiplicando l'utilizzo segnalato dal gateway per le tariffe standard di Anthropic si ottiene un'approssimazione basata sulle tariffe di $0,4291 per Fable contro $0,1799 per Opus in quei quattro compiti. La formula è token di input × tariffa di input + token di output × tariffa di output, diviso per un milione. Questo esclude tutte le richieste di progettazione e le chiamate non riuscite.proxy basato sulle tariffe di $0,4291 per Fable contro $0,1799 per Opus in queste quattro attività. La formula è token di input × tariffa di input + token di output × tariffa di output, diviso per un milione. Ciò esclude tutte le richieste di progettazione e le chiamate non riuscite.
Questo proxy è non è l'addebito effettivo del gateway. Non abbiamo verificato la fattura, l'equivalenza della contabilità dei token o il margine. Inoltre non misura il costo di successive modifiche umane o di tentativi aggiuntivi.
Cosa stabiliscono i benchmark ufficiali
La valutazione di lancio di Anthropic dà a Fable un vantaggio su diversi compiti difficili. La tabella seguente riproduce tre punteggi riportati; si tratta di valutazioni del fornitore, separate dai nostri test basati sui ruoli.
| Valutazione | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0 | 49.1% | 45.5% |
| FrontierSWE v2 | 69.9% | 62.3% |
| Terminal-Bench-Science 0.1 | 74.6% | 58.7% |
Il rapporto di lancio utilizza il massimo sforzo disponibile di ciascun modello, salvo diversa indicazione. Questi punteggi supportano la prova di Fable in lavori tecnici impegnativi; non stabiliscono un vantaggio universale nella scrittura, nel giudizio sul prodotto o nel gusto visivo.
Entrambi i modelli indicano una finestra di contesto di un milione di token e un limite di output di 128.000 token. Tali limiti non sono stati sottoposti a stress test in questa sede.
Domande frequenti
Fable 5.2 è migliore di Opus 5.5 per la programmazione?
Anthropic riporta punteggi Fable più alti in diverse difficili valutazioni di codifica. Il nostro esercizio di codifica è uno spazio di lavoro AI a file singolo, non un benchmark di repository, quindi non può stabilire un vincitore generale nella codifica.
Fable 5.2 costa di più?
Le tariffe standard di input e output API sono il doppio di quelle di Opus 5.5: 8 $/40 $ contro 4 $/20 $ per milione di token. Il costo effettivo delle attività dipende anche da utilizzo, ragionamento, nuovi tentativi, caching e dal servizio che emette la fattura.
Questi test sono stati eseguiti all'interno di GlobalGPT?
No. Hanno usato i modelli nominati tramite un gateway API di terze parti. Non stabiliscono disponibilità dei modelli, fatturazione o funzionalità native all'interno di GlobalGPT o delle app di Claude.
Ci si può fidare di uno dei due modelli per riassumere la ricerca senza verificare?
Entrambe le risposte di ricerca hanno calcolato correttamente il risultato principale, ma ciascuna ha introdotto almeno un'inferenza che necessitava di modifiche. Controlla ogni dettaglio del disegno dello studio e separa le stime dalle affermazioni di significatività.
Una pagina generata esteticamente migliore dimostra una migliore capacità di codifica?
No. Il design visivo, le interazioni funzionanti, l'accessibilità e la manutenibilità sono dimensioni separate. Una singola pagina attraente non può stabilire l'affidabilità della codifica a livello di repository.
Ai modelli è stato dato lo stesso sforzo di ragionamento?
Abbiamo utilizzato input e limiti di output identici, con le impostazioni di ragionamento lasciate al valore predefinito della piattaforma. Il mapping del gateway non è stato verificato in modo indipendente, quindi non si tratta di un benchmark a pari sforzo.
Dovrei passare tutto il mio lavoro a Fable 5.2?
Utilizzate prima un test di accettazione specifico per l'attività. Iniziate con il modello meno costoso che lo soddisfa, poi passate a Fable quando riuscite a identificare un miglioramento utile.
Verdetto finale: quale modello dovreste usare?
Iniziate con Opus 5.5 quando l'obiettivo è una prima bozza accettabile. La sua tariffa standard per token più bassa lo rende la base pratica per la scrittura di routine, la pulizia dei dati e la pianificazione. Per maggiori informazioni, consultate la nostra recensione di Claude Opus 5.5.
Provate Fable 5.2 quando un compito difficile specifico non soddisfa ancora i vostri criteri di accettazione. Mantenete gli stessi input e verificate se risolve il guasto effettivo. Le linee guida per la selezione del modello raccomanda altresì di iniziare con l'ultimo Opus e di passare a un livello superiore quando l'Opus con sforzo maggiore non è sufficiente.
Se nessuno dei due modelli premium è necessario, Sonnet 5.5 vs Opus 5.5 è il confronto dei costi più rilevante.
Per un insieme più ampio di fornitori, vedere i nostri test del generatore di testo AI.
Per il lavoro sui repository, la demo a file singolo di questa recensione è solo un punto di partenza. Non testa l'accesso alla shell, le modifiche multi-file, l'uso prolungato degli strumenti o il comportamento di ripristino di un agente di codifica. Per i dettagli di configurazione, consultare la nostra guida scegliere un modello in Claude Code prima di considerare un completamento chat come sostituto di un ambiente di sviluppo completo.



