Il modello DeepSeek V4 Pro è ora disponibile in versione di serie, ma la scelta tra Pro, Flash e Vision-Exp è diventata meno immediata dopo gli aggiornamenti di agosto 2026. I tre modelli condividono lo stesso nome di famiglia, ma rispondono a priorità diverse: affidabilità in condizioni complesse, costi e volumi, oppure input di immagini.
La scelta pratica dipende innanzitutto dal carico di lavoro. La versione Flash è il punto di partenza più sensato per testi di grandi volumi e automazioni in cui il budget è un fattore determinante. La versione Pro è la scelta più indicata quando una risposta incoerente comporta costose rielaborazioni. Quando l’input include immagini, utilizzare deepseek-v4-flash-vision-exp piuttosto che uno dei due modelli basati esclusivamente sul testo.
Se preferisci riunire in un unico flusso di lavoro le attività di ricerca, scrittura, ragionamento e assistenza alla programmazione, puoi accedere a GlobalGPT. Esiste inoltre un percorso dedicato per DeepSeek V4 Pro. Si tratta di un'interfaccia alternativa; la fatturazione, i limiti e le integrazioni dell'API ufficiale continuano a far parte dell'ambiente proprio di DeepSeek.

La versione DeepSeek V4 è stata rilasciata ufficialmente?
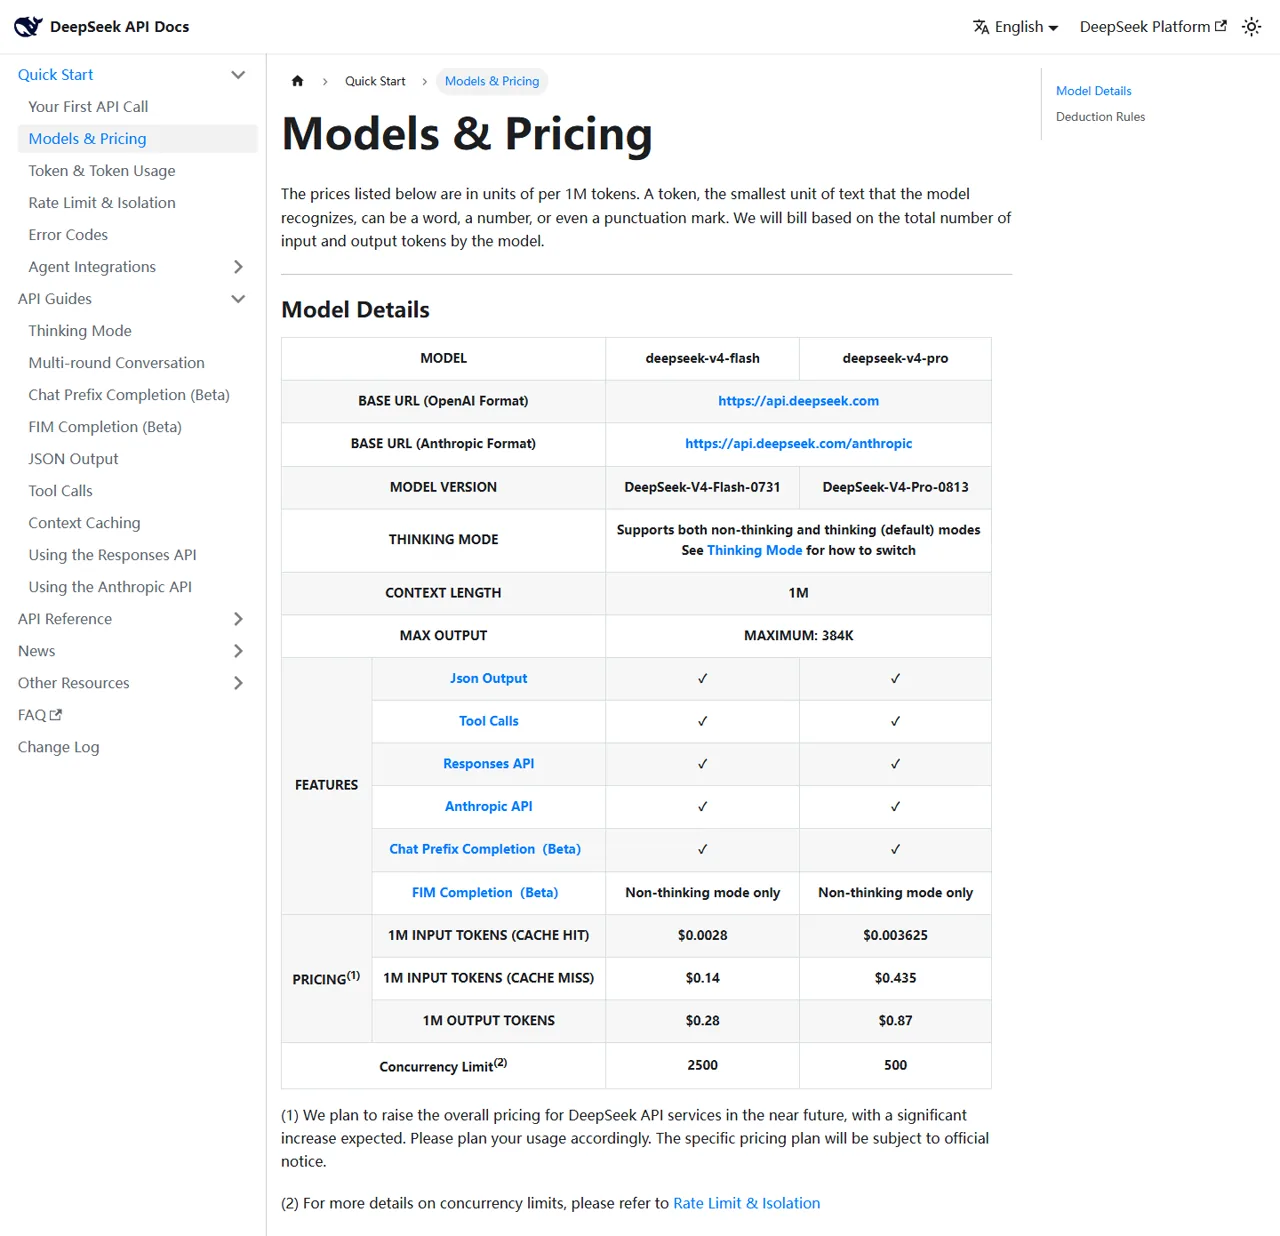
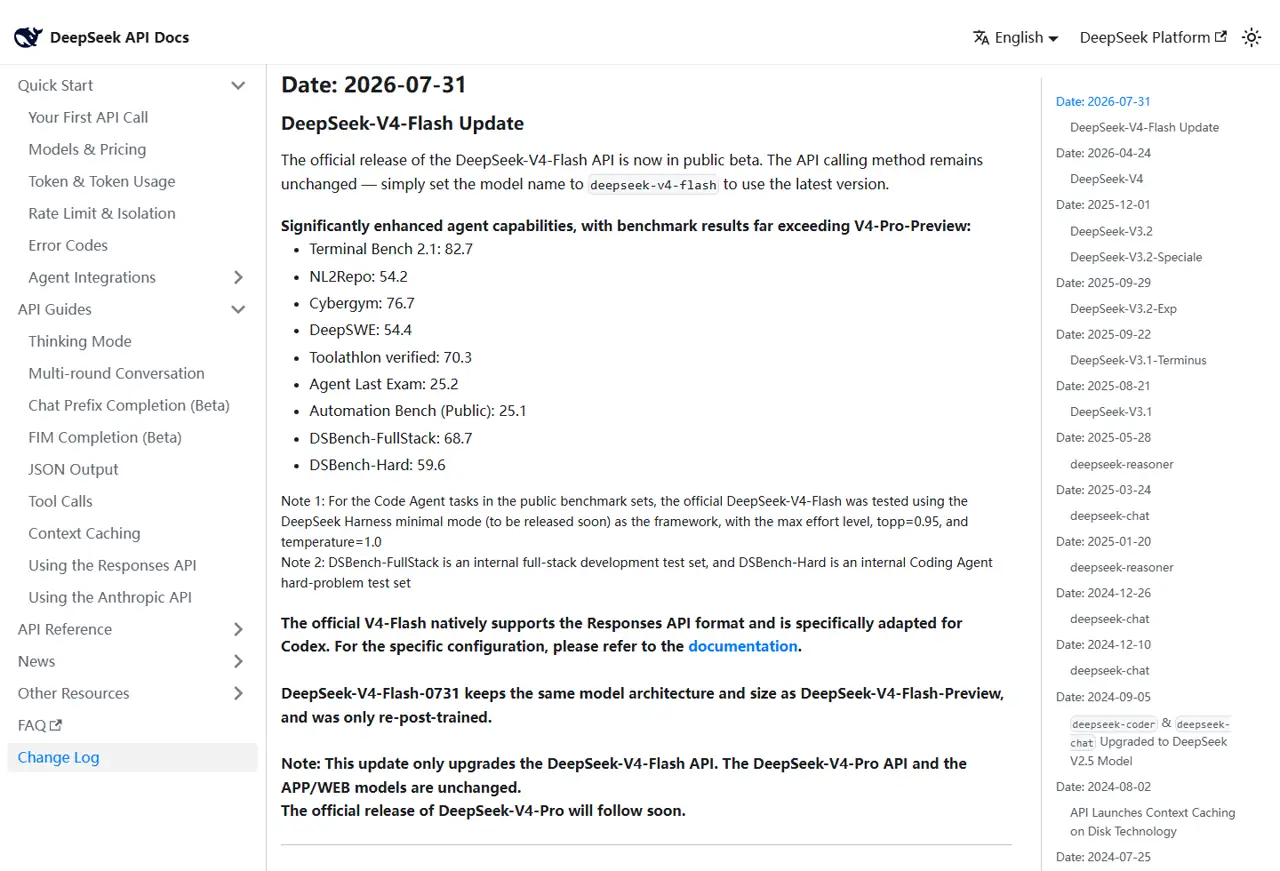
Sì. Il 13 agosto 2026, DeepSeek ha annunciato la disponibilità generale di V4 Pro. La documentazione ufficiale identifica il modello di produzione come DeepSeek-V4-Pro-0813. V4 Flash appare come DeepSeek-V4-Flash-0731, mentre il modello sperimentale di visione lanciato il 21 agosto come deepseek-v4-flash-vision-exp.
- V4 Pro: un modello di testo destinato a compiti più impegnativi.
- V4 Flash: un modello di testo ottimizzato in termini di costi e volume.
- V4 Flash Vision-Exp: una variante sperimentale che accetta immagini.
La disponibilità generale non implica che ogni prodotto o fornitore offra la stessa interfaccia, le stesse quote o le stesse integrazioni. Per le decisioni relative alle API, consultare il sito ufficiale Modelli e prezzi pagina e il Note di rilascio di GA.
DeepSeek V4 Pro
Versione: Pro-0813
La taglia più adatta: codifica più complessa, agenti, ragionamento e risultati finali caratterizzati da numerosi vincoli.
DeepSeek V4 Flash
Versione: Flash-0731
La taglia più adatta: produzione ad alta produttività, attività di codifica di routine, recupero dati e carichi di lavoro sensibili ai costi.
I nomi possono creare confusione perché il rapporto tecnico V4 descrive le varianti Preview, mentre l’API attiva utilizza versioni di produzione datate. Nel corso di questa recensione, “Pro” indica Pro-0813 e “Flash” indica Flash-0731, a meno che una frase non specifichi esplicitamente “V4 Preview”.”
Cosa è cambiato nella versione DeepSeek V4 Pro?
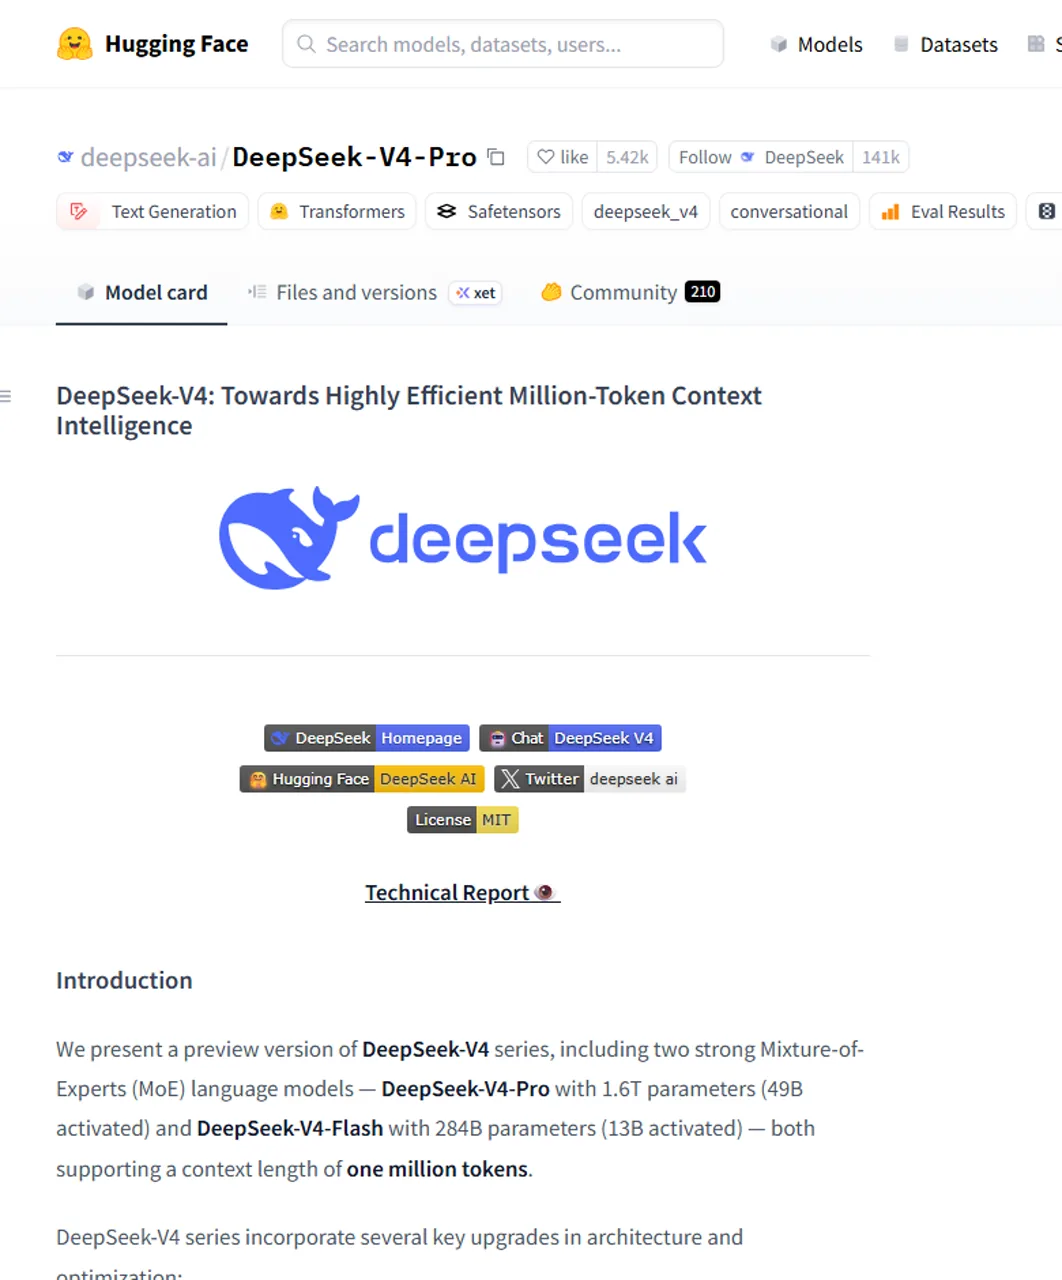
I cambiamenti più evidenti riguardano la scalabilità, la capacità contestuale, le interfacce orientate agli agenti e una strategia di prodotto a due livelli. Quella di DeepSeek Scheda ufficiale del modello Pro identifica un modello "mixture-of-experts" con un totale di 1,6 trilioni di parametri e 49 miliardi di parametri attivi, rilasciato sotto licenza MIT. I materiali di accompagnamento alla versione V4 descrivono nuovi lavori relativi all'attenzione e al routing volti a rendere praticabile l'elaborazione di milioni di token.
- Due livelli attuali: Pro per i lavori in cui la qualità è fondamentale e Flash per la produttività e i costi.
- Una memoria di lavoro molto più capiente: una finestra di contesto di 1 milione di token specificata per entrambi i modelli.
- Limite massimo di generazione elevato: fino a 384K token di output secondo le specifiche ufficiali.
- Interfacce degli agenti: chiamate agli strumenti, output JSON, API delle risposte e accesso compatibile con Anthropic.
- Pesi liberi: Sono disponibili schede tecniche e file ufficiali del modello V4, anche se un'implementazione locale su larga scala rimane un progetto infrastrutturale di grande portata.
Questa combinazione rende V4 adatto alla codifica su scala di repository, a pacchetti di ricerca di grandi dimensioni e a tracce di agenti in più fasi. Inoltre, cambia il quadro di riferimento competitivo: una valutazione utile deve ora andare oltre la qualità della chat e chiedersi come si comporta il modello quando utilizzato con strumenti specifici, formati rigidi e input di grandi dimensioni. Il nostro Confronto tra DeepSeek e ChatGPT fornisce ulteriori approfondimenti sulle differenze tra questi ecosistemi.
DeepSeek V4 Pro vs Flash: la differenza nella pratica
Entrambe le versioni presentano lo stesso contesto di titolo e gli stessi limiti di output, quindi non si tratta di una scelta tra “modello completo e modello a contesto ridotto”. Si tratta principalmente di una decisione relativa a qualità, prezzo e pianificazione della capacità. Il limite ufficiale di concorrenza di Flash è cinque volte superiore a quello di Pro, mentre i token di input e output con cache miss di Pro costano poco più di tre volte tanto.
Pro vs Flash: una panoramica
Specifiche e prezzi ufficiali verificati il 13 agosto 2026; le osservazioni pratiche derivano da un'unica esecuzione per ciascuna attività e non costituiscono benchmark ufficiali.
Scegli Flash quando…
Hai bisogno di scalabilità a basso costo, correzioni di codice di routine, estrazione, classificazione o numerose richieste in parallelo, e puoi verificare calcoli di grande importanza e vincoli di formato.
Scegli Pro quando…
Il risultato tiene conto di fattori quali codice, politiche, aspetti finanziari o numerosi vincoli precisi, e il costo aggiuntivo è inferiore al costo di un errore anche minimo.
Test pratici: codifica, recupero e rispetto dei vincoli
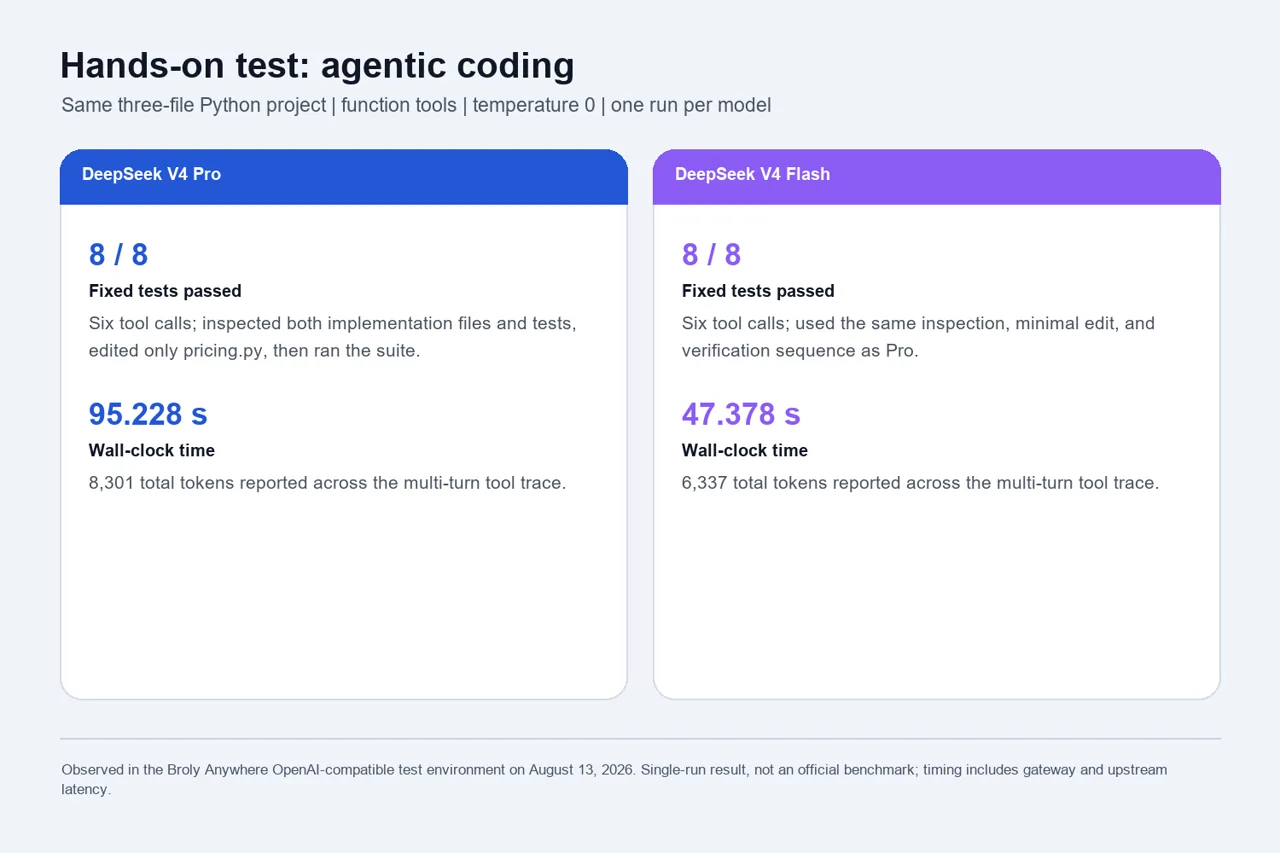
Abbiamo testato entrambi gli ID dei modelli API tramite lo stesso endpoint Broly Anywhere compatibile con OpenAI il 13 agosto 2026. La temperatura era pari a 0. Ciascun risultato riportato corrisponde a un'esecuzione per modello e per attività. Il tempo reale include i ritardi del gateway e a monte, pertanto è utile come dato di osservazione, ma non come classifica stabile della latenza.
Scheda di valutazione pratica
Sia Pro che Flash hanno superato tutti i test corretti.
Sia le risposte che tutti i riferimenti bibliografici richiesti erano corretti.
Pro ha rispettato tutte le regole; Flash non ha rispettato i vincoli aritmetici e di lunghezza.
Test 1: debug in Python con approccio agentico
L'hub ha fornito a ciascun modello quattro strumenti — elaborazione di file di elenco, lettura di un file, scrittura di un file ed esecuzione di test — all'interno di un piccolo progetto Python di tre file dedicato alla determinazione dei prezzi. Questo approccio è più simile al flusso di lavoro di un agente rispetto alla richiesta di uno snippet di codice nella chat.
Debug, applicazione di patch e verifica di un progetto Python relativo alla determinazione dei prezzi
Entrambi i modelli hanno seguito lo stesso percorso di sei chiamate, modificando solo l'implementazione, e hanno prodotto 8 promossi. Flash ha completato questa prova in 47,378 secondi contro i 95,228 secondi di Pro, utilizzando un numero inferiore di token restituiti. In questo caso non c’è stato un vincitore in termini di qualità. Per un altro punto di vista incentrato sul codice, consulta il nostro Test di programmazione in Python: DeepSeek vs ChatGPT.
Test 2: recupero di un dossier di circa 20,7K token
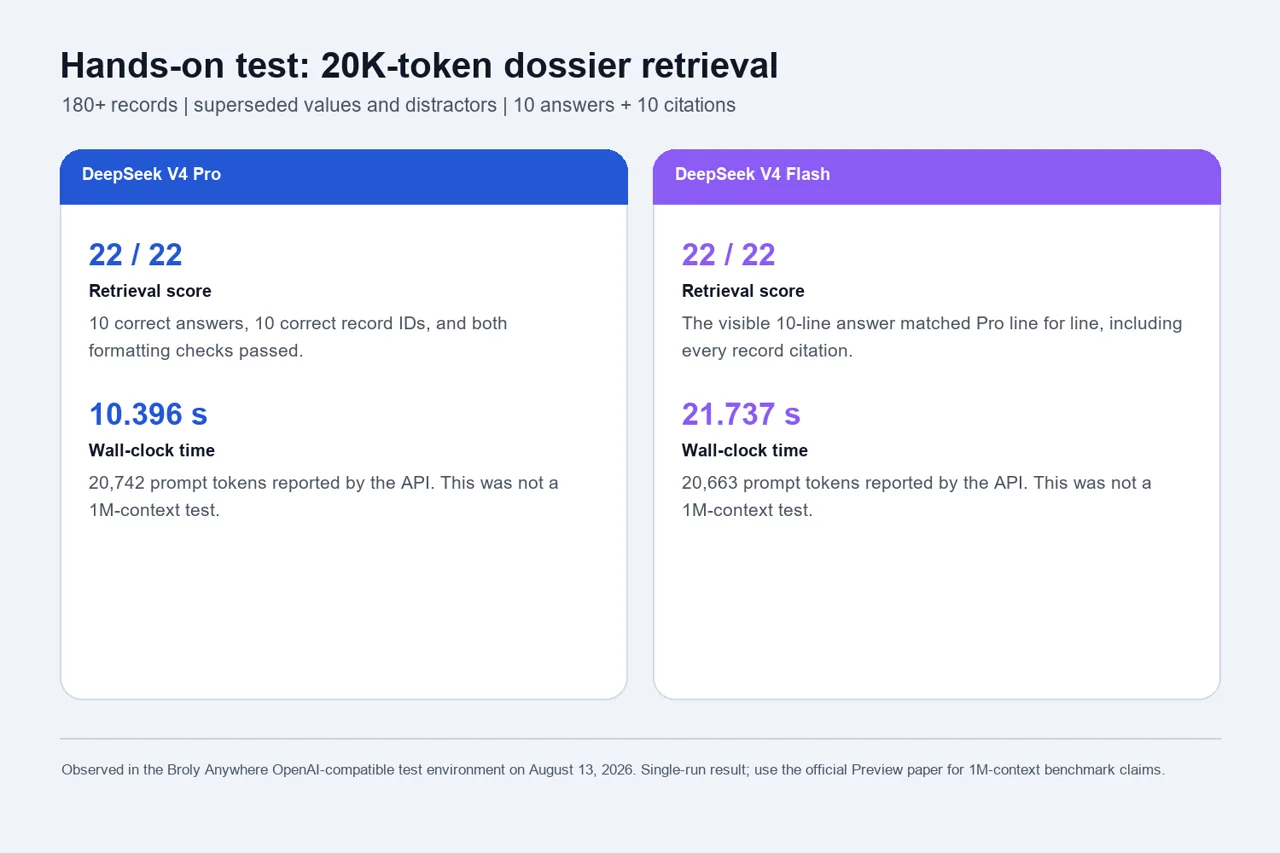
Abbiamo allegato un dossier contenente oltre 180 documenti, distrattori ripetuti, bozze obsolete e dieci fatti sparsi. Il modello doveva rispondere in un formato preciso di dieci righe e citare un documento per ogni risposta.
Rispondi a un dossier controverso con riferimenti precisi
Entrambi i modelli hanno totalizzato 22/22: dieci risposte corrette, dieci citazioni corrette e due punti relativi al formato. Pro ha completato questa prova in 10,396 secondi e Flash in 21,737 secondi. L’utilizzo effettivo del prompt è stato di circa 20,7K token. Ciò lo rende un utile test di recupero di media lunghezza, ma non convalidare l'intera finestra di 1 milione di token.
Test 3: una nota decisionale rigorosa sul lancio
Questo compito prevedeva un riassunto di 120–180 parole, una tabella composta esattamente da quattro righe, un rischio fisso e valori numerici sconosciuti, una breve decisione, un JSON valido e un calcolo dei costi per il primo anno basato su note relative ai settori finanziario, legale, ingegneristico, commerciale, dell’assistenza e della sicurezza.
Redigere una nota di lancio con regole aritmetiche e di output rigorose
Con un limite di 2.048 token di completamento, entrambi i modelli hanno utilizzato il budget di completamento disponibile per il ragionamento restituito e non hanno prodotto alcuna risposta visibile. Abbiamo conservato tali record, quindi abbiamo rieseguito il prompt invariato con un limite di 8.192 token. Pro ha ottenuto un punteggio di 12/12. Flash ha ottenuto un punteggio di 8/12 perché ha riportato $217.100 invece di $216.900, ha riportato l’errore $200 nella varianza, e ha scritto un riassunto di 94 parole invece delle 120–180 parole richieste.
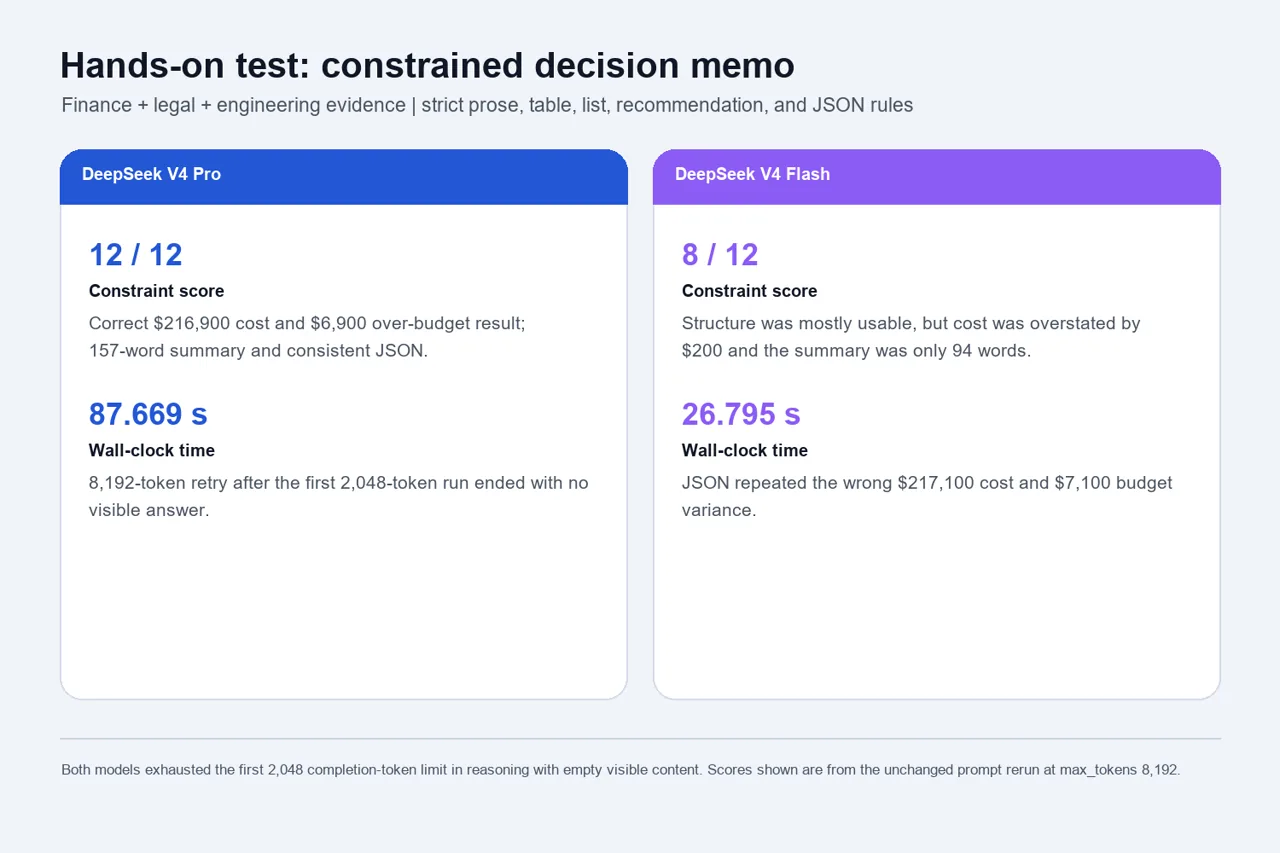
La lezione è specifica, non universale: Flash si è già dimostrato eccellente nelle attività di codifica e recupero, mentre Pro ha dato risultati più affidabili nella combinazione più complessa di vincoli aritmetici, strutturali e di policy. Se il vostro flusso di lavoro si basa su una shell dell’agente, il nostro Confronto tra OpenClaw e Claude: Code vs OpenCode aiuta ad adattare il modello allo strumento circostante.
Benchmark DeepSeek V4: cosa dimostrano i dati ufficiali
La fonte di riferimento più affidabile è il Relazione tecnica DeepSeek V4, ma le sue tabelle e i suoi grafici descrivono i modelli V4 Preview. Sono utili per comprendere le funzionalità previste dell’architettura e la configurazione dei test; non si tratta di punteggi indipendenti relativi alla versione API Pro-0813 datata.
I punteggi in anteprima non sono i punteggi Pro-0813
Architettura e risultati dei benchmark di DeepSeek.
Versioni di produzione obsolete elencate nella documentazione API.
I punteggi in anteprima non possono essere rinominati come punteggi Pro-0813.
L'aggiornamento Flash del 31 luglio pubblica anche i risultati degli agenti e indica l'harness, le impostazioni e il supporto Codex. Questi dettagli sono importanti perché le classifiche tra diversi fornitori possono variare a seconda dello scaffolding, del budget di ragionamento, delle definizioni degli strumenti e delle regole di riprova. Un risultato senza l'indicazione dell'harness non è sufficiente per dichiarare un vincitore incondizionato.
Per lo stesso motivo, i nostri tre compiti integrano le prove ufficiali anziché sostituirle. Essi illustrano ciò che è accaduto in un determinato contesto reso pubblico. Se state confrontando i prodotti degli agenti anziché limitarsi alle API dei modelli, il nostro Guida al codice Codex vs Claude spiega perché il flusso di lavoro circostante può influire sull'esperienza dell'utente.
Prezzi dell'API DeepSeek V4
I prezzi dell'API di DeepSeek sono insolitamente competitivi al momento del lancio. La tabella sottostante riporta i dati ufficiali relativi al costo per milione di token, verificati il 13 agosto 2026. La pagina ufficiale avverte inoltre che i prezzi aumenteranno in modo significativo in futuro, pertanto è opportuno considerare questi dati come valori relativi al periodo del lancio.
Prezzo per 1 milione di token
Un carico di lavoro semplice senza cache, con 10 milioni di token in ingresso e 2 milioni di token in uscita, risulterebbe pari a $1,96 su Flash e a $6,09 su Pro a queste tariffe. Questo esempio non tiene conto degli accessi alla cache, dei ricarichi del fornitore, dei tentativi di ripetizione e di eventuali variazioni di prezzo successive. I team che mettono a confronto i fornitori dovrebbero utilizzare un unico mix di token e un'unica base di fatturazione; il nostro Guida ai prezzi dell'API Claude Opus 4.6 spiega perché input, output e caching richiedono righe separate.
Cosa significa la finestra di contesto da 1M — e quali sono i limiti
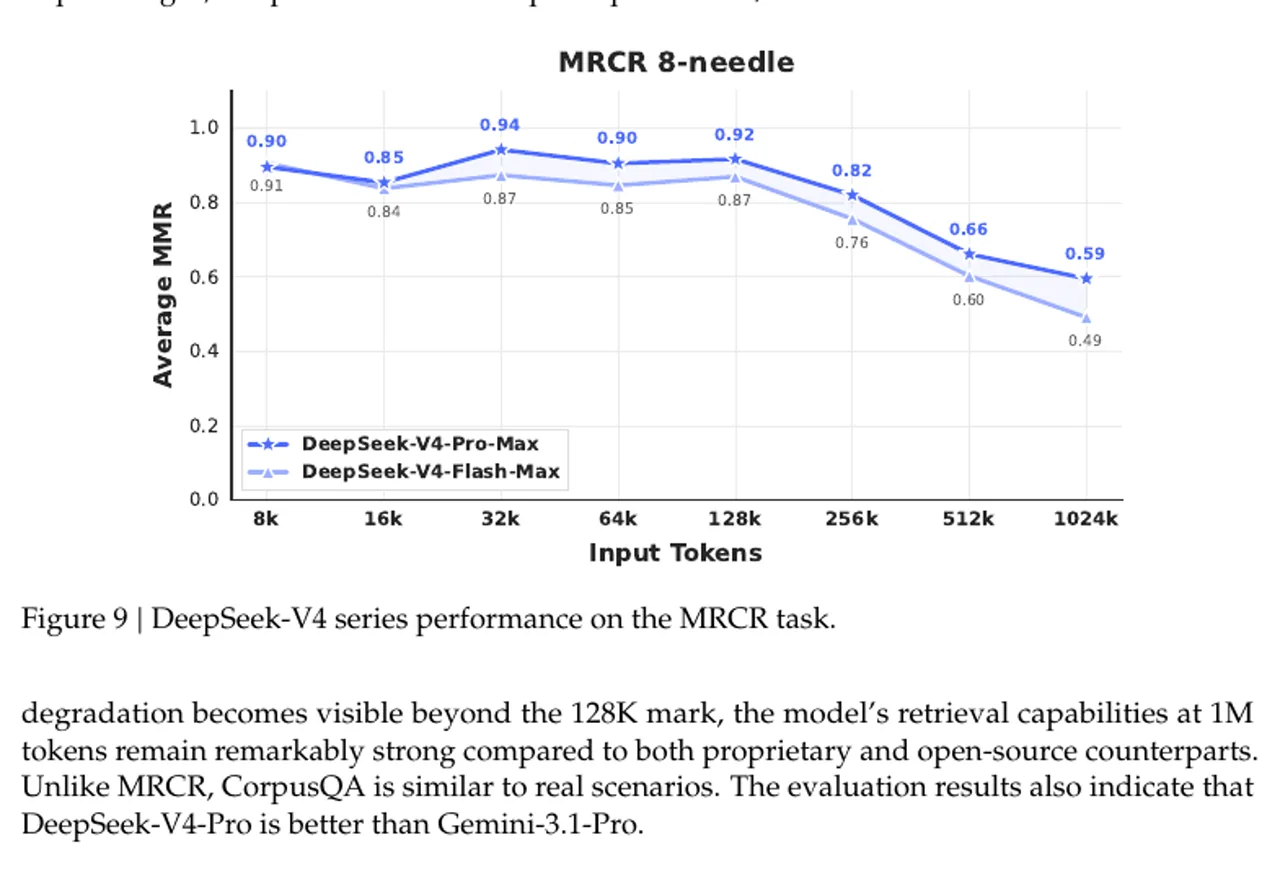
Una finestra di contesto di 1 milione di token rappresenta una capacità, non una garanzia di richiamo perfetto in ogni posizione. Offre all’API lo spazio necessario per gestire repository di grandi dimensioni, raccolte di documenti, pacchetti di ricerca o cronologie degli agenti. La questione relativa alla qualità è se il modello sia in grado di recuperare il dettaglio corretto quando le prove rilevanti sono sepolte tra centinaia di migliaia di token che distraggono l’attenzione.
Il rapporto di anteprima di DeepSeek include un grafico relativo alla risoluzione della coreferenza a più round (MRCR) con un numero di token in ingresso compreso tra 8K e 1M. La curva rimane solida per lunghezze più brevi, ma diminuisce dopo i 128K. Si tratta di una normale evidenza di un problema intrinseco legato al contesto lungo, ed è per questo che “supporta 1M” non dovrebbe mai essere interpretato come “senza perdite a 1M”.”
L'interfaccia API presenta limitazioni specifiche. Quelle di DeepSeek Guida all'API delle risposte descrive un'implementazione senza stato: caratteristiche quali id_risposta_precedente, le conversazioni, l'archivio e il contesto non sono supportati. Anche gli input di immagini e file non sono supportati, quindi è necessario estrarre il testo o creare il livello di stato al di fuori del modello.
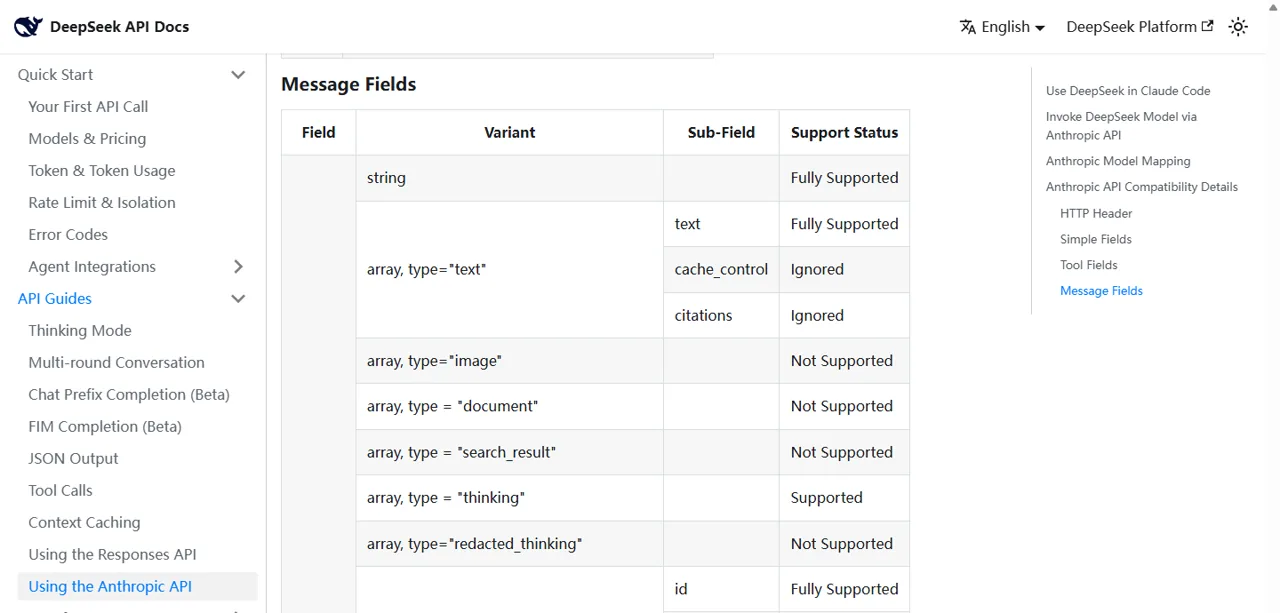
Il Tabella delle API compatibili con Anthropic allo stesso modo contrassegna le varianti relative alle immagini e ai documenti come non supportate. La compatibilità implica quindi formati di richiesta e strumenti familiari, non una corrispondenza perfetta, funzionalità per funzionalità, con ogni modello o client Anthropic.
Come provare DeepSeek V4 Pro e Flash
Hai a disposizione tre opzioni pratiche. Scegli in base alle tue esigenze: una semplice conversazione, il controllo delle API di produzione o un'area di lavoro multimodello.
Scegli il percorso di accesso
DeepSeek Web/App
Ideale per provare il modello tramite l'interfaccia utente di DeepSeek.
API ufficiale
Ideale per la fatturazione tramite token, strumenti, JSON, framework per agenti e controllo della produzione.
GlobalGPT
Ideale per aprire file Pro o Flash in un ambiente di lavoro multimodello più ampio senza dover prima creare un client.
Percorso 1: chat ufficiale DeepSeek
Inizia da Sito ufficiale di DeepSeek se vuoi semplicemente farti un'idea dell'esperienza utente attuale. L'accesso per gli utenti e la fatturazione dell'API sono due cose distinte; il fatto che sia disponibile un'interfaccia di chat non significa che l'API sia gratuita.
Percorso 2: API ufficiale e agenti di codifica
Utilizzo deepseek-v4-pro o deepseek-v4-flash con le interfacce documentate compatibili con OpenAI. Entrambe supportano le modalità “thinking” e “non-thinking”, l’output JSON, le chiamate agli strumenti, l’API Responses e l’accesso compatibile con Anthropic. Il FIM si applica solo in modalità “non-thinking”.
DeepSeek pubblica anche un Guida ufficiale all'integrazione di Codex. Se stai valutando quale shell di agente scegliere, confronta Claude: Prezzi e limiti di utilizzo del codice prima di dare per scontato che il costo del gettone del modello corrisponda all'intero importo della fattura.
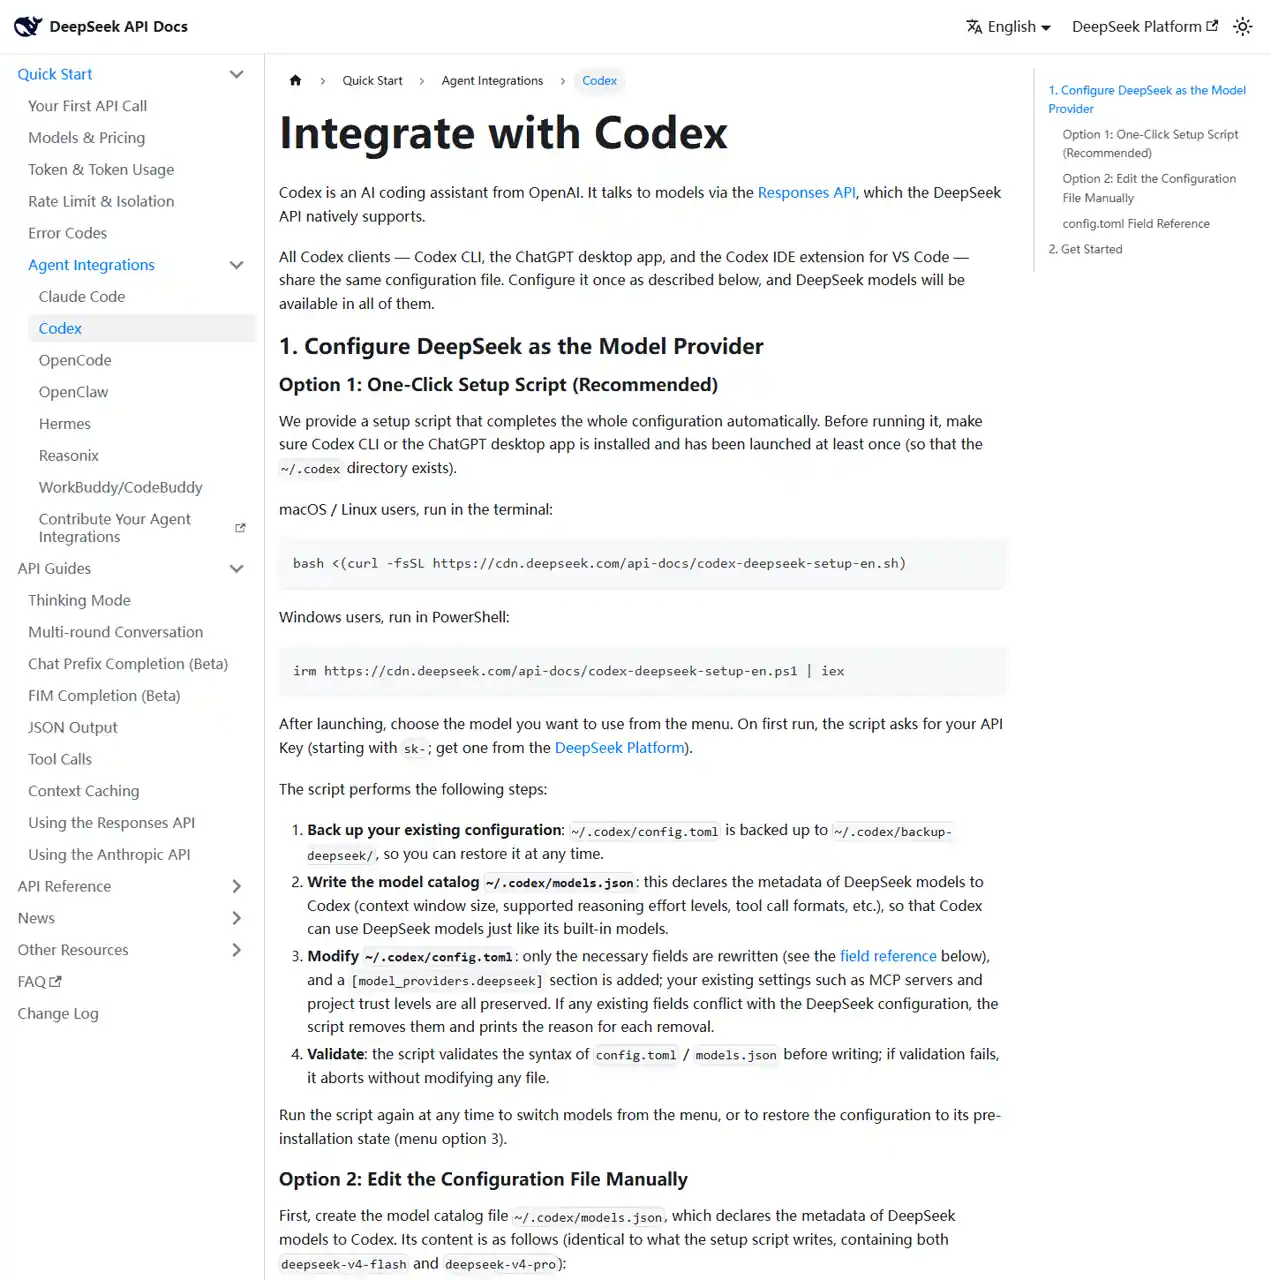
Gli utenti del codice Claude possono seguire la stessa logica basata su endpoint e modelli descritta nella nostra guida a Configurazione di un modello nel codice Claude, controllando la tabella di compatibilità in tempo reale di DeepSeek per individuare eventuali campi non supportati.
Percorso 3: GlobalGPT
GlobalGPT dispone di voci dedicate per entrambi i modelli. Il percorso di conversione verificato è DeepSeek V4 Pro su GlobalGPT. Esiste anche una pagina del prodotto in Flash, ma non abbiamo trovato un parametro di campagna specifico per Flash verificato, quindi non ne inventeremo uno.
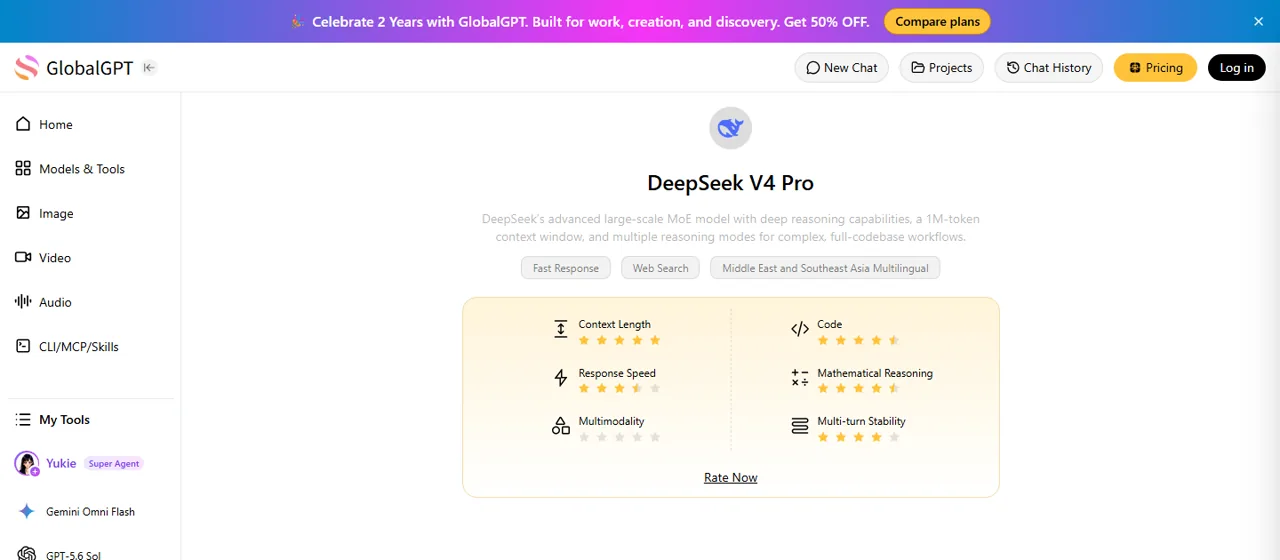
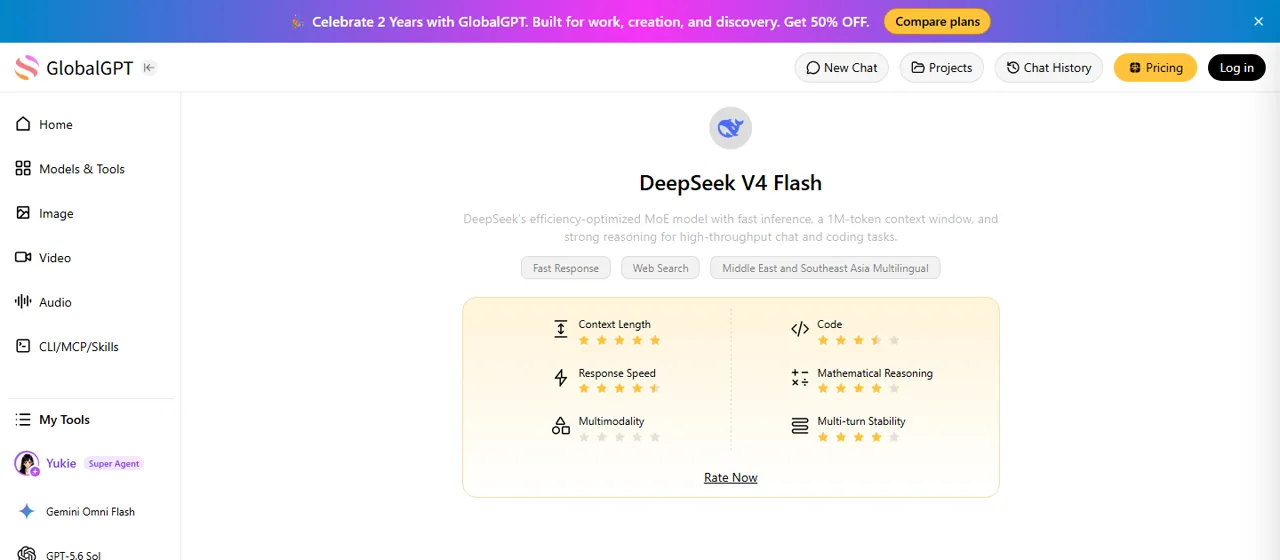
Per i flussi di lavoro dei terminali, il Configurazione del codice GlobalGPT CLI in Claude spiega come una piattaforma multimodello possa integrarsi in una routine di codifica già esistente. Non sostituisce gli strumenti nativi del repository, ma cambia il modo in cui si accede ai modelli e li si confronta.
Quale modello DeepSeek V4 dovresti scegliere?
Corrispondere il modello al costo del fallimento
Flash
Scelgetelo per chat ad alto volume, estrazione di dati, codice di routine, recupero dati e agenti con un solido sistema di convalida. Ha superato alla perfezione due delle nostre tre prove al prezzo ufficiale più basso.
Pro
Sceglietelo quando aritmetica rigorosa, formattazione, linee guida e ragionamento multidominio si fondono in un unico risultato finale. È stato l’unico modello a ottenere un punteggio di 12/12 nel nostro test.
GlobalGPT
Scegli l'approccio basato sulla piattaforma quando desideri provare il modello o confrontare le alternative senza dover prima scrivere un client API.
Per molti team, Flash rappresenta la scelta più intelligente per la prima implementazione: è molto più economico, supporta gli stessi limiti di contesto e di output specificati e ha gestito i nostri test di codifica e di recupero da 20,7K senza alcuna perdita di qualità. Aggiungere controlli deterministici per i numeri, lo schema e le sezioni obbligatorie.
Passa alla versione Pro quando i tempi di revisione o i costi derivanti da eventuali errori superano il risparmio ottenuto con i token. La differenza di prezzo è reale, ma lo è anche il valore di ottenere fin dal primo tentativo un documento di conformità o una nota di lancio ben strutturato. Se nella tua rosa di candidati figurano altri assistenti, la più ampia Guida alla scelta tra DeepSeek e ChatGPT può aiutare a distinguere la qualità del modello dall'ecosistema del prodotto.
Conclusione: vale la pena acquistare il DeepSeek V4 Pro?
Vale la pena prendere in considerazione DeepSeek V4 Pro quando il lavoro richiede più controllo che volume. Non è l’opzione predefinita più economica: nell’API, Pro costa tre volte di più di Flash nelle principali righe di input e output con cache mancante, sia nei periodi di picco che in quelli di calma. Questo sovrapprezzo ha senso quando una risposta errata comporta rielaborazioni, costi aggiuntivi di revisione o rischi operativi.
Per le attività di routine, Flash offre il miglior compromesso tra costi e scalabilità. Per le immagini, utilizza Vision-Exp. Se l'obiettivo non è la gestione delle API, ma passare dalla ricerca alla scrittura e all'assistenza tecnica, uno spazio di lavoro multimodello può rivelarsi più pratico rispetto alla configurazione separata di ciascun servizio.
Prossimo passo
Apri DeepSeek V4 Pro in un’area di lavoro che riunisce anche altri modelli per la ricerca, la scrittura e l’assistenza alla programmazione.
Prova DeepSeek V4 ProDomande frequenti su DeepSeek V4
È già uscito il DeepSeek V4 Pro?
Sì. DeepSeek V4 Pro è stato reso disponibile al pubblico il 13 agosto 2026 con l'identificativo di produzione DeepSeek-V4-Pro-0813.
Qual è la differenza tra DeepSeek V4 Pro e Flash?
Flash privilegia i costi e la concorrenza, mentre Pro è progettato per attività di elaborazione del testo con maggiori vincoli e un costo di errore più elevato. Entrambe le versioni prevedono una finestra di contesto di 1 milione di token e un output massimo di 384K token.
Quanto costa il DeepSeek V4 Pro?
Per ogni milione di token, i prezzi Pro fuori picco sono pari a $0,022 per gli input con cache hit, $0,66 per gli input con cache miss e $1,98 per gli output. I prezzi nelle ore di punta sono rispettivamente $0,044, $1,32 e $3,96.
Quali sono le ore di punta delle API?
Le fasce orarie di punta sono dalle 01:00 alle 04:00 e dalle 06:00 alle 10:00 UTC, dal lunedì al venerdì. In tutte le altre fasce orarie si applicano le tariffe fuori punta.
DeepSeek V4 supporta le immagini?
deepseek-v4-flash-vision-exp accetta immagini. La guida ufficiale elenca i formati JPEG, PNG, GIF e WebP. I modelli di testo Pro e Flash devono essere trattati separatamente.
La finestra di contesto di 1 milione di token garantisce un recupero perfetto?
No. Il limite di 1 milione di token si riferisce alla capacità. Il recupero dei dati dipende comunque dalla struttura del documento, dalla posizione dei fatti, dal prompt e dal metodo di verifica.
Posso usare DeepSeek V4 con Codex?
Sì. La documentazione ufficiale descrive un’integrazione tramite l’API Responses ed elenca Flash, Pro e Vision-Exp come opzioni di modello.
Come posso provare DeepSeek V4 Pro senza configurare un'API?
È possibile utilizzare un'interfaccia che offre il modello, come ad esempio GlobalGPT. Questa soluzione è adatta per chat, ricerche, scrittura e assistenza tecnica; la fatturazione e le funzionalità non sono equivalenti a quelle della console API ufficiale.