
È facile fraintendere il prezzo del GPT-6 Sol perché si tendono a confondere due questioni. Un preventivo API è un calcolo a consumo basato sui token e sul listino prezzi del fornitore. Un percorso di abbonamento/flusso di lavoro rappresenta una scelta più ampia relativa alla frequenza con cui è necessario utilizzare un modello, diversi modelli e gli strumenti collegati.
Questa guida utilizza GPT-6 Sol a GlobalGPT per i test pratici. La pagina ufficiale di rilascio di OpenAI indica che GPT-6 Sol costa $2 per milione di token in ingresso e $10 per milione di token in uscita, con uno sconto di 90% sulle letture di input memorizzate nella cache (circa $0,20 per milione di token di input memorizzati nella cache). Il calcolatore riportato di seguito utilizza tali tariffe pubblicate quando vengono inserite e mantiene separata la modalità di abbonamento.
Per lavori interattivi di più ampia portata, GlobalGPT riunisce GPT-6 Sol insieme ad altri modelli e funzioni di intelligenza artificiale in un’unica dashboard. Questo è importante quando il lavoro vero e proprio passa dalla ricerca alla stesura, al codice, alle immagini, ai video o a un flusso di lavoro collegato a un’interfaccia a riga di comando (CLI).
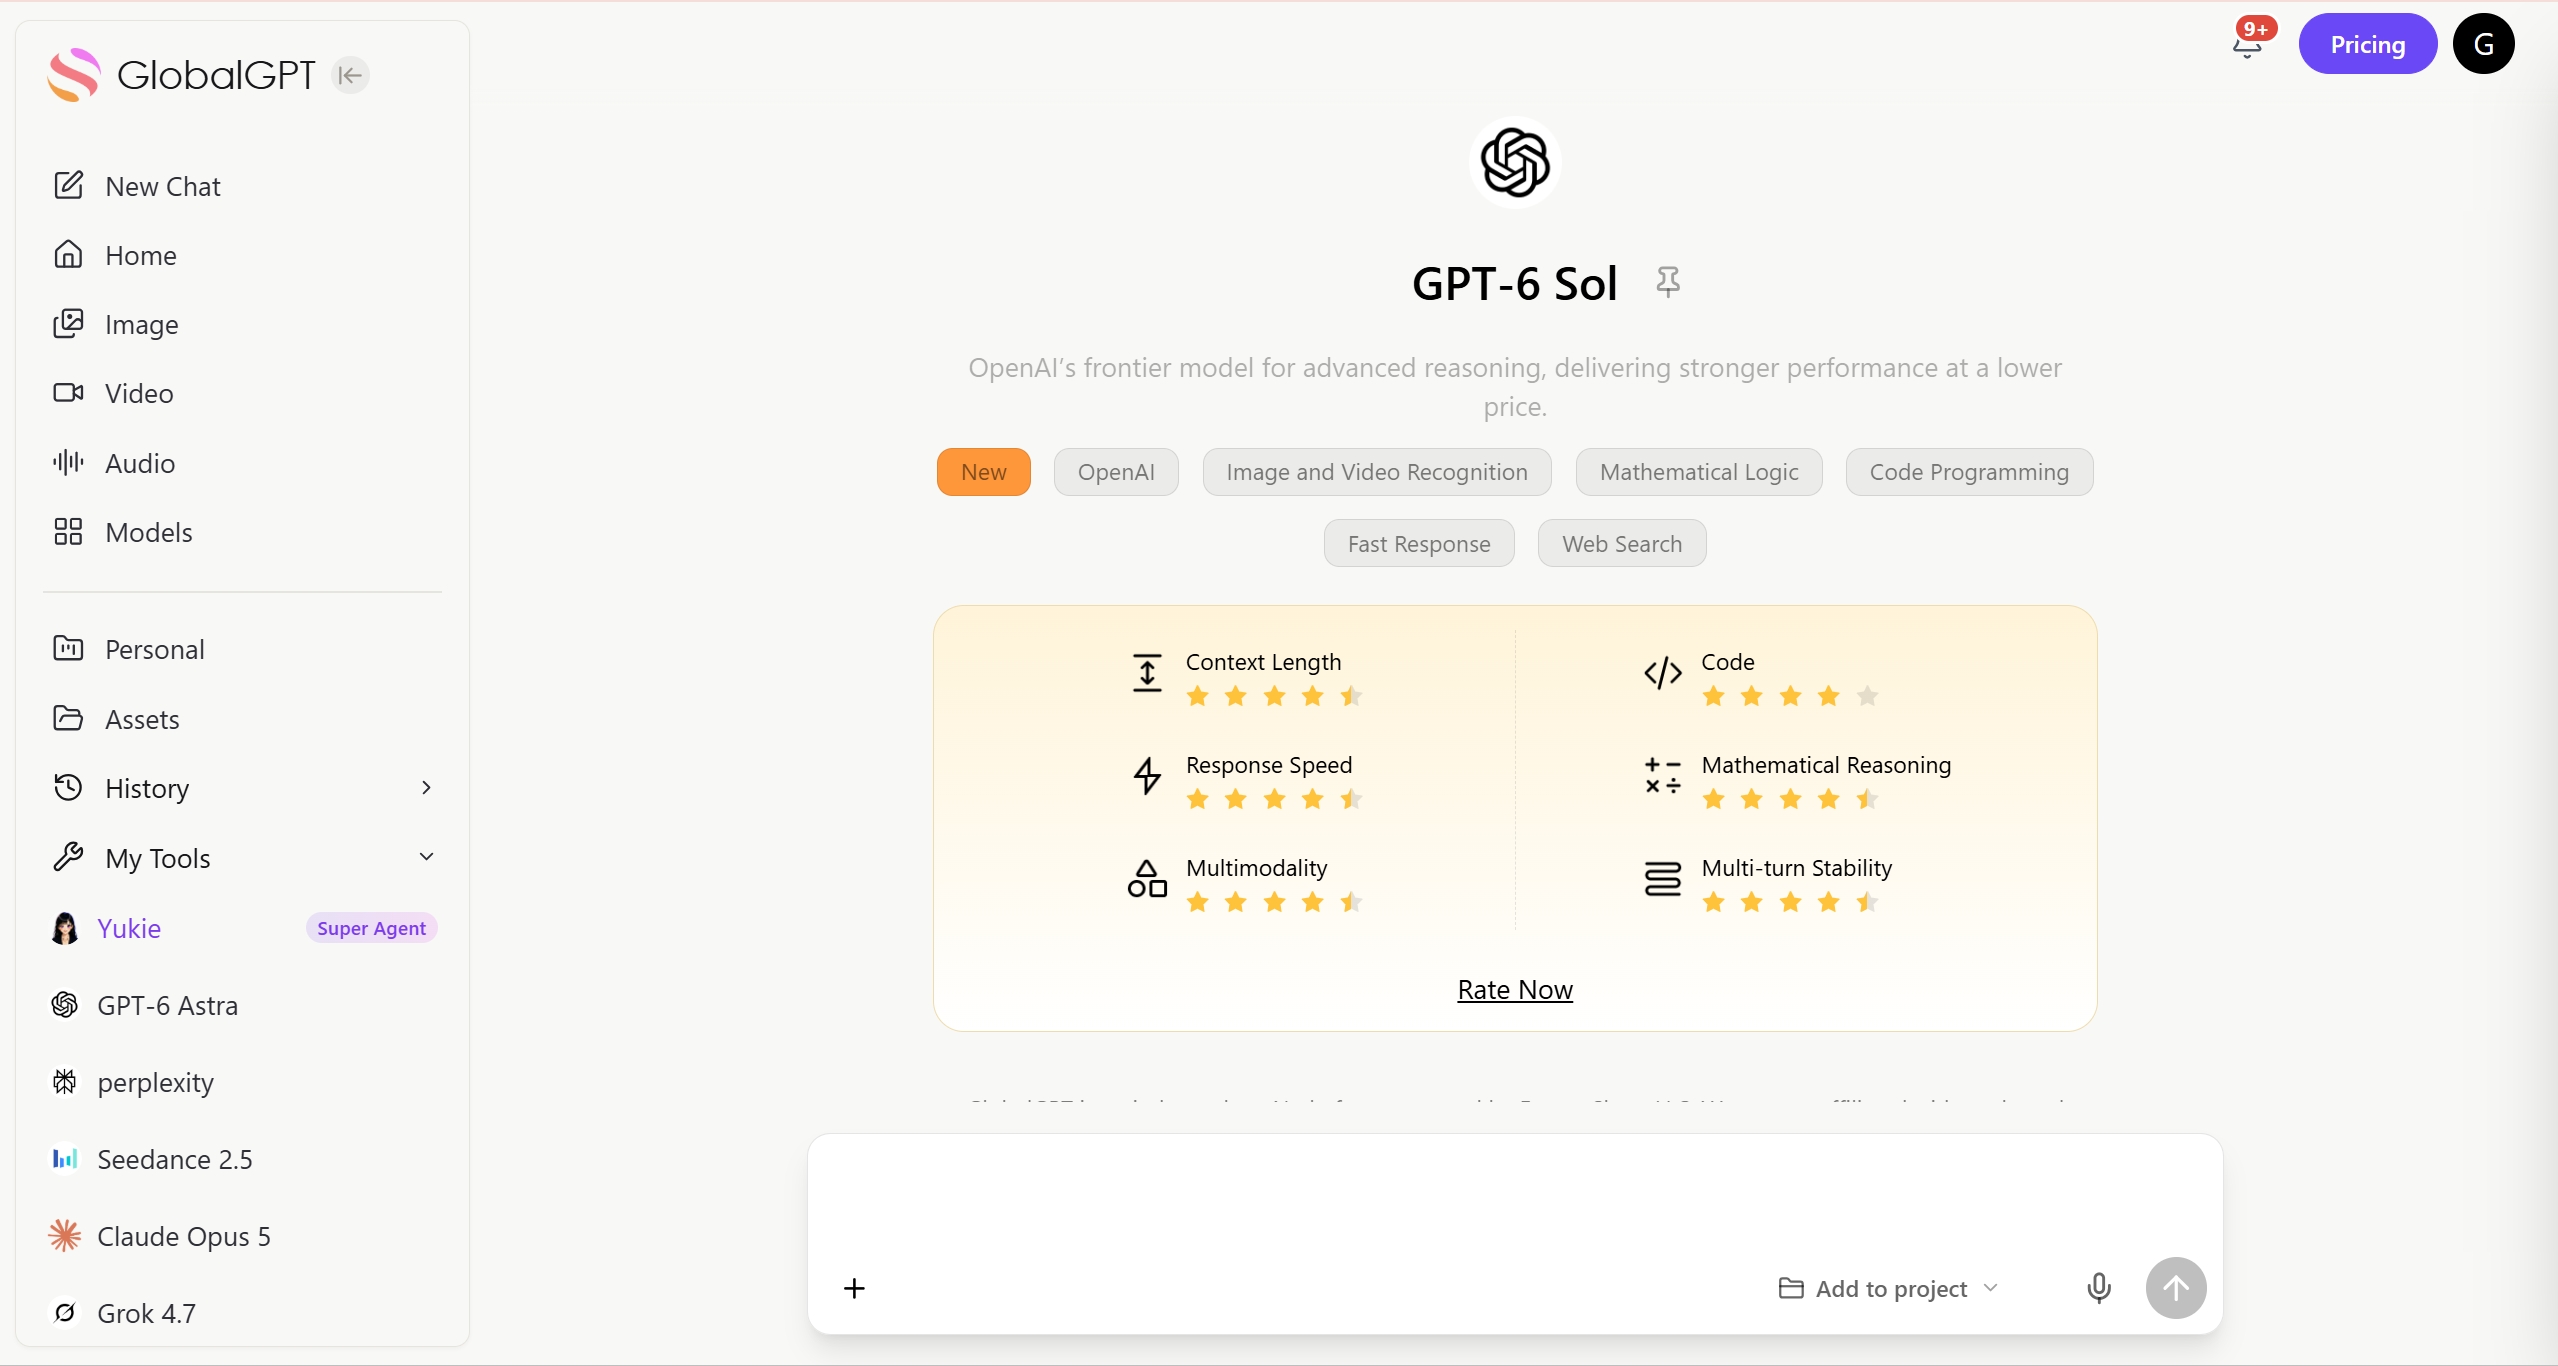
A Area di lavoro GlobalGPT offre un modello di abbonamento che copre diversi modelli e funzioni di intelligenza artificiale. Si tratta di una modalità di acquisto diversa rispetto alle chiamate API a consumo offerte da un fornitore. Il Recensione di GPT-6 Sol spiega in che modo il modello si inserisce in un flusso di lavoro più ampio.
Cosa può significare l’espressione “prezzo del GPT-6 Sol”
Ci sono tre aspetti distinti relativi ai costi: il contatore di token di input/output dell’API, le regole opzionali come l’elaborazione da cache o in batch e il costo di un abbonamento che include l’accesso e gli strumenti di workflow. Solo i primi due possono essere ridotti a una formula basata sui token.
- API: È l'ideale quando il software invia richieste prevedibili e occorre una stima tracciabile per ogni singola chiamata.
- Abbonamento/flusso di lavoro: è particolarmente utile quando le persone passano da un modello all’altro e da una funzione all’altra nel corso di un’attività più ampia.
- Percorso misto: utile quando le attività di produzione sono programmabili, mentre l’esplorazione, la scrittura o il lavoro multimodale sono interattivi.
Stato ufficiale dei prezzi delle API
OpenAI indica che GPT-6 Sol consuma $2 per milione di token in ingresso e $10 per milione di token in uscita. La stessa pagina di annuncio indica che le letture degli input memorizzati nella cache beneficiano di uno sconto di 90%, che equivale a $0,20 per ogni milione di token di input memorizzati nella cache. OpenAI presenta queste tariffe come inferiori di 50% rispetto al prezzo promozionale di GPT-5.6 Sol.
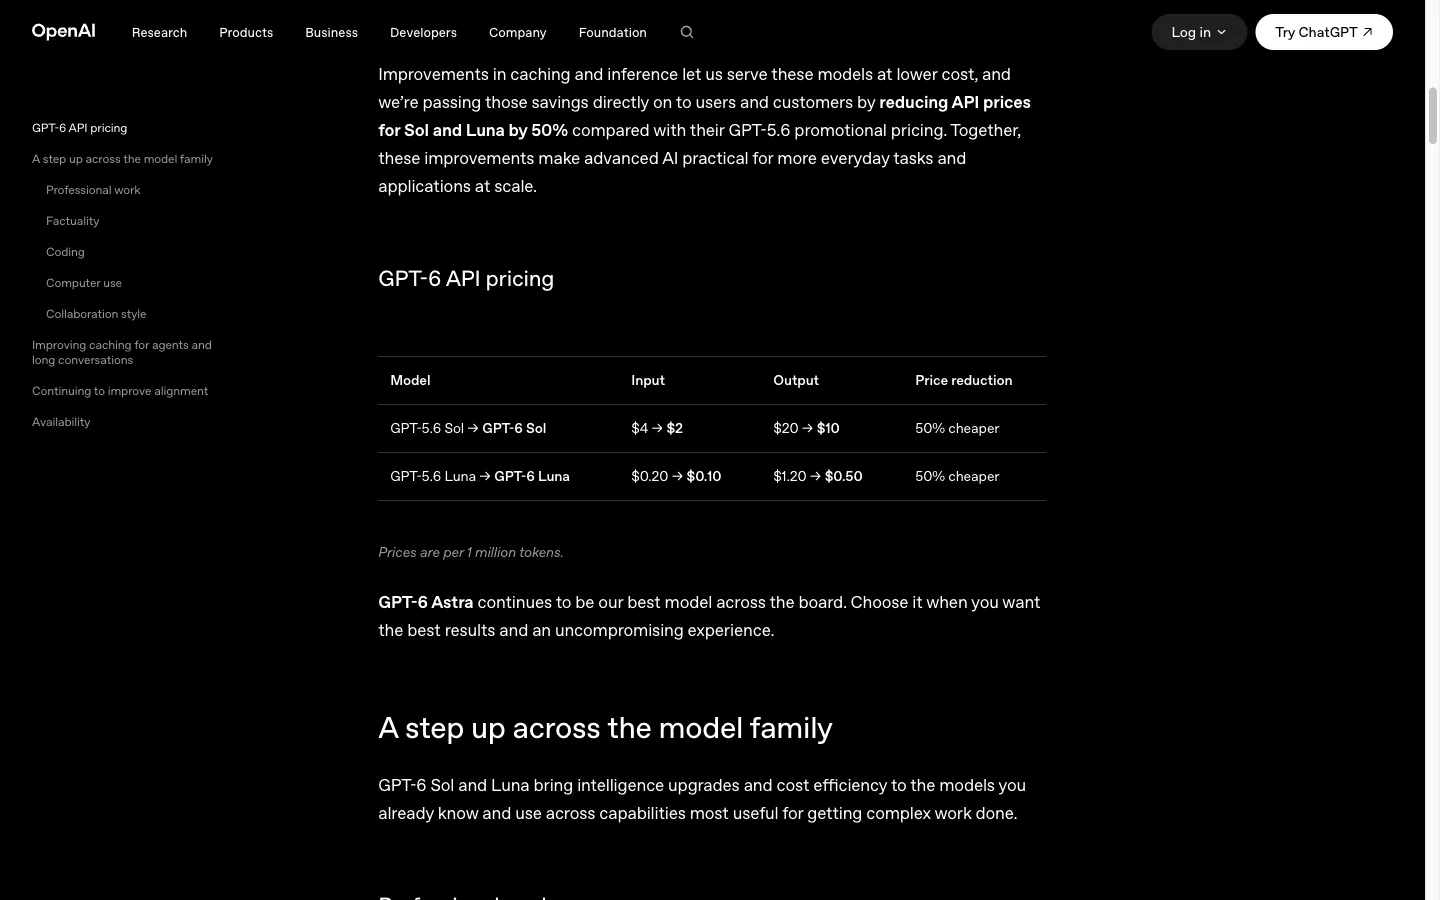
A parità di numero di token, l'output costa cinque volte di più rispetto all'input non memorizzato nella cache. Mantenere una risposta concisa può essere importante tanto quanto abbreviare il prompt.
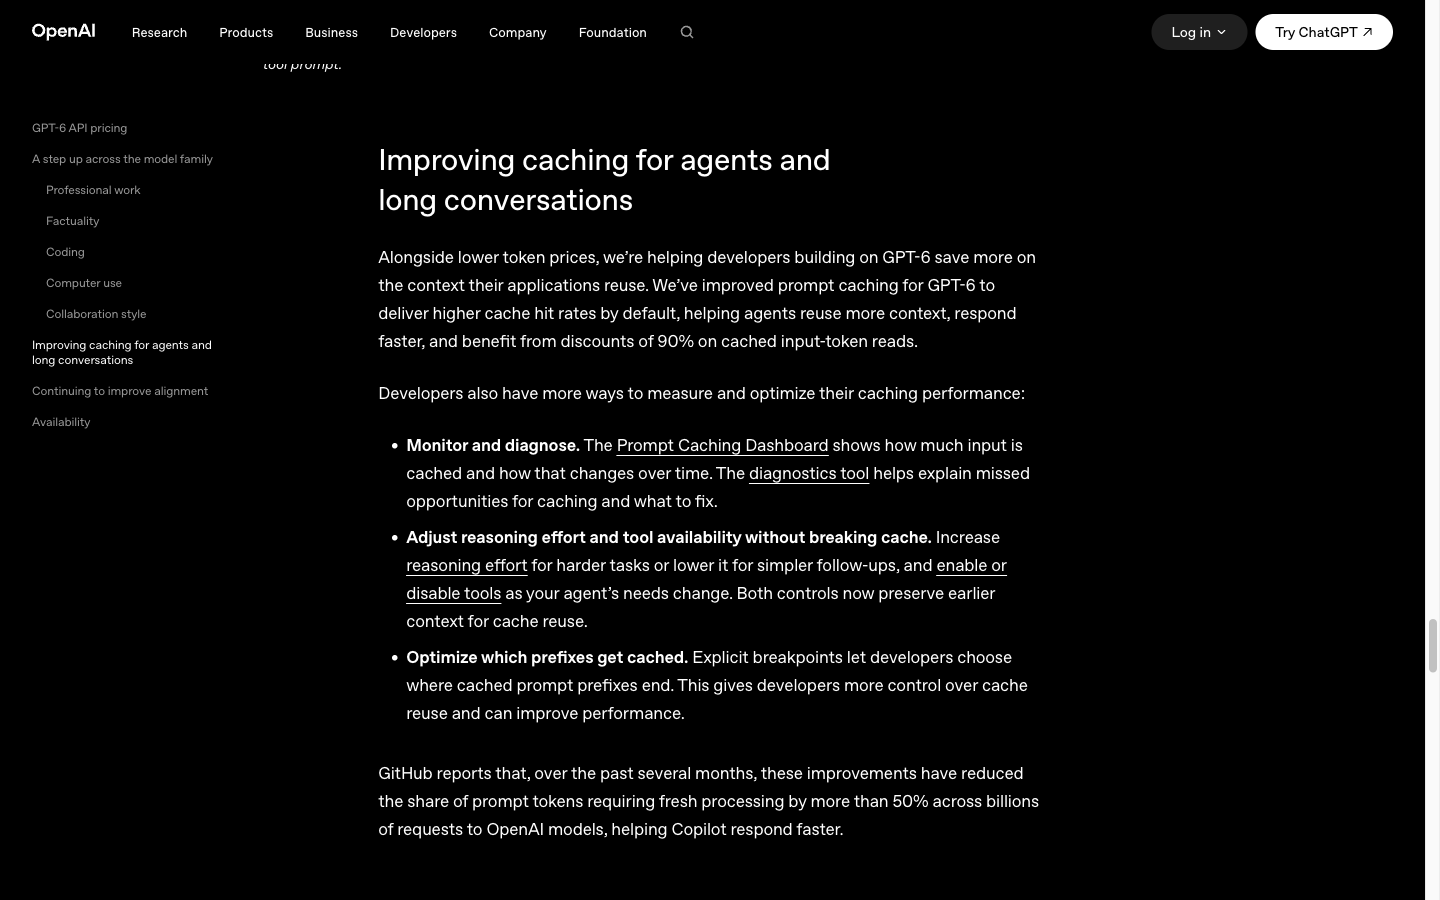
Lo sconto trasforma $2 per milione di token immessi in $0,20 per milione di letture in cache idonee. La ripetizione di un prompt non costituisce prova di un cache hit; per la riconciliazione dei costi effettivi, utilizzare i dati registrati relativi all'utilizzo dei token in cache.
Preventivi elaborati in base alle tariffe pubblicate
Gli esempi che seguono utilizzano le tariffe GPT-6 Sol pubblicate. Mostrano come il conteggio dei token si traduca in una stima dell'API; non si tratta di un prezzo di abbonamento.
| Scenario | Ingresso | Uscita | Formula | Risultato |
|---|---|---|---|---|
| Breve sessione di domande e risposte | 12.500 @ $2/M | 2.000 @ $10/M | 0,0125 × 2 + 0,002 × 10 | $0.045 |
| Registro strutturato | 1.200.000 @ $2/M | 300.000 @ $10/M | 1,2 × 2 + 0,3 × 10 | $5.40 |
| Contesto memorizzato nella cache | 1.000.000 a $0,20/M | 100.000 @ $10/M | 1×0,20 + 0,1×10 | $1.20 |
Dividere i token per un milione prima di moltiplicarli per la tariffa per milione. Applicare la tariffa memorizzata nella cache solo ai token in ingresso che soddisfano effettivamente i requisiti per un cache hit; addebitare la tariffa standard sui restanti token in ingresso.
Uno sconto sull’importo a credito 90% non comporta una fattura di importo inferiore pari a 90%
Esempio di calcolo: 1 milione di token in ingresso in totale + 100.000 token in uscita. Il verde acqua rappresenta il costo di input; il ruggine rappresenta il costo di output. Cambia solo l'hit della cache di input.
Il risparmio è pari a $1,80, ovvero 60% del totale di questo esempio. L'elaborazione costa ancora $10 per milione di token. Una risposta lunga può quindi incidere in modo significativo sul costo, anche quando il prompt è memorizzato nella cache.
Costo = (input totale − input memorizzato nella cache) / 1M × $2
 + input memorizzato nella cache / 1M × $0,20
 + output / 1M × $10
Tratto da Tariffe standard pubblicate da OpenAI e sconto per la lettura dalla cache 90%. Si ipotizzano accessi alla cache ammissibili; sono esclusi i costi degli strumenti, le imposte e altre rettifiche di fatturazione.
API interattiva e calcolatore di flussi di lavoro
Utilizza i valori GPT-6 Sol pubblicati come valori iniziali: input $2/M, output $10/M e input memorizzato nella cache $0,20/M. Il selettore di percorso spiega il confine decisionale GlobalGPT senza includere il prezzo dell'abbonamento nei calcoli dell'API.
Calcolatore dei costi dell'API GPT-6 Sol
Utilizza i valori OpenAI pubblicati come punto di partenza: $2/M in ingresso, $10/M in uscita e $0,20/M in ingresso nella cache. Potrai sostituirli quando verrà pubblicato un nuovo listino ufficiale.
Risultato API = (input totale − input memorizzato nella cache) ÷ 1.000.000 × velocità di input + output ÷ 1.000.000 × velocità di output + input memorizzato nella cache ÷ 1.000.000 × velocità di cache. Il valore del flusso di lavoro viene indicato come decisione di instradamento, non come prezzo di sottoscrizione.
Verifiche pratiche su GPT-6 Sol
Cosa dimostrano effettivamente i tre controlli pratici
| Controllo | Risultato osservato | Cosa supporta |
|---|---|---|
| P01: aritmetica di base | $0.041, ricavato dalle tariffe fittizie fornite per i modelli $2/$8 | Le tariffe riportate di seguito sono indicative e l’importo stimato è puramente fittizio; non si tratta della fattura ufficiale odierna. |
| P02: preventivo strutturato | $7.20 dal registro fittizio $3/$12; 105 token effettivamente inseriti | Aritmetica JSON e conservazione delle incognite. Il dato di 1,2 milioni di token era un valore di registro, non un test su un contesto esteso. |
| P03: funzione della calcolatrice | Il primo tentativo ha raggiunto il limite di output; il secondo ha restituito la funzione completa | Generazione di codice con un solo tentativo di riprova specificato. Non sono stati testati l’API Batch, una fattura del fornitore né gli sconti in batch. |
Questi controlli chiariscono in che modo il modello gestisce un’attività di determinazione dei prezzi. Il listino prezzi ufficiale riportato sopra indica quanto addebita il fornitore. Tenere separate queste due questioni impedisce che un dato generato dal modello venga interpretato come un’affermazione relativa al prezzo.
Questi test utilizzano GPT-6 Sol in GlobalGPT. Mostrano come il modello gestisce i calcoli relativi ai prezzi, i dati strutturati e il codice della calcolatrice; la tabella di fatturazione del fornitore riportata sopra proviene dalla pagina di rilascio pubblicata di OpenAI. P01 e P02 mantengono i loro primi risultati. P03 è stato riprovato una volta poiché la sua prima risposta si è interrotta al limite di output prima di completare la funzione.
P01 · Domande e risposte sulla quotazione delle azioni short
P01-breve · primo risultato restituitoHTTP 2005,23 sIn questa verifica: GPT-6 Sol ha elaborato il prompt in GlobalGPT. Il risultato mostra come gestisce i calcoli relativi ai prezzi e le istruzioni strutturate; è indipendente da qualsiasi listino prezzi del fornitore.
Utilizzo: 109 in entrata · 132 in uscita · 241 in totale · finish_reason=stop.
Visualizza il prompt esatto e l'output completo
Prompt
Stai testando uno strumento esplicativo sui prezzi. Utilizza esclusivamente il listino prezzi fittizio fornito: inserisci $2,00 per milione di token, ottieni come risultato $8,00 per milione di token. Domanda: quanto costerebbero 12.500 token in ingresso e 2.000 token in uscita? Mostra la formula, indica che il risultato è fittizio e specifica quali informazioni sarebbero ancora necessarie per un preventivo reale da parte di un fornitore.
Output completo
**Costo fittizio:**
(12.500 ÷ 1.000.000 × $2,00) + (2.000 ÷ 1.000.000 × $8,00) = **$0,041** (4,1 ¢).

Per ottenere un preventivo reale da un fornitore, occorrerebbero il nome del fornitore e il modello, le tariffe attuali e eventuali sconti, costi aggiuntivi o tasse applicabili.
P02 · Preventivo strutturato
Struttura P02 · primo risultato restituitoHTTP 2005,639 sIn questa verifica: GPT-6 Sol ha elaborato il prompt in GlobalGPT. Il risultato mostra come gestisce i calcoli relativi ai prezzi e le istruzioni strutturate; è indipendente da qualsiasi listino prezzi del fornitore.
Utilizzo: 105 in entrata · 196 in uscita · 301 in totale · finish_reason=stop.
Visualizza il prompt esatto e l'output completo
Prompt
Restituisce un oggetto JSON compatto con le chiavi input_cost, output_cost, total_cost, assumptions, unknowns. Utilizza questo registro fittizio: 1.200.000 token in ingresso, 300.000 token in uscita; i tassi sono $3/M in ingresso e $12/M in uscita; il tasso di ingresso memorizzato nella cache non è specificato. Non aggiungere uno sconto memorizzato nella cache né alcuna informazione relativa al fornitore.
Output completo
{"costo_input":3,60,"costo_output":3,60,"costo_totale":7,20,"ipotesi":["USD; tutti i token di input fatturati a $3/M senza sconto per la cache"],"incognite":["tasso di input memorizzato nella cache","numero di token di input memorizzati nella cache"]}P03 · Funzione di calcolo dei costi
P03-code-batch · secondo tentativo dopo il troncamento del limite di outputHTTP 20013,602 sIn questa verifica: GPT-6 Sol ha elaborato il prompt in GlobalGPT. Il risultato mostra come gestisce i calcoli relativi ai prezzi e le istruzioni strutturate; è indipendente da qualsiasi listino prezzi del fornitore.
Utilizzo: 129 in entrata · 757 in uscita · 886 in totale · finish_reason=stop.
Riprova: il primo tentativo si è interrotto al raggiungimento di max_tokens e non è stato completato; è consentito un nuovo tentativo in caso di output non valido
Visualizza il prompt esatto e l'output completo
Prompt
Scrivi una funzione JavaScript completa ed eseguibile `estimateTokenCost(inputTokens, outputTokens, inputRatePerMillion, outputRatePerMillion)` per un calcolatore di prezzi. Requisiti: restituisca un chiaro messaggio di errore di convalida per valori vuoti, non numerici, negativi o non finiti; accetti lo zero solo quando entrambi i conteggi dei token sono pari a zero; utilizzi l'aritmetica ordinaria; includa un esempio normale e un esempio finito molto grande senza generare infinito; non affermi che questi tassi siano reali. Restituisca solo il codice JavaScript completo e una breve nota.
Output completo
```javascript
function estimateTokenCost(
  inputTokens,
  outputTokens,
  inputRatePerMillion,
  outputRatePerMillion
) {
  const values = {
    inputTokens,
    outputTokens,
    inputRatePerMillion,
    outputRatePerMillion
  };

  for (const [name, value] of Object.entries(values)) {
    if (typeof value !== "number" || !Number.isFinite(value)) {
      return { error: `${name} must be a finite number.` };
    }
    if (value < 0) {
      return { error: `${name} cannot be negative.` };
    }
  }

  const bothCountsZero = inputTokens === 0 && outputTokens === 0;
  if (!bothCountsZero && (inputTokens === 0 || outputTokens === 0 ||
      inputRatePerMillion === 0 || outputRatePerMillion === 0)) {
    return { error: "Zero values are allowed only when both token counts are zero." };
  }

  const cost =
    (inputTokens / 1_000_000) * inputRatePerMillion +
    (outputTokens / 1_000_000) * outputRatePerMillion;

  if (!Number.isFinite(cost)) {
    return { error: "The calculated cost is not finite." };
  }

  return { cost };
}

// Illustrative rates only; these are not real prices.
console.log(estimateTokenCost(1_000, 500, 2, 4));
console.log(estimateTokenCost(1e150, 2e150, 3e150, 4e150));
```

Note: The examples use hypothetical rates.
API vs percorso di workflow GlobalGPT
Il prezzo è solo uno dei fattori che influenzano la decisione. Un'API può essere lo strumento giusto per una chiamata al backend anche quando, per le attività manuali correlate, è preferibile optare per un abbonamento o un flusso di lavoro.
| Domanda | Percorso API | Percorso del flusso di lavoro GlobalGPT |
|---|---|---|
| Come viene calcolato il costo? | Token a consumo da un listino prezzi di un fornitore verificato. | Condizioni attuali del piano, regole di accesso e valore del flusso di lavoro; verificare la pagina live. |
| Quale lavoro è adatto? | Chiamate programmabili, processi batch, servizi di produzione. | Ricerca interattiva, scrittura, programmazione e molteplici funzioni di intelligenza artificiale in un’unica dashboard. |
| Cosa bisogna verificare? | Unità di input/output, regole relative alla cache e ai batch, limiti e ID del modello. | Prezzo attuale del piano, mappatura dei modelli, quote e controlli sull'utilizzo. |
| In quale contesto si inserisce CLI? | Integrazione diretta delle applicazioni. | L'interfaccia CLI di GlobalGPT consente di integrare l'accesso ai modelli con i terminali e i flussi di lavoro esistenti, qualora disponibili per il proprio account. |
Raccogli i dati effettivi relativi ai token dalla tua applicazione, calcola l'esposizione dell'API in base al listino prezzi verificato e valuta separatamente il valore della dashboard multimodello per il resto dell'attività. Tieni separati questi registri.
FAQ
Qual è il prezzo ufficiale dell'API GPT-6 Sol?
OpenAI indica che GPT-6 Sol costa $2 per milione di token in ingresso e $10 per milione di token in uscita. Le letture di input memorizzate nella cache beneficiano di uno sconto di 90%, equivalente a $0,20 per milione di token di input memorizzati nella cache, come indicato nella pagina di rilascio pubblicata.
GPT-6 Sol è incluso in un piano GlobalGPT?
Non dedurre l’inclusione di un piano dalla directory dei modelli. Verifica la pagina del piano GlobalGPT attuale e la mappatura dei modelli indicata per il tuo account.
Come si calcola il costo di una singola richiesta API?
Sottrarre innanzitutto gli input memorizzati nella cache dal totale degli input. Addebitare gli input non memorizzati nella cache a $2/M, gli input memorizzati nella cache ammissibili a $0,20/M e gli output a $10/M. Aggiungere, ove applicabile, i costi relativi agli strumenti o altre spese documentate separatamente.
È meglio utilizzare un'API o un abbonamento?
Utilizza l’API per le chiamate a consumo programmabili con un listino tariffe verificato. Prendi in considerazione GlobalGPT quando il tuo lavoro coinvolge diversi modelli e funzioni di IA in un’unica dashboard. Un percorso misto può rivelarsi utile quando le chiamate di produzione e il lavoro interattivo presentano esigenze diverse.
Lascia che sia il listino prezzi a fare i conti e il flusso di lavoro a prendere le decisioni. Verifica nuovamente i prezzi in tempo reale e i termini dei piani prima di impegnare il budget.









