Inizia dal suono che vuoi produrre. Scegli Pick Eleven Music v2 per brani musicali e basi strumentali strutturate, Qwen Audio 3.0 TTS Flash per la narrazione e le voci espressive, e Seed Audio 1.0 quando desideri che dialoghi, rumori ambientali ed effetti sonori si fondano in un’unica scena completa.
Non è necessario trovare un unico modello audio ‘migliore’. Un creatore che realizza musica di sottofondo ha esigenze diverse da quelle di un professionista del marketing che registra una voce fuori campo o di un regista che sta girando una scena in una stazione ferroviaria. Abbiamo testato questi progetti reali — non solo le liste delle funzionalità — e qui sotto potete ascoltare tutti e dieci i primi risultati.
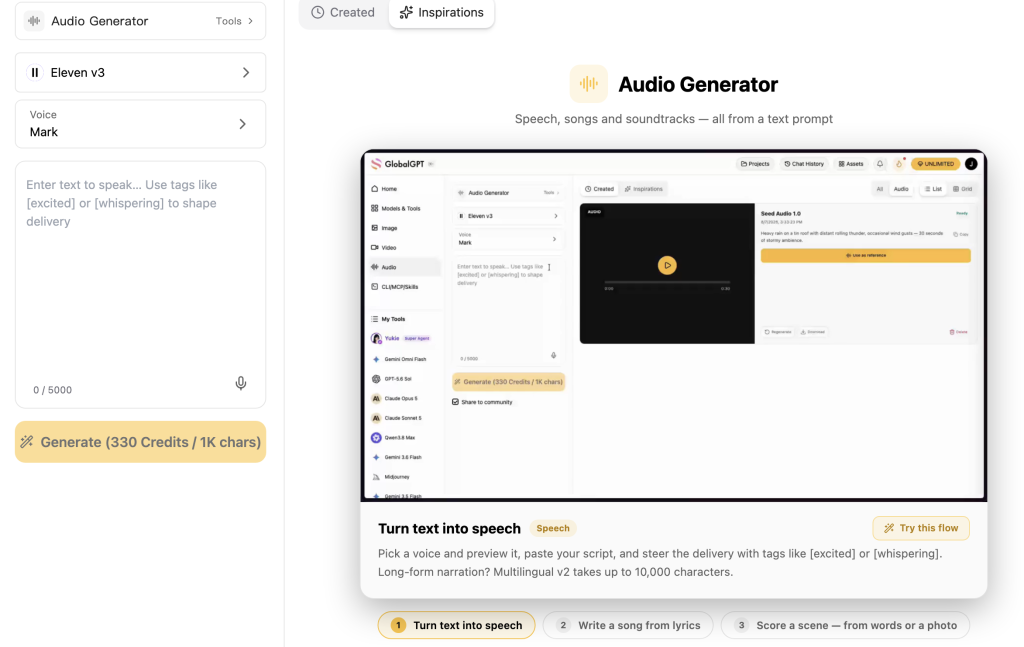
Se vuoi provare la stessa idea con il tuo prompt, GlobalGPT ti offre un unico punto da cui passare da uno all’altro. Si tratta inoltre di uno spazio di lavoro multimodello più ampio: puoi utilizzare modelli come GPT-5.6 Sol, Claude Opus 4.8 e Gemini 3.1 Pro per la scrittura e la ricerca, per poi passare a GPT Image 2 o Seedance 2.0 quando il progetto richiede immagini o video. Ciò significa che puoi redigere la sceneggiatura, generare l’audio e continuare a sviluppare il resto del progetto senza dover mettere insieme una serie di strumenti separati. L’accesso ai modelli varia a seconda del piano.
Inizia da ciò che vuoi realizzare
Si tratta di spunti di riflessione, non di una classifica universale.
Risposta veloce: quale modello è adatto a quale attività audio?
Ecco un modo semplice per decidere: scegli in base al risultato finale, non al marchio. Eleven è il punto di partenza naturale quando il prodotto finale è la musica; Qwen TTS Flash è adatto alla narrazione e alle voci espressive; Seed è indicato per le scene che richiedono un mix di dialoghi, rumori ambientali ed effetti sonori. I nostri sei test pratici mostrano in quali contesti ciascuna scelta si è rivelata più efficace, mentre i dieci brani riportati di seguito vi consentono di valutare personalmente i pro e i contro.
| Modello | Inizia da qui quando… | Cosa abbiamo provato | Tieni presente che |
|---|---|---|---|
| Eleven Music v2 | Ti serve una canzone o un brano strumentale strutturato | Due duelli musicali e un'esibizione canora | Non l'abbiamo usato per la narrazione |
| Qwen Audio 3.0 TTS Flash | Ti serve una narrazione o una voce espressiva | Due scontri verbali | Questi risultati si riferiscono alla versione di Flash sottoposta a test |
| Seed Audio 1.0 | Ti serve una scena completa con diversi tipi di suoni | Musica, dialoghi e una scena ambientata in una stazione ferroviaria | Un output flessibile non riproduce tutte le caratteristiche a monte |
Innanzitutto, si tratta di tre diversi tipi di modelli audio
Eleven Music v2: un flusso di lavoro dedicato alla musica
ElevenLabs descrive Eleven Music come testo trasformato in musica con la possibilità di controllare genere, stile e struttura. La documentazione illustra inoltre la produzione di brani vocali o strumentali, la generazione multilingue e la modifica per sezioni o dell’intero brano. Queste caratteristiche ne fanno il flusso di lavoro dedicato alla musica più chiaro tra quelli qui presentati; ciò non implica tuttavia che si tratti dello stesso tipo di approccio TTS di Qwen.

Qwen Audio 3.0 TTS Flash: il percorso vocale testato in questa occasione
Qwen Audio 3.0 TTS Flash — il percorso esatto di Anywhere è qwen-audio-3.0-tts-flash—è la via vocale utilizzata nei livelli B1 e B2. Documentazione sulla sintesi vocale di Alibaba Cloud riporta quel preciso nome Flash nel contesto della voce personalizzata. Il presente articolo non trasferisce le informazioni relative alla durata, al formato o alle voci integrate da altre righe o varianti Qwen.

Seed Audio 1.0: un flusso di lavoro più ampio nel panorama audio
Posizioni di ByteDance Seed Audio 1.0 per la generazione di scene complete che comprendono voci, effetti sonori, ambientazione sonora e orchestrazione unificata. Ciò lo rende la scelta naturale quando un unico output deve coordinare diversi tipi di suoni. L’immagine acquisita non suggerisce visivamente la presenza di musica, pertanto le osservazioni relative alla musica contenute in questo articolo derivano dai nostri test pratici piuttosto che da quell’immagine.

Il separato Pagina dell'API BytePlus identifica seed-audio-1.0 come percorso non in streaming con ingressi audio o video di riferimento, controllo della temporizzazione e durata dell'uscita fino a 120 secondi. Queste sono le caratteristiche del percorso, distinte dalla più ampia descrizione del posizionamento del modello.

Come abbiamo testato i tre flussi di lavoro audio
Abbiamo bloccato i prompt prima della generazione, inviato dieci attività in sequenza e conservato il primo output valido di ciascuna attività. Tutte e dieci le richieste sono andate a buon fine senza alcun tentativo di ripetizione. I frammenti di "readiness" sono stati esclusi; l'audio di prova riportato di seguito è il primo file multimediale valido non elaborato.
- Prove ufficiali: documentazione relativa ai prodotti o alle API di prima parte.
- Prove relative al percorso osservato: formato, durata, costo, decodifica e controlli del segnale relativi a questa sessione.
- Prove basate sull'ascolto: le preferenze a coppie cieche di un utente per A1, A2, B1 e B2, oltre alla valutazione semantica per C1 e C3.
- Limiti: non è stata eseguita la verifica della stabilità; B1 e B2 non sono stati trascritti né controllati automaticamente parola per parola.
Il costo totale rilevato è stato di $0,4819752667 per dieci output. Tale cifra si riferisce alla presente sessione e non costituisce una promessa ufficiale di prezzo.
Test musicali: Eleven Music v2 contro Seed Audio 1.0
A1: Colonna sonora di sottofondo per documentari
A1: Colonna sonora di sottofondo per documentari
Colonna sonora strumentale di 30 secondi per un documentario di viaggio, caratterizzata da un'intensità crescente e da un finale risolutivo.
Mostra il prompt esatto in cui si è bloccato il sistema
Crea una colonna sonora strumentale di 30 secondi per un breve documentario di viaggio. Inizia con un delicato fingerpicking alla chitarra acustica e un pianoforte dai toni caldi, aggiungi leggere percussioni a mano dopo il primo terzo del brano, intensifica delicatamente il ritmo e concludi con una cadenza pulita e risolutiva. Il brano deve trasmettere speranza e riflessione. Nessuna voce, nessun dialogo e nessun effetto sonoro.
| Modello | Percorso esatto | Stato | Durata effettiva | Formato | Costo osservato |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | Prima data di validità | 30,041 s | MP3, stereo a 44,1 kHz | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | Prima data di validità | 30.000s | PCM WAV, stereo a 40 kHz | $0.0700000 |
- Controlli oggettivi
- Entrambi i file sono stati decodificati correttamente, non hanno presentato quasi alcun clipping e si sono conclusi con una dissolvenza netta. Non è stata registrata una conformità completa degli strumenti.
- Giudizio dell'ascoltatore
- L'ascoltatore ha preferito Eleven Music v2 perché la progressione da leggero a pesante risultava più naturale e il coordinamento strumentale appariva più armonioso.
- Risultato dell'attività
- Undici sono stati scelti per questo primo compito.
- Limitazioni
- Un primo risultato valido per ciascun modello; non è stata eseguita l'analisi di stabilità.
Prova di ascolto A1
Ascolta i primi brani di A1
Gioca una delle due carte per confrontare direttamente i due modelli.
Eleven Music v2
eleven-music-v2Generato tramite il percorso Anywhere testato il 6 agosto 2026. Un primo risultato valido; non è stata eseguita la verifica di stabilità.
Seed Audio 1.0
seed-audio-1.0Generato tramite il percorso Anywhere testato il 6 agosto 2026. Un primo risultato valido; non è stata eseguita la verifica di stabilità.
Per l'A1, l'ascoltatore ha scelto la prima versione di Eleven per una transizione più naturale dal suono leggero a quello pesante e per un coordinamento strumentale più armonioso.
A2: Segnale strutturato di lancio del prodotto
A2: Segnale strutturato per il lancio di un prodotto
Un brano strumentale in tre parti della durata di 30 secondi: ritmo minimale, con l’aggiunta di percussioni e un’energia crescente, per poi concludersi con un finale brillante.
Mostra il prompt esatto in cui si è bloccato il sistema
Crea un brano strumentale di 30 secondi per il lancio di un prodotto, suddiviso in tre sezioni ben distinte: da 0 a 8 secondi, un ritmo sintetizzato minimale; da 8 a 22 secondi, aggiungi una batteria elettronica nitida e un’energia armonica crescente; da 22 a 30 secondi, concludi con un finale brillante e un finale pulito. Moderno e deciso, ma non aggressivo. Nessuna voce, discorso o suono ambientale.
| Modello | Percorso esatto | Stato | Durata effettiva | Formato | Costo osservato |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | Prima data di validità | 30,041 s | MP3, stereo a 44,1 kHz | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | Prima data di validità | 27,704 s | PCM WAV, stereo a 40 kHz | $0.0646436 |
- Controlli oggettivi
- Entrambi i file sono stati decodificati correttamente senza quasi alcun clipping. Il seed ha restituito 27,704 secondi per una richiesta di 30 secondi; si tratta di un comportamento tipico del percorso, non di una perdita di qualità.
- Giudizio dell'ascoltatore
- L'ascoltatore ha preferito Seed Audio 1.0 per l'introduzione più chiara e la maggiore ricchezza delle stratificazioni musicali; l'inizio di Eleven era difficile da distinguere.
- Risultato dell'attività
- Scelta preferita per questo primo compito; i due test musicali hanno dato risultati contrastanti.
- Limitazioni
- I tempi esatti delle sezioni non sono stati verificati in modo esaustivo; non è stato eseguito il test di stabilità.
Prova di ascolto A2
Ascolta i primi brani dell'A2
Gioca una delle due carte per confrontare direttamente i due modelli.
Eleven Music v2
eleven-music-v2Generato tramite il percorso Anywhere testato il 6 agosto 2026. Un primo risultato valido; non è stata eseguita la verifica di stabilità.
Seed Audio 1.0
seed-audio-1.0Generato tramite il percorso Anywhere testato il 6 agosto 2026. Un primo risultato valido; non è stata eseguita la verifica di stabilità.
Per la categoria A2, il primo risultato di Seed ha ottenuto il favore degli ascoltatori perché l’introduzione era più chiara e gli strati sonori risultavano più ricchi. Il percorso di Seed ha restituito 27,704 secondi per una richiesta di 30 secondi; registriamo tale scostamento separatamente, senza considerarlo una penalizzazione in termini di qualità. Poiché ciascun modello ha ottenuto un risultato migliore in un unico compito musicale, non vi è un vincitore nella categoria musicale.
Test vocali: Qwen TTS Flash vs Seed Audio 1.0
B1: Narrazione documentaristica neutra
B1: Narrazione documentaristica neutra
La stessa narrazione in inglese ambientata in un porto, con tono calmo e neutro, ritmo moderato e pause naturali.
Mostra il prompt esatto in cui si è bloccato il sistema
Ogni mattina, il porto si risveglia prima della città. I traghetti solcano le acque, le luci dei negozi si accendono e i primi pendolari scendono sul molo. Alle sette in punto, la tranquilla riva è ormai diventata il fulcro della giornata. Narrazione documentaristica pacata in un inglese chiaro e neutro. Mantenere un ritmo moderato e inserire pause naturali. Nessuna musica, sottofondo o effetti sonori.
| Modello | Percorso esatto | Stato | Durata effettiva | Formato | Costo osservato |
|---|---|---|---|---|---|
| Qwen Audio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | Prima data di validità | 27,507 s | MP3, 22,05 kHz mono | $0.0051300 |
| Seed Audio 1.0 | seed-audio-1.0 | Prima data di validità | 18,780 s | PCM WAV, 40 kHz stereo (canali identici) | $0.0438200 |
- Controlli oggettivi
- Entrambi i file sono stati decodificati correttamente e contenevano attività simile al parlato e pause. L'utente non ha segnalato alcun problema evidente relativo al testo.
- Giudizio dell'ascoltatore
- L'ascoltatore ha preferito Qwen perché lo trovava più naturale e simile a un documentario; Seed suonava rigido, come un promemoria prima di un esame.
- Risultato dell'attività
- Per questo compito di prima produzione è preferibile utilizzare il modello Qwen.
- Limitazioni
- Accuratezza letterale non verificata; test di stabilità non eseguito.
Prova di ascolto B1
Ascolta i primi brani del livello B1
Gioca una delle due carte per confrontare direttamente i due modelli.
Qwen Audio 3.0 TTS Flash
qwen-audio-3.0-tts-flashGenerato tramite il percorso Anywhere testato il 6 agosto 2026. Un primo risultato valido; non è stata eseguita la verifica di stabilità.
Seed Audio 1.0
seed-audio-1.0Generato tramite il percorso Anywhere testato il 6 agosto 2026. Un primo risultato valido; non è stata eseguita la verifica di stabilità.
Il primo output di Qwen risultava più naturale e simile a un documentario; Seed, invece, sembrava un po’ rigido all’ascolto. Se la verifica delle trascrizioni è fondamentale per il tuo flusso di lavoro, questa guida a parte spiega Come ChatGPT è in grado di trascrivere l'audio. Non abbiamo utilizzato la trascrizione per verificare il testo B1 parola per parola.
B2: Evoluzione emotiva
B2: Progressione emotiva
Una voce femminile che passa da un sussurro teso a una narrazione neutra, per poi sfociare in un'eccitazione sollevata.
Mostra il prompt esatto in cui si è bloccato il sistema
“Ce l’abbiamo fatta”, sussurrò Maya. Poi le luci si riaccendero. “Ok, ora possiamo festeggiare!” Usa una sola voce femminile adulta e coerente. Pronuncia la prima frase a bassa voce e con tono teso, quella centrale con tono narrativo neutro e l’ultima con entusiasmo e sollievo. Mantieni chiari i cambiamenti emotivi, ma senza esagerare. Nessuna musica né effetti sonori.
| Modello | Percorso esatto | Stato | Durata effettiva | Formato | Costo osservato |
|---|---|---|---|---|---|
| Qwen Audio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | Prima data di validità | 25,913 s | MP3, 22,05 kHz mono | $0.0052950 |
| Seed Audio 1.0 | seed-audio-1.0 | Prima data di validità | 9,180 s | PCM WAV, 40 kHz stereo (canali identici) | $0.0214200 |
- Controlli oggettivi
- Entrambi i file sono stati decodificati correttamente; erano presenti più regioni vocali. Le differenze di durata non sono state valutate ai fini della qualità.
- Giudizio dell'ascoltatore
- L'ascoltatore ha preferito il modello Qwen per la sua resa più intensa dei sussurri e per l'atmosfera narrativa più convincente.
- Risultato dell'attività
- Per questo compito di prima produzione è preferibile utilizzare il modello Qwen.
- Limitazioni
- Accuratezza letterale non verificata; test di stabilità non eseguito.
Prova di ascolto B2
Ascolta le prime uscite del B2
Gioca una delle due carte per confrontare direttamente i due modelli.
Qwen Audio 3.0 TTS Flash
qwen-audio-3.0-tts-flashGenerato tramite il percorso Anywhere testato il 6 agosto 2026. Un primo risultato valido; non è stata eseguita la verifica di stabilità.
Seed Audio 1.0
seed-audio-1.0Generato tramite il percorso Anywhere testato il 6 agosto 2026. Un primo risultato valido; non è stata eseguita la verifica di stabilità.
Il primo risultato generato da Qwen presentava un tono più sussurrato e una maggiore impronta narrativa. L'utente non ha rilevato alcun problema evidente nel testo di B1 o B2, ma l'esatta accuratezza delle parole rimane da verificare.
Esempi di flussi di lavoro basati su un unico modello
C1: Eleven Music v2 – Brano vocale strutturato
C1: Brano vocale strutturato
Una canzone indie-pop di 30 secondi con strumentazione e struttura fisse e due versi obbligatori.
Mostra il prompt esatto in cui si è bloccato il sistema
Crea una canzone indie-pop allegra della durata di 30 secondi con una cantante solista femminile, chitarra vivace, basso e battiti di mani. Struttura: un’introduzione strumentale di quattro secondi, una breve strofa, un ritornello e una conclusione pulita. Utilizza una volta ciascuna delle seguenti frasi del testo: Strofa: ‘Il mattino alla finestra, i progetti prendono il volo’. Ritornello: ‘Parti da dove sei e rendi luminoso questo momento’. Nessuna narrazione parlata né effetti sonori.
| Modello | Percorso esatto | Stato | Durata effettiva | Formato | Costo osservato |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | Prima data di validità | 30,041 s | MP3, stereo a 44,1 kHz | $0.0750000 |
- Controlli oggettivi
- Il file MP3 è stato decodificato correttamente. È stato rilevato un campione isolato trascurabile a fondo scala, senza clipping diffuso.
- Giudizio dell'ascoltatore
- L'ascoltatore ha ritenuto che il requisito fosse parzialmente soddisfatto: la voce risultava un po' innaturale e presentava un rumore di fondo simile a quello elettrico.
- Risultato dell'attività
- Obiettivo parzialmente raggiunto per questo primo risultato.
- Limitazioni
- L'osservazione si applica solo a questo primo risultato; la stabilità non è stata verificata.
Prova di ascolto C1
Ascolta la prima registrazione del C1
Riproduci il primo output valido di questa vetrina dedicata a un unico modello.
Eleven Music v2
eleven-music-v2Generato tramite il percorso Anywhere testato il 6 agosto 2026. Un primo risultato valido; non è stata eseguita la verifica di stabilità.
C1 ha adempiuto parzialmente al contratto. L'ascoltatore ha trovato la voce un po' innaturale e ha percepito un rumore di fondo simile a quello elettrico. Si tratta di un'osservazione specifica relativa a quel campione, non di una segnalazione di difetto di carattere generale.
C3: Seed Audio 1.0 – Scena completa della stazione ferroviaria
C3: Scena completa della stazione ferroviaria
Una scena di 20 secondi ambientata in una stazione costiera che combina rumori ambientali, un treno in movimento, un segnale acustico e un annuncio preciso.
Mostra il prompt esatto in cui si è bloccato il sistema
Crea una scena completa di 20 secondi ambientata in una stazione ferroviaria costiera all’alba. Inizia con una leggera brezza marina e il verso lontano dei gabbiani. Un treno si avvicina da sinistra e frena in corrispondenza del binario. Una tranquilla annunciatrice della stazione dice esattamente: ‘Il treno costiero delle sette e un quarto sta per arrivare al binario due’. Aggiungi un breve e delicato segnale musicale prima dell’annuncio, poi lascia che il treno e l’atmosfera si dissolvano naturalmente. Mantieni il discorso comprensibile e la scena spazialmente coerente.
| Modello | Percorso esatto | Stato | Durata effettiva | Formato | Costo osservato |
|---|---|---|---|---|---|
| Seed Audio 1.0 | seed-audio-1.0 | Prima data di validità | 20.000s | PCM WAV, stereo a 40 kHz | $0.0466667 |
- Controlli oggettivi
- Il file WAV è stato decodificato correttamente, non presentava quasi alcun clipping e, dal punto di vista tecnico, conteneva la struttura a più parti richiesta.
- Giudizio dell'ascoltatore
- L'ascoltatore ha ritenuto che il requisito fosse parzialmente soddisfatto, poiché i rumori della frenata e dell'arresto del treno sembravano un po' artificiali.
- Risultato dell'attività
- Obiettivo parzialmente raggiunto per questo primo risultato.
- Limitazioni
- L'annuncio esatto non è stato trascritto in modo indipendente; non è stato eseguito il test di stabilità.
Test di ascolto C3
Ascolta la prima uscita del C3
Riproduci il primo output valido di questa vetrina dedicata a un unico modello.
Seed Audio 1.0
seed-audio-1.0Generato tramite il percorso Anywhere testato il 6 agosto 2026. Un primo risultato valido; non è stata eseguita la verifica di stabilità.
Anche C3 ha soddisfatto in parte i requisiti del contratto: l’ascoltatore ha trovato i suoni della frenata e dell’arresto del treno un po’ artificiali. Anche i creatori di video che combinano la voce generata con le immagini potrebbero riscontrare questo problema Guida ai dialoghi, all'audio e alla sincronizzazione labiale utile, anche se in questo caso la sincronizzazione labiale non è stata testata.
Costo, lunghezza dell'output e comportamento del percorso
Carica osservata e durata effettiva dell'erogazione
Un primo risultato valido per ogni compito tramite Anywhere il 6 agosto 2026. Le tariffe si riferiscono alle osservazioni delle sessioni e non costituiscono un listino prezzi ufficiale. Le due mini-barre utilizzano scale visive separate; non vengono utilizzati né un doppio asse né un punteggio combinato.
I costi osservati variano da $0,00513 per Qwen B1 a $0,075 per ciascuna uscita di Eleven. La durata effettiva varia da 9,180 secondi per Seed B2 a 30,041 secondi per le uscite musicali di Eleven. Si tratta di risultati misurati durante le sessioni, non di prezzi di listino o punteggi di qualità.
Perché provare questi modelli audio su GlobalGPT?
La generazione di musica, la sintesi vocale espressiva e i paesaggi sonori completi sono attività diverse, motivo per cui in questo caso non esiste un unico modello che si riveli la soluzione ideale. GlobalGPT rende questa distinzione pratica: puoi iniziare con Eleven Music per una traccia, passare a Qwen Audio per la narrazione oppure utilizzare Seed Audio per una scena composta, senza dover gestire una piattaforma separata per ogni flusso di lavoro audio.
Poiché GlobalGPT è uno spazio di lavoro multimodello piuttosto che uno strumento esclusivamente audio, il lavoro non deve necessariamente concludersi con un file audio. È possibile utilizzare altri modelli di intelligenza artificiale presenti sulla piattaforma per redigere o perfezionare una sceneggiatura, effettuare ricerche su un argomento, creare immagini di supporto e sviluppare materiale video da abbinare al prodotto audio finito.
Il 10 agosto 2026, il Pagina dei prezzi di GlobalGPT sono stati indicati gli equivalenti mensili pari a $5,8 per il piano BASIC, $10,8 per il piano PRO e $25,0 per il piano UNLIMITED, con le opzioni “Selezionato annualmente” e “Fatturato annualmente” visualizzate. Questi sono i dati relativi alla fatturazione annuale riportati nella pagina; l’accesso ai modelli varia a seconda del piano.

Quale modello scegliere?
Matrice dei risultati del primo output a sei attività
| Flusso di lavoro | Modelli testati | Risultato | Motivo osservato | Tipo di prova | Limitazione |
|---|---|---|---|---|---|
| A1 · Musica | Eleven contro Seed | Undici preferiti | Una progressione più naturale e una strumentazione più armoniosa | Preferenze degli ascoltatori non vedenti | Un primo risultato ciascuno |
| A2 · Musica | Eleven contro Seed | Preferibilmente con semi | Un'introduzione più chiara e una struttura più articolata | Preferenze degli ascoltatori non vedenti | Seed ha restituito 27,704 s |
| B1 · Espressione orale | Qwen contro Seed | Qwen (preferibile) | Uno stile narrativo più naturale nei documentari | Preferenze degli ascoltatori non vedenti | Testo non verificato parola per parola |
| B2 · Espressione orale | Qwen contro Seed | Qwen (preferibile) | Un'atmosfera più intensa, tra sussurri e narrazione | Preferenze degli ascoltatori non vedenti | Testo non verificato parola per parola |
| C1 · Canto vocale | Solo undici | Soddisfatto in parte | La voce aveva un suono innaturale, simile a un rumore elettrico | Revisione semantica da parte dell'utente | Osservazione specifica per campione |
| C3 · Panorama sonoro | Solo semi | Soddisfatto in parte | Il rumore della frenata e dell'arresto del treno sembrava artificiale | Revisione semantica da parte dell'utente | Annuncio non trascritto |
Nessuna serie viene trasformata in un punteggio complessivo o in un vincitore assoluto.
- Scegli Eleven Music v2 quando il lavoro riguarda essenzialmente la musica: brani strumentali strutturati, canzoni o editing musicale a livello di sezione.
- Scegli Qwen Audio 3.0 TTS Flash quando si tratta di narrazione o di discorso espressivo guidato.
- Scegli Seed Audio 1.0 quando l'output deve presentarsi come una scena completa che combini atmosfera, effetti e dialoghi.
Queste raccomandazioni riassumono l'adeguatezza al flusso di lavoro e sei valutazioni relative al primo risultato. Non indicano un unico vincitore assoluto.
Limiti di questo confronto
- Un primo risultato valido per ciascun modello e attività; nessuna ripetizione per motivi di stabilità.
- I testi B1 e B2 non sono stati trascritti né controllati parola per parola.
- I giudizi di ascolto sono soggettivi e specifici per ogni campione.
- Un percorso Anywhere non costituisce l'intero prodotto a monte.
- Nessuna classifica indipendente attendibile include questi tre percorsi specifici nell'ambito di un unico metodo.
- Il formato del file, la frequenza di campionamento, i canali, la dimensione del file e il volume di riproduzione non sono stati considerati come parametri di qualità.
Domande frequenti
01Eleven Music v2, Qwen Audio 3.0 e Seed Audio 1.0 sono modelli dello stesso tipo?
No. Eleven Music v2 è un flusso di lavoro dedicato alla musica, Qwen Audio 3.0 TTS Flash è il sistema di sintesi vocale testato in questa occasione, mentre Seed Audio 1.0 è pensato per la generazione di audio a scena intera. Questo confronto fornisce quindi raccomandazioni in base alle diverse attività, anziché imporre una classifica universale.
02Quale modello è stato progettato per la generazione di musica tramite intelligenza artificiale?
Eleven Music v2 è senza dubbio la scelta migliore tra i programmi dedicati alla musica presenti in questo confronto. La sua documentazione ufficiale descrive la possibilità di controllare genere, stile, struttura, output vocale o strumentale, il supporto multilingue e la modifica a livello di sezione o dell'intero brano.
03Quale percorso, tra quelli testati, si adatta meglio alla narrazione e al discorso espressivo?
Qwen Audio 3.0 TTS Flash, identificato qui con il percorso esatto di Anywhere qwen-audio-3.0-tts-flash, si è dimostrato il più adatto ai test di narrazione e di discorso espressivo. L’ascoltatore ha preferito il suo primo risultato sia in B1 che in B2, ma la stabilità e l’accuratezza lessicale non sono state testate.
04Quale modello è in grado di creare un panorama sonoro completo con voce ed effetti?
Seed Audio 1.0 rappresenta la soluzione ideale per la creazione di un paesaggio sonoro composto. Il suo posizionamento ufficiale comprende voce, effetti sonori, ambientazioni e orchestrazione unificata, mentre il test C3 ha combinato in un unico risultato un annuncio di stazione, il rumore del treno in movimento, un segnale acustico e un’ambientazione costiera.
05Posso usarli tutti e tre con GlobalGPT?
Sì. Nell’area di lavoro audio di GlobalGPT puoi provare Eleven Music per la musica, Seed Audio 1.0 per scene audio complete e Qwen Audio 3.0 per i discorsi. GlobalGPT integra inoltre flussi di lavoro relativi alla scrittura, alla ricerca, alle immagini e ai video nella stessa piattaforma multimodello. La disponibilità dei modelli varia a seconda del piano.
06Questo confronto individua un vincitore assoluto?
No. I modelli sono destinati a flussi di lavoro diversi e i risultati pratici riportati si riferiscono a un primo output valido per ciascun modello e attività, senza ripetizioni per verificare la stabilità. La conclusione utile è condizionata: Eleven per la musica dedicata, Qwen TTS Flash per il parlato e Seed per scene audio complete.
Prova il tuo flusso di lavoro audio personalizzato
Porta con te il tuo brief musicale, il copione della narrazione o lo spunto per il paesaggio sonoro al Generatore audio GlobalGPT e confronta il risultato con il lavoro che devi effettivamente portare a termine. Presta attenzione alla struttura musicale, all’interpretazione vocale, alla coerenza della scena e al rispetto delle indicazioni, invece di scegliere un modello basandoti solo sul nome.
Una volta che la direzione audio funziona, puoi proseguire il progetto utilizzando gli altri modelli di IA di GlobalGPT per lo sviluppo della sceneggiatura, la ricerca, le immagini di supporto e i concept video. In questo modo, il test si trasforma in un flusso di lavoro pratico per la creazione di contenuti, anziché in una semplice demo audio isolata; ripeti i risultati solo quando hai bisogno di confermare la stabilità del sistema.