Qwen 3.8 Max adalah model andalan terbaru dari Alibaba Qwen yang dirancang untuk pemrograman, pekerjaan profesional, agen yang berjalan dalam jangka panjang, dan tugas-tugas multimodal. Nama resminya adalah Qwen3.8-Max, hal ini diumumkan pada tanggal 3 Agustus 2026 dengan total 2,4 triliun parameter, 95 miliar parameter aktif, dan jendela konteks sebesar 1 juta token.
Peluncuran ini lebih dari sekadar pembaruan benchmark rutin. Qwen memposisikan model ini sebagai agen yang mampu merencanakan, menggunakan alat, menganalisis umpan balik visual, dan terus bekerja dalam rangkaian tugas yang panjang—bukan sekadar chatbot yang menjawab satu perintah pada satu waktu. Hal ini menempatkannya dalam kategori yang sama dengan model AI terbaik untuk penerapan di dunia nyata, namun harga API-nya, paket dengan kuota tak terbatas, dan persyaratan implementasinya perlu ditelaah lebih lanjut sebelum Anda beralih.
Apa Itu Qwen3.8-Max?
Qwen3.8-Max adalah model “mixture-of-experts” berskala besar yang dikembangkan oleh tim Qwen dari Alibaba. Model ini memiliki total 2,4 triliun parameter, namun mengaktifkan 95 miliar parameter untuk setiap token. Model ini menggabungkan pemahaman teks, kode, visual, penggunaan alat, dan perencanaan jangka panjang dalam satu sistem yang dirancang untuk menyelesaikan pekerjaan kompleks dari awal hingga akhir.
The rilis resmi Qwen menjelaskan empat tujuan utama: pemrograman otonom yang lebih kuat, hasil kerja profesional berstandar produksi, tugas-tugas berulang yang lebih panjang, dan agen multimodal asli. Secara praktis, Qwen ingin model tersebut beralih dari “jawab pertanyaan ini” menuju “ambil tujuan ini, buat rencana, gunakan alat yang tersedia, periksa hasilnya, dan lanjutkan hingga pekerjaan selesai.”
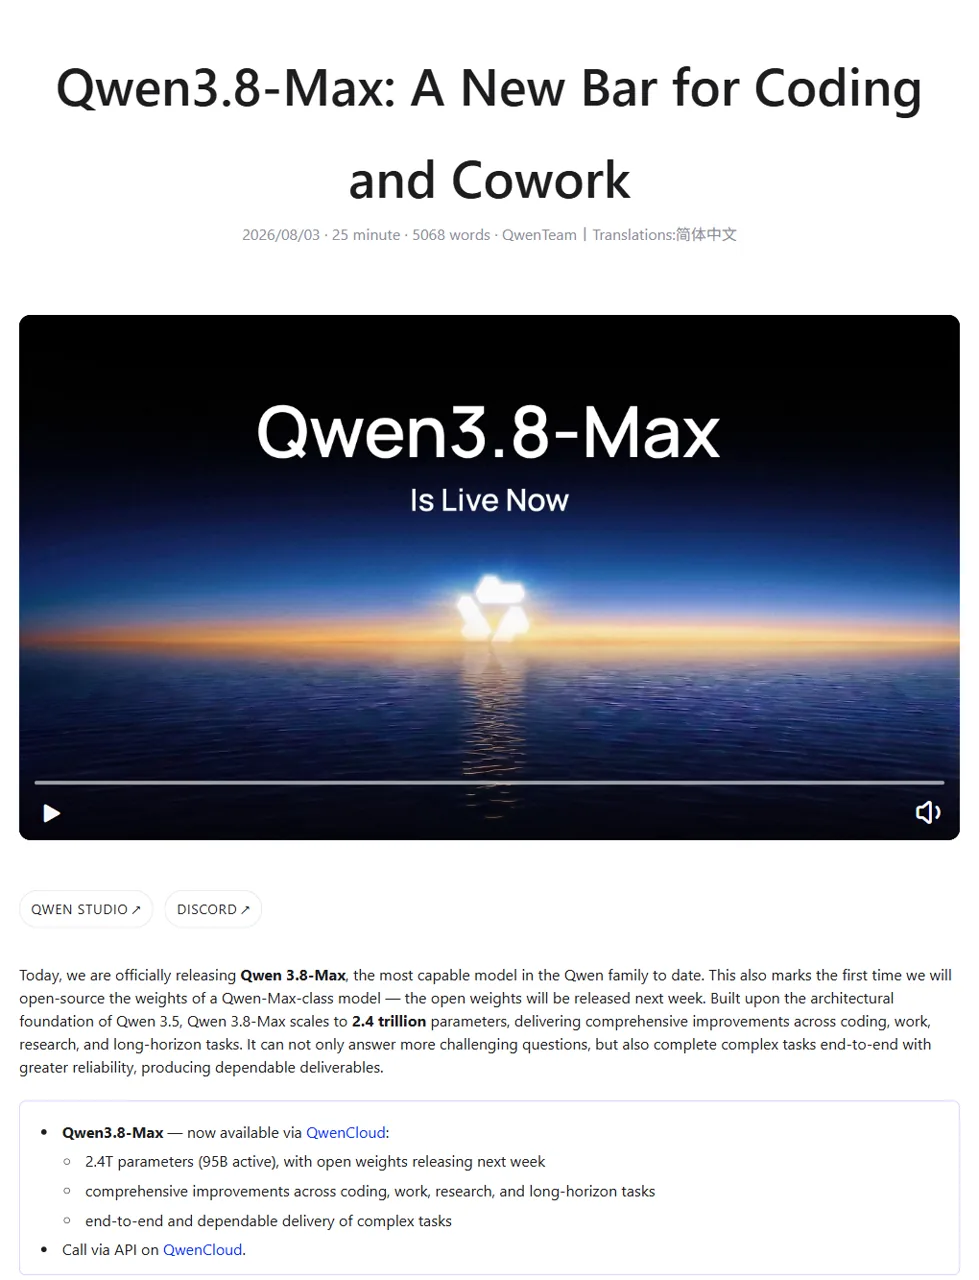
Qwen 3.8 Spesifikasi Maksimum
Jumlah parameter perlu dilihat dalam konteksnya. Model dengan 2,4 triliun parameter memang sangat besar, tetapi model Qwen3.8-Max tidak menggunakan setiap parameter untuk setiap token. Desain “mixture-of-experts”-nya mengarahkan setiap token melalui bagian aktif yang lebih kecil dari jaringan tersebut. Oleh karena itu, angka 95 miliar parameter aktif lebih berguna untuk memahami perilaku inferensi daripada jumlah total saja, meskipun kedua angka tersebut tidak dapat secara langsung menunjukkan latensi sebenarnya atau persyaratan perangkat keras.
Jendela konteks sebesar 1 juta token lebih langsung bermanfaat. Jendela ini mampu menampung repositori besar, kumpulan dokumen panjang, riwayat agen yang luas, atau catatan operasional selama berbulan-bulan dalam satu permintaan. Hal ini memang tidak menjamin tingkat pengambilan data yang sempurna untuk setiap token, tetapi memberikan ruang yang jauh lebih luas bagi pengembang untuk menyimpan instruksi, hasil keluaran alat, kode, dan keputusan-keputusan sementara tanpa perlu melakukan pemangkasan yang berlebihan.
Apa Saja yang Dapat Dilakukan oleh Qwen3.8-Max?
Pemrograman otonom
Materi peluncuran Qwen menyoroti proyek-proyek yang cakupannya jauh melampaui sekadar permintaan pembuatan kode tunggal. Perusahaan tersebut menggambarkan pengembangan otonom yang berlangsung lebih dari 10 hari, mulai dari folder kosong hingga menjadi proyek produksi sambil beradaptasi dengan kesalahan dan persyaratan baru. Itulah arah yang tepat untuk agen berskala repositori, meskipun pembeli tetap harus memvalidasi model tersebut pada bahasa pemrograman, rangkaian pengujian, aturan keamanan, dan lingkungan penerapan mereka sendiri.
Dalam praktik rekayasa sehari-hari, pertanyaan-pertanyaan praktisnya lebih sederhana: Apakah model tersebut mampu memproses beberapa berkas sekaligus? Apakah model tersebut mempertahankan antarmuka saat melakukan refactoring? Apakah model tersebut akan menulis uji coba, memeriksa kegagalan, dan memperbaiki tambalannya sendiri? Kriteria-kriteria tersebut lebih penting daripada satu skor papan peringkat saat memilih model AI terbaik untuk pengkodean.
Tugas “cowork” profesional
Istilah “cowork” merujuk pada hasil kerja, bukan sekadar obrolan santai. Qwen menyoroti laporan, penelitian, presentasi, analisis, dokumen, dan hasil kerja lainnya di berbagai bidang profesi. Model cowork yang baik harus mengikuti arahan, menyusun bukti secara terorganisir, menggunakan format yang tepat, dan menghasilkan sesuatu yang dapat diedit atau diserahkan oleh seseorang—bukan sekadar paragraf yang masuk akal.
Agen dengan cakrawala waktu panjang
Qwen juga melaporkan tugas-tugas tingkat sistem yang berlangsung hingga ratusan putaran. Contoh-contohnya mencakup lebih dari 500 putaran optimasi desain chip dan simulasi strategi e-commerce selama setahun. Ini adalah demonstrasi dari vendor, bukan janji bahwa setiap agen akan berjalan tanpa pengawasan selama berhari-hari. Namun, hal ini menunjukkan arah pengembangan produk: perencanaan berkelanjutan, evaluasi berulang, dan perbaikan berkesinambungan, bukan sekadar jawaban yang terpisah-pisah.
Perencanaan multimodal dan umpan balik visual
Qwen3.8-Max memperlakukan gambar dan layar sebagai bagian dari siklus agen. Seorang agen visual dapat memeriksa sebuah halaman, memilih tindakan, mengamati perubahan yang terjadi, dan merevisi rencananya. Hal ini mendukung tugas-tugas penggunaan komputer, pemahaman dokumen, pengujian antarmuka, pemrograman visual, grafik, dan penalaran spasial. Bagian yang sulit bukanlah sekadar mengenali sebuah gambar; melainkan menjaga agar pengamatan visual tetap terhubung dengan tujuan agen melalui banyak langkah.
Uji Coba Langsung: Hasil yang Berguna, Respons yang Lambat, dan Satu Eksekusi yang Kosong
Saya menjalankan tiga permintaan terpisah terhadap qwen3.8-max ID model melalui API yang kompatibel dengan Anywhere OpenAI pada tanggal 4 Agustus 2026. Ini adalah serangkaian pengujian praktis berskala kecil, bukan uji kinerja independen atau klaim mengenai setiap penerapan Qwen. Pengujian ini berguna karena menunjukkan baik kualitas jawaban yang ditampilkan maupun perilaku jalur gateway yang diuji.
Debugging Retry-helper
Tugas pertama menggunakan fungsi percobaan ulang yang bermasalah dari skenario webhook pembayaran. Petunjuk tersebut membatasi model pada tiga kali percobaan, dua nilai penundaan backoff yang tepat, pengembalian hasil secara langsung jika berhasil, serta memicu kembali pengecualian ketiga setelah kegagalan total.
Jawaban tersebut mengidentifikasi tiga kesalahan terpisah: tidur tanpa syarat setelah setiap upaya, sebuah yang belum ditetapkan hasil setelah terjadinya pengecualian, serta pemeriksaan "truthiness" yang menyebabkan keberhasilan tertunda atau ditangani dengan tidak tepat. Baris yang diharapkan adalah "dibayar" dengan argumen sleep_fn [0,1; 0,2].
Saya kemudian menjalankan kode tersebut secara lokal daripada hanya mempercayai penjelasannya. Kode tersebut berhasil melewati tiga kasus: dua kegagalan yang diikuti oleh keberhasilan, serta nilai keberhasilan "falsey" pada panggilan pertama sebesar 0, dan tiga kegagalan di mana hasil akhirnya RuntimeError("failure-3") harus ditingkatkan kembali. Ini merupakan solusi teknik yang baik. Komprominya terletak pada latensi: respons yang terlihat memakan waktu 51,577 detik melalui gateway yang diuji.
Sintesis bukti yang saling bertentangan
Tugas kedua ini menguji apakah model tersebut mampu membedakan fakta resmi terkini dari catatan lama, klaim vendor, komentar komunitas, dan rute platform yang belum terverifikasi.
Model tersebut menangani konflik yang disengaja dengan benar. Model tersebut tidak mengulang konteks 256K atau harga input $1.20 sebagai harga saat ini, tidak mengubah komentar tentang empat GPU menjadi persyaratan perangkat keras, dan tidak menyatakan bahwa GlobalGPT sudah memiliki rute khusus Qwen3.8-Max. Model tersebut juga menandai tabel benchmark resmi sebagai data yang dilaporkan oleh vendor. Waktu responsnya adalah 94,973 detik, sehingga ini merupakan hasil yang mengutamakan kualitas daripada hasil ekstraksi yang cepat.
Apa yang gagal dalam tes perencanaan?
Permintaan ketiga meminta rencana migrasi CMS selama dua jam yang melibatkan dua insinyur, dengan kriteria keputusan lanjut/tidak lanjut dan titik pemulihan yang jelas. Permintaan pertama berakhir setelah 133,682 detik ketika koneksi hulu terputus. Rentang percobaan ulang yang lebih singkat max_completion_token menjadi 1.200, tetapi API melaporkan alasan_penyelesaian: "panjang", menghabiskan seluruh alokasi waktu pemrosesan, dan tidak menghasilkan jawaban yang terlihat setelah 32,899 detik.
Itu adalah peringatan operasional yang berguna, tetapi bukan bukti bahwa Qwen3.8-Max tidak mampu merencanakan migrasi. Tidak ada rencana yang tersedia untuk dievaluasi. Melalui gerbang ini, perencanaan yang kompleks memerlukan alokasi waktu penyelesaian yang lebih besar, pemrosesan bertahap, atau perintah bertahap agar proses penalaran internal tidak menghabiskan seluruh anggaran respons sebelum teks yang terlihat dihasilkan.
Qwen 3.8: Skor Uji Kinerja Maksimum
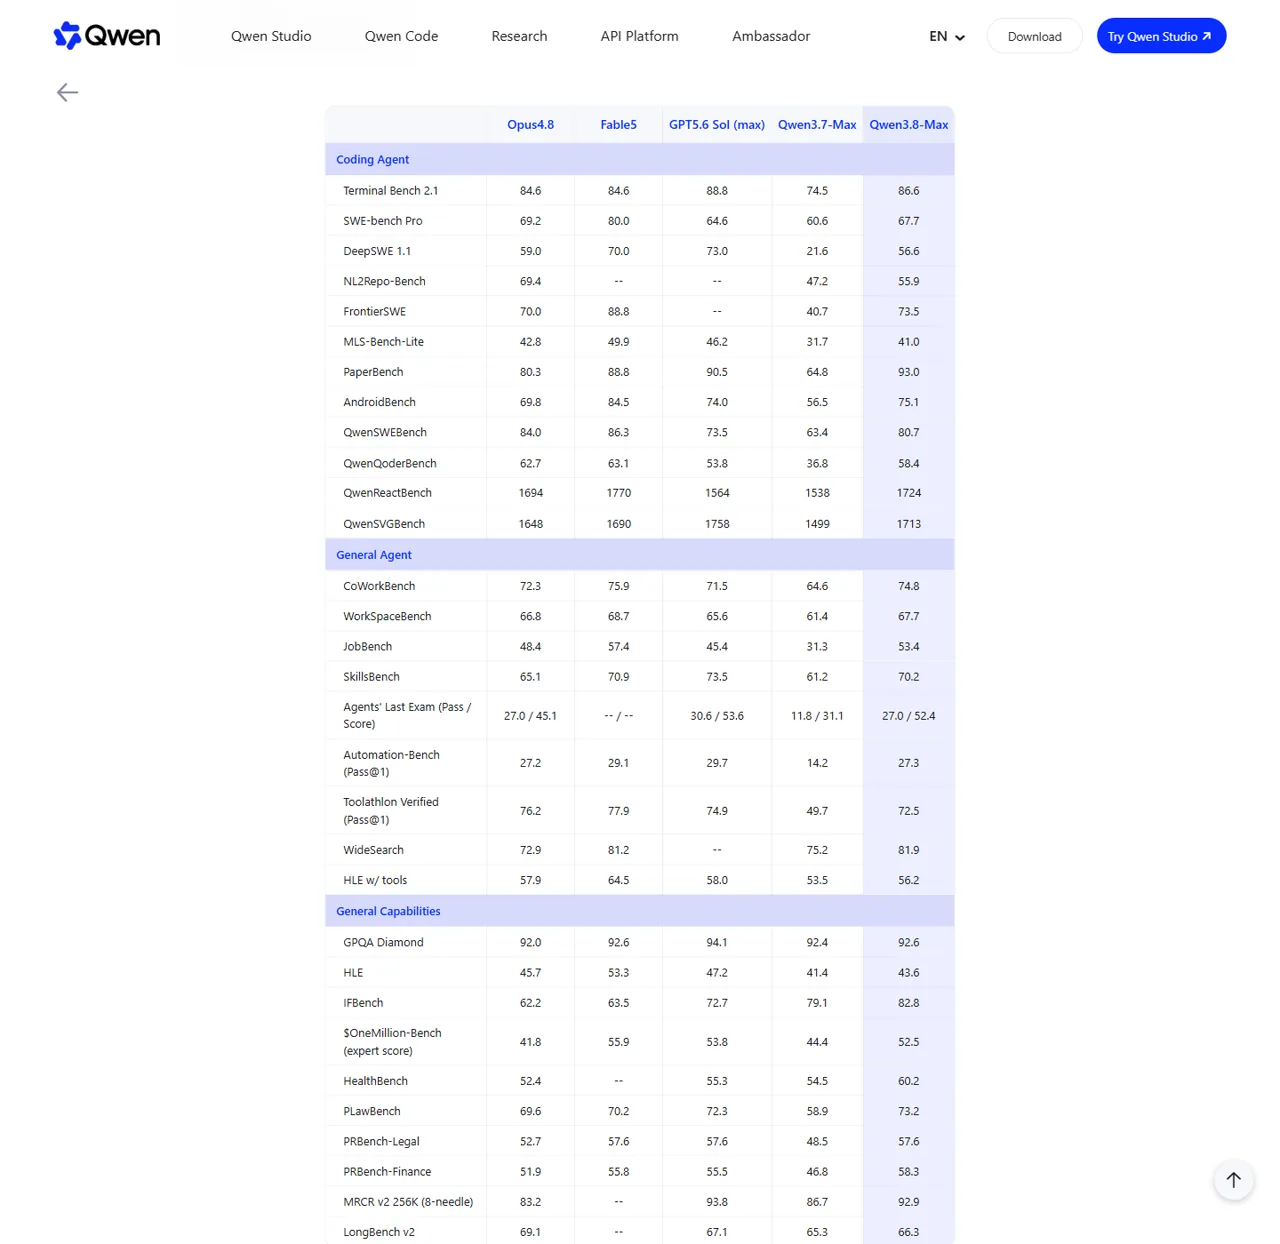
Paket benchmark resmi Qwen menampilkan Qwen3.8-Max sebagai agen pemrograman dan multimodal yang tangguh, namun hasilnya beragam—bukan dominasi mutlak. Model ini memimpin di antara model-model yang terdaftar pada beberapa tes, berada dekat dengan pemimpin pada tes lainnya, dan tertinggal di belakang GPT-5.6 Sol atau Fable 5 dalam beberapa kategori. Hal ini merupakan penilaian yang lebih seimbang daripada menyederhanakan puluhan tes menjadi satu label “model terbaik”.
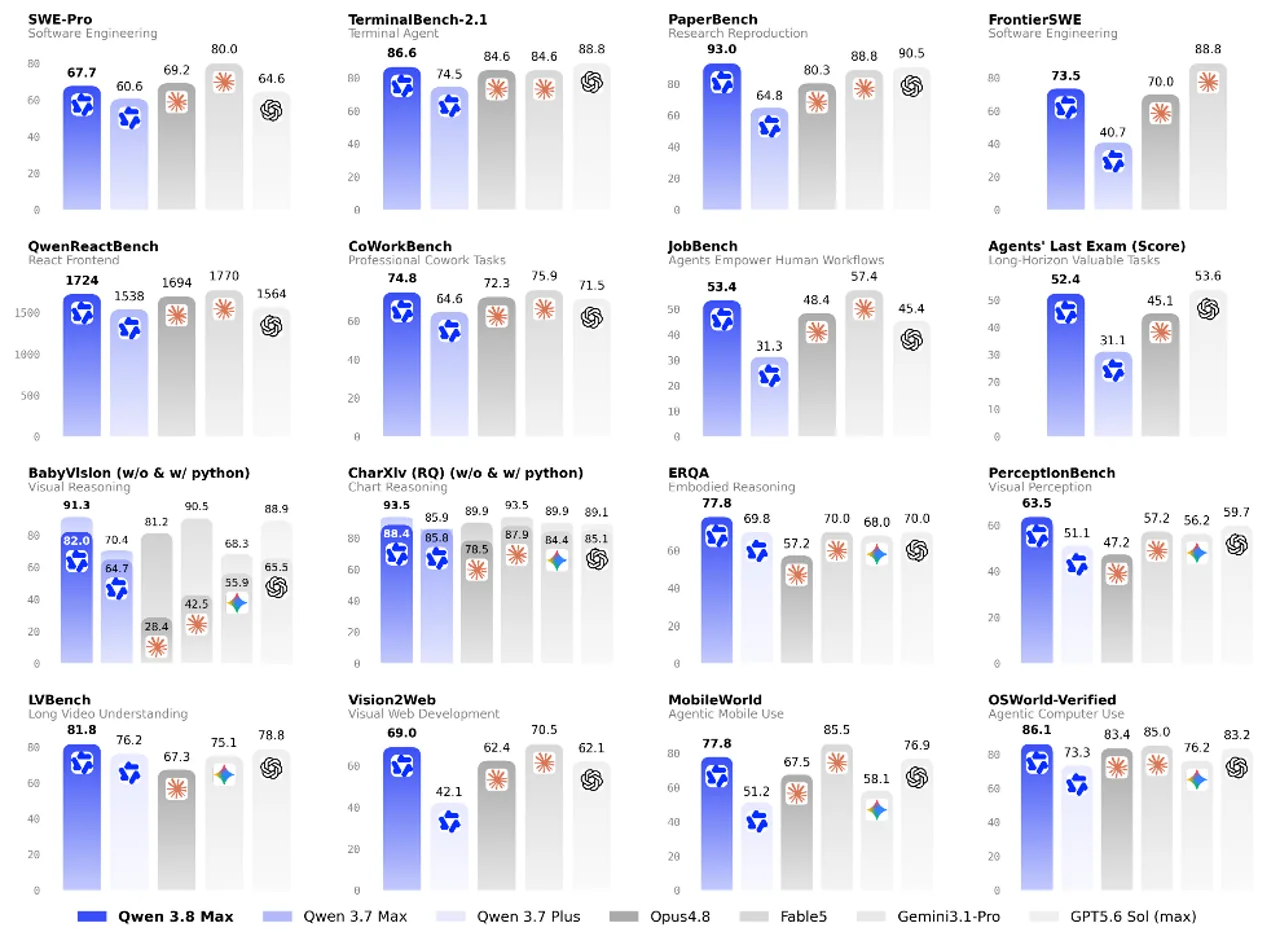
Hasil terpilih dari tabel resmi Qwen
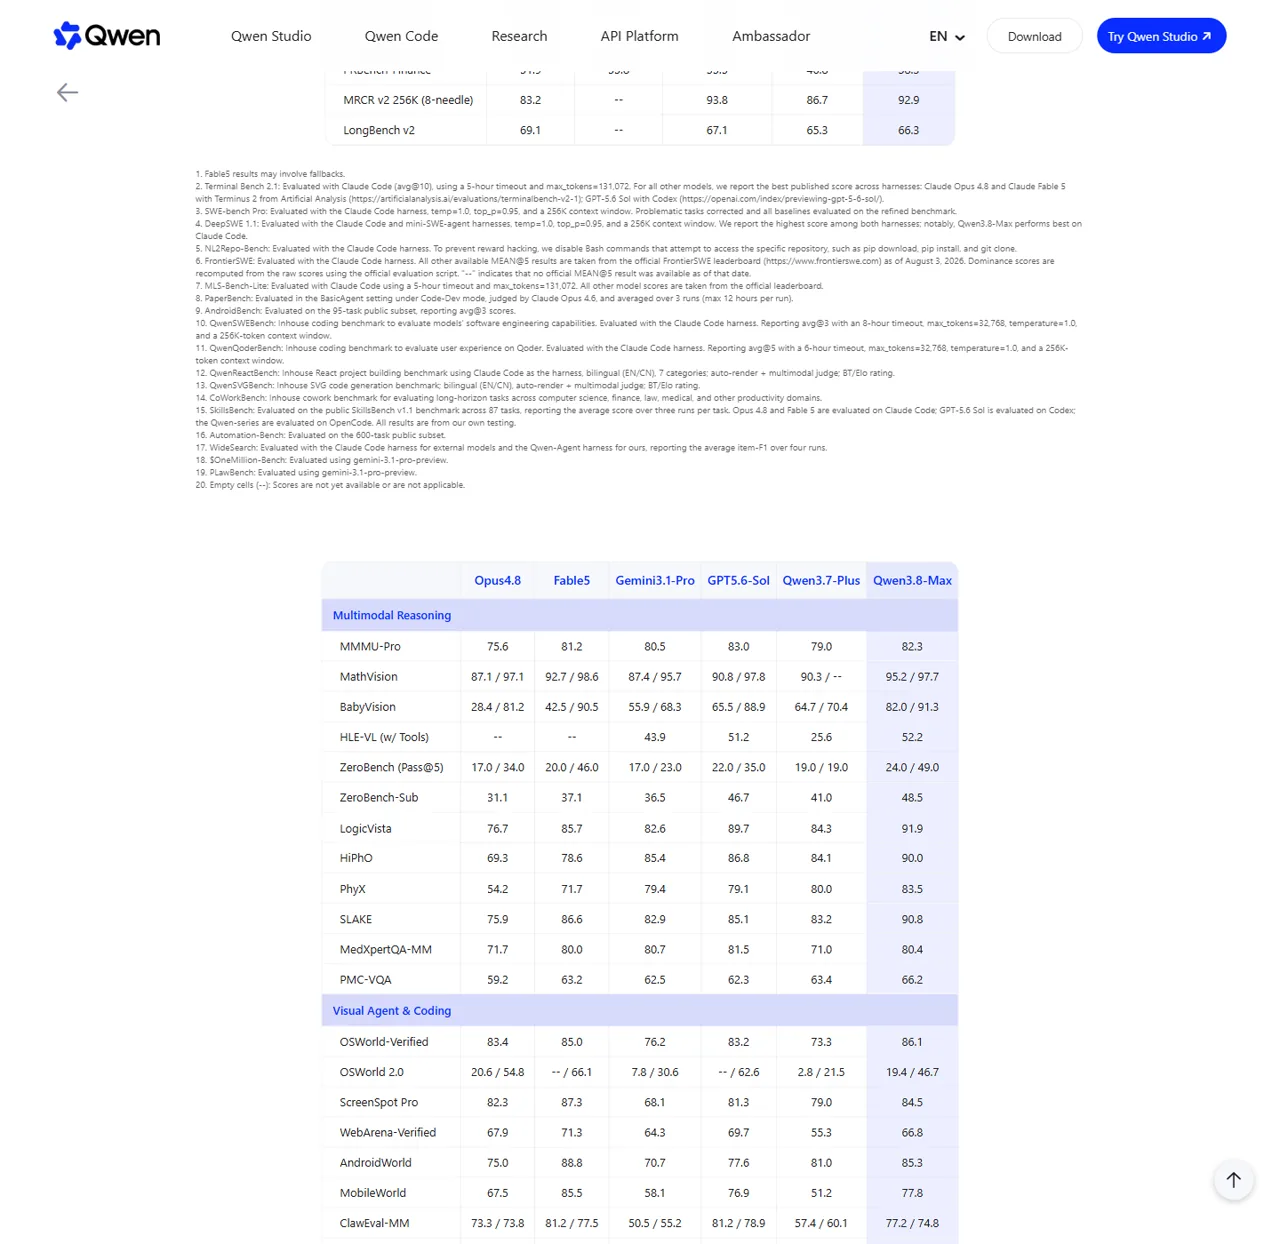
Angka-angka ini bersumber dari materi rilis resmi Qwen. Catatan kaki menunjukkan bahwa tabel tersebut menggabungkan laporan model resmi, kartu sistem, papan peringkat publik, dan evaluasi internal Qwen. Konfigurasi dan pengaturan juga bervariasi antar model. Gunakan tabel ini untuk mengidentifikasi keunggulan yang menjanjikan, lalu verifikasi daftar pendek tersebut melalui penelitian Anda sendiri sebelum mengambil keputusan yang memerlukan biaya tinggi.
Apa arti dari hasil pengkodean tersebut
Keunggulan yang paling menonjol adalah keseimbangannya. Qwen3.8-Max menempati peringkat teratas dalam berbagai bidang, mulai dari pekerjaan terminal, rekayasa perangkat lunak, implementasi dokumen, tugas kolaboratif, pencarian web, hingga mengikuti instruksi. Model ini tidak perlu unggul di setiap kategori untuk menjadi berguna; agen yang secara konsisten menunjukkan kinerja kuat dalam perencanaan, pemrograman, penggunaan alat, dan pemeriksaan visual mungkin lebih dapat diandalkan daripada model yang dioptimalkan untuk satu tes khusus.
Tabel resmi tersebut juga menunjukkan mengapa pengujian berdampingan itu penting. GPT-5.6 Sol memimpin di beberapa baris yang berfokus pada penalaran atau terminal, sementara Fable 5 tetap sangat kompetitif pada tugas-tugas kolaborasi, antarmuka, dan visual. Sebuah tabel terpisah Perbandingan GPT-5.6 vs Fable 5 dapat membantu Anda mengaitkan kelompok model tersebut dengan skenario penggunaan sehari-hari sebelum memasukkan Qwen3.8-Max ke dalam daftar pilihan.
Apa arti dari hasil multimodal tersebut
Qwen3.8-Max mencatatkan hasil resmi yang gemilang dalam bidang penalaran multimodal, pengaitan visual, penggunaan komputer, pengolahan dokumen, dan pemahaman spasial. Skor 86,1 yang diraihnya pada OSWorld-Verified sangat relevan bagi agen yang beroperasi melalui layar, karena penilaian ini mengukur kemampuan menyelesaikan tugas di dalam lingkungan desktop, bukan sekadar mendeskripsikan sebuah gambar.
Perbandingan Qwen3.8-Max
Tidak ada jawaban singkat yang tepat untuk pertanyaan, “Apakah Qwen3.8-Max lebih baik daripada GPT, Claude, atau Gemini?” Data Qwen sendiri menunjukkan bahwa pemimpin di setiap kategori berubah dari baris ke baris. Kesesuaian produk juga bergantung pada keandalan alat, kualitas hasil, latensi, ketersediaan regional, kontrol privasi, dan antarmuka yang mengelilingi model tersebut.
Qwen3.8-Max tampak paling menarik jika Anda menginginkan satu model yang dapat menangani pemrograman, dokumen, penelitian, tugas-tugas jangka panjang, dan agen visual. GPT-5.6 Sol mungkin masih menjadi pilihan yang lebih baik untuk beban kerja di mana kemampuan penalaran terbaiknya serta hasil akhir yang dihasilkan dapat diterapkan ke lingkungan Anda. Fable 5 layak untuk diteliti lebih lanjut untuk tugas-tugas kolaborasi dan yang banyak melibatkan antarmuka pengguna; Perbandingan Fable 5 vs Opus 4.8 memberikan penjelasan lebih lanjut mengenai bagian keputusan tersebut.
Bobot terbuka yang direncanakan untuk model ini berpotensi menjadi keunggulan struktural terbesarnya. Kinerja berbasis API saja memang penting saat ini, namun bobot yang dapat diunduh membuka peluang untuk penyempurnaan, infrastruktur pribadi, penelitian, dan penerapan di tingkat regional. Nilai akhirnya akan bergantung pada lisensi yang dirilis, format bobot, dukungan kuantisasi, serta perangkat keras yang diperlukan untuk menjalankan model tersebut dengan kecepatan yang memadai.
Qwen3.8-Max: Struktur Harga API
Qwen mencantumkan harga peluncuran berikut ini dalam pengumuman resmi:
Perkiraan sederhananya adalah:
biaya yang diperkirakan = masukan yang tidak disimpan dalam cache × $2/M + masukan yang disimpan dalam cache × $0,25/M + keluaran × $6/M
Sebagai contoh, sebuah eksekusi yang menggunakan 10 juta token masukan yang tidak disimpan dalam cache dan 2 juta token keluaran akan dikenakan biaya sekitar $32 berdasarkan tarif peluncuran sebelum dikenakan biaya dari platform lain: $20 untuk masukan ditambah $12 untuk keluaran. Seorang agen yang membaca ulang repositori besar pada setiap giliran dapat menghabiskan biaya jauh lebih besar, sehingga pengelolaan cache dan konteks menjadi sama pentingnya dengan harga masukan yang tercantum.
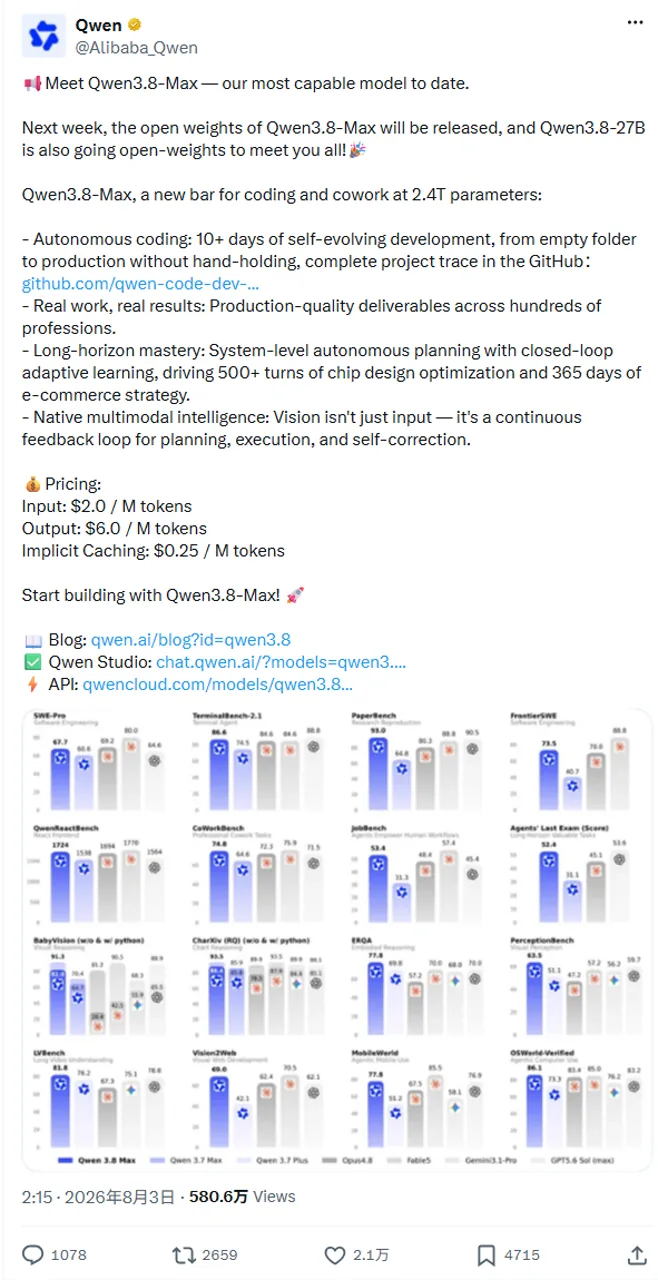
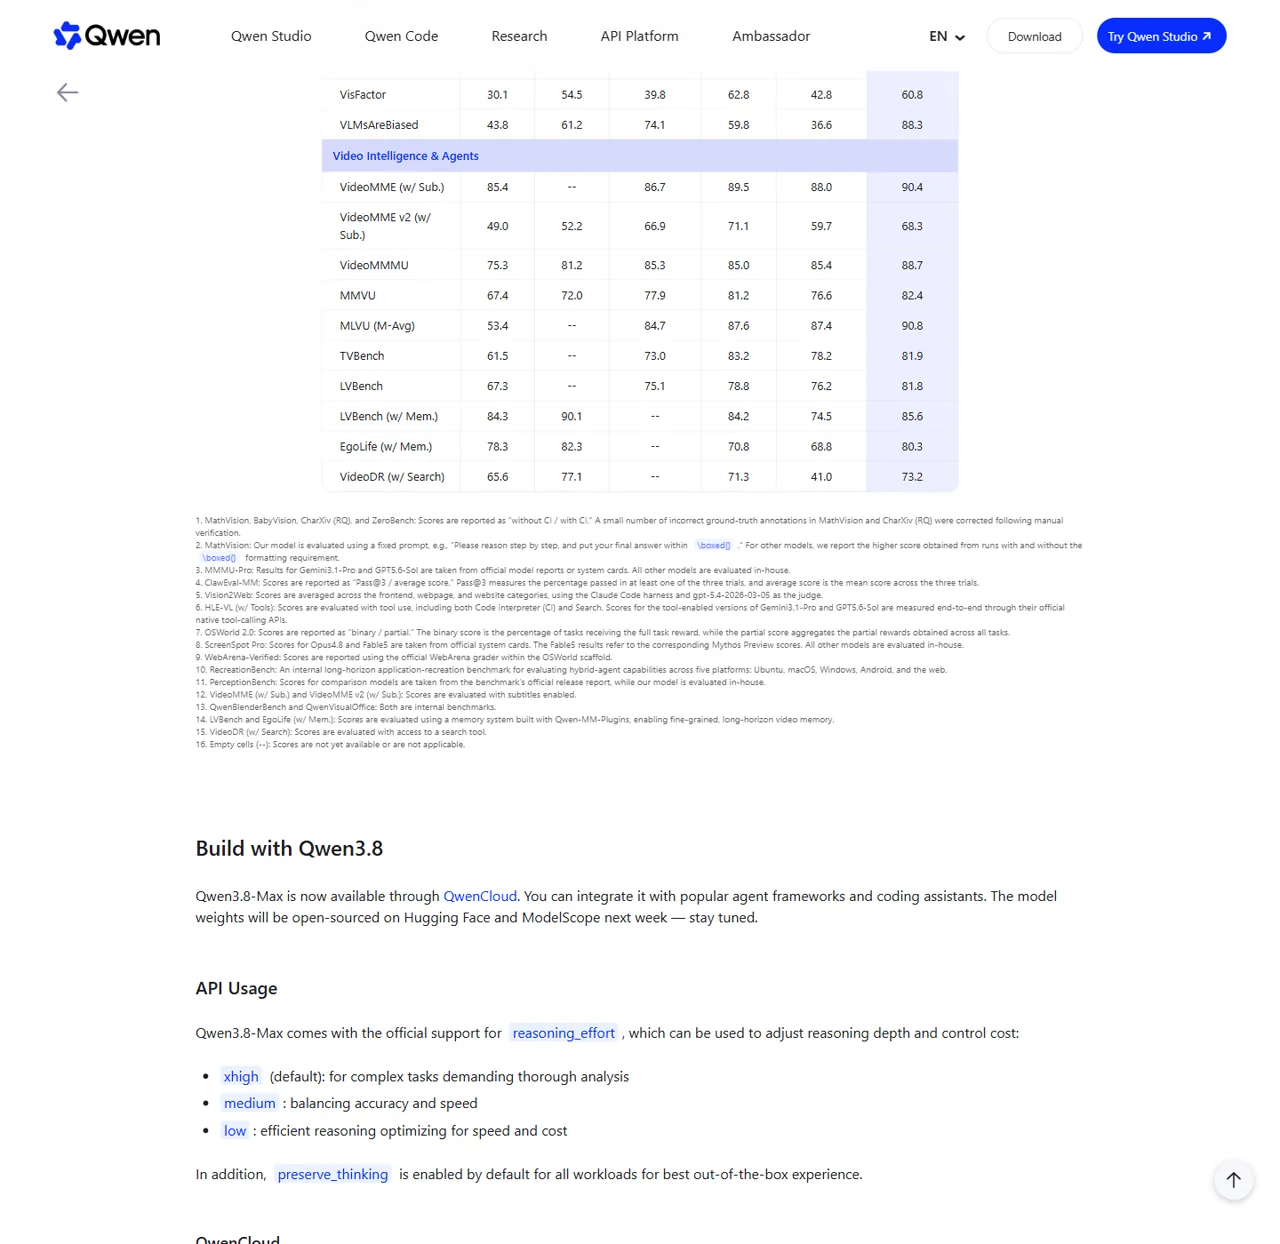
Qwen3.8-Max juga mendukung upaya penalaran kontrol. Bagian API resmi mencantumkan xtinggi sebagai pengaturan default untuk analisis kompleks, sedang untuk menyeimbangkan akurasi dan kecepatan, serta rendah agar pekerjaan dapat dilakukan dengan lebih cepat dan efisien. melestarikan_pemikiran diaktifkan secara default. Kontrol-kontrol ini dapat menekan biaya, tetapi sebaiknya diuji berdasarkan kualitas tugas, bukan dianggap sebagai mode yang dapat saling diganti.
Penetapan harga lintas penyedia juga perlu diperhatikan dengan hati-hati. Model dengan tarif token yang lebih rendah tetap bisa lebih mahal jika membutuhkan prompt yang lebih panjang, lebih banyak percobaan ulang, atau panggilan alat tambahan. The Panduan Harga Gemini 3.1 Pro API merupakan contoh yang bermanfaat mengenai mengapa panjang konteks dan tingkatan penggunaan juga penting selain tingkat dasar.
Cara Mengakses Qwen3.8-Max
1. Gunakan Qwen Studio untuk evaluasi langsung
Rute tercepat untuk melihatnya pertama kali adalah Qwen Studio. Mulailah dengan tugas nyata, bukan sekadar pertanyaan sepele: berikan arahan yang rumit, masalah pemrograman yang melibatkan banyak berkas, kumpulan dokumen, atau alur kerja berbasis gambar. Periksa apakah hasilnya akurat, dapat diedit, dan cukup lengkap untuk menghemat waktu.
2. Gunakan API QwenCloud untuk aplikasi
Qwen3.8-Max tersedia melalui QwenCloud. Halaman pengumuman tersebut menyebutkan bahwa API-nya mendukung protokol pelengkapan obrolan dan respons sesuai standar industri yang kompatibel dengan spesifikasi OpenAI, serta antarmuka yang kompatibel dengan Anthropic. Hal ini memudahkan proses migrasi, namun Anda tetap disarankan untuk memeriksa nama model, parameter, perilaku streaming, skema alat, dan penanganan kesalahan dalam dokumentasi resmi.
3. Hubungkan dengan alat pemrograman dan alat agen
Halaman rilis Qwen mencakup integrasi untuk Qwen Code, Claude Code, Codex, dan OpenClaw. Dengan demikian, model ini dapat diintegrasikan ke dalam alur kerja terminal atau agen yang sudah ada tanpa perlu membuat antarmuka baru. Dukungan integrasi tidak menghilangkan biaya alat yang terkait, jadi bandingkan tagihan model ini dengan tagihan terpisah Struktur harga Codex sebelum menstandarkan alur kerja tim.
Pengguna Kode Claude juga harus memisahkan biaya produk pemrograman dari API model eksternal. Paket-paket yang tersedia dan jalur penagihan dirangkum dalam Panduan Penetapan Harga Kode Claude.
Pengguna OpenClaw memiliki pertanyaan tambahan: model mana yang menawarkan kombinasi terbaik antara penggunaan alat, kecepatan, dan harga untuk agen tertentu. Yang Perbandingan model OpenClaw menyediakan kerangka kerja praktis untuk membuat pilihan tersebut, alih-alih secara otomatis memilih model terbesar.
4. Pastikan alur kerja multi-model tetap akurat
Pada saat peluncuran, QwenCloud merupakan jalur produksi yang telah terverifikasi untuk Qwen3.8-Max. Jika Anda juga membandingkan alternatif seperti GPT, Claude, Gemini, atau Fable, maka Ruang kerja multi-model GlobalGPT dapat mengurangi kebutuhan berpindah tab di antara model-model yang didukungnya. Gunakan rute resmi Qwen untuk Qwen3.8-Max sampai halaman model khusus GlobalGPT telah diverifikasi; jangan berasumsi bahwa URL model baru sudah ada hanya karena model tersebut telah diumumkan.
Qwen3.8—Batas Maksimum Beban Terbuka
Qwen mengumumkan bahwa bobot Qwen3.8-Max akan dirilis pada minggu setelah peluncuran tanggal 3 Agustus. Hal yang sama postingan resmi di X Juga disebutkan bahwa Qwen3.8-27B akan menjadi kategori open-weight. Ini merupakan kabar baik bagi penerapan dan penelitian di tingkat lokal, namun pengumuman itu saja belum cukup untuk merencanakan sebuah klaster produksi.
Sebelum mengunduh atau menyusun anggaran untuk perangkat keras, pastikan lima hal berikut dari kartu model akhir:
- Ketentuan lisensi dan penggunaan komersial yang tepat.
- URL repositori resmi Hugging Face atau ModelScope.
- Format presisi dan kuantisasi yang tersedia.
- Persyaratan minimum dan yang direkomendasikan untuk CPU, GPU, RAM, dan penyimpanan.
- Apakah model yang telah dirilis sesuai dengan perilaku API yang dihosting dan panjang konteksnya.
“Open weight” dan “open source” tidak selalu sama. Istilah “open weight” menunjukkan bahwa parameter model dapat diunduh; sedangkan lisensi menentukan apa saja yang boleh Anda modifikasi, distribusikan ulang, atau gunakan secara komersial. Selama repositori dan lisensinya belum tersedia, halaman-halaman yang menjanjikan unduhan Qwen3.8-Max, build GGUF, atau persyaratan perangkat keras lokal yang tepat masih terlalu terburu-buru.
Pengumuman model 27B sebaiknya ditangani dengan cara yang sama. Meskipun model ini mungkin menjadi pilihan yang lebih realistis bagi pengguna lokal, arsitektur, panjang konteks, kebutuhan memori, dan skor benchmark-nya harus diambil dari kartu spesifikasi resmi model tersebut—bukan disalin dari model Max.
Qwen3.8—Batasan Maksimum dan Kesesuaian Terbaik
Hal-hal yang perlu diperhatikan
- Sebagian besar bukti peluncuran berasal dari Qwen. Evaluasi independen mungkin menggunakan petunjuk, alat, atau aturan penilaian yang berbeda-beda.
- Konteks yang panjang bukanlah ingatan yang sempurna. Sebuah model dapat memproses 1 juta token, namun tetap saja bisa melewatkan suatu detail atau mengikuti instruksi yang kurang jelas.
- Agen yang menghasilkan banyak output bisa menjadi mahal. Tingkat keluaran $6 per juta menjadi penting ketika alur kerja menghasilkan kode yang panjang, laporan, atau jejak penalaran yang berulang.
- Rincian penerapan lokal belum lengkap sampai bobot dan kartu model tiba. Sistem dengan total parameter 2,4T tidak akan berperilaku seperti model desktop berukuran kecil.
- Penggunaan alat menambah satu lapisan kegagalan lagi. Status peramban, izin, kesalahan jaringan, dan skema alat yang tidak didefinisikan dengan baik dapat membuat model yang sebenarnya mumpuni menjadi tidak berfungsi.
- Informasi peluncuran berubah dengan cepat. Harga, repositori, integrasi, dan ketersediaan sebaiknya diperiksa kembali sebelum dipublikasikan atau dilakukan pengadaan.
Siapa yang sebaiknya mencobanya sekarang?
Intinya sederhana: Qwen3.8-Max memang layak diuji secara serius, tetapi tidak boleh dilakukan migrasi secara membabi buta. Gunakan satu tugas yang menantang dengan kriteria keberhasilan yang jelas, catat jumlah total token dan upaya ulang, lalu bandingkan hasil akhir—bukan hanya jawaban pertama.
Pertanyaan yang Sering Diajukan
Kapan Qwen 3.8 Max dirilis?
Qwen3.8-Max secara resmi diumumkan pada tanggal 3 Agustus 2026. Model yang dihosting ini tersedia melalui Qwen Studio dan QwenCloud sejak peluncuran. Qwen menyatakan bahwa bobot terbuka akan dirilis pada minggu berikutnya, sehingga ketersediaan API dan ketersediaan bobot yang dapat diunduh harus dianggap sebagai tonggak pencapaian yang terpisah.
Apakah Qwen3.8-Max bersifat open source?
Qwen telah mengumumkan rilis open-weight untuk Qwen3.8-Max, namun repositori dan lisensi final lah yang menentukan apa saja yang boleh dijalankan, dimodifikasi, didistribusikan ulang, atau digunakan secara komersial oleh pengguna. Sampai berkas-berkas tersebut tersedia secara online dan terverifikasi, pernyataan “rilis open-weight telah diumumkan” lebih akurat daripada mengasumsikan bahwa setiap izin open-source atau format lokal sudah tersedia.
Berapa banyak parameter yang dimiliki oleh Qwen3.8-Max?
Qwen3.8-Max memiliki total 2,4 triliun parameter dan mengaktifkan 95 miliar parameter per token. Model ini menggunakan arsitektur “mixture-of-experts”, sehingga jumlah parameter total dan jumlah parameter aktif menggambarkan bagian-bagian yang berbeda dari sistem. Tidak ada satu pun angka tersebut yang secara sendiri-sendiri dapat memprediksi kecepatan di dunia nyata atau kebutuhan perangkat keras.
Apa itu jendela konteks Qwen3.8-Max?
Rilis resmi menyebutkan jendela konteks sebesar 1 juta token. Ukuran tersebut cukup besar untuk menampung kode yang luas, dokumen, hasil keluaran alat, dan riwayat agen, namun ukuran konteks maksimum tidak menjamin hasil pencarian yang sempurna. Uji model tersebut berdasarkan posisi, format, dan kepadatan informasi yang digunakan dalam alur kerja Anda yang sebenarnya.
Berapa harga API Qwen3.8-Max?
Pada saat peluncuran, Qwen menetapkan tarif sebesar $2 per juta token masukan, $6 per juta token keluaran, dan $0,25 per juta token yang disimpan dalam cache secara implisit. Anggaplah angka-angka ini sebagai harga peluncuran dan verifikasilah sebelum menyusun anggaran. Biaya agen juga bergantung pada penggunaan kembali konteks, upaya penalaran, upaya ulang, dan panjang keluaran yang dihasilkan.
Apakah Qwen3.8-Max lebih baik daripada GPT-5.6 Sol atau Fable 5?
Tidak pada setiap pengujian. Tabel resmi Qwen menunjukkan bahwa Qwen3.8-Max memimpin dalam beberapa tolok ukur pemrograman, pencarian, mengikuti instruksi, dan penggunaan komputer, sementara GPT-5.6 Sol atau Fable 5 memimpin dalam tolok ukur lainnya. Model mana yang lebih baik bergantung pada tugas, lingkungan alat, latensi, harga, dan kualitas hasil akhir.
Apakah saya bisa menjalankan Qwen3.8-Max secara lokal?
Qwen telah mengumumkan ketersediaan bobot model yang dapat diunduh untuk minggu setelah peluncuran, namun kelayakan implementasi di tingkat lokal bergantung pada berkas akhir, tingkat presisi, dukungan kuantisasi, lisensi, dan panduan perangkat keras. Tunggu hingga kartu model resmi dirilis sebelum mempercayai perkiraan tepat mengenai RAM, VRAM, atau penyimpanan. Varian Qwen3.8 yang lebih kecil mungkin akan lebih praktis setelah didokumentasikan secara resmi.
Apa itu Qwen3.8-27B?
Postingan peluncuran Qwen menyebutkan bahwa Qwen3.8-27B juga akan dirilis dengan bobot terbuka. Artikel peluncuran Max tidak memberikan detail yang cukup untuk menggunakan kembali spesifikasi model Max pada versi 27B. Silakan periksa kartu model khusus untuk mengetahui arsitektur, jendela konteks, hasil pengujian kinerja, lisensi, dan petunjuk pengunduhan.
Apakah saya bisa menggunakan Qwen3.8-Max pada GlobalGPT?
Rute GlobalGPT khusus untuk Qwen3.8-Max belum diverifikasi pada saat publikasi. Gunakan Qwen Studio atau QwenCloud untuk akses langsung. GlobalGPT tetap berguna untuk membandingkan model GPT, Claude, Gemini, dan Fable lainnya yang tersedia tanpa perlu berpindah platform.
Keputusan Akhir
Gunakan Qwen Studio atau QwenCloud untuk evaluasi langsung Qwen3.8-Max. Gunakan GlobalGPT untuk membandingkan model-model terverifikasi lainnya tanpa menyiratkan bahwa rute khusus Qwen3.8-Max sudah ada.
Bandingkan model-model yang tersediaQwen 3.8 Max merupakan salah satu peluncuran model paling ambisius pada tahun 2026: total 2,4 triliun parameter, 95 miliar parameter aktif, jendela konteks sebesar 1 juta token, hasil resmi yang impresif dalam bidang pemrograman dan agen multimodal, serta rencana pengembangan dengan bobot terbuka yang telah diumumkan. Harga API peluncurannya cukup kompetitif untuk dicoba, terutama karena penggunaan cache dapat mengurangi biaya konteks berulang.
Alasan terkuat untuk memperhatikannya bukanlah sekadar kemenangan dalam satu uji perbandingan. Melainkan upaya untuk menggabungkan pemrograman, hasil kerja profesional, perencanaan jangka panjang, umpan balik visual, dan penggunaan alat dalam satu model. Mulailah dengan Qwen Studio atau evaluasi QwenCloud yang terkendali, ukur kualitas tugas yang telah diselesaikan dan total biayanya, lalu tunggu bobot resmi dan lisensi sebelum membuat janji terkait penerapan lokal.
Sumber primer yang diperiksa pada tanggal 4 Agustus 2026: Qwen3.8-Max, Rilis Resmi dan Postingan resmi peluncuran @Alibaba_Qwen.