Satu model saja sudah cukup untuk membangun keseluruhan suasana suara.
Seed Audio 1.0 mampu menggabungkan suara manusia, efek suara (Foley), suara latar, sinkronisasi waktu, dan musik instrumental. Hasil pengujian kami menunjukkan potensi kreatif yang luar biasa tinggi—serta masalah konsistensi yang tidak boleh Anda abaikan.
Seed Audio 1.0 adalah salah satu model audio pertama yang pernah saya uji yang terasa dirancang berdasarkan sebuah adegan utuh, bukan sekadar satu jenis output. Model ini mampu berbicara, berakting, menambahkan efek suara latar, membuat efek suara Foley, menempatkan dialog pada garis waktu, dan menghasilkan musik instrumental hanya dari satu perintah.
Kesimpulan singkatnya: Seed Audio 1.0 memiliki potensi yang luar biasa besar dalam pembuatan audio terpadu, terutama untuk dialog yang disinkronkan dengan waktu dan adegan suara sinematik. Kelemahannya terletak pada konsistensi hasilnya. Hasil yang bagus bisa terdengar sangat lengkap, sementara hasil lain dari prompt yang sama mungkin menyertakan ucapan yang tidak jelas, melewatkan satu peristiwa, atau mengubah suara yang diminta.
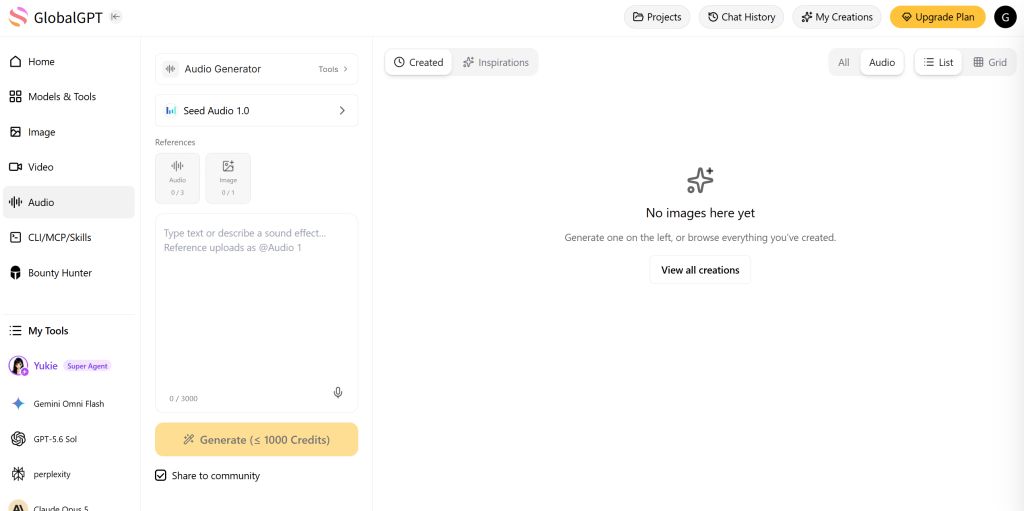
Saya menghasilkan 23 sampel yang telah diberi skor melalui lingkungan pengujian Anywhere/BrolyAI. Secara keseluruhan, sampel-sampel tersebut mencakup narasi, dialog dua karakter, ucapan dengan cap waktu, urutan yang hanya berisi efek suara (SFX), adegan suara ditambah musik, musik mandiri, penampilan multibahasa, monolog berdurasi dua menit, serta kelanjutan audio referensi.
Ulasan Seed Audio 1.0: kesimpulan singkat
| Kategori | Hasil dari pengujian kami |
|---|---|
| Suara yang ekspresif | Kualitasnya sangat baik pada putaran terbaik, namun tidak konsisten pada putaran-putaran berikutnya |
| Dialog antar-penutur | Skrip yang akurat dan pemisahan suara pembicara yang jelas |
| Waktu dialog | Fitur yang paling andal dalam rangkaian pengujian kami |
| Efek suara | Urutan peristiwa dan ruang yang realistis; kurang akurat dalam menghitung jumlah peristiwa secara tepat |
| Suara + Efek Suara + Musik | Adegan-adegan yang meyakinkan dan utuh ketika setiap peristiwa yang diharapkan terjadi |
| Musik mandiri | Lebih mumpuni dari yang diperkirakan; menghasilkan petunjuk terstruktur berdurasi 30 detik |
| Suara multibahasa | Skenario terbaik yang luar biasa, tetapi pada salah satu dari dua putaran tersebut terdengar ucapan tambahan yang tidak nyata |
| Rekaman audio berdurasi dua menit | Identitas suara yang kuat dan koherensi naratif yang konsisten di kedua putaran |
| Audio referensi | Hasilnya tidak dapat diandalkan di lokasi pengujian kami; tingkat kesamaan suaranya rendah |
Terbaik untuk: para kreator yang membuat drama radio, adegan game, konsep podcast, prototipe sinematik, dan storyboard berbasis audio.
Kurang cocok untuk: pekerjaan yang membutuhkan formulasi yang deterministik, penghitungan kejadian berulang yang tepat, atau kloning suara yang andal dari satu proses pembangkitan tanpa pengawasan.
Apa itu Seed Audio 1.0?
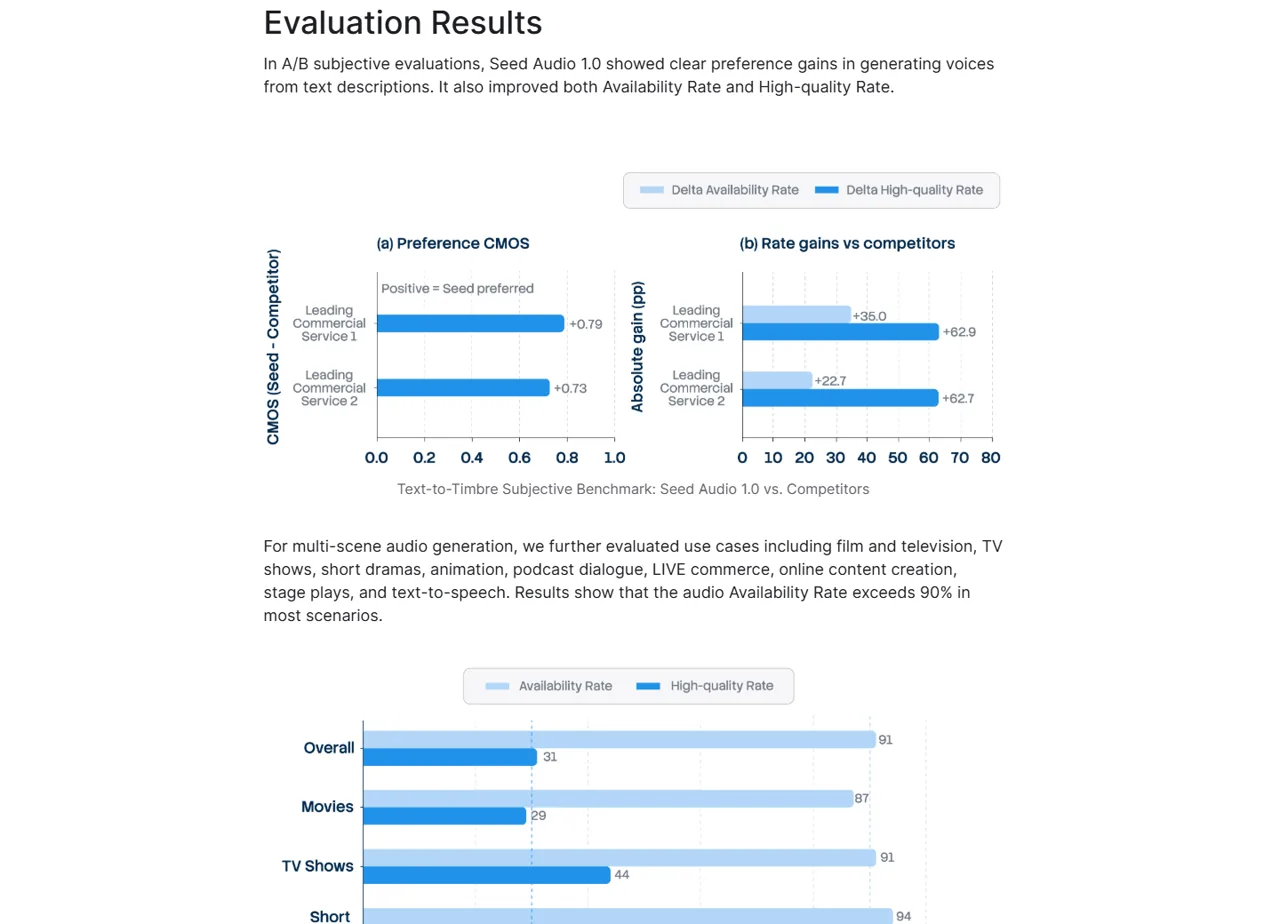
Seed Audio 1.0 adalah model terpadu untuk pembuatan teks-ke-audio dari ByteDance Seed. Alih-alih memperlakukan ucapan, suara latar, efek, dan musik sebagai tugas terpisah, model ini mampu menghasilkan semuanya secara bersamaan sebagai satu adegan suara. Halaman produk resminya menyebutkan bahwa model ini mendukung sinkronisasi dialog dengan interval 100 milidetik dan dapat menghasilkan audio hingga dua menit dalam satu kali proses.
Desain yang terpadu itulah daya tarik sesungguhnya. Sebuah prompt dapat menggambarkan siapa yang berbicara, bagaimana suaranya, apa yang terjadi di dalam ruangan, efek apa saja yang muncul kemudian, dan jenis musik apa yang mengiringi adegan tersebut. Jika dijalankan dengan baik, hasilnya terdengar seperti karya yang dirancang secara utuh, bukan sekadar disatukan secara terpisah.
Ada batasan penting di sini. Peta jalan ByteDance sendiri menyebutkan bahwa sinkronisasi yang sangat detail saat ini terutama difokuskan pada dialog karakter. Kontrol yang lebih presisi terhadap efek suara, suara latar, dan musik masih menjadi bidang yang perlu dikembangkan lebih lanjut. Pengujian yang kami lakukan sejalan dengan perbedaan tersebut: sinkronisasi dialognya sangat baik, sementara ketepatan hitungan efek suara (Foley) kurang dapat diandalkan.
Sumber resmi yang diverifikasi pada tanggal 6 Agustus 2026:
- Halaman produk Seed Audio 1.0
- Pengantar ByteDance Seed
- Dokumentasi API BytePlus Audio 1.0
- Harga BytePlus Audio 1.0
Bagaimana kami menguji Seed Audio 1.0
Kami merancang sembilan tugas dan menjalankan 23 generasi yang dinilai. Sebagian besar uji kemampuan dilakukan dengan dua atau tiga kali pengulangan, karena satu sampel yang telah disempurnakan tidak memberikan gambaran yang memadai mengenai keandalan produksi.
| Uji | Tugas | Lari |
|---|---|---|
| T01 | Narasi bahasa Inggris yang ekspresif | 3 |
| T02 | Dialog radio yang terdiri dari dua karakter | 3 |
| T03 | Dialog pada detik ke-0, ke-4, dan ke-9 | 3 |
| T04 | Adegan di lorong yang hanya menampilkan efek suara | 2 |
| T05 | Suara, suara latar, efek suara, dan musik | 3 |
| T06 | Musik instrumental mandiri | 3 |
| T07 | Satu karakter yang sama dalam bahasa Inggris, Jepang, dan Jerman | 2 |
| T08 | Monolog podcast berdurasi 120 detik | 2 |
| T09 | Lanjutan dari suara referensi | 2 |
Ke-23 hasil yang direncanakan berisi sekitar 12,5 menit audio yang dihasilkan dan mencatat biaya generasi hulu sebesar $1.7504 melalui lingkungan pengujian. Seed Audio tidak melaporkan penggunaan token teks. Penagihan didasarkan pada detik yang dihasilkan, sehingga token generasi dicatat sebagai tidak berlaku.
Semua hasil yang dinilai berupa berkas WAV PCM stereo 40 kHz, 16-bit. Apabila pemutaran otomatis langsung tidak tersedia, Gemini 3.6 Flash menerima berkas WAV tersebut sebagai masukan audio dan menghasilkan transkrip terstruktur, pemeriksaan peristiwa, perkiraan waktu, serta catatan artefak. Penilaian tersebut merupakan evaluasi pendengaran otomatis, bukan skor MOS yang diberikan oleh manusia.
Pembangkitan suara: nada tinggi yang mengesankan, konsistensi yang tidak merata
T01 · Narasi yang ekspresif
Varians tinggiSatu kalimat terdengar seperti ucapan yang dihalusinasi, satu lagi terdengar kaku, dan satu lagi terdengar alami dan lengkap.
Prompt yang digunakan
Seorang narator wanita dengan nada tenang mengucapkan dua kalimat yang persis sama, dengan nada yang berubah dari rasa khawatir menjadi keyakinan. Tanpa musik atau efek suara.Petunjuk narasi meminta seorang narator wanita yang bersuara tenang untuk mengucapkan dua kalimat persis seperti yang tertera, dengan transisi dari rasa prihatin yang terkendali menuju rasa percaya diri yang semakin meningkat, tanpa suara latar.
Ketiga eksekusi tersebut menunjukkan perilaku yang sangat berbeda:
- Putaran 1: mengucapkan kalimat yang diminta, lalu melanjutkan dengan pidato yang tidak jelas dan tidak terstruktur selama beberapa detik.
- Putaran ke-2: mengucapkan teks persis seperti itu, tetapi terdengar lambat dan terputus-putus.
- Lari ke-3: membacakan naskah secara utuh dengan alami, disertai pengaturan tempo yang tepat dan konsistensi suara yang optimal.
Inilah inti dari ulasan ini. Seed Audio 1.0 mampu menghasilkan kualitas suara yang baik, namun satu kali proses saja tidak cukup untuk pekerjaan yang menuntut ketelitian dalam pemilihan kata. Buatlah alternatif-alternatif dan dengarkan seluruh hasilnya sebelum dipublikasikan.
Model tersebut memang mematuhi instruksi larangan dalam ketiga sesi narasi: tidak ada musik, tidak ada efek suara, dan tidak terdeteksi adanya suara latar yang tidak diinginkan.
Dialog yang melibatkan banyak karakter dan pemisahan pembicara
T02 · Drama radio dua tokoh
3/3 naskah persisKetiga naskah tersebut sama persis. Suara latar ruangan dan durasi pengantar bervariasi di setiap pengambilan gambar.
Prompt yang digunakan
Maya berbisik, Eli menjawab dengan tenang, dan suara dengungan kulkas terdengar di sela-sela tiga giliran dialog yang berulang.Adegan di minimarket kami menampilkan dua karakter dewasa dan tiga dialog tetap. Maya harus berbisik dengan nada tegang, sementara Eli berusaha terdengar tenang. Satu-satunya suara latar yang diminta hanyalah dengungan lemari es yang samar.
Ketiga rekaman tersebut menyajikan dialog dalam urutan yang benar dengan dua suara yang berbeda. Rekaman terbaik menggabungkan dialog yang tepat, pemisahan suara yang jelas, emosi yang meyakinkan, serta dengungan kulkas yang terus-menerus.
Pengujian lainnya menunjukkan masalah yang lebih kecil pada tingkat adegan. Salah satunya menghabiskan sekitar separuh dari durasi 30 detiknya untuk suara latar sebelum memulai dialog. Yang lainnya mengabaikan suara dengungan kulkas yang diminta. Kedua kesalahan tersebut tidak merusak adegan dialog, tetapi keduanya mengurangi efisiensi penyuntingan.
Untuk drama audio, hasil praktisnya cukup menggembirakan: Seed Audio mampu menangkap perubahan karakter dan kontras vokal. Anda mungkin masih perlu memotong bagian pembuka yang terlalu panjang atau melakukan regenerasi untuk mendapatkan nuansa ruangan yang tepat.
Waktu dialog menjadi hasil yang paling menonjol
T03 · Pengaturan waktu pada tingkat prompt
Yang paling dapat diandalkanKetiga uji coba tersebut menempatkan garis-garis tersebut di dekat titik-titik yang diminta, masih dalam batas ketidakpastian waktu evaluator.
Prompt yang digunakan
Tempatkan tiga garis radio pada 0,0, 4,0, dan 9,0 detik dengan narator pria/wanita/pria.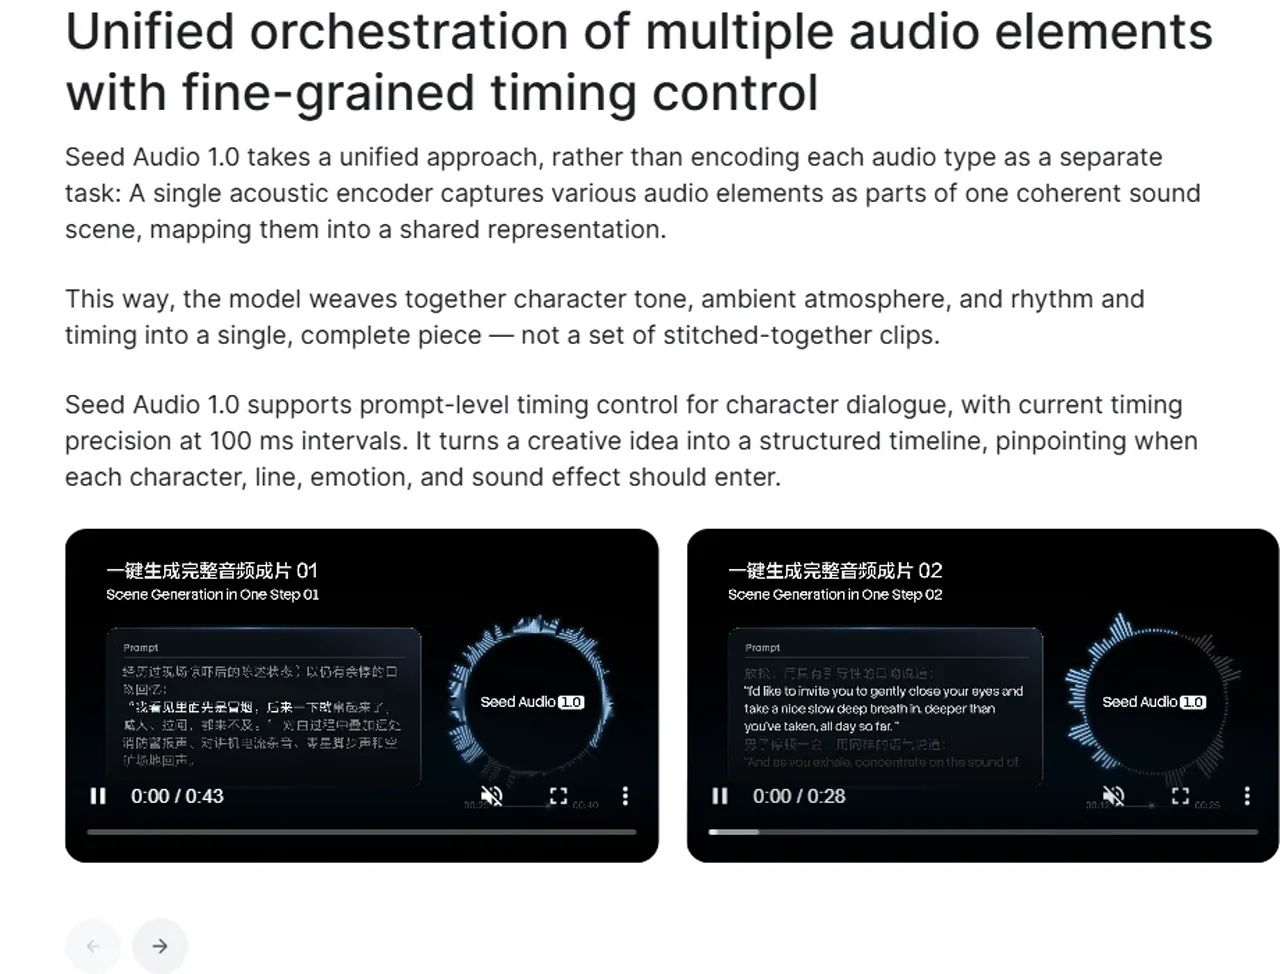
Uji waktu tersebut memerlukan tiga saluran radio:
- “Unit tujuh, lapor.” pada 0,0 detik.
- “Pintu masuk utara aman.” pada detik ke-4,0.
- “Pertahankan posisi.” pada detik ke-9,0.
Pada ketiga putaran tersebut, urutan kalimat, urutan, dan pola pembicara laki-laki-perempuan-laki-laki semuanya benar. Perkiraan audio dari Gemini menempatkan awal putaran yang diulang sekitar 0,1, 4,0, dan 9,0 detik. Uji coba pertama diperkirakan terjadi pada sekitar 0,1, 3,9, dan 8,9 detik.
Pengukuran-pengukuran tersebut tidak boleh disajikan sebagai bukti tingkat laboratorium dengan presisi 100 milidetik—penilai itu sendiri menyebutkan ketidakpastian sekitar 0,1 detik. Meskipun demikian, ini adalah kemampuan yang paling dapat diulang yang kami uji. Jika Anda membutuhkan dialog untuk dimasukkan di dekat posisi yang direncanakan dalam garis waktu, Seed Audio 1.0 sangat menjanjikan.
Pembuatan efek suara: adegan yang realistis, penghitungan yang tidak sempurna
T04 · Lorong (hanya efek suara)
Gagal menghitungRuang dan susunannya memang meyakinkan, tetapi pada dua putaran tersebut terdengar empat langkah kaki dan dua langkah kaki.
Prompt yang digunakan
Kunci, sebuah pintu yang berat, tepat tiga langkah kaki, gemuruh, dan bunyi benturan terakhir. Tak ada suara maupun musik.Prompt yang hanya berisi efek suara (SFX) tersebut menggambarkan sebuah lorong kecil berubin: kunci-kunci di dekat mikrofon, pintu kayu yang berat terbuka, tiga langkah kaki yang lambat menjauh, gemuruh petir dari kejauhan, dan bunyi pintu yang dibanting sebagai penutup. Dialog dan musik dilarang.
Kedua hasil tersebut berhasil menciptakan ruang akustik yang meyakinkan, mempertahankan urutan peristiwa, serta mencegah bocornya suara atau musik. Efek-efek tersebut dinilai realistis, dengan kesan jarak yang baik dan konsistensi ruang yang memadai.
Kedua rekaman tersebut tidak mengikuti jumlah langkah yang tepat. Yang satu menghasilkan empat langkah kaki; yang lain menghasilkan dua. Hal ini menjadikan Seed Audio berguna untuk menghasilkan konsep Foley yang meyakinkan, namun kurang dapat diandalkan ketika seorang editor membutuhkan tepat tiga bunyi benturan, ketukan, langkah kaki, atau tembakan.
Alur kerja terbaik adalah menggunakan pembangkitan efek suara (SFX) satu tahap untuk menciptakan suasana dan pembuatan prototipe cepat, kemudian mengganti atau mengedit adegan-adegan yang sangat bergantung pada hitungan dalam DAW.
Suara, suara latar, efek suara, dan musik dalam satu adegan
T05 · Campuran sinematik lengkap
2/3 sudah selesaiDua dari tiga putaran berhasil menyelesaikan setiap gerakan. Satu putaran gagal melakukan pukulan terakhir yang menghasilkan bunyi benturan logam.
Prompt yang digunakan
Gang yang basah oleh hujan, lalu lintas, suara sirene, bisikan seorang detektif, dentuman senar, langkah kaki yang cepat, dan bunyi benturan logam.
Uji adegan lengkap itu sengaja dibuat penuh dengan unsur-unsur. Adegan tersebut menampilkan gang yang basah di malam hari, tetesan air, lalu lintas, sirene polisi yang berbunyi, dialog detektif yang diucapkan dengan bisikan, alunan biola yang terkendali, langkah kaki yang cepat, dan bunyi pintu logam yang dibanting.
Dua dari tiga pengulangan mencakup urutan adegan secara lengkap. Dialog tetap terdengar jelas di atas suara latar dan musik, dan adegan tersebut terasa utuh secara spasial, bukan sekadar potongan-potongan yang tidak berhubungan yang disatukan. Satu pengulangan tidak menampilkan bunyi benturan logam di bagian akhir, meskipun secara keseluruhan berhasil menciptakan suasana yang tepat dan mengucapkan dialognya dengan akurat.
Di sinilah model terpadu menunjukkan keunggulannya yang paling menonjol. Untuk pembuatan storyboard dan pengembangan ide kreatif, menghasilkan sebuah adegan campuran secara utuh dari satu prompt jauh lebih cepat dan lebih ekspresif daripada mengumpulkan setiap komponennya satu per satu. Untuk tahap produksi akhir, petunjuk akhir yang penting tetap perlu diverifikasi.
Apakah Seed Audio 1.0 bisa menghasilkan musik?
T06 · Musik mandiri
Karya musikKetiganya menciptakan musik yang terstruktur. Salah satunya membuat suara piano yang dibisukan sulit dibedakan.
Prompt yang digunakan
Sebuah musik latar tegang berkecepatan 72 BPM dengan ostinato cello, piano yang dibisukan, drone analog, bagian yang semakin memuncak, dan akhir yang belum tuntas.
Ya. Dalam pengujian kami, Seed Audio 1.0 menghasilkan musik instrumental mandiri yang dapat dikenali, bukan sekadar tekstur ambient yang samar-samar.
Petunjuknya meminta sebuah cuplikan musik penuh ketegangan berdurasi 30 detik pada 72 BPM dengan ostinato selo bernada rendah, denyut piano yang diredam, dengungan analog yang lembut, pengembangan yang jelas, dan akor akhir yang tidak terselesaikan. Ketiga versi tersebut membentuk cuplikan musik yang koheren dengan nuansa tempo dan akhiran yang diminta. Dua di antaranya mencakup semua elemen yang diminta; pada salah satu rekaman, suara piano yang diredam sulit dibedakan.
Hal ini tidak secara otomatis menjadikan Seed Audio sebagai pengganti generator lagu khusus. Tugas kami adalah membuat cuplikan musik instrumental sinematik yang singkat, bukan lagu dengan bait dan reff yang dilengkapi lirik. Meski demikian, kemampuan musiknya cukup mumpuni untuk mendukung adegan game, trailer, podcast, dan previsualisasi—terutama ketika musik harus berinteraksi dengan dialog dan desain suara dalam proses pembuatan yang sama.
Kinerja multibahasa: sangat baik pada skenario terbaik, lemah pada skenario terburuk
T07 · Satu suara, tiga bahasa
1/2 bersihSatu kali percobaan berjalan tanpa cela; yang lainnya mengalami pengulangan dan ucapan yang tidak jelas saat terjadi peralihan bahasa.
Prompt yang digunakan
Seorang tokoh perempuan berbicara dalam bahasa Inggris, Jepang, dan Jerman dengan identitas yang sama dan ekspresi yang tenang.
Tugas multibahasa tersebut meminta seorang karakter perempuan untuk memerankan peran yang sama di ruang rekaman dalam bahasa Inggris, Jepang, dan Jerman. Dua kali pengambilan rekaman menghasilkan kesan yang bertolak belakang.
Hasil yang lebih baik berhasil menyampaikan ketiga kalimat tersebut secara akurat, mempertahankan gaya bicara yang sama, menjaga emosi yang tenang, dan menggunakan jeda yang tepat. Hasil yang lebih lemah memang dimulai dengan benar dalam bahasa Inggris, namun kemudian mengulang dan mengalami gangguan pada bagian bahasa Jepang serta merusak bagian pembuka dalam bahasa Jerman. Konsistensi gaya bicara lintas bahasa yang dirasakan pun menurun drastis.
Artinya, Seed Audio 1.0 mampu menghasilkan penampilan karakter multibahasa yang meyakinkan, namun fitur ini memerlukan beberapa kandidat dan proses peninjauan yang mempertimbangkan aspek bahasa. Jangan menyetujui hasil keluaran multibahasa hanya dengan memeriksa bahasa pertama saja.
Pembuatan dalam dua menit dan stabilitas rekaman suara berdurasi panjang
T08 · Monolog berdurasi 120 detik
2/2 stabilKedua rekaman tersebut berdurasi 120 detik dengan suara yang stabil. Salah satunya mengalami sedikit kesalahan pengucapan.
Prompt yang digunakan
Seorang pembawa acara podcast pria menceritakan kisah tentang stasiun cuaca yang terstruktur, yang mencakup tiga penemuan dan tanpa latar belakang.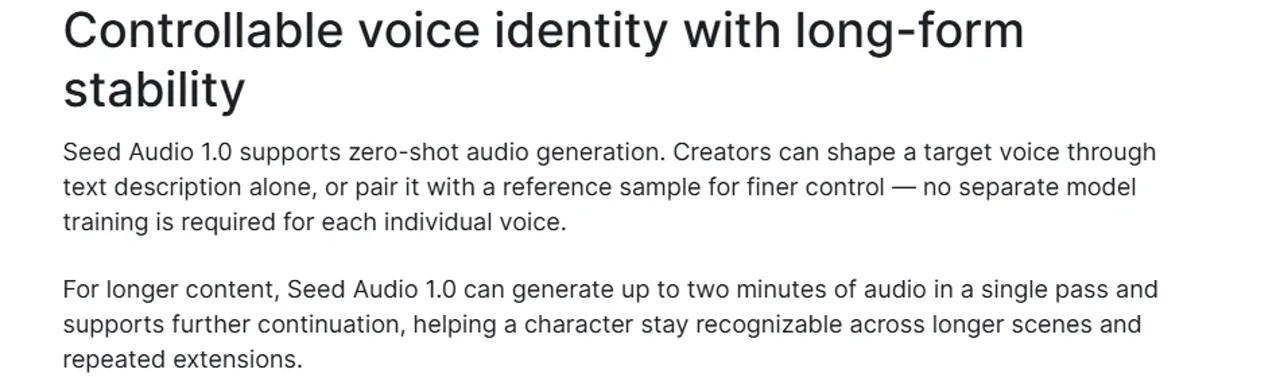
Kedua tugas berdurasi panjang tersebut menghasilkan berkas WAV berdurasi tepat 120 detik. Masing-masing menggunakan suara seorang pembawa acara podcast pria dengan kualitas suara studio yang polos, tanpa musik, dan tanpa efek suara.
Pembacaan pertama mempertahankan satu sudut pandang dan struktur investigasi yang koheren sepanjang teks: pembukaan yang jelas, tiga penemuan yang disajikan secara kronologis, peralihan dari rasa ingin tahu ke rasa gelisah, serta pertanyaan akhir yang belum terjawab. Tidak terdeteksi adanya penyimpangan sudut pandang yang jelas atau bagian yang tidak jelas.
Penyampaian kedua juga sama-sama koheren dan stabil, dengan satu kesalahan pengucapan singkat sekitar menit 1:31. Ini merupakan hasil yang memuaskan untuk monolog berdurasi dua menit yang direkam dalam satu kali pengambilan. Hal ini menunjukkan bahwa klaim Seed Audio mengenai format panjang bukan sekadar batasan durasi; model ini mampu mempertahankan identitas dan struktur naratif sepanjang durasi rekaman.
Keterkaitan audio referensi perlu diperhatikan dengan hati-hati
T09 · Lanjutan referensi
Rute belum pastiTeksnya persis sama, tetapi tingkat kemiripan suaranya rendah; salah satu hasil keluaran berubah menjadi suara laki-laki dan ditambahkan efek suara (Foley).
Prompt yang digunakan
Melanjutkan dari narasumber perempuan yang telah ditunjuk, sambil tetap mempertahankan ciri khas suaranya dan gaya perekaman yang intim.Tes acuan tersebut menggunakan sampel narasi yang paling kuat sebagai masukan resmi dan meminta kelanjutan narasi dengan identitas perempuan yang sama secara umum serta gaya perekaman yang intim.
Kedua hasil tersebut mengucapkan kelanjutan yang diminta dengan tepat, tetapi tidak ada yang cocok dengan referensi. Hasil pertama berubah menjadi bisikan yang penuh napas dan mendapat skor kesamaan suara yang konservatif sebesar 2/5. Hasil kedua dinilai menggunakan suara laki-laki, mendapat skor kesamaan 1/5, dan menambahkan efek suara (Foley) yang tidak diinginkan selama sekitar 17 detik sebelum mulai berbicara.
Ada batasan penting terkait lingkungan di sini. Titik akhir tugas Anywhere memang menerima bidang referensi tersebut, tetapi tidak mengembalikan konfirmasi yang menunjukkan bagaimana model hulu memanfaatkan referensi tersebut. Hasil-hasil ini membuktikan bahwa kelangsungan referensi tidak dapat diandalkan melalui jalur pengujian kami; hasil-hasil ini tidak membuktikan bahwa API bawaan BytePlus selalu berperilaku sama.
Harga dan batasan Seed Audio 1.0
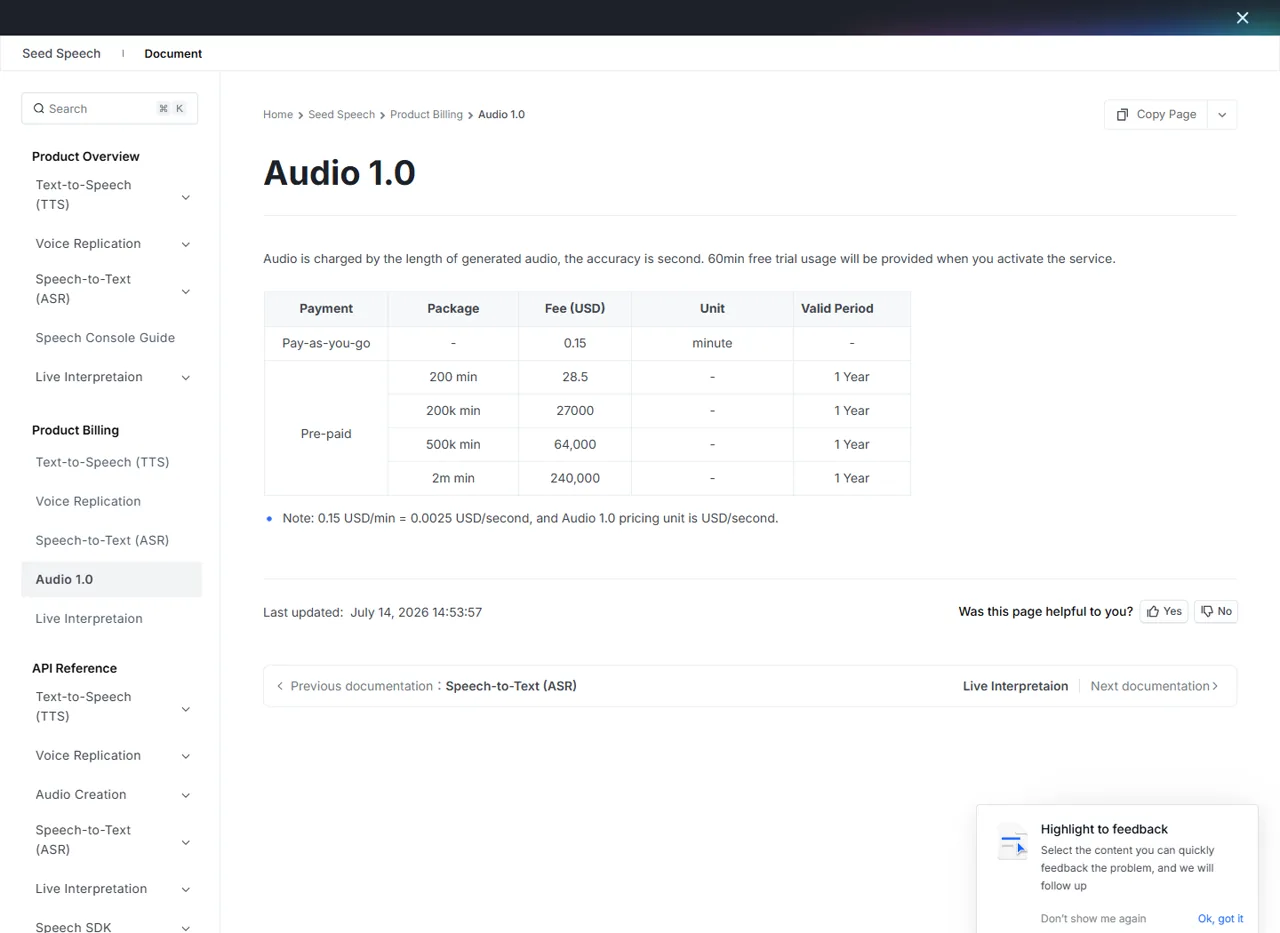
Tagihan dihitung per detik, dengan 60 menit uji coba gratis saat layanan diaktifkan.
daya keluaran maksimum
karakter prompt
referensi audio
gambar referensi
BytePlus mencantumkan harga resmi sistem bayar sesuai pemakaian sebesar $0,15 per menit yang dihasilkan, ditagih per detik, dengan 60 menit uji coba gratis ketika layanan diaktifkan. Dokumentasi API menetapkan sebuah Output maksimum 120 detik, mendukung prompt hingga 3.000 karakter, memungkinkan hingga tiga klip audio referensi, dan menerima satu gambar referensi.
Setiap klip audio referensi dapat berdurasi maksimal 30 detik dan berukuran maksimal 10 MB. Batas ukuran gambar referensi adalah 10 MB. Batas-batas ini merupakan batas bawaan BytePlus; platform pihak ketiga mungkin menampilkan formulir input dengan kapasitas lebih kecil atau menerapkan sistem harga yang berbeda.
Rute pengujian Anywhere/BrolyAI kami melaporkan biaya upstream secara terpisah dan rata-rata sekitar $0.14 per menit yang dihasilkan. Kolom lingkungan pengujian tersebut tidak boleh disamakan dengan harga eceran BytePlus atau harga akhir dari platform lain.
Kelebihan dan Kekurangan Seed Audio 1.0
Keunggulannya
- Suara terpadu, efek suara, suara latar, dan musik
- Penentuan waktu dialog yang sangat baik
- Identitas yang kuat dan mendalam
- Musik sinematik yang bermanfaat
Di mana bagian yang patah
- Variansi antar pengambilan yang besar
- Pidato yang terkadang tidak jelas
- Penghitungan SFX eksak yang lemah
- Kontinuitas rute kami tidak dapat diandalkan
Kelebihan
- Menghasilkan suara, efek latar, efek suara (Foley), dan musik dalam satu proses.
- Waktu dialog yang sangat tepat dalam serangkaian pengujian yang kami lakukan.
- Pemisahan suara yang jelas antara kedua speaker dan penanganan naskah yang tepat.
- Menghasilkan musik sinematik yang bermanfaat dan dapat dinikmati secara mandiri.
- Mempertahankan ciri khas suara dan koherensi narasi selama dua menit.
- Menghasilkan file WAV stereo 40 kHz yang jernih melalui jalur pengujian kami.
Kekurangan
- Hasil pengulangan dapat sangat bervariasi dalam hal kealamian dan keandalan.
- Sesekali terjadi ucapan yang terdengar seperti halusinasi atau tidak jelas.
- Jumlah SFX yang tepat tidak dapat diandalkan.
- Beberapa adegan yang sudah lengkap tidak menyertakan peristiwa terakhir yang diminta.
- Kinerja multibahasa perlu ditinjau dengan cermat.
- Kontinuitas suara referensi kurang baik di lingkungan pengujian kami.
- Pengiriman paralel dalam jumlah besar memicu kesalahan konkurensi di hulu, meskipun tugas-tugas yang gagal tidak dikenakan biaya.
Siapa yang sebaiknya menggunakan Seed Audio 1.0?
Seed Audio 1.0 sangat cocok bagi para pembuat konten audio yang memandang karya mereka sebagai rangkaian adegan, bukan sekadar aset-aset terpisah. Perangkat lunak ini sangat berguna terutama untuk drama radio, dialog game, prototipe sinematik, storyboard audio, konsep podcast, dan cuplikan musik suspense berdurasi pendek.
Sistem ini kurang meyakinkan jika digunakan sebagai sistem pengiriman akhir dengan satu klik. Jika pemilihan kata yang tepat, identitas suara, atau jumlah peristiwa sangat penting secara hukum atau kreatif, rencanakanlah proses pembuatan berulang dan tinjauan oleh manusia. Model ini bekerja paling baik jika Anda menganggapnya sebagai sutradara audio yang cepat dengan beberapa pengambilan suara—bukan sebagai alat render yang deterministik.
Pertanyaan yang Sering Diajukan
Apakah Seed Audio 1.0 merupakan model teks-ke-suara?
Apakah Seed Audio 1.0 dapat menghasilkan efek suara tanpa suara bicara?
Apakah Seed Audio 1.0 bisa menghasilkan musik?
Berapa lama Seed Audio 1.0 dapat menghasilkan suara?
Apakah Seed Audio 1.0 mendukung audio referensi?
Berapa harga Seed Audio 1.0?
Keputusan akhir
Seed Audio 1.0 adalah model audio terpadu yang benar-benar menarik. Kemampuannya untuk menghasilkan ucapan, efek suara (Foley), suara latar, dan musik yang meyakinkan dari satu perintah bukan sekadar klaim saat peluncuran: uji coba kami terhadap adegan campuran dan musik menunjukkan bahwa elemen-elemen tersebut dapat bekerja sama dengan baik.
Fitur terbaiknya adalah sinkronisasi dialog. Kelemahan terbesarnya adalah konsistensi. Dari 23 sampel, model tersebut berulang kali menunjukkan hasil terbaik yang sangat baik dan hasil alternatif yang terasa jauh lebih lemah.
Untuk pembuatan prototipe kreatif, kompromi tersebut mudah diterima. Buatlah beberapa versi, pilih yang paling baik, dan periksa setiap bagian penutupnya. Untuk produksi deterministik, pencocokan suara yang tepat, atau pekerjaan yang sensitif terhadap jumlah peristiwa, pastikan tahap peninjauan dan penyuntingan oleh manusia tetap ada dalam alur kerja.
Kesimpulan keseluruhan: Seed Audio 1.0 adalah salah satu generator audio tingkat adegan paling mumpuni yang pernah kami uji, namun alat ini paling baik digunakan sebagai alat kreatif multi-pengambilan daripada sebagai renderer akhir satu kali pengambilan.