
GPT-6.1 Sol adalah model seimbang dari OpenAI yang dirancang untuk pemrograman kompleks, penggunaan komputer, dan pekerjaan profesional. Model ini tetap mempertahankan jendela konteks 1.050.000 token dan batas keluaran 128.000 token dari GPT-6 Astra, namun tarif API Standar turun menjadi $2 per juta token masukan dan $10 per juta token keluaran. Angka tersebut setara dengan seperlima dari tarif token Astra saat ini. Komprominya sederhana: Astra tetap menjadi produk unggulan, sementara Sol bertujuan untuk menyediakan kemampuan yang cukup bagi tim yang mengutamakan biaya per tugas yang diselesaikan.
Panduan ini menjelaskan perbedaan antara apa yang Dokumen OpenAI untuk GPT-6.1 Sol berdasarkan pengamatan para kreator independen dalam uji coba awal. Hal ini juga memperlihatkan aturan penetapan harga berbasis konteks panjang, contoh biaya yang realistis, pola API Respons yang berfungsi, serta cara praktis untuk memilih di antara Sol, Astra, Luna, dan GPT-6 Sol versi sebelumnya.
Apa Itu GPT-6.1 Sol?
GPT-6.1 Sol adalah model Sol terbaru dalam keluarga GPT-6 dari OpenAI. Deskripsi resminya menyebutnya sebagai model untuk pemrograman kompleks, penggunaan komputer, dan pekerjaan profesional, dengan performa yang mendekati Astra namun dengan biaya yang lebih rendah. Dalam hierarki keluarga ini, Astra merupakan pilihan dengan kemampuan tertinggi, Luna adalah pilihan yang mengutamakan efisiensi, sedangkan Sol merupakan pilihan tengah untuk pekerjaan yang cukup sulit sehingga memerlukan penalaran yang kuat, namun cukup sering dilakukan sehingga biaya per unit menjadi faktor penting.
ID modelnya adalah gpt-6.1-sol. String persis itu berperan penting dalam panggilan API, log pengujian, catatan penagihan, dan konfigurasi penerapan. Versi yang lebih lama gpt-6-sol tetap merupakan model yang berbeda meskipun harga input dan outputnya yang tidak tersimpan dalam cache sama. Halaman OpenAI untuk model lama kini mengarahkan pembaca ke versi yang lebih baru, sedangkan kami Ulasan GPT-6 Sol dan Batasan API menjadi acuan historis.
Alasan paling jelas untuk memperhatikan pembaruan ini bukanlah sekadar angka di papan peringkat. Melainkan kombinasi antara jendela konteks berukuran luas, dukungan alat yang luas, lima tingkat upaya penalaran, serta harga yang membuat penggunaannya lebih luas daripada Astra. Sebuah model yang sedikit lebih lemah namun cukup terjangkau untuk dijalankan pada setiap draf serius, tinjauan kode, atau alur kerja bertahap dapat memberikan nilai lebih daripada model unggulan yang hanya digunakan pada kesempatan langka.
Penempatan tersebut masih perlu diuji berdasarkan tugas-tugas Anda sendiri. OpenAI’s panduan pemilihan model secara eksplisit merekomendasikan untuk membandingkan Sol dengan Astra pada pekerjaan yang sama. Alur kerja dokumen hukum, refaktorisasi repositori, agen peramban, dan presentasi papan dapat menguji kemampuan yang berbeda-beda. Perlakukan label model sebagai hipotesis awal, lalu ukur keakuratan, jumlah revisi, latensi, dan biaya total per hasil yang diterima.
Spesifikasi GPT-6.1 Sol
The katalog model resmi Mencantumkan masukan berupa teks dan gambar dengan keluaran berupa teks. Audio dan video bukanlah jenis masukan atau keluaran yang didukung oleh model itu sendiri. Perbedaan ini berguna saat merancang suatu produk: Anda dapat mengirimkan tangkapan layar, diagram, halaman yang dipindai, atau gambar lainnya, tetapi transkripsi audio dan pemahaman video memerlukan komponen atau alat terpisah.
Batas masukan maksimumnya lebih rendah daripada jendela konteks utama karena keluaran dan pemrosesan internal memerlukan ruang di dalam anggaran total. Batas keluaran sebesar 128.000 token memang cukup besar, tetapi meminta jawaban yang sangat panjang jarang menjadi desain terbaik. Keluaran yang panjang membutuhkan biaya lebih besar, memakan waktu lebih lama untuk ditinjau, dan dapat menyimpang. Untuk sebagian besar pekerjaan perangkat lunak, keluaran terstruktur yang lebih kecil dengan titik pemeriksaan lebih mudah diverifikasi.
Upaya penalaran mendukung rendah, sedang, tinggi, xtinggi, dan maks; pengaturan defaultnya adalah "medium". Yang tidak ada dan minimal Pengaturan tersebut tidak tersedia. Gunakan upaya yang lebih rendah untuk transformasi rutin, dan tingkatkan hanya jika biaya kesalahan atau kompleksitas suatu tugas membenarkan penggunaan token dan waktu tambahan. Tujuan praktisnya adalah pengaturan paling ringan yang masih dapat lulus uji penerimaan Anda.
Para pengembang yang membandingkan pola harga dan perilaku token di masa lalu dapat menggunakan layanan kami Contoh harga dan biaya GPT-6 Sol sebagai acuan. Perubahan spesifikasi utama bukanlah ukuran konteks, yang tetap konsisten di seluruh model GPT-6 yang dibahas di sini. Perubahan tersebut terletak pada penyesuaian posisi Sol yang lebih baru dan input yang disimpan dalam cache dengan biaya lebih rendah.
Kinerja: Apa yang Ditunjukkan oleh Bukti Resmi
Dalam siaran pers peluncurannya, OpenAI menyatakan bahwa GPT-6.1 Sol menunjukkan peningkatan yang signifikan dibandingkan GPT-6 Sol dalam berbagai tugas profesional yang kompleks, seperti menulis dan men-debug kode, memahami dokumen, serta menjalankan alur kerja bisnis multi-langkah. Perusahaan tersebut menyatakan bahwa GPT-6 Sol mendekati performa GPT-6 Astra dalam beberapa evaluasi dengan biaya yang lebih rendah. Hal tersebut merupakan klaim evaluasi resmi, bukan jaminan bahwa setiap prompt akan menghasilkan hasil yang mendekati performa Astra.
The Lampiran kartu sistem tata surya GPT-6.1 Hal ini menetapkan batasan penting: evaluasi dilakukan di lingkungan penelitian OpenAI atau melalui API, sedangkan ChatGPT di lingkungan produksi bisa berbeda karena prompt sistem, alat yang tersedia, dan pengaturan upaya tidak sama. Inilah mengapa sebuah artikel yang objektif harus memisahkan bukti benchmark resmi dari hasil uji coba pembuat konten dan dari evaluasi internal perusahaan.
Salah satu contoh konkretnya adalah HealthBench. Dalam tabel yang dipublikasikan, GPT-6.1 Sol mencatat skor yang disesuaikan dengan panjang teks sebesar 64,2 pada HealthBench Professional, 58,5 pada HealthBench, 36,2 pada HealthBench Hard, dan 96,0 pada HealthBench Consensus. Skor Astra yang sesuai adalah 64,7, 58,3, 36,6, dan 95,5. OpenAI menggambarkan model-model tersebut berada dalam rentang 0,5 poin persentase di keempat evaluasi tersebut.
Hasil tersebut mendukung istilah “dekat Astra” dalam kelompok evaluasi tersebut. Hal ini tidak membuktikan kesetaraan dalam hal kualitas rekayasa perangkat lunak, keandalan peramban, atau gaya tampilan. Tolok ukur kesehatan mengukur kemampuan yang berbeda dari memperbaiki kondisi persaingan atau mengoordinasikan alat-alat. Untuk melihat lebih dalam profil pengujian yang lebih luas dari produk andalan tersebut, lihat Ulasan dan Uji Coba Langsung GPT-6 Astra.
Interpretasi praktis yang paling kuat bersifat bersyarat: GPT-6.1 Sol termasuk dalam daftar kandidat untuk tugas-tugas berat, terutama ketika harga Astra dapat membatasi penggunaannya. Model ini layak dievaluasi secara berdampingan, bukan langsung dipromosikan. Ukur tingkat keberhasilan, jumlah koreksi oleh manusia, kesalahan alat, jumlah token keluaran, dan waktu hingga diperoleh hasil yang diterima. Metrik-metrik tersebut mengubah perbandingan model menjadi keputusan bisnis.
Pemrograman: Apa Saja yang Dapat Dilakukan oleh GPT-6.1 Sol
GPT-6.1 Sol memiliki komponen dasar yang diharapkan dari model pemrograman modern: streaming, keluaran terstruktur, pemanggilan fungsi, pencarian berkas, masukan gambar, pencarian web, dan penyimpanan sementara prompt. Melalui Responses API, OpenAI juga mencakup interpreter kode, shell yang dihosting, penerapan patch, keterampilan, penggunaan komputer, MCP, dan pencarian alat. Hal ini menjadikan model tersebut cocok untuk alur kerja yang memeriksa file, mengusulkan perubahan, menjalankan perintah, dan menghasilkan keluaran yang telah diverifikasi oleh mesin.
Dukungan kapabilitas tidak berarti setiap lingkungan secara otomatis menyediakan setiap alat. Aplikasi Anda tetap yang menentukan alat apa saja yang tersedia, izin apa yang diberikan kepada alat-alat tersebut, bagaimana hasil dikembalikan ke model, dan tindakan mana yang memerlukan konfirmasi. Fitur Chat Completions berfungsi pada GPT-6.1 Sol tanpa perlu memanggil alat, sedangkan OpenAI mengarahkan aplikasi yang menggunakan alat ke Responses. Sistem agen baru sebaiknya memperlakukan batas API tersebut sebagai pilihan arsitektural, bukan sekadar perbedaan sintaksis yang sepele.
Pada saat publikasi, model yang tepat belum diungkapkan dalam katalog obrolan tempat uji coba, sehingga panduan ini tidak mengklaim adanya tolok ukur baru untuk keempat tugas pemrograman yang direncanakan. Penilaian pemrograman didasarkan pada data kemampuan resmi dan uji coba publik yang telah disebutkan namanya. Hal itu lebih bermanfaat daripada diam-diam mengganti Astra atau Sol yang lebih lama dan mencantumkan nama model yang salah pada hasilnya.
Evaluasi yang komprehensif harus mencakup proses debugging dengan uji regresi, fitur multi-file yang dibatasi, tinjauan keamanan, serta keputusan rekayasa yang terikat skema. Tugas-tugas tersebut tidak hanya menguji proses pembuatan kode. Tugas-tugas tersebut juga mengungkap apakah model tersebut mempertahankan API, mendeteksi kasus-kasus ekstrem, mematuhi batasan keluaran, serta menyatakan hal-hal yang tidak dapat diverifikasi. Kami panduan model AI terbaik untuk pemrograman pada tahun 2026 menjelaskan mengapa pilihan terbaik berbeda-beda tergantung pada alur kerja.
Temukan cacat terkecil, pertahankan API-nya, dan tambahkan tes yang dapat dijalankan.
Perhatikan konkurensi, urutan, validasi, dan perilaku saat terjadi kegagalan.
Prioritaskan jalur eksploitasi, berikan solusi sementara, dan hindari klaim yang mengandalkan kerangka kerja fiktif.
Saat Anda menjalankan perintah seperti ini, nilai hasilnya secara otomatis. Apakah angka nol masih ada? Apakah duplikat sudah dihapus? Apakah pengurutan numerik sudah benar? Apakah tes-tes tersebut berjalan dengan node --test? Penjelasan yang apik tidak dapat menutupi pernyataan yang keliru. Prinsip yang sama berlaku dalam pekerjaan repositori: tentukan kriteria penerimaan sebelum memilih model, lalu tinjau patch-nya, bukan seberapa meyakinkannya uraian tertulisnya.
Harga GPT-6.1 Sol
The halaman resmi harga API Mengukur tarif GPT-6.1 Sol per satu juta token. Biaya input sebesar $2, biaya input yang disimpan dalam cache sebesar $0,10, biaya penulisan ke cache sebesar $2,50, dan biaya output sebesar $10. Oleh karena itu, input yang disimpan dalam cache setara dengan 5% dari laju input yang tidak disimpan dalam cache, sedangkan penulisan konten cache baru dikenakan biaya 1,25 kali lipat dari biaya input biasa. Biaya khusus alat dapat ditambahkan secara terpisah, sehingga perhitungan token hanyalah salah satu bagian dari beban kerja penggunaan alat.
Detail penetapan harga yang paling penting adalah ambang batas 272K. Begitu jumlah input melebihi 272.000 token, seluruh permintaan akan diproses dengan laju input dan cache dua kali lipat serta laju output 1,5 kali lipat. Ini bukanlah biaya tambahan marjinal yang hanya diterapkan pada token di atas ambang batas tersebut. Aplikasi yang secara rutin berada di dekat batas tersebut sebaiknya menghitung jumlah token sebelum mengirim dan mempertimbangkan penggunaan chunking, pengambilan data, atau kompresi.
Mode Cepat menggandakan harga Standar. Mode Batch dan Flex memangkas tarif Standar sebesar 50%, sedangkan pemrosesan regional menambahkan premi sebesar 10% jika tersedia. Mode-mode tersebut mengatasi masalah yang berbeda: Mode Cepat mengutamakan kecepatan dengan mengorbankan latensi, Mode Batch mengorbankan kecepatan demi biaya, Mode Fleksibel mengorbankan kepastian penjadwalan demi biaya, dan pemrosesan regional memenuhi kebutuhan lokasi data. Jangan membandingkan harga mereka tanpa mempertimbangkan batasan operasional masing-masing.
Harga Standar Astra adalah $10 untuk input dan $50 untuk output per juta token, tepat lima kali lipat dari tarif utama Sol. Harga tersebut Harga dan batas token API GPT-6 Astra Panduan ini membahas selisih harga tersebut secara lebih mendalam. Sol dan versi GPT-6 Sol sebelumnya menggunakan harga input dan output yang sama tanpa penyimpanan dalam cache, namun GPT-6.1 Sol mengurangi jumlah input yang disimpan dalam cache dari $0.20 menjadi $0.10 per juta token.
Contoh Biaya Sebenarnya
Harga token menjadi lebih mudah dinilai jika dikonversi menjadi permintaan lengkap. Contoh-contoh di bawah ini menggunakan pemrosesan Standar, tanpa biaya panggilan alat, tanpa premi regional, dan tanpa input yang disimpan dalam cache kecuali disebutkan lain. Panjang output yang sebenarnya sering kali memengaruhi tagihan lebih besar dari yang diperkirakan pengembang karena biaya output di GPT-6.1 Sol lima kali lipat lebih mahal daripada input biasa.
Untuk tinjauan kode dengan 100K input dan 5K output, biaya input sebesar $0.20 dan biaya output sebesar $0.05, sehingga menghasilkan perkiraan sebesar $0.25. Jika seluruh 100K input memenuhi syarat sebagai cache, bagian inputnya turun menjadi $0.01 dan totalnya menjadi $0.06. Jika aplikasi harus menulis prefiks 100K tersebut ke dalam cache terlebih dahulu, bagian penulisan ke cache adalah $0.25 sebelum keluaran.
Contoh dengan 300 ribu input melampaui ambang batas. Input ditagih dengan tarif efektif sebesar $4 per juta, sehingga 300 ribu dikenakan biaya sebesar $1,20. Output ditagih dengan tarif efektif $15 per juta, sehingga 10.000 dikenakan biaya $0,15. Totalnya adalah $1,35. Oleh karena itu, permintaan yang hanya sedikit di atas ambang batas dapat dikenakan biaya jauh lebih tinggi daripada permintaan yang berada tepat di bawahnya, bahkan sebelum diperhitungkan biaya alat.
Mode Batch atau Flex akan mengurangi setengah dari total Standard yang memenuhi syarat, sedangkan mode Fast akan menggandakannya. Untuk contoh pertama, itu berarti kira-kira $0,125 pada mode Batch atau Flex dan $0,50 pada mode Fast. Tim yang masih menggunakan model GPT-5.6 versi lama dapat membandingkan asumsi-asumsi tersebut dengan Harga GPT-5.6 dan kredit Codex kerusakan.
Cara Menggunakan GPT-6.1 Sol
Cara paling praktis bagi pengembang adalah menggunakan Responses API. Instal SDK OpenAI versi terbaru, masukkan kunci API melalui lingkungan Anda, dan atur model untuk gpt-6.1-sol. The panduan resmi pembuatan teks merekomendasikan Respons untuk permintaan model langsung, dan halaman model mengharuskannya untuk pemanggilan alat.
1. Mulailah dengan permintaan API Responses biasa
Buatlah permintaan pertama sesederhana mungkin. Pastikan ID model yang tepat tersedia untuk proyek Anda, catat bidang model dan penggunaan yang dikembalikan, serta simpan metadata yang cukup untuk mereproduksi proses tersebut. Jangan langsung memulai dengan rantai alat yang rumit. Permintaan yang sederhana akan memisahkan masalah akses model dari masalah definisi alat, izin, dan orkestrasi.
2. Tambahkan alat hanya melalui API Respons
Apabila alur kerja memerlukan pencarian berkas, pencarian web, eksekusi kode, akses shell, penggunaan komputer, MCP, atau fungsi khusus, tentukan kumpulan alat terkecil yang diperlukan. Batasi cakupan berkas dan jaringan, validasi argumen alat, dan tentukan tindakan mana yang memerlukan konfirmasi pengguna. Model tersebut dapat mengusulkan dan memanggil alat-alat tersebut, namun aplikasi Anda tetap bertanggung jawab untuk menjalankannya serta menerapkan izin akses.
3. Sesuaikan upaya penalaran dengan evaluasi
Mulailah dengan pengaturan “medium”, yang merupakan pengaturan default. Jalankan kumpulan evaluasi yang representatif, lalu bandingkan pengaturan “low”, “high”, atau “xhigh” berdasarkan tingkat penerimaan, jumlah token keluaran, latensi, dan jumlah revisi. Pengaturan “Max effort” mungkin berguna untuk tugas-tugas tersulit, tetapi menggunakannya di semua situasi dapat menghilangkan keunggulan biaya yang membuat Sol menarik. Pertahankan pengaturan paling ringan yang secara andal lolos uji.
4. Gunakan GlobalGPT untuk perbandingan interaktif
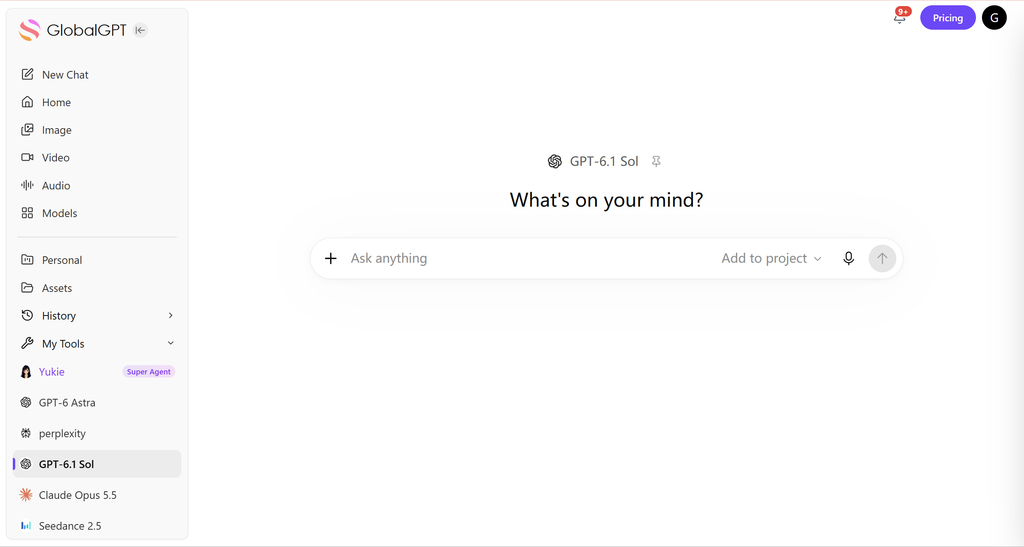
Untuk tugas interaktif, buka Ruang kerja multi-model GlobalGPT dan pilih GPT-6.1 Sol saat opsi tersebut tersedia di menu pemilihan akun Anda. Cara ini berguna untuk membandingkan jawaban tanpa perlu membuka tab terpisah atau berlangganan layanan tambahan. Cara ini tidak menggantikan pengaturan penerapan API, otomatisasi repositori, Codex, atau IDE. Panduan kami mengenai Pilihan model ChatGPT untuk pengkodean membahas perbedaan-perbedaan alur kerja tersebut.
GPT-6.1 Sol vs GPT-6 Sol, Astra, dan Luna
Keempat model dalam perbandingan ini menerima teks dan gambar, menghasilkan teks, serta memiliki jendela konteks sebesar 1.050.000 token dengan batas maksimum keluaran 128.000. Perbedaan yang signifikan terletak pada posisi, harga, tanggal batas, pengaturan penalaran, dan tingkat kualitas yang Anda amati pada tugas nyata. Tabel ini menggunakan harga token Standard resmi terkini yang diperiksa pada tanggal 1 Oktober 2026.
| Model | Paling cocok | Masukan / 1M | Tersimpan dalam cache / 1M | Keluaran / 1M | Batas |
|---|---|---|---|---|---|
| GPT-6.1 Sol | Pekerjaan yang rumit dengan pengendalian biaya | $2 | $0.10 | $10 | 30 April 2026 |
| GPT-6 Astra | Pekerjaan yang paling menuntut dan mengutamakan kualitas | $10 | $1 | $50 | 30 April 2026 |
| GPT-6 Sol | Integrasi Sol versi lama yang sudah ada | $2 | $0.20 | $10 | 20 April 2026 |
| GPT-6 Luna | Tugas-tugas yang terfokus dan berskala besar | $0.10 | $0.01 | $0.50 | 18 Mei 2026 |
Pilih Astra jika tugasnya cukup sulit sehingga peningkatan kualitas sekecil apa pun dapat mencegah pengerjaan ulang oleh manusia yang mahal. Pilih GPT-6.1 Sol jika pekerjaannya masih rumit namun sering dilakukan, terutama jika diskon input yang disimpan dalam cache dapat membantu. Pilih Luna jika volume dan latensi menjadi faktor utama dan ruang lingkup tugasnya sudah jelas. Pertahankan Sol versi lama hanya jika risiko migrasi, evaluasi yang sudah ada, atau masalah kompatibilitas membuat peralihan segera menjadi tidak menarik.
Selisih harga lima kali lipat antara Sol dan Astra memang besar, tetapi harga per token tidak sama dengan harga per hasil yang diterima. Model yang lebih mumpuni mungkin menggunakan lebih sedikit token keluaran, memanggil lebih sedikit alat, atau membutuhkan lebih sedikit revisi. Sebaliknya, Sol dapat menang bahkan dengan satu revisi tambahan jika harga satuan Astra melebihi selisih tersebut. Bandingkan jejak tugas secara keseluruhan daripada hanya mengalikan panjang prompt tunggal.
Para pembaca yang sedang mempertimbangkan apakah beralih ke model andalan ini layak dilakukan dapat menggunakan Perbandingan GPT-6 Astra versus GPT-5.6 Sol untuk konteks tingkatan sebelumnya. Untuk varian dengan harga terendah dalam jajaran saat ini, Ulasan GPT-6 Luna dan Penggunaan Terbaiknya menyajikan batasan API yang relevan serta kesesuaian dengan beban kerja.
Apa Kata Para Pengulas
OpenAI memperkenalkan GPT-6.1 Sol dalam pidato utama acara DevDay pada 29 September 2026, bersamaan dengan peluncuran produk-produk lainnya. Video resmi tersebut menetapkan waktu peluncuran dan positioning produk; namun, video tersebut bukanlah bukti independen. Reaksi eksternal yang bermanfaat justru datang dari para kreator yang mengungkapkan tugas, kumpulan data perbandingan, metode perhitungan biaya, dan kegagalan, alih-alih sekadar mengulang pernyataan resmi peluncuran.
Bisakah Dia Membuat Kode? melaporkan bahwa Sol jauh lebih murah dan lebih cepat dalam perbandingan tiga putaran antara Blender dan Godot, namun menyebutkan bahwa kualitas gimnya menurun seiring berjalannya putaran.
Matt Johnston Ia melaporkan skor tertimbang sebesar 96 dan biaya rangkaian tes $2.63 dalam konfigurasi sembilan tesnya, sekaligus secara jelas menyebutkan kegagalan pada tugas penguin.
Duncan Rogoff membandingkan Sol dengan Sonnet 5.5 dalam enam proses pembangunan dan mencatat waktu, token, serta biaya akhir.
Dalam Video tiga babak dari ’Can It Code?’, tugas-tugas tersebut berkembang dari kit ruang bawah tanah berpoligon rendah di Blender menjadi karakter yang telah dimodelkan dan dianimasikan, lalu menjadi game Godot yang dapat dimainkan. Pencipta memperkirakan waktu $29.17 dan 7 jam 5 menit untuk Sol di seluruh putaran, jauh di bawah hasil perbandingan, namun menilai game akhir kurang menyenangkan dan mengatakan Sol semakin buruk di setiap putaran. Kesimpulannya adalah soal biaya dan kecepatan dengan peringatan mengenai kualitas, bukan peringkat keseluruhan.
Ulasan Matt Johnston atas sembilan pertandingan uji coba melaporkan skor tertimbang sebesar 96, sama dengan Sonnet 5.5 dalam tabel Stonelabs-nya, serta biaya paket sebesar $2.63 dibandingkan dengan sekitar $14 untuk Astra dan $12 untuk Opus 5.5. Ia juga menyoroti adanya kesalahan pada tugas penguin. Angka-angka tersebut merupakan bagian dari desain benchmark dan perhitungan biayanya; angka-angka tersebut harus direproduksi sebelum digunakan untuk pengadaan.
Perbandingan enam model karya Duncan Rogoff mencakup halaman arahan, game browser 3D, adegan Blender, video penjelasan interaktif, dan presentasi untuk investor. Deskripsi publiknya menyebutkan bahwa uji coba ini memantau waktu pembuatan, penggunaan token, dan biaya akhir. Sampai hasil lengkap yang dapat dilihat telah ditinjau, panduan ini menggunakan video tersebut sebagai bukti metode perbandingan praktis, bukan sebagai bukti bahwa salah satu model menang.
Ulasan-ulasan awal ini sepakat mengenai satu pertanyaan yang bermanfaat: apakah harga murah Sol tetap bertahan saat diterapkan pada proyek yang lengkap? Jawaban mereka bergantung pada jenis tugasnya. Seorang pembuat melihat efisiensi biaya yang mencolok dengan kualitas game akhir yang kurang memuaskan; yang lain melaporkan skor tinggi dan biaya paket yang rendah; sedangkan yang ketiga merancang kompetisi head-to-head yang luas. Keragaman tersebut lebih informatif daripada kalimat kesimpulan yang disintesis.
Siapa yang Sebaiknya Menggunakan GPT-6.1 Sol?
GPT-6.1 Sol cocok untuk tim yang sudah memiliki pekerjaan yang substansial dan siklus evaluasi. Model ini sangat menarik terutama ketika konteks besar yang sama dapat digunakan kembali melalui penyimpanan prompt (prompt caching), ketika penerapan Astra terlalu mahal untuk diskalakan, atau ketika Luna tidak memberikan kedalaman yang cukup untuk tugas tersebut. Model ini kurang menarik ketika tugas ekstraksi atau klasifikasi ringan sudah berjalan dengan andal di tingkatan yang lebih murah.
- Pemrograman berskala repositori
- Hasil kerja profesional yang kompleks
- Peninjauan konteks panjang dengan penyimpanan dalam cache
- Alur kerja penggunaan alat dengan evals
- Keputusan yang sangat penting bagi keselamatan
- Tugas-tugas yang berisiko menimbulkan kesalahan mahal
- Pekerjaan di sekitar ambang batas 272K
- Aliran yang sensitif terhadap latensi
- Penandaan sederhana
- Transformasi deterministik pendek
- Ekstraksi bervolume tinggi dan berisiko rendah
- Tugas-tugas yang telah diselesaikan oleh Luna
Tim perangkat lunak sebaiknya mempertimbangkan Sol ketika mereka membutuhkan model untuk menganalisis beberapa berkas sekaligus, membuat tes, meninjau masalah keamanan, atau mengoperasikan alat di bawah pengawasan. Analis dapat menggunakannya untuk sintesis multi-dokumen dan hasil kerja yang terstruktur. Tim operasional dapat menggunakannya untuk alur kerja yang menggabungkan data, aturan, dan konteks bisnis. Dalam setiap kasus, alur kerja memerlukan kriteria penerimaan yang eksplisit serta langkah verifikasi yang dilakukan oleh manusia atau secara otomatis.
Pengguna individu dan tim kecil mungkin lebih memilih ruang kerja multi-model yang interaktif sebelum membangun integrasi API. Hal ini membuat perbandingan antara Sol dan Astra menjadi lebih konkret tanpa harus menentukan arsitektur aplikasi terlebih dahulu. Jika Anda masih mempertimbangkan pilihan antara penyedia layanan dan jenis layanan, panduan kami mengenai memilih model AI berdasarkan tugas, alat, dan biaya memberikan daftar calon yang lebih luas.
Batas dan Mode Kegagalan
Jendela konteks sebesar satu juta token adalah kapasitas, bukan memori yang sempurna. Petunjuk penting tetap dapat teredam oleh dokumen yang tidak relevan, aturan yang berulang, atau bukti yang saling bertentangan. Susunlah masukan yang panjang, identifikasi sumber yang dapat dipercaya, dan mintalah model untuk mencantumkan file atau bagian teks yang menjadi dasar kesimpulan penting. Proses pengambilan dan pemadatan data bisa lebih efektif daripada mengirimkan seluruh data pada setiap giliran.
Langkah penetapan harga berdasarkan konteks panjang merupakan risiko kedua. Permintaan dengan 273 ribu token masukan akan dikenakan tarif yang lebih tinggi untuk keseluruhan permintaan, bukan hanya seribu token terakhir. Hal ini dapat menimbulkan tagihan yang tidak terduga pada aplikasi yang menyusun konteks secara dinamis. Tambahkan fitur penghitungan token dan pemeriksaan anggaran sebelum permintaan dilakukan, serta catat dokumen mana saja yang menyebabkan panggilan melampaui batas tersebut.
Penggunaan alat memperluas kemampuan dan permukaan serangan. Perlakukan halaman web, berkas yang diunduh, dan hasil keluaran alat sebagai data yang tidak tepercaya. Lakukan validasi terhadap argumen fungsi, isolasi eksekusi kode, batasi jalur berkas dan akses jaringan, serta wajibkan konfirmasi untuk tindakan berdampak tinggi. Dukungan model ini terhadap penggunaan shell yang dihosting atau komputer tidak boleh dijadikan alasan untuk memberikan izin yang luas.
Terakhir, uji coba awal oleh para pembuat konten dapat memberikan informasi yang berguna tanpa harus dianggap sebagai hasil yang pasti. Perbedaan dalam petunjuk sistem, alat bantu, panduan, batas waktu, dan kriteria penilaian dapat mengubah hasil yang semula tampak menjanjikan. Gunakan uji coba publik untuk merancang evaluasi Anda sendiri, bukan untuk mengabaikannya. Sebuah model yang unggul dalam pembuatan game visual mungkin tetap gagal dalam rencana migrasi Anda, dan sebaliknya juga bisa terjadi.
Pertanyaan yang Sering Diajukan
Jawaban-jawaban ini merangkum fakta-fakta resmi mengenai API serta poin-poin pertimbangan praktis yang telah dibahas di atas.
Apa itu GPT-6.1 Sol?
GPT-6.1 Sol adalah model penalaran OpenAI yang dirancang untuk pemrograman kompleks, penggunaan komputer, dan pekerjaan profesional. Dengan konfigurasi OpenAI, model ini berada di antara tingkatan Luna yang terjangkau dan tingkatan unggulan Astra, dengan kemampuan yang mendekati Astra namun dengan harga API yang lebih rendah.
Berapa harga GPT-6.1 Sol?
Tarif standar API adalah $2 per juta token masukan, $0,10 per juta token masukan yang disimpan dalam cache, $2,50 per juta token penulisan ke cache, dan $10 per juta token keluaran. Prompt panjang, mode Cepat, pemrosesan regional, Batch, dan Flex dapat mengubah tarif efektif.
Apa itu jendela konteks GPT-6.1 Sol?
OpenAI memiliki jendela konteks sebesar 1.050.000 token, batas maksimum masukan 922.000 token, dan hingga 128.000 token keluaran. Jendela yang besar memungkinkan model menganalisis materi yang cukup luas, tetapi hal ini tidak menjamin recall yang sempurna atau membuat setiap permintaan besar menjadi efisien.
Apakah GPT-6.1 Sol cocok untuk pemrograman?
Alat ini dirancang untuk pemrograman yang kompleks dan mendukung keluaran terstruktur, pemanggilan fungsi, interpreter kode, shell terhosting, penerapan patch, keterampilan, MCP, serta alat-alat lain melalui Responses API. Tim produksi tetap disarankan untuk menjalankan pengujian khusus repositori sebelum mengalihkan alur kerja yang kritis.
Haruskah saya menggunakan GPT-6.1 Sol atau GPT-6 Astra?
Pilihlah Sol jika faktor biaya menjadi pertimbangan utama dan evaluasi Anda sendiri menunjukkan bahwa Sol memenuhi standar kualitas yang ditetapkan. Pilihlah Astra untuk pekerjaan yang paling menuntut, terutama jika peningkatan kualitas yang tipis saja sudah sepadan dengan tarif token Standar yang lima kali lebih tinggi. Uji keduanya pada tugas-tugas yang sama dan representatif sebelum mengambil keputusan.
Apa yang terjadi jika sebuah prompt melebihi 272 ribu token masukan?
OpenAI menyatakan bahwa permintaan lengkap akan dikenakan biaya sebesar dua kali lipat dari laju input dan cache normal, serta 1,5 kali lipat dari laju output normal, begitu jumlah input melebihi 272 ribu token. Perubahan mendadak ini bisa jadi lebih berpengaruh daripada ukuran jendela konteks yang tercantum secara umum dalam aplikasi yang menangani dokumen panjang.
Apakah GPT-6.1 Sol mendukung API Chat Completions?
Ya, fitur Chat Completions didukung untuk permintaan yang tidak melibatkan pemanggilan alat. OpenAI mengarahkan pengembang ke API Responses untuk pemanggilan alat, sehingga aplikasi baru yang bersifat agen atau menggunakan alat sebaiknya dimulai dengan API Responses daripada bergantung pada antarmuka yang lebih lama.
Apakah GPT-6.1 Sol dapat menerima gambar?
Ya. Halaman model resmi mencantumkan masukan berupa teks dan gambar dengan keluaran berupa teks. Audio dan video bukanlah jenis masukan yang didukung oleh model ini, meskipun sebuah aplikasi dapat menggunakan layanan atau alat lain yang terkait dengan model tersebut jika jenis media tersebut diperlukan.
Bagaimana cara menggunakan GPT-6.1 Sol pada GlobalGPT?
Buka GlobalGPT, mulai obrolan baru, lalu pilih GPT-6.1 Sol saat model tersebut muncul di pemilih model untuk akun Anda. GlobalGPT adalah ruang kerja multi-model yang praktis; kunci API, pengaturan penyebaran, dan otomatisasi repositori tetap menjadi alur kerja pengembang yang terpisah.
Keputusan Akhir
GPT-6.1 Sol adalah opsi GPT-6 yang paling menarik bagi pembeli yang membutuhkan kemampuan penalaran dan pemrograman yang mumpuni, namun tidak dapat membenarkan penggunaan Astra pada setiap eksekusi. Versi ini memiliki batas konteks dan keluaran yang setara dengan Astra, menggunakan batas pengetahuan yang sama hingga 30 April 2026, dan biayanya seperlima dari harga per token masukan dan keluaran yang tidak disimpan dalam cache berdasarkan tarif Standar. Diskon untuk masukan yang disimpan dalam cache juga lebih besar dibandingkan dengan GPT-6 Sol versi sebelumnya.
Model tersebut belum tentu menjadi pilihan terbaik. Luna tetap jauh lebih murah untuk pekerjaan yang terfokus, dan Astra mungkin masih dapat mengurangi jumlah revisi pada tugas-tugas tersulit. Perbandingan yang tepat adalah biaya total per hasil yang diterima, yang diukur dengan menggunakan prompt, alat, data, dan aturan penilaian yang sama. Untuk input di atas 272 ribu token, pertimbangkan faktor pengganda harga sebelum mengambil keputusan.
Buka GlobalGPT, pilih GPT-6.1 Sol jika sudah tersedia, lalu bandingkan dengan Astra atau Luna menggunakan satu tugas nyata dan satu daftar periksa penerimaan.
Buka GlobalGPTUntuk penerapan API, mulailah dengan halaman model resmi dan permintaan API Responses yang sederhana. Untuk perbandingan interaktif, gunakan rute multi-model di atas. Apa pun caranya, simpan hasil keluaran, riwayat penggunaan, pengaturan, dan kegagalan. Janji GPT-6.1 Sol bukan sekadar token yang lebih murah; melainkan peluang yang lebih baik untuk menjalankan penalaran yang mumpuni cukup sering sehingga menjadi bagian dari alur kerja.









