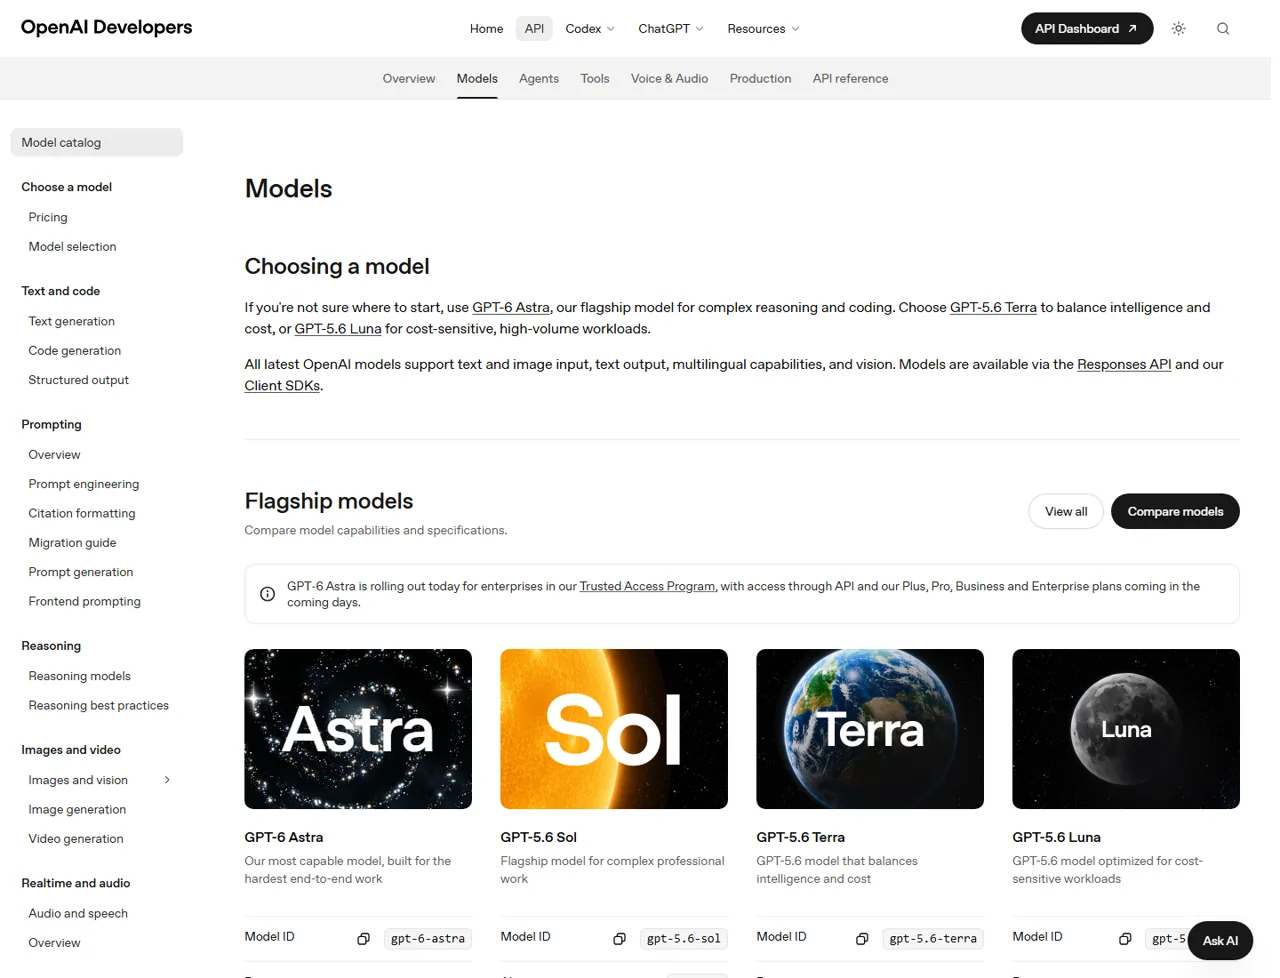
Réponse rapide : Coûts du GPT-6 Astra $10 pour 1 million de jetons d'entrée, $1 par million de jetons d'entrée mis en cache, $12,50 par million de jetons d'écriture dans le cache, et $50 par million de jetons émis aux tarifs standard tant que la longueur de la requête reste inférieure ou égale à 272 000 tokens d'entrée. Au-delà de 272 000, la requête complète passe à la tarification « long-context » : $20 d’entrée, $2 d’entrée en cache, $25 d’écritures en cache et $75 de sortie par million de tokens. OpenAI correspond à une fenêtre de contexte de 1,05 million de tokens et à une sortie maximale de 128 000.
Ces chiffres font d’Astra un outil puissant, mais suffisamment coûteux pour nécessiter une bonne planification. Une requête répétée peut s’avérer bien moins onéreuse lorsque la mise en cache fonctionne, tandis qu’une requête dépassant à peine les 272 000 tokens d’entrée peut devenir nettement plus coûteuse. Ce guide distingue les tarifs officiels des exemples de calcul et de nos observations pratiques sur l’API, réalisées le 5 septembre 2026.

Tarifs de l'API GPT-6 Astra
OpenAI distingue deux types de tarification Standard : la tarification à court terme et la tarification à long terme. Le seuil est basé sur jetons d'entrée, et non pas la somme totale des données d'entrée et de sortie. Le contexte court couvre les requêtes comportant jusqu'à 272 000 tokens d'entrée ; le contexte long s'applique au-delà de ce seuil.
Coût pour 1 million de jetons
La tranche supérieure s'applique à l'ensemble de la demande. Les prix indiqués s'entendent par million de jetons.
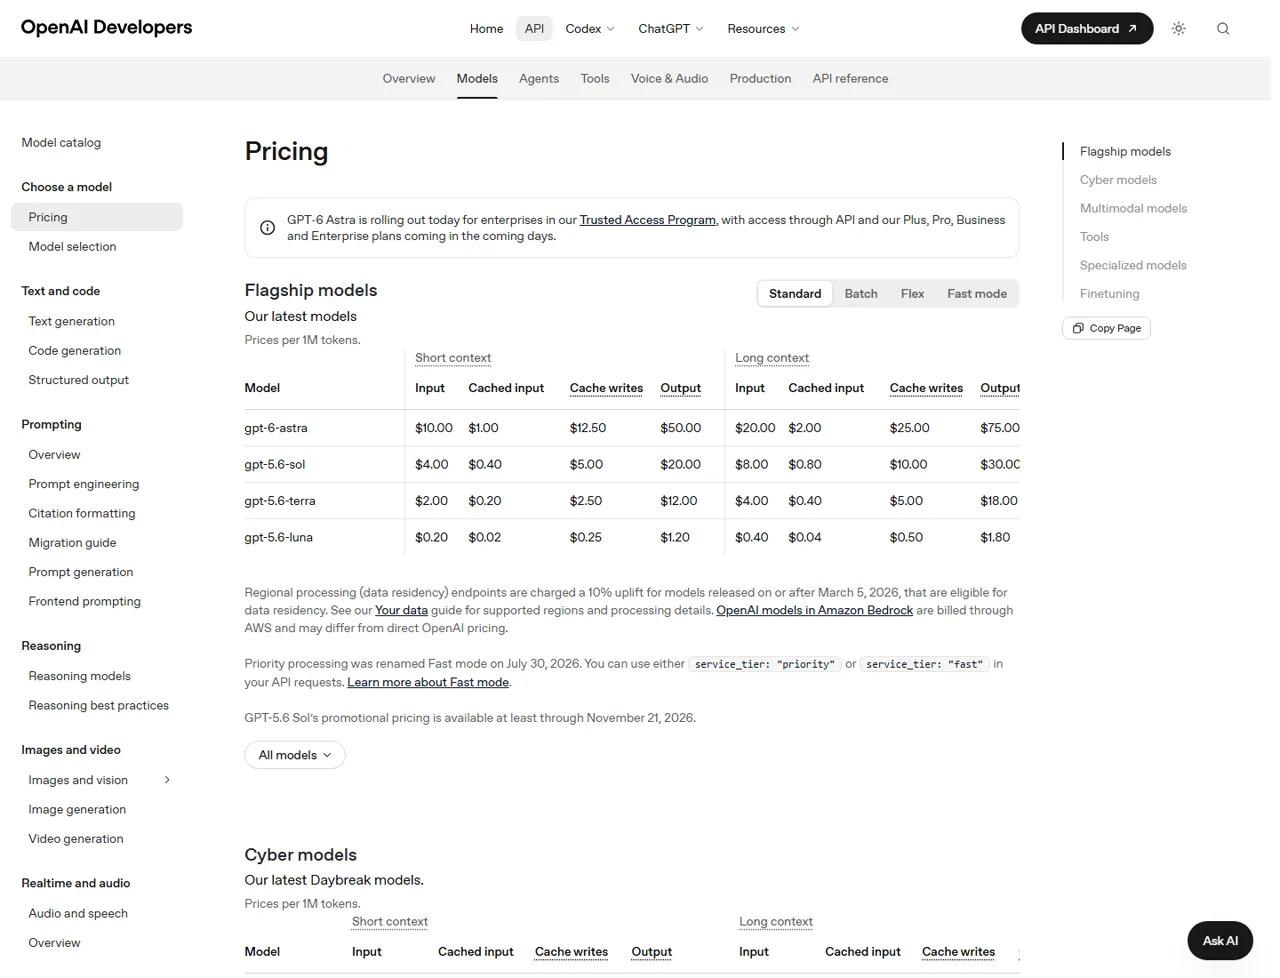
Le point le plus important à retenir est que le fait de dépasser les 272 000 ne donne pas lieu à une facture à taux mixte. Selon Documentation sur la tarification de l'API de OpenAI, les tarifs plus élevés s'appliquent à l'ensemble de la demande dès lors que le volume d'entrée dépasse le seuil fixé. Les équipes qui comparent Astra à un ancien produit phare devraient donc ne pas se limiter au prix d'entrée annoncé ; notre Guide des tarifs GPT-5.6 fournit des éléments de contexte utiles pour cette discussion sur le budget.
La mise en cache des requêtes peut réduire considérablement les coûts liés à la saisie répétée, mais la création d'un cache a un coût. Une écriture en cache coûte 1,25 fois le tarif d'entrée applicable hors cache. Les traitements par lots et Flex coûtent 50% en tarification Standard, tandis que le traitement Fast coûte deux fois le tarif applicable. Le traitement régional éligible ajoute 10%, et le traitement Fast n'est pas disponible pour Astra avec une résidence des données dans l'UE.
Combien coûte un appel à l'API Astra GPT-6 ?
Pour une requête « Standard », calculez séparément chaque catégorie de jetons facturés, puis additionnez les résultats :
Coût total = coût des entrées non mises en cache + coût des entrées mises en cache + coût d'écriture dans le cache + coût des sorties.
(0,0125 × $10) + (0,002 × $50)$0.225(0,1 × $10) + (0,005 × $50)$1.25(0,1 × $1) + (0,005 × $50)$0.35(0,3 × $20) + (0,01 × $75)$6.75Les devis aux tarifs standard ne comprennent pas les outils, les majorations régionales et les autres services facturés séparément.
Les 100 000 exemples montrent pourquoi les préfixes réutilisables sont importants : l'estimation du rapport modèle/jeton passe de $1,25 à $0,35 lorsque toutes les entrées sont considérées comme mises en cache. Il s'agit là d'une illustration tarifaire, et non d'une garantie que chaque invite répétée produira un accès au cache. Pour une estimation budgétaire multimodèle plus large, comparez les hypothèses de workflow dans notre Guide des modèles d'IA tout-en-un.
Jetons GPT-6 Astra, fenêtre de contexte et limites de sortie
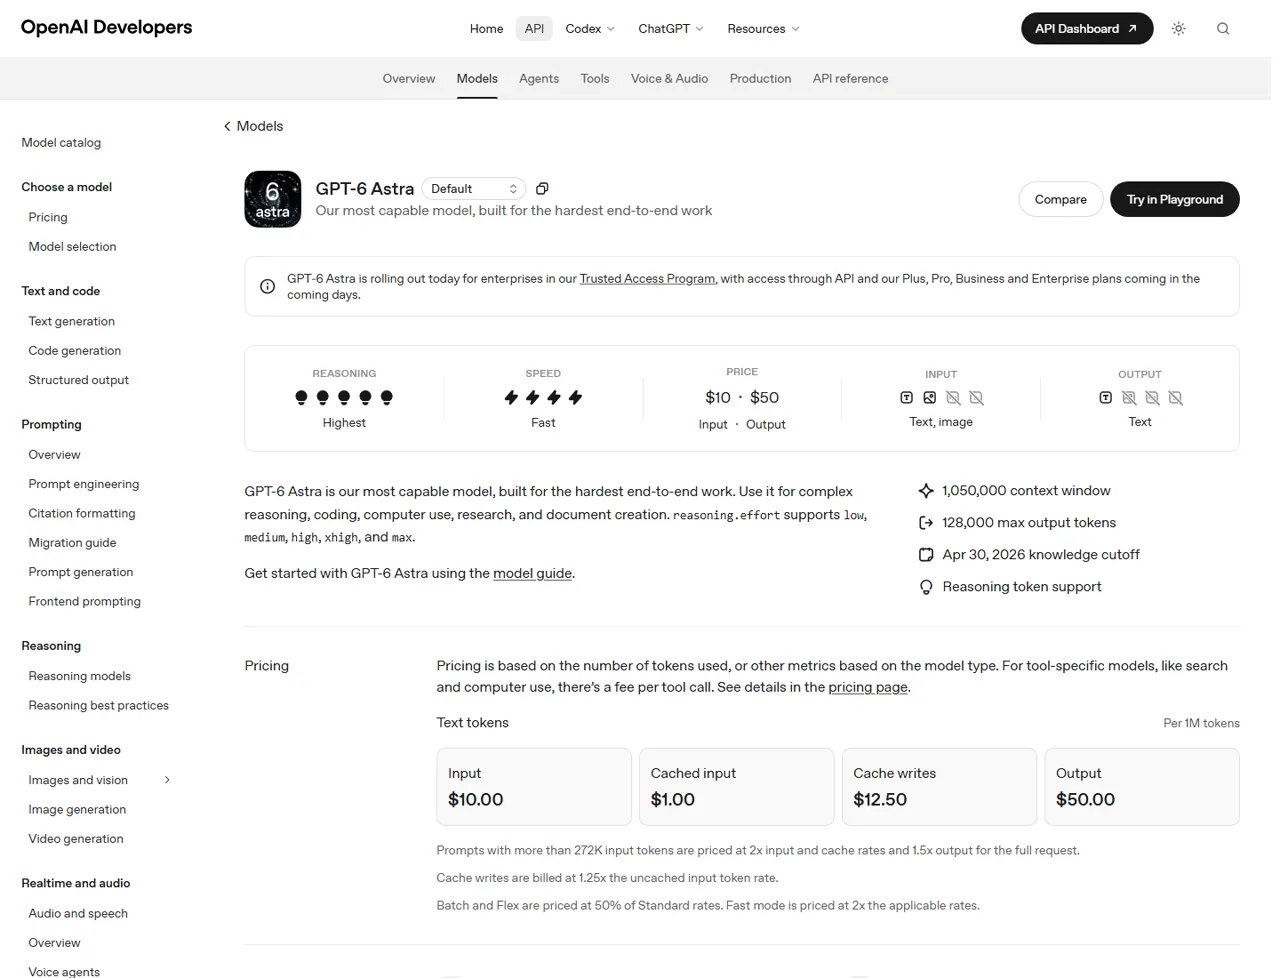
Le Page officielle du modèle GPT-6 Astra documents a Fenêtre contextuelle de 1 050 000 jetons et un Production maximale de 128 000 jetons. Sa date limite de mise à jour des connaissances est fixée au 30 avril 2026. Il accepte des entrées sous forme de texte et d'images, renvoie du texte et prend en charge les paramètres de niveau de raisonnement. faible, moyen, élevé, xhigh, et max.
Une grande fenêtre contextuelle est une capacité, et non une recommandation visant à satisfaire toutes les requêtes. La recherche, la sélection de documents, la synthèse et la structure des invites peuvent permettre de maintenir l'entrée en dessous du seuil des 272K. Le choix du modèle a également son importance : les développeurs spécialisés dans la programmation peuvent comparer les compromis dans notre Le meilleur modèle d'IA pour le codage une analyse, plutôt que de partir du principe que le modèle présentant la plus grande fenêtre est automatiquement celui qui correspond le mieux.
Six exercices pratiques pour tester l'API GPT-6 Astra
État des tests : GPT-6 Astra est désormais disponible via l’API de compatibilité Broly Anywhere depuis le 5 septembre 2026. Nous avons exécuté les six tâches indiquées ci-dessous. Cinq d’entre elles ont généré des réponses HTTP 200 exploitables ; la requête limite de 272 000 s’est soldée par un échec de transport et n’a pas pu être vérifiée.
Consignes et résultats observés
Référence du modèle gpt-6-astra. Chaque résultat correspond à un test observé, et non à un test de performance officiel. Le temps réel inclut les délais liés à la passerelle et à la liaison montante.
Comptabilité de base des jetons
Le modèle a donné le résultat théorique attendu. L'utilisation réelle de l'API s'est élevée à 54 jetons d'entrée et 26 jetons de sortie.
Mise en cache de l'invite
Les deux requêtes ont abouti à des résultats corrects, mais le préfixe répété a enregistré zéro jeton de mise en cache et zéro jeton d'écriture dans le cache dans les deux réponses.
Seuil de prix de 272 000
La requête synthétique de grande envergure s'est terminée avant l'arrivée d'une réponse HTTP. Aucun objet d'utilisation n'a été renvoyé ; par conséquent, la tranche de débit et le comportement de facturation n'ont pas été mesurés.
Raisonnement « minimum » vs « maximum »
Les deux exécutions ont donné le résultat $265,20. Max a mis plus de temps et a généré 88 jetons de raisonnement ; cette tâche arithmétique unique n'a pas montré d'amélioration de la qualité des réponses.
Paramètre de sortie 128K
Le point de terminaison de compatibilité a renvoyé « OK » au lieu de rejeter un jeton dépassant la limite maximale officielle. Il s'agit d'un comportement propre à la passerelle, et non d'une indication d'une fenêtre de sortie prise en charge plus large.
Tarifs et niveaux de service
Les réponses normales ne contenaient aucun en-tête « remaining-request » ni « remaining-token ». Les sondes « Flex » et « priority » ont toutes deux abouti, mais ont renvoyé la valeur « service_tier : default ».
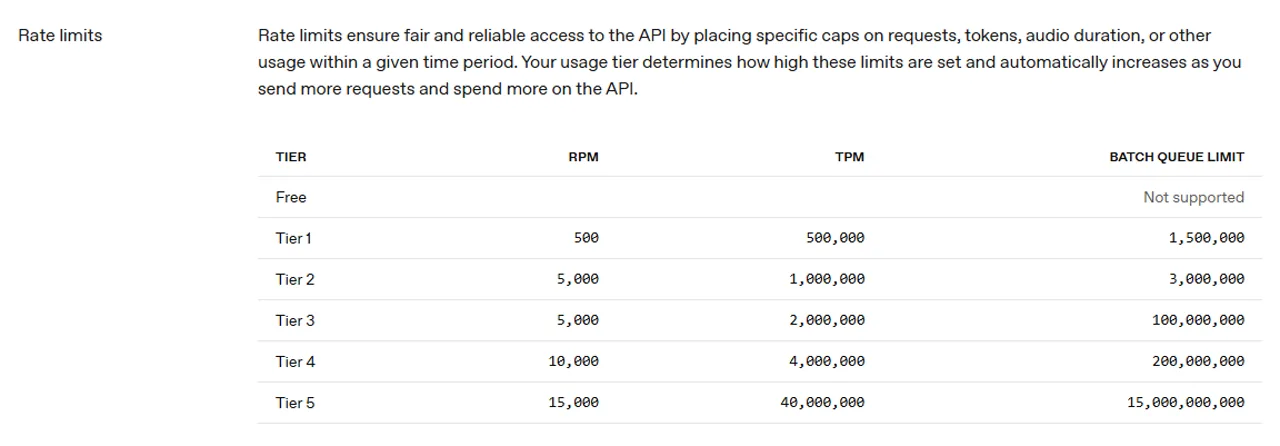
Limites de débit de l'API GPT-6 Astra
GPT-6 Astra n'est pas pris en charge dans le cadre du niveau « Free ». Les limites de publication augmentent en fonction du niveau d'utilisation, mais les en-têtes des projets en production restent la source la plus fiable pour connaître la capacité restante et les délais de réinitialisation.
La capacité augmente fortement au niveau 5
La hauteur de la barre est donnée à titre indicatif. Les valeurs exactes de RPM, TPM et de la file d'attente des lots ci-dessus sont déterminantes.
Les options « Batch » ou « Flex » permettent de réduire de moitié les tarifs par jeton de modèle lorsque des réponses immédiates ne sont pas nécessaires. L’option « Fast » peut convenir aux tâches sensibles à la latence, mais elle double le prix applicable et n’est pas disponible avec la résidence des données dans l’UE pour Astra. Avant de déployer une charge de travail en production, comparez le coût du modèle avec les autres dépenses liées à la plateforme ; notre Guide des prix Codex Cela montre pourquoi il ne faut pas mélanger les abonnements aux produits et la facturation par API.
Ce que révèlent les premières critiques
Le créateur indépendant Matt Wolfe a publié une première vidéo présentant des démonstrations de programmation, d'utilisation d'ordinateurs, de Blender et d'Unreal Engine. Ces exemples sont utiles pour comprendre les types de workflows explorés par les testeurs, mais il ne s'agit pas de résultats de tests de performance contrôlés et ils ne remplacent pas les tests d'API mentionnés ci-dessus. Des comparaisons plus générales telles que ChatGPT vs Claude vs Gemini Il convient également de les considérer comme des recommandations spécifiques à chaque charge de travail, et non comme un classement universel.
À qui s'adresse GPT-6 Astra ?
Astra semble être une solution adaptée aux tâches de codage complexes, aux flux de travail autonomes, à l'analyse de documents volumineux et aux tâches multimodales où un raisonnement plus poussé ou une fenêtre contextuelle très large peuvent compenser un coût élevé par token. Les équipes devraient le tester dans le cadre d'une tâche ciblée et mesurable, et comparer le rapport qualité-prix, et non pas simplement la qualité du résultat. Notre Aperçu des meilleurs modèles d'IA offre un cadre de sélection plus large.
- Utilisez Astra dans les cas suivants : la tâche est complexe, les erreurs coûtent cher, un contexte étendu est nécessaire, ou le modèle peut remplacer plusieurs passes moins performantes.
- Optez pour un modèle moins cher dans les cas suivants : le travail consiste en des tâches de routine telles que le classement, l'extraction, la réécriture ou la production de grands volumes, avec des exigences de qualité simples.
- Optimisez en premier lieu lorsque : les requêtes dépassent régulièrement les 272 000, les longs préfixes statiques peuvent être mis en cache, ou la latence ne nécessite pas de traitement « Standard » ou « Fast ».
Pour les lecteurs qui comparent des options haut de gamme similaires, le Comparaison entre les modèles GPT-5.6, Fable 5 et GPT-5.5 offre une autre perspective sur le rapport coût-performance, les capacités et l'adéquation à la charge de travail. GlobalGPT dispose d'un Page d'accueil de GPT-6 Astra. Nos observations relatives à l'API ont été enregistrées séparément via le point de terminaison de compatibilité de Broly Anywhere.
Questions fréquemment posées
Quel est le prix de l'API GPT-6 Astra ?
La tarification standard pour un contexte court est de $10/M pour les entrées, $1/M pour les entrées mises en cache, $12,50/M pour les écritures dans le cache et $50/M pour les sorties. Au-delà de 272 000 jetons d'entrée, la requête complète utilise $20/M d'entrée, $2/M d'entrée mise en cache, $25/M d'écritures en cache et $75/M de sortie.
Que se passe-t-il lorsqu'une requête dépasse les 272 000 tokens d'entrée ?
OpenAI transfère l'intégralité de la requête vers la tranche de contexte long. Il ne s'agit pas d'un système mixte dans lequel seuls les jetons supérieurs à 272 000 coûtent plus cher.
Quelle est la taille de la fenêtre de contexte de GPT-6 Astra ?
OpenAI prévoit une fenêtre de contexte de 1 050 000 tokens, une entrée maximale de 922 000 tokens et une sortie maximale de 128 000 tokens. Les tokens de raisonnement occupent également de l'espace dans le contexte et sont comptabilisés dans la sortie.
GPT-6 Astra prend-il en charge les images en entrée ?
Oui. La documentation du modèle mentionne la prise en charge de l'entrée de texte et d'images, avec une sortie sous forme de texte. L'audio et la vidéo ne figurent pas parmi les modalités d'entrée prises en charge par ce modèle.
Ces exemples de coûts correspondent-ils à des factures officielles ?
Non. Il s'agit d'exemples de calculs basés sur les tarifs indiqués. Votre facture peut également inclure la facturation des jetons mis en cache, le mode de traitement, le traitement régional et d'autres services facturés séparément.
Quels sont les modes de traitement disponibles ?
Les tarifs Astra sont documentés pour les options Standard, Batch, Flex, Fast et Ultrafast. Les options Batch et Flex coûtent la moitié du tarif Standard, l'option Fast coûte le double du tarif Standard et l'option Ultrafast coûte six fois le tarif Standard dans la même bande de contexte. Le traitement régional éligible ajoute 10% ; la disponibilité dépend du mode et du point de terminaison.
Comment GPT-6 Astra est-il facturé via GlobalGPT ?
L'API de GlobalGPT indique 23 crédits pour 1 000 jetons d'entrée et 117 crédits pour 1 000 jetons de sortie pour GPT-6 Astra. Les jetons de raisonnement sont facturés comme des jetons de sortie. Il s'agit des tarifs en crédits de GlobalGPT ; l'utilisation de l'API OpenAI suit sa propre tarification en dollars américains.
Verdict final
GPT-6 Astra combine une fenêtre de contexte de 1,05 million de tokens et une sortie maximale de 128 000 tokens, le tout à un tarif premium. Son tarif « Standard » pour un contexte court commence à $10 par million de tokens d’entrée et à $50 par million de tokens de sortie, mais la limite de 272 000 tokens, les tokens de raisonnement, les écritures en cache, le mode de traitement et la majoration régionale peuvent modifier considérablement la facture. Estimez le nombre de tokens avant d’envoyer des requêtes volumineuses, vérifiez la mise en cache à partir des données d’utilisation et évaluez Astra en fonction de la valeur de la tâche accomplie plutôt qu’en vous basant uniquement sur le prix affiché.